基于本地论文库的专题分析 · 2026-10-20
判断:这个方向已经非常拥挤,尤其是“给固定状态多一点空间”和“让同一状态少受干扰”两条主线。 从高阶张量、稀疏槽表、多记忆路由,到预条件、独立擦除、查询修正、时间分区和状态训练,主要设计环节都有多组相邻工作。新方法需要回答的已经是:相对这些近邻,究竟在什么资源预算、什么记忆负载下改善了哪一种失效。
本次以 paper-readings 为统计总体:135 篇独立论文,136 个来源版本,138 份中文笔记。按 arXiv 编号或独立 GitHub 来源去重,选用每篇本地已有的最高版本与最高笔记修订。纳入 45 篇直接相关论文(A)和 23 篇机制近邻(B),共 68 篇;另 67 篇在末尾说明边界。B 包括 SSM、非线性快权重、显式记忆和综述,68 不是“68 种纯 linear attention 算法”。这是用户论文库的专题整理,不是全球论文数量统计,也不以收录数量代替学术质量判断。
文中的“作者报告”保留各篇的实验条件;“本次分析”用于统一符号、归类和推导。核心数值对照本地原文 PDF/TeX,全部相关论文的题名、版本、笔记与原文链接见第 8 节。图表由 Matplotlib 绘制,统计图来自去重清单,实验图来自指定论文,未混合不同论文的分数制作排行榜。
1. 为什么可以说已经非常拥挤
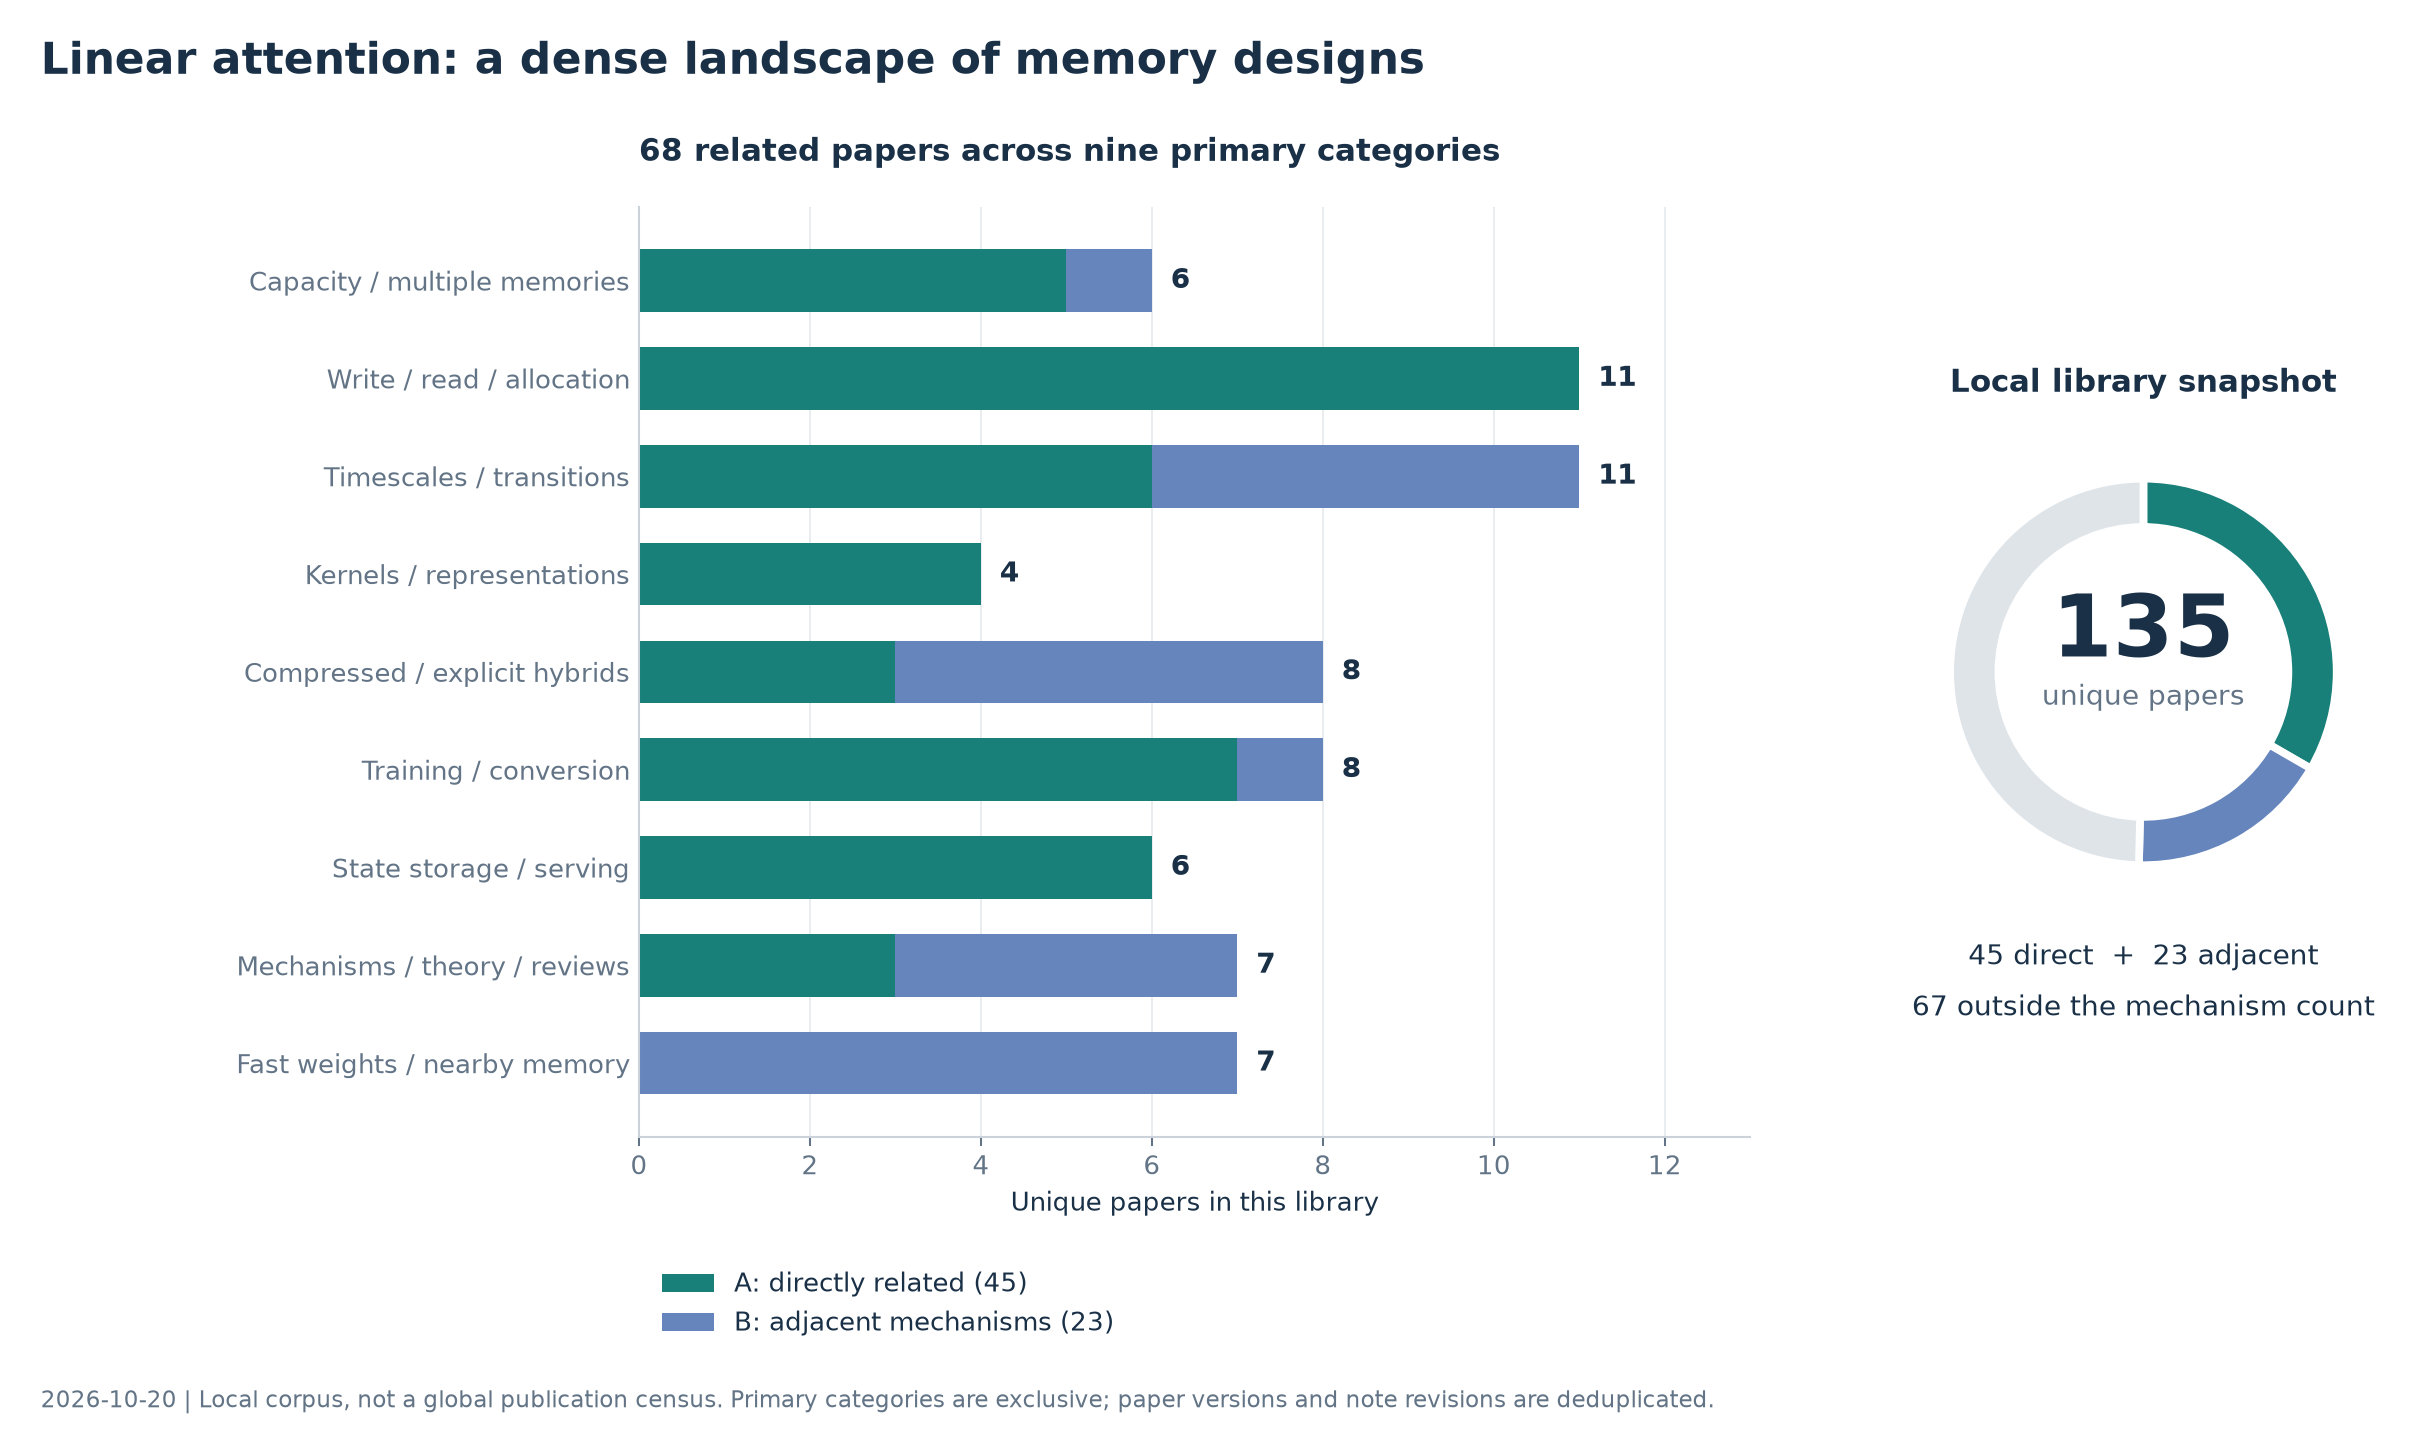
图 1 的分类按主要贡献互斥计数:扩容与多记忆 6 篇,写入/读取/容量调度 11 篇,时间尺度/状态变换 11 篇,核与压缩表示 4 篇,压缩与显式检索组合 8 篇,训练与转换 8 篇,状态存储与服务 6 篇,机制/理论/综述 7 篇,快权重近邻 7 篇。颜色区分 A/B;这反映本地库的研究覆盖面,不代表全领域的发表占比。
拥挤更直接的证据是创新动作的密集重叠:
| 一个自然的研究想法 | 已经存在的近邻 | 新工作需要进一步说明什么 |
|---|---|---|
| 把状态变大,但少增加慢权重参数 | Triadic、SDM、MoM、FwPKM | 扩大的内容地址、总存储、学习初态和真实访问成本各是多少 |
| 不让所有 token 修改同一块记忆 | MoM、SDM、Proteus、CyFA | 是增加了总记忆,还是在等总预算下改善了隔离与调度 |
| 根据历史几何调整写入 | PDN、OSDN、KDN、Bayesian Layer、Lattice | 对角/稠密统计、写入方向和局部正交分别贡献什么 |
| 不只做普通 delta 更新 | EDA、Q-Delta、MDN、DeltaProduct、SRWM | 新增擦除、反馈、动量或多步计算是否值得额外成本 |
| 改善旧信息的保留时间与表示 | DSLA、MS-GLA、FRAC、SpectralShift、Selective RoPE、CKDA、SFDA | 长寿命信号、噪声积累和状态追踪能否同时改善 |
| 给线性状态配一个精确记忆通道 | BASED、Samba、LoLA、HOLA、NAtS-L、KVM | 缓存大小、选择规则和分支分工的独立作用是什么 |
| 让状态在训练时真正学会承担任务 | JRT、HedgeCATs、DAT、LengthGen、HypeNet | 推理架构变化与训练、蒸馏、输入顺序的收益能否分开 |
| 把节省的字节和带宽变成可用资源 | StateReduction、DAMP、LeapQuant、DeltaLog | 节省来自裁剪、精度还是写回调度,能否在同质量下成立 |
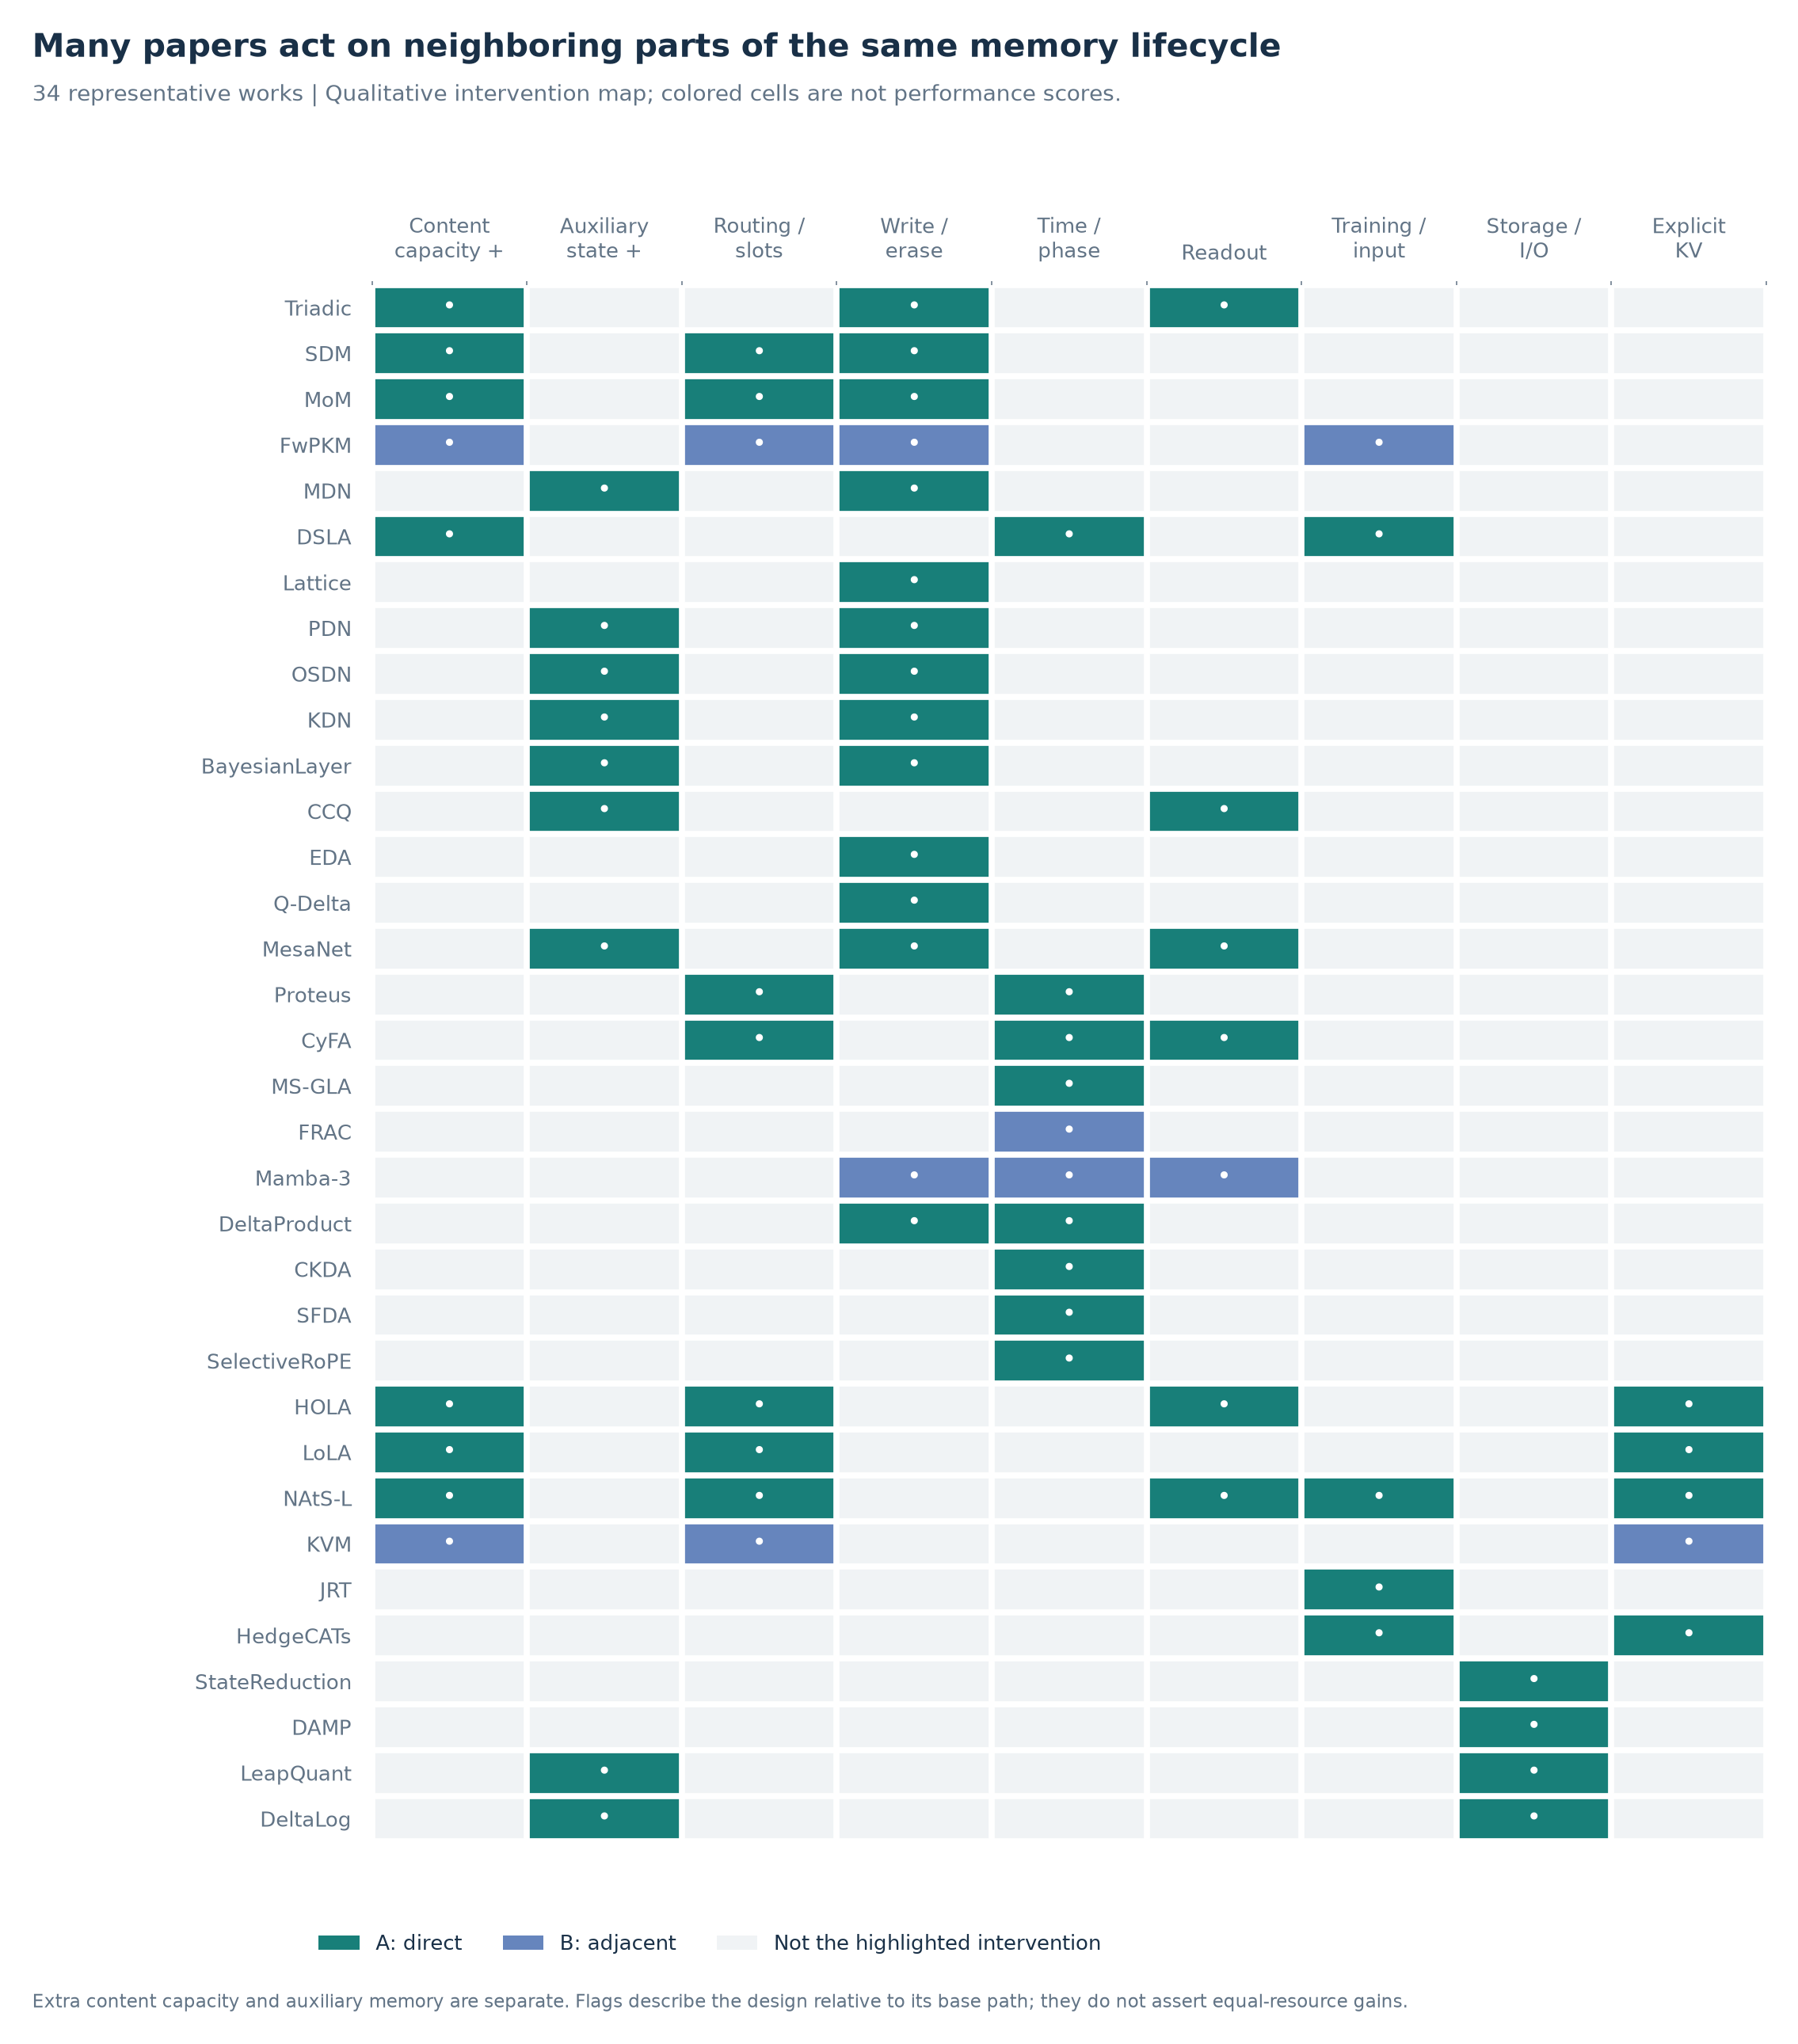
图 2 选取 34 个代表工作,标记其干预环节;色块是本次机制分类,既不是提升幅度,也不是作者认可的统一分类。“内容容量增加”与“辅助状态增加”分列:MDN 的动量、CCQ 的协方差、KDN 的不确定性都占资源,却不直接增加主内容记忆的地址数。一个方法可以横跨多列,因此实际的近邻关系比主分类更密集。
这里的“拥挤”并不意味着问题已经解决。原文中的剩余缺口很具体:大状态仍会在多事实检索中失效;局部回归更准确未必改善最终召回;混合模型可能主要依赖显式 KV;固定状态可以一直运行,却不能因此无损保存任意多的新事实。竞争密度高和基础瓶颈尚存,可以同时成立。
2. 先定义 state:四种容量不能混为一谈
2.1 内容维度、总字节、可用地址与任务能力
统一采用列向量记号,单头关联状态为 $S_t\in\mathbb R^{d_v\times d_k}$。最简单的线性记忆是
忽略归一化与门控时,输出为 $o_t=\sum_{i\le t}v_i(k_i^\top q_t)$。它把显式历史变成固定统计;这里“linear”首先指状态计算结构,不表示整个神经网络没有非线性。核归一化的线性注意力还需要分母统计,例如 $z_t=\sum_{i\le t}\phi(k_i)$。GLA、DeltaNet、SSM、固定槽 softmax 和记忆网络也有不同递推,不能全部当作这个最简公式的同一实现。
| 容量概念 | 应如何计量 | 容易产生的误判 |
|---|---|---|
| 名义内容状态 | 所有层、所有头的内容元素数,例如 $\sum_{\ell,h}d_{k,\ell h}d_{v,\ell h}$ | “参数差不多”不代表序列状态差不多 |
| 总运行时存储 | 内容状态 + 协方差/动量/统计 + 日志/补偿 + 卷积状态 + 精确 KV;逐项记录 dtype | 主矩阵没变,却多存了一块同规模辅助矩阵 |
| 可区分的地址与可实现的变换 | key 的独立方向、槽位组织、路由可达性、允许的转移族 | 多一些 value 通道不一定能多保存同样数量的独立 key |
| 任务有效容量 | 指定事实负载、距离、数据分布和准确率门槛下,可可靠使用多少新关联 | PPL、稳定秩或单针准确率不能单独代表全部记忆能力 |
多头同样要看约束:固定每头维度而增加头数会扩大状态;固定总投影宽度时,更多头通常会缩小每头维度,状态总元素数不一定增加。比较时应直接报告形状与元素数,不能只报 head 数。
本次建议把存储写成
并另报共享慢权重、可学习初态、训练优化器状态以及服务中的检查点数量。推理持久状态、训练峰值显存、单个 GPU 内核的工作集,是不同资源指标。
更有解释力的利用率指标是在相同任务、value 信息量和准确率门槛下,比较每 MiB 总运行时状态可支持的独立随机关联数。它需要配合实际延迟和训练预算;不存在脱离任务分布的统一“state 利用率百分比”。
2.2 容量与利用率为什么相关,又为什么不能互相代替
对普通线性读出,若一组固定 keys 组成 $K=[k_1,\ldots,k_N]\in\mathbb R^{d_k\times N}$,要求同时恢复任意 values $V$,就需要解 $SK=V$。当 $N>d_k$ 时,一般无法对任意独立 $V$ 精确成立。这个理想化事实说明了地址方向的重要性;它不是对多层、带门控、非线性读出模型的通用容量定理。
有限精度还有更基本的约束。以下是本次教学推导:设一个完整状态含 $M$ 个、每个 $b$ bit 的元素,任务要求在读完后,对任意一个已知索引准确返回其独立取值,取值集合大小为 $Q$。若要对全部 $Q^N$ 种赋值无误,至少需有
这只针对新随机值、全部赋值均需正确的任务。现实文本有冗余,可以压缩;但改进利用率不能突破这种任务中的有限存储计数约束。扩容改变可存信息的上限,利用率决定模型离现有资源所允许的能力还有多远。
状态稳定秩 $\|S\|_F^2/\|S\|_2^2$、key 条件数、读写方向重叠可用于诊断;它们都不能独自证明事实可被正确读取。StateReduction v3 与 LinearAttn-Memory v1 分别提供了谱诊断和因果干预的实例。
2.3 六篇基础工作,作为后续方法的参照
这些是本次在线核对的原始来源,不加入本地 135/68 的计数:
| 基础工作 | 与两条主线的关系 |
|---|---|
| Transformers are RNNs(2020) | 将核化注意力改写为可递推的固定统计 |
| Linear Transformers Are Secretly Fast Weight Programmers(2021) | 将线性注意力连接到快权重与误差修正写入 |
| Gated Linear Attention(2023) | 内容相关门控与高效训练,成为大量状态利用率工作的基线 |
| Parallelizing Linear Transformers with the Delta Rule(2024) | 让 delta 递推可高效分块训练,支撑后续更新规则研究 |
| Gated Delta Networks(2024) | 组合遗忘和 delta 修正,成为扩容与抗干扰方法的共同底座 |
| Kimi Linear / KDA(2025) | 更细粒度的遗忘控制与专门分块算法,是许多新方法的直接比较对象 |
3. 主线一:增加 state 容量
3.1 扩大地址,而不是只扩大投影:Triadic
Triadic v1 把单次 $v_t\otimes k_t$ 写入变成 $v_t\otimes k_t\otimes k'_t$,第二 key 维度为 $E$。忽略遗忘和 delta 的基础式为
展平联合地址 $\kappa_t=k_t\otimes k'_t$ 后,状态是 $d_v\times(d_kE)$ 矩阵。它真正扩大了内容地址空间,同时利用乘积结构,只需增加短的第二 key/query 投影,而不是直接学习一整套 $d_kE$ 维投影。按片遗忘与联合 delta 更新进一步控制使用方式;所以它兼有容量和组织收益。
代价也明确:稠密内容状态、跨块传递和逐 token 访问随 $E$ 增长。“少加参数”并不是“少加状态”。400M GDN 从 6.3 MB 到 50.3 MB,参数从 380.9M 到 385.4M;作者表格按每元素 2 字节计量。训练内核的 FP32 工作集不能直接套用这个字节数。
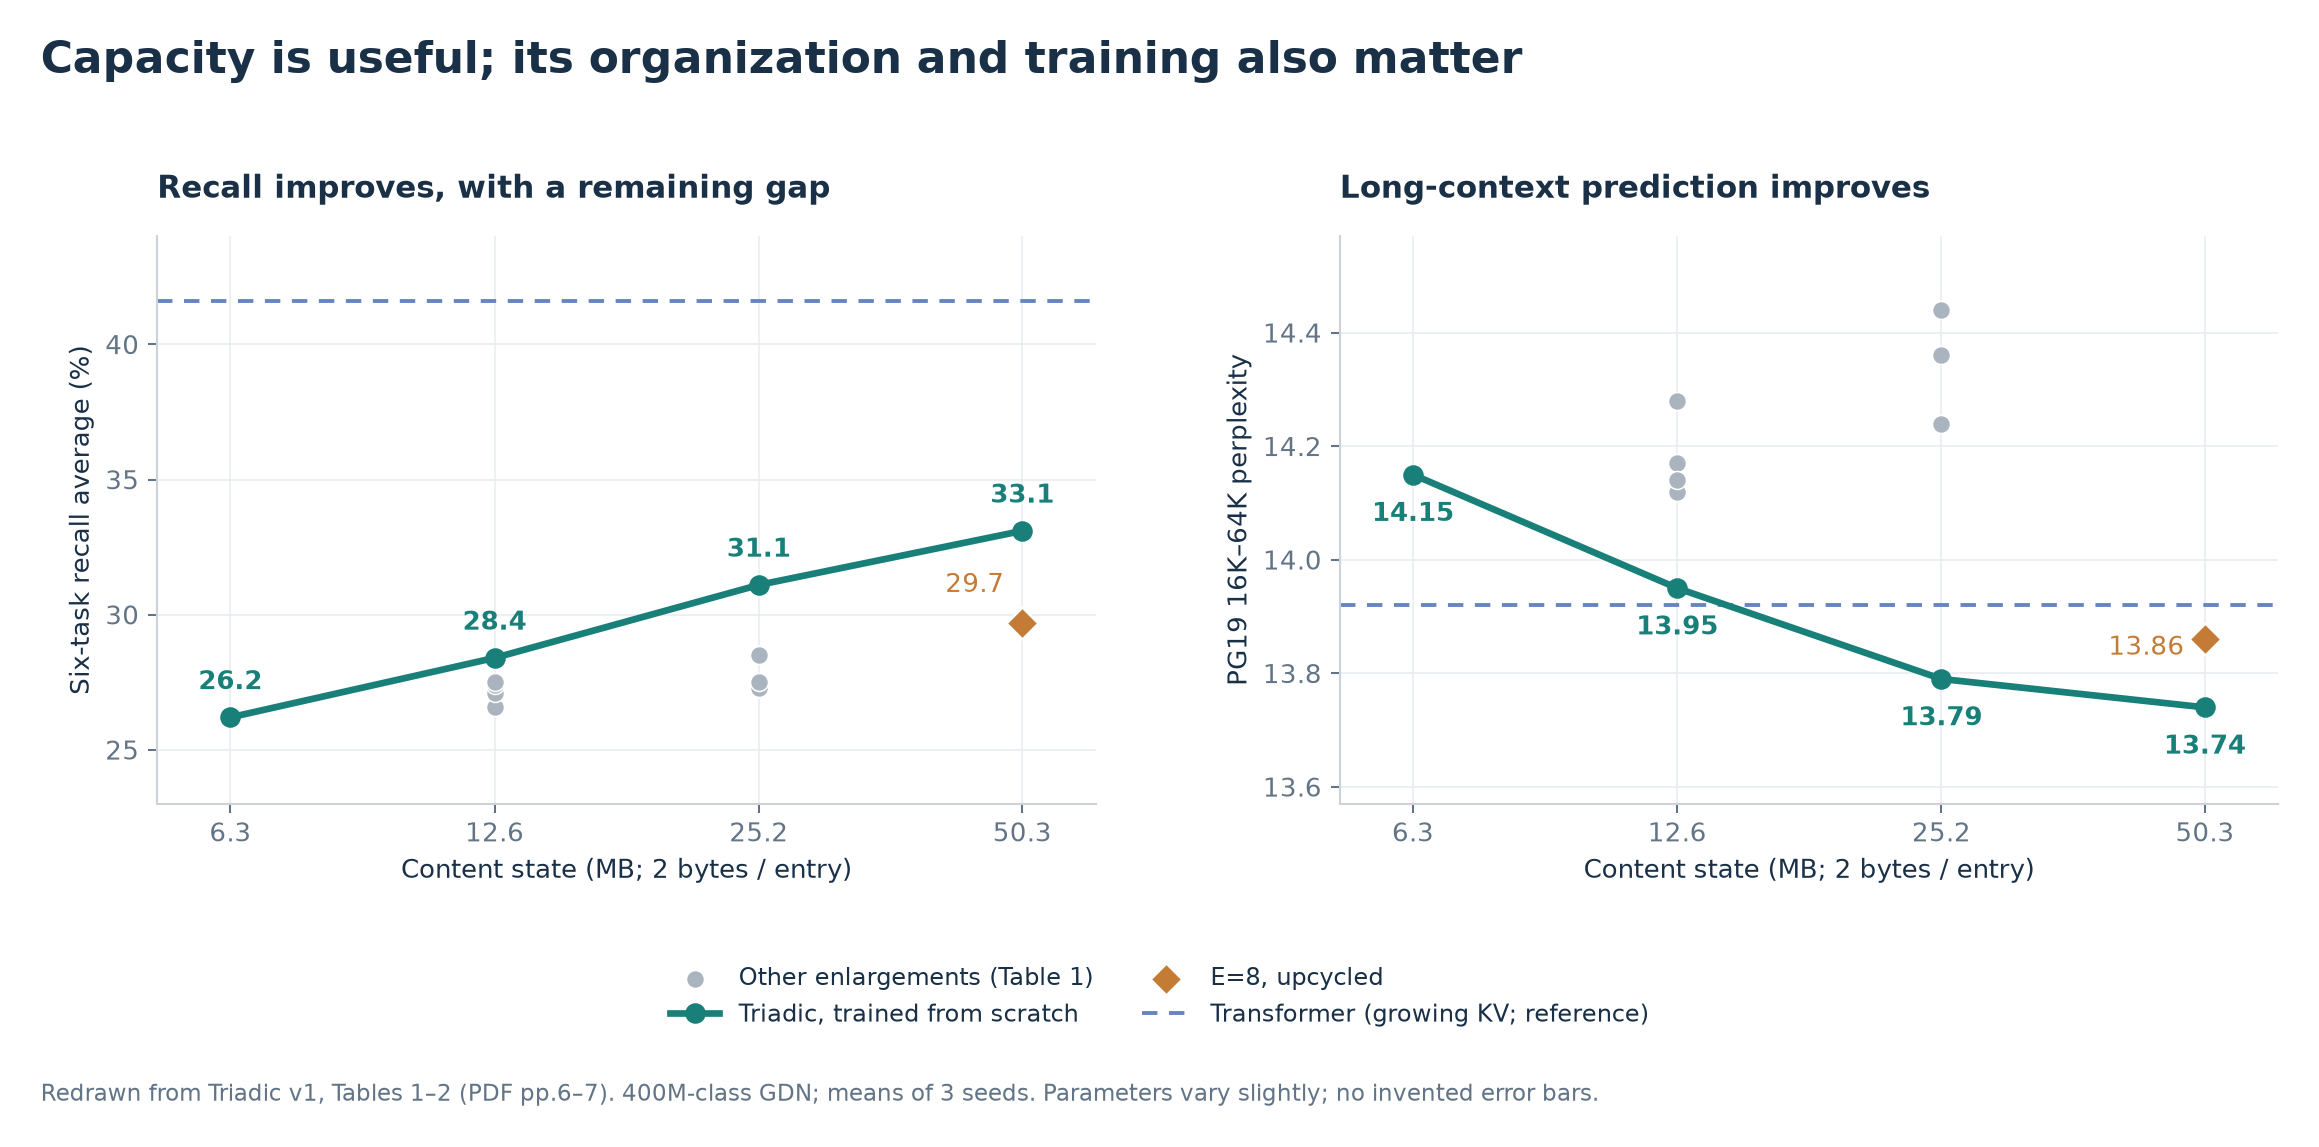
图 3 根据 Triadic **Table 1(PDF p.6)、Table 2(p.7)**重绘,均为 400M 类 GDN;400M 结果是三个训练种子的均值,图中不虚构误差条。横轴是按 2 字节/元素计量的状态 MB,采用以 2 为底的对数刻度。灰点是扩大 head/value 等替代方案,绿线是从头训练的 Triadic,橙点是扩容后继续训练的 E=8。Transformer 虚线仅作任务参照,其 KV 随长度增长,不代表等固定状态预算。
这组结果同时说明三件事:
- 扩容确实有用:E=1→8 时,六任务召回均分 26.2→33.1,PG19 16K–64K PPL 14.15→13.74。
- 同样大的状态,组织和参数分配仍重要:4 倍状态下,Triadic 的召回为 31.1,而大 head / 分组 value / 宽 value 为 28.5 / 27.3 / 27.5。参数预算迫使部分替代方案缩窄 MLP,因而不能把全部差异归因于“存储格式本身”。
- 容量相同,训练经历仍重要:50.3 MB 下,E=8 从头训练为 33.1,后期扩容为 29.7;增加可用坐标并不意味着模型已学会使用它们。
在另一项 1.3B、H100 单块前向+反向测试中,8 倍状态增加约 28%–30% 耗时;这是专门内核利用结构的结果,不能直接解释成端到端训练或生成都只增加 30%。1.3B 的四项 NIAH 曲线在 64K 仍明显落后 Transformer(Fig.3,p.7;效率见 Sec.3.5,p.8)。
3.2 大而稀疏访问:SDM 与 FwPKM
SDM v1 维护 $N\times d_v$ 的显式记忆表,每 token 只选 $W$ 个槽写入、$R$ 个槽读取。主要内容访问由 $W,R$ 控制,总存储由 $N$ 控制。乘积键将寻址拆为两个子空间,避免扫描完整 $N$ 槽表。
这里没有写成“扩容完全不增加计算”,因为子键投影、top-k 和不规则访存仍有成本。默认 $W=R=64$;寻址子空间还会随 $\sqrt N$ 变化。低 FLOPs 的稀疏访问也可能比驻留在片上存储的稠密更新更慢。
尤其要重视其预算口径:论文的 Params 明确排除了 SDM 记忆,默认初始记忆 $M_0$ 可学习。 Table 1(PDF p.6)中,8.14B 档位的全部全局层状态由 GDN 的约 2.2M 元素增至 SDM 的 7.963B 元素;这是数量级的存储改变。若全部按 2 字节稠密保存,后者约 15.9 GB,此处只是按表内元素数换算,不是作者实测的服务峰值显存。
8B 档位 RULER 13 任务、4K–131K 多长度平均为 GDN 34.2、SDM 50.2、FullAttn 61.2。1.4B 消融中,去掉可学习初态后 SDM 仍为 28.0,高于 GDN 的 20.0;学习初态后为 31.2。因而既有在线容量收益,也有额外参数记忆收益。作者报告 8B 的 SDM 训练吞吐比 GDN 慢约 1.49 倍,不能把 isoFLOP 写成同速度(Tables 2–3,pp.8–9)。
FwPKM v2 是相邻路线:大值表配稀疏寻址,在块边界用局部目标更新快键和快值,属于测试时学习。它还涉及重读次数和快权重共享协议。两者都在“用少量激活访问大记忆”,但 SDM 的稀疏 delta 层和 FwPKM 的局部训练记忆不是同一个更新算法。另需注意,SDM v1 的逐槽更新式与图示/附录中的联合稀疏回读存在差异;复现时应先确认具体残差定义,不直接采用正文所称的“精确恢复 GDN”等价关系。
3.3 多个状态、不同职责:MoM、DSLA、MDN
MoM v4 让 token 路由到部分独立循环记忆,另有共享状态。总记忆更多,部分历史不再被每个 token 覆写,因而扩容与干扰隔离同时发生。主配置是 4 个路由记忆、激活 2 个,另加 1 个共享记忆。即使固定激活预算,未激活状态也必须保存;不能据此声称等总状态。
DSLA v3 的双状态采用不同遗忘门,混合历史与近期信息。它既付出额外矩阵存储,也改变时间尺度。如果只拿单状态作对照,不能判断收益有多少来自双倍资源、有多少来自门控分工。
MDN v1 则提醒我们区分内容扩容与优化辅助记忆:它维护内容 $S_t$ 和动量 $M_t$ 两个矩阵,后者累积历史残差方向。同尺寸下总矩阵元素约为单状态的两倍,但主内容地址没有简单翻倍。把 MDN 当作“更好优化器”比较时,应与同总字节的宽状态、双时间尺度状态或其他辅助统计比较。
3.4 精确 KV、核特征与神经快权重也在争夺同一预算
精确缓存是对总记忆系统的扩容。 HOLA v1 直接在 GDN 旁加有限 KV,LoLA v3 在混合模型中重新分配局部窗口和全局保留槽位。二者还利用残差或自召回误差选择条目,所以不能把它们归为单纯“更多缓存”。NAtS-L v2 学习块级存储选择,KVM v5 允许固定槽或增长槽;增长槽版随长度变化的复杂度需要单列。
核特征也决定状态尺寸。 二阶 Taylor/多项式特征可能把 key 特征维度扩展到二次量级。BASED v2 在这一方向上结合小窗口与 IO 设计;OAL v1 学习的系数很少,却仍保存原始维度对的二阶状态。不能用“只增加少量可学习参数”来代替运行时容量和成本分析。SANATAN v2 的 $6d$ 显式映射及 p=1 精确递推同理,精确针对选定核,而非精确恢复 softmax。
非线性快权重改变假设空间。 TTT v4、LaCT v1、MoNe v1 把一个小网络的权重当状态。更复杂的映射可能在同类输入上压缩更多规律,也引入更多参数、激活与更新计算。它们是重要近邻,不能仅凭“都是 memory”就声称和同字节 DeltaNet 存在普遍容量排序。
4. 主线二:提高 state 利用率
与其问“状态有没有更满”,更有意义的是沿生命周期问:写入是否必要、是否破坏旧内容、能保留多久、查询是否能读到、训练是否让该路径真正参与任务。
4.1 改善写入几何:预条件、不确定性与正交更新
普通 delta 以当前误差修正状态:
当历史 keys 高度相关时,沿 $k_t$ 更新会影响其他非正交地址。这是 PDN / OSDN / KDN / Bayesian Layer / Lattice 密集竞争的共同问题。
预条件写入。 让读残差仍使用 $k_t$,写回改用 $\widetilde k_t$:
PDN v1 用历史 key 的逐维二阶统计产生有界缩放;OSDN v1 在线学习对角预条件器。它们通常只需 $O(d_k)$ 辅助状态,重要实现点是不把残差读取键和写入键同时替换。
更完整的历史几何。 KDN v1 从 Kalman 视角以不确定性增益控制残差写入,实用变体用对角或各向同性统计;BayesianLayer v3 保留稠密协方差以改变写入方向。若已有内容状态是 $O(d_kd_v)$,再增加 $O(d_k^2)$ 协方差,就不能称为严格相同总 state;当 $d_k\approx d_v$,这项开销可能与内容矩阵同量级。
局部正交保护。 Lattice v2 对单个槽向量 $s$ 的更新方向做类似
的投影,再进行归一化控制。这里是本次统一记号的几何示意:更新在当前槽方向的正交补内,不代表全部槽彼此正交,也不保证所有旧关联不受损。它强调以更新几何提高压缩效率,而不是直接增加槽位。
这些方法共同的检验难点是:当前 key 的回归误差下降,并不保证未来 query 下所有历史事实都更好。 OSDN 的 1.3B 结果就是明确反例:局部残差比 0.432→0.265,重复召回却 0.227→0.217。应把局部代理指标和最终检索一起报告。
4.2 将清理、写入和查询反馈分开
EDA v1 增加独立擦除地址 $e_t$。统一为本报告的状态方向,可写作
这允许先在 A 方向清理,再在 B 方向修正写入;普通 delta 把清理与写入绑在同一个 key 上。擦除是方向性操作,其他非正交关联也会受影响,模型需要学会何时值得清理。主内容矩阵形状不变,但增加投影、状态访问和计算。顺序不能任意交换。
Q-Delta v1 把 query 对旧状态的读出纳入残差信号。变化发生在“本次应如何修改状态”的计算,仍沿 key 写回;主内容矩阵不变。它与 EDA 的独立删除、PDN 的写入预条件是不同自由度。
DeltaProduct v7 每 token 做多次 Householder 型更新;MDN v1 用动量累积方向。它们也让同一主状态产生更丰富的演化,但分别支付多步计算或辅助存储。更强的状态更新能力,应以更多更新的直接对照衡量,而不只比较一次标准 delta。
4.3 区分“状态里还有信息”和“查询能读取信息”
CCQ v2 保留骨干写入,在读取前使用历史 key 的协方差修正 query:
它压低高方差方向的读取分量,核心针对读出时的混合与噪声;同时需要协方差矩阵和均值。原文一些检索结果改善很大,但端到端解码吞吐约下降 35%。更关键的是,附录 E 中训练后关闭即时修正仍保留多数收益,因此还应检验它是否通过训练改变了上游特征,而不把全部作用解释为推理时的瞬时“清洗”。
MesaNet v2 是另一种读出路线:保存交叉统计 $G_t$ 和 Gram 统计 $H_t$,求解
这里 $\Lambda$ 是正定正则。共轭梯度迭代数成为可调的读取计算预算:不是扩大主内容地址,而是更认真地利用已有统计。额外 Gram 存储和求解时间也应计入;有限次迭代不等于数值上精确的回归解。
LinearAttn-Memory v1 提供了必要诊断:内容写入、查询前状态和查询输出的反事实替换,可以分开测量写入、保留、读出。其被测多事实任务中,信息竞争比单纯增加间隔更有破坏性;混合模型的直接身份信息又可能主要在 FA KV 中。对“提升利用率”的主张,这类路径干预比单看状态范数更有说服力。
4.4 用时间组织容量:慢尺度、相位与相对时间槽
这一子方向也很拥挤,但几种机制应分开:
| 机制 | 代表工作 | 对利用率的作用与代价 |
|---|---|---|
| 两个遗忘速度 | DSLA | 将短期与历史内容分开;多存状态 |
| 多时间分辨率更新 | MS-GLA | 粗分支减少写入频率、缓解干扰;池化损失细节,需因果延迟 |
| 分布较广的衰减模式 | FRAC | 用快慢指数模式近似长尾保留;有限模式、有限有效时间范围 |
| 扩窗后的遗忘谱适配 | SpectralShift | 改变训练中慢衰减方向的分布;保留与清理之间仍有取舍 |
| 输入相关旋转与反射 | Selective RoPE、CKDA、SFDA、Mamba-3 | 让信息以相位和方向演化,扩展状态追踪;计算与表示精度仍有限 |
| 相对时间槽与可学习时钟 | CyFA | 让不同历史年龄有更结构化的地址;固定槽循环使用,仍有覆盖和混合 |
CyFA 值得单列。 CyFA v1 用对齐的 key/value 状态表示相对时间槽;可学习时钟控制旧信息如何移动,新写入进入年龄零处。精确坐标变换将移动状态改写为两遍标量递推,避免每 token 做稠密槽移动。在匹配主要循环状态预算下,400M 召回均分由 KDA 的 26.31 到 33.25(+6.94 个百分点),8K 训练吞吐约为 KDA 的 1.37 倍。预算匹配针对主要循环状态,辅助缓存、实际分配形状与静态参数仍应单列(Table 2、Figs.5–6,PDF pp.6–10;架构核算见附录)。
旋转能力不等于增加记忆量。 CKDA v1 在实数状态中用负通道门与扩展更新率组合旋转,SFDA v1 显式引入相位,Mamba-3 v1 同时改进写入和 MIMO。它们能扩展可实现的转移或提高每次访问的计算量,但不自动增加可无误存储的独立随机事实。涉及复数记号时,应按实际保存的实数通道和 dtype 计量,不能把一个复数元素与一个实数元素当作相同字节。CKDA 的语言模型均分与匹配 KDA 基本持平、SFDA 主要验证理论和小型计数,是定位这些工作的必要条件。
SSM-Gating v1 也说明“记得更久”不是单调更好:衰减过强会压低远处信号,过弱则积累干扰;训练还可能学到参数记忆捷径。慢时间尺度、长尾核和旋转,都需要在多事实负载下检验,而不仅是单针或 PPL 外推。
4.5 选择性保护难压缩内容:HOLA 与 LoLA
线性状态适合提取规律,但一些事实、稀有值或高残差关联更需要直接保留。HOLA v1 用写入幅度 $\beta_t\|r_t\|$ 选择 KV;LoLA v3 用自召回误差决定哪些 KV 不应只交给低秩状态。它们把记忆分配策略作为研究对象。
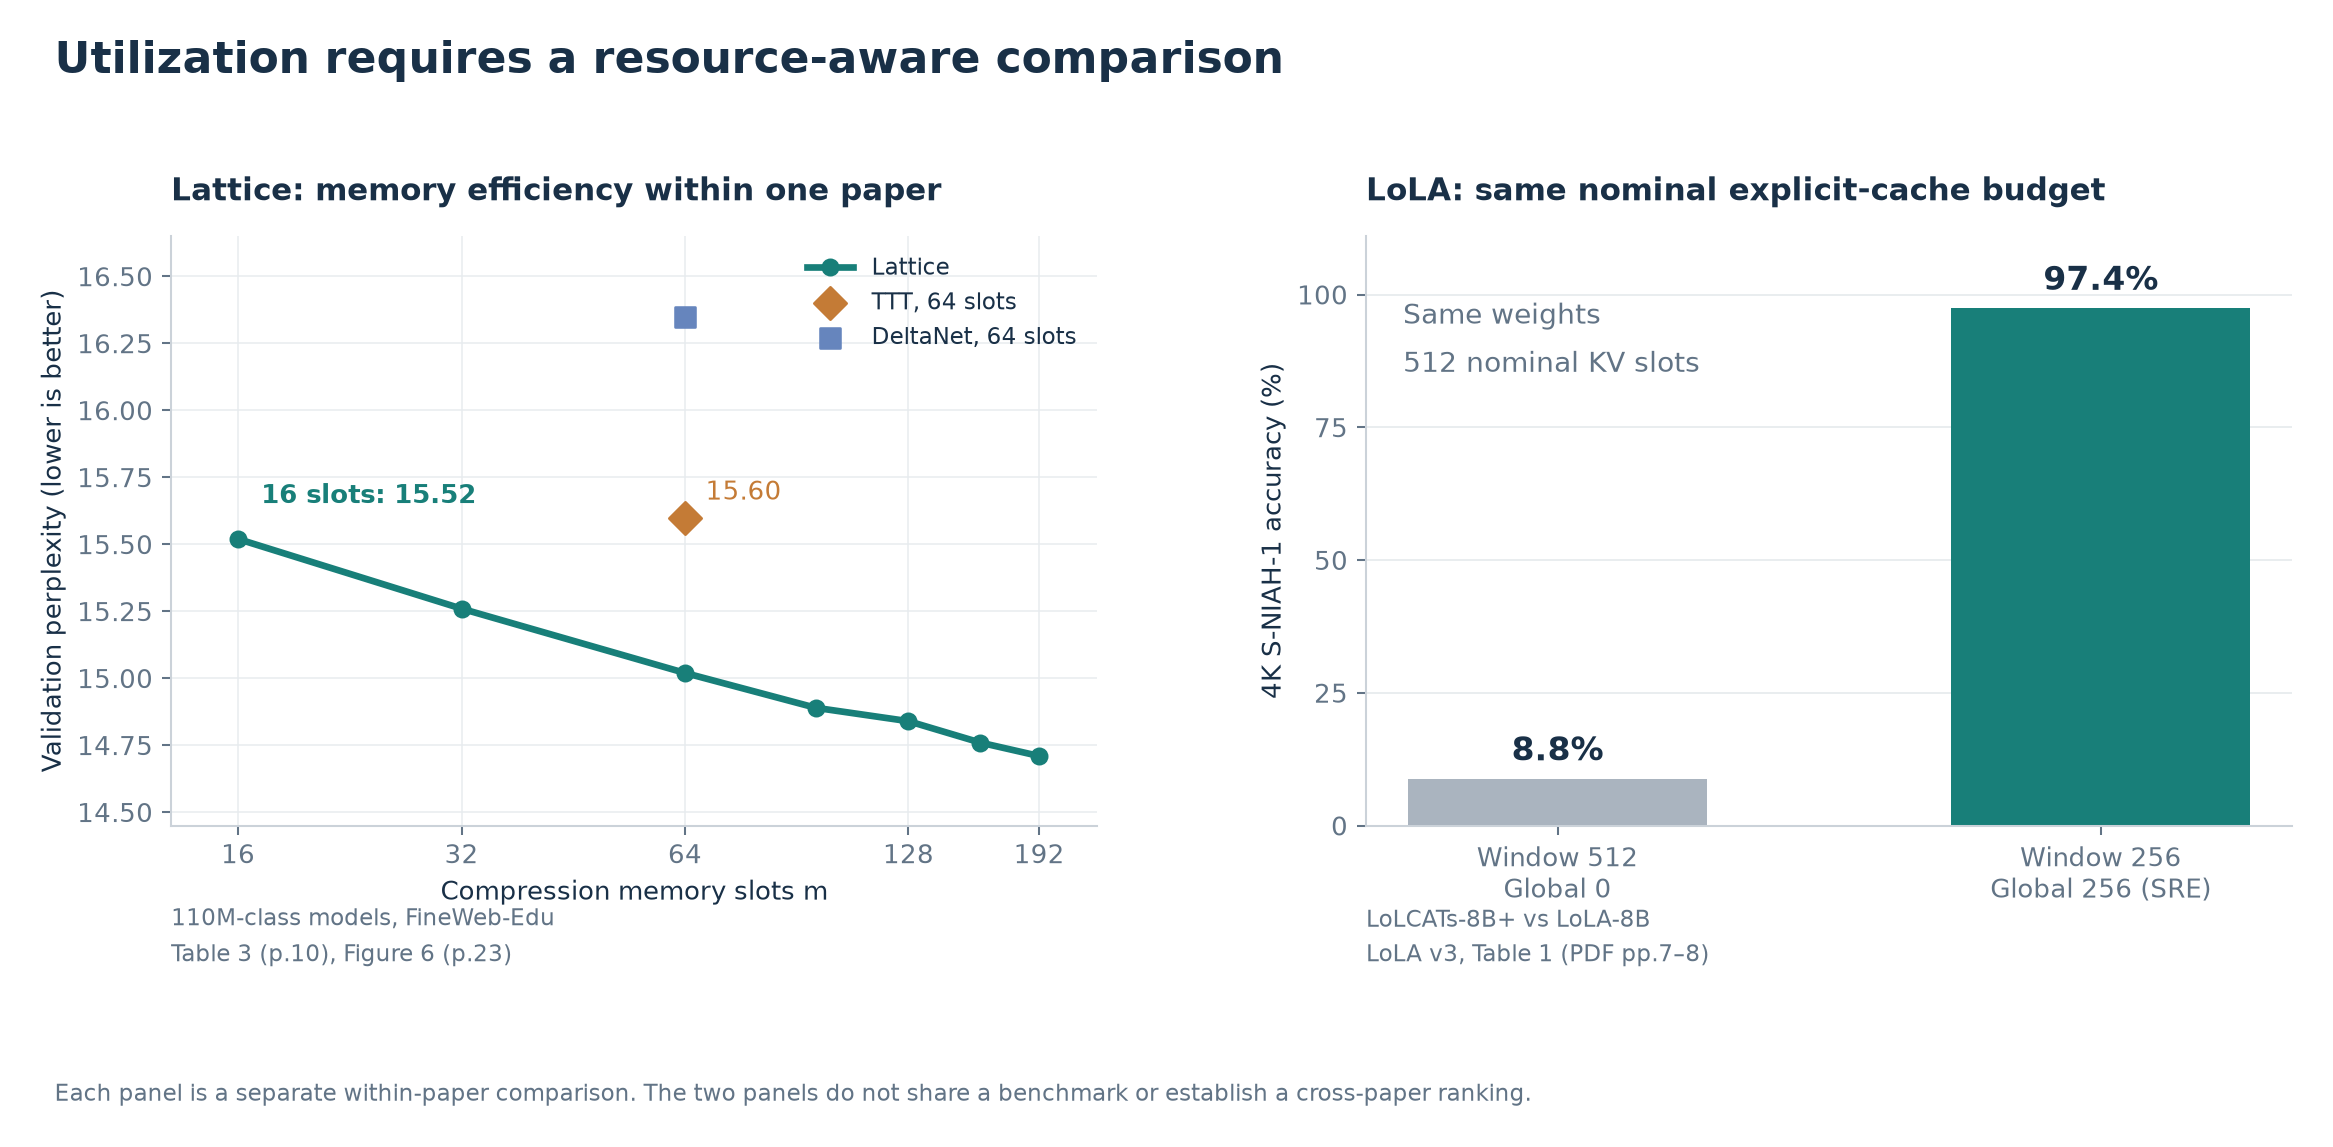
图 4 左图根据 Lattice **Table 3(PDF p.10)、Fig.6(p.23)**重绘:110M 类、FineWeb-Edu 中,Lattice 在 16 槽得到 PPL 15.52,TTT 在 64 槽为 15.60;这是该压缩层的槽位比较,不能读成全模型显存降低 75%。右图根据 LoLA **Table 1(PDF pp.7–8)**重绘:同一权重、相同名义 512 个显式 KV 槽位下,4K S-NIAH-1 从扩大窗口的 8.8% 到按 SRE 分配的 97.4%。两图实验互不相同,不可跨面板比较方法强弱。
LoLA 摘要常见的 0.6%→97.4% 还包含从 64 槽到 512 槽的扩容;8.8%→97.4% 才更接近“同名义容量下改进分配”的证据。这里仍需注意物理缓存布局、分母统计和预填充临时量,名义槽数相同不必然等于完全相同的实测峰值显存。
HOLA 的同预算 recency 对照也有帮助:340M、15B tokens、2K 训练长度下,WikiText-103 PPL 为 GDN 27.32、recency 25.04、HOLA 22.92;32K S-NIAH-1 分别为 0.14、0.24、0.58。前一段变化包含增加精确缓存,后一段支持选择/读出策略的额外价值(Table 1、Fig.1,PDF pp.1、7–9)。
4.6 让训练学会使用状态,而不是绕开状态
HedgeCATs 是本方向很重要的一篇负结果。 HedgeCATs v2 的 Mistral-7B 实验中,SWA+LA 六任务平均分 65.48,删去 LA 后反而为 65.56;LA-only 为 34.78。混合模型的高分不足以说明循环状态被用好了。分阶段迁移、推理时再混合和 SWA dropout 的价值,是让 LA 分支产生可观察的增益(Table 1,PDF p.5)。
DAT v1 在合成复合任务中先训练循环路径、后开放注意力,说明优化顺序影响模块分工。LengthGen v2 通过 State Passing 等初态干预扩大训练状态覆盖,针对的是长运行时遇到未训练状态的分布偏移。JRT v1 让模型知道问题后重读,改变固定容量内应该保留什么,支付额外输入与预填充计算。
利用率还涉及深度方向的信号复用。CLVR v1 发现直接跨层传写入误差并不稳定受益,先投影到共享残差坐标、再传完整写入 value 的方案表现更好;匹配实验的验证损失改善通常很小,且均为单次运行。它提示不同层的状态坐标不能直接混加,也不能从小幅 LM 损失改善推断长程事实记忆已经提高。
这些方法提示:固定推理状态形状并不等于固定使用能力。 评估新写入规则时,应与可用的训练/蒸馏策略比较;评估新训练策略时,则应固定结构、数据量与计算预算。
4.7 字节与带宽效率是第三个维度,可以支持前两条主线
StateReduction v3 裁剪 key/query 通道,是真正缩小内容矩阵;DAMP v2 根据误差及其未来保留程度分配精度;LeapQuant v1 用窗口量化、补偿与平滑减少递归量化误差;DeltaLog v1 用基底+日志减少反复写回。
这些工作研究的是如何更便宜地保存和访问状态。同一模型压缩后召回不变,不代表逻辑容量增加;把节省的存储再投入更多槽位、辅助统计或缓存,才构成新的容量—利用率组合,而这需要额外实验验证。
其中有两个边界尤其值得保留:
- StateReduction 的 GDN-1.3B 裁剪 50%、恢复后,WikiText-2 PPL 为 16.3(原模型 16.8),但 4K NIAH 为 61.9(原模型 81.3)。可压缩的 PPL 冗余不等于可压缩的检索冗余。
- DeltaLog 保持逻辑递推、延迟物理合并;LeapQuant 还要计入高精度窗口日志和补偿因子。仅比较量化基底的 bytes/value,会低估完整状态预算。
5. 把最关键的原文证据放在一起
下表用于比较论证类型。每行只作其所在论文、任务与训练协议内的对照,分数不能横向排序;更多具体单项见本地笔记与原文。
| 论文与比较条件 | 原文结果 | 对容量/利用率的含义 |
|---|---|---|
| Triadic,400M,E=1→8,3 seeds;Tables 1–2,pp.6–7 | 状态 6.3→50.3 MB;召回 26.2→33.1;PG19 16K–64K PPL 14.15→13.74 | 大状态有效,参数只小幅增加;收益未与状态倍数成比例 |
| Triadic,同为 50.3 MB;Table 2,p.7 | E=8 后期扩容召回 29.7,从头训练 33.1 | 相同容量的训练使用能力不同 |
| SDM,8B 档位长上下文续训后;Table 2,p.8 | RULER 34.2→50.2,FullAttn 61.2 | 大稀疏记忆改善召回,仍有缺口;包含可学习初态且大记忆未计入匹配参数 |
| SDM,1.4B 初态消融;Table 3,p.9 | GDN 20.0;SDM 零初态 28.0、可学习初态 31.2 | 区分在线容量与预训练参数记忆的贡献 |
| Lattice,110M,FineWeb-Edu;Table 3,p.10 | Lattice 16 槽 PPL 15.52;TTT 64 槽 15.60 | 支持该设置下更高槽位效率,不是整个模型等字节或等速度证明 |
| CyFA,400M,主要循环状态匹配;Table 2,pp.6–8 | 六任务召回 KDA 26.31→CyFA 33.25 | 时间地址组织在主状态预算匹配下有效 |
| OSDN-APF,1.3B/100B;Tables 8、16,pp.35、40 | 残差比 0.432→0.265;重复召回 0.227→0.217 | 局部更新代理指标改善,没有转化为该召回指标改善 |
| Bayesian Layer v3,WikiText-103;Table 2,p.9 | AR-hit PPL 23.72→18.15;整体 PPL 18.75→20.01 | 关联子集改善伴随总体取舍;还需付出稠密协方差 |
| CCQ,1.3B GLA,同训练预算;Table 3,p.8,App.E | 4K S-NIAH-1 为 47.8→96.8;推理关闭修正仍保留多数收益 | 干预读取有收益,但要区分训练效应与即时修正 |
| LoLA,同权重、名义 512 显式槽;Table 1,pp.7–8 | 4K S-NIAH-1:扩大窗口 8.8%,SRE 分配 97.4% | 强调选择性存储,而非仅靠扩大窗口 |
| HOLA,同容量 recency 对照;Table 1、Fig.1,pp.1、7–9 | PPL 25.04→22.92;32K 单针 0.24→0.58 | 精确缓存内部的选择与读出也决定利用率 |
| HedgeCATs,Mistral-7B 消融;Table 1,p.5 | SWA+LA 65.48,SWA-only 65.56 | 总体质量不证明状态分支有贡献 |
| StateReduction,GDN-1.3B,裁剪 50% 并恢复;Tables 1、4,pp.8–9 | PPL 16.8→16.3;4K NIAH 81.3→61.9 | 容量冗余依任务而变,PPL 与召回应同时看 |
以上来源分别为 Triadic v1、SDM v1、Lattice v2、CyFA v1、OSDN v1、BayesianLayer v3、CCQ v2、LoLA v3、HOLA v1、HedgeCATs v2、StateReduction v3;PDF 页码均从 1 开始,完整原始来源也在第 8 节逐篇列出。
6. 对“研究已经拥挤”的具体判断
6.1 已经很难仅凭一个局部动作建立贡献
“再加一个 gate”“再存一个状态”“用二阶信息”“给状态加旋转”“困难 token 存精确缓存”都已有密集先例。 区别仍然可能有价值,但需要落实到:哪种统计、哪个地址、哪种不变量、哪种计算组织,以及在哪个合理预算下收益成立。
例如,PDN 与 OSDN 都做写入预条件,但历史统计和在线更新目标不同;KDN 与 Bayesian Layer 都引入不确定性,却选择不同近似;CCQ 和 MesaNet 都利用 key 的二阶几何,但一个修正 query,一个求累计回归解。这些不是同一方法,也说明只写“引入 curvature/covariance”不足以界定新意。
相似地,MoM、SDM、Proteus、CyFA 都减少某些历史写入之间的冲突,但分别依赖独立记忆、稀疏访问、容量开放时机和相对时间组织。贡献需要解释具体冲突怎样减少,而不只是画出更多 memory blocks。
6.2 两条主线正在合流
| 方法类型 | 扩大了什么 | 怎样提高已有资源的使用 | 必须另计的成本 |
|---|---|---|---|
| Triadic | 联合 key 地址维度 | 乘积地址、逐片遗忘、delta 修正 | 稠密大状态与读写量 |
| SDM / MoM | 总槽表或记忆组数 | 稀疏访问、不同写入域 | 未激活状态、寻址、可学习初态 |
| HOLA / LoLA | 精确保存通道或其分配范围 | 残差/SRE 选择难压缩关联 | KV、分数、缓存管理与临时量 |
| PDN / OSDN / KDN | 辅助统计,主内容地址未直接扩大 | 更合适的写入方向和强度 | 对角统计、不确定性与额外运算 |
| CCQ / MesaNet | 二阶辅助统计 | 更好读出或求解历史拟合 | 协方差/Gram、矩阵访问和求解 |
| DeltaProduct / Mamba-3 | 可实现转移或每次访问的计算 | 同状态上更充分的状态计算 | 多次更新、MIMO 和训练 FLOPs |
| DAMP / LeapQuant / DeltaLog | 不直接增加逻辑地址 | 减少表示误差、存储或写回成本 | 高精度例外、日志与内核复杂度 |
因此,容量与利用率不是两组互不相干的论文标签,而是同一设计的两条预算轴。 实际研究前沿是使内容记忆、辅助记忆、精确检索和计算协作,在质量、状态字节和延迟之间形成更好的取舍。现有证据没有给出一个全面胜出的固定状态方案。
6.3 对新选题更有价值的是明确缺口
以下是本次分析提出的研究问题,不声称在全球文献中无人研究,也不把组合现有模块自动视作创新。
| 可检验问题 | 最接近的已有工作 | 应如何证明超出了近邻 |
|---|---|---|
| 同总字节下,增加内容槽还是保留历史几何更有效? | Triadic、SDM、PDN、KDN、CCQ、MesaNet | 将辅助矩阵预算换算成可用内容状态,比较容量—干扰—延迟曲线,寻找稳定的负载分界 |
| 能否在同容量下保护未来仍会被查询的事实,而非仅拟合当前 key? | Lattice、EDA、Q-Delta、HOLA、LoLA、How Linear Attention Remembers | 固定事实数、增加冲突和重写,直接测未来读出及非目标损伤;同时与等预算精确缓存比较 |
| 扩容后为什么没有充分利用新坐标,训练怎样改变这个差距? | Triadic upcycling、Proteus、LengthGen、HedgeCATs | 固定最终状态与训练 FLOPs,比较从头训练、后期扩容、状态覆盖和分支训练;用路径干预定位 |
| 省下的状态字节投入哪里最值得? | StateReduction、DAMP、LeapQuant、DeltaLog 加扩容/预条件方法 | 在同一服务峰值内存与目标延迟下分配容量、统计和精确 KV,包含日志、检查点和并发成本 |
这些问题的价值在于给出可失败、可复核的比较:如果优势被等资源的扩大状态、一次额外更新、随机/近期缓存或更合理训练消除,就应据此重新界定方法贡献。
7. 一套能区分容量收益与利用率收益的实验方案
7.1 最小实验矩阵
固定骨干、训练数据、token 预算、优化器搜索范围与评测协议,至少设置下列四组,并对多个状态预算重复。这里“利用率改进”应替换为待研究的具体机制。
| 原更新/读取规则 | 加入利用率改进 | |
|---|---|---|
| 小内容状态 | 基线 | 检验小状态内的改进 |
| 大内容状态 | 检验单独扩容 | 检验扩容与改进是否互补 |
同时给出两套配对:等主要内容状态用于分析机制,等总运行时字节用于判断资源效率。若方法增加计算,还要给等训练 FLOPs 或等端到端延迟的对照,不能只控制总参数量。MoM/SDM 另报总与激活资源,可学习初态单列。
7.2 将记忆压力拆成四种自变量
- 距离压力:固定独立事实数量,只增加中性 filler,测衰减与长运行状态偏移。
- 负载压力:固定距离,增加同时需要保留的独立随机关联,测有效容量。
- 碰撞与更新压力:控制 key 相似度、重复写入、事实改写、相互冲突和删除,测干扰、替换与非目标损伤。
- 查询压力:单针、多 key、多 query、多 value 与多步组合分开测,检验状态是否只能保留一个显著目标。
随机 values 应在测试时重新生成,避免慢权重记住固定答案。真实文本则补充长文问答、抽取与位置分段 PPL,不能用随机召回替代全部语言质量,也不能用总体 PPL 替代记忆能力。
7.3 关键消融与报告项
| 要排除的解释 | 必要对照 |
|---|---|
| 只是多了存储 | 等总字节扩大内容状态;等预算近期/随机精确缓存;辅助状态也计入 |
| 只是多算了几次 | 基线增加一次或多次 delta 更新;匹配 MIMO/CG 类读取计算 |
| 只是训练更充分 | 等 token/FLOPs,控制蒸馏、续训、初态、数据与优化器调参 |
| 混合模型绕开了循环状态 | 去掉 LA、去掉显式 KV、状态替换/输出恢复、读取路径干预 |
| 只改善了局部代理指标 | 当前残差、历史关联损伤、最终 query 准确率共同报告 |
| 节省只发生在局部内核 | 报整模型 prefill/decode、batch、输入/输出长度、硬件和并发;核内加速单列 |
最终应报告质量—字节—时间的 Pareto 曲线,以及给定准确率门槛下可支持的事实负载。状态谱和读写重叠作为解释性诊断;至少对核心比较重复种子并提供不确定性,不用某篇单次大提升代替整体证据。
本报告的选题判断:若只准备提出一种略有变化的 state 更新、附加门控或 memory 分支,当前近邻已经相当密集;若能在完整资源约束下解释并改善“写入冲突—保留—读出—训练分工”的具体失效,仍有清晰研究价值。
图表原始数据与来源定位见 plot_data.json,机制分类见 mechanism_map.json,绘图代码见 plot_survey.py。PNG 用于 Markdown,配套 SVG 可用于汇报与编辑。
展开完整论文目录与筛选说明
8. 本地相关论文完整目录(68 篇)
A 为直接研究线性注意力算子、状态机制、训练或系统的论文;B 为机制紧邻的 SSM、快权重、压缩检索或综述。分类按主要贡献互斥计数,机制标签可以重叠。每篇采用本地已有的最高版本、最高笔记修订;这不表示该版本是在线最新版本。名称后的链接打开本地中文笔记,题名链接打开原始来源。
8.1 扩容与多记忆(6 篇)
| 论文、版本与原始题名 | 机制、资源变化和应如何解读 |
|---|---|
| Triadic · A · v1/r1 Triadic Linear Attention: Three-Dimensional Recurrent States for Long-Context Sequence Modeling · PDF | 双 key 的张量积扩展联合地址,状态增至 E 倍;少量新增投影不消除稠密状态的存储和读写成本。 |
| SDM · A · v1/r1 Sparse Delta Memory: Scaling the State of Linear RNNs through Sparsity · PDF | 大槽表配合稀疏 top-k 读写;容量和激活算术部分解耦,但可学习初态、总存储及路由成本须单列。 |
| MoM · A · v4/r1 MoM: Linear Sequence Modeling with Mixture-of-Memories · PDF | 多个独立循环记忆、top-k 路由及共享记忆;同时扩容与隔离写入,等激活预算不代表等总状态。 |
| FwPKM · B · v2/r1 Fast-weight Product Key Memory · PDF | 乘积键稀疏寻址配合在线快键/快值更新;大容量、重读和真实吞吐成本共同影响结果。 |
| MDN · A · v1/r1 MDN: Parallelizing Stepwise Momentum for Delta Linear Attention · PDF | 用额外动量矩阵积累历史残差,提供逐步动量的分块算法;同尺寸下主状态加动量约为双状态。 |
| DSLA · A · v3/r1 On-the-Fly Adaptive Distillation of Transformer to Dual-State Linear Attention · PDF | 历史/近期双状态采用不同遗忘门;容量、时间尺度和逐层转换策略同时改变。 |
8.2 写入、读取与容量调度(11 篇)
8.3 时间尺度与状态变换(11 篇)
8.4 核与压缩表示(4 篇)
| 论文、版本与原始题名 | 机制、资源变化和应如何解读 |
|---|---|
| BASED · A · v2/r1 Simple linear attention language models balance the recall-throughput tradeoff · PDF | 二阶 Taylor 全局状态、小窗口精确注意力及卷积组合;将容量、局部精度和 IO 内核一起设计。 |
| LAVO · A · v1/r1 Linear Attention via Orthogonal Memory · PDF | 固定正交方向的均值统计与局部注意力组合;对压缩槽做 softmax,平均压缩会损失历史细节。 |
| RACE · A · v5/r1 RACE Attention: A Strictly Linear-Time Attention Layer for Training on Outrageously Large Contexts · PDF | 可微软哈希桶保存质量与值统计;固定桶数下线性,容量、碰撞和哈希构造仍有成本。 |
| SANATAN · A · v2/r1 SANATAN: Root-Parity Gated Angular Attention with an Exact Constant-State Recurrent Form · PDF | 角度核及根标签门控具有显式 6d 特征;常状态精确递推针对 p=1,强基线和公开制品尚有差距。 |
8.5 压缩记忆与显式检索组合(8 篇)
8.6 训练、转换与长度泛化(8 篇)
8.7 状态压缩与服务系统(6 篇)
| 论文、版本与原始题名 | 机制、资源变化和应如何解读 |
|---|---|
| StateReduction · A · v3/r1 On State Reduction in Linear Attention · PDF | 联合裁剪 key/query 通道以缩小真实状态;恢复后 PPL 接近原模型,纯递归长距召回仍可能下降。 |
| DAMP · A · v2/r1 DAMP: Decay-Aware Mixed-Precision Recurrent-State Quantization · PDF | 按量化误差及其未来保留程度分配通道精度;改善字节与带宽效率,不直接扩大逻辑地址空间。 |
| LeapQuant · A · v1/r1 LeapQuant: Efficient Linear Attention with Accurate Recurrent State Quantization · PDF | 窗口量化、低秩补偿和残差平滑抑制递归误差;完整预算还应计入高精度日志与补偿因子。 |
| DeltaLog · A · v1/r1 DeltaLog: Deferred Materialization of Recurrent States for Linear Attention Decoding · PDF | 稠密基底加有界更新日志,延迟物理写回;逻辑状态仍逐 token 更新,主要降低写带宽。 |
| HYPIC · A · v2/r1 HYPIC: Accelerating Hybrid-Attention LLM Serving with Position-Independent Caching · PDF | 缓存段级仿射状态变换以组合历史;固定单层轨迹的精确组合与深层复用近似需区分。 |
| Tail-Replay · A · v2/r1 Tail-Replay: Escaping the Curse of Linear Attention in Prefix Caching for Hybrid LLMs · PDF | 缓存精确 FA 输出并短尾重放恢复 LA 状态;改善前缀复用,增加辅助缓存且恢复存在误差。 |
8.8 机制、理论与综述(7 篇)
| 论文、版本与原始题名 | 机制、资源变化和应如何解读 |
|---|---|
| LinearAttn-Memory · A · v1/r1 How Linear Attention Remembers · PDF | 因果干预区分写入、保留、读出;负载与写入重叠损害召回,混合模型直接记忆载体可转向 KV。 |
| CLVR · A · v1/r1 Linear Attention Architectures: Mechanisms, Trade-offs, and Cross-Layer Routing · PDF | 统一遗忘/擦除/写入比较,研究跨层 value 路由;单次小幅损失改善尚非独立的容量扩展证据。 |
| LLM-Memory · B · v1/r1 Memory for Large Language Models · PDF | 以表示、更新和持续性统一模型级记忆;是综述框架,用来界定状态与外部记忆的边界。 |
| Attention-Evolution · B · v1/r1 The Evolution of Attention in Large Language Models: Mechanisms, Trade-offs, and Emerging Trends · PDF | 从表示到整合梳理注意力和混合架构;说明研究设计轴众多,不计作一种独立更新算法。 |
| SSM-Gating · B · v1/r1 On the Importance of Gating: Memorization vs. In-Context Learning in State Space Models · PDF | 区分门控导致的优化捷径与长历史干扰;遗忘既可能削弱信号,也可能抑制噪声。 |
| Hybrid-Hierarchy · A · v1/r1 A Provable Expressiveness Hierarchy in Hybrid Linear-Full Attention · PDF | 有限精度通信下区分状态容量和全注意力访问轮数;专门任务下界不等于一般 LM 的运行成本结论。 |
| Transformer-Topology · B · v5/r1 The Topological Trouble With Transformers · PDF | 分析计算图中状态跨位置/跨层的可达性;为增加状态计算和循环深度提供结构参照。 |
8.9 快权重与神经记忆近邻(7 篇)
| 论文、版本与原始题名 | 机制、资源变化和应如何解读 |
|---|---|
| TTT · B · v4/r1 Learning to (Learn at Test Time): RNNs with Expressive Hidden States · PDF | 将小模型权重作为隐状态,由自监督内层目标更新;线性/MLP 状态的表达力、计算与存储不同。 |
| LaCT · B · v1/r1 Test-Time Training Done Right · PDF | 以大块在线更新提高计算强度,支撑更大非线性快权重;块大小与局部窗口共同影响记忆。 |
| SRWM · B · v2/r1 A Modern Self-Referential Weight Matrix That Learns to Modify Itself · PDF | 同一矩阵产生并执行自身 delta 更新;扩展的是更新控制器的适应能力,而非单纯槽位数。 |
| NL · B · v1/r1 Nested Learning: The Illusion of Deep Learning Architectures · PDF | 多时间尺度优化统一记忆和优化器,Hope 组合自指记忆与 CMS;容量与优化器状态均应计入。 |
| MoNe · B · v1/r1 MoNe: Modular Neural Memory for Efficient Long Context Inference · PDF | 冻结 Transformer,逐层 SwiGLU 快权重压缩上下文,再转成查询 KV;任务训练与受控检索是重要条件。 |
| MemoryMosaics · B · v3/r1 Memory Mosaics at scale · PDF | 自适应核、门控 key 和多层记忆改善 ICL;长期分支保存历史 KV,不属于固定状态线性注意力。 |
| Metis · B · v2/r1 Metis: Memory Foundation Model · PDF | 跨轮持久矩阵以学习到的前向规则读写;说明紧凑状态可用于持久记忆,但离完整上下文质量仍远。 |
9. 边界与未计入的论文
下列 67 篇仍在完整清单中,但没有纳入 68 篇的机制计数。其价值是提供资源或任务对照;不能因为标题中出现 attention、memory 或 recurrence,就算作循环线性注意力的新方法。
显式 KV、稀疏检索与压缩的参照,未作为固定循环 state 方法计数(21 篇):Attention-Temperature、BinaryPC、BoV、DA、DepthWeave-KV、Diffuser、DoSA、EG-MLA、FusedKV、GOAT、HashAttention、LLA、LRKV、LatentLLM、RIS-Kernel、ResidualKV、SAS、SparDA、SpargeAttn、VHA、VarRate。
网络深度、层间/循环间共享及投影结构,未作为 token 历史 state 方法计数(15 篇):AlgebraLayers、DeltaAttnRes、DepthBench、DiscoLoop、ELR、LPT、LoopLM-Conditioning、LoopedReuse、MELT、MoD、MoDA、OASIS、Parcae、RelaxedRecursive、ResFormer。
外部文档、智能体、参数记忆、数据或提示组织,未研究本报告的序列内循环 state(13 篇):CL-Composition、CLM、ExplicitLM、GenMem、ICL-Data、JitMem、LightMem、MemPrism、PartRep、REMORY、Sleep、TIDE、Trace-as-State。
主要研究扩散、潜空间语言建模、训练或表示分析,未给出本文所需的 state 机制(18 篇):CALM、CDLM、CKA、ClockDiffusion、Cogentic、ConceptLM、ELF、ELF-REG、Efficient-DLM、FMLM-star、LangFlow、LoopMDM、MDM-LS、NCP-ArchPreview、Puro-2B、SEDD、Sigma、Smoothie。
完整的 135 篇去重清单、选用版本、分类和纳入理由见 CSV / JSON。统计单元为论文,不把同篇的 v1/v3 或 r1/r2 重复计数。