Spectral Unlearning:中文精读笔记
原题:Spectral Unlearning: Transformer Structure-Preserving Updates for Language Models
作者:Sung Il Choi、Junhao Cai、Dohun Kim、Changhee Joo(Korea University)
版本:arXiv:2611.11902v1,2026-11-09 提交;获取与研读日期:2026-11-12。
原文:arXiv v1 · 本地 PDF
发表:已接收 NeurIPS 2026;依据为 作者更新的 arXiv Comments 和 作者实验室录用公告。本次未独立确认正式论文集出版记录。
代码:作者官方实现 unlearn-ml/spectral-unlearning,含优化器、训练器、配置和实验脚本。以上状态核实于 2026-11-12。
论文总览
机器遗忘(machine unlearning)希望模型忘掉指定数据或能力,同时保留其余知识。论文的切入点是:相同遗忘损失的梯度,经过不同的参数几何处理,会得到不同的更新方向。 作者不另造一套遗忘损失,而是将权重看成矩阵线性映射,用谱范数下的最陡下降方向替代逐元素更新,并用 Muon、KLShampoo、SOAP 实现可扩展近似。
核心公式是:对梯度 $G=U\Sigma V^\top$,理想更新方向为 $-UV^\top$。它保留梯度的左右奇异方向,把奇异值幅度压平;这里分解的是梯度矩阵,并非直接删除模型权重的某些奇异分量。作者通过 RMS-to-RMS 算子范数解释这一方向,并扩展到多层的最大范数几何。
主要证据来自 TOFU 上的遗忘、隐私、效用三轴指标,以及 RWKU、WMDP 和再学习实验。以 TOFU、Llama-3.2-3B、5% 遗忘为例,RMU 的 Agg 从 AdamW 的 0.7151 提高到 SOAP 的 0.7360;retain-only 参考为 0.7402。这表示接近参考,不表示行为等价:两者的 Mem/Priv/Util 分别为 0.7160/0.8468/0.6673 与 0.6362/0.9999/0.6753。(Tables 12、16,PDF pp. 36、38。)
最重要的阅读取舍是把三件事分开:谱方向的数学推导、带历史状态的实际优化器、有限指标上的经验遗忘质量。 三者相互支持,但不互相替代。
结构地图
页码均从 PDF 第 1 页计数,与该版本印刷页码相同。
| 原文章节 | 内容与作用 | PDF 页码、关键证据 |
|---|---|---|
| 1 Introduction | 将优化几何作为独立于损失函数的设计轴 | pp. 1–2,Fig. 1 |
| 2 Preliminaries | GD/NPO/RMU;一般范数最陡下降;sign 更新 | pp. 2–4,Eqs. (1)–(8) |
| 3 Spectral Unlearning: Transformer Structure-Preserving Updates | 谱更新、三种实际实现及算法 | pp. 4–6,Eqs. (9)–(12),Fig. 2,Algorithm 1 |
| 4 Spectral Updates and Transformer Geometry | RMS-to-RMS 范数与多层定理 | pp. 6–7,Lemma 1、Theorem 2,Eqs. (13)–(17) |
| 5 Experiments | TOFU、学习率、层分析、RWKU/WMDP、再学习 | pp. 7–10,Tables 1–3,Figs. 3–6 |
| 6 Conclusion | 总结优化几何的作用 | p. 10 |
| A Proofs | 对偶范数、RMS 缩放、多层最大范数的完整推导 | pp. 14–17 |
| B Practical Realization on the LLM scale | 不同矩阵的归一化位置与单双侧预条件 | pp. 17–19,Table 4 |
| C Experimental Setup and Hyperparameter | 训练预算、优化器、学习率、种子与额外基线 | pp. 19–22,Table 5 |
| D Evaluation Protocol Details | Mem、Priv、Util 的实际计算 | pp. 22–23,Eqs. (49)–(56) |
| E Extended Empirical Analysis | 结构对齐、子指标、学习率、轨迹、等时比较、谱指数 | pp. 23–30,Table 6,Figs. 7–14 |
| F Qualitative Examples | 遗忘泄漏、幻觉、退化及保留知识案例 | pp. 30–34,Tables 7–11 |
| G Comprehensive Quantitative Results | 完整均值/标准差、训练成本、全部子指标 | pp. 35–42,Tables 12–28 |
| H Limitations and Broader Impacts | 评估形式、成本、规模与一般优化收益的边界 | p. 43 |
一:动机——遗忘效果不只由损失决定
设模型为 $\pi_w(y\mid x)$,遗忘集为 $\mathcal D_u$,保留集为 $\mathcal D_r$。常见目标写成
损失决定梯度中“往哪边忘、哪些行为要保留”的信号;优化器再决定怎样把信号转换成参数变化。逐元素方法保留每个标量的历史统计,但通常不显式建模同一矩阵不同行列之间的相关性。Transformer 的投影矩阵却是共同作用于隐藏向量的线性算子,因此可以从算子范数而非扁平参数坐标出发设计更新。(Sec. 1–2,PDF pp. 1–4。)
这项工作的创新主要是将这种几何观点系统用于 LLM 遗忘,连接现有矩阵优化器并做控制实验。App. A 也明确指出,谱范数解释神经网络优化的几何思想已有先前研究;本文不是首次提出 Muon、Shampoo 或 SOAP。
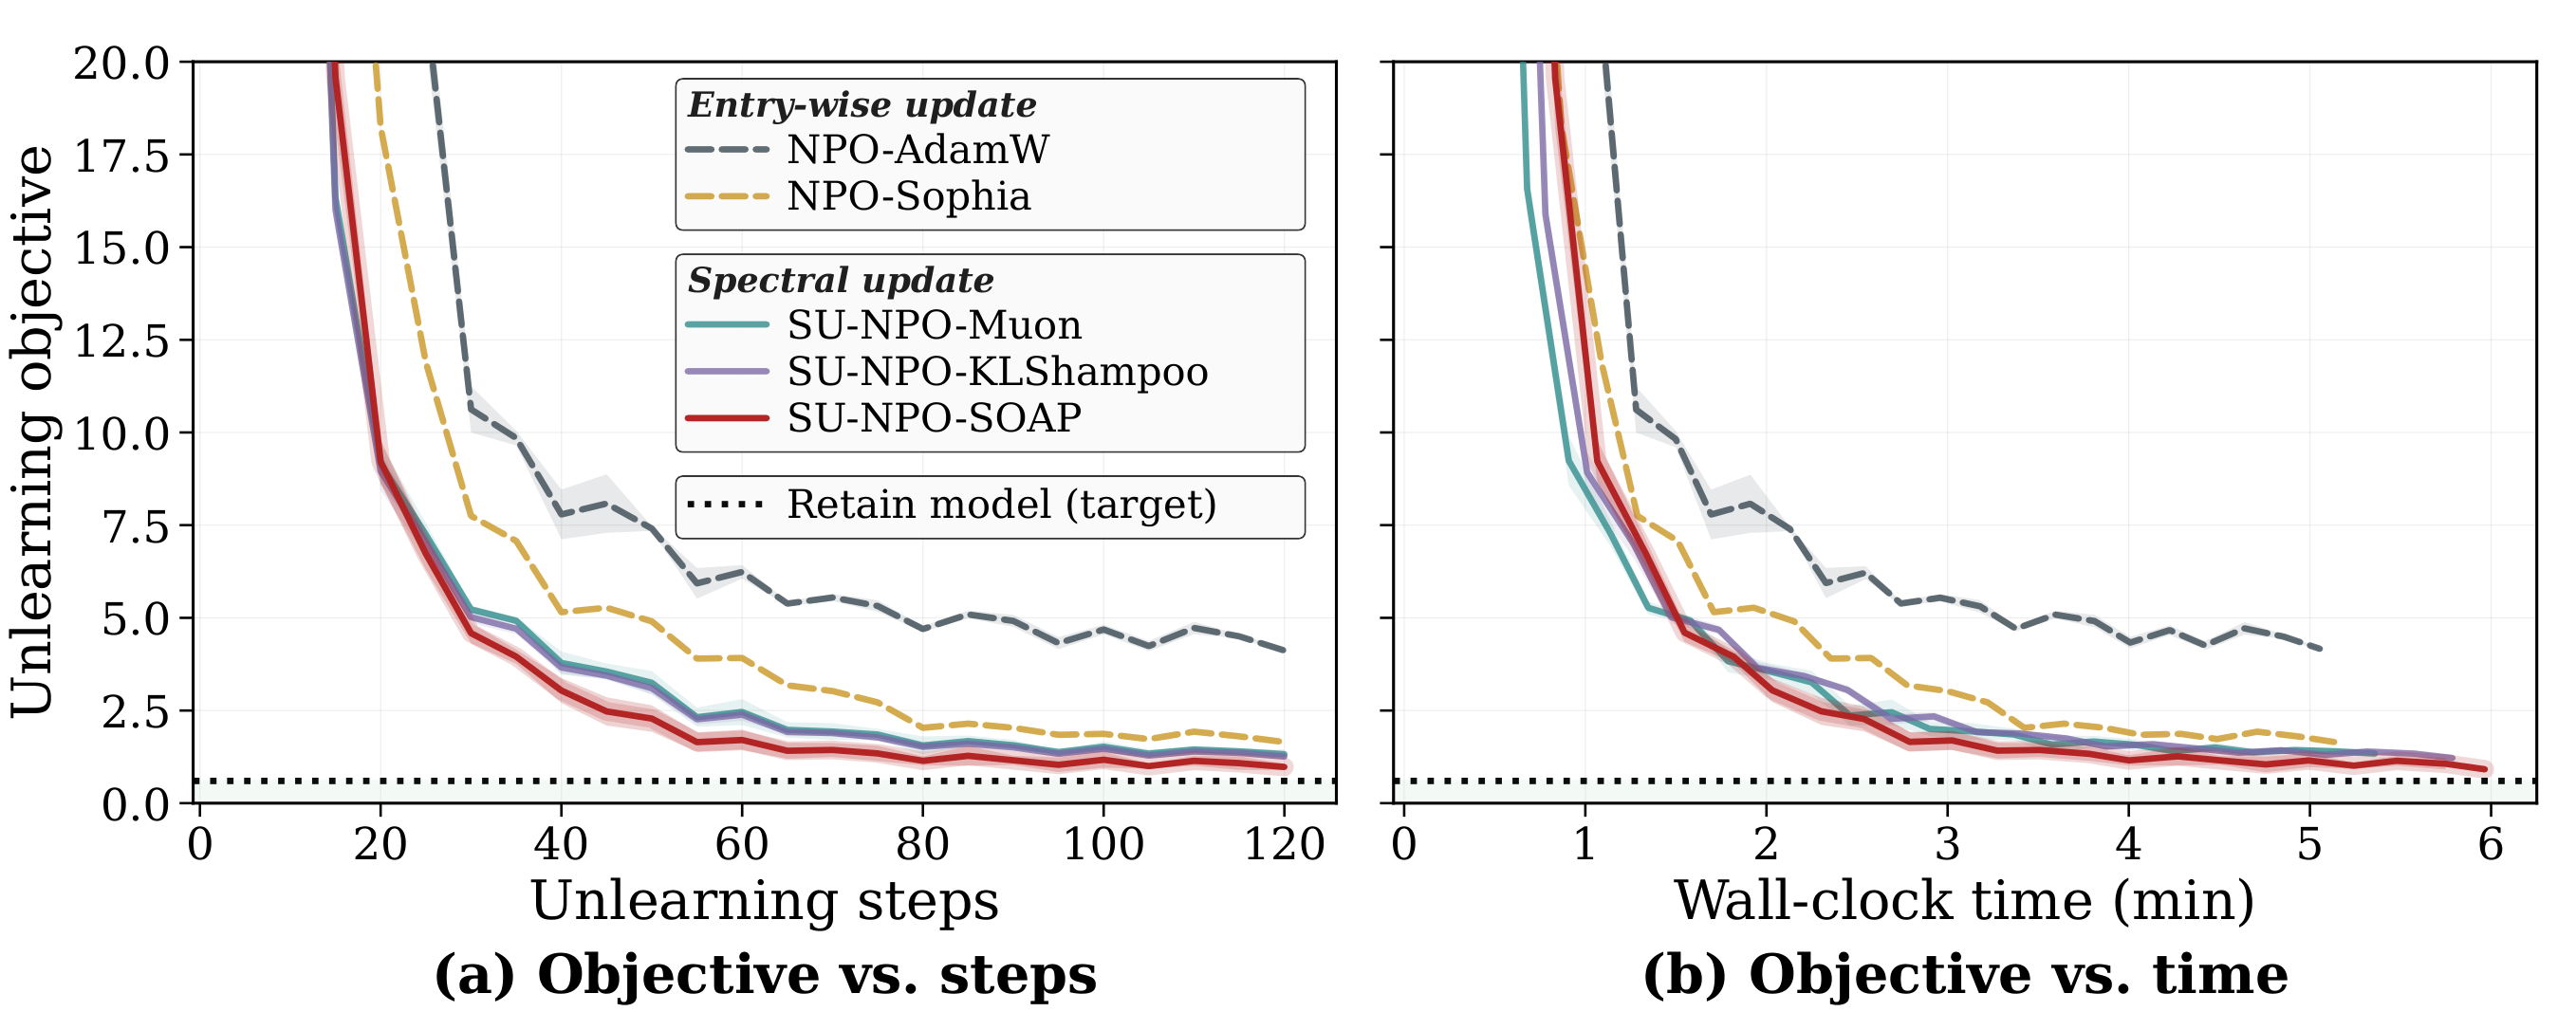
原文 Fig. 1,PDF p. 2,Llama-3.2-1B、TOFU。左横轴为训练步数,右为时间;纵轴是遗忘训练目标。实线是谱方案,虚线为逐元素基线,参考线来自 retain-trained 模型。它说明训练动态差别,但目标值变低并不自动证明知识被干净移除,仍需后面的多轴评估。
二:方法——从范数选择到可实施更新
2.1 三种遗忘目标分别提供什么信号
梯度差(Gradient Difference,GD):
最小化第一项压低遗忘答案的概率,第二项保持保留答案。第一项无下界,过激更新可能让保留能力崩溃。这里 GD 是方法名“Gradient Difference”,不要与泛指梯度下降混淆。(Eq. (2),PDF p. 3。)
负偏好优化(Negative Preference Optimization,NPO):
$w_0$ 是冻结参考,$\beta>0$ 控制平滑程度。该遗忘项以 0 为下界,缓解 GD 的无界问题;序列概率相对参考降低会使其减小。主文 Eq. (3) 展示遗忘项,实际实验另加保留 NLL,取 $\beta=0.1$、遗忘与保留权重均为 1。这个参考比值本身不等于一个全局 KL 约束,保留行为仍靠实际训练目标和评估控制。(PDF p. 3;App. C.3,PDF p. 20。)
表征误导遗忘(Representation Misdirection for Unlearning,RMU):
$u$ 是固定随机单位方向,$c$ 是幅度;遗忘数据的中间表征被引向随机目标,保留数据靠近参考表征。TOFU 实验在第 7 个 transformer block 取目标,$c=2$,允许全部 transformer 参数训练;这与 WMDP 的层限制版本应分开理解。(Eq. (4),PDF p. 3;App. C.3,PDF p. 20。)
2.2 最陡下降依赖“怎样测量一步有多大”
给定梯度 $g$,在选定范数下最小化局部二次模型:
若损失局部满足相应范数下的 $\lambda$-smooth 条件,这个二次项也是局部上界的一部分。先固定单位方向 $t$,再优化幅度,可得
$\|g\|_*$ 为对偶范数,给出单位步预算下最强的一阶响应;$t^*$ 为实现该响应的方向。它可能不唯一。(Sec. 2.2,Eqs. (5)–(6),PDF p. 3;App. A.1,PDF p. 14。)
选扁平向量的 $\ell_\infty$ 范数时,对偶为 $\ell_1$,最优方向是逐元素 $\operatorname{sign}(g)$。作者通过移除 AdamW 的移动平均、权重衰减等因素,把它与 sign descent 联系起来;完整 AdamW 并不在每一步都等于 sign 更新。(Sec. 2.3,Eqs. (7)–(8),PDF p. 4。)
2.3 谱范数的对偶给出极因子方向
对 $W\in\mathbb R^{m\times n}$,谱范数是最大奇异值:
现在测量的是矩阵对任意单位输入的最大作用幅度,而非最大单个参数变化。令梯度的 SVD 为 $G=U\Sigma V^\top$,谱范数的对偶为核范数 $\|G\|_*=\sum_i\sigma_i$。因此
证明关键步骤:当 $\|T\|_2\le1$ 时,
取 $T=UV^\top$ 可达到该上界。再把幅度 $c$ 代入 $-c\sum_i\sigma_i+\lambda c^2/2$,最小点为 $c=\sum_i\sigma_i/\lambda$。秩不足时存在多个最优方向;公式给出其中一个选择。(Sec. 3.1,Eqs. (9)–(11),PDF p. 4;App. A.3,PDF p. 15。)
实际迭代将幅度交给学习率,得到
Eq. (12) 的固定/调度学习率是实际算法选择,不是逐步计算 $\operatorname{tr}\Sigma/\lambda$ 的精确二次模型最小步。
教学例子:若 $G=\operatorname{diag}(10,1)$,欧氏梯度方向在两个坐标上的幅度比是 10:1;谱方向 $UV^\top=I$ 则是 1:1。被压平的是更新的奇异谱,既不要求权重本身正交,也不意味着低秩截断。它会增加较弱梯度模态相对较强模态的影响。
2.4 为什么 RMS-to-RMS 几何会导向谱范数
对 $x\in\mathbb R^d$,定义 $\|x\|_{\rm RMS}=\|x\|_2/\sqrt d$。对输入维度 $d_{\rm in}$、输出维度 $d_{\rm out}$ 的线性映射:
证明只需把 $\|x\|_{\rm RMS}=1$ 改写为 $\|x\|_2=\sqrt{d_{\rm in}}$,再按输出维度除以 $\sqrt{d_{\rm out}}$。(Lemma 1、Eq. (16),PDF p. 6。)这是关于两个范数的恒等式。pre-norm 的 RMSNorm 为选择这种输入/输出尺度提供架构动机。
多层定理进一步选择网络更新范数
令 $a_l=\sqrt{d_{\rm out,l}/d_{\rm in,l}}$,则局部二次模型的一个解是
证明的核心是:惩罚只取所有层中最大的步幅,而每个非零梯度层都能贡献线性下降;因此没达到最大幅度的层可以免费增加幅度,最优时这些层使用共同 RMS-to-RMS 幅度。其值由所有层的对偶范数之和决定。(Theorem 2、Eq. (17),PDF pp. 6–7;App. A.4,PDF pp. 16–17。)
若所有相关矩阵都是方阵,$a_l=1$,可以共享一个标量。真实模型含矩形 MLP 投影,论文实际使用的无显式维度缩放更新还涉及工程约定。定理说明的是选定网络范数下的局部最陡下降方向;它不证明该层间最大范数优于其他组合,也不直接给出遗忘保证。App. H 将与层间 $\ell_1/\ell_2$ 组合的经验比较列为开放问题。
2.5 三种实现:相同几何动机,不是相同的逐步更新
| 实现 | 处理方式 | 与理想 $UV^\top$ 的关系 |
|---|---|---|
| Muon | 对动量矩阵做少量 Newton–Schulz 迭代 | 近似动量的极因子,而非每步原始梯度的精确 SVD |
| KLShampoo | 用左右二阶统计预条件,$\Delta W\propto-L_t^{-1/4}G_tR_t^{-1/4}$ | 累积的行列统计保留矩阵结构 |
| SOAP | 在 Shampoo 型特征基中做 Adam 式更新 | 特征基旋转与坐标自适应共同决定实际方向 |
Muon 的主文示意迭代为
其中 $M$ 是动量矩阵,实验取 5 次迭代。KLShampoo 维护近似 $\mathbb E[GG^\top]$、$\mathbb E[G^\top G]$ 的统计。SOAP 则利用这些统计的特征向量构建坐标基,在该基中更新后旋转回来。(Sec. 3.2,PDF p. 5。)
由此可见,“谱方法”在文中是一组矩阵结构优化实现。动量、EMA、数值正则、有限刷新频率和权重衰减,都使它们区别于理论里的瞬时无历史更新。尤其 SOAP 的成功,不应被解释成实验证明“每步精确 $UV^\top$ 是唯一有效机制”。
2.6 真实架构中的单双侧预条件
RMSNorm 直接作用于残差维度 $d$,不会直接归一化 MLP 的中间维度 $d_{\rm ff}$。App. B 因此区分:
| 矩阵类型 | 典型形状 | 预条件侧 |
|---|---|---|
| Attention 投影 | 主文简化为 $d\times d$ | 左右两侧 |
| MLP gate/up | $d_{\rm ff}\times d$,高矩阵 | 仅右侧、输入残差维度 |
| MLP down | $d\times d_{\rm ff}$,宽矩阵 | 仅左侧、输出残差维度 |
| Embedding | 词表维度乘 $d$ | AdamW |
SOAP 设 max_precond_dim=d、merge_dims=False:1B 的 $d=2048$,3B 的 $d=3072$;超过维度上限的一侧不维护预条件统计。论文的矩阵清单见 Table 4,PDF p. 18。
单双侧关系中的精确结论:对满列秩的高矩阵,
对满行秩的宽矩阵,
因此从瞬时梯度计算精确逆平方根时,单侧也能得到极因子,不必一定构建双侧大矩阵。(App. B.5,PDF pp. 18–19,Eqs. (46)–(48)。)
这个结论的条件不能省略:它针对满秩、瞬时 Gram 矩阵、$-1/2$ 次幂。EMA 统计、KLShampoo 的 $-1/4$ 次幂、SOAP 的基内 Adam 并不自动等于它;App. B 后半也将累积统计称为近似。秩不足时直接求逆需要改用适当正则或伪逆。
主文还把每个投影的输入都概括成 RMS-normalized,App. B.3 则澄清:$W_Q,W_K,W_V,W_1$ 直接接收 RMSNorm 输出;$W_O$、$W_2$ 的输入经过注意力或非线性,只是尺度受控,未必单位 RMS。固定的正尺度重标定不改变极因子的朝向,但逐样本尺度/方向分布的变化不能一概归为单个学习率。更准确地说,RMS 几何为设计提供动机,真实实现仍需逐矩阵适配。
2.7 完整训练流程
- 选用 GD、NPO 或 RMU,确定遗忘与保留数据。
- 在同一个当前模型上计算总损失与各矩阵梯度。
- 按矩阵维护动量/左右二阶统计/特征基。
- 用所选实现构造预条件方向并更新;embedding 使用 AdamW。
- 按论文的逐配置扫参选择学习率,最后同时评估遗忘、隐私与效用。
这是 Algorithm 1 的教学整理(PDF p. 5)。算法中的逐矩阵循环描述更新组织;实际自动微分通常一次反向得到全部梯度,不需要为每个矩阵重新跑完整训练批次。
三:实验——配置与指标决定怎样解释“更好”
3.1 基准、参考模型和控制变量
| 基准 | 模型 | 评价任务 |
|---|---|---|
| TOFU | Llama-3.2-1B-Instruct、3B-Instruct | 指定作者相关数据的遗忘,含 1%/5%/10% 划分;保留、真实作者、世界事实评估 |
| RWKU | Llama-3-8B-Instruct | 真实人物知识遗忘,同时保留相关邻近知识和 MMLU |
| WMDP | Zephyr-7B-$\beta$ | 生物/网络安全领域知识评估,同时保留 MMLU |
TOFU 有两个参考:Original 在完整数据上微调;Retrain 只在 retain 集上微调。后者是该微调任务的 retain-trained oracle,不是对基础模型全部预训练语料做精确删数重训。(Sec. 5.1,PDF p. 7。)
主实验为 3 种损失乘 5 种优化器,共 15 种组合;逐元素基线为 AdamW、Sophia,谱实现为 Muon、KLShampoo、SOAP。另比较 UNDIAL、SatImp、WGA、AltPO、SimNPO、PDU、IdkDPO、GradAscent、CEU 九种基线。额外方法使用各自规范设置,例如 WGA/SatImp 为 5 epochs,其余主组合为 10 epochs,不能将所有 24 种方法描述成训练完全相同。(App. C.7,PDF pp. 21–22。)
3.2 主训练预算
- TOFU 主组合训练 10 epochs,首个 epoch 线性预热,之后 9 epochs 线性衰减至 0;weight decay 为 0.01。
- 1B:micro-batch 8、累积 4,有效批 32;3B:micro-batch 4、累积 4,有效批 16。
- 对 1%/5%/10% 遗忘划分,1B 约为 13/63/125 个更新步,3B 约为 25/125/250 步。小遗忘集的实际步数很少。
- 每个模型、划分和方法调学习率,基本网格为 $\{1,2,3,5\}\times\{10^{-6},10^{-5}\}\cup\{10^{-4}\}$;特定 GD 配置另试 $7\times10^{-6}$、$1.5\times10^{-5}$。
- 三个种子 $\{0,1,2\}$ 改变数据打乱和优化内部随机性,不重新训练初始 checkpoint,也不重划分遗忘集。
- 使用 RTX A6000 48GB;1B/3B 每个作业用单卡,扫参作业并行;7B WMDP 用四卡 ZeRO-3。训练和谱状态使用 bfloat16,SOAP 特征分解用 float32。
来源:App. C,PDF pp. 19–21。SOAP 的基与预条件每 10 步刷新;1% 划分中刷新次数尤其有限。论文没有给出这些很小分差的独立显著性检验,因此下文保留均值与标准差。
3.3 Agg 是三轴调和平均,不是单一遗忘准确率
定义
三项均越大越好,调和平均使弱项对总分影响较大。Agg 相近不代表三个分项相近,更不代表模型输出分布无法区分。(App. D,PDF pp. 22–23。)
Mem:四项的调和平均。
- ES(extraction strength)衡量给较短前缀时,后续连续目标后缀可被提取的程度;原始 ES 越低越好。
- EM 在本文是token 级贪心预测一致率,不是整条回答完全匹配率;它也记录不连续匹配,原始值越低越好。
- F.Prob 是原始遗忘问题上,答案 token 概率几何平均后再对样本取均值;越低代表残留目标似然越少。
- F.TR 使用正确答案的改写与错误扰动答案。令 $R_z=p_z^{\rm pert}/(p_z^{\rm para}+10^{-10})$,再取
它在二者概率接近时高,而不是越偏向错误答案越高。这样可惩罚“把所有正确答案压到极低、却很确信另一个错误答案”的过度遗忘。论文用原始 F.Prob 替代默认评估中的 paraphrase probability,以减少与 F.TR 重复计入同一改写信号;P.Prob 仍列在附录,但不进入本文 Mem。(Eqs. (51)–(53),PDF pp. 22–23。)
Priv:与 retain-only 参考的 MIA 行为接近程度。
四个成员推断攻击基于平均损失、压缩长度校正、最低 40% token 概率及其标准化版本。目标是接近对应参考 AUC,不是一概将 AUC 压到 0 或 0.5;小于 0.5 也不能据此断言隐私更好。Priv 是这里规定的经验相似度,不是差分隐私或可认证遗忘保证。(Eqs. (54)–(55),PDF p. 23。)
Util:十项等权调和平均。 在 retain、real-author、world-facts 三个集合上各计算答案概率、ROUGE-L recall、retain 方向的 truth ratio,再加遗忘输出的 fluency,合为十项。Fluency 来自非乱码分类器,能发现部分退化,但重复流畅模板也可能得到好分。(Eq. (56),PDF p. 23;Sec. 5.3,PDF p. 9。)
WMDP/RWKU 不使用这套 Agg,而用有方向的 Gain $\Delta$。例如 RWKU:
其中 $F$ 为 forget 残留知识,$N$ 为 neighbor,$M$ 为 MMLU;下标 0 表示 Original。WMDP 将前两项替换为 Bio/Cyber 的下降量,第三项仍为 MMLU 的变化。(Sec. 5.5,PDF pp. 9–10。)
四:结果——哪些收益稳定,哪些结论需缩小表述
4.1 梯度相关结构:谱方案能捕捉逐元素统计忽略的信息
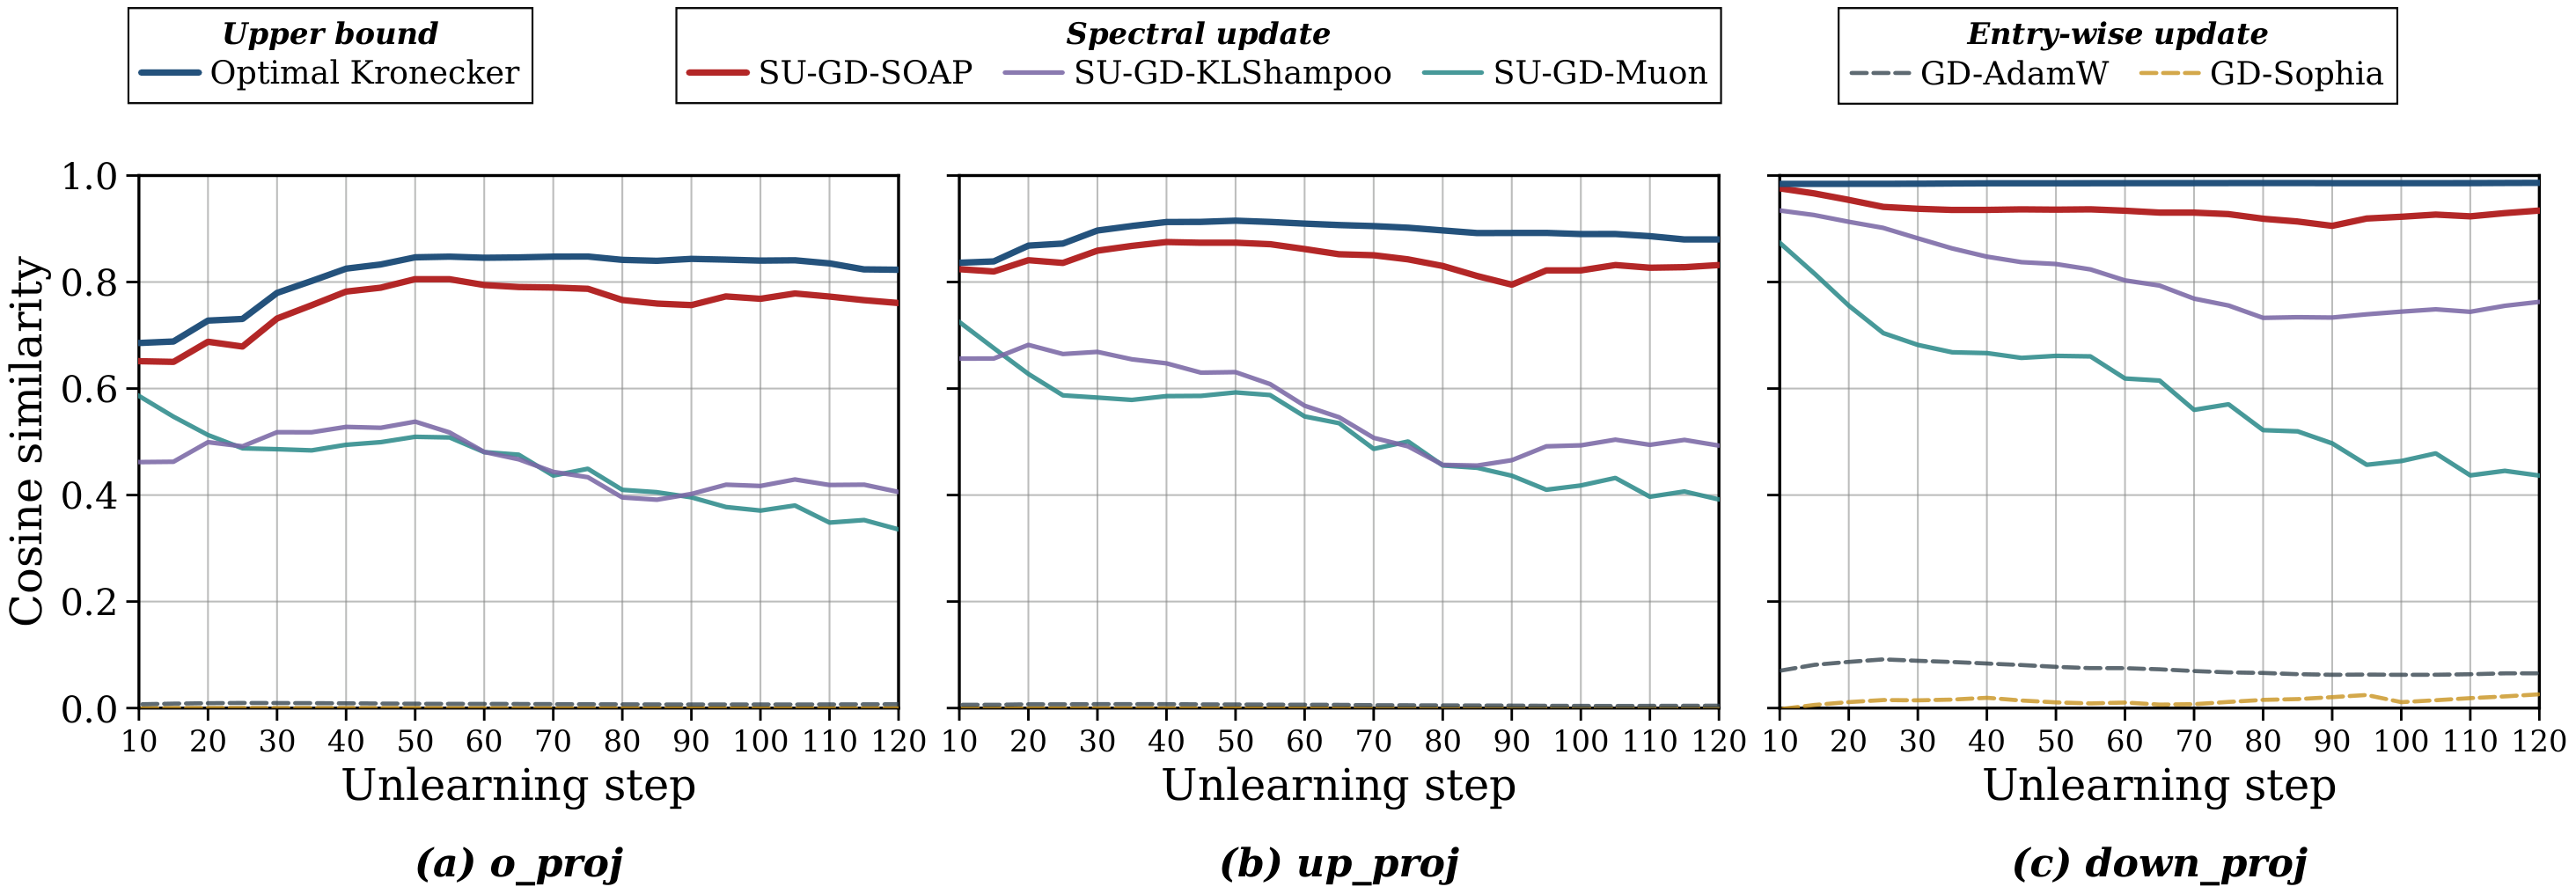
原文 Fig. 2,PDF p. 5。横轴为遗忘步数,纵轴为与测量梯度协方差的余弦相似度;三面板依次为 attention output、MLP up、MLP down。深蓝是最优 Kronecker 参考,红色 SOAP 最接近它,Muon/KLShampoo 居中,AdamW/Sophia 接近零。这里的相似度衡量的是协方差结构近似,不是直接计算每种实际更新与精确 $UV^\top$ 的方向余弦。
App. E.1 的 Figs. 7–8(PDF pp. 24–25)扩展到第 7/15 blocks 以及 NPO/RMU:结构与逐元素方案间的分离依然存在。它支持矩阵相关性是有用信号;不能单凭这张图就把 SOAP 的全部收益归因于精确谱最陡下降。
4.2 TOFU 主设置:SOAP 的综合分优势较一致
以下均取 Table 12 的精确均值,Agg 越高越好;每个单元为“较好的逐元素基线 → 同损失 SOAP”。
| 目标 | GD | NPO | RMU |
|---|---|---|---|
| 1B,10% | 0.5704 → 0.6043 | 0.6876 → 0.6926 | 0.6888 → 0.6982 |
| 1B,5% | 0.5653 → 0.6075 | 0.6599 → 0.6711 | 0.6801 → 0.6862 |
| 3B,10% | 0.5839 → 0.6091 | 0.7243 → 0.7262 | 0.7038 → 0.7165 |
| 3B,5% | 0.5737 → 0.6455 | 0.7062 → 0.7211 | 0.7317 → 0.7360 |
来源:Table 1,PDF p. 7(两位小数);Table 12,PDF p. 36(精确均值与标准差)。上述 12 个模型—划分—损失组合里,SOAP 的均值均高于 AdamW 和 Sophia。不过,并非所有谱实现都胜过两条逐元素基线:3B、10%、GD 时 Muon 为 0.5016、KLShampoo 为 0.5108,均低于 Sophia 的 0.5839。
一个大收益例子是 3B、5%、GD:SOAP 为 $0.6455\pm0.0089$,AdamW 为 $0.5398\pm0.0221$,Sophia 为 $0.5737\pm0.0305$。SOAP 比 AdamW 高 0.1057 个分数单位;这是综合指标的差,不应写成任务准确率提高 10.57 个百分点。
不同损失的最优总分也不一样。GD 的遗忘项无下界,几何改善不能消除目标自身的全部问题。NPO 在一些设置中原本就接近参考,收益可能只有几个千分点。RMU 常产生更强遗忘但也可能过度破坏表征;SOAP 改善的是这些取舍。
4.3 “匹配重训练参考”应怎样理解
主文对 3B、5%、SU-RMU-SOAP 使用了“匹配 retain-trained reference”的表述。Table 1 两者都四舍五入为 0.74,但精确数据为:
| 方法 | Agg ↑ | Mem ↑ | Priv ↑ | Util ↑ |
|---|---|---|---|---|
| RMU-AdamW | $0.7151\pm0.0012$ | 0.8440 | 0.6856 | 0.6444 |
| RMU-Sophia | $0.7317\pm0.0021$ | 0.6920 | 0.9010 | 0.6474 |
| SU-RMU-SOAP | $0.7360\pm0.0011$ | 0.7160 | 0.8468 | 0.6673 |
| Retrain | 0.7402 | 0.6362 | 0.9999 | 0.6753 |
来源:Tables 12、16,PDF pp. 36、38。SOAP 与 Retrain 的 Agg 差 0.0042,各轴差异明显大于两位小数总分所呈现的印象。尤其 SOAP 的 Mem 高于参考,Priv 却低于参考,调和平均让它们得到接近的综合值。因此这里应说接近参考的聚合得分,不应推导模型分布或隐私行为不可区分。
4.4 1% 遗忘集给出明确反例
扩展到 Table 12 的 1% 划分后,“所有规模和划分均胜出”的表述不成立:
- 1B、NPO:SOAP 0.6445±0.0128,低于 Sophia 0.6486±0.0042,也低于 KLShampoo 0.6550±0.0041。
- 3B、RMU:SOAP 0.7139±0.0033,低于 AdamW 0.7169±0.0006。
- 3B、GD:Muon 0.6392±0.0040、KLShampoo 0.6379±0.0052,高于 SOAP 0.6217±0.0190。
这些数值提示,SOAP 是较强的整体选择,但不是每个小划分的最优实现。按 Table 12 均值计算,SOAP 在 18 个损失—模型—划分单元中有 16 个高于同损失两条逐元素基线中的较好者。App. G.1 的计数表述与表格范围不完全一致,本笔记以具体单元为准;这些小差异不直接作统计显著判断。
九种额外基线扩展了比较范围。每个模型—划分中选出的最佳 SOAP 组合均高于这些额外方法,但不应理解为每个 SOAP 损失都高于每个额外基线,例如 3B、10% 的 WGA 0.6172 高于 SU-GD-SOAP 0.6091。(Table 12,PDF p. 36。)
4.5 多轴改善不是所有子指标同时改善
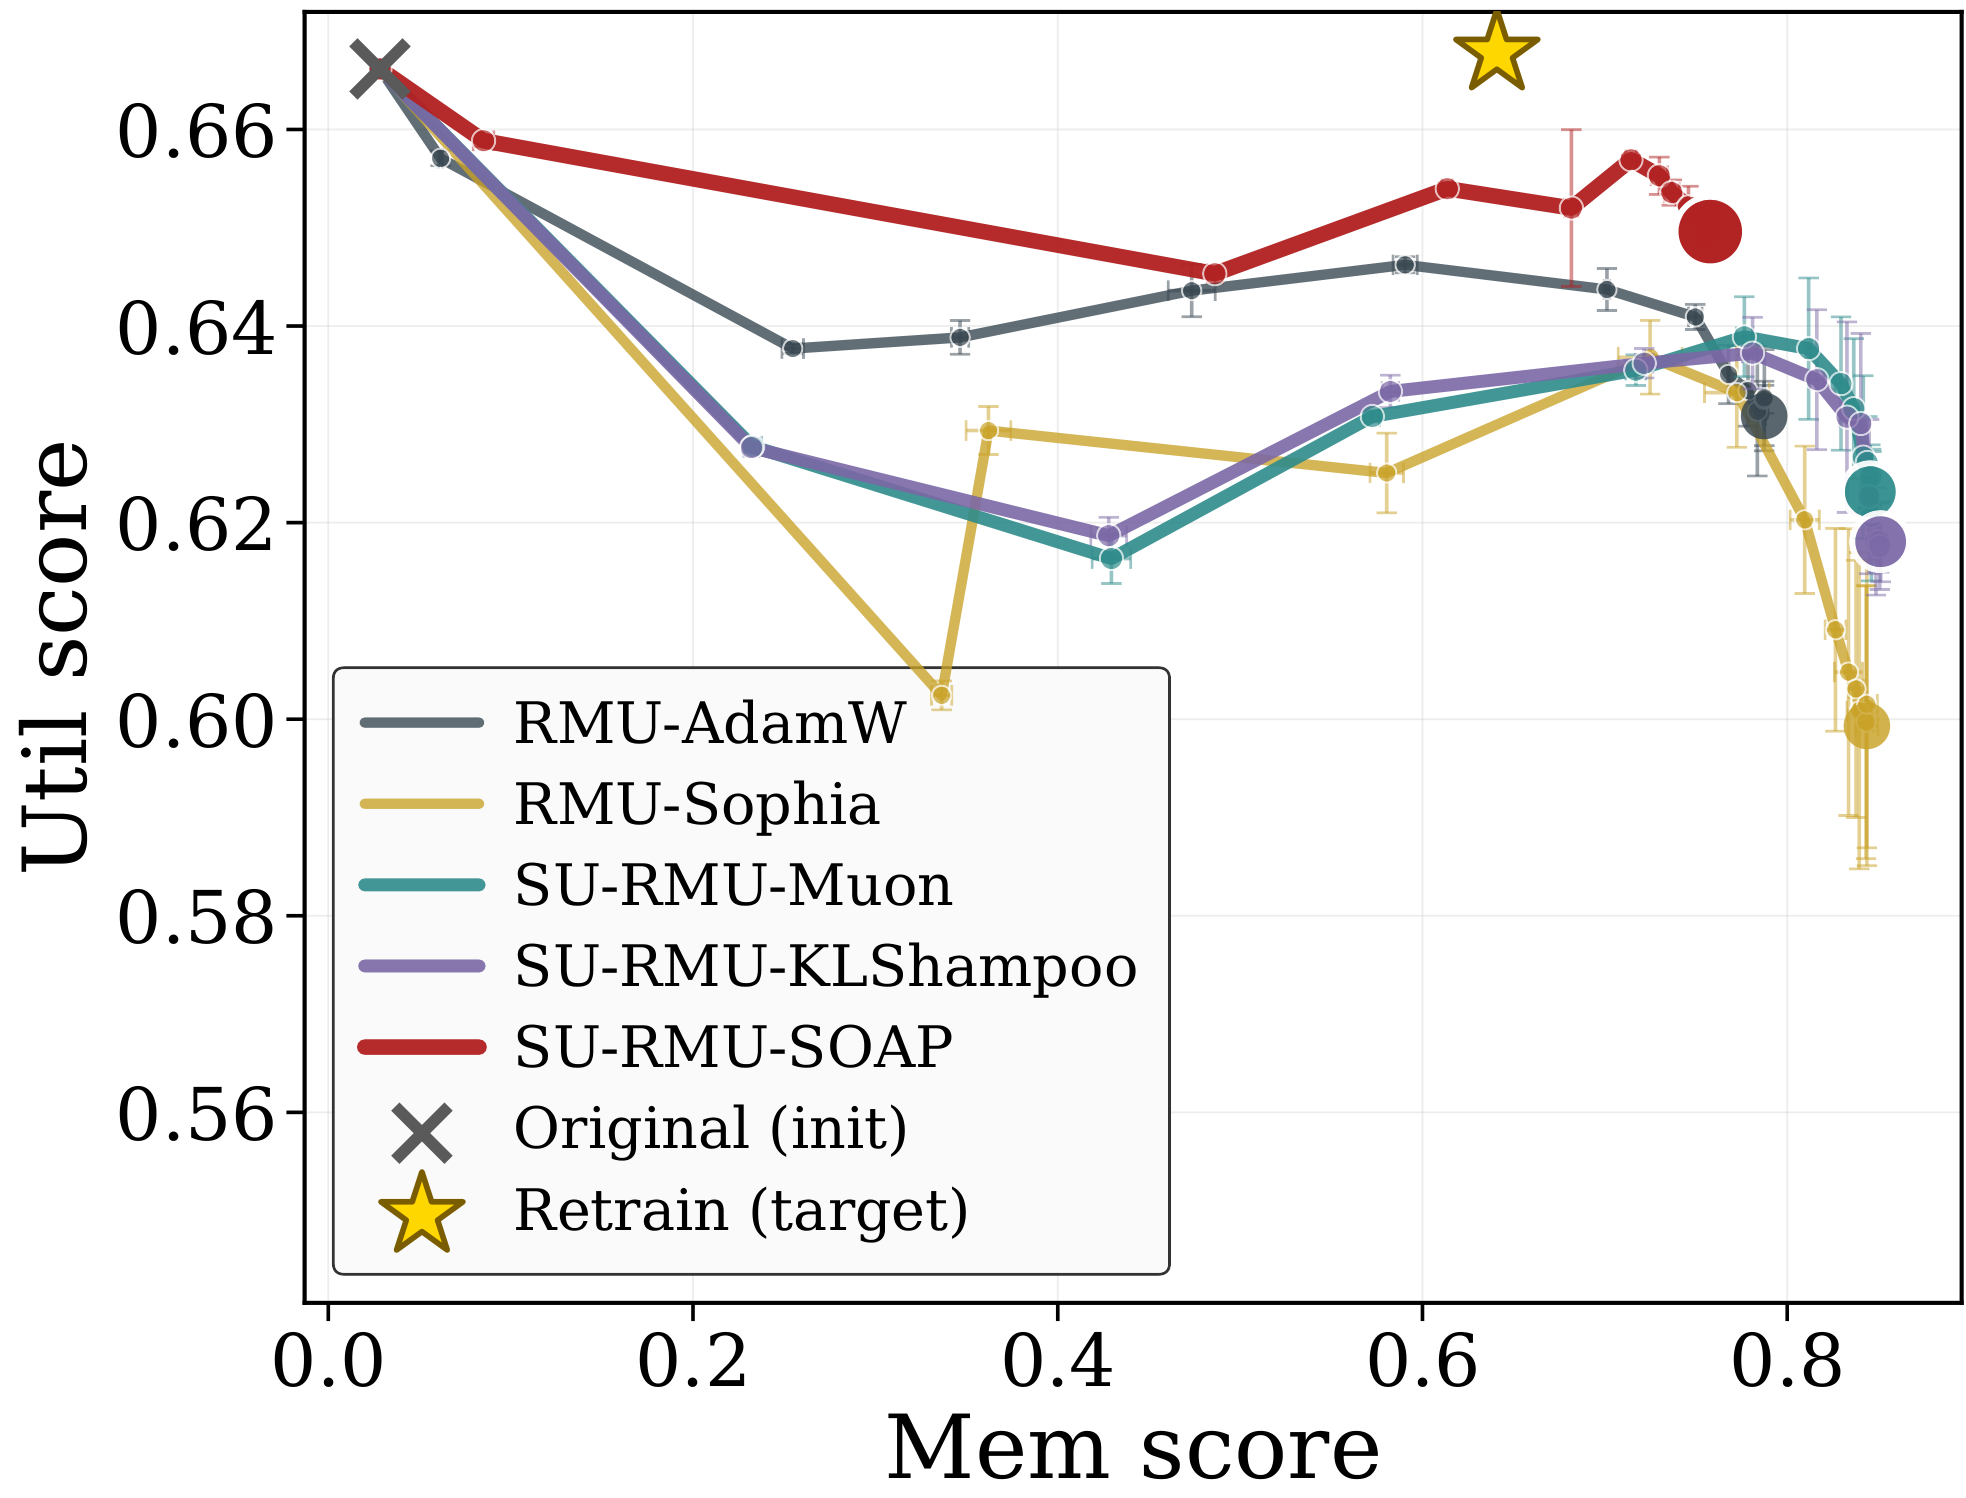
原文 Fig. 3,PDF p. 8,3B、10%、RMU。横轴是 Mem,纵轴是 Util;向右表示遗忘更充分,向上表示效用更好。黄色星为 Retrain,曲线为不同优化器的训练轨迹。SOAP 在该图中提供较有利的折中,但图中向右下方移动也显示,增加遗忘会付出效用代价。
Table 6(PDF p. 25)按 2 模型 × 3 划分 × 3 损失 = 18 个单元比较优化器家族。Spectral 是 Muon/KLShampoo/SOAP 的家族均值,Entry-wise 是 AdamW/Sophia 的均值,不是只比较 SOAP:
| 子指标 | 逐元素家族均值 | 谱家族均值 | 谱家族胜出单元 |
|---|---|---|---|
| F.TR ↑ | 0.5756 | 0.6059 | 18/18 |
| F.Prob ↓ | 0.1585 | 0.0859 | 14/18 |
| EM ↓ | 0.6202 | 0.5677 | 13/18 |
| ES ↓ | 0.0900 | 0.0687 | 12/18 |
| Retain ROUGE ↑ | 0.5632 | 0.5912 | 12/18 |
| Retain probability ↑ | 0.6214 | 0.6598 | 11/18 |
隐私子指标合计胜出 55/72,效用子指标为 102/180,所有子指标合计 214/324。域内保留收益比真实作者/世界事实等域外收益更明显;后者很多指标仅有 9/18 或 10/18 胜出。
具体到 3B、5%、RMU,从 AdamW 换 SOAP 后,Mem 从 0.8440 降为 0.7160,但 Priv 从 0.6856 升为 0.8468、Util 从 0.6444 升为 0.6673,总分仍提高。这个例子直接说明高 Agg 可能表示更平衡的遗忘,而非“残留记忆指标无一例外更低”。
4.6 学习率:更宽的有效区间仍有崩溃阈值
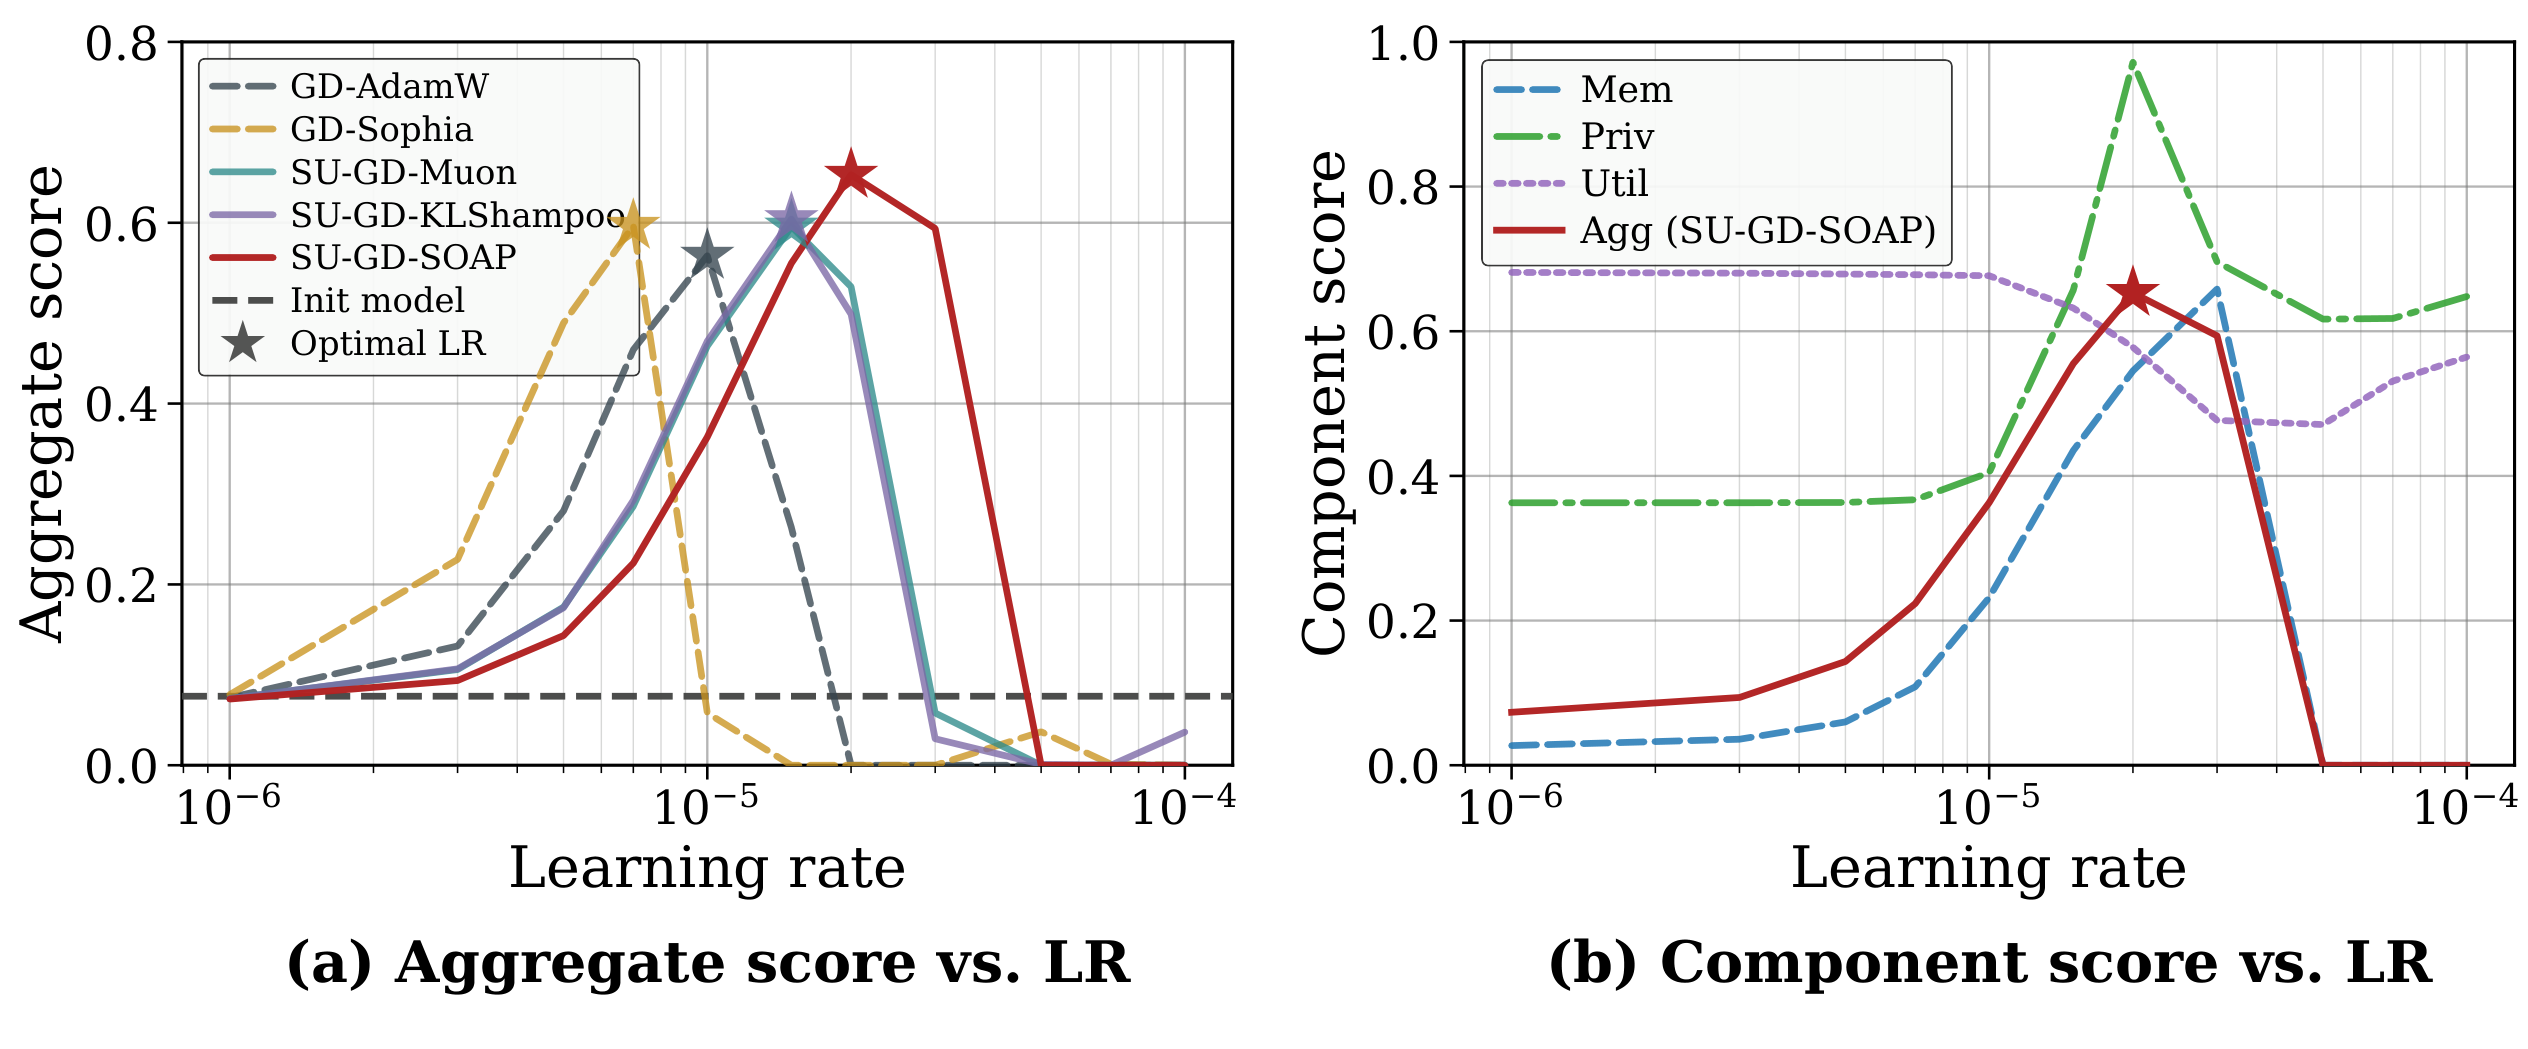
原文 Fig. 4,PDF p. 8;设置为 GD、3B、5%。横轴为对数学习率,左纵轴 Agg,星号为各方法最优学习率;右图分解 Mem/Priv/Util。SOAP 的最优点更高,在较宽范围维持较好结果;学习率过大时仍会崩溃。
App. E.3(Fig. 9,PDF p. 26)把各方法横纵轴按自身最优点归一化,再比较 90% 峰值区间:谱方法的较宽平台不只是最优学习率平移的结果。另一面板使用与 retain-trained 参考的输出分布 JSD,SOAP 在有用学习率附近更接近参考,但极端学习率下同样失去优势。
App. E.4(Fig. 10,PDF p. 27)进一步显示:逐元素 GD 的训练目标可变成很大的负值,同时 retain probability/ROUGE 下降。因此训练目标更低未必更好。极大学习率时 fluency 可能因输出重复的流畅模板而回升,也不能据此判断效用恢复。
4.7 层与轨迹分析支持“选择性更新”的解释
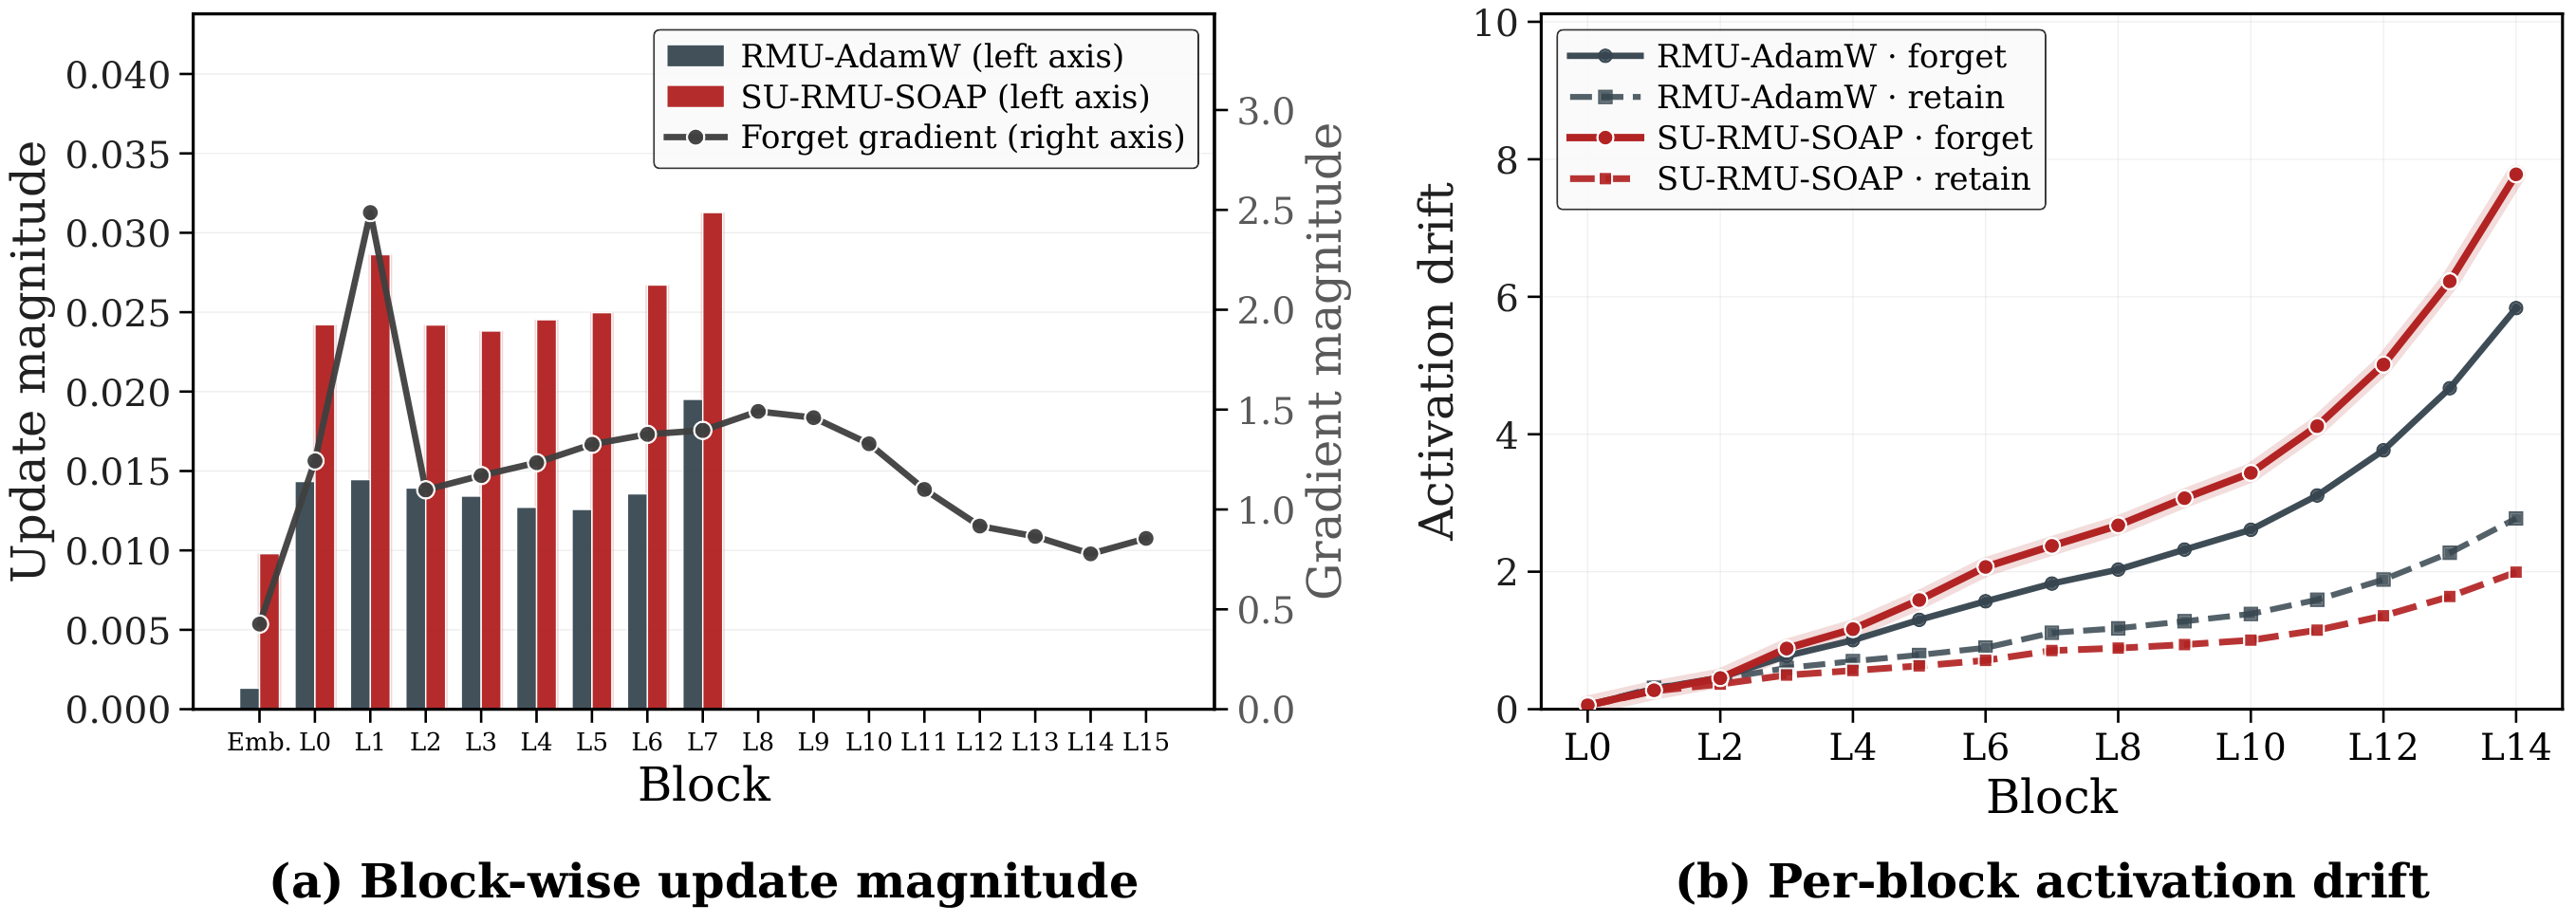
原文 Fig. 5,PDF p. 9。左横轴为 block,柱形是每步权重变化 Frobenius 范数的平均,右轴折线为梯度参考量;图注/图例称其为 forget gradient magnitude,正文则描述为初始化时 forget/retain 的梯度分歧。两处口径未完全统一,因此不将该线精确定义为某个未写出的冲突公式。
可直接读到的现象是:SOAP 对早中层、特别 L1,分配更大的更新;右图实线为 forget 表征漂移,虚线为 retain 漂移,SOAP 扩大了二者间隔,说明它在该实验中对遗忘样本影响更大,同时保留漂移较受控。(Sec. 5.4。)
App. E.5 的 Fig. 11(PDF p. 28)在 NPO、1B、10% 下比较遗忘目标与保留目标轨迹,SOAP 达到较低的遗忘目标并保持有竞争力的保留损失。这里的 forget loss 指 NPO 训练目标,不是希望升高的普通遗忘集交叉熵。Fig. 12 把各层累计参数位移做二维 PCA,显示不同优化器走不同路径;二维景观有助于观察,不能单独证明方向改善完全独立于步长、历史状态等因素。
4.8 时间和显存:谱更新并不是免费加速
| TOFU,3B,10% | 时间(分钟) | 峰值显存(GiB) | Agg |
|---|---|---|---|
| GD-AdamW | 8.79 | 14.64 | 0.3813 |
| SU-GD-Muon | 13.04 | 25.30 | 0.5016 |
| SU-GD-KLShampoo | 15.80 | 31.42 | 0.5108 |
| SU-GD-SOAP | 18.08 | 36.76 | 0.6091 |
| NPO-AdamW | 15.69 | 20.55 | 0.7243 |
| SU-NPO-SOAP | 24.32 | 42.75 | 0.7262 |
来源:Table 14,PDF p. 37;Agg 来自 Table 12,PDF p. 36。均为原文均值。相同 epoch 预算下,GD-SOAP 的时间约为 AdamW 的 2.06 倍,显存约 2.51 倍;NPO 对应约 1.55 倍和 2.08 倍,但 Agg 增益仅 0.0019。最优选择取决于损失和成本预算。
App. E.6 的 Fig. 13(PDF p. 29)将基线延长到 SOAP 结束时间之后,横轴为真实时间,纵轴为 Agg,虚线为基线、红实线为 SOAP,竖点线标 SOAP 结束。图实际展示 1B/3B、5%/10%、三种损失的 12 个单元,不含 1% 划分。GD/RMU 的若干基线在延长训练后崩溃或过度遗忘,SOAP 较稳定;NPO 更接近加速到平台,基线可追平,3B/5% 的 NPO 面板甚至显示 AdamW 后期略高。因此原文“额外时间也无法超过”的文字不宜作无例外结论。
这组实验支持谱方案在部分配置中有较好的达到有效结果的时间,并不意味着每步更便宜,或所有最终分数都更高。
4.9 RWKU 与 WMDP:增益是遗忘与保留的联合变化
| 基准、损失 | 更新 | Forget/Bio ↓ | Neighbor/Cyber | MMLU ↑ | Gain ↑ |
|---|---|---|---|---|---|
| RWKU,GD | AdamW | 0.1127 | 0.5657 ↑ | 0.6392 | 0.1117 |
| RWKU,GD | SOAP | 0.1460 | 0.6539 ↑ | 0.6376 | 0.1295 |
| RWKU,NPO | AdamW | 0.3250 | 0.7520 ↑ | 0.6292 | 0.0997 |
| RWKU,NPO | SOAP | 0.2034 | 0.7334 ↑ | 0.6281 | 0.1336 |
| WMDP,GD | AdamW | 0.2916 | 0.2574 ↓ | 0.4527 | 0.1271 |
| WMDP,GD | SOAP | 0.2789 | 0.2473 ↓ | 0.5084 | 0.1533 |
| WMDP,RMU | AdamW | 0.3079 | 0.2723 ↓ | 0.5387 | 0.1454 |
| WMDP,RMU | SOAP | 0.3028 | 0.2581 ↓ | 0.5476 | 0.1548 |
来源:Table 3,PDF p. 10;WMDP 三种子标准差见 Table 13,PDF p. 36。RWKU 的中间列是要保留的 Neighbor;WMDP 的中间列是要降低的 Cyber,两者方向不同。
对三种损失、两个基准,SOAP 的 Gain 均更高。但 RWKU-GD 的残余 Forget 从 0.1127 上升到 0.1460,联合收益来自更好保留邻近知识;这不是更彻底的目标遗忘。WMDP 为四选一,0.25 是随机猜测参照:SOAP-GD 的 Cyber 0.2473 已接近该值。不能将略低于 0.25 解释成“负知识”,也不能把该测试推成所有开放式危险能力均已消除。
4.10 再学习:谱方案恢复得较少,但仍可恢复
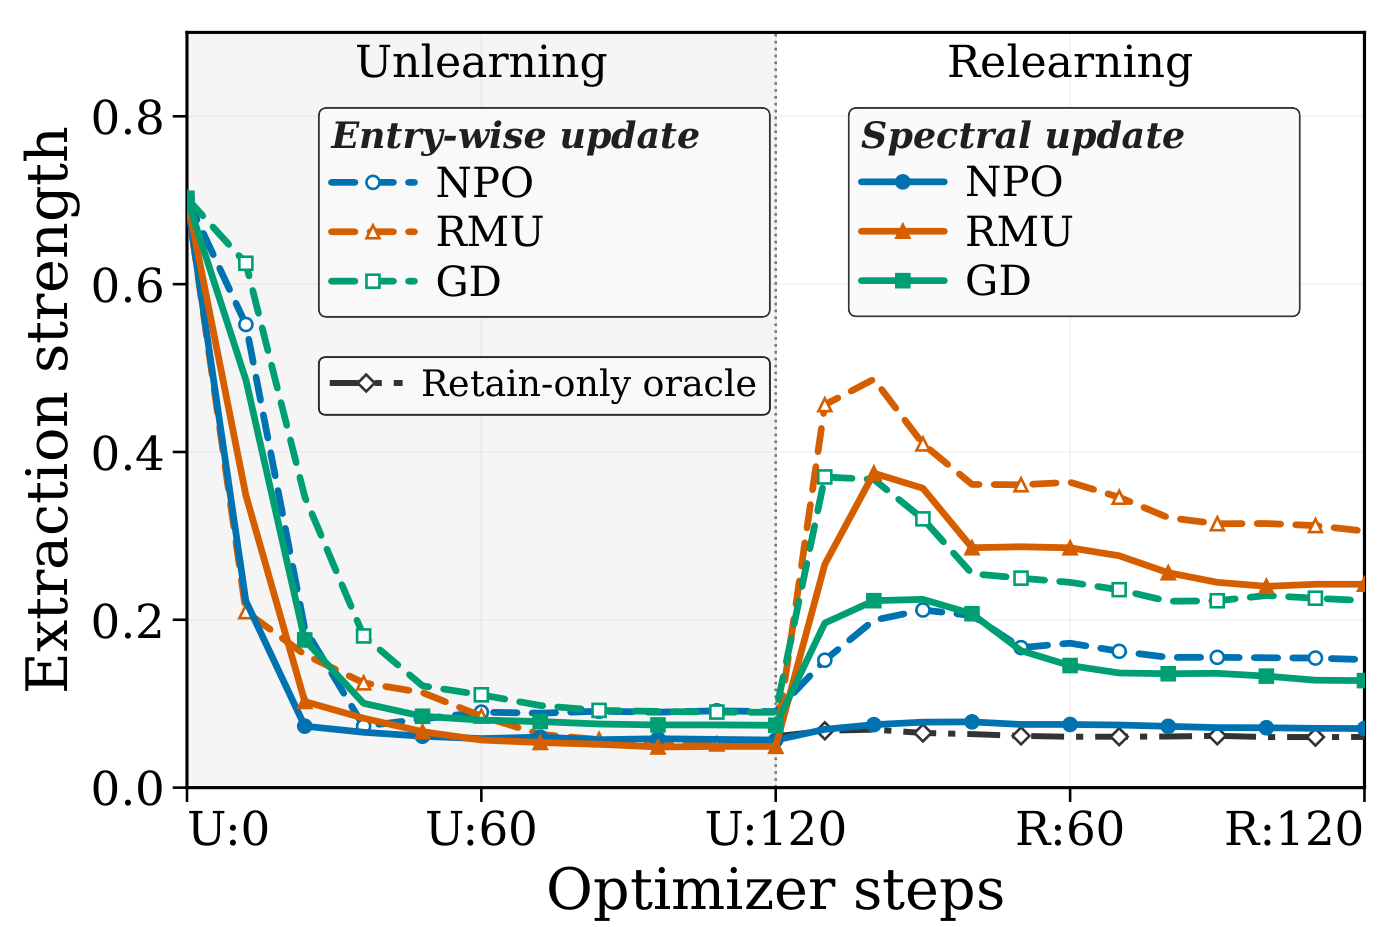
原文 Fig. 6,PDF p. 10。先遗忘完整数据中的 10%,再用遗忘集的随机 10%(完整数据的 1%)微调。横轴分为 unlearning 与 relearning,纵轴 ES,越低越好;颜色区分 NPO/RMU/GD,虚线是 AdamW、实线是 SOAP,灰色点划线为 retain-only oracle。
进入再学习后,几条曲线都可能回升;同损失下 SOAP 最终 ES 低于 AdamW。NPO 的最终恢复最低,谱 NPO 接近 oracle。RMU-AdamW 恢复更明显,作者联系到 SOAP 更大的 forget 表征漂移,认为较远的表征移动更难通过少量再学习逆转。这是与层分析一致的解释,实验没有将所有恢复机制逐一隔离。
因此,证据支持的是在该有限再学习协议下更难重新提取,不是不可逆删除。论文没有为更大再学习数据量或所有攻击形式给出保证。
4.11 谱指数与案例:收益也有一般优化成分
App. E.7(Fig. 14,PDF p. 30)改变动量矩阵的谱指数:
$p=1$ 接近原动量方向,$p=0$ 对应谱压平。这里另做单位 RMS 归一化,使幅度口径固定。随着 $p$ 降低,GD、NPO 的平均效用上升,仅做 retain SFT 也受益。这支持谱压平有价值,同时说明还需区分“针对遗忘任务的独有效应”与“一般优化改进”;App. H 明确承认这一点。
App. F 的五组生成案例(Tables 7–11,PDF pp. 31–34)补充了指标之外的行为:GD-AdamW 有时几乎复述遗忘答案,SOAP-GD 可偏离目标属性;NPO 往往输出流畅但无关的幻觉,RMU 有时产生退化文本。保留/一般知识问题中,NPO/RMU 的 SOAP 方案常更好,但 GD 的所有实现仍有错答。这说明优化几何能改善折中,却不能将“错误、乱码、拒答”自动变成理想遗忘。案例是少量选例,不用于估算总体发生率。
五:结论——应当带走的机制与边界
论文最有用的贡献,是把遗忘优化拆成可组合的两层:损失定义遗忘信号,矩阵几何决定怎样执行这个信号。 谱范数与 RMS-to-RMS 恒等式给出清晰的方向解释;TOFU 的多轴结果、再学习和跨基准实验说明,这个设计轴具有实际价值。SOAP 是本文整体表现较强的实现。
同时,几个具体边界会改变应用决策:
- 理论针对选定范数下的局部模型;实际 SOAP/Muon/KLShampoo 带历史统计和数值近似,不能称为每步精确执行定理。单侧极因子恒等式也有满秩和瞬时逆平方根条件。
- 主文 5%/10% 设置中 SOAP 的综合均值优势较一致;1% 设置存在反例,且接近的总分可能对应不同的遗忘—隐私—效用组合。
- 更好的训练轨迹伴随显著的时间/显存成本;NPO 在部分配置下本已接近最佳,增加复杂优化器的收益较小。
- TOFU 的 retain-only 参考只针对该微调任务;固定问题、概率和四选一测试仍不足以刻画所有残余知识。再学习结果是经验稳健性证据。
如果据此开展后续研究,优先保持遗忘目标和数据划分不变,比较矩阵更新与逐元素基线的学习率曲线、分项指标及等时成本;再进一步控制动量、方向归一化和谱指数,分解收益来自哪里。这样才能判断采用谱优化器是在改善目标遗忘,还是主要改善一般训练动态。