Transformer-FSQ:用离散潜变量实现极端 KV Cache 压缩
- 作者:Andras Szecsenyi、Thomas L. Lee、Vaisakh Shaj、Elliot J. Crowley、Amos Storkey(爱丁堡大学)
- 版本:arXiv:2611.09598v1,2026-11-06 提交;本次研读:2026-11-10
- 原文:arXiv 摘要页 · 本地 PDF
- 发表:未查到正式发表信息(截至 2026-11-10);作者研究组将其列为 arXiv 预印本。作者组出版列表
- 代码:代码待发布。论文列出作者仓库,但该仓库在查证时公开为空仓库,没有可读文件。论文第 13 页称代码已提供,与当日仓库状态不一致。
- 一句话要点:Transformer-FSQ 在每个 token 的归一化残差状态上训练一个 4-bit 有限标量量化瓶颈,把原本分开的 K/V 缓存改成供所有 KV 头共享的紧凑离散代码;在 Qwen3 的 12×–97.5× 压缩区间,它在所测方法中保留了最高的 RULER 检索分数,并以融合内核把 8B 模型 32× 时的解码吞吐维持在未压缩 SDPA 的水平。
论文总览
KV cache 随上下文长度线性增长,是长上下文推理中的显存与带宽负担。论文聚焦一个具体问题:怎样在预训练 Transformer 保留标准注意力的前提下,把每个 token 的 K/V 状态压到远超常见 2–4 bit 量化的程度,同时保留后续不同 query 对过去 token 的检索能力。
方法的关键变化是“先压缩,再生成 K/V”。每层先把归一化残差向量投影到较宽、低比特的潜变量,再对每个坐标独立做有限标量量化(Finite Scalar Quantization, FSQ)。缓存只保存打包后的整数码;所有 KV 头从同一份码重建键和值。模型转换从预训练权重和一小份校准激活开始,随后仅微调新增编码器与解码器,主干权重保持冻结。
证据分成三个层次:在 8,192 token 的 RULER 合成检索上,FSQ 在 12×–97.5× 的极端压缩区间领先所测基线;LongBench 的政府报告摘要支持这种优势能迁移到部分自然文档任务,但 narrativeqa 上 token eviction 仍更强;专门融合的 Triton 解码内核在 8B 模型的 32× 压缩时达到未压缩 SDPA 的 1.01 倍吞吐,在 97.5× 时达到 1.54 倍。千万级以上 token 的容量数字来自 8K 质量点外推,不是对百万 token 实际检索的测量。
结构地图
| 原文章节 | 内容 | PDF 页码与主要证据 |
|---|---|---|
| §1 Introduction | 本地显存瓶颈与极端压缩目标 | pp. 1–3,Fig. 1–2 |
| §2 Related work | eviction、标量量化、低秩潜变量、向量量化 | p. 3 |
| §3 Discrete latents for KV-cache compression | VQ 与 FSQ 的表示差异 | pp. 4–5,Eq. (1)–(3), Fig. 3 |
| §4 Transformer-FSQ | 共享潜码、转换、RoPE 与内核 | pp. 5–7,Eq. (4)–(9), Fig. 4 |
| §5 Experiments | 配置、检索与真实文档结果、吞吐 | pp. 8–11,Tables 1–2, Figs. 2, 5–6 |
| §6–8 | 局限、结论与声明 | pp. 12–13 |
| Appendices A–G | 复现细节、额外结果、消融和逐任务分数 | pp. 20–42,特别是 C–E、G |
一、动机与问题设定
KV cache 保存每层每个历史 token 的 key 和 value,随序列增长而占用内存。以 Qwen3-8B-Base 为例,半精度模型权重约 15.3 GiB;16 GiB 显卡中只剩约 0.74 GiB 给缓存和运行时,因此在不压缩时约可容纳 5.4k 个 token。论文估算 256× 压缩后可把缓存容量提高到约 1.39M token(§1, PDF p. 1, Fig. 1)。这是容量估算,不能直接视为模型已通过百万 token 质量评测。
作者将既有压缩方法分成四类:PyramidKV 通过 token eviction 减少保留位置;KIVI 减少每个数值的比特数;Palu 以低秩投影缩窄状态;TransMLA 缓存共享潜变量并额外保存旋转键;VecInfer 用离散向量码替代数值向量。前几类的公开精度结果大多停留在约 14× 以内。本文关注更高压缩率下的准确率—容量折衷,同时尽量避免显式码本、每 token 的量化尺度和复杂查表。
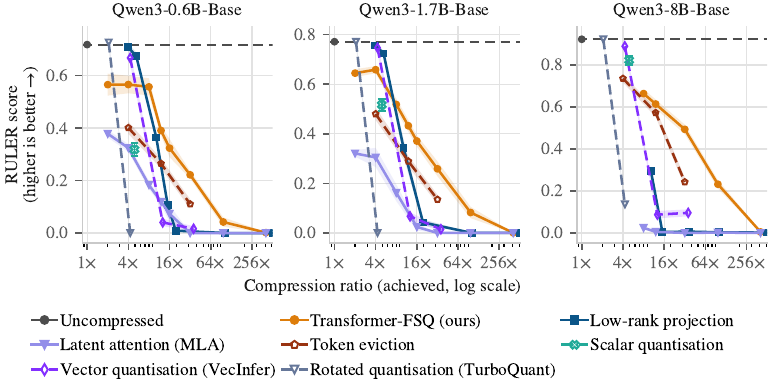
图 2 的横轴是实际缓存压缩率(对数刻度),纵轴是 RULER 分数(越高越好);三个面板分别是 Qwen3-0.6B、1.7B、8B。FSQ 曲线在约 12× 后仍保持较高分数,而低秩和 eviction 等基线更早下滑。原图:Fig. 2,PDF p. 2。
二、方法:把每 token 的 K/V 换成共享离散代码
2.1 先在残差状态上压缩
令 $x_t\in\mathbb{R}^{C}$ 为第 $t$ 个 token 在注意力前归一化后的残差状态。线性编码器 $E\in\mathbb{R}^{G\times C}$ 产生 $G$ 维潜变量;FSQ 把每一维限制并舍入到有限标量级别:
每维有 $L$ 个级别时需要 $b=\lceil\log_2 L\rceil$ bit,缓存占用为 $\lceil Gb/8\rceil$ byte/token/layer。主实验使用 $L=16$,即每维 4 bit;相同字节预算下,潜变量维数可以是 FP16 表示的 4 倍。这里的 $L^G$ 是所有坐标组合构成的隐式网格大小,不是模型要预测的类别词表。
FSQ 对标量 $u$ 先做有界变换,再舍入:
$\lfloor\cdot\rceil$ 表示就近舍入,$\operatorname{sg}$ 是 stop-gradient。$L=16$ 时 $h=7.5075$、中心偏移 $\delta=0.5$;前向传播使用真正的离散值,反向传播把舍入近似成恒等映射。因为训练每一步都经过同一个量化网格,编码器能适应推理时的离散误差。网格按坐标独立定义,不存储学习到的 codebook,也不需要最近邻搜索或每 token 缩放元数据(§3, PDF pp. 4–5, Eq. 2–4)。
2.2 共享代码如何参与注意力
解码器 $W_{kv}$ 分成 key 和 value 两部分:
其中 $N_k$ 是模型原有的 key normalization(若有)。同一代码 $z_t$ 服务所有 KV 头,而不是为每个头分别保存 K/V。对某个 query head 的注意力权重 $a_t^{(h)}$,值投影可以在线性层后移:
因此内核先对代码做注意力加权求和,再应用一次 $W_v$;不需要把每个历史值都还原出来。键的情况不同:RoPE 对每个位置 $t$ 使用不同旋转,所以键必须按位置重建后再与 query 点积。FSQ 因此用较少的缓存读流量,换取额外的 key 重建计算(§4.1、§4.3、§4.5,PDF pp. 5–7, Eq. 5–6)。
2.3 从预训练模型转换
转换先用 32,768 个 ClimbMix token 捕获各层的归一化残差激活。编码器行由中心化激活的主成分方向初始化:
量化后的潜变量记为 $Z=Q_{\mathrm{FSQ}}(XE^\top)$,解码器用带 $\lambda=1$ 的 ridge regression 重建残差,再与原始 K/V 投影组合:
当 $G>C$,初始化会循环重复 PCA 方向;相同方向开始时相同,部分坐标可能携带重复信息。这是 FSQ 在温和压缩率下参数开销偏大的原因之一。低缓存占用下,投影更窄,作者报告 FSQ 在 0.6B、1.7B、8B 模型上分别约 12×、8×、6× 之后,新增瓶颈参数才少于被替代的 K/V 参数(§4.2, PDF pp. 6–7, Eq. 7–8)。
转换后仅训练新增的编码器和解码器,主干冻结。主要结果使用 ClimbMix 上每个原模型参数对应 0.25 个训练 token;AdamW 学习率 $10^{-5}$,序列长度 1,024。质量评测使用完成该微调预算的模型(Appendix C.2–C.3, PDF pp. 22–23)。
三、实验设计
论文在 Qwen3-0.6B-Base、1.7B-Base、8B-Base 上比较 Transformer-FSQ 和五类代表方法:PyramidKV、KIVI、VecInfer、Palu、TransMLA;另将免训练 TurboQuant 作为 RULER 图中的参考。比较按实际 cache bytes 计费,包括量化尺度、全精度窗口、位置状态和辅助缓存;三种模型未压缩缓存基准均为 4,096 byte/token/layer(§4.4, §5.1, Table 1, PDF pp. 7–8)。
- RULER:13 个合成检索任务,每个 50 个样本,固定上下文 8,192 token;包括单键、多键、多值、多查询、变量跟踪与 QA。使用官方任务分数,微调方法评测最多 3 个种子;Qwen3-8B 只有 1 个种子。图中 95% bootstrap 区间先重采样种子,再按任务分层重采样样本。
- LongBench:自然文档上的 narrativeqa(F1)、gov_report(ROUGE-L)、trec(分类准确率),每个任务使用相同可评分文档。上下文最多 32,768 token,生成贪心解码;0.6B 和 1.7B 使用 3 个种子,8B 使用 1 个种子。8B 上所有方法共同完成的文档数分别是 gov_report 180、narrativeqa 70、trec 200。
- 吞吐:NVIDIA L40S,比较完整模型每步解码吞吐与同批量、同上下文的未压缩 native SDPA。覆盖 batch 1/4/16/64 与 2,048–150,000 token 的 8 个上下文点;报告跨配置中位数与 95% bootstrap 区间。KIVI、VecInfer、Palu 使用作者已发布的内核(Appendix D.5)。
四、结果:质量、吞吐与容量折衷
4.1 RULER:优势集中在极端压缩区间
在约 5× 以内,VecInfer、Palu 等方法通常能保留更高准确率;例如 VecInfer 在 4.3× 左右保留了三种模型未压缩 RULER 分数的 93%、97%、96%。到 12×–97.5×,Transformer-FSQ 在论文所测方法中得分最高。下表给出主要 RULER 均值(13 项任务的平均分,范围 0–1;原文 Table 9–11,PDF pp. 37–39):
| 模型 | 12× | 32× | 97.5× | 未压缩 |
|---|---|---|---|---|
| Qwen3-0.6B | 0.39 | 0.22 | 0.04 | 0.72 |
| Qwen3-1.7B | 0.43 | 0.26 | 0.08 | 0.77 |
| Qwen3-8B | 0.61 | 0.49 | 0.23 | 0.92 |
这些分数显示优势不等于无损:在 Qwen3-8B 上,32× 约保留未压缩 RULER 的 54%,97.5× 约保留 25%;更小模型在 97.5× 的宏平均分更低。逐任务表显示单键检索在更高压缩率下还能工作,多键干扰检索和变量跟踪更早退化。论文的核心结果是压缩—质量前沿延伸到了基线难以工作的区间,而不是每个检索任务都同等抗压。
4.2 LongBench:摘要受益,叙事问答仍偏向 eviction
在 Qwen3-8B 的 gov_report 摘要任务上,未压缩模型 ROUGE-L 为 16.9;FSQ 在 32× 得 12.5、97.5× 得 11.4,而 Palu 在约 102× 得 7.0(Fig. 5、Tables 12–14,PDF pp. 9、40–42)。这支持极端压缩下的质量优势能迁移到自然文档摘要。
不同任务有不同机制。在 Qwen3-8B narrativeqa 上,PyramidKV 在 26.6× 得 18.8 F1、197.8× 得 11.5;FSQ 在 32× 得 8.5、97.5× 得 6.5。token eviction 对该任务仍较强,说明均匀压缩每个 token 与按需删去部分 token 的优劣取决于任务。LongBench 的样本数也受方法是否能完成长文档 prefill 影响,8B 的比较只使用每项任务所有配置共同完成的文档。
4.3 融合解码:极端压缩时省下的读流量抵消重建开销
FSQ 内核在 GPU 上直接读 packed code、解包并用 tensor cores 重建键,在寄存器中完成 RoPE 与在线 softmax,同时累积注意力加权的 code;合并分块后才执行一次 $W_v$。重建的 K/V 不写回显存。每步解码仍需为每个位置重建 key,但大幅减少 HBM cache 流量(§4.5、Appendix D.4, PDF pp. 7、27–30)。
完整模型相对 native SDPA 的吞吐中位数如下(Fig. 6, PDF p. 11;扩展结果见 Appendix D.5):
| 模型 | 32× | 97.5× | 409.6× |
|---|---|---|---|
| Qwen3-0.6B | 1.38× | 2.00× | 1.98× |
| Qwen3-1.7B | 1.34× | 2.17× | 2.20× |
| Qwen3-8B | 1.01×(95% 区间 0.98–1.05) | 1.54×(1.16–1.88) | 1.63×(1.20–2.26) |
在 32× 时,key 重建计算大致抵消 cache 读取减少;越深压缩,带宽节省越明显。在至少 100,000 个 batch token 的 Qwen3-0.6B 配置中,最高报告为 5.86×。但在相同 cache 大小下,FSQ 只在 15% 的 0.6B/1.7B 配置快于 KIVI 已发布内核,因此论文结论是极端压缩下有优势,而不是对所有低比特缓存方法都更快。
4.4 与 token eviction 组合:容量数字来自外推
FSQ 缩小每个 token 的表示,PyramidKV 减少保留的 token,两者可叠加。Qwen3-0.6B 在 8,192 token 的 RULER 上,FSQ 8× 加共享头 PyramidKV 2× 达到总计 16×、分数 0.39;匹配字节数的 PyramidKV 为 0.30。FSQ 16× 加 PyramidKV 2× 达到总计 32×、分数 0.22,匹配预算的 PyramidKV 为 0.10(Table 6, PDF p. 29)。
在 16 GiB 显卡、RULER 阈值 0.30 下,作者据此估算叠加方案可容纳 3.8M token,约为共享头 PyramidKV 基线 2.23M 的 1.7 倍(95% 区间 1.0–2.3;Fig. 11, PDF p. 28)。这个 PyramidKV 是为匹配 FSQ 共享码结构而实现的共享头变体,不是其余实验中的原版逐头方法。容量曲线把 8K 的质量点换算为可容纳 token 数,受 prefill 峰值显存约束;它并未实测 3.8M token 的检索质量。
4.5 消融与联合压缩
在相同缓存预算 80 byte/token/layer 下,16-level FSQ 在训练中就经过舍入(STE)得到 RULER 0.177±0.017;先训练连续潜变量、推理时再量化到同一 FSQ 网格,得到 0.136±0.014(Table 7, PDF p. 34)。这支持让表示适应推理网格。16 个级别也优于同预算下的 4 级和 256 级:80 byte 时分数分别为 0.104、0.177、0.035;144 byte 时为 0.178、0.232、0.161(Table 8, PDF p. 35)。
在权重量化测试中,Qwen3-8B 的 4-bit NF4 未压缩模型分数为 0.913,接近 16-bit 的 0.922。先在 16-bit 主干微调 FSQ、再量化为 NF4,32× 缓存分数从 0.493 降至 0.382;若直接在冻结的 NF4 主干上微调 FSQ,分数恢复到 0.464,距离 16-bit 主干上的 FSQ 仅 0.029(§5.2 RQ5, PDF pp. 10–11)。
代码坐标在两百万个 held-out token 上使用了可用 4-bit 容量的 79%–83%。静态 Huffman 编码扣除块级开销后最多节省 12.9% cache bytes,但解码慢 16.6×–21.2×;作者因此保持定长打包。加最近 128 个 token 的全精度窗口,在按字节计入窗口后没有移动 RULER 的质量—压缩曲线(Appendix E.6、E.9, PDF pp. 34–35)。
五、结论、取舍与后续问题
Transformer-FSQ 的设计价值在于把“共享的预注意力状态”作为压缩对象,而不是独立压缩已经展开的 K 与 V。FSQ 网格无需码本表,窄缓存可降低显存流量;但 RoPE 使 key 解码无法像 value 一样整体后移,速度收益依赖压缩率、模型规模、批量与序列长度。参数开销在轻压缩区间也值得注意:例如 0.6B 在 2× 时瓶颈参数约比原 K/V 投影多 294M,约为模型大小的 49%。
结果覆盖三种 Qwen3 尺寸、RULER 8K 检索和 LongBench 三项任务(最长约 32K),并未评测压缩下的代码生成、算术推理或 many-shot in-context learning。FSQ 的主要设置采用 16 个级别;低压缩时更少坐标、更细级别的配置尚未系统探索。8B 的长上下文评测只有一个训练种子。因而“极端 KV 压缩实用”在本文证据中具体指:所测检索/摘要任务的质量点与 L40S 解码吞吐,而不代表所有长上下文能力都保留。
作者提出的后续方向包括按层分配潜变量宽度与级别数、从未压缩模型蒸馏各层状态、用 LoRA 辅助适配,以及评估更长上下文中的推理和代码任务。动态压缩也可能在序列变长时逐步降低级别,但粗化后的代码无法还原丢掉的细节,如何在不重新计算激活的情况下细化缓存仍未解决。
作者声明使用生成式 AI 协助设计 FSQ 与 PyramidKV 叠加实验、实现融合解码内核,以及构建评测/绘图工具;他们说明已复核辅助产物,并称相关代码有自动化测试(§8, PDF p. 13)。不过本次查证时论文链接的 GitHub 仓库仍为空,因此公开代码的可用性尚未兑现。