Muir:线性注意力中的敏感度分配门控与匹配滤波读出
- 作者:Tushaar Gangavarapu、Gil Tabak、Clemens JS Schaefer
- 原文版本:arXiv:2611.08376v1,2026-11-08 获取;本地 PDF
- 发表:截至 2026-11-08 未查到正式会议或期刊发表记录;Google Research 条目将其列为 arXiv (2026)(官方记录)。
- 代码:未查到独立公开代码仓库;作者在论文附录 J 提供了 JAX 版 token mixer 与分块核参考实现(原文,PDF pp. 62–65)。
论文总览
Muir 研究的是一个看似矛盾的问题:线性注意力把任意长的历史压入固定大小的矩阵状态,因此推理状态不随上下文增长;但有限状态容量会让不同键相互干扰,模型需要在“忘得快以抑制干扰”和“记得久以保留旧信息”之间取舍。作者以 Gated DeltaNet-2(GDN-2)为基线,指出它的门控参数分配、状态读出和 TPU 分块训练各有一个瓶颈。
论文的论证主线是:
- 写入门比擦除门更值得分配容量。 单步状态对写门的敏感度不依赖当前键的稀疏度;擦除门的作用则同时乘上键坐标平方和已有状态行能量。经过 SiLU 和单位范数化的键只把大部分能量放在少数通道,因此擦除门可用更低秩投影。
- 不同衰减速度造成状态行能量失衡。 慢衰减行累积历史写入,快速衰减行主要保留近期信息。无权读出时,高能量行会压过低能量行;单靠增加写时擦除来压噪声,又会更快抹掉远处的绑定。
- 读出时按通道重加权可以分担擦除。 静态读出增益适合单一检索时距;动态增益可以随查询变化,在不同检索时距间切换。读出抑制干扰后,写时擦除可以降低,状态有效记忆跨度随之增加。
- 低秩门控节省的参数用于加宽 FFN。 主模型在每层参数预算不变时,将 FFN 宽度从 GDN-2 的 5,888 增至 7,680(在 $d=2{,}048$ 时增加 30.4%),同时容纳一个查询读出门。
- 边界枢轴分块核让大块 TPU 计算既稳定又并行。 它避免对衰减前缀做除法,避免物化完整的三维衰减张量,并把三角求解改成分治式块矩阵运算。
论文覆盖 166M–1.34B 参数的模型,并报告语言建模、常识题、合成和真实检索、长度外推、吞吐以及机制探针。强项是理论解释、机制诊断与架构和硬件实现之间的对应;主要取舍是静态读出与动态读出并非同一配置的最优选择:前者更适合单一远距查询,后者更适合多跳查询和连续长流。
结构地图
| 原文章节 | 内容 | PDF 页码与定位 |
|---|---|---|
| 1. Introduction | 线性状态容量、GDN-2 的参数和读出问题、TPU 分块瓶颈 | pp. 1–3,Fig. 1 p. 2 |
| 2. Preliminaries | 通道门控 Delta Rule、Chunkwise Parallel Form、TPU 硬件背景 | pp. 3–5 |
| 3. Channel-Wise Gated Delta Memory Dynamics | 写/擦敏感度、稳态行能量、匹配滤波、合成实验 | pp. 5–9,Fig. 2 p. 9 |
| 4. Muir | 五门融合低秩投影、读出增益、Boundary-Pivoted Chunkwise Kernel | pp. 10–14,Fig. 3 p. 10、Fig. 4 p. 13 |
| 5. Experiments | 预训练配置、语言建模、检索、长度外推、吞吐、数值稳定、消融 | pp. 14–21,Figs. 5–9 pp. 16–20,Table 2 p. 21 |
| 6. Mechanistic Analysis | 门敏感度、行能量、读出增益、擦除干预、多跳诊断 | pp. 21–24,Fig. 10 p. 22、Figs. 11–12 p. 23、Fig. 13 p. 24 |
| 7. Conclusion | 总结、静态/动态增益取舍与实现限制 | pp. 24–25 |
| Appendices | 证明、合成任务、核分析、配置、完整结果和参考实现 | proofs pp. 40–43;Tables 6–23 pp. 44–61;JAX 参考实现 pp. 62–65 |
一:动机
固定状态带来吞吐,也带来干扰
对每个注意力头,线性注意力用 $S_t\in\mathbb{R}^{d_k\times d_v}$ 汇总过去的键值关联。它避免 Transformer 随序列长度增长的 KV cache,但不同 token 必须共享有限数量的键方向。键重叠时,读出一个值也会带出其他写入,Delta Rule 因此在新写入前先减去当前键方向上的旧预测。
GDN-2 将这套更新细化为逐通道衰减、擦除和写入门。它为衰减 $f$ 与输出 $g$ 使用秩 128 投影,却为擦除 $b$ 和写入 $w$ 使用完整的 $d\times d$ 投影。与 Transformer 的每层 $12d^2$ 非嵌入参数预算对齐时,门控挤压了 FFN:在 $d=2{,}048$ 时,GDN-2 的 FFN 宽度是 5,888,而 Transformer 是 8,192。
作者提出三个相互关联的缺口:
- 门控容量没有按状态敏感度分配。 擦除和写入都用 dense 投影,尽管擦除仅沿当前键激活的方向影响状态。
- 读出与状态行的噪声规模不匹配。 通道衰减使慢行能量远大于快行;无权查询会让慢行主导输出。若只靠更强擦除来抑制这类干扰,就会缩短所有通道的有效记忆。
- 通道衰减使大块并行训练数值困难。 传统分解需要除以极小的累计衰减,或者构造 $C\times C\times d_k$ 张量、顺序求解三角系统;这些操作在 TPU 的慢速向量单元上成为瓶颈。
二:方法
2.1 GDN-2 状态更新与 Muir 读出
每头的键、查询经 SiLU 后作 $\ell_2$ 归一化,值保持未归一化。令 $\hat S_t=\operatorname{Diag}(\alpha_t)S_{t-1}$、$\hat k_t=b_t\odot k_t$、$\hat v_t=w_t\odot v_t$,GDN-2 的更新为
这里 $k_t,q_t\in\mathbb{R}^{1\times d_k}$,$v_t\in\mathbb{R}^{1\times d_v}$;$\alpha_t\in(0,1)^{d_k}$ 控制每个状态行的保留率,$b_t\in(0,2)^{d_k}$ 控制沿当前键的擦除,$w_t\in(0,1)^{d_v}$ 控制每个值通道写入量。输出门 $g_t$ 在每头 RMSNorm 后逐通道调制。
Muir 保留同一递归,但读出时增加查询增益:
$\gamma^{\mathrm{stat}}$ 是可学习的静态通道轮廓,$2\sigma(z_t^q)\in(0,2)$ 是依赖当前 token 的动态调制;初始化时两者的乘积为 1。它只缩放查询,不缩放写状态用的键,因此不破坏 $k_t$ 的单位范数。
2.2 理论分析:写入敏感度、行能量与匹配滤波
写门和擦除门进入状态更新的方式不对称。 对任意扰动 $\delta b,\delta w$,命题 3.1 给出
在各维独立、单位方差的各向同性扰动下,
因此写门每一步都能改变输入值;擦除门只有在“该行已有能量”且“当前键使用了该行”时才明显影响状态。训练检查点中键的有效参与通道数仅约 6/128(Muir 为 5.98,GDN-2 为 7.43),测得写门对状态的敏感度约为擦除门的 13.3 倍(166M,Table 3 / Fig. 10,PDF pp. 22–23)。作者还把擦除键 $b\odot k$ 分解为沿 $k$ 的分量和正交残差 $s$;该残差形成非正规擦除变换,增大转移矩阵谱范数。低秩擦除投影可减少这种无效的斜向变化,同时通道偏置仍能保留不同的基础擦除率(Sec. 3.1、Appendix D.1,PDF pp. 5–6、40–41)。
稳态行能量由注入强度和有效时间常数共同决定。 在作者设定的平稳 i.i.d. 输入流中,记 $c_j=\mathbb{E}[k_{t,j}^2]$、$\lambda_j=\mathbb{E}[\alpha_{t,j}^2]$、$\bar b_j=\mathbb{E}[b_{t,j}]$、$\sigma_v^2=\mathbb{E}\|\hat v_t\|_2^2$。在行近似不相关及二阶矩闭合后,稳态行能量近似为
快衰减由 $1-\lambda_j$ 主导;慢衰减时,状态行会积累更多值写入,除非通过擦除额外缩短其时间常数。该公式中的 key 四阶矩先有精确递推,之后再用 $\mathbb{E}[k_i^2k_j^2]\approx c_ic_j$ 和 $\mathbb{E}[b_j^2]\approx\bar b_j^2$ 做闭合;所以它是有明确假设的近似定律,不是对任意数据流的恒等式(Proposition 3.4、Appendix D.2,PDF pp. 6、41–42)。
匹配滤波在查询时权衡目标信号与干扰。 若要在时距 $\ell$ 后取回曾写入的 $v_{t-\ell}$,每个通道的目标信号存活率记作 $\bar a_{\ell,j}$,干扰行方差为 $m_j^\ast$。在目标信号与跨写入干扰满足文中独立/不相关条件时,期望 MSE 为
最优读出方向因此满足 $\gamma_j^\ast(\ell)\propto \bar a_{\ell,j}/m_j^\ast$:只按行范数归一化会过度放大目标信号已消失的快行;最优权重同时看“剩余目标信号”和“行噪声”。但 $\bar a_{\ell,j}$ 随时距改变,不同 $\ell$ 的最优向量一般不共线,一个静态增益不能对所有查询距离都最优(Proposition 3.6、Remark 3.7,PDF pp. 7–8)。
对均值为 $H$ 的几何检索时距分布,作者得到静态滤波器
这会产生介于不加权和全白化之间的分数幂关系 $\gamma_j\propto \rho_j^{-p}$。在训练模型中拟合到的中位指数为 $p=0.35$。理论上,读出滤波减少高能行的干扰后,可以降低写时擦除率,使各通道的 $\tau_{\mathrm{eff},j}$ 增大;这是“读出替代部分擦除”的机制(Corollary 3.8、Proposition 3.10,PDF pp. 8、42–43)。
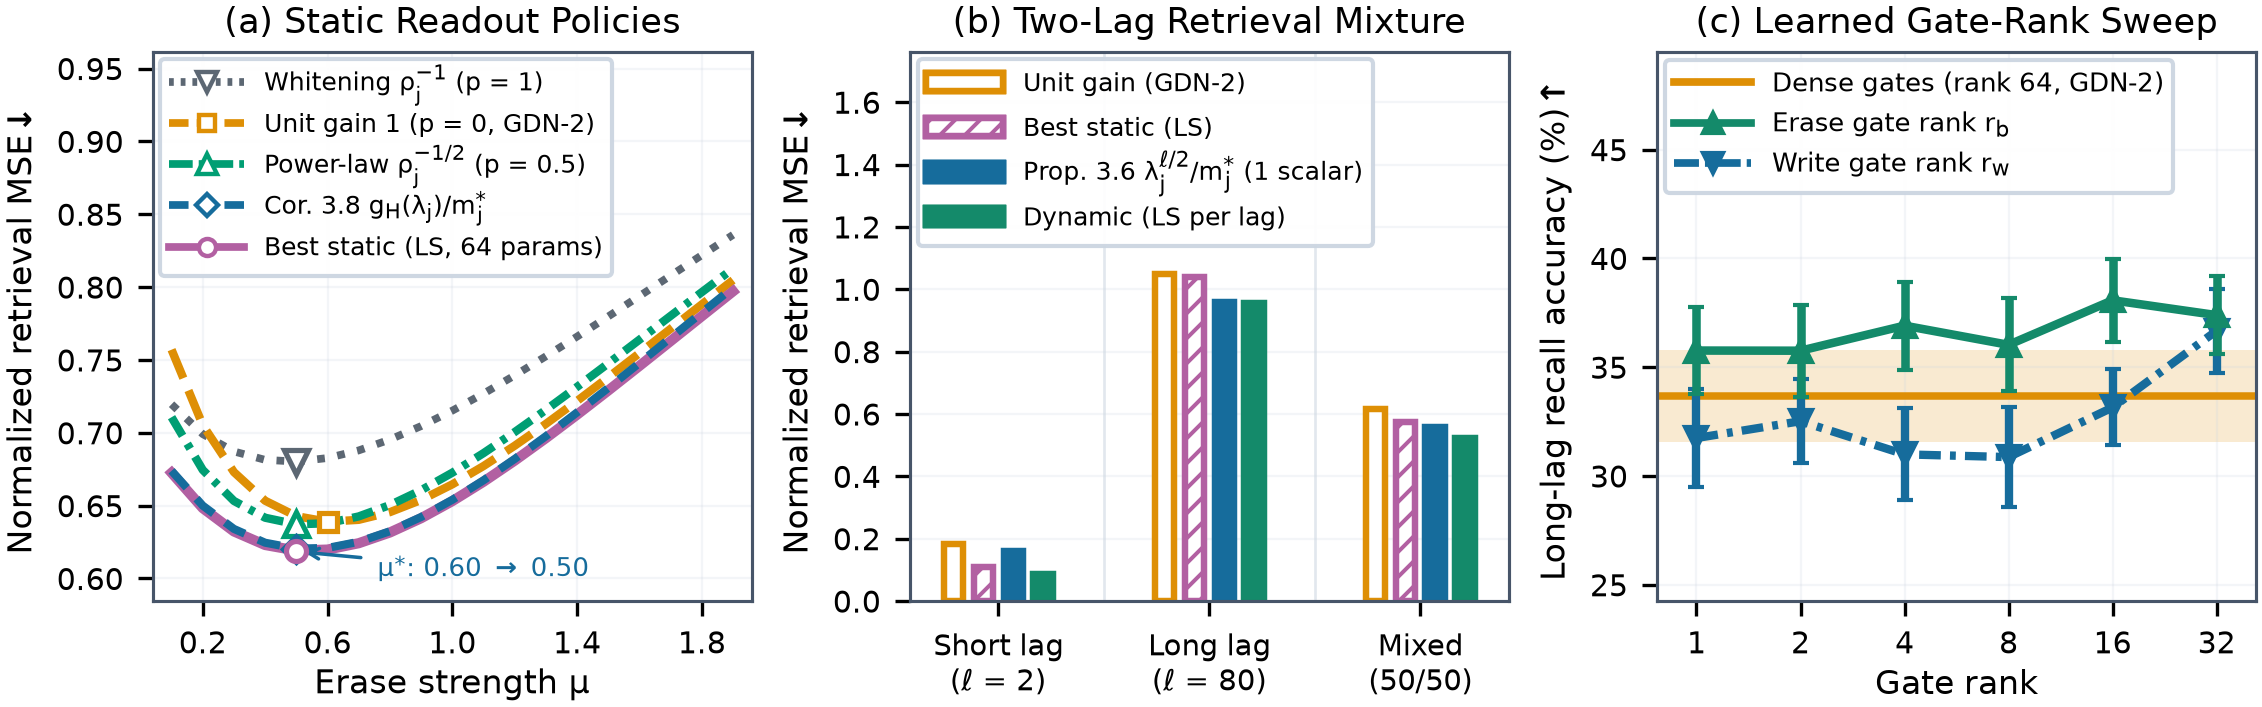
图 2 的三个面板依次比较静态增益与擦除强度、短/长时距混合任务,以及学习任务中的门秩。单头合成任务有 64 个键通道;在 $H=27$ 时,完全逆 RMS 白化比单位增益更差,而半幂和理论滤波降低 MSE,并将最优擦除 $\mu^\ast$ 从 0.60 降到 0.50。拟合滤波与静态最小二乘 oracle 基本重合。在另一项 20-seed 的端到端两头任务中,低秩擦除门在所测秩上改善长时距召回;写门降到秩 8 以下则损害表现,秩 16 接近 dense,秩 32 超过 dense。图和参数见 Sec. 3.2 / Fig. 2,PDF pp. 8–9;完整数值见 Appendix E / Tables 6–7,pp. 44–45。
2.3 五门融合投影与参数再分配
Muir 将衰减 $f$、擦除 $b$、输出 $g$、写入 $w$、查询增益 $q$ 五路门控合并为一个共享降维投影,再用各自的上投影和通道偏置产生 logits:
主模型的秩分配是 $(r_f,r_b,r_g,r_w,r_q)=(64,64,128,128,128)$。低敏感度的衰减和擦除门用秩 64;直接调节输出、写入和值读出的三路门用秩 128。总秩 512 刚好填满两个 $256$ 列 MXU tile,且分组方式也对齐 TPU 的 128-lane VMEM tile,减少窄矩阵乘法的填零浪费。消融不使用动态 $q$ 门时,将这 128 秩转给写门,$r_w=256$,保持总秩不变。
在每层 $12d^2$ 参数预算下,Muir 的门控投影参数量为 $2dR_{\mathrm{tot}}$,并设 $d_{\mathrm{ffn}}=4d-R_{\mathrm{tot}}$。在 $d=2{,}048$ 时,GDN-2 的门投影为 9.44M 参数,Muir 为 2.10M;节省的 7.34M/层把 FFN 从 5,888 扩至 7,680(+30.4%),保持总参数相同。若固定原 FFN 宽度,门控压缩可让整层非嵌入参数与线性 FLOPs 下降 14.6%。(Sec. 4.1 / Fig. 3,PDF pp. 10–11;配置见 Appendix G / Table 11,p. 49。)
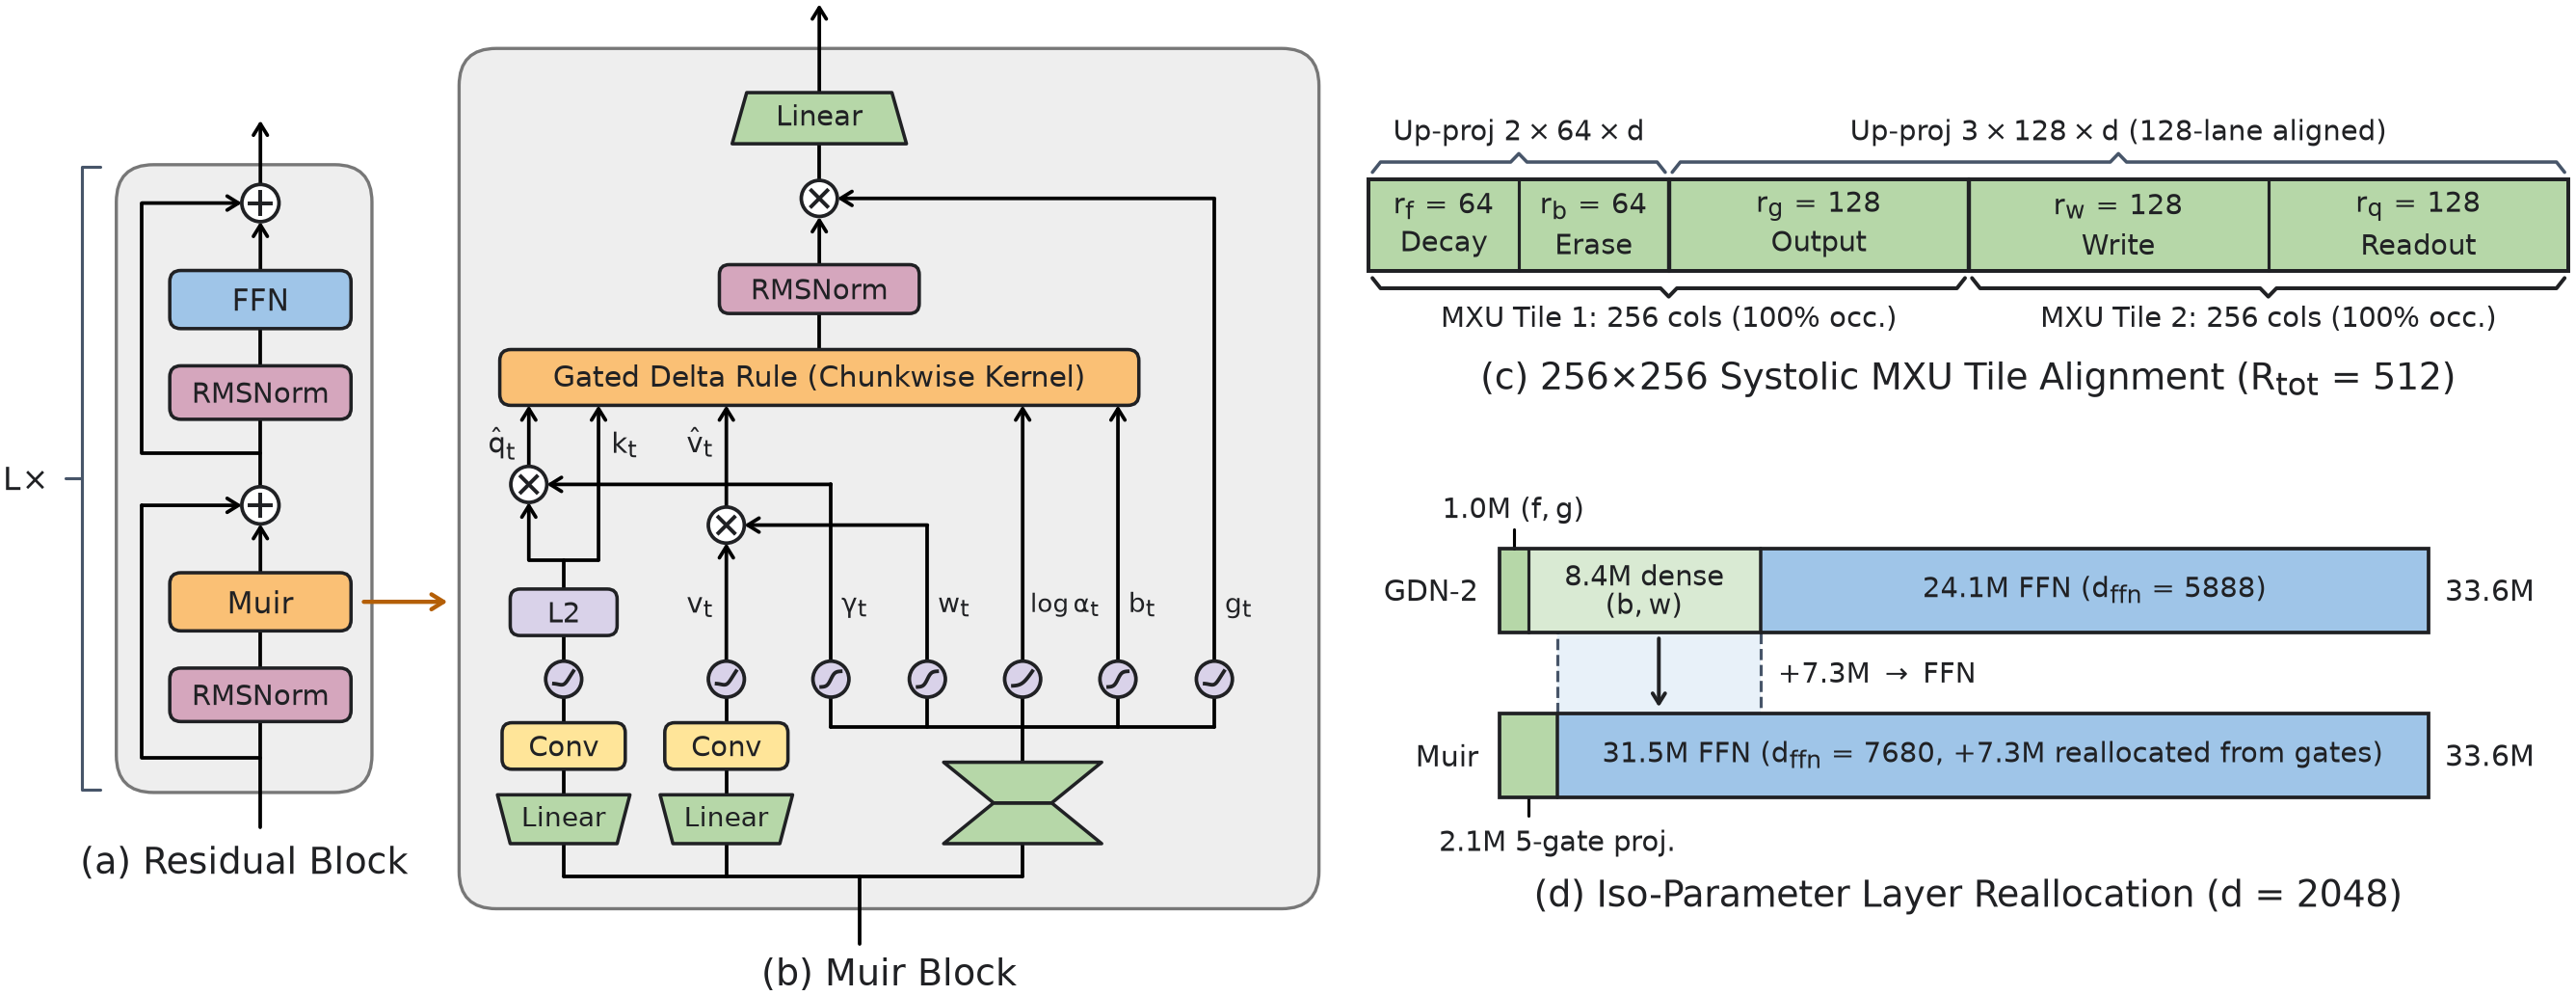
左侧是残差块与 Muir token mixer;右上是按硬件 tile 对齐的秩分配;右下显示等参数条件下将门投影节省量投入 FFN。作者报告的是模型设计和参数/FLOP 预算,不是单独证明 FFN 加宽能解释所有检索提升。
2.4 Boundary-Pivoted Chunkwise Kernel
训练时,逐 token 更新状态的算术强度低。把长度为 $T$ 的序列拆成 $C=256$ token 的块,可以把块内运算改成矩阵乘法。定义相对衰减 $\pi_{t,s}=\exp(\Lambda_t-\Lambda_s)$,则块内 Delta Rule 化为求解单位下三角系统 $TZ=[\hat V,\hat K_{\odot\pi}]$,其中 $T=I+L_{\mathrm{strict}}$;求得 $U,Y$ 后即可用矩阵乘法算块输出和下一块状态。
直接实现有两个问题:用 $\pi_t/\pi_s$ 拆解会在快衰减通道上令分母下溢、倒数溢出;逐对计算虽稳定,却需要 $C\times C\times d_k$ 张量并由向量单元处理;顺序前代也受慢向量单元限制。
Muir 对三角矩阵做分治块逆。每个长度为 8 的叶块直接从非正的 log-decay 差计算衰减,并用有限 Neumann 级数求逆;之后反复合并相邻块。对跨左右子块的键对,选左块末端为枢轴 $p$,将相对衰减拆成
两个 log 差都非正,因而两项指数始终在 $(0,1]$,不用除法。完整块逆与读出矩阵通过五层分治合并构造;自定义反向传播只保存整块逆和解,反向再计算边界衰减,避免保存整棵树的中间值。
TPU7x 的 MXU 是 $256\times256$,VPU 吞吐约低 64 倍;把 $V$ 和 $K_{\odot\pi}$ 合并成 $256\times256$ 右端矩阵,使求解完整利用 MXU。作者报告在 $C=256,d_k=d_v=128$ 时,每 token、每头的块核计算中 98% FLOPs 落在 MXU,VPU 计算减少 24 倍,块核总 FLOPs 减少 12%;跨块状态扫描保存在 VMEM 中。相对 float64 顺序参考,bf16 前向输出和终态相对误差约为 $7.62\times10^{-3}$ 与 $6.72\times10^{-3}$;fp32 则约 $10^{-6}$。在训练检查点采样的 1,536 个三角系统中,条件数最大值低于 40,bf16 分块逆处于作者实测的稳定区间;合成对抗条件数约 12,865 时,bf16 求解误差会上升到 5.23,说明数值结论依赖实际系统保持适度条件数(Sec. 4.2、5.2.4 / Figs. 4、9,PDF pp. 11–14、20;Appendix F / Tables 8–10,pp. 46–48)。
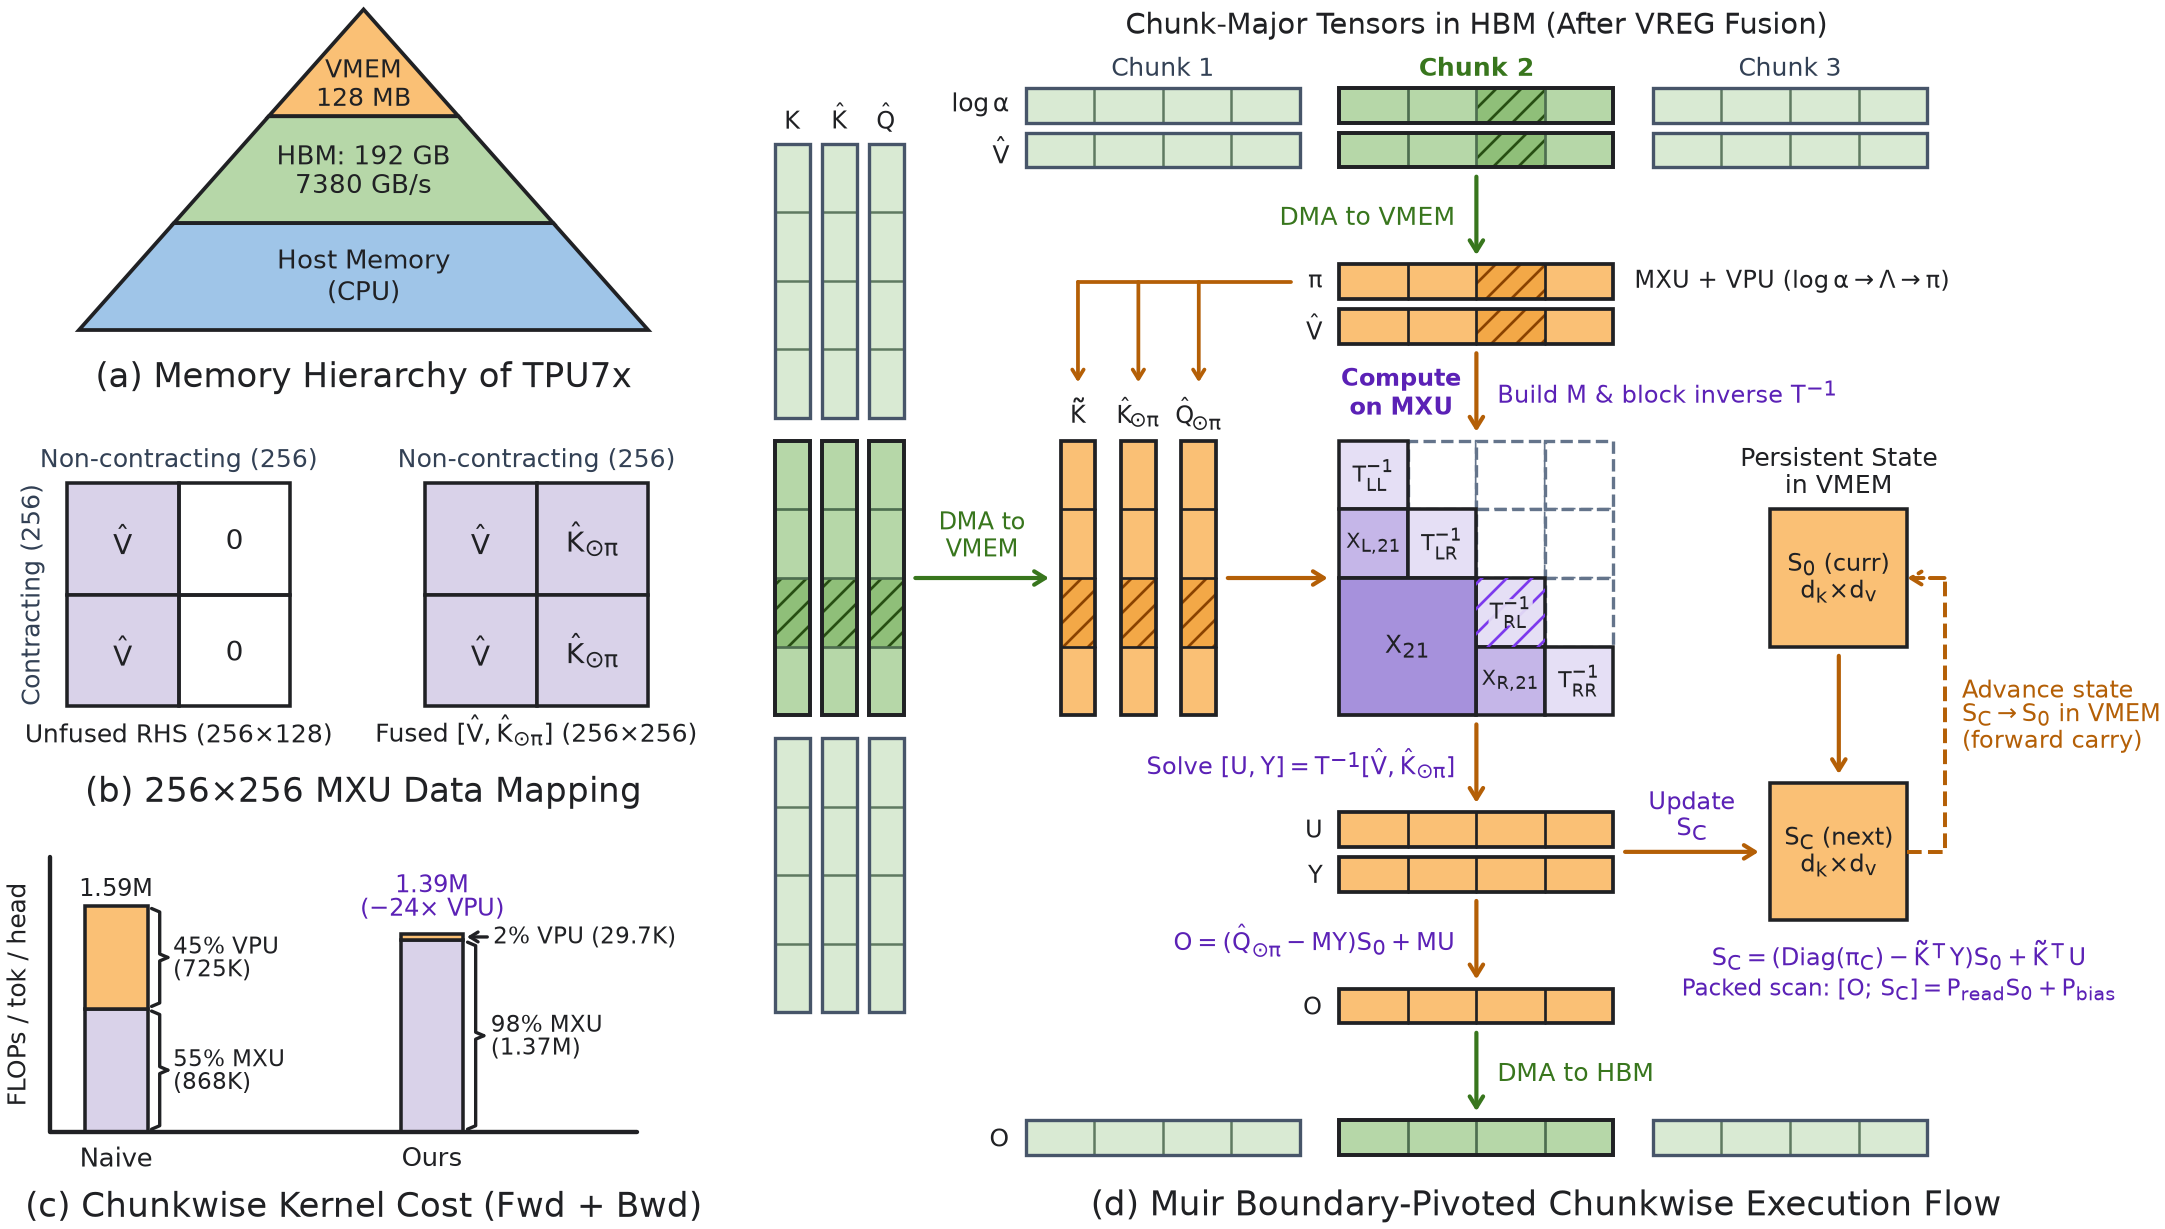
图中左侧比较朴素核与 Muir 的 MXU/VPU 计算量;右侧展示将 log-decay、边界缩放、分块逆和状态扫描安排到不同内存/计算层级的执行过程。
三:实验设置
- 模型规模:166M、406M、834M、1.34B,四类架构在每个规模下对齐深度、残差宽度、头维度 $d_k=d_v=128$、每层 $12d^2$ 非嵌入参数预算、未绑定词嵌入及状态总大小。
- 训练:FineWeb-Edu 上从头训练 100B token;32K Llama-2 SentencePiece tokenizer;序列长度 4,096、每步 524,288 token、8 张 TPU7x;bf16 混合精度,状态和累计 log-decay 使用 fp32。AdamW,学习率峰值 $4\times10^{-4}$,前 1B token warmup,之后余弦衰减。所有预训练用固定随机种子 0 和相同数据顺序。
- 基线:RoPE Transformer + TPU Pallas Splash Attention;GDN-2;Muir 的无读出增益、静态增益、完整动态增益三种配置。完整 Muir 的总门控秩 512,FFN 宽度 7,680。
- 评测:FineWeb-Edu 验证 token NLL、WikiText 和 LAMBADA 词级 PPL、8 项零样本常识准确率、WinoGrande/TriviaQA 五样本评测;RULER 六项检索任务;Based/JRT 六项真实文档抽取任务;4K 训练长度向 128K 文档和 10M 连续流外推;1K–1M passkey;TPU 吞吐和核精度。
这些训练比较使用单一固定 seed,论文未报告不同预训练 seed 间的方差。合成任务另有 20 个 seed;不能把合成任务的不确定度误当作语言模型预训练的多次独立重复。
四:结果
4.1 语言建模与常识任务
下表是完整动态读出 Muir 在 100B token 结束时的 FineWeb-Edu 验证 token NLL。NLL 越低越好;括号内是相对 GDN-2 和 Transformer 的绝对下降,单位为 millinats(mnat)。
| 参数量 | Transformer | GDN-2 | Muir | Muir 相对 GDN-2 / Transformer |
|---|---|---|---|---|
| 166M | 2.4569 | 2.4466 | 2.4276 | −19.0 / −29.3 mnat |
| 406M | 2.2424 | 2.2354 | 2.2174 | −18.0 / −25.0 mnat |
| 834M | 2.1186 | 2.1060 | 2.0862 | −19.8 / −32.4 mnat |
| 1.34B | 2.0335 | 2.0177 | 1.9973 | −20.4 / −36.2 mnat |
所有 Muir 变体在四个规模上都降低验证 NLL 和 WikiText PPL;Muir 在约 85B token 达到 GDN-2 的 100B-token 验证损失,作者据此报告约 1.2 倍更快达到该损失。1.34B 时,Muir 的八项零样本常识平均为 53.84%,GDN-2 为 52.46%,Transformer 为 52.05%;5-shot TriviaQA 为 19.32%,高于 GDN-2 的 16.48%。但 Based/JRT 的六任务 2K-cut 平均是 Muir 34.60%、GDN-2 32.08%、Transformer 45.92%:Muir 改善了循环基线,仍低于 Transformer 的总平均。来源:Sec. 5.2.1、Table 1,PDF pp. 15–16;Based 的完整表为 Appendix H / Table 14,p. 53。
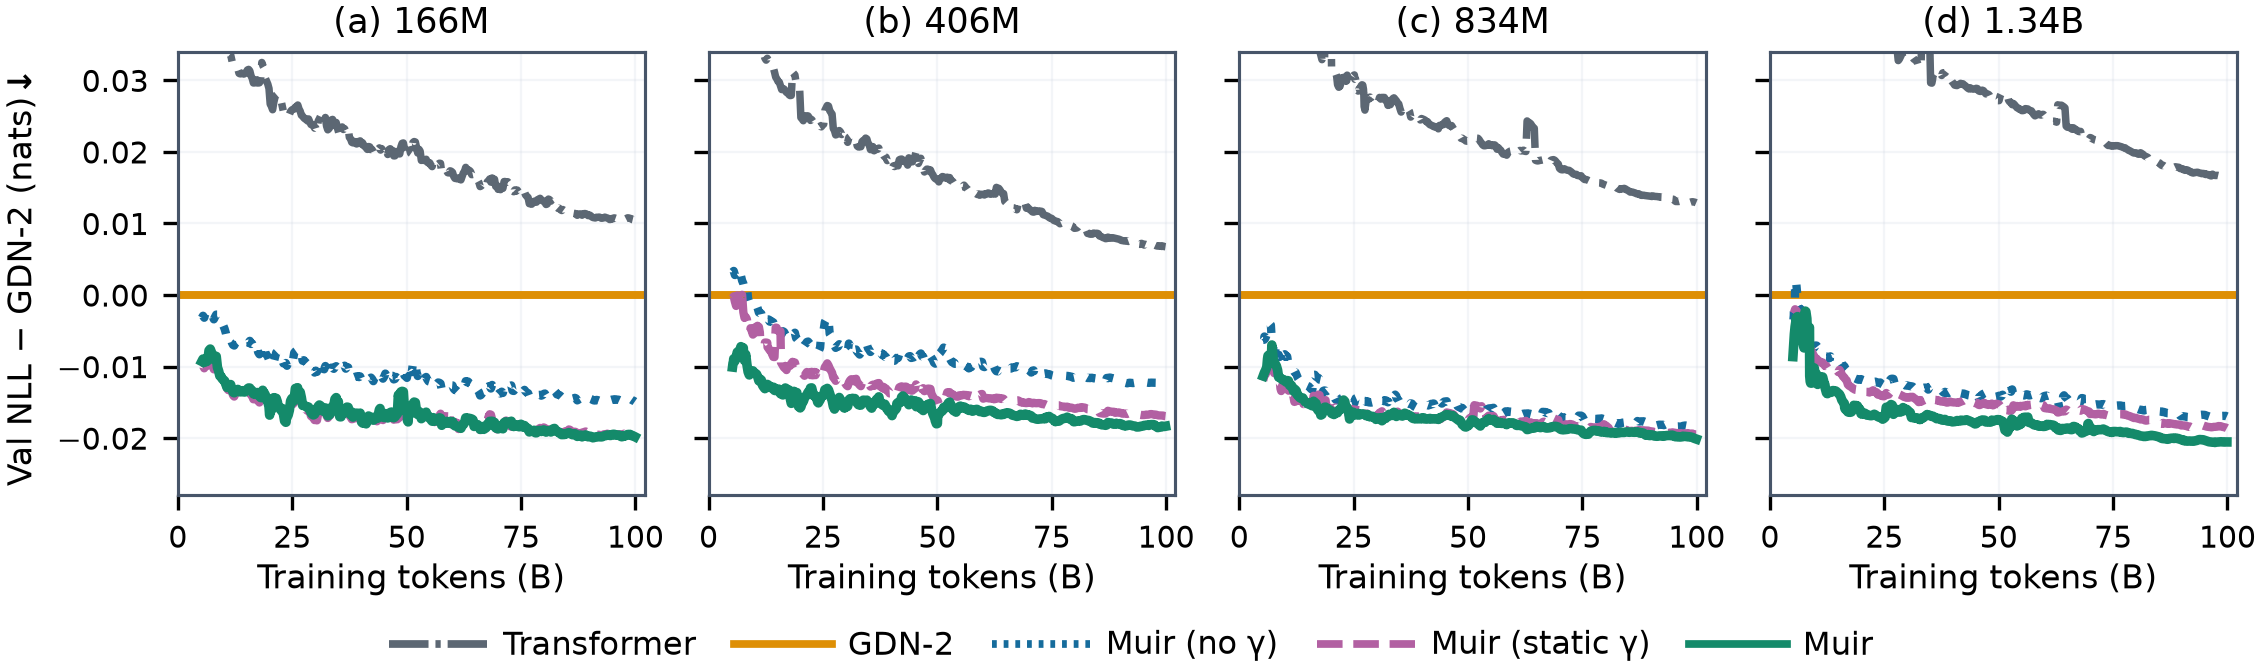
曲线展示相对 GDN-2 的验证 NLL 差。Muir 家族在训练早期就开始领先;完整 Muir 在 1.34B 规模上最后约低 20.4 mnat。
4.2 合成与真实检索
在 1.34B RULER 测试中,完整 Muir 的六任务平均准确率在 1K–4K 为 73.0%,GDN-2 为 61.8%,Transformer 为 70.9%;扩展到 1K–8K 时分别为 67.2%、55.3%、58.0%。分项结果体现动态增益对多距离检索的价值:
| RULER 任务(平均准确率) | Transformer | GDN-2 | Muir(动态) |
|---|---|---|---|
| 5-hop Variable Tracking | 8.8% | 21.5% | 34.3% |
| 4-value MV-NIAH | 58.0% | 53.8% | 68.9% |
| 4-query MQ-NIAH | 64.0% | 47.6% | 69.1% |
在单次 needle 查询上,静态增益反而更合适:它保留完整写门秩 $r_w=256$,完整动态版则把一半写门秩分给查询增益 $r_q=128$。静态读出在 1M passkey 上的零样本准确率为 90.0%,64K 纯文本 cooldown 后为 99.4%;动态读出主要在多跳/多答案任务上占优。不同配置和评测长度不能混为同一个模型结果。RULER 的完整结果在 Appendix H / Tables 13、17,PDF pp. 52、56;Fig. 6 p. 17、Fig. 8 p. 19。
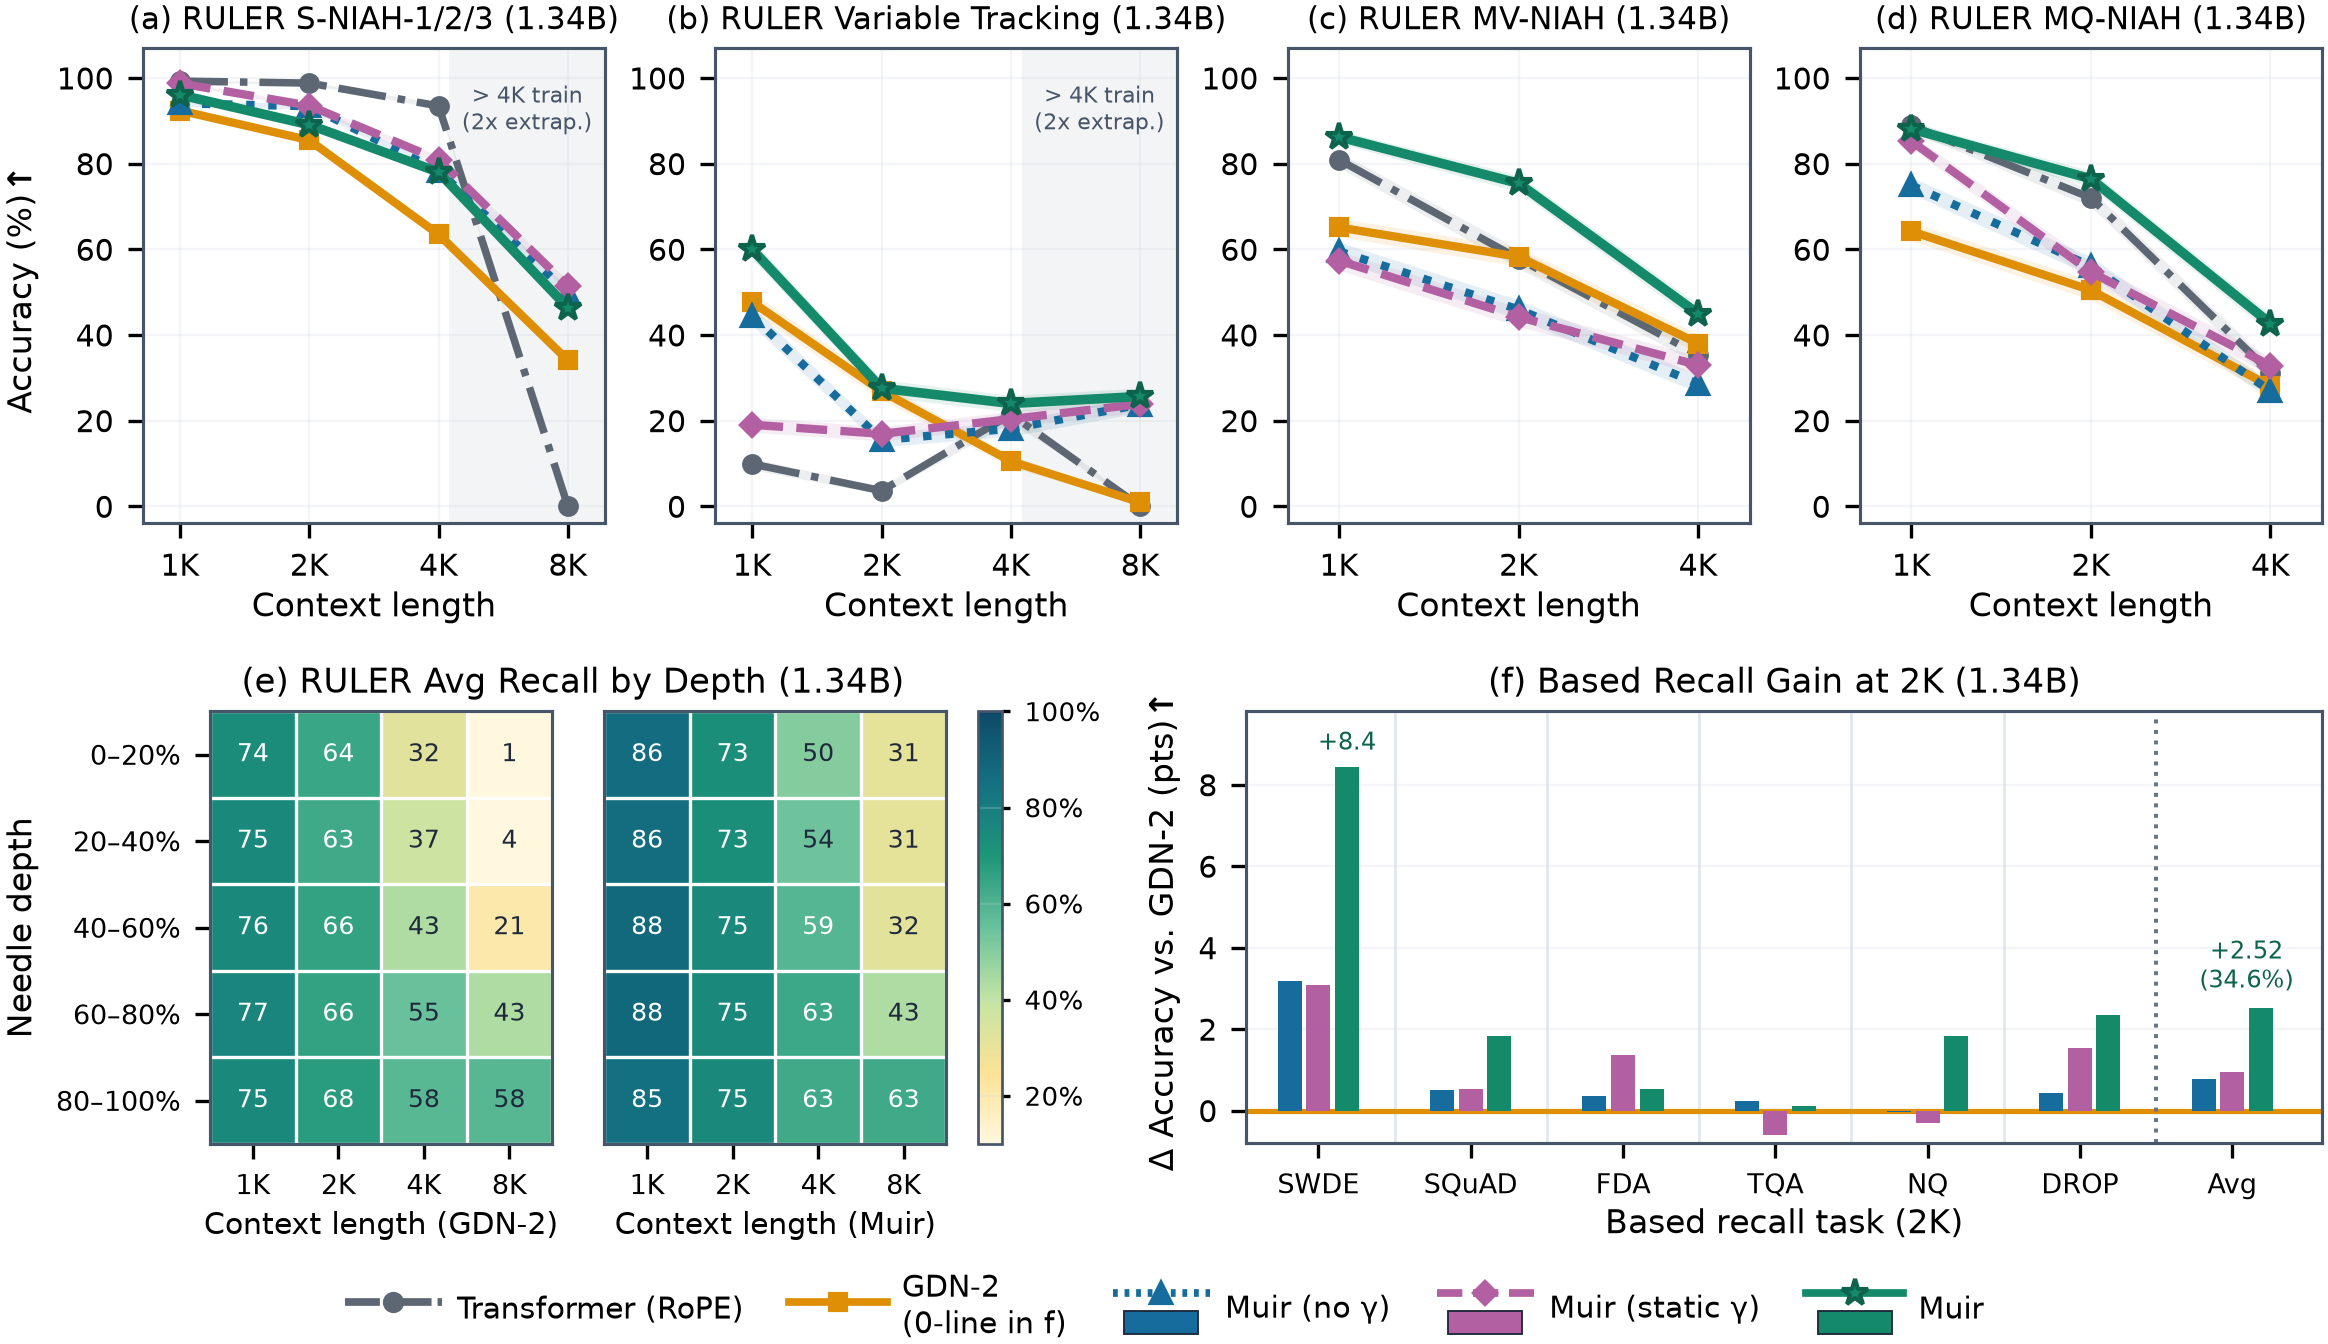
上排显示单针、五跳、四值和四查询表现;左下按针所在深度展示准确率;右下比较 2K Based/JRT 各任务相对 GDN-2 的变化。动态 Muir 的 Based 六任务平均提升 2.52 个百分点,其中作者估计动态读出带来约 69% 的提升。
4.3 长度外推与吞吐
1.34B Muir 从 4K 训练长度零样本外推到 10M 连续 token 流(2,560 倍训练长度),验证 PPL 从 4K 时的 8.41 降至并稳定在 10M 时的 8.11;GDN-2 在 10M 时为 8.31。完整模型的 24 层 fp32 状态总计 25MB。动态读出在持续累积的长文本上避免静态增益的漂移:128K 文档的 tail NLL 漂移为 +0.0047 nats,静态读出为 +0.0171。经过 0.315B token、64K 长度的纯文本 cooldown 后,完整 Muir 的 10M PPL 为 7.95。相反,单针 passkey 的静态增益在 1M 最好。这再次说明增益机制取决于查询时距分布,而不是“动态必然全面优于静态”。来源:Sec. 5.2.3 / Fig. 7,PDF p. 18;Appendix H / Tables 16–17,pp. 55–56。
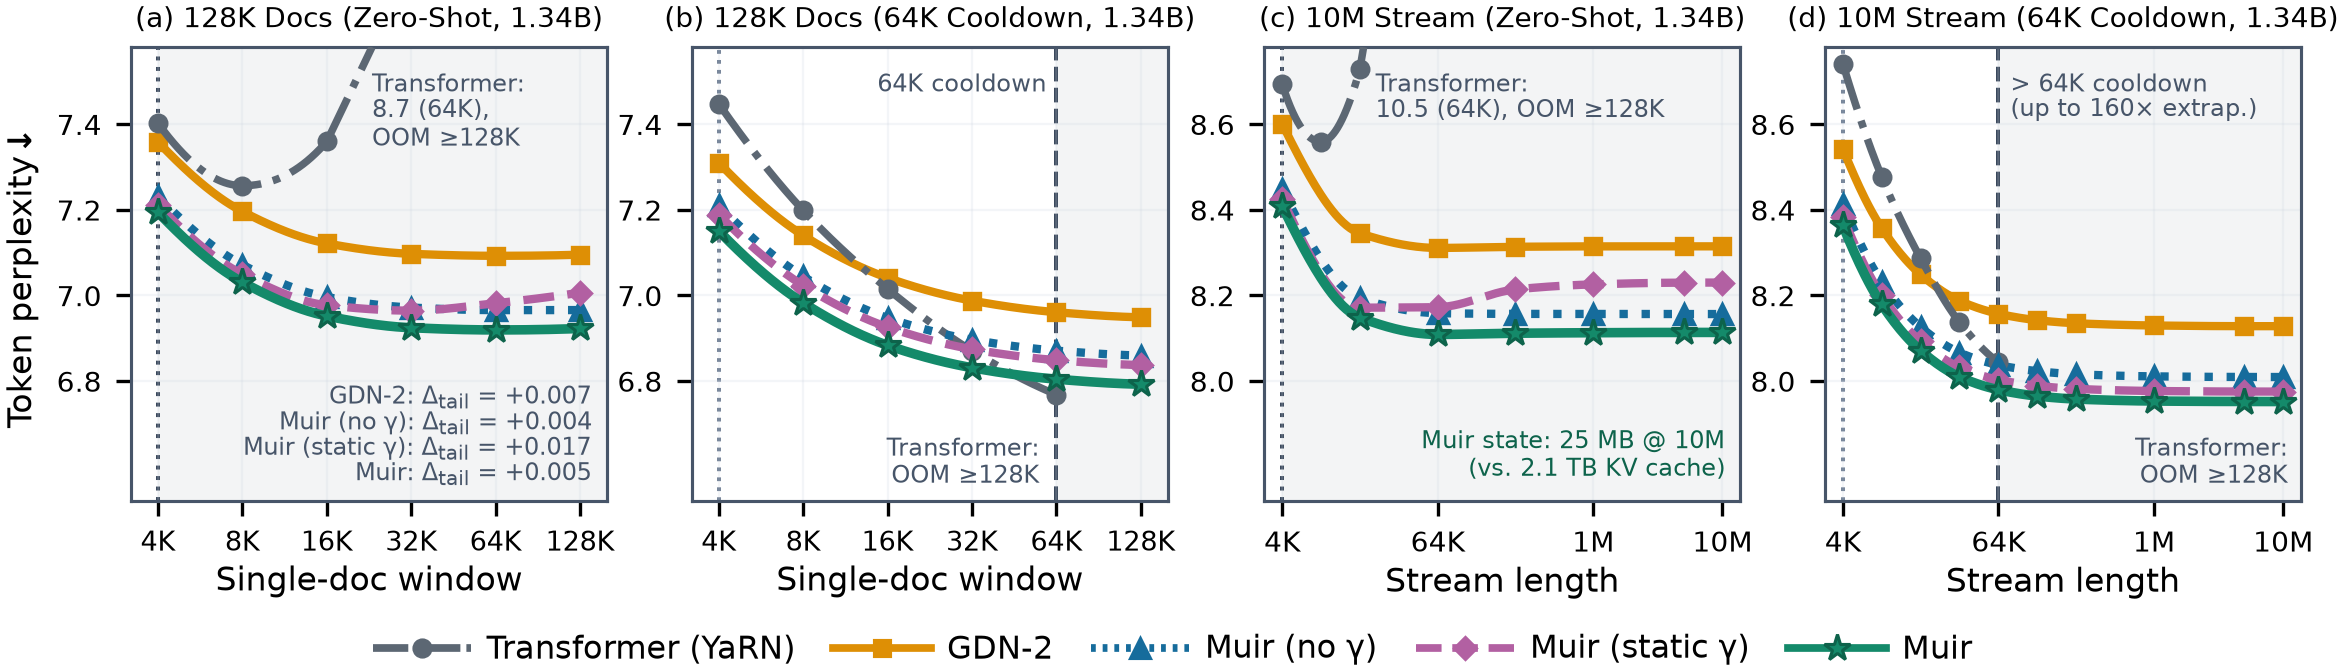
图中对比零样本与 64K cooldown。连续长流下,动态增益曲线保持平稳并低于 GDN-2;静态增益在无 cooldown 时出现小幅上漂。
在 8 张 TPU7x、固定每步 524,288 token 的测量中,1.34B Muir 与 GDN-2 在训练长度 4K 的吞吐分别为 179.4 与 179.3 千 token/s;16K 时是 268.5 与 264.3,32K 时是 256.1 与 253.5。由于两者使用相同分块递归核,Muir 以近乎相同吞吐支持更宽 FFN 和额外读出门。对照用的是 TPU Pallas Splash Attention Transformer:Muir 在 16K 和 32K 分别快 1.64 倍和 2.74 倍;短上下文约 11K 以下,Transformer 的手工融合 Splash 核更快。测量取 100-step 区间 p50,不能外推为不同硬件/实现上的普遍吞吐比(Sec. 5.2.4 / Table 9,PDF pp. 19、47)。
4.4 机制证据与消融
- 秩分配:对训练后秩 128 的门逐一做 SVD 截断,衰减门 $f$ 和擦除门 $b$ 降至秩 64 的损失变化不超过 0.6 mnat;读出 $q$、写入 $w$、输出 $g$ 降至 64 分别增加 4.5、6.4、247 mnat。方向与 64/128 的非对称秩分配一致(406M,Fig. 10 / Table 19,PDF pp. 22、58)。
- 行能量定律:在 166M 检查点中,理论预测行能量与实测值的中位 Spearman 相关为 0.957(GDN-2)和 0.960(Muir)。在 1.34B 中,raw 行能量 p90/p10 中位比为 17.2(Muir)和 14.7(GDN-2);乘以读出增益后,Muir 的比值降至 9.6,即相对 GDN-2 降低 34.7%。
- 擦除与记忆跨度:1.34B Muir 的平均并行擦除率为 0.652,GDN-2 为 0.782(低 16.6%);相邻自擦除由 0.406 降到 0.328。作者在机制分析中还报告状态谱有效秩提高 16.1%,时间回看窗口从 49.3 延长至 78.7 token。$p=0.35$ 的分数幂读出接近训练得到的增益;单位读出与完全白化分别使 NLL 增加约 0.10 和 0.31 nats(166M)。
- 多跳解释:在五跳 Variable Tracking 中,Muir 把查询读出权重沿着目标跳转移动;根节点写入 $H_1$ 到查询时的保留率从 GDN-2 的 37% 增到 45%,五个绑定的平均保留率从 46% 增到 52%(1.34B,Fig. 13 / Table 23,PDF pp. 24、61)。
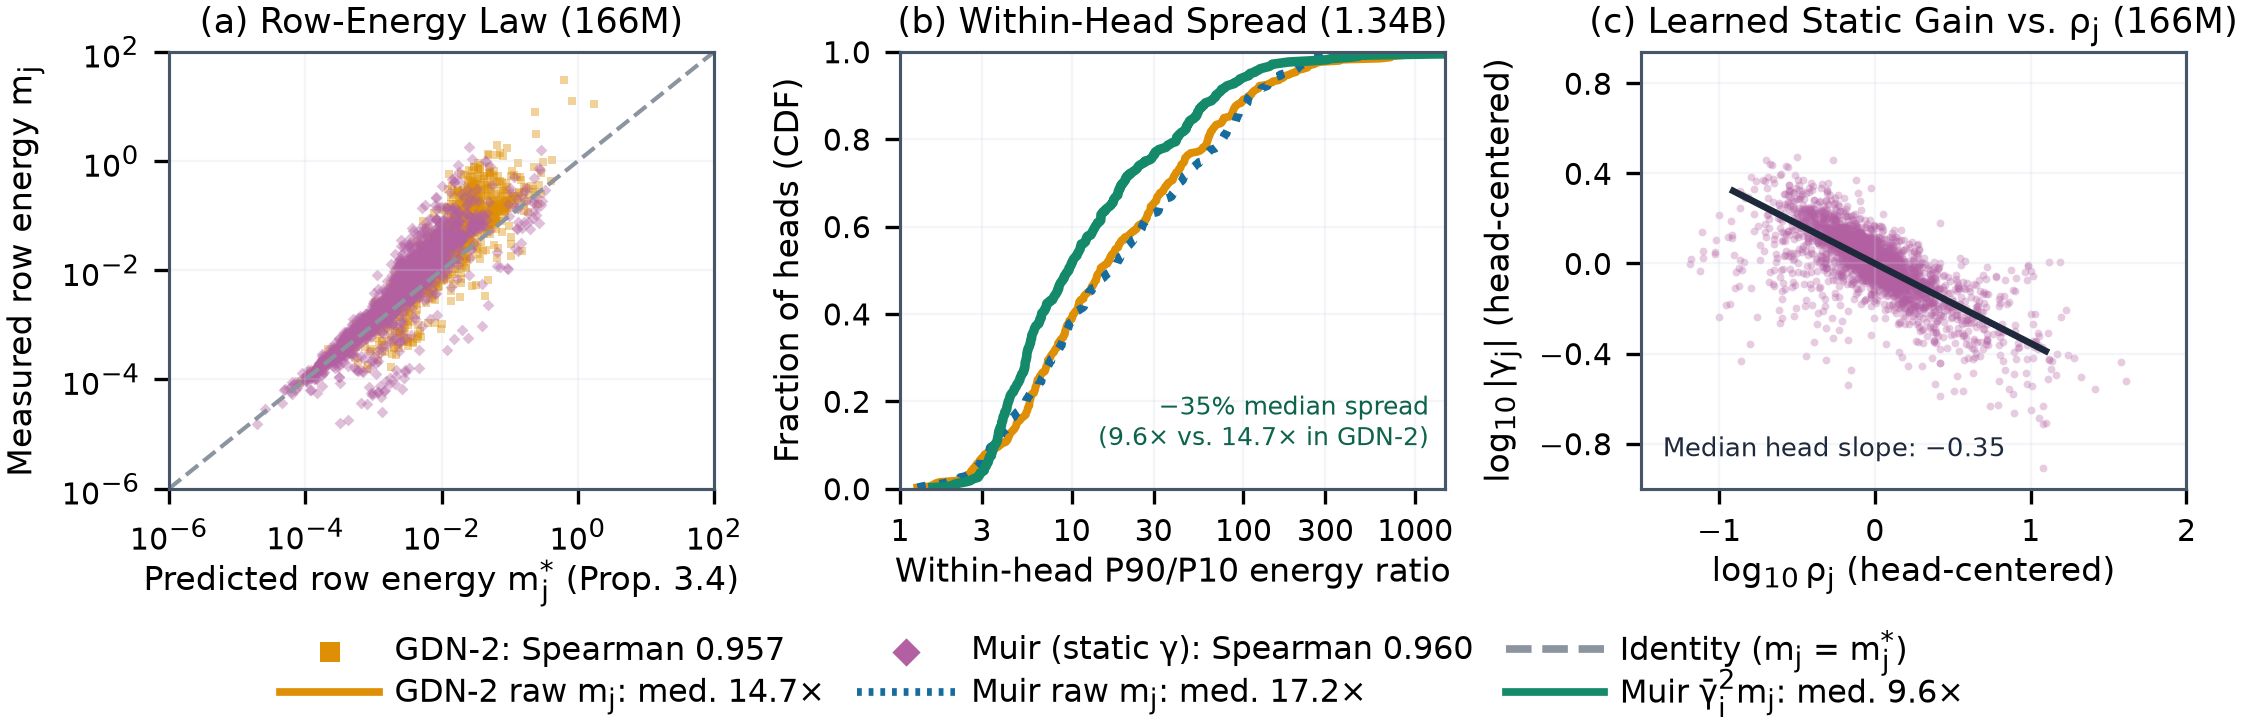
图 (a) 显示理论行能量与检查点测量的对应;(b) 显示读出增益压缩加权后行能量分布;(c) 给出 $\log|\gamma_j|$ 对 $\log\rho_j$ 的斜率约 $-0.35$。
五:结论、边界与启发
论文贡献不只是新增一种门,而是把状态敏感度分析、读出加权、参数预算与并行核共同设计。对固定状态模型而言,谁控制写入、谁控制擦除、读出时怎样处理不同通道的信噪比,都会改变模型实际能保留的信息。作者的检查点探针为理论提供了实证支持:写入门比擦除门敏感约 13 倍,稳态行能量与公式高度相关,读出增益同时减少加权行能量失衡和写时擦除。
适用边界和取舍:
- 稳态行能量定律与匹配滤波推导依赖平稳 i.i.d. 输入、近似不相关状态行、门控统计和二阶矩闭合;作者进一步用训练模型探针验证趋势,但这些探针不等同于现实语言分布完全满足理论假设。
- 静态增益适合单距离的 passkey 读出,并在固定总秩下保留更高写门容量;动态增益适合多跳、多值/多查询及长流语言建模,但减少一半写门秩后,1M passkey 表现明显下降。
- 自定义核在训练检查点采样的中等条件数范围内精度良好;人工构造的高条件数系统会使 bf16 近似逆不稳定。此数值结论与实际 $T$ 矩阵的条件数有关。
- Muir 的硬件优势集中在较长序列;约 11K 以下的短上下文 Transformer 仍凭专用融合核更快。作者提出后续可结合局部滑窗注意力,或把树合并与状态扫描融合为单个 Pallas 核。
- 预训练在四个规模上都使用随机种子 0;报告未展示独立训练种子间的统计波动。模型规模最高 1.34B,性能结论应按论文的训练数据、硬件、核和任务设置理解。
对后续设计的启发是:不要只按门控输出维度平均分参数;先检查门控对状态更新的导数,再把容量分给真正控制有效写入的分支。若通道噪声不均、且目标检索时距分布已知或可估计,读出时做信噪比加权可能比一味加大擦除更省记忆。
参考定位
- 原文:Gangavarapu, Tabak, and Schaefer, Muir: Linear Attention with Sensitivity-Allocated Gating and Matched-Filter Readout, arXiv:2611.08376v1。
- 发表记录核查:Google Research publication entry。