On the Design of Hyper-Connections: Simplification, Stability, and Scalability:精读笔记
作者: Xiangdong Zhang、Xiaohan Qin、Sunan Zou、Tuo Dai、Bizhao Shi、Zhuo Xia、Yebin Yang、Yizhou Chen、Yuliang Liu、Yu Cheng、Junchi Yan
论文: arXiv:2611.05984v1,2026-11-04 提交;本次研读:2026-11-05;本地原文 PDF。下文页码均为从 1 开始的 PDF 页码。
发表: 未查到正式发表信息(截至 2026-11-05);arXiv 记录。
代码: 论文给出的 SimpleHC 仓库链接 于 2026-11-05 返回 404,公开实现暂无法核实。
论文总览
Hyper-Connections(HC)把一条残差流扩为多条,通过读取门、写入门和流间混合控制信息传递;mHC 进一步用 Sinkhorn 约束混合矩阵。论文问的是:哪些结构真正带来模型质量收益,哪些状态访问造成训练开销,能否在规模扩大时同时保持质量、效率与稳定性?
作者在 15B-A1B MoE 上拆解组件,发现两组独立有效的相互作用:①学习读取/写入门而不混合;②固定门但允许无约束混合。前者足以达到与 mHC 接近的表现,同时免去反复相乘的混合矩阵。由此提出 SimpleHC:保留 4 条残差流和各子层独立的读写门,残差流之间使用恒等传递;每 4 个子层共用一个组入口状态来计算门,批量读取该状态,在组末一次写回。组内较早子层的输出通过标量修正进入后续子层输入。
在 30B-A2B MoE 上,SimpleHC 与 mHC 的 Pile 验证损失同为 1.561,14 项下游平均分分别为 63.1 与 62.9。在独立的 8 层、隐藏宽度 $C=6144$ 的效率测量中,SimpleHC 相对普通残差基线的单步训练时间增量为 2.4%,mHC 和 identityHC 约为 7.0%。因此这篇论文最有价值的结论是:减少跨子层对宽残差状态的读写,比单纯去掉混合计算更能释放训练效率;保留子层差异并正确传递组内输出,则可避免明显的质量损失。(Sec. 5.4–5.5,PDF pp. 9–10,Table 4、Fig. 3)
结构地图
| 原文章节 | 作用 | PDF 页码和主要证据 |
|---|---|---|
| 1 Introduction;2 Preliminaries | 问题、HC/mHC 的统一表示 | pp. 1–3,Fig. 1 |
| 3 SimpleHC | 恒等残差传递、共享状态、标量修正与分组算法 | pp. 3–5,Fig. 2、Algorithm 1、Eqs. (1)–(6) |
| 4 Infrastructure Design | 融合前后向及流量核算 | pp. 5–6,Table 1、Eqs. (7)–(10) |
| 5 Experiments | 组件拆解、共享策略、30B 扩展、训练效率 | pp. 6–10,Tables 2–4、Figs. 3–4 |
| 6 Analysis | 最小结构、门控可预测性、稳定性 | pp. 9–12,Figs. 5–6 |
| 7 Related Work;8 Conclusion | 定位与结论 | p. 12 |
| Appendices A–E | 配置、等价性证明、门控与压力实验细节 | pp. 16–23,Tables 5–8 |
一:动机——HC 的收益和开销来自哪里
对第 $l$ 个注意力或 FFN/MoE 子层,令 $X_l\in\mathbb{R}^{n\times C}$ 为 $n$ 条宽度为 $C$ 的残差流。统一形式是
$h^{\mathrm{pre}},h^{\mathrm{post}}\in\mathbb{R}^{n}$ 分别决定怎样汇聚已有流、怎样把子层输出分配回流;$H^{\mathrm{res}}\in\mathbb{R}^{n\times n}$ 混合旧流。HC 使用逐流投影和无约束混合,mHC 使用完整 $nC$ 状态生成门,并通过 Sinkhorn 近似约束混合矩阵为双随机矩阵。论文默认沿用 mHC 的完整状态门控参数化。(Sec. 2,PDF pp. 2–3)
开销来自每个子层重复访问 $nC$ 元素的宽状态,而不只来自新增 FLOPs。即使把 mHC 的混合换成恒等矩阵,逐层门控、基础读取和宽状态写回仍要反复读写。在作者的高效实现中,mHC 相对普通残差基线增加约 7%–27% 的端到端训练时间,虽然论文指出其附加 FLOPs 少于 1%;这给“少访问宽状态”提供了直接动机。(Sec. 1,PDF p. 2;Sec. 4、5.5,PDF pp. 5、9)
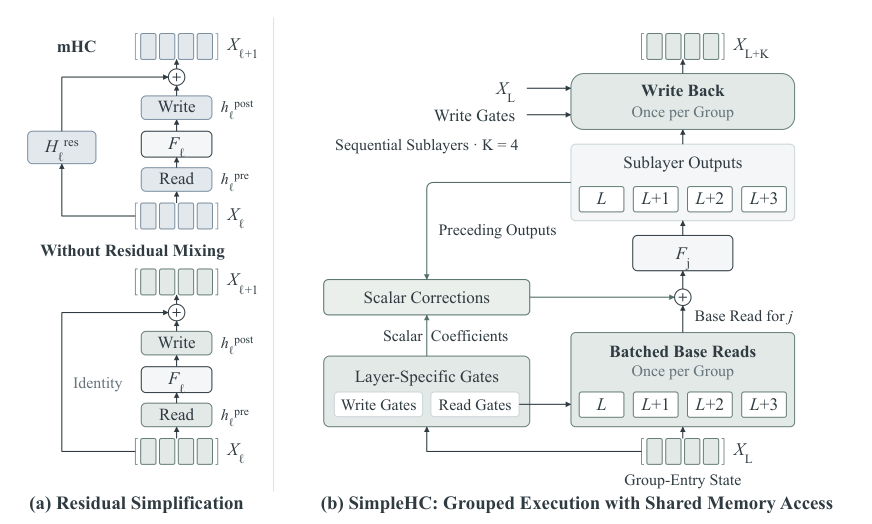
原 Fig. 2,PDF p. 3。左侧取消流间混合;右侧仍逐子层执行 $F_j$,但门控和基础读取都使用组入口 $X_L$,最后一次写回。
二:方法——分组状态读取与精确的组内输出传递
2.1 结构选择:恒等传递,保留独立读写门
SimpleHC 令 $H_l^{\mathrm{res}}=I$,故 $X_{l+1}=X_l+h_l^{\mathrm{post}}o_l^\top$。读写门保留 mHC 的完整状态输入:$z_l=\operatorname{RMSNorm}(\operatorname{vec}X_l)$、$\ell_l^s=\alpha_l^s(W_l^s)^\top z_l+b_l^s$,$h_l^{\mathrm{pre}}=\sigma(\ell_l^{\mathrm{pre}})$、$h_l^{\mathrm{post}}=2\sigma(\ell_l^{\mathrm{post}})$。这里 $s$ 为 pre/post,两类参数和每个子层的参数分别独立。$n=4$ 是主要实验设置。去掉混合后,从组入口 $L$ 到组内任意 $j$ 的状态是按写门加权的历史输出之和:
这条加法关系是后续推导的结构条件。使用无约束混合时,旧输出还要经过中间多层的混合矩阵乘积,无法直接用一个读写门内积概括其贡献。(Sec. 3.1、App. C,PDF pp. 3、19)
2.2 计算步骤:先批量读,再逐层修正,最后写回
对于一组 $K=4$ 个连续子层 $j=L,\ldots,L+3$,SimpleHC 首先分别用各层自己的参数、但共同用 $X_L$ 计算门:$\bar h_j^s=g_j^s(X_L)$。把 4 个读门组成矩阵 $\bar H^{\mathrm{pre}}$,批量得到基础输入 $V=X_L^\top\bar H^{\mathrm{pre}}\in\mathbb{R}^{C\times K}$。第 $j$ 层真正送入 $F_j$ 的输入还要加上前面输出的贡献:
$d_{j,k}$ 是标量,但乘的是 $C$ 维输出 $o_k$。例如 $K=2$ 时,$u_{L+1}=X_L^\top\bar h_{L+1}^{\mathrm{pre}}+d_{L+1,L}o_L$;若只取基础读取,第二层就看不到第一层输出。各子层仍按顺序计算 $o_j=F_j(u_j)$。最终统一写回
在给定同一组入口门控时,以上计算与每层都物化 $X_j$ 的顺序执行在精确算术中等价。归纳理由是:假定先前各 $o_k$ 一致,展开顺序状态后,第 $j$ 层读到的输入正是“基础读取 + 标量修正”,因而该层输出也一致;组末写回再把所有更新相加。梯度也随同一个函数一致,但必须保留门对 $X_L$ 的依赖。与原始 identityHC 的差别恰在门控的条件输入:SimpleHC 用 $X_L$ 近似各 $X_j$,并不声称两种门控相等。(Sec. 3.2、Algorithm 1,PDF pp. 4–5;App. B,PDF pp. 18–19)
2.3 为何 $K=4$:宽状态流量与修正开销的平衡
作者核算每 token、每子层的逻辑前向激活读取和写入量,排除参数、注意力/FFN 内部及小系数缓存。SimpleHC 的流量为
第一项 $4nC/K$ 来自每组一次门控投影读取、一次基础读取和一次宽状态读写;$2C$ 与窄向量有关;修正成本随 $K$ 增长。在 $n=K=4$ 时,$Q_{\mathrm{corr}}=3C$,总量为 $9C$,而融合后的 mHC 和 identityHC 都为 $18C$。按论文列举的 $K=2,4,8,16$,流量分别为 $11.5C,9C,9.25C,12.375C$;$K=4$ 是这些候选中的最低值,同时共享门控的质量实验仍接近参考方法。流量是模型内残差操作的逻辑计数,不能直接等同于端到端时间缩短一半。(Sec. 4.3、Table 1,PDF pp. 5–6)
2.4 工程执行
前向将 4 层的读写门投影并为一个 $4C\times32$ 投影;同一次状态读取取得投影、RMS 统计量,另外批量聚合基础读取。组内用小核把此前的 $C$ 维输出与标量系数相乘相加,组末融合 4 次写回。反向同时复用组末状态梯度计算多层输出梯度,并把小门控梯度打包成张量核上的规约。作者使用 DeepGEMM 与 Triton 实现;性能提升既来自数学上的分组结构,也来自针对宽激活和小门控梯度的融合实现。(Sec. 4.1–4.2,PDF pp. 5–6)
三:实验——分别检验结构和执行策略
共同设置。 结构拆解和共享策略用 15B 总参数、1B 激活参数的 MoE;扩展实验用 30B-A2B。两者均为 MLA 骨干、全局注意力与 512 窗口滑动注意力按 1:3 交替,序列长 8192,采用 Muon/AdamW,残差流数默认 $n=4$。Pile test split 上报告验证损失(越低越好);15B 用 MMLU、HellaSwag、MATH、MBPP、C3 五项下游任务,30B 扩为 14 项,平均分越高越好。各任务的 few-shot 设置见 App. A:如 15B MMLU 5-shot、HellaSwag 10-shot、MATH 4-shot。(Sec. 5.1,PDF p. 7;App. A,PDF pp. 16–18)
对照角色。 Vanilla 是单残差流基线;HC 是原始无约束混合形式;mHC 是 Sinkhorn 约束混合形式;identityHC 把 mHC 的混合矩阵设为恒等但仍逐子层取门;SimpleHC 在 identityHC 的残差结构上加入共享状态与标量修正。因此 mHC 对比说明综合质量和成本,identityHC 对比隔离“分组状态访问”带来的变化。(Sec. 5.2–5.3,PDF pp. 7–8)
3.1 结构拆解:两组相互作用都能改善结果
15B-A1B 的 Table 2 中,mHC 的损失/五项平均分为 1.659/55.0。无混合、完整状态学习读写门的 identityHC 为 1.660/55.4;只保留无约束混合、把读门固定为 $1/4$、写门固定为 $1$ 时为 1.660/56.0。两组机制分别都接近或超过 mHC 的平均分,且在 mHC 参数化下同时使用门与无约束混合达到 1.657/56.2。这支持“两个可用的交互来源”,并非证明二者表示能力完全等价。
约束是关键:同样的完整状态门控下,mHC 的 Sinkhorn 混合平均分 55.0,恒等混合 55.4,无约束混合 56.2。固定读门或写门使 identityHC 平均分分别降为 53.6/52.8,表明读写门需要配合。把读/写门的输入限制为各自流而非完整状态,损失由 1.660 增至 1.661/1.663。作者因此选择完整状态读写门加恒等传递,兼顾结果与混合的传播风险。(Sec. 5.2、Table 2,PDF p. 7;Sec. 6.1,PDF pp. 10–11)
3.2 共享策略:独立门和标量修正都不可省
| 15B-A1B 配置 | Pile 损失 ↓ | 五项平均分 ↑ | 解释 |
|---|---|---|---|
| mHC,逐子层门控 | 1.659 | 55.0 | 质量参考 |
| identityHC,逐子层门控 | 1.660 | 55.4 | 去混合参考 |
| SimpleHC,$K=4$,层独立门 | 1.660 | 55.0 | 共享入口状态仍接近 mHC |
| 共享 $K=8$ | 1.662 | 54.3 | 共享跨度变大后略降 |
| $K=4$,组内重用同一对门 | 1.667 | 53.5 | 抹掉子层差异会掉分 |
| $K=4$,省略标量修正 | 1.705 | 47.9 | 后续层失去组内前序输出 |
Sec. 5.3、Table 3,PDF p. 8。省略修正的实验仍在组末写回全部输出,因此性能损失指向组内输入缺少前序输出。
3.3 30B 扩展:综合接近,单项有取舍
30B-A2B 的四种方法在相同骨干的对比中,Pile 损失从 Vanilla 的 1.579 降至 mHC、identityHC、SimpleHC 均为 1.561;14 项平均分分别是 59.3、62.9、62.8、63.1。SimpleHC 的 MATH 为 41.5(mHC 38.4),C3 为 91.4(mHC 89.6);HumanEval 为 45.1(mHC 47.6),GSM8K 为 74.5(mHC 75.0)。因此结论应是综合表现相当,而非每项都更好。(Sec. 5.4、Table 4,PDF p. 9)
3.4 训练效率:窄算子开销的实际收益
效率实验使用另外一组 8 层模型,隐藏宽度从 $1024$ 到 $6144$,序列长 8192,BF16,global batch 256,CUDA Graph 开启、不做激活重计算;各宽度使用相同骨干与并行设置。它测的是端到端单步时间相对 Vanilla 的增量,并非 30B 全深度模型的实测训练总时长。(Sec. 5.5、App. A.2,PDF pp. 9、17)
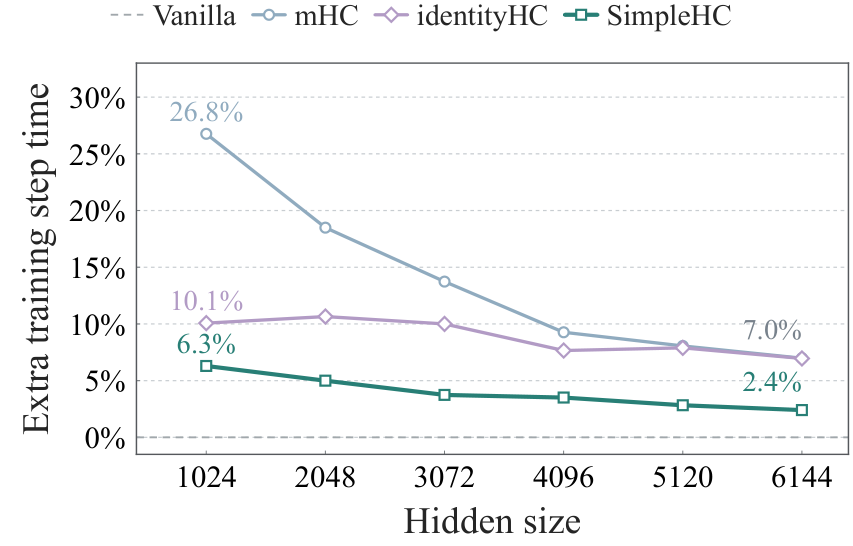
原 Fig. 3(a),PDF p. 9。横轴是隐藏宽度,纵轴是相对 Vanilla 的单步训练时间增量;在 $C=1024$ 时 SimpleHC/mHC/identityHC 分别为 6.3%/26.8%/10.1%,在 $C=6144$ 时约为 2.4%/7.0%/7.0%。
最宽设置下,专用融合核把 SimpleHC 的增量从 PyTorch 版本的 22.5% 降到 2.4%。同宽下 xHC 的高效实现约 27.7%,但其配置使用 16 条残差流、4 条活跃流,模型结构不同,宜把它视为另一种容量/效率取舍。作者估算的 backward 保留激活存储,在 8 层、$C=2048$、8192-token、microbatch 1、无重计算设置下从 mHC 的 3044.5 MiB 降至 SimpleHC 的 2092.875 MiB,即约 31.26%;此统计排除了注意力/FFN 内部、优化器、临时工作区和 CUDA allocator,因此不是峰值显存。(Sec. 5.5、Fig. 4,PDF pp. 9–10;App. A.2、Table 7,PDF pp. 17–18)
四:分析——为什么门能共享,以及稳定性证据
4.1 两组机制调节的是同一类历史贡献,但风险不同
一般 HC 中,从旧输出 $o_k$ 到后续输入 $u_j$ 的残差路径系数是
恒等传递时,它退化为两个门的内积;无约束混合时,中间矩阵乘积提供更多权重自由度,也可能放大路径系数。作者在两个 15B 模型的 262,144 个抽样 token 位置上发现,无约束混合加固定门的峰值绝对路径系数更大(App. D,PDF p. 20)。这是传播风险的诊断证据;它测的是抽样路径系数,不是全网 Jacobian 或失稳因果证明。mHC 的 Sinkhorn 约束旨在控制这类风险,但结构拆解显示其质量收益在此实验里接近恒等传递。(Sec. 6.1,PDF p. 10;App. C–D,PDF pp. 19–20)
4.2 门随子层变化,却可由共同入口状态预测
门控差异图显示,不同子层的读写门分配模式确实不同;这与 Table 3 中重用同一对门掉分相吻合。作者进一步冻结一个训练好的 15B identityHC,把每组后 3 层在其真实状态 $X_j$ 上得到的门作为目标,只用 $X_L$ 训练各层独立的预测器。最终测试集上,读/写门 MAE 为 0.01653/0.01034;不重新训练、只把教师门映射作用于 $X_L$ 时为 0.05817/0.05044,常量均值门为 0.07345/0.06893。写门 MAE 先除以 2 归一到 $[0,1]$。这解释了为什么可共享门的输入,却不应共享门的参数。(Sec. 6.2、Fig. 5,PDF p. 11;App. D.3,PDF pp. 20–21)
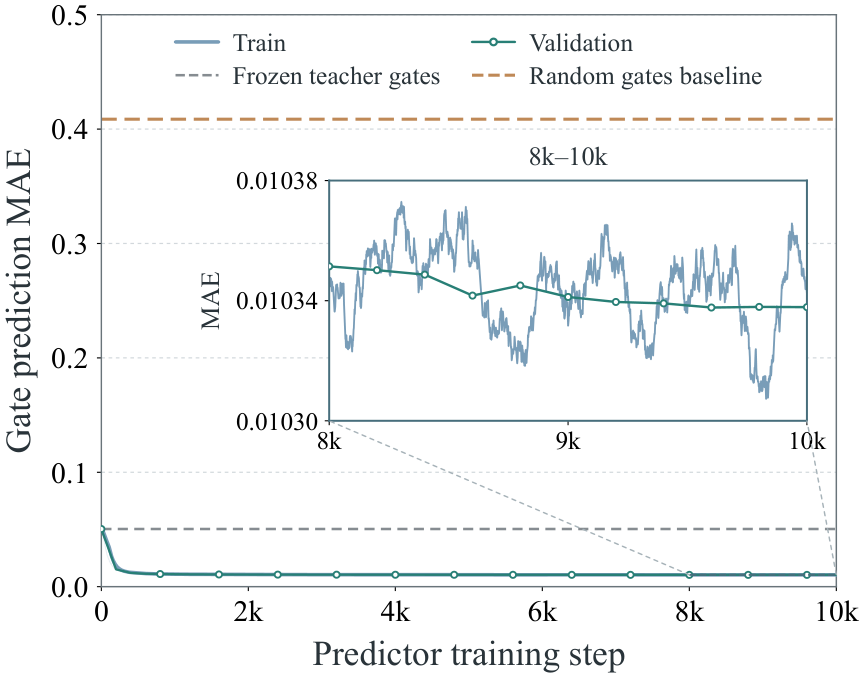
原 Fig. 5(b),PDF p. 11。虚线为冻结教师映射与随机门对照;训练后的验证 MAE 约 0.0103。该探针让教师轨迹保持冻结,说明入口状态包含可预测的门信息,不把探针结果直接等同于 SimpleHC 的下游质量。
4.3 标准训练和压力实验
15B 常规训练中,SimpleHC 在 warmup 后较早阶段的梯度范数波动较小;1000 步滚动标准差的最大值为 0.032,mHC/identityHC 为 0.206/0.248,后期各方法范围接近。作者提出共享入口状态可能减弱对组内状态波动的敏感性,这是解释性假设。(Sec. 6.3、Fig. 6(a),PDF p. 11;App. E.2,PDF p. 22)
压力实验同时使用 64 层、512 个路由专家和参考学习率的 10 倍,在 230B-A6B MoE 上训练 28,000 步。mHC 出现约 $1.9\times10^6$ 的梯度尖峰,而 identityHC/SimpleHC 保持较平稳;损失与分支输出尺度图也显示 mHC 的异常。作者记录的一个事件中,FFN 输出先出现极大值,随后有限轮 Sinkhorn 得到的混合矩阵行和未完全归一,可能进一步放大异常;另一个反向事件中动态混合的门输入梯度路径很强。论文明确表示尚不能判定后者是数学敏感性还是数值反向问题,因此不能把失稳简单归因于单一机制。(Sec. 6.3、Fig. 6(b),PDF p. 11;App. E,PDF pp. 21–23)
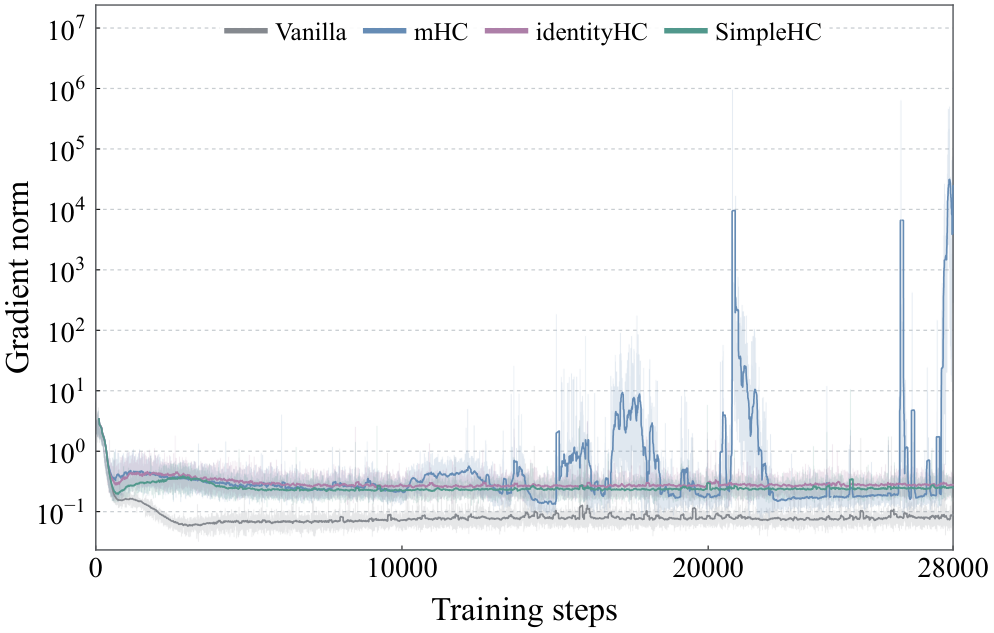
原 Fig. 6(b),PDF p. 11。横轴为训练步数,纵轴为对数尺度梯度范数;本图对应多项压力同时施加的设置。
五:结论与实际取舍
SimpleHC 的贡献分成两层:结构上用完整状态的学习读写门取代混合矩阵;执行上用组入口状态统一生成层独立的门,再用标量修正恢复组内前序输出、在组末一次写回。后者才把融合 mHC 的逻辑残差状态流量从 $18C$ 减到 $9C$。15B 和 30B 结果支持它在这些 MoE 训练设置下保持与 mHC 接近的质量,8 层效率测试则显示小幅端到端时间增量;压力实验提供稳定性证据。(Secs. 3–6,PDF pp. 3–12)
理解结论时有三项具体边界。第一,$2.4\%$ 时间增量测于 8 层基准模型,不是 30B 模型完整训练的实测总成本。第二,约 $31\%$ 的内存降低是限定范围的保留激活估计,不能读成峰值 GPU 显存降幅。第三,230B 压力测试把深度、专家数和学习率同时提高,证明这些合并压力下的观察,无法单独归因某一个因素;作者对 mHC 反向异常的原因也保留了数学/数值两种可能。(App. A.2、E,PDF pp. 17–18、21–23)