You don’t need long context:中文精读笔记
作者:Peter Belcak、Saurav Muralidharan、Jindong Jiang、Yonggan Fu、Wonmin Byeon、Hanrong Ye、Ryan Angilly、Ali Taghibakhshi、Shih-Yang Liu、Siru Ouyang、Greg Heinrich、Pavlo Molchanov。
论文:arXiv:2611.05306v1,2026 年 11 月 3 日提交,31 页技术报告;本地原文 PDF。研读日期:2026 年 11 月 5 日。本文的页码均为 PDF 从 1 开始的页码。
发表:arXiv 记录标为 Technical report;截至 2026 年 11 月 5 日,未查到正式发表或录用信息。
代码:截至 2026 年 11 月 5 日,未查到本论文专属的公开官方实现。作者使用的基础框架 mini-swe-agent 已公开,但该仓库不是本研究的实验代码。
论文总览
论文检验一个容易混淆的命题:任务持续很久、材料很长,是否意味着每次模型调用都必须保留完整历史或读入整份材料?作者把信息保存在环境中,让智能体以任务导向的状态摘要接续工作,并对大文档按需检索。在两款主测模型 Claude Opus 4.5 与 GPT 5.6 Sol 上,六组长流程任务多数接近完整历史基线;七组长输入任务在选择性阅读下多为持平或更好;两项软件任务甚至允许每个新会话只执行一次动作。这个结果支持“短工作上下文+可检索的外部信息”这一工作方式,但不证明任何任务都不需要长上下文。(Sec. 3–6,PDF pp. 9–15)
效率动机与任务结果是两类证据:在三款开放权重模型的固定硬件服务实验中,16K 相比 256K 的解码吞吐量高 3.6、5.6、7 倍;论文后续的“优化零售成本节省”则是根据这一吞吐差异与假定定价函数推算,并非这些基准任务的实付账单。(Fig. 1、4,PDF pp. 1、8;App. B,pp. 20–21)
结构地图
| 原文章节 | 作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 提出成本动机和三个研究问题 | pp. 1–3;Fig. 1–2 |
| 2 Methodology | 定义上下文、数据集、模型、FHA/EoCC/SAC 与选择性阅读 | pp. 3–8;Fig. 3–4 |
| 3 Long-horizon tasks don’t need long contexts | 六组长流程比较及历史丢失的反例 | pp. 9–10;Fig. 5 |
| 4 Long-input tasks don’t need long contexts | 七组长输入比较与文档长度分析 | pp. 11–13;Fig. 6–8 |
| 5 Compaction can be performed after every action | SAC 结果与语义状态空间模型设想 | p. 14–15;Table 2 |
| 6 Conclusion | 结论及其适用范围 | p. 15 |
| Appendices A–G | 压缩内容、成本公式、逐项结果、读取示例与提示模板 | pp. 20–31;Tables 3–17 |
一:问题与动机
论文把“长上下文”来源拆成两种:长流程的工具结果和决策不断累积;长输入的原始材料本身很大。前者可把历史压成行动所需的状态,后者可把材料留在文件系统,先搜索再读取局部。两种处理均改变模型此刻看到的信息量,却不必删除全部原始信息。作者据此提出 RQ1(长流程)、RQ2(长输入)、RQ3(每次调用只做一次动作)。(Sec. 1,PDF pp. 2–3)
图 1 横轴是配置的上下文窗口大小,纵轴是基于峰值持续解码吞吐量换算的每百万输出 token 成本。云端实验使用 8 张或 16 张 H100,预填充最长前缀一次并启用前缀缓存,再让每个请求生成 1,024 token;比较的是相同 GPU 配置下的解码效率。GLM 5.2、Kimi K2.6、Qwen 3 Coder Next 在 256K 相对 16K 的单位输出成本分别为 3.6、5.6、7 倍。图 2 还显示本地 DGX Spark 上部分模型的单 token 延迟随输入增长近乎翻倍。(Sec. 2.5,PDF pp. 1–2、8)
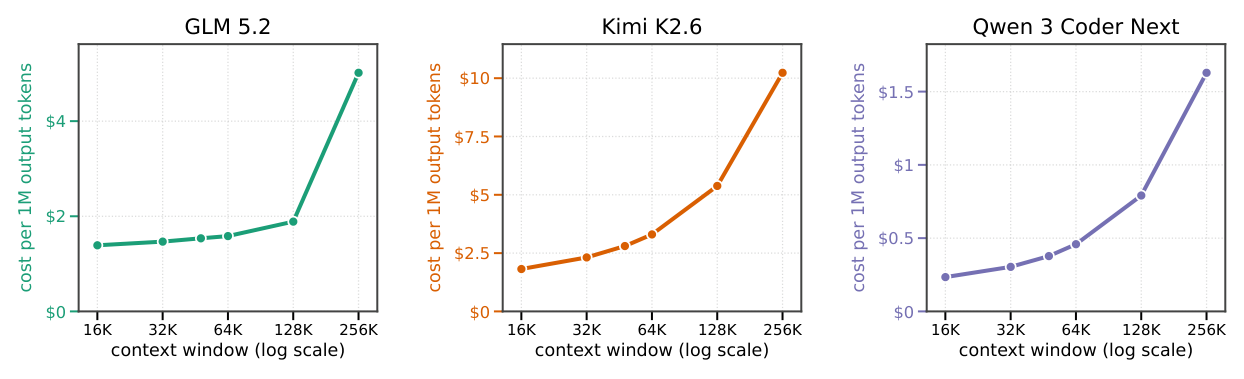
原文 Fig. 1,PDF p. 1。三个面板的纵轴单位不同,因此应比较每个模型自身从 16K 到 256K 的倍数,不跨面板直接比较美元高度。
二:方法:把工作状态与资料库分开
论文的“上下文”指单次推理时模型收到的输入及随后的输出;峰值长度是一个任务里最长的一段会话,总长度是该任务各段会话的最终长度之和。总长度大并不表示任一单次调用有同样长的上下文。作者把约 16K–50K token 称作相对于主流 256K 以上窗口的“短上下文”,这是实验定义,并非语言学意义上的短文本。(Sec. 2.1、2.4,PDF pp. 3–4、7)
| 策略 | 每次新调用保留什么 | 触发方式与用途 |
|---|---|---|
| 完整历史累积(FHA) | 原任务、全部动作、全部观察 | 长流程的基线 |
| 会话末压缩(EoCC) | 原任务、压缩后的工作状态;环境仍保留 | 达到压缩阈值后生成交接摘要,再开启新会话 |
| 单动作压缩(SAC) | 原任务、当前语义状态 | 每做完一个环境动作就更新状态并重启 |
EoCC 的“48K/36K”表示总上下文上限/触发压缩阈值:36K 附近要求模型写交接摘要,48K 留出压缩回合空间。交接摘要的重点是原任务、已验证事实、当前工作、完成条件、下一步和所需资料位置,而不是平均压缩整个执行记录。附录 A 和 G 给出这一设计与实际提示模板。(Sec. 2.4,Fig. 3,PDF p. 7;Apps. A、G,pp. 20、30–31)
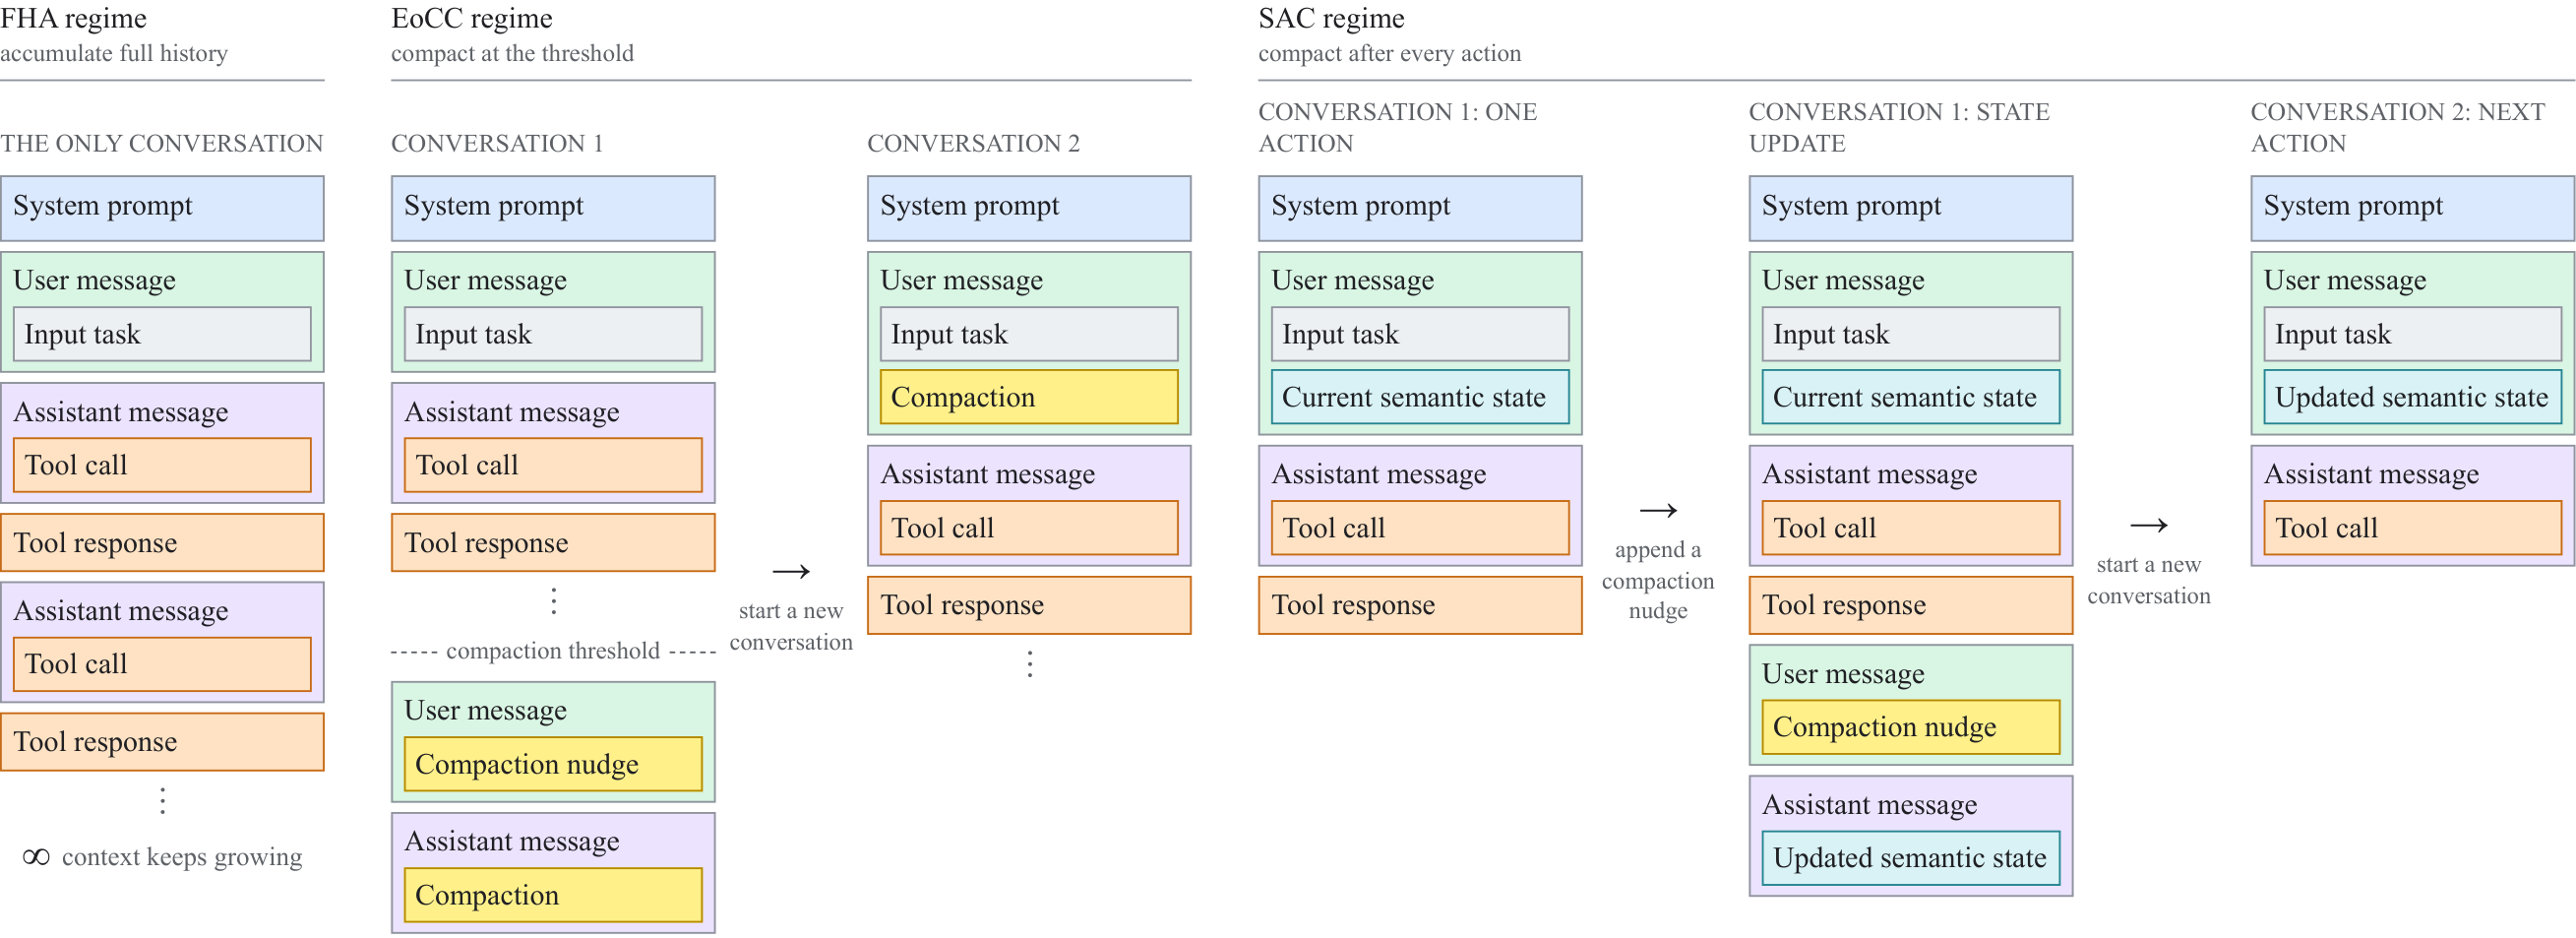
原文 Fig. 3,PDF p. 7。左侧历史持续增长;中间到阈值后以摘要接续;右侧每一步都以语义状态交接。图中的“短”指活跃会话,不指抹去任务环境。
长输入实验把文档放进环境文件,问题只告知文件位置。智能体可用搜索、文件清单与有界读取工具取得相关片段;附录 E 的读取命令默认最多 6,000 字符、硬上限 8,000 字符。这样把“读长材料”转化为一系列可检索动作。必须注意:这组实验同时改变了输入呈现方式和上下文管理;尤其在压缩次数中位数为零的任务,性能变化主要应归于选择性阅读,不能单独归功于 EoCC。(Sec. 2.4、4,PDF pp. 7、11–13;App. E,pp. 25–26)
主结果覆盖六组长流程基准:SWE-bench Verified、SWE-bench Multilingual、Terminal-Bench 2.1、FRAMES、$\tau^2$-bench、BFCLv3;以及七组长输入基准:LongBench v2、LOONG、AA-LCR、NIAH、RULER、Counting-Stars、BABILong。两款主测模型分别来自不同开发者;五款本地开放权重模型另作补充检验。(Sec. 2.2–2.3,PDF pp. 4–6)
三:六组长流程实验
作者沿不同阈值比较 EoCC 与各模型的 FHA。Fig. 5 上半部是同一模型相对其自身基线的准确率百分点变化,下半部是推算的优化零售成本倍数。跨六组基准、22 个阈值配置,每款模型至多有 5 个配置比基线低超过 2 个百分点;全范围为 Opus −3.7 至 +5.6 点、GPT −3.3 至 +4.4 点。对应的推算成本节省范围分别是 2.2–8.8 倍、2.4–5.0 倍。这些范围汇集不同任务与阈值,并不是单一任务的典型值。(Sec. 3,Fig. 5,PDF pp. 9–10)
逐项看最紧阈值,结论更具体。下表均为“FHA 基线 → EoCC 最紧配置”,单位为通过率或准确率百分比;不同基准的指标不可合并平均。(App. C,Tables 3–8,PDF pp. 22–23)
| 基准;最紧上限/阈值 | Opus 4.5 | GPT 5.6 Sol |
|---|---|---|
| SWE-bench Verified;16K/12K | 70.0 → 68.8 | 84.4 → 84.6 |
| SWE-bench Multilingual;16K/12K | 66.3 → 64.3 | 79.3 → 77.7 |
| Terminal-Bench 2.1;16K/12K | 47.2 → 48.3 | 87.6 → 85.4 |
| FRAMES;16K/12K | 81.0 → 79.6 | 90.2 → 87.1 |
| BFCLv3;12K/8K | 62.0 → 62.5 | 39.5 → 39.5 |
| $\tau^2$-bench;8K/6K | 79.3 → 78.8 | 73.9 → 73.9 |
这不是“压缩总能提高准确率”:FRAMES 的 GPT 最紧配置下降 3.1 点;不同阈值下也有波动。压缩的总 token 消耗不一定下降,例如 SWE-bench Verified 中 GPT 的标称零售费用从 167.68 美元增至 16K/12K 时的 203.12 美元。论文报告的 4.1 倍左右成本节省,来自另一个假设——短窗口零售单价会随服务成本降低;它不是现行标称价格直接算出的账单节省。(App. C,Table 3,PDF p. 22)
作者还给出信息丢失的反例:若任务最终要问很早以前第 $i$ 次掷币的结果,固定预算摘要迟早会删掉某些结果。其解决路径是把完整历史保存在可检索外部记录中,而非要求摘要无损。这揭示了本文结论成立所依赖的系统条件:状态摘要承担“下一步怎么做”,原始记录承担“必要时再找证据”。(Sec. 3.1,PDF p. 10)
四:七组长输入实验
与一次性粘贴全文的基线相比,选择性阅读通常保留或提高准确率。下面列出能反映不同任务类型的原表数值;“→”右侧为对应选择性阅读设置。LOONG 的数值是平均分,RULER 是平均召回率,Counting-Stars 展示完全匹配率;不能把这些列当同一个统计量。(App. F,Tables 11–17,PDF pp. 27–29)
| 基准与设置 | Opus 4.5 | GPT 5.6 Sol | 解释 |
|---|---|---|---|
| LongBench v2;16K/12K | 68.0 → 67.6 | 70.8 → 72.6 | 503 道异构长文选择题 |
| LOONG;32K/24K | 70.1 → 80.2 | 79.3 → 84.0 | 1,600 道多文档题,平均分 |
| AA-LCR;16K/12K | 65.0 → 84.0 | 82.0 → 83.0 | 100 道跨文档推理题 |
| NIAH;48K/36K | 60.0 → 100.0 | 80.0 → 100.0 | 125 个“针”检索实例 |
| RULER;16K/12K | 62.5 → 95.7 | 65.5 → 96.4 | 13 类任务的平均召回率 |
| Counting-Stars;16K/12K | 65.1 → 81.2 | 76.6 → 81.2 | 192 题的完全匹配率 |
| BABILong;16K/12K | 67.1 → 92.0 | 70.7 → 94.0 | 550 道嵌入式推理题 |
LOONG 还报告“全对率”:Opus 从 38.9% 增至 32K/24K 下的 53.7%,GPT 从 44.4% 增至 52.1%。这说明平均分提升没有只来自部分答案多拿一点分。(App. F,Table 12,PDF p. 27)
七组长输入任务的推算优化零售成本相对全文基线节省 6.5–54.6 倍(Opus)和 4.4–233.3 倍(GPT)。极大倍数来自选择性读取减少送入模型的材料,再叠加短窗口单价假设;它们跨越不同基准,既不是实际付款记录,也不能归因于压缩单独起效。(Sec. 4,Fig. 6,PDF pp. 11–12;App. B,pp. 20–21)
NIAH 的 100% 不能概括所有长文任务:作者指出,问题与插入句及常见同义词具有方便搜索的词汇重叠。RULER、Counting-Stars 与 BABILong 包含聚合、变量追踪或推理,提供不同于单句检索的证据。Fig. 7–8 将源文档长度与各段会话最终长度之和相对照:多数点的会话长度没有随文档长度同比增长,但图中仍有长尾。横轴是对数刻度;图并未报告每个任务的峰值上下文等于纵轴。(Sec. 4,Figs. 7–8,PDF pp. 12–13;App. F,pp. 27–29)
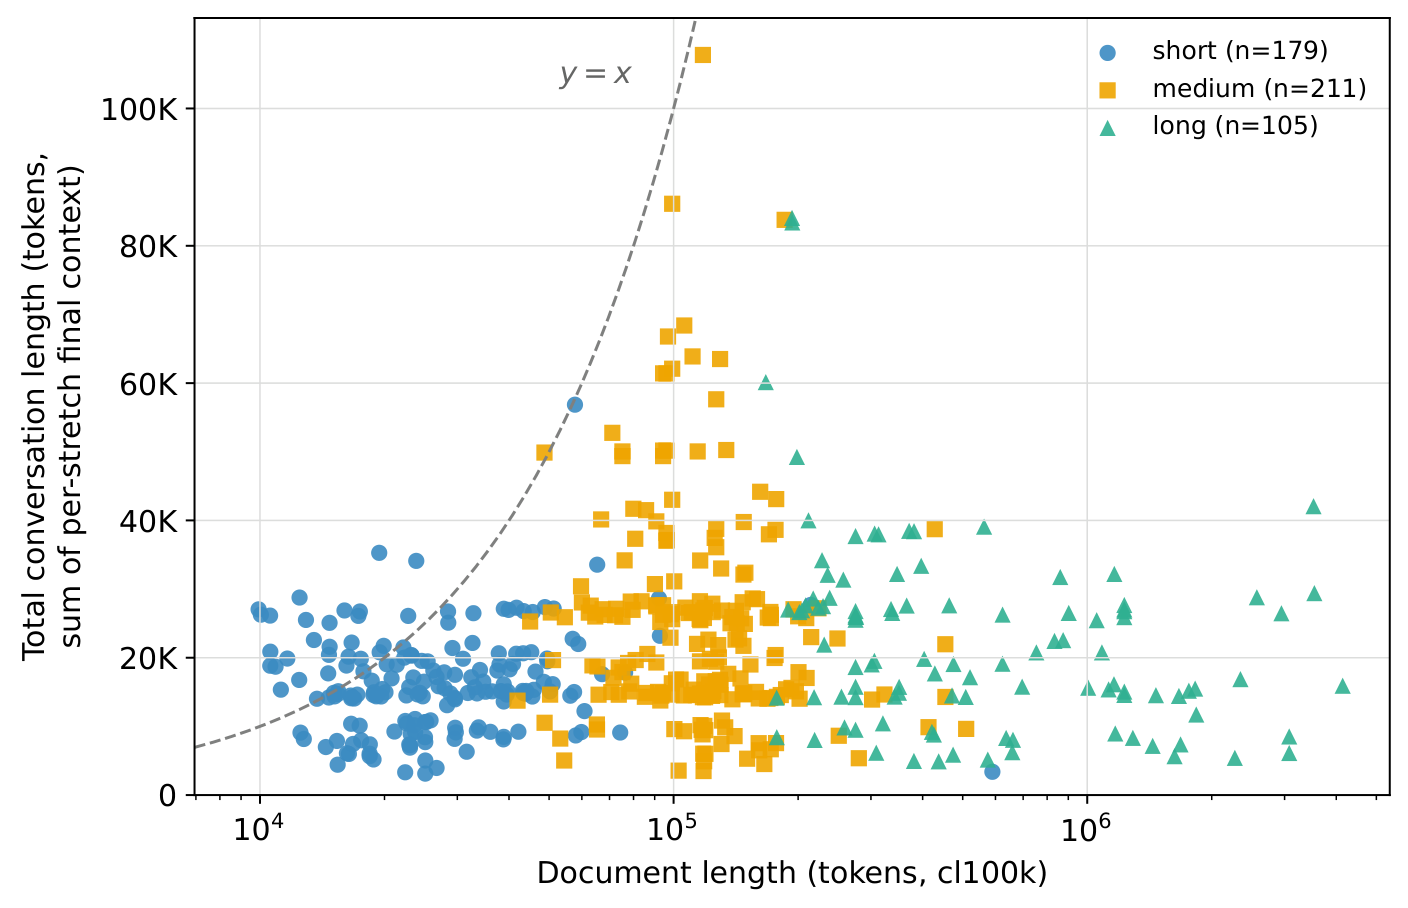
原文 Fig. 7,PDF p. 12。虚线是 $y=x$;纵轴为多段会话长度之和。它展示“资料量不必全部进入模型会话”,并保留了需要更多读取的离群点。
五:单动作压缩、成本推导与结论
SAC 在每个动作结束后更新语义状态,让下一次调用重新从原任务和状态出发。Table 2 只检验 SWE-bench Verified 与 Terminal-Bench 2.1;下面的峰值为每任务单次会话最长上下文的中位数/最大值,单位 K token。(Sec. 5,Table 2,PDF p. 14)
| 模型与任务 | FHA 准确率 | SAC 准确率 | FHA 峰值中位/最大 | SAC 峰值中位/最大 |
|---|---|---|---|---|
| Opus;SWE-bench Verified | 70.0% | 70.2% | 32/200 | 8/16 |
| Opus;Terminal-Bench 2.1 | 47.2% | 51.8% | 27/130 | 9/19 |
| GPT;SWE-bench Verified | 84.4% | 82.4% | 18/173 | 7/15 |
| GPT;Terminal-Bench 2.1 | 87.6% | 84.3% | 17/133 | 8/37 |
Opus 在这两项任务不降,GPT 分别下降 2.0 和 3.3 个百分点;因此单动作交接可行,但并非无代价。作者由此提出语义状态空间模型(Semantic State Space Model, SSSM):未来可后训练模型,使它读取自然语言状态、选择动作、观察结果、再输出供下一调用接续的更新状态。这里提出的是模型设计方向;论文没有训练或评估一个 SSSM。它与传统神经状态空间模型的关键差别,是跨动作传递可解释的语言状态。(Sec. 5.1,PDF pp. 14–15)
成本推导也值得单独读。若 $T_M(W)$ 是固定 GPU 资源下窗口 $W$ 的峰值解码吞吐量,作者先计算
三款实测模型的 $r_M$ 是 0.2772、0.1777、0.1439,作者把均值取整为 $r=0.20$。再对闭源模型假设从 16K 处的标准输出价 20% 线性升至参考窗口的标准输出价;未缓存输入价是输出价的 1/5,缓存输入价又是未缓存输入价的 1/10。对一个基准的百万 token 数 $I$(未缓存输入)、$H$(缓存输入)、$O$(输出),推算
这解释了为什么 Fig. 5–6 的“节省倍数”可远大于仅从已公布 API 价格算出的变化:模型将开放权重部署的吞吐比外推到闭源模型,并假设未来有随窗口变化的零售定价。服务吞吐实验没有测出闭源模型真实的上下文分段价格,也未给出任务端到端延迟节省。(App. B,Eqs. 1–4,PDF pp. 20–21)
补充的五款本地开放权重模型显示一个重要边界:在 SWE-bench Verified 的 16K/12K 设置下,五者均低于各自 FHA 基线;Qwen 3 Coder Next 更从 53.0% 降至 3.6%,作者将其与冗长轨迹挤占压缩间的有效工作空间联系起来。因而“强模型+可用工具+可靠交接”的结果不能直接套到任意模型。(App. D,Tables 9–10,PDF p. 24)
我的判断:论文最强的证据是把“任务所需信息总量”与“下一步必须同时摆在模型眼前的信息量”分开,并给出跨任务和单动作压缩的实测成绩。工程上应保存原任务、完成条件、当前进度、下一动作及证据位置,使文件和历史可检索;随后同时测任务成功率、峰值上下文、总 token、实际账单和端到端耗时。它支持在所测工作流中缩短活跃上下文,并未完成“所有长上下文模型都可被替代”的证明。(Sec. 6,PDF p. 15)