LiSA:面向长程视觉建模的线性随机注意力
题名: LiSA: Linear Stochastic Attention for Long-Range Visual Modeling
作者: Sahar Dastani、Fereshteh Shakeri、Samuel Barbeau、Kunal Mahatha、Ismail Ben Ayed、Herve Lombaert、Christian Desrosiers
原文: arXiv:2611.04216v2,2026-11-04 修订;本次阅读使用 v2,获取日期 2026-11-09。
PDF: 本地原文
- 发表: 根据作者项目页的 WACV 2027 标注和 arXiv v2 的 WACV camera-ready 文件,记录为已接收至 WACV 2027;这是依据作者材料作出的判断,未找到单独公开的录用通知。截至 2026-11-09,尚未找到 CVF/IEEE 正式论文集条目。作者仓库、WACV 2027 官方作者指南。
- 代码: 作者官方实现仓库已建立,但 README 当前写明“Code Coming Soon”,实现尚未公开。
论文总览
LiSA 针对核化线性注意力的一项表达能力缺口:普通线性注意力将 \(K^\top V\) 先汇总,再让每个 query 读取一次,因此每个值只经过一跳关联。若两个图像区域需要通过中间 patch 建立联系,单次聚合不会显式计算这种传递关系。LiSA 把非负、行归一化的 query–key 相似度视作转移矩阵,用截断随机游走累加一跳到多跳的信息,再以局部 \(3\times3\) 注意力保留邻近细节。
关键的计算技巧是利用转移矩阵的低秩形式 \(S=\tilde QK^\top\),把 \(S^kV\) 改写成在 \(d_h\times d_h\) 特征空间中的递推,避免显式构造 \(n\times n\) 矩阵。论文报告在固定小截断长度下,序列长度方向仍为线性复杂度。ImageNet、ADE20K 和 COCO 结果显示,改进在 PVT-T、高分辨率分类及密集预测任务上尤其明显;Swin 的 ADE20K mAcc 则下降,LiSA 在长序列上的延迟也高于 FLatten。
结构地图
以下页码均为 PDF 物理页码。
| 原文部分 | 作用 | PDF 页码与证据 |
|---|---|---|
| 摘要、1 Introduction | 问题、线性注意力的一跳限制、贡献 | pp. 1–2;Fig. 1 在 p. 1 |
| 2 Related Work | 高效视觉 Transformer、线性注意力、多跳注意力 | pp. 2–3 |
| 3 Method | 随机游走、低秩计算、局部注意力与融合 | pp. 3–5;Fig. 2 在 p. 4,Algorithm 1 在 p. 5 |
| 4.1 Image Classification | ImageNet 分类与跨骨干迁移 | pp. 5–6;Tables 1–2 在 p. 6 |
| 4.2 Semantic Segmentation | ADE20K 上的 S-FPN、UPerNet | p. 6;Table 3 |
| 4.3 Object Detection | COCO 上的 Mask R-CNN | pp. 6–7;Table 4 在 p. 7 |
| 4.4 Ablation Study | 线性注意力基线、\(\alpha\)、截断深度、组件贡献 | pp. 7–8;Fig. 3 在 p. 7,Tables 5–7 在 pp. 7–8 |
| 定性与效率结果 | 注意力图、长序列延迟和显存 | p. 8;Figs. 4–5 |
| 5 Conclusion | 总结与后续方向 | p. 8 |
| Supplementary 6–12 | 命题证明、额外消融、失败模式、架构和效率数据 | pp. 11–13;Table 13 在 p. 13 |
一:动机
标准自注意力显式计算所有 token 对的相似度,时间和显存随 token 数 \(n\) 呈二次增长。核化线性注意力用正特征映射 \(\phi\) 重排乘法:
从而避免保存 \(n\times n\) 的注意力矩阵。作者指出,这种重排的核心仍是一次直接关联:token \(i\) 读取与它直接相似的 token \(j\),但不会显式传播 \(j\) 从其他 token 收到的信息。用 \(A=\phi(Q)\phi(K)^\top\) 表示关联时,普通线性注意力计算 \(AV\),而 \(A^2V,A^3V\) 等间接路径没有进入该层的输出(Sec. 1、3.1,PDF pp. 2–3)。
这对视觉任务的影响是:被遮挡、改变视角或外观差异较大的同一物体部位,直接 query–key 相似度可能较弱;中间 patch 可以提供关联路径,但单跳汇聚没有这种路径。作者的主张不是增加 token 对计算,而是用多跳传播给长程关系更多表达力,同时保留线性序列复杂度。
二:方法
2.1 符号与一跳基线
输入有 \(n\) 个 token,\(X\in\mathbb R^{n\times d}\)。投影后 \(Q,K\in\mathbb R^{n\times d_h}\),\(V\in\mathbb R^{n\times d}\)。实验默认使用 ReLU 特征映射,故 \(Q,K\) 非负;补充材料比较 ELU 和 ReLU,ReLU 略优(76.3% 对 76.0%,Table 8,PDF p. 11)。
普通线性注意力先聚合所有 key–value 外积,再逐 query 读取:
并按行分母做归一化(正文 Eq. 3,PDF p. 3)。它的关联可看作图上的一跳消息传递。
2.2 将关联变成随机游走
把每个 patch 当作图节点。令
因此
每一行表示从起点 \(i\) 走向其他 token 的转移概率。忽略极小的数值稳定项时,\(S\) 行随机;由于它是两个窄矩阵的乘积,秩至多为 \(d_h\)(Sec. 3.2,PDF pp. 3–4)。
固定续走概率 \(0\le\beta<1\) 时,每走一步以概率 \(\beta\) 继续,或以 \(1-\beta\) 结束。截断到 \(T\) 项后,路径长度 \(k\) 的权重按几何级数衰减并重新归一化:
教学直觉: 若 patch \(i\) 与 \(m\) 直接相似度一般,但 \(m\) 与 \(j\) 很相似,那么 \(S^2_{ij}\) 可通过路径 \(i\to m\to j\) 把 \(j\) 的值送回 \(i\)。\(T=1\) 只有 \(S^0=I\) 的自环;更大的 \(T\) 纳入更长路径。论文默认主实验 \(T=3\),消融通常用 \(T=5\)。
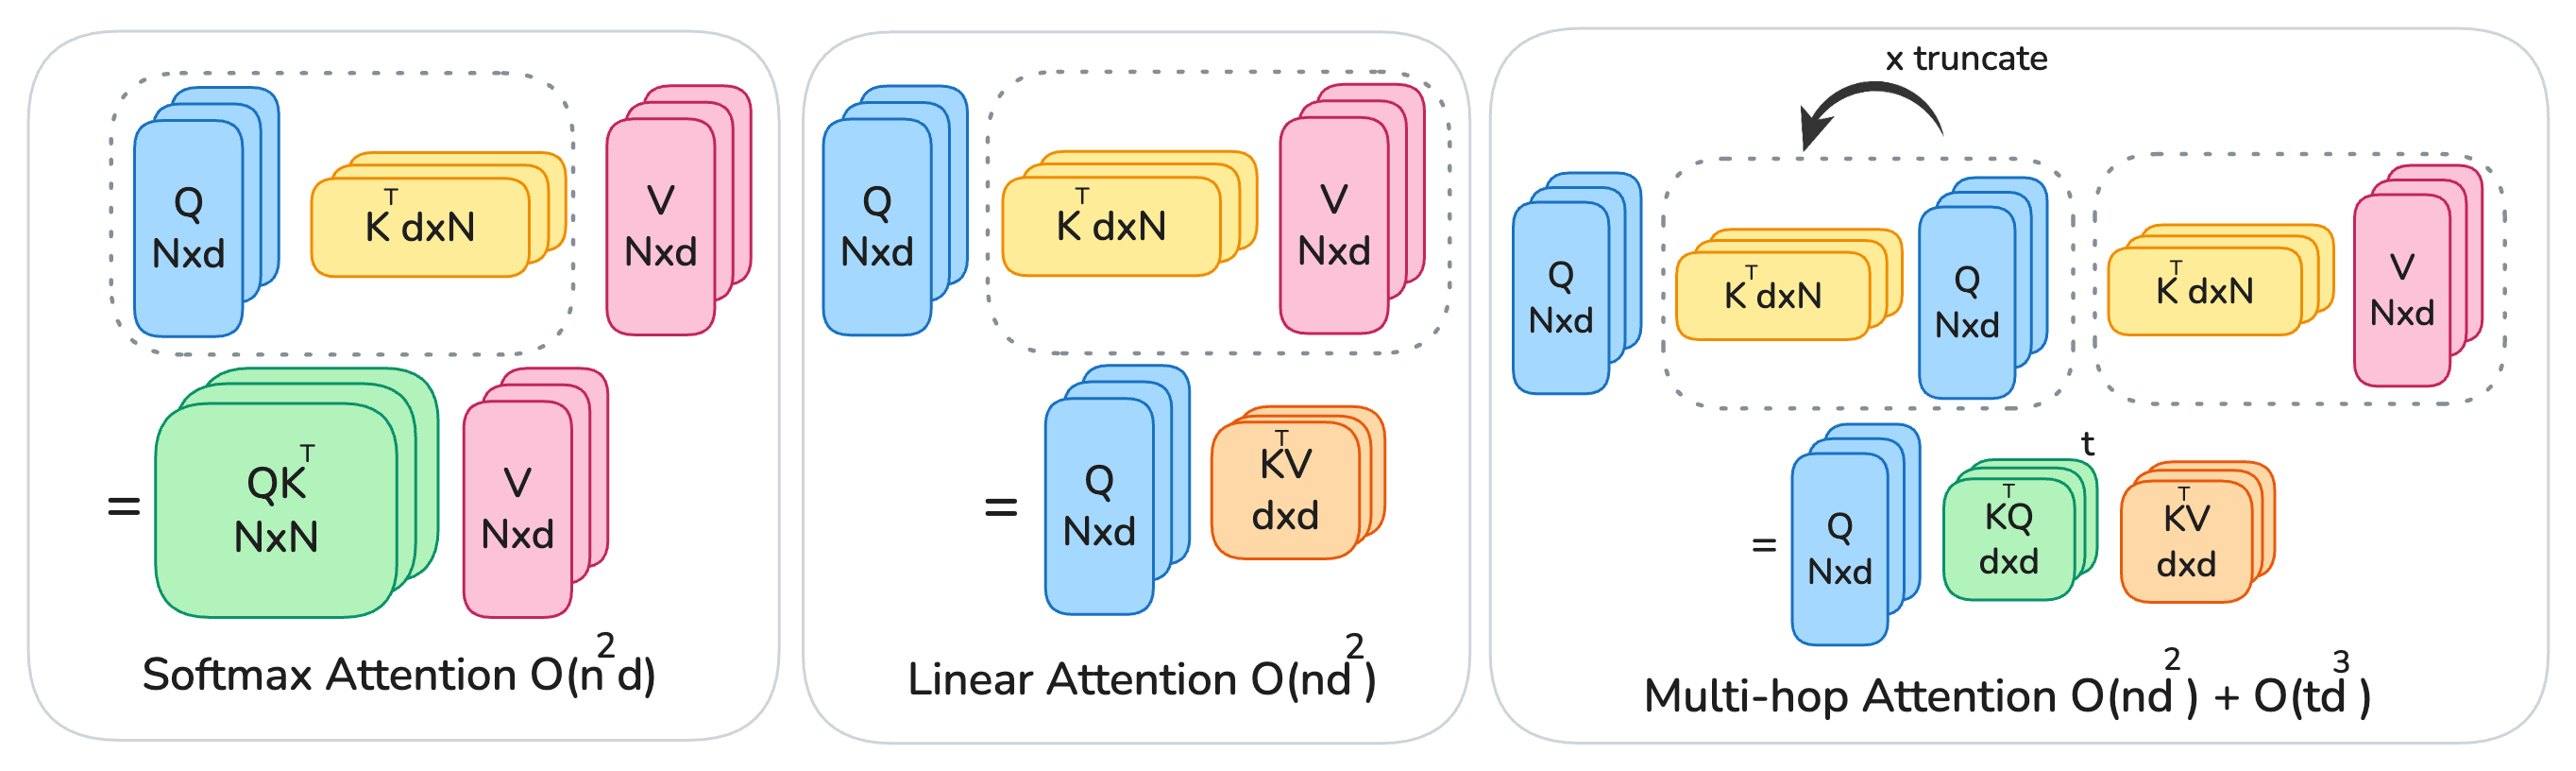
图 1 为论文原 Fig. 1(PDF p. 1):左侧 softmax 注意力形成 token 对矩阵;中间线性注意力先计算 \(K^\top V\);右侧 LiSA 在低维空间递推多个扩散项。图中复杂度写作 \(O(nd^2)+O(Td^3)\),强调固定 \(T,d\) 时对 token 数 \(n\) 呈线性。
2.3 低秩计算避免 \(n\times n\) 矩阵
因为 \(S=\tilde QK^\top\),对 \(k\ge1\) 有:
矩阵 \(K^\top\tilde Q\) 只有 \(d_h\times d_h\)。所以,模型可先在特征维度计算 \(K^\top V\),再递推 \(K^\top\tilde Q\) 的幂并左乘 \(\tilde Q\),而不显式存储 \(S\) 或 \(S^k\)。论文给出的复杂度是 \(O(Td_h^3)+O(ndd_h)\);固定小 \(T\) 时关于 token 数线性。Algorithm 1 每个截断项都累加一次 token 维投影,因此实际常数随 \(T\) 增加;主实验采用短截断 \(T=3\)(Eq. 8、Algorithm 1,PDF pp. 4–5)。
若不截断,几何级数可写成
这说明多阶交互的闭式表达,但直接求逆和反向传播更昂贵,故实践中使用截断多项式。
2.4 输入自适应的步长权重与局部支路
作者进一步用非负权重 \(\beta_k\) 替代固定几何权重:
补充材料说明权重按 token、按 head 预测:把该 token 的 query 和 key 拼接,经两层小 MLP 和 softmax 得到 \(T\) 个权重。因而不同位置可在短路径与长路径之间自适应分配权重(Eq. 10、Supp. Sec. 8,PDF pp. 5、12)。
多跳扩散会把相邻 token 表示逐渐混合,过深时可能导致过平滑。LiSA 另设一个 \(3\times3\) 局部支路,只在 token 自身及其最多 8 个空间邻居间计算遮罩后的指数相似度,再做行归一化。最终输出为
其中 \(\alpha\) 是可学习混合系数。全局支路提供远距离上下文,局部支路保留边缘和细节;作者的 \(\alpha\) 消融显示两支路的学习式组合优于只用任一支路(Sec. 3.2,PDF p. 5;Fig. 2,p. 4)。
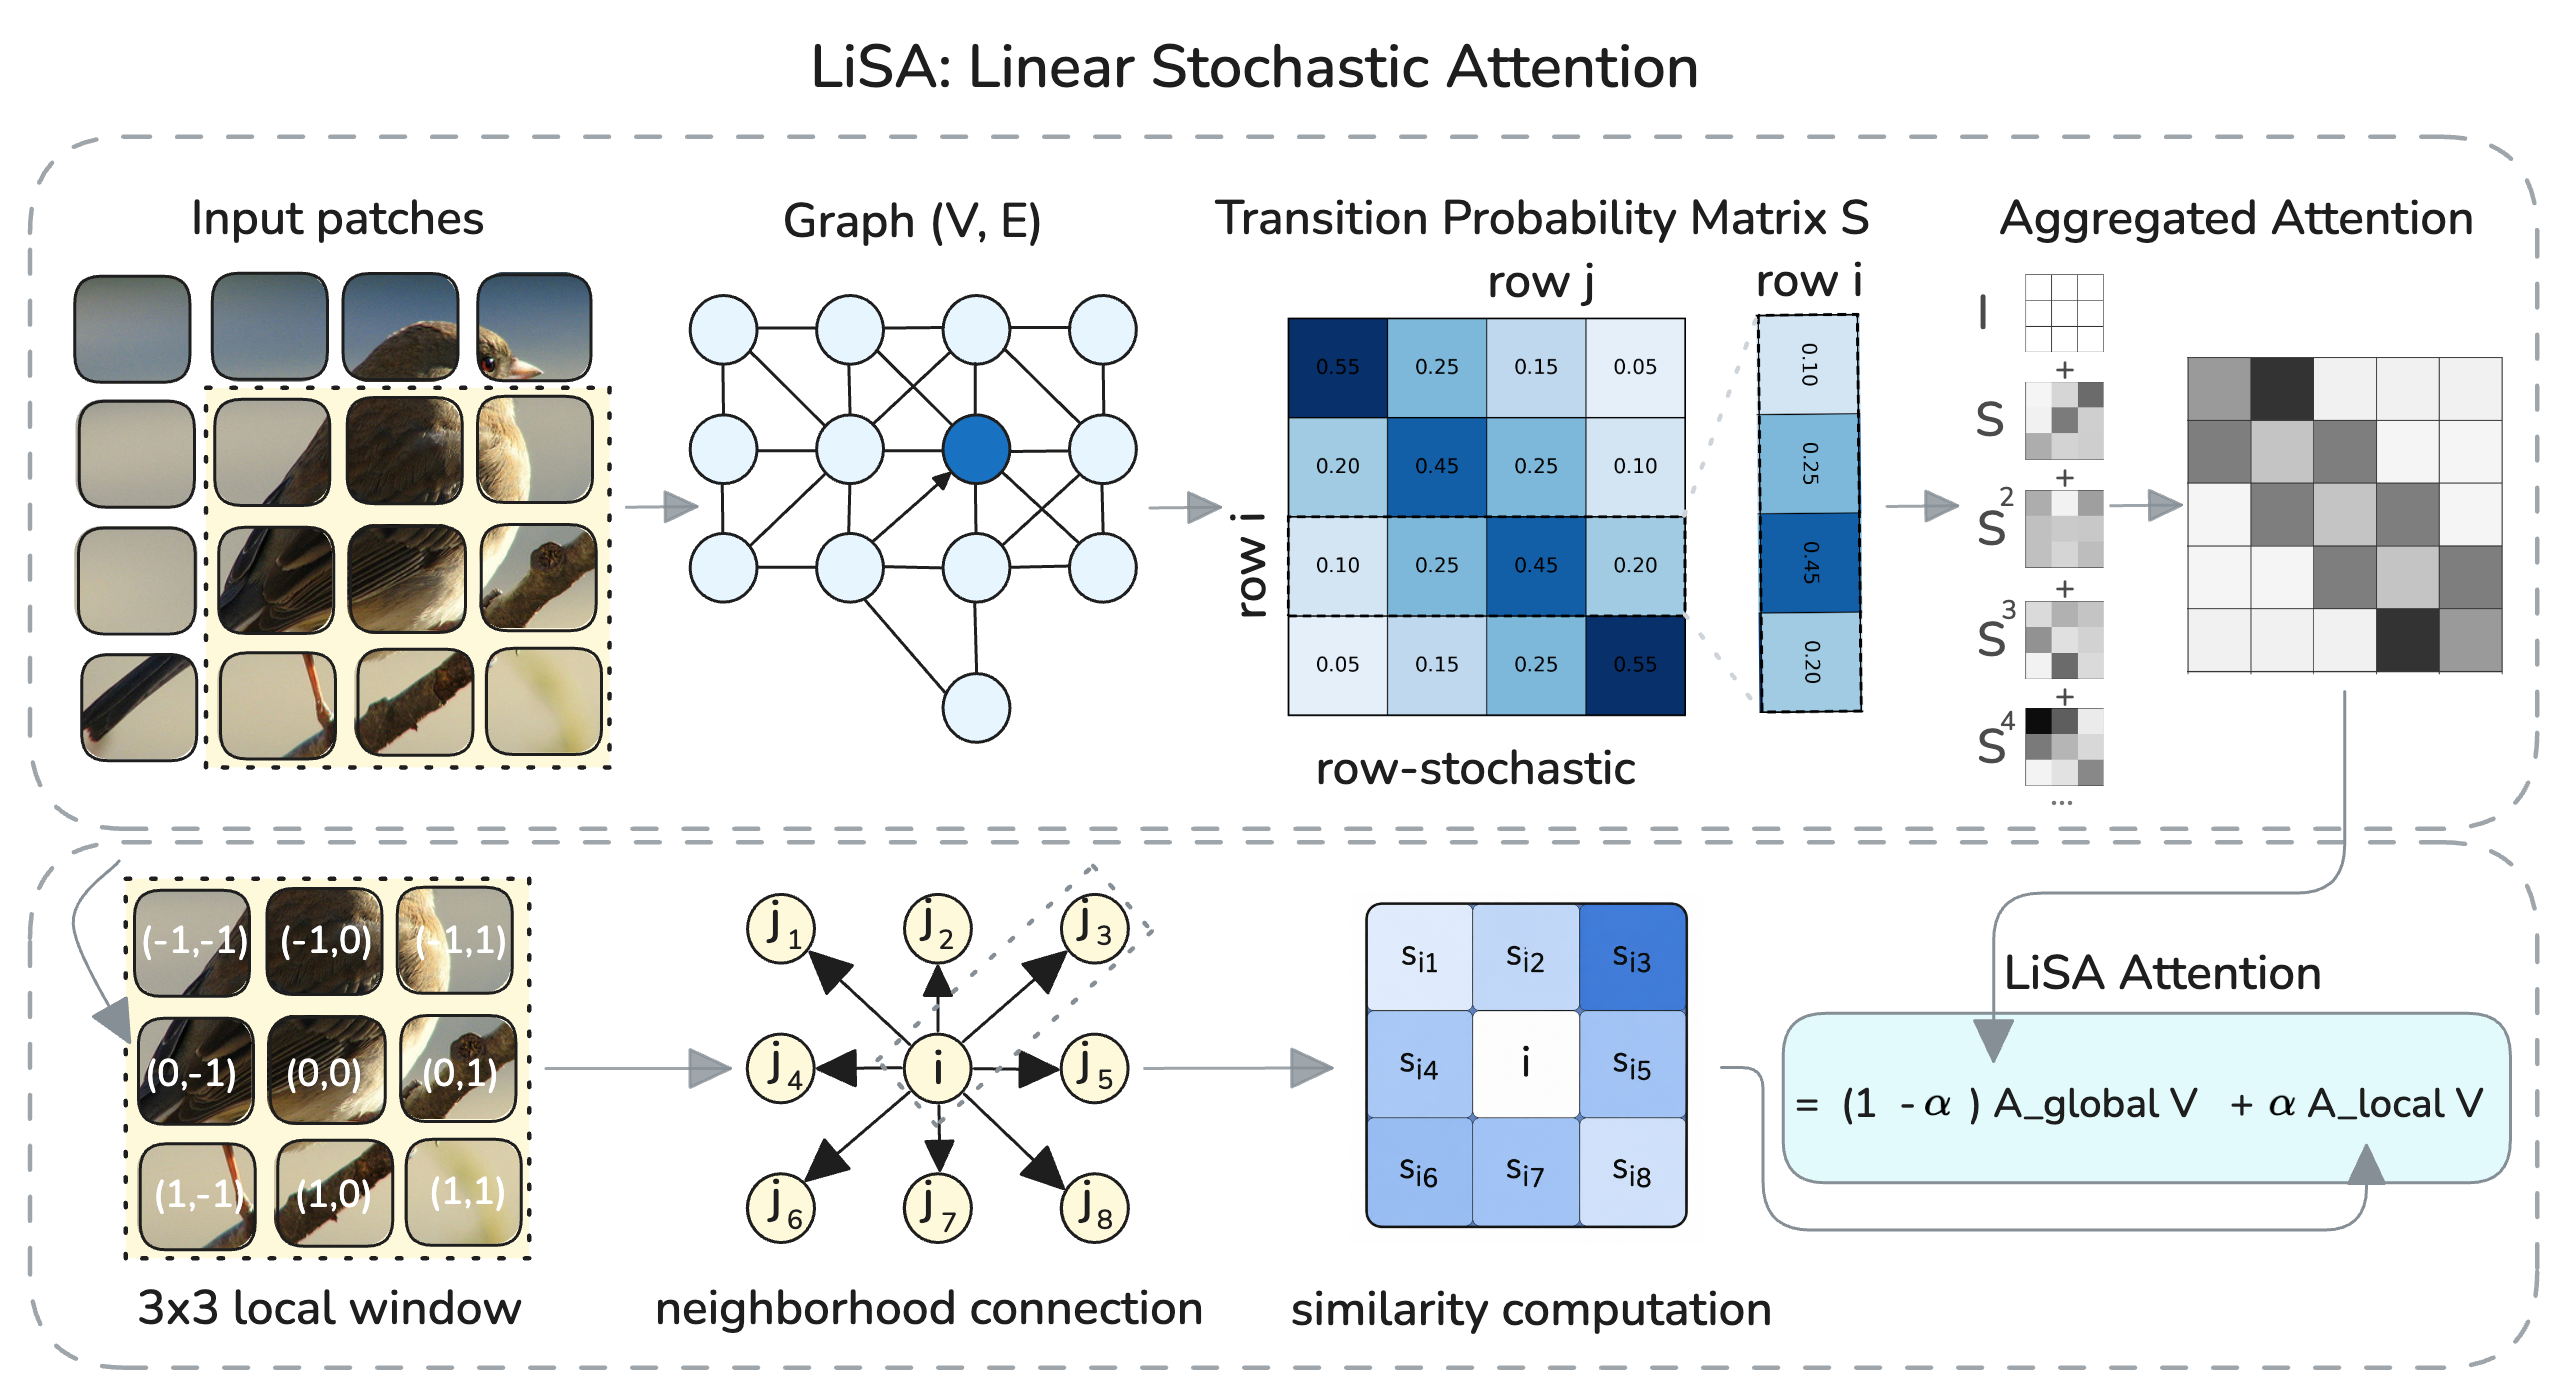
图 2 为论文原 Fig. 2(PDF p. 4)。上半部由相似度得到全局转移矩阵并汇总 \(S,S^2,\ldots\);下半部将局部邻域相似度形成局部注意力,最后按 \(\alpha\) 融合。
2.5 随机游走截断命题的解释边界
补充材料证明:若 \(S\) 行随机,\(\|S^k\|_1=n\)(这里是所有元素绝对值之和),则无限级数中 \(k\ge T\) 的未归一化尾项满足 \(\|R_T\|_1=n\beta^T\),随 \(T\) 指数衰减(Supp. Sec. 6,PDF p. 11)。
需要区分这个尾项与正文 Eq. 4 的有限步概率矩阵:Eq. 4 把前 \(T\) 项乘以 \(1/(1-\beta^T)\) 重新归一化,而补充证明的 \(R_T\) 是无限级数中直接省略的尾部。因而 \(n\beta^T\) 精确界定的是未归一化尾项,不能直接当作“归一化 \(P^{(T)}\) 与 \(P^{(\infty)}\) 之差”的界。
三:实验
| 任务 | 数据和模型 | 训练/比较设定 | 主要指标 |
|---|---|---|---|
| 分类 | ImageNet-1K;DeiT、PVT、Swin、BiFormer | DeiT/PVT/Swin 主实验 \(T=3\);300 epochs,从头训练,AdamW,8 张 A100/H100;与原 self-attention 和 FLatten 比较 | Top-1 accuracy,越高越好 |
| 语义分割 | ADE20K;Semantic FPN、UPerNet,PVT/Swin/BiFormer 骨干 | ImageNet-1K 预训练骨干;遵循 PVT 或 Swin 基线配置 | mIoU、mAcc,越高越好 |
| 检测与实例分割 | COCO;Mask R-CNN,PVT-T 和 Swin-T | ImageNet 预训练;1× schedule;报告 1280×800 输入 FLOPs | box AP、mask AP 及 AP50/AP75,越高越好 |
| 消融 | DeiT-T/S;默认说明为 mini-ImageNet,\(T=5\) | 比较截断深度、全局/局部融合和 FLatten 辅助组件 | Top-1;截断深度实验报告 3 次运行均值±标准差 |
主实验训练方案给出 300 epochs 和 8 张 A100/H100;正文没有在同一处逐项列出所有下游微调超参数。COCO 使用 1× schedule,ADE20K 分别沿用 PVT 与 Swin 配置(Sec. 4,PDF pp. 5–7)。
四:结果
4.1 ImageNet:提升取决于骨干和输入分辨率
下表的差值是 Top-1 百分点,不是相对百分比。主实验使用 \(T=3\);表中 FLOPs/参数也随分辨率或骨干变化(Table 1,PDF p. 6)。
| 骨干/输入 | Self-attention | FLatten | LiSA | LiSA 对 SA / FLatten |
|---|---|---|---|---|
| DeiT-T,224 | 72.20 | 74.10 | 74.54 | +2.34 / +0.44 |
| DeiT-T,384 | 74.90 | 76.53 | 77.54 | +2.64 / +1.01 |
| DeiT-S,224 | 79.80 | 80.10 | 80.78 | +0.98 / +0.68 |
| PVT-T,224 | 75.10 | 77.80 | 78.53 | +3.43 / +0.73 |
| PVT-S,224 | 79.80 | 81.70 | 81.96 | +2.16 / +0.26 |
| Swin-T,224 | 81.30 | 82.10 | 82.25 | +0.95 / +0.15 |
PVT-T 的绝对增益最大,而已有层级/局部结构的 Swin-T 增益较小。DeiT-T 在 384² 输入下,LiSA 比原 SA 少 FLOPs(3.75G 对 4.70G),同时比 FLatten 高 1.01 个 Top-1 点。BiFormer 上也有迁移:T/S/B 从 81.4/83.8/84.3 提高到 82.4/84.1/85.0(Table 2,PDF p. 6)。
线性注意力消融表在 DeiT-S 上给出 LiSA 80.78%,高于 FLatten 80.1%、线性角度注意力 79.21%、原始 SA 79.8% 等对照(Table 5,PDF p. 7)。这些结果支持 LiSA 可作为不同线性注意力设计上的插件;它们并不意味着每种模型或配置都会得到同样幅度的提升。
4.2 ADE20K:PVT-T 提升明显,Swin 的 mAcc 有取舍
| 骨干/解码头 | 方法 | FLOPs | mIoU | mAcc |
|---|---|---|---|---|
| PVT-T / Semantic FPN | PVT | 158G | 36.57 | 46.72 |
| FLatten | 169G | 37.21 | 48.95 | |
| LiSA | 170G | 40.85 | 51.75 | |
| Swin-T / UPerNet | Swin | 945G | 44.51 | 55.61 |
| FLatten | 946G | 44.82 | 57.01 | |
| LiSA | 947G | 45.03 | 56.40 |
PVT-T 上 LiSA 相对原 PVT 提高 4.28 mIoU 点和 5.03 mAcc 点,FLOPs 与 FLatten 接近。Swin-T 的 mIoU 和 mAcc 均高于原 Swin(分别 +0.52、+0.79),但相对 FLatten,mIoU 仅高 0.21,mAcc 低 0.61。因而论文摘要所说的跨任务改进在这个设置下不能概括成所有指标都优于 FLatten(Table 3,PDF p. 6)。BiFormer-S 的 mIoU 从 48.9 到 49.5(Table 2,PDF p. 6)。
4.3 COCO:PVT 检测增益高于 Swin
| 骨干 | FLOPs | box AP:基线 → LiSA | mask AP:基线 → LiSA | 绝对增益 |
|---|---|---|---|---|
| PVT-T | 240G → 245G | 36.7 → 40.5 | 35.1 → 37.6 | +3.8 / +2.5 |
| Swin-T | 267G → 269G | 43.7 → 44.5 | 39.8 → 40.3 | +0.8 / +0.5 |
比较使用 Mask R-CNN、1× schedule 和 1280×800 输入。PVT-T 的 AP50/AP75 提升也较大:box AP50 +3.7、box AP75 +4.8;mask AP50 +3.0、mask AP75 +2.9。Swin 的对应提升较小(Table 4,PDF p. 7)。
4.4 消融:多跳、融合与新增组件分别贡献什么
截断长度。 DeiT-T 的 \(T=1,2,3,4,5\) Top-1 均值分别为 73.34、75.43、75.63、75.16、75.73;标准差为 0.64、0.56、0.39、0.13、0.47,均来自 3 次运行。相对一跳 \(T=1\),多跳设置均更高;\(T=3\) 与 \(T=5\) 接近。作者因此将主实验设为 \(T=3\),将计算开销较大的消融设为 \(T=5\)(Fig. 3,PDF p. 7)。这组数字在消融上下文中报告,不能直接与 ImageNet 主表 74.54% 混作同一训练配置。
全局/局部融合。 DeiT-T 上只用全局为 73.7%,只用局部为 73.4%,学习融合 \(\alpha\) 后为 76.3%;DeiT-S 分别为 78.3%、78.1%、80.7%(Table 6,PDF p. 7)。局部支路单独表现略低,但与全局支路组合带来最高结果。
区分 LiSA 核心与 FLatten 的 F/D 组件。 作者把所提全局-局部核记为 GL,把 FLatten 的 focusing 和 depthwise-convolution 组件记为 F、D,并在两种核心上都一致添加:
| 核心/组件 | LA | GL(LiSA) |
|---|---|---|
| 无附加组件 | 65.7 | 69.2 |
| +F | 65.9 | 69.3 |
| +D | 73.3 | 75.2 |
| +F+D | 74.4 | 76.3 |
GL 在每一组对照下都高于 LA,支持增益来自 LiSA 的高阶全局-局部算子,而非只因复用了 FLatten 组件(Table 7,PDF p. 8)。
4.5 定性注意力与实际效率
论文图像展示了 vanilla 线性注意力较分散的响应,以及 LiSA 响应在同一物体区域内更集中。对鸟图像的逐步可视化中,局部支路只影响查询 patch 周围;LiSA 随 \(T=3,5,7\) 增大,把响应传播到更远的鸟身与尾部。它是机制示意证据,并非单独的定量准确率测量(Fig. 4,PDF p. 8)。
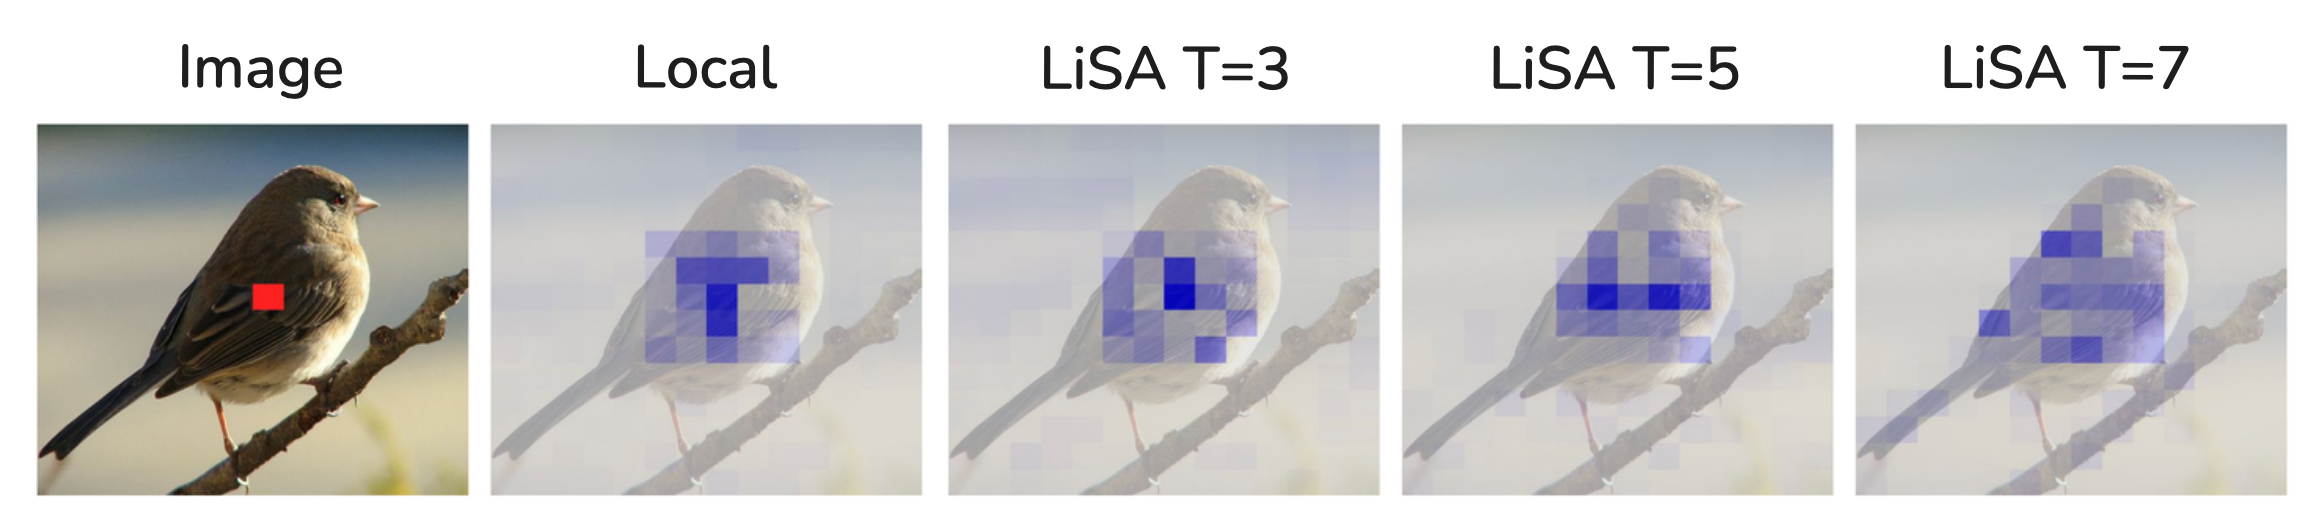
原 Fig. 4b(PDF p. 8)。较大的 \(T\) 扩大响应覆盖,也说明传播深度是需要选择的设计参数。
在补充材料 Table 13(PDF p. 13)中,序列长度 16,385(输入 2048²)时,DeiT-T、FLatten、LiSA 的延迟分别为 898.92、91.84、161.71 ms;峰值显存为 50,281.7、1,605.2、3,409.1 MB。LiSA 相比 softmax DeiT-T 延迟约低 5.6 倍、显存约低 14.8 倍,但比 FLatten 慢约 1.76 倍、显存约高 2.12 倍。短序列时 LiSA 也有额外开销:197 token 下三者延迟为 3.50、7.15、13.53 ms(按 DeiT-T、FLatten、LiSA 顺序)。因此结果说明高分辨率下仍可保持线性内存趋势,并不代表 LiSA 比所有线性基线更快。论文未在该效率表附近说明 GPU 型号和 batch size,跨平台的绝对毫秒数需谨慎比较。
五:结论与讨论
LiSA 的关键机制是:先把核化 query–key 相似度归一化成转移概率,再用短随机游走显式聚合多跳关联,并通过低秩因子避免构造 \(n\times n\) 注意力矩阵;局部窗口负责减轻过平滑。结果显示它在 PVT-T 和高分辨率 DeiT-T 上的收益明显,在 COCO PVT-T 上也有较大的 AP 提升。对已有层级和局部建模能力较强的 Swin,收益较小;ADE20K Swin 的 mAcc 下降,且在超长序列上速度落后于 FLatten。
实际取舍主要由截断长度和骨干决定:\(T\) 增大能扩大路径范围,但增加递推工作,并可能过平滑;主结果使用 \(T=3\),较深的 \(T=5\) 在消融中只略高。补充材料把 over-smoothing 列为失败模式,并指出短序列上 \(O(Td_h^3)\) 额外项更难摊薄(Supp. Secs. 9–10,PDF p. 12)。在 ADE20K Swin-T 上,LiSA 的 mAcc 高于原 Swin,但低于 FLatten。作者下一步计划扩展到更多线性注意力变体和训练方案。当前作者代码仓库仍只有说明页,尚不能从公开实现复核实验。