SparseGDN: Chunk Sparse in Linear Attention:中文研读笔记
- 作者:Jiedong Zhuang、Peng Zhao、Jialin Tang、Haoji Hu;浙江大学、ByteDance。
- 原文:arXiv:2610.41420v1,2026-10-30 提交;本地 PDF。获取与研读日期:2026-11-03。以下页码均从 PDF 第 1 页开始计数,与正文印刷页码一致。
- 发表:未查到正式发表信息(截至 2026-11-03);arXiv 记录未列出会议、期刊或录用声明。
- 代码:未查到公开代码(截至 2026-11-03);论文及 arXiv 页面未提供可核实的实现链接。
- 配套汇报:英文幻灯片 PDF · 可编辑 TeX。
论文总览
SparseGDN 的核心是把 Gated Delta Network(GDN)的预填充拆成“便宜地处理所有 token”和“有选择地维护长期状态”:chunk 内只保留邻近块的 Delta 求解系数,chunk 间只执行被选中的循环读写,再通过紧凑状态与两 chunk 局部读取重建所有 token 的输出。 这是对已有模型的推理算子与 GPU 执行流程的改造,预训练权重保持固定。
GDN 虽然对序列长度具有线性复杂度,但实际预填充仍要反复构造读修正矩阵、执行状态更新、保存并读取中间状态。SparseGDN 将一个“相邻 value-head 对 × 一个 64-token chunk”定义为循环事件,默认平均保留约 29% 的事件。它用尾部变换值、衰减所决定的记忆寿命和输出门能量估计事件价值,在执行循环更新之前完成选择。
在 Qwen3.5-4B、Qwen3.5-9B 的 13 项 RULER 任务、4K–128K 上下文上,默认配置的聚合分数分别变化 +0.017、−0.115 个百分点;相对原生 FLA,包含在线选择的 24 层 GDN 核心预填充获得约 1.50–1.94 倍加速。完整模型的峰值显存另行测量:128K 时,两种规模都节省 26.222 GB。理解这些结果的关键是区分算子近似、执行优化,以及质量、核心延迟、完整模型显存三种实验口径。(Secs. 2–3;Table 1,PDF p. 12;Table 7,p. 20。)
结构地图
| 原文章节 | 主要问题 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 线性复杂度为何仍慢;状态异质性与系数局部性 | pp. 2–3;Fig. 2;总延迟 Fig. 1 在 p. 1 |
| 2.1 Dense GDN Prefill | 稠密状态修正、更新与输出 | p. 4;Eqs. (1)–(4) |
| 2.2 Method Overview and Approximation Boundary | 哪些步骤改变算子,哪些仅改变执行 | p. 4;流水线 Fig. 3 在 p. 3 |
| 2.3 Block-Adjacent Intra-Chunk Computation | 用七个 16×16 块近似局部逆矩阵 | pp. 5–6;Eqs. (5)–(9) |
| 2.4 Dynamic Event Selection | 排序、预算升级收益、动态档位数量 | pp. 6–8;Eqs. (10)–(14)、Fig. 5 |
| 2.5 Deferred Update Materialization and Event Layout | 延后构造 W、CSR 压紧事件 | pp. 8–9;Eqs. (15)–(16) |
| 2.6 Event-Sparse Recurrent Propagation | 跳过读写但保留衰减 | pp. 9–10;Eqs. (17)–(21)、Fig. 6 |
| 2.7 Mapped Group-Wise Output Reconstruction | 稀疏状态如何产生所有 token 的输出 | pp. 10–11;Eqs. (22)–(25) |
| 3.1 Experimental Setup | 模型、数据、精度与计时范围 | p. 12;Eqs. (26)–(27) |
| 3.2 Main Results | 默认配置的质量与核心加速 | pp. 12–13;Table 1、Fig. 7 |
| 3.3 True-Sparse Batch Scaling | batch 2/4/8 的速度及 OOM | p. 14;Fig. 8、Table 2 |
| 3.4 Accuracy–Efficiency Trade-off | 不同保留预算的折中 | pp. 15–16;Table 3、Fig. 9 |
| 3.5 Algorithmic and Selector Ablations | 近似、随机选择、寿命、可见性、档位与尾窗 | pp. 15–18;Tables 4–5、Fig. 10 |
| 3.6 Kernel-Pipeline Ablations | 稀疏性怎样转化为执行收益 | pp. 18–19;Table 6 |
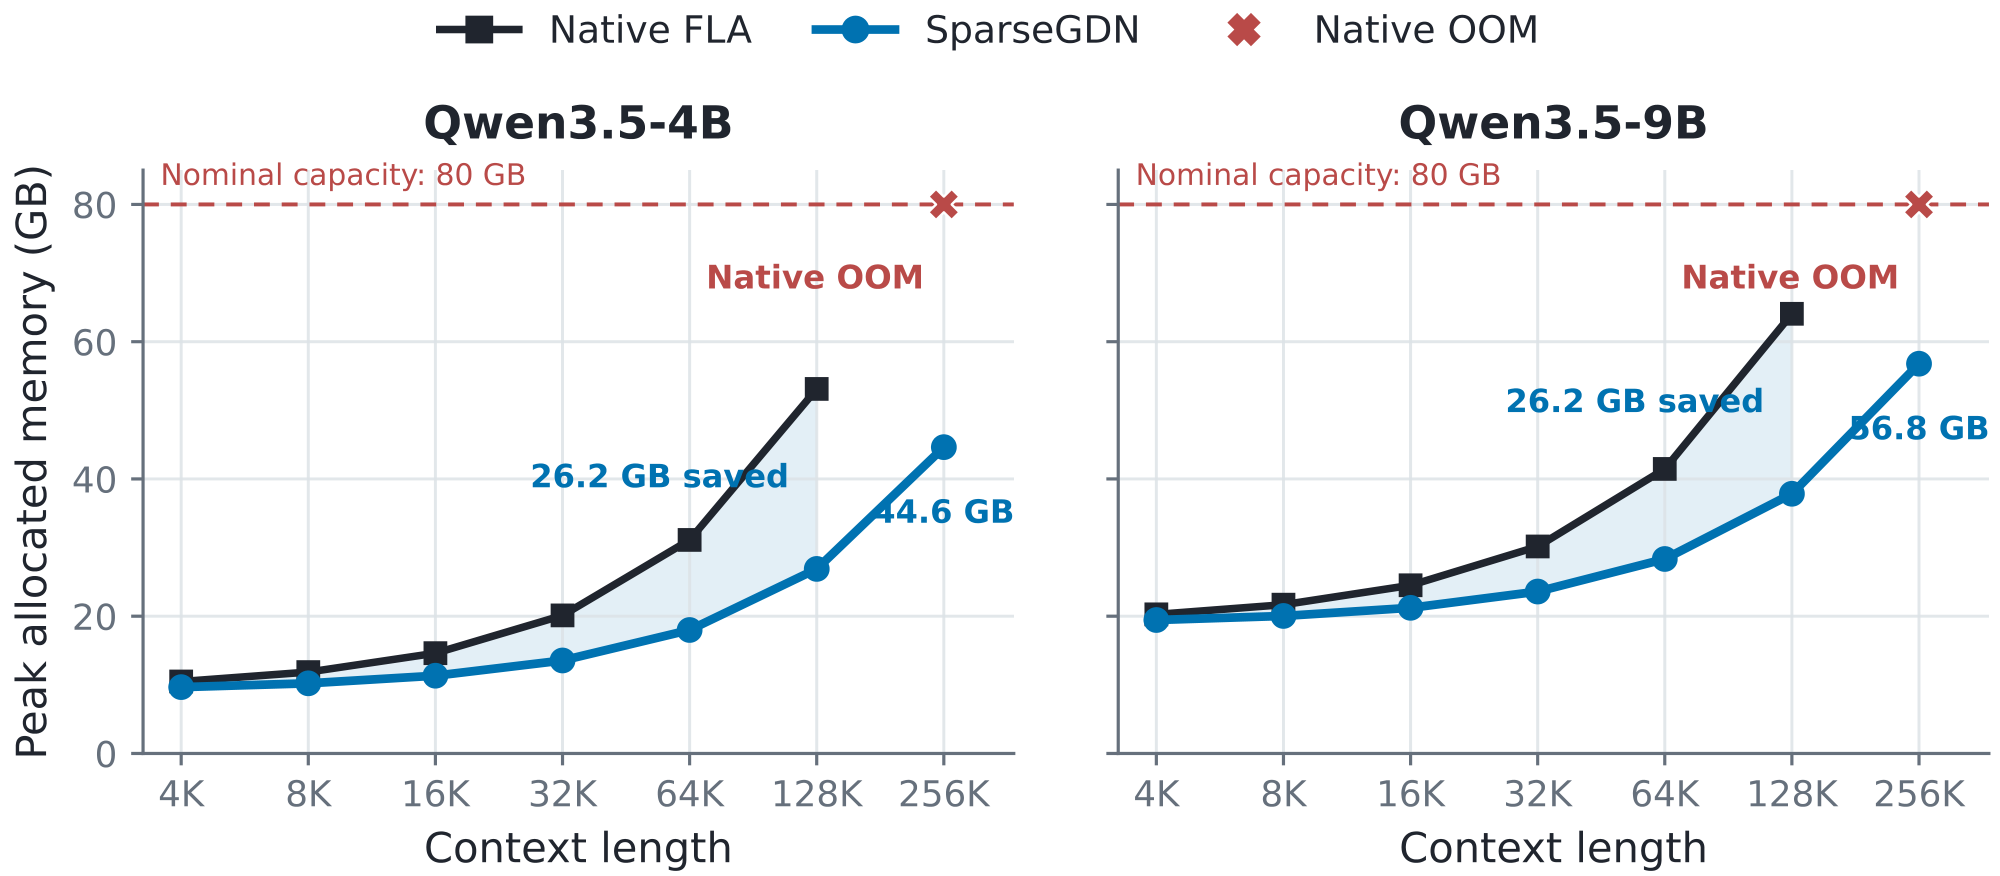
| 3.7 Peak-Memory Scaling | 完整模型预填充的峰值与增量显存 | pp. 19–20;Fig. 11、Table 7 |
| 4 Conclusion and Limitations / 5 Related Work | 选择器局限与工作定位 | pp. 20–21 |
一:动机——线性复杂度之内仍有大量冗余
1.1 目标是已有 GDN 的长上下文预填充
预填充(prefill)需要一次处理整个输入提示,建立后续生成需要的状态。GDN 用固定大小的矩阵状态汇总历史,避免 softmax attention 随历史增长的两两交互;但 chunkwise 实现仍对每个 chunk、每个 value head 执行局部 Delta 求解、历史状态修正、矩阵写入及状态存取。SparseGDN 保持相同的线性渐近复杂度,削减其中的计算与访存常数。
它选择的是循环事件。一个事件包含同一 chunk 上、共享 query/key head 的两个相邻 value heads;两个 head 共用事件掩码,却分别维护状态。所有 token 都继续经过局部计算并得到输出。这个粒度与矩阵乘和状态布局相匹配,是算法选择与硬件实现之间的接口。(Secs. 1、2.1–2.2,PDF pp. 2–4。)
1.2 两种观察支持两层稀疏化
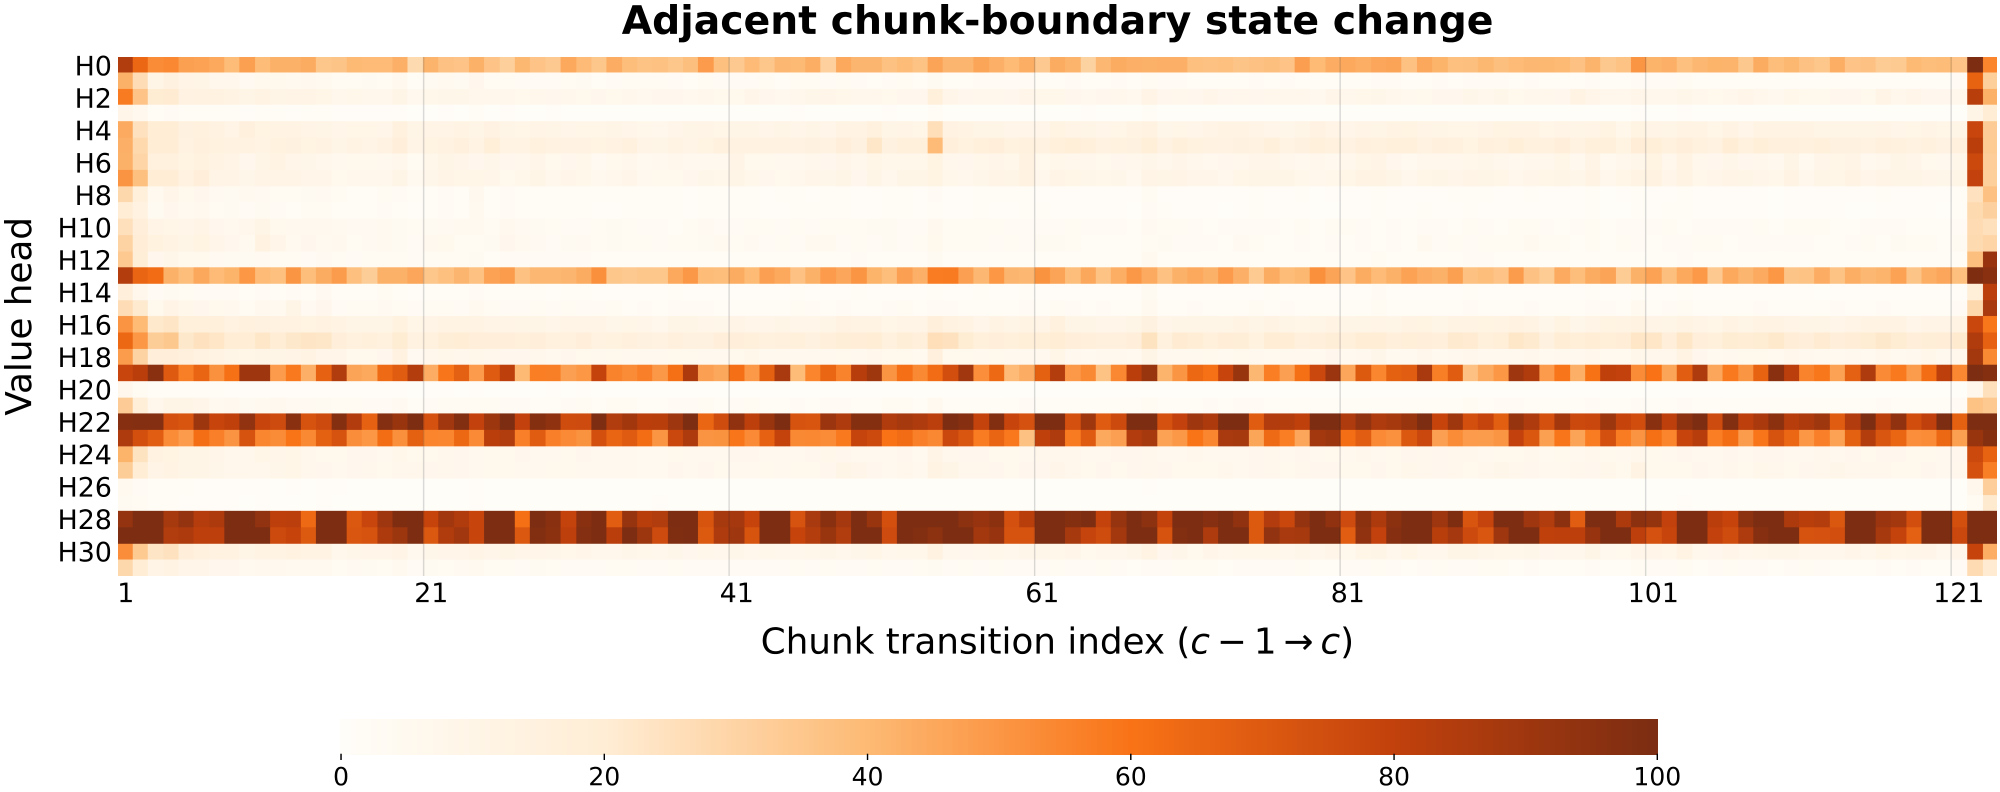
原文 Fig. 2a,PDF p. 2。横轴是 chunk 边界转换,纵轴是 value head,深色表示更大的相对状态变化。作者在 Qwen3.5-4B 第 16 层、一个 8K RULER 输入上定义
这一样本中,中位变化为 6.56%,63.8% 的 head–chunk 转换低于 10%,相邻状态余弦相似度中位数为 0.9979;32 个 heads 中有 21 个的中位变化低于 10%。同时,少量 heads 持续大幅变化。这使“为不同 head 分配不同保留预算”比统一跳步更有依据。状态变化小只是选择策略的动机;实际保留效果由后续质量实验检验。
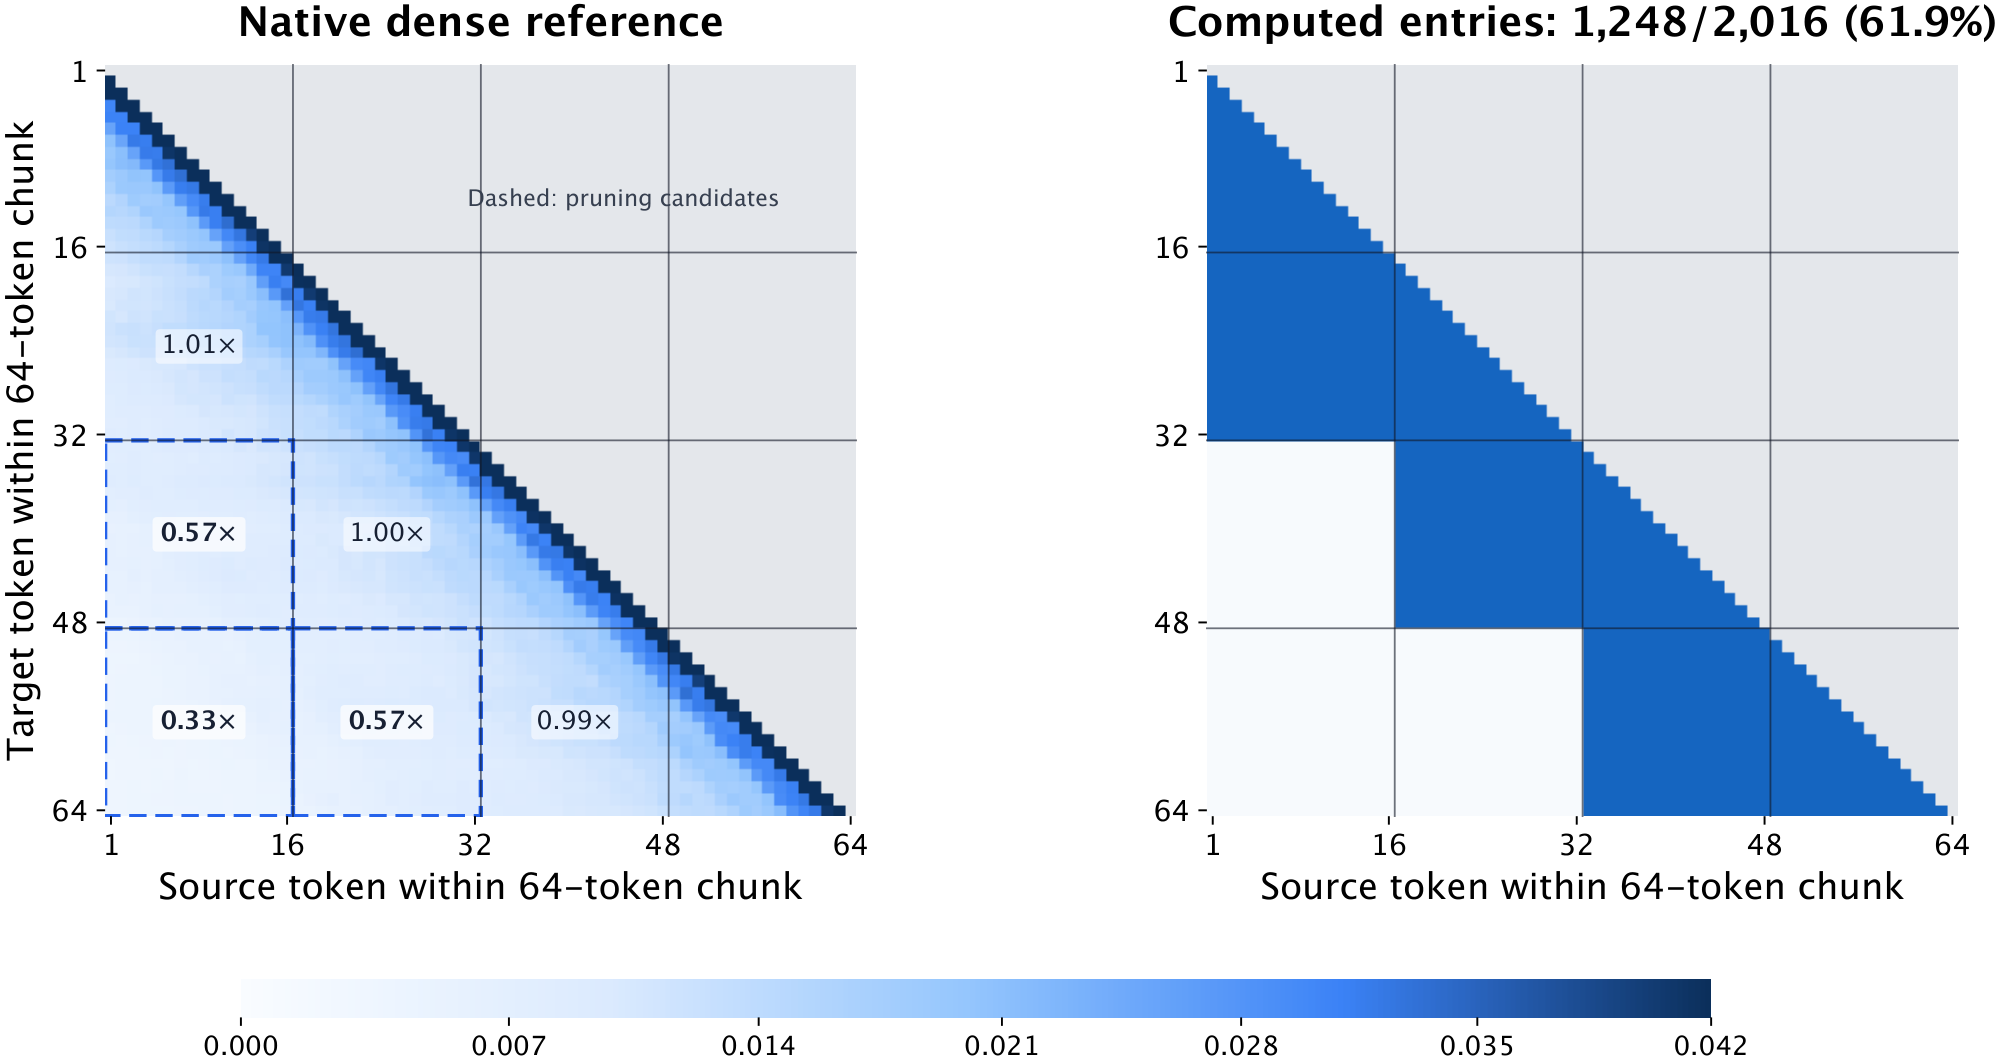
原文 Fig. 2b,PDF p. 2。两轴分别为同一 64-token chunk 内的目标和来源位置。左图是去除单位对角后、对 123 个完整 chunk 和 32 个 heads 平均的 $|M^{-1}-I|$;系数在因果对角附近更强,跨越更远的 16-token 块时减弱。右图是拟保留的对角和紧邻下对角块。它支持把局部求解做成块邻接近似,与跨 chunk 的动态选择相配合。
二:方法——从稠密状态更新到稀疏事件流水线
2.1 先读懂稠密 GDN 在算什么
原文省略 batch 维。$Q,K\in\mathbb R^{T\times N_q\times d}$,$V\in\mathbb R^{T\times N_v\times d_v}$。两个被测模型都使用 $N_q=16$、$N_v=32$、$d=d_v=128$,每个 query/key head 由两个相邻 value heads 共享。序列切成 $L=64$ 的 chunks;以下固定一个 value head,必要时省略 $h$。
| 符号 | 含义及局部维度 |
|---|---|
| $S_{c,h}$ | 进入 chunk $c$ 前的历史状态,$d\times d_v$ |
| $U_{c,h}$ | 局部 Delta 求解得到的变换值,$64\times d_v$ |
| $W_{c,h}$ | 读取历史状态的修正矩阵,$64\times d$ |
| $U'_{c,h}$ | 经历史状态修正后的值,$64\times d_v$ |
| $g_{c,h,i}$ | 从 chunk 起点到位置 $i$ 的累计保留门,使用以 2 为底的对数 |
| $\gamma_{c,h}$ | chunk 末端累计对数保留率,即 $g_{c,h,63}$ |
| $A_{c,h}$ | chunk 内带衰减的因果 query–key 交互,$64\times64$ |
稠密循环先扣除历史状态已解释的部分,再写入新的残差信息:
$\odot$ 将每个 token 的门值广播到特征维度。第一项让旧记忆衰减;第二项把修正后的值写入 key 所对应的方向。越早的 token,在抵达 chunk 边界前经历的衰减越多。
输出则结合历史读取与本地交互:
这里的 $O$ 是 RMSNorm、模型输出门和输出投影之前的 GDN-core 输出。这个位置也界定了后面的性能测量。(Sec. 2.1,PDF p. 4,Eqs. (1)–(4)。)
2.2 完整流程与近似边界
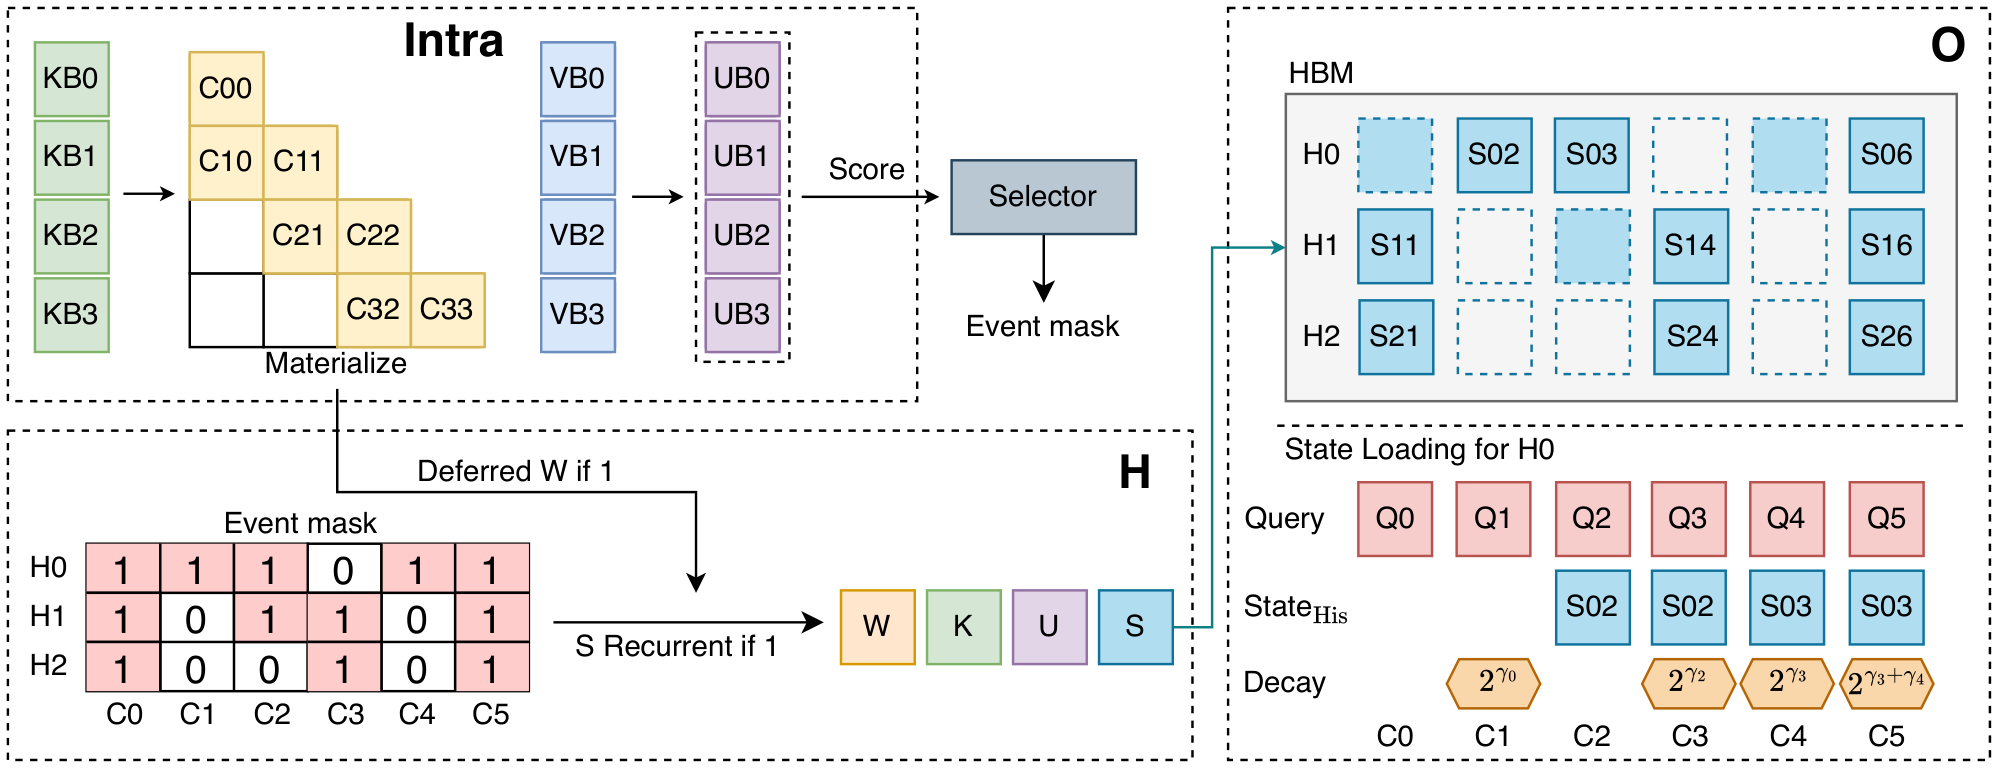
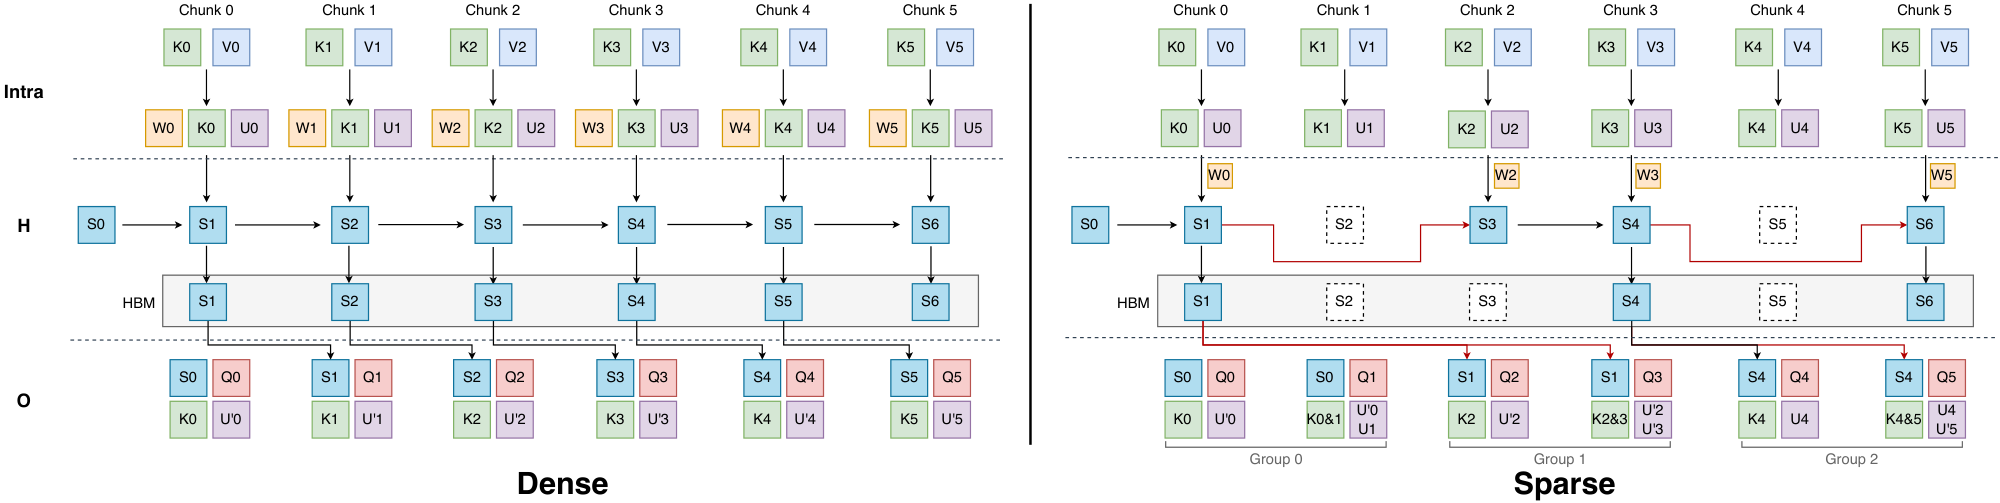
原文 Fig. 3,PDF p. 3。由左向右读:Intra 处理所有 chunks,产生 $U$、紧凑系数和分数;Selector 产生事件掩码;Deferred-$W$ 仅为选中事件构造 $W$;$H$ 执行稀疏状态传播并保存必要快照;$O$ 根据快照、衰减和两 chunk 内的局部项生成完整输出。
其中,块邻接求解、事件选择和两 chunk 的输出规则共同定义了一个近似算子。延后构造、CSR 扫描、紧凑状态和映射读取则是这个算子的执行优化。这样区分,才能理解后面哪些消融检验质量,哪些消融在保持算子行为的条件下检验速度。(Sec. 2.2,PDF p. 4。)
2.3 块邻接求解:保留逆矩阵中的七个块
令 $\beta_t$ 为 token 更新强度。稠密局部 Delta 系统为
$M$ 是单位下三角矩阵。作者把它划成四个连续的 16-token 块,用 $C$ 近似 $M^{-1}$,只保留
对角块与相邻块分别为
在精确算术下,这七个块等于完整逆矩阵的对应块;近似来自把更远的下三角块置零。它保留 2,016 个因果非对角元素中的 1,248 个,即 61.9%。这个比例描述求解系数支撑,不能直接作为整个算子的 FLOPs 比例。
再构造两套加权系数:$\widetilde C_{ij}=C_{ij}\operatorname{diag}(\beta_j)$ 用来生成 $U$,$\overline C_{ij}=C_{ij}\operatorname{diag}(\beta_j\odot2^{g_j})$ 用来生成 $W$。例如
第 0 块只有自身项。$U$ 分块逐步计算,减少同时存活的累加 tile;$\overline C$ 的七个块暂存,供选择后构造 $W$。(Sec. 2.3,PDF p. 5,Eqs. (5)–(8)。)
2.4 选择信号:写入强度、记忆寿命、输出可见性
先在每个 head 对内部排序 chunks。 Intra 的最后一个 16-token tile 还在片上时,计算
尾部 token 到 chunk 边界的衰减较少,且 $U$ 已包含更新强度和保留的 Delta 交互,所以 Tail-16 是一种廉价的候选写入强度信号。按 head 分别归一化后再平均,避免一对 heads 中量级更大的一方完全控制排序。它在执行 $WS$ 之前可得;实际写入还依赖 keys、衰减和 $U-WS$,因此这只是排序代理。(Eqs. (9)–(10),PDF pp. 5、7。)
再估计给某个 head 对更多预算的收益。 每个 head 的 $r_h$ 取最后至多 16 个有效 chunks 的平均末端保留率 $2^{\gamma_{c,h}}$,并定义
$C=\lceil T/64\rceil$。$L_h$ 用常数保留率下的几何和估计记忆寿命;它只建模门衰减,没有建模后续 Delta 更新对旧信息的修改。$\eta_h$ 是对预激活输出门 $Z$ 抽样后,经 SiLU 和学习到的 RMSNorm 缩放得到的平均平方能量;$G_h$ 衡量该 head 相对于本层平均值的输出可见性。
抽样在每个 chunk 的位置 8、24、40、56 进行,每次只读取一个轮换的 value 坐标:$v_{c,a}=73(4c+a)\bmod d_v$。这些量来自层输入投影和门值,均可在循环传播前获得。
令 $\mathcal C_a\subseteq\mathcal C_b$ 为较低、较高预算保留的 chunks 集合,则升级收益代理为
这里使用未归一化的 $s$,保留不同 head 对之间的强度差异;与“同一 head 对内部”的排序用途不同。(Sec. 2.4,PDF pp. 7–8,Eqs. (11)–(12)。)
2.5 动态预算:先选择高档,再选择中档
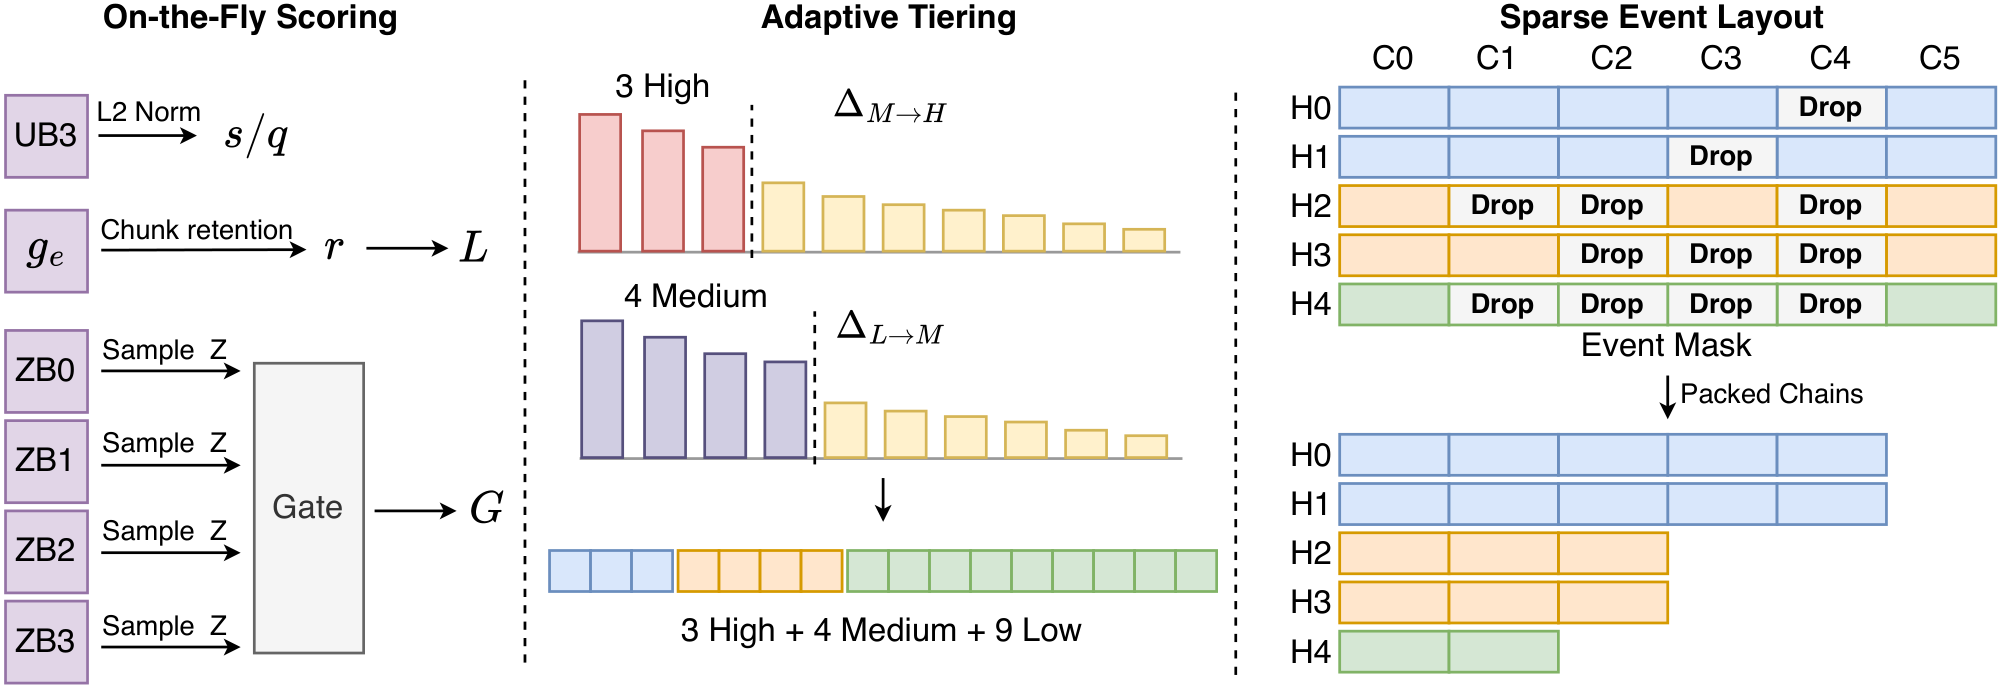
原文 Fig. 5,PDF p. 7。从左到右依次是廉价统计量、档位分配、按时间压紧的事件链。每个 head 对的三个候选保留率为
首尾两个有效 chunks 是必选锚点,其余 $k_\ell-2$ 个按 $q_c$ 选择;因此三个候选集合嵌套。$C=1$ 时直接保留唯一 chunk。
对 16 个 head 对分别计算 $L\to M$、$M\to H$ 收益,并各自除以跨 head 对的均值,得到 $x_M,x_H$。对降序收益向量 $x$,作者用
衡量切分后高低收益两组的分离程度。先在 $n_H\in\{1,2,3,4\}$ 中选择最佳高档数量,再在其余 head 对上选择中档:
| 高档数量 $n_H$ | 中档候选数量 $n_M$ |
|---|---|
| 1 | 11、12、13 |
| 2 | 7、8、9 |
| 3 | 3、4、5 |
| 4 | 0 |
其余为低档。候选设计把名义平均保留率限制在约 28.44%–31.31%,实际值还取决于档位选择、整数舍入与锚点。Fig. 5 中的 9 低/4 中/3 高只是一个示例;默认算法动态决定数量。掩码 $z_c=\mathbb I[c\in\mathcal C_\ell]$ 由一对 value heads 共用。(Sec. 2.4.3,PDF p. 8,Eqs. (13)–(14)。)
2.6 延后 W 与 CSR:不要先算完再丢弃
选中事件才执行
这样减少的不只是后续状态更新,还包括原本为所有事件构造 $W$ 的工作。事件按压缩稀疏行(compressed sparse row,CSR)布局:一行对应一个 head 对,行内按 chunk 时间排序;行间按高、中、低档位排序,让长事件链优先调度。元数据保存物理 head 对映射、每行起止偏移、事件 chunk 索引、每个输出组对应的前驱事件,以及各 head 的对数衰减前缀。
有效事件数为 $E=\sum_\ell n_\ell k_\ell$。但 $W$ 缓冲按 $E_{\max}=16k_H$ 的容量预分配,实际 $E$ 由 GPU 上的末端 CSR 偏移给出,避免为动态分配而把计数拷回主机。因此,约 29% 的有效事件数并不表示所有缓冲容量也降为稠密的 29%。(Sec. 2.5,PDF pp. 8–9,Eqs. (15)–(16)。)
2.7 稀疏递推:跳过写入,仍让历史正常衰减
选中事件执行原来的读修正与状态写入;未选中事件定义为
因此,跳过事件同时省略 $W_{c,h}S_{c,h}$ 和新内容写入,历史衰减保留。为避免循环扫描所有被跳过的 chunks,定义
若相邻两个保留事件是 $e 指数恰好覆盖 $e+1,\ldots,c-1$ 的被跳过 chunks;若两个保留事件相邻,间隙衰减为 1。$U$ 缓冲原地复用:选中事件改写为 $U'$,其余保持 $U$。只保存后续输出组会引用的中间状态快照,最终 $S_{C,h}$ 单独返回给后续自回归解码。(Sec. 2.6,PDF pp. 9–10,Eqs. (17)–(21)。) 原文 Fig. 4,PDF p. 6。左侧逐 chunk 存储状态;右侧仅处理被选中的循环事件,红箭头跨过空隙并累计衰减。输出按 $(c,c+1)=(2r,2r+1)$ 组成一组,两个 chunks 共用组入口状态 $S_c$。 找到组前最近的保留事件后,用前缀衰减恢复 $S_c$;没有前驱且预填充初态为零时,组入口也是零。两块输出为 跨块交互为 $A_{c+1,c}[i,j]=\langle Q_{c+1}[i],K_c[j]\rangle2^{g_{c+1,i}+\gamma_c-g_{c,j}}$。因为整个 $c$ 都早于 $c+1$,无需再加三角掩码。不论偶数 chunk 是否写入持久状态,奇数 chunk 的输出都会保留这个相邻局部项。 固定 Intra 结果和事件掩码,与“直接把稀疏状态代入逐 chunk 稠密输出式”的结果 $O^{\mathrm{chunk}}_{c+1}$ 比较,有 这条差分式说明:当 $z_c=1$ 时两种输出代数一致;当 $z_c=0$ 时,组输出额外保留邻块贡献。原文例子跳过 chunk 4、保留 chunk 5:$S_5=2^{\gamma_4}S_4$,$U'_5=U_5-W_5S_5$,但 $O_5$ 仍含 $A_{5,4}U_4/\sqrt d$。这部分没有进入本层持久状态,也没有进入 chunk 5 的循环读修正。 本次分析将其理解为:把“短程局部可见”与“长期记忆写入”解耦,在减少持久更新时维持一条廉价的信息路径。它同时是一项算子设计,后面的 kernel 消融并未单独测量删除这条局部路径的质量影响。(Secs. 2.2、2.7,PDF pp. 4、10–11,Eqs. (22)–(25)。) 两个模型均有 24 个 GDN 层及相同的 head 几何。激活与 tensor-core 输入采用 BF16,循环状态累加和选择统计采用 FP32。方法直接用于已有权重,不增加训练阶段。 原生对照为 FLA 的稠密 GDN。主延迟比较的是 Native 的 Intra+$H$+$O$ 与 SparseGDN 的 Selector+Intra+$H$+$O$。原生构造 $W$ 计入 Intra;稀疏路径的 Deferred-$W$ 计入 $H$。计时排除输入/输出投影、周边预后处理、softmax-attention 层、MLP、tokenization 和自回归解码。因此,主加速比描述核心预填充,质量和显存实验则涉及完整模型的相应行为。 原文列出 PyTorch 2.9.0+cu128、Triton 3.5.0、Transformers 5.9.0;最终正文没有明确 GPU 型号。Fig. 11 以 80 GB 名义容量作参考,不能据此确定加速器型号。固定负载的延迟也不同于对 7,800 个质量请求逐一计时后取平均。(Sec. 3.1,PDF p. 12;Secs. 3.3、3.7,pp. 14、19–20。) 数据来自 Table 1,PDF p. 12。差值沿用原文未舍入分数计算的结果,所以可能与展示分数直接相减相差 0.001。4B 最大绝对变化为 16K 的 +0.341 个百分点;9B 最大下降发生在 8K,为 −0.692 个百分点,其余五个长度的绝对变化均不超过 0.103。聚合接近不意味着每个长度都同样接近。 原文 Fig. 1,PDF p. 1。横轴为上下文长度,纵轴为跨 24 层汇总的核心延迟(ms);灰色为 FLA,彩色为 SparseGDN。4B 在 128K 从 447.97 ms 降到 230.61 ms;9B 对应为 453.34→235.02 ms。更长上下文下,固定启动开销更容易摊薄,减少的循环与状态流量也更多。两种规模相似的加速趋势,与它们相同的 GDN 层数和张量几何相符。(Sec. 3.2,PDF p. 13。) 原文 Fig. 7 上行,PDF p. 13,完整保留三列及坐标、图例。左列比较原生 Intra 和稀疏 Intra+Selector,中列是 $H$,右列是 $O$;越低越好。以 4B、128K 为例: 阶段图报告各阶段的中位数,堆叠柱是分量中位数之和,不宜把其和当成另一种总延迟统计。Intra 的收益包含局部求解减少、逐块计算,以及把 $W$ 构造迁到仅处理选中事件的 $H$;$H$ 减少读修正与状态写入;$O$ 仍计算每个 token 的输出及局部交互,主要通过状态压缩和共享组入口读取获益。因而约 71% 的事件稀疏率自然不会变成约 3.4 倍的整体核心加速。 原文 Fig. 8,PDF p. 14。横轴为长度,纵轴为核心加速比,线条区分 batch 2/4/8。所有完成的 Native–Sparse 配对获得 1.560–1.988 倍加速。固定 batch 时,加速随长度增加;固定长度时,扩大 batch 会让 Native 的单样本延迟下降得更快,缩小相对收益。例如 4B、32K 从 batch 2 的 1.933× 降到 batch 8 的 1.750×;9B 对应为 1.928×→1.748×。 图上的叉号是 Native OOM,画在固定高度以便展示,不是实测加速比。Table 2 的 OOM† 还表示 Sparse 在独立进程验证完成:4B、batch 4/128K 为 843.411 ms,batch 8/64K 为 835.367 ms。其他普通 OOM 条目未独立确认 Sparse 完成,不能都解释成稀疏路径可运行。(Sec. 3.3、Table 2,PDF p. 14。) 来自 Table 3,PDF p. 15。此处加速是六个长度的几何平均,不同于 Table 1 的逐长度加速。每个预算点都会重新计算 head 对档位和 chunk 选择。 原文 Fig. 9,PDF p. 16。横轴越右越快,纵轴是相对基线的分数差,越高越好;标注为实测 keep。约 10% 保留可接近 2.1×,代价是约 2 个百分点的聚合下降;默认点约为 1.72×。在已测聚合指标下,约 49% 的点比约 39% 的点更慢、分数也略低,处于被支配位置。这也说明在混合近似和离散选择下,保留更多事件的聚合分数不必单调提高。 局部近似与事件策略。 Table 4 在完整 4K 集上比较下列方案: 自适应相对匹配预算的随机选择,4K 分别高 1.310、1.226 个百分点,配对 bootstrap 95% 区间分别为 [0.481, 2.154]、[0.494, 1.983];跨六长度聚合优势扩大到 2.006、1.614 个百分点,并赢得全部 12 个模型–长度比较。选择统计确实携带有用信息。 这些自定义方案都保留两 chunk 局部输出规则;Full64 使用自定义 BF16 kernel,且每个 adaptive 方案从自己的 Intra 输出重新选掩码。因此 Full64+adaptive 与 SparseGDN 的差别同时包含求解近似和掩码重选,不能把分数差全部归到某一个固定掩码下的系数误差。(Sec. 3.5,PDF pp. 15–17;Table 4,p. 17。) 寿命、排序与输出可见性。 每模型 130 个 8K 请求的诊断,先关闭选择器可见性因子以分离影响:在 tail 信号上加入寿命,非锚点重要性质量召回分别增加 32.037、31.484 个百分点;固定档位和精确保留数量后,tail 排序比随机高 14.171、13.646 个百分点。这里的“重要性”由稠密解码轨迹估计,诊断目标不同于任务分数。 另在完整 8K 集上把选择器的 $G_h$ 置为 1,模型自身输出门保持不变,观察到 4B、9B 分数分别下降 0.487、0.410 个百分点。但配对 95% 区间为 [−1.128, +0.128]、[−1.077, +0.205],均包含零,证据比随机选择对照弱。(PDF p. 16。) 动态档位数量。 在 Qwen3.5-9B 上,固定每层 9 低/4 中/3 高仍保留输入相关的 head 对身份和 chunk 排序;动态数量把聚合分数由 96.183% 提到 96.502%,keep 从 29.816% 降至 29.043%。配对增益为 0.319 个百分点,95% 区间 [0.114, 0.532];128K 提升最大,为 1.044 个百分点。两方案实测 keep 没有强制匹配。区间来自按任务和长度分层的 20,000 次配对重采样,未做多重比较调整。(Table 5,PDF p. 17。) 为什么选 Tail-16。 Fig. 10 的左图固定 Tail-16 的 head 对档位、精确保留数和锚点,仅改变非锚点排序窗;右图给出示例性 128K 任务分数。 原文 Fig. 10,PDF p. 18。左图蓝/橙线是相对 Tail-16 的重要性召回差,灰线是单独读取已物化 $U$ 的 score kernel 成本;右图蓝/橙线为 4B/9B 分数。 更长窗的代理召回更高,但 Tail-64 的独立扫描成本约为 Tail-16 的 2.59 倍,且任务分数没有跨模型一致改善:Tail-16 在 128K 为 95.413%/96.310%,Tail-32 为 95.508%/96.208%,Tail-64 为 95.290%/96.349%。实际流水线把 Tail-16 融合在最后一个片上 tile 中,独立扫描曲线只表征统计量成本,不能当作生产核心延迟的直接比较。默认窗是成本与排序质量的选择。(PDF pp. 17–18。) Table 6 的变体保持相同事件掩码和组局部输出规则,在计时负载上产生位级一致的末输入 token 预填充 logits。它们用不同的匹配参考路径隔离各项机制,单独计时的 Selector 不在范围内,融合进 Intra 的统计仍包含。 来自 Sec. 3.6、Table 6,PDF pp. 18–19。Deferred-W 比较包括相应的 packed-W 消费路径;CSR 对照在所有 chunks 做循环 GEMM、但维持相同掩码和衰减算术;Compact 对照显式展开稠密组入口状态;单独的 mapped-O 对照固定 H 侧的稠密状态物化,仅比较 O 的读取;联合项进一步去掉该物化。各行参考不同,不能相乘得到总加速。 128K 时,CSR 在两模型为 1.226×/1.230×,mapped-O 为 1.374×/1.368×。按档位调度从 16K 开始启用,在 128K 为 1.044×/1.045×;4K、8K 两种调度走相同路径,但仍纳入几何平均。结果表明,减少矩阵物化和状态流量与减少事件数量共同贡献了加速。 原文 Fig. 11,PDF p. 20。横轴长度,纵轴峰值 allocated memory(GB);深色为 Native,蓝色为 SparseGDN。阴影表示双方都完成时的节省量,80 GB 虚线为名义设备容量参考,256K 的叉号为 OOM 标记。 来自 Table 7,PDF p. 20。增量定义为 $M_{\mathrm{incr}}=M_{\mathrm{peak}}-M_{\mathrm{entry}}$,减去前向开始前已存活的模型权重等分配。所以 59.56%/57.97% 是前向增量的相对下降,不是总峰值的同等百分比下降。 128K 两模型的总峰值都下降 26.222 GB,与相同 GDN 几何相符。256K 的 Native 在首次预热就 OOM,Sparse 则完成;这给出了该配置下的可运行性结果,没有可用的 Native 完整前向峰值作为定量比较。这个显存实验也没有将 RULER 质量评测扩展到 256K。(Sec. 3.7,PDF pp. 19–20。) SparseGDN 提供了一个完整的推理优化实例:先用块邻接近似降低所有 chunks 的基础成本,再用廉价统计量选择长期状态写入,最后通过延后计算、事件链和映射输出避免为被跳过的工作付费。短程输出仍有局部信息路径,长期记忆则按事件预算维护。这解释了为什么仅有一个稀疏掩码不足以实现论文中的收益。 相较于 softmax attention 的 KV-cache 选择,它操作的是循环状态更新与中间状态流量;相较于修改并重新训练 recurrent 模型,它直接近似已有 GDN 的预填充算子。原文 Related Work 将它放在动态稀疏执行、线性注意力与状态空间模型、缓存选择和 GPU 系统设计的交叉处。(Sec. 5,PDF p. 21。) 实际取舍集中在两处。第一,选择器依赖手工设计的 tail、寿命和门能量代理,以及固定候选保留率和共享 head-pair 决策,可能漏掉罕见而关键的状态转移;更精细的预算需要同时控制在线成本。第二,当前质量证据来自 RULER 的受控检索、追踪、聚合与问答,速度来自固定负载的 GDN 核心计时。部署判断还需要开放式生成、真实请求分布和完整模型延迟,并补齐明确硬件配置。(Sec. 4,PDF p. 20;Sec. 3.1,p. 12。) 本次分析最值得延伸的问题是:能否用同样便宜、但更接近实际修正写入的信号替代 raw-U 尾部幅度;能否在独立测量两 chunk 局部读取贡献后,联合选择输出组范围与长期写入预算。二者都直接对应当前算子中“保留哪些信息”与“花多少执行成本”的接口。2.8 两 chunk 输出组:短程读取与长期写入分开
三:实验——先区分质量、速度与显存的口径
实验 对象与协议 指标及方向 主质量实验 RULER 全 13 个任务;4K、8K、16K、32K、64K、128K;每任务每长度 100 例,每模型共 7,800 例 官方 RULER 分数,越高越好;各长度及聚合值;分数差用百分点 主延迟实验 默认 batch 1;每个长度的固定计时负载;5 次预热、30 次 CUDA-event 测量;跨 24 层汇总 GDN-core 延迟越低越好;Native/Sparse 加速比越高越好 batch 扩展 batch 2/4/8;使用前 B 个 niah_single_1 请求并重复或截断到目标长度;1 次预热、5 次测量,中位数 整个 batch 的核心延迟比;另记 OOM 选择器诊断 每模型 130 个分层抽取的 8K 请求 非锚点 dense-decode 重要性质量的保留比例,越高越好 完整模型显存 batch 1、BF16、use_cache=True、仅保留末 token logits;4K–256K;1 次预热、3 次测量取最大值 峰值 allocated memory 及前向增量,越低越好 四:结果——质量、预算与执行收益分别看
4.1 主结果:约 29% 事件保留,聚合质量接近稠密基线
模型 Native 聚合分数(%) SparseGDN(%) 差值(百分点) 平均事件保留率 Qwen3.5-4B 96.142 96.159 +0.017 29.044% Qwen3.5-9B 96.617 96.502 −0.115 29.043% 上下文 4B 差值(百分点) 4B 核心加速 9B 差值(百分点) 9B 核心加速 4K −0.264 1.498× +0.026 1.500× 8K +0.051 1.504× −0.692 1.506× 16K +0.341 1.696× −0.062 1.702× 32K −0.246 1.830× +0.087 1.825× 64K +0.290 1.891× −0.103 1.892× 128K −0.069 1.943× +0.054 1.929× 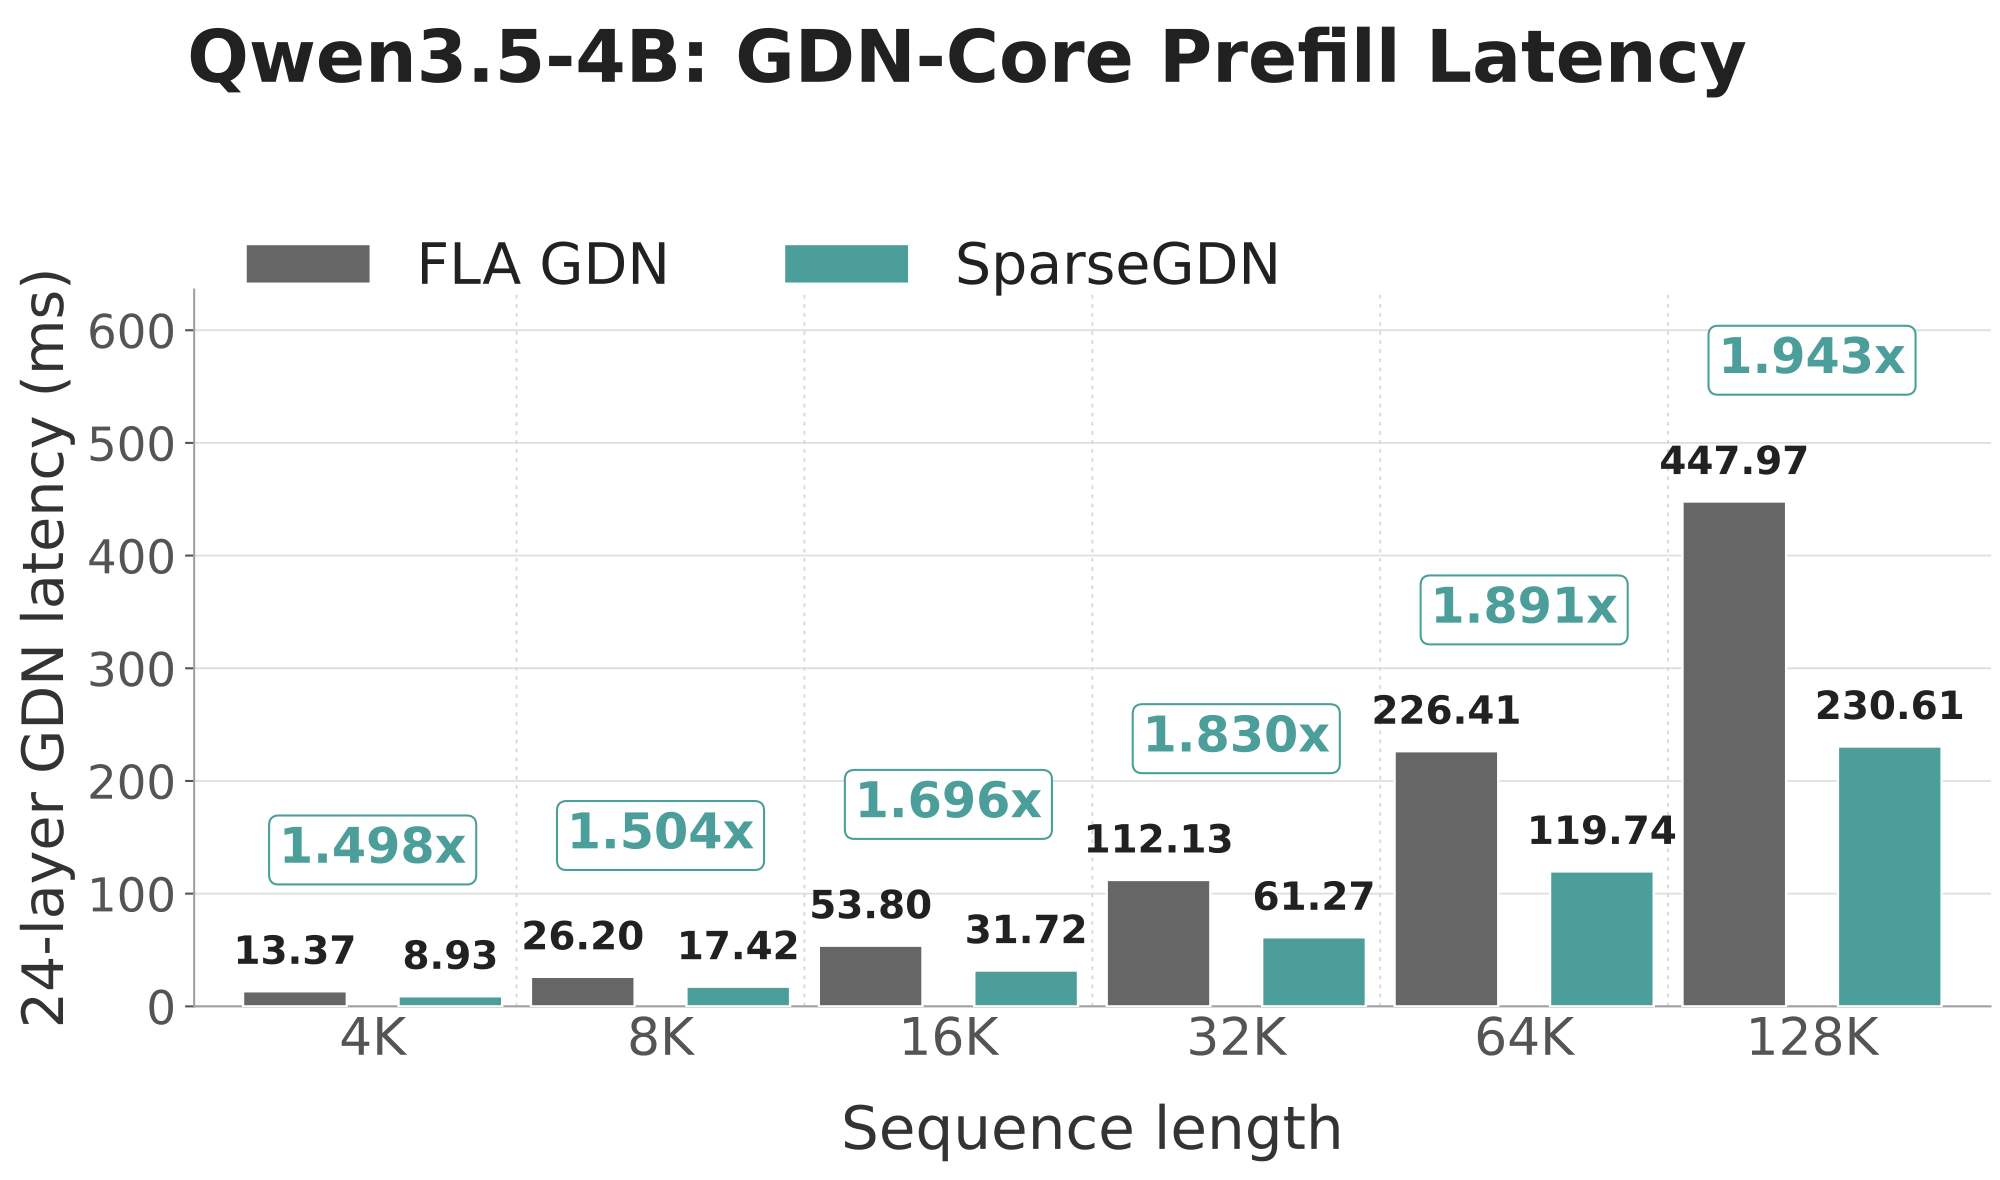
4.2 分阶段:Intra、H、O 都有收益,O 仍需处理所有 token
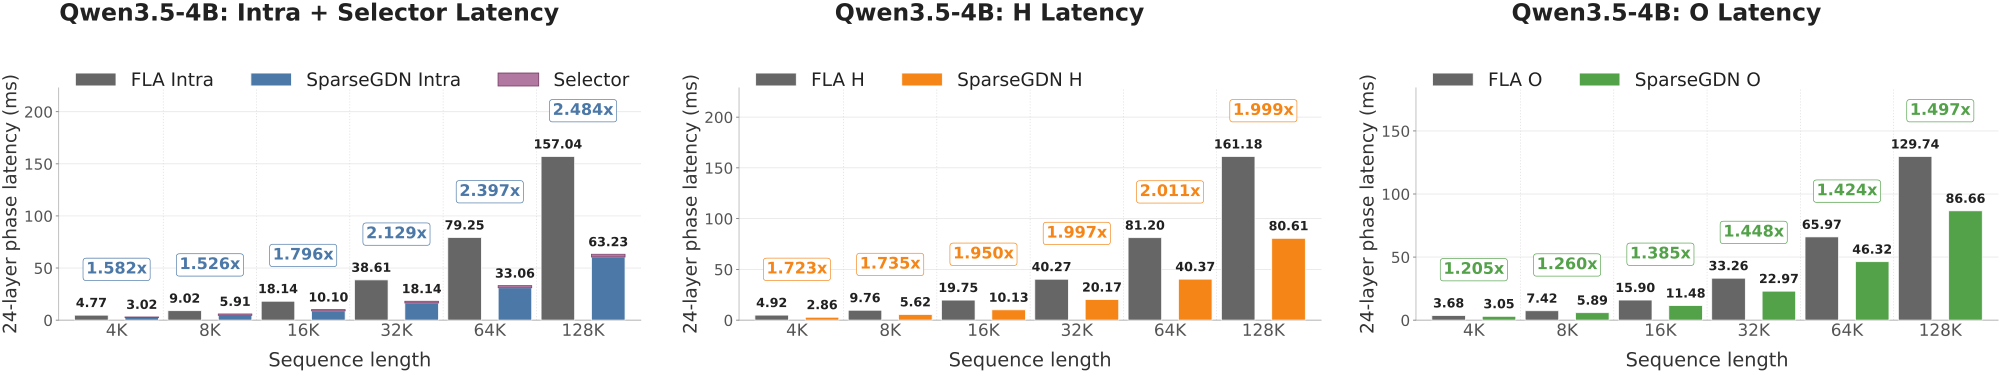
阶段 Native(ms) Sparse(ms) 阶段加速 Intra 对 Intra+Selector 157.04 63.23 2.484× H(稀疏侧包含 Deferred-W) 161.18 80.61 1.999× O 129.74 86.66 1.497× 4.3 batch 扩展:所有已完成配对都加速,OOM 单独解释
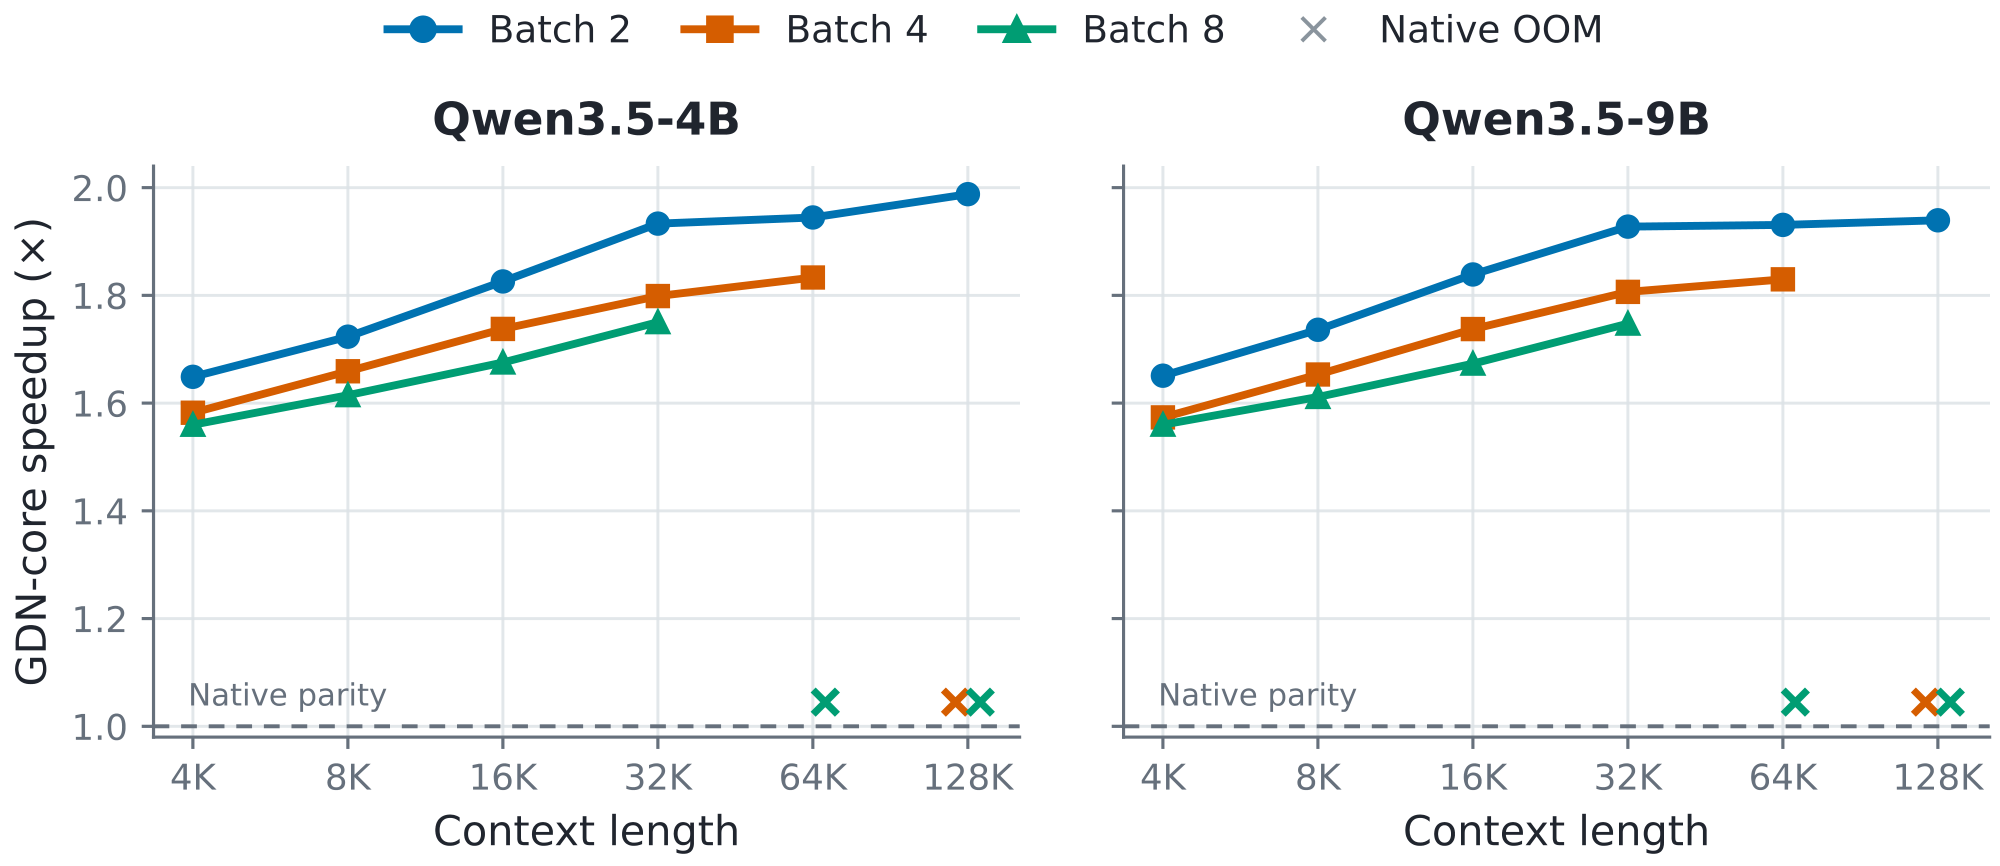
4.4 预算折中:约 39% 保留与约 10% 保留服务于不同目标
名义预算 4B 实测 keep 4B 差值(百分点)/加速 9B 实测 keep 9B 差值(百分点)/加速 10% 9.760% −2.063 / 2.089× 9.755% −2.281 / 2.099× 20% 19.493% −0.821 / 1.867× 19.502% −0.727 / 1.868× 默认 29.044% +0.017 / 1.718× 29.043% −0.115 / 1.717× 40% 39.253% +0.075 / 1.618× 39.261% +0.051 / 1.618× 50% 49.325% +0.053 / 1.425× 49.337% +0.033 / 1.425× 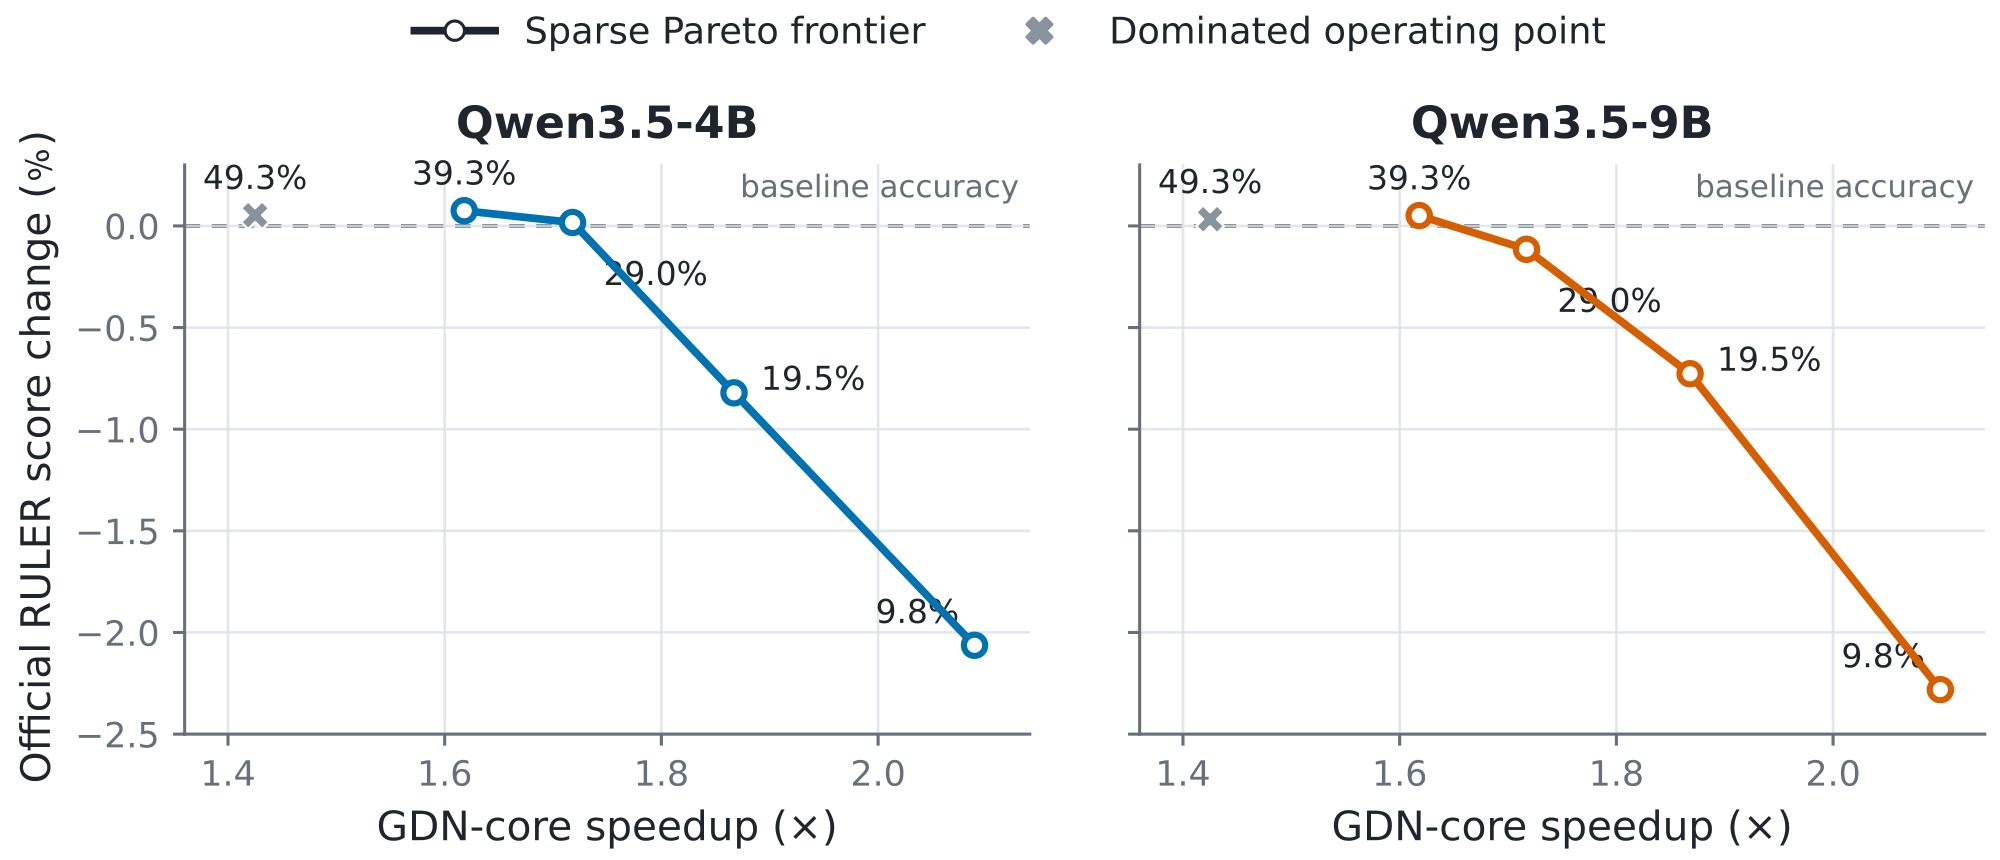
4.5 算法与选择器:保留什么,比保留多少更重要
方案 4B 分数(%) 9B 分数(%) 对照作用 Native 96.641 96.821 原生稠密基线 Block-adjacent + all 96.410 96.846 仅采用块邻接求解,保留全部事件 Full64 + adaptive 96.669 96.787 完整局部求解,约 29% 自适应保留 Block-adjacent + random 95.067 95.621 约 29% 随机保留 SparseGDN 96.377 96.846 块邻接求解与自适应保留结合 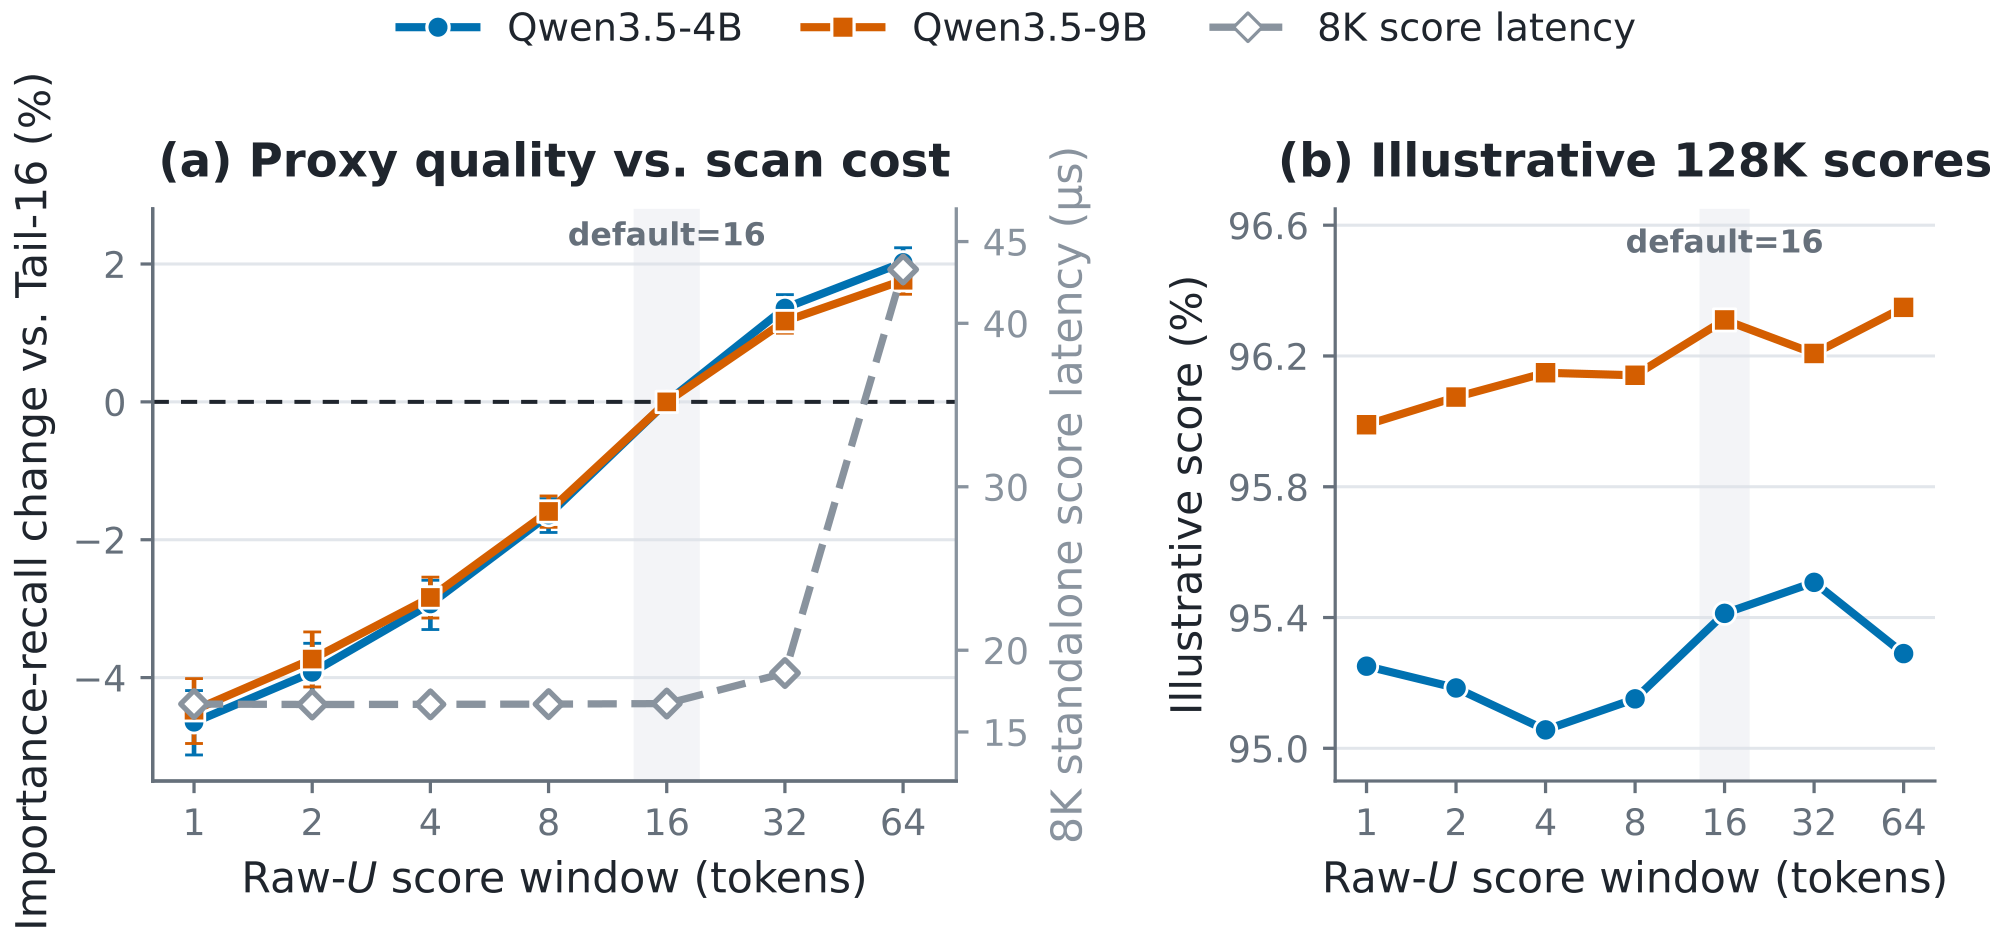
尾窗 4B 召回差(百分点) 9B 召回差(百分点) 独立扫描成本(µs/层,8K) 8 −1.643 −1.590 16.705 16 0 0 16.739 32 +1.362 +1.172 18.606 64 +2.024 +1.764 43.291 4.6 kernel 消融:真实执行路径决定稀疏性是否有价值
优化 测量范围 4B 几何平均加速 9B 几何平均加速 Deferred-W Intra+H+O 1.336× 1.338× CSR event scan H 1.149× 1.153× Compact states H 1.398× 1.402× Tier scheduling H 1.029× 1.030× Mapped O O 1.239× 1.226× Compact + mapped Intra+H+O 1.226× 1.224× 4.7 显存:完整模型峰值与前向增量要分开
模型/长度 Native 峰值(GB) Sparse 峰值(GB) Native/Sparse 前向增量(GB) 增量下降 4B / 128K 53.116 26.894 44.027 / 17.804 59.56% 9B / 128K 64.066 37.844 45.235 / 19.012 57.97% 4B / 256K OOM 44.637 OOM / 35.544 — 9B / 256K OOM 56.794 OOM / 37.960 — 五:结论——价值在于让近似与数据流一起设计