Dual DeltaNet:值侧记忆重组如何改善线性注意力
论文:Dual DeltaNet: Value-Side Memory Reorganization for Linear Attention
作者:Yixiao Qian、Yaxin Zhang、Song Chen、Jiaxu Liu、Shengze Cai、Chao Xu
版本:arXiv:2610.38578v1,2026-10-28 提交;本次获取与研读日期:2026-11-13。
原文:arXiv v1 · 本地 PDF · 英文汇报 PDF · 可编辑 TeX
- 发表:未查到正式发表信息(截至 2026-11-13);arXiv 页面 未列会议、期刊或出版 DOI,PDF 首页标为 Preprint。
- 代码:作者官方实现 DualDeltaNet,已有 DDN 层、模型、递推/分块算子及 130M、340M、1B 配置。
论文总览
线性注意力把任意长度历史压缩到固定大小的矩阵状态,节省了逐 token 的 KV 缓存,却让不同关联竞争有限的存储空间。Kimi Delta Attention(KDA)沿当前键读取一个值,再按残差纠正这个值。Dual DeltaNet(DDN)补充另一种读取方向:用当前值的部分特征探测整个状态,找出这些特征占据的地址方向,再把这一地址响应朝当前键的地址拉近。
它的核心贡献是同一矩阵状态上的双侧更新,以及与之配套的双侧 compact WY 分块算法和秩至多为 2 的解码更新。收益最集中在合成针检索(needle-in-a-haystack, NIAH):1B 模型平均准确率为 74.52%,KDA 为 64.27%,提高 10.25 个百分点。语言建模和通用下游的提升较小;真实检索在 1B 时仍落后 GDN-2。实现层面的取舍也很清楚:固定状态大小不变,额外计算能提高算术强度,但在报告的 H200 配置下延迟仍比 KDA 高。[Sec. 3–5,PDF pp. 3–8,Tables 1–5]
结构地图
以下页码均为从 1 开始的 PDF 页码,本论文与印刷页码相同。
| 原文章节 | 论证作用 | PDF 页码与主要证据 |
|---|---|---|
| 1. Introduction | 固定状态的干扰问题;值侧读取的动机 | pp. 1–2 |
| 2. Background | 线性注意力、DeltaNet、KDA | pp. 2–3,Eqs. (1)–(4) |
| 3. Methodology | 选择器、双侧 delta rule、秩 2 形式与模块 | pp. 3–4,Eqs. (5)–(10),Figs. 1–2,Algorithm 1,Table 1 |
| 4. Chunkwise Computation | 消去衰减、双侧 WY、块边界与因果读出 | pp. 4–6,Eqs. (11)–(33),Algorithm 2 |
| 5. Experiments | 预训练、通用任务、两类检索、效率、消融 | pp. 6–9,Tables 2–6,Fig. 3 |
| 6. Conclusion | 键侧纠错与值侧重组互补 | p. 9 |
| A. Compact WY Representation | 秩 1 转移乘积的紧凑表示及证明 | p. 11,Lemma A.1 |
| B. Implementation Details | 衰减、状态 kernel、精度与重计算 | p. 11,Eqs. (38)–(39) |
| C. Experimental Details | 参数/状态配平、优化及评估协议 | pp. 11–12,Tables 7–8 |
一:动机——为什么只纠正“键对应什么值”仍不够
1.1 同一个状态有两种读取方向
设每个注意力头的状态为 $S_t\in\mathbb R^{d_k\times d_v}$,键、查询 $k_t,q_t\in\mathbb R^{d_k}$,值 $v_t\in\mathbb R^{d_v}$。最简单的线性注意力为
从行看,$S$ 有 $d_k$ 个地址,每行保存一个 $d_v$ 维值。键 $k$ 既参与查询时的语义匹配,也决定写入值在各地址上的分布。这些地址是向量空间中的坐标,通常是稠密的连续表示。
当 $S=\sum_jk_jv_j^\top$ 时,两种读取分别是
前者问“与这个键相似的历史关联存了什么”;后者问“与这些值特征相似的内容占据了哪些地址方向”。$e\in\mathbb R^{d_v}$ 是值侧选择器。$Se$ 是加权地址响应,并不一般等于某个历史语义键,也不是键值映射的逆运算。[Sec. 1–2,PDF pp. 2–3,Eqs. (1)–(4)]
1.2 KDA 的纠错视野
先对状态做逐键通道遗忘:$\bar S_{t-1}=D_tS_{t-1}$,其中 $D_t=\operatorname{Diag}(\alpha_t)$、$\alpha_t\in(0,1)^{d_k}$。KDA 再写入值残差:
这里 $\beta_t\in(0,1)$ 决定纠错强度。与直接累加相比,它会减去当前键已读到的内容,减少重复写入。但这个读取只沿 $k_t$ 聚合状态,没有显式查看与当前值相关的内容散布在什么地址上。DDN 就在 KDA 更新后增加这一步。[Sec. 3,PDF p. 3,Eqs. (5)–(6)]
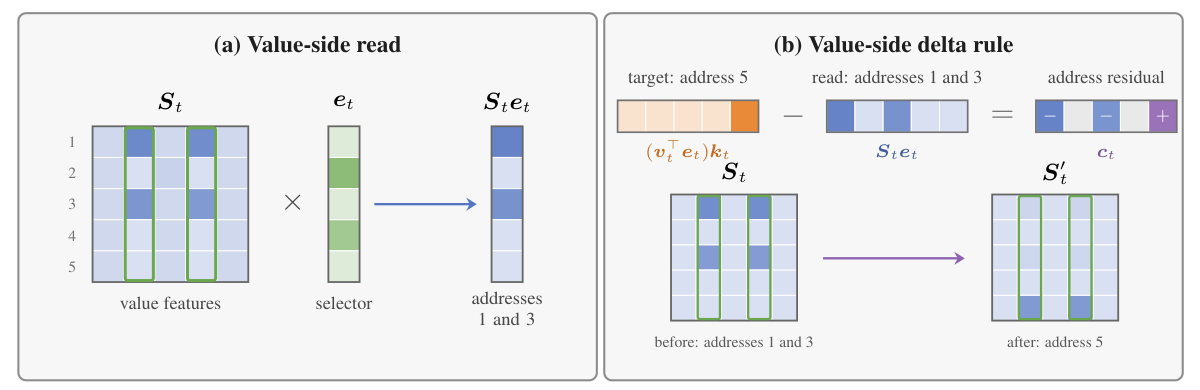
原文 Fig. 1,PDF p. 3。左图用值特征选择器读出地址 1、3 的响应;右图将它与地址 5 的目标比较,形成地址残差。图中的搬移是机制示意,实际更新是对所有行施加连续的秩 1 校正。
二:方法——一个状态,两侧残差,两个计算形式
2.1 核心符号与数据流
| 符号 | 维度 | 作用 |
|---|---|---|
| $S,\bar S,S^{\mathrm{KDA}}$ | $d_k\times d_v$ | 历史状态、衰减后状态、键侧更新后状态 |
| $q,k$ | $d_k$ | L2 归一化的查询与键 |
| $v,\hat v=v/\lVert v\rVert_2$ | $d_v$ | 原始值与单位值方向 |
| $m,e$ | $d_v$ | sigmoid 通道门与单位选择器 |
| $\beta,\gamma$ | 标量 | 键侧、值侧纠错强度,均在 $(0,1)$ |
| $\tau=v^\top e,\eta$ | 标量 | 目标地址尺度与等价写入强度 |
| $A,B$ | $d_k\times d_k$、$d_v\times d_v$ | 左侧键擦除与右侧值特征转移 |
对一个 token,依次生成投影与控制门,衰减旧状态,进行 KDA 键侧纠错,进行值侧地址纠错,最后用查询读取更新后的状态。训练的分块形式与推理的递推形式实现相同更新。
2.2 选择器决定读什么,单位值方向决定写什么
DDN 从输入生成值特征门 $m_t=\operatorname{sigmoid}(s_t^m)$,并构造
$m_t$ 调整各值通道在探测中的比重;再次归一化避免探测强度随门整体缩放而变化。$\tau_t$ 保留当前值在选定方向上的尺度,因此理想单个关联 $k_tv_t^\top$ 的值侧读数恰为 $\tau_tk_t$。
随后执行
$S_t^{\mathrm{KDA}}e_t\in\mathbb R^{d_k}$ 是状态当前的地址响应;括号内是它与目标响应的差。外积右因子是 $\hat v_t$,而不是 $e_t$:读取时挑选特征,写入时沿完整当前值方向纠正。新增状态变化的秩至多为 1,不需要增加独立槽位或第二份记忆。[Sec. 3,PDF p. 3,Eqs. (7)–(8)]
一个有助于理解的本次推导:设 $c_t=\hat v_t^\top e_t$,$r=S_t^{\mathrm{KDA}}e_t$,则
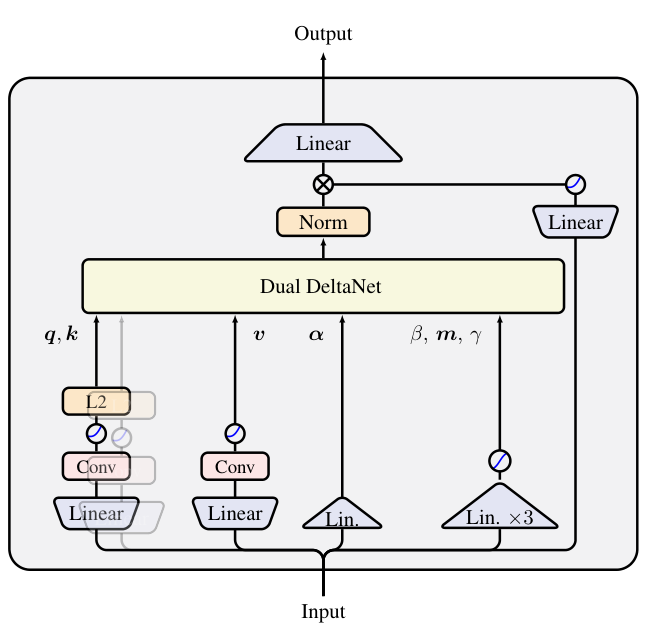
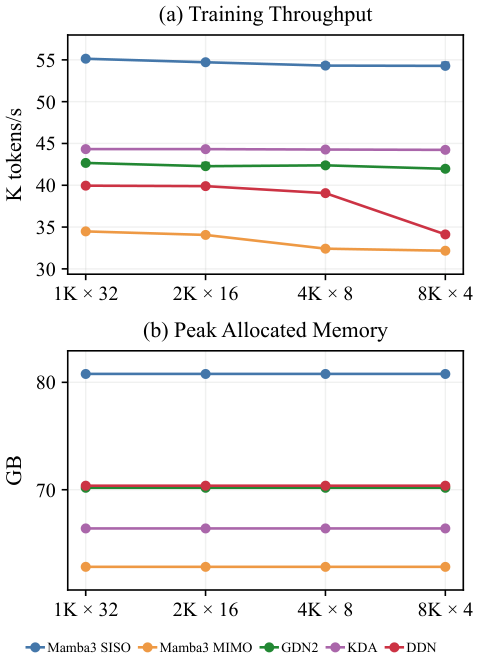
对非零值向量,由正门 $m_t$ 可得 $0 记 展开上式得到论文 Eqs. (9)–(10): 左乘 $A_t$ 改变键/地址方向上的旧内容,右乘 $B_t$ 改变值特征之间的状态传播。$B_t$ 在选择器带门时一般不对称。$\eta_t$ 来自原 KDA 写入经过右侧转移,再加上值侧目标写入;漏掉 $(1-\beta_t)$ 会把等价关系写错。令 $\gamma_t=0$,更新退化为 KDA。 直接按概念顺序实现,需要先构造 $S^{\mathrm{KDA}}$ 再做值侧读取。Algorithm 1 将两次依赖状态的读取都改为从衰减状态完成: 这里减去的 $\beta_t\tilde v_t^\top e_t$,补偿了键侧更新对值侧读数的影响。随后 因此相对衰减状态的增量秩至多为 2,不代表整个记忆状态只有秩 2。实际输出为 $o_t=d_k^{-1/2}S_t^\top q_t$;背景中的简化线性注意力式省略了这个缩放,算法和分块推导使用它。[PDF p. 4,Algorithm 1] Table 1 在输入输出每元素 2 字节、状态读写占主导的假设下,计算 KDA 的主项为 $7d_kd_v$ FLOPs,DDN 为 $11d_kd_v$ FLOPs。二者都将状态读入、写回各一次,主项流量是 $4d_kd_v$ 字节,因此算术强度分别趋于 1.75 和 2.75 FLOPs/byte。增加 57.1% 的理论算术强度意味着同一次状态流量承担了更多计算;具体速度还取决于 kernel、归约和并行度。[PDF p. 4,Table 1] 长度为 $C$ 的块 $n$,入口状态为 $S_{[n]}=S_{nC}$。以下省略块下标,只写块内位置 $i$。先定义累计衰减 令 $\bar k^i=(\Pi^i)^{-1}k^i$、$\bar u^i=\beta^i\Pi^ik^i$,可将递推化为 因为每个 $\alpha$ 都严格为正,累计衰减在代数上可逆。实际实现对累计 log-decay、归一化和三角求解使用 FP32。[Sec. 4,PDF pp. 4–5,Eqs. (11)–(14);App. B,p. 11] 展开到块边界后,入口状态经历左右两侧转移,每次写入也经历后续两侧擦除: 关键是保留左右乘积相反的时间顺序。将 $\bar k^i,\bar u^i,e^i,\hat v^i$ 分别按行堆成 $\bar K,\bar U,E,\hat V$;令 $\Gamma=\operatorname{Diag}(\gamma^i)$、$N=\operatorname{Diag}(\eta^i)$,得到 这里 $H\in\mathbb R^{d_k\times C}$,$Z\in\mathbb R^{C\times d_v}$。两个三角系统分别编码键方向、值方向经过后续 token 之后剩余的写入方向。于是 $P_L=I-H\bar U$、$P_R=I-E^\top\Gamma Z$,不需要显式逐 token 相乘巨大的转移矩阵。[PDF p. 5,Eqs. (15)–(22)] 为方便 kernel 计算,论文进一步整理为 这把块内部的大量运算变成三角求解和矩阵乘法;块边界的状态仍按序传递。[PDF p. 5,Eqs. (23)–(25)] 查询 $j$ 只能看到前缀 $1\ldots j$。按行构造 $Q_\pi$,第 $j$ 行为 $d_k^{-1/2}(\pi^j\odot q^j)^\top$,然后 $\operatorname{tril}$ 在这里包括对角线,严格下三角的三角系数则使用参数 $-1$。$O_{\mathrm{base}}$ 是入口状态经过键侧前缀转移后的贡献;$G_R\hat V$ 合并新写入和入口状态的值侧擦除。下三角掩码屏蔽未来 token,使输出与递推形式一致。[PDF pp. 5–6,Eqs. (26)–(33),Algorithm 2] 附录 A 对任意秩 1 转移 $Q_i=I-u_iw_i^\top$,定义 $U=[u_1,\ldots,u_m]$、$W=[w_1,\ldots,w_m]$,证明 证明把乘积与单位阵之差写成望远镜求和。令 $f_i=Q_m\cdots Q_{i+1}u_i$,则 由于 $I+T$ 是单位下三角矩阵,它始终可逆,无需向量正交假设。DDN 对左右两侧分别应用这个恒等式,是其分块算法的代数基础。[App. A,PDF p. 11,Lemma A.1,Eqs. (34)–(37)] 原文 Fig. 2,PDF p. 4。$q,k,v$ 分支经线性投影、短因果卷积与 SiLU,$q,k$ 再做 L2 归一化。控制分支生成 $\alpha,\beta,m,\gamma$;图中上方为归一化、输出门与投影。 衰减沿用 KDA:$\alpha_t=\exp(g_t)$,$g_t=-\exp(a_{\mathrm{decay}})\odot\Delta_t$,$\Delta_t=\operatorname{softplus}(W_\Delta x_t+b_\Delta)$,从而 $0<\alpha_t<1$。$m$ 和衰减的 logits 使用分开的低秩投影,瓶颈宽度 $d_v$。初始化 $m=0.5$、$\gamma=0.05$,初始 $e=\hat v$,先从较弱的值侧纠错开始。[App. B–C,PDF pp. 11–12] 实现上的主要代价来自 $Se$ 要沿 $d_v$ 做归约。KDA/GDN-2 能把状态列切成独立 value tiles;DDN 的值侧读取耦合了这些列。作者使用 TileLang,每个序列、每个头分配一个 program,整份状态驻留共享内存,program 内顺序处理各块。因此小 batch 时独立 program 数量只有 batch × heads,可能无法充分利用 GPU。主要矩阵和携带状态存 BF16,矩阵乘累加用 FP32;缓存两侧三角逆和因果查询键交互,其余中间量在反向重算。[App. B,PDF p. 11] 所有模型在 FineWeb-Edu 上训练,batch 为 256 条序列、每条 2,048 tokens,共用 32,000 词表的 LLaMA tokenizer。AdamW 使用 $(\beta_1,\beta_2)=(0.9,0.95)$、$\epsilon=10^{-8}$、weight decay 0.01,梯度裁剪 1.0,余弦学习率降至峰值的 10%;warmup 为 512/1,024/1,024 步。[Sec. 5,PDF p. 6;App. C,p. 12,Tables 7–8] KDA 是直接母模型,用于衡量增添值侧机制后的收益;GDN-2 改进擦除与写入的解耦;Mamba-3 包括 SISO 和 rank-4 MIMO,是另一类状态动力学与计算强度的对照。线性注意力的 $d_k=d_v=128$,Mamba-3 的状态/头维度均为 64,使用更多头以配平每层 $n_{\mathrm{head}}d_kd_v$。每个规模也通过调整模型与 MLP 宽度匹配总参数。 因此这是同 token 预算、近似等总参数、等每层状态大小的比较。各结构宽度并不相同:例如 1B KDA 的模型/MLP 宽度为 1,760/4,864,DDN 为 1,744/4,848。结果应理解为匹配容量下的完整架构比较,不能全部归因于单独一个算子。论文表格给出点估计,没有提供多次独立训练的方差;这对 0.01 量级的困惑度差异尤其相关。 下游和检索采用 zero-shot 的 lm-evaluation-harness;生成用 greedy decoding,真实检索最多 48 个新 token、NIAH 最多 128 个。NIAH 的 Single-1 是重复文本中的词→数字,Single-2 是文章中的词→数字,Single-3 是文章中的词→UUID,MultiKey-1 是文章中四个词→数字关联的检索。[App. C,PDF p. 12] 来源:Table 2,PDF p. 7。加粗的 DDN 下游均值在各规模也是五种模型中的最高值。 DDN 对 KDA 的三类 ppl 都下降,但幅度差异很大:130M 的 LAMBADA 从 69.91 降到 60.93,下降 8.98、相对下降约 12.85%;130M 和 1B 的训练 ppl 都只下降 0.01。七任务均值分别增加 0.65、1.04、0.22 个百分点。1B 最接近的对手是 Mamba-3 MIMO,均值 50.48%,与 DDN 相差 0.11 个百分点。 平均最优不意味着逐项最优。例如 1B DDN 在 WinoGrande 上为 54.46%,低于 KDA 的 56.12%;ARC-C 为 32.85%,低于 KDA 的 33.28%。Mamba-3 MIMO 在 340M/1B 的训练 ppl 也优于 DDN。结果支持值侧更新能与一般建模能力共存,并带来小幅综合收益。 来源:Table 3,PDF p. 7;每格为四种任务、三种长度的平均 accuracy(%)。 在 1B 下,DDN 的 Single-1 三长度全部 100%,Single-2 在 4,096 tokens 达到 80.8%,KDA 为 54.2%,GDN-2 为 56.6%;Single-3 在 1,024/2,048/4,096 tokens 分别为 97.0/83.6/36.0%,KDA 为 59.4/67.2/19.0%。这些结果与“改善有限状态中的关联保留”的解释一致。4,096 长度超过 2,048 的训练长度,但其证据范围仍是 4K 的合成检索。 需要同时读具体失败项: 340M 的平均提升主要由 Single-1 与 Single-3 抵消了 Single-2 的下降;MultiKey-1 的三长度也都低于 KDA。1B 的 MultiKey-1 在短长度仍弱于 Mamba-3 MIMO(1,024 tokens 为 53.2%)。论文没有解释 340M Single-2 退步的来源,不能从平均提升推出值侧重组对所有记忆冲突都更好。 来源:Table 4,PDF p. 8;六任务平均 contains accuracy(%)。 对 KDA,DDN 分别提高 1.00、1.91、0.30 个百分点。340M 的 FDA 为 8.71%,KDA 为 3.81%,这一单项提升较突出。到 1B,GDN-2 的 FDA 达 17.42%,DDN 仅 12.89%;GDN-2 在 SQuAD 和 TriviaQA 也更好,因而总均值领先 DDN 0.60 个百分点。 DDN 在 1B 的 NQ 最好(17.45%),却在 SWDE 上低于 KDA(32.58% 对 35.46%)。合成关联收益并未等幅迁移至每个真实检索任务,说明内容类型和查询形式会改变两类状态更新的相对优势。 原文 Fig. 3,PDF p. 8,来自作者原始矢量图。横轴为序列长度 × batch size,总 token 数约固定;上图越高越好、下图越低越好。蓝/橙/绿/紫/红分别为 Mamba-3 SISO、MIMO、GDN-2、KDA、DDN。 DDN 的吞吐低于 KDA/GDN-2,高于 Mamba-3 MIMO;显存稍高于 KDA,接近 GDN-2。Mamba-3 SISO 吞吐最高,也使用更多显存,因为默认保留更多前向中间量。这里各实现保留自己的默认重计算策略,比较的是当前完整实现的速度—内存取舍。到 $8K\times4$,DDN 吞吐下降,符合附录 B 对小 batch 并行度不足的分析;图中没有可直接引用的精确数据表,因此不把目测曲线值当精确吞吐数字。 来源:Table 5,PDF p. 8。H200,batch 64,生成长度等于输入长度。 在 4K 下,DDN 相对 KDA 的 prefill 延迟增加约 12.95%,prefill+decode 增加约 13.78%;8K 下分别增加约 12.10%、13.74%。这些是对应总延迟的相对增幅。DDN 的实际成本接近 GDN-2 和 Mamba-3 MIMO,保留固定状态的优点,但没有在此设置中超过 KDA 的速度。 来源:Table 6,PDF p. 9。原文主结果 Table 4 的 340M KDA 检索均值是 21.31,而消融表写 21.30;此处保留各表原值,这一 0.01 差异不影响排序。 两种 DDN 都保留值侧更新,只改变选择器是否使用可学习通道门。对无门 DDN,带门版本的 NIAH 提高 1.12/1.45 个百分点,下游提高 0.62/1.28 个百分点;但 340M 真实检索反而下降 0.26 个百分点。直接证据是门控改善若干综合指标。若要进一步区分“值侧校正本身”与新增投影/宽度分配的贡献,可做固定 $\gamma=0$、保留参数路径的匹配消融;论文未提供这一控制。 DDN 把有限矩阵记忆的维护扩展到两个方向:键侧残差纠正“当前键应读出什么”,值侧残差纠正“当前值特征应从哪些地址读出”。这没有扩大状态,却让一次更新利用到更广的状态信息。代价是两侧耦合增加计算,也使原本可独立处理的 value tiles 需要归约。 最有说服力的结果是同参数、同每层状态、同 token 预算下的合成召回提升,尤其 1B 的 NIAH 平均 +10.25 个百分点;最重要的适用条件是任务与规模:340M 的 Single-2 有大幅退步,1B 真实检索未超过 GDN-2,通用语言建模的部分差异很小。这使它更适合被看作一个有明确代数实现、值得进一步研究的记忆更新机制。 对后续研究,优先的问题是解释 Single-2 的反例并检验值侧纠正何时会误伤其他关联;在保持架构与预算匹配的控制中测量该项的贡献;以及解决列耦合造成的小 batch kernel 并行度问题。前两项关系到机制理解,后一项决定这种更新在实际推理与训练预算中的吸引力。2.3 等价的双侧递推
2.4 秩 2 解码:把两次纠错合成一次状态更新
2.5 分块训练:消掉衰减,分别压缩左右转移
2.6 因果读出:不能直接用块末状态回答块内查询
2.7 Compact WY 的证明抓手
2.8 模块与实现为何影响效率
三:实验——比较条件和指标分别说明什么
3.1 训练预算与比较角色
规模 数据量(约) 层数 每层状态元素数 训练步数 峰值学习率 130M 5B tokens 12 98,304 9,500 $6\times10^{-4}$ 340M 15B tokens 24 131,072 30,000 $4\times10^{-4}$ 1B 50B tokens 24 229,376 95,000 $4\times10^{-4}$ 3.2 任务与统计口径
实验组 检验问题 指标与协议 语言建模 新机制是否损害一般预测能力 FW-Edu 训练 ppl:末 500 步每 10 步记录 loss,均值取指数;WT2 为 word-level ppl;另测 LAMBADA ppl,均越低越好 七项通用下游 通用能力是否受益 LAMBADA、PIQA、WinoGrande、ARC-E/C、OpenBookQA 用 raw accuracy;HellaSwag 用长度归一化 accuracy;表中均值越高越好 合成 NIAH 固定状态能否精确保留关联 RULER 四变体 × 1,024/2,048/4,096 三长度,各格 500 例;accuracy 越高越好,Avg. 是 12 格均值 六项真实检索 能否迁移到真实文本召回 SWDE、SQuAD Completion、FDA、TriviaQA/NQ/DROP Cloze;输入最多 2,048 tokens;contains accuracy:输出含任一可接受答案即正确 效率 额外运算的实际成本 H200、1B、BF16 训练吞吐/峰值 allocated memory;推理 batch 64,生成长度等于输入长度,秒数越低越好 四:结果——主要优势在记忆召回,收益有任务差异
4.1 语言建模与通用下游
规模 模型 FW-Edu ppl ↓ WT2 ppl ↓ LAMBADA ppl ↓ 七任务均值 % ↑ 130M KDA 14.79 42.53 69.91 37.38 130M DDN 14.78 42.36 60.93 38.03 340M KDA 10.93 28.13 29.09 42.40 340M DDN 10.88 27.43 28.41 43.44 1B KDA 8.23 19.07 13.86 50.37 1B DDN 8.22 19.00 13.56 50.59 4.2 合成 NIAH:最强平均提升与明显反例并存
规模 Mamba-3 SISO Mamba-3 MIMO GDN-2 KDA DDN DDN−KDA(百分点) 130M 12.95 11.65 26.88 38.10 40.57 +2.47 340M 35.02 41.53 48.57 51.20 53.87 +2.67 1B 47.25 60.73 69.40 64.27 74.52 +10.25 任务、规模 长度 KDA % DDN % 差值(百分点) Single-2,340M 2,048 95.6 67.2 −28.4 Single-2,340M 4,096 40.6 14.4 −26.2 MultiKey-1,1B 1,024 34.4 37.6 +3.2 4.3 真实检索:中小规模收益更明显
规模 Mamba-3 SISO Mamba-3 MIMO GDN-2 KDA DDN 130M 12.81 12.98 15.53 15.18 16.18 340M 20.56 21.45 21.54 21.31 23.22 1B 27.63 29.45 31.80 30.90 31.20 4.4 效率:更高算术强度如何兑现
1B 模型 Prefill,4K (s) ↓ Prefill+Decode,4K (s) ↓ Prefill,8K (s) ↓ Prefill+Decode,8K (s) ↓ Mamba-3 SISO 1.35 14.66 2.69 27.44 Mamba-3 MIMO 1.64 16.70 3.35 33.46 GDN-2 1.58 16.53 3.16 33.11 KDA 1.39 14.66 2.81 29.34 DDN 1.57 16.68 3.15 33.37 4.5 选择器消融:学会挑选特征有收益,但不处处占优
规模 变体 下游均值 % 真实检索均值 % NIAH 均值 % 130M KDA 37.38 15.18 38.10 130M DDN,$e=\hat v$ 37.41 15.87 39.45 130M DDN,带门 38.03 16.18 40.57 340M KDA 42.40 21.30 51.20 340M DDN,$e=\hat v$ 42.16 23.48 52.42 340M DDN,带门 43.44 23.22 53.87 五:结论——固定状态的改进来自更丰富的读写关系