StateLoop: Persistent State for Looped Transformers|中文精读笔记
论文:Feichen Song、Boyi Zeng、He Li、Shixiang Song、Yiqin Hao、Zitong Wang、Yizhou Yang、Yifan Liu、Ziwei He、Zhouhan Lin,StateLoop: Persistent State for Looped Transformers。
原文:arXiv:2610.35544v1,2026-10-26 提交;本地 PDF;本次研读 2026-10-28。
发表:截至 2026-10-28 未查到正式发表信息;arXiv 记录未列会议或期刊。
代码:截至 2026-10-28 未查到公开实现;论文也未给出仓库链接。
论文总览
循环 Transformer(looped Transformer)让同一主干网络重复执行,以增加每个 token 的计算深度而不为每次循环复制一套参数。普通循环模型把本次主干输出直接送入下次循环:若某次迭代提取的信息要在更后面才用到,它只能在同一条不断被改写的隐藏流中存活。StateLoop 给每个 token 增加一条沿循环深度持续更新的状态流;门控更新决定保留旧状态或写入新主干输出,再把状态投影回主干流。这里的“持久”是跨模型内部的循环迭代,并非将一个 token 的状态永久传给后续生成 token。(Sec. 1/3,PDF pp. 1–4;Fig. 1,p. 3)
在共同的 1.4B、四次主干迭代、30B 训练 token 设置下,无跨 token 状态混合的 StateLoop 将 Pile 验证困惑度(PPL)从 Vanilla Looped 的 7.79 降至 7.61,八项零样本任务平均准确率从 53.31% 提至 54.28%(+0.97 百分点),同时参数增加 1.18%、自回归解码延迟增加 1.42%。加入因果注意力或 Mamba-2 状态混合后,零样本平均分分别达到 54.74% 与 54.75%。这些结果表明:显式状态有收益,是否沿 token 轴混合状态则是另一个独立设计选择。(Tables 1–3,PDF pp. 6–8)
结构地图
| 原文章节 | 在论证中的作用 | PDF 位置 |
|---|---|---|
| 1. Introduction | 提出普通循环隐藏流的信息保留问题与贡献 | pp. 1–2 |
| 2. Related Work | 循环深度、跨迭代连接、动态状态/记忆的关系 | p. 2 |
| 3. Method | 双流架构、选择性状态更新、可选 token 混合、最终读出与训练 | pp. 2–5;Fig. 1;Eqs. (1)–(12) |
| 4. Experiments | 1.4B 主结果、410M 深度、1.4B 解码效率 | pp. 5–8;Tables 1–3;Fig. 2 |
| 5. Ablation and Analysis | 状态宽度、反馈与持久性消融、状态读出干预 | pp. 8–10;Table 4;Figs. 3–4 |
| 6. Conclusion | 总结与规模边界 | p. 11 |
一:动机
把 24 层主干重复 $K$ 次,可用一套参数实现约 $24K$ 层的计算路径。然而 Vanilla Looped 中,第 $k$ 次输出 $H^k$ 一边承载已有信息,一边充当下一次主干的输入。反复处理可能覆盖早期有用内容。作者由 DenseFormer 中“后层能访问更早输出有利”的结果引出一个动机假设:循环模型也应能保留早先迭代的信息;这不是本文已经证明的机制事实。(Sec. 1–2,PDF pp. 1–2)
StateLoop 的取舍是保留直接主干通路,同时额外开一条状态通路。普通隐藏流仍可供下一次主干计算;状态通路以门控方式积累、选择并回读信息。相比只扩大前馈层,此设计把新增参数用于跨循环迭代的信息保存。相比直接用门控状态替代整个主干输入,它也保住了原有的直连路径;后面的反馈消融专门检验这一点。(Sec. 3/5.2,PDF pp. 2–4/9)
二:方法
2.1 两条轴:token 位置与循环深度
令输入序列长度为 $n$,主干宽度为 $d$,状态宽度为 $d_s$,共享主干为 $T$,循环次数为 $K$。主干输出 $H^k\in\mathbb R^{n\times d}$;状态 $S^k\in\mathbb R^{n\times d_s}$ 在每个 token 位置各有一行。初值和第一次主干计算为
每个 $H^k$ 都更新一次状态,因此 $S^{k+1}$ 是吸收第 $k$ 次主干输出后的状态。默认的选择性状态更新在循环轴工作,各 token 的状态各自更新;可选状态混合器 $\mathcal X_\psi$ 才在token 轴用因果注意力或 Mamba-2 交换信息。这一区分避免把“每 token 有一条跨层状态”误解为普通时间序列 RNN 的跨 token 状态。(Sec. 3.1–3.2,PDF pp. 2–4,Eqs. (1)–(3))
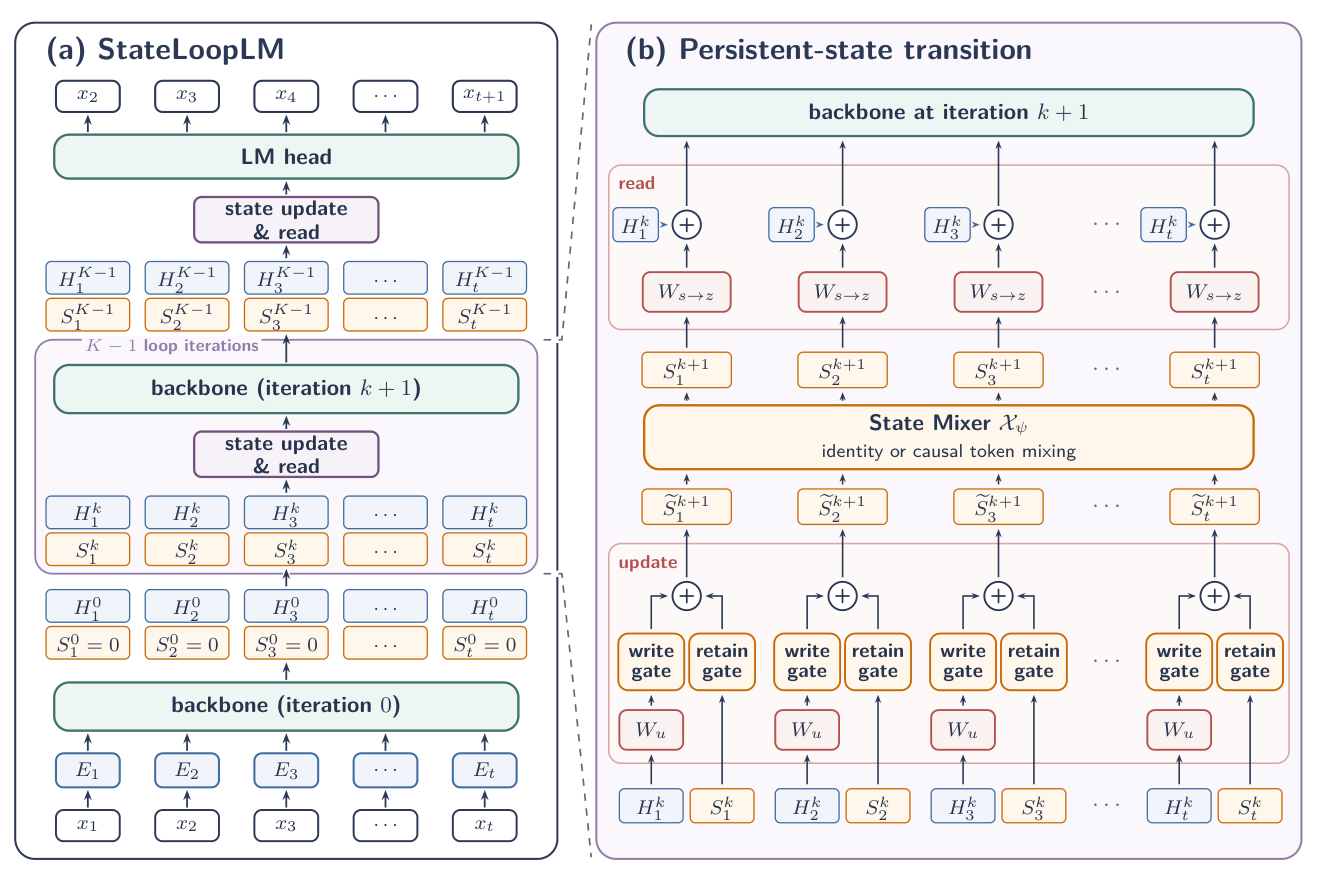
原文 Fig. 1(PDF p. 3)。左侧沿循环深度交替运行共享主干与状态更新;右侧表明门控写入、可选 token 轴混合、以及投影回主干的读取。图中的 $W_{s\to z}$ 用于下次循环,$W_{s\to out}$ 用于最终预测,二者是不同的投影。
2.2 门控状态更新与回读
先标准化主干输出并投影到状态宽度:
令 $\Delta^k=\operatorname{softplus}(U^kW_\Delta^\top+b_\Delta)$、$\lambda=\exp(A_{\log})$,则每个状态通道的保留系数是 $g^k=\exp(-\lambda\odot\Delta^k)$。$g^k$ 随当前 token 和迭代的主干输出而变,处于 $(0,1)$;状态更新是逐元素插值:
大的 $g^k$ 更偏向保留旧状态,小的 $g^k$ 更偏向写入这次主干的投影。论文把这种参数化称为选择性 SSM 更新;它在这里沿循环深度使用,默认 $\mathcal X_\psi$ 为恒等映射。作者把 $\Delta$ 的初值设为 0.3,各通道的 $\lambda$ 从 0.01 到 4 对数分布,以给不同通道不同的初始写入速率;这些参数随后学习。(Sec. 3.2.1,PDF p. 4,Eqs. (5)–(6))
对尚未到最后一步的循环,下一次主干输入为
这个加法是架构的关键:旧信息可以从显式状态回流,但当前 $H^k$ 仍有直接通路。最终循环后,另一投影参与预测:
语言模型头对 $Y_t$ 预测 $x_{t+1}$,训练目标仍是标准下一 token 交叉熵。主干、更新门、反馈与可选混合器的参数均在循环之间共享,整体端到端训练。(Sec. 3.1/3.3,PDF pp. 3–5,Eqs. (4)、(10)–(12))
2.3 可选 token 混合与推理成本
默认 StateLoop 不在状态分支跨 token 混合。StateLoop + Attn 在每次更新后,对状态做预归一化因果自注意力并残差相加;StateLoop + Mamba-2 则用沿 token 轴的残差 Mamba-2 模块。两者保持 $n\times d_s$ 形状与因果性,可能把不同位置的信息写入同一位置后续循环可读的状态,但会额外带来参数与缓存。(Sec. 3.2.2,PDF p. 4,Eqs. (7)–(9))
自回归解码时,模型仍要逐 token 生成;每个新 token 在当前前向计算中经历 $K$ 次共享主干迭代。默认状态只在当前 token 的循环深度内暂存,主干仍使用每循环各自的 KV 缓存;加入 Attn 或 Mamba-2 混合时还需相应的循环专属 token 轴缓存。这解释了论文为何同时报告质量与逐 token 延迟,不能只从“共享参数”推断推理便宜。(Sec. 4.4,PDF pp. 7–8)
三:实验设计
主实验均从零在 Pile 上训练,使用同一 GPT-NeoX 分词器与 LLaMA 风格主干。1.4B 对比:24 层共享主干、宽度 2048、32 个注意力头、$K=4$、30B 原始训练 token、批量 256、序列长度 2048。默认状态宽度 $d_s=2048$。410M 的深度与状态实验使用宽度 1024、25B token,并在 $K=3,\ldots,7$ 分别训练模型;它们不是把一个已训练三次循环的模型临时多跑几圈。(Sec. 4.1/4.3,PDF pp. 5–7)
评价指标的口径分别是:Pile 与 LAMBADA-OpenAI 的 token PPL、WikiText-2 的 word PPL(均越低越好);LAMBADA、ARC-Easy、ARC-Challenge、WinoGrande、PIQA、HellaSwag、SciQ、RACE-high 共八任务的零样本与五样本准确率,以及八项简单平均 Avg-8(越高越好)。跨数据集的 PPL 不宜直接按绝对值比较,因为分词与统计单位不同。(Sec. 4.1,PDF p. 5)
Vanilla Looped 是相同共享主干的直接基准;Vanilla Looped + FFN 以更宽前馈层检验“仅加参数”是否可复制收益。PonderLM、Hyperloop、MeSH、Parcae 与 Pause Token 是不同跨迭代信息或计算设计;所有基线在同一代码库实现,但部分保留其原论文的前置/循环/后置结构。MeSH 与 Parcae 的层应用次数匹配 $4\times24=96$,不等于所有结构和计算成本完全一致。(Sec. 4.1,PDF p. 5)
四:结果与证据
4.1 1.4B 主结果:状态分支优于单纯加宽
| 模型(均训练 30B token) | 参数 | Pile token PPL↓ | LAMBADA token PPL↓ | WikiText-2 word PPL↓ | 零样本 Avg-8↑ | 五样本 Avg-8↑ |
|---|---|---|---|---|---|---|
| Vanilla Looped | 1420.92M | 7.79 | 6.94 | 16.50 | 53.31% | 55.12% |
| Vanilla + FFN | 1467.22M | 7.75 | 7.00 | 16.34 | 52.85% | 55.54% |
| StateLoop(恒等混合) | 1437.71M | 7.61 | 6.71 | 15.96 | 54.28% | 56.60% |
| StateLoop + Attn | 1454.49M | 7.60 | 6.64 | 15.93 | 54.74% | 57.15% |
| StateLoop + Mamba-2 | 1467.23M | 7.60 | 6.88 | 15.95 | 54.75% | 57.13% |
来自 Tables 1–2(PDF pp. 6–7)。恒等混合版比 Vanilla 少 0.18 Pile PPL,零样本 Avg-8 高 0.97 个百分点;同时仅增加 16.79M 参数(+1.18%)。参数相近的 Mamba-2 版与加宽 FFN 版相比,也有更低 PPL 与更高平均准确率,支持收益并非只由额外参数数量解释。Attn 与 Mamba-2 的平均分接近,但并非每个任务都提升:例如恒等混合版的零样本 ARC-Easy 52.27% 略低于 Vanilla 的 52.57%;因而“平均准确率提高”不能改写成“所有任务都提高”。(Table 2,PDF p. 7)
4.2 循环深度:优势随训练深度扩大
在 410M、25B token、$d=d_s=1024$ 的配对实验中,$K$ 从 3 增至 7 时,Pile PPL 分别为 Vanilla 9.59→9.34、StateLoop 9.45→9.04。差距由 $K=3$ 的 0.14 增至 $K=7$ 的 0.30。两条曲线都受益于更多循环,但 StateLoop 的额外收益更大;这与“更深计算更需要保留早先信息”的解释相符。横轴是训练时使用的循环深度,每个点对应独立训练的配对模型。(Sec. 4.3,PDF pp. 6–7;Fig. 2,p. 7)
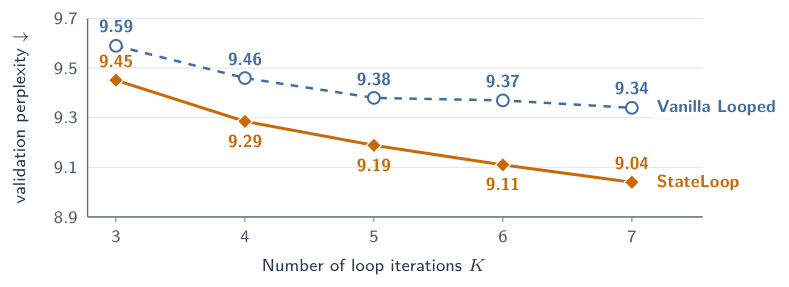
原文 Fig. 2(PDF p. 7)。纵轴越低越好;蓝色为 Vanilla,橙色为 StateLoop。右端差距更大,但图只覆盖 410M 与 $K\le7$。
4.3 解码开销:状态分支比多一次主干循环便宜
在 1.4B、BF16、单卡、批量 1、1024 token 预填充加 1024 token 续写的协议下,$K=4$ Vanilla 为 $121.224\pm1.099$ ms/token;恒等混合 StateLoop 为 $122.943\pm1.483$ ms/token(+1.418%),Attn 为 +2.106%,Mamba-2 为 +1.792%。将 Vanilla 增到 $K=5$ 则为 $151.527\pm1.064$ ms/token,相对 $K=4$ 增加 24.997%。这说明状态分支在该协议下的运行开销远小于再执行一次完整主干;它没有把循环次数减少,绝对延迟仍略高于同为 $K=4$ 的 Vanilla。(Sec. 4.4,Table 3,PDF p. 8)
4.4 状态宽度与因果组件消融
在 410M、$K=7$、25B token 的恒等混合设置下,Vanilla 的 PPL 为 9.34;状态宽度 $d_s=128,256,512,1024$ 的 PPL 依次为 9.16、9.13、9.08、9.04。$d_s=512$ 已保留了大部分质量收益,而额外参数约为 $d_s=1024$ 时的一半;说明有效状态不必与主干同宽。(Sec. 5.1,Fig. 3,PDF p. 8)
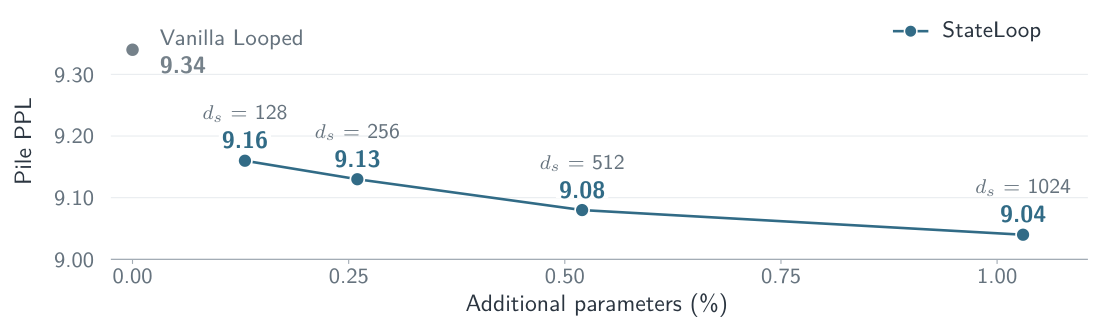
原文 Fig. 3(PDF p. 8)。横轴是相对 406.90M Vanilla 的额外参数百分比,纵轴为 Pile PPL;每个点同时标有状态宽度与 PPL。
| 410M、$K=7$ 消融 | 参数 | Pile PPL↓ | 检验的问题 |
|---|---|---|---|
| Vanilla Looped | 406.90M | 9.34 | 不加状态分支 |
| 仅用状态作下次主干输入 | 409.00M | 9.44 | 去掉直接 $H^k$ 反馈路径 |
| 每次重置状态 | 411.10M | 9.25 | 有状态分支,但没有跨循环持久性 |
| StateLoop,持续状态 | 411.10M | 9.04 | 完整设计 |
| StateLoop,GRU 更新 | 416.34M | 9.09 | 改用另一种门控更新 |
原文 Table 4(PDF p. 9)。重置状态仍优于 Vanilla(9.25 对 9.34),因此单步状态分支本身就有收益;在同参数量下让状态跨循环保留,又从 9.25 改善到 9.04,较明确地隔离了“持久性”的贡献。只用状态作反馈反而达到 9.44,说明直接主干通路也重要。GRU 的 9.09 表明收益不特属于选择性 SSM 公式,但原公式用更少参数得到 9.04。(Sec. 5.2,PDF p. 9)
4.5 状态读取与持续更新究竟何时有用
作者对已训练的 410M、$K=7$ 模型,穷举 $2^7$ 种状态读出掩蔽组合,计算每次读出对掩蔽后 NLL 增量的 Shapley 分摊。前六次反馈读出合计 63.70%,最终预测读出为 36.30%;$R_5,R_6,R_7$ 三次合计占大部分。这说明该模型的状态主要在较晚循环和最终预测中被使用,早期读出贡献较小;Shapley 数值是该掩蔽实验的归因份额,并非状态内部“信息含量”的直接单位。(Sec. 5.3,Fig. 4a,PDF p. 10)
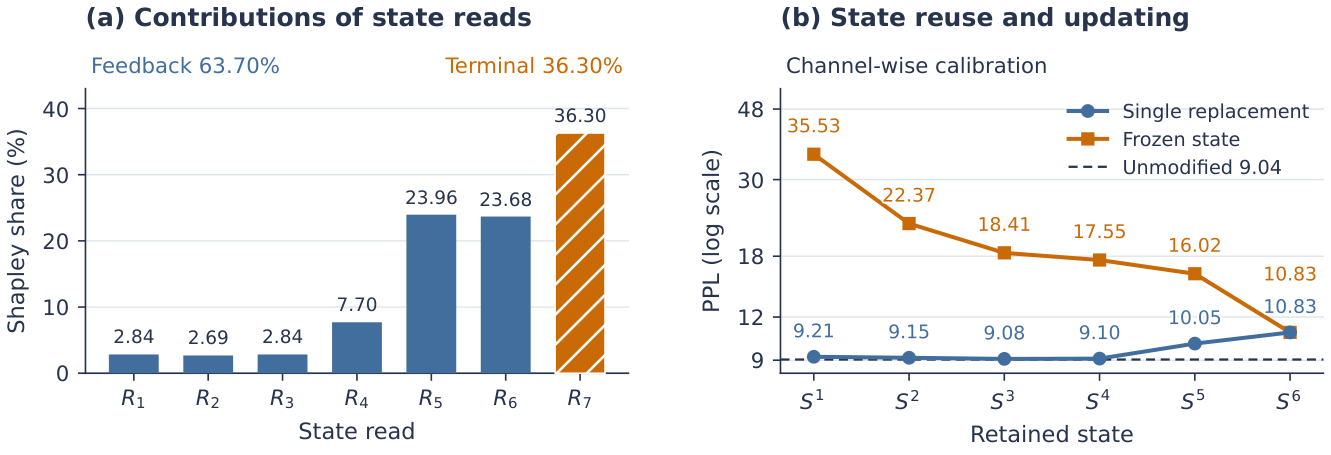
原文 Fig. 4(PDF p. 10)。右图先按通道均值与标准差校准旧状态,再做单次替换或从某一旧状态开始冻结;两条曲线的差异检验后续更新的价值。以 $S^3$ 为例:仅在下一边界替换一次,PPL 从 9.04 变为 9.08;后续一直冻结重用它,则升至 18.41。较早状态在邻近边界仍部分可用,但让它不再随循环更新会显著伤害预测。(Sec. 5.3,Eq. (15),PDF p. 10)
五:结论与理解边界
StateLoop 的有效设计并非一个单独“记忆门”:直接主干路径 + 显式门控状态 + 后续反馈与最终读出共同构成模型。重置、状态独占反馈、GRU 替换、宽度变化和读出干预分别检验了这些组件的作用。最有说服力的证据是重置与持久版本在相同参数和训练协议下的 9.25→9.04 PPL 差距;深度曲线与读出干预进一步支持跨循环保留且持续更新信息的解释。
研究边界也很具体:1.4B 的主比较固定 $K=4$,系统性的深度与状态机制实验只在 410M 完成;解码开销在指定单卡、批量 1 和 1024+1024 token 协议下测得。后续最直接的问题是,在更大模型和更多训练循环下,状态宽度、混合器与实际质量—延迟折中是否仍沿同一趋势变化。(Sec. 6,PDF p. 11)