Low-Bit N-Gram Embeddings for Language Models:中文研读笔记
作者:Stephen Chung、Wenyu Du(DualverseAI)
论文:arXiv:2610.31646v1,2026-10-22 提交;2026-10-25 获取
原文:本地 PDF · arXiv PDF
论文总览
论文研究一个具体的存储取舍:语言模型的 n-gram 嵌入表可以用很少的查表计算增加容量,但表中行数很大;与其减少行数、加剧哈希碰撞,能否保留行数而降低每个数值的位宽?作者将每个嵌入分量存为低比特码本索引,并给每行一个 16-bit 缩放因子。在五个从头训练的小模型上,4-bit 表相对原来的 16-bit 表节省约 74–75% 的表内存,同时保留 99% 以上由表带来的验证损失改善。将节省的位宽换成约四倍的表行数后,2-bit 表仍只用原表 52–54% 的内存,且获得原表改善的 122–126%;压缩后再短暂微调可进一步提高到 129–145%。对两个已有大模型,合适的混合位宽相对原 FP8 表节省 46.7% / 55.0% 的表内存,所测三个语料上的困惑度变化均小于 1.2%。(摘要;Sec. 3.2–3.6;PDF pp. 4–9、18、22–23)
核心判断是:在这些设置中,表的地址容量与每个分量的数值精度可以重新分配预算。同时要区分三个口径:上述百分比只针对 n-gram 表,不是整个模型;小模型与大模型的原表分别是 16-bit 与 FP8;“改善保留率”是相对无表模型的损失下降比例,不是模型准确率。(Sec. 3.1;App. B.5;PDF pp. 4、16)
结构地图
| 原文位置 | 作用 | PDF 定位 |
|---|---|---|
| Sec. 1 Introduction | 哈希表容量与内存的矛盾、主要贡献 | pp. 1–2;Fig. 1 p. 2 |
| Sec. 2 Method | 四表查找、低比特重建、码本与缩放 | pp. 2–3;Eqs. (1)–(2) p. 3 |
| Sec. 3.1 Experimental setup | 小模型、基准和“改善保留率” | p. 4 |
| Sec. 3.2–3.3 | 位宽、码本、缩放和混合精度 | pp. 4–5;Figs. 2–3 p. 5 |
| Sec. 3.4 | DeepSeek / Qwen 的困惑度与任务测试 | pp. 6–7;Figs. 4–5 pp. 6–7 |
| Sec. 3.5–3.6 | 低比特训练、微调和扩大表行数 | pp. 7–9;Figs. 6–7 p. 8 |
| Secs. 4–5 | 相关工作与结论 | p. 9 |
| Apps. A–B | 哈希、量化实现与实验协议 | pp. 13–16;Tables 1–2 pp. 14–15 |
| App. C | 完整数值、位宽扫描与替代哈希 | pp. 17–24;Tables 3–10、Figs. 8–10 |
一:动机——为什么先压位宽,而不是缩表
n-gram 表将当前 token 及其前驱组成的短序列映射到一个学习到的向量。每个位置只取少量向量,额外计算小,但所有可能的 token 组合远超可存储的行数,因此要哈希到固定大小的表。减少行数会让更多不同 n-gram 共用整行向量;增加行数能缓解这种冲突,却直接增加内存。DeepSeek-V4.1-Flash 的 Engram 记忆被论文列为规模例子:约 1960 亿个参数。(Sec. 1;PDF p. 1)
作者的切入点是保留更多行、降低每个嵌入分量的精度。这样不改变查表地址的数量,主要改变每行能表达的数值。论文还把省下的内存用于扩表,直接检验“多行低精度”是否优于“少行高精度”。这是一种有明确预算约束的容量重分配,而非只比较量化误差。(Sec. 1;PDF pp. 1–2)
二:方法——四表查找与逐行缩放量化
1. 输入到模型的向量
从头训练实验沿用 Over-Tokenized Transformer 的查表形式:两个表处理 bigram,两个表处理 trigram。对位置 $t$,四个哈希函数各选出一行,每行维度为 $d/4$;拼接得到维度 $d$ 的向量,再与 token embedding 相加:
这里 $x_t$ 是 token ID,$E[x_t]\in\mathbb R^d$,$h_j$ 给出表 $T_j$ 的行地址,$u_t$ 是送入后续语言模型的输入。四次查找相当于给当前 token 附加两个 bigram 和两个 trigram 记忆片段。(Sec. 2, Eq. (1);PDF p. 3)
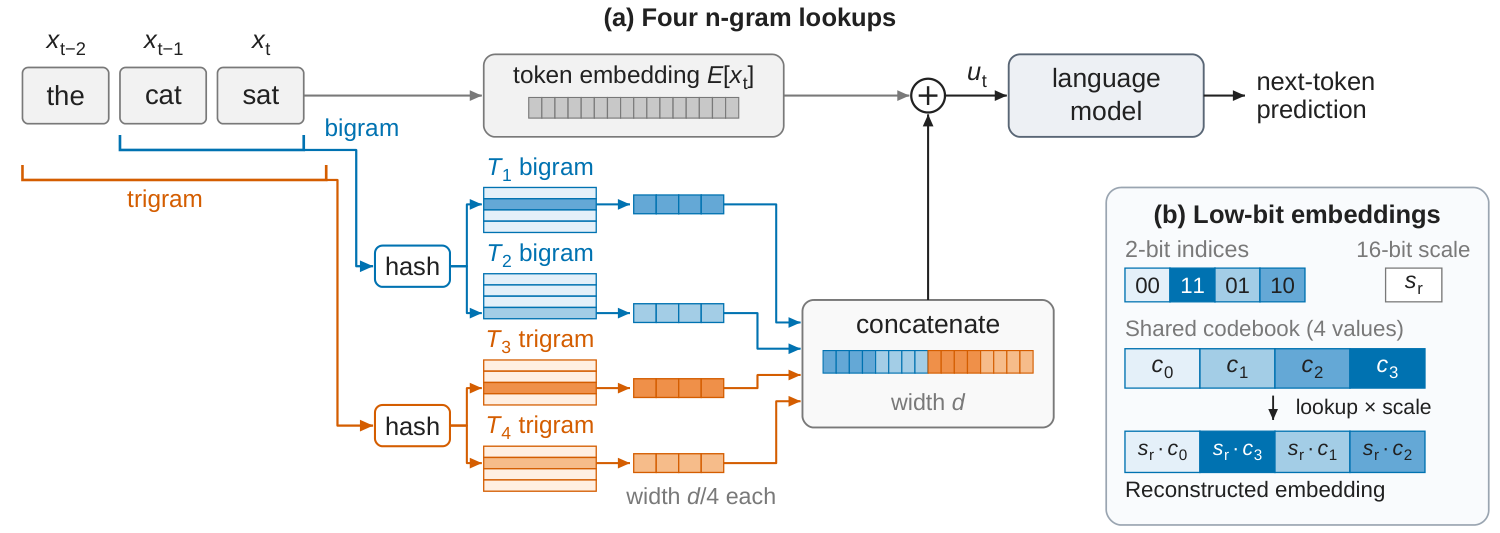
原文 Fig. 1,PDF p. 2。左图的蓝色与橙色分别是 bigram、trigram 的两次查表;右图展示索引、共享码本和逐行缩放因子如何还原一个向量。
附录给出从头训练时的地址构造:词表大小 $V=8192$,基数 $B=V+1$,$k_t^{(2)}=x_t+Bx_{t-1}$,$k_t^{(3)}=x_t+Bx_{t-1}+B^2x_{t-2}$;序列起始处缺失的前驱取 $V$。四表分别对接近 $m$ 的不同模数取余,默认 $m=262{,}141$,扩表实验为 $m=1{,}048{,}573$。不同模数让两个同阶表不必总发生相同碰撞。(App. A.1;PDF p. 13;最后一句为基于地址式的解释)
2. 分量索引、共享码本、逐行缩放
对一行嵌入 $r$ 的第 $i$ 个原值 $w_{ri}$,压缩表示为
$q_{ri}$ 是 $b$-bit 索引;$c_k$ 是该表所有行共享的第 $k$ 个码本值,存为 BF16;$s_r$ 是这一行独有的 16-bit 缩放因子。因此,一个含 $p$ 个分量的嵌入,主要存储从 $16p$ bit 变为 $pb+16$ bit,另有每表极小的共享码本开销。以 $p=128$ 为例,2-bit 从 2048 bit 降至 272 bit,减少约 86.7%;4-bit 为 528 bit,减少约 74.2%。运行时按索引取码本值并乘以该行缩放因子,不再运行码本拟合。(Sec. 2, Eq. (2);App. B.5;PDF pp. 3、16)
3. 码本如何选,缩放为什么关键
论文比较三种每表共享的码本:均匀间隔;正态分位点(在零附近更密);从训练完的嵌入分布拟合的 Lloyd–Max。后者先按每行 RMS 标准化,从每表最多 400 万个分量初始化分位点,然后交替“分配到最近码字—用被分配值的均值更新码字”60 次。这样先消除不同行的整体尺度差异,再让共享码本拟合分量分布。(Sec. 2;App. A.2;PDF pp. 3、13–14)
码本固定后,缩放可以取最大绝对值匹配、RMS,或在一组候选中选重建均方误差最小者。误差拟合候选包括 RMS 与 $\alpha s_r^{\max}$,其中 $\alpha=1.00,0.95,\ldots,0.30$;候选缩放、重建值均按 BF16 处理。压低 $\alpha$ 会牺牲极值范围,但使常见较小值被更细地表示。在 31M Llama、2-bit 的对比中,均匀码本配最大值缩放只保留 58.04% 的收益;改用误差拟合升至 86.36%。均匀、正态分位点、Lloyd–Max 在误差拟合下分别约为 86.36%、86.47%、86.52%,因此这里缩放选择比三种码本的差别更关键。(Sec. 3.3, Fig. 3a;App. A.3;PDF pp. 5、14)
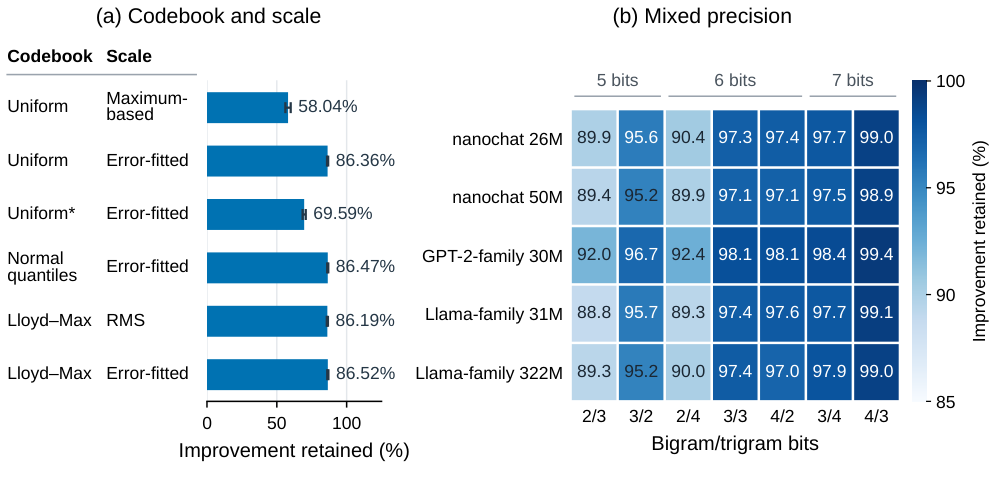
原文 Fig. 3,PDF p. 5。左图横轴是表收益保留率,右图的热图数值也是保留率;码本结果应在同一位宽和模型下比较。
三:实验——各个百分比究竟比较什么
从头训练的五个模型
作者训练 nanochat 26M / 50M、GPT-2-family 30M、Llama-family 31M / 322M。名称中的参数量不含 n-gram 表。默认每个模型有四张约 262k 行的表;扩表测试覆盖 nanochat 26M 与两个 Llama 模型,每表约 1M 行。五个模型都用 8192 词表、ClimbMix、三个随机种子;小模型约训练 5 亿个预测目标,322M 模型约 10 亿。验证集是去重并排除训练/开发重叠后的 ClimbMix 文档,共 2048 万余个预测目标。(Sec. 3.1;Apps. B.1–B.2;PDF pp. 4、14–15)
对每个架构,先比较同设置下无表模型的验证损失 $L_{\varnothing}$ 与 16-bit 表模型的损失 $L_{16}$;再压缩已训练好的表得到 $L_b$。损失以 **bits per byte(BPB,越低越好)**报告。论文的“改善保留率”可写成
$R_b=100\%$ 表示和原 16-bit 表一样好,$0\%$ 表示回到无表模型;超过 $100\%$ 表示优于原表。以 31M Llama 的均值为例,无表、16-bit、4-bit 的 BPB 分别是 1.06471、1.03956、1.03971,所以 4-bit 几乎保留全部损失下降,附录报告 99.4%。(Sec. 3.1;Table 3;PDF pp. 4、17)
已有大模型的评估
DeepSeek-V4.1-Flash 有 bigram / trigram / four-gram 表,Qwen3.8-Flash-Next 有 bigram / trigram 表;二者原表为 FP8,论文只压缩表、保持模型其余部分固定。先用 WikiText-2 验证集选择位宽,再在留出的 WikiText-2、Penn Treebank、C4 上测试:每个语料 64 个窗口、32768 个计分 token。下游测试用 HellaSwag、ARC-Challenge、WinoGrande 的完整评测集;前两项为长度归一化准确率,WinoGrande 为准确率。困惑度越低越好;准确率差异以百分点理解,置信区间来自配对 bootstrap。(Sec. 3.4;App. B.3;PDF pp. 6、15–16)
四:结果——从压缩到重新分配内存
3.2 位宽与收益:4-bit 几乎不动损失,2-bit 出现代价
在默认 262k 行/表、Lloyd–Max 码本和误差拟合缩放下,附录 Table 3 给出以下跨五模型的范围;范围中的内存节省和保留率均相对各自的 16-bit 表:
| 每分量位宽 | 表内存节省 | 原表收益保留率 | 读法 |
|---|---|---|---|
| 4 bit | 74.0–74.6% | 99.3–99.6% | 很接近原表 |
| 3 bit | 80.2–80.8% | 97.1–98.1% | 进一步压缩,损失小 |
| 2 bit | 86.5–87.1% | 85.9–90.1% | 精度代价明显 |
| 1 bit | 92.7–93.3% | −27.3–29.0% | 直接后量化不可靠 |
最后一行出现负值,意味着相应 Llama 模型的直接 1-bit 压缩比无表模型还差;它不意味着“负内存收益”。三种架构的 2-bit 点也并非同等稳健,例如 30M GPT-2 的保留率标准差为 4.2 个百分点,而 322M Llama 为 0.9 个百分点。(Fig. 2;Table 3;PDF pp. 5、17)
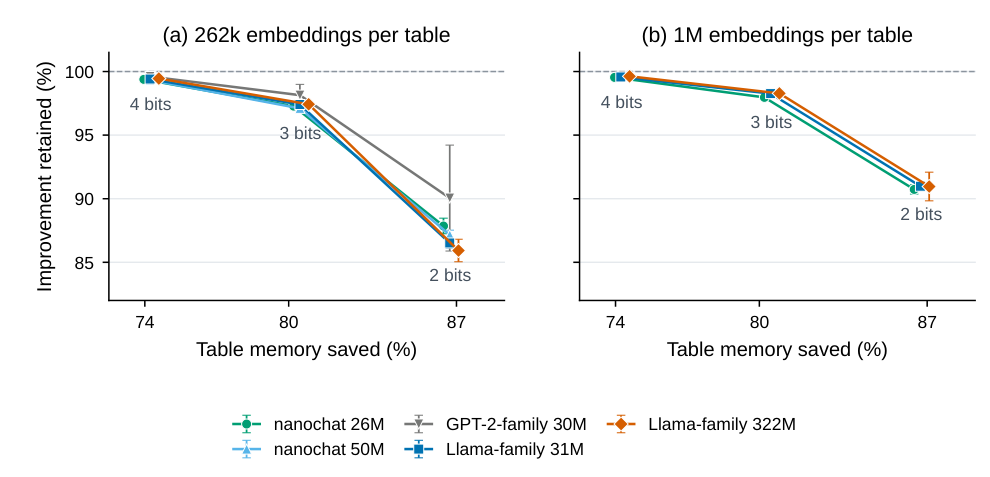
原文 Fig. 2,PDF p. 5。横轴为相对 16-bit 表节省的内存,纵轴为由表带来的损失改善保留率;右图使用更大的 1M 行表,并以对应 1M 行高精度表的收益作保留率参照。
3.3 混合精度:小模型更值得给 bigram 位宽
两个 bigram 表和两个 trigram 表行数及分量数接近,故同总位数的 $b_2/b_3$ 配置内存近似相同。作者扫描两者各 2、3、4 bit 的九种组合。在五个小模型和两种表规模中,同预算下给 bigram 更多位通常更好:默认表的 4/3-bit 保留 98.9–99.4% 收益,同时节省 77–78% 表内存。31M Llama 的同预算例子是 4/3:99.1% 对 3/4:97.7%。这表明被量化的两组特征对误差的敏感度不同;单纯按表的行数平均分配位宽不是最佳选择。(Sec. 3.3, Fig. 3b;App. C.3, Fig. 8;PDF pp. 5、20)
3.4 大模型:原 FP8 表仍有压缩空间,但位宽偏好不同
在 WikiText-2 选择集上,统一 4-bit 时 DeepSeek 的困惑度增加 1.26%,Qwen 几乎不变;统一 3-bit 时分别增加 5.06% 与 0.52%。等内存的混合配置显示 DeepSeek 更受益于给 trigram 或 four-gram 加一位,Qwen 则更受益于给 bigram 加一位。因此不能把小模型“优先 bigram”的经验直接当成各架构的固定规则。(Sec. 3.4, Fig. 4;PDF p. 6)
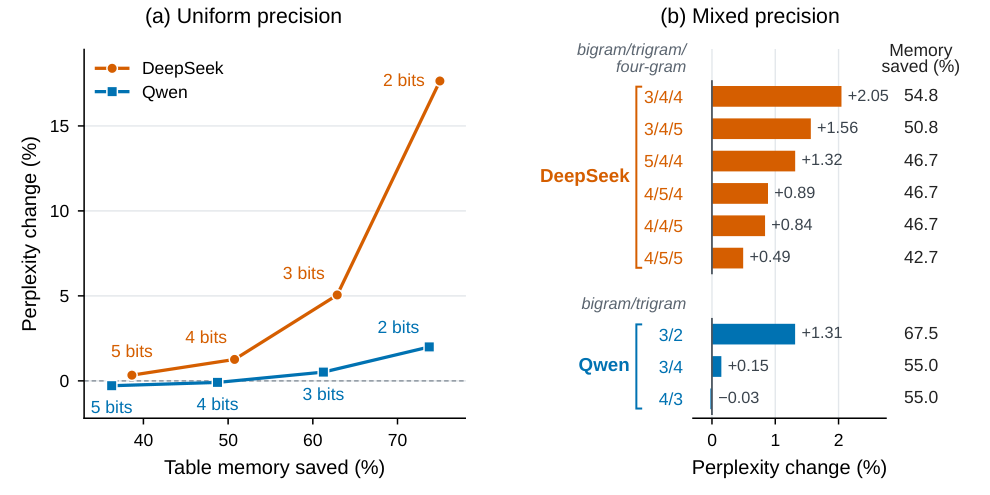
原文 Fig. 4,PDF p. 6。左图横轴是相对 FP8 原表的内存节省,纵轴是 WikiText-2 选择集困惑度相对变化;右图在标出各阶 n-gram 位宽的同时给出内存节省与困惑度变化。
作者进一步选择 DeepSeek 4/5/4-bit、Qwen 4/3-bit。两者分别节省 46.7%、55.0% 的表内存;在三个留出语料上的结果为:
| 模型 / 留出语料 | 原困惑度 → 低比特困惑度 | 相对变化 |
|---|---|---|
| DeepSeek / WikiText-2 | 2.7564 → 2.7870 | +1.110% |
| DeepSeek / PTB | 7.7730 → 7.7794 | +0.082% |
| DeepSeek / C4 | 7.9679 → 7.9584 | −0.119% |
| Qwen / WikiText-2 | 4.2270 → 4.2671 | +0.949% |
| Qwen / PTB | 4.0633 → 4.0558 | −0.183% |
| Qwen / C4 | 9.2329 → 9.2354 | +0.027% |
来源:App. C.4, Table 6,PDF p. 22。WikiText-2 留出集的增加有配对 95% 区间:DeepSeek 为 [0.689%, 1.540%],Qwen 为 [0.443%, 1.479%];PTB/C4 的区间跨零。
下游三项任务的平均准确率差为 DeepSeek −0.93 个百分点、Qwen −0.27 个百分点。逐项看,最大点估计下降是 DeepSeek 在 WinoGrande 的 −1.74 个百分点、Qwen 在 WinoGrande 的 −1.42 个百分点;表 7 中六项配对 95% 区间均跨零。因而数据支持“在所测任务上变化较小”,也保留了单项估计的不确定性。(Fig. 5;Table 7;PDF pp. 7、22)
3.5 低比特训练与微调:适应量化误差有用
31M Llama、262k 行/表的实验比较四条路径:从一开始用量化前向训练;先预训练再压缩并微调;先微调再压缩;以及直接压缩。前两种需要训练时保留 BF16 权重副本供梯度更新,前向查得的向量被量化,反向以直通估计器传梯度。262k 表的短微调额外进行 381 次更新,全部权重可训练;比较微调顺序时使用同等微调预算的参照模型。(Sec. 3.5;App. B.4;PDF pp. 7–8、15–16)
| 路径(31M Llama) | 1-bit 保留率 | 2-bit 保留率 |
|---|---|---|
| 直接预训练在低比特前向下 | 77.0% | 87.0% |
| 预训练 → 压缩 → 微调 | 65.3% | 92.0% |
| 预训练 → 微调 → 压缩 | −5.7% | 86.5% |
| 预训练 → 压缩 | −5.7% | 86.5% |
来源:App. C.5, Table 8,PDF p. 23;均为三种子的均值。 微调放在压缩之后,尤其在 1-bit 时,比仅增加相同训练步数更有效;而 1-bit 从头适应量化前向又高于后量化再短微调。训练阶段保留 BF16 副本意味着这里的表压缩比例不能直接当作训练峰值内存节省。(Fig. 6;App. B.4;PDF pp. 8、15–16)
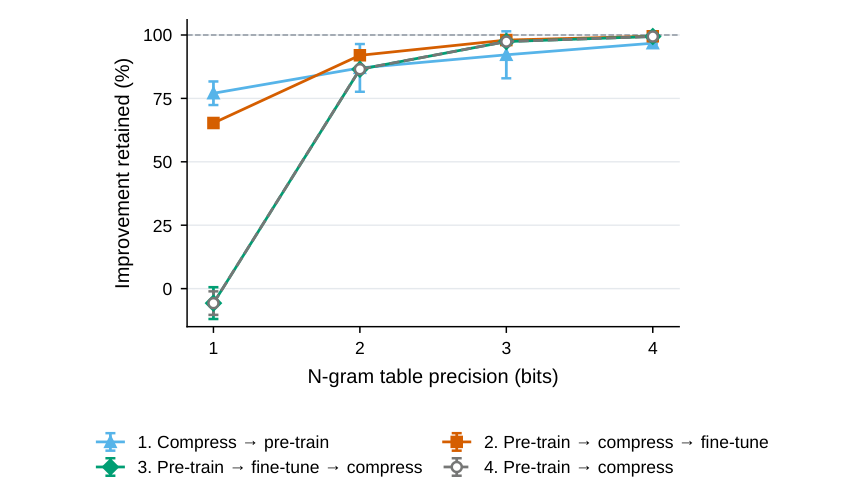
原文 Fig. 6,PDF p. 8。四条曲线在同一位宽下比较;横轴是每分量位宽,纵轴是相同训练预算参照下的收益保留率。
3.6 把存储预算换成更多行
参照为每表约 262k 行、16-bit。将行数约增至 1M 后,2-bit 表仍只占原表的约一半;三种模型均超过原表提供的损失改善:
| 模型 | 1M 行、2-bit 内存 / 原表 | 压缩后、未微调 | 压缩后再微调 |
|---|---|---|---|
| nanochat 26M | 54.2% | 121.9% | 128.7% |
| Llama-family 31M | 53.1% | 125.8% | 136.3% |
| Llama-family 322M | 51.7% | 122.3% | 144.7% |
来源:App. C.1, Table 4,PDF p. 18;App. C.5, Table 9,PDF p. 23。收益列都相对 262k 行的 16-bit 表;两种微调顺序使用相同的额外预算。 这组实验真正支撑“重投资”的结论:2-bit 减少单行容量,允许约四倍行数,哈希共享压力降低后的收益超过量化误差。3-bit 更进一步提高改善,但内存上升到原表的 76.7–79.2%;4-bit 的 1M 行表在三种模型上反而略超原表内存(101.7–104.2%)。(Sec. 3.6, Fig. 7;Tables 4、9;PDF pp. 8、18、23)
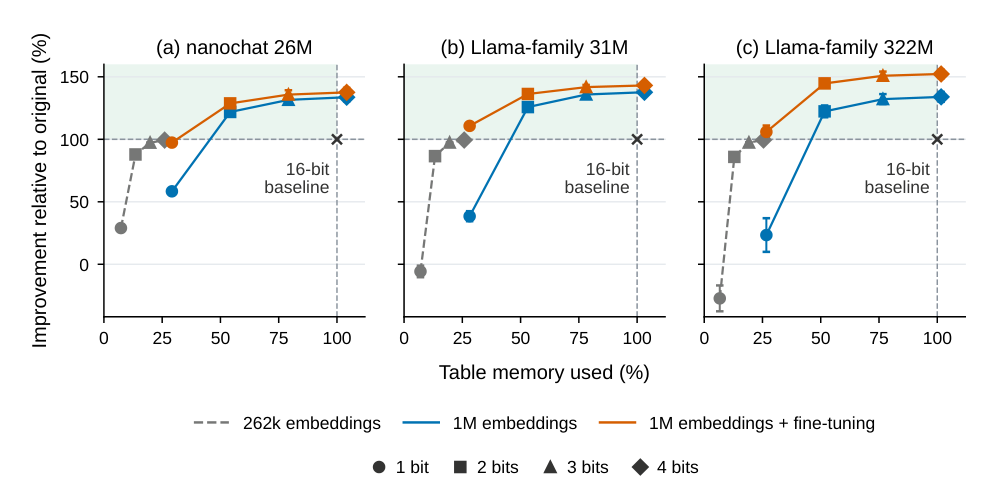
原文 Fig. 7,PDF p. 8。横轴是使用的表内存,纵轴是相对原 262k/16-bit 表的改善;(100%, 100%) 是原表。绿色区域表示比原表省内存且改善更多。
附录补充:碰撞的“共享粒度”也可能重要
传统哈希让两个碰撞的 n-gram 共享整行。附录 C.6 试验按分量另选地址:一种只在同一列中选行,另一种在扁平化表中任取元素。在 2-bit、从头低比特训练的三个架构上,传统整行哈希相对 16-bit 原表保留 87.0–93.7% 的改善;两种逐分量方案的均值范围约 93.6–100.3%。例如 31M Llama 分别为 87.03%、100.28%、98.39%(传统、同列、全随机),但同列方案标准差达 10.54 个百分点。结果提示碰撞共享的粒度值得研究;这里的方差也使单个均值的排序不宜过度解读。(App. C.6, Table 10;PDF p. 24)
五:结论与实际取舍
这篇论文最有用的经验不是“所有表都用 4 bit”,而是把设计拆成三个变量:行数、分量位宽、不同 n-gram 阶数的位宽分配。4-bit 为无需明显牺牲原表收益的压缩点;更激进的 2-bit 适合配合更大的表或压缩后微调;缩放因子拟合在 2-bit 时比更换码本家族更有影响。适合的混合位宽须按模型实测,DeepSeek 和 Qwen 的偏好就不同。(Secs. 3.2–3.6;PDF pp. 4–9)
部署时要把论文结论放回测量条件:报告的是表的理论存储量,没有给出压缩查表解码后的端到端吞吐或总模型显存收益;大模型只改表、在有限语料窗口及三项下游任务上评估;从头低比特训练还保留 BF16 主副本。这些条件决定了本文最强的证据是“表存储—所测模型质量”的取舍,实际服务收益仍需按硬件和查表实现测量。(App. B.3–B.5;PDF pp. 15–16)