A Fix for Softmax and Cross-Entropy:中文精读笔记
作者:Jonathan T. Barron、Dan Gnanapragasam、Michael Tschannen(Google DeepMind)
论文:arXiv:2610.31642v1,2026-10-22 提交;本地原文 PDF
本次研读:2026-10-27
论文总览
论文指出:常用的“先减最大 logit”只解决指数溢出,没有保证极小但有意义的梯度在浮点数中存活。一类错误出现在硬标签分类的高置信度阶段:目标类梯度被舍入为零,非目标类梯度却仍为正,破坏交叉熵梯度的零和性质。另一类错误出现在软标签蒸馏的教师与学生几乎重合时:先分别算概率再相减会丢掉两者的微小差异,甚至在 logits 完全相同处产生伪梯度。作者通过改写计算顺序,在不改变精确算术下的 softmax/交叉熵定义的前提下保留这些梯度,并在模运算 grokking 与蒸馏实验中观察到 loss spike 和学生漂移消失。(Sec. 1–3, PDF pp. 1–4;Fig. 1, p. 1)
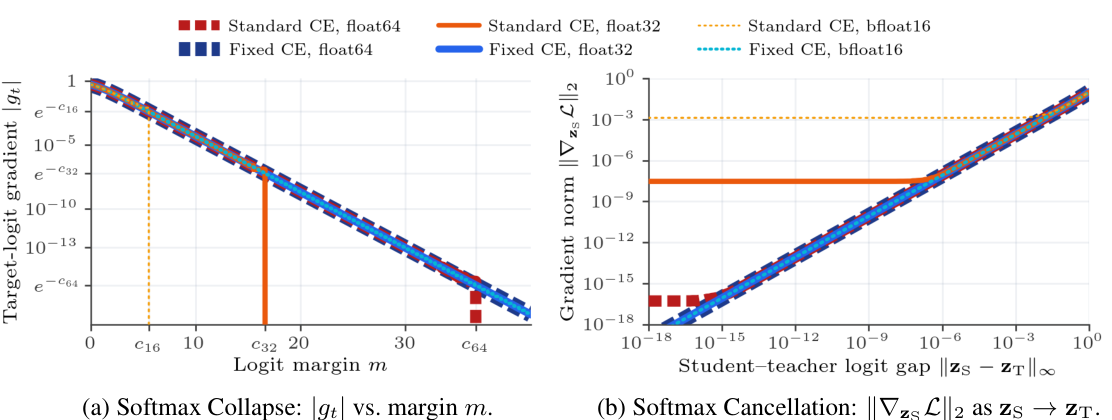
图 1 左:横轴是目标类相对其他类的 logit margin,纵轴是目标 logit 梯度绝对值,标准实现到精度断崖后骤降为零;右:横轴是学生与教师 logit 的最大差距,纵轴是梯度范数,标准实现出现非零噪声底。图中 fixed 曲线由作者提出的计算式产生。(Fig. 1, PDF p. 1)
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 | |—|—| | 1 Introduction | 定义两个问题和 margin | pp. 1–2,Fig. 1,Eq. (1)–(2) | | 2 Softmax Collapse | 推导硬标签失真及改写的 log-softmax、交叉熵 | pp. 2–3,Eq. (3)–(7) | | 3 Softmax Cancellation | 推导从教师/学生 logit 差求梯度 | pp. 3–4,Eq. (8)–(9) | | 4 The Slingshot Mechanism | 解释与 Adam/AdamW 的相互作用 | pp. 4–5,Fig. 2 | | 5 Margin Equilibria | 分析权重衰减与 Adam 的 $\epsilon$ 对 margin 的平衡 | pp. 5–6,Eq. (10)–(11),Fig. 3–4 | | 6 Grokking Across Precisions and Benchmarks | 精度、$\epsilon$、基线和多任务比较 | pp. 6–8,Fig. 5–6,Table 1 | | 7 Soft-Target Distillation | 检查教师与学生重合时的参数漂移 | p. 8,Fig. 7 | | 8 Conclusion | 归纳发现和使用范围 | pp. 8–9 |
一:问题为何出现
设 $z\in\mathbb R^K$ 为一条样本的 $K$ 类 logits,$t$ 是正确类,$q=\operatorname{softmax}(z)$。交叉熵对 logits 的精确梯度是 $g=q-p$;硬标签时 $p_t=1$,其余为零。因此 $\sum_k g_k=0$:给所有 logits 同时加同一个常数不会改变损失,这是应被梯度保留的平移不变性。常见的减最大值实现避免了 $e^{z_k}$ 溢出,但不保证后续求和、相减能保留很小的量。(Sec. 1–2, PDF pp. 1–2,Eq. (1)–(4))
作者定义目标类 margin
$$m=z_t-\log\sum_{j\ne t}e^{z_j},\qquad e^{-m}=\sum_{j\ne t}e^{z_j-z_t}.$$当 $t$ 已是最大 logit,常规 softmax 的分母是 $1+e^{-m}$。若 $e^{-m}$ 小到加在 $1$ 上被舍入掉,就得到 $q_t=1$,于是直接计算 $g_t=q_t-1=0$;非目标梯度 $g_j\approx e^{z_j-z_t}$ 仍然非零。其临界 margin 约为 bf16:5.5,fp32:16.6,fp64:36.7。这些数字对应“加到 1 上后不可分辨”,并非指数函数本身已经下溢。(Sec. 1–2, PDF pp. 1–2,Fig. 1a,Eq. (2)–(4))
一个原文例子是 fp32 的 $z=(9,-9,-9)$、$t=0$:此时 $e^{-m}=2e^{-18}\approx3.046\times10^{-8}$。标准实现给出损失 $0$、梯度 $(0,1.523\times10^{-8},1.523\times10^{-8})$;修正实现给出损失 $3.046\times10^{-8}$、梯度 $(-3.046\times10^{-8},1.523\times10^{-8},1.523\times10^{-8})$。这直观显示错误是目标分量缺失,并非整条样本已无梯度。(Sec. 2, PDF p. 3,代码例子)
二:两个修正如何计算
2.1 高置信度硬标签:先求小量,再用 softplus
硬标签交叉熵可以写为
$$\mathcal L(z,t)=\operatorname{softplus}(-m),\qquad m=-\operatorname{LSE}_{j\ne t}(z_j-z_t).$$这里 $\operatorname{LSE}$ 是 log-sum-exp;目标类从非目标求和中排除。稳定的 softplus 在 $e^{-m}$ 很小时保留 $\log(1+e^{-m})\approx e^{-m}$。自动微分沿 $z_j-z_t$ 求导,直接得到
这使目标梯度由非目标梯度的负和生成,避开“先把 $q_t$ 舍入成 1、再减 1”的路径。通用 log-softmax 则选最大 logit $i_{\max}$,把该槽精确设为 0、从 LSE 中排除,再对其余量用 softplus 合并。即使 softmax 前向输出的最大概率仍因精度限制显示为 1,沿修正表达式反传仍能得到正确的小梯度。(Sec. 2, PDF pp. 2–3,Eq. (5)–(7))
2.2 近似相同的教师与学生:从 logit 差求概率差
软标签蒸馏中,$p=\operatorname{softmax}(z_T)$、$q=\operatorname{softmax}(z_S)$,精确梯度为 $q-p$。标准流程分别求 $p$、$q$ 再相减,两个接近的概率先被舍入,差值信息就丢失了。更直接的恒等式是 $q_k/p_k=e^{\delta_k}/\sum_i p_i e^{\delta_i}$,其中 $\delta=z_S-z_T$。作者用 $p$ 加权中心化并计算
$$d_k=\delta_k-\sum_i p_i\delta_i,\qquad s_k=d_k-\operatorname{log1p}\!\left(\sum_i p_i\operatorname{expm1}(d_i)\right),\qquad u_k=p_k\operatorname{expm1}(s_k).$$$s_k$ 是 $\log(q_k/p_k)$,$u_k$ 是避免近似相等概率直接相减的 $q_k-p_k$。最后采用 $g_k=u_k-q_k\sum_i u_i$ 消除剩余的求和漂移。若 $z_S=z_T$,则 $\delta=d=s=u=g=0$。expm1 和 log1p 分别在自变量接近 0 时精确计算 $e^x-1$、$\log(1+x)$;论文用“前向值仍为交叉熵、反向梯度替换为 $g$”的 JAX 写法实现。(Sec. 3, PDF pp. 3–4,Eq. (8)–(9))
论文给出的 fp32 三类数值例子中,标准梯度为 $[-5.960,1.452,-0.112]\times10^{-8}$,修正梯度为 $[-4.596,4.144,0.451]\times10^{-8}$,后者与 fp64 参考结果一致;标准结果的第三分量连符号都错了。(Sec. 3, PDF p. 4,代码例子)
三:Slingshot 与 margin 平衡
作者对 Slingshot 的机制解释是:记忆训练集后,margin 增大到 fp32 断崖附近;常规交叉熵的目标梯度突然归零,让 Adam 二阶矩估计 $\hat v$ 衰减。若权重衰减或残留的非目标更新使少量样本掉回断崖以下,目标梯度又突然出现,此时它被很小的 $\sqrt{\hat v}+\epsilon$ 放大,形成参数跃迁和训练损失尖峰。修正梯度则平滑减小,因此在论文实验中消除了这类尖峰。(Sec. 4, PDF pp. 4–5,Fig. 2)
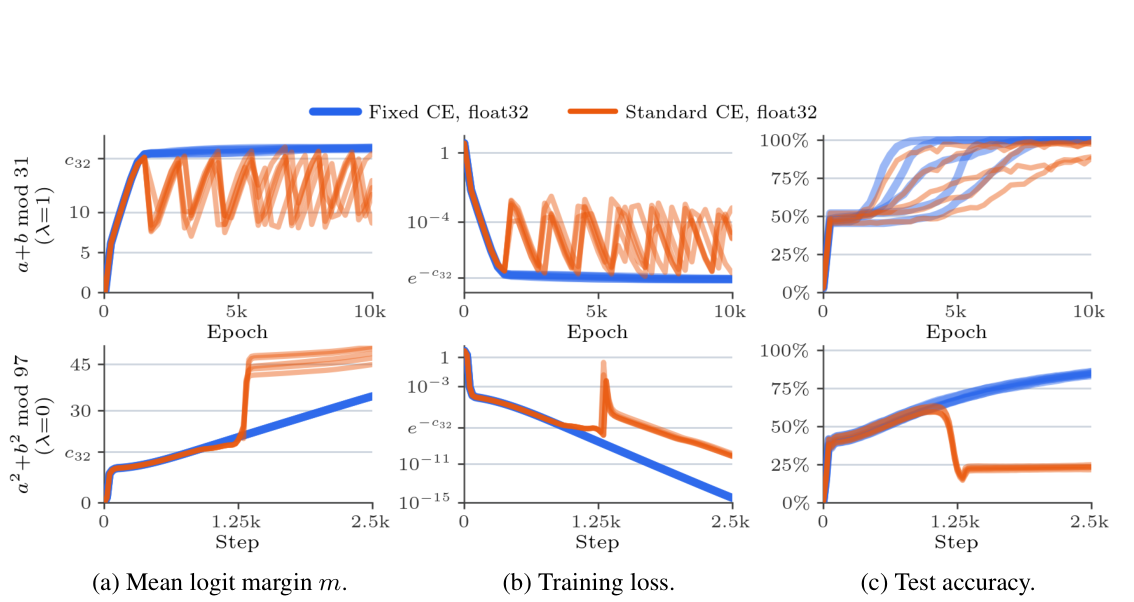
图 2 上排是 $a+b\bmod31$、权重衰减 $\lambda=1$:橙色标准实现的 margin 反复跌回断崖附近、loss 尖峰重复出现,蓝色修正实现平滑达到更高测试准确率。下排是 $a^2+b^2\bmod97$、$\lambda=0$:标准实现约在第 1250 步的尖峰后准确率从 61% 降至 23%,修正实现继续升至 85%。这也解释了为何有些既有观察会把尖峰误认为有助泛化:当输出前有 LayerNorm 且无权重衰减,尖峰增大前层权重范数,相当于偶然减小有效学习率;不同权重范数约束下的效果不能混为一谈。(Sec. 4, PDF p. 5,Fig. 2)
修正后,$\lambda>0$ 时 margin 并不无限增大。AdamW 的驻点满足
$$\frac{g_i}{|g_i|+\epsilon}+\lambda\theta_i=0.$$记忆之后 $|g_i|\propto e^{-m}$;在 $|g_i|\ll\epsilon$ 区间,归一化梯度约为 $g_i/\epsilon$,它最终与 $\lambda\theta_i$ 平衡。对论文所考察的设置,平衡 margin 近似为 $m^*(\epsilon)\approx\log(1/\epsilon)$;$\lambda$、参数尺度和梯度比例常数被此近似省略,因此这不是与模型配置无关的精确等式。$\epsilon=10^{-8}$ 时预测值约 18.4,恰在 fp32 断崖 16.6 之上,于是标准实现可能先触发断崖;$\epsilon\ge10^{-7}$ 时预测值至多约 16.1,标准实现可在断崖前停下。(Sec. 5, PDF pp. 5–6,Eq. (10)–(11),Fig. 3)
作者还用 LaProp 直接更新二阶矩的平方根,避免平方梯度先下溢,检验 $\epsilon$ 从 $10^{-8}$ 到 0 的趋势:有权重衰减时各曲线靠近相应 $\log(1/\epsilon)$ 平台;无权重衰减时 margin 越过该值继续上升。$\epsilon=0$ 时,fp32 梯度最终在约 $m=81.2$ 处下溢。(Sec. 5, PDF p. 6,Fig. 4)
四:实验结果如何支持结论
精度、优化器参数与基线
主实验使用一层、宽度 64 的 ReLU Transformer 学习 $a+b\bmod31$;训练集占 50%,full-batch AdamW 训练 10,000 epochs,学习率 $10^{-3}$、$\beta_1=0.9$、$\beta_2=0.98$、$\lambda=1$。只改变损失、bf16/fp32/fp64 精度及 $\epsilon\in\{10^{-8},10^{-12},10^{-16}\}$。Table 1 的测试准确率为 5 个种子的均值 ± 标准差,越高越好;final margin 反映训练停止时的置信度,不是准确率。(Sec. 6, PDF pp. 6–7,Fig. 5,Table 1)
| 精度与方法 | $\epsilon=10^{-8}$ 测试准确率 | $\epsilon=10^{-16}$ 测试准确率 | $\epsilon=10^{-16}$ final margin |
|---|---|---|---|
| fp32 修正 CE | 100.0 ± 0.0% | 99.0 ± 2.3% | 36.8 |
| fp32 标准 CE | 94.3 ± 5.4% | 96.5 ± 4.3% | 12.7 |
| bf16 修正 CE | 100.0 ± 0.1% | 98.9 ± 2.4% | 36.8 |
| bf16 标准 CE | 93.3 ± 7.4% | 94.2 ± 8.3% | 5.8 |
| fp64 修正 CE | 100.0 ± 0.0% | 99.0 ± 2.0% | 36.8 |
| fp64 标准 CE | 100.0 ± 0.0% | 97.2 ± 3.2% | 30.1 |
较小的 $\epsilon$ 把目标 margin 推高,因而即便 fp64 标准实现,在 $\epsilon=10^{-16}$ 时也接近并跨过 36.7 的精度断崖;修正 CE 仍沿预期 margin 增长。两个相关基线的对照也有意义:Zero-sum Projection 把每个 logit 梯度减去平均值,只修补零和约束,不能重建丢失的目标梯度;在 fp32、$\epsilon=10^{-12}$ 时准确率 48.9 ± 2.6%。StableMax 改用分段有理函数取代指数,改变了损失形状,margin 可达数千;同条件下准确率 95.6 ± 2.0%,修正 CE 为 99.6 ± 0.7%。(Sec. 6, PDF p. 7,Table 1)
另外四个 grokking 任务
作者以 $\epsilon=10^{-12}$ 测试两项模加法 Transformer 任务($\bmod113$、$\bmod31$,$\lambda=1$)和两项模多项式二层 MLP 任务($a^2+b^2\bmod97$、$a^3+b\bmod97$,$\lambda=0.2$)。四项中,fp32 标准 CE 到 16.6 左右都出现反复尖峰,而 fp32 修正 CE 的测试准确率轨迹接近 fp64 标准 CE,最终达到 100%。(Sec. 6, PDF pp. 7–8,Fig. 6)
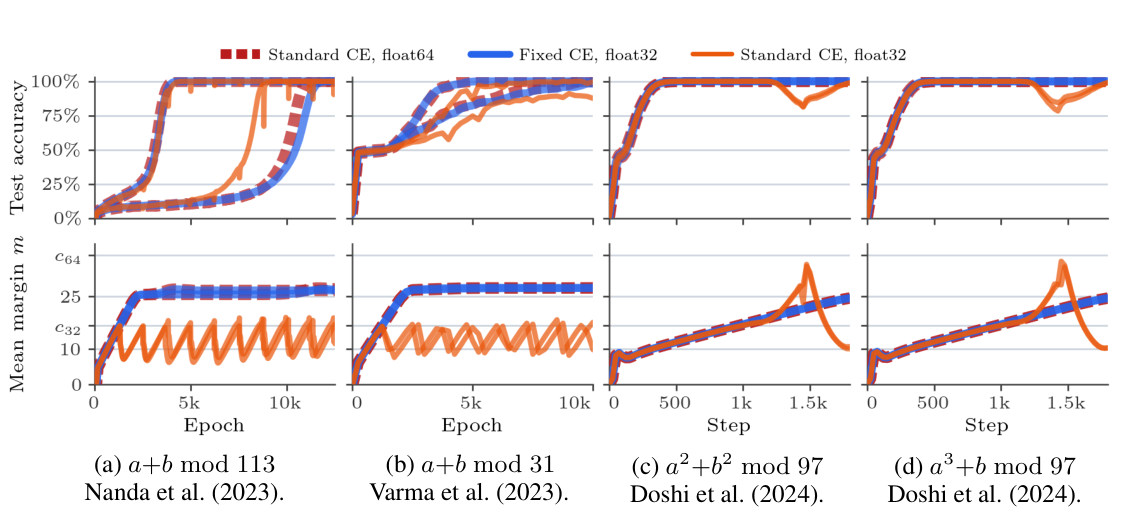
图 6 上排读测试准确率、下排读平均 margin;蓝色是 fp32 修正 CE,橙色是 fp32 标准 CE,红色虚线是 fp64 标准 CE。后两项的横轴是训练 step,前两项是 epoch,不能直接比较时间尺度。
软标签蒸馏:从相同教师权重出发
教师先在 $a+b\bmod53$ 达到 100% 测试准确率,再把全部权重复制给学生。随后用温度 $T=4$、Adam 学习率 $2\times10^{-3}$、$\lambda=0$、$\epsilon=10^{-8}$ 蒸馏 2,000 步;温度将缩放后的 margin 保持在 bf16 断崖以下,以隔离第二种错误。初始参数相同使真实梯度应为零,因此这个设置直接测试数值伪梯度会否驱动训练。评估量是 held-out $\mathrm{KL}(p_T\Vert q_S)$(越低越好)和测试准确率(越高越好)。(Sec. 7, PDF p. 8,Fig. 7)
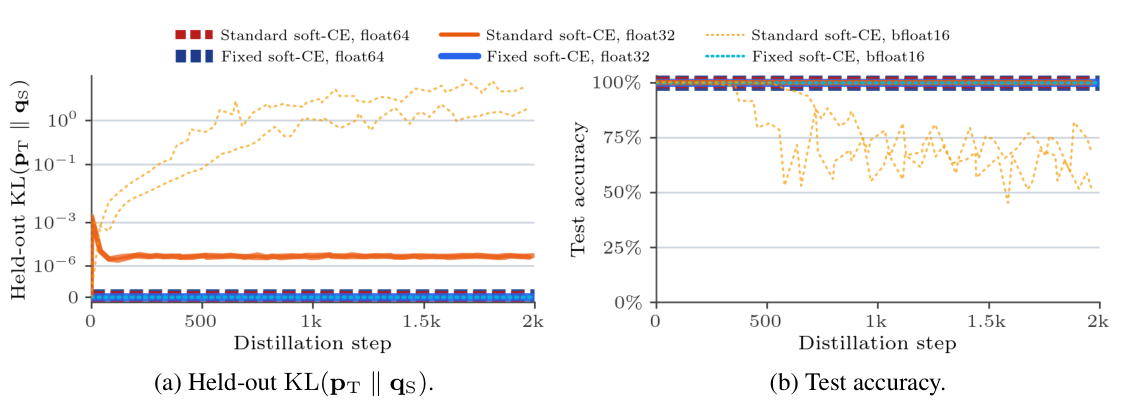
标准实现的残留梯度量级约为 fp64 $10^{-17}$、fp32 $10^{-8}$、bf16 $10^{-3}$。它一旦超过 Adam 的 $\epsilon=10^{-8}$,便可能被归一化成近似学习率量级的参数步:bf16 学生明显偏离教师且准确率下降,fp32 出现短暂 KL 尖峰。修正实现的学生保持 $\mathrm{KL}=0$、测试准确率 100%(图中展示 3 个种子中的 2 个)。(Sec. 7, PDF p. 8,Fig. 7)
五:结论与实践判断
本文的关键价值在于改变浮点计算路径,而非改变精确算术目标:高置信度时直接保留非目标概率总质量;近教师蒸馏时直接由 logit 差构造概率差。两个修正都围绕梯度应满足的结构性质,因而比事后归零或只升高精度更切中论文所测的失败机制。(Sec. 2–3、6–7,PDF pp. 2–8)
证据主要来自受控的模运算 grokking 和“学生初始化为教师”的蒸馏测试;作者也指出所测极大 margin、极小教师—学生差异在常规大规模训练中不常见。论文提出可以低开销替换常用函数,但没有给出大规模训练或端到端运行时间的实测比较。因此是否在特定模型中带来收益,需要结合该模型的 margin、数值精度及蒸馏接近程度判断。(Sec. 8, PDF pp. 8–9)
实现时应对照所读版本:arXiv v1 的软标签 JAX 片段直接使用 $p_k\operatorname{expm1}(s_k)$;作者项目页现行片段在 $|s_k|\ge1$ 时回退到 $q_k-p_k$,以规避极端下溢概率与溢出指数形成的 $0\cdot\infty$。论文实验关注 $z_S\approx z_T$ 的区域,读者复制代码时应按实际动态范围选择处理方式。