OpenAttention: One Percent Is Enough with Tail Proxies:中文精读笔记
论文:Hyunwoo Yu、Jongbeom Lee、Hyunbin Kim、Sungjun Park、Jaemin Choi、Jincheol Yang、Seunghun Moon、Bongjoon Hyun、Kyomin Sohn、Kyeongbo Kong、Suk-Ju Kang。版本:arXiv:2610.30951v1,2026-10-22 提交;本次研读于 2026-10-25。原文:本地 PDF,27 页。
论文总览
长上下文解码时,读取 KV 缓存带来大量内存流量。稀疏注意力只精确读取少量 token,但未读取的长尾仍可能贡献可观的 softmax 质量和输出。OpenAttention 的核心办法是:精确读取少量重要 token,同时把其余 token 分成若干簇,每簇用一个带成员数的均值代理进入同一个 softmax。查询几何聚类 QGC 让簇内注意力分数尽量接近;查询几何选择器 QGS 找出该精确读取的 token;ErrorGate 估计每簇的代理权重误差并分配预算。
在 Llama-3.1-8B-Instruct、RULER-32K HARD 七项任务上,总 KV 读取量为 1% 时,OpenAttention 的平均准确率是 86.30,密集注意力为 87.04,即保留约 99.15% 的分数、相差 0.74 个百分点(Fig. 8,PDF 第 7 页;Table 11,第 23 页)。定制内核在 32K 上下文、batch 32、1% 读取时将单层解码注意力阶段由 1.20 ms 降至 0.12 ms;该 10× 不代表完整解码步的端到端加速(Table 9,第 22 页)。
结构地图
| 原文章节 | 作用与关键定位 |
|---|---|
| §1 Introduction | 未读取长尾的问题;Fig. 1–2,PDF 第 1–2 页 |
| §2 Key observation on one simple proxy | 单代理与随机采样的输出误差、权重差异;Fig. 3–4、Eq. (1)–(3),第 3–4 页 |
| §3 OpenAttention | QGC、QGS、ErrorGate 与融合内核;Fig. 5–7、Eq. (4)–(7),第 4–7 页 |
| §4 Experiments | 密度、消融、跨模型、KV 压缩、长度;Fig. 8、Table 4–7,第 7–9 页 |
| §5–6 Related work / Conclusion | 与丢弃、采样和聚类方法的关系、局限;第 8–9 页 |
| Appendix A–C | 精确误差恒等式与界、尾部公式、诊断、内核算法;第 12–22 页 |
| Appendix D–I | 预算搜索、逐任务结果、baseline 配置、非 RULER 任务、KV 压缩与长度协议;第 22–27 页 |
一:动机——为什么不能只预测 top-k
top-k 方法精确算出少量最大的注意力项后,通常把其余项直接丢弃;这在需要累积多处信息的任务(论文举例为 FWE)会改变输出。vAttention 先选重项再随机抽取残差,MagicPIG 用哈希碰撞做重要性采样。低读取率下,实用选择器漏掉的高权重 token 仍在尾部,极小的随机样本容易完全错过它们(§1,PDF 第 2 页)。
作者先在两个 RULER 解码注意力头上做受控比较:固定总读取量,观察“只选 top-k”“top-k 加随机样本”“top-k 加一个尾部代理”的相对输出误差。使用 HashAttention 选择器时,一个代理在所绘密度范围内误差最低;使用 oracle top-k 时,它在低密度更有利。这是两个注意力头上的机制观察,不等同于全任务性能结论(Fig. 3,PDF 第 3 页)。
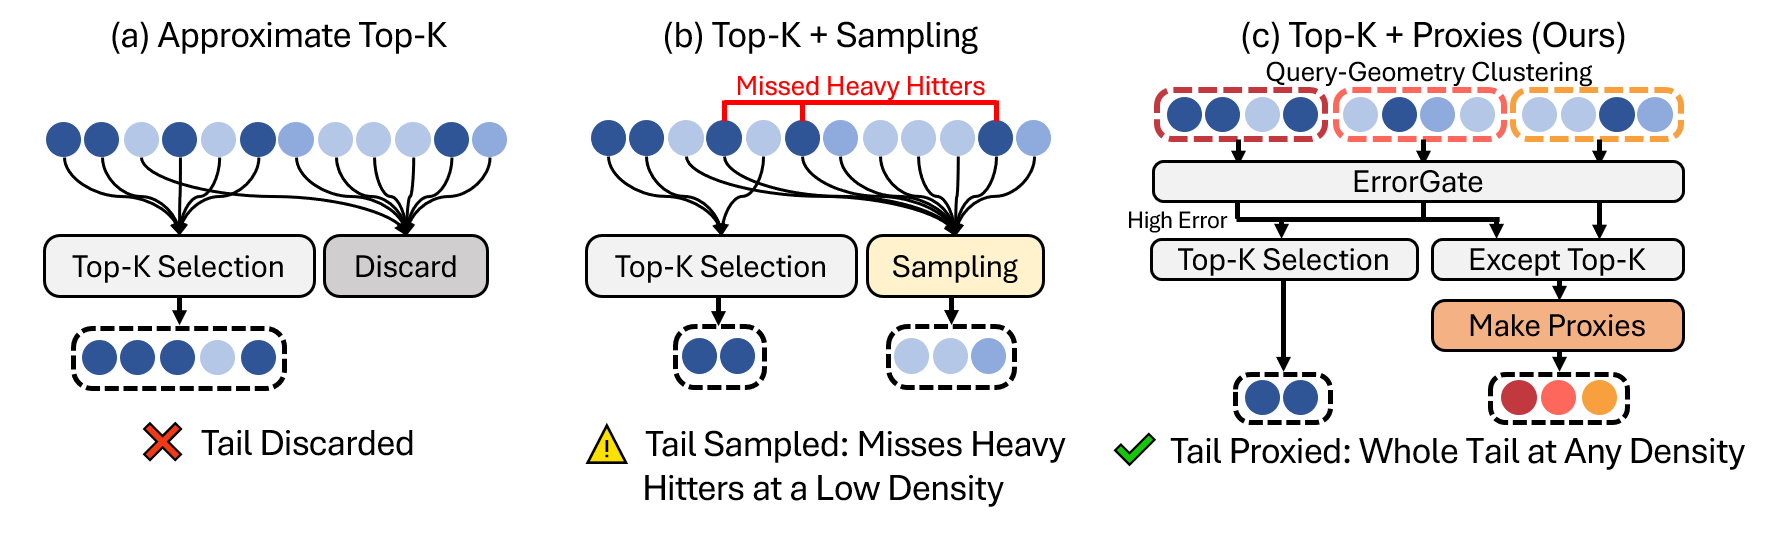
原 Fig. 2,PDF 第 2 页。三条路径的差别在于:未精确读取的 token 是被忽略、随机抽取,还是整体由代理参与归一化。
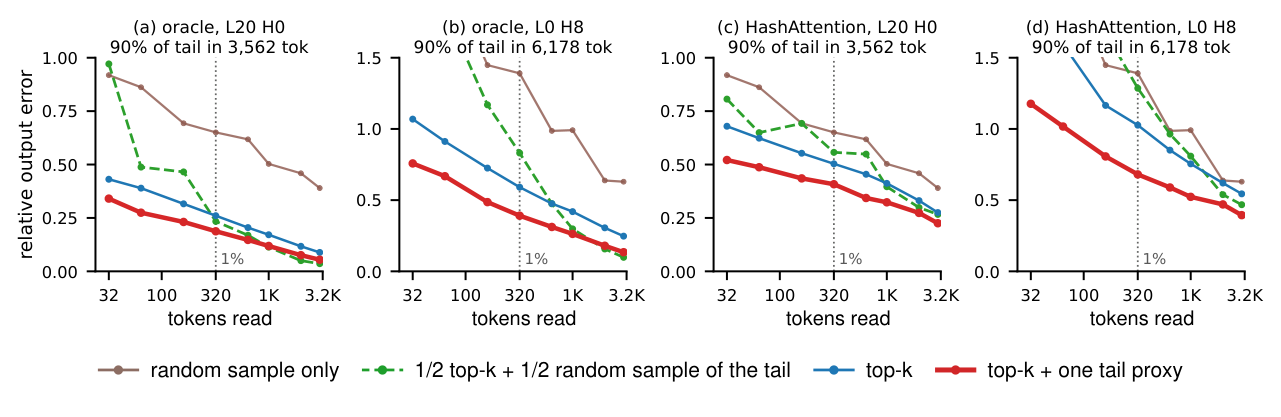
原 Fig. 3,PDF 第 3 页。横轴为总读取 token 数,纵轴为相对注意力输出误差;红线是 top-k 加一个尾部代理。
一个代理代表什么
令 $z_i=d^{-1/2}q^\top k_i$、$w_i=e^{z_i}$、$Z=\sum_iw_i$,已精确读取集合为 $X$,余下尾部 $T$ 含 $N$ 个 token。若尾部平均 logit 与平均 value 分别为 $\bar z_T,\bar v_T$,一个虚拟 token 用
进入 softmax,因此它的未归一化质量是 $Ne^{\bar z_T}$。$\log N$ 让一个代表上千成员的代理获得合适的计数权重。这里是 logit 的均值再取指数,一般小于真正尾部质量 $\sum_{i\in T}e^{z_i}$,所以并非精确保质量的压缩。教学例子:若两个尾部 token 的 logit 都为 0、value 为 1 与 3,则代理 logit 为 $\log2$、value 为 2,分子贡献 $2\cdot2=4$ 与原尾部完全一致;logit 不相等时就出现误差(Eq. (1)、Appendix A,PDF 第 3、12–13 页)。
采样与代理的误差表达式
论文把未归一化权重差异定义为 $\mathcal E=Z^{-1}\sum_i|\hat w_i-w_i|$;它既不是归一化注意力距离,也不是输出误差。若尾部占真实 softmax 质量的比例为 $\tau$,均匀无放回抽 $m$ 个尾部 token,则对固定的一条查询及其尾部有
采样未选中的项权重变零,选中的项又按 $N/m$ 放大;两部分都计入绝对差,因此 $m\ll N$ 时第二式逼近 $2\tau$。这“近乎两倍”只针对上述权重指标。单代理的精确有限尾部式是 $\mathcal E_{\rm proxy}=\tau e^{-G_T}D_T$,其中 $G_T=\log[N^{-1}\sum_Te^{z_i-\bar z_T}]$、$D_T=N^{-1}\sum_T|e^{z_i-\bar z_T}-1|$。若额外假设中心化尾部 logit 服从高斯分布,得到预测 $\mathcal E_{\rm proxy}^{\rm G}=\tau\operatorname{erf}(\sigma_z/\sqrt2)$;它不是任意有限尾部的保证(Eq. (2)、Appendix A.2,PDF 第 4、17–19 页)。
误差指标还不足以解释 Fig. 3:输出取决于 value 方向和归一化分母。抽样尾部质量估计的相对 RMSE 为
样本越少、尾部质量越集中在少数 token,这一不确定性越大。论文的诊断中,1% 读取下 vAttention 样本包含“最重的未读取 token”的概率约为 0.5%(Appendix A.2、Fig. 10,PDF 第 17、20 页)。代理没有抽样方差,却仍会因 logit 不齐和 value 与权重的相关性而偏离密集输出。
二:方法——把长尾分簇,并把预算花在代理误差大的地方
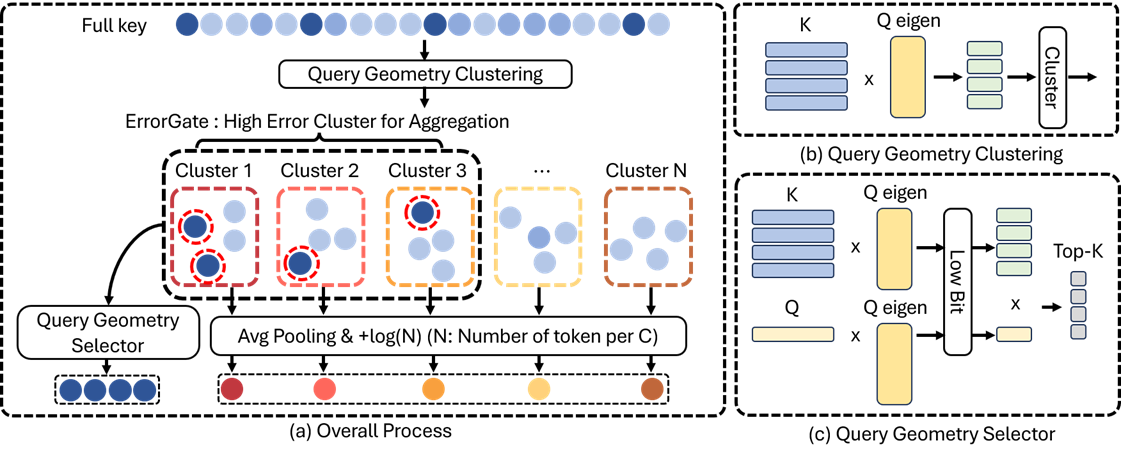
原 Fig. 5,PDF 第 5 页。QGC 分簇,ErrorGate 决定扩展哪些簇,QGS 选簇内 token,剩余成员形成代理。
整体计算与不重复计数
请求预填充后,QGC 将 KV 缓存分成 $C$ 簇。每簇缓存人数 $n_b$、原始键均值 $\bar k_b$、value 均值 $\bar v_b$ 与键逐维方差。每次查询先用 QGS 选少量精确 token,再对扣除这些 token 的剩余成员计算 ErrorGate 分数;分给簇 $b$ 的额外读取量为 $q_b$。读出这些 token 后,再从簇内计数与矩中扣除它们,得到最终残差 $n'_b,\bar k'_b,\bar v'_b$。最终输出为
$X$ 包含 sink、局部窗口、初始 QGS top-k 和额外精确读取。扣除操作确保被精确读取的 token 不会再被代理代表。每个非空残差簇作为 logit $\bar z'_b+\log n'_b$、value $\bar v'_b$ 的虚拟 token 进入同一次 softmax(§3.1、Eq. (8)、Appendix A,PDF 第 4、12–13 页)。
QGC:按查询真正看见的键差异聚类
令 $M=\mathbb E[qq^\top]$ 表示查询的二阶矩。两键的预期 logit 平方差为 $d^{-1}(k_i-k_j)^\top M(k_i-k_j)$。因此沿 $M$ 的主特征向量聚类,比只看欧氏键距更直接地降低簇内 logit 离散度。取前 $r=16$ 个特征对 $(U_r,\Lambda_r)$,将键映成
再做 k-means。论文在预填充阶段以预采样查询统计与当前问题片段统计各占一半构造 $M$;分簇每个请求做一次,后续解码沿用。图示诊断中,解码查询与 $M$ 首特征向量的绝对余弦相似度中位数为 0.82(Fig. 6,第 5 页)。在同一 1% 读取、$C=64$ 配置中,位置分簇、原键 k-means、QGC 的 RULER 平均准确率依次为 84.37、85.42、86.30(Table 1,第 5 页)。这支持查询几何在该配置中的作用;聚类目标是预期 logit 离散度的代理目标,并非直接最小化最终输出误差。
QGS:复用查询方向找精确读取的 token
QGS 用同一个 $M$ 的前 $r=32$ 个特征方向。每个键一次性形成 int8 投影码 $c_i=Q_8(U_r^\top k_i)$,每步以 $\tilde z_i=(U_r^\top q)^\top c_i$ 近似其排序分数,再精确读取所选 token 的原 KV。一个 KV 头下的查询头共用方向;新 token 到来时增量编码。它用小码扫描获取较准确的选择,而非用近似分数代替最终注意力 logit(Eq. (5),PDF 第 6 页)。
| 选择器 | 读取 1/16 时 top-32 recall | 读取 1/32 时 recall | 单层选择时间 |
|---|---|---|---|
| HashAttention | 0.74 | 0.63 | 0.24 ms |
| Double Sparsity | 0.97 | 0.95 | 0.50 ms |
| QGS | 0.97 | 0.94 | 0.22 ms |
Table 2,PDF 第 6 页;同一组 21 个请求、所有层和头、前 8 个生成步的诊断。该时间是选择阶段,不能从注意力内核计时中消失。
ErrorGate:代理质量 × 簇内权重离散
对残差簇定义 $\delta_i=z_i-\bar z_b$。其精确的未归一化权重差异贡献为
这解释了为何仅按质心质量排序不够:大的簇若分数几乎相同,代理已很准确;质量较小但离散大的簇也可能重要。精确 $D_b$ 需要读完整簇,部署时用高斯模型及缓存的键逐维方差估计:
$\Phi_{\rm normal}$ 是标准正态累积分布函数,与 QGC 的投影矩阵 $\Phi$ 不是同一个符号。这是估计的权重差异分数,不是可保证的输出误差上界。论文的确定性输出界还包含 value 的离散度因子;高斯假设与对角协方差近似只用于便宜的部署评分(Eq. (3)、(6)、Appendix A,PDF 第 4、6、13–16 页)。对角与完整方差版本的估计分数 Spearman 相关系数为 0.92;追踪真实误差最大八簇的召回分别为 91%/97%(Fig. 7,第 6 页)。
ErrorGate 按 $\hat\varepsilon_b$ 比例用水位填充确定 $q_b$,要求 $\sum_bq_b=E$,然后 QGS 在各簇里挑前 $q_b$ 项。这是部分读取的启发式分配;完整读取若干簇时“选精确误差最大的簇”才有直接的非负项移除解释(Eq. (7)、Appendix A.1,第 6–7、16–17 页)。1% 配置采用 $C=64$、初始 top-k 约 9 项、额外读取 $E=216$ 项;每簇均值和方差统计合计按 1.5 个 KV 行计费,故代理流为 $96$ 行,约占该 1% 总预算的 29%(附录配置与 §4,PDF 第 7、22–23 页)。
融合内核如何实现
OpenAttention.flash 在 Triton 写的 FlashAttention-2 在线 softmax 中,把精确 token 的散列读取与残差簇的虚拟 token 顺次放进 tile;代理 logit 加 $\log n'_b$。预先缓存的计数、一阶和二阶矩让“从簇中扣除已读 token”只需更新统计量。论文报告部署 $C=64$ 的整模型簇统计约 12 MiB,相对于其对照的 4.0 GiB KV 缓存约 0.3%(Appendix C、Algorithm 1,PDF 第 20–22 页)。
三:实验协议与比较对象
主实验使用 Llama-3.1-8B-Instruct(bf16,32 个 query 头、8 个 KV 头)、RULER-32K HARD 七任务,每任务 200 个样本。上下文预填充仍用密集注意力,稀疏注意力施加在问题片段和生成阶段。主表中的“读取率”按每 query 头读取的 KV 行计,OpenAttention 的均值/方差代理流也计入;各法扫描压缩索引的成本都未计入这个读取率。HashAttention 与 vAttention 共用公开的 HashAttention 选择签名,MagicPIG 用自身的 LSH 抽样器及校准的哈希参数,OpenAttention 则用 QGS。基线 sink 和局部窗口各为 0.1%,OpenAttention 各为约 0.01%,总读取预算对齐(§4 Setup,第 7 页;Appendix F,第 23–25 页)。
指标方面,RULER 表格为七任务的平均准确率,越高越好;Fig. 3 的“相对输出误差”和 Eq. (2) 的 $\mathcal E$ 是两种不同量。内核表为单层、单次解码注意力阶段毫秒数,越低越好。论文在跨模型、非 RULER 与长度迁移使用 3% 配置,但各表的样本数、任务及基线协议不同,不能直接混合做同一平均。
四:主要结果与解释
4.1 读取率越低,代理的差异越明显
| 总读取率 | OpenAttention | HashAttention | vAttention | MagicPIG |
|---|---|---|---|---|
| 10% | 87.08 | 81.23 | 83.08 | 52.52 |
| 5% | 86.82 | 71.55 | 68.86 | 34.42 |
| 3% | 86.83 | 63.48 | 55.74 | 24.01 |
| 1% | 86.30 | 48.22 | 36.29 | 10.53 |
RULER-32K HARD 七任务平均准确率;密集为 87.04。MagicPIG 实际读取率依次约 10.0%、5.1%、2.9%、1.1%;其余按表列目标。原 Fig. 8,第 7 页;Table 11,第 23 页。
低于 10% 时,vAttention 即使用与 HashAttention 相同的选择器,也低于直接丢弃尾部的 HashAttention;这与小样本遗漏残差重要项的机制分析一致。OpenAttention 的 1% 分数比最强的所列稀疏基线高 38.08 个百分点(86.30−48.22)。逐任务看,1% 下 HashAttention 的 niah_multikey_3 为 0,OpenAttention 为 97.0;FWE 分别为 78.5 与 93.5(Table 11,第 23 页)。这些是论文所选七个困难任务、同一协议下的结果。
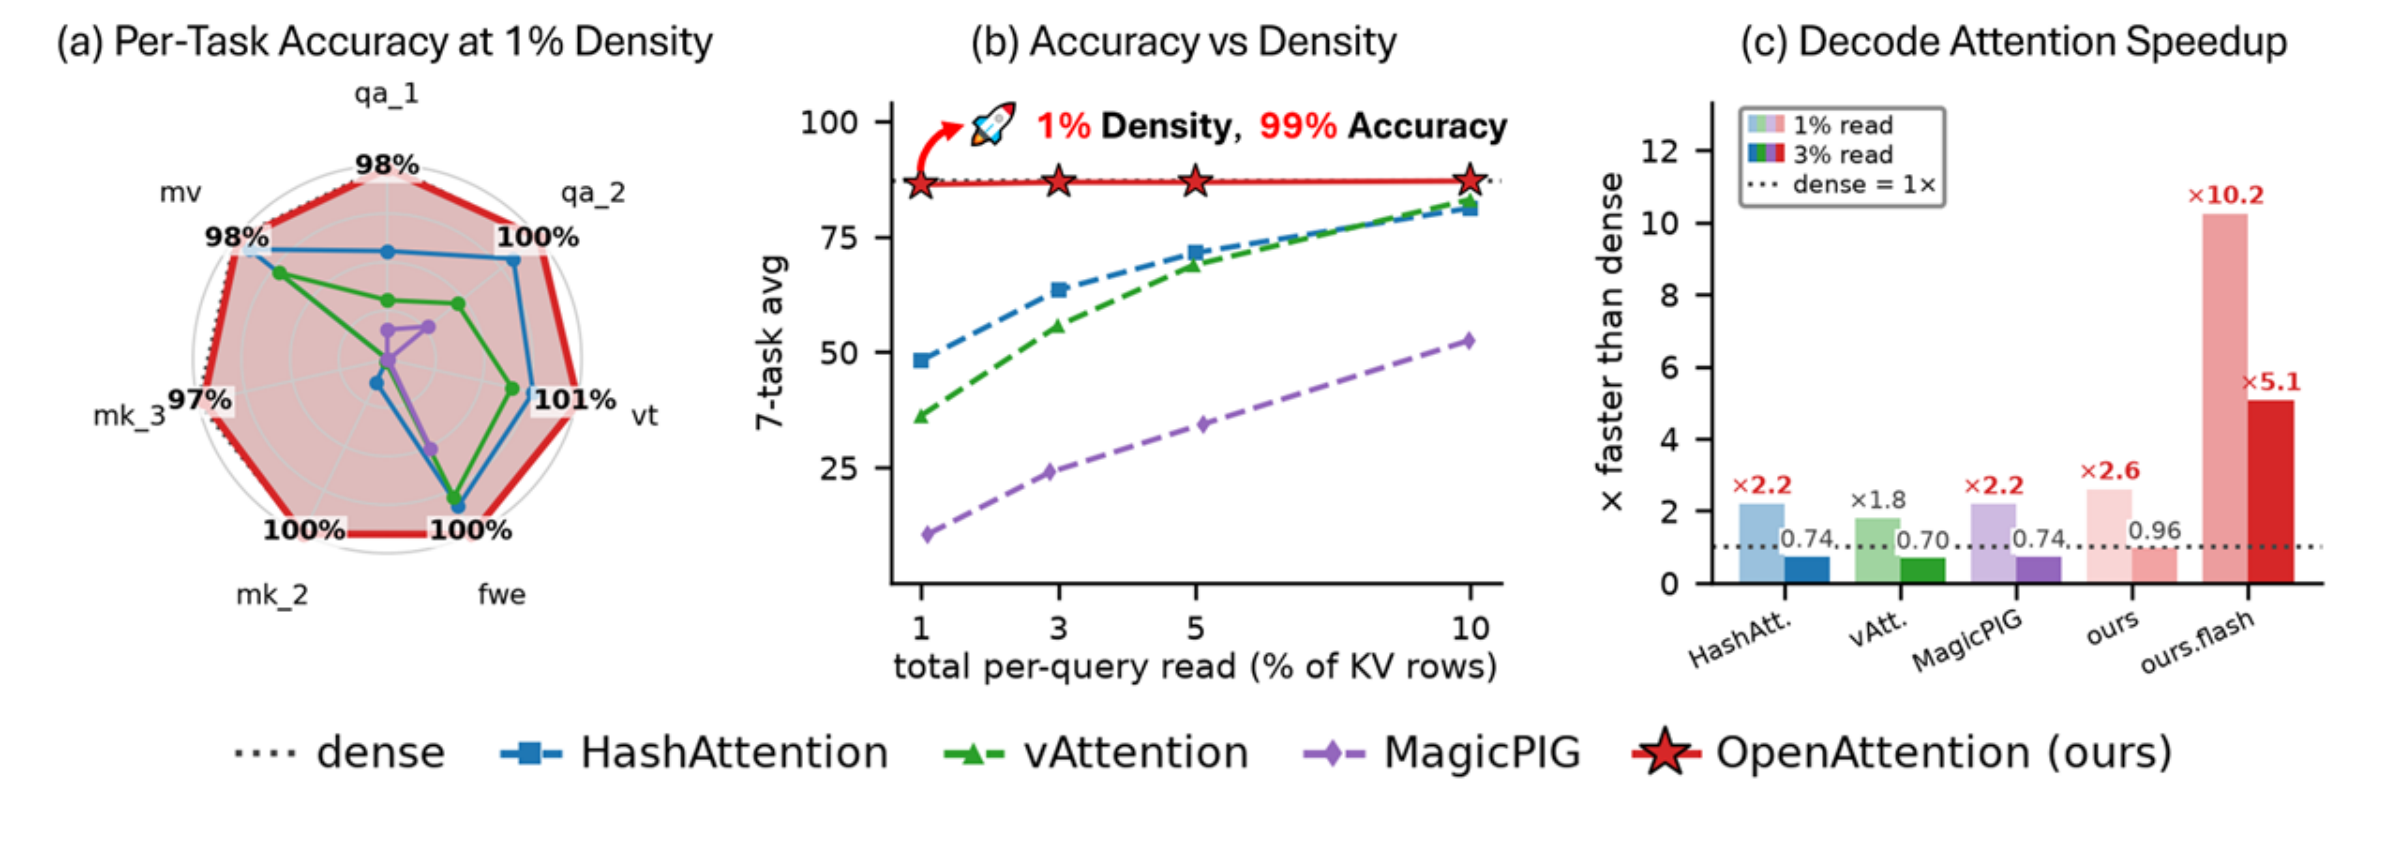
原 Fig. 1,PDF 第 1 页。中图横轴是总读取率;右图是解码注意力阶段的速度倍数。
4.2 消融揭示各模块的角色
| 5% 读取消融配置 | 七任务平均准确率 |
|---|---|
| HashAttention 选择器 + 尾部抽样 | 67.35 |
| 仅把抽样改为代理 | 77.91 |
| 代理 + ErrorGate | 85.90 |
| 代理 + QGS | 86.73 |
| 代理 + ErrorGate + QGS | 86.82 |
Table 4,PDF 第 8 页;逐任务见 Table 12,第 24 页。此处首行 67.35 是消融实验自身的配置,主比较 Table 11 中的 vAttention 5% 行为 68.86;不能把两张表的首行当作同一次运行。
“仅代理”已提高 10.56 个百分点,说明保留尾部信息本身有效;再改进簇预算或选择器可进一步缩小误差。在固定 1% 部署配置下,ErrorGate 按估计误差排序得 86.30,只按均值 logit/质量得 85.99,只按方差得 84.81(Table 3,第 6 页)。差异有方向,但估计误差与另一种 Jensen 质量缺口排序 86.28 的结果在一个标准误内,不能由这些分数宣称 ErrorGate 的公式唯一最优(Appendix A.1,第 16 页)。
4.3 跨模型、上下文和数据集
在 3% 读取的 RULER-32K HARD 上,Llama-8B、DeepSeek-R1-Distill-Llama-8B、Mistral-7B 的密集分数为 87.04/73.46/65.46,OpenAttention 为 86.59/73.49/64.83;三者与密集相差均不超过 0.7 个百分点(Table 5,PDF 第 8 页)。长度扫描(每任务 100 样本)中,16K、32K、64K、96K 的 OpenAttention 分数为 87.49/87.38/84.82/78.10,对应密集 87.14/87.75/85.49/78.01。该扫描随长度增加簇数、保持约 3% 总读取并设 $E=0$;64K 和 96K 是按 RULER 脚本生成的合成扩展集(Table 7,第 9 页;Appendix I,第 27 页)。
没有明确问题片段的 LongBench 摘要任务改用静态查询矩:3% 读取下 gov_report 与 multi_news 的 ROUGE-L 为 35.53/26.80,密集为 36.08/26.61;LongBench-v2 的首 60 个请求零样本准确率为 33.30,密集为 30.00。后者样本少,论文将其定位为提示性结果(Table 15–16,PDF 第 26 页)。
与 KV 淘汰压缩组合时,每层仅保留 2048 项,再让 OpenAttention 读取原上下文的 10%:StreamingLLM 28.00→28.28,SnapKV 69.98→69.49,PyramidKV 70.34→70.14,三者平均变化约 −0.14 个百分点。这说明该设置下稀疏读取可以叠加到已压缩缓存,却不能修复淘汰造成的主要信息损失(Table 6,第 9 页;Appendix H,第 25–26 页)。
4.4 性能数字的实际含义
在 H100 NVL、32K、bf16、batch 32、无 ErrorGate 额外扩展 $E=0$ 的内核实验中,1% 时密集注意力阶段 1.20 ms、OpenAttention.flash 0.12 ms;3% 时 1.22 ms 对 0.24 ms,约 5.1×。batch 1 时差距小得多:1% 为 0.06/0.05 ms。索引扫描、top-k 选择、ErrorGate 打分、残差统计更新都未进入这些阶段时间;因此完整推理加速需要额外测量,且内核表并不是主准确率配置的逐项同成本计时(Table 9、Appendix C,PDF 第 21–22 页)。另一个 5%+256 项扩展的 batch 扫描里,融合版本 batch 32 约比密集快 1.9×,说明扩展和配置会改变速度(Fig. 11,第 22 页)。
五:结论与值得继续检验的地方
最有用的方法启发是把“尾部怎么处理”提升到与“挑哪些 top-k”同等重要:低读取量下,用少数带人数的残差代理保留所有未读成员的平均贡献,再依据代理质量 × 簇内分散程度分配有限的精确读取。QGC 与 QGS 使用同一查询几何,形成较一致的低成本索引与聚类方案。
理解结论时有三个具体条件。第一,Eq. (2) 的采样两倍差异是固定尾部、未归一化权重指标;代理的高斯式与 ErrorGate 分数是模型估计,不能直接当任意输入上的输出误差保证。第二,核心准确率来自预填充仍密集的 RULER 困难子集;非 RULER 测试覆盖较少,问题片段缺失时使用静态矩。第三,10× 仅是未计索引与更新的注意力内核阶段计时,且性能表 $E=0$。若要判断部署收益,应在目标任务上同时测端到端准确率、全解码步时延和构建/扫描成本。作者也指出对角协方差估计无法精确恢复每簇误差(§6,PDF 第 9 页)。