PACE:四位循环状态的周期性与通道对齐编码——精读笔记
原题:PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
作者:Patrick Haller、Filipe Laitenberger、Alan Akbik
版本:arXiv:2610.29545v1,2026-10-21 提交;本次研读与查询日期:2026-10-27。 本地原文 PDF。下文页码从 PDF 首页起算。
发表:截至 2026-10-27,arXiv 条目未列期刊、会议或正式出版 DOI;另行检索未查到可靠的正式发表记录。
代码:截至 2026-10-27,论文及检索结果中未查到可核实的 PACE 官方公开实现。
论文总览
问题:混合线性注意力模型的每条并发序列都要保存每层每头的循环状态矩阵。把状态压到 4 位可以减少显存,但每生成一个 token 就量化一次,会持续向递归状态注入误差。作者希望在不微调模型的条件下,兼顾状态质量、驻留显存和解码速度。Sec. 1,PDF p. 2。
答案:PACE 把量化与状态实际写回的时刻对齐:预填充仍按 256 token 的 kernel chunk 量化;解码时缓存最近 $dP$ 个 token 的更新,只在 flush 时量化一次。它还观察到大幅值状态元素沿 value 通道成列聚集,因此量化组沿 key 轴划分,组内不跨列;混合精度版本再把每层最易长期保留量化误差的四分之一头存为 8 位。Secs. 3–5,PDF pp. 5–7。
主要结果:在四个 Qwen3.5/3.6 混合模型上,PACE-4/8 以 6.82 驻留 bit/状态值达到与 DAMP INT8(9.90 bit)接近的五项平均分,但 4B 模型明显低一些,且三个更大模型的 IFEval 都低约 2 个百分点。全 4 位的 PACE-4 以相同的 5.03 驻留 bit 在四个模型的五项平均分上均超过本文重实现的 Q-Mamba DSQ。解码吞吐测试显示周期性 INT4 保留了 buffer 的速度收益;这个计时配置是均匀 INT4 状态,尚未包含 PACE-4/8 的按头分配。Table 1,PDF p. 9;Fig. 6,PDF p. 11。
结构地图
| 原文章节 | 作用 | PDF 位置 |
|---|---|---|
| 1 Introduction | 显存瓶颈、四项设计及概览图 | pp. 2–3,Fig. 2 |
| 2 Background and Related Work | gated delta 递推、chunk kernel、buffer 与量化背景 | pp. 3–5,Eqs. 1–4 |
| 3 Rounding Period and Error Propagation | 分开定义预填充与解码周期,分析误差留存 | p. 5,Eq. 5 |
| 4 Channel Structure of the Recurrent State | 列状大值及对 $u_t$ 的置换检验 | pp. 5–6,Fig. 3 |
| 5 Method | buffer 成本、列内量化组、按头精度分配 | pp. 6–7,Eq. 6、Fig. 4 |
| 6 Experimental Setup | 四个模型、五项主基准、基线和协议 | p. 8 |
| 7 Results | 周期、主比较、消融、状态漂移及吞吐 | pp. 8–11,Tables 1–2、Figs. 5–6 |
| 8 Conclusion / Limitations | 总结与适用条件 | pp. 11–12 |
| Appendices A–F | 周期明细、35B 漂移、轴统计、buffer 精度、零点和显存 | pp. 15–17,Tables 3–6、Fig. 7 |
一:动机——为什么 4 位状态难用
每个 gated-delta 头保存 $S_t\in\mathbb R^{d_k\times d_v}$。它不像 Transformer 的 KV cache 那样随上下文增长,但并发时仍要为每条请求各存一份。作者估计在 64 条并发序列下,fp32 状态占“模型权重 + 状态”显存的 10%–41%。常见的逐 token 状态量化会在每次写回时重新舍入同一个矩阵,误差因此进入后续递推。预填充阶段的 chunk kernel 只在 chunk 边界物化状态,天然少做舍入;解码阶段逐 token 调用 kernel 才出现频繁舍入。Sec. 1,PDF p. 2;Sec. 2.2,PDF p. 4。
作者的两个判断是:(1)舍入频率与位宽同样重要;(2)同一量化组是否混入幅值很不相同的状态通道,会决定 4 位量化误差。前者导出周期性写回,后者导出沿 key 轴、在同一 value 列内分组。按头 4/8 位分配处理剩余的长寿命误差。Secs. 3–5,PDF pp. 5–7。
二:方法——怎样让状态少舍入、少互相拖累
1. 状态更新与“列”的含义
基本线性注意力将历史压入 $S_t$,读出为 $o_t=S_t^\top q_t$。本文使用的 gated delta rule 写成
$k_t\in\mathbb R^{d_k}$ 是 key,$v_t,u_t\in\mathbb R^{d_v}$ 是 value 与 delta value,$a_t\in(0,1)$ 为每头衰减,$\beta_t$ 为写入强度。外积 $k_tu_t^\top$ 告诉我们:某个 $u_t$ 通道若跨 token 持续偏大,它会反复写入 $S_t$ 的同一列;因此“沿 key 轴分组”就是在固定 value 列里取连续 $g$ 个元素,共用一个 scale。Sec. 2.1,Eqs. 2–3,PDF p. 3;Sec. 4.2,PDF p. 6。
2. 周期舍入与 buffer
设预填充周期为 $P$、解码周期为 $dP$。主实验固定 $P=256$;逐 token 解码对应 $dP=1$,PACE 主配置取 $dP=8$。flush 时,kernel 读取压缩状态、恢复精度、一次处理 buffer 内的 $(a_t,k_t,v_t)$,再将新状态量化写回。周期内的 token 使用 buffer 参与计算,状态无须每次写回。原图的时间轴和 flush 流程如下。Fig. 2,PDF p. 3;Sec. 5.1,PDF p. 6。
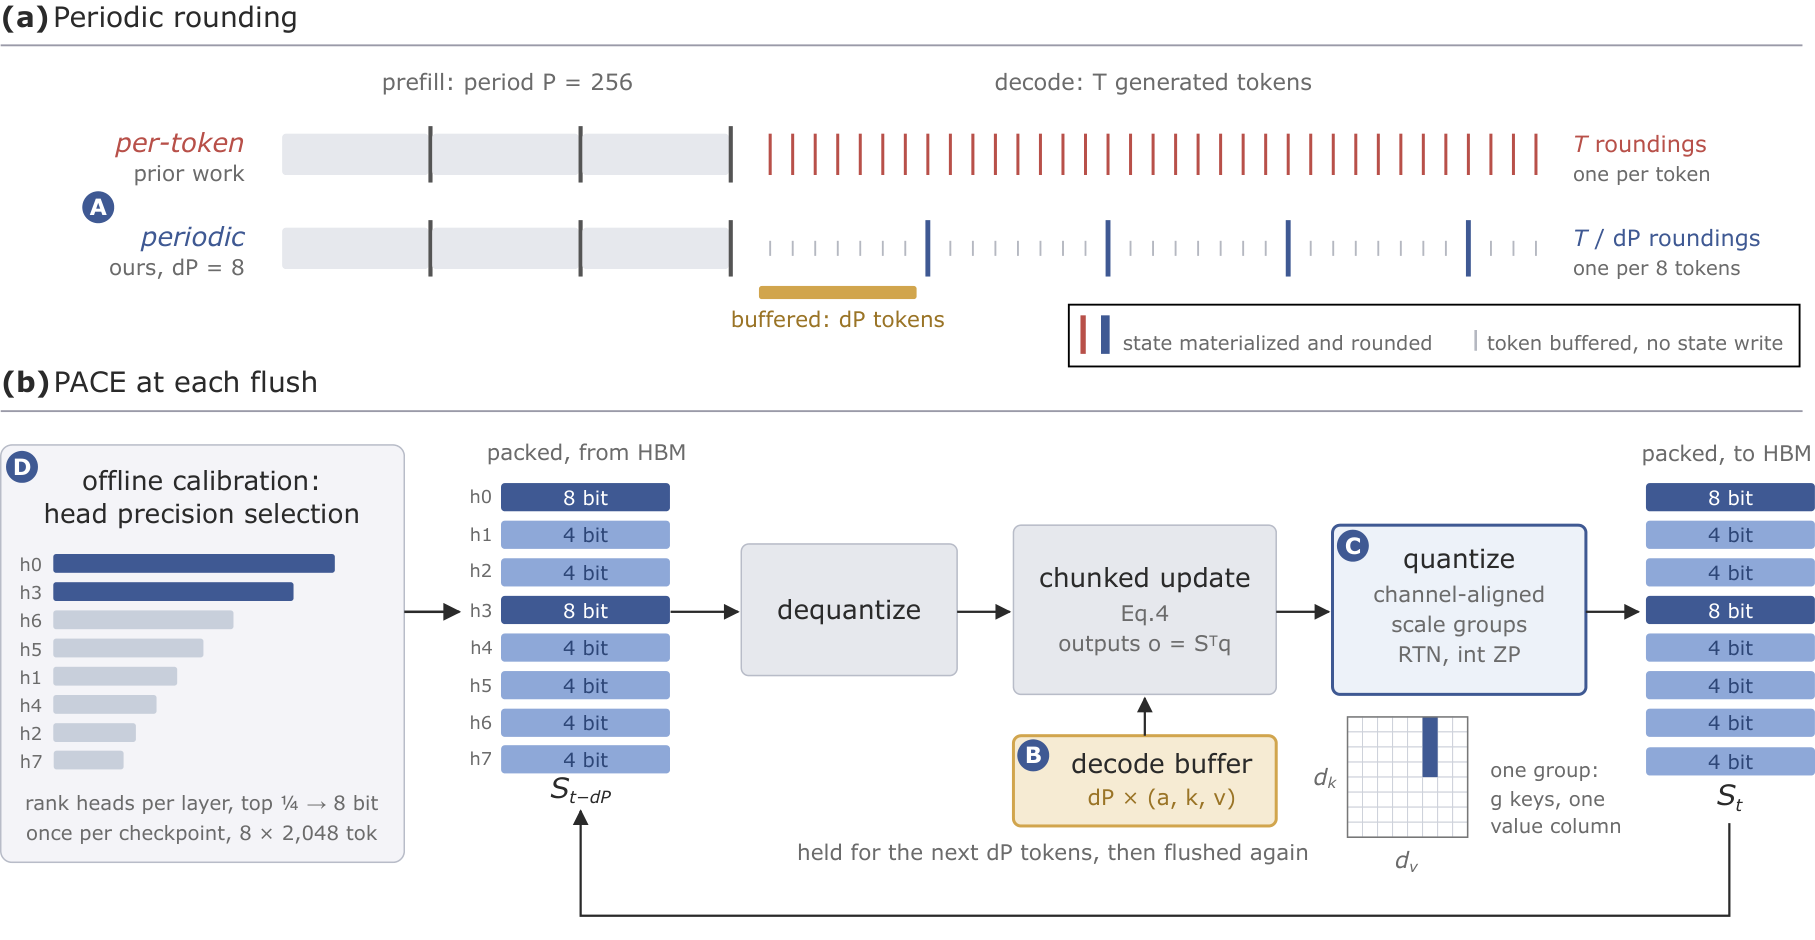
对单位范数的 key,作者用每头平均衰减 $a_h$ 表示一次舍入误差传播 $dP$ 步后的能量比例,得到留存误差近似尺度
$$E_h=\frac{e_h}{1-a_h^{2dP}},$$其中 $e_h$ 是一次舍入注入的误差能量。若误差注入可按独立项累积、且相邻 flush 之间的衰减可由 $a_h$ 代表,分母对应几何级数。$dP$ 增大使同一份旧误差在下一次舍入前衰减更多;$a_h$ 越接近 1,误差越长寿。原文称其为上界,但从逐 token 变化的 $a_t$ 换成“平均”$a_h$ 的定义未展开,因此这里更适合把它用作按头排序与解释的代理量。Sec. 3.2,Eq. 5,PDF p. 5。
buffer 的显存不能省略。作者定义驻留 bit/状态值为“压缩状态 + 解码 buffer”除以状态元素数。若 buffer 的 key、value 位宽为 $b_k,b_v$,$\gamma$ 个 value 头共用一个 key 头,则每缓存一个 token 增加
$$c=\frac{b_kd_k/\gamma+b_vd_v+32}{d_kd_v}\quad\text{bit/状态值},\qquad \text{buffer 成本}=c\,dP.$$例如均匀 4 位、$g=32$ 的状态 payload 加 fp16 scale 为 $4+16/32=4.50$ bit/值;8-bit key/value buffer 在 $dP=8$ 时贡献约 $0.78$,合计 5.28。延长周期会继续降低舍入误差,也会线性增大 buffer;因此 $dP=8$ 是本文报告的折中点。Sec. 5.1,Eq. 6,PDF p. 6;App. A,PDF p. 15。
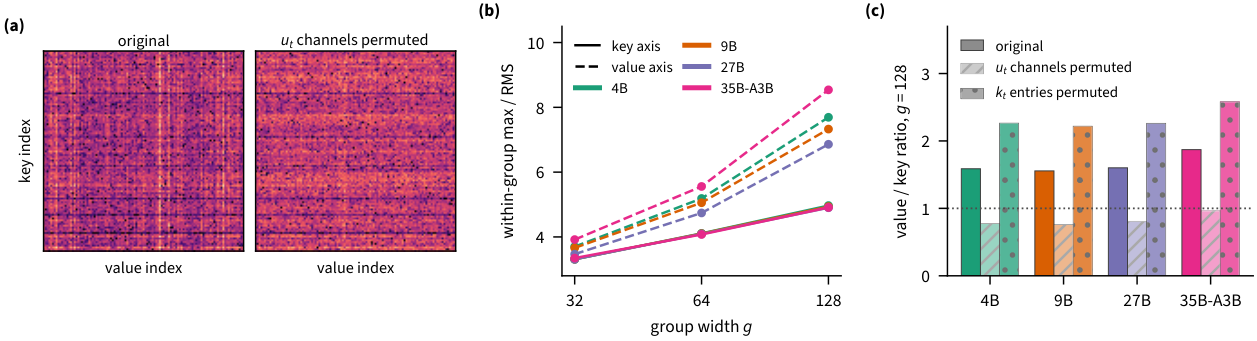
3. 按通道对齐量化组
组内共享 scale 时,最大绝对值通常决定量化步长;若一个组横跨许多 value 列,少数大值会让其余小值可用的 4 位格点变粗。作者以组内 $\max|x|/\operatorname{RMS}(x)$ 衡量这一现象:该值越大,典型元素相对于组最大值越小。图 3 中,value 轴分组(跨列、虚线)的比值高于 key 轴分组(列内、实线);在 $g=128$ 时,四个模型的“value/key”比值为 1.588、1.555、1.601、1.871。每个 token 随机置换 $u_t$ 的通道后,比值降至 0.776、0.760、0.808、0.963;置换 $k_t$ 则使列优势更明显。这比单看热图更有力地把列结构追溯到持久偏大的 delta-value 通道。Fig. 3,PDF p. 4;Table 4,PDF p. 16。
PACE-4 在每个头用对称 4 位、key 轴 $g=64$ 分组和 int8 buffer;状态占 $4+16/64=4.25$ bit/值,加入 buffer 后是 5.03。PACE-4/8 用 key 轴 $g=32$ 的仿射量化,并把零点存为 4/8-bit 整数码,使零状态仍可精确表示;四分之三的头为 4 位、四分之一为 8 位,平均状态存储 5.66 bit/值。其 buffer 用 int4 key 与 bf16 value,合计驻留 6.82 bit/值。两种配置的 buffer 精度不同,不能只比较 state payload。Secs. 5.2–5.3,PDF p. 7;App. E,PDF p. 17。
4. 按头分配精度
PACE-4/8 在每个 checkpoint 上用 8 个保留的 2,048-token 窗口估计各头一次舍入的 $e_h$,结合上式 $E_h$ 排序;每层得分最高的四分之一头保留 8 位,其余 4 位。这是离线校准,不是用目标基准微调权重。它把 DAMP 所用的“误差 × 持久性”思想从 key 通道粒度改为头粒度。Sec. 5.3,PDF p. 7。
三:实验设置——比较的口径
四个骨干是 Qwen3.5-4B、9B、27B、Qwen3.6-35B-A3B,均为 gated-delta 层与全注意力层交错的混合模型。五项主任务是 GSM8K、MMLU-Pro(每学科 40 题,共 560 题)、IFEval(541 条)、RULER variable tracking(32,768 token)和 MATH-500;主表的 avg 为这五项得分的简单平均,越高越好。GSM8K/MATH-500 用 exact match,IFEval 用 prompt-level strict accuracy,RULER 用变量追踪准确率;WikiText-103 困惑度越低越好。生成任务零样本、贪心解码、关闭 thinking。Sec. 6,PDF p. 8;Table 1,PDF p. 9。
对照包括全精度状态、DAMP INT8/INT4 与作者重实现的 Q-Mamba DSQ。DAMP INT8 为逐 token 舍入、9.90 bit/值;主表其余量化配置用 $dP=8$。Q-Mamba DSQ 在本文只重实现量化器,没有原方法发表版本的微调步骤,因而“PACE-4 超过 Q-Mamba”应读作与这个后训练对照比较。主表、消融表和周期表来自不同评测运行,各有全精度行;例如 4B 的 GSM8K 全精度在主表为 89.2,在附录周期表为 82.7,跨表不可直接相减。Sec. 6,PDF p. 8;Table 1,PDF p. 9;Table 3,PDF p. 15。
四:结果——每个组件解决了什么
7.1 解码周期:更少舍入换回质量,buffer 增加成本
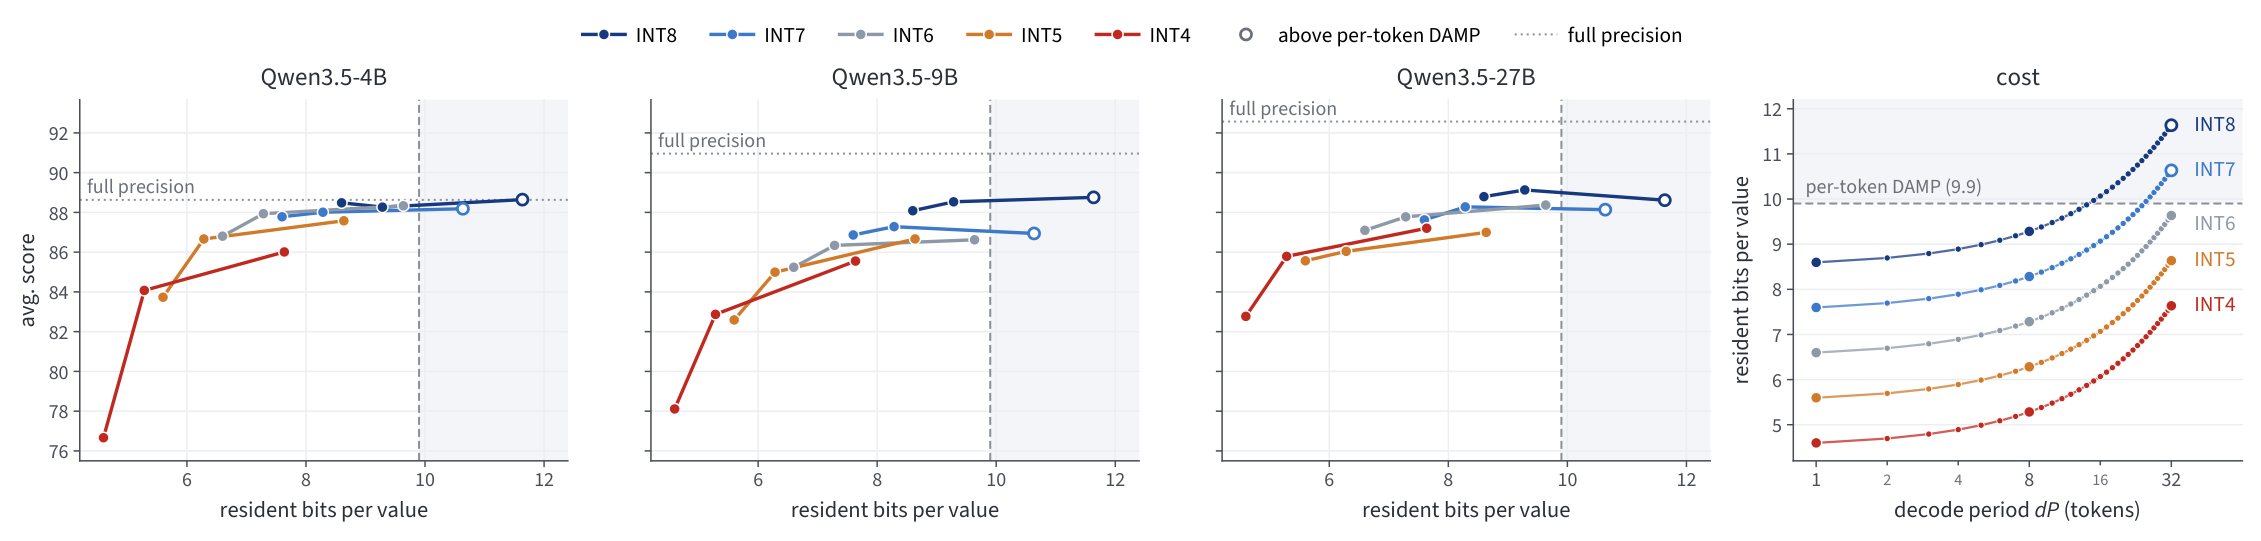
先固定 value 轴 $g=32$ 的均匀量化器,仅改变解码周期。9B 的 INT4 在 $dP=1,8,32$ 时,三项平均分(GSM8K、IFEval、RULER-32k)分别为 78.1、82.9、85.6;驻留成本从 4.60、5.28 增至 7.64 bit/值。35B-A3B 对应三项平均分 70.7、77.3、78.4。周期增加并不让每项任务单调改善:35B-A3B 的 RULER-32k 为 77.3、76.3、75.7,与作者关于长上下文误差可能主要来自固定的预填充周期的判断相容。此处的平均分只有三项,不能与后述五项主表直接比较。Fig. 4,PDF p. 7;Table 3,PDF p. 15。
7.2 主比较:接近 8 位 DAMP 的平均分,IFEval 仍落后
下表保留主表的五项平均分与驻留成本。PACE-4/8 的 6.82 bit 是 DAMP INT8 的 69%;PACE-4 的 5.03 bit 是其 51%。这里的“接近”主要适用于 9B、27B、35B-A3B 的平均分,且这些模型的 IFEval 分别比 DAMP INT8 低 2.1、1.9、2.0 个百分点。Table 1,PDF p. 9。
| 模型 | DAMP INT8:9.90 bit | PACE-4/8:6.82 bit | PACE-4:5.03 bit | Q-Mamba DSQ:5.03 bit |
|---|---|---|---|---|
| Qwen3.5-4B | 80.9 | 79.1 | 79.6 | 75.2 |
| Qwen3.5-9B | 83.7 | 83.7 | 80.0 | 72.8 |
| Qwen3.5-27B | 87.4 | 87.3 | 84.2 | 78.9 |
| Qwen3.6-35B-A3B | 86.3 | 85.0 | 77.3 | 71.2 |
4B 的 PACE-4/8 比 DAMP INT8 低 1.8 分,且比同为 4 位的 PACE-4 低 0.5 分,说明更高平均位宽没有在每个规模上自动换得更高任务分数。主表还列出与 DAMP INT4 同为 6.44 bit 的 PACE-4/8, int8 buffer,其四个模型平均分都高于 DAMP INT4;buffer 精度和状态精度需要一起看。Table 1,PDF p. 9。
7.3 消融:列内分组是实质增益,按头分配有任务差异
在 4B 上,同为 5.28 bit、$g=32$ 时,key 轴分组把 IFEval 从 value 轴的 73.75 提至 80.59,WikiText-103 困惑度从 8.158 降至 7.719;在 27B 上 IFEval 从 75.05 提至 78.37。这直接检验了“列内共享 scale”的收益。Table 2,PDF pp. 9–10。
在 6.44 bit 条件下,head allocation, key axis 与 DAMP INT4 相比,4B 的 IFEval 为 81.52 对 79.48、困惑度为 7.687 对 8.003;但 27B IFEval 为 78.00 对 79.85。因此按头分配改善了 4B 的这两个指标,不能把消融概括成“在所有任务上更好”。IFEval 下标的 $\pm$ 数字是与全精度行配对差值的 95% 区间,不是简单的多次训练方差。Table 2 与 Sec. 7.3,PDF pp. 9–10。
附录把 buffer 内 key 与 value 分开量化:9B 的 PACE-4/8 若用 int4 key / bf16 value,IFEval 为 82.4;交换成 bf16 key / int4 value 后仅 22.7。作者认为 key 量化后经 L2 归一化,幅值误差被削弱,而 value 的误差直接进入写入项;这解释了混合配置为何优先给 buffer value 留 bf16。App. D,Table 5,PDF pp. 16–17。
7.4 状态漂移:机制证据
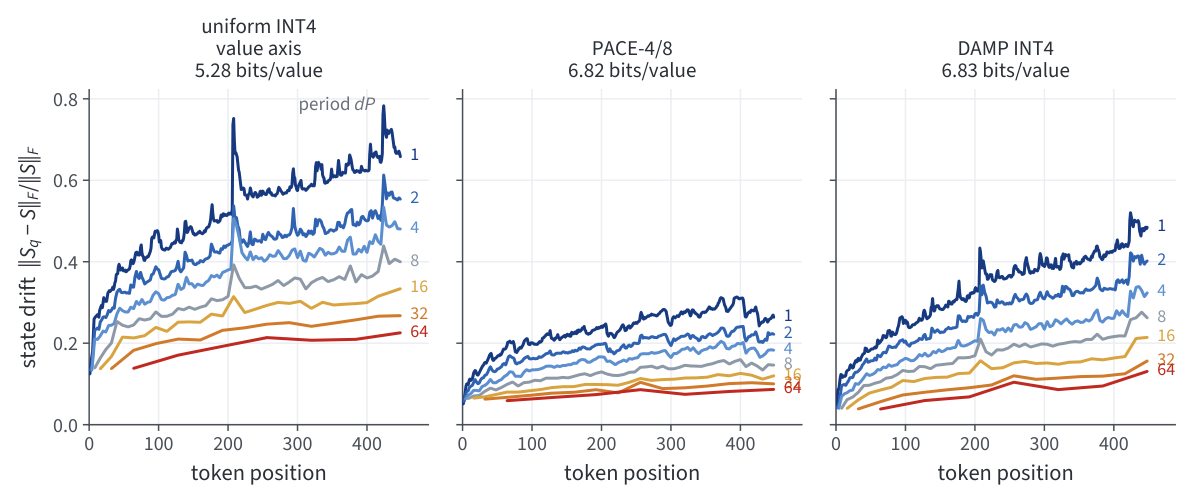
作者在 WikiText-103 的前 512 个 token 上比较量化状态与全精度状态,用 $\|S_q-S\|_F/\|S\|_F$ 并对循环层取中位数。4B 的均匀 INT4、DAMP INT4、PACE-4/8 三种量化器中,$dP$ 从 1 增至 64 都降低了曲线上的漂移;35B-A3B 的附录图也呈同样顺序。这与“舍入更少、旧误差有时间衰减”的解释一致,是直接的状态层面证据。Fig. 5,PDF p. 10;App. B,Fig. 7,PDF p. 16。
7.5 吞吐:测到的是周期性 INT4 的 kernel 收益
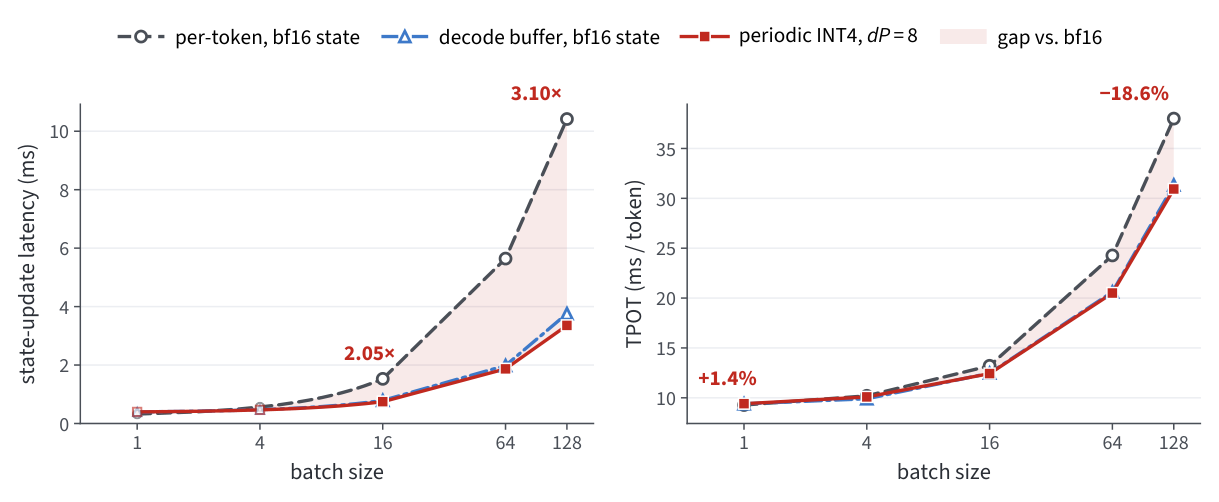
单张 H100 PCIe、Qwen3.5-4B、512-token 上下文、batch 1–128 下,作者比较逐 token bf16、bf16 加 decode buffer、以及 $dP=8$ 的均匀 INT4 状态 + int8 buffer。batch 128 时,周期性 INT4 的每输出 token 时延(TPOT)比逐 token bf16 低 18.6%;batch 1 则高 1.4%。图上 bf16 buffer 已提供主要收益,INT4 在其上进一步改善。相同运行中,均匀 INT4 的每序列实测驻留显存为 6.75 MiB 状态 + 1.14 MiB buffer + 0.08 MiB 其他,约 5.32 bit/值,与公式估计的 5.28 接近。Sec. 5.1 有一句称 Table 6“不含 buffer”,但 Table 6 明列 1.14 MiB buffer 且给出合计 bit/值;这里按表格列项读取。Sec. 5.1,PDF p. 6;Fig. 6,PDF p. 11;App. F,Table 6,PDF p. 17。
五:结论与实际取舍
PACE 的贡献是把循环状态量化的设计空间从“每个值用几位”扩展到何时舍入、哪些值共用 scale、哪些头最需要位宽。本文的周期实验和状态漂移共同支持“减少舍入次数可减轻递归误差”;置换实验与消融共同支持 gated-delta 状态按 value 列组织 scale 的原因;主表显示混合 4/8 位在三种较大 Qwen 骨干上以约七成 DAMP INT8 的驻留 bit 获得接近的五项平均分。Secs. 3–7,PDF pp. 5–11。
实际边界集中在三处。第一,列状离群值、衰减排序和精度分配只在这四个 Qwen 混合 gated-delta 模型上得到检验。第二,长上下文 RULER 的误差可能受预填充舍入影响,但主基准的预填充周期一直固定为 256,尚无该轴的实验。第三,速度实验验证的是均匀 INT4 周期性 kernel,未计时 PACE-4/8 的 key 轴分组与按头混精度,所以不能把 Fig. 6 的 18.6% 直接归给完整 PACE-4/8。将这三项分开理解,论文给出的机制和工程价值仍然明确。Limitations,PDF p. 12。