Transformers Learn Two Competing Sorting Algorithms, and Only One Length-Generalizes:中文精读
作者:Khashayar Gatmiry、Nathan W. Henry、Chloe H. Su、Emmanuel Abbe、Samy Bengio、Melanie Weber、Jonathan A. Kelner、Peter L. Bartlett
论文:arXiv:2610.26974v1(2026 年 10 月 18 日提交);本地原文 PDF
研读日期:2026 年 10 月 26 日。下文的页码均为从 1 开始的 PDF 页码。
论文总览
一个注意力层原则上就能完成的排序任务,在两层、每层单头的 Transformer 中会形成两类解法:有些模型的第二层注意力可以删掉,另一些模型必须依赖它。两类模型在训练长度上都几乎完全正确,但只依赖第一层的模型在更长序列上迅速失准;使用两层的模型在论文测试的长度范围内几乎保持满分。相对初始化尺度可以强烈改变训练最终选中哪类解法。(§3、§5;PDF pp. 4–5、10–11,图 1、6)
作者给出两个相互补充的机制解释。其一,序列越长,排序后相邻数字的差距越小;两层模型让第一层擅长这种训练时较少见的小间隔,让第二层更多处理较大间隔。其二,第一层收集的候选值会改变第二层查询,使后者主要在一个较窄的数值窗口里寻找下一个元素。消融、路径干预、注意力分数和候选集统计为这些解释提供了证据。(§4;PDF pp. 5–10,图 2–5)
这不是“层数越多越能泛化”的规律。最小值任务里,两层解法反而泛化较差;排序的附录实验还表明,加入第二个注意力头后,可移除第二层的模型也能泛化。决定结果的是学到的计算方式如何应对长度改变带来的输入分布变化。(§6、附录 D;PDF pp. 11–13、30–31,图 1、19)
结构地图
| 原文章节 | 作用 | PDF 位置与关键证据 |
|---|---|---|
| §1 Introduction | 提出“多余容量会学到什么”与跨任务对照 | pp. 1–3,图 1 在 p. 2 |
| §2 Setup of the Sorting Task | 排序数据、模型和训练协议 | p. 4 |
| §3 Two Sorting Algorithms Emerge from Initialization | 用第二层消融定义两类解法 | pp. 4–5,图 2 在 p. 5 |
| §4 Two-stage solutions and their Mechanistic Analysis | 间隔分工、干预、查询侧提示与候选集 | pp. 5–10,图 3–5 在 pp. 7–9 |
| §5 What Determines Which Algorithm Emerges? | 初始化、词表规模和模型宽度 | pp. 10–11,图 6 在 p. 11 |
| §6 Do these phenomena persist across other algorithms? | 最小值与贪心硬币任务 | pp. 11–13,回看图 1 |
| §7 Related Work;§8 Conclusion | 与长度泛化、机制多解的研究对接并归纳结论 | pp. 13–15 |
| 附录 A–D | 初始化细节、词表与宽度、训练长度、深层及多头实验 | pp. 18–31,尤其图 7–19 |
| 附录 E–H | 第二层 QK 分数、残差路径和间隔干预的进一步分析 | pp. 31–37,图 20–30 |
一:动机——为何同样的训练精度不够
任务很简单:从一组互不相同的整数中依次找出最小值、次小值,直到全部排好。理论上,一个足够宽的单层 Transformer 可以实现排序;因此,两层模型有一层“可用但不必用”的容量。作者关心的是优化过程会不会使用它,以及训练时的解法差异会不会影响分布外的长度泛化。此前“简单解法通常泛化更好”的直觉,无法直接回答这两个问题。(§1;PDF pp. 2–3)
论文把长度泛化作为机制的压力测试:训练始终用固定长度,测试把输入拉长。即使模型在训练长度上得到 100% 准确率,长序列也会改变相邻排序值的间隔和注意力竞争者数量。因而,看似同样正确的模型可能暴露不同的薄弱点。这里的“单阶段 / 两阶段”是训练后通过消融第二层注意力得到的功能分类,并非训练前指定的架构或严格意义上的传统排序算法。(§2–3;PDF p. 4)
二:方法——任务、两类计算路径和机制假说
2.1 数据流与判别标准
从词表 $\{1,\ldots,N\}$ 无放回均匀抽取 $K$ 个整数 $x_1,\ldots,x_K$,输入后接 SEP,模型自回归输出升序排列 $x_{s(1)},\ldots,x_{s(K)}$。在已输出 $x_{s(i)}$ 的位置,正确的下一个词元是 $x_{s(i+1)}$;定义相邻间隔 $g_i=x_{s(i+1)}-x_{s(i)}$。主实验常用 $K=16$,在 $2\le K\le N$ 上测试。模型是无位置编码、因果掩码的两层 Transformer,每层一个注意力头;在线采样数据,以 AdamW、学习率 $0.03$、批量 $4096$ 训练 $60{,}000$ 步,优化输出词元的交叉熵。(§2;PDF p. 4)
第二层可移除性(removability)指删掉第二层注意力后仍能把整条输出序列排对的比例,论文据此区分单阶段与两阶段。图中的词元准确率则是按各输出位置统计的长度泛化指标;它与“整条序列全对”的比例不是同一口径。论文只消融第二层注意力,仍保留第二层 MLP,所以“单阶段”不等于把整个第二个 Transformer block 删除。(§3;PDF pp. 4–5,图 1–2)
2.2 单阶段与两阶段到底怎样算
单阶段模型的第一层注意力通常把最大权重放在下一个正确值上,也给附近更大的值一些权重。作者据此提出“候选集”解释:第一层生成一个包含多个可能下一个值的混合表示,后续 MLP 与输出映射再从中选出答案。这个解释是对内部行为的机制假说,而非由消融测试直接推出的唯一实现。(§3.1;PDF p. 5,图 2)
两阶段模型的第二层注意力不可删,并且通常比第一层更精确地聚焦正确下一个值。正文统计其关注位置的正确率约为 99.5%,第一层约为 86%;图 2 展示的单个样例分别为 100% 与 87.5%,不能把样例数字当作总体统计。(§4.2;PDF pp. 5、8,图 2)
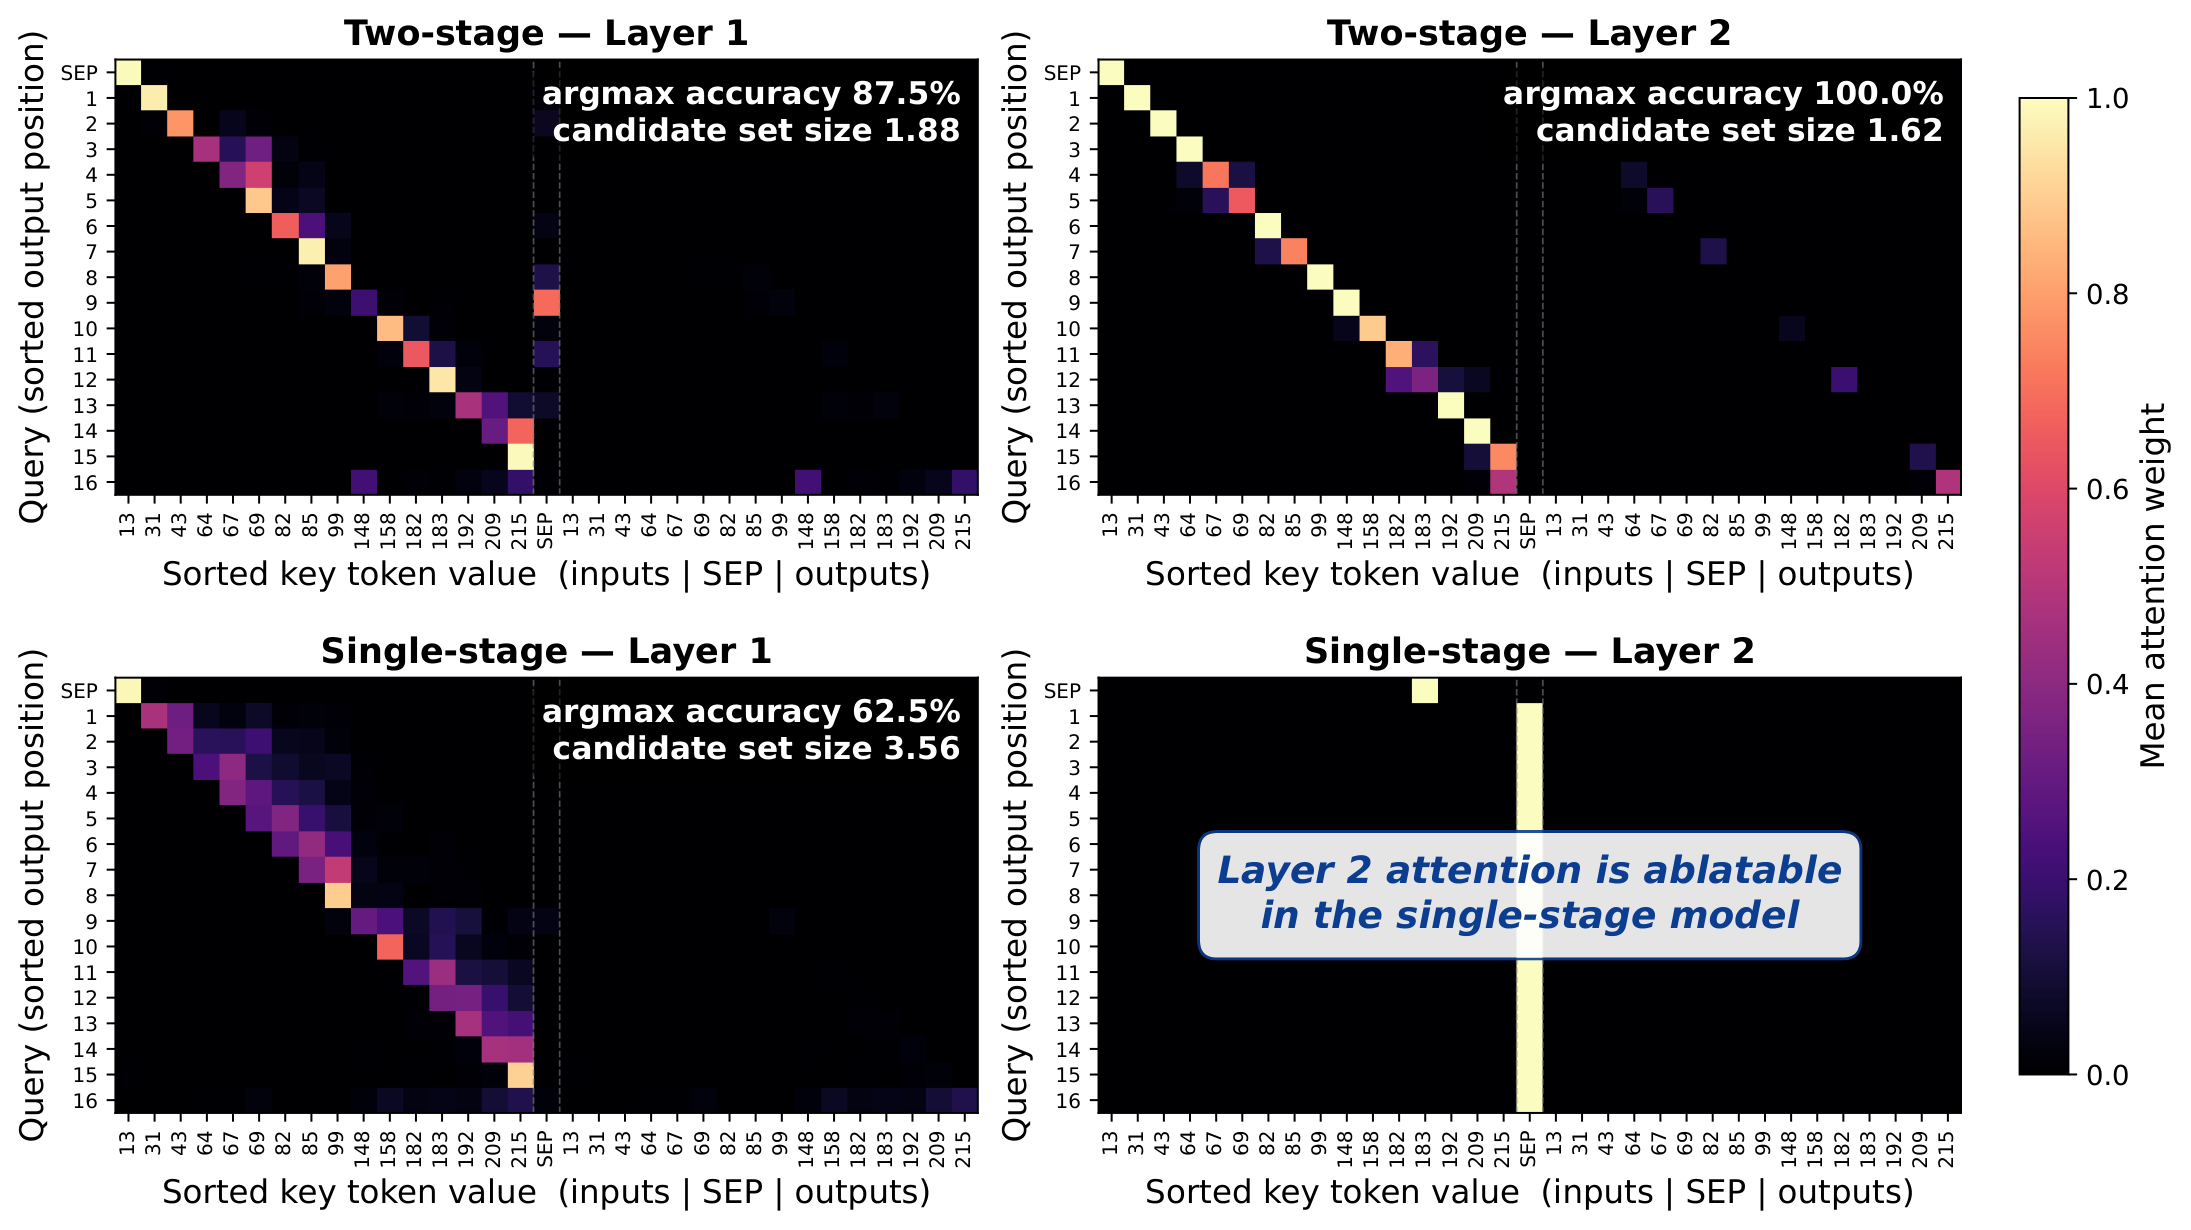
原图 2,PDF p. 5。 行是升序输出位置;左半列是按数值排序的原输入,竖虚线之后是分隔符与已输出词元。两阶段模型的第二层权重沿着“下一正确值”形成更锐利的轨迹;单阶段模型第一层覆盖的邻近候选更宽,而其第二层主要看 SEP。热图呈现路径差异,是否真正依赖该路径仍由消融实验判定。
2.3 为什么长序列会暴露小间隔错误
作者给出无放回抽样下相邻排序值的平均间隔:
这里的 $N$ 是可选整数总数,$K$ 是序列长度。固定 $N=256$ 时,$K=16$ 的平均间隔约为 $15.12$,到 $K=128$ 约为 $1.99$,到 $K=256$ 必为 $1$。进一步由均匀子集的间隔计数可得任一内部间隔满足 $\Pr(g=1)=K/N$:这一步是帮助理解分布变化的教学推导,对应三种长度分别为 6.25%、50%、100%。因此,仅靠随机长度 16 输入取得高准确率,仍可能没有学好连续整数的排序。(§4.1、附录 C;PDF pp. 6、23)
作者提出的分工是:小 $g$ 时第一层路径足以贡献正确答案;$g$ 变大时,第一层越来越多地把注意力给 SEP 或已排序词元,第二层接管。图 3a 的纵轴是第一层投向原输入的注意力质量,随 $g$ 增大明显下降;图 3b 的纵轴是删掉第二层注意力后的词元准确率,多数两阶段模型在 $g=1$ 仍很准,较大 $g$ 时趋近零。不同种子在 $g=1$ 的表现并不完全一致,说明“两阶段”内部还有分工差异。(§4.1;PDF pp. 6–7,图 3)
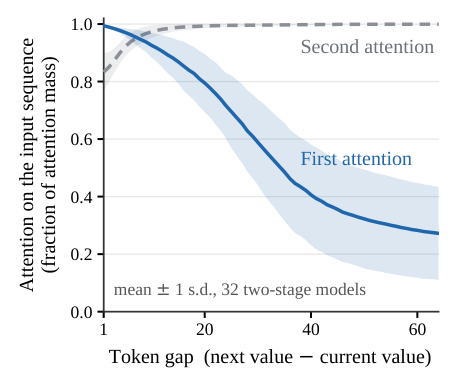
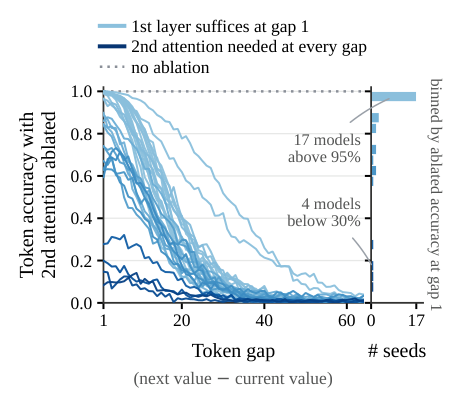
原图 3a–b,PDF p. 7。 这两个图分别测“看哪里”与“删去第二层还能否预测”;方向一致,却不能只凭注意力权重就断定因果。作者还做了路径“劫持”干预:在 $K=32,N=512$ 的 23 个两阶段种子上,把第一层绕开第二层的直接路径或第二层注意力指向人为选定值。小间隔时两条路径都可能改变输出;间隔增大后,第一层直接路径的劫持成功率衰减,第二层仍接近 100%。(§4.1;PDF p. 8,图 4)
2.4 第一层如何给第二层一个搜索窗口
为分析第二层的查询—键分数,作者先考虑第一层注意力集中于单个词元的简化情形:
$z$ 是当前输出值,$t$ 是第二层考虑的候选键值;$x$、$y$ 分别是第一层在查询侧和键侧关注的值,$V_x^{(1)}$ 是第一层注意力输出投影后的 value 向量。这个式子把第一层汇集的上下文怎样改变第二层查询写成可检查的路径。附录 E 的替换实验支持此简化:13 个两阶段检查点中,仅用第一层 MLP 输出给第二层注意力计算 QK 分数,注意力分布平均 $\ell_1$ 距离均小于 $0.03$,整序列准确率最大下降 $0.05\%$;另有两个 $N=1024$ 检查点偏离,说明它是常见机制而非架构必然性。(§4.2、附录 E;PDF pp. 8–9、31–33,式 (1)、图 20–22)
扫描这个分数函数时,第二层几乎不随键侧目标 $y$ 改变,却强烈随查询侧目标 $x$ 改变:高分区域大致落在 $[z,x]$。作者把它称为窗口内单调性(windowed monotonicity):第一层提供一个近似上界提示,第二层只需在较小窗口里区分候选,而不必在整个词表上维持全局精确排序。人为改变 $x$ 后,第二层最关注的键通常落在 $z$ 与 $x$ 之间,并随 $x$ 增大;当提示过远时,在约 300 附近饱和。图 5 的说明也指出:当 $x$ 非常接近 $z$ 时,上述规律不稳定。提示是作者对观测到的内部运算的解释,不应读成每次预测都严格满足的数学上界。(§4.2、附录 F–G;PDF pp. 8–9、33–36,图 5、20、23–28)
候选集统计给出另一个侧面。按“注意力权重 $>0.04$ 的键数”计,训练长度上两阶段模型每层约关注 1.5 个键,单阶段第一层约 3.6 个;当测试长度达到训练长度的 8 倍时,两阶段第一层约 3.1 个,单阶段第一层约 8.7 个。它支持较小搜索范围与更好泛化的联系,但候选数是按阈值定义的描述性量,不能单独证明窗口机制。(§4.2;PDF pp. 9–10,图 5b)
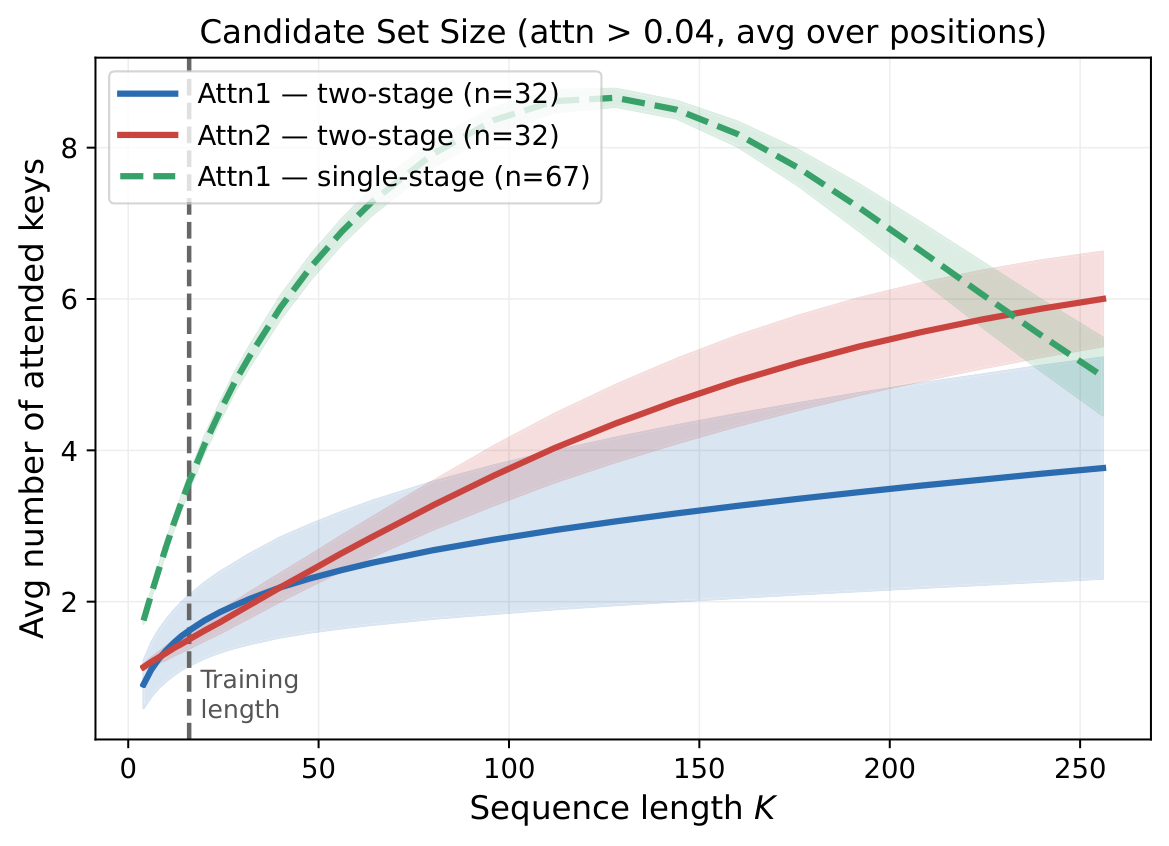
原图 5b,PDF p. 9。 横轴为测试长度 $K$,虚线为训练长度 16;纵轴为平均超过 0.04 阈值的键数。蓝色两阶段第一层始终比绿色单阶段第一层集中。红色两阶段第二层在极长序列也会变宽,因此“两个注意力层始终都更尖锐”并不是图的结论。
三:实验——如何区分机制与泛化
主实验通过固定训练长度、改变测试长度与随机种子,检查两件事:最终是否依赖第二层注意力,以及这种依赖如何预测长序列的词元准确率。图 1a 在排序设置 $N=256,K_{\rm train}=16,\sigma=0.01$ 下显示两簇:蓝色两阶段曲线到 $K=256$ 基本维持在 1,红色单阶段曲线则下降到约 0.2。图 1 的颜色是消融后的整序列准确率,曲线纵轴是未经消融的词元准确率,不能把二者当成同一个指标。(§3;PDF pp. 2、4–5,图 1a)
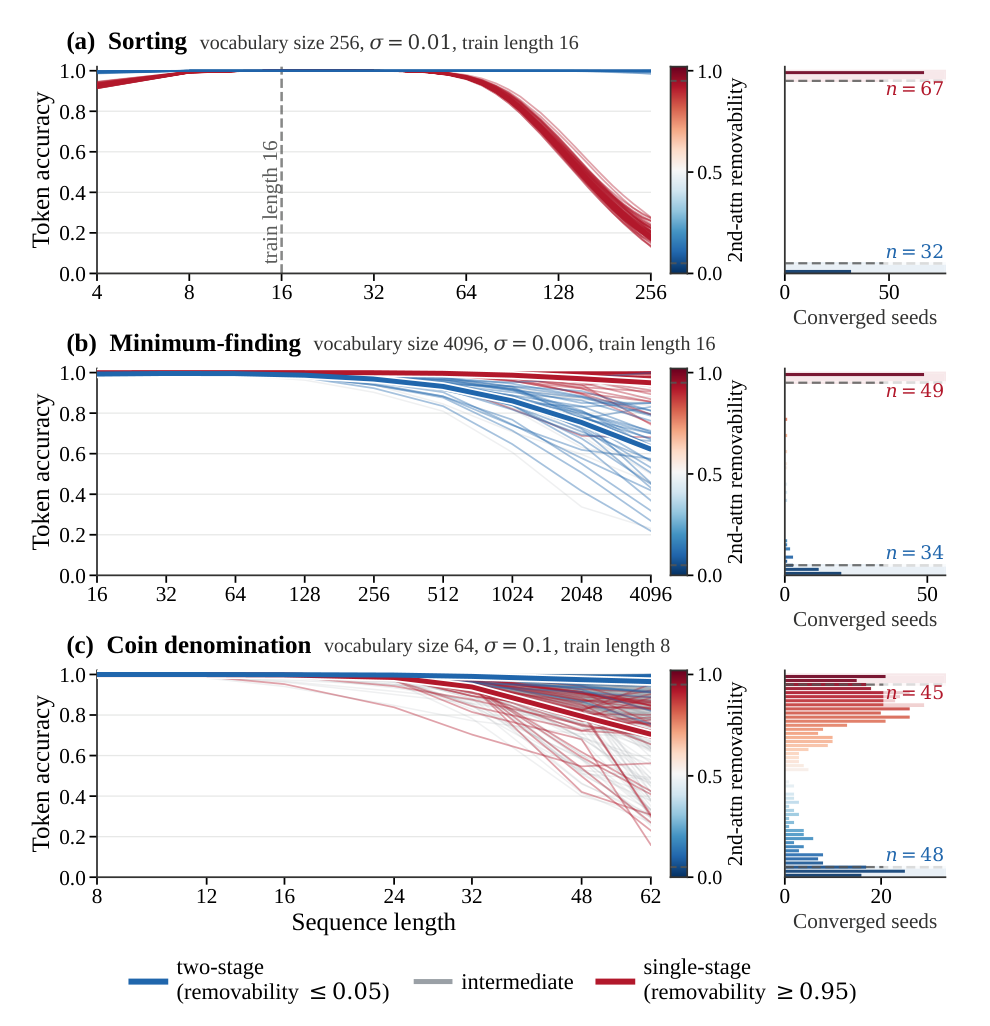
原图 1,PDF p. 2。 三行分别是排序、最小值与贪心硬币;每条线代表一个种子。前两项的训练长度都是 16,硬币任务是 8;词表分别为 256、4096、64。右侧分布图显示第二层注意力可移除性。排序中“蓝优于红”、最小值中“红优于蓝”的反转,是理解论文结论的关键。
作者又用三类实验把相关性推进到机制证据:按间隔分组的消融与路径劫持检验层间分工(图 3–4);替换残差路径、扫描 QK 分数、改变第一层注意力目标检验提示机制(图 5、附录 E–H);改变初始化、词表和宽度检验训练会选哪类解法(图 6、附录 A–C)。这些实验的对照对象不同:不能把“注意力 argmax 命中率”“消融后整序列准确率”和“无消融的长序列词元准确率”混作一个准确率。(§4–5、附录 A–H)
四:结果——哪个解法被学到,以及何时有效
4.1 初始化可引导解法,但引导过强会损及泛化
保持一个注意力层初始化标准差为 $0.01$,只增大另一个,论文在排序 $K=16,N=128$、每条件 100 个种子下得到:(§5.1;PDF pp. 10–11,图 6)
| $\sigma_1$ / $\sigma_2$ | 两阶段种子占比 | 含义 |
|---|---|---|
| $0.012/0.010$ | 0% | 第一层更大,全部选单阶段 |
| $0.010/0.010$ | 26% | 对称基线 |
| $0.010/0.011$ | 82% | 第二层稍大,明显偏向两阶段 |
| $0.010/0.013$ | 100% | 全部选两阶段 |
作者推测较大初始化使该层更早形成结构,这是训练动力学解释,不是单靠终点分布证明的过程。图 6 下半部分还显示,$\sigma_2=0.013$ 时尽管分类结果全是两阶段,部分种子的远距离泛化变差;附录 A 发现较差种子的第一层小间隔分工也较弱。因此,引导到“两阶段”不等于保证其中每个模型都具备同样好的内部协作。(PDF pp. 11、19–20,图 6、8)
任务难度与容量也改变解法概率:词表从 $N=64$ 增大到 $512$ 更偏向两阶段;固定 $N=256$ 时,嵌入宽度从 $E=32$ 增大到 $80$,两阶段份额从全部降到零。作者的解释是区分更大词表使任务变难,而更宽的表示让单阶段解法更容易训练出来。这些是关于出现频率的结果,不是说宽度本身必然降低已经学到的某个两阶段模型的长序列准确率。(§5.2、附录 B;PDF pp. 10、21–22,图 9–10)
4.2 训练长度改变小间隔暴露机会
附录 C 固定 $N=256$、改变训练长度。$K_{\rm train}\ge16$ 时,两阶段模型基本都泛化到最长测试长度;更短训练长度下,即使被归为两阶段,也没有种子实现完全长度泛化。在 $K_{\rm train}=4$ 的种子中,第一层对 $g=1$ 原输入的注意力质量与 $K=256$ 词元准确率相关系数为 $r=+0.77$;较小候选集也与较好泛化相关。(PDF pp. 23–25,图 11–13)
定向构造的连续整数输入更直接暴露失败模式:训练长度 32 的完全连续序列在训练分布中的预期频率约 $10^{-39}$,两阶段模型在连续段上的准确率为 1,单阶段为 0.89;训练长度到 64 时,单阶段在这种输入上也可达到 1。另一方面,训练长度越大,超大间隔越稀少,模型跨越大间隔的能力又会下降。这里展示的是训练分布与特定输入类型的互动,不能把两类机制当成脱离训练长度的固定能力。(附录 C;PDF pp. 25–27,图 14–15)
4.3 换任务后,泛化方向可以反转
最小值任务从 $\{1,\ldots,4096\}$ 有放回抽取长度 16 的序列,只输出最小值。单阶段模型在更长输入上优于两阶段模型(图 1b)。两阶段模型较能处理某些重复值输入,却更容易在大量值挤在最小值附近时失败;后者随着长度增加更常见。作者给出一个关于重复竞争者的解释:若唯一最小值的 softmax 前分数为 $a_1$,而 $n$ 个次小值各得 $a_2$,要让最小值获得比它们合计更多的注意力,需 $a_1-a_2>\log n$。这说明重复会增加分数间隔要求,但近最小值拥挤为何特别伤害两阶段仍主要是经验发现。(§6;PDF pp. 11–13,图 1b)
贪心硬币任务给出第三种形态:输入不同面值和目标,反复选不超过当前余数的最大面值并输出余数;训练面值集合大小 8、词表大小 64。更依赖第二层的模型总体倾向于更好泛化,但解法类型与泛化关系比排序更连续、更分散,无法简单分成两个完全整齐的簇。(§6;PDF pp. 11–12,图 1c)
4.4 “需要两层”只适用于主实验的单头条件
四层、单头排序模型也可出现不同必需深度;能只靠第一层工作的种子不能长度泛化,至少使用两层的种子则能泛化。不过作者明确说,四层模型未显示出两层模型那样整齐的间隔分工或层层缩小候选集,因此主文机制不能直接外推到更深结构。(附录 D;PDF pp. 27–29,图 16–17)
更关键的是多头对照:在 $E=64$、训练长度 16 的设置中,两层每层两个头时,图 19b 的模型全部属于“第二层可移除”的单阶段类,却仍能长度泛化;单层模型里两个头也胜过一个头(图 19c)。所以图 1a 的对比支持的是“在本文单头设置中,两阶段机制能克服特定失败模式”,而不是“排序的长度泛化必须有第二层”。(附录 D;PDF pp. 30–31,图 18–19)
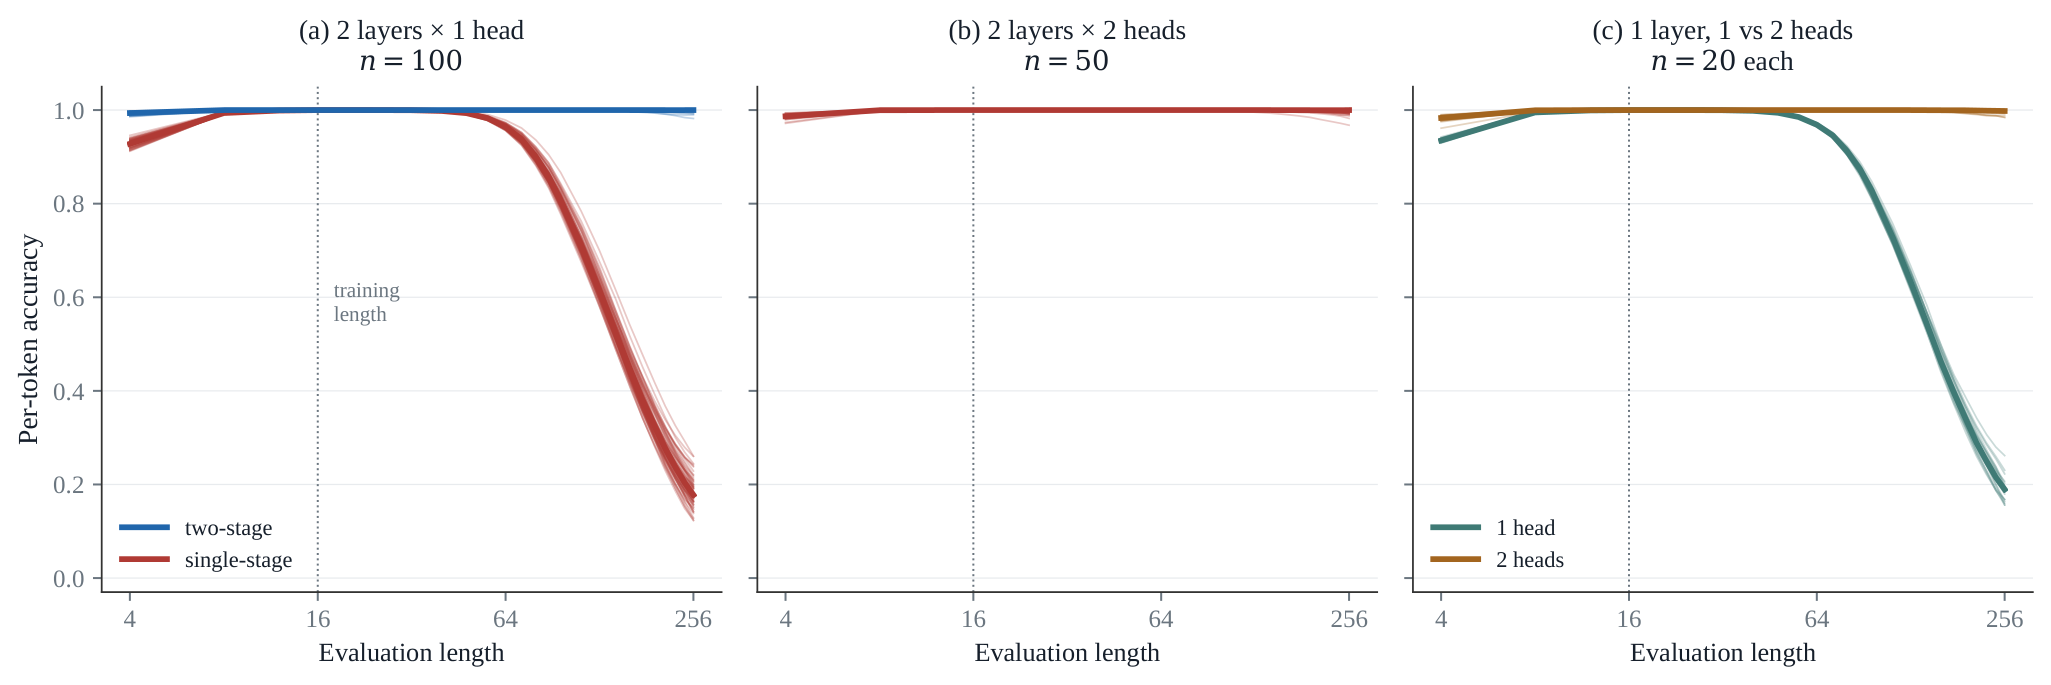
原图 19,PDF p. 31。 三个面板分别比较两层单头、两层双头与单层单双头;虚线是训练长度 16。中图红线属于单阶段,却保持高词元准确率,直接限定了主文“单阶段失准”的适用范围。
五:结论与研究启发
这篇论文最有价值的区分是:训练任务相同、训练长度精度相同,不代表模型学到了相同算法,也不代表长度外推相同。消融先揭示两类功能路径,按间隔分析说明长序列改变了关键输入的比例,路径干预和 QK 扫描再为两阶段模型的层间分工与查询侧提示提供更具体的解释。初始化比例、词表大小和宽度能改变哪类解法更容易出现。(§3–5;PDF pp. 4–11)
对方法设计的启示,是把训练分布中稀少、测试时会变常见的输入类型明确列出来,再问模型哪条路径处理它们;只比较训练精度或抽象的“简单/复杂”不足以判断长度泛化。最小值任务的反转和多头结果说明,真正可迁移的是这种失败模式与分布变化相匹配的分析方式,而非“增加层数”这个表面规则。(§6、附录 D;PDF pp. 11–13、30–31)
读图时的一处原文笔误。 附录 G 有一句称第二层分数“几乎完全依赖键侧 $y$”,但同一附录引用的图 20、其前一段以及正文 §4.2 都显示分数对 $y$ 几乎不变、主要随查询侧 $x$ 改变;这里按图与上下文理解为 $x/y$ 写反。(PDF pp. 9、32、34)