MemT-1.0: Towards Memory-Native Evolution:中文精读
作者:MemTensor Team(Zhiyu Li、Zeyu Zhang、Linyun Liu 等)
论文:arXiv:2610.26825v2;2026-10-22 获取;本地原文 PDF
论文总览
论文研究如何把跨轮记忆做成模型计算的一部分:历史交互结束后写入每条轨迹自己的动态状态,新一轮只带当前输入,模型便可从该状态读取历史信息。MemT-1.0 在冻结的语言模型旁加入并行记忆分支,以逐 token 的稳定 GDN-2 更新状态,并提出 Mixture-of-Storage(MoS)扩容。它用 20B token 的续预训练数据和 14B token 的后训练数据训练记忆参数;后训练让只见记忆状态的学生拟合能看到完整历史的主干教师。(Sec. 2–3,PDF pp. 6–14)
主结果:Flash 和 Nano 在 11 个记忆基准的等权平均分分别为 50.6、47.0,高于所比较的参数化记忆基线最好值 38.1;最强的文本记忆系统仍达到约 68.6。Nano 在 BEAM 128K 历史的指定单请求实验中,相对完整上下文的端到端推理约快 1.86×,每条轨迹的逻辑持久状态约小 66×。用检索到的编码经验指导代理任务时,Nano 在 SWE-bench Verified 的三次运行平均成功率由无经验基线的 66.07% 提升至 69.33%(执行前存储)或 69.73%(执行中触发存储)。(Table 2,PDF p. 20;Sec. 6.5–6.6,PDF pp. 22–24;Table 5,PDF p. 29)
结构地图
| 原文章节 | 主要作用 | PDF 页码与关键材料 |
|---|---|---|
| 1 Introduction | 动机、系统与贡献 | p. 5 |
| 2 Model Architecture | 跨轮状态、稳定写入、读取、MoS | pp. 6–10;Figs. 4–5 |
| 3 Training | 主干准备、34B 数据、蒸馏和两阶段训练 | pp. 10–14 |
| 4 System and Infrastructure | 分布式训练、分块算子和有状态服务 | pp. 14–16;Table 1 |
| 5 Memory Scaling Behavior | 后训练进度和记忆专家数的变化 | pp. 16–18;Figs. 6–7 |
| 6 Evaluation | 记忆、通用能力、消融、延迟与状态大小 | pp. 18–25;Tables 2–4,Figs. 8–10 |
| 7 Application in Agentic Tasks | 检索经验写入记忆与编码代理评测 | pp. 25–30;Fig. 11,Table 5 |
| 8–9 Limitations and Discussion / Conclusion | 有限容量与发展方向 | pp. 30–31 |
| Appendices B–G | 实际模型几何、稳定性推导、评测口径、代理细节、窗口实验、案例 | pp. 35–65 |
一:动机
完整上下文保存逐字历史,读取细节方便,但每次查询要持续处理增长的 KV 状态;检索系统只送相关片段,却需要维护随历史增长的文本和索引。参数化记忆尝试将历史压入固定大小的状态,主要难题是写入之后还能否准确找回并更新事实。作者在前作 Metis 的“动态局部记忆+可训练超记忆”框架上,针对写入粒度、数值稳定性、容量与训练目标作了改造。(Sec. 1–2,PDF pp. 5–9)
这里的“记忆原生演化”是方向而不是已经实现的自主持续学习:本论文的在线记忆状态可跨交互变化,超记忆参数仍在部署时固定;编码代理的经验由外部构建和检索。若把存储的经验进一步固化到超记忆参数,需要后续训练。(Sec. 7–8,PDF pp. 25–30)
二:方法
2.1 两条时间尺度与读写边界
在交互步 $t$,冻结的主干参数 $\theta_b$ 和训练所得的超记忆参数 $\phi$ 是共享的;每条轨迹、每个选中层都有自己的动态矩阵 $M_t^{(l)}$。一条新轨迹从零状态开始。当前轮生成时,原有注意力与记忆注意力并行,输出相加后送往主干的后续计算。整轮内所有 token 读取进入该轮时的快照 $M_t$;在整轮完成后,写入器按 token 顺序处理 $X_t\Vert Y_t$,提交 $M_{t+1}$。 因此“逐 token 更新”描述写入器内部的顺序,绝不表示本轮后面的生成 token 会立即看到本轮刚写入的状态。(Sec. 2.1–2.2,Fig. 4,PDF pp. 6–8;Sec. 4.2,PDF p. 15)
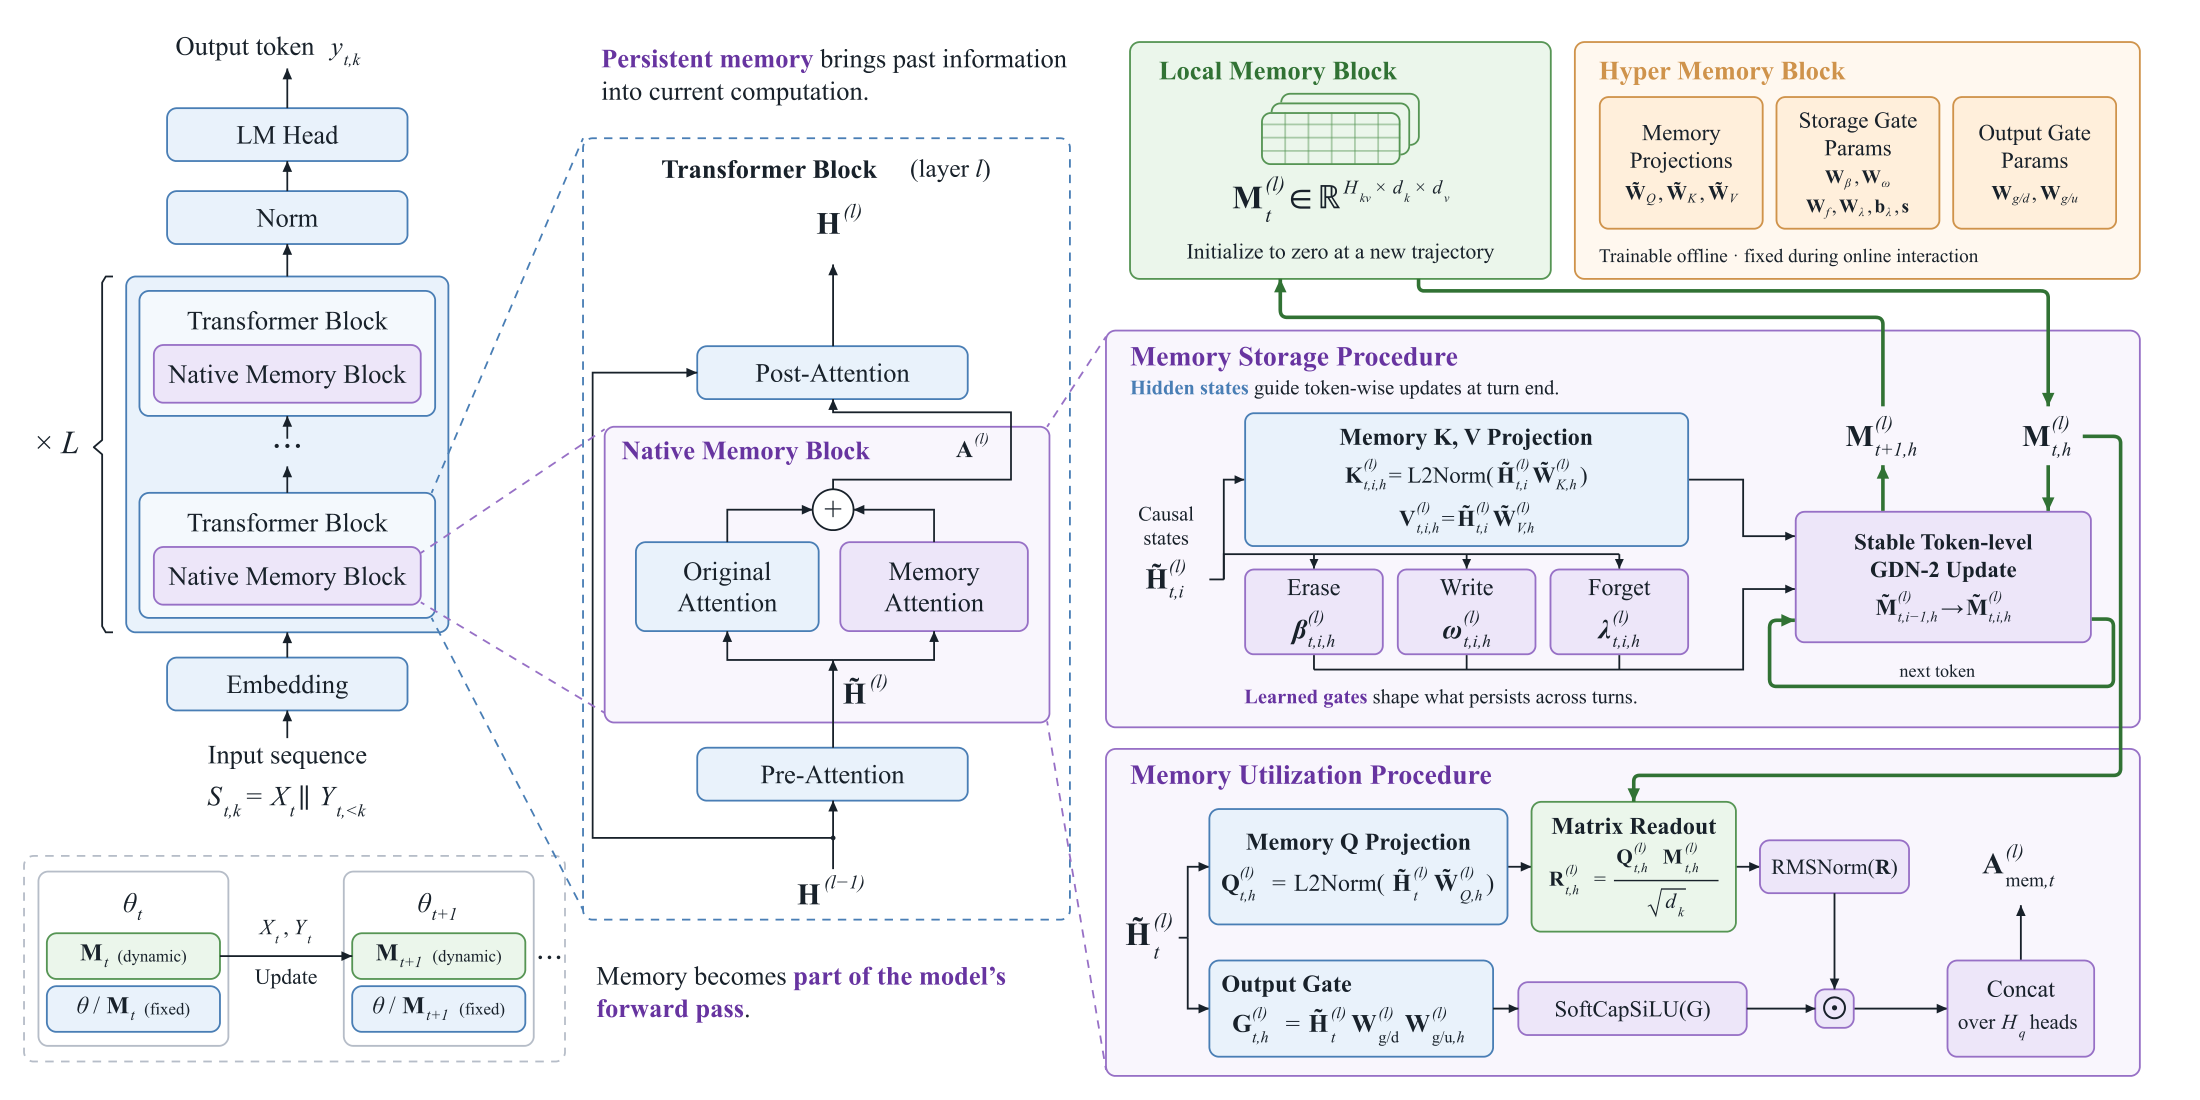
原图 Fig. 4,PDF p. 6。 左边是选中 Transformer 层的并行分支;右上区分每条轨迹变化的局部矩阵与离线训练、在线固定的超记忆参数;右下区分轮末写入和本轮读取。这也是理解训练时梯度可穿过先前写入、在线推理时参数不更新的关键。
单个记忆块的局部状态形状为 $M_t^{(l)}\in\mathbb R^{H_{kv}\times d_k\times d_v}$。其中 $H_{kv}$ 是通道数,$d_k,d_v$ 是键和值宽度。部署状态元素数满足
$$N_{\mathrm{state}}=\sum_{l\in\text{memory layers}} E_lH_{kv,l}d_{k,l}d_{v,l},$$其中 $E_l=1$ 表示不扩成多个专家。固定结构下,该数不随同一条轨迹的历史长度增长,但会随轨迹数增加,当前轮还需要 KV cache 与计算空间。附录 B 的主评测模型均为每层 1 个记忆专家:Nano 在 10 个层上各用 16 个 $256\times256$ 状态,共 10,485,760 个 FP32 元素(40 MiB);Flash 在 20 个层上各用 64 个 $512\times512$ 状态,共 335,544,320 个元素(1,280 MiB)。MoS 的 2/4 专家容量试验属于另一个受控设置,不能将其容量收益直接归于主评测检查点。(Sec. 4.3,PDF p. 16;Appendix B,Table 6,PDF p. 35)
2.2 写入:对称化的逐 token Delta 更新
对单层、单通道、轮内第 $i$ 个 token,投影得到 L2 归一化的键 $k_i$ 和值 $v_i$,以及逐维擦除门 $\beta_i$、写入门 $\omega_i$、负的遗忘对数门 $\lambda_i$。把省略的层/轮下标恢复即可对应原文。核心式子可写为
$S_i$ 是轮内暂存状态,$L_t$ 是本轮 token 数。$D_i$ 沿键维遗忘,$(I-u_i^\top u_i)$ 沿当前写入方向擦除旧关联,$u_i^\top z_i$ 写入新关联;逐 token 顺序处理允许后一个 token 修改前一个 token 建立的关联。(Sec. 2.2,PDF p. 8;Sec. 4.2,PDF p. 15)
为何要对称化? 未修正 GDN-2 的擦除矩阵为 $A=I-k^\top(\beta\odot k)$。当 $\beta\odot k$ 不与 $k$ 共线时,它会把某些与 $k$ 正交的输入推向 $k$ 方向,可能使范数增加。原文附录 C 在二维基底下得到对某个正交方向 $e$ 的 $\lVert eA^\top\rVert_2^2=1+\gamma^2$。作者把擦除门的平方根放到两边,得到对称的 $I-u^\top u$;在 $\|u\|_2^2<1$ 时,单步擦除沿 $u$ 收缩、正交方向不扩张。这个推导说明具体的非扩张性质;整个含遗忘门和写入项的递推有界,还需相应范数及输入界条件。(Appendix C,PDF pp. 37–40)
2.3 读取:固定快照如何影响生成
对当前隐状态生成查询 $q_i=\operatorname{L2Norm}(\tilde h_i\tilde W_Q)$,读出 $r_i=q_iM_t/\sqrt{d_k}$。读出先做 RMSNorm,再与受限幅 SiLU 作用的输出门相乘,各通道拼接为记忆注意力输出。原文的限幅函数为
$$\operatorname{SoftCapSiLU}(x)=\tau\tanh\!\left(\frac{x\sigma(x)}{\tau}\right),\qquad \tau=2.$$门控让记忆分支对当前 token 的影响可变化,而不是不加区分地把状态加入主干。Nano/Flash 的具体投影、融合点与初始化不同;两者主干在记忆训练时均冻结,记忆分支的可训练参数分别约 4.51 亿和 36.09 亿。(Sec. 2.2,PDF pp. 8–9;Appendix B,PDF pp. 35–37)
2.4 MoS 扩容
Mixture-of-Storage 把一层扩成 $E$ 个独立状态和超记忆参数,并用共享专家地址 $C$ 训练两套密集路由:$\alpha_{\rm s}$ 控制写入、$\alpha_{\rm u}$ 控制读取。写入权重缩放每个专家的擦除门和写入门,不缩放对数遗忘门;读取则对全部专家输出加权求和:
$$\alpha_{\rm u}=\operatorname{softmax}_E(\tilde HW_{\rm route/u}C^\top),\quad \alpha_{\rm s}=\operatorname{softmax}_E(\tilde HW_{\rm route/s}C^\top),\quad A_{\rm mem,i}=\sum_{e=1}^E\alpha_{{\rm u},i,e}A_{{\rm mem},i,e}.$$这是密集路由,每个专家都计算,增加容量也增加计算和中间激活;它不是只激活少数专家的稀疏 MoE。(Sec. 2.3,Fig. 5,PDF pp. 9–10)
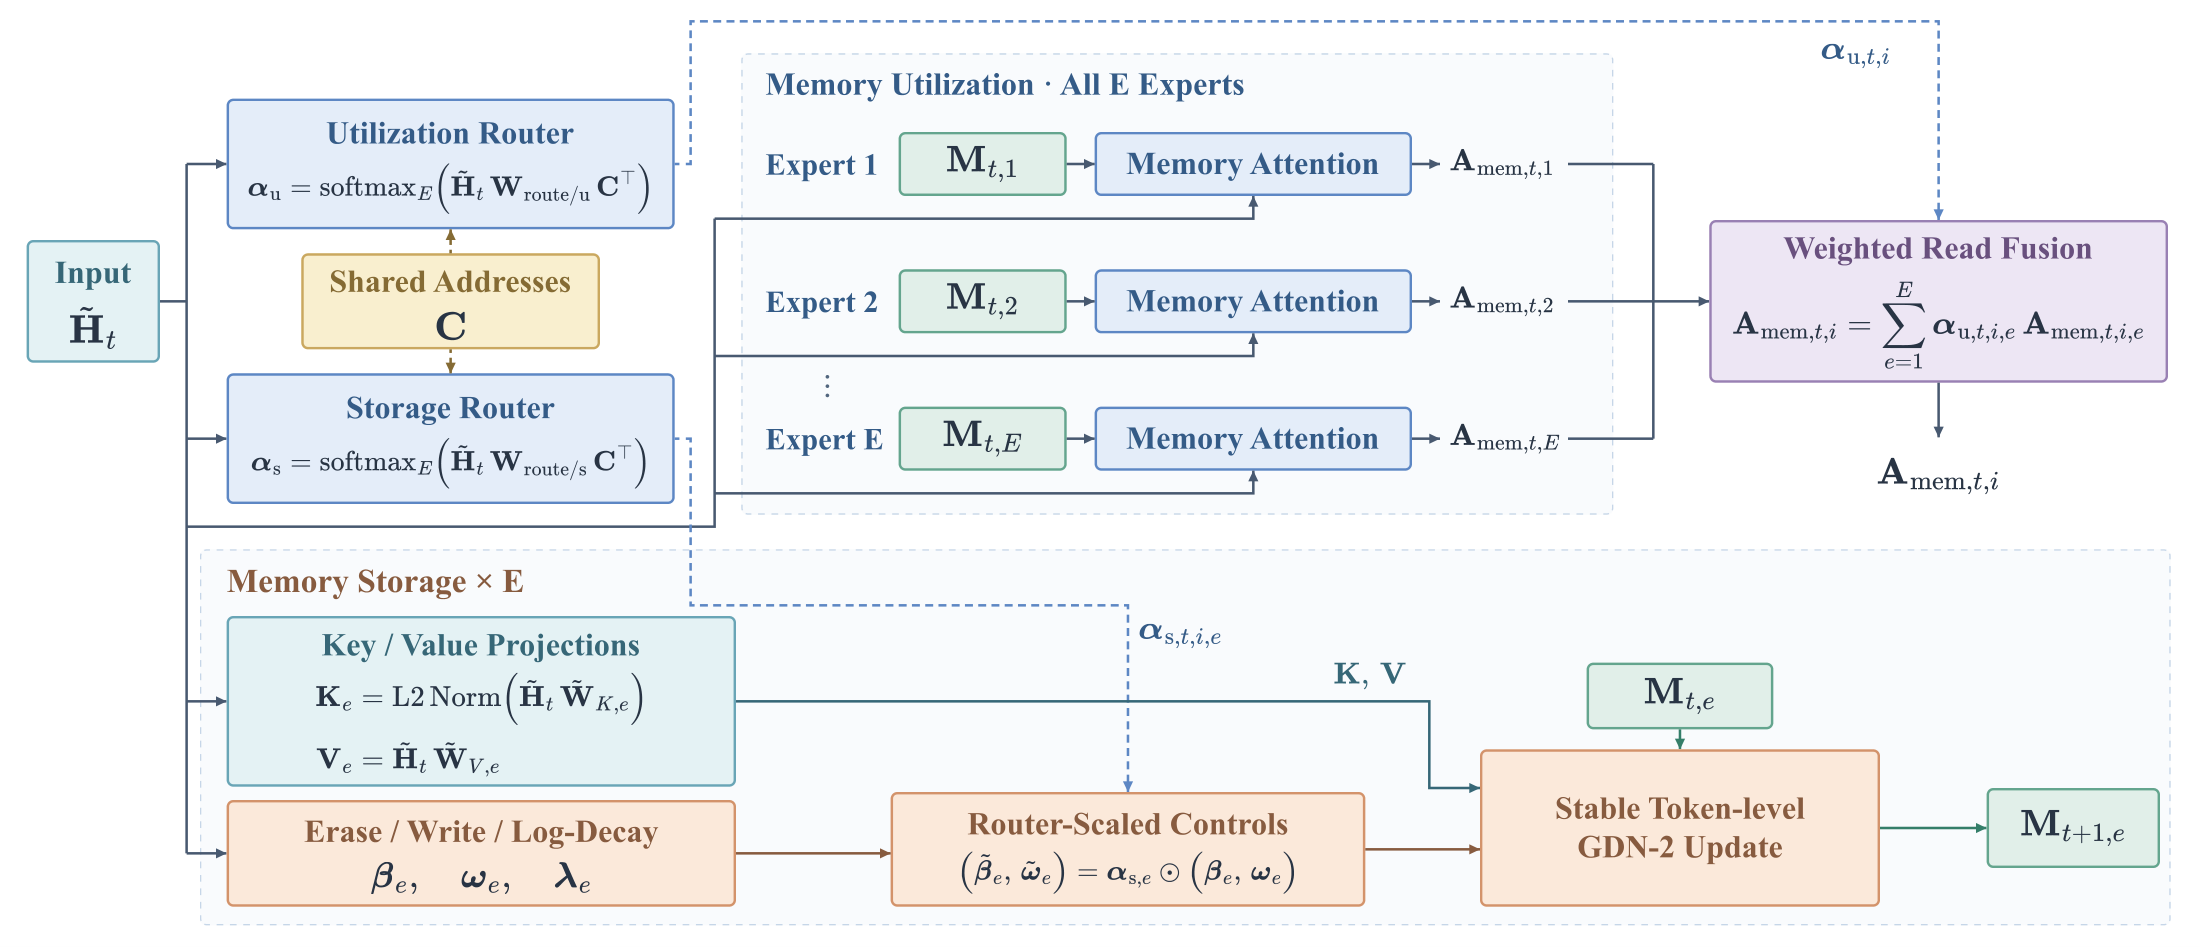
原图 Fig. 5,PDF p. 9。 上半部的读取路由混合所有专家,下半部的存储路由调节各专家写入强度;两条路由共享地址但有不同的投影。
2.5 训练:把“全文教师”压进跨轮状态
作者先对 Flash 的 DeepSeek-V4-Flash 主干做能力准备:多次探测任务、判断缺失的是可靠执行、程序/规范还是事实,再选择重放、经验证的自身成功轨迹或指导示范。最终混合约 126.5K 条轨迹、2.4B token,准备后主干在所监控六项基准平均提高 6.3 分。此步骤发生在挂载记忆模块之前,与后面的记忆训练分开。(Sec. 3.1,PDF pp. 10–11)
记忆训练用总计 34B token:20B 续预训练(continued pre-training, CPT)数据让学生仅凭当前片段文本和此前状态做语言建模;14B 后训练数据包含记忆原生语言建模、存取任务及长程记忆任务。后训练时教师见完整历史 $C_{
后训练对教师 Top-64 词概率重归一化,最小化前向 KL:
$$\ell_{t,k}=T_d^2\sum_{v\in\mathcal K_{t,k}}\hat q_{t,k}(v)\log\frac{\hat q_{t,k}(v)}{p^{T_d}_{t,k}(v)},\qquad T_d=1.$$$\hat q$ 是只在教师 Top-64 上重归一化的分布,学生 $p$ 仍对整个词表归一化,所以把概率放到教师未选词也会受罚。CPT 用交叉熵,后训练以 KL 为目标。评测检查点的训练 pack 最多 64K token,写入步 2K token;Nano/Flash 的全局 batch 分别为 64/192 packs。(Sec. 3.3–3.6,PDF pp. 12–14;Appendix B,Table 7,PDF p. 37)
2.6 系统实现的成本
训练 pack 可包含独立轨迹:同一步的文本注意力不跨步,记忆只沿本轨迹传播,并在轨迹边界清零。系统按 decoder 层批量处理完整 pack,把需要顺序性的记忆写入交给分块 WY 计算;本轮读取可批量用同一旧快照。MoS 的完整 pack 专家投影会膨胀激活,因此作者按完整步划窗口,并在反传时重算中间量。单 GPU、合成隐状态、单个四专家记忆块、32K-token pack 下,4096-token 窗口的峰值已分配内存从 47.83 降到 9.49 GiB(约减 80.1%),前反向中位时间从 463.0 增至 470.6 ms(约增 1.6%);这是记忆块微基准,不能解读为整模型训练加速。(Sec. 4.1–4.2,Table 1,PDF pp. 14–16;Appendix F,PDF pp. 60–62)
三:实验设计
记忆任务。 11 个基准按历史长度分四组,覆盖事实回忆、个性化、操作和长程查询。每条历史先按顺序写入并隔离状态,再在无原历史文本的条件下回答多个问题。Table 2 的 AVG 是 11 项等权平均分;不同子基准各有自己的评分定义,例如 PS-Bench 报告 $100(1-\mathrm{ASR})$,方向是越高越好。文本类对照包括完整上下文、DenseRAG、MemOS、Mem0、OpenViking、Graphiti;参数化类包括 Temp-LoRA、Doc-to-LoRA、SHINE、$\delta$-mem、LiveMem、MemoryLLM、ICAE。参数化基线使用的模型规模和机制并不完全相同,因此 Table 2 更适合判断所列系统在同一评测流程中的表现,而非单独归因于某个组件。(Sec. 6.1,PDF pp. 18–20;Appendix D,PDF pp. 40–43)
通用任务。 6 项基准覆盖知识、指令、长上下文与代码。作者先将少量无关示例写入 MemT 状态或放入对应主干的文本上下文,再比较同一噪声设置下的 MemT 与其自身主干。因此 Table 3 的 MemT 行是相对差值,单位为分,而非绝对成绩。(Sec. 6.1、6.3,PDF pp. 18、20–21;Appendix D.4,PDF pp. 51–52)
效率。 BEAM 历史、固定 512-token 查询和强制生成 128 token;历史准备一次,预热一次查询,计时五次查询,35 条历史取均值。完整上下文、Temp-LoRA 和 Nano 在各自独占的两张 GPU 上用 HF 推理,单请求、batch 1;$\delta$-mem 用其公开实现。端到端时间包含准备历史与一次响应生成,查询首 token 延迟(TTFT)排除历史准备。状态大小是准备后、查询前的逻辑每轨迹持久状态,排除共享权重,不是 GPU 进程峰值内存。(Sec. 6.5–6.6,PDF pp. 22–24)
四:结果与解释
4.1 记忆能力:参数化类别领先,精确长程召回仍落后
| 方法 | 11 项等权 AVG ↑ | LongMemEval-S ↑ | BEAM-1M ↑ | 来源 |
|---|---|---|---|---|
| MemT-1.0-Flash | 50.6 | 37.2 | 37.0 | Table 2,p. 20 |
| MemT-1.0-Nano | 47.0 | 32.6 | 35.8 | Table 2,p. 20 |
| Temp-LoRA(参数化基线最佳 AVG) | 38.1 | 13.4 | 32.3 | Table 2,p. 20 |
| MemOS,DeepSeek 分支(文本记忆) | 68.6 | 83.2 | 72.6 | Table 2,p. 20 |
| 完整上下文,Qwen 分支 | 66.3 | 76.8 | 43.7 | Table 2,p. 20 |
Flash 比 Nano 的等权平均高 3.6 分,论文指出优势主要来自记忆操作等任务;Nano 在 PerMemSafe、Memora 反而更高。最强文本记忆系统在 LongMemEval-S 和 BEAM-1M 的明显优势说明:固定状态能保存可用信息,却比保留可检索原文更难持续保有精细证据。尤其要注意,这些是不同系统、部分不同主干的整体比较;不能把 12.5 分差解释成“只改变记忆模块”后的纯因果增益。(Sec. 6.2,Table 2,PDF pp. 19–20)
附录 G 的四个单例展示事实回忆、缺失信息时拒答、链式规则应用和更新追踪。64K 案例中,Nano 在后续又经历约 508 轮对话后,仍区分展览时间的正式变更与后来未采纳的建议;这为“状态可保存某些长期关系”提供直观例子,整体可靠性仍应由 Table 2 的批量评测判断。(Appendix G,PDF pp. 62–65)
4.2 通用能力与消融:关键在写入粒度和后训练
| 相对同主干的无关噪声设置 | 六项 AVG 变化(分) | 具体差异 | 来源 |
|---|---|---|---|
| Flash | 0.0 | BigCodeBench-Hard +2.0;MMLU-Pro −1.8 | Table 3,p. 21 |
| Nano | −0.9 | IFEval +3.3;LiveCodeBench v6 −5.8 | Table 3,p. 21 |
“总体基本保留”并不表示每项不变:Nano 的 LiveCodeBench v6 下降 5.8 分最突出,而另一个代码基准提高 2.0 分。消融的 11 项平均分:完整 Nano 约 46.97;去 CPT 44.9;去后训练 36.3;逐 token 改整轮聚合 40.98;未对称化 GDN-2 46.43;普通 GDN 46.72;加入双向编码 45.43。由此可判断:在作者给定训练预算下,逐 token 更新和后训练比更新式的这几个局部变体更影响总体成绩;附录 C 的对称化价值主要来自数值机制,Table 4 的小幅均分差本身不足以证明很大能力增益。(Sec. 6.3–6.4,Tables 3–4,PDF pp. 20–22)
4.3 扩容与训练进度:受控设置下有收益
同一 Nano 后训练轨迹、重复使用同一语料两轮,平均分从 36.65 升至第一轮末 45.40、第二轮末 46.80;LoCoMo 从 40.39 到 55.39、57.53。增益前期更快,后期仍有波动和小幅提升。另一个实验在 400 步 CPT 后比较 2 与 4 个 MoS 专家,4 专家在 200/3400/5500 步的平均分分别高 0.41/2.01/2.69 分。这说明容量收益可能随训练推进显现,但这些曲线不构成跨架构、跨预算的普遍缩放定律。(Sec. 5.3–5.4,Figs. 6–7,PDF pp. 17–18)
4.4 延迟与存储:收益出现在较长历史
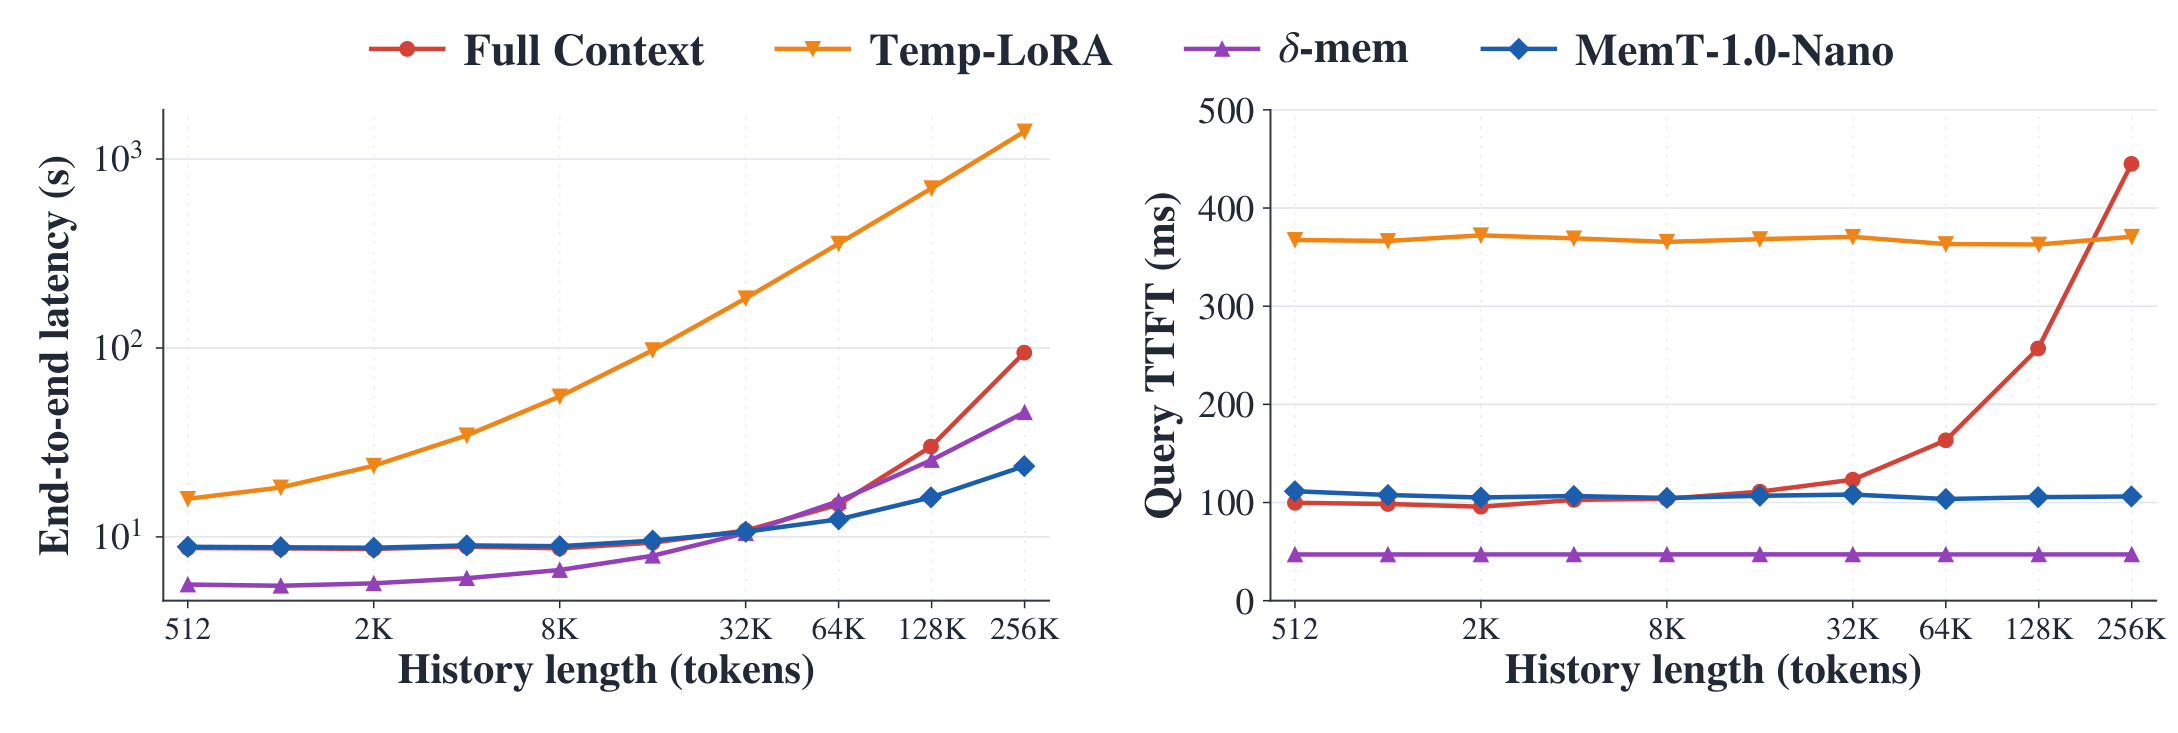
原图 Fig. 8,PDF p. 23。 横轴是历史 token 数;左图纵轴为包含历史准备的端到端秒数(对数刻度),右图为不含历史准备的查询 TTFT 毫秒数。Nano 在短历史通常较慢,到 32K 左右与完整上下文接近;在 64K、128K、256K 的端到端加速分别约 1.20×、1.86×、3.99×。128K/256K 的 TTFT 分别约 104–112 ms,完整上下文约 257/445 ms;读固定状态使查询首 token 时间随历史增长较平稳。作者指出长历史端到端优势主要来自更低的历史准备成本。(Sec. 6.5,Fig. 8,PDF pp. 22–24)
128K 历史时,Nano 的逻辑每轨迹持久状态比完整上下文小约 66×。完整上下文的曲线受 256K 窗口上限约束;短历史时 DenseRAG 的已存文本和向量反而可小于 Nano 的固定分配。相应取舍是固定大小状态的细节承载能力有限,见 Table 2 中长历史问答差距。(Sec. 6.6,Fig. 9,PDF p. 24;Appendix D.5,PDF p. 53)
论文还把 Nano 的 FP32 记忆矩阵在每次写入后做在线 SVD 截断,再重建稠密状态来评估秩与成绩关系。LoCoMo 的成绩通常随秩增加,PersonaMem 较早饱和。图中的“理论因子存储”随秩线性增长,但该实验后续计算仍使用重建的稠密矩阵,不能把曲线当成已实现的低秩部署内存节省。(Sec. 6.7,Fig. 10,PDF p. 25)
4.5 编码代理:存的是外部检索出的程序经验
流程是:从成功轨迹归纳 1,040 条经验,用 BGE-M3 按任务检索;在任务开始前或检测到执行失败、空观察、重复操作等断点时,将经验写成文本上下文,或通过单独的写入操作压进 Nano 状态。每条任务轨迹最多存储一次。训练数据由失败轨迹在断点加入经验、同状态续跑且通过测试的续写构成;原始轨迹 18,820 条、试验断点—经验组合 199,500 个,经过筛选得到 42,403 个样本。训练时主干冻结,学生仅靠记忆取经验,教师见经验文本;主实验选择 KD 和完整成功后缀监督。(Sec. 7.2–7.3,Fig. 11,PDF pp. 26–28)
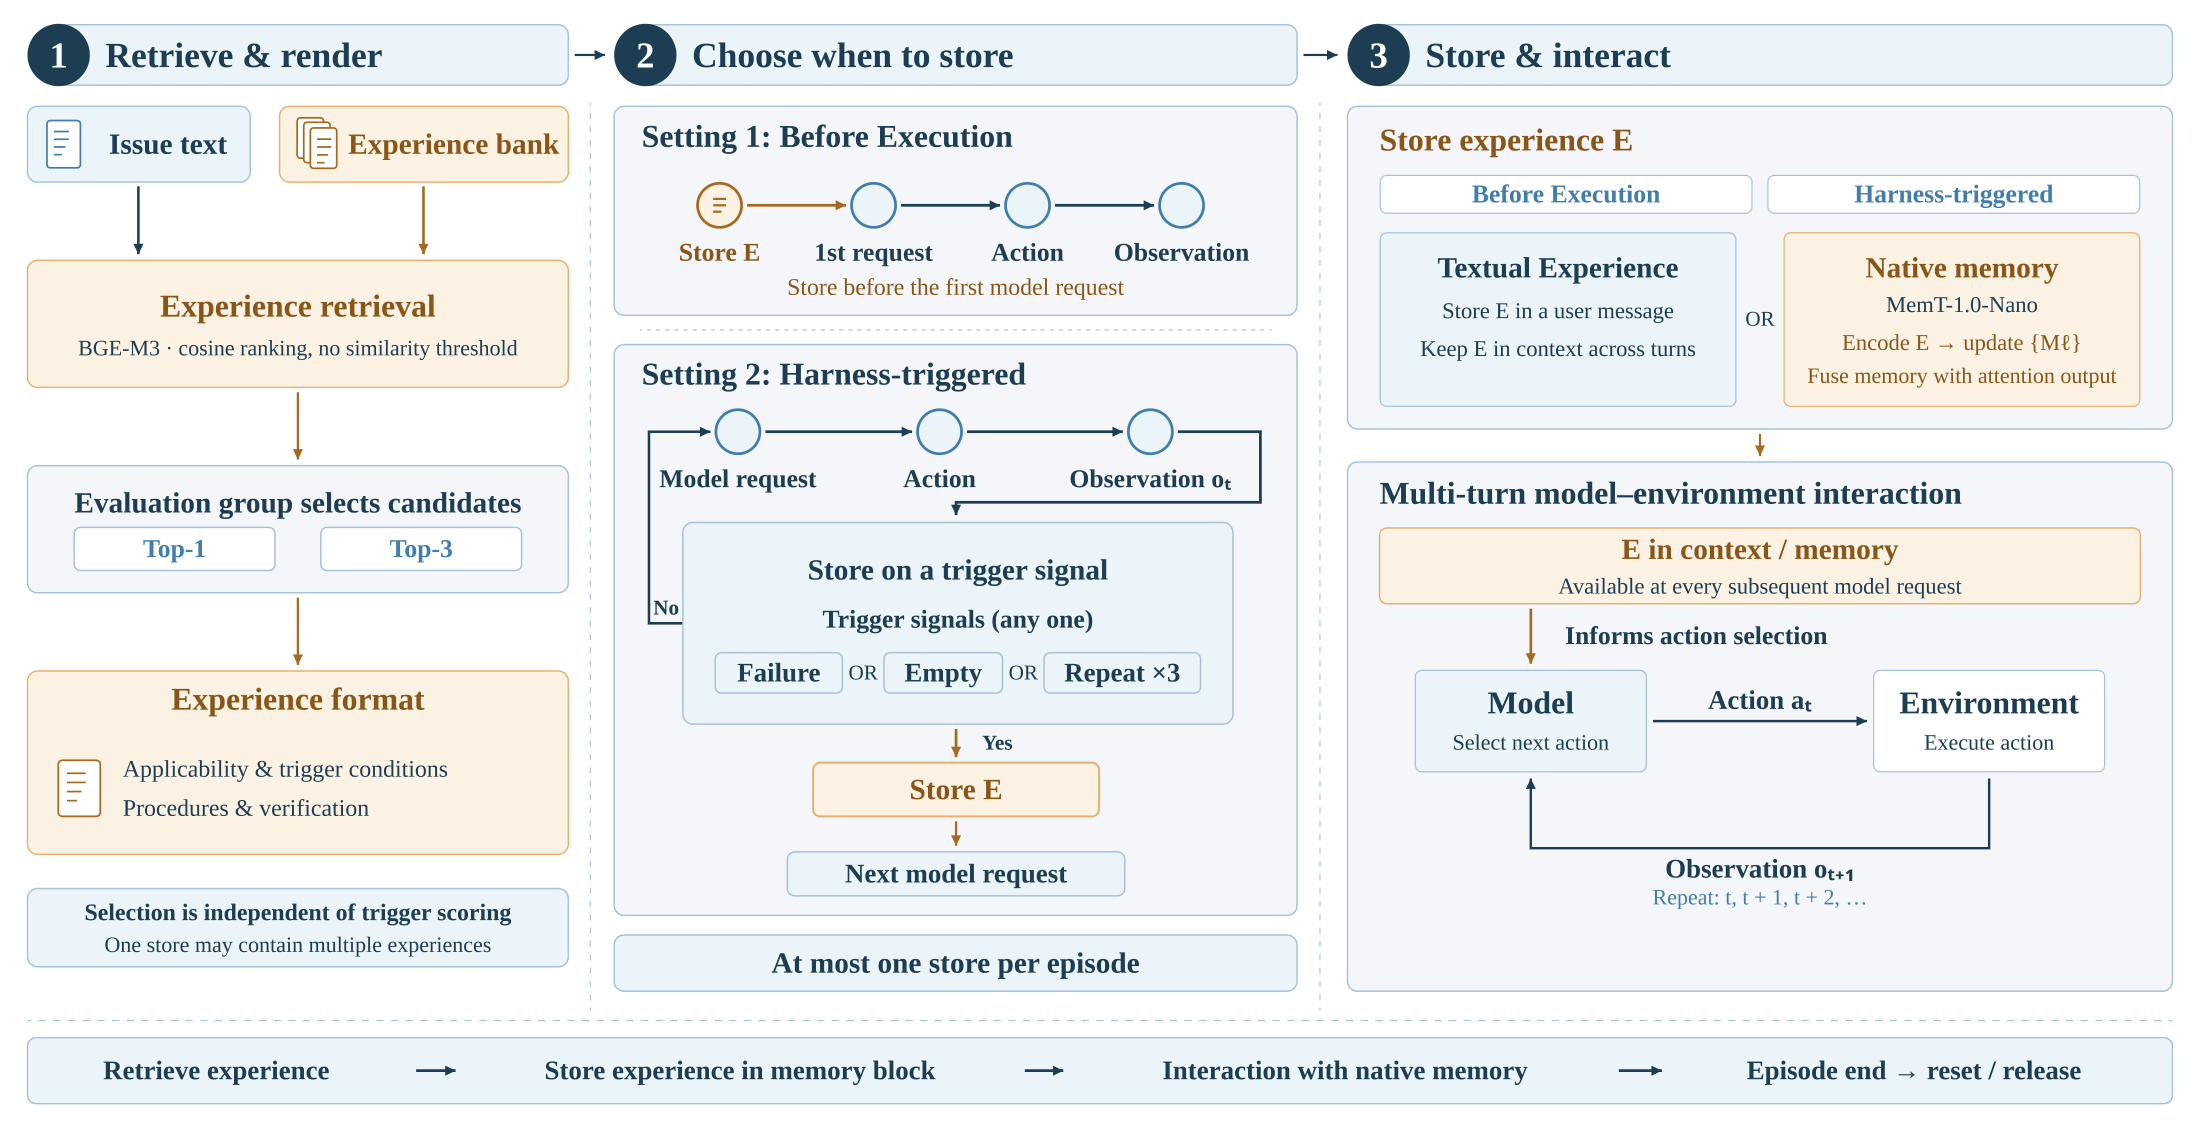
原图 Fig. 11,PDF p. 27。 左侧是检索和选取经验,中间是执行前或触发式写入时机,右侧是文本与记忆两种供给方式。这里的“自演化”证据实际测量的是外部经验能否被记忆模型用来改善后续动作。
| 测试集与写入时机 | 方法 | 平均成功率 ↑ | 三次全成功 $\mathrm{pass}^{3}$ ↑ | 三次至少一次成功 $\mathrm{pass@3}$ ↑ |
|---|---|---|---|---|
| Verified,执行前 | 无经验 / 文本经验 / Nano | 66.07 / 68.87 / 69.33 | 54.00 / 61.60 / 61.60 | 77.60 / 76.40 / 77.40 |
| Verified,触发式 | 无经验 / 文本经验 / Nano | 66.07 / 69.13 / 69.73 | 54.00 / 61.80 / 62.80 | 77.60 / 76.80 / 77.80 |
| Multilingual,执行前 | 无经验 / 文本经验 / Nano | 60.00 / 64.22 / 62.89 | 45.33 / 56.33 / 53.67 | 73.67 / 72.67 / 72.00 |
| Multilingual,触发式 | 无经验 / 文本经验 / Nano | 60.00 / 63.00 / 63.56 | 45.33 / 53.67 / 55.33 | 73.67 / 72.67 / 73.00 |
Table 5,PDF p. 29。 Verified 500 题、Multilingual 300 题;每题独立运行三次。文本经验在 Verified 执行前用 Top-3,其他格用 Top-1,因此对应格不是完全相同数量文本的对照。最稳健的现象是相对无经验基线,Nano 的平均成功率与三次全成功率普遍提高;$\mathrm{pass@3}$ 没有同样一致的增长。Multilingual 执行前文本经验仍优于 Nano,不能概括为所有设置都超越文本经验。(Sec. 7.4,PDF pp. 28–29)
附录解释上的一个重要问题。 主文 Sec. 7.3 把应用训练描述为 MemT-1.0-Nano 的超记忆后训练;附录 E.2 的“Trainable Parameters and Memory Operations”却明确写的是 Metis:其 token selector、$512\times512$ 状态、104,962,580 个参数与附录 B 的 Nano 配置不同。附录 E.3 也明确另列 Metis 配置和 MemT 对照。因此 E.2 的这些结构数字和部分训练诊断不可直接当作 MemT-1.0-Nano 的实现细节;应用训练的部分具体口径需作者澄清。(Sec. 7.3,PDF p. 28;Appendix B,PDF p. 35;Appendix E.2–E.3,PDF pp. 56–60)
五:结论
MemT-1.0 给出了一套明确的跨轮记忆机制:旧状态参与当前轮生成,当前轮结束再逐 token 写入,超记忆参数通过全文教师蒸馏学习如何压缩和利用历史。论文在固定状态大小、长历史成本和参数化记忆平均成绩上给出了积极证据,代理实验表明程序经验也能经由记忆状态影响多步行动。(Secs. 2–7,PDF pp. 6–30)
实际取舍集中在容量与保真度:一条轨迹的存储大小固定,长历史细节可能在后续更新中被覆盖;文本记忆系统在精确长程回忆上仍领先。系统收益还取决于历史长度、准备成本、并发和状态复用次数。后续值得检验的是如何选择保留的信息、扩容后能否改善精确召回,以及能否把线上局部记忆持续巩固到共享的超记忆参数;本文没有将这些展望当作已完成结果。(Sec. 8–9,PDF pp. 30–31)