Scaling Parameter-Efficient Fine-Tuning for Brain Encoding:中文精读笔记
作者:Zhuofan Josh Ying、Guanglong Sun、Nolan Ho、Kieran Liu、Rui Yang、Andrew Chen、Nikolaus Kriegeskorte、Pony Ma、Hossein Adeli。PDF 首页将第一作者简写为 Josh Ying。
论文:arXiv:2610.26802v1,2026-10-19 提交;本次获取与研读日期:2026-10-28;本地原文 PDF。下文页码均从 PDF 首页起计数。
发表:未查到正式发表信息(截至 2026-10-28;arXiv 条目、第一作者主页均将其列为 arXiv 论文)。
代码:作者官方 BrainLoRA 实现,仓库 README 指向本论文,并含训练脚本与模型源码。
论文总览
一句话:在自然电影的全脑 fMRI 预测中,作者让有限神经数据只更新大型多模态骨干的低秩适配器,再用单次因果前向与轻量读出器控制计算成本;由此得到比冻结骨干加大型读出器更好的预测,并能把模型扩展成多适配器集成。
典型脑编码(brain encoding)系统把预训练骨干冻结,只训练从其特征到神经反应的读出器。BrainLoRA 把神经监督引入骨干,同时避免全参数微调:在 Qwen3-Omni 的前 32 层注意力投影上训练 8.91M 参数的 LoRA,配合 52.3M 参数的线性读出器,或只多约 0.2M 参数的交叉注意力读出器。149 秒窗口加 60 秒先导上下文可在一次因果前向中产生所有时间点的特征。其单模型在 Algonauts 2025 的 Friends 第 7 季/OOD 电影上达到 Pearson $r=0.327/0.228$,高于原文引用的 MIRAGE 单模型 $0.310/0.217$;261 模型集成达到 $0.343/0.248$。这些排名是作者在 2026 年 10 月论文撰写时对公开挑战榜的描述,而不是该论文已在会议发表的意思。(Sec. 4–5,PDF pp. 4–10,Table 1)
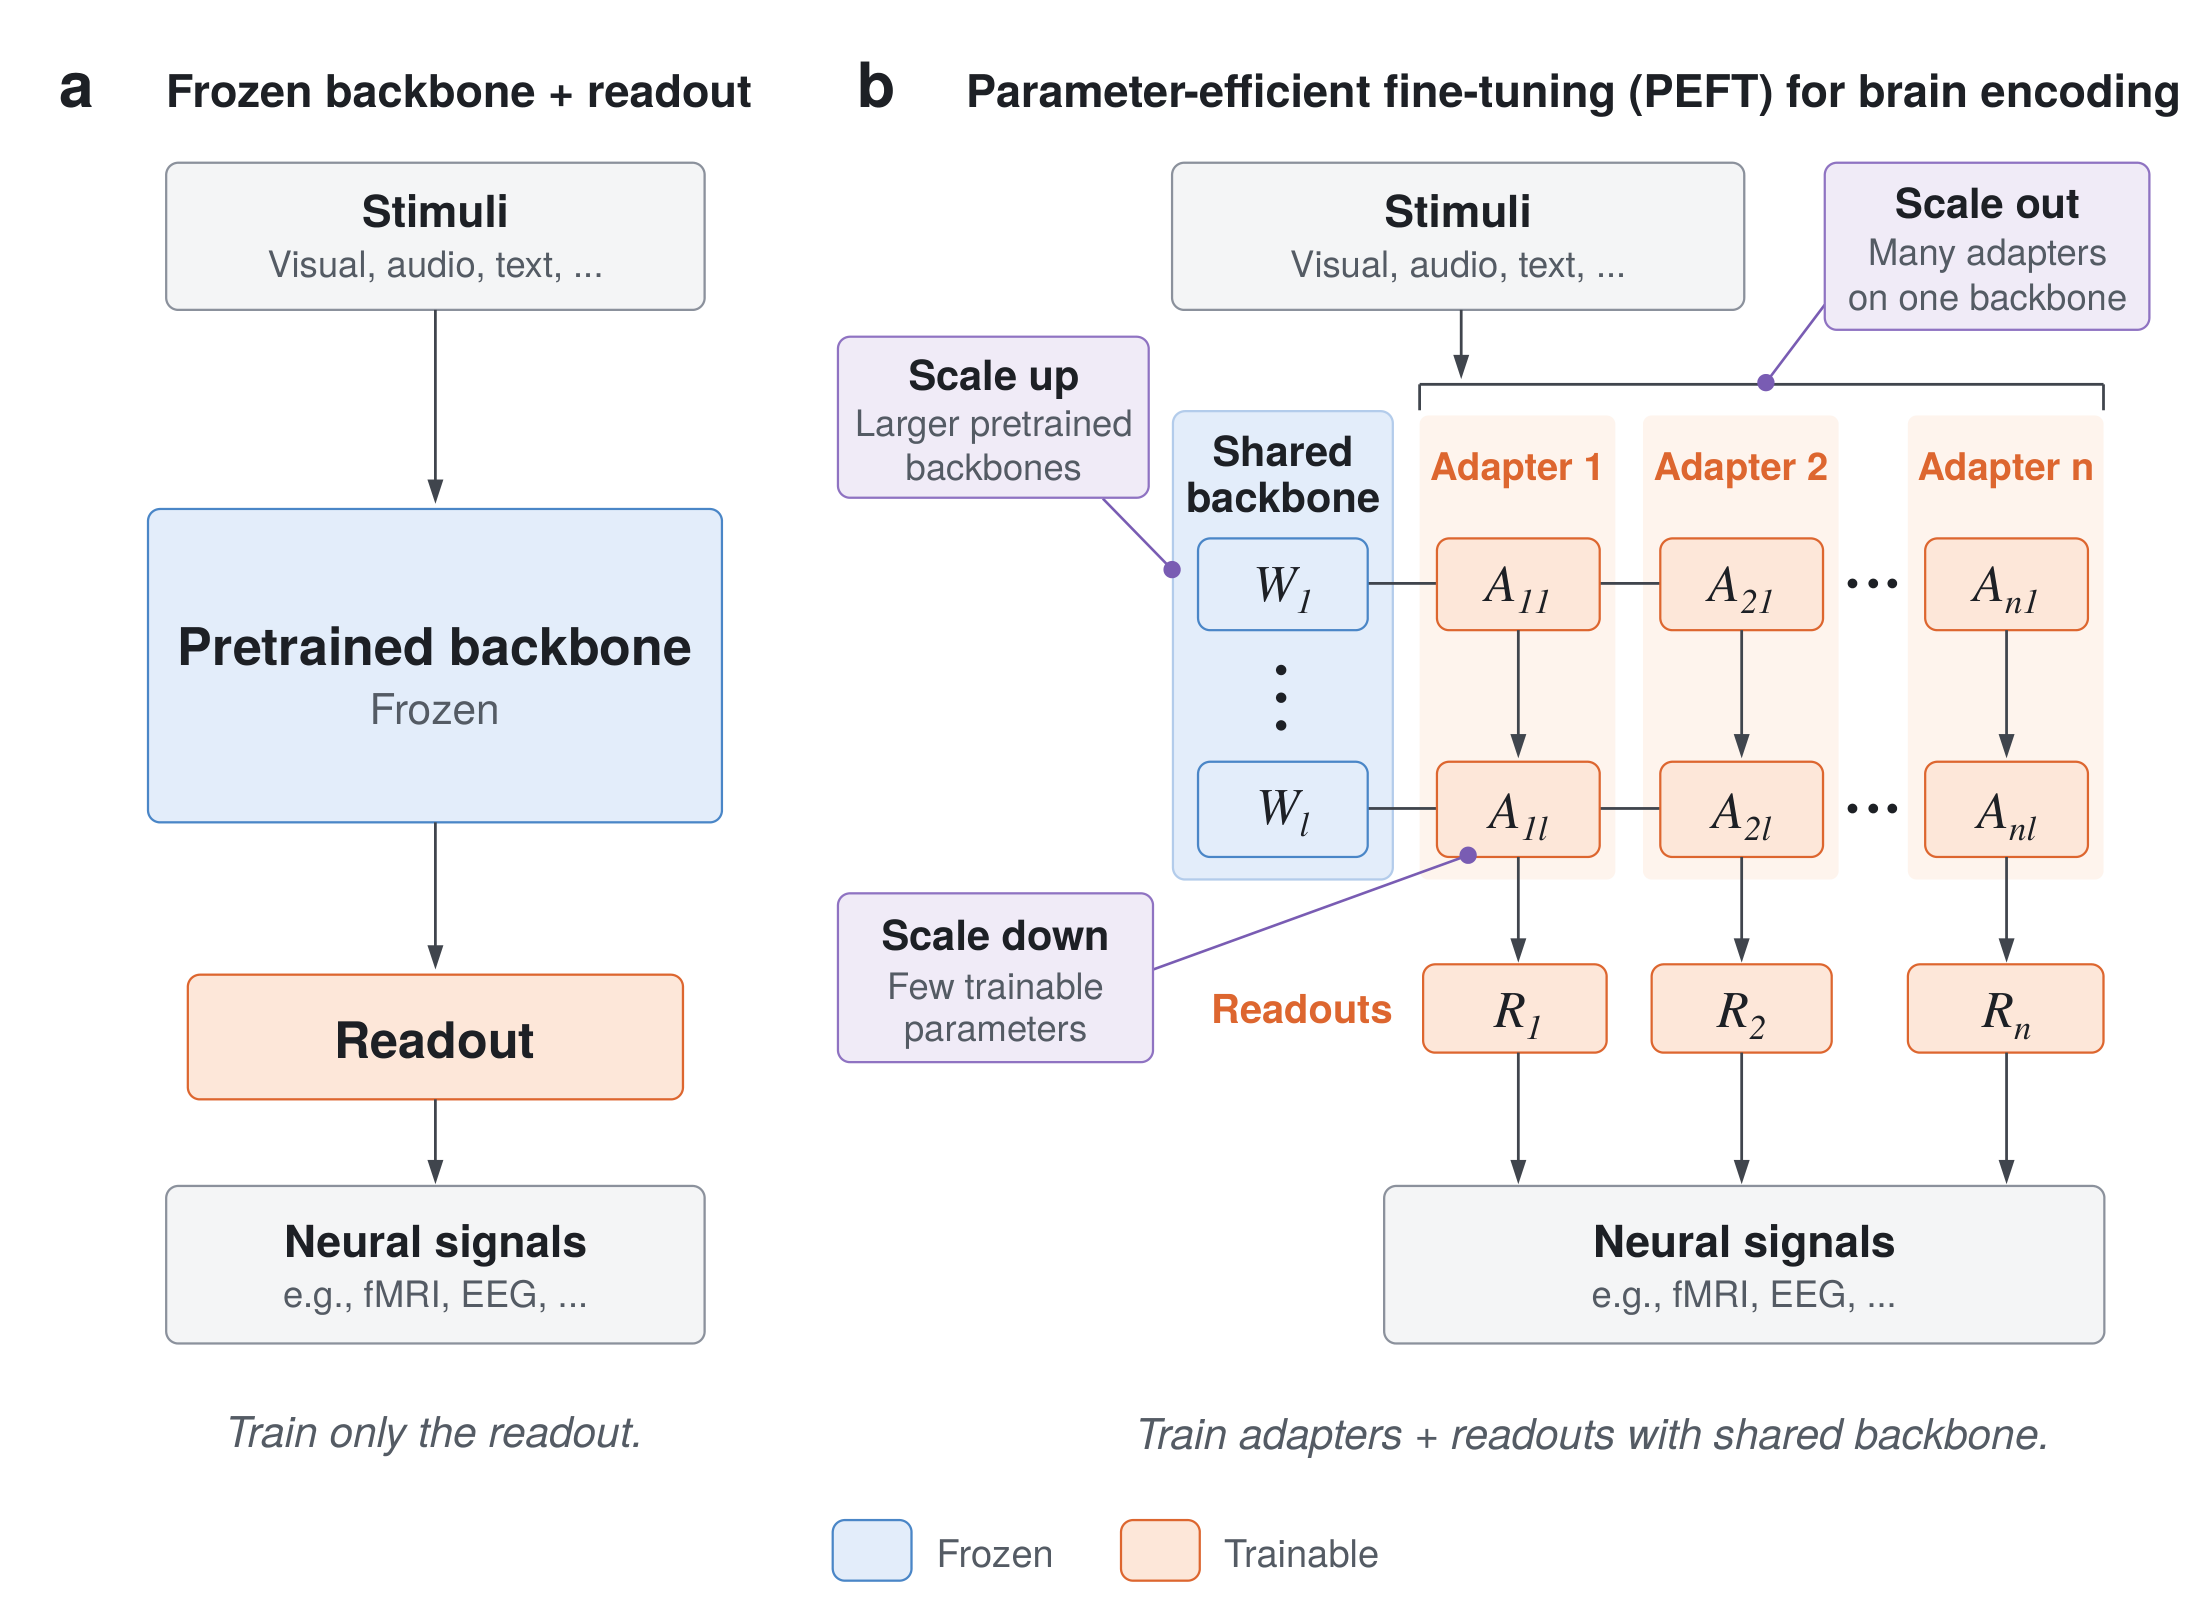
原文 Fig. 1,PDF p. 2。右图把“扩大预训练先验、缩小每次更新、增加专门化适配器数量”画成三个可组合方向;本论文分别以大骨干、LoRA 和集成验证它们。
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 冻结骨干的局限、PEFT 假设与三条扩展轴 | pp. 1–2,Fig. 1 p. 2 |
| 2 Related work | 按神经信号进入模型的位置组织既有方法 | p. 3 |
| 3 Preliminaries | 定义冻结、PEFT、全参数训练的可优化空间 | p. 4,Eqs. (1)–(2) |
| 4 Method | 数据、单次因果提取、LoRA、读出与闭式重拟合 | pp. 4–5,Fig. 2 p. 5 |
| 5 Experiments | 九骨干、同骨干对照、消融、归因、多模型集成 | pp. 5–10,Table 1 p. 6、Table 2 p. 7、Figs. 3–5 pp. 5/8/9 |
| 6 Discussion | 三条扩展轴、基础模型展望与实验范围 | p. 10 |
| Appendices B–D, F | 输入设计、计算量、核验因果前向、选模协议 | pp. 16–21,Tables 3–5 |
| Appendices H–Q | 其他 PEFT、九骨干、负对照、跨人/跨数据集迁移、区域与模态归因 | pp. 24–35,Tables 11–17、Figs. 10–13 |
| Appendices R–S | 集成残差与复现细节 | pp. 35–38,Tables 18–20 |
一:动机——为何让少量神经数据进入骨干
预训练多模态模型提供视觉、听觉和文本的强先验,但固定特征后,脑数据只能调末端映射。增大读出器未必等价于改进骨干表示:MIRAGE 使用同一 Qwen3-Omni 骨干及约 1.1B 参数读出器。另一方面,全量更新数十亿参数面对有限 fMRI 数据,计算和统计成本都高。作者提出中间方案:保留预训练权重,只让低维 $\psi$ 对骨干做受限更新。(Sec. 1–3,PDF pp. 1–4)
原文将刺激 $X$、神经反应 $Y$、骨干 $f_\theta$ 和读出器 $g_\phi$ 统一写为
读出器同时负责把刺激表征对齐到 fMRI 的采样时间。三种参数空间是
因此核心比较是:同一预训练先验与神经数据下,允许骨干做一个小维度、可学习的更新,是否比把预算只给读出器更有效。原文还把这一思路拆成 scale up(更强的预训练骨干)、scale down(更少的适配参数)和 scale out(共享骨干上的多个适配器);这三项是方法设计方向,不是式 (2) 推出的性能定理。(Sec. 3,PDF p. 4)
二:方法——从电影片段到 1,000 个脑区
2.1 数据流与时间对齐
Algonauts 2025/CNeuroMod 数据含 4 名受试者观看《Friends》及电影时的全脑 fMRI,目标被划为 1,000 个 Schaefer parcel。训练使用《Friends》前五季及 movie10 的有效窗口;第 6 季用于选模型和验证;保留的第 7 季是分布内(ID)测试,另一些电影是分布外(OOD)测试。主要指标是每个脑区的时间序列 Pearson 相关,再对脑区与四人汇总;越大越好。第 6 季的验证分数不能与附录 Fig. 6 的“单时间点、跨 1,000 脑区的空间相关”混为一谈。(Sec. 4–5,PDF pp. 4–5;App. B、E,pp. 16–20)
原 MIRAGE 特征协议在每个时间截点重新编码重叠滑窗,约每片 2,758 次前向。Qwen3-Omni 的解码器有因果掩码,作者于是把 149 秒训练窗口(100 个 TR,每 TR 1.49 秒)连同前置 60 秒上下文一起输入,一次前向输出各时间点的视觉、听觉、文本表征。特征以 2 Hz 时间栅格取样,读出器再引入固定的 4.47 秒血流动力学位移。视觉和音频的前端编码器在局部块内双向处理,严格的“截至时间 $t$ 不见未来”只近似成立;附录 F 的前缀重编码实验认为主要状态差异来自长度相关的 bf16/MoE 数值效应,局部前瞻范围至多为音频块的 8 秒。(Sec. 4,PDF pp. 4–5;App. F,p. 21)
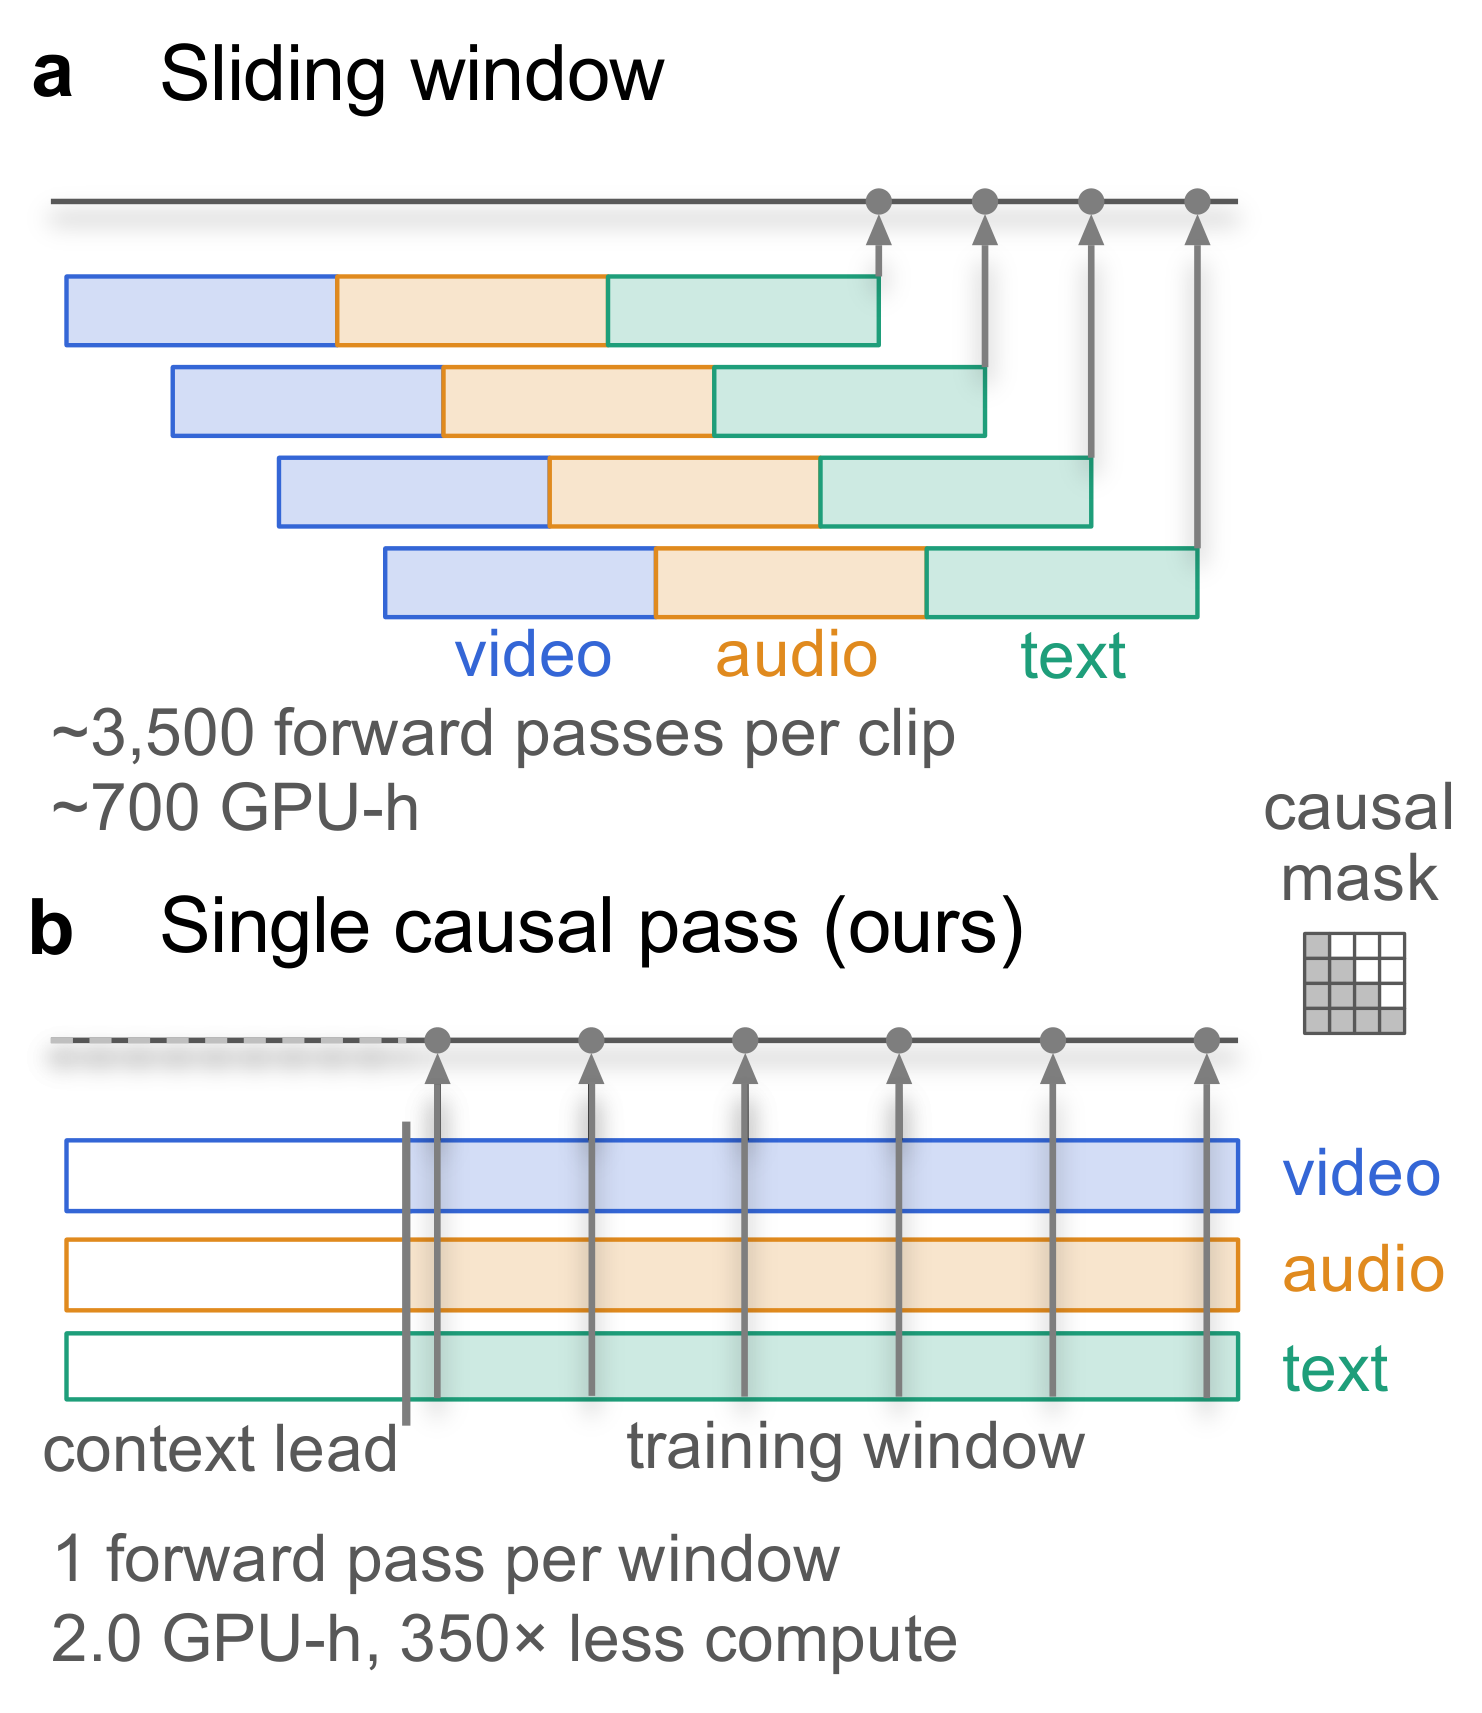
原文 Fig. 2,PDF p. 5。上半部重复编码重叠上下文;下半部每个窗口一次前向,灰色箭头对应多个预测时间点。
2.2 骨干适配与轻量读出
主实验取 Qwen3-Omni 解码器第 32/48 层的特征,并在该层截断计算。rank 16、$\alpha=32$ 的 LoRA 插入前 32 层自注意力的 $q/k/v/o$ 投影,新增 8.91M 可训练参数;视觉和音频塔保持冻结。按标准 LoRA 记法,单个被适配的权重可教学式地写作 $W'=W_0+(\alpha/r)BA$,其中 $BA$ 的秩不超过 $r$;原文 Eq. (2) 给的是更一般的 $\Delta(\psi)$ 表述。(Sec. 4,PDF p. 5;App. S,p. 36)
线性读出器先把每个模态、每个 0.5 秒的 2048 维向量投影至 512 维,再按 8 个对数间隔时间滞后块汇总;每 TR 得到 $8\times3\times512=12{,}288$ 维特征,最后由各受试者的线性映射预测 1,000 个 parcel。8 个滞后块覆盖约 0.5–192.5 秒,越远的历史块越宽。这个路径有 52.3M 参数。交叉注意力版本保留每 TR 的查询,从约 3,200 个音频/视频/文本 token 中选择信息,替换固定滞后平均,只多约 0.2M 参数;原始序列约 19,300 个 token,单纯把所有视觉 patch 都放进去未见收益。交叉注意力的增益主要来自更丰富的 token 集合,而非在同一 894 个池化向量上换用注意力。(Sec. 4–5,PDF pp. 5–7;App. K、S,pp. 27、37)
LoRA 与读出器联合优化一个 epoch,即 1,429 个训练窗口、每步一个窗口。随后固定适配后的骨干,再遍历训练特征,按脑区用岭回归闭式重解最终线性映射 $W$;惩罚系数在训练窗口内部的留出集选,验证第 6 季不参与该求解。可把每个脑区的解理解成 $\hat w_p=(X^\top X+\lambda_p I)^{-1}X^\top y_p$,此式是读者理解重拟合的简化写法。重拟合提升主线性模型的验证 $r$ 约 0.0061;附录指出主要收益来自重解 $W$,而不是每脑区单独选 $\lambda_p$。(Sec. 4–5,PDF pp. 5–7;App. D、S,pp. 18–19、37)
2.3 计算代价为何降下来
| 同一 331 片语料、单张 A800-80GB | MIRAGE 式冻结骨干+大型读出 | 单次因果前向+LoRA+线性读出 |
|---|---|---|
| 特征提取 | 约 701 GPU·h | 1.99 GPU·h |
| 训练/闭式重拟合 | 约 1.88 / 无 | 4.84 / 1.67 GPU·h |
| 端到端合计 | 约 702 GPU·h | 8.5 GPU·h |
| 可训练参数 | 约 1,123M | 61.2M |
提取成本约降 352 倍,而端到端约降 83 倍;后者包含 LoRA 反向传播及重拟合。前向次数下降约 545 倍,但新协议每次处理的序列更长。作者在自己的硬件上测量滑窗提取,并用 49 个验证片段外推至 331 片;两协议处理的上下文并不完全相同,因此这些倍数是所比较协议的成本比,不是同一数值结果的两个等价实现。(App. C,PDF pp. 17–18,Table 4)
三:实验设计——每一组比较在问什么
九骨干实验固定 rank 16 LoRA、60 秒上下文、闭式重拟合与相应层特征,比较每个骨干冻结和适配后的第 6 季 $r$;九个模型覆盖 4.7B–104.3B 总参数,层位置按各骨干选定。因此它检验“这种训练方式在不同预训练骨干上是否都有效”,不直接证明参数量越大越准。(Sec. 5.1,PDF p. 5;App. I,p. 25)
同骨干主对照都以 Qwen3-Omni 为基础,分别比较冻结、LoRA、全参数微调,以及线性/交叉注意力读出;MIRAGE、TRIBE 等行是原论文引用的对方作者数字,ID/OOD 则来自挑战服务器。作者只用第 6 季选择超参数、模型成员及集成权重;论文称榜单分数未用于这些选择。单模型表格各行是一次训练;LoRA+线性的 15 个种子均值 $0.32609\pm0.00024$,作者认为差小于约 0.00077 的行不能仅凭表格区分。(Sec. 5.2,PDF p. 6,Table 1;App. D,pp. 18–19)
消融与负对照分离适配器、重拟合、读出器和输入设计的作用。错位目标对照保留真实 fMRI 的时间相关等统计量,只打乱刺激与反应的配对;其最终读出仍在对齐数据上重拟合,从而检验有用更新是否依赖刺激配对。(Sec. 5.3,PDF p. 7,Table 2;App. L,pp. 27–28)
归因与扩展先用三模态 Shapley 分解检查预测对哪种内容敏感,再以融合训练 kernel 和 261 模型池分析计算与集成质量。这些实验分别回答“适配后利用了什么信息”和“增加适配器数量还有多少收益”。(Sec. 5.4–5.5,PDF pp. 7–10)
四:结果——改进来自哪里
4.1 九骨干均提升,但尺寸并不决定脑预测分数
| 多模态骨干 | 总参数 | 冻结 $r$ | LoRA+线性 $r$ | 增益 |
|---|---|---|---|---|
| Phi-4-MM | 4.7B | 0.2521 | 0.2841 | +0.0320 |
| Qwen2.5-Omni 3B | 6.0B | 0.2807 | 0.3139 | +0.0331 |
| Gemma 3n E4B | 7.8B | 0.2631 | 0.3026 | +0.0395 |
| LCO-Omni 7B | 8.9B | 0.2683 | 0.3199 | +0.0517 |
| MiniCPM-o | 9.4B | 0.2594 | 0.3249 | +0.0655 |
| Qwen2.5-Omni 7B | 11.2B | 0.2748 | 0.3178 | +0.0431 |
| Qwen3-Omni 30B | 31.7B | 0.2907 | 0.3263 | +0.0356 |
| Nemotron Omni | 33.0B | 0.2780 | 0.3227 | +0.0447 |
| Ming-flash 104B | 104.3B | 0.2856 | 0.3227 | +0.0371 |
九个增益均为第 6 季、四人均值 Pearson $r$ 的绝对差值;对应的交叉注意力通常再多约 0.003。最大的骨干并非最好的骨干,作者报告参数量与分数相关仅为冻结时 $r=0.71$、适配后 $r=0.60$。Qwen3-Omni 的优势还在于与 MIRAGE 共用骨干,方便比较训练策略。(Sec. 5.1,PDF p. 5,Fig. 3;App. I,p. 25,Table 12)
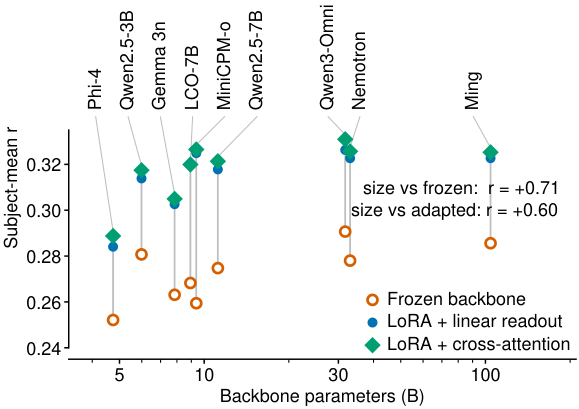
原文 Fig. 3,PDF p. 5。横轴是骨干总参数量,纵轴是验证集四人平均 $r$;同一模型的空心点到实心点表示适配带来的增益。
4.2 同骨干对照:小适配器比大读出器更有效
| 方法 | 可训练参数 | 验证 s06 | ID s07 | OOD 电影 |
|---|---|---|---|---|
| MIRAGE 单模型(引用原作者) | 1.1B | 0.319 | 0.310 | 0.217 |
| 冻结+线性读出 | 52.3M | 0.291 | 0.287 | 0.187 |
| LoRA+线性读出 | 61.2M | 0.326 | 0.322 | 0.222 |
| 全参数微调+线性读出 | 20.3B | 0.323 | 0.320 | 0.217 |
| 冻结+交叉注意力 | 52.5M | 0.312 | 0.307 | 0.212 |
| BrainLoRA:LoRA+交叉注意力 | 61.4M | 0.331 | 0.327 | 0.228 |
| 全参数微调+交叉注意力 | 20.3B | 0.330 | 0.326 | 0.225 |
LoRA+线性读出已经在 ID 与 OOD 超过 MIRAGE 单模型,参数量约为后者的 $61.2/1123\approx5.4\%$;交叉注意力再把 ID/OOD 提至 0.327/0.228。与 MIRAGE 的 15 模型集成(0.323/0.227)相比,该 BrainLoRA 单模型在 ID 更高、OOD 基本相当。全参数微调在这里没有超过 LoRA,尤其在 OOD;这个结论限定于该训练数据量与所选学习率协议。(Sec. 5.2,PDF p. 6,Table 1)
消融把增益分得更清楚:冻结+线性为 0.2907;加 rank-16 LoRA 后为 0.3263,绝对增益 +0.0356;去掉闭式重拟合为 0.3202,说明重拟合本身提供 +0.0061。把 rank 16 升到 32 仅为 0.3268,差 0.0005,落在作者的种子波动阈值内。交叉注意力为 0.3310,但在相同 894 个池化特征上使用它几乎无增益,因此关键是输入 token 更细。(Sec. 5.3,PDF p. 7,Table 2;App. K,p. 27)
错位训练的 LoRA 在对齐训练数据上重拟合读出后只有 0.1874,低于对应的错位冻结对照 0.2617,也低于正确对齐的冻结对照 0.2907;对齐 LoRA 则为 0.3263。该负对照支持“有效适配依赖刺激—脑反应配对”,而不是仅靠 fMRI 的边际统计量。(App. L,PDF p. 28,Table 13)
输入设计也有可量化取舍:冻结 MIRAGE 读出下,原分辨率滑窗 0.3187,整片单次前向 0.3149;窗口化无上下文为 0.3091,加入 30 秒先导后为 0.3124。对可共同训练的 LoRA+线性读出,先导 0、30、60、90、120 秒并重拟合的分数依次是 0.3206、0.3249、0.3263、0.3260、0.3263,60 秒后基本饱和。注意滑窗的 0.3187 来自冻结 MIRAGE 头,0.3263 则来自不同的适配骨干与线性头;它们证明的是整套系统可在更低成本下更准,而非“单次前向生成与滑窗完全相同的特征”。(App. B,PDF p. 16,Table 3)
4.3 跨人和跨数据集迁移
留一人实验中,适配器只在另外三人上训练,第四人的读出器在其训练数据上闭式求解。四个被留出者相对冻结骨干仍提高 +0.0301 至 +0.0355,约保留四人共同训练时 97% 的增益。此处要区分:适配器没有见过被留者的 fMRI,但其个人读出器仍用了该人的训练数据。(App. M,PDF p. 29,Table 14)
NNDb 测试更换扫描站点、受试者、预处理与 TR,仍是自然电影。把 Algonauts 的 LoRA 和四人平均读出器不再训练直接迁入 NNDb,20 名受试者的平均 $r$ 从 0.0991 到 0.1223,绝对增益 +0.0232;按各数据集独立估计的噪声上限归一化,相当于 +11.1 个百分点,与 Algonauts 验证集的 +10.7 个百分点相近。在 NNDb 上重新拟合个人读出器的增益则是 +15.4 个噪声上限百分点,但这是另一种评估设置。归一化只在上限可估的 NNDb 816 个脑区上进行,原始 $r$ 则是 1,000 脑区均值。(App. N,PDF p. 30,Table 15)
少样本个人校准进一步表明,先用其他受试者读出器均值作为锚点,再对新人的残差做岭回归,优于从零开始解读出器;在 Algonauts 留一人设置,20 分钟数据的验证 $r$ 为 0.2718,而从零拟合为 0.2273。适配器相对冻结骨干的优势在所测所有数据预算下都保留。(App. O,PDF p. 31,Table 16)
4.4 归因:多模态骨干学到什么
作者对视频、音频、文本三个输入流枚举全部 $2^3=8$ 种内容组合。缺失某模态时用训练集平均 embedding 替代,同时保留 token 数、位置与时间;计算预测的精确三人 Shapley 分解 $\phi_m$。因 Pearson $r$ 不是线性函数,论文再以 $\operatorname{cov}(\phi_m,y)/(\sigma_{\hat y}\sigma_y)$ 计每个模态的准确度贡献,这些贡献加上布局项后汇总为预测相关。另以 $\operatorname{cov}(\phi_m,\hat y)/\operatorname{var}(\hat y)$ 计预测构成份额,和为 1。图上的空间贡献与文中百分比份额因而不是同一统计量。(Sec. 5.4,PDF pp. 7–8;App. Q,pp. 33–34)
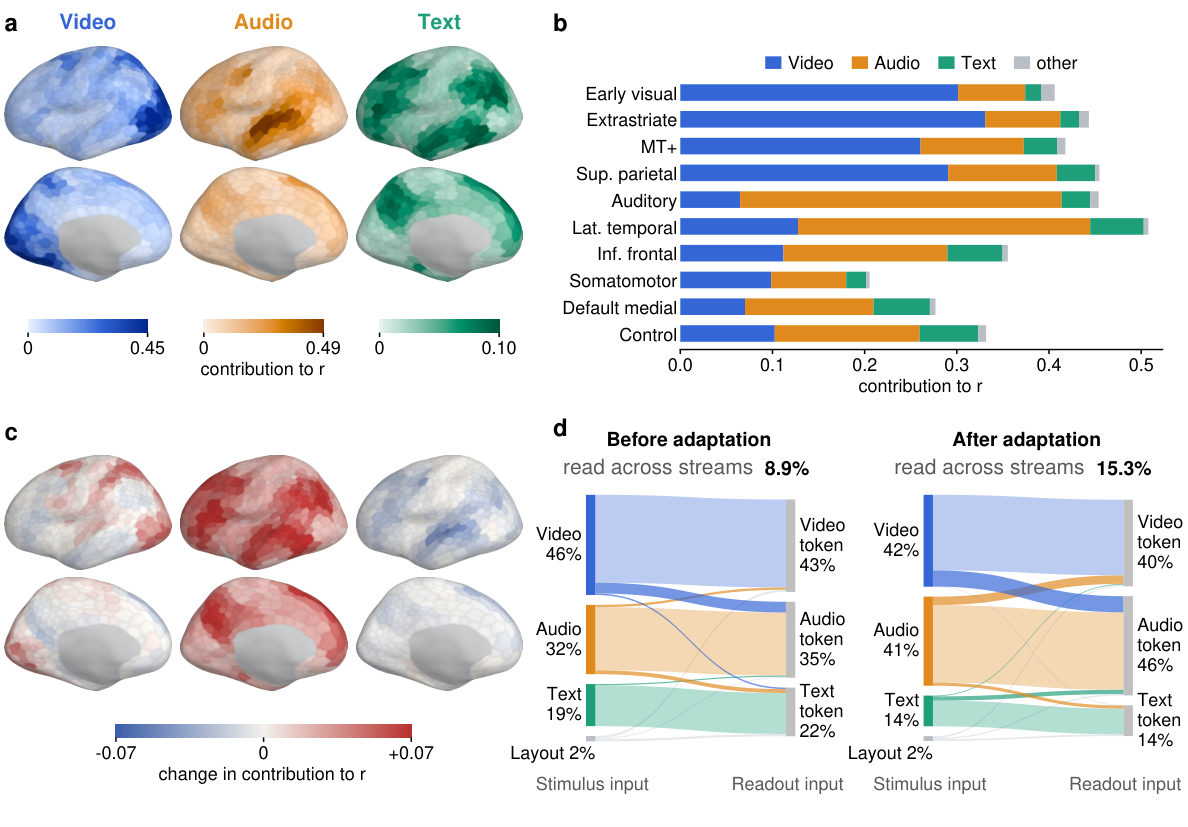
原文 Fig. 4,PDF p. 8。a/b:各脑区的内容贡献与区域条形图;c:适配前后贡献差;d:输入内容经不同模态的 token 位置抵达读出器的流向。颜色表示三种输入内容,跨线表示跨模态位置读取。
从预测份额看,早期视觉皮层由视频占 72.5%,听觉皮层由音频占 72.9%,外侧颞叶音频 60.3%、文本 12.5%,与已知的粗粒度感觉分工一致。适配后各脑区的模态图空间分布大体仍相似,但全脑平均音频贡献相对提高 39%、视频提高 5%、文本下降 17%;249 个脑区的主导模态转向音频。经另一模态 token 位置读出的预测份额由 8.9% 升到 15.3%,即增加 6.4 个百分点。这是在论文的内容移除基线下对模型依赖路径的描述,不能把 Shapley 份额直接解释为脑内信息流。(Sec. 5.4,PDF p. 8,Fig. 4;App. Q,pp. 33–35)
4.5 多适配器训练与集成
多 LoRA kernel 把不同样本路由到其适配器的低秩更新融合为一次分组 gather–矩阵乘,而非逐适配器独立启动。32 个 rank-16 适配器的训练步成本仅为单适配器的 1.08 倍,较串行跑 32 次快 29.8 倍;这是序列长度 128、单张 A800 上的小规模 kernel 基准,端到端提升会小于该倍数。作者明确指出算术 FLOPs 没有减少,提升来自 GPU 利用率。(Sec. 5.5,PDF p. 9,Fig. 5a;App. C,pp. 18–20,Fig. 8)
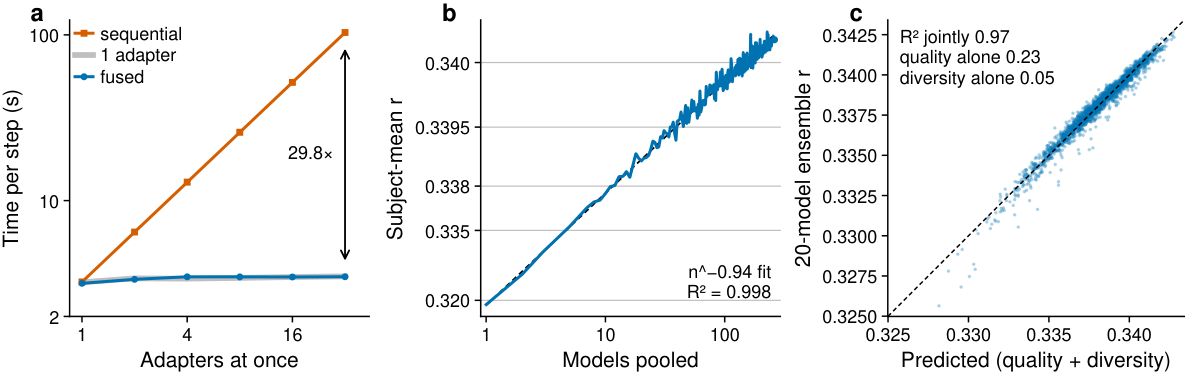
原文 Fig. 5,PDF p. 9。a 比较训练步时间;b 是随机子集平均准确度趋于上限的速度;c 是固定 20 模型时,成员质量和残差相关共同解释集成分数。
261 个模型的脑区级最小残差方差集成在验证/ID/OOD 上分别达 0.3483/0.3428/0.2483;挑出的 15 模型子集为 0.3465/0.341/0.247,大幅降低推理模型数。集成权重在第 6 季按 episode 分组做样本外拟合,避免同一集片段跨折。随机子集平均分数按 $m(n)=m_\infty-An^{-b}$ 拟合,$b\approx0.94$;这是向天花板收敛的经验曲线,并非分数随 $n$ 无界增长。不同读出结构和骨干比只换随机种子更能提供误差多样性。(Sec. 5.5,PDF pp. 9–10;App. D、G、J,pp. 18–19、22–27)
集成收益仍有限:附录 R 用跨受试者协方差分离可重复的刺激锁定信号,估计 261 模型均值还遗漏其 32.5%(95% 区间 30.0–35.3%)。这使“第 1 名”与“已解释所有可预测脑信号”成为两件不同的事;这部分残差是后续模型设计可针对的具体目标。(App. R,PDF pp. 35–36,Table 18)
五:结论与思考
论文最有说服力的链条是:在可比较的 Qwen3-Omni 骨干上,LoRA 的 +0.0356 验证增益大于仅改读出器或增加 rank 的效果;错位目标消融说明增益需要正确的刺激—反应监督;跨受试者与跨电影数据集实验表明更新不只记住训练四人;单次因果前向和融合训练使这种适配可以扩展到 104B 骨干与 261 个模型。(Secs. 4–6,PDF pp. 4–10;Apps. L–N,pp. 27–30)
具体适用域是 自然电影刺激、四人主训练基准、fMRI 脑区预测。NNDb 改变了人和采集条件,却仍在电影域;它没有验证论文展望中的跨任务、跨神经测量模态的共享脑基础模型。归因提供了可解释的模型依赖证据,尚不能独立推出脑区真实计算机制。作者提出的通用脑基础模型与“每任务、每脑区专门适配器”属于未来方向;目前直接展示的是单基准上的适配与集成。(Sec. 6,PDF p. 10)