DLite:面向 AI Agent 的无历史草稿推测解码——研读笔记
原题:DLite: History-free Speculative Decoding for Agentic AI
作者:Jiaming Xu、Hanzhen Wang、Tianlang Zhao、Jiewen Xiao、Chengze Yuan、Jiayi Pan、Yongkang Zhou、Jiancai Ye、Yu Wang、Guohao Dai
版本:arXiv:2610.23787v1,2026 年 10 月 16 日提交;本次研读:2026 年 10 月 25 日
原文:本地 PDF · arXiv 页面 · 作者代码
论文总览
推测解码(speculative decoding)用小草稿模型一次猜测多个 token,再由目标模型并行验证。Agent 请求常有长输入、短输出和频繁多轮调用;传统草稿模型既要理解不断增长的历史,又要保存、更新自己的历史 KV cache。论文测到某些现有草稿器在代理任务上的每轮输出长度降到约 1–2,且在一个 DeepSeek-V4 MTP/SGLang 设置中,草稿 KV 更新与维护占端到端推理延迟的 10%–20%。[Sec. 1、3.1,PDF pp. 2–4,Fig. 1]
DLite 的主意:让目标模型承担长历史建模。每一轮把目标模型的多层隐藏状态、当前锚点 token 和 $K$ 个待预测位置交给一个无历史 KV 的并行草稿主干;低秩顺序头只补上当前草稿块内部的因果依赖。训练时先向结构相近、但有历史 KV 的教师蒸馏,再直接对齐目标模型。目标模型自己的 KV cache 与最终验证仍保留,因此“无历史”只指草稿模型。[Sec. 4,PDF pp. 4–6,Fig. 3]
在作者报告的 Qwen3-4B/8B、H800 实验中,DLite 在 SWE-bench 上相对 DSpark 的解码加速分别为 $2.68\times$ 对 $1.64\times$、$2.74\times$ 对 $1.60\times$;后者约高 71%,对应摘要的“最高约 70%”。摘要中的“2–6”是每轮输出长度 $\tau$ 的量级,不是 $2$–$6\times$ 加速。[Sec. 5.2,PDF p. 8,Table 3]
结构地图
| 原文章节 | 作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | Agent 工作负载与两项瓶颈 | pp. 1–2,Fig. 1(p. 2) |
| 2 Background | 推测解码、三种草稿架构和蒸馏 | pp. 2–3,Eq. (1)、Fig. 2(p. 3) |
| 3 Motivation | 接受长度下降与草稿 KV 维护的共同原因 | pp. 3–4 |
| 4 DLite Framework | 无历史并行主干、低秩顺序头、两阶段训练 | pp. 4–6,Fig. 3–4、Eq. (2)–(7) |
| 5 Experiments | 常规、长上下文、代理、并发与消融 | pp. 7–9,Tables 1–4、Fig. 5 |
| 6 Conclusion | 方法总结 | pp. 9–10 |
| Appendix A.1/A.2 | 训练细节与架构选型 | pp. 12–14,Table 5(p. 13) |
一:动机——为什么草稿模型不该再保存完整历史
推测解码的一个验证轮次先由草稿模型 $M_D$ 提出 $N$ 个候选,再由目标模型 $M_T$ 一次验证。图 2(a) 展示了接受候选前缀、在首个拒绝位置由目标模型补出下一 token 的流程。论文用近似式概括加速来源:[Sec. 2.1,PDF p. 3,Eq. (1)]
$\tau$ 是每个验证轮次平均产出的 token 数;分子是逐 token 目标模型生成同样数量 token 的时间,分母含一次目标验证和草稿生成的时间。因而高接受长度与低草稿延迟都重要。实际系统还涉及状态更新、调度等开销,这个式子用于解释方向,不能直接从 $\tau$ 推出实测加速比。
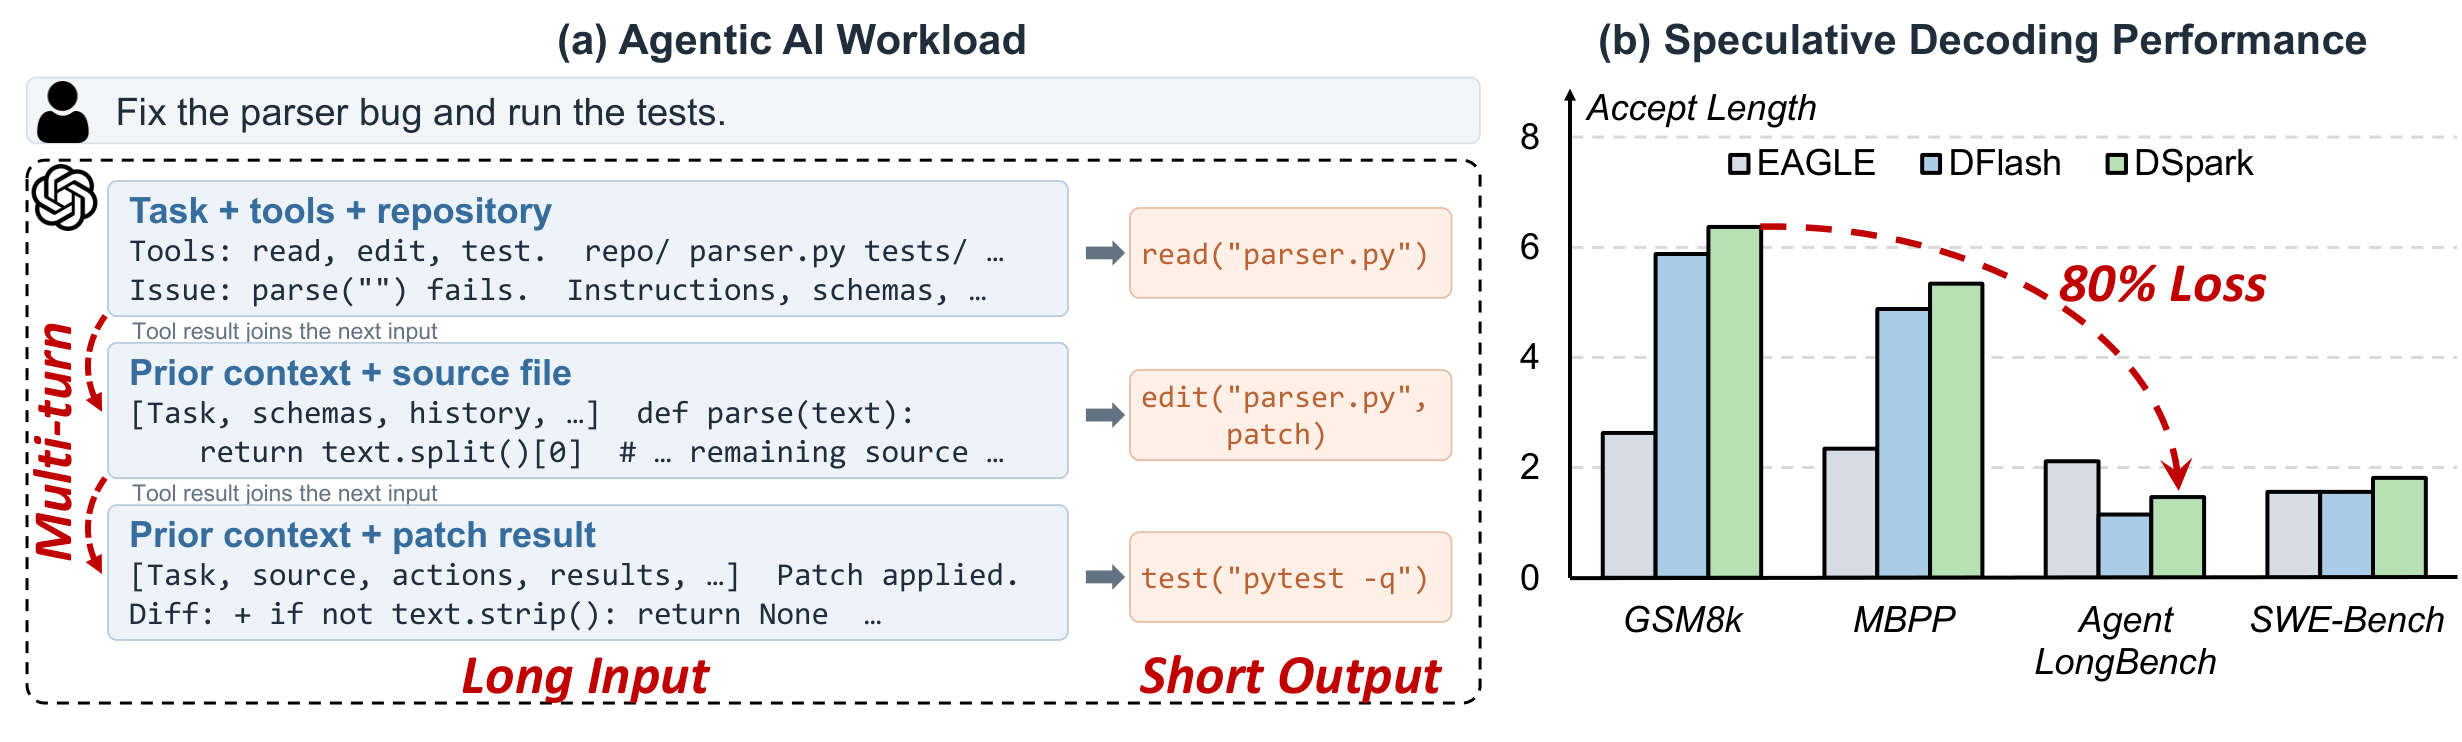
原文 Fig. 1,PDF p. 2。 左半边说明工具结果不断加入下一轮长输入、每轮模型输出却较短;右半边说明 EAGLE、DFlash、DSpark 在 GSM8K/MBPP 与 AgentLongBench/SWE-bench 上的接受长度差异。图中的“80% loss”是具体比较的近似概括,不宜当作所有基准、所有模型的统一跌幅。
论文将已有草稿器分成自回归(如 EAGLE-3)、并行(如 DFlash)和半自回归(如 DSpark)三类。它们在草稿延迟与块内依赖之间取舍,但都显式依赖草稿历史状态。作者的解释是:小模型独立重建长历史越来越困难,系统又必须在验证后把已接受 token 写回草稿 KV,并为多轮前缀复用保留历史。DLite 因而把“理解历史”交给已有目标模型,把草稿侧改成局部预测。[Sec. 2.1、3,PDF pp. 3–4,Fig. 2]
二:方法——目标隐藏状态 + 局部块 + 轻量因果修正
2.1 一轮推理的数据流
- 目标模型完成输入预填充,保存自己的 KV cache,并提供当前上下文的隐藏状态。
- 草稿主干接收来自目标模型多层的隐藏状态、当前锚点 token 和 $K$ 个 draft placeholder;以局部位置编号和双向注意力并行算出 $h_1,\ldots,h_K$。
- 顺序头依次读取前面已生成的草稿 token,在隐藏空间修正 $h_T$,再得到候选 token。
- 目标模型按标准推测解码规则验证候选;下一轮使用新的锚点和目标特征重建草稿输入。整个过程中没有需要跨轮延续的草稿历史 KV。[Sec. 4.1,PDF pp. 4–5,Fig. 3]
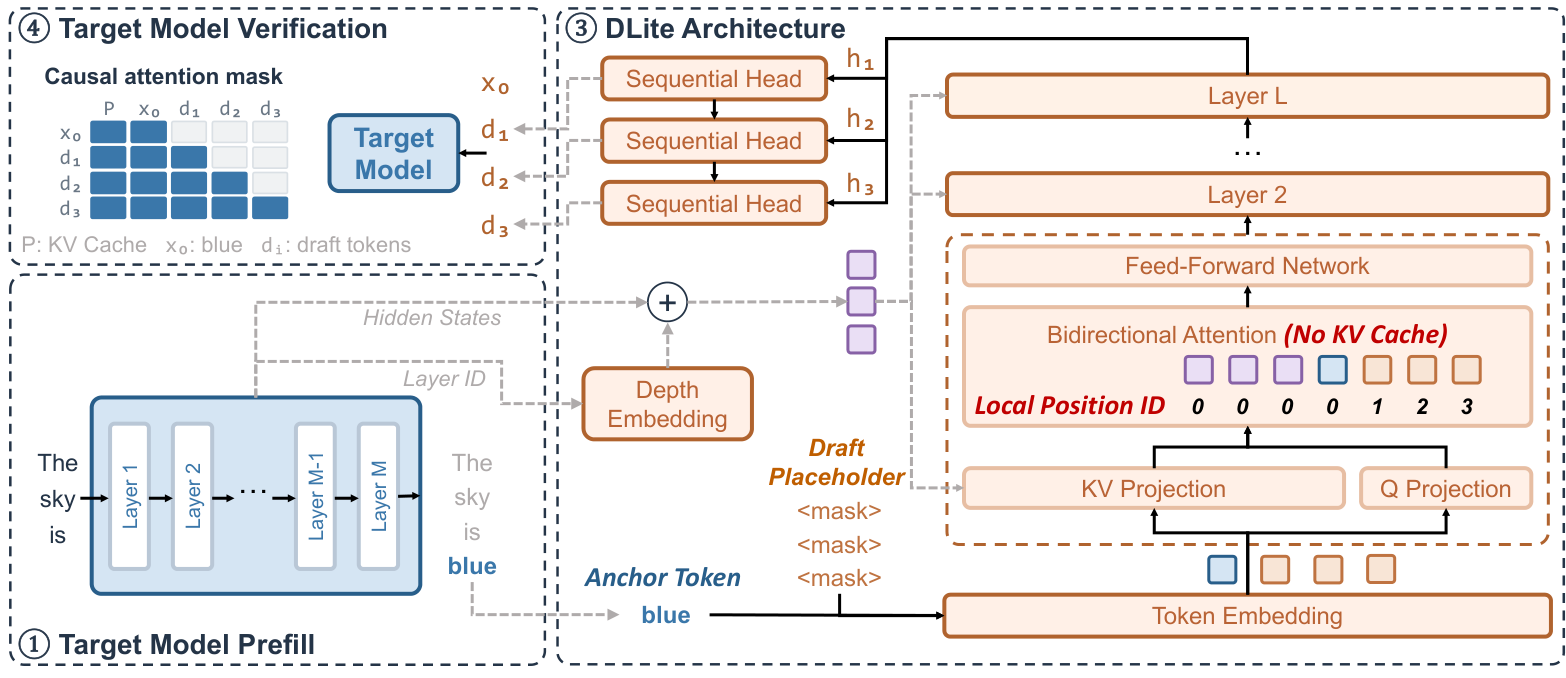
原文 Fig. 3,PDF p. 5。 右下的局部位置编号把目标特征和锚点放在当前位置附近,把占位符排为后续位置;图中蓝色目标模型仍保留标准 KV 与因果验证。这里的“固定局部上下文”指草稿端输入结构不随累计历史长度增长,目标端仍处理完整上下文。
2.2 并行主干如何接收历史信息
对目标模型第 $l$ 层在当前时刻的隐藏状态 $h_t^{(l)}$,DLite 加上可学习的来源嵌入:[Sec. 4.1.1,PDF p. 4,Eq. (2)]
$$z_t^{(l)}=h_t^{(l)}+e_{\mathrm{depth}}^{(l)}.$$$e_{\mathrm{depth}}^{(l)}$ 让主干区分不同目标层的特征,也区分这类特征与普通 token 嵌入。多层特征按序列维度拼接,即作为不同输入元素,而非先在特征维拼成一个长向量。主干并行处理这些上下文特征、锚点和占位符。锚点保存近期 token 的精确信息;局部位置编号每轮重置,让草稿端不必随着全局位置增长而改变预测结构。论文并未给出显式的信息无损压缩保证,效果由验证与实验衡量。[Sec. 4.1.1,PDF pp. 4–5;Appendix A.2,PDF p. 13]
2.3 顺序头只补当前块里缺失的条件
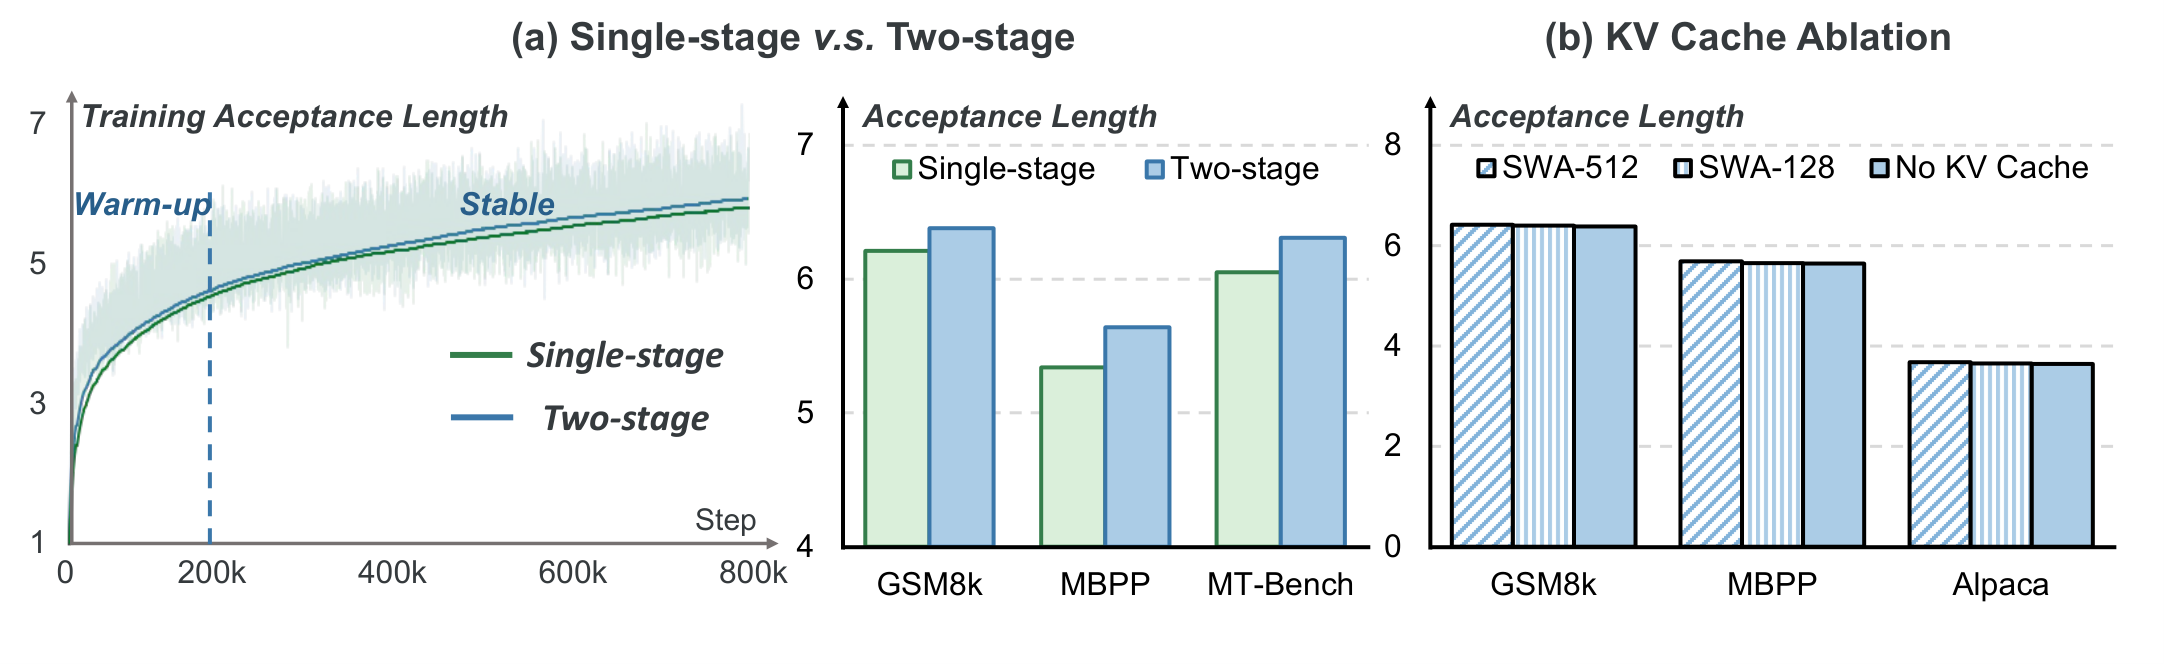
设 $t$ 是草稿块起点,$T$ 是块内偏移。目标模型的条件可拆为历史 $x_{ 并行主干在尚未采样前面的草稿 token 时就算出了 $h_T$;它通过目标特征获取历史信息,但缺少块内前缀。因此低秩 RNN 式顺序头递推 $E$ 是 token 嵌入;$s_T$ 只承载当前块已生成 token 的摘要,$h_T$ 承载由目标模型提供的上下文信息。与图 4(a) 所画的 DSpark 对比,DLite 先在隐藏空间融入块内依赖,随后才做词表投影,避开中间阶段对每个位置反复做 $D\times V$ 的词表映射($D$ 是隐藏维度,$V$ 是词表大小)。这解释了作者预期的并发草稿延迟优势。[Sec. 4.1.2,PDF pp. 5–6,Fig. 4(a)] 直接让并行、无历史的草稿器用目标模型分布做 KL 蒸馏,在图 4(b) 的设置中接受率较低;作者把困难归因于两者条件和结构差异。训练先构造同构但可访问历史 KV 的教师 $p_i^H$:教师先以 token 交叉熵训练,再用前向 KL 指导 DLite 分布 $q_i$:[Sec. 4.2,PDF p. 6,Eq. (6)] 位置越靠后权重越小,文中取 $\gamma=4$。稳定阶段移除教师,让 DLite 直接对齐目标分布 $p_i^T$,同时保留监督 token $y_i$ 的交叉熵:[Sec. 4.2,PDF p. 6,Eq. (7);Appendix A.1,PDF p. 12] 论文用“TV”称呼上述 $L_1$ 差异,公式没有标准总变差距离常见的 $1/2$ 系数;理解或复现时应按论文公式与其 $\lambda_{\mathrm{TV}}=1$ 的权重使用,$\lambda_{\mathrm{CE}}=0.1$。附录给出教师交叉熵 8 个 epoch、KL 热身 2 个 epoch、稳定阶段 6 个 epoch。教师只用于训练,推理时不用。[Appendix A.1,PDF p. 12] 目标模型为 Qwen3-4B 和 Qwen3-8B,服务实验在 NVIDIA H800 上进行。所有推测方法设置 $K=7$;DLite 的草稿主干为 5 层 Transformer,分别取 12/14 个目标层隐藏状态,顺序头秩分别为 320/512。训练使用 1.3M Open-PerfectBlend 与 600K Nemotron Post-Training Dataset V2 提示词,答案由对应目标模型重新生成;训练序列最长 4096 token。[Sec. 5.1,PDF p. 7;Appendix A.1,PDF p. 12] 对照包括无推测的自回归基线、EAGLE-3、DFlash、DFlash2、DSpark 和 DFlow;表 2–4 的重点对照为 EAGLE-3、DFlash、DSpark。论文说明 DFlash2 和 DFlow 的部分数字来自 RedHatAI 或原论文,因此表 1 的这两行并非全部由本文同一服务设置重新测得。[Sec. 5.1,PDF p. 7] 指标:$\tau$ 为平均每次目标验证产生的 token 数,越大越好;Speedup 是相对无推测自回归解码的速度比,$1\times$ 为持平;TPS 是给定并发数下的总 token 吞吐,越大越好。实验分常规数学/代码/对话、LongBench v2 的四类长上下文任务,以及四类代理任务。附录说明代理任务抽样:SWE-bench 50 个提示、AgentLongBench 50 个、AgentMemoryBench 共 180 个问题、BFCL 41 个会话且只汇总输入超过 32K token 的模型调用;BFCL 的工具执行时间不计入测速。[Sec. 5.1,PDF p. 7;Appendix A.2,PDF pp. 13–14] 来源:Sec. 5.2,PDF p. 7,Table 1;数值越大越好。 去掉草稿历史 KV 后,常规任务上没有观察到相对 DSpark 的质量损失。不过不能概括为“每项都领先所有方法”:Qwen3-4B 的 MT-Bench 上,DFlash2 的 4.14 高于 DLite 的 3.94。[Table 1] 来源:Sec. 5.2,PDF p. 8,Table 2。 四个 LongBench v2 子任务、两个目标模型上,DLite 都超过表中 DSpark 的 $\tau$ 与解码加速。以 4B 的代码仓库理解为例,$\tau$ 从 2.44 到 3.14,同时加速从 $2.02\times$ 到 $2.66\times$,与“目标特征承载长历史、草稿专注局部”的设计动机一致。 来源:Sec. 5.2,PDF p. 8,Table 3。 Qwen3-8B 的 SWE-bench 加速比相对 DSpark 提高 $(2.74/1.60-1)\approx71\%$;这是“加速比的相对提升”,不是额外提高 1.14 个百分点。表中衡量的是模型解码效率;在 BFCL 里工具执行时间已被排除,不能把该数字直接解释为完整 Agent 工作流缩短相同比例。 Table 4 把并发从 1 提到 64,报告总 TPS 与相对基线加速。Qwen3-4B 的 LiveCodeBench 在并发 64 时,DLite/DSpark 为 12,075/11,309 TPS,约高 6.8%;Qwen3-8B 的同一任务为 5,758/5,621 TPS,约高 2.4%。同时两者 $\tau$ 也不同,因而这些总吞吐结果与低开销顺序头的解释相符,却不能单独量化顺序头节省了多少时间。正文称“所有设置都更高”,但 Qwen3-4B MT-Bench 并发 16 有一个很小的反例:DLite 8,162、DSpark 8,177 TPS。[Sec. 5.2,PDF pp. 8–9,Table 4] 原文 Fig. 5,PDF p. 9。 (a) 两阶段训练在稳定阶段的训练曲线和最终 GSM8K/MBPP/MT-Bench 接受长度上高于单阶段;(b) 在相同训练设置下,无草稿 KV 与 128/512 token 滑动 KV 的最终接受长度接近。后一个结果支持“充分训练后草稿历史状态的额外收益较小”,并不表示所有训练时刻都一样。[Sec. 5.3] 附录 Table 5 使用同一 80K 样本子集做设计空间探索,不能与主实验的 1.9M 样本结果混为一组:14 层目标特征的四任务平均 $\tau=3.30$,20/36 层为 3.29/3.27;按序列维拼接是 3.30,按特征维拼接是 3.04;顺序头秩 512 是 3.30,升到完整 4096 也只有 3.33。作者据此选择 8B 的 14 层与秩 512,在接受长度和额外计算间取舍。[Appendix A.2,PDF p. 13,Table 5] 这篇工作的关键不是让草稿模型更擅长重算长历史,而是利用目标模型已经计算出的上下文表示,令草稿计算量与历史长度脱钩,再用低秩顺序头保留推测块内部的因果信息。两阶段蒸馏使这种与目标模型结构差异较大的草稿器更易训练;实测优势随上下文和代理执行复杂度增大而更明显。[Sec. 4–6,PDF pp. 4–10] 理解结果时需要保留三个实际条件:一是当前数据来自 Qwen3-4B/8B、H800 和文中选定的任务与请求样本;二是方法需要取得目标模型多层隐藏状态,部署可行性依赖服务栈能否暴露和传递这些特征;三是论文报告的是推测解码接受长度、解码加速和 TPS,没有以 Agent 任务完成率或包含工具时间的全流程时延作为主指标。标准目标模型验证保障推测结果遵循其采样规则,但速度收益仍取决于验证与草稿实现的实际成本。2.4 为什么分两阶段训练
三:实验设置——比较对象与统计口径
四:结果——收益主要落在长历史与多轮场景
4.1 常规任务:接受长度大体持平或略高
目标模型 / 任务 DSpark $\tau$ DLite $\tau$ 说明 Qwen3-4B / GSM8K 6.27 6.38 数学 Qwen3-4B / MBPP 5.48 5.64 代码 Qwen3-8B / LiveCodeBench 5.43 5.66 代码 Qwen3-8B / Alpaca 3.64 3.78 对话 4.2 长上下文:接受长度与解码速度同时提高
模型 / LongBench v2 子任务 DSpark Speedup / $\tau$ DLite Speedup / $\tau$ 4B / Multi-Doc QA $1.81\times$ / 2.20 $2.18\times$ / 2.74 4B / Code Repo Understanding $2.02\times$ / 2.44 $2.66\times$ / 3.14 8B / Long-dialog History $3.02\times$ / 4.01 $3.96\times$ / 4.77 4.3 代理任务:SWE-bench 的相对差距最大
模型 / 代理任务 DSpark Speedup / $\tau$ DLite Speedup / $\tau$ 4B / AgentMemBench $1.72\times$ / 2.10 $2.39\times$ / 2.80 4B / AgentLongBench $1.45\times$ / 1.84 $2.07\times$ / 2.51 4B / BFCL-v3 $2.11\times$ / 2.54 $2.37\times$ / 2.78 4B / SWE-bench $1.64\times$ / 1.89 $2.68\times$ / 3.15 8B / SWE-bench $1.60\times$ / 1.94 $2.74\times$ / 3.19 4.4 高并发:延迟与接受质量共同决定吞吐
4.5 消融与架构选型
五:结论与理解边界