Knowledge That Is Linear Before Fine-Tuning Generalizes After It:中文研读笔记
作者:Faridoun Mehri、Hinrich Schütze(LMU Munich / MCML)
原文:arXiv:2610.22300v2 · 本地 PDF
版本与研读日期:v2,2026-10-19 修订;本次研读 2026-10-27
发表:未查到正式发表信息(截至 2026-10-27);arXiv 记录未列出期刊或会议。
代码:作者提供的官方代码与数据,仓库包含关系、提示模板、微调、探针与分析代码。
论文总览
论文研究一个比“模型能否答对旧事实”更进一步的问题:**旧知识是否有可供新学习利用的结构?**作者把能支持新任务留出泛化的事实称为 active facts,把虽能回忆、却在该任务中不能支持泛化的事实称为 inert facts。这是一种依赖任务的操作性区分,并非给每条事实贴上永久标签。
实验把旧关系(如城市 $\to$ 洲)的答案随机映射到无关的新词(欧洲 $\to$ crab,亚洲 $\to$ zebra),只用部分城市微调模型,再测试未见城市。新词的映射不告诉模型,因此成功的迁移需要利用旧关系中“哪些主体共享答案”的结构。作者用微调前、主体表示上的交叉验证线性探针准确率衡量这种结构的线性可读性(Pre-linearity)。在 11 个模型、70 个关系上,它与留出泛化的相关为 Pearson $r=0.87$–$0.92$;同时控制四种关系属性后仍为 $0.70$–$0.82$(Table 1,PDF 第 7 页)。这支持“线性可读性比原任务召回更能预测该实验中的新知识迁移”,但仍是关系层面的相关证据。
结构地图
| 原文章节 | 作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 定义问题、给出随机重标实验直觉 | 第 1–3 页;Fig. 1,第 2 页 |
| 2 Related work | 区分统计事实泛化、逻辑蕴含与改写 | 第 3–4 页 |
| 3 Method | 定义新关系、三个指标、嵌套交叉验证和控制变量 | 第 4–6 页;Fig. 5,第 14 页 |
| 4 Experimental setup | 关系、模型、标签集合及重复实验 | 第 6–8 页;Table 1,第 7 页 |
| 5 Results | 主相关、控制、召回比较、鲁棒性与错误分析 | 第 8–9 页;Fig. 2–4,第 6、8、9 页 |
| 6 Conclusion | 概括表示结构与新关系泛化的关联 | 第 9–10 页 |
| Appendix A–H | 探针分折、训练细节、逐关系结果、随机重复、标签和错误归因 | 第 14–24 页;Fig. 5–8、Table 3–7 |
一:动机
如果预训练文本描述 Mary 在法国成长、上法国学校、用法语写作,却没有直接说其母语,模型推测她的母语是法语,属于作者所说的统计事实泛化:依据已知事实推断一个高概率但并非逻辑必然的新事实。它有别于对同一事实的改写,也有别于从前提必然推出结论的蕴含。旧研究已考察事实召回、关系表示和从已知事实推断;本文进一步追问哪些已知关系能够成为新学习的基础(Sec. 1–2,PDF 第 1–4 页)。
作者的假设是:若旧关系的答案在预训练模型的主体表示中能被简单线性边界读出,微调更容易把该结构接到一套新标签上。下图是原文的示意:A 和 B 的旧关系召回都高,但 A 的颜色簇较可分,重标后能迁移到空心标出的未见主体;B 的表示交错,错误标签也接近探针误判的类别。图是概念图,不是实验散点。
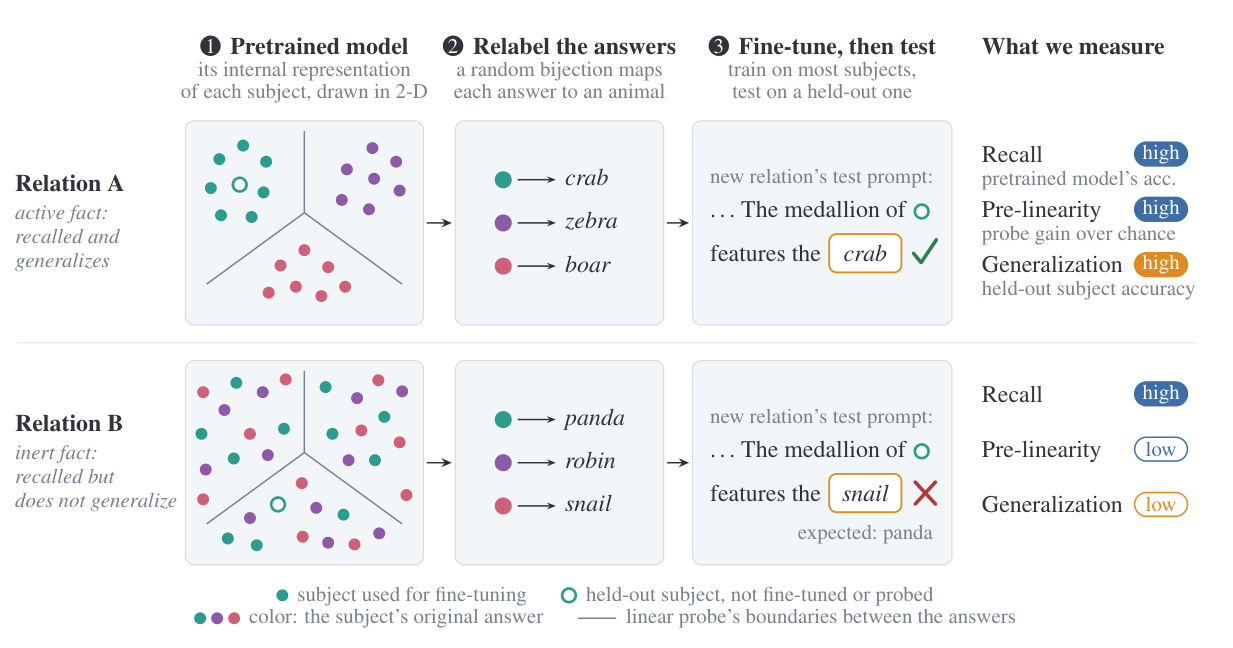
原文 Fig. 1,PDF 第 2 页。圆点颜色表示旧关系答案,空心圆为未参与微调和探针训练的主体。
二:方法
2.1 造出“依赖旧知识、但答案全新”的任务
给定旧关系 $R$,记主体 $u$ 的有效答案为 $e_R(u)\in\mathcal E$。这里的“有效答案”按首 token区分:如果两个答案首 token 相同,就归为同一类。作者从标签池 $\mathcal A$ 随机抽取 $|\mathcal E|$ 个标签构成 $L$,并随机建立双射 $\pi:\mathcal E\to L$。新关系为
例如 $e_R(\text{Paris})=e_R(\text{Munich})=\text{Europe}$,且 $\pi(\text{Europe})=\text{crab}$,那么两个城市的新答案同为 crab。训练时只给部分主体 $T$ 的新关系事实,不显式提供旧关系 $R$ 或双射 $\pi$;测试集 $H$ 的主体从未参加微调、探针拟合或调参。每个旧答案至少有 4 个训练主体和 1 个留出主体。动物标签取自 WordNet 并经过词频、首 token 唯一性、语义邻近性等筛选,以减少标签歧义和原关系的语义捷径(Sec. 3,PDF 第 4–5 页;Appendix F,第 22 页)。
2.2 三个指标分别测什么
三个指标都以候选答案集合内的首 token top-1 正确率为基础。先按每个答案类别分别求主体准确率,再对类别等权平均,所以大类不会因主体多而主导;均匀随机猜测的基线约为 $1/|\mathcal E|$。
| 指标 | 模型、数据与问题 | 定义要点 |
|---|---|---|
| Recall(旧关系召回) | 微调前模型;$T$ 上的旧关系提示 | 旧答案在候选旧答案中的类别平衡准确率 |
| Pre-linearity(预先线性可读性) | 微调前模型;$T$ 的主体表示 | 线性探针的嵌套交叉验证类别平衡准确率,减去训练折多数类基线 |
| Generalization(新关系泛化) | 每个关系单独微调后的模型;$H$ 上的新关系测试提示 | 新标签在候选新标签中的类别平衡准确率 |
因此这里的 Generalization 是给定候选标签的分类测试,不等同于开放式生成的整体能力。Recall 在 $T$ 上测量,Generalization 在 $H$ 上测量,探针也只用 $T$;这样的分工让“旧关系可读”成为微调前可测的预测变量(Sec. 3,PDF 第 5–6 页)。
2.3 探针如何得到 Pre-linearity
作者在旧关系查询模板里,取主体跨度最后一个 token在某一层的激活 $h$,先对该关系的训练折做 PCA,再对白化后的前 $q=16$ 个主成分拟合 softmax 线性分类器:
$\mu$、$v_k$、$\sigma_k$ 分别是当前训练折的均值、主方向和沿该方向的标准差。探针用交叉熵加 $\tfrac{10^{-2}}{2}\|W\|^2$ 拟合;维数与正则化系数对所有模型、关系固定。每个外层 10 折的训练部分再做内层 5 折,只用内层验证选择表现最好的网络层;选层后在该外层训练部分重新拟合,预测外层测试折。PCA 与白化也在每次拟合的训练数据上重新计算。汇总每个 $T$ 主体唯一一次折外预测后,减去外层训练折多数类的类别平衡基线,得到 Pre-linearity。这里测的是受限为 16 维 PCA 表示的线性探针可读性,并非证明模型所有相关知识都以唯一线性机制存储(Sec. 3,PDF 第 5–6 页;Fig. 5,第 14 页)。
2.4 微调与控制变量
新关系放进虚构小说情境,避免把动物标签伪装成现实地理事实。每个训练主体有 4 个改写模板,第 5 个模板专用于测试。所有权重参与微调,损失只落在标签的首 token;训练 20 个 epoch,每条事实在 4 种措辞下各出现 20 次。各模型在训练主体上最终准确率均为 1.00,排除了“新映射本身尚未学会”这一简单解释(Sec. 3,PDF 第 5 页;Appendix B/Table 3,第 14–15 页)。
作者还为每个关系记录四个可能同时影响探针与泛化的因素:旧关系 Recall、答案数 $\ln|\mathcal E|$、训练主体数 $\ln|T|$、主体在 Dolma v1.7 中出现次数的平均 $\log_{10}(1+\text{count})$。最后一项是各模型预训练曝光量的代理,并非每个模型真实训练语料的计数。统计分析在同一个模型的 70 个关系之间求相关和偏相关,不把 11 个模型当成 770 个独立模型重复(Sec. 3–4,PDF 第 6–8 页)。
三:实验设置
关系共 70 个:Hernandez 集 11 个、作者构造的 Town 集 6 个、BEAR 集 53 个。进入实验的关系在每个模型下需至少 5 个有效答案、每个答案至少 5 个主体、训练主体至少 25 个。Town 集把 300 座城镇映射到区域、官方语言或纬度、经度、海拔、人口分档;这为自然事实之外加入了规则明确的关系(Sec. 4,PDF 第 6–7 页;Appendix E,第 21–22 页)。
11 个开放权重模型覆盖约 2B–27B 参数,包括基础模型与后训练模型;Qwen3.5-9B 同时包含 Base 与后训练版本。主实验用 179 个动物名作标签。标签类别鲁棒性实验只在 MiniCPM5-2B-Base 上进行,另用 13 个 WordNet 名词类别。重随机实验对 MiniCPM 的全部 70 个关系做 3 次;其余 10 个模型仅对 Hernandez+Town 的 17 个关系做 3 次,Qwen3.8-27B 不参加这项重复(Sec. 4,PDF 第 7–8 页)。
Pearson $r$ 衡量关系层面的线性关联,Spearman $\rho$ 衡量排序一致性。置信区间按关系重采样、进行 10,000 次 95% 百分位 bootstrap;偏相关每次重采样会重新拟合控制变量回归(Appendix H,PDF 第 24 页)。
四:结果
4.1 线性可读性稳定预测留出泛化
下图每点是一个关系,横轴 Pre-linearity,纵轴 Generalization;11 个面板各对应一个模型。相同模型内部的点明显沿对角线排列,而不是把大模型与小模型的总体能力混合后才出现相关(Fig. 2,PDF 第 6 页)。
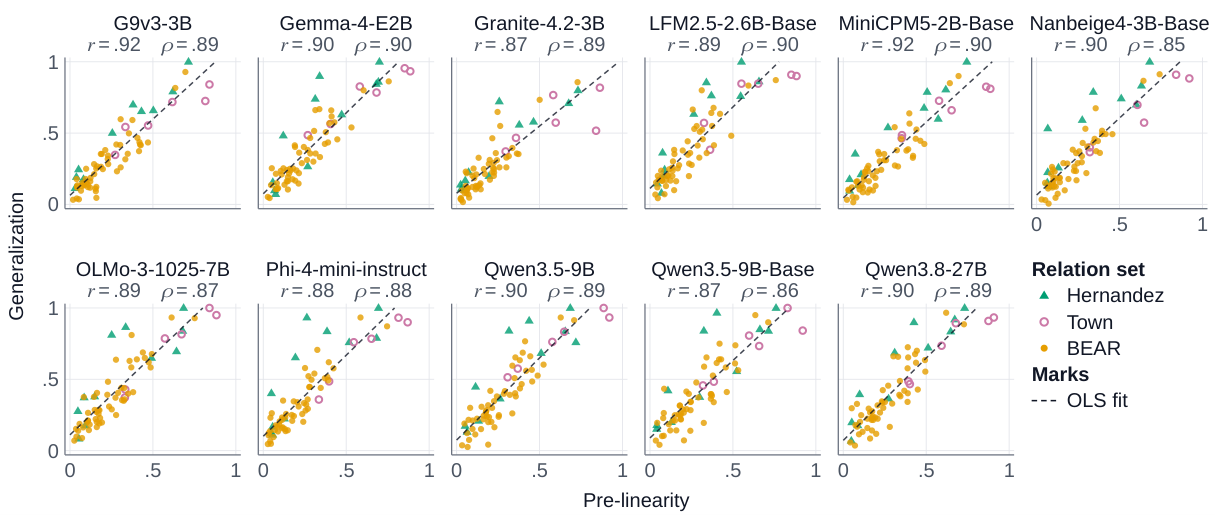
原文 Fig. 2,PDF 第 6 页。符号表示 Hernandez、Town、BEAR 三种关系来源;虚线是每个模型内的线性拟合。
| 比较(同模型内跨 70 个关系) | Pearson $r$ 范围 | Spearman $\rho$ 范围 | 来源 |
|---|---|---|---|
| Pre-linearity 与 Generalization,原始相关 | 0.87–0.92 | 0.85–0.90 | Table 1,第 7 页 |
| 控制 Recall | 0.79–0.86 | 0.79–0.87 | Table 1,第 7 页 |
| 同时控制 Recall、答案数、主体数和主体频率 | 0.70–0.82 | 0.75–0.85 | Table 1,第 7 页 |
这四项控制会降低相关,但没有消除它。联合控制后 11 个 Pearson 系数的平均值为 0.77;作者报告其 95% 区间的最低下界仍为 0.56。上述数值是相关系数,不是“泛化准确率提升 70%–82%”(Table 1,PDF 第 7 页)。
4.2 Recall 有信息,但不是最强预测量
只看旧关系 Recall,它与 Generalization 的 Pearson 相关为 0.63–0.74;控制 Recall 后,Pre-linearity 与 Generalization 仍有 0.79–0.86 的相关。反向控制 Pre-linearity 后,Recall 的 Pearson 相关降为 0.40–0.58。因此旧任务答得好与新任务泛化仍有联系,线性可读性提供更强的关系层预测信号,而不是“Recall 完全无用”(Sec. 5,Fig. 3a,PDF 第 8–9 页)。
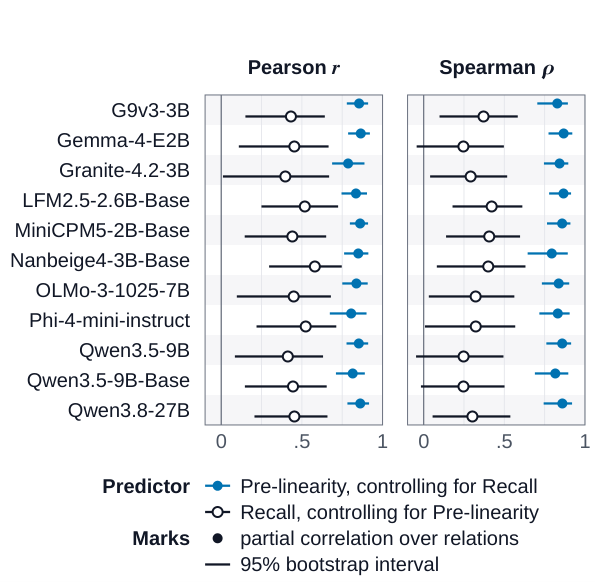
原文 Fig. 3a,PDF 第 8 页。蓝点:Pre-linearity 控制 Recall 后的偏相关;空心点:Recall 控制 Pre-linearity 后的偏相关。横线为 95% bootstrap 区间。
4.3 改标签与改随机种子并未改变主关联
在 MiniCPM5-2B-Base 上,把动物标签替换为其他 13 种词类,Pre-linearity 与 Generalization 的 Pearson $r$ 仍为 0.91–0.93;新标签类别与动物标签对关系泛化难度的排序相关 $\rho=0.95$–$0.97$。这说明主相关不依赖于“动物词恰好容易学”,但这项类别检验仅覆盖该模型(Sec. 5,Fig. 3b,PDF 第 8–9 页)。
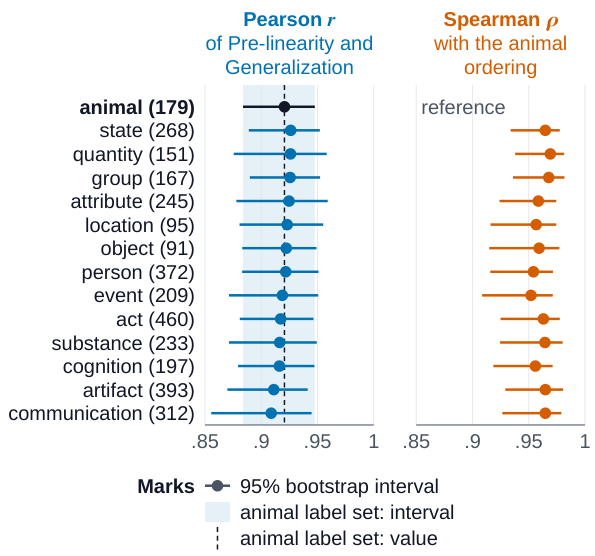
原文 Fig. 3b,PDF 第 8 页。蓝色为各词类的 Pearson 相关,橙色为相对于动物标签结果的关系排序一致性。
重新抽取旧答案到新标签的双射并改变微调随机种子后,MiniCPM 全部 70 个关系的三次 Pearson $r$ 分别为 0.92、0.93、0.92;另 10 个模型在 17 个关系上的重复系数总体落于 0.78–0.95。这里的重复检验的是映射与训练随机性;主体划分、标签子集及提示模板保持不变(Sec. 4–5,Table 2,PDF 第 9 页;Appendix D/Table 4–5,第 20 页)。
4.4 错误标签更接近探针的误判
作者用 $\pi^{-1}$ 将微调后答错的动物标签映回旧关系答案,再比较几个解释会不会选中该错误答案:线性探针前三名、微调前模型旧关系预测前三名、训练集中最高频答案、表示空间的 5 个最近邻主体,以及微调前模型在新提示上的答案。多个解释同时匹配时平分这次错误的归因份额,并与“在同一微调模型的错误之间打乱标签”和均匀随机错误标签作比较(Sec. 5,PDF 第 9 页;Appendix G,第 23–24 页)。
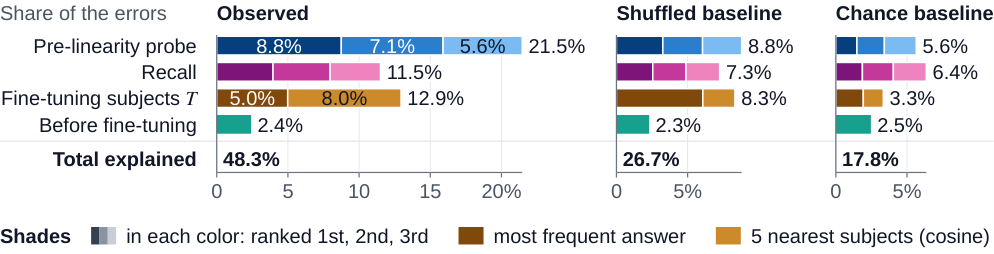
原文 Fig. 4,PDF 第 9 页。横轴是所有留出错误中的份额;Observed、Shuffled、Chance 三组不可读作准确率。
在 770 个模型×关系的微调单元里,757 个至少产生一次错误,合计 37,571 个留出错误。探针前三名分得 21.5% 的错误份额,打乱基线为 8.8%;旧关系模型预测前三名分别为 11.5% 和 7.3%。所有解释合计覆盖 48.3% 错误,打乱基线为 26.7%。这把关系层面的相关推进到主体层面的错误对应:模型答错时,错误类别较常落在探针认为相近的旧答案上。归因份额受候选解释集合与分摊规则影响,因此适合读作诊断证据(Fig. 4,PDF 第 9 页;Appendix G,第 23–24 页)。
五:结论与思考
这项工作把“会说出旧事实”与“能借旧事实学会新关系”分开测量。随机重标消除了新标签的常规语义,留出主体检验旧关系结构能否迁移;线性探针则在微调前给出一个可测的关系属性。跨模型、跨关系的主相关、联合控制、标签/种子重复以及错误标签分析共同支持:在这一类新关系微调任务中,旧关系的线性可读结构,比旧关系的候选答案召回更能预测后续泛化。
实践上的启发是,筛选可供微调利用的已有知识时,可以补测表示层的关系可读性,而不只依赖提示式事实问答分数。这个推论仍需按任务核验:本文使用英语关系、随机词类标签、全参数微调与受限候选首 token 分类;Dolma 主体频率只是各模型曝光量的代理。现有对照与错误分析支持“模型利用了探针所读到的结构”这一解释,尚不能单独确定线性读出本身就是微调泛化的因果机制。