词汇参考系:用模型原生语义解释语言模型残差流
原题: Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
作者: Jian Gu、Hongyu Zhang、Chunyang Chen、Aldeida Aleti
arXiv: 2610.22169v2,2026-10-18 修订;本次获取:2026-11-10
原文: arXiv PDF · 本地 PDF
- 发表: 发表状态暂无法核实。截至 2026-11-10,arXiv v2 的 Comments/Journal reference 为空;作者主页的 Selected Papers 将本文标为 ArXiv,但 Featured Work 区域出现归属不清的 ICSE'26 标记,未能找到与本文对应的正式会议或期刊记录。arXiv 版本页 · 作者主页
- 代码: 作者在 arXiv 页面提供了官方代码仓库。仓库公开,包含实现、文档、示例和测试。
论文总览
论文要回答的问题是:一个处在中间层的残差流状态,应该用什么坐标解释,才能反映后续网络在当前上下文里如何读取它?
常见的 logit lens、tuned lens、Jacobian lens 每层至多给一个固定映射,因此同一层不同上下文的状态会沿相同方向被解释。点云方法则描述状态之间的几何关系,却不直接测量模型对这些状态的响应。作者提出词汇参考系(lexical reference frame):把状态沿模型尚未执行的层继续传递,并在词汇表坐标中读取它;参考系随层和上下文改变。LexFrame[n] 用可控的注意力轮数近似完整的原生参考系,其中 LexFrame[1] 只略去后续层里前缀 token 彼此之间的注意力。
在 SmolLM3-3B 和 OLMo3-7B 上,LexFrame[1] 在中层与完整模型原生读出方向的平均余弦相似度达到 0.97;逐层平均的输出 KL 散度分别为 0.16 和 0.15 nats。它的局部词汇基向量可用于较有选择性的预测引导,系数差值也比线性 attribution patching 更贴近完整前向干预的效果。这些结果支持一个核心观点:解释中间状态时,读出方向与状态沿这些方向携带多少输出信息是两个问题,需要连同后续层的非线性传输一起处理。(Sec. 3–4,PDF pp. 4–9)
结构地图
| 原文章节 | 内容 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 固定 lens 与点云分析的缺口;提出 native frame 与 LexFrame[n] | pp. 1–2,Fig. 1 |
| 2 Related Work | lenses、点云几何、方向/组件归因 | p. 3 |
| 3 Lexical Reference Frames | 词汇读出/基向量、coherence bound、有限阶传输 | pp. 3–5,Eqs. (1)–(3),Figs. 2–3 |
| 4 Experiments | 对 lenses、点云、坐标性质、steering 和 attribution 的比较 | pp. 5–9,Figs. 4–5,Tables 1–6 |
| 5 Conclusion | 汇总方法主张 | p. 9 |
| Appendix A: Technical Details | 模型、数据、校准、评估设置 | pp. 13–14 |
| Appendix B: Additional Results | 训练检查点、深度变化、长上下文、early exit、消融与例子 | pp. 13–16,Figs. 6–9,Tables 7–9 |
| Appendix C: Properties of Reference Frames | 读出与基向量性质、coherence bound 证明、复杂度 | pp. 16–17,Eqs. (4)–(6) |
| Appendix D: Discussion | 适用解释与潜在应用 | p. 18 |
一:动机——中间层状态缺少模型自己的“词汇坐标”
Transformer 的输入嵌入与输出 unembedding 在残差流两端分别定义了 token 状态与词汇 logits;中间层并没有同样直接的词汇定义。模型压缩、early exit、幻觉检测、知识编辑等工作会读取中间状态,因此解释结果是否可信,取决于所用的读出是否符合后续层实际如何处理该状态。(Sec. 1,PDF pp. 1–2)
两类现有做法各自遗漏一部分:
- 固定 lens: Logit lens 直接复用输出 unembedding;tuned lens 为每层训练一个仿射映射;Jacobian lens 对剩余网络的 Jacobian 做跨提示平均。它们可以依层而变,却不能随单个上下文改变同一 token 的读出方向。
- 点云统计: rank、各向异性、主成分或层间相似度概括一批状态的分布,但状态间的距离未必对应替换状态后模型输出会变多少。
作者把 native frame 作为分析参照:对某个状态固定其前缀,运行剩余层并观察输出词汇坐标如何随该状态变化。它不是独立于模型的“语义真值”,而是模型本身定义的状态读法。要获得有信息量的中间层读数,需要让近似方法明确省略一部分计算;否则完整 native frame 的 reading 就是模型自己的输出。(Sec. 3.2–3.3,PDF pp. 4–5)
固定 lens 的方向上限
记 \(b_i\) 为同一标签在不同上下文状态下的单位 native lexical readout,\(r\) 为不依赖具体状态的单位方向。固定方向的平均余弦满足
当不同序列状态足够多时,\(\hat\kappa\) 趋近于 readout coherence \(\kappa_\ell(v)\),因此固定方向的上限趋近 \(\sqrt{\kappa_\ell(v)}\)。上限是 native readouts 跨上下文变化的结果,而非某种 lens 拟合器的弱点;它约束的是方向相似度,不直接给出读数分布的 KL 上界。中层平均上限在 SmolLM3-3B 为 0.30、OLMo3-7B 为 0.35。(Sec. 3.2、Appendix C.2,PDF pp. 4、17)
二:方法——沿剩余网络传输状态,再用词汇坐标读取
记号与两种“方向”
令 \(x_\ell(t)\in\mathbb R^d\) 为位置 \(t\) 在第 \(\ell\) 层后的残差流状态,\(T_\ell\) 为保持前缀上下文并将该状态传到最后一层的 native transport,\(N\) 为最终归一化。令 \(W\) 为 unembedding,\(w_v\) 为 token \(v\) 的 unembedding 行,\(\bar w\) 为词表平均行,\(s_v=W^+e_v\) 为最接近“只含 token \(v\)”的输出 lexical basis。定义 \(J_\ell=\partial N(T_\ell)/\partial x_\ell(t)\)。
| 对象 | 原文定义 | 直观作用 |
|---|---|---|
| lexical readout | \(b_\ell(v)=J_\ell^\top(w_v-\bar w)\) | 在当前状态附近,哪种小移动最快改变 token \(v\) 的中心化 logit;是局部梯度/协向量 |
| lexical basis | \(s_\ell(v)=J_\ell^+s_v\) | 在当前层做什么最小移动,使最终状态朝输出词汇基向量 \(s_v\) 移动;是写入或 steering 方向 |
| transported coefficient | \(z_\ell(v)=\langle w_v,N(T_\ell(x_\ell(t)))\rangle\) | 将传输后的状态投到输出词汇坐标,reading 是这些系数形成的 token 分布 |
因此,readout 与 basis 不应混为一谈:前者回答“模型沿哪一方向测量 \(v\)”,后者回答“沿什么方向移动状态可尽量增加 \(v\)”。另外,\(b_\ell(v)^\top x_\ell(t)\) 不是该 token 在中间层的系数;它是状态缩放时中心化 logit 的局部响应。论文报告该内积与中心化 logit 的相关仅为 0.10(SmolLM3)和 0.02(OLMo3)。(Eqs. (1)–(2)、Appendix C.1,PDF pp. 4、17)
LexFrame[n] 如何控制被省略的上下文交互
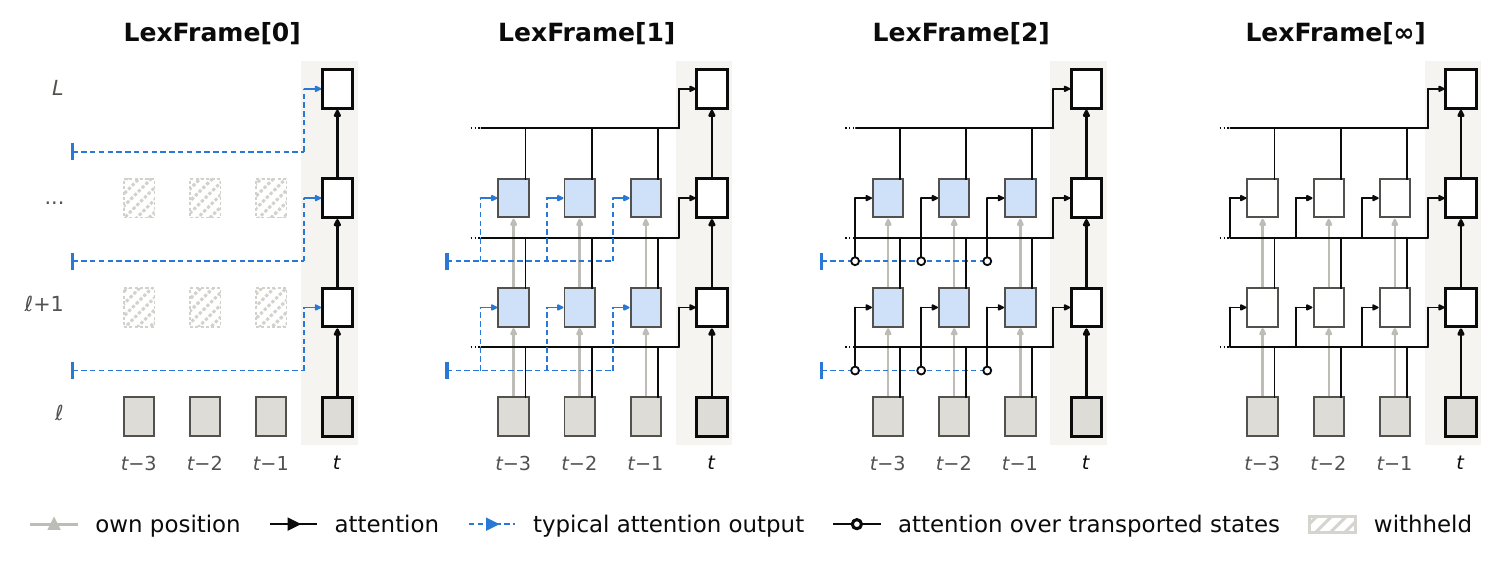
原图:Fig. 3,PDF p. 5。横向比较各阶 frame;方框表示位置在各层的状态,箭头区分目标位置自身传递、attention、典型 attention 输出及被略去的交换。
- LexFrame[0]: 目标位置沿模型自己的剩余层传输,但把每层注意力输出用典型值替代: \[ \hat a_k(y)=\bar a_k+G_k(y-\bar y_k). \] \(\bar y_k,\bar a_k\) 是 attention 输入、输出的校准均值,\(G_k\) 是用无标签校准文本对 attention 输入到输出做的 ridge 回归。它仍运行剩余层,只是不让目标状态从前缀读取新的信息。
- LexFrame[1]: 目标位置在每个剩余层执行真实 attention,但前缀位置的状态用 LexFrame[0] 传输;因此目标 token 能直接读取前缀,前缀 token 之间的后续交换仍被省略。
- LexFrame[2]: 前缀状态可再使用一轮 attention 交换后供目标读取,允许信息经一个中间前缀位置传播。
- LexFrame[\(\infty\)]: 所有位置都用真实前向状态,恢复完整模型 native frame。它的 reading 正好是模型输出;有限阶 frame 只在剩余层数不超过其阶数时严格等于完整模型。
每增加一阶,就多允许一轮位置间的信息传递。估计典型 attention 输出只需在校准文本上前向一次并逐层拟合 ridge;作者用训练切分的 256 条、每条 128 token 的序列校准。模型输出本身不参与拟合。读取阶数 \(n\) 时,约有 \(n+1\) 条传输流经过剩余层;逐层读取一条完整序列的成本约为 \((n+1)(L+1)/2\) 次前向通过。(Sec. 3.3、Appendix C.2–C.3,PDF pp. 5、17)
三:实验——设置与比较对象
| 项目 | 论文设置 |
|---|---|
| 模型 | SmolLM3-3B,36 层,输入/输出嵌入 tying;OLMo3-7B,32 层,二者不 tying |
| 文本 | WikiText-103 英文;主结果按 128 token 切分 |
| 校准 / 测试 | 256 条训练序列估计典型 attention 输出;64 条测试序列评估;除长上下文实验外,各实验使用相同测试序列 |
| 对照 | Logit lens、Jacobian lens(在 100 个 prompts 上拟合);另有独立文本拟合的 linear probe 用于方向分析 |
| 汇总口径 | 表格对层 1 到 \(L-1\) 等权平均,排除 embedding 与输出层;单次确定性运行,图中区间是按序列 bootstrap 的 95% percentile 区间 |
| 指标 | KL 为 \(D_{\mathrm{KL}}(p_{\text{model}}\|p_{\text{reading}})\),单位 nats;Top-1 是与模型 top token 的一致率;ECE 对照 WikiText 下一真实 token 计算,15 个 bins |
作者没有纳入 tuned lens,因为该方法是以模型输出训练,而输出又是本实验评分的目标。实验运行在 RTX 4080 SUPER 单卡;主要比较使用两个开源模型家族和单一英文语料。(Sec. 4、Appendix A,PDF pp. 5–6、13–14)
四:结果——LexFrame[1] 从中层起追上模型自己的读出
4.1 方向与输出 reading
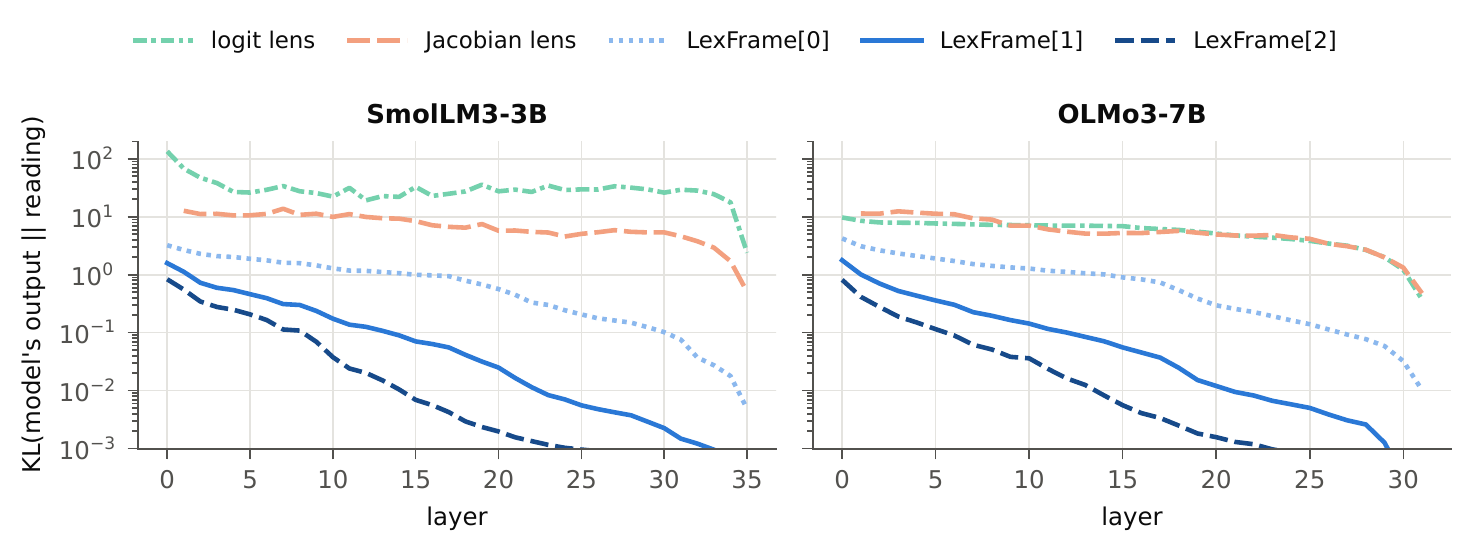
原图:Fig. 4,PDF p. 6。纵轴为模型输出到各方法 reading 的 KL(对数刻度),左右分别是 SmolLM3-3B 与 OLMo3-7B。LexFrame 的阶数越高,通常越接近模型;两种 lens 大多在临近输出层才快速收敛。
中层的方向对比更直接。LexFrame[1] 对 native lexical readouts 的平均余弦相似度达到 0.97(两个模型均如此),高于任何固定方向可达到的中层上限 0.30/0.35。LexFrame[2] 在更早层已接近 native frame,因为它多保留了一轮前缀内部交换。(Sec. 4.1,PDF pp. 2、6;Fig. 1、Table 1)
| 方法 | SmolLM3 KL ↓ | Top-1 一致 ↑ | ECE ↓ | OLMo3 KL ↓ | Top-1 一致 ↑ | ECE ↓ |
|---|---|---|---|---|---|---|
| Logit lens | 29.06 | 0.04 | 0.632 | 5.66 | 0.15 | 0.107 |
| Jacobian lens | 7.51 | 0.14 | 0.376 | 6.19 | 0.13 | 0.191 |
| LexFrame[0] | 0.87 | 0.64 | 0.018 | 0.93 | 0.64 | 0.045 |
| LexFrame[1] | 0.16 | 0.86 | 0.027 | 0.15 | 0.86 | 0.018 |
| LexFrame[2] | 0.06 | 0.92 | 0.020 | 0.05 | 0.93 | 0.020 |
Table 1,PDF p. 7。Top-1 一致率是与模型预测一致,并非真实下一词准确率;ECE 才是对真实下一 token 的校准误差。模型自身 ECE 分别为 0.018 和 0.023,LexFrame[1] 接近这一水平。逐层看,LexFrame[1] 与模型 top token 的一致率从 SmolLM3 第 18 层、OLMo3 第 17 层起超过 0.90;两种 lens 到第 35/30 层才达到 0.50。
4.2 层内状态距离不等同于模型对状态的敏感度
作者在同层用另一条真实序列的状态替换目标位置状态,再完整运行模型,观察输出变化。不同 point-cloud 距离与这种替换效果的秩相关最高不超过 0.28;LexFrame[1] 两个状态 reading 的散度与替换效果的秩相关为 0.94/0.95。embedding 层也已有 0.64/0.66。该结果说明,剩余网络的词汇响应方向与状态云最主要的变化方向并不相同。(Sec. 4.2,PDF p. 7,Table 2)
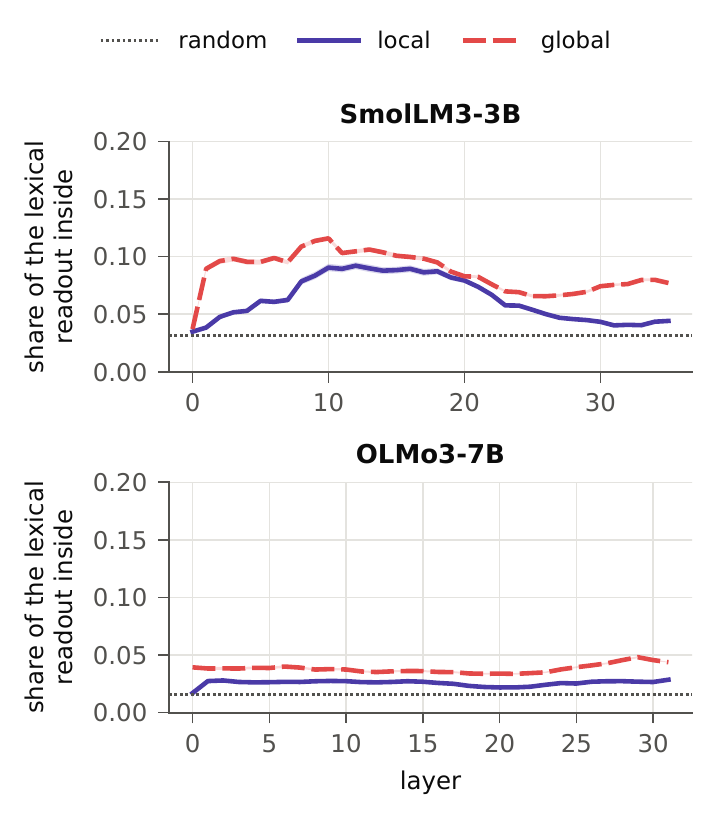
原图:Fig. 5,PDF p. 7。纵轴表示 lexical readout 的平方范数落在 64 个主成分方向上的比例;“local”根据每个状态的近邻估计,“global”使用全体状态。占比整体接近或仅略高于随机方向,支持“几何变化方向未必是后续网络敏感方向”的解释。
4.3 读出方向不等于写入方向;中层坐标需由传输定义
移动状态范数的 0.1 倍后,检查目标 token 是否成为 logit 增幅最大的标签。LexFrame[1] basis 的成功率为 0.84(SmolLM3)与 0.97(OLMo3),native basis 则为 0.98/1.00;native readout 只有 0.56/0.79。固定 input/output basis 较差。readout 是梯度,虽然上升目标 token 最快,也会同时提升与其 logit 同涨的其他 token;basis 是针对输出词汇方向求得的最小局部移动。(Sec. 4.3,PDF p. 8,Table 3)
另一个测试检查输出词汇系数能否不经过传输而直接从层状态得到。用原层状态或每层固定映射代替 transport,KL 仍为 5.64–8.36 nats;用 LexFrame[1] transport 后降到 0.15–0.16 nats,top-token 一致率为 0.84–0.87;native transport 则精确重建模型 logits。由此可见,中间层系数不是层状态对输出向量的简单内积。(Sec. 4.3,PDF p. 8,Table 4)
4.4 Steering:basis 更能控制副作用
任务是让当前第二候选 token 超过第一候选。Reach 是成功翻转的比例;Side 是翻转时其他 token logits 的平均改变量(nats,越小越好);Clean 是其他 token 改变量低于 0.1 nats 的翻转比例。
| 模型 | 方向 | Reach ↑ | Side ↓ | Clean ↑ |
|---|---|---|---|---|
| SmolLM3 | LexFrame[1] readout | 0.92 | 0.23 | 0.61 |
| SmolLM3 | LexFrame[1] basis | 0.89 | 0.12 | 0.71 |
| SmolLM3 | Native basis | 0.90 | 0.11 | 0.73 |
| OLMo3 | LexFrame[1] readout | 0.94 | 0.20 | 0.64 |
| OLMo3 | LexFrame[1] basis | 0.95 | 0.07 | 0.82 |
| OLMo3 | Native basis | 0.97 | 0.06 | 0.85 |
Table 5,PDF p. 9。LexFrame[1] basis 用有限阶 Jacobian 求解,仍实现较高 reach 与 clean flips;其方向不需要完整 native Jacobian。相比 readout,basis 用稍低或相近的 reach 换取更少的其他 token 副作用。(Sec. 4.4)
4.5 Attribution:系数差值保留了后续层的非线性响应
参考效应通过消去某层/子层在一个位置写入的内容、保留前缀并继续完整前向,测量预测 token 中心化 logit 的变化。LexFrame[1] 系数差值与该效应的层平均相关为 0.88/0.90;以 native lexical readout 与写入向量内积作线性 attribution patching,则为 0.62/0.68。(Sec. 4.4,PDF p. 9,Table 6)
差距主要出现在 MLP:LexFrame[1] 的 MLP attribution 为 0.88/0.90,线性 native attribution 为 0.63/0.71;attention 处差距较小(0.79/0.85 对 0.75/0.84)。作者据此认为后续层对 MLP 写入更明显地偏离一阶线性响应,直接比较 transport 后的系数差值能保留这部分非线性。
4.6 深度、训练与上下文变化
- 逐层 settle 与 early exit: 从最后一层向前计算连续 top-token 一致区间,LexFrame[1] 平均覆盖总层数的 0.82/0.81;在一半序列上选取阈值、使模型一致率为 0.95 后,在另一半序列上平均可跳过 0.45/0.42 的层。Logit lens/Jacobian lens 最多跳过 0.04。此处是“可供退出参考”的离线一致性结果,LexFrame 自己仍要运行剩余层来读出,论文没有声称 LexFrame 计算本身带来加速。(Appendix B,PDF pp. 15–16,Table 7)
- 训练检查点: 对每个 checkpoint 重新校准后,LexFrame[1] 的平均 top-token 一致率在已训练检查点上至少为 0.85/0.86;Logit lens 的一致率随训练从 0.21 降至 0.04(SmolLM3)、从 0.27 降至 0.15(OLMo3)。其 KL 则从 4.82 升至 29.06、从 2.32 升至 5.66 nats。作者将 lens 变差解释为模型中层 native frame 越来越远离固定输出 frame。(Appendix B,PDF pp. 13–14)
- 上下文长度: 测试从 128 扩至 1024 token 后,LexFrame[1] KL 从 0.16/0.15 升至 0.25/0.18 nats,LexFrame[2] 从 0.06/0.05 升至 0.15/0.08;排序未变。(Appendix B,PDF p. 15,Fig. 9)
- 典型 attention 拟合项: 用层均值或零 attention 替代 ridge 回归时,LexFrame[1] 的 KL、方向余弦和 attribution 均变差。以完整回归为例,KL 0.16/0.15、余弦 0.89/0.87、归因相关 0.88/0.90;均值替代后 KL 增为 1.26/0.52。(Appendix B,PDF p. 16,Table 8)
- 跨深度变化: LexFrame[1] 与 native readout 的角度每层约缩小剩余角度的 9.2%/10.5%,指数拟合 \(R^2=0.98/0.99\)。这是经验拟合;作者将其联系到过阻尼系统的指数弛豫,但本文没有建立从 Transformer 动力学推出该速率的理论机制。(Appendix B,PDF pp. 14–15,Fig. 8)
五:结论、取舍与适用范围
LexFrame 把“方向如何随上下文变化”和“当前状态经剩余网络后会产生什么词汇系数”分开处理。有限阶 frame 仍让目标状态通过自己的剩余层,只控制前缀内部还有多少注意力交换;在本文设置中,一轮目标对前缀的 attention 已足以让中层 reading 接近完整模型。
适用时的取舍: 它能提供比固定 lens 更贴近模型前向使用方式的分析坐标,并支持局部 steering 与消融归因;但读取需要额外运行剩余 Transformer 层,计算成本明显高于单次矩阵乘法的 lens。因此,论文中的 early-exit 实验衡量的是 LexFrame reading 暗示了多少可跳层深度,而不是部署 LexFrame 后直接得到的推理提速。
证据范围: 实验覆盖两个开源模型、WikiText-103 英文、单次确定性运行及有限训练检查点。作者提供按序列 bootstrap 的区间,但没有以多次独立训练作为统计重复;point-cloud 替换、steering 与 attribution 的证据都是这些模型和采样设置下的度量。更广泛任务中,reading 是否能改善实际检测、编辑或推理系统,需要应用侧单独评估。
参考与本地图件
原论文的图件来自 arXiv v2 作者源码,保存在本目录 figures/;图注均标明原图号和 PDF 页码。完整作者源码位于 ../source/tex/files/(本地核验附件),PDF 在 ../source/paper.pdf。