Continuum Attention:连续记忆轨迹上的因果注意力
- 作者:Afshin Khadangi(University of Luxembourg)
- 原文版本:arXiv:2610.20586v2,2026-11-09 获取;本地 PDF
- 发表:截至 2026-11-09 未查到正式发表记录。arXiv 页面记录 v1(10 月 14 日)与 v2(10 月 26 日);作者 TeX 的首页标注 “Working Paper”。arXiv 记录
- 代码:作者的官方实现公开,包含 Metal 与 CUDA 内核、解析参考实现、测试和训练工具;仓库 README 将其标为 Continuum Attention 官方实现。
论文总览
标准因果注意力把历史视为一列离散 key/value 位置,查询只在 token 索引上取值。Continuum Attention(CA)将相邻 key 与 value 连成分段线性轨迹,让每个查询按连续的指数相关密度对可见轨迹积分。由于轨迹上的 score 和 value 都是线性的,每段积分可以用指数矩的闭式表达计算;前向只需 0、1 阶矩,解析反向传播再用到 2 阶矩。
CA 的主要实证证据来自两类实验。五种子的小模型控制实验在相同温度下优于 softmax;在 101M 参数的字节级语言模型中,CA 在 FLORES 八种语言的宏平均 BPB 最低(1.8915),相对最强基线 AU-Net(2.0077)降低约 5.8%。收益有明确边界:Stack-smol 代码数据上 CA 最差;注意力计算仍为二次复杂度;512 长度的小模型下 CA 前向吞吐比匹配 softmax 低约 39%。
结构地图
| 原文章节 | 内容 | PDF 页码与定位 |
|---|---|---|
| 1. Introduction | 离散检索的动机、连续注意力相关工作和贡献 | pp. 1–2 |
| 2. Method | 轨迹、指数密度、精确积分、边界、解析梯度、稳定计算及 Transformer 集成 | pp. 2–7;Eqs. (1)–(35) |
| 3. Experiments and Results | 101M 架构与训练、数据效率、跨域、多语言、选择题、扰动鲁棒性和 CUDA 验证 | pp. 7–11;Figs. 2–6、Tables 1–4 |
| 4. Discussion and Limitations | 贡献定位、系统代价和跨域泛化 | p. 11 |
| 5. Conclusion | 总结与代码链接 | p. 12 |
| Appendix A | TinyStories 五种子实验、配对置信区间、额外验证和 Metal 吞吐 | pp. 15–18;Tables A.1–A.4 |
| References | 相关工作与数据集引用 | pp. 13–14 |
一:动机
注意力的 query/key/value 本身是连续向量,但 softmax 注意力只在离散 token 位置上计算相关性并加权 value。CA 的出发点是:如果相邻表示之间也定义了一个有意义的连续记忆路径,查询是否能从路径上的中间位置取回信息?
作者不引入新的插值网络,而是直接在相邻 key 与 value 之间做线性插值。这保留原有 causal Transformer 的投影、残差和前馈结构。关键设计在于 score 沿每段路径也是仿射函数,因此“对连续域积分”没有变成数值积分问题,而有精确的有限维计算。
此前连续注意力和积分算子已用于连续域表示或神经算子。本文的具体贡献是:把轨迹定义在因果 Transformer 相邻 token 的 key/value 上,并为自回归语言模型推导精确分段积分和解析梯度(Sec. 1、Sec. 4,PDF pp. 1–2、11)。
二:方法
2.1 连续记忆与查询相关密度
对第 $i$ 个 causal query,可见 token 为 $0,\ldots,i$。对于区间 $[j-1,j]$,$u=t-(j-1)\in[0,1]$,CA 定义
查询在连续位置 $t$ 上的 score 为
输出是 $\mathbf{o}_i=\int_{-1/2}^{i+1/2}p_i(t)\mathbf{v}(t)\,dt$。因为 $\mathbf{k}(t)$ 在线段内线性变化,score 也线性变化;不同 query 会通过端点 score 差值改变同一段内的相关分布。
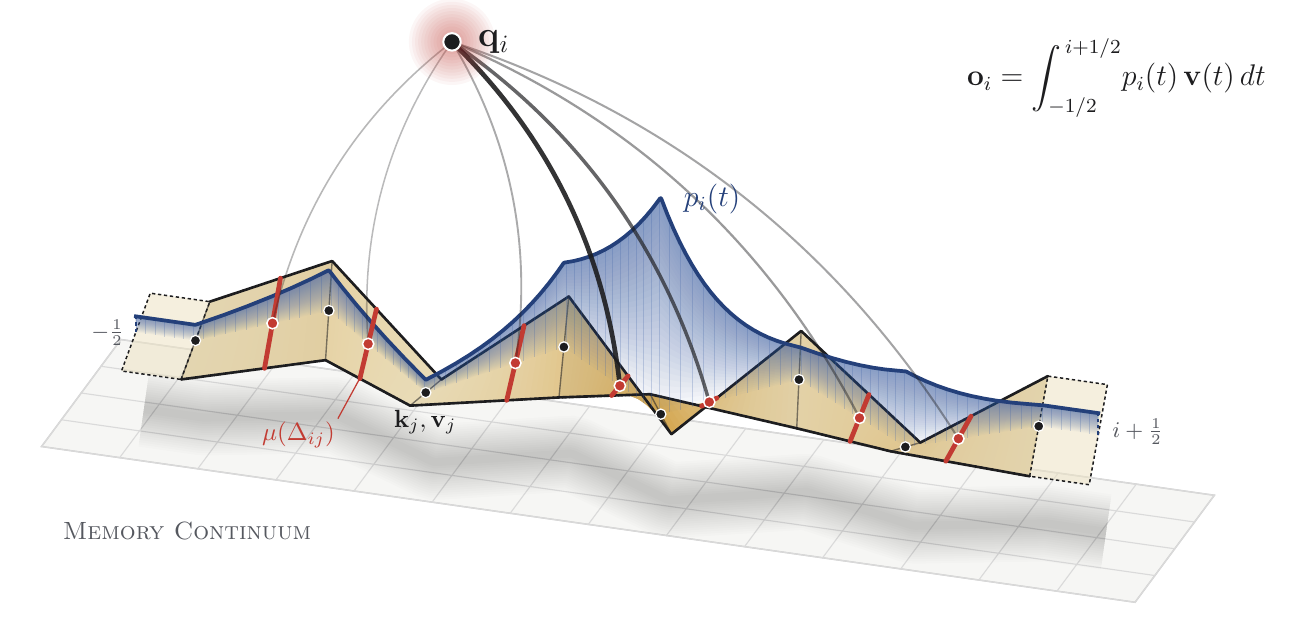
原图展示 query 对连续轨迹生成的相关密度 $p_i(t)$,以及区间内的自适应检索位置 $\mu(\Delta_{ij})$。半 token 端帽把首尾离散位置纳入积分域。来源:Fig. 1,PDF p. 1。
2.2 指数矩给出每段闭式积分
令一段两端 score 为 $a_{ij}=s_i(j-1)$、$b_{ij}=s_i(j)$,$\Delta_{ij}=b_{ij}-a_{ij}$。定义
当 $\Delta\neq0$ 时,
而 $\Delta=0$ 的连续极限分别为 $1,1/2,1/3$。分段的未归一化质量和 value 分子为
其中 $\mu(\Delta)=\frac{1}{1-e^{-\Delta}}-\frac{1}{\Delta}$,$\mu(0)=1/2$。它随 $\Delta$ 从 0 单调增至 1:相关性沿段上升时,段内有效取值向右端移动;相关性下降时,取值偏向左端。每段因此有两种查询适配:总质量 $M_{ij}$ 决定该段的贡献量,$\mu$ 决定在端点 value 间取哪个插值位置(Sec. 2.2–2.3,Eqs. (4)–(18),PDF pp. 2–4)。
2.3 半 token 端帽、归一化与有效离散权重
积分域在首尾各延伸半个位置,端帽的质量为 $\frac12e^{s_i(0)}$ 与 $\frac12e^{s_i(i)}$,对应的分子分别乘以 $\mathbf v_0$、$\mathbf v_i$。加上所有分段后,
当所有可见位置的 score 相同,端帽与相邻区间的半质量相加后,每个离散 value 权重相同,CA 退化为均匀因果注意力。更一般地,输出可改写成原始离散 value 的凸组合:权重非负且逐行和为 1。这一性质保留了标准注意力的 convex aggregation 语义,但权重来自相邻区段积分的组合,而非单独逐 token softmax(Sec. 2.4,Eqs. (19)–(22),PDF p. 5)。
2.4 解析梯度、数值稳定与复杂度
分段 score 对端点的导数包含 $J_0,J_1,J_2$;各段端点贡献累加后得到 $\partial\mathcal L/\partial \mathbf q_i$、$\partial\mathcal L/\partial \mathbf k_j$,value 梯度则通过最终有效权重累加。学习的正 gain 以 $\gamma=\exp(\rho)$ 参数化并可直接求导。因此 CA 不需要对积分做数值求积,也不需要用离散近似反传(Sec. 2.5,Eqs. (23)–(35),PDF pp. 5–6)。
直接用闭式分式在 $\Delta\approx0$ 时会发生消减误差。作者在零附近用级数 $J_n(\Delta)=\sum_{r=0}^{\infty}\Delta^r/[r!(n+r+1)]$,一般区间使用稳定指数表达,并按 query 可见的最大 score 平移归一化。
计算量为每头 $\mathcal O(T^2d_h)$,与 dense softmax 同阶;显式物化完整权重矩阵需 $\mathcal O(T^2)$ 存储。分块可以减少保留完整矩阵的需求,但论文的 CUDA tiled 实现仍会物化中间 score/weight tile,因此 CA 不是线性复杂度注意力,也没有 FlashAttention 式线性显存保证(Sec. 2.6、Sec. 3.6,PDF pp. 6、10–11)。
2.5 小模型与大模型中的 gain
小模型控制实验分三类 CA:S 为 learned gain、初始温度 $\tau=1$;H 为 learned gain、初始 $\tau=0.30$;P 为固定 $\tau=0.30$。Softmax 控制 B$_{0.20}$/B$_{0.30}$/B$_{0.50}$ 为固定温度,F/G 为相应初始化的 learned gain。B$_{0.30}$ 与 P 的参数数目、初始 score scaling 和 Transformer 结构完全相同,因此 P 对 B$_{0.30}$ 是最直接的“连续积分机制”对照。大模型则让每个 head 学习正 gain,初始化 $\gamma=1$(有效温度 $\tau=1$)(Sec. 2.7、App. A,PDF pp. 7、15–16)。
三:实验设置
小模型:配对五种子控制
- TinyStories UTF-8 字节语言建模,256 符号;训练语料取训练 split 前 16M bytes。模型为 6 层、宽度 256、4 头、head dim 64、SwiGLU 维度 720、共享输入输出 embedding。
- 比较 context $T=192$ 与 $512$,每个长度训练预算均为 3.84M bytes;每个配置 5 个种子,共 8 配置 × 5 种子 × 2 长度 = 80 次训练。固定温度模型参数量分别约 5.01M 与 5.09M;learned gain 多 24 个标量。
- 主开发集使用官方验证流前 2M bytes,128 个采样 batch;额外不相交的 4M bytes 使用 256 个 batch。所有模型按训练种子和评估 batch 配对,报告五种子的 mean NLL 与配对 95% Student-$t$ CI。置信区间不做多重比较校正。
- 额外验证部分在加入 H/P 消融之前已被查看,因此作者将其称为 exploratory;下面将它与主开发集结果分开描述。
大模型:101M 参数字节级 decoder
- 256 字节词表,context 2,048,宽度 1,024,8 个因果 Transformer block、16 头(每头 64 维)、FFN 扩张 4 倍,RMSNorm、RoPE、GELU,无 dropout,约 101.2M 参数。
- FineWeb-Edu UTF-8 原始字节,50,000 optimizer steps,总计 26.2144B bytes;4 张 NVIDIA V100,FP16 和 gradient scaling,每步 524,288 bytes。AdamW,峰值学习率 $3\times10^{-4}$,2,000 步 warmup 后 cosine decay 到 $3\times10^{-5}$。
- 对照为约 100M 参数的普通 Transformer、FastWeight、Byte Latent Transformer(BLT)和 AU-Net;训练语料、字节 context、step budget、batch、scheduler、precision 和 GPU 对齐,参数数尽量匹配。
- 主语言建模指标 BPB 为所有预测字节负 log likelihood 除以 $\ln2$,越低越好;跨域结果和多选题均平均 3 个种子。
四:结果
4.1 五种子小模型:匹配温度后 CA-P 稳定占优
主开发集 Table A.1 的 mean NLL(nats/byte,越低越好):
| 配置 | Attention 设置 | $T=192$ | $T=512$ |
|---|---|---|---|
| B$_{0.30}$ | Softmax,固定 $\tau=0.30$ | 1.029903 | 1.174585 |
| G | Softmax,learned gain,初始 $\tau=0.30$ | 1.026097 | 1.200387 |
| H | CA,learned gain,初始 $\tau=0.30$ | 1.013707 | 1.127689 |
| P | CA,固定 $\tau=0.30$ | 1.009888 | 1.126540 |
P 相对参数与温度匹配的 B$_{0.30}$ 分别降低 0.020016 与 0.048045 nats/byte;配对 95% CI 分别为 [0.013779, 0.026253] 与 [0.033504, 0.062587],两种长度均五个 seed 全部支持 CA。H 相对 learned softmax G 的降低分别为 0.012389 与 0.072698;$T=192$ 的 CI [−0.004571, 0.029349] 包含 0,而 $T=512$ 的 [0.030012, 0.115383] 不包含 0。P 与 H 之间是否 learned gain 的比较没有清楚优势:两种长度 CI 都跨 0。因此主机制证据是控制 temperature 后的 CA-P 对 B$_{0.30}$,不是未经控制的 S 对任意 softmax。
额外 4M 字节验证:$T=192$ 的 CA-P 相对 dev 集选出的 G 低 0.016368 nats/byte,但 CI [−0.000134, 0.032870] 跨 0;$T=512$ 的 CA-P 相对 B$_{0.30}$ 低 0.045741,CI [0.031634, 0.059848]。该部分在 H/P 设计后被再次使用,属于 exploratory。来源:App. A.1–A.3,PDF pp. 16–18;Tables A.1–A.3。
4.2 训练数据效率与显存
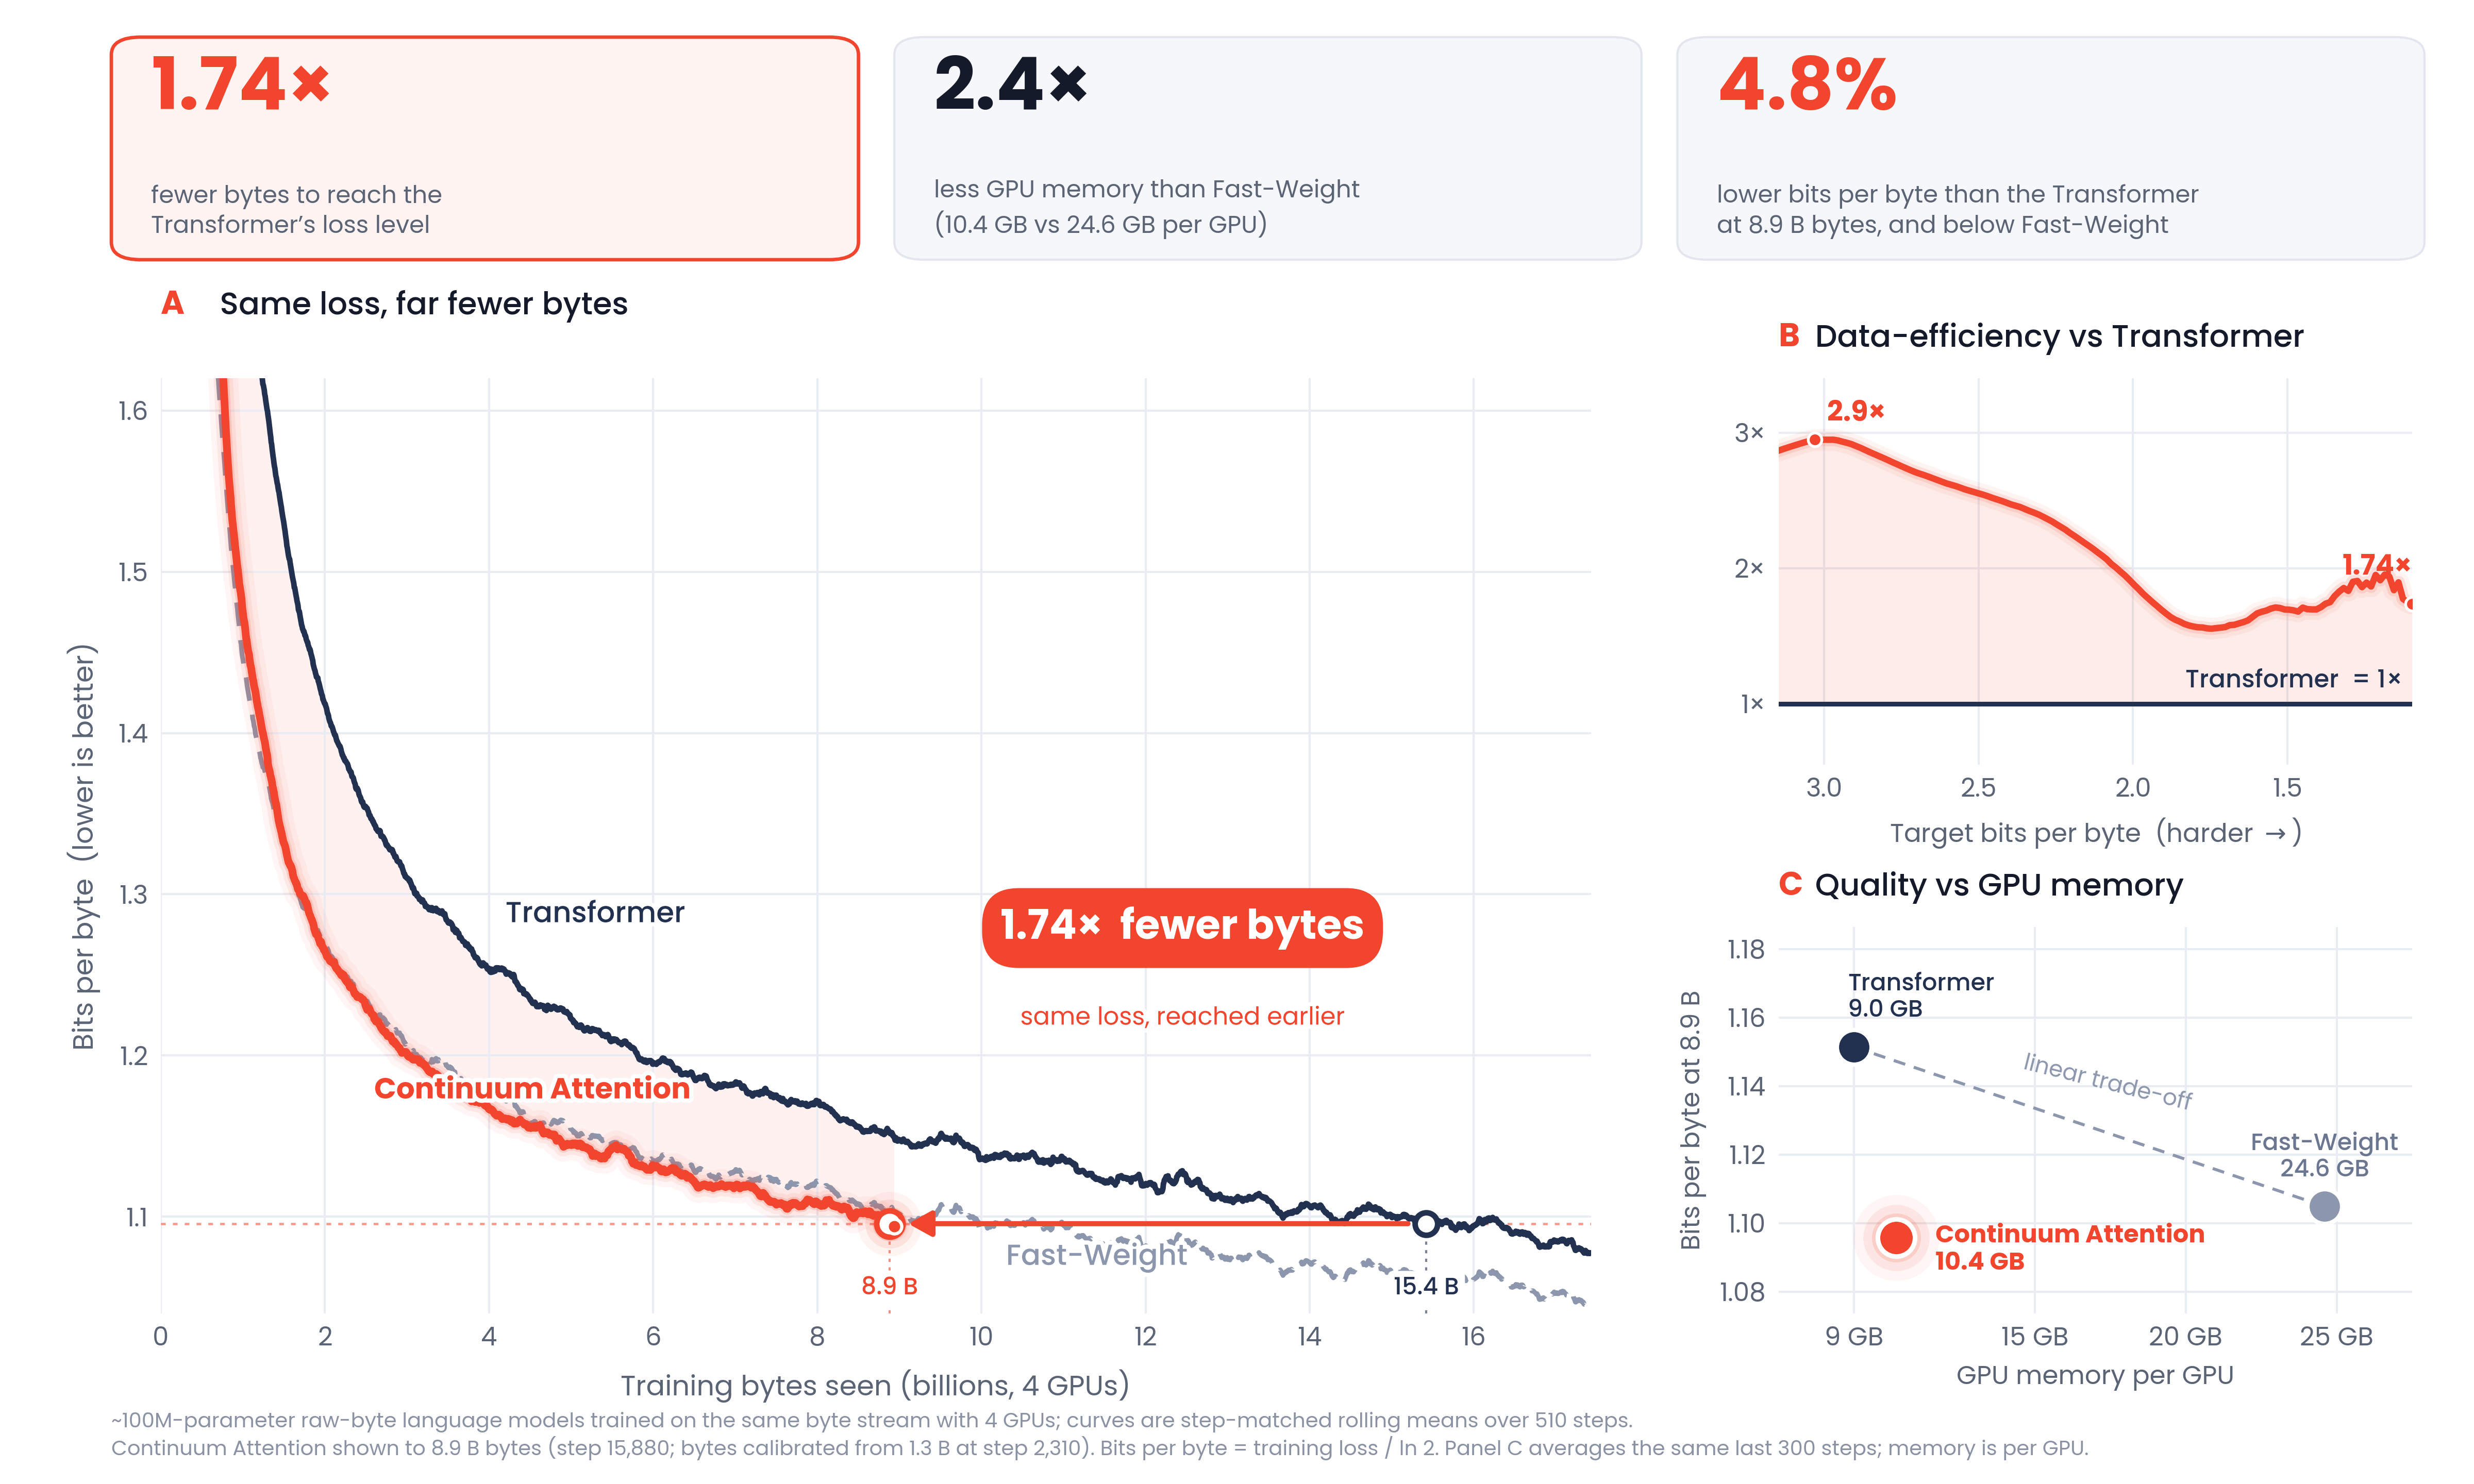
图左对齐四 GPU 上的原始字节训练曲线;右上展示达到相同 training BPB 目标相对 Transformer 所需字节比例;右下对比 8.9B bytes 时 loss 与显存。CA 在约 8.9B bytes 达到约 1.10 BPB,Transformer 约需 15.4B,按该目标测得 1.74 倍数据效率(约少 42% 字节)。在 CA 的 8.9B 比较点,报告 BPB 比 Transformer 低 4.8%。对应每 GPU 显存约为 CA 10.4GB、Transformer 9.0GB、FastWeight 24.6GB;CA 比 FastWeight 少约 2.37 倍显存,但比 Transformer 稍高。图中的数据效率是特定训练损失阈值下的比较,不是全流程训练吞吐的倍速。来源:Fig. 2,PDF p. 8。
4.3 跨域字节语言建模:优势集中在 FLORES
| Model | FineWeb-Edu | PG-19 | Stack-smol(代码) | FLORES 八语宏平均 |
|---|---|---|---|---|
| Transformer | 1.0457 | 1.4635 | 2.4474 | 2.0082 |
| FastWeight | 1.0187 | 1.4956 | 2.9558 | 2.0599 |
| BLT | 1.0336 | 1.5920 | 2.6138 | 2.0233 |
| AU-Net | 1.0319 | 1.4885 | 2.4894 | 2.0077 |
| Continuum Attention | 1.0229 | 1.4717 | 3.3451 | 1.8915 |
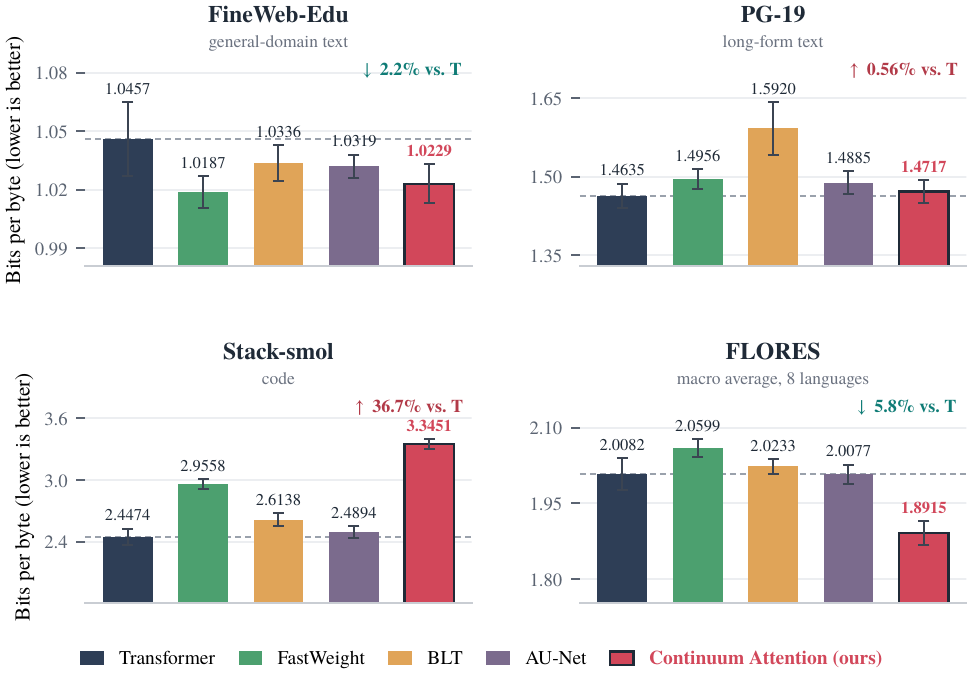
CA 在 FineWeb-Edu 与 PG-19 接近强基线,但在 Stack-smol 明显最差;最清楚的优势是 FLORES。图表中的 BPB 跨 3 个种子求均值,越低越好。来源:Sec. 3.3、Fig. 3 / Table 1,PDF p. 9。
4.4 FLORES 八语结果
CA 对每一种评测语言均取得最低 mean BPB,宏平均 1.8915;相对 AU-Net 的 2.0077 约低 5.8%。宏平均对八种语言等权,而非按样本或语言资源量加权。
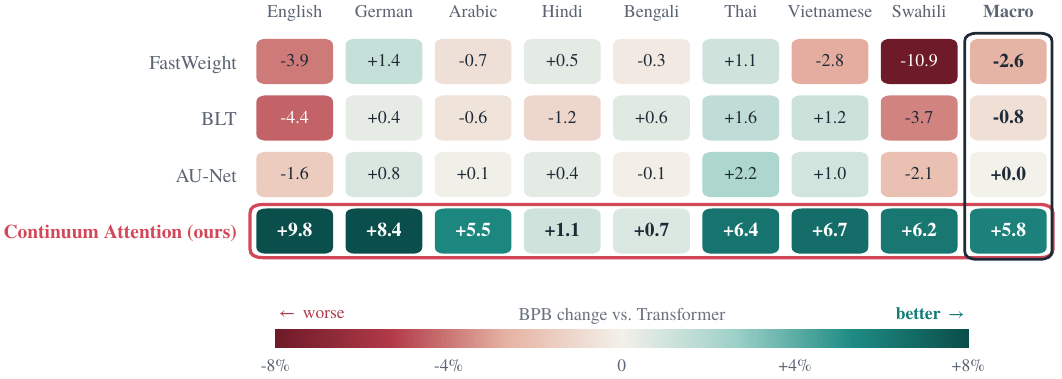
图中的百分数是相对 Transformer 的 BPB 改善,正数代表更低 BPB。CA 从英语 +9.8% 到孟加拉语 +0.7% 均为正值,八语平均 +5.8%;不同 baseline 并未在所有语言上都胜出。逐语种表见 Table 2,PDF p. 10。
4.5 零样本多选题与字节扰动
| Model | HellaSwag | PIQA | ARC-Easy | ARC-Challenge | 四任务均值 |
|---|---|---|---|---|---|
| Transformer | 28.81 | 60.55 | 35.96 | 22.74 | 37.02 |
| FastWeight | 29.95 | 60.61 | 37.72 | 20.07 | 37.09 |
| BLT | 28.80 | 60.55 | 33.16 | 21.07 | 35.90 |
| AU-Net | 28.64 | 60.66 | 34.67 | 20.86 | 36.21 |
| Continuum Attention | 30.70 | 60.23 | 34.04 | 23.08 | 37.01 |
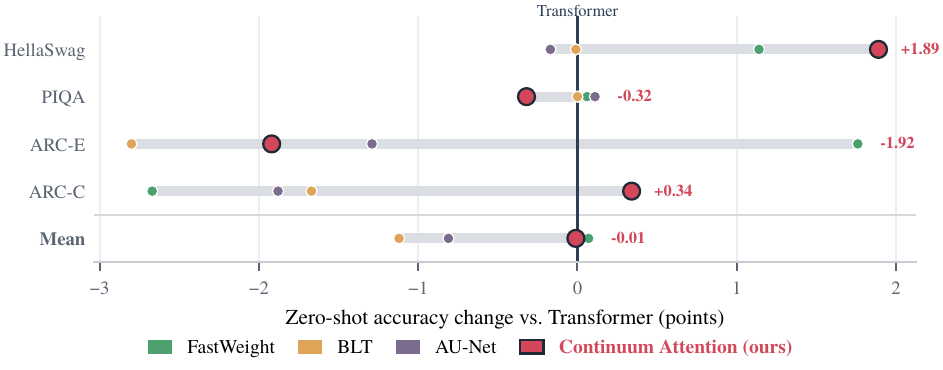
CA 在 HellaSwag 与 ARC-Challenge 数值最高,但整体均值 37.01 略低于 Transformer 37.02 和 FastWeight 37.09。差值单位为 accuracy percentage points;CA 相对 Transformer 在四项分别 +1.89、−0.32、−1.92、+0.34 pp。来源:Sec. 3.5、Fig. 5 / Table 3,PDF p. 11。
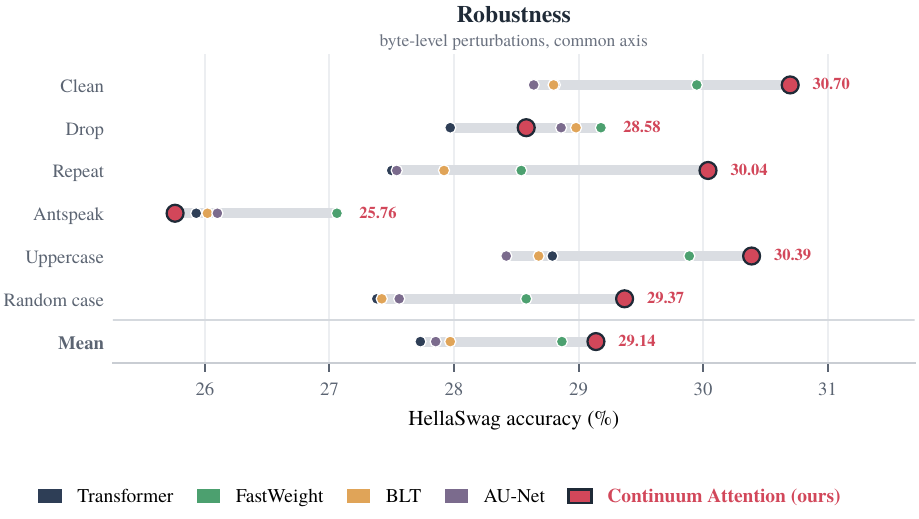
HellaSwag 字节级确定性扰动下,CA 在 clean、repeat、uppercase、random case 领先;FastWeight 在 byte drop 和 antspeak 上领先。CA 对 antspeak 的准确率从 clean 30.70% 降到 25.76%,因此不能概括成对任意字节扰动都更鲁棒。来源:Fig. 6 / Table 4,PDF pp. 11–12。
4.6 实现验证与运行速度
CUDA 实现将 query-prefix 切成 tiles,FP32 做 score 归一化,主要 QK 和加权 value 收缩用 FP16 tensor-core 矩阵乘;score weight 生成和解析 score 向量-雅可比积使用 CUDA kernels。测试在长度至 2,048 下将输出与独立参考计算核对;未来位置扰动不改变先前 attention 输出,前缀输出对未来 Q/K/V 的梯度为零,整模型也在 query tile 边界做了因果扰动测试。
V100 上、$B=2$、16 heads、$T=2048$、$d_h=64$ 的隔离 attention 前向+反向时间为 16.60ms(5.01ms 前向、11.59ms 反向);同形状 conventional tiled comparator 为 23.47ms,同一运行中 score-and-gradient fused comparator 为 19.52ms。这些数字是算子级时延,不是完整 decoder 的训练吞吐。单 V100、batch 8、2,048-byte context 的全模型 FP16 推理约 78,000 input bytes/s。代码和数值检查支持实现正确性,但论文没有据此建立对全 Transformer 训练的总体速度优势(Sec. 3.6,PDF pp. 10–11)。
五:结论与边界
CA 的方法贡献是将“在相邻 token 之间定义连续表示”落实为一个严格归一化、可解析求值和可解析反传的因果注意力算子。半 token 端帽令等 score 时回到均匀因果注意力;分段指数矩则让连续积分保持精确。
证据强度最清晰的部分是温度匹配的小模型比较和多语言 FLORES 表现。跨域结果并非一致提升:代码域 Stack-smol 上 CA 明显落后;多选题平均也未超过最强 baseline。效率方面,固定 gain 小模型在 $T=512$ 上训练吞吐约慢 7.3%,前向约慢 39.1%;大模型 CUDA 部分报告算子级计时,而不是训练端到端吞吐。CA 的算术仍是 $\mathcal O(T^2d_h)$,并会物化中间 attention tiles。当前结果来自 101M 参数、2,048 bytes 的主要模型实验;是否能扩展到更大模型、更长 context 和更广语域仍待验证。
参考定位
- 原文:Afshin Khadangi, Continuum Attention, arXiv:2610.20586v2。
- 作者官方代码:akhadangi/continuum-attention。