Cortex: Consolidating Context into Parametric Memory:中文精读
作者:Jintian Zhang、Feng He、Xinnian Liang、Ziwen Xu、Haoming Xu、Haojing Huang、Shuangzhi Wu、Ningyu Zhang
论文:arXiv:2610.20399v1(2026-10-14 提交);研读日期:2026-10-25
原文:本地 PDF
论文总览
这篇论文研究一个常见却容易被混淆的问题:模型读到一段知识、经验或指令时,回答明显变好;拿走这段上下文,提升又消失。作者称这部分可由上下文激活、但尚未写入模型的能力为记忆整合(Memory Consolidation, MC)的对象。任务要求同时实现两件事:让更新后的模型在不再看到原上下文时收回目标增益,并保住目标外的能力。作者提出 Cortex:让更新前的模型想象未来可能会问什么、在上下文中回答,再把“有上下文的教师”的输出分布和中间状态蒸馏给“无上下文的学生”;只训练 FFN 中可并入模型的低秩更新或新增非线性通道。(§2–3,PDF 第 3–7 页,图 2–3)
论文的主要实验证据跨越代理经验、近期 API 学习、人格倾向、知识抑制、事实编辑五类任务,以及单次、批量和连续更新。在最系统的连续实验中,Qwen2.5-14B-Instruct 接受固定的 50 条 zsRE 事实更新后,Cortex-Structural 达到 88.9% 目标增益恢复率、99.8% 非目标表现保留率;每次新增约 0.74M 参数,50 次累计 36.86M。这表明论文所测的事实集合能较稳定地写入小幅结构扩展,但最终可组合推理的 portability 只有 49.4%,明显低于直接事实命中的 95.3%。(§5.2,PDF 第 12–14 页;表 14,PDF 第 79 页)
结构地图
| 原文章节 | 作用 | PDF 位置 |
|---|---|---|
| §1 Introduction | 上下文收益消失的问题、总体贡献 | 第 1–3 页;图 1 |
| §2 Problem Formulation | 上下文增益、CR/RR、三种更新协议 | 第 3–4 页 |
| §3 Cortex | 前瞻性排练、FFN 写入、上下文到参数的蒸馏 | 第 4–7 页;图 2–3 |
| §4 Memory Consolidation Testbed | 五类任务、数据拆分与评价指标 | 第 7–10 页;图 4、表 1 |
| §5 Experiments | 单次/批量、连续编辑、六组消融 | 第 10–16 页;图 5–7 |
| §6–8 Related Work / Discussion / Conclusion | 与编辑、遗忘、上下文蒸馏等研究的关系及发展方向 | 第 17–20 页 |
| 附录 A–D | 表达能力条件、实验设置、完整结果、提示词 | 第 30–99 页;尤其表 10–20 在第 75–84 页 |
一:动机与问题定义
可利用信息与持久记忆之间的缺口。 设原模型为 $M$,暂时可见的上下文为 $C$,目标问题分布为 $Q_C^+$,不希望改变的保留分布或评分属性为 $Q_C^-$. 作者定义
当差值显著为正时,模型能用 $C$,却无法在移除它后保留收益;Cortex 处理这一类 memory failure。若有上下文仍做不好,差值很小可能是模型本身的能力问题,参数化记忆不能按本文定义替它解决。目标是产生 $M'=\mathcal A(M,C)$,以无源上下文推理,然后计算
CR 为 1 表示收回所测的全部上下文增益;RR 为 1 表示保留所测的原始表现。两者可超过 1,也可出现负 CR。理解比率要同时看分母:上下文增益需要足够大,原始保留分数也要有意义。$Q_C^+$ 和 $Q_C^-$ 可以是同一批回答的不同属性,例如人格倾向与语言流畅度。(§2,PDF 第 3–4 页)
三种协议。 单次更新只写一个上下文;批量更新把多个兼容上下文一起写入;连续更新从 $M_{t-1}$ 加入新上下文 $C_t$ 得到 $M_t$。连续协议在当前步不能取回旧源上下文,但可以保留旧问题用于回放;每步都要检查仍有效的历史更新,目标外能力参照最初的 $M_0$。(§2、§4,PDF 第 4、8–9 页)
作者选择参数写入,还有一个推理时的动机:检索式记忆必须先判断哪条旧经验与当前问题相关,间接相关性可能直到推理中途才显现;折入 FFN 的写入直接参加常规前向计算。论文把这作为设计理由,跨任务的间接联想优势仍是后续研究问题。(§1、§7,PDF 第 2、18–19 页)
二:Cortex 怎样把上下文写入参数
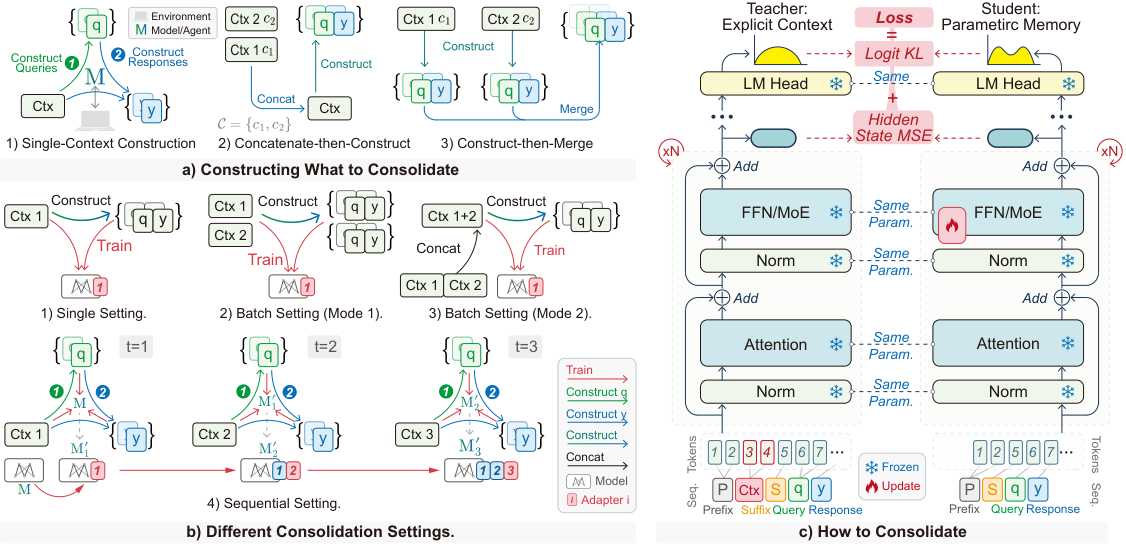
原图 2,PDF 第 5 页。左侧区分如何构造排练数据、如何安排更新;右侧是同参数教师与学生的不同输入。
1. 写什么:前瞻性排练
对于非代理任务,冻结的更新前模型先以 $C$ 生成未来可能的查询,再带着 $C$ 给出答案:
$$q_i\sim M(\cdot\mid I_q,C),\qquad y_i\sim M(\cdot\mid C,q_i).$$$I_q$ 是“预测上下文将怎样被使用”的生成指令。候选三元组 $(C,q_i,y_i)$ 可按任务过滤。这样形成的是由当前模型及当前上下文决定的训练分布,而不是开发者提前指定的下游问题分布。ALFWorld 和 $\tau^2$-Bench 是例外:问题来自训练环境,作者只保留成功的离线交互轨迹;整合阶段不再访问环境。评估问题及答案不参与排练与梯度训练。批量时可先拼上下文再生成样本,也可分别生成后合并样本;每个样本仍关联自己的教师上下文。(§3.1,PDF 第 5 页;附录 B.1,第 34–36 页)
这一步决定模型学到的“未来用途”范围。若生成的问题只覆盖直接复述事实,即使训练损失很低,也未必会在组合推理或环境变化中调用新知识。论文的 portability 差距正体现了这种覆盖问题。(§5.2,PDF 第 13–14 页)
2. 写哪里:Synaptic 与 Structural 两种 FFN 更新
以无偏置 SwiGLU FFN 为例,$F(x)=W_D[(W_Ux)\odot\operatorname{SiLU}(W_Gx)]$。作者冻结原权重,只训练两类小型写入:
Structural 新增 $k$ 个中间通道,$U_s,G_s\in\mathbb R^{k\times d_h}$,$D_s\in\mathbb R^{d_h\times k}$。它把新增行接到 $W_U,W_G$,把新增列接到 $W_D$,推理时可折入变宽的 FFN;Synaptic 则把低秩增量加回原矩阵。$k=r$ 时,单层 Structural 训练 $3kd_h$ 个矩阵参数,Synaptic 训练 $3r(d_h+d_{\mathrm{ff}})$ 个;前者较省训练参数,但会增长部署时的 FFN 宽度。连续更新的新增通道也逐次累计。(§3.2,PDF 第 6 页;附录 A,第 30–32 页)
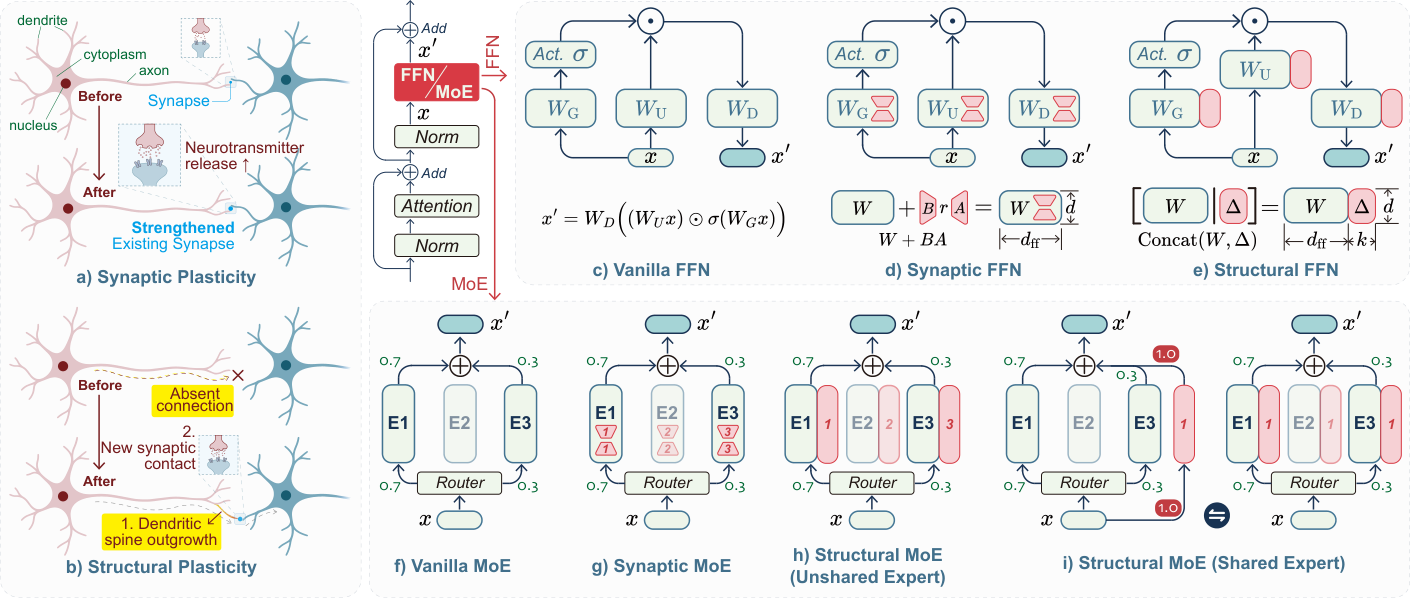
原图 3,PDF 第 6 页。生物图像提供设计启发;模型机制看 (c–i):Structural 增加独立非线性特征,MoE 版本让共享分支接收所有 token 的训练信号。
在混合专家模型(MoE)里,路由器权重冻结,但上游隐状态改变仍可能改变路由结果。独立扩展只能从选到该专家的 token 获得直接梯度;Cortex-Structural 使用每个 token 都经过的共享分支 $E_s$。若路由权重满足 $\sum_e g_e(x)=1$,则
$$\sum_e g_e(x)E_e(x)+E_s(x)=\sum_e g_e(x)\bigl(E_e(x)+E_s(x)\bigr).$$这给出把共享分支复制折入各专家的代数等价;若实际路由权重不归一化,额外共享分支仍可使用,但上述折叠恒等式不成立。折入每位专家也会复制存储及按激活路由重复计算,不能把“可合并”直接理解为零部署开销。(§3.2、附录 A,PDF 第 6、33 页)
3. 怎么写:上下文到记忆的蒸馏
教师是冻结的 $M_{t-1}$,输入为固定前缀、源上下文 $C$、固定后缀、查询 $q$ 和强制给定的答案 $y$;学生去掉 $C$,只训练当前新参数 $\psi_t$。两边对齐共有的 token 位置:输出端用温度 $T$ 的教师到学生 KL;每层 FFN 残差更新后的隐状态用 MSE,且按层数 $L$ 和隐藏维度 $d_h$ 归一化。概念上:
$\mathcal J$ 依任务选择答案/动作预测位置,或所有对齐的非上下文位置;两项损失使用同一集合。为降低目标储存量,只缓存教师 top-$K_v$ logits,并将教师在这 $K_v$ 个词上的概率重新归一化;学生仍用全词表归一化,因此该 KL 仍会惩罚落在教师 top-$K_v$ 之外的学生概率。另混入少量由模型自身回答的通用问题以保护非目标能力。(§3.3,PDF 第 6–7 页;附录 B.3,第 48–50 页)
隐状态 MSE 的作用可以从单层残差看出:当学生少看了上下文,注意力及其残差状态与教师不同,新增 FFN 分支要学习一个补偿 $R(u_i)=h_i^T-\bar h_i$。附录证明:固定新增特征矩阵 $\Phi$ 时,精确拟合有限状态的条件是目标修正矩阵 $\Delta$ 的行空间包含于 $\Phi$ 的行空间;更一般的最小二乘残差为 $\lVert\Delta(I-\Phi^\dagger\Phi)\rVert_F^2$。若特征可训练、输入满足定理条件且通道数 $k\ge n$,Structural 能插值任意 $n$ 个有限状态。它解释 FFN 匹配的表示可能性,不等于实际 $k=1$ 对未见问题的泛化保证。(附录 A,PDF 第 30–32 页)
连续更新还把历史问题放入最多 100 条的缓冲区,抽取最多 50 条,以当前 $M_{t-1}$ 在无旧上下文条件下重新生成答案;旧源上下文和旧答案不长期保存。此前的适配器保持启用但冻结。当前更新另有 16 条从 132 条固定通用问题循环抽取的例子,其答案、logits 和隐状态始终来自 $M_0$。因此“无旧上下文”仍有历史查询回放和通用能力约束,并非完全无历史数据。(§3.3、附录 B.2,PDF 第 7、39 页)
三:实验设计与可比性
| 任务 | 上下文与目标 | 保留口径 | 关键规模 |
|---|---|---|---|
| 代理经验 | ALFWorld / $\tau^2$-Bench 成功经验,目标为环境成功率 | MMLU、SimpleQA、数学 | 分别 134 个 unseen 游戏、100 个测试任务 |
| 新 API | 2025-11 至 2026-02 发布的 15 个 Python 包文档,目标为可执行测试通过率 | MMLU、SimpleQA、LiveCodeBench | 每包 10 题,共 150 题 |
| 人格倾向 | Power-seeking、Psychopathy 指令与目标行为 | 前者只测同一回答的流畅度;后者无 RR | 200 / 1000 条评估问题 |
| 知识抑制 | RWKU 10 个实体的拒答指令,目标为降低目标答案 ROUGE-L | 邻近实体知识、BBH | Forget L1/L2 与 Neighbor L1/L2 探针 |
| 事实编辑 | 50 个兼容 zsRE 事实,目标为直接命中、改写泛化、组合迁移的均值 | locality;批量/连续另测 MMLU、SimpleQA、数学 | 每事实四类问题、各 7 次生成 |
原表 1 与 §4,PDF 第 8–10 页;具体评估次数见附录 B.1,PDF 第 36–38 页。表中的“支持单次/批量/连续”是任务设计能力,不表示每一种任务与模型的笛卡尔组合都做了实验。
对照包括无上下文原模型 Vanilla、有上下文的原模型 Context、专用事实编辑和抑制方法、上下文蒸馏方法、超网络与测试时训练方法。可训练 baseline 使用目标 CR 的留出问题选择超参和训练时长,保留率不用于选择,再在目标测试问题上评估。在与 SDCD/SELF-PARAM 对照的 API 与编辑设置中,Cortex 分别使用每包 28 条、每事实 1 条排练问答,另有 4 条通用保留问答;因此图 5 的方法差异包括数据构造、优化目标、更新位置与参数容量,消融才逐项控制这些因素。(§5.1、附录 B.1,PDF 第 10、34–37 页)
连续编辑固定事实顺序、三个训练随机种子(43、44、45)。每次只用 2 条当前编辑 QA、最多 50 条历史查询回放和 16 条通用例子,AdamW 训练 30 epoch;教师 top-1024 logits,$T=2$,KL+MSE 权重各 1。每步评估此前所有事实,MMLU、SimpleQA、GSM8K 每五步在固定子集评估。目标聚合均值将 efficacy、generalization、portability 等权;保留均值将 locality 与三个通用基准等权。最后再用聚合分数算 CR/RR,不能先分别算比率再平均。(附录 B.2,PDF 第 39–41 页)
四:实验结果
单次与批量:恢复率和保留率必须一起读
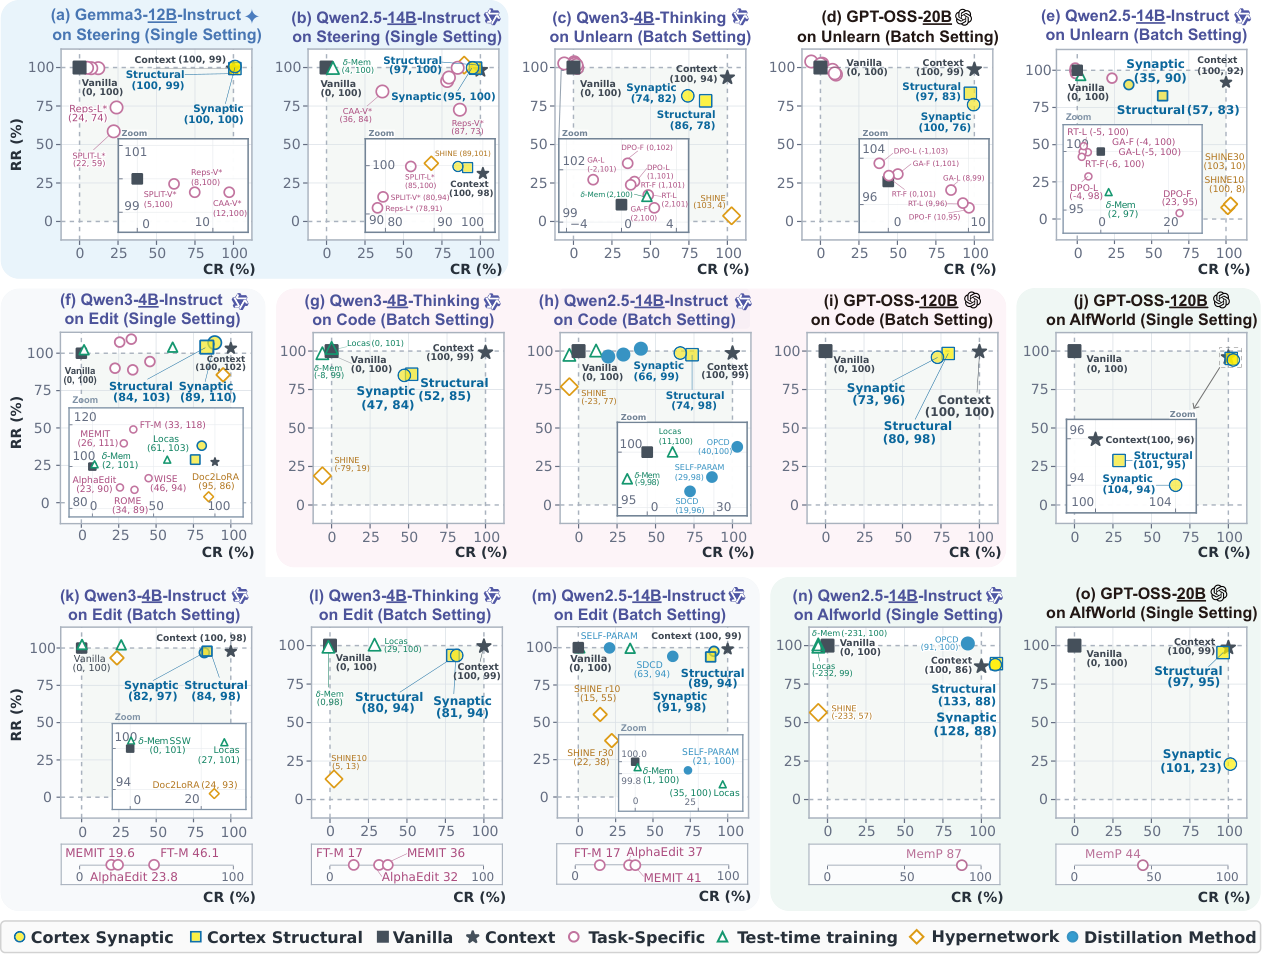
原图 5,PDF 第 11 页。横轴 CR,纵轴 RR;每个小图是一个任务—模型组合。黄色标记是 Synaptic、方形是 Structural;面板底部的细条显示 RR 不完整的方法的 CR。
在图 5 的 15 个面板里,至少一个 Cortex 变体位于可同时计算 CR/RR 的无上下文方法的经验帕累托前沿。典型结果:Qwen2.5-14B 的批量 API 学习,Synaptic 为 66% CR / 99% RR,Structural 为 74% / 98%;Qwen2.5 的批量编辑为 91% / 98% 和 89% / 94%。相同批量 API 任务的 OPCD 约为 41% CR / 100% RR;在批量编辑中,Synaptic 超过 SDCD 的 63% / 94%。(§5.1、图 5,PDF 第 10–12 页;表 11、13,第 76、78 页)
人格倾向是这组结果中的全局行为更新。在 Qwen2.5-14B 的 Power-seeking 上,Structural 获得 96.9% CR / 99.6% 流畅度 RR;Gemma3-12B 的 Structural 为 100.3% / 99.3%。这里的 RR 只来自同一批回答的流畅度评分,不能当作 MMLU 等通用能力保留率。Psychopathy 使用行为匹配准确率,没有报告 RR;例如 Qwen3-4B 的 Structural CR 为 98.0%。(§4.2、§5.1,PDF 第 9–11 页;表 17–18,第 82–83 页)
方法排序依任务改变:Structural 在八组代码学习比较中的六组 CR 更高,Synaptic 在八组事实编辑比较中的七组更高。单事实编辑里,Doc2LoRA 在 Qwen3-Instruct 达到 95% CR / 86% locality RR,高于 Cortex 的 84–89% CR,却低于其 103–110% RR;其批量编辑 CR 降到约 24%。批量 API 学习也会降低 Cortex 的恢复率:GPT-OSS-20B 从单包 91–93% 降至 15 包 45–59%,120B 则从 82–85% 降至 73–80%。这些比较指出批量互扰、目标恢复和保留之间的具体取舍。(§5.1、图 5,PDF 第 10–12 页;附录 C,第 75–81 页)
前沿不意味着每种设置都兼得高 CR/RR。GPT-OSS-20B 的 ALFWorld 中,Synaptic 约 101% CR / 23% RR,而 Structural 为 97% / 95%;保留率低主要来自通用基准崩塌。在 GPT-OSS-20B 的 $\tau^2$-Bench,Structural 为 38.5% CR,Synaptic 为 −92.3% CR:成功率分别 62.0%、56.3%,介于或低于 Vanilla 的 60.3%,而 Context 是 64.7%。这说明目标效果在不同交互环境里并不稳定。(§5.1,PDF 第 12 页;表 10、19,第 75、83 页)
知识抑制的局部代价也很突出。GPT-OSS-20B 上,Structural / Synaptic 的 CR 为 97.4% / 99.5%,但 RR 为 83.3% / 75.9%;相近实体的 Neighbor 分数明显下降,而 BBH 基本维持。论文用 $1-\mathrm{ROUGE\text{-}L}$ 作为目标的高为好分数,因此这些结果是“目标回答文本重合度降低”,并不直接证明参数中的事实已被擦除。(§4.2、§5.1,PDF 第 9、12 页;表 20,第 84 页)
连续编辑:高恢复率来自初始写入和后续保护
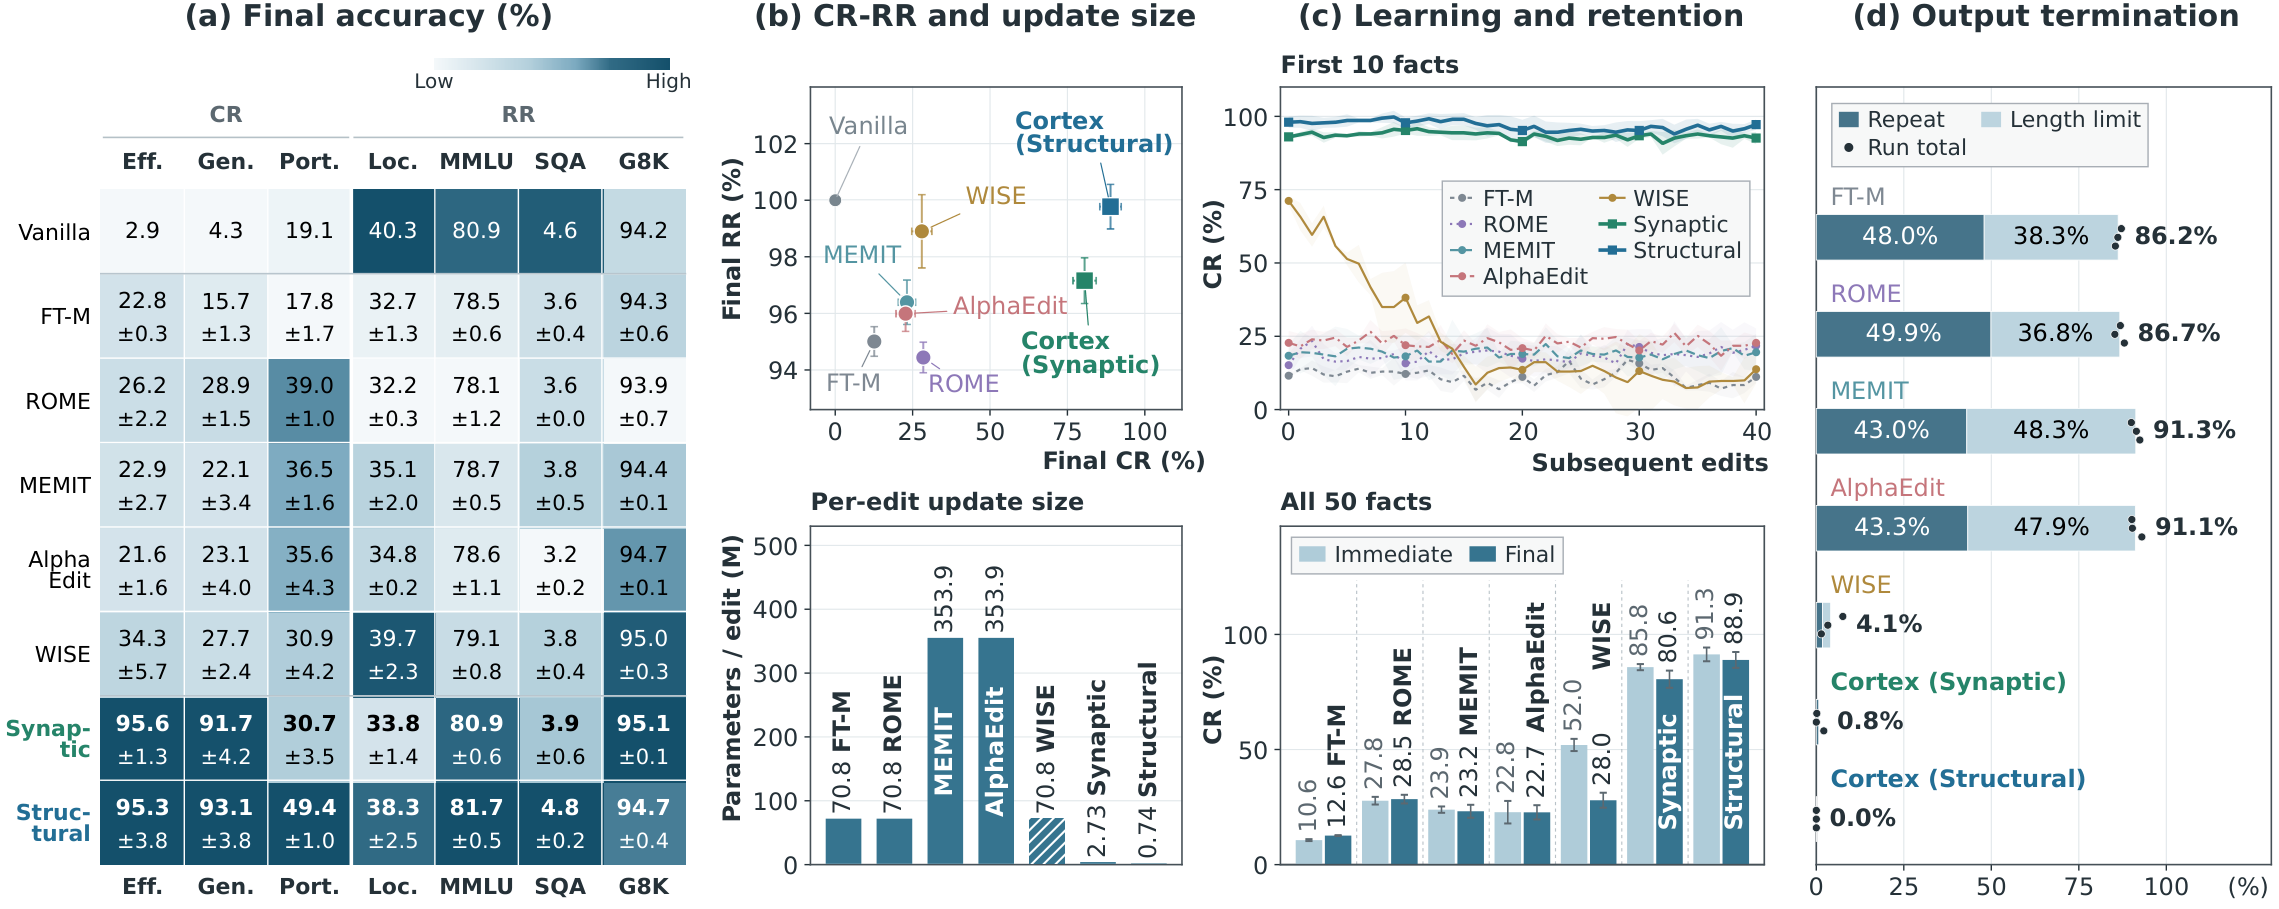
原图 6,PDF 第 13 页。(a) 各原始准确率,(b) CR/RR 与每次更新参数,(c) 初始习得对比最终保存,(d) 重复或长度限制导致的终止。
| 方法,50 次编辑后 | CR | RR | Efficacy | Generalization | Portability | 每次新增/修改 |
|---|---|---|---|---|---|---|
| Vanilla | 0.0% | 100.0% | 2.9% | 4.3% | 19.1% | — |
| 最佳外部 baseline(ROME,按 CR) | 28.5% | 94.4% | 26.2% | 28.9% | 39.0% | 70.78M |
| Cortex-Synaptic,$r=1$ | 80.6% | 97.2% | 95.6% | 91.7% | 30.7% | 2.73M |
| Cortex-Structural,$k=1$ | 88.9% | 99.8% | 95.3% | 93.1% | 49.4% | 0.74M |
原表 14,PDF 第 79 页。参数列按每次更新;Structural / Synaptic 在第 50 步累计为 36.86M / 136.40M。三个种子的标准差:Structural 的 CR 为 3.5 点、RR 为 0.8 点。
CR 的参考目标均值是 Vanilla 8.76%、带上下文 88.10%,Structural 最终目标均值 79.3%,由此得到约 $(79.3-8.76)/(88.10-8.76)=88.9\%$。RR 的原始保留均值为 Vanilla 55.0%、Structural 54.9%。这里的 99.8% 是四项分数的等权平均比值,其中 Structural 的 locality 从 40.3% 降到 38.3%,MMLU 从 80.9% 升到 81.7%,SimpleQA 从 4.6% 升到 4.8%,GSM8K 从 94.2% 升到 94.7%。所以它概括了所测项目的整体保留,并不代表所有邻近事实完全不变;SimpleQA 的基线本身也很低。(附录 B.2,PDF 第 40 页;表 14,第 79 页)
对同样的 50 个事实,Structural 的平均 CR 在各事实刚写入后为 91.3%,最终为 88.9%,仅下降 2.4 点;Synaptic 是 85.8% 到 80.6%,下降 5.2 点;WISE 是 52.0% 到 28.0%,下降 24.0 点。图 6(c) 上半部分只跟踪最早十个事实,在各自后续 40 次更新后,Structural / Synaptic 的均值 CR 仍为 97.2% / 92.6%。这两种统计的事实集合不同,不能混为同一个“遗忘率”。(§5.2,PDF 第 13–14 页;附录 B.2,第 40–41 页)
Structural 的优势尤其表现在组合问题:两个变体的最终直接命中率接近(95.3% 与 95.6%),portability 却差 18.7 点(49.4% 与 30.7%)。刚写入时已是 52.4% 对 36.1%,说明差别主要在初始获得,随后又有小幅流失。论文另统计在 512-token 窗口内,Cortex-Structural 的 700 条/种子原问题与改写回答中,重复或长度上限终止合计 0.0%;Synaptic 为 0.8%,FT-M/ROME/MEMIT/AlphaEdit 为 86.2–91.3%。这为一些 baseline 的低编辑分数提供输出退化的证据。(§5.2、图 6,PDF 第 13–14 页;附录 B.2,第 40–41 页)
六组消融:哪些部件真的起作用
| 问题 | 受控结果与解释 |
|---|---|
| 相同训练数据足够吗? | Qwen2.5 批量 API 中,Structural 比使用同数据的 LoRA-KL 高 23.0 个 CR 点;数据、蒸馏目标与写入位置共同影响结果。 |
| 更新 attention 有帮助吗? | 连续编辑 $r=4$、KL 条件下,仅 FFN 的 CR/RR 比包含 attention 的 LoRA-All 高 3.8 / 4.0 点,也使用更少训练参数。 |
| 旧问题回放有用吗? | 首 25 个事实在各自经历 25 次新编辑后,有回放的两变体正确率均超过 96%;去掉历史问题回放,Structural 降至 40.5%,Synaptic 降至 8.0%。固定的通用问题仍在,因此隔离的是历史编辑保护。 |
| 隐状态 MSE 的效果? | 连续 Synaptic $r=4$ 中,加入 MSE 使 RR 高 2.7 点、CR 低 4.0 点;Structural $k=16$ 则两者都提升。 |
| MoE 为什么共享? | GPT-OSS-20B 上按总训练参数匹配,共享分支在 ALFWorld / API 任务的 CR 高 4.6 / 10.3 点;按活跃参数匹配时只训练独立方案约 1/8 的扩展权重,CR 差在 2 点内。共享分支接收全部 token 的训练信号。 |
| 更新越宽越好吗? | 相同 KL+MSE 和训练设置下,$k=1$ 的 Structural 与 $r=1$ 的 Synaptic 在各自容量扫描中 CR 最高;这是该优化配方和 50 条编辑序列下的结果。 |
§5.3,PDF 第 14–16 页,图 7;实验细节与附图在附录 B.3,第 48–69 页。
自生成答案的控制实验尤其值得注意:固定排练问题、保持目标骨干的教师预填流程,只把答案来源从自身换成 Gemini 3 Pro,在 GPT-OSS-20B 批量编辑的 Synaptic 比较中,平均 efficacy 从 89.5% 降至 21.4%,MMLU 从 75.8% 降至 15.9%。这是该配对设置中答案分布匹配的强烈信号;它并不把所有外部教师概括为同样效果。(附录 B.3,PDF 第 69–70 页)
五:结论与进一步理解
论文最清晰的贡献是把“有上下文能做到、无上下文做不到”的缺口变成可归一化的目标,并同时要求非目标表现保留;Cortex 再用前瞻性查询、同模型有上下文教师、FFN 内可合并写入把这一目标落到训练流程。结果说明,在所测试的任务、模型和更新长度内,Structural 尤其适合把小批事实稳定累积为参数能力;作者的附录分析也解释了为何新特征能够补偿部分上下文缺失。(§2–5、附录 A,PDF 第 3–16、30–33 页)
实际取舍有三点。第一,连续编辑的稳定性依赖保留历史问题和对其回放;冻结旧参数并不能冻结旧预测。第二,接近 100% 的综合 RR 可与局部知识下降并存,抑制任务里这种局部外溢更显著。第三,Structural 的每步增量小,但 50 步容量会累计,训练又要求教师与学生计算隐状态及多轮优化;附录讨论将结构扩展后的修剪、合并和更大规模跨任务连续整合作为未来方向,而这些尚不是本文完成的实证结论。(§5.2–8,PDF 第 13–20 页;附录 B.2,第 39 页)