Learning to Compute Is Not Learning to Retain or Reuse in Looped Transformers:中文研读笔记
中文题意:循环 Transformer 学会计算,并不意味着学会保留答案或复用状态。
作者:Peilong Zhou、Hongtao Zhang、Yulong Huang、Cangyuan Li、Mingyu Chen、Ying Wang。前两位作者共同第一作者。
论文:arXiv:2610.19768v1,2026-10-14 提交;获取与研读日期:2026-10-15。本地原文 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为 PDF 页码,与本版印刷页码一致。
论文总览
循环 Transformer 将同一个网络块反复应用于隐藏状态,因而可以在推理时增加循环次数。但额外计算有时会把已经正确的答案变错,即过度思考(overthinking)。只看最终准确率,无法知道模型究竟没有完成计算、没有保存算出的答案,还是虽然输出正确,其内部状态却不能被后续计算直接复用。
本文用上下文内 Mealy 状态机执行任务,把这三件事分别测量:模拟器提供每一步的精确答案;跨输入替换一个隐藏向量,检验其能否驱动正确的反事实后续执行;在答案出现时冻结该位置的隐藏向量,检验它是否已经可以停止更新。论文的主要贡献是一套区分能力的实验,而非新的通用循环架构。
三个结果构成论证主线:
- 计算正确不保证答案保持。 只监督最后位置的模型,在长度 32、循环 32 时终点准确率为 100%,多跑到循环 64 后只有 22.33%。每个样本仍只监督一个位置、但将位置随机化,可把循环 64 的终点准确率提高到 99.80%。
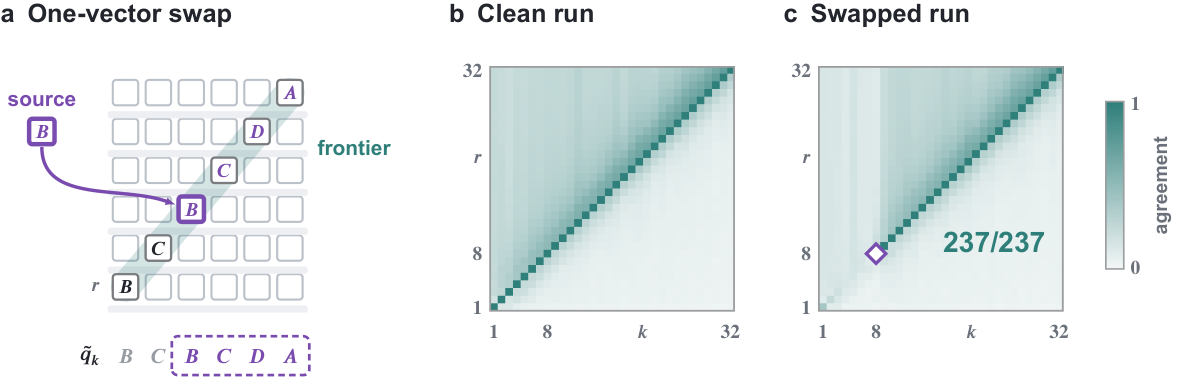
- 早期状态确实参与了计算。 在位置 8、循环 8 替换一个 128 维隐藏向量,10 个模型各自在全部 237 个有效样本对上,按各位置自己的计算时刻,精确执行源输入的后续 24 步。
- 答案保持不保证状态可以立即冻结。 上述 sampled-prefix 模型在答案首次出现时冻结各位置,终点准确率跌到 4.10%;延后两轮冻结恢复到 99.80%。隐藏状态在输出已经正确后,仍可能有后续计算需要的工作。
这里最值得保留的判断是:输出正确、输出稳定,与隐藏状态对下游是否仍然合用,需要不同的测试。[Sec. 3–5,PDF pp. 4–8;Fig. 2–4]
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 提出计算、保持、复用的区分 | pp. 1–2 |
| 2 A controlled setting for computation and retention | 状态机、循环架构、监督目标和指标 | pp. 2–4;Fig. 1;Eq. (1)–(4) |
| 3 Training to retain changes inference-budget robustness | 监督位置、退出深度、梯度路径的对照 | pp. 4–6;Fig. 2 |
| 4 Computation is exact, but its answers are transient | 单向量替换与精确反事实执行 | pp. 6–7;Fig. 3;Eq. (5) |
| 5 Answers become readable before their states become reusable | 缓存答案、冻结状态、延迟冻结及迷宫检验 | pp. 6–8;Fig. 4 |
| 6 Related work | 说明与过度思考、停止策略、因果干预工作的关系 | p. 9 |
| 7 Discussion and limitations | 贡献与可解释范围 | pp. 9–10 |
| A Experimental methods and scoring | 数据生成、模型、课程与严格评分定义 | pp. 12–15;Fig. A1;Table A1 |
| B Additional results and their scope | 训练细项、长度泛化、延迟替换及时间交叉 | pp. 15–22;Tables A2–A14;Figs. A2–A3 |
| C Local downstream recovery and source-phase controls | 用局部下游重置检验状态的时间兼容性 | pp. 22–25;Fig. A4;Tables A15–A17 |
| D Frontier freezing | 冻结协议、逐种子结果、外部迷宫模型 | pp. 25–30;Fig. A5;Tables A18–A26 |
| E Local recovery of the first natural failure | 定位从循环 32 到 33 的首次自然错误 | p. 31;Table A27 |
一:动机——“多算以后出错”包含不同问题
设一个位置的答案在第 $k$ 轮已经正确。之后可能发生三件不同的事:一是继续更新使其输出变错;二是输出一直正确,但同一隐藏状态在不同计算阶段不能互换;三是把该隐藏状态固定下来后,其他位置无法继续正确计算。前者是答案保持问题,后两者涉及状态与下游计算之间的兼容性。
这也说明,只训练在某个退出深度答对,不一定会形成稳定的解状态。作者将能力分解为:
| 性质 | 本文怎样判断 | 仅凭什么还不够 |
|---|---|---|
| 计算(computation) | 中间答案按时出现,且替换中间状态能驱动精确反事实执行 | 最终答案正确,或探针能读出中间标签 |
| 保持(retention) | 同一输入和参数下,继续循环仍能读出正确答案 | 某一个退出点准确率高 |
| 复用(reuse) | 位置状态被保持不变后,下游仍正确;补充实验检验跨运行、跨阶段替换 | 当前输出正确,甚至后续输出一直正确 |
正文对“可复用”的操作性定义主要是冻结后仍可供下游使用。附录的跨运行替换是另一种依赖时间和上下文的复用要求;延迟冻结成功,并不推出可以任意交换隐藏向量。
作者承认,过度思考、随机退出、计算前沿、隐藏状态替换都已有先例。本文的新意在于:让每个位置、每个读取时刻以及每个反事实执行都有明确目标,从而能在“答案刚出现”的时刻干预状态。[Sec. 1、6,PDF pp. 1–2、9]
二:方法——用可精确模拟的任务拆开三种能力
2.1 Mealy 机为什么适合做这个实验
Mealy 机有状态集合 $Q$、输入字母表 $\Sigma$、输出字母表 $\Gamma$、初态 $q_0$、转移函数 $\delta$ 与输出函数 $\lambda$。给定长度为 $H$ 的动作序列 $a_1,\ldots,a_H$:
$q_k$ 是第 $k$ 个动作执行后的状态;$y_k$ 是这次转移发出的输出,依赖转移前状态与当前动作。模型输入包括初态、整个转移表和动作序列,中间的 $q_k,y_k$ 只作为标签,不输入模型。[Eq. (1),PDF p. 2]
每台机器使用 4、6 或 8 个状态,2 或 4 个输入符号,以及 2 个输出符号。生成器保证所有状态可达,并筛选行为上最小的机器;随机重命名符号、打乱表行,降低固定命名捷径的作用。每个转移表项以包含“源状态、输入、目标状态、输出”的一个因子化 token 编码。全局分类命名空间为 16 个状态 ID 和 4 个输出 ID,因此输出头维度与单台机器实际使用的类别数不同。
它的关键优势是可以产生唯一确定的反事实目标:如果将位置 $c$ 后的状态改成另一条轨迹的 $q_c^S$,再执行原来的后缀动作,模拟器能精确给出后面每一步应该是什么。于是“模型输出发生变化”与“模型执行了正确的替代计算”可以严格区分。[Sec. 2,Appendix A.1,PDF pp. 2–4、12]
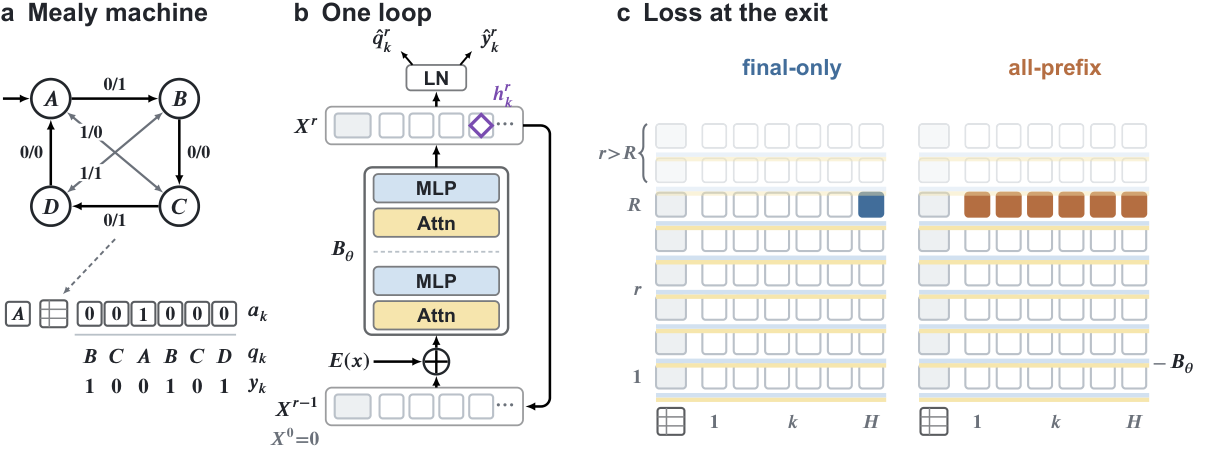
原图 1,PDF p. 3。左侧从状态机与动作得到逐位置目标;中间展示一个包含两层 Transformer 的共享块;右侧横轴是动作位置 $k$,纵轴是循环 $r$,有颜色的格子是最终退出轮接受监督的位置。all-prefix 的监督遍及位置,但没有遍及每一轮循环。
2.2 循环模型的状态与数据流
模型以零隐藏状态开始,每轮重新加入相同的输入嵌入:
其中 $X^r,E(x)\in\mathbb R^{T\times128}$,$T$ 为初态、表项与动作 token 的总数。$B_\theta$ 包含两个参数各自不同的 pre-LN Transformer 层,整个两层块跨循环共享权重。主模型宽度 128、4 个注意力头、MLP 宽度 512,无 dropout、位置嵌入或循环深度嵌入。[Eq. (2),PDF p. 3;Appendix A.2,pp. 12–13]
初态和转移表构成输入前缀,前缀 token 之间可以互相注意;动作位置 $k$ 只能访问前缀以及动作 $1{:}k$。因此相同呈现方式下,长度 $k$ 的输入与它在长序列中的前 $k$ 个位置,具有相同的未干预计算。
$h_k^r\in\mathbb R^{128}$ 表示第 $r$ 轮后动作位置 $k$ 的隐藏向量。模型对 $\operatorname{LN}(h_k^r)$ 应用共享的状态头与输出头。所有隐藏状态干预都发生在整个块结束后、最终读出归一化之前。这定位了本文究竟在替换什么,也限制了结果不能直接等同于某一层或某个 KV 缓存的冻结。
2.3 三种监督目标:改变的是位置覆盖
主比较固定训练退出轮 $R=H$。令 $\ell_{i,k}^{R}$ 为样本 $i$ 在位置 $k$、退出轮 $R$ 的状态交叉熵与输出交叉熵之和:
三个目标都只在退出轮施加损失,并按被监督的位置数取平均。final-only 与 sampled-prefix 每个样本都只监督一个状态—输出对;all-prefix 每个样本监督 $H$ 对。[Eq. (3),PDF p. 3]
在参数、批次与 $H$ 固定时,sampled-prefix 满足:
因此它是 all-prefix 平均损失的无偏估计,用来检验收益是否需要每个样本同时提供很多监督位置。它仍然需要中间轨迹标签,也不能由损失期望相同推断两个随机优化过程完全相同。[Appendix B.1,PDF p. 15]
训练课程包含长度 $1$ 到 $32$。由于动作注意力是因果的,在短序列上监督终点 $k$、退出轮 $k$,也会约束长序列中相同前缀的 $h_k^k$。final-only 因此主要要求沿对角线“及时算出”;all-prefix 与 sampled-prefix 还会在较长输入的退出轮 $H>k$ 要求位置 $k$ 保持正确。这解释了监督位置为什么可能改变保持能力。[Sec. 2,PDF p. 4]
2.4 指标:读哪里、什么时候读、要求多少位置正确
| 记号或指标 | 定义与口径 | 用途 |
|---|---|---|
| $A(H,r)$,终点联合准确率 | 在循环 $r$,最后位置 $H$ 的状态和输出同时正确的样本比例 | 终点能力及继续循环后的保持 |
| $T(H,r)$,整轨迹精确率 | 在同一循环 $r$,全部 $H$ 个位置的状态和输出都正确的样本比例 | 所有答案能否同时保留 |
| $\tau(k)$,首次正确前沿 | 状态准确率、输出准确率这两个边际比例都首次达到 99% 的循环 | 确定群体层面答案何时出现 |
| $s(k)$,指定读取时刻 | 实验预设;例如 $s(k)=k$,或所有位置都在 $r$ 读 | 区分按计算进度读与统一退出读 |
| 后缀精确率 | 有效样本对中,所有 $k>c$ 在指定时刻都与反事实状态、输出一致的比例 | 检验完整的替代执行 |
终点指标为:
首次正确前沿使用两个边际准确率,并非逐样本的联合保证;整轨迹精确率又比每个位置的平均正确率严格。所有表中准确率越高越好。[Eq. (4),PDF p. 4;Appendix A.3,pp. 13–14]
2.5 三种干预分别回答什么
跨输入替换(swap)。 source 与 base 使用相同机器、符号命名、表行顺序和后缀动作,只在位置 $c$ 及之前的动作不同,并要求 $q_c^S\ne q_c^B$。将 source 的完整向量复制到 base:
随后继续运行模型,而不输入任何符号答案。有效样本对要求事实与反事实后缀至少有一处不同;完全忽略干预的模型因而不能得到满分。后缀评分将每个位置的状态与输出都做联合判定。[Eq. (5),PDF p. 6;Eq. (6),p. 14]
答案缓存(readout cache)。 在未干预运行中,于 $s(k)$ 将预测保存到模型外部,内部状态照常更新。它检测答案是否曾经被算出。
状态冻结(freeze)。 在受干预轨迹自身运行到 $s_d(k)=k+d$ 时,捕获位置 $k$ 的向量;之后每轮块计算完毕,再写回该捕获值。其他位置正常更新,冻结位置仍可被注意力读取,输入前缀不冻结。下面是对协议的教学性写法:
这里的 $v_k$ 来自该干预分支本身;它并非从事先保存的干净轨迹逐位置拷贝。因此较晚捕获的位置,可能已经受到较早冻结引起的错误影响。实际实验仍计算全部块,再执行写回,没有直接节省 FLOPs。[Sec. 5;Appendix D.1、D.3,PDF pp. 8、25–28]
三:实验——训练对照与样本口径
3.1 共同训练配置
主要训练使用 132,000 步 AdamW、批大小 256,初始学习率 $3\times10^{-4}$ 并余弦衰减到零,权重衰减 0.01,梯度范数裁剪到 1。35 阶段课程逐步增加最大长度至 32。除初始阶段外,每个批次以 0.5 概率选择当前最大长度,否则均匀选择一个较短长度。所有主要比较使用固定的最后一步检查点,未按评测表现挑选种子。[Appendix A.2,PDF pp. 12–13;Table A1]
行为评测一般每个模型每种长度用 512 条轨迹,来自 16 台机器、每台 32 条轨迹。先在模型内部计算比例,再对模型种子等权平均。512 条轨迹并不代表 512 台相互独立的状态机。
3.2 哪些结果属于同一组比较
| 实验 | 模型与样本 | 需要保持的区分 |
|---|---|---|
| 主训练比较 | 5 条件 × 3 种子;共同流 20260923 | 原 final-only/all-prefix 检查点重新评测,不是新增独立训练 |
| 历史预算比较 | 6 配对种子;流 20260909 | Slack-4/Jitter-8 与历史 baseline 数值单列 |
| 位置 8 的替换 | 10 个 final-only 模型;共享 256 对,237 对有效 | 每个模型各自 237/237,不将复用样本对当新任务样本 |
| 位置 16 的延迟替换与重置 | 每条件 6 模型;256 对,主要切片 242 对有效 | 完整后缀、一步目标和不同替换范围用不同评分切片 |
| 新训练条件的冻结 | sampled-prefix 与 matched random exit,各 3 模型;流 20260924 | 与主保持实验使用不同评测流 |
| 外部迷宫 | 1 个发布检查点;每种尺寸 32 个迷宫 | 有任务和架构变化,没有训练种子重复 |
这一划分很关键:正文的 final-only 循环 64 准确率为 22.33%,历史六种子版本为 30.50%;它们对应不同样本流和种子集合,不能交叉拼成一张配对结果表。[Sec. 2,Appendix A.1、B.1–B.2,PDF pp. 4、12、15–18]
3.3 两组额外训练对照
退出轮是否变化。 保留 final-only 监督,比较 Slack-4 的 $R=H+4$ 与 Jitter-8 的 $R=H+U\{0,\ldots,8\}$。二者条件期望都为 $H+4$,训练中累计批级块应用次数只差约 0.062%。这控制的是循环工作量;该计数没有按实际序列长度加权,不能称为测得的总训练 FLOPs 相等。[Appendix B.3,PDF pp. 18–19]
随机退出还是截断梯度在起作用。 设 $m=H+8$,采样 $n\sim U\{0,\ldots,m-1\}$,再采样 $k\mid n\sim U\{1,\ldots,m-n\}$,若 $n+k progressive 在随机分支的前 $n$ 轮不保留梯度图,仅反传后 $k$ 轮;matched random exit 在相同输入、相同退出轮和损失权重下完整反传。完整 $m$ 轮分支始终保留全梯度。接受后的退出分布不是均匀分布,也不是 Jitter-8。两条件前向工作匹配,反向工作不同;作者的矩阵乘法代理分别为 $5.919\times10^{16}$ 与 $7.438\times10^{16}$ MACs,未包含所有训练开销。[Appendix B.1,PDF pp. 15–16] 共同流、长度 $H=32$、三个模型种子的均值如下。$A_r$ 是终点联合准确率,$T_r$ 是同轮整轨迹精确率,单位均为 %。[Table A2,PDF p. 16;Fig. 2,p. 5] final-only 从循环 32 的 100% 到循环 33 已降为 60.81%。输入长度完全没有变化,因此这是已解决样本在继续计算后的失败。相比之下,sampled-prefix 在同样每样本一个监督位置的条件下保持了几乎全部终点答案。这支持监督位置覆盖的作用,无需将收益解释为每个样本同时接收更多标签。 终点与整轨迹也必须分开理解。matched random exit 在循环 64 有 97.85% 的终点准确率,整轨迹精确率却只有 29.56%;sampled-prefix 的两项分别为 99.80% 与 96.03%。只要求最后一个答案能够在不同退出轮正确,与要求各中间答案也保存下来,形成不同的轨迹。 这里的 99.80% 是有限评测窗口内的保持。循环 96 时 sampled-prefix 的整轨迹精确率已降到 74.09%,并没有得到无限循环下的稳定性结论。三种子点估计也不足以建立 sampled-prefix 普遍优于 all-prefix 的排序。 原图 2,PDF p. 5。横轴为推理循环,纵轴为正确率;细线为单模型,粗线为均值。左上与右上分别展示终点和整轨迹,左下比较 Slack-4/Jitter-8,右下比较 progressive/matched random exit。阴影为训练退出轮支持范围。下方两组各自有不同的工作量匹配方式,不能把整张图理解为统一的等 FLOPs 排名。 历史六种子、长度 32 的等期望循环比较: 单位为终点联合准确率 %;来源为 Table A8,PDF p. 19。Jitter-8 在循环 64 比 Slack-4 高 55.54 个百分点,六对种子均有优势,而且循环 64、96 已超出其长度 32 训练退出范围 32–40。代价是共同循环 36 的均值下降 6.71 个百分点,一些种子也没有完全掌握训练长度范围。 progressive 与 matched random exit 的比较进一步排除“随机深度与截断梯度混在一起”的解释。progressive 的种子 9、11 在整个扫描范围内最高终点准确率分别只有 59.38%、52.73%,属于学习不充分;种子 10 能在循环 40 和 48 达到 100%,但循环 96 降至 26.56%。matched random exit 的三个种子都在循环 32 达到 100%。因此本任务配方没有显示截断梯度的额外收益。这里测试的是原 progressive 思路在该 Transformer/状态机设置中的改编,不能将结果直接推广成对其原始卷积架构的否定。[Sec. 3,PDF pp. 5–6;Table A3,p. 16] 将输入增至训练范围之外的 $H=64$,共同流结果如下: 单位为 %;来源为 Table A4,PDF p. 17。final-only 在自然对角线循环 64 上最好,但长期保持差;all-prefix 的初始外推均值更低,晚期保持更好。这说明“能把更长问题算对”和“算完以后不变错”是两条评测轴。 历史六种子的采样长度边界也呈混合变化:final-only 为 $[88,56,72,56,48,56]$,all-prefix 为 $[72,88,48,48,64,80]$,三升三降。边界定义为已评测长度中、按 $R=H$ 读出时终点联合准确率至少 99% 的最大长度,不保证所有中间长度均成功。[Table A11,PDF p. 20] 补充预算实验还显示,训练 $R=2H$ 的 Double 模型出现 $\tau(k)=2k-1$,在 $H=32,R=64$ 能达到 100%,强行在循环 32 读取只有 2.93%。计算前沿会随训练预算变化,不能把“每轮一步”视为该架构必然满足的定律;Double 的循环工作量也约为 Serial 的两倍。[Appendix B.3–B.4,PDF pp. 19–20] 位置 8 的实验在 $H=32$ 时,于循环 8 替换 $h_8^8$,然后按 $s(k)=k$ 读取位置 $9,\ldots,32$。256 个不同状态样本对中,237 对的事实与反事实后缀可区分;10 个模型中的每一个,均为 237/237 后缀完全正确。它不只改变紧邻的一个预测,而是产生长达 24 步的精确反事实执行。[Sec. 4,PDF p. 6;Appendix A.4,p. 14] 原图 3,PDF p. 7。中、右面板横轴为位置 $k$,纵轴为循环 $r$,颜色表示状态与输出联合匹配相应目标的比例。中间以 base 的正常轨迹为目标,右侧以 source 的反事实后续轨迹为目标。沿对角线的亮带表示答案在各自计算时刻正确;向上离开对角线后变淡,表示继续循环后读出退化。热图是 256 对、10 模型的平均,标出的 237/237 则是有效集合上的严格后缀指标。 若把所有位置都改为在循环 32 读取,7 个模型没有任何有效后缀完全正确,另外 3 个模型各只有 1 个。按时算对整个过程,不等于在同一退出轮还能同时读出整个过程。 这解释了 final-only 的整轨迹精确率接近零,仍可与精确的逐步计算共存。 定位扫描也支持前沿的因果作用:320/320 个循环—种子单元中,宽度一的替换造成的最大损伤在位置 $k=r$。但完整隐藏向量可能同时携带状态、历史、时序等内容;这个结果证明指定上下文中的充分性,没有提取出唯一的符号状态编码。后缀还可能在若干步后重新汇合,因此“全部后缀匹配”不要求源状态与原状态的区别一直维持到最后。[Appendix A.4,PDF p. 14] 最直接的比较是:在每个位置首次能正确读出时,保存它的答案,或保持它的隐藏向量。 原始冻结组包含 6 个 final-only、3 个 all-prefix 和 3 个较大 final-only 模型;较大模型宽度 512、每块四层,块参数量约为主模型的 32 倍。所有模型的答案缓存都保存了完全正确的 32 步轨迹;立即冻结隐藏向量后,整轨迹精确率却至多约 2%。错误并非小模型独有,也没有被 all-prefix 的保持训练消除。[Fig. 4b,PDF p. 7;Appendix D.1–D.2,pp. 25–26] 新冻结组进一步测试保持效果更强的训练条件。以下终点分数来自新流 20260924,每条件三种子、每模型 512 条长度 32 轨迹: 单位为 %;$d$ 表示在 $k+d$ 捕获位置 $k$。延迟冻结列在终点实际捕获轮 $r=32+d$ 评分,不是一律在循环 32 评分;这些分数在终点捕获后保持到循环 64。延迟列相应时刻的 clean 终点准确率全部为 100%。[Table A20,PDF p. 27;Tables A21–A24,pp. 29–30] 这个时间对齐不是细节:sampled-prefix 种子 10 在延后一轮的分支中,循环 32 时终点仍为 100%,实际到循环 33 捕获时却只有 82.81%。若只报循环 32,会把尚未发生的终点冻结误当作成功。 sampled-prefix 的延后两轮冻结,还达到 99.54% 的按各位置捕获时刻读取的整轨迹精确率;matched random exit 延后四轮达到 99.74%。不过后一组并非所有 clean 对角线读出都精确:种子 9 的最差位置联合准确率为 96.48%,缓存整轨迹精确率为 94.92%。因此 sampled-prefix 的三个完全正确 clean 轨迹,是“先算对、仍不能立即冻结”的更干净证据。[Appendix D.3,PDF pp. 27–28] 原图 4,PDF p. 7。a 为冻结轨迹示意;b 比较全部 32 个位置是否同时正确;c 显示错误随位置推进;d 横轴为捕获延迟、纵轴为实际捕获时的终点准确率。b/c 使用原始模型组,d 使用新增的两组模型,指标和样本组不能混用。 错误从哪里开始? 立即冻结时位置 1、2 仍正确,位置 3 首先失败。运行循环 3 前,位置 1 缺失了“答案已正确之后的循环 2 更新”,而位置 2 的循环 2 向量仍与 clean 一致。这个缺失更新使 final-only 的位置 3 准确率降到约 68%,随后错误沿序列累积。只冻结前 8 个位置、让后面 24 个位置正常更新,仍会严重破坏终点;sampled-prefix 和 matched random exit 的终点均值分别只有 7.49%、7.42%。这把问题指向冻结状态作为下游输入的作用。[Sec. 5,PDF p. 8;Tables A18、A20、A25] 怎样理解“还需要更新”? 作者提出,模型没有位置和循环嵌入,隐藏状态可能还承担顺序或时间信息,供后续位置寻找前驱。冻结会同时固定这些信息。实验没有区分这是时序信息、表征格式还是其他内部机制;它直接显示的是,在本协议下当前正确的状态尚不能停止演化。 位置 16 的实验补充了冻结以外的一条证据。all-prefix 在正常运行中一直保持正确,但将源向量的收集与插入都推迟 $a$ 轮,并按 $s(k)=k+a$ 读取后续位置时,反事实后缀精确率由 93.9% 降至 17.7%、10.2%、0%,分别对应 $a=0,1,2,4$;正常运行按相同读取时刻的事实后缀精确率始终是 100%。[Table A12、Fig. A3,PDF p. 21] 仅看这条下降曲线,仍混合了 source 状态变老与 base 整个运行进入晚期两个因素。时间交叉实验中,即使把原来循环 16 的新鲜源向量保留到循环 20 再插入,all-prefix 下一步反事实准确率仍为 0%;在循环 16 原位插入则为 94.63%。于是附录 C 固定其余网络处于循环 20,只改变两处: 第二处来自 base 自己的早期向量,没有把 source 在位置 17 的答案塞入网络。两处同时干预后,再运行一轮,于循环 21 读取位置 17。[Eq. (7),PDF p. 23] 单位为一步反事实联合准确率 %,每条件六种子均值、242 个有效样本对;来源为 Table A15,PDF p. 24。all-prefix 不干预时的 0% 是反事实匹配率,其事实准确率为 100%;不能把此处的零解读成模型本身已经不会计算。 原图 A4,PDF p. 23。左侧标记新鲜源与老化源的收集轮数、位置 17 的重置以及实际读出位置;右侧展示 all-prefix 六个种子的反事实匹配率,横轴为百分比。联合恢复几乎回到早期参考值,而老化源加重置只达到重置本身的水平。 all-prefix 的新鲜源和老化源,原输出头都能 100% 正确读出状态与输出,但它们不能在同一接收条件下互换。新鲜源与下游重置的配对交互量: 在 all-prefix 中为 $+68.39\pm10.54$ 个百分点;$\pm$ 为六个模型种子的样本标准差。老化源的对应交互仅为 $+0.14\pm0.34$ 个百分点。这支持局部下游状态与源状态共同决定接收效果。它只恢复了一个位置、一次更新,不能替换为“恢复整个后缀”的表述。[Eq. (8),PDF p. 23;Appendix C.2–C.4,pp. 23–25] 同符号状态、不同历史的替换也会损伤预测,因此完整向量不是纯粹的符号状态按钮。只重置下游时,同状态对的 all-prefix 事实准确率从 100% 跌到 25.13%;重置是强干预,而不是通用纠错步骤。另一个替换范围对照在循环 20 读取位置 21 时,替换当前前沿位置 20 可达 100%/93.5%,只替换旧位置 16 则为 0%/0%。但两处到目标的距离不同,这个结果只能作为有效干预位置的参照,不能单独证明旧位置的信息已被擦除。[Tables A14、A17,PDF pp. 22、25] 作者使用已发布的 迷宫没有与位置 $k$ 对应的统一前沿。作者将每个像素在完整 clean 轨迹中最后一次预测变化视为答案到达时刻,再于该时刻或延迟后冻结像素状态。这使用后续轨迹确定时刻,属于离线诊断,不能直接当作在线早停规则。 来源为 Table A26,PDF p. 30;协议与局限见 Appendix D.4,pp. 28、30。小迷宫已经整体解出后统一冻结是安全的;更大迷宫仍在计算时统一冻结则失败。该模型的输出头使用 $3\times3$ 卷积,因此冻结某个像素状态不一定固定其输出:邻近状态仍会影响读出。这与 Transformer 的逐位置输出头不同,不能把两者逐像素指标完全等同。 附录 E 选出循环 32 终点正确、循环 33 错误的样本集合 $E$。在循环 32 结束后,将位置 31、32 分别或同时重置为其自身循环 31 的状态,再运行一轮。主模型六种子合计有 771 个这类失败样本: 恢复一部分原本失败样本,并不表示总体更好:仅重置位置 32 同时破坏了大量原本正确的样本。联合重置则在所测循环恢复全部失败且不损伤原来正确的样本。较大模型也恢复了 79/79 个失败样本。[Table A27,PDF p. 31] 联合重置保留了前 30 个位置的晚期状态,在最后两处近似重放上一轮已成功的计算,因此说明这两处联合恢复足够重建首次失效的输出。但主模型继续到循环 34 后准确率又降至 63.7%,低于 clean 的 65.5%;较大模型则为 93.4%,高于 clean 的 76.8%。这个局部恢复没有建立持久修复方案,也没有识别具体的注意力电路。 本文最强的贡献是把一个模糊的“过度思考”现象拆成可检验的命题。监督位置覆盖和退出分布可以大幅改善答案保持;精确反事实替换显示,严重的晚期退化可以发生在一条曾经完全正确的计算轨迹之后;冻结实验进一步显示,答案保持得好,也不代表状态在答案刚出现时就能停止更新。 这为逐位置早停提出了一个具体问题:停止标准必须考虑该位置对尚未完成计算的位置有什么作用。 在本文受控设置下,等待若干轮可以恢复冻结后的性能,但所需延迟随模型与训练条件变化,作者没有提出可直接部署的安全停止算法。答案缓存保住已出现的结果时,模型内部仍在继续计算,所以它也不是已经验证的省算力方案。 本次分析认为,一个有价值的后续方向是将“答案读出何时稳定”与“供下游使用的状态何时可以固定”分别建模,再测试这种区分能否带来实际计算节省。这个方向来自实验启发;本文未训练这样的双目标停止机制,也未报告实际推理加速。 对结论影响最大的范围限制集中在三处:主要证据来自一个合成执行任务与一个基本循环架构;新训练控制只有三种子,且 sampled-prefix 依赖中间标签;全向量干预同时影响符号内容、历史和时间信息,因而支持功能层面的分离,尚不足以识别其微观原因。外部迷宫实验拓宽了观察范围,但一个检查点、每尺寸 32 个迷宫的结果,仍不足以确定大型语言模型中的同类状态何时可安全停止。[Sec. 7,PDF pp. 9–10] 组会讨论最值得追问的是:如果一个隐藏状态持续输出相同答案,它仍在为谁、以什么形式继续工作?本文给出了这种工作确实存在的因果证据;具体由哪些表示和计算承担,仍有待进一步定位。四:结果——逐步建立“计算、保持、复用”的分离
4.1 监督位置覆盖显著改变答案保持
训练条件 $A_{32}$ $A_{64}$ $A_{96}$ $T_{32}$ $T_{64}$ $T_{96}$ final-only 100.00 22.33 22.07 0.00 0.00 0.00 all-prefix 100.00 94.27 82.16 100.00 74.28 67.45 sampled-prefix 100.00 99.80 96.61 100.00 96.03 74.09 matched random exit 100.00 97.85 86.26 74.09 29.56 11.52 progressive 69.27 58.53 38.09 12.37 0.00 0.00 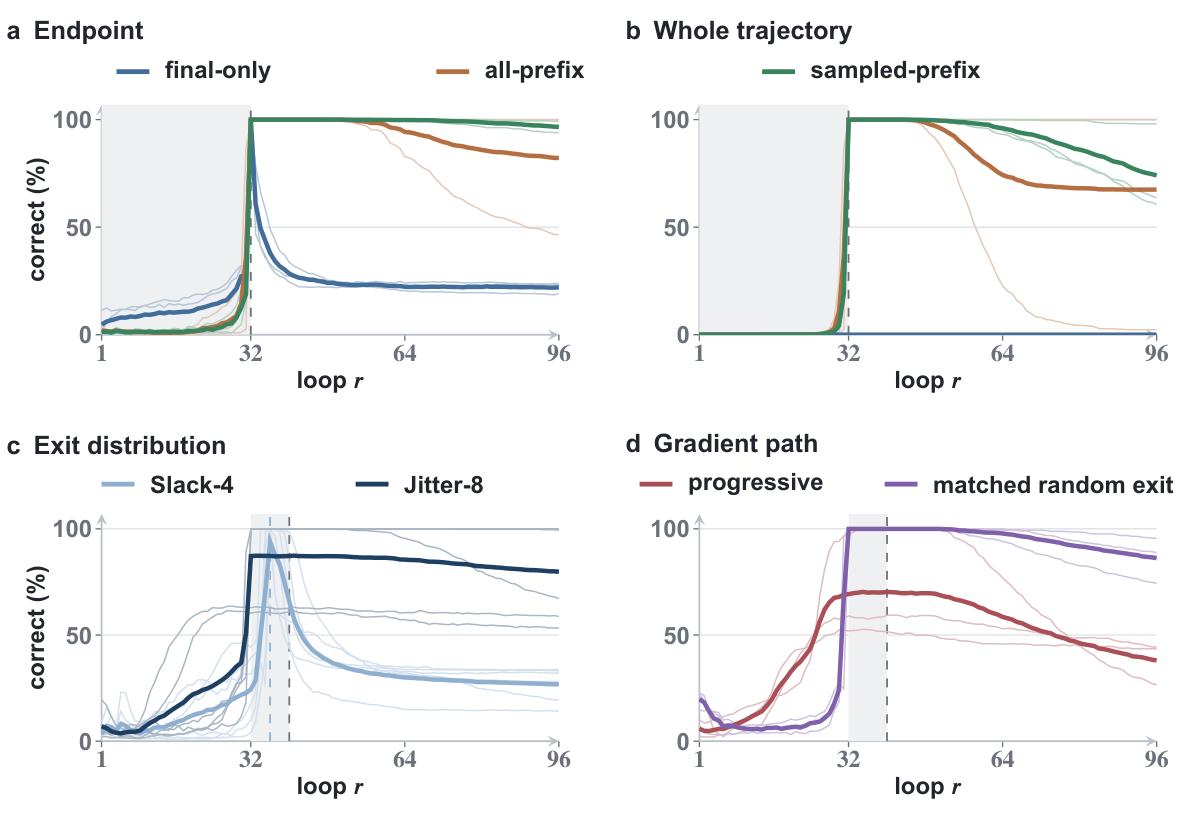
4.2 随机退出有帮助,截断梯度在本配方中妨碍学习
条件 循环 36 循环 48 循环 64 循环 96 Slack-4 93.98 38.15 30.01 26.79 Jitter-8 87.27 87.17 85.55 79.79 4.3 保持能力与长度外推的排序不同
条件 $A(64,64)$ $A(64,192)$ final-only 97.79 17.12 all-prefix 76.69 72.72 sampled-prefix 85.87 60.61 matched random exit 86.07 53.71 progressive 33.92 17.19 4.4 单向量替换证明了精确的后续计算
4.5 冻结实验:输出已正确,状态仍需更新
条件 clean,$r=32$ 答案缓存 $d=0$ $d=1$ $d=2$ $d=4$ sampled-prefix 100.00 100.00 4.10 80.21 99.80 100.00 matched random exit 99.93 99.93 6.25 20.18 87.24 99.80 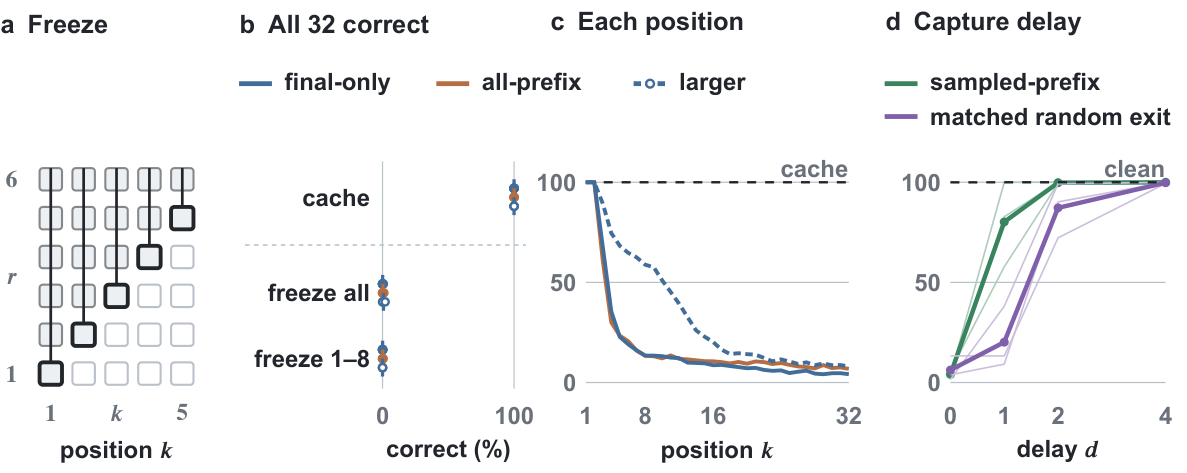
4.6 延迟替换与下游重置:复用取决于两端的计算阶段
对照或晚期干预 final-only all-prefix 早期插入新鲜源的参考值 100.00 94.63 不干预 16.67 0.00 仅插入新鲜源 26.72 0.00 仅重置下游 19.63 26.17 新鲜源 + 下游重置 100.00 94.56 老化源 + 下游重置 19.70 26.31 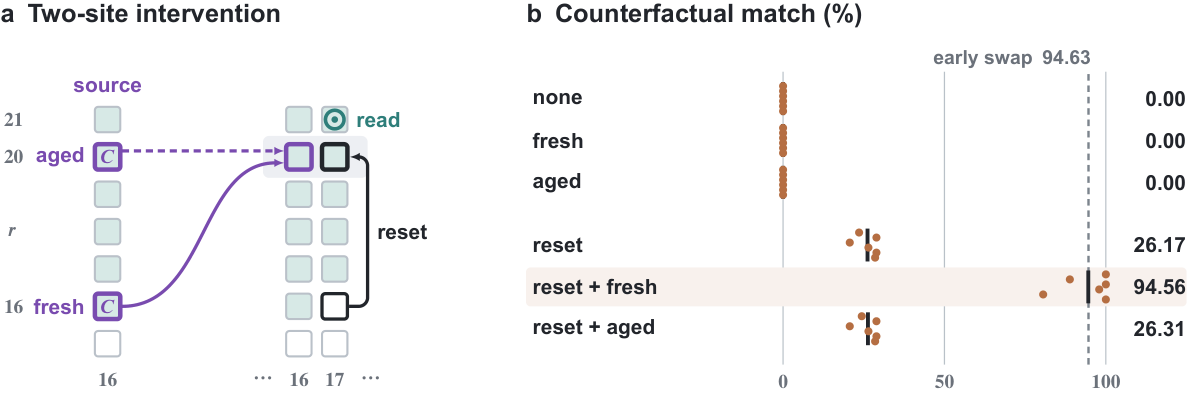
4.7 外部迷宫模型也存在答案出现与状态可冻结的间隔
dt_net_recall_2d 检查点:宽度 128,以 progressive loss 在 $9\times9$ 迷宫、30 次迭代条件下训练。它在所有 32 个测试迷宫上,从迭代 25 到 120 始终正确,因此没有观察到已解答案遗失。条件 $9\times9$,迭代 120 $33\times33$,迭代 120 正常运行 32/32 19/32 仅缓存答案 32/32 19/32 到达时立即冻结 0/32 0/32 延后 1 轮 3/32 0/32 延后 2 轮 28/32 2/32 延后 4 轮 32/32 18/32 所有像素统一在迭代 30 冻结 32/32 0/32 4.8 自然错误的局部恢复:能定位,尚不能持续修复
重置位置 恢复的失败样本数 循环 33 所有样本准确率 不重置 0/771 74.9% 仅位置 31 585/771 89.5% 仅位置 32 143/771 35.2% 位置 31 与 32 771/771 100.0% 五:结论——这篇论文怎样改变对循环推理的评测