Copy-Paste Language Models:中文精读笔记
作者:Nathan Godey、Yoav Artzi(Cornell University)
论文:arXiv:2610.19247v1,2026 年 10 月 13 日提交;本次研读于 2026 年 10 月 23 日。
原文:本地 PDF · arXiv 页面
论文总览
语言模型经常需要复用上下文中的词,但标准输出层必须先把当前隐状态投影到整个词表。作者提出 Copy-Paste Language Model(CPLM):保留普通 LM head,再加一个对历史位置打分的 Copy-Paste(CP)head;LM head 输出 <copy> 概率作为门,CP head 的 <sink> 又允许退回普通预测。两路概率在词表上混合,仍用标准下一 token 交叉熵端到端训练,无复制标签或辅助损失。
论文的关键解释是训练信号:普通 LM head 把大词表上的梯度压到较小的隐维度;CP head 对上下文位置预测,提供另一条较少受此瓶颈影响的梯度路径。作者在 135M–1.7B 预训练、不同注意力骨干、SFT、长上下文和文档检索中报告收益,并用梯度截断与字节级实验检验这一解释。最醒目的应用是 256-token 滑窗骨干:保留每个历史 token 的一份 CP key 后,它能在长上下文中直接定位要复制的词。(Sec. 1–4,PDF pp. 1–9)
结构地图
| 原文章节 | 解决的问题 | PDF 页码及主要证据 |
|---|---|---|
| 1 Introduction | 为什么显式复制仍有价值 | pp. 1–2,Fig. 1 |
| 2 Method | 两个输出头、复制门、sink 和混合分布 | pp. 2–3,Eqs. (1)–(7) |
| 3 Experiments & Results | 预训练、SFT、长上下文与检索 | pp. 4–8,Figs. 2–5,Tables 1–3 |
| 4 Analysis | 梯度瓶颈和归纳头的机制解释 | pp. 8–9,Figs. 6–7 |
| 5 Related Work;6 Conclusion | 与指针、缓存等工作的关系及边界 | pp. 9–10 |
| Appendices A–H | 配置、开销、消融、评测细节和机制干预 | pp. 18–32,Tables 4–16,Figs. 8–18 |
一:动机——复制为什么会卡在输出端
作者统计:FineWeb-Edu 中约 60% 的 token 在前面的 4k-token 上下文出现过。自注意力确实能找到早先位置,但普通 LM 最后仍通过固定矩阵 $W\in\mathbb{R}^{V\times D}$ 输出词表概率;这里词表大小 $V$ 通常远大于隐维度 $D$。这既限制可表示的输出分布,也使反传时 $V$ 维 logit 梯度先被 $W^\top$ 压到 $D$ 维。论文关心的是:若让模型直接对位置预测,并把复制结果映回 token,能否改善学习和推理?(Sec. 1–2.1,PDF pp. 1–3)
指针网络和复制机制并非本文首创。作者明确把新贡献放在现代 decoder-only LM 的预训练及梯度瓶颈解释上:已有注意力能读取历史信息,新增输出路径仍可能改变模型怎样学习这件事。与只在推理时外挂缓存相比,这一路径从预训练开始参与反传。(Sec. 1、5;Appendix C.5,PDF pp. 2、9–10、24)
二:方法——从历史位置直接预测 token
设前缀为 $x_{\le t}$,当前隐状态 $h_t\in\mathbb{R}^D$,下一 token 属于词表 $\mathcal V$。普通头给出 $p_{\mathrm{LM}}(v\mid x_{\le t})=\operatorname{softmax}_{u\in\mathcal V}(w_u^\top h_t)_v$。CP head 用当前状态生成 query、用每个历史状态生成 key:
默认 $W_Q,W_K\in\mathbb R^{D\times D}$。对位置归一化后,把相同 token 的位置概率相加,得到词表上的复制分布:
例如前缀里某词出现两次、位置概率分别为 0.2 和 0.3,它的复制概率就是 0.5;不在前缀中的词复制概率为零。这里查的是历史位置及该位置的 token,与附录对照的 neural cache “匹配旧状态后取其下一个 token”不同。(Sec. 2.2,Eqs. (2)–(3),PDF p. 3;Appendix C.5,PDF p. 24)
LM head 增加只用于控制复制的 <copy> token,其 softmax 概率为 $c_t$;普通词表分布 $p_{\mathrm{LM}}$ 单独在真实词表上归一化。CP head 另有可学习的 <sink> key;$s_t$ 是在 sink 与历史位置共同归一化时分配给 sink 的概率。最终有效复制权重为 $\lambda_t=c_t(1-s_t)$:
这个式子同时说明两件事:<copy> 开启复制;即使开启,若当前位置不适合复制,sink 也能把概率送回普通头。两个分布的凸组合保证输出仍是合法词表分布。训练只对混合分布做下一 token 交叉熵,门、位置匹配和骨干一起学习。采样时可以先抽普通头含 <copy> 的分布;仅抽到 <copy> 才计算位置注意力,再由 sink 决定是否回退,这是对该混合分布的精确两阶段采样。贪心解码不能简单地把两阶段各自取 argmax 当作混合分布 argmax。(Sec. 2.2,Eqs. (4)–(7),PDF p. 3;Appendix C.4,PDF p. 23)
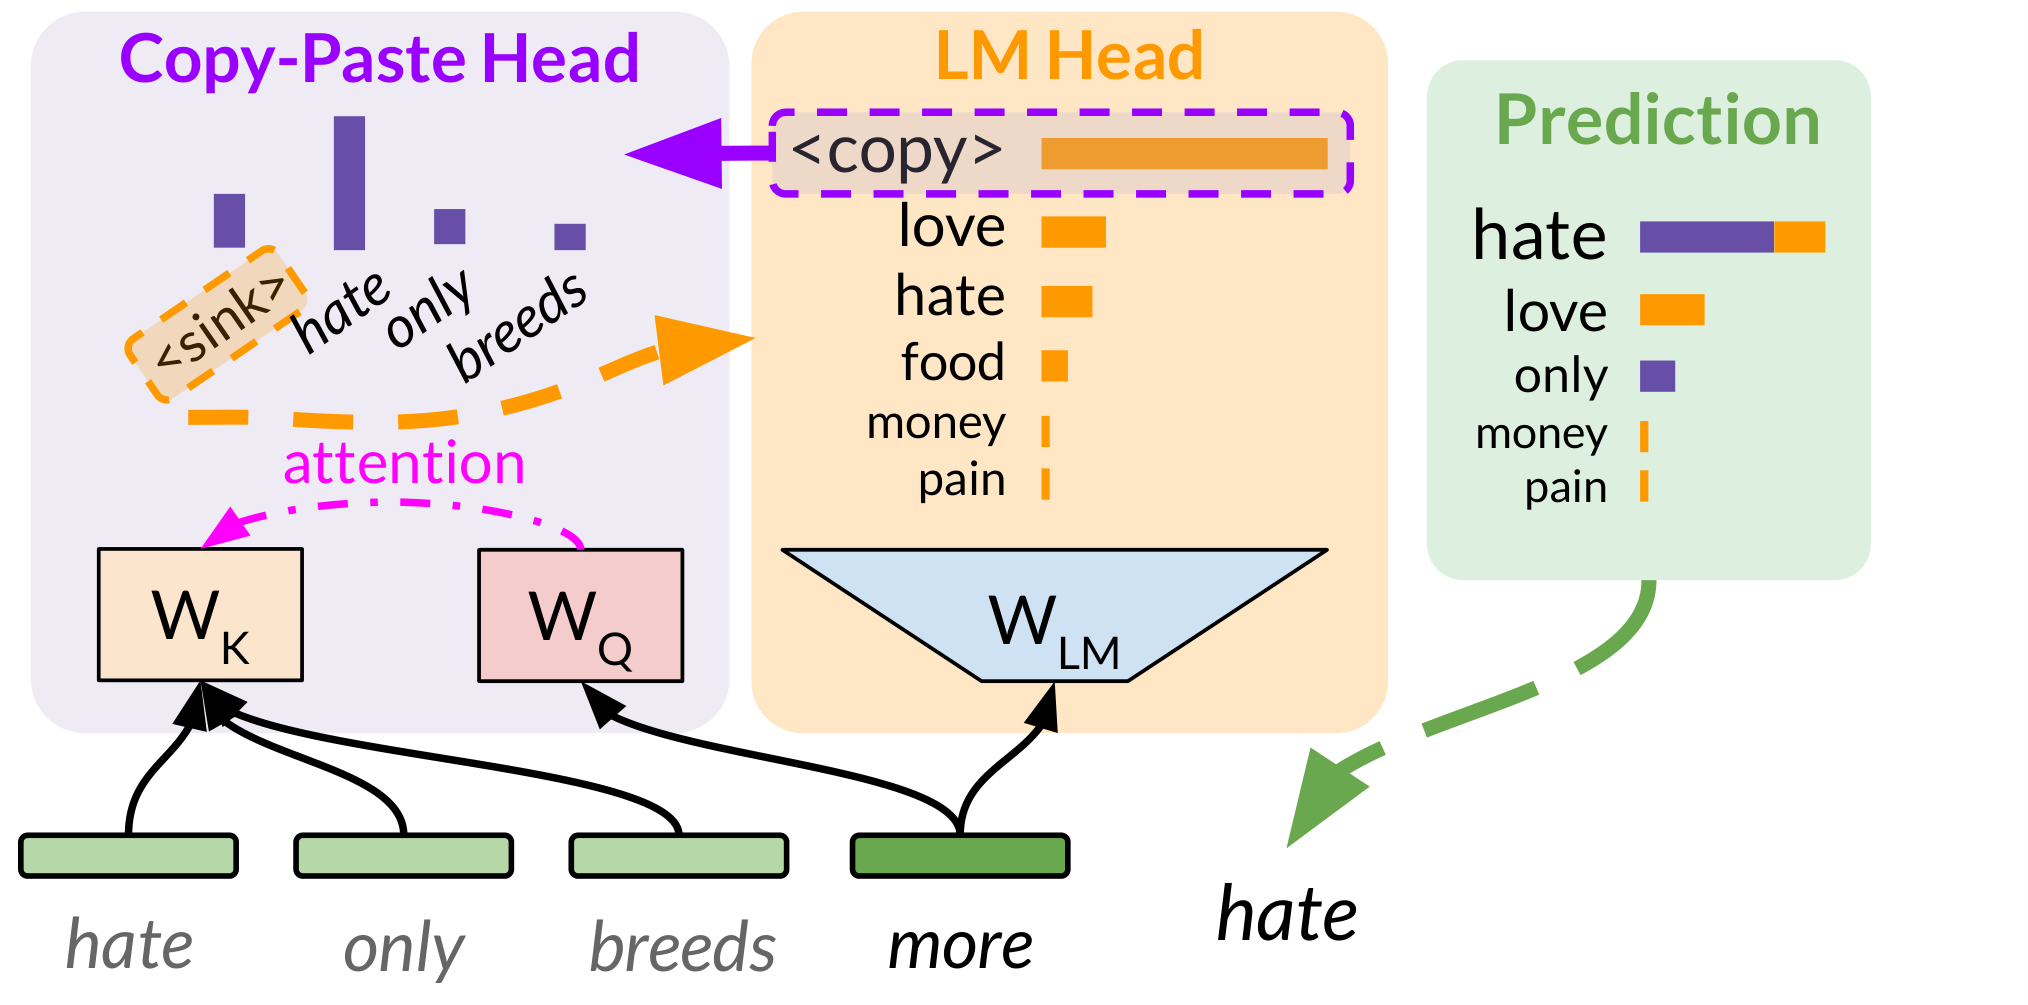
原图 Fig. 1 左,PDF p. 1。紫色柱表示对历史位置的复制权重,橙色为 LM head;图中同一个 hate 的两路质量在最终预测中合并。
三:实验设计与结果
3.1 预训练:收益是否跨规模和骨干成立?
作者按 SmolLM2 配方在 FineWeb-Edu 上训练 135M、360M、1.7B 模型;前两档各 20B token、2,048 长度,1.7B 为 200B token、4,096 长度。成对比较使用相同骨干和超参。骨干包括全注意力(Full)、滑窗注意力(SW)、全局层与滑窗层交替的 Hybrid;135M 附录还测试 Gated DeltaNet(GDN)。主比较的 SW/Hybrid 窗口是 256。这样 Full/Hybrid 的 CPLM 增益不能只解释为“新添了全局访问”:它们本来就能访问全上下文。(Sec. 3.1、Appendix A,PDF pp. 4、18)
在 1.7B 训练曲线上,Full 和 Hybrid CPLM 达到 vanilla 最终损失所需 token 数约少到 $1/1.25$,SW CPLM 则约少到 $1/2$;作者也观察到 135M 与 360M 的同向收益。135M 三种骨干各用 3 个种子重复,最终验证 PPL 的 CPLM 改善为 Full $16.33\to15.83$、SW $16.89\to16.02$、Hybrid $16.37\to15.84$,均显著超过种子波动。(Sec. 3.1,Fig. 2,PDF p. 4;Appendix C.1,Table 7,PDF p. 20)
| 1.7B 基座,zero-shot 平均准确率 ↑ | Vanilla | CPLM | 差值(百分点) |
|---|---|---|---|
| Full | 62.45 | 63.06 | +0.61 |
| SW-256 | 61.63 | 62.48 | +0.85 |
| Hybrid 3:1 | 62.22 | 62.59 | +0.37 |
原文 Table 1,PDF p. 4;平均覆盖 HellaSwag、LAMBADA、PIQA、SciQ、ARC-e/c、WinoGrande。最大的单项增益来自 LAMBADA,Full 为 $44.46\to46.92$,SW 为 $42.46\to46.42$;其目标词常能从前文复制。
在 135M 滑窗大小扫描中,同窗比较时 CPLM 的验证 PPL 总更低;作者报告域内 FineWeb-Edu 降 0.5–2 点,域外数据最高降 15 点。Fig. 3 的横轴是每 token 缓存量,纵轴是 PPL,曲线左下方更优;它展示了 CP key 让局部骨干以更少缓存访问远处 token。1.7B 的 FinePDF 对照中,SW CPLM 以包括 copy cache 在内约 12 倍更少的每 token 缓存匹配 Full vanilla 的 PPL,且各骨干 CPLM 对其 vanilla 配对在 FinePDF 上低约 0.5–1.5 PPL。(Fig. 1、3,PDF pp. 1、5)
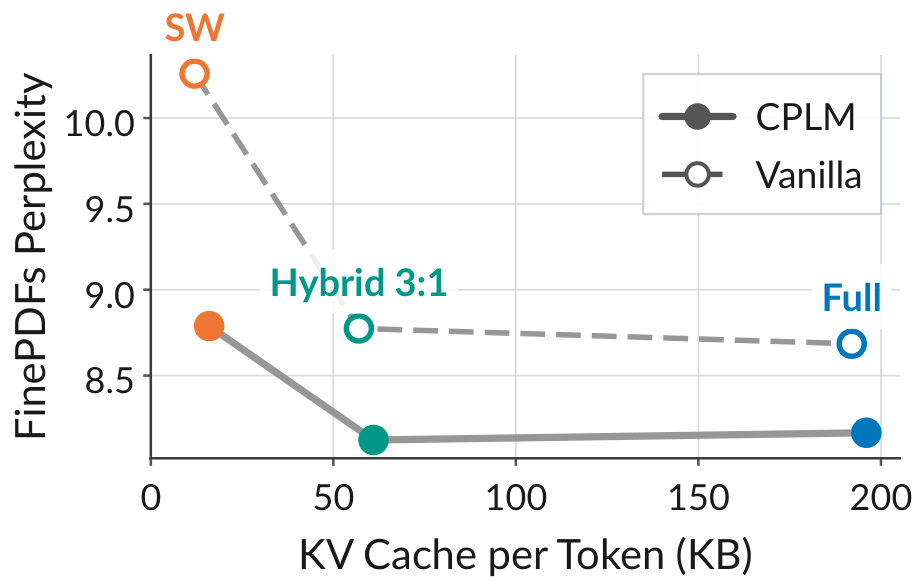
原图 Fig. 1 右,PDF p. 1。纵轴 PPL 越低越好,横轴缓存 KB/token 越小越省内存;比较条件是该文 1.7B 配置。
在 5,000 篇 16k-token FinePDF 文档上,CPLM 的滚动 PPL 随位置下降,到 16k 约 6.5–7;vanilla SW/Hybrid 在约 10–13 附近平台化,Full 在训练长度之外恶化。CP 门随位置更常开启、sink 使用下降;SW CPLM 在 16k 位置平均复制距离超过 2,000 token,远超其 256-token 骨干窗口。这里的 16k 是预训练长度的四倍,Full/Hybrid 使用 YaRN×4,SW 保留原 RoPE。(Sec. 3.1,Fig. 4,PDF p. 5;Appendix G.2,Fig. 15,PDF p. 28)
3.2 SFT:复制能力能否带到数学、代码和指令任务?
1.7B 模型在 Tulu-3 上以最长 16k 序列做 SFT。下表是原文 Table 2 的跨任务平均分;同表还报告 Tulu-3 和 Nemotron-3 推理数据的 PPL,CPLM 在所有三种骨干上均更低。MATH 只选 level 1–2 的 861 题,MATH/GSM8K 报 pass@4,HumanEval/MBPP 报 pass@10;因此平均分是不同任务指标的算术汇总,不能解读成单一任务的准确率。(Sec. 3.2,PDF p. 6;Appendix D,PDF pp. 24–25)
| SFT 后平均分 ↑ | Vanilla | CPLM | 差值(百分点) |
|---|---|---|---|
| Full | 24.2 | 26.4 | +2.2 |
| Hybrid 3:1 | 24.3 | 25.5 | +1.2 |
| SW-256 | 18.9 | 24.0 | +5.1 |
原文 Table 2,PDF p. 6。SW 的 MATH 为 $7.2\to16.4$、GSM8K 为 $18.6\to25.2$;Hybrid 的 MBPP 是一个反例,$19.0\to17.4$。论文据此报告总体改善,单项并非全胜。
3.3 长上下文:复制能跨越骨干窗口吗?
在 1.7B 基座模型上,RULER 平均 13 类任务、长度 4k–16k;BABILong 平均 qa1–qa5、长度 0k–16k;LongBench 汇总 16 个英文任务的 16k 成绩。Full/Hybrid 用 YaRN×4,SW-256 用普通 RoPE。尤其 SW 的 RULER $7.9\to29.2$、LongBench $7.4\to13.4$,显示 CP head 能弥补局部注意力在某些检索任务上的缺口;BABILong 只从 13.8 到 16.1,效果小得多。(Sec. 3.3,Table 3,PDF p. 6)
| 1.7B 基座,分数 ↑ | Full Vanilla→CPLM | Hybrid Vanilla→CPLM | SW Vanilla→CPLM |
|---|---|---|---|
| BABILong | 26.4→32.0 | 27.7→32.9 | 13.8→16.1 |
| RULER | 33.6→39.6 | 33.2→37.8 | 7.9→29.2 |
| LongBench | 10.4→12.2 | 9.5→14.3 | 7.4→13.4 |
单针检索测试将随机 7 位数字插在不同深度、1k–64k 长度的填充文本中,每个深度×长度单元有 200 个样本,贪心生成最多 16 token,答案包含该数字即算正确。全网格平均:Full $49.7\to54.8$、Hybrid $58.2\to83.6$、SW $14.3\to99.4$。热图说明 SW CPLM 能从远于 256 token 的位置取出数字;也显示 Full 骨干两种模型在 16k 及以上均失败,CP head 没有普遍解决骨干的长度外推问题。更复杂的 BABILong 在长于 2k 时,两个 SW 模型也接近底线。(Appendix E,Fig. 13,PDF p. 25;Appendix F,PDF pp. 26–28)
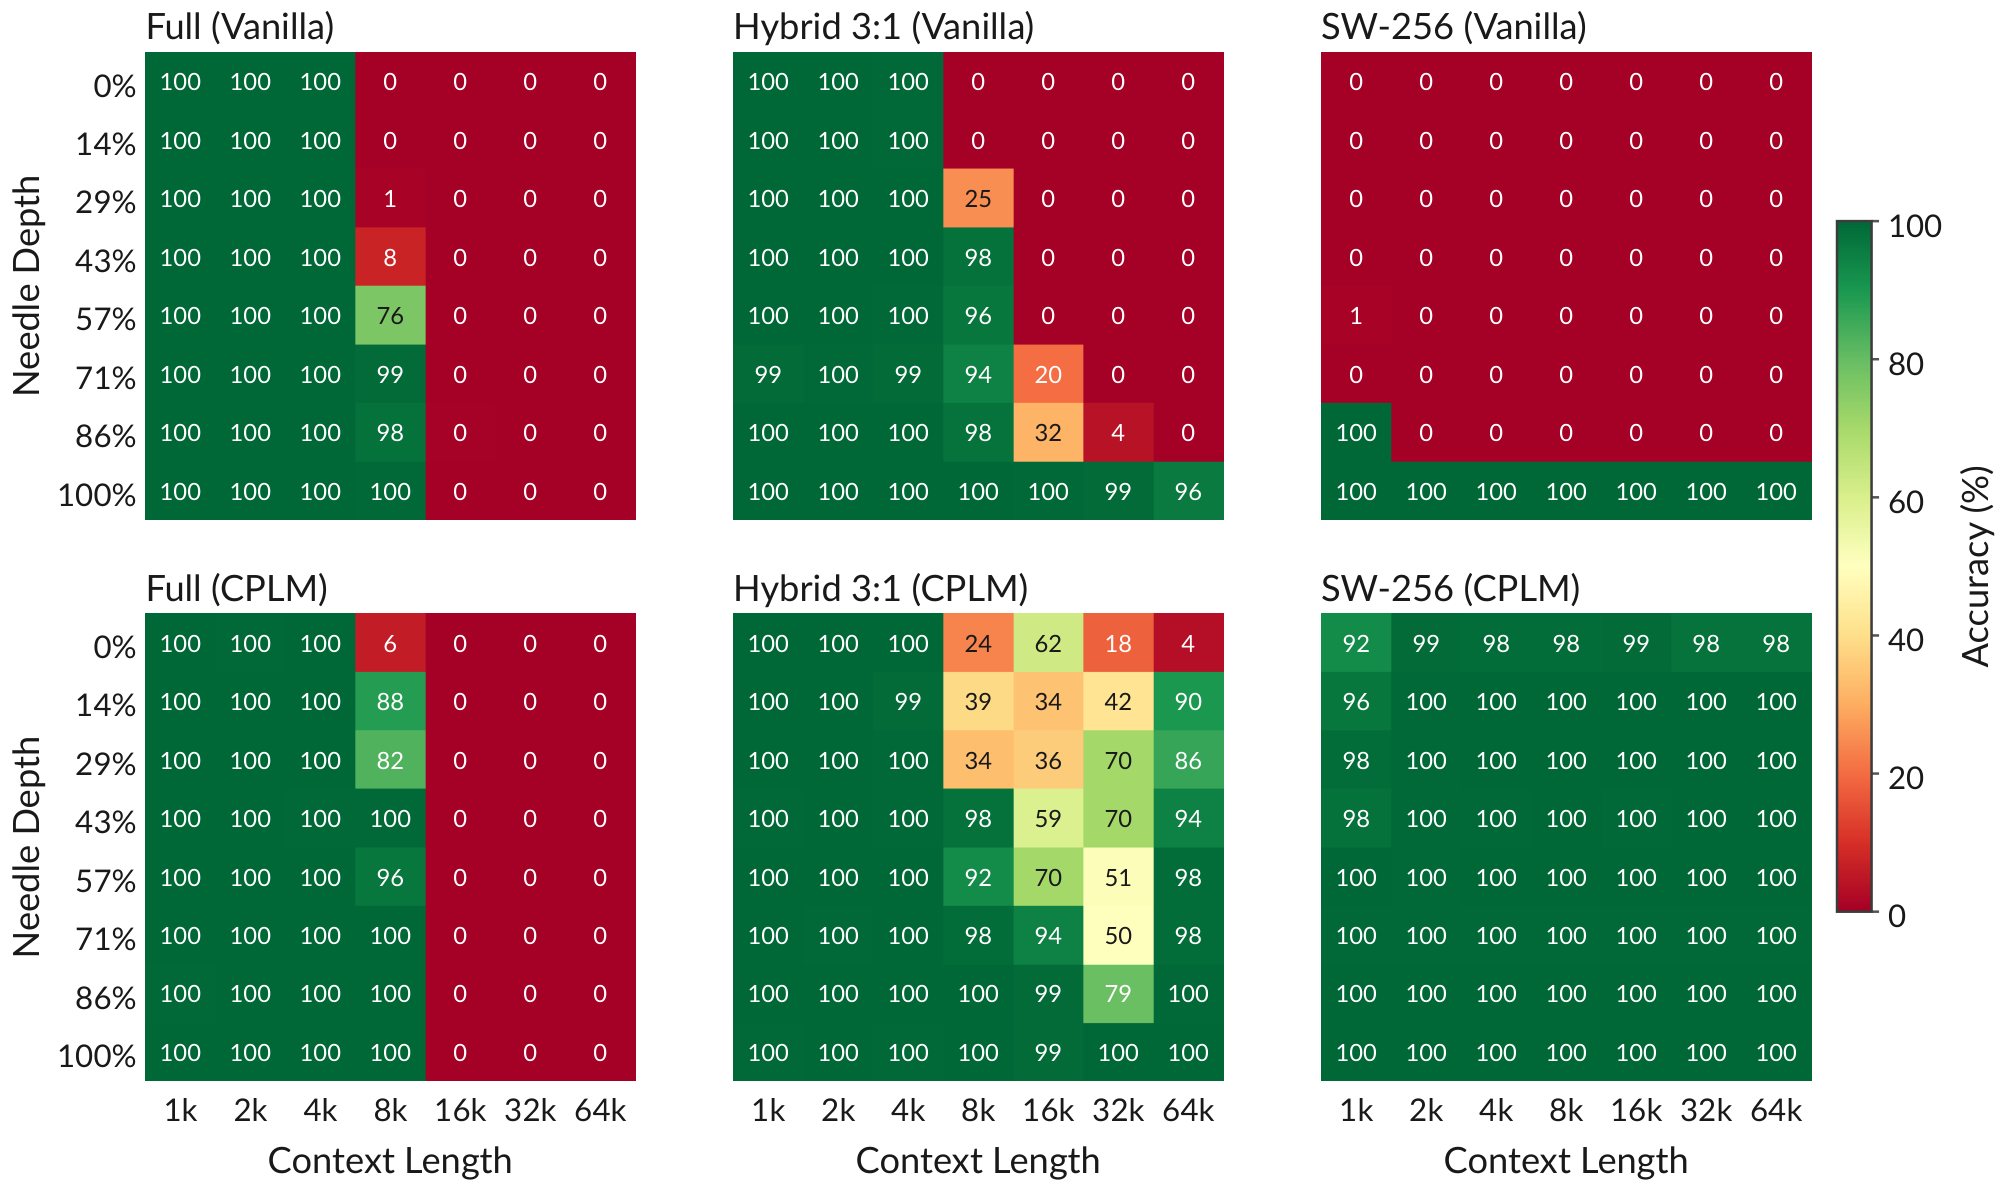
原图 Fig. 13,PDF p. 25。每列为长度、每行为插针深度;上排 vanilla、下排 CPLM,颜色与数字为正确率(%)。
3.4 文档检索:CP key 能否独立承担文档记忆?
作者在 HotpotQA distractor 设置上微调 1.7B 模型,每题含两个正确段落和训练时随机 5–50 个干扰段落;对 200 个验证问题评估 5–500 个干扰段落,指标是 Exact Match。一个设置让骨干照常读文档;另一个把每篇文档独立编码,使回答端只能通过 CP key 访问文档。vanilla 控制组则仅保留最后一层 KV 来访问文档,并各自在其评测设置中微调。(Sec. 3.4,PDF pp. 7–8)
在“文档不进入回答端骨干 KV”的条件下,CPLM 用 copy key 保留了文档可见设置下、5 个干扰段落时约 90–97% 的准确率;500 个干扰段落时仍有 34–38% EM。作者报告这时缓存比 Full 模型完整 KV 小约 50 倍,且文档 key 可预计算、跨问题复用。最后一层 KV 控制组占用约两倍 copy cache,却停留在约 14% EM 的无文档水平。这个实验支持 CP key 作为可学习检索记忆的作用;它测的是所述 HotpotQA 协议,不是一般 RAG 系统的端到端基准。(Sec. 3.4,Fig. 5,PDF p. 8)
开销和设计消融
CP head 额外有两个 $D\times D$ 投影及一个 sink key。1.7B 参数量增加约 0.5%;在单张 B300、4k 序列的全注意力骨干吞吐测量中,1.7B 为 55,862→54,113 token/s,即 0.969 倍;9B/30B 的约 1% 内差异仅是未训练架构的性能测量,不是 9B/30B 的任务效果。1.7B 全注意力模型推理时 copy cache 为 KV cache 的约 2.1%,解码步慢约 1.7–1.8%(表列的 1.7B 设置);训练时需融合内核和适当分块来控制临时内存。(Appendix B,Tables 5–6,PDF p. 19)
135M 消融显示:copy key/query 维度从 64 到 2,048,PPL 波动小于 0.02,暗示可用更窄的检索缓存;sink 对小滑窗尤其有用。与 sigmoid 门、共享 softmax 等指针变体相比,本文门控加 sink 的 PPL 持平或小幅领先,差距约一到两个种子标准差;它胜出的重点在可先做门控决策,并非全新的指针算子。推理外挂 neural cache 对 vanilla 几乎没有改善:调参后混合权重 $\gamma\le0.002$。(Appendix C,Figs. 8、10,Tables 8–9,PDF pp. 20–24)
四:机制证据——收益主要从哪里来?
梯度路径。 论文测量 135M、2,048-token 序列的 logit 梯度投影损失:LM head 丢失超过 99% 的梯度范数;CP 路径以长度 $t$ 而非词表大小 $V$ 为目标维度,在较早位置最多保留约 85%。这不是说 CP 矩阵自身突破了随机矩阵行为,而是其目标矩阵形状更有利。在 SpamLang 的“一个随机符号反复出现”任务里,固定 $D=576$、词表从 8k 增至 512k;vanilla 在 512k 时准确率仅 34%,CPLM 在所有词表规模完成任务。(Sec. 4.1,Fig. 6,PDF pp. 8–9)
直接干预。 作者让 $q_t=W_Q\operatorname{sg}(h_t)$、$k_\tau=W_K\operatorname{sg}(h_\tau)$,截断 CP 路径进入骨干的梯度,仍训练两个投影与 sink。验证结果如下;全 CPLM 的损失改善为 0.031 nat/token,截断后仅剩 0.008,即约四分之一。另一方面,当 byte 词表只有 257 项而 $D=576$ 时,普通 LM head 已无此低秩瓶颈;20B byte 训练后 CPLM NLL 为 0.6918,vanilla 为 0.6908,未见收益。这两项干预共同支持“额外梯度路径是主要来源”的解释;字节实验的 token 单位与普通预训练不同,不能直接横比绝对损失。(Appendix H,Tables 15–16、Figs. 17–18,PDF pp. 30–32)
| 135M token 级模型 | 验证 NLL ↓ | PPL ↓ | 与 vanilla 的 NLL 差 |
|---|---|---|---|
| Vanilla | 2.794 | 16.34 | — |
| CPLM | 2.763 | 15.85 | −0.031 |
| CPLM,截断 CP→骨干梯度 | 2.786 | 16.22 | −0.008 |
原文 Table 15,PDF p. 30。附录 Fig. 14(PDF p. 27)还显示:即使 $c_t$ 接近零、主要靠普通 LM head 预测的 token,CPLM 的 NLL 也较低,与骨干受益的解释一致。
骨干学到的复制机制。 在重复随机序列探针中,CPLM 复制第二遍序列更准,但 Full/Hybrid 骨干中满足阈值的 induction head 更少:$T=128$ 时为 4 个,而 vanilla 为 13–15 个。读法是 CP head 承担了部分复制工作,骨干无需让同样多注意力头专职完成它;这个探针显示功能分工,并非给出训练收益的单独因果证明。(Sec. 4.2,Fig. 7,PDF p. 9)
五:结论与取舍
本文最有力的论证链是:显式位置指针 → 更直接的输出及梯度路径 → 更好的预训练与复制能力 → 在局部骨干和文档检索中形成新的缓存/性能取舍。其中“梯度路径”不是只靠相关性推断:梯度截断使收益大幅缩小,移除词表维度瓶颈的字节实验使收益消失;而非复制 token 的损失改善进一步说明收益不止于直接拷贝答案。(Sec. 4;Appendix G–H,PDF pp. 8–9、27、30–32)
适用边界也很具体:CP head 只能直接复制当前可访问上下文中已出现的 token;论文真实任务效果训练到 1.7B,较大规模只测了开销;Full 骨干在 16k 以上的单针测试仍失败,SW 在复杂多事实检索中仍弱。因而本文证明了在这些模型和协议下,向输出端加可训练复制路径有价值,尤其适合局部或压缩状态骨干;扩展到 span、外部语料和更大训练规模仍是作者列出的后续方向。(Sec. 6,PDF p. 10)