Jeva: System One Models from First Principles:中文精读笔记
- 作者:Qi Li、Xinchao Wang(National University of Singapore)
- 论文:arXiv:2610.18773v2,2026-10-18 修订;本次于 2026-10-28 获取。本地原文 PDF
- 发表:截至 2026-10-28 未查到正式发表信息;作者主页将其列为“Preprint (2026)”。
- 代码:作者官方公开代码;Jeva-4B 模型。
论文总览
Jeva 研究的是如何直接从一组候选项中作出类型化决策:选择一项(Choice)、判断真假概率(Noul),或给出量表期望分数(Score)。这类任务通常需要识别“没有合适候选项”、抵抗候选顺序变化、接纳不同数量的候选项,并复用反复出现的候选描述。论文认为,把请求和候选项串成一段文本再读取答案 token,难以同时满足这些结构要求。(§1,PDF 第 2–3 页)
Jeva 的主线是:请求与各候选项独立编码 → 请求状态读取固定的候选记忆并更新 → 分开计算候选间竞争和“至少一个候选可用”的覆盖概率 → 按决策类型解释输出。独立编码使候选项及其键/值投影可跨请求复用;集合上的对称聚合和共享打分使候选概率随置换同步置换;覆盖门把空答案从候选竞争中分离。(§3,PDF 第 4–6 页)
在 Jeva-4B 的报告结果中,BANKING77 的 16 候选空答案检测 AUROC 为 98.66%;600 个 Choice 样例的测试置换中观察到 0 次决策翻转;ToolRet 的 2,048 候选组准确率 69.88%、中位请求延迟 12.040 秒;新组合的长文档候选集在完全复用候选计算时,中位延迟由 2,102.0 毫秒降至 75.1 毫秒。这些是不同实验的指标,不能合并成一个端到端加速结论。(§4,PDF 第 7–9 页)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键内容 |
|---|---|---|
| §1 Introduction | 提出四个决策结构要求与联合编码的不足 | 第 2–3 页;图 2 在第 2 页 |
| §2 Related Work | 定位类型化决策、双编码器、集合函数与空答案校准 | 第 3 页 |
| §3 Jeva: A Native Decision Architecture | 输入编码、状态更新、覆盖门、对称性、缓存与训练 | 第 4–6 页;图 3–5、式 (1)–(9) |
| §4 Experiments | 决策质量、空答案、扩容、批处理和复用 | 第 7–9 页;表 1–2、图 6–9 |
| §5 Conclusion | 总结结构设计和实测收益 | 第 9 页 |
| 附录 A–C | 证明、实现细节、训练与评测协议、类型化样例 | 第 11–18 页 |
一:动机——把“选择”视作有结构的计算
传统的答案 token 读取把候选项放进有顺序的文本序列。候选描述于是与当次请求一起计算;请求变化或重新组合候选集,通常需要再处理整段文本。用固定字母或标签词表作输出时,候选数量还受标签空间约束。即便对候选分数做 softmax,得到的也只是“给定这些候选,彼此谁更可能”,无法单独判断“是否存在正确候选”。论文把这些问题归结为四个目标:空答案感知、候选置换稳定、候选数量可扩展、候选计算可缓存。(§1,PDF 第 2–3 页;图 1)
一个关键动机来自独立打分的局限。若每项分数为 $g(x,\iota,o_i)$,在候选集 $\mathcal O$ 上经温度 $\tau>0$ 的 softmax 得到 $q$,则任意两项的对数胜算为
分母与其他候选项无关。因此,增加第三项虽会重新分配概率,却不能翻转仍在集合中的 $i$、$j$ 的偏好。Jeva 希望保留候选项可独立预计算的优点,同时让最终判断依赖当次完整候选集。(§3.1,式 (2),PDF 第 4 页)
二:方法——固定候选记忆,更新请求状态
2.1 输入、编码与整体数据流
一个请求由状态 $x$、问题 $\iota$、类型 $t$ 和候选序列 $\mathcal O=(o_1,\ldots,o_K)$ 组成;论文的类型化接口取 $K\geq2$。共享语言骨干 $E_\theta$ 分别处理请求模板 $T_x(t,\iota,x)$ 和每项候选模板 $T_o(t,o_i)$,再取最后一个非填充 token 的隐藏状态。无偏置投影得到
这里 $z_0$ 是当次请求状态;$u_i$ 是单位化的候选语义向量。候选模板只含决策类型和该项文本,不含当前问题、状态、候选位置或其他候选项;所以在固定模型和输入策略下,同一类型的同一候选项可复用编码结果。骨干与投影在训练时仍可更新,缓存是在权重固定后才成立。(§3.1,式 (1),PDF 第 4 页;附录 C,第 16–17 页)
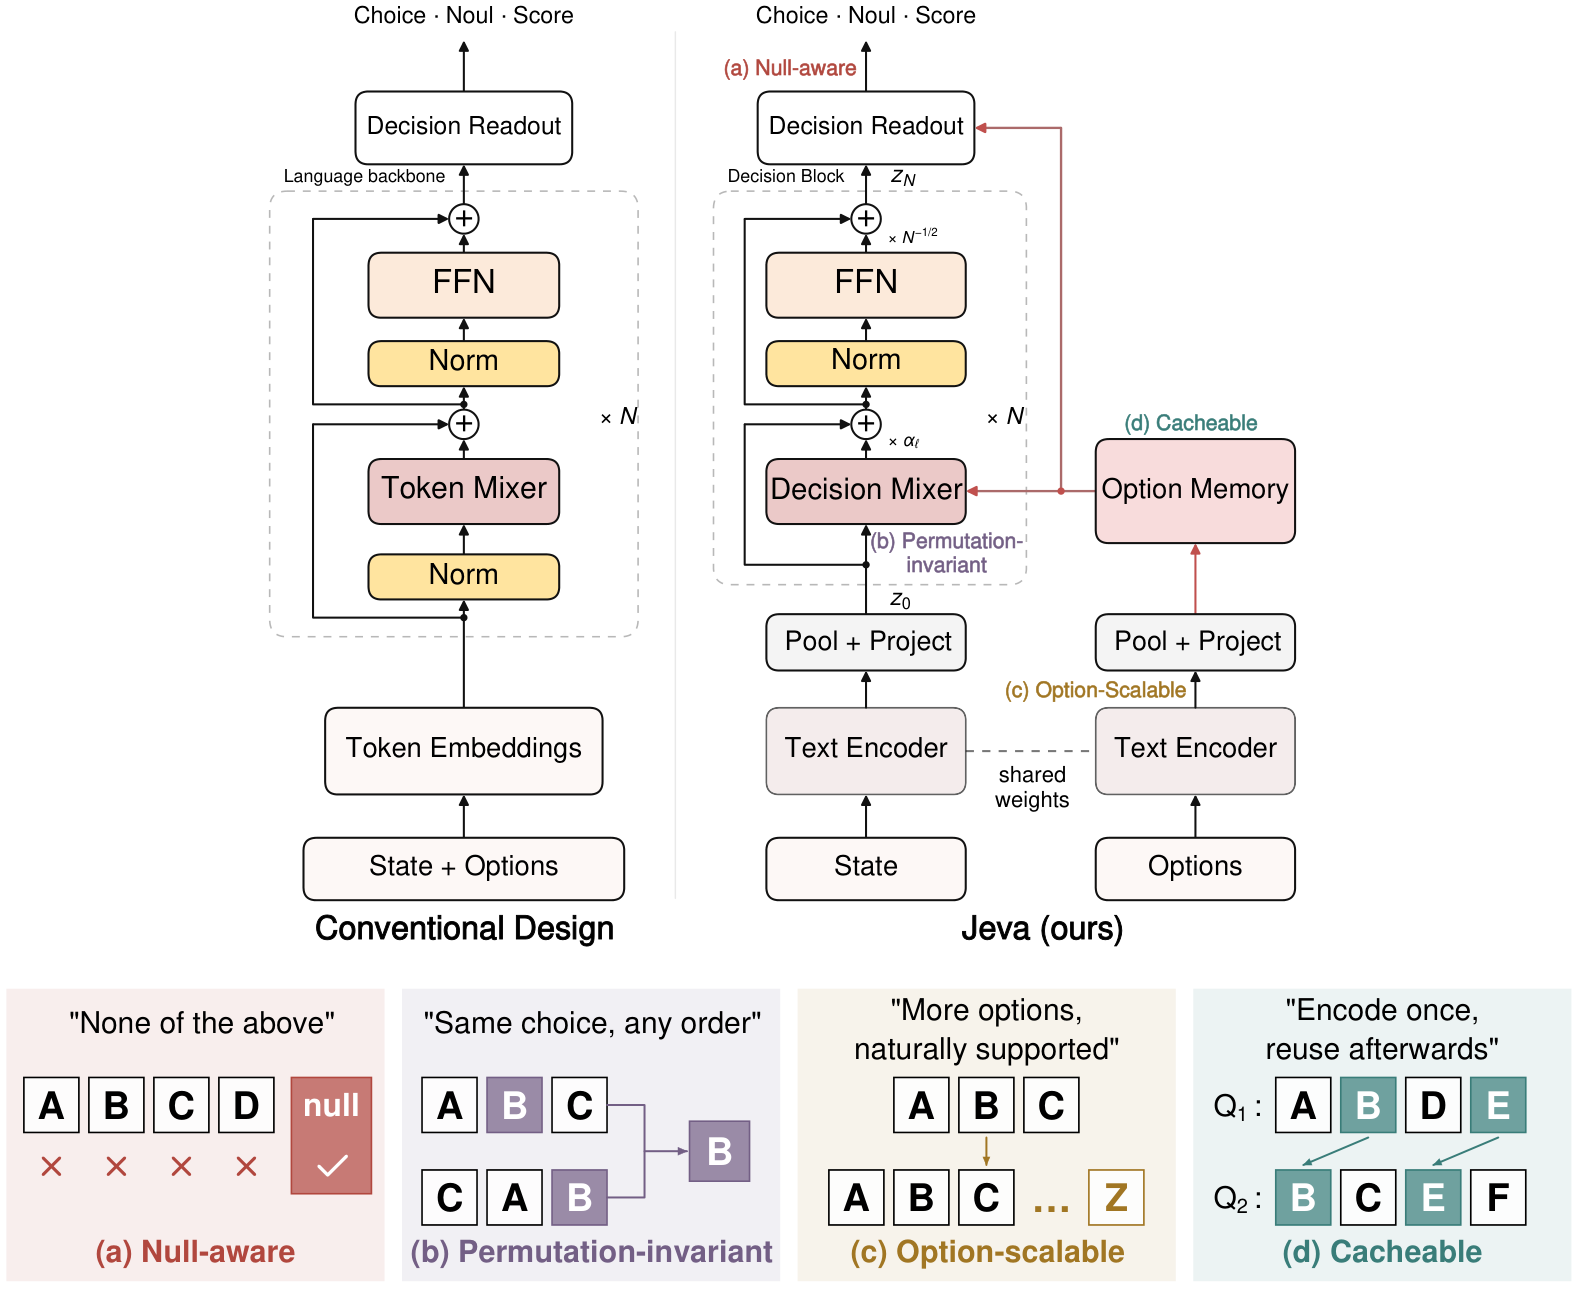
原文图 1,PDF 第 1 页。右侧将请求编码和候选编码分开;决定当次结果的模块只更新请求状态,候选记忆保持不变。图下方的四格对应论文四项目标。
2.2 集合条件化的决策块
记候选矩阵 $U=[u_1^\top;\ldots;u_K^\top]$。每个决策块的第 $h$ 个头,用当前状态生成归一化查询 $q_\ell^h$,用各候选向量生成归一化键 $k_{\ell i}^h$ 和值 $v_{\ell i}^h$。其读取权重与消息为
其中 $\tau_\ell>0$ 是学习得到的集合读取温度,$a_{\ell i}^{h}$ 是中间的证据分配权重,不是最终选择概率。它等价于最大化“兼容性加温度加权熵”的分配:$\arg\max_{a\in\Delta_K}\{a^\top c+\tau_\ell\mathcal H(a)\}$。温度越高,在固定兼容性分数下分配越分散。(§3.2,式 (3);附录 A.1,PDF 第 4、11 页)
随后只对请求状态作两次残差更新:
$F_\ell$ 是无偏置 SwiGLU 网络;$L$ 为决策块数。键和值始终由候选向量决定,块间不更新候选项。系数满足 $0<\alpha_\ell/\tau_\ell<1/\sqrt L$;这约束了消息强度与读取温度的比例,但不能单独理解为整层更新的全局稳定性保证。(§3.2,式 (4),PDF 第 4–5 页)
为什么一层也能看见“候选之间的关系”? 论文给出构造:取相同请求 $z_0=(1,0)$、固定的 $A=(4,3)/5$ 与 $B=(4,-3)/5$,只把第三项在 $C_+=(3,4)/5$ 和 $C_-=(3,-4)/5$ 之间替换。在指定温度与混合系数下,更新后 $s_A-s_B=\pm24\alpha w/25\approx\pm0.00559$,于是两组中分别由 $A$、$B$ 唯一获胜。独立打分则保持 $A$ 与 $B$ 的相对顺序。这是表达能力的存在性构造,说明固定候选向量不妨碍集合条件化判断;它不表示添加任意候选都应该改变答案。(命题 1、式 (5),PDF 第 5 页;附录 A.2、B.1)
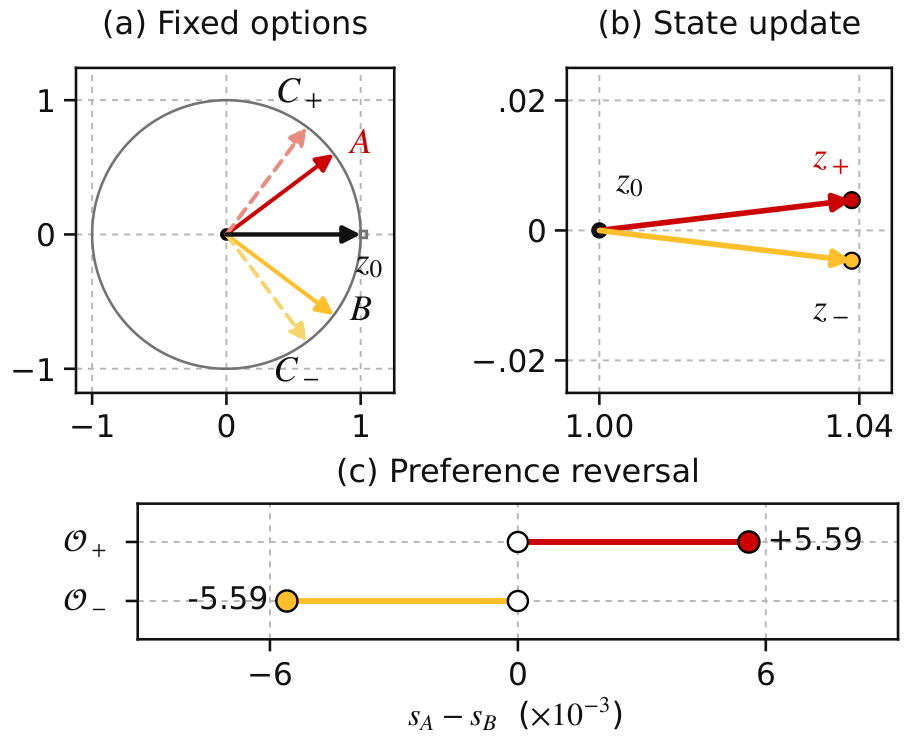
原文图 3,PDF 第 3 页。左图固定 A/B,只替换 $C_+$ 与 $C_-$;中图显示状态沿相反方向更新;下图显示 A/B 分数差异翻转。
2.3 将“谁最好”与“有无答案”分开
最终候选分数 $s_i=z_L^\top u_i$ 先形成条件分布 $q_i=\operatorname{softmax}_i(s/\tau_{\mathrm{dec}})$。它回答“在有可接受答案的前提下选哪一项”。另用最大分数估计覆盖概率
$\rho$ 是“至少一个候选项可接受”的估计,$b_{\mathrm{cov}}$ 是学习到的阈值,$\tau_{\mathrm{cov}}>0$ 控制门的斜率。$q$ 对所有 $s_i$ 同加常数不敏感,而 $\rho$ 会响应绝对分数水平;这正是独立覆盖门的作用。开集 Choice 比较 $(p_\bot,p_1,\ldots,p_K)$;闭集 Choice 使用 $q$。Noul 返回肯定布尔候选的 $q_{i^+}$,并不等于“空答案”的 $p_\bot$;Score 对给定量表值 $v_i$ 返回 $\sum_iq_iv_i$。(§3.3,式 (6),PDF 第 5–6 页;附录 C,第 17 页)
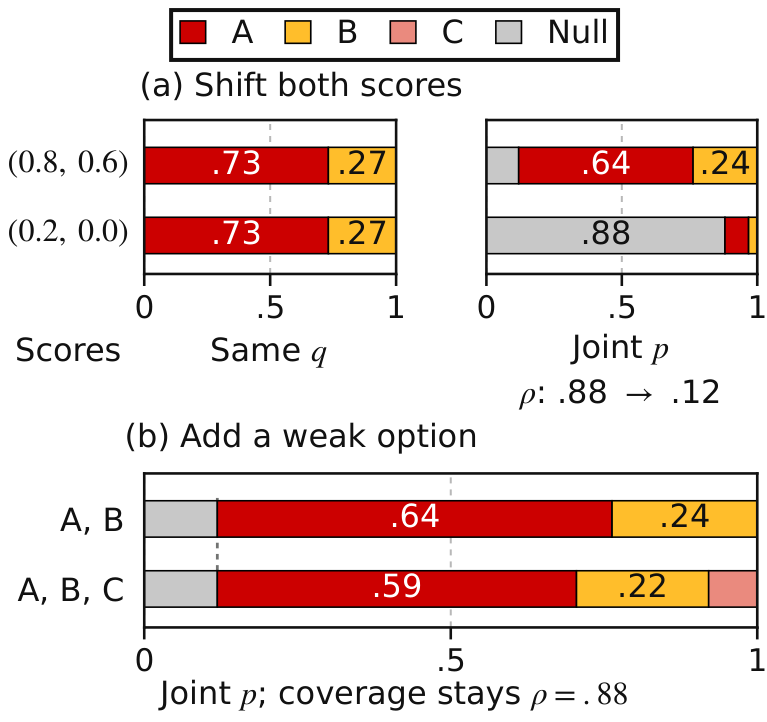
原文图 4,PDF 第 4 页。(a) 两项分数一起下降时,候选内比例 $q$ 不变,但 $\rho$ 从 0.88 降到 0.12;(b) 在固定最终分数下增加较弱的 C,$\rho$ 仍为 0.88,候选概率被重新分配。
论文的命题 2 针对固定的最终分数:加入低于原最大值的候选,不改变这个门的 $\rho$。相比之下,给每项同样的分数 $s$、另设固定空答案分数 $b_0$ 的扁平 softmax 会产生
即空答案概率被 $K$ 的分母项强制改变。Jeva 避免了这一覆盖概率的机械数量效应;实际加项仍可能改变集合更新后的 $s_i$,而联合最大概率决策还受 $q_{\max}$ 影响。附录给出的精确条件是:当 $\operatorname{logit}(\rho)<-\log q_{\max}$ 时,空答案概率高于每个单独候选概率。(§3.3,式 (7),PDF 第 5–6 页;附录 A.3、B.4,第 12、14 页)
2.4 顺序对称、候选复用和计算规模
单个候选的原子记忆为
置换候选项及其元数据只会置换各项的键、值与最终概率。注意力的加权和在重排后相同,因此 $z_L$、$p_\bot$、Noul 与 Score 输出不变;唯一获胜候选的语义身份也不变。这是精确算术、固定权重与确定性计算下的结构性质;并列第一的索引择优规则与浮点归约可产生细微实现差异。(命题 3、式 (8),PDF 第 6 页;附录 A.4、B.5)
缓存有两层:Set 复用完整的有序候选元组;Hybrid 还复用每个候选向量及每层键/值,因此新组合只须处理尚未见过的项。当前请求的状态编码、集合读取和输出仍重新计算,缓存的是候选计算而非旧答案。模型权重、tokenizer、模板或长度策略改变时,记忆须失效。(§3.4,PDF 第 6 页;附录 C,第 18 页)
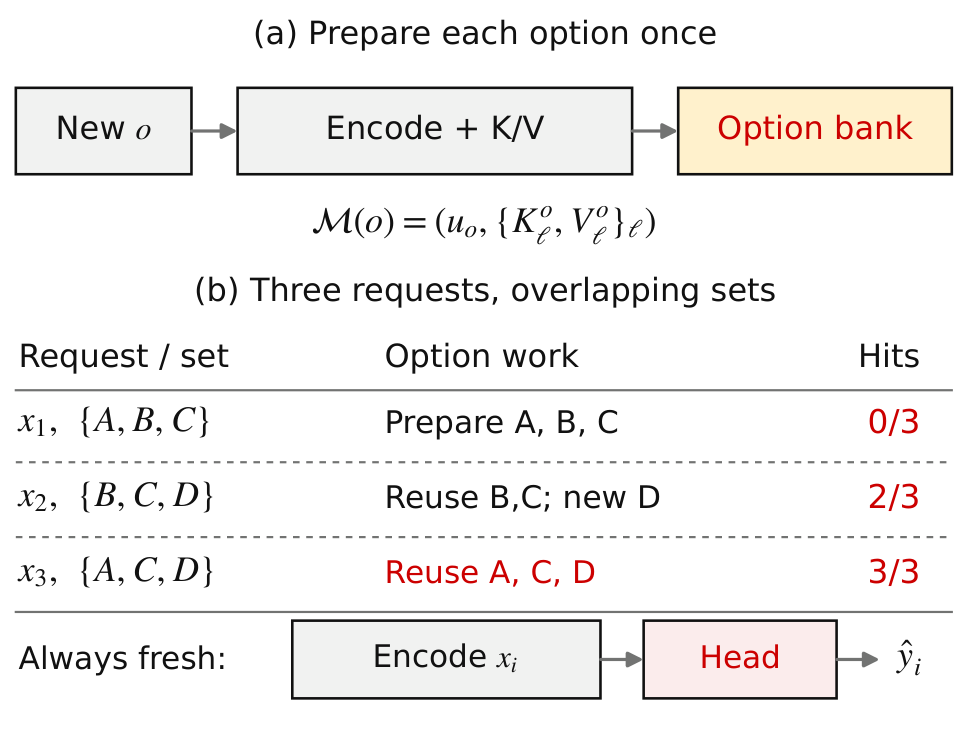
原文图 5,PDF 第 4 页。三次请求的整组候选均不同,单项命中数却可从 0/3 增至 2/3、3/3;下方显示每次仍需新的请求编码与决策。
在已准备候选记忆、固定宽度与深度下,决策模块成本为 $O\!\left(L(d^2+Kd+df)\right)$,对候选数 $K$ 线性增长;$M$ 项的记忆量为 $O(M(L+1)d)$。未缓存的新项还要支付各自的文本编码与键/值投影。线性决策头与“输出 $K$ 项密集分布本就需 $\Omega(K)$”相匹配,但请求延迟仍会受编码批处理和文本长度影响。(§3.4,PDF 第 6 页;附录 A.4、B.6,第 12、15 页)
2.5 训练目标与具体模型
对于归一化的开集目标 $(y_\bot,y_1,\ldots,y_K)$,令 $c_y=\sum_i y_i$、$g=\operatorname{logit}(\rho)$,主要损失是
它恰是完整分布 $p=(1-\rho,\rho q)$ 的交叉熵:全空答案样例只教覆盖门,不硬造某一候选的排序目标;有答案样例同时训练覆盖与竞争。闭集样例使用候选交叉熵,Noul/Score 在相关阶段另有辅助项。(§3.5,式 (9),PDF 第 6–7 页;附录 A.5、B.8)
Jeva-4B 使用 Qwen3.5-4B 骨干,池化宽度 2560、决策宽度 $d=768$、一个决策块 $L=1$、八个头和宽度 $f=3072$ 的 SwiGLU;两侧投影与决策核心合计 13,370,117 个参数,骨干另以 rank-64 LoRA 训练。课程从类型化决策、意图选择扩展至验证、阅读推理和大候选集检索;推理时合并 LoRA 后,才为固定模型准备缓存。(§3.5,PDF 第 7 页;附录 B.7–B.8、C.1,第 15–16 页)
三:实验——问题、对照与度量
| 检验问题 | 数据与协议 | 主要度量 |
|---|---|---|
| 一般决策是否准确? | Typed Decisions 2,000 题;BANKING77、MASSIVE 各取 $K=8,16$;Mind2Web 三个 $K=16$ 切片 | 含适用空答案的 first-argmax 准确率(%↑),并记录请求支持率 |
| 类型化输出质量如何? | Typed 中 600 Noul、800 Score、600 Choice | Noul Brier/MAE(↓);Score MAE/RMSE(原量表单位,↓);Choice 翻转率/全顺序准确率/平均 TV |
| 能否识别空答案? | BANKING77,$K=16$ 的 3,080 个匹配请求,其中 588 个无答案 | 空答案 AUROC(%↑);约 5% FPR 的 TPR(%↑) |
| 大候选集是否可用? | ToolRet 500 个请求,六组不同查询,$K=32$ 至 2,048;另用同 83 查询做嵌套候选集 | 可支持请求、最高目标得分项命中率(%↑)、p50 延迟(秒↓)、跨所有 $K$ 正确率 |
| 重用候选是否省时? | Typed 共享候选库与 MLDR 长文档;Off、Set、Hybrid;新组合设置确保整组缓存零命中 | 中位请求延迟、避免的候选编码行、结果一致性;预热另计 |
一般准确率仅在完整支持的切片上比较。开集适配也因模型接口而异:JevK5 与 CLM 增加显式 None 候选;Jev、InternDecision、KEV 等类型化模型另答一条“至少一个候选适用吗”的 Noul 问题,再把该概率与候选条件分布组合。大型候选实验的附加项含弱标注或未判定的负例,389/500 请求有多个正例;判对规则是最高分项属于目标候选。延迟在一张 H200 上同步计时,跨模型保留各自运行时;同一模型内部的批处理与缓存对照固定检查点和请求流。(§4,PDF 第 7–8 页;附录 C,第 15–18 页)
四:结果——每组证据能说明什么
4.1 一般准确率与类型化输出
下表的“最佳其他模型”只取原表中完整支持该切片的模型,差值为 Jeva 减对照的百分点。(表 1,PDF 第 5 页)
| 切片 | Jeva-4B | 最佳其他模型 | 差值 |
|---|---|---|---|
| Typed Decisions | 78.30% | InternDecision-4B:78.70% | −0.40 |
| BANKING77,$K=8$ | 92.05% | Jev-1.13.0:86.14% | +5.91 |
| BANKING77,$K=16$ | 91.62% | Jev-1.13.0:82.50% | +9.12 |
| MASSIVE,$K=8$ | 91.09% | Jev-1.13.0:84.63% | +6.46 |
| MASSIVE,$K=16$ | 90.22% | Jev-1.13.0:81.61% | +8.61 |
| Mind2Web,cross-task | 79.99% | Jev-1.13.0:66.26% | +13.73 |
| Mind2Web,cross-website | 62.25% | Jev-1.13.0:59.97% | +2.28 |
| Mind2Web,cross-domain | 66.23% | Jev-1.13.0:62.47% | +3.76 |
Jeva 在八个切片中的七个排名第一,Typed 整体准确率比 InternDecision-4B 低 0.40 个百分点。Typed 的细项显示:Jeva 的 Noul Brier 0.0184、MAE 0.0939 为表中最低,Score MAE 0.2315 最低;Score RMSE 0.3222 略高于 InternDecision-4B 的 0.3208。Brier 与 RMSE 单位不同,不应把图 6(a) 两个坐标直接相减。(§4.1、表 1–2、图 6(a),PDF 第 5–7 页)
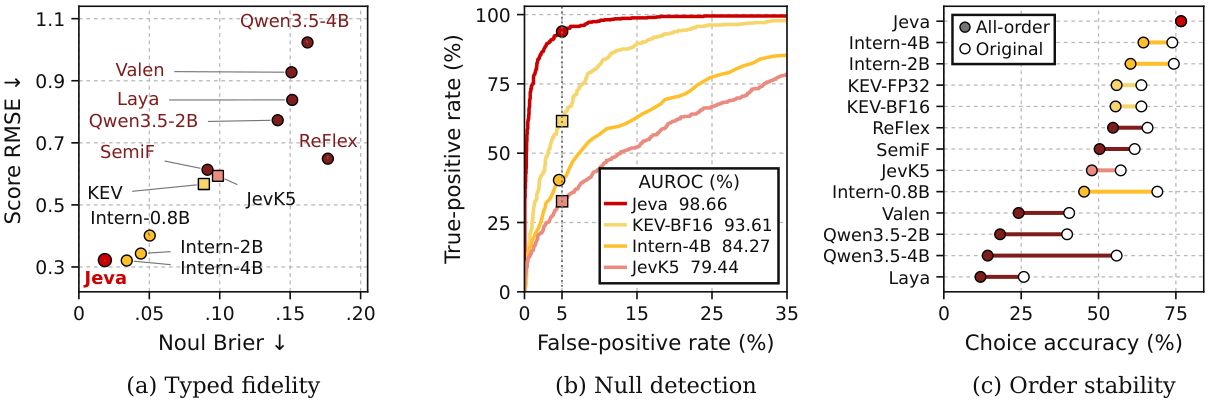
原文图 6,PDF 第 7 页。左图两个轴都是误差且单位不同;中图的 ROC 衡量阈值变化下的空答案检出;右图连接原顺序与所有测试顺序都正确的准确率。
4.2 空答案与候选顺序
在 BANKING77 的 3,080 个 $K=16$ 请求中,Jeva 的空答案 AUROC 98.66%,KEV-BF16 93.61%,InternDecision-4B 84.27%,JevK5 79.44%。Jeva 在 5.02% 假阳性率处检出 93.88% 的无答案请求;这是作者按各模型答案存在样例的经验 95 分位阈值测出的操作点,而非固定阈值下的总体准确率。该组结果支持独立覆盖门对“无正确项”有用。(§4.2、图 6(b),PDF 第 7–8 页)
顺序测试将 600 个 Choice 样例各自使用原顺序、逆序和最多三种固定随机顺序,并按候选语义身份对齐。Jeva 的翻转率 0%、平均总变差 $3.17\times10^{-8}$、全顺序准确率 76.67%;Jev-1.13.0 的翻转率 17.00%、全顺序准确率 66.67%,InternDecision-4B 分别为 22.67%、64.50%。这与模型的置换等变结构相符;“0 次”专指这些测试顺序与样本。(§4.1、表 2、图 6(c),PDF 第 6–8 页)
4.3 候选数量、批处理和嵌套集合
ToolRet 六个不同查询的候选数队列合计 500 个请求。Jeva 全部支持,聚合准确率 78.40%;递归选择的 JevK5 同样覆盖全部请求,聚合准确率 64.00%。在 $K=2048$ 的队列,Jeva 准确率 69.88%、p50 延迟 12.040 秒,JevK5 为 67.47%、约 28 秒。两者都可支持该队列,Jeva 在此对照的中位延迟约快 2.33 倍,并在决策头中一次读取完整候选集。InternDecision 两个变体在 $K=32$ 只支持 65/84 请求,更大队列超过登记的接口限制;不把其低覆盖切片的准确率与完整支持模型直接对比。(§4.3、图 8,PDF 第 8 页)
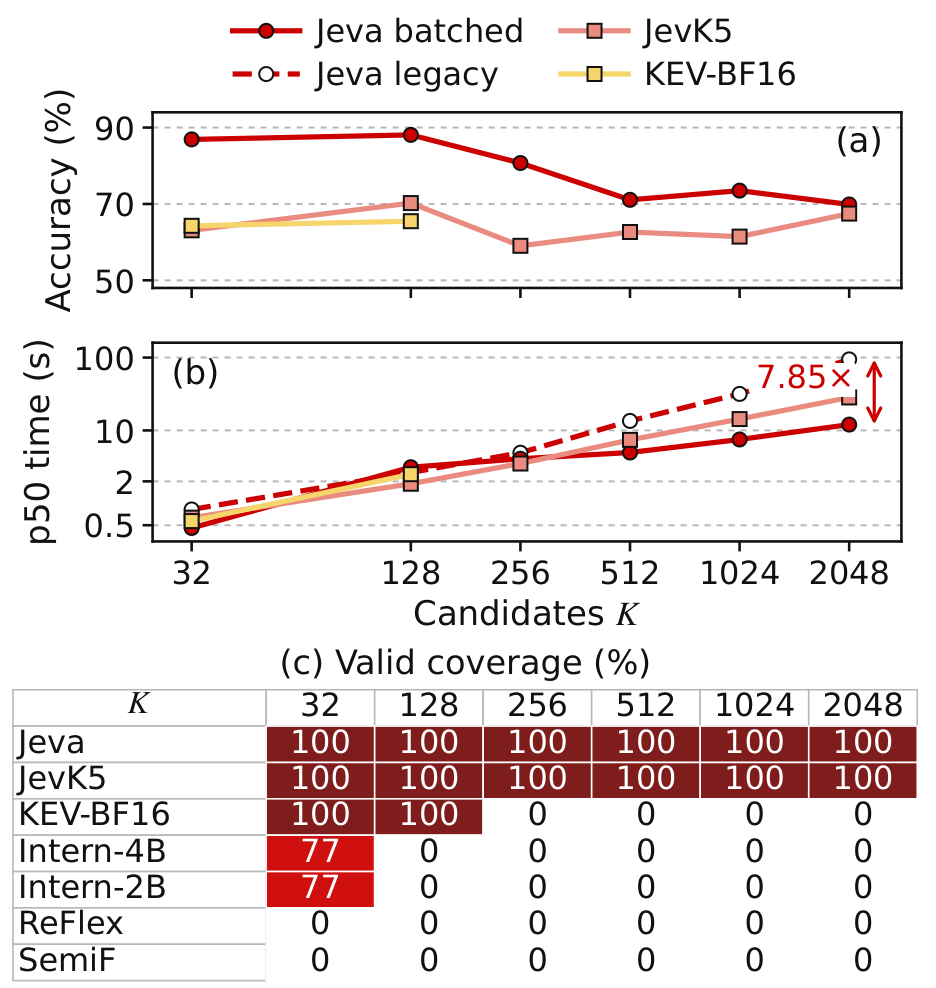
原文图 8,PDF 第 8 页。上面是完整支持切片的准确率,中间是自然请求流的 p50 延迟,下面逐队列列出支持率。虚线 Jeva 是旧的分块编码设置,实线是长度感知批处理。
长度感知的候选编码批处理为最多 256 行 / 131,072 填充 token;在相同 Jeva 检查点和候选顺序下,$K=2048$ 的 p50 从旧 chunk-2 编码的 94.459 秒降为 12.040 秒,是 7.85 倍的模型内部批处理改进。这与上段对 JevK5 的约 2.33 倍比较不是同一个分母。(§4.3,图 8(b),PDF 第 8 页)
另一个嵌套集合实验固定同一批 83 个查询,让候选数从 32 增至 2,048,并要求每个大小都判对。Jeva 为 58/83(69.88%),JevK5 为 48/83(57.83%),CLM 为 7/83(8.43%)。这里的 69.88% 是“跨所有候选数都正确”的比例,恰好与前述 $K=2048$ 不同查询队列的准确率同数,统计对象并不相同。(§4.3、图 7,PDF 第 7–8 页)
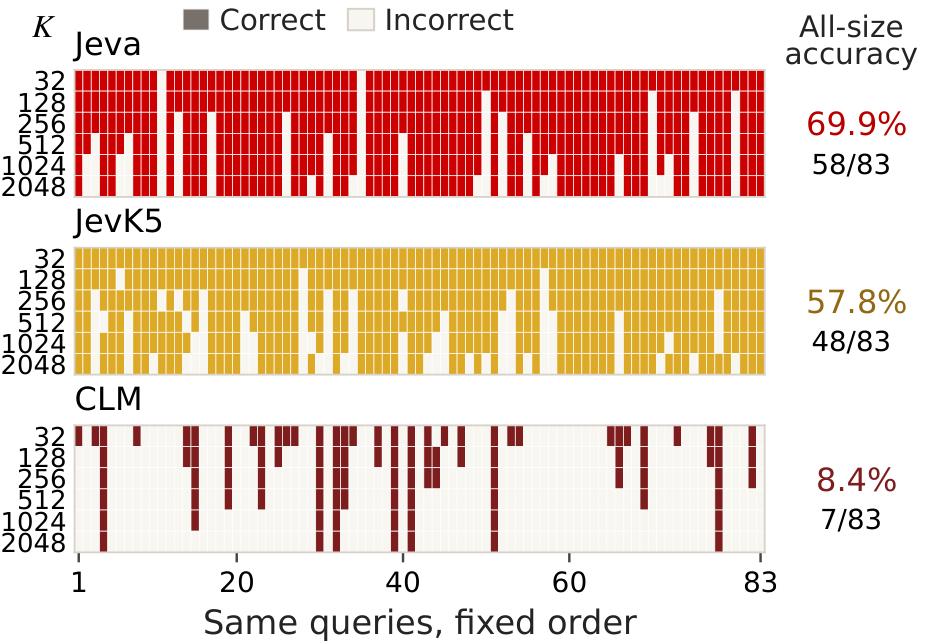
原文图 7,PDF 第 7 页。每列是同一个查询、每行是候选数量;只有一列所有行都正确,才计入右侧 all-size accuracy。
4.4 新组合与共享候选库的缓存收益
缓存实验固定模型权重,并轮换 Off、Set、Hybrid 模式、重置缓存。MLDR 的新组合请求被设计为整组候选缓存零命中:0% 复用时,Hybrid 不能减少候选编码;约 50% 复用时,其 p50 加速比为 1.95 倍;100% 单项复用时,p50 从 2,102.0 毫秒降至 75.1 毫秒,即两组中位数之比 27.98 倍;逐请求配对加速比的中位数是 27.86 倍。只缓存完整集合的 Set 在这些新组合中仍约 2.1 秒。(§4.4、图 9(a),PDF 第 8–9 页)
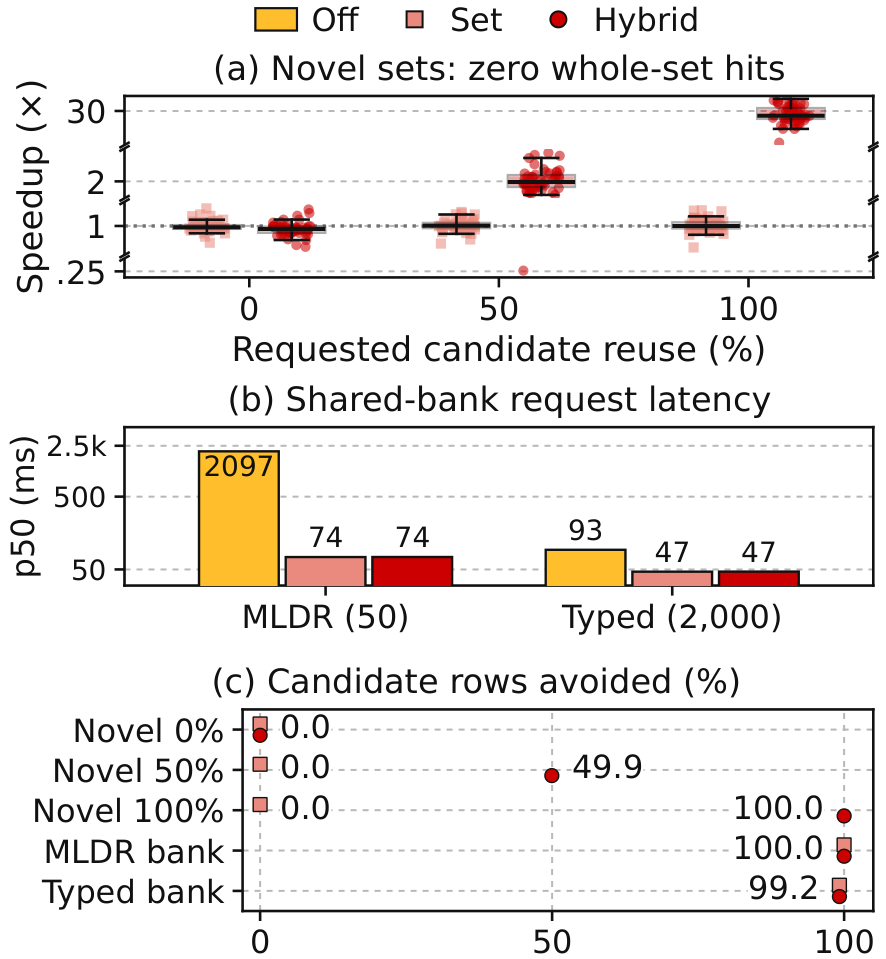
原文图 9,PDF 第 8 页。(a) 的 100% 指单项候选可复用,整组命中仍为 0;(b) 是共享候选库;(c) 是免去的候选编码行比例。新组合预热另行计时,不计入请求 p50。
共享库下,Typed Decisions 的 p50 由 93.1 毫秒降至 Set 的 46.6 毫秒、Hybrid 的 46.7 毫秒,避免 99.2% 的候选行编码;MLDR 的 p50 由 2,097.3 毫秒降至约 73.9/74.2 毫秒。Typed 计时含冷启动;MLDR 预热另计并排除。各条件的决策没有变化,但最大绝对概率差为 0.00736,可由不同批处理与浮点执行路径理解,不能把实现中的输出称为逐位相同。(§4.4,图 9(b,c),PDF 第 8–9 页;附录 B.5)
原文在这一实验的样本数上有一个值得留意的口径差异:§4.4 称每个复用水平有 50 个匹配 MLDR 查询,而图 9(a) 图注和附录 C.4 称每档绘出的新组合请求为 46 个。以上延迟按正文报告,涉及图中箱线图的样本量则按图注理解。(PDF 第 8–9、16 页)
五:结论与实际取舍
论文最有力的贡献是将四项决策结构要求落实到可检查的计算部件:独立候选编码支持复用,集合条件化状态更新允许候选间关系影响结果,覆盖门估计空答案,对称聚合确保候选重排只重排概率。理论给出了存在性的集合依赖表达能力、精确算术下的置换与缓存等价以及固定最终分数时覆盖门不受弱候选数量强制影响的性质;实验分别检验了质量、空答案、顺序稳定、扩容和请求延迟。(§3–5,PDF 第 4–9 页)
理解结果时有三项实际取舍。第一,缓存节省的是候选侧工作;请求编码和决策头每次仍运行,且必须为固定权重与输入策略管理缓存失效。第二,ToolRet 的弱/未判定负例、不同模型的开集适配与各自运行时,限定了横向准确率和延迟比较的含义。第三,Jeva 结合了专门架构与分阶段训练,表中跨模型优势不能单独归因于某一个模块;论文未以相同骨干和训练配方逐项删除四个部件来估计各自贡献。对需要反复在大型候选库上做类型化决策的场景,这篇论文的可迁移思路是:先分开表示候选,再用小型集合模块完成当次判断,并显式建模答案是否存在。