NoteBank:用稀疏文本存档与原生回放释放线性注意力的长上下文能力
论文:History Replays Itself: Unleashing Long-Context Capability in Linear Attention
作者:Li Nanbo、Firas Laakom(共同一作),Yilan Zhang、Piotr Piękos、Yimeng Chen、Liangyu Wang、Yifan Xu、Mateusz Ostaszewski、Dandan Guo、Wenyi Wang、Yanning Dai、Yuhui Wang、Jürgen Schmidhuber;KAUST。
版本:arXiv:2610.15715v1,2026-10-11 提交;获取与研读日期:2026-11-02。
原文与汇报:原文 PDF · 英文幻灯片 PDF · 可编辑 TeX。
- 发表:未查到正式发表信息(截至 2026-11-02);作者主页将本文列为 Preprint,arXiv 页面未列会议或期刊出版记录。
- 代码:待发布;作者项目页标示“Code Coming soon”。
论文总览
NoteBank 的出发点是:递归状态擅长持续计算,却不必独自承担长期证据存储。它在不知道未来问题时,从输入流中选出连续文本,保存原始 token ID 和由骨干自身特征构造的地址;问题到来后,检索少量笔记,把它们重新送入同一个模型,再回答问题。权重可以完全冻结,写入、寻址和读出都不需要额外的神经模型。
最强证据来自同一 Gated DeltaNet(GDN)检查点的检索实验:约百万 token 上下文中,六项 RULER 检索任务的平均分从 1.7% 提高到 70.3%(+68.6 个百分点),默认只回放两条、每条最多 64 token 的笔记。关键变化是历史文本可重新访问,而非递归矩阵变大。(Sec. 4.1,PDF p. 6,Fig. 3)
理解论文需要分清三个层次:
- 保存、找到、用好证据是不同问题。 GDN 的检索接近存档覆盖率;Mamba-2 有较多已存但未取出的证据,路由仍有明显改进空间。
- 任务收益的来源不同。 GDN 的冻结权重检索恢复很强,但其 LongBench 大部分提升来自 LoRA 读出适配。Mamba-2 还有读出前状态重置这一独立干预。
- 开销需要区分口径。 百万 token 下 GDN 增加约 0.025% 的解析 FLOPs,端到端实测延迟增加约 12.4%。74.5 MiB 是状态与存档的持久载荷;“约 1/2600”对应匹配宽度、层数和精度的理论全 MHA KV cache。
结构地图
以下为从 1 开始的 PDF 页码,本版本与印刷页码一致。
| 原文章节 | 论证作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 固定状态同时承担计算与记忆的矛盾 | pp. 1–3;Fig. 1 |
| 2 Preliminary | 递归更新、先上下文后问题的设定 | p. 3;Eq. (1) |
| 3 NoteBank | 存档、写入、地址、投票与回放;复杂度 | pp. 3–5;Fig. 2,Eqs. (2)–(7) |
| 4 Recovering Long-Context Capability | 合成检索、LongBench 与大模型结果 | pp. 5–7;Fig. 3,Tables 1–2 |
| 5 Almost a Free Lunch? | 解析运算量、持久载荷、实测延迟 | pp. 7–8;Fig. 4 |
| 6 Understanding NoteBank: Evidence Access and Utilisation | 覆盖率、oracle、替代路由、适配归因 | pp. 8–10;Fig. 5,Tables 3–4 |
| 7 Discussion and Limitations | 方法启发与后续方向 | p. 10 |
| A Related Works | 与状态缓存、RAG、重复阅读等区分 | pp. 16–17 |
| B Algorithmic Details | 句子选择、随机坐标压缩、回放与 LoRA | pp. 17–19;Algorithm 1,Eqs. (8)–(10) |
| C Experimental Details | 模型、样本、重置、训练与成本记账 | pp. 20–23;Eqs. (11)–(21) |
| D Additional Results | 分任务、重置对照、成本与预算消融 | pp. 24–30;Figs. 6–12,Tables 5–8 |
一:动机——把计算状态与证据保存分开
1. 固定状态为什么成为访问瓶颈
原文用一个层、一个头的广义线性注意力表示递归核心:
$\mathbf q_t,\mathbf k_t\in\mathbb R^{d_k}$,$\mathbf v_t\in\mathbb R^{d_v}$,$\mathbf S_t\in\mathbb R^{d_v\times d_k}$;$\mathbf A_t$控制保留与变换,$\beta_t$控制写入强度。标准加性线性注意力可取$\mathbf A_t=\mathbf I,\beta_t=1$;门控和 delta rule 改变更新方式。该表达省略外围输出门控和归一化。(Sec. 2,PDF p. 3,Eq. (1))
模型先读上下文$\mathbf X=(x_1,\ldots,x_T)$,随后才收到问题$\mathbf Q$。普通推理只保留$\mathcal S_T$,回答依赖$p_\phi(\mathbf Y\mid\mathcal S_T,\mathbf Q)$。越早出现的证据,越需要在后续大量更新中幸存,而写入时尚不知道它将来是否重要。
更好的更新规则能改善压缩,却不能让有限精度的固定状态无损保存任意增长的历史。NoteBank 改变可访问的记忆集合:在状态之外保存部分原文,后续重新计算。这也意味着整个系统的记忆随历史增长,固定大小的是骨干递归状态。
2. 相对于已有办法,变化在哪里
| 办法 | 保留或重复什么 | 与 NoteBank 的关键区别 |
|---|---|---|
| JRT(Just Read Twice) | 重复完整上下文和问题 | NoteBank 在问题已知后只回放选中的少量片段 |
| 递归状态缓存,如 Memory Caching、MARCH | 历史压缩状态 | NoteBank 存原始文本,取出后重新编码 |
| KV 缓存检索,如 InfLLM | 历史神经 K/V 表征 | NoteBank 无需保存历史 token 的完整多层 K/V |
| 常见文本检索增强流程 | 文本及独立检索表征 | NoteBank 复用首次因果处理的骨干特征,不另训检索器 |
此表依据 Appendix A(PDF pp. 16–17)归纳。独特组合是“未知问题时稀疏存原文 + 骨干原生寻址 + 原生前向回放”;外部记忆、文本检索和重复阅读各自并非本文新提出。
二:方法——Write、Address、Replay
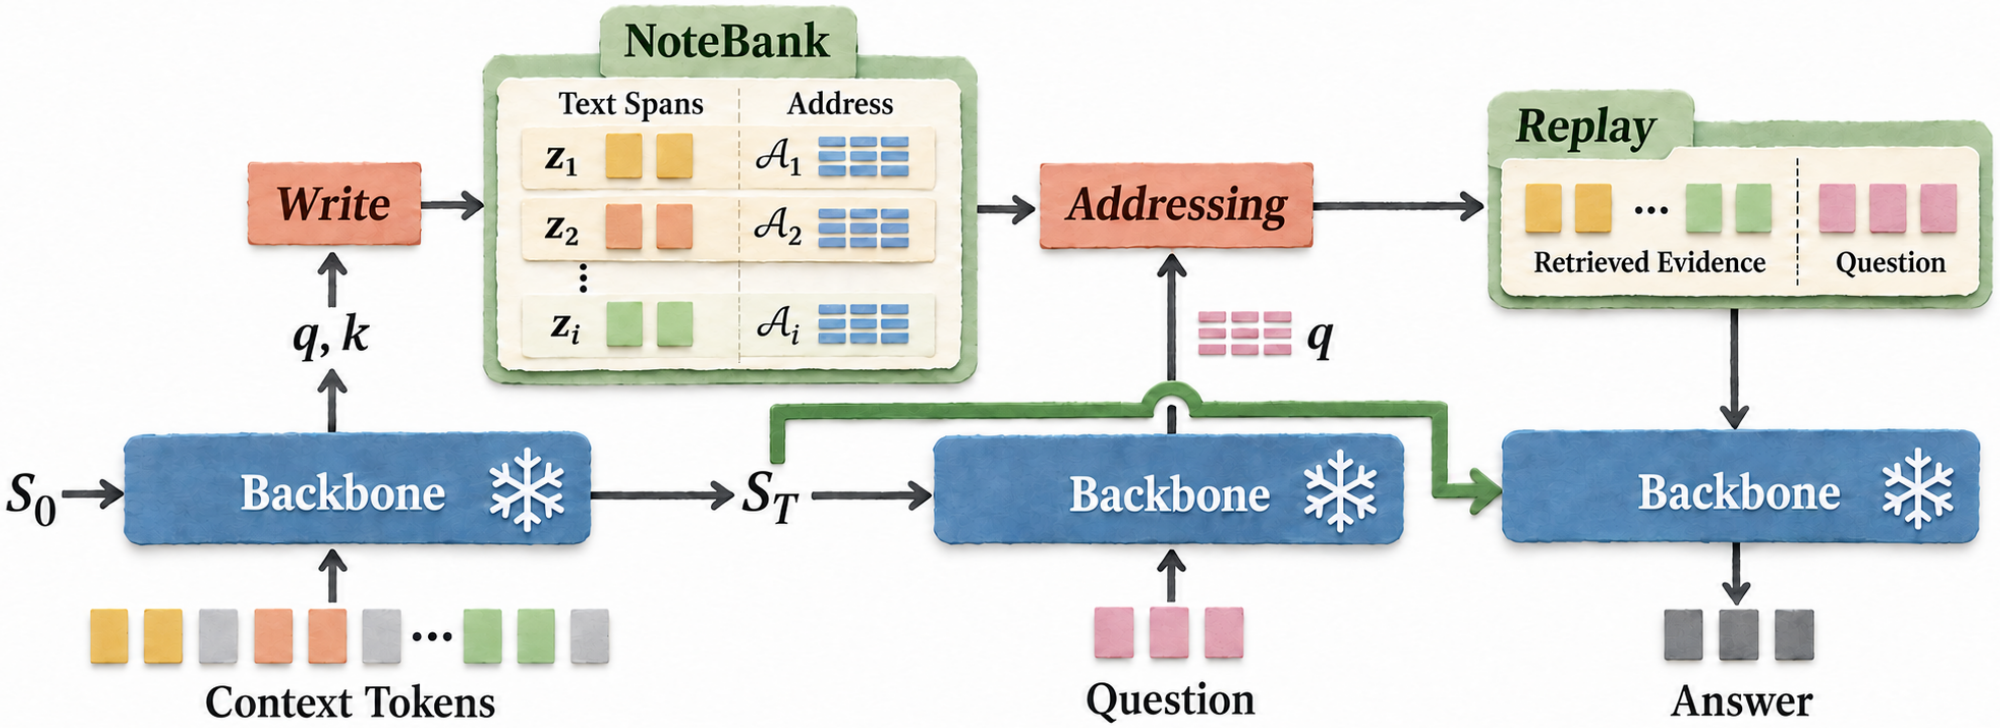
原文 Fig. 2,PDF p. 4。按左到右读:上下文前向同时产生递归状态和笔记;问题先走检索分支;答案分支从保留状态的另一份副本开始,先读检索文本再读问题。两个分支不能串接成“永久写入问题后再回放”。
1. 存储对象与预算
$\mathbf z_i$是原始 token ID;$\boldsymbol\rho_i^{\ell,h}\in\mathbb R^{d_\rho}$是该段在某一层—头通道的地址。文本独立于后续递归状态更新保存。(Eq. (2),PDF p. 3)
| 符号 | 含义 | 1.3B 短笔记实验设置 |
|---|---|---|
| $C$ | 完整写入块的 token 数 | GDN/GDN-2 为 512;Mamba-2 为 256 |
| $W$ | 每个完整块最多写几条笔记 | 2 |
| $B$ | 每条笔记最大 token 数 | 64 |
| $R$ | 每问题最多取几条笔记 | RULER 主结果为 2;消融为 1、2、4 |
| $J$ | 索引的层—头通道数 | GDN 192;GDN-2 288;Mamba-2 48 |
| $d_\rho$ | 每通道地址维数 | 16 |
大模型实验另报告回放条数,不据此假定所有实验的块长、片段长完全相同。(App. C.1/C.3,PDF pp. 20–21)
2. Write:用 key 的局部独特性选文本
对块$\mathcal C$和通道$(\ell,h)$,先将每个 key 归一化,再求均值,最后归一化均值:
token 的独特性为
帽号表示$\ell_2$归一化。方向越偏离块内典型 key,分数越高。这是与未来问题无关的局部显著性启发式,“不同寻常”只是值得保存的候选信号。(Eqs. (3)、(8),PDF pp. 4、18)
具体选段遵循句子结构:
- 用 48-token 滑窗累加$d_t$,选最高分窗口。
- 以窗口中央 token 所在句子为起点,先左后右加入相邻句子,直到再扩展会超过$B$。
- 若初始句子自身超长,在句内保留合法的连续$B$-token 片段。
- 为第二条笔记排除与第一条重叠的整个句子,再选剩余最高分窗口;没有候选时只写一条。
块之间保留递归状态。候选区额外包含上一块最后 32 token,沿用其原块分数和 query 特征。一次写入内的笔记不重叠,跨块仍可能重叠。最后不足$C$的尾块只做前向、不写笔记;全文短于$C$时存档为空。(App. B.2,PDF pp. 17–19)
3. 地址:由 key 选位置,实际存 query
每通道分别在片段$I_i$中找独特性最高的位置:
key 用来挑位置,存储的是该位置的 query 特征,所以后续匹配的是压缩 query 与压缩 query。不同通道可以选同一片段中的不同 token。(Eq. (4),PDF p. 4;Eq. (9),PDF p. 19)
$P^{\ell,h}\in\{0,1\}^{d_\rho\times d_k}$是固定坐标选择矩阵:每通道随机选 16 个不重复坐标,跨文档和问题不变,没有学习参数。笔记地址以未归一化 BF16 保存;问题表征也转为 BF16,匹配时两者转为 FP32,再归一化算余弦。
这一设计让多个原生通道提供互补寻址线索,但没有显式训练语义检索目标。因此它依赖骨干已有表征的结构,不同骨干的路由质量可能不同。
4. Address:每通道先找最像的一条,再投票
从$\mathcal S_T$的临时副本处理问题,获得$\mathbf u_\tau^{\ell,h}=P^{\ell,h}\mathbf q_\tau^{\ell,h}$。对笔记$i$:
对问题 token 取最大值,允许局部表达触发匹配;通道各投一票,使每通道具有相同票权。取票数最高的至多$R$条,同票优先较早插入的笔记。取出的文本按原文位置排序,不按得分排序。(Eq. (5),PDF pp. 4–5)
教学例子:三个通道分别投给 A、B、A,则 A 两票、B 一票;若$R=2$,两条都取回,但回放先后由原文位置决定。
5. Replay:丢弃检索分支,重新读证据与问题
检索时处理过问题的临时状态被丢弃。答案分支重新复制$\mathcal S_T$,随后执行
$\mathbf R$包含原始 token;位置编号从上下文末端继续,不恢复到笔记旧位置。回放通过正常前向作用于全部网络;混合模型也经过完整注意力块,遵循既有注意力和缓存策略。(Eq. (6),PDF p. 5;App. B.4,PDF p. 19)
Algorithm 1(PDF p. 18)可概括为:因果处理上下文并写笔记 → 从状态副本探测问题 → 匹配/投票/取回并丢弃临时状态 → 从另一副本先回放再问答。问题因此处理两次,但上下文只完整处理一次。
Mamba-2 实验有一个特例:回放前将递归状态置零,保留卷积缓存和位置信息;上下文处理、写笔记和问题检索不变。此干预针对长输入中的状态幅度爆炸,影响结果归因,见后文。
6. 可选 LoRA:学习如何读,不改变存什么
NB-TF 完全不训练。NB-LoRA 在冻结骨干投影上加入$\Delta W=(\alpha/r)BA$,仅在回放、再次处理问题和生成答案时启用;上下文写入与检索时关闭。GDN 适配 Q/K/V/O,Mamba-2 适配$x/B/C$分支及输出投影。
只对答案(含 EOS)计算负对数似然:
上下文状态和离散选段当作常量,梯度通过回放及问答传播到适配器。作者用 2,400 条 Natural Questions 衍生短答案样本、少于 9.3M token,rank 8、$\alpha=16$,600 次 AdamW 更新;各骨干及检索预算的适配器在全部 12 项 LongBench 任务间共享。训练含 678 条无支持证据样本,仍保留原 gold answer,不是训练专门的拒答目标。(App. B.4/C.4,PDF pp. 19、21)
7. 复杂度:存档增长,回放有界
固定模型维度与块长时,写入为$O(T)$;每问题额外做一次前向,再穷举匹配,成本$O(|\mathbf Q|N_TJd_\rho)$;回放最多$RB$ token。存储与寻址随历史线性增长,单次回放长度不随历史增长。(Sec. 3.3,PDF p. 5,Eq. (7))
“稀疏”的量级值得具体理解:$C=512,W=2,B=64$最多每块存 128 token,即输入数量的 25%。百万 token 统计中平均存了约 232,514 token,约占输入数量的 22.2%(按存储次数计,跨块可能重复);每次却只回放至多 128 个。存档预算与读取预算差别很大。(App. C.7,PDF p. 23;百分比为据原文计数计算)
三:实验——每组比较检验什么
1. 模型与对照
主检索实验为三个 1.3B 检查点:GDN、GDN-2、Mamba-2。大模型为 NVIDIA Mamba-2-8B 和 Qwen3.5-9B。后者有 24 个 GDN 块、8 个 Transformer 注意力块;仅从 GDN 块取写入和寻址特征,回放经过完整网络。
同一骨干内的 Plain、JRT 和 NB 使用同一检查点。Plain 读一次;JRT-Prompt 将上下文和问题读两遍;NB-TF 检验记忆接口;NB-LoRA 引入读出训练。Transformer、Titans+SSC、MARCH 的 LongBench 分数来自其他工作的汇总,是背景参照,预训练条件不同。(App. C.1/C.3/D.1,PDF pp. 20–21、25)
2. 数据、指标与预算
| 实验 | 实际评估范围与指标(越高越好) | 条件 |
|---|---|---|
| RULER-NIAH | 3 项单针 + multi-key/query/value;每长度每任务 100 例;六任务等权平均 | 4K、16K、64K、256K、1M;主图$R=2$;$K=2^{10}$ |
| LongBench-v1 | 12 子集,每项 30 例,共 360 例;原生任务指标在 0–100 尺度上宏平均 | GDN $R=1$;Mamba-2 $R=4$ |
| MemoryAgentBench | FactConsolidation、EventQA、RULER QA 的选定配置;任务宏平均准确率 | 主表$R=4$;报告 2,100 问题;有 clean-start 对照 |
| LongBench-v2 | 375 道 QA/对话相关完整输入样本;样本准确率 | Qwen $R=8$;两者均开 YaRN,关闭 thinking,贪心生成 |
| 效率 | FLOPs、持久载荷、延迟与峰值显存 | H100 80GB、BF16、batch 1;实测固定生成 32 token |
LongBench-v1 的 12 子集为 narrativeqa、qasper、multifieldqa_en、hotpotqa、2wikimqa、musique、gov_report、qmsum、multi_news、trec、triviaqa、samsum。总均分混合了不同任务的评分方式,23.03 不是统一问答准确率。LongBench-v2 仅保留预留回放与生成空间后仍能完整放入位置预算的样本,不截断,也不代表完整 benchmark。(App. C.2,PDF p. 20)
MemoryAgentBench 的协议描述有一处不一致:App. C.2 列出 11 个配置,其中 8 组各 100 问题、3 组各 500 问题,合计应为 2,300;正文和表格却报告 2,100。这里保留原表分数和“报告 2,100”的口径,不自行改总数或由任务家族均值重算总体结果。
3. Mamba-2 的状态处理
作者观察到未经修改的 Mamba-2 在长上下文中状态幅度爆炸,在读出边界采用$\mathbf S^{\ell,h}\leftarrow\lambda\mathbf S^{\ell,h}$。NB 取$\lambda=0$,即回放前重置;主文 Plain 保留原模型开箱即用表现。(App. C.3,PDF p. 21)
所以 Mamba-2 的 Plain→NB 同时包含状态处理和证据回放。附录 Mamba-2-8B 的 clean-start 对照直接显示重置后再加入回放的增量。GDN 的冻结权重检索结果不涉及这一额外重置。
四:结果——从检索恢复到代价与归因
1. 跨长度检索:GDN 的证据最清楚
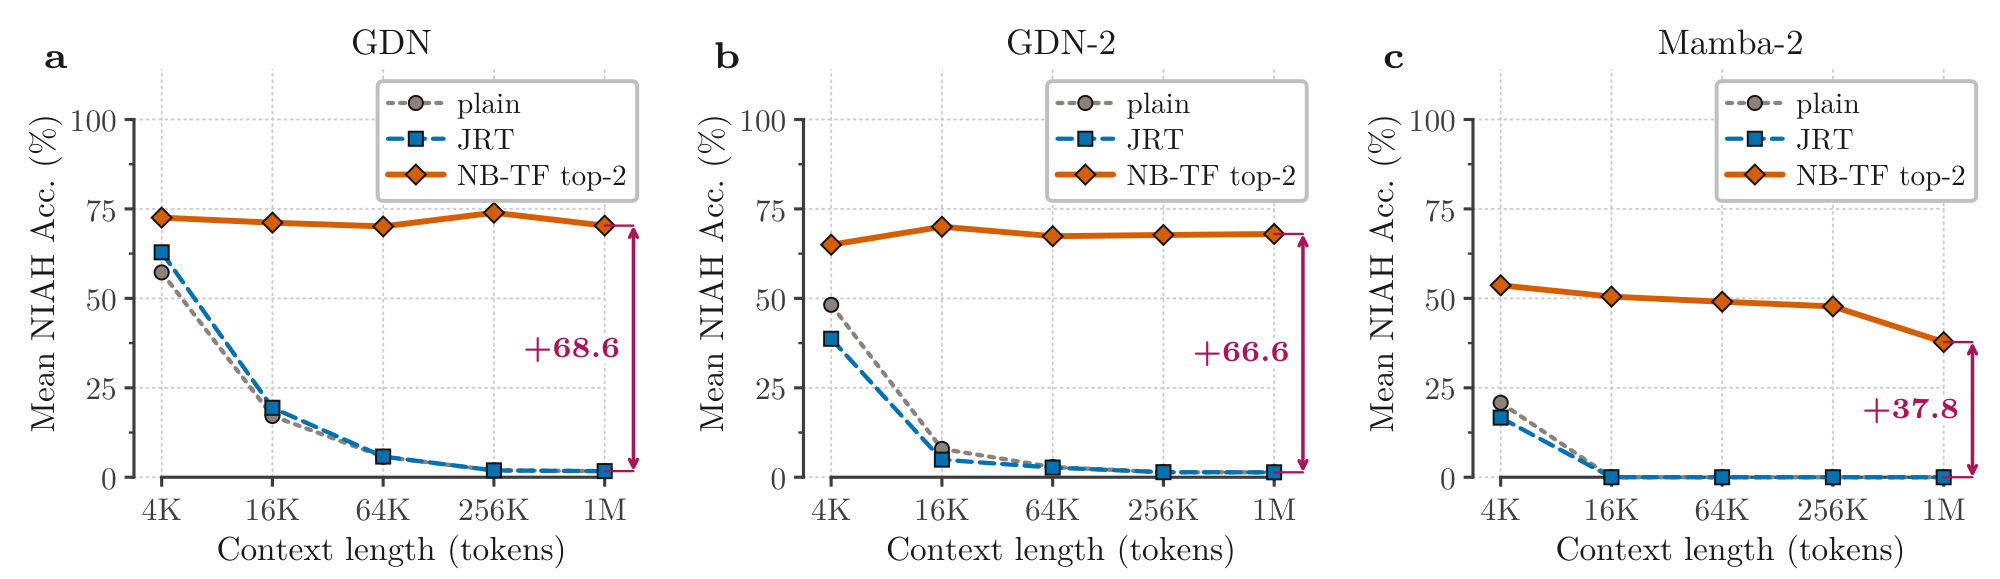
原文 Fig. 3,PDF p. 6。横轴为上下文长度,纵轴为六项 RULER 平均分;面板依次为 GDN、GDN-2、Mamba-2。灰/蓝曲线是 Plain/JRT,橙线是 NB-TF top-2。
GDN 从 4K 到 1M 维持约 70%,Plain 和 JRT 随长度增大接近零。百万 token 处,三个骨干分别比 Plain 高 68.6、66.6、37.8 个百分点。GDN 的 1.71→70.33 在正文四舍五入为 1.7→70.3;这些是$R=2$结果,不能与后续 top-1/top-4 混用。
同一组冻结参数可以利用重新送入的证据,即使其递归状态原本几乎无法支持远距离检索。重复整个长输入的 JRT 没有同样恢复,支持问题条件化的选择性回放更有效。
附录 Fig. 6(PDF p. 24)显示:单针通常恢复较好,多问题和多值仍困难,少量笔记可能覆盖不了全部目标;Mamba-2 的长度退化更明显。70.3 是这六项检索的平均表现。
2. LongBench:无训练增益与适配增益不同
| 骨干 | 方法 | 单文档 QA | 多文档 QA | 摘要 | Few-shot | 总均分 |
|---|---|---|---|---|---|---|
| GDN | Plain | 6.88 | 7.02 | 13.99 | 34.08 | 15.49 |
| GDN | JRT | 7.72 | 6.63 | 14.79 | 33.56 | 15.67 |
| GDN | NB-TF | 6.66 | 7.33 | 13.52 | 36.76 | 16.07 |
| GDN | NB-LoRA | 19.06 | 20.48 | 11.37 | 41.22 | 23.03 |
| Mamba-2 | Plain | 2.22 | 2.10 | 11.27 | 11.56 | 6.79 |
| Mamba-2 | JRT | 2.39 | 1.89 | 9.21 | 8.34 | 5.12 |
| Mamba-2 | NB-TF | 5.98 | 5.36 | 16.51 | 25.88 | 13.43 |
| Mamba-2 | NB-LoRA | 17.84 | 15.54 | 7.46 | 27.52 | 17.10 |
Table 1(PDF p. 6),Sec. 4.2(p. 7)。GDN 为 top-1,Mamba-2 为 top-4;类别和总分均为相应任务的宏平均。
GDN 无训练只提高 0.58 分,并非每类都改善。适配后 QA 大幅提高,但摘要从 NB-TF 的 13.52 降到 11.37;Mamba-2 摘要从 16.51 降到 7.46。适配语料偏短答案 QA,收益具有明显任务依赖。
Transformer、Titans+SSC、MARCH 的参考总分分别为 16.05、16.50、14.87;其 LongBench 模型采用 16K 上下文训练,而本研究的 GDN、Mamba-2 检查点分别在 2K、4K 序列预训练。这支持“已有短上下文模型可加装记忆”,不构成相同预训练预算下的架构排名。(Table 5,PDF p. 25)
适配贡献的二乘二对照:
| GDN 的记忆接口 | RULER@1M Frozen | RULER@1M LoRA | LongBench Frozen | LongBench LoRA |
|---|---|---|---|---|
| 无 NoteBank | 1.7 | 1.7 | 15.49 | 22.72 |
| 有 NoteBank,top-1 | 59.8 | 58.4 | 16.07 | 23.03 |
Table 4,PDF p. 10。适配器有/无回放分别训练,数据与训练预算匹配。检索恢复主要来自记忆:只适配仍为 1.7,加 NB 已达 59.8。LongBench 则主要来自适配:不加 NB 也能到 22.72,与加 NB 的 23.03 只差 0.31 分。因此不能将 15.49→23.03 全部归给存档。
3. 大模型:增益、重置与子集
| 模型 / benchmark | Plain | Clean start | NB-TF | 条件 |
|---|---|---|---|---|
| Mamba-2-8B / MemoryAgentBench | 0.0 | 13.0 | 14.7 | top-4;回放前重置 |
| Qwen3.5-9B / MemoryAgentBench | 55.7 | — | 56.8 | top-4;YaRN 同开 |
| Qwen3.5-9B / LongBench-v2 | 46.1 | — | 49.3 | top-8;375 题,YaRN 同开 |
Tables 2、6,PDF pp. 6、25;均为作者报告的百分制结果。Qwen 增量分别为 +1.1、+3.2 个百分点。
Mamba-2-8B 只做 clean start 已到 13.0,top-4 在此基础上增加 1.7 个百分点。最大任务家族增量在 single-hop FactConsolidation:14.0→22.0。top-1→top-4 并非处处有益,EventQA 从 17.9 降到 16.4。(App. D.1,PDF pp. 25–26)
Qwen 的 top-1 在 MemoryAgentBench 上与 Plain 总分相同,top-4 才提高。强混合骨干有收益,但量级远小于弱递归骨干的合成检索恢复。
4. 效率:运算、载荷和时间分别看
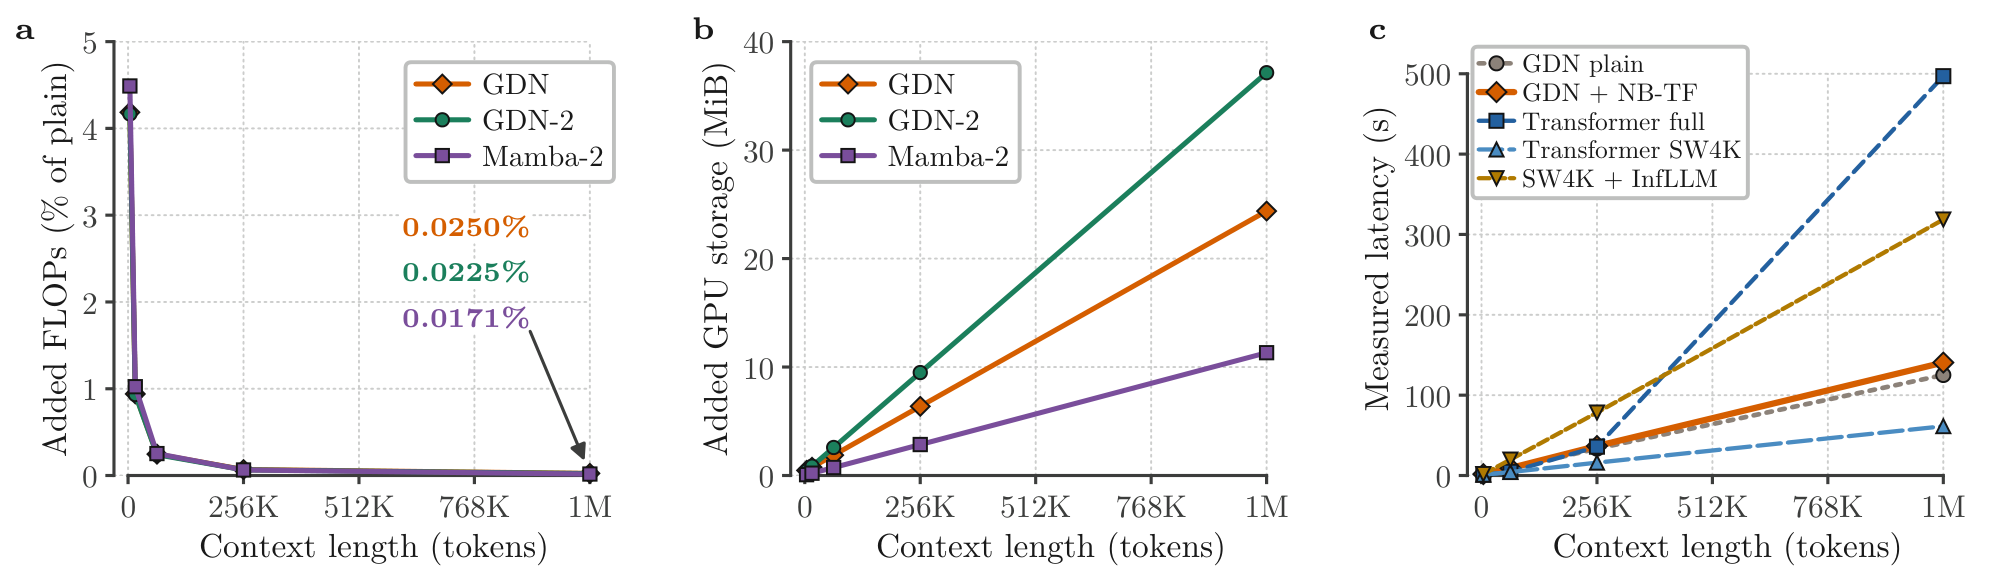
原文 Fig. 4,PDF p. 8。左为附加解析 FLOPs 比例,中为增加的持久 GPU 存储,右为端到端时间。固定的额外问题前向和回放随输入变长被摊薄;地址存储仍线性增长,时间也没有与 Plain 完全重合。
解析 FLOPs。 对纯递归骨干,$f_\phi$为每 token 骨干运算量,$h_\phi$为语言模型头成本:
输出长度匹配时,普通问题处理和生成成本相消;增量是额外问题探测和回放。乘加按两个 FLOPs 计。GDN 在 1M 的 Plain 约 2891.4 TFLOPs,增量约 0.722 TFLOPs,即 0.025%;GDN-2、Mamba-2 为 0.0225%、0.0171%。统计为总增量除以总 Plain 成本,不是逐样本比例的简单平均。(Eqs. (12)–(16),PDF pp. 22–23)
写入和路由有随$T$增长的项,相对开销趋向小的非零底。解析计数不包含排序、索引、数据搬运等全部系统成本,采用递归等价运算量;混合模型还需计回放的注意力成本。
持久存储。 设存档 token 数为$U$,BF16 地址、int32 token、每笔记三个 uint64 位置字段的载荷为
| GDN 百万 token 下持久项目 | 大小 |
|---|---|
| FP32 递归状态 | 48 MiB |
| BF16 卷积缓存 | 1.125 MiB |
| 地址、文本与元数据 | 24.959 MiB |
| 辅助张量 | 约 0.402 MiB |
| 合计 | 约 74.49 MiB |
参照为$M_{\mathrm{MHA}}=4|\mathcal L|DP$ bytes,$|\mathcal L|=24,D=2048$,不共享 KV 头、BF16 K/V,约 196,503.5 MiB(约 192 GiB)。比值约 1/2638,摘要圆整为约 1/2600。(Eqs. (17)–(21),PDF p. 23)
这里排除权重、瞬时 workspace、状态分支副本和 Python 对象开销;CPU 文本与元数据约 0.98 MiB。另一个实测 Transformer 基线采用 32 query / 8 KV heads 的 GQA,与理论全 MHA 的规模不同;不能把 1/2600 当作二者总显存峰值比。
实测成本。
| GDN,1M 输入,H100,batch 1,固定生成 32 token | Plain | NB-TF top-2 |
|---|---|---|
| 端到端延迟 | 125.11 s | 140.64 s |
| 峰值 GPU 显存,含权重及临时分配 | 2.93 GiB | 3.27 GiB |
| 六项 RULER 平均分(独立质量评估) | 1.71 | 70.33 |
Sec. 5.3、Table 7,PDF pp. 8、26。延迟增加 15.53 秒,约 12.4%;多个匹配长度的增量为 10.6%–13.2%。计时每轮重建存档,包括问题探测、路由和回放,排除模型加载与最初的 prompt tokenization。
同一 Transformer 检查点的 Full、SW4K、InfLLM 在 1M 的检索分数为 0、1.17、0。它们未额外伸长 RoPE,输入超过该检查点配置的 4096 位置范围;该比较描述受测系统,不能外推为 NoteBank 优于所有长上下文 Transformer。(App. C.5/D.1,PDF pp. 22、26)
5. 保存、路由、读出:哪里还有余量
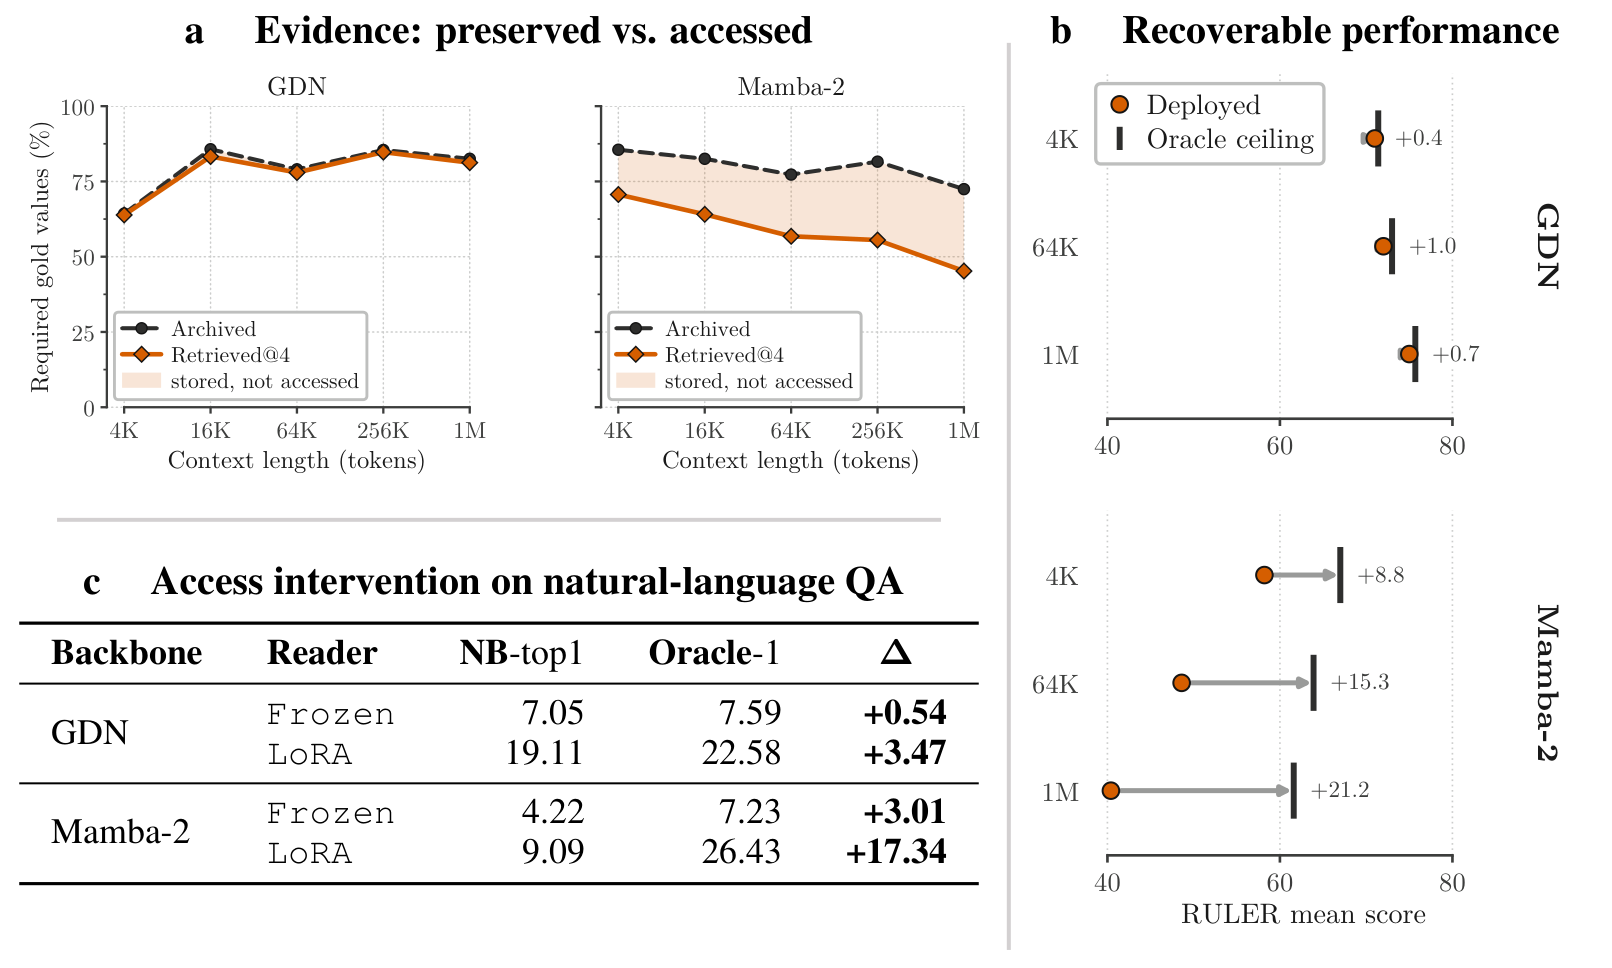
原文 Fig. 5 完整面板裁切,PDF p. 9。左上比较 gold value 存档覆盖率与 top-4 取回覆盖率,阴影为已存未取回;右侧 oracle 固定存档、reader 与预算,只换选段;左下在四项自然语言 QA 上选单条笔记。
GDN 取回覆盖率紧贴存档覆盖率,Mamba-2 间隔更大。百万 token oracle 将 GDN 从 75.0 提到 75.7,Mamba-2 从 40.4 提到 61.6。此干预配置与主图 top-2 不同,75.0 不能与 70.3 直接拼成一组实验。
四项 LongBench QA 为 hotpotqa、2wikimqa、musique、qasper。oracle 选包含答案字符串的片段:Mamba-2 冻结 reader 4.22→7.23,LoRA reader 9.09→26.43;GDN 对应 7.05→7.59、19.11→22.58。更好读出可放大正确寻址的收益,但包含答案未必提供完整支持证据,这一自然语言 oracle 是代理诊断,不是严格上界。(Sec. 6.1,PDF pp. 8–9)
替代路由是否有用?
| 路由,固定存档与 top-1 | RULER@1M GDN | RULER@1M Mamba-2 | LongBench GDN | LongBench Mamba-2 |
|---|---|---|---|---|
| 随机 | 1.7 | 0.0 | 21.96 | 13.83 |
| 平均输入 embedding | 30.8 | 20.8 | 22.40 | 16.70 |
| 原生特征投票 | 59.8 | 37.6 | 23.03 | 14.25 |
| BM25 | 64.0 | 52.7 | 23.50 | 18.66 |
| BGE | 45.4 | 34.0 | 23.77 | 17.24 |
Tables 3、8,PDF pp. 10、27。原生路由的 RULER 表现优于随机、平均 embedding 和 BGE;BM25 又进一步提高 Mamba-2。LongBench reader 固定为 LoRA,GDN 不同路由差距较小。
RULER reader 的原文标注不一致:Table 3 图注概称固定 LoRA readers,但 GDN 的 59.8 在 Table 4 列为 Frozen,LoRA 为 58.4。因此保留同表路由比较,不把它与 Table 4 当成完全相同适配条件的实验。
原生路由 26 ms 包括问题前向、匹配和投票;CPU BM25 为 87 ms;BGE 的 2630 ms 包含全库存档编码,平均 embedding 的 7600 ms 也有不同计时范围。Table 8 已说明它们不是等范围的逐查询延迟排名,不能直接算出原生路由相对 BGE 的查询加速倍数。
6. 消融:多存、多读、读更长并不等价
| 变量 | 关键发现 | 含义与出处 |
|---|---|---|
| 每块写入$W$ | 2 条优于 1 条,增加算术较少 | 打分可复用,覆盖与存储量增加。Fig. 8,p. 28 |
| 回放条数$R$ | 1M 时 GDN 59.5→75.2,Mamba-2 37.1→40.8(1→4 条) | 边际收益随模型、长度变化。Fig. 9,pp. 27–28 |
| 块长$C$ | GDN 的 512 不逊于 64;Mamba-2 长输入更受益于 64;2048 明显变差 | 更密集写入增加保存机会和存储。Fig. 10,pp. 28–29 |
| 单条长度$B$与$R$ | 1M 最佳均为$(128,4)$:GDN 76.8,Mamba-2 41.3 | Mamba-2 的$B=256$普遍更差。Fig. 11,p. 29 |
| LoRA 下$B\times R$ | LongBench 最佳:GDN $(256,2)$为 24.13;Mamba-2 $(128,4)$为 17.81 | 训练后仍依赖证据数量与粒度。Fig. 12,pp. 29–30 |
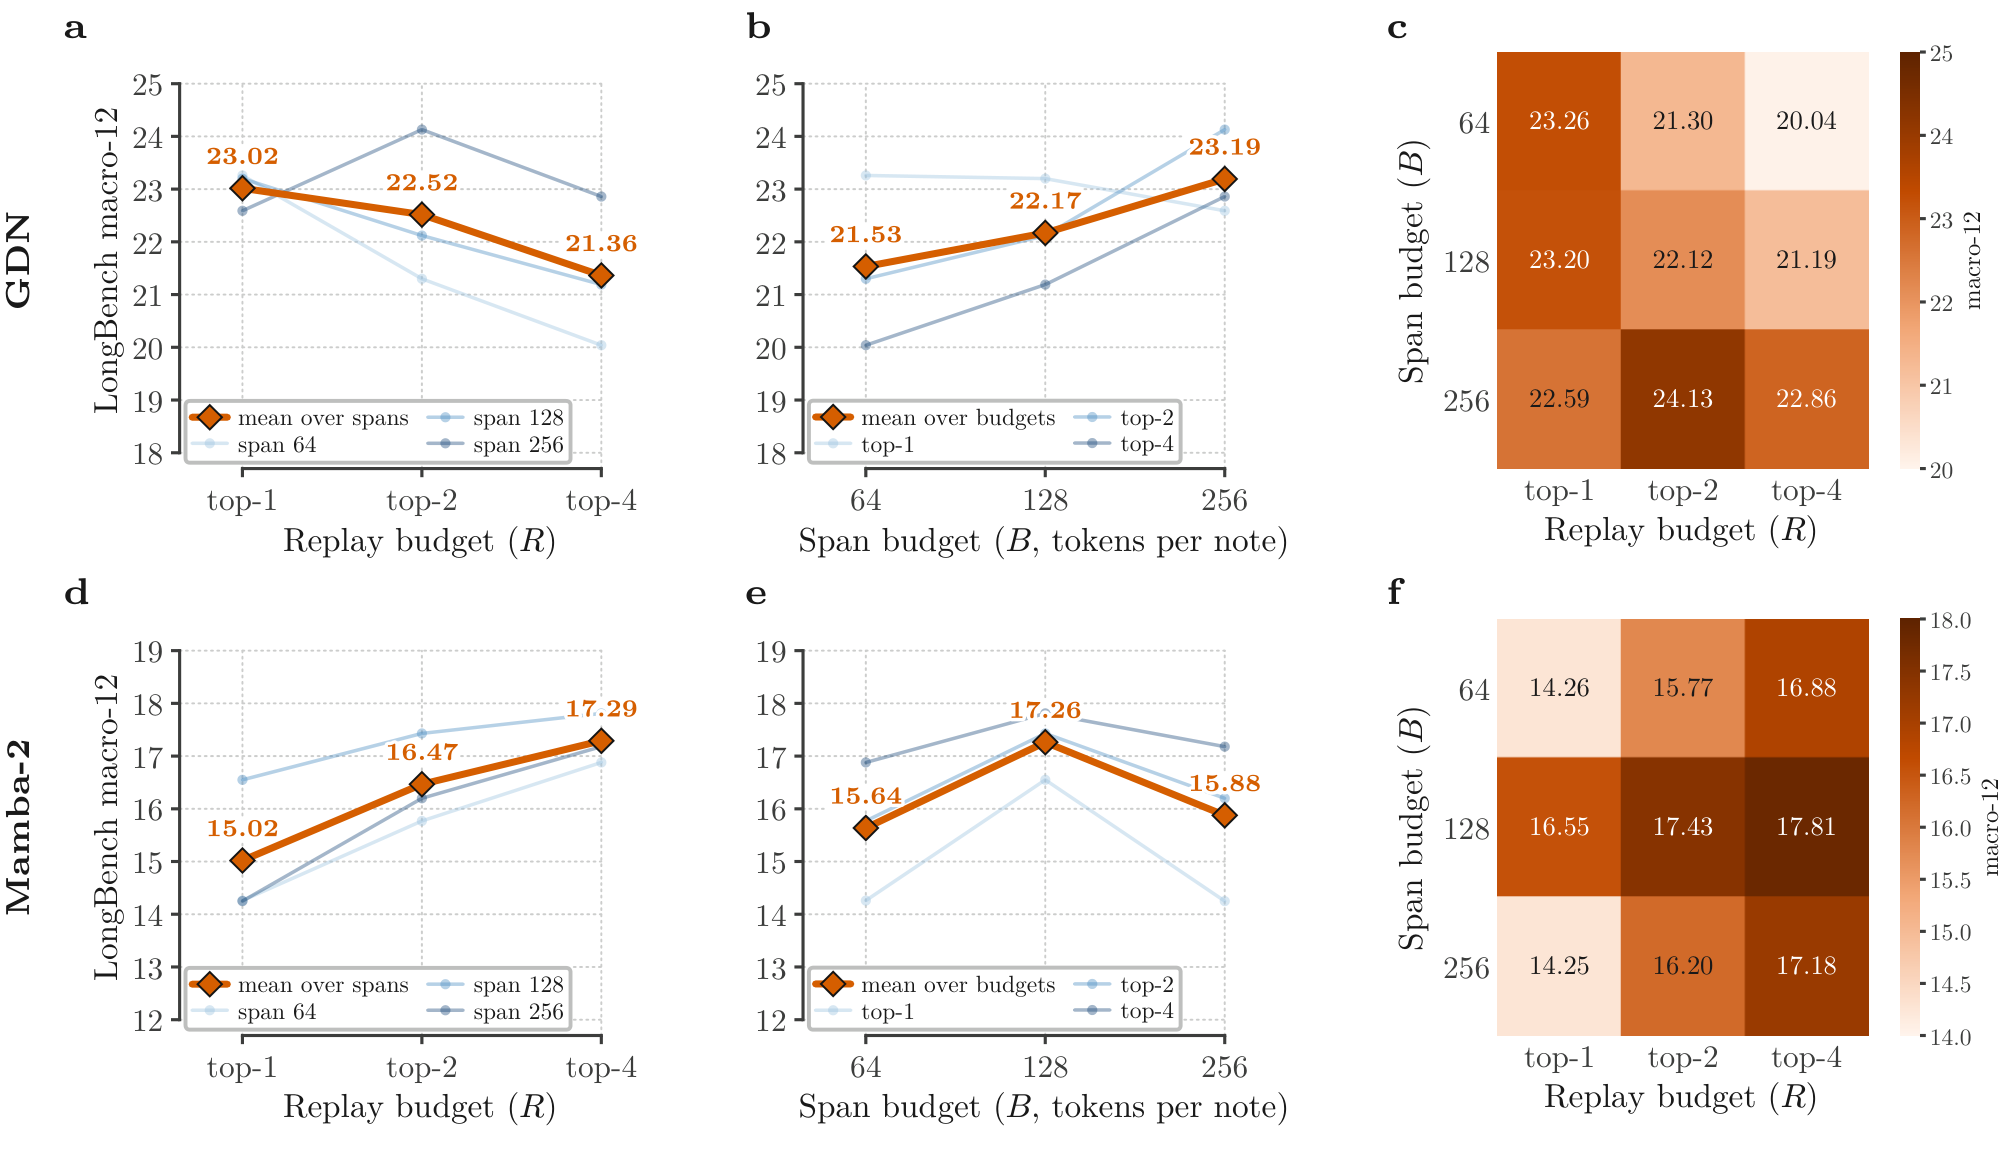
原文 Fig. 12,PDF p. 30。上排 GDN,下排 Mamba-2;左、中对另一预算取平均,右侧为完整配置热图。GDN 对所有片段长度取平均时,$R=1\to4$使分数 23.02→21.36,单个最佳却是$B=256,R=2$。边际平均会隐藏预算交互。
消融与主表有少量数值差异,例如 GDN top-1 的 59.5 与 Table 4 的 59.8;这里按各自图表报告,不替换或拼接。对$R$取平均的写入、块长结果也不能当作固定 top-$R$ 主实验。
五:结论——接口改进很强,收益来源逐项分清
NoteBank 的设计启发是:让递归状态负责持续计算,让外部文本档案负责证据存在,再交给原模型重新理解取回的证据。 当模型已会使用短证据时,瓶颈可能在于能否保存并再次送达,而非必须重训状态更新规则。
最扎实的支持是同一冻结 GDN 在百万 token RULER 的恢复。自然语言结果提示更具体的优化方向:GDN 需要适合任务的读出行为,Mamba-2 需要更好路由与稳定读出;固定一套$C,W,B,R$不会适合所有骨干。
实际采用时,以下取舍会改变判断:
- 查询未知时会漏存证据。 跨段整合需要足够覆盖,不能仅依据单针成绩选预算。
- 档案和全库匹配仍线性增长。 低 FLOPs 比例是在完整长输入前向上摊销,多问题使用时应单独测寻址、状态复制与搬运。
- 混合骨干保留注意力成本。 Qwen 的可用性结果不自动继承纯 GDN 的 74.5 MiB、0.025%。
- 归因优先看匹配对照。 GDN 的适配对照、Mamba-2-8B 的 clean-start 对照,比把主表全部增益归给记忆更能指导实现。
由这些诊断引出的研究问题是:在相同存储和回放 token 预算下,改进未知查询时的写入覆盖,或改进无需额外编码器的寻址,能否比单纯增大回放条数带来更稳定的自然语言收益?这是本次分析提出的后续方向。