Next-Concept Modeling:中文精读笔记
论文:Hermann Kumbong、Ishan S. Khare、Iddah Mlauzi、Andrew Woen、Charles Ding、E. Kelly Buchanan、Simran Arora、Azalia Mirhoseini、Christopher Ré,Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation。
版本:arXiv:2610.14162v1,2026-10-09 提交;本次研读 2026-10-26。原文:本地 PDF。
论文总览
Next-Concept Modeling(NCM)把一段长度为 $L$ 的文本编码为 $K$ 层离散代码:前层短而粗,后层长而细。生成器只需按层串行运行 $K$ 次,每次并行预测该层全部代码;最后由分词器的解码器一次性还原文本。这里的“concept”指粗层携带的信息,不是人工标注的语义概念。其关键收益来自两处:串行步数从逐 token 的 $L$ 缩为层数 $K$,而且前几层处理的序列明显短于 $L$。(Sec. 3,PDF p. 5–7;Fig. 2/4,pp. 2/5)
在约一亿参数的生成器设置下,LM1B 上 NCM 以 12 次函数求值(NFE)得到 93.05 Gen. PPL,DUO 以 128 次得到 97.30;相应采样墙钟时间约快 21 倍。XSum 上无引导 NCM 的 ROUGE-L 为 28.0、8 NFE,对照 AURORA-LM 为 26.6、128 NFE,论文报告在相近质量区域约快 31 倍。OpenWebText 上 NCM 的时间优势约 10 倍,但其 83.12 Gen. PPL 并非表中最低,因此应把质量、样本熵与采样时间一起读。(Table 2/8,PDF pp. 10/26;Fig. 1/5,pp. 1/9;Sec. 4.6,p. 12)
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 扩散模型的步数、单步成本、训练预算问题;NCM 的整体主张 | pp. 2–3;Fig. 1/2 |
| 2 Background & Related Work | 离散/连续扩散、潜变量与层级文本生成 | pp. 3–4;Fig. 3 |
| 3 Next-Concept Modeling | 多尺度残差量化、两阶段训练、按层并行生成 | pp. 5–7;Fig. 4;Eqs. (1)–(10) |
| 4 Experiments | 分词器、无条件/条件生成、数独、扩展与效率 | pp. 8–12;Tables 1–3;Figs. 5–8 |
| 5 Conclusion | 总结效果和效率 | p. 13 |
| Appendix A–I | ELBO、数据/架构、基线来源、消融、失败例与局限 | pp. 21–35;Tables 4–11;Figs. 9–19 |
一:动机
自回归模型一次承诺一个 token,长度 $L$ 的输出需约 $L$ 个串行生成步。掩码扩散模型虽然在每步并行更新多个位置,却要多轮去噪;压缩轮数会损害生成质量,并且多数轮次仍处理整段 $L$ 个位置。蒸馏等少步采样可再减少步数,但会引入额外训练,且仍未缩短单步序列。NCM 改变的是生成的表示与顺序:先生成整个文本的短代码表示,再补残差信息,直到细层。(Sec. 1–2,PDF pp. 2–4)
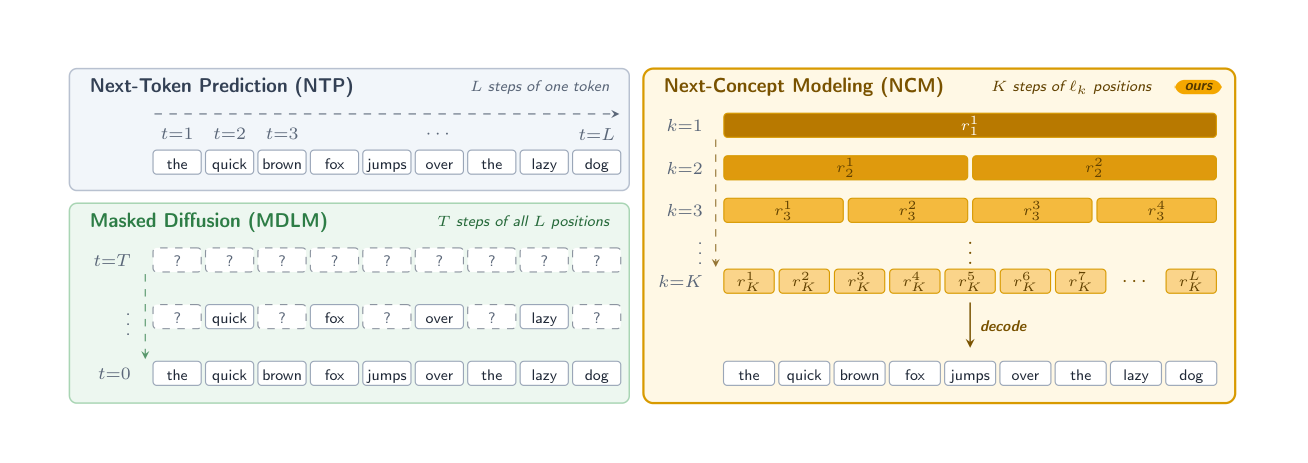
原文 Fig. 2(PDF p. 2)。右图每一横排是一个尺度;同一层内部的代码同时产生。它说明 $K$ 次串行前向传播与层内并行的关系,但不意味着各层之间可以同时采样。
二:方法
2.1 表示与概率分解
令 $x\in\mathcal T^L$ 为文本 token,$r_k\in\{1,\ldots,|\mathcal V_k|\}^{\ell_k}$ 为第 $k$ 层代码,$\ell_1<\cdots<\ell_K=L$。$\mathcal V_k$ 是该层码本,$d$ 是潜变量宽度;$\hat z^{(k)}\in\mathbb R^{L\times d}$ 表示前 $k$ 层的累计重建。NCM 建模
第二个等号明确了设计假设:给定先前层的累计重建,同层各位置条件独立。因此一次前向传播可以给出该层全部代码的分布;层间依赖则由 $\hat z^{(k-1)}$ 传递。最终冻结的解码器从 $\hat z^{(K)}$ 预测 $L$ 个 token。公式定义见 Sec. 3.2,PDF p. 6,Eqs. (3)–(5)。
2.2 第一阶段:学习多尺度残差分词器
编码器给出 $z=E_\phi(x)\in\mathbb R^{L\times d}$。每层把上层留下的残差降采样至 $\ell_k$ 个向量,分别找最近码字;重建算子 $R_k$ 将这些码字重新映射到长度 $L$,并累加:
所以细层不是重新描述全部文本,而是修正此前的量化误差。每次训练随机截断后面的层,只用前 $k$ 层去重建原文(nested dropout),迫使粗层本身保留可用信息。分词器损失由 token 重建交叉熵、编码器承诺项与码本量化项组成:
$\operatorname{sg}$ 表示停止梯度,离散量化的重建梯度通过 straight-through estimator 传回编码器。此阶段需兼顾高精度重建:对自然文本,少量实体或数字替换已可能改变意思;对数独,一个错误数字足以令整盘无效。(Sec. 3.3,PDF pp. 6–7,Eqs. (6)–(9);Table 1,p. 8)
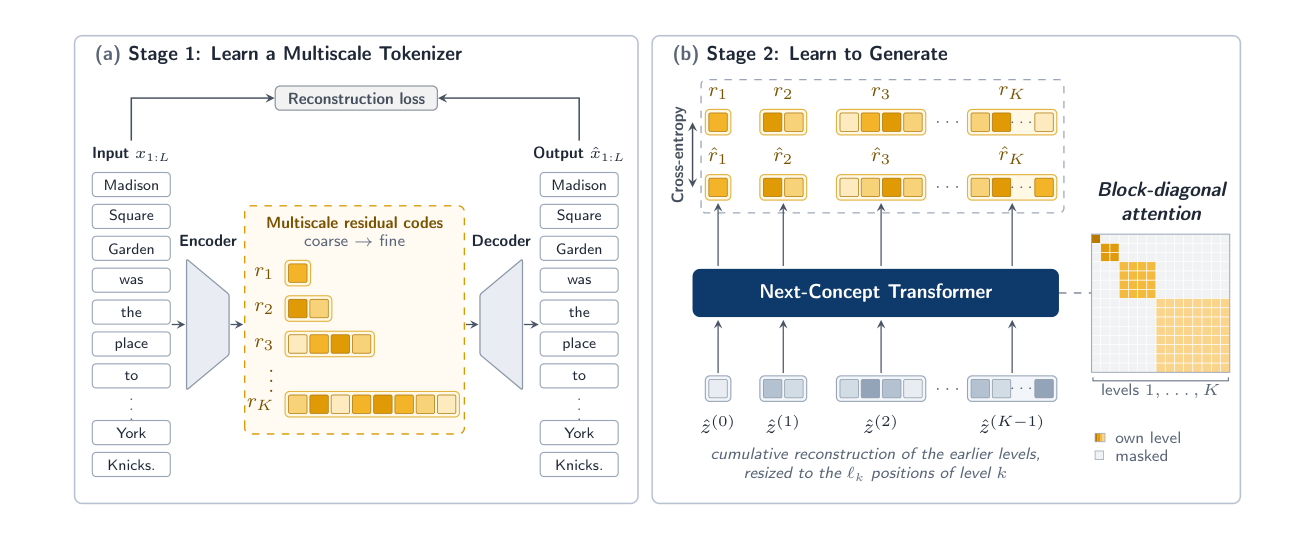
原文 Fig. 4(PDF p. 5)。左半侧是编码、逐层残差量化与重建;右半侧是冻结分词器后,以之前层的累计重建预测下一层。右侧注意力矩阵表示各目标块不直接读取其他目标块。
2.3 第二阶段:训练与采样生成器
分词器冻结后,训练时用真实代码构造各层的输入,一次前向传播预测所有层;无条件任务采用块对角注意力,因为每个输入块已包含先前层的累计信息。为缓解训练时真实代码与推理时自生成代码之间的差异,作者随机把一部分条件代码替换为同层其他码字,监督标签仍保持原真实代码。损失为
$\tilde z$ 是被扰动条件代码的累计重建。$\alpha=0$ 时每个代码位置等权,$\alpha=1$ 时每层总权重相同。推理时不再使用真实代码,而是从 $k=1$ 到 $K$ 反复“读取当前累计重建 → 并行采样本层 → 更新累计重建”,最后解码并对 token 分布取最大值;因而推理需要 $K$ 次生成器调用。条件任务加入前缀:目标块可注意前缀和自身,前缀不读取目标块。XSum 与 WMT14 的生成器先用未配对文本训练,再用源–目标配对训练。(Sec. 3.4,PDF p. 7,Eq. (10) 与 Algorithms 1–2;Appendix C,p. 23)
附录 A 还给出了概率解释:确定性分词器指派一个代码层级,完整文本重建对数似然加代码先验对数概率形成文本对数似然的一个 ELBO。仅在条件干净且 $\alpha=0$ 时,生成器交叉熵(除以总代码数)正对应此下界的生成项;条件扰动和重加权是为了实际生成而作的训练目标修改。(PDF pp. 21–22,Eqs. (16)–(18))
2.4 一个直观例子
原文德英翻译轨迹中,第一层已出现 “However”,但句子残缺;第 8 层形成关于中小企业易受黑客攻击和监控的基本句子,第 11 层补齐措辞。中间质量并非单调:这一单例的 BLEU 从第 8 层 51.7 降到第 9 层 38.9,最终第 11 层为 77.8。它说明层级具有逐步修订能力,也提醒我们不能把每一层都当作可靠的完整译文。(Fig. 3,PDF p. 4;Appendix J.2,p. 36)
三:实验设计
每个数据集各训练一套分词器与生成器。表中规模指生成器参数;冻结分词器仍是系统的一部分,例如 LM1B 分词器约 111.4M 参数、生成器约 97.1M。主要配置如下(Appendix B–C,PDF pp. 22–24):
| 数据集/任务 | 目标长度 $L$ | 层数 $K$ | 生成器 |
|---|---|---|---|
| TinyStories/无条件 | 128 | 12 | 88.6M |
| LM1B/无条件 | 128 | 12 | 97.1M |
| OpenWebText/无条件 | 1,024 | 32 | 94.7M |
| XSum/摘要 | 48 | 8 | 88.0M |
| WMT14 De–En/翻译 | 64 | 11 | 120.0M |
| Sudoku/约束求解 | 89 | 12 | 25.5M |
无条件质量以 GPT-2-large 对生成样本计算 generative perplexity(Gen. PPL,越低越好),并报告每个样本的 unigram 熵 $H$:低 PPL 若伴随明显降低的 $H$,可能只是样本多样性减少。条件任务使用 BLEU 与 ROUGE-1/2/L(越高越好);数独按整盘正确率(越高越好),难度由 40、35、30 个已给数字区分。NFE 是一次输出所需生成器调用次数;classifier-free guidance 的每步计两次调用。延迟另按单张 NVIDIA H100 SXM 80GB、批量 16、合计生成 1,024 个序列测量。(Sec. 4,PDF pp. 8–12;Appendix D,pp. 24–25)
比较对象的来源并不完全相同:LM1B 基线复用同一组 66B token 训练预算的既有检查点;TinyStories 中数个基线由作者按同类配置训练;条件任务部分质量数字取自已有论文,部分公开检查点用于重测,未公开检查点的采样时间用同架构随机权重计时。因而质量表可比较所列协议下的结果,时间曲线也要连同 Appendix D 的计时来源阅读。(PDF pp. 24–25)
四:结果与解释
4.1 分词器能否忠实重建
全层级的逐 token 精确重建率为:OWT 99.99%、LM1B 99.86%、TinyStories 99.98%、XSum 99.79%、WMT14 98.79%,三个数独难度均为 100%。这使“先生成代码、再译回文本”成为可行路径;但 WMT14 仍约有 1.21% token 未精确重建,OWT 错例也含实体、数字、词界替换。数独的 100% 重建尤其关键,因为后续整盘正确率不能由分词器错误上限所限制。(Table 1,PDF p. 8;Appendix G,p. 31)
4.2 无条件生成:要同时读 PPL、熵与采样成本
| 数据集 | NCM:NFE / Gen. PPL / $H$ | 关键对照:NFE / Gen. PPL / $H$ | 数据 $H$ |
|---|---|---|---|
| TinyStories | 12 / 15.41 / 3.98 | FMLM+:128 / 15.43 / 3.90;MDLM:128 / 17.89 / 4.03 | 3.96 |
| LM1B | 12 / 93.05 / 4.31 | DUO:128 / 97.30 / 4.30 | 4.31 |
| OWT | 32 / 83.12 / 5.42 | DUO:1,024 / 77.69 / 5.55;FLM:1,024 / 62.23 / 5.33 | 5.44 |
原文 Table 8(PDF p. 26);Fig. 5(p. 9)给出不同 NFE 或采样时间上的曲线。TinyStories 与 LM1B 支持 NCM 用显著更少调用取得接近或更好 PPL。OWT 的 NCM $H$ 更贴近数据;FLM 虽有更低 PPL,其 $H=5.33$ 也更低,因此单靠 62.23 与 83.12 的排序无法判断整体生成质量。附录 E.1 换用四个其他评估模型,LM1B 上 NCM 的平均 Gen. PPL 为 83.24、DUO 为 92.52,但单独的 Mistral-7B 评分 DUO 更低,说明评估模型也会影响排序。(PDF p. 25)
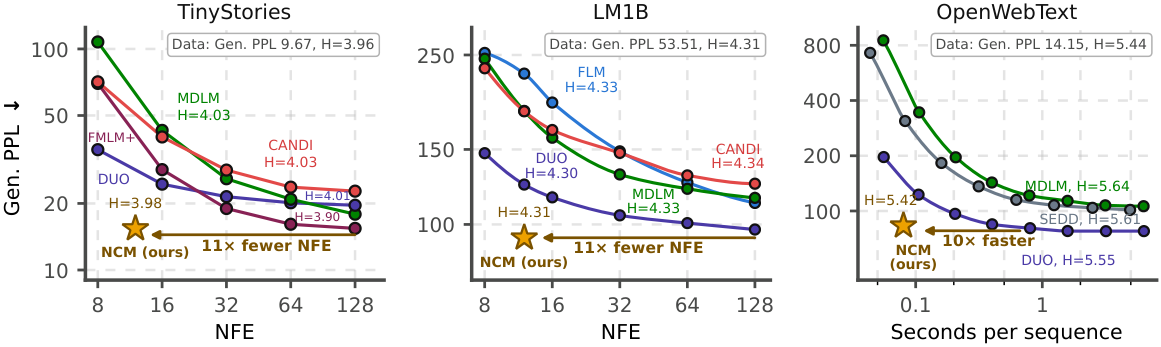
原文 Fig. 5(PDF p. 9)。左、中面板横轴为 NFE,右面板为每段 OWT 文本采样秒数;三图纵轴均为 Gen. PPL。星形是 NCM 的工作点,曲线展示扩散/流模型随采样预算改变的质量。
4.3 条件生成:少步生成与多候选选择
| 任务与设置 | NCM | 主要对照 | 读法 |
|---|---|---|---|
| XSum,无引导 | R1/R2/RL = 35.0/12.8/28.0;8 NFE | AURORA-LM = 34.7/12.2/26.6;128 NFE | 三个 ROUGE 均较高,调用数为 1/16 |
| XSum,MBR | 37.3/14.0/29.6;128 NFE | AURORA-LM + guidance = 36.3/13.4/28.6;184 NFE | 用 16 个候选把速度余量换成质量 |
| WMT14,无引导 | BLEU 22.6;11 NFE | E2D2 = 24.8;64 NFE | NCM 较快,BLEU 低 2.2 |
| WMT14,MBR | BLEU 25.2;132 NFE | ELF + guidance = 26.4;128 NFE | 增加候选后追平表内 AR 25.2,但未超过最佳非 AR 对照 |
数字见 Table 2(PDF p. 10)。MBR(minimum Bayes risk)从多个样本中选与其他候选平均相似度最高者;XSum 的 $16\times8=128$ NFE,WMT14 的 $12\times11=132$ NFE。它利用 NCM 单样本较便宜这一点,在相近预算内改善指标,但并非免费改进。Fig. 6(p. 11)显示 XSum 的墙钟时间–ROUGE-L 曲线上,NCM 多候选在所测时间范围内优于对照。
ROUGE 的优势也需要与事实一致性分开看:论文展示的一条 XSum 摘要把原文和参考中的 “Gary Taylor-Fletcher” 写成 “James Taylor-Fletcher”,并把“初始一个月租借”写成“至赛季结束”。这是 Fig. 8 中可直接看见的具体失败例,说明摘要分数不能替代实体与事件核查。(PDF p. 12)
4.4 数独:整盘约束是否受益于全局粗层
NCM 用 12 NFE,在 easy/medium/hard 上分别解出 99.5%/96.5%/86.1% 的完整棋盘;最强表内对照 FMLM+ 为 16 NFE、97.7%/92.8%/81.3%。作者解释为粗层能先建立整盘表示,细层再修正。不过表中的基线数字取自已有工作,且任务经过专用训练;结果支持该协议下的优势,不能单凭这一表证明模型已经具备广义推理能力。(Sec. 4.4 与 Table 3,PDF p. 10;Appendix D.3,p. 25)
4.5 效率、扩展与消融
在相近质量区域,论文报告 LM1B 较 DUO 少 11 倍 NFE、快 21 倍;XSum 较 AURORA-LM 少 16 倍 NFE、快 31 倍;OWT 的采样时间优势约 10 倍。超过 NFE 比率的加速来自粗层短序列、平均每步更便宜。LM1B 的分词器与生成器总训练暴露量是 13.36B token 位置,对照为 66B(约 4.9 倍);OWT 约 127.22B,对照超过 500B。该口径包括重复读入、填充及分词器训练,衡量的是 token 暴露量,不是 FLOPs 或总训练时间。(Fig. 1/5/7,PDF pp. 1/9/12;Appendix C.2,p. 24)
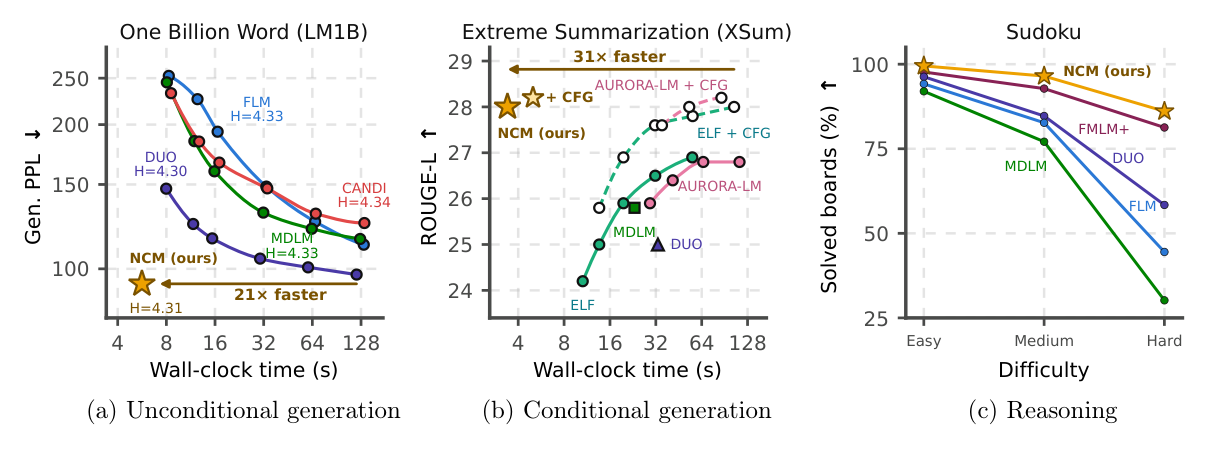
原文 Fig. 1(PDF p. 1)。左、中的点显示质量与时间的折中,右图是不同难度数独整盘正确率;图中水平箭头标的是作者选取工作点的墙钟时间比。
三个直接检验设计机制的消融尤其有用:
- 层数与层长。 TinyStories 上 $K$ 从 4 增至 32,Gen. PPL 随之下降但收益递减;保持 12 层而改变 $\ell_k$ 增长曲线,指数和二次日程在 10k 步实验中分别为 57.7、59.6 PPL,平方根与对数日程远差。这表明“几层、每层放多少代码”会同时影响质量与串行成本。(Appendix F.1,PDF pp. 27–28,Figs. 9–10)
- 注意力与误差暴露。 TinyStories 上块对角注意力得到 15.41 PPL、5.65 秒,块因果为 19.63、7.90 秒;它无需再重复读取前层块,因为输入本身就是累计重建。没有条件代码扰动时的 10k 步 PPL 约 49,适度扰动可降到约 19,过强扰动又反弹:鲁棒训练是该方法能逐层自回归生成的关键。(Appendix F.2–F.3,PDF pp. 28–29,Table 9/Figs. 11/13)
- 损失权重与采样。 增大 $\alpha$ 会增加粗层损失占比,但 TinyStories 的 PPL 在 $\alpha\le1$ 时仍约 18.9–19.0,至 1.5 略升到 19.4;强调粗层并不自动改进生成。CFG 在 XSum 的收益有限;MBR 增加候选数提升 ROUGE,但有递减收益。(Appendix F.2/F.4,PDF pp. 29–30,Figs. 12/14/15)
LM1B 生成器从 97M 扩至 317M、725M 时,在固定生成器训练 token 预算下 Gen. PPL 下降,三者共享冻结分词器。此图提供初步扩展迹象,尚未评估更大数据集上的完整两阶段训练预算。(Sec. 4.5,PDF p. 11,Fig. 6;Appendix C.2,p. 24)
五:结论与思考
NCM 的中心贡献是用可学习的离散层级确定文本生成顺序:训练时各层标签可并行计算,推理时层间串行而层内并行,粗层计算较轻。它在报告的多个任务上把较少 NFE 转化为实际采样加速;数独结果提示这种全局到细节的顺序可能适合需要联合约束的输出。表中的质量判断仍需同时看指标、多样性、预算与基线来源。
两个实际取舍直接来自其机制。首先 $K$ 和各层长度预设,短输出也需走完全部层;若能按输入难度提前停止,速度还有空间。其次分词器与生成器分开训练,代码层级由重建目标塑造,未必最适合生成目标;这也让完整系统的参数和训练成本高于仅报告生成器规模所暗示的数字。作者还指出粗层切换时偶有生成伪影。对下一步研究,值得联合测量“动态层数—准确率—墙钟时间”,以及端到端学习层级是否能在不损害精确重建的前提下进一步改善生成。(Appendix I,PDF p. 35)