DoSA: Dots Sparse Attention:中文精读笔记
作者:Fanxu Meng、Taosong Fang(Dots Studio, Xiaohongshu Inc.,共同一作)
论文:arXiv:2610.13990v1;获取与研读日期:2026-10-19
来源:版本化 arXiv 页面 · 本地原文 PDF · 作者提供的代码链接
配套材料:英文汇报 PDF · 可编辑 Beamer 源文件。下文页码均为原文 PDF 页码,与本版本印刷页码一致。
论文总览
DoSA 解决的是稀疏注意力中的一个反直觉瓶颈:最终只关注少量 token,但为了决定关注谁,Indexer 仍可能对所有 key 计算所有 head 的分数。它保留原有带符号权重的多头 ReLU 评分函数,先用少量 head 和可证明的上界排除不可能进入 Top-K 的候选,再对幸存候选计算完整分数。
方法的核心是一对界:种子集合提供全局第 K 大分数的下界,廉价的筛选计算提供每个候选分数的上界。只有候选上界严格小于种子阈值时才剪枝。构造有效上界需要分别处理正、负权重 head:正项使用非负投影和残差范数上界,负项使用由激活频率选择的聚合方向,安全地估计至少应该减去多少。完整分数用于最终排序,筛选上界不参与最终排名。(Sec. 2,PDF pp. 2–4)
在 GLM-5.2 的 60 个完整 Indexer 微基准配置中,DoSA 均快于 SGLang 和 LiteTopK,最高加速分别为 2.74×、1.69×。约 1M token 的端到端测试中,GLM-5.2、DeepSeek-V3.2 相对 SGLang 的 TTFT 加速分别为 1.86×、1.94×。这些收益来自减少评分、写回和选择工作;算法仍扫描每个 key。文中的精确性相对于原 Indexer 的评分规则成立,并要求数值上界保守、候选不丢失;若要返回完全相同的并列 token ID,还需统一并列排序规则。(Sec. 4,PDF pp. 6–8;App. A.2、C,PDF pp. 14、17–18)
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 长上下文中 Indexer 成为瓶颈;提出有证据的提前拒绝 | pp. 1–2,Fig. 1 |
| 2.1 Problem formulation;2.2 Seed threshold and retained heads | 定义原始分数、种子阈值与保留 head | pp. 2–3,Eq. (1)–(3) |
| 2.3 Upper-bounding omitted positive heads | 非负投影、权重折叠与联合残差上界 | pp. 3–4,Eq. (4)–(7) |
| 2.4 Lower-bounding omitted negative contributions | 负项聚合及激活感知支持集 | p. 4,Eq. (8) |
| 2.5 Score bounds and candidate refinement | 组合证书、完整重评分与稀疏写回 | p. 4,Eq. (9);Fig. 2 在 p. 3 |
| 3 GPU Kernel Design | 查询分组、共享 key 读取、紧凑选择及解码路径 | p. 5,Fig. 3 |
| 4.1 Experimental setup;4.2 Indexer microbenchmarks | 实验设置、prefill、decode、逐层剪枝 | pp. 6–8,Fig. 4–6 |
| 4.3 End-to-end inference performance;4.4 Ablation study | TTFT 与筛选/写回消融 | p. 8,Fig. 8;Fig. 7 在 p. 7 |
| 5 Related work;6 Limitations and conclusion | 相邻技术定位、适用条件和未来方向 | p. 9 |
| A Certificate Validity and Exact Selection | 正负项证明、固定阈值算法与精确选择定理 | pp. 13–14,Algorithm 1、Theorem 1 |
| B Certificate Tightness and Computational Cost | 单锚点最优性、松弛来源、head 预算 | pp. 14–16,Eq. (13)–(21) |
| C Numerical Conditions and Recovery | FP8 误差覆盖、RMS 上界、候选存储与恢复 | pp. 17–18,Eq. (22)–(28) |
| D Additional Experimental Analysis | profiling 口径、证书组件与逐层检索测试 | pp. 18–21,Fig. 9–12 |
一:动机——选出稀疏集合本身仍很昂贵
DeepSeek Sparse Attention(DSA)使用多头 Indexer 给可见 key 评分,再选出 Top-K 供注意力访问。稀疏的是后续注意力连接,索引评分仍遍历全部候选。上下文增长时,这个步骤可能比实际稀疏注意力更贵。
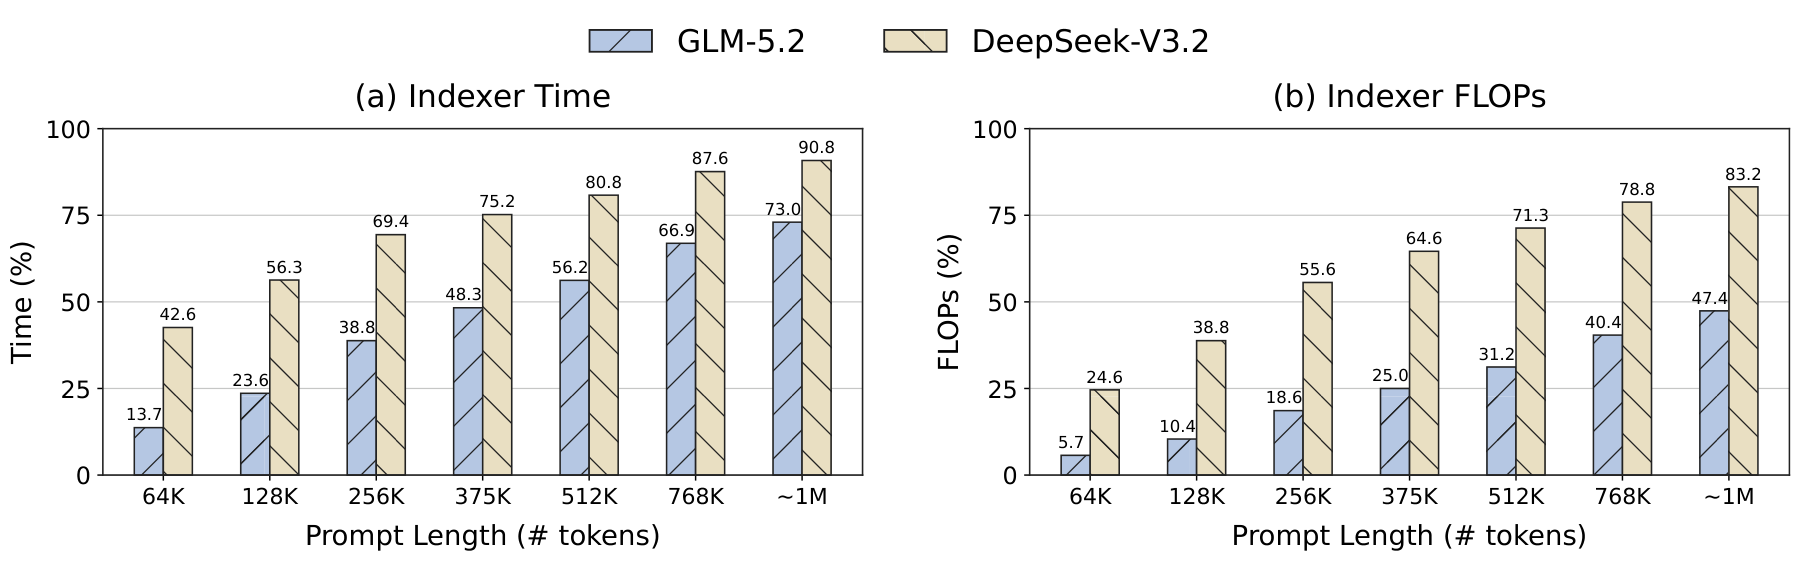
原文 Fig. 1,PDF p. 2。横轴是输入 token 数;左图为完整 prefill GPU 时间中 Indexer 的比例,右图为理论矩阵 FLOPs 的比例。约 1M token 时,GLM-5.2 的两项占比分别是 73.0%、47.4%,DeepSeek-V3.2 是 90.8%、83.2%。时间占比还受选择操作、数据搬运等非矩阵工作影响,因此仅减少浮点乘加不够,写回和 Top-K 也需配合优化。这些比例来自 GPU prefill profiling,不是对整个 TTFT 的分解。(App. D.1,PDF p. 18)
已有方法分别缓解不同成本。SGLang 是完整评分后再选择的基线;LiteTopK 把评分、候选过滤和选择融合,减少中间分数写回,但仍为每个 key 计算全部 head。少 head 筛选后重排可以节省计算,但已被第一阶段遗漏的赢家无法由重排补回。DoSA 的新贡献是针对带符号多头评分函数构造廉价的安全上界,让提前拒绝有严格依据。(Sec. 1、5,PDF pp. 1–2、9)
“上界低于当前胜出阈值即可跳过”的原则来自精确文档检索中的 MaxScore/WAND。本文的难点在于把这一原则用于带 ReLU、正负权重的神经索引器,并把不规则候选集合映射到高效 GPU 执行。
二:方法——把完整评分变成有条件的计算
2.1 原始评分函数及输入输出
固定一个 query,原始分数为:
这是原文 Eq. (1),PDF p. 2。
| 符号 | 含义 |
|---|---|
| $\mathbf q_h\in\mathbb R^D$ | 当前 query 的第 $h$ 个 Indexer head 向量 |
| $\mathbf k_i\in\mathbb R^D$ | token $i$ 的 key,供这些 head 共享 |
| $w_h\in\mathbb R$ | 当前 head 权重,可以为正、负或零 |
| $H,D$ | Indexer head 数、单个向量维度 |
| $\Omega$ | 当前 query 的可见 key 集合,遵守可见性约束 |
| $K$ | 要返回的不同 token ID 数;实验取 2,048 |
| $R,r$ | 筛选阶段直接计算的 head 集合及其大小 |
| $P,N$ | 未直接计算的正权重、负权重 head 集合 |
输入是既有模型的 query、key、权重和可见域,输出是按原始分数选出的 K 个 token ID。DoSA 是推理执行优化,不需要改写模型参数或重新训练 Indexer。筛选计划中的折叠权重只用于形成上界。
2.2 种子集合为什么能提供安全阈值
选择至少含 K 个不同且可见 key 的集合 $\mathcal S\subseteq\Omega$,用原评分函数计算它们的完整分数,取第 K 大值:
理由是集合 $\mathcal S$ 已经给出至少 K 个分数不低于 $\tau$ 的见证;扩大到全集后,第 K 大值只能保持或升高。于是只要 $s_i\le U_i<\tau$,就能证明 token $i$ 不会成为赢家。阈值质量影响剪枝效率,不影响这个论证的正确性。(Eq. (2),PDF p. 2;App. A.2,PDF p. 14)
下面是帮助理解的教学例子,数值并非论文实验。设 $K=2$,种子分数为 10、7、3,则 $\tau=7$。
| 非种子候选 | 上界 $U_i$ | 完整分数 $s_i$ | 执行结果 |
|---|---|---|---|
| a | 6.5 | 6 | 上界已低于 7,不计算完整分数 |
| b | 9 | 8 | 重评分后保留 |
| c | 7 | 7 | 等于阈值,必须保留 |
| d | 9 | 1 | 上界不够紧,重评分后过滤 |
最终从种子和保留记录中选出分数 10、8。这里 $\tau^*=8$,种子阈值 7 虽然不是真实边界,仍足以安全剪掉 a。d 展示了“幸存”只表示尚不能排除,并不表示真的进入 Top-K。
原理允许用更多已知完整分数提高阈值,但本文 prefill kernel 在扫描期间保持种子阈值固定。(Sec. 3,PDF p. 5)
2.3 哪些 head 值得直接计算
令 $\mathcal H_+=\{h:w_h>0\}$、$\mathcal H_-=\{h:w_h<0\}$。给定预算 $r$:
- 若正 head 数不超过 $r$,全部保留正 head;剩余位置按 $|w_h|\|\mathbf q_h\|_2\min(p_h,1-p_h)$ 从高到低选择负 head。
- 若正 head 超过 $r$,保留 $w_h\|\mathbf q_h\|_2$ 最大的 $r$ 个正 head。
这里 $p_h$ 是 seed 样本中该 head 的激活频率,激活指 $\mathbf q_h^\top\mathbf k_i>0$。负 head 的优先级同时看强度与激活不确定性:越接近一半激活、一半不激活,越难由一个固定支持集概括,直接算它越可能减少松弛。定义 $P=\mathcal H_+\setminus R$、$N=\mathcal H_-\setminus R$。(Sec. 2.2,PDF p. 3)
正确性不依赖于这个选择启发式;附录证明它优化的是样本上的松弛代理目标,而不是实际时延的全局最优解。
2.4 正权重 head:用已算方向解释,再覆盖残差
正项不能直接丢掉,否则分数可能被低估。对每个 $h\in P$,找一个保留 head 作为锚点:
零范数锚点的匹配分数和系数取零。由于 $\beta_h\ge0$,ReLU 的次可加性与正齐次性给出:
第一项重用已经算过的点积,第二项用 Cauchy–Schwarz 不等式覆盖所有可能残差。投影越贴近,残差越小,上界越紧。(Eq. (4)–(5),PDF p. 3)
把投影贡献折入锚点权重:
这样逐 key 只需计算保留 head,再加一个 $E_P\|\mathbf k_i\|_2$。$E_P$、锚点和折叠权重都在 query 侧预先准备、跨 key 重用。(Eq. (6),PDF p. 4)
附录 B.1 的最优性结论很具体:在 $[\mathbf q^\top\mathbf k]_+\le\beta[\mathbf p^\top\mathbf k]_++c\|\mathbf k\|_2$、$\beta,c\ge0$、对任意 key 都成立的单锚点界中,最小 $c$ 是 $\mathbf q$ 到非负射线 $\{\beta\mathbf p:\beta\ge0\}$ 的距离。它并不意味着对每个实际 key 的整个上界都最小,也不解决保留 head 集合的全局选择问题。(Proposition 5,PDF p. 15)
联合残差进一步利用方向之间的关系。 各省略 head 面对同一个 key,残差不一定同时取到各自的最坏情况。令 $\mathbf u_h=w_h\mathbf d_h$,可以改用:
证明先用 $[x]_+=(x+|x|)/2$ 分离有符号和与绝对值和,再将绝对值和写为符号向量的最大值,并用 Gram 内积的绝对值和上界其范数。(Eq. (7),PDF p. 4;App. A.1,PDF pp. 13–14)
一个教学例子是两个加权残差方向 $\mathbf u$ 和 $-\mathbf u$。逐项范数界为 $2\|\mathbf u\|$,联合界只需 $\|\mathbf u\|$;对应的实际残差 ReLU 和为 $|\mathbf u^\top\mathbf k|$。联合界不需额外读取 key,但 query 端 Gram 计算随省略正 head 数呈平方增长。附录还给出按坐标组构造 $B_g$、最终以 $\sqrt{\sum_g B_g^2}\|\mathbf k\|$ 合并的版本,可以维持每个 key 仅一个 RMS 摘要的形式。
2.5 负权重 head:保守地减去一个聚合项
负 head 的贡献是减分。全部忽略它们不会低估分数,但上界可能大得几乎无法剪枝。对任意 $A\subseteq N$,定义:
这是对真实“减分量”的下界,所以减去 $L_N$ 后仍然保持分数上界。一个聚合方向可以替代任意多个省略负 head。(Eq. (8),PDF p. 4)
把所有负 head 都聚合进去可能因先求和再 ReLU 而发生抵消。教学例子:两个权重绝对值均为 1 的负 head,点积为 5 和 −4;逐 head ReLU 的真实减分量是 $5+0=5$,全部聚合只能得到 $[5-4]_+=1$。只聚合激活的第一个 head 则得到 5。加入未激活 head 反而使上界更松。
DoSA 从 seed 的激活频率选择多数支持集:
它的理论依据是一个可分离代理目标。令 $a_h=|w_h|\|\mathbf q_h\|_2$,则:
在非零样本 key 上,这上界了归一化负项松弛的均值。每个 head 独立比较 $a_h(1-p_h)$ 与 $a_hp_h$,就得到 $p_h\ge1/2$ 的选择规则;若将某个负 head 改为直接计算,便移除其 $a_h\min(p_h,1-p_h)$ 代理代价。这也解释了保留负 head 的优先级。(App. B.2,Eq. (15)–(16),PDF p. 16)
若新 key 的激活集合恰好等于 $A$,负聚合项就是精确的;激活模式不同只可能让界更松。任意支持集都满足基础不等式,种子统计失准不会因此失去安全性。
2.6 组合证书与完整算法
组合得到原文 Eq. (9):
正残差项可替换为已证明有效的联合或分组界。下面按 Algorithm 1 重述数据流:
- 用原评分函数计算不同可见 seed 的分数,得到固定阈值 $\tau$。
- 为当前 query 准备 $R$、锚点、折叠权重、负支持集和残差界。
- 扫描非种子 key,只有 $U_i\ge\tau$ 的候选进入集合 $V$。
- 对 $V$ 中每个候选计算全部 H 个原始 head 的分数。
- 只写回完整分数 $s_i\ge\tau$ 的记录,形成 $C$。
- 在 $\mathcal S\cup C$ 上按原分数与规定的并列规则选出 Top-K。
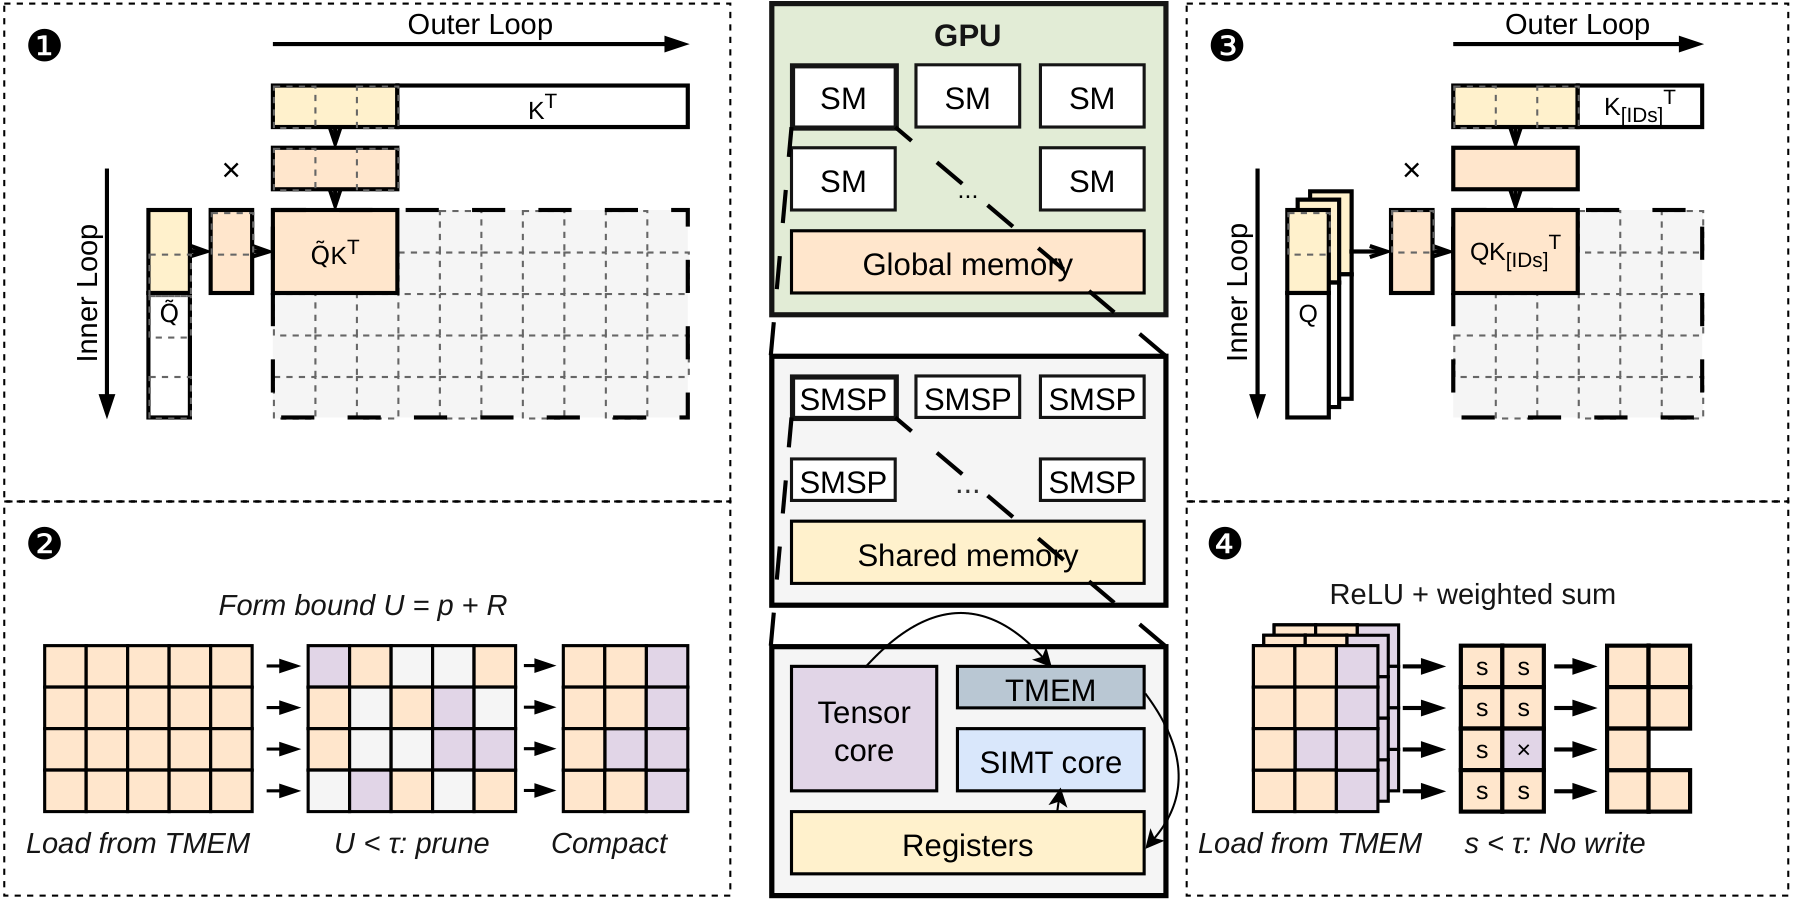
原文 Fig. 2,PDF p. 3。按 ①筛选点积、②上界与候选压紧、③幸存者全 head 点积、④原始分数与稀疏写回阅读。灰色表示避免的计算,紫色表示避免的写回;图省略 seed 初始化和最终 Top-K。
精确选择证明的关键只有两种删除路径:筛选删除意味着 $s_i\le U_i<\tau$;完整评分后删除意味着 $s_i<\tau$。两者都严格低于全局第 K 大值,因此所有可能赢家仍在最终候选集中。两次过滤都必须保留等号。 若边界存在并列且没有统一总序,只能保证返回一个合法 Top-K 集合;要与原实现得到相同 ID,需要同一 tie order。(Theorem 1,PDF p. 14)
2.7 松弛、选择间隔和 head 预算
在逐项残差形式下,上界与真实分数之差可以精确分成三部分:正项投影余量、未被支持集覆盖的激活负 head、以及支持集内正负点积相互抵消的损失。记 $x_h=\mathbf q_h^\top\mathbf k$、$c_h=|w_h|$,$Z_A^+=\sum_{h\in A}c_h[x_h]_+$、$Z_A^-=\sum_{h\in A}c_h[-x_h]_+$,则:
其中 $\delta_P$ 是正 head 上界相对真实正项的差。三个部分均非负;联合残差界会改变第一项的具体形式。(Proposition 6、Eq. (14),PDF p. 15)
令真实阈值 $\tau^*=\tau_K(\Omega)$,选择间隔 $\Delta_i=\tau^*-s_i$,阈值不足量 $b=\tau^*-\tau$,证书松弛 $\delta_i=U_i-s_i$,则:
这把性能来源说清楚了:好 seed 减少 $b$,紧上界减少 $\delta_i$,而模型自身的分数分布决定有多少候选远离边界。边界附近若有大量近似同分 key,即使证书有效,也可能留下很多幸存者。(Eq. (17),PDF p. 16)
设初始化完整评分 $N_0$ 个 key,筛选 $N_s$ 个 key,其中 M 个幸存;筛选使用 $r$ 个保留 head 和 $d_a$ 个辅助行。逻辑点积数约为:
这里 $D_{\mathrm{base}}$ 的 D 表示点积计数,和向量维度 D 是不同记号。记 $f=N_0/(N_0+N_s)$、$m=M/N_s$:
筛选减少点积的条件是 $m<1-(r+d_a)/H$。在初始化和辅助行数固定时,多用 $\Delta r$ 个 head 只有令剪枝率增加超过 $\Delta r/H$ 才划算。增加 head 可能同时改变锚点和支持集,剪枝率也不必严格单调。(Eq. (18)–(21),PDF p. 16)
这解释了为何“剪掉约 97% 候选”不等于“省掉约 97% 的全部计算”。例如仅作教学估算,假设 $H=32,r=14,d_a=2,m=0.0265$,忽略初始化时,逻辑点积仍约为基线的 $16/32+0.0265=52.65\%$。该组合不是论文报告的统一配置;模型还未计入 padding、规划、key 读取、选择和恢复成本。
2.8 FP8 下的精确性与候选恢复
实数不等式 $s_i\le U_i$ 不能自动推出浮点实现也安全。本文另定义原评分器实际算出的分数 $s_i^{\mathrm{ref}}$,要求数值上界满足 $s_i^{\mathrm{ref}}\le U_i^{\mathrm{num}}$,且种子与幸存者使用同一原评分器。(App. C.1,PDF p. 17)
写 $\mathbf k_i=\alpha_i\bar{\mathbf k}_i$,其中 $\alpha_i>0$、$\bar{\mathbf k}_i$ 为 FP8 payload。负聚合方向用两个辅助 FP8 行及残差表示:$\mathbf a_A=\mathbf v_0+\mathbf v_1+\mathbf e_A$。两个辅助点积必须先相加再过 ReLU,筛选共用 $r+2$ 个逻辑点积。
在全部正 head 已保留时,32-head 实现的 $r=14,16$ 路径还采用绝对值形式。令:
则:
它相对基础证书多出 $[-\mathbf a_A^\top\mathbf k]_+$ 的松弛。$r=20$ 路径保留带正投影的基础形式。以上是论文给出的 32-head 实现细节,不能直接当作 64-head 模型的配置。(Eq. (24)–(25),PDF p. 17)
设 $\rho_i\ge\|\bar{\mathbf k}_i\|_2/\sqrt D$ 是保守 key RMS 摘要,数值证书为:
其中 $\widehat U_i$ 是实际筛选表达式,$C$ 覆盖方向表示、权重形成、正残差和算术误差;两个 $\varepsilon$ 分别覆盖缩放前后适合用绝对量表达的误差。$\operatorname{Eval}_{\mathrm{up}}$ 表示向上包住真实表达式,可以用有向舍入或显式误差界实现。RMS、残差范数、系数以及最终计算都必须保守;简单“使用 FP32”或四舍五入得到 RMS 不足以证明上界。(Eq. (26)–(28),PDF pp. 17–18)
候选缓存也属于正确性条件。最终只要 K 个结果,不代表中间候选最多只有 K 个:若所有分数都等于阈值,所有 key 都必须幸存。缓存满时需要扩容、完整分数的精确分块 Top-K 合并,或回到全域计算,不能截断候选。若发现无效 scale、RMS 或非有限界,不能据此剪枝;query 级错误的恢复必须重新覆盖全部可见 key,包括报错前已经删掉的候选。(App. C.3,PDF p. 18)
2.9 GPU 执行为什么能兑现理论节省
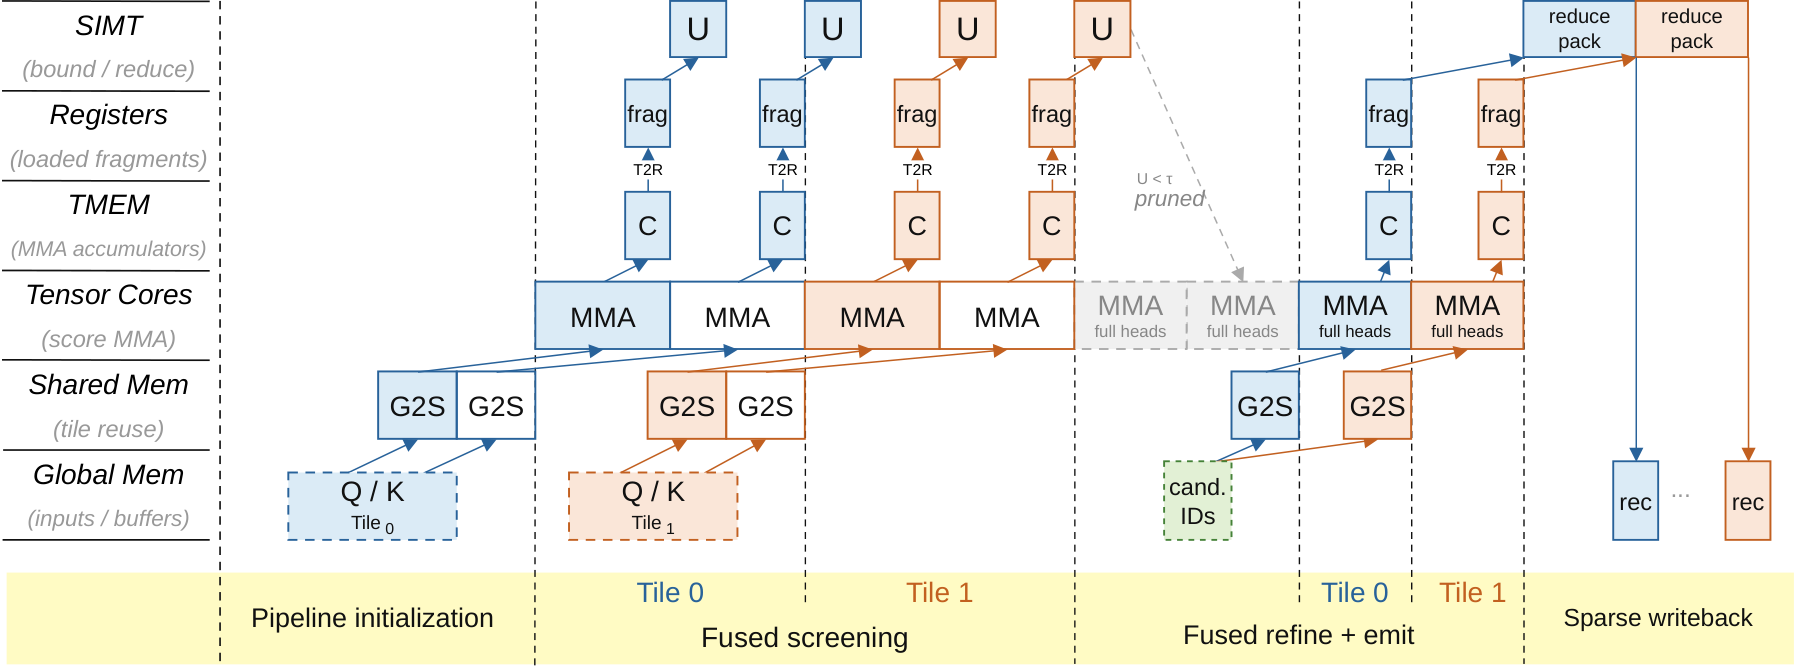
原文 Fig. 3,PDF p. 5。从左到右是初始化、融合筛选、融合精算与输出、稀疏写回;蓝色和橙色表示相继 tile,展示 key 加载与矩阵计算的重叠。
筛选阶段把保留 head 预算相近的 query 分组为固定宽度 tile,让小而规则的点积继续使用 Tensor Core。SIMT 线程从 Tensor Memory(TMEM)取累加结果,形成上界并用 warp ballot 压缩候选掩码。
精算阶段以四个 query 为一组:同一个 key 若至少通过两个 query 的筛选,且位于共同可见范围,就进入共享流;其余进入逐 query 流。这样一次 key 读取可服务多个 query,代价是可能多算部分 query–key 对。该取舍减少散乱 gather 和重复搬运。
写回阶段把完整评分与阈值过滤融合,只有 $s_i^{\mathrm{ref}}\ge\tau$ 才生成记录。记录包含单调分数编码和精确 ID;边界编码处用原始分数解歧,避免把粗编码当作最终精确排序依据。(Sec. 3,PDF p. 5)
解码路径不同。 单步 query 较少,共享 key 读取机会有限。本文解码仍做完整 FP8 评分,利用近期已选的不同 key 在当前 query 下重新评分,构造安全阈值并缩小后续选择输入。近期结果提供见证,不直接把旧分数当当前阈值。
三:实验——先分清测量范围
3.1 模型、工作负载与基线
| 项目 | 原文设置 |
|---|---|
| 模型 | GLM-5.2:32 个 Indexer head;DeepSeek-V3.2:64 个;均取 $K=2,048$ |
| 完整 Indexer 微基准 | GLM-5.2、单 GPU;真实模型激活;包含 query/key 准备;重放末尾 query chunk,覆盖 21 个产生 Indexer 的层 |
| 端到端 | 八路张量并行 TP8;GLM prefill chunk 为 32K,DeepSeek 为 16K;每次请求清空 prefix cache |
| prefill 输入 | InfiniteBench 英文/中文书籍与代码;长上下文补充 Gutenberg 文本与 SQLite 源码,取连续片段 |
| 长度和 chunk | 长度 128K、256K、512K、768K、约 1M;微基准 chunk 为 4K、8K、16K、32K |
| 基线 | SGLang v0.5.18;LiteTopK,用于区分全评分融合与提前避免评分的收益 |
| 时延测量 | 完整 Indexer 使用 warmup 后 CUDA events;端到端报告单请求首 token 时间 TTFT |
来源:Sec. 4.1–4.2,PDF pp. 6–7;App. D.1,PDF p. 18。1K 表示 1,024 token,约 1M 的 profiling 点为 1,048,569 token。论文只写 NVIDIA GPU,没有给出具体 GPU 型号;这会妨碍复现实测时延及判断硬件适用范围。
3.2 四种时间口径
| 测量 | 包含什么 | 解读时的注意点 |
|---|---|---|
| Fig. 1 Indexer 时间占比 | 准备、key cache 访问、评分和选择,相对于整个模型 prefill GPU 区间 | 不包含 CPU tokenization 和请求传输,不等于 TTFT 占比 |
| Fig. 4 complete-Indexer | 包含 query/key 准备的完整索引延迟 | 对应 2.74× 的主微基准结论 |
| Fig. 8 TTFT | 单次请求到首 token 的端到端延迟 | 对应 1.86×、1.94× 等服务收益 |
| Fig. 7、11–12 retrieval | 评分与选择;附录逐层测试明确排除 query/key 准备 | 不能拿最高逐层 3.74× 替换完整 Indexer 加速 |
附录证书组件消融对每个输入、每层计时十次,生存率报告算术平均,时延倍率报告几何平均;逐层检索热图则每方法、每单元重放十二次,比较中位延迟。(App. D.2、D.4,PDF pp. 18–21)
四:结果——哪些节省被实验支持
4.1 Prefill:长 key 维度带来主要收益
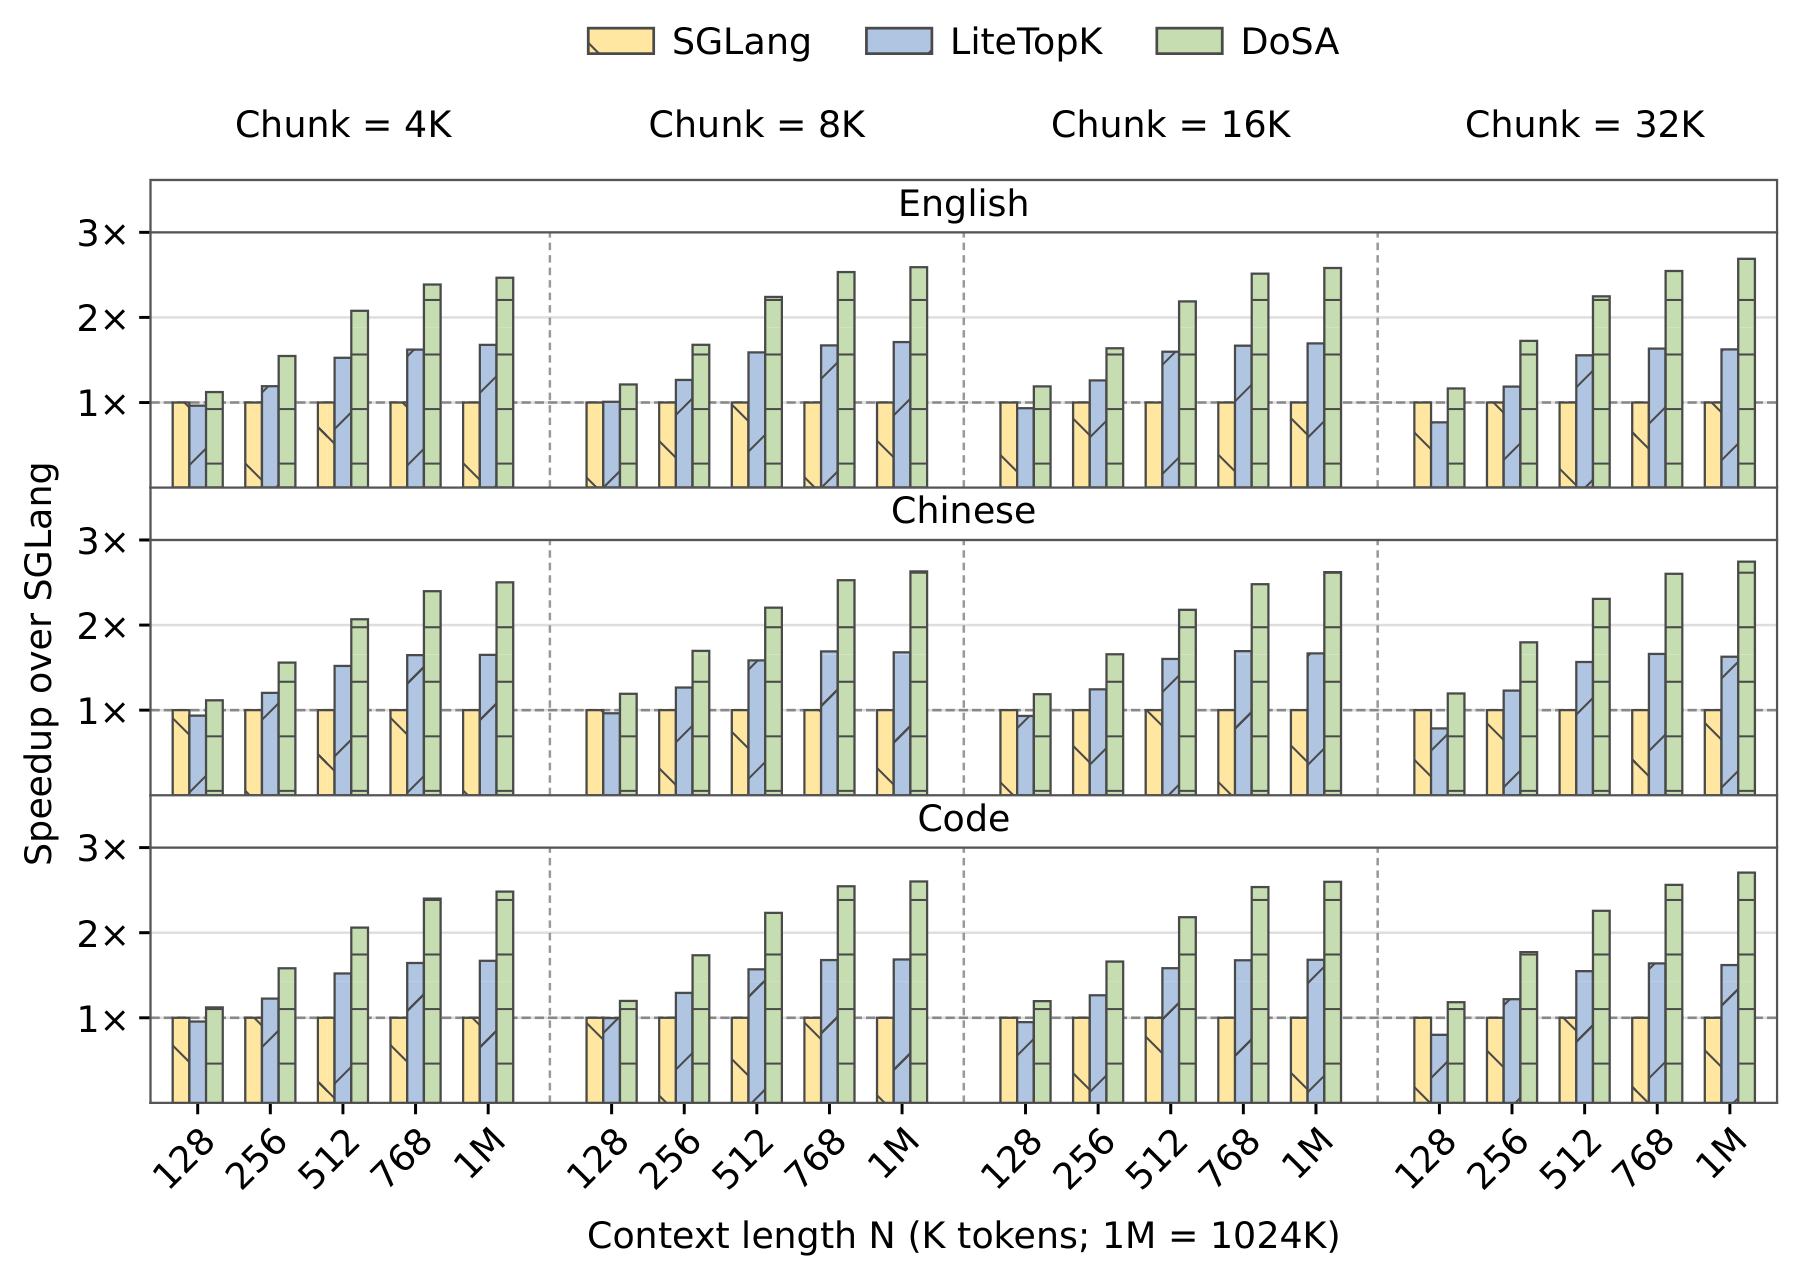
原文 Fig. 4,PDF p. 6。三行分别为英文、中文、代码;每行四组对应 chunk 大小;组内横轴是 context length。纵轴为相对 SGLang 的加速倍数,越高越好,SGLang 自身为 1×。
| 完整 Indexer 比较范围 | 相对 SGLang | 相对 LiteTopK |
|---|---|---|
| 全部 60 个配置 | 1.12–2.74× | 1.17–1.69× |
| 约 1M token | 2.47–2.74× | 1.47–1.69× |
60 个配置来自 3 个输入域 × 5 个长度 × 4 个 chunk 大小,DoSA 全部最快;长度至少 512K 时,所有配置相对 SGLang 均超过 2×。(Sec. 4.2,PDF p. 7)
论文用英文输入说明趋势:固定 16K query chunk,长度从 128K 增至 1M,加速由 1.19× 升至 2.58×;固定 1M context,chunk 从 4K 增至 32K,加速由 2.47× 升至 2.69×。query 侧准备可跨更长 key 维度摊销,而扩大 query batch 会同时增加各方法的工作,因此上下文长度的作用更明显。
相对 LiteTopK 仍有收益,支持“提前避免全 head 评分”具有独立于融合/减少写回的价值。
4.2 Decode:收益来自选择,而非证书跳过评分
| 单请求长度 | 解码 Indexer 相对 SGLang 加速 |
|---|---|
| 256K | 1.06× |
| 512K | 1.11× |
| 约 1M | 1.26× |
来源:Fig. 5,PDF p. 7。请求来自 HELMET、InfiniteBench、LongBench v2 的文档分析,以及 SQLite 代码审查;每个工作负载用等长请求填满约 1M token 的 KV cache。横轴是单请求长度,不应误读为每个点都有相同 batch 数。该实验测的是解码 Indexer,并未据此报告同倍率的端到端每 token 生成加速。
4.3 剪枝率:大量候选可以在完整评分前被拒绝
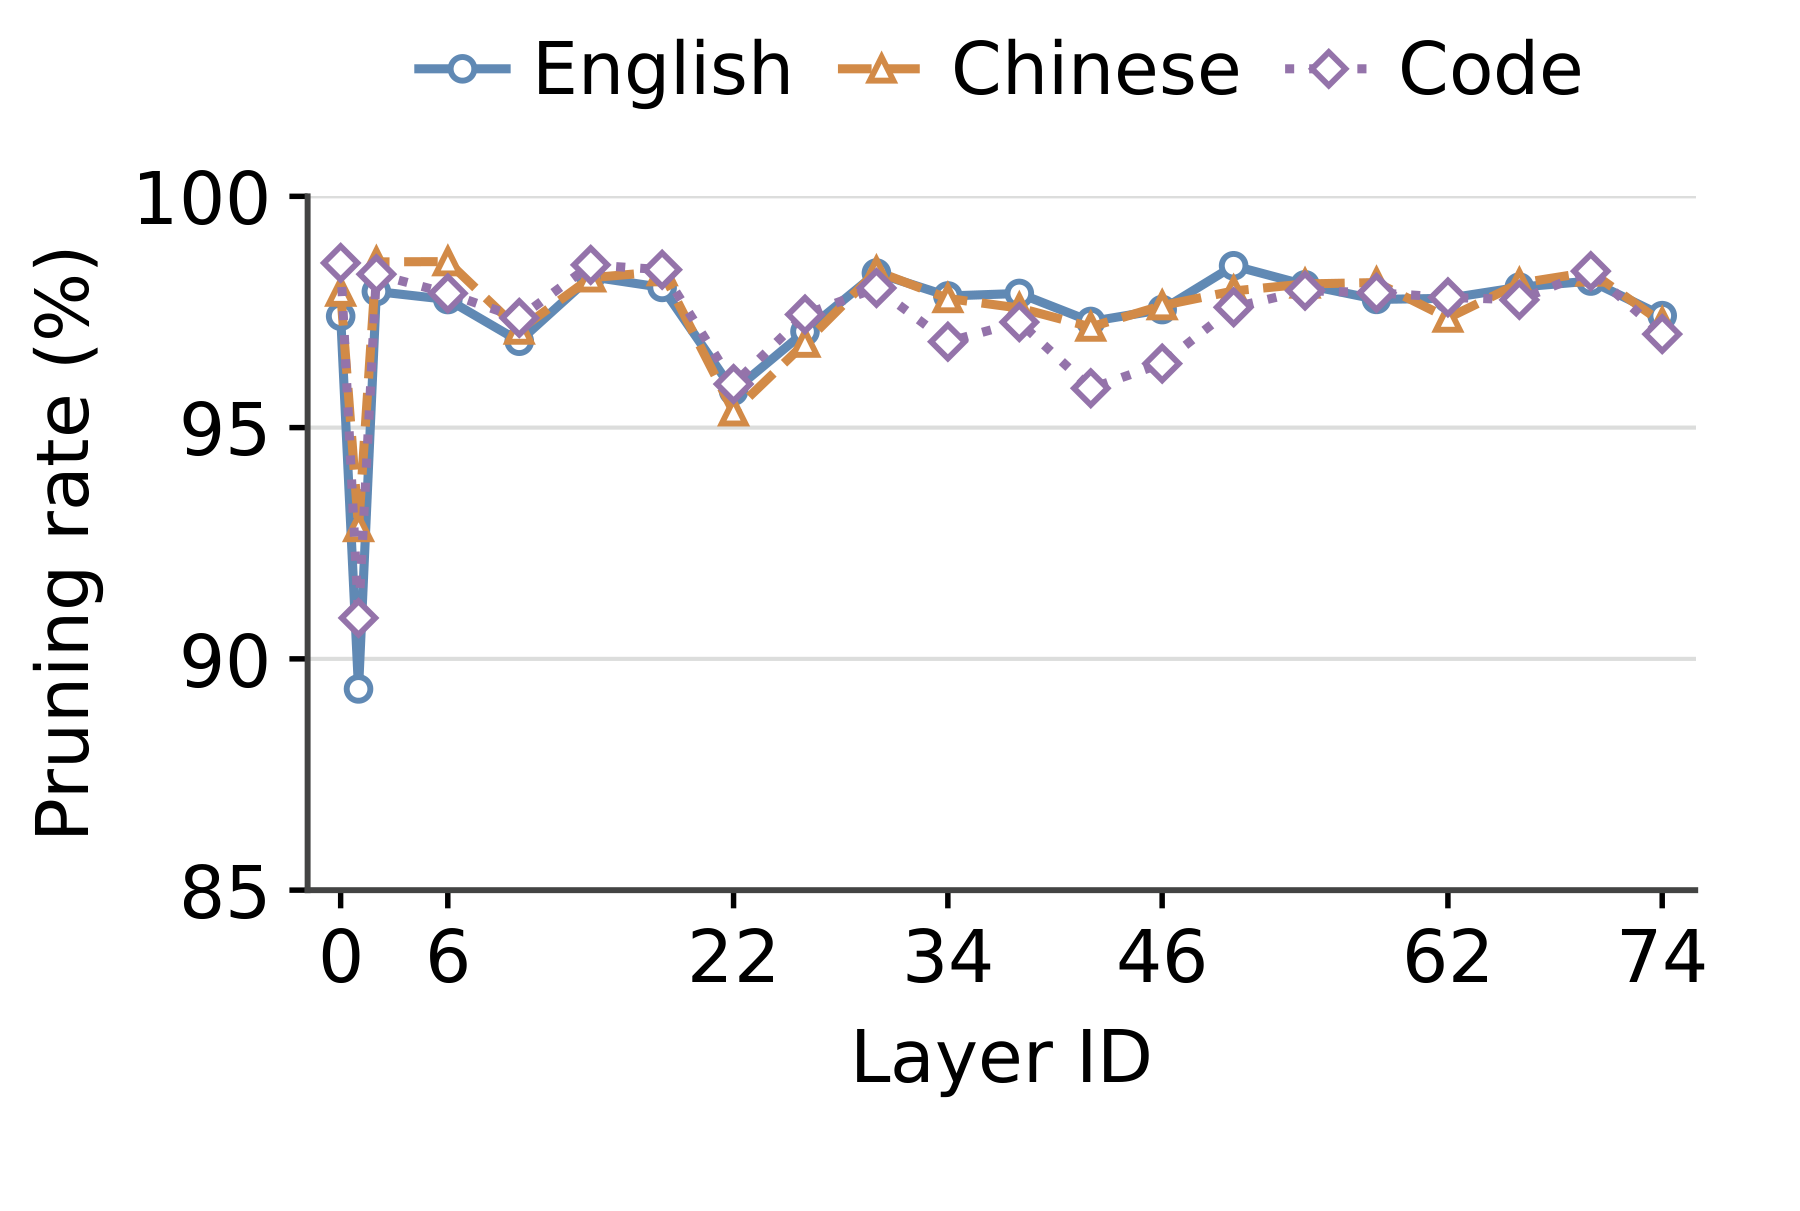
原文 Fig. 6,PDF p. 7。横轴是模型层 ID,纵轴是被筛掉的 query–key 对比例 $p=1-N_{\mathrm{keep}}/N_{\mathrm{screen}}$,三条线对应输入域。
每个域的 21 层中有 20 层剪枝率超过 95%,域平均为 97.2%–97.5%。最低点都位于 layer 1,仍拒绝约 89%–93%;其余层均超过 95%。跨域曲线相近,支持作者关于层级分数几何比输入域更显著影响证书效果的解释。(Sec. 4.2,PDF pp. 7–8)
这与选择间隔公式一致:多数 key 与 Top-K 边界有足够距离,即使上界有一定松弛,也能排除。筛选本身的点积和读 key 成本仍然存在,剪枝率不能直接换成总 FLOPs 降幅。
4.4 端到端 TTFT:约 1M 时接近减半
| 模型,约 1M token,TP8 | 相对 SGLang 加速 | 相对 LiteTopK 加速 | 相对 SGLang 的延迟降幅 |
|---|---|---|---|
| GLM-5.2,chunk 32K | 1.86× | 1.26× | 约 46.2% |
| DeepSeek-V3.2,chunk 16K | 1.94× | 1.50× | 约 48.5% |
加速数字来自 Sec. 4.3、Fig. 8,PDF p. 8。最后一列为本次分析按 $1-1/S$ 换算;加速 1.94× 不等于延迟下降 94%。
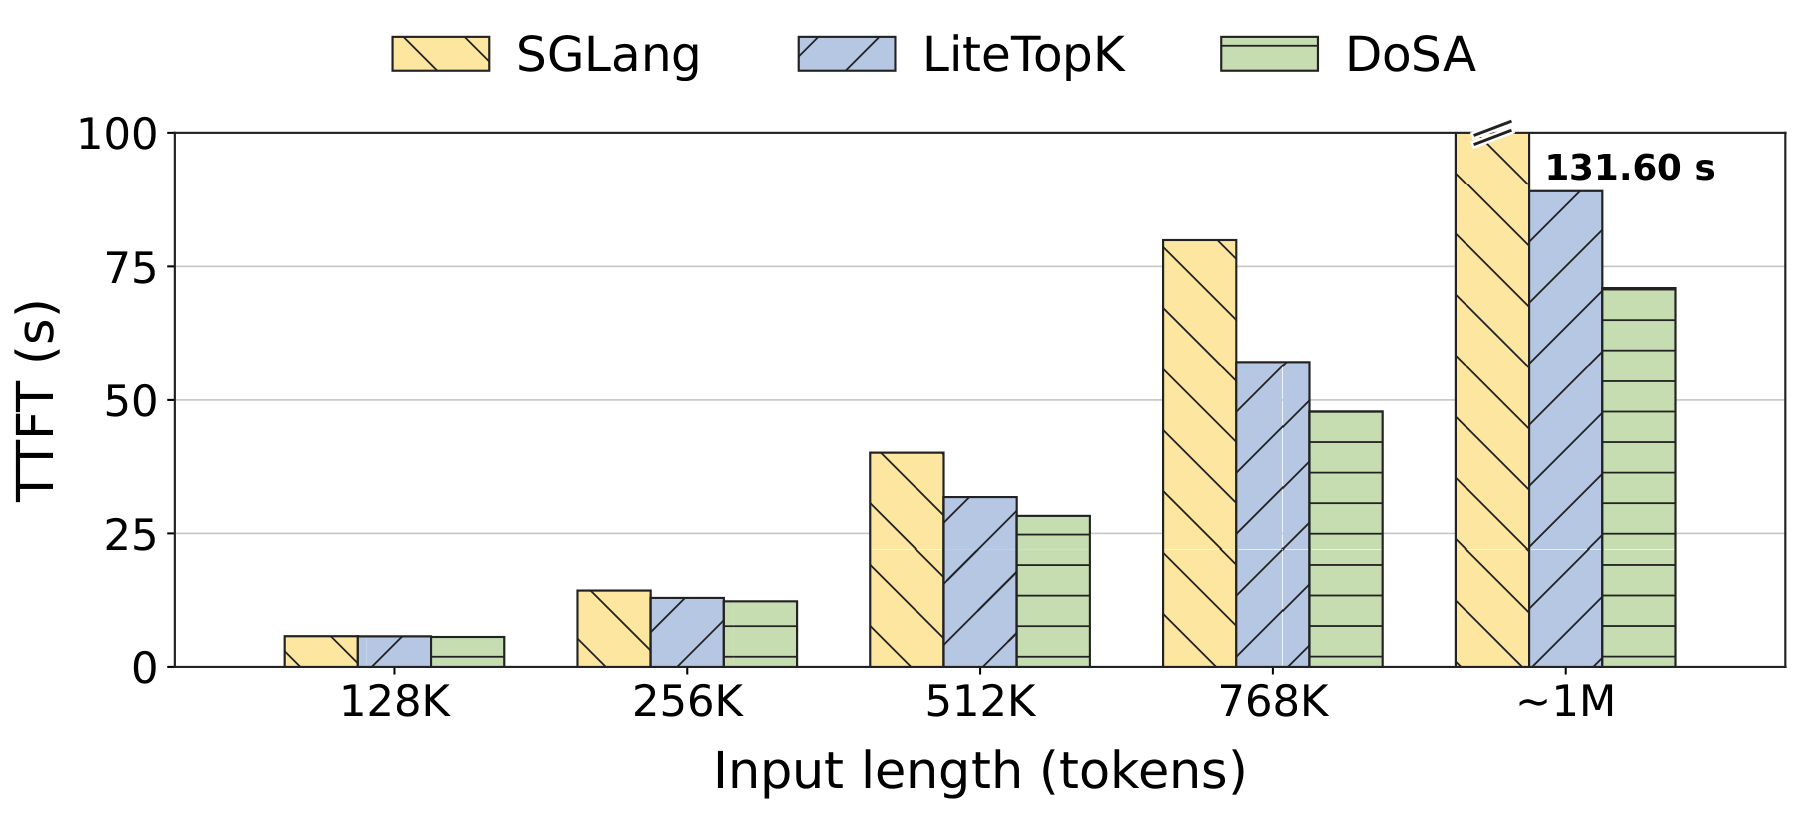
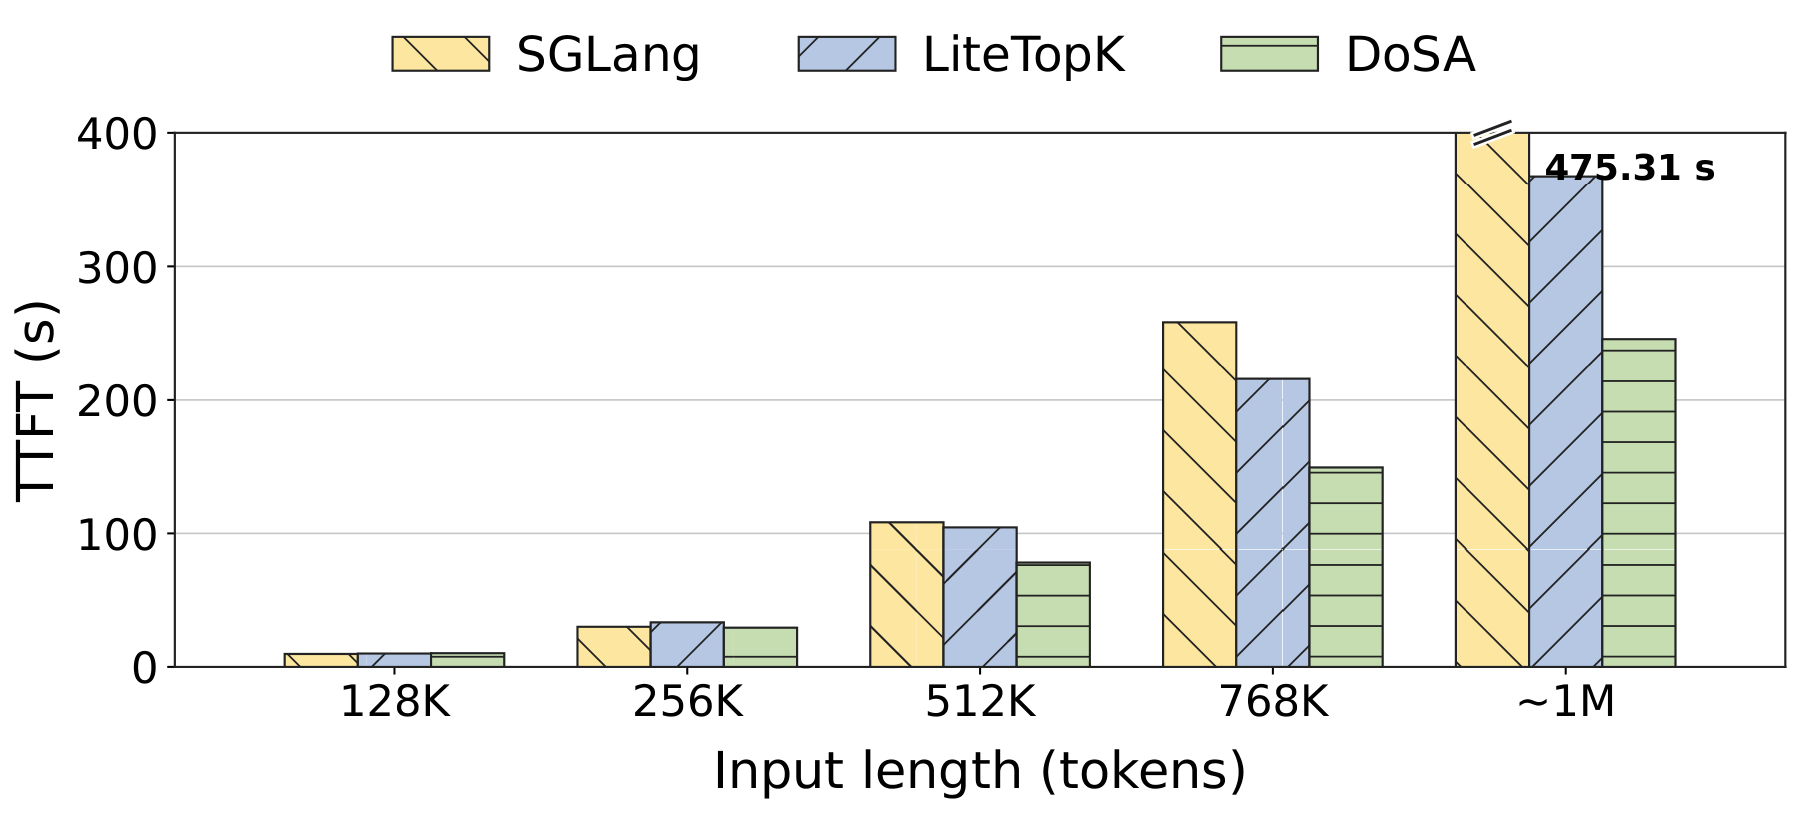
原文 Fig. 8 两个面板,PDF p. 8。横轴为输入长度,纵轴为 TTFT 秒数,越低越好。两图纵轴范围不同,应在各面板内比较方法,不能直接比较柱高。
作者用 Amdahl 定律解释端到端收益:Indexer 时间占比为 $f$、该部分加速为 $s$ 时,理想总加速 $S=(1-f+f/s)^{-1}$。随着 Indexer 在长上下文占据更大 GPU 时间比例,优化它更能改变总体延迟。这里是机制解释:Fig. 1 的 GPU 时间占比与端到端 TTFT 的统计范围不同,不宜把不同口径、不同配置的最大值代入当作严格预测。
4.5 筛选和稀疏写回具有互补作用
原文在 LOFT 的 SciFact 检索样例上,用 16K query、896K key,对 21 个 Indexer 层的 retrieval 延迟取平均。(Sec. 4.4,PDF p. 8;Fig. 7,PDF p. 7)
| 变体 | 证书筛选 | 稀疏写回 | 图示 retrieval 时间 | 原文相对 Base 延迟下降 |
|---|---|---|---|---|
| Base | 关闭 | 关闭 | 76.2 ms | — |
| Full | 关闭 | 开启 | 58.4 ms | 23.4% |
| Dense | 开启 | 关闭 | 47.7 ms | 37.4% |
| DoSA | 开启 | 开启 | 40.2 ms | 47.3% |
图中时延保留一位小数,正文降幅使用原文报告值。联合使用得到 1.90× retrieval 加速;在 Full 上加入筛选再省 31.1%,在 Dense 上加入稀疏写回再省 15.7%。两个单项百分比不能直接相加,因为涉及重叠成本及组合后的执行行为。
Full 仍然支付完整 head 评分成本;Dense 减少评分却保留较重的中间写回。两者各自留下的开销解释了为什么证书和 GPU 数据流必须一起设计。
4.6 证书组件消融:负聚合决定当前工作负载的主要收益
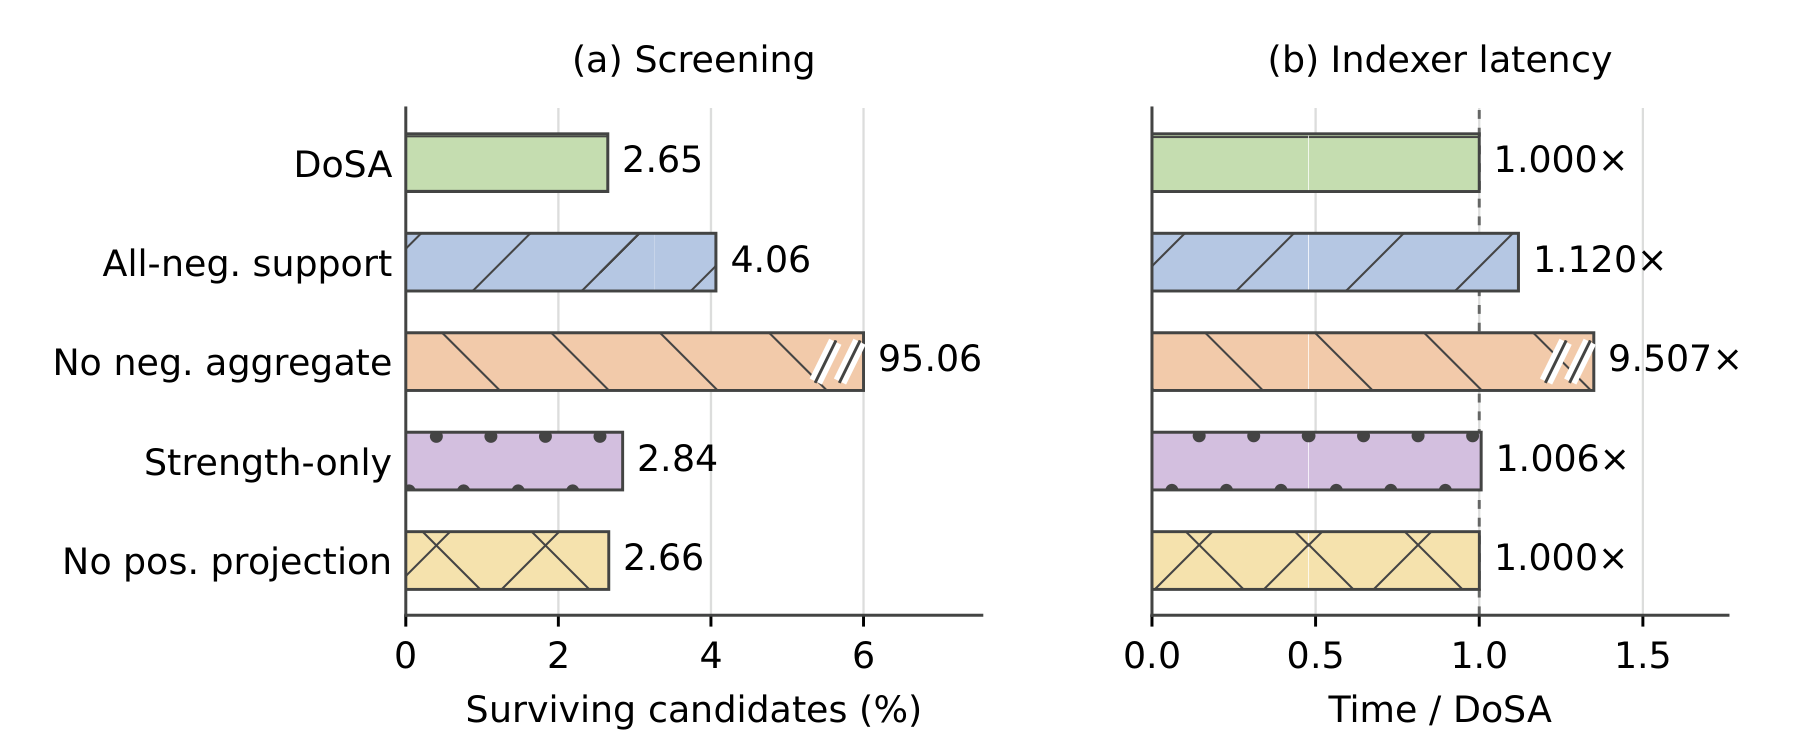
原文 Fig. 9,PDF p. 19。左图是候选生存率,越低越好;右图是相对 DoSA 的 Indexer 时延,越低越好。斜线表示超出显示范围的柱,不能按截断后的长度估算数值。
| 变体 | 平均候选生存率 | 相对 DoSA 的几何平均时延 |
|---|---|---|
| DoSA | 2.65% | 1.000× |
| 聚合所有省略负 head | 4.06% | 1.120× |
| 移除负聚合 | 95.06% | 9.507× |
| 负 head 仅按强度选择 | 2.84% | 1.006× |
| 移除正 head 投影 | 2.66% | 1.000× |
来源:App. D.2,PDF pp. 18–19。95.06% 对 2.65% 是生存率增加 92.41 个百分点。9.507× 的时延包括候选池满后的恢复成本,因此不能将它完全归因于正常路径多做的矩阵乘法。
最鲜明的证据是负聚合:忽略减分项虽然安全,却几乎失去筛选能力。聚合所有负 head 也逊于按激活选择支持集,符合“未激活 head 引发抵消”的机制。反之,本组样本仅 0.42% 的 query-layer 行需要正 head 投影,所以去掉正投影的总体效果极小。这说明当前实证收益主要来自负项处理;正投影和联合残差提供的是覆盖更多正 head 配置的能力,不能把它们描述成已由消融证明的主要加速来源。
附录 D.3 进一步按层拆开:去掉负聚合在大多数层留下近乎全部候选;全负支持集在早期层尤其不利,layer 2 的相对 Indexer 延迟达到 3.41×。Fig. 10 两个纵轴均为对数刻度。(PDF pp. 19–20)
4.7 逐层检索:总体稳定,也存在慢点和扩容代价
附录 D.4 重放末尾 32K query,共 21 层 × 12 个输入 = 252 个单元,计时排除 query/key 准备。每单元每方法重放 12 次,用基线中位延迟除以 DoSA 中位延迟。(PDF pp. 20–21,Fig. 11–12)
| 对照 | DoSA 更快的单元 | 最大 retrieval 加速 |
|---|---|---|
| SGLang | 251/252,99.6% | 3.74× |
| LiteTopK | 250/252,99.2% | 2.08× |
3 个更慢的对照比较增加 0.7%–9.0% 延迟;跨输入取中位数时,21 层相对两个基线都快于 1×。这里的 3.74× 是单元级 retrieval 峰值,和主文 2.74× complete-Indexer 峰值不是同一统计量。
这组证据有一项重要实现背景:容量修复后只重测了 5 个单元,其余 247 个保留原运行结果。重测单元是 EN01 的 layer 26,以及 EN02、EN04、ZH04、CD04 的 layer 1。三种方法在这些单元均配对重测。约 1M key 容量下,修复为每 query 预留 1,024 个候选 ID 页和 114,688 条输出记录,相对原分配增加 9.94 GiB 工作区;整张矩阵没有在修复后全部重跑。这个披露同时说明候选存储并非小细节:它既影响精确性,也影响内存预算和性能评价。(App. D.4,PDF p. 20)
五:结论——可证明跳过评分的价值与取舍
DoSA 提供了一条很清晰的系统设计思路:Top-K 任务需要的是确定赢家,不必知道每个输家的精确分数。只要廉价上界能与已有赢家的阈值分离,就能安全省去完整计算。本文把这种思路落实到带符号多头 ReLU 评分函数,并通过共享读取、稀疏写回和紧凑选择把逻辑节省转化为实际时延收益。
理解这篇论文时,最有价值的三个判断是:第一,负项为当前工作负载提供了主要筛选信息;第二,种子质量、证书松弛和真实选择间隔共同决定剪枝率;第三,精确性必须贯穿实数证明、浮点误差与候选存储。
适用性上,DoSA 仍逐 key 扫描,没有把长上下文检索变为次线性访问。短上下文、松界或大量边界同分候选会让筛选成本难以收回;当前端到端结果主要支持长上下文 prefill 的计算收益。解码侧使用的是全评分加紧凑选择,其收益应按对应路径理解。对于超出模型声明上下文的测试,作者将其定位为计算扩展性观察,没有据此验证任务准确率;合法但 ID 不同的并列 Top-K 也未必产生相同生成文本。(Sec. 6,PDF p. 9;App. D.1,PDF p. 18)
作者提出两个直接承接现有瓶颈的方向:训练时约束证书松弛,让 Indexer 更容易被安全剪枝;为 key 块构造紧凑摘要与块级上界,以便整块跳过、进一步减少 key 读取。前者改变“模型几何是否利于筛选”,后者改变“仍需扫描全部 key”的访问成本,均属于未来工作。