Orthros:阶段感知异构注意力精读笔记
原题:Orthros: Phase-Aware Heterogeneous Attention for Efficient Transformers
作者:Yuhong Chou、Zehao Liu、Yuqi Pan、Qian Liu、Xianwei Chen、Zhongzhu Zhou、Jibin Wu
版本与日期:arXiv:2610.13735v1,2026-10-09 首次提交;本次获取与研读:2026-11-12。PDF 首页内部日期为 2026-10-07。
原文:arXiv v1 · 本地 PDF
发表:已接收 NeurIPS 2026,依据为 作者更新的 arXiv Comments 和 共同作者论文列表;本次未查到可独立核实的正式论文集记录。
代码:截至 2026-11-12 未查到作者官方实现;有 第三方核心机制复现(范围说明),属于小规模机制诊断,不是论文完整实验复现。
论文总览
Orthros 希望同时保留两种性质:长输入的预填充(prefill)保持线性复杂度,而生成输出时仍能逐层读取全部历史。为此,它将一个序列分成两条共享参数但表征不同的 token 流:基础流在所有位置执行滑动窗口注意力(Sliding Window Attention,SWA),负责建立完整的逐层 KV;输出专用流只在要预测下一 token 的位置出现,通过全历史因果交叉注意力(cross-attention)读取这些 KV,并产生 logits。
关键不是把远处 KV 丢掉,也不是将其压进固定维度状态,而是省略不承担输出预测的位置上的全局查询。预填充时只需要最后一个 prompt token 的输出副本;生成时每步同时处理一个基础 token 和一个输出副本。这种计算分工适合长输入、短输出。
主要结果分三组理解:1.3B、100B-token 从零训练中,七项常识任务平均分为 53.98,Transformer 为 53.41;8B 模型转换后,在相同 80B 原始 token 的继续训练预算下,平均分略优于保持原架构的 CPT;系统测试中,21.9× 是 8 卡、1M 输入长度的纯预填充结果,单 H100、batch=2、128K 输入/128 输出的端到端加速则约为 3.45×。(Tables 1–4、Fig. 4,PDF pp. 9–11。)
需要同时保留的代价是:预训练复制全部 token,输出路径也执行 FFN 等计算;KV 历史仍完整保存;长输出会削弱端到端收益。因此本文讨论的是重新分配训练、预填充和解码的计算,不是所有阶段都变成线性、也不是 KV 内存压缩方案。
结构地图
以下为从 1 开始的 PDF 页码,与该版本印刷页码相同。
| 原文章节 | 作用 | PDF 页码、关键证据 |
|---|---|---|
| 1 Introduction | 以阶段分工替代固定层间分配计算 | pp. 1–2 |
| 2 Related Works | 区分线性注意力、滑窗、跨层 KV 共享与 decoder–decoder | pp. 2–4,Eqs. (1)–(3) |
| 3 Method | 双流注意力、四种运行方式、复杂度 | pp. 4–7,Fig. 1,Eqs. (4)–(5),Algorithms 1–2 |
| 4.1 Scaling and Ablation Study | 160M–6.8B、scale-offset 消融 | p. 8,Fig. 2;Table 7,p. 20 |
| 4.2 Training from Scratch | 1.3B、100B token 的架构对照 | p. 9,Table 1 |
| 4.3 Conversion Training | Llama3.1/Qwen3-8B 的 80B-token 转换 | pp. 9–10,Table 2 |
| 4.4 In-Context Recall Capacity | 六项召回任务与 128K NIAH | p. 10,Table 3、Fig. 3 |
| 4.5 Prefilling Efficiency | 单卡及 8 卡预填充延迟 | p. 11,Fig. 4 |
| 4.6 End-to-End Inference | 单 H100、SGLang、不同输出长度 | pp. 11–12,Table 4 |
| 5 Discussion, Limitation and Future Work | 训练—推理成本、KV、MoE 与部署边界 | p. 12 |
| A Experiment Settings | 训练与转换配置 | pp. 19–20,Tables 5–6 |
| B Experiment Metrics | 六种规模的完整消融数值 | p. 20,Table 7 |
一:动机——为什么按处理阶段分配注意力
1.1 线性读入与全局召回之间的矛盾
标准因果注意力在位置 $t$ 查询全部 $1\ldots t$,对整段输入形成二次计算。固定窗口 SWA 将每个位置限制在最近 $w$ 个 token;核化线性注意力则将历史压入递归状态。它们能降低读入成本,却可能损失远处信息的精细召回。混入部分 full-attention 层有助于恢复能力,但只要 full-attention 层比例固定,长序列的二次项仍存在。(Sec. 1、2.1,PDF pp. 1–3。)
Orthros 的观察是:推理 prompt 内部的大多数位置不需要立即产出下一 token,它们主要服务于后续输出。是否可以让这些位置只建立可检索的记忆,而将昂贵的全局读取留给真正承担预测的位置?
1.2 与 decoder–decoder 架构的区别
论文讨论的 decoder–decoder 方案先用 self-decoder 产生共享 KV,后半 cross-decoder 在生成时读取它。Orthros 不将网络固定切成两半;它在每一层内部保留基础流和输出流,每层有自己的 KV,FFN、归一化和大投影参数继续共享。(Sec. 2.2、3,PDF pp. 3–6。)
由此获得两点灵活性:不需要把后半网络全部绑定到单份跨层 KV;现有 Transformer 可以逐层替换注意力后继续训练。不过“可替换模块”指架构适配方便,并不表示不经训练就能无损转换。
二:方法——两条流、同层 KV、四种运行方式
2.1 先看数据流,而不是把它理解成两个独立模型
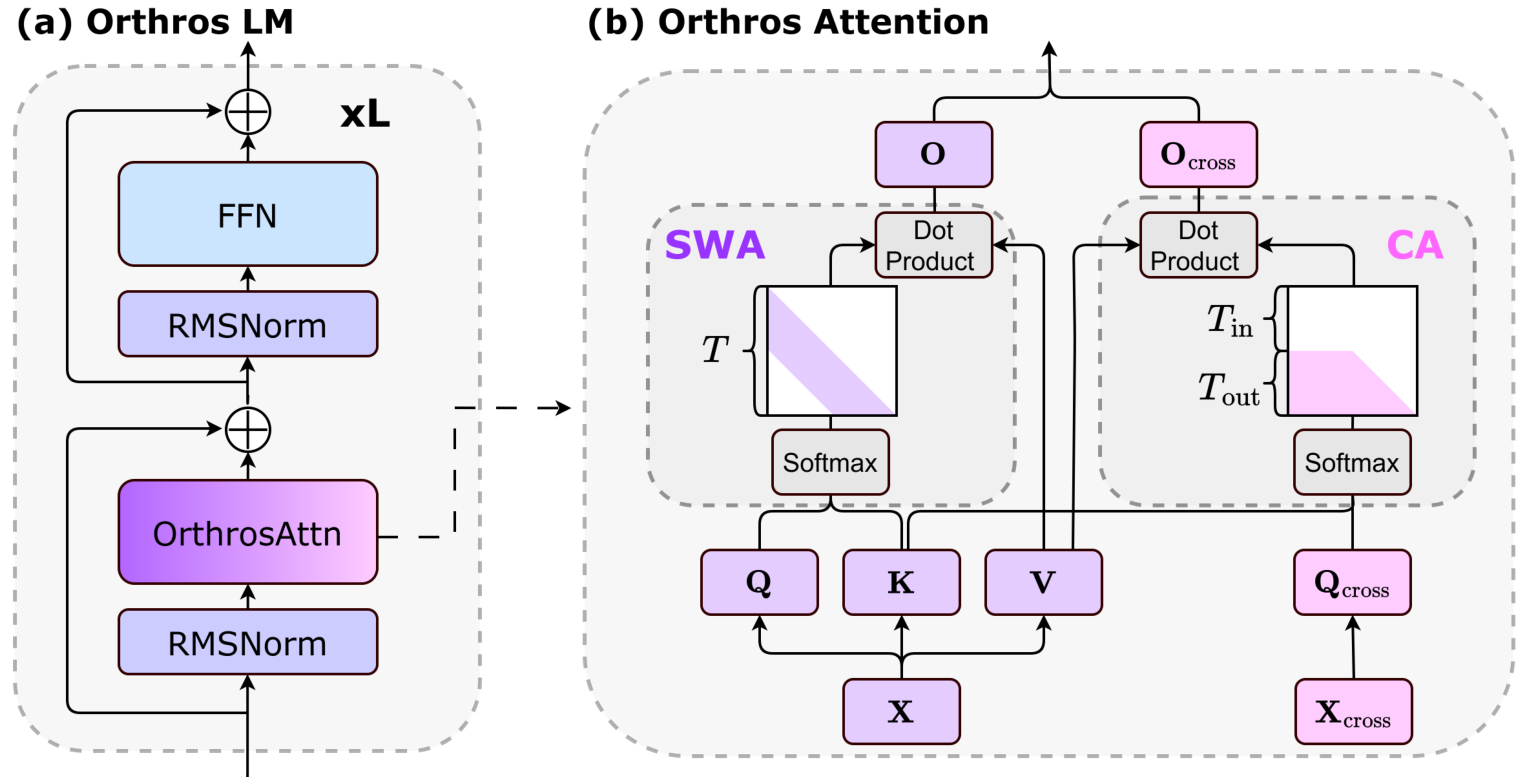
原文 Fig. 1(a)–(b),PDF p. 5,保留原图结构。左是含残差、RMSNorm、FFN 的层;右是注意力内部:$X$ 产生 $Q,K,V$,$X_{\rm cross}$ 只产生 $Q_{\rm cross}$。紫色 SWA 是局部读取,粉色 CA 是全历史因果读取;二者的结果再使用共享输出投影。这里共享的是同一层基础流的 KV。同层 K/V 直接由本层 attention 的基础输入 $X$ 投影得到,不是先取本层 SWA 输出再生成;SWA 的局部更新影响下一层的基础表征。
在每一层,基础 token $x_t$ 与输出专用 token $x'_t$ 具有同一原始位置,但在前几层后已有不同表征。它们最初来自相同 embedding 的复制,之后分别沿局部与全局路径演化。输出流仅在有预测需求的位置存在;它不产生新的 K/V,也不写回历史缓存。
2.2 关键符号与投影
论文用行向量表示 token。$T$ 是不含 EOS 的完整输入序列长度;$T_{\rm out}$ 是承担输出预测的位置数,包含最终 prompt 位置和最后一个生成 token 预测 EOS 的位置;$T_{\rm in}=T-T_{\rm out}$。因此 $T_{\rm out}$ 是预测位置数,不要机械等同于一段文本中已经生成的 token 数。
| 符号 | 形状或范围 | 含义 |
|---|---|---|
| $x_t,x'_t$ | $1\times d_{\rm model}$ | 基础/输出专用表征 |
| $W_Q,W_K,W_V$ | 单头写法 $d_{\rm model}\times d$ | 共享主投影 |
| $q_t,q'_t,k_t,v_t$ | $1\times d$ | 单头 query/key/value |
| $\alpha,\beta,\alpha',\beta'$ | $1\times d$ | 两流各自的可学习 scale-offset |
| $w$ | 默认 128 | 基础流读取窗口 |
基础流生成全部位置的 K/V:
两种 query 则为
两组向量让共享 $W_Q$ 能针对局部读入和全局输出分别调整响应。它们比另建两套大矩阵轻量,保留了参数读取共享的机会。(Sec. 3.1,PDF p. 4;Algorithm 1,PDF p. 6。)
2.3 局部写入与全局读取使用不同的注意力域
令 $\mathcal W_t=\{\max(1,t-w+1),\ldots,t\}$,则
第一式对所有基础位置计算,第二式仅在 $T_{\rm out}$ 个预测位置计算。第二式仍满足 $j\le t$ 的因果约束,而“全局”表示可看任意远的过去,不表示能看未来。(Eqs. (4)–(5),PDF p. 5。)
两流都经过共享 $W_O$、token-wise FFN 和归一化,各自保留残差。最终只取输出流计算 logits 与交叉熵。这些输出流 token 虽然共享网络权重,却不是 KV cache 中额外存储的第二套历史。
2.4 为什么可以省略 prompt 中间位置的全局路径
训练与推理一致性的核心是一个依赖关系:基础流的更新只依赖基础流,基础 KV 不依赖任何输出流表征。 因此,训练时即使每个位置都运行输出流,也不会改变基础流存储的 KV;推理时跳过不需要预测的位置的输出流,后续仍会得到相同的基础缓存。
反过来,如果把输出流的全局结果写回基础流或未来 KV,那么为构建相同缓存,预填充时就可能又必须计算所有位置的全局路径,失去主要效率收益。这是从原文数据流得到的机制解释。(Sec. 3.1–3.2、Algorithms 1–2,PDF pp. 4–7。)
教学例子:prompt 为 $[A,B,C]$,只在 $C$ 上复制输出 token $C'$,全局读取当前层的 $K_A,K_B,K_C$,预测 $D$。下一步将生成的 $D$ 作为新输入,同时形成 $D$ 和 $D'$:$D$ 更新基础缓存并读取局部窗口,$D'$ 读取全部基础历史预测 $E$。未来缓存记录的是各层基础 $D$ 的 K/V,而不是 $D'$ 的全局表征。
实现时还必须保留原始位置对应关系:虽然 Algorithm 2 为方便把输出副本追加到 tensor 尾部,它的 causal mask 仍需按原位置满足 Eq. (5) 的 $j\le t$。物理拼接后的数组下标不能被当作新的语义位置;这是由原文公式推得的实现要求。
2.5 四种模式只是改变哪些位置需要副本
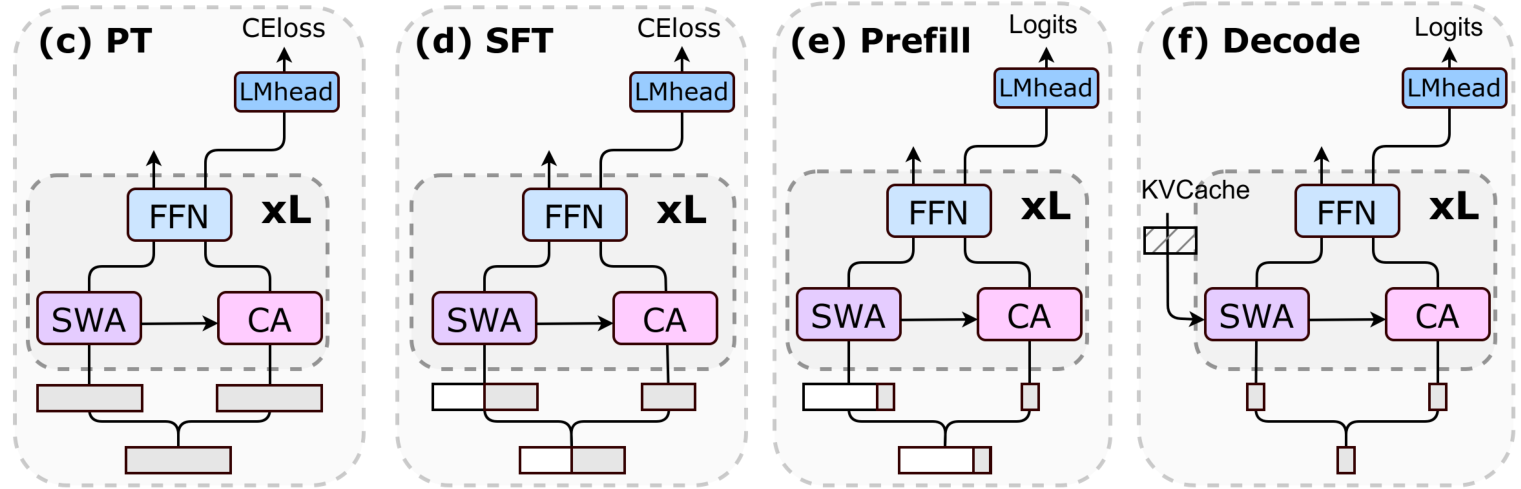
原文 Fig. 1(c)–(f),PDF p. 5。每个小图中的 SWA 生成基础记忆,CA 读取记忆,FFN 为 token-wise 共享模块。
| 模式 | $T_{\rm in},T_{\rm out}$ | 执行与监督 |
|---|---|---|
| 预训练 PT | $0,T$ | 每个位置都预测下一 token,整段复制;只用输出流计算 loss |
| 监督微调 SFT | $T-T_{\rm out},T_{\rm out}$ | prompt 仅建记忆,回答预测位置有输出副本 |
| 预填充 Prefill | $T-1,1$ | 基础流读完整 prompt,仅最后位置做全局查询产生首 token |
| 解码 Decode | 当前步 $T=1$,$0,1$ | 一个新 token 加一个副本;另加历史 KV |
来源:Sec. 3.2,PDF pp. 6–7。解码时局部输入长度是 1,不表示全局检索只有 1 个 key;cross-attention 使用整个历史缓存。原文将 rollout 后只对生成位置优化的 RL 也归入 SFT 型计算安排,这是一种接口兼容性说明,本文没有报告完整 agentic RL 训练结果。
2.6 复杂度与内存:线性成立在哪些条件下
记隐藏宽度为 $D$。每层计算为
三项分别是基础 SWA、输出全局读取、投影与 FFN 等 token-wise 计算。原文在 $w\ll D$ 时把 SWA 视为比投影更小的项;解释长度渐近时应同时声明窗口和模型宽度固定。(Sec. 3.3,PDF p. 7。)
- Prefill:$T_{\rm out}=1$,固定 $D,w$ 时对 $T$ 线性。最后一次全历史查询仍是 $\mathcal O(TD)$,只是没有所有 prompt query 两两交互的二次项。
- 短输出生成:若 $T_{\rm out}$ 为常数,总计算随输入线性;若 $T_{\rm out}=o(T)$,全局读取项为次二次。仅说输出比输入“小很多”而仍保持固定比例,并不足以得到严格的次二次渐近结论。
- 长输出或 PT:$T_{\rm out}=\Theta(T)$,仍有 $\mathcal O(T^2D)$;PT 还复制全部 token,增加投影、FFN、激活等开销。
对 prompt 长度 $P$、生成长度 $R$,忽略边界常数,一个便于理解的推导是:全局检索成本包含 $\sum_{r=1}^R(P+r)=RP+R(R+1)/2$,再加最后 prompt 位置的查询。因此长生成仍会积累二次项。这个表达是教学展开,并非新增实验结果。
缓存内存仍随历史增长。 窗口仅限制基础流“读取哪些 KV”,不意味着驱逐较老 KV。所有历史位置、每一层的基础 KV 都为输出流保留;Orthros 本身没有固定大小状态压缩,也没有 YOCO 式将半个网络压成一份跨层 cache。(Sec. 5,PDF p. 12。)
三:实验——分别看模型能力、转换成本与服务性能
3.1 各组实验的预算不同
| 实验 | 模型与数据 | 训练预算/协议 |
|---|---|---|
| 规模与 SO 消融 | Transformer、Orthros、w/o SO;160M–6.8B | 每种规模 10B token,长度 2048,batch 0.25M token |
| 从零训练架构比较 | 1.3B;FineWeb-Edu | 100B token,长度 2048,batch 2M token |
| 转换 | Llama3.1-8B、Qwen3-8B-Base | 同一 80B-token CC/数学/代码语料;长度 32768,batch 8M token |
| NIAH 长上下文 | 转换后的 Qwen3-8B Orthros | 另加 20B-token ProLong 长上下文训练,再评估 128K |
| 预填充测试 | 8B Orthros 与 Qwen3,FLA 风格实现 | 单卡 8K–128K;8 卡 64K–1M,启用序列并行 |
| 端到端测试 | Qwen3 风格 Transformer/Orthros;两种 hybrid | 单 H100、SGLang、Triton attention、batch=2 |
来源:Sec. 4、App. A,PDF pp. 8–11、19–20。Orthros 默认窗口均为 128;从零训练中的单纯 SWA 基线窗口是 512,不是 128。
Table 5 的消融配置为 AdamW、学习率 $3\times10^{-4}$、cosine schedule、1500 warmup steps、weight decay 0.05、seed 42,8 路数据并行。Table 6 的转换配置为 AdamW、学习率 $3\times10^{-5}$、10,000 steps、500 warmup steps、最小学习率比例 0.1、weight decay 0.1、seed 42,32 路数据并行及 activation checkpointing。训练硬件为 H100 80GB。(PDF pp. 19–20。)
主文 1.3B 的 100B-token 实验与 10B-token 消融不可混用;附录“同配置”的概括不能覆盖主文明写的不同 token/batch 预算。表中的小分差没有多次独立训练的误差条,因此以下按报告结果比较,不把它们提升为统计显著结论。
3.2 baseline 各自在比较什么
- Transformer:标准 full attention,保留全历史上下文计算。
- GDN / GLA / RetNet:不同的线性/递归状态方案,用于比较效率架构的模型能力与召回。
- SWA:只保留局部注意力的控制组,显示缺少全局输出读取时的差别。
- Orthros w/o SO:取消两流的 query scale-offset 分工,检验小额参数特化是否有帮助。
- Base:转换前的原始 checkpoint;Base CPT:保持原架构,在同一 80B token 上继续训练,区分额外数据训练与转换的效果。
- Linear Hybrid / Orthros-H:系统实验中的 8B hybrid 对照。Linear Hybrid 使用 Qwen3.5 风格架构;Orthros-H 在 Orthros 上加入 1:3 的 full/linear 层间混合,GDN 的 cross 查询绕过卷积模块。它们不是 Table 1 中另两套质量评测结果。
3.3 指标、单位与统计对象
常识推理包括 ARC-C、ARC-E、HellaSwag、OpenBookQA、PIQA、Social-IQa、WinoGrande,报告百分制准确率或表头指定的 normalized accuracy,越高越好。这里 Norm 是选择题答案评分的归一化口径,不是对模型做归一化。Table 1 的七任务均分,与 Table 7 消融表的六任务均分不是同一个指标:后者没有 SIQA,且表头对若干任务另标 Norm。
召回表的 DP、NQ、SW、TQ、FD、SQ 分别指 DROP、NarrativeQA、SWDE、TriviaQA、FDA、SQuAD;这里 NQ 不是 Natural Questions。主文仅给表内分数和“越高越好”,没有逐项展开评估器,因此不擅自把所有列都称为 exact match。
系统指标则为:
- TTFT(秒):首 token 到达延迟,越低越好,包含服务端预填充相关路径。
- E2E(秒):完整请求结束延迟,越低越好。
- Output throughput(token/s):整个 batch 产生的 token 总数除以 E2E,包含预填充影响。
- Decode-only throughput(token/s):解码阶段吞吐,需与包含预填充的 Output 分开。
Table 4 的 batch=2,例如 $2\times128/24.647\approx10.4$ token/s,正好对应 Orthros 的 Output throughput;它不是单条请求每秒 10.4 token 的解码速度。Fig. 4 的预填充图纵轴为毫秒,不要与 Table 4 的秒混用。(PDF p. 11。)
四:结果——能力大体保持,收益集中在长输入短输出
4.1 规模扩展与 scale-offset:大规模收益更明显
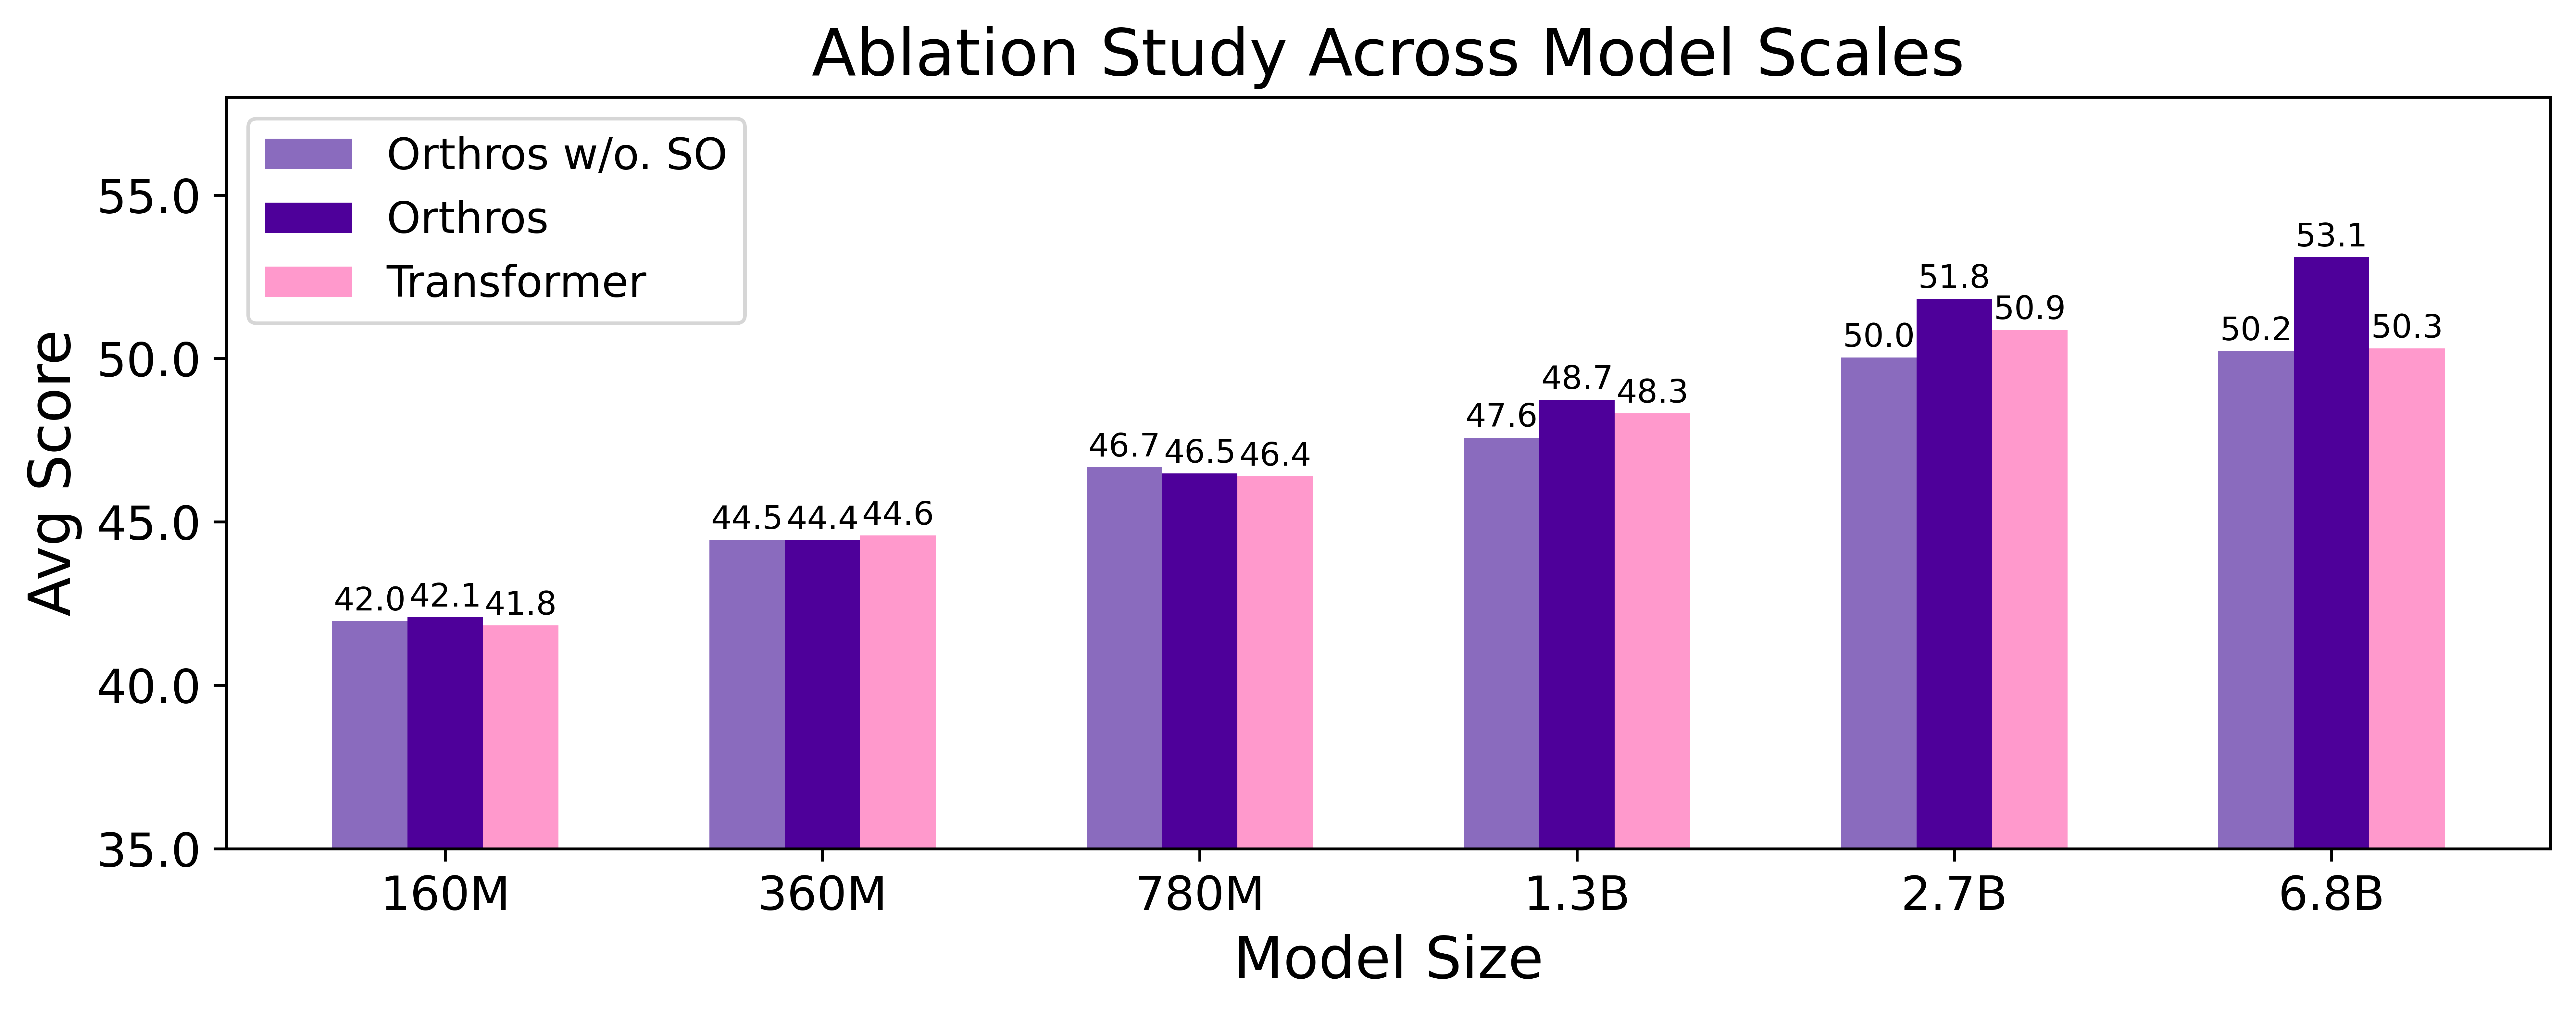
原文 Fig. 2,PDF p. 8,横轴为规模,纵轴为任务平均分;图例区分普通 Transformer、Orthros 和 w/o SO。精确值见 Table 7,PDF p. 20:
| 参数规模 | Transformer | Orthros w/o SO | Orthros w/ SO |
|---|---|---|---|
| 160M | 41.83 | 41.96 | 42.08 |
| 360M | 44.58 | 44.45 | 44.44 |
| 780M | 46.39 | 46.67 | 46.48 |
| 1.3B | 48.32 | 47.58 | 48.74 |
| 2.7B | 50.87 | 50.03 | 51.83 |
| 6.8B | 50.31 | 50.23 | 53.10 |
每个模型都只训练 10B token。6.8B 下 SO 比 w/o SO 高 2.87 个百分点,比 Transformer 高 2.79 个百分点,支持两类 query 专门化的价值。但 360M/780M 上 SO 并未胜过 w/o SO;也不能把固定 10B token 的曲线称为等训练 FLOP 的 scaling law。
4.2 1.3B 从零训练:常识任务均分有竞争力
| 模型 | 七任务平均分 ↑ |
|---|---|
| Transformer | 53.41 |
| Orthros | 53.98 |
| GDN | 53.29 |
| GLA | 51.90 |
| RetNet | 51.96 |
| SWA(窗口 512) | 53.22 |
来源:Table 1,PDF p. 9;每种模型均使用 100B token。Orthros 比 Transformer 高 0.57 个百分点,在 ARC-C、ARC-E、HellaSwag、OBQA、SIQA 上更高,PIQA 和 WinoGrande 略低。例如 OBQA 为 40.20 vs 37.80,PIQA 为 71.82 vs 72.91。
这个实验说明双流架构可以学到有竞争力的语言表征。它按原始训练 token 对齐,Orthros 却额外处理输出副本,因此不是等计算预算下的训练效率优势。
4.3 8B 转换:要优先比较 Base CPT,而不只比较原模型
| 模型家族 | 原始 Base | Base CPT(80B) | Orthros Conversion(80B) |
|---|---|---|---|
| Llama3.1-8B | 65.47 | 67.00 | 67.26 |
| Qwen3-8B | 67.87 | 67.55 | 68.37 |
来源:Table 2,PDF p. 9,八任务均分(七项常识加 MMLU)。Llama 转换相对原始模型提高 1.79 个百分点,但相对同 token 继续训练仅提高 0.26;Qwen 对应为 0.50 与 0.82。
各任务仍有取舍:Llama 的 MMLU 为 Base CPT 68.89、Orthros 68.65;Qwen 为 Base CPT 77.96、Orthros 77.76。因此“转换后均分更高”不等于每项能力都提高。
Base CPT 是必要对照,能排除“仅仅因为多看了 80B token”这一解释;但 PT 中 Orthros 处理双份 token-wise 路径,不能据此进一步宣称收益已在相同训练 FLOP 下归因于架构。本文展示的是同原始数据预算下可行的转换,所需的 80B-token 继续训练也不是零成本的推理时替换。
4.4 召回:均分接近 Transformer,具体任务差异仍在
| 模型 | 六项召回任务平均 ↑ |
|---|---|
| Transformer | 33.9 |
| Orthros | 34.4 |
| GDN | 28.4 |
| GLA | 27.1 |
| RetNet | 25.7 |
| SWA | 28.8 |
来源:Table 3,PDF p. 10。主文和表题明确是从零训练的 1.3B 模型。附录 A 另有一句将 recall-intensive benchmarks 概括为 converted 8B,与主文不一致;这里按主文与表题记录,不将 Table 3 的结果归给 8B。
Orthros 平均略高于 Transformer,显著高于这些线性/滑窗对照,支持完整 KV 加全局输出查询能够改善召回。细分时,FDA 为 24.1 vs 16.4、SWDE 为 39.9 vs 36.7;但 SQuAD 为 38.7 vs 42.6、TriviaQA 为 59.8 vs 62.3。更准确的结论是整体接近 full attention 的召回水平。
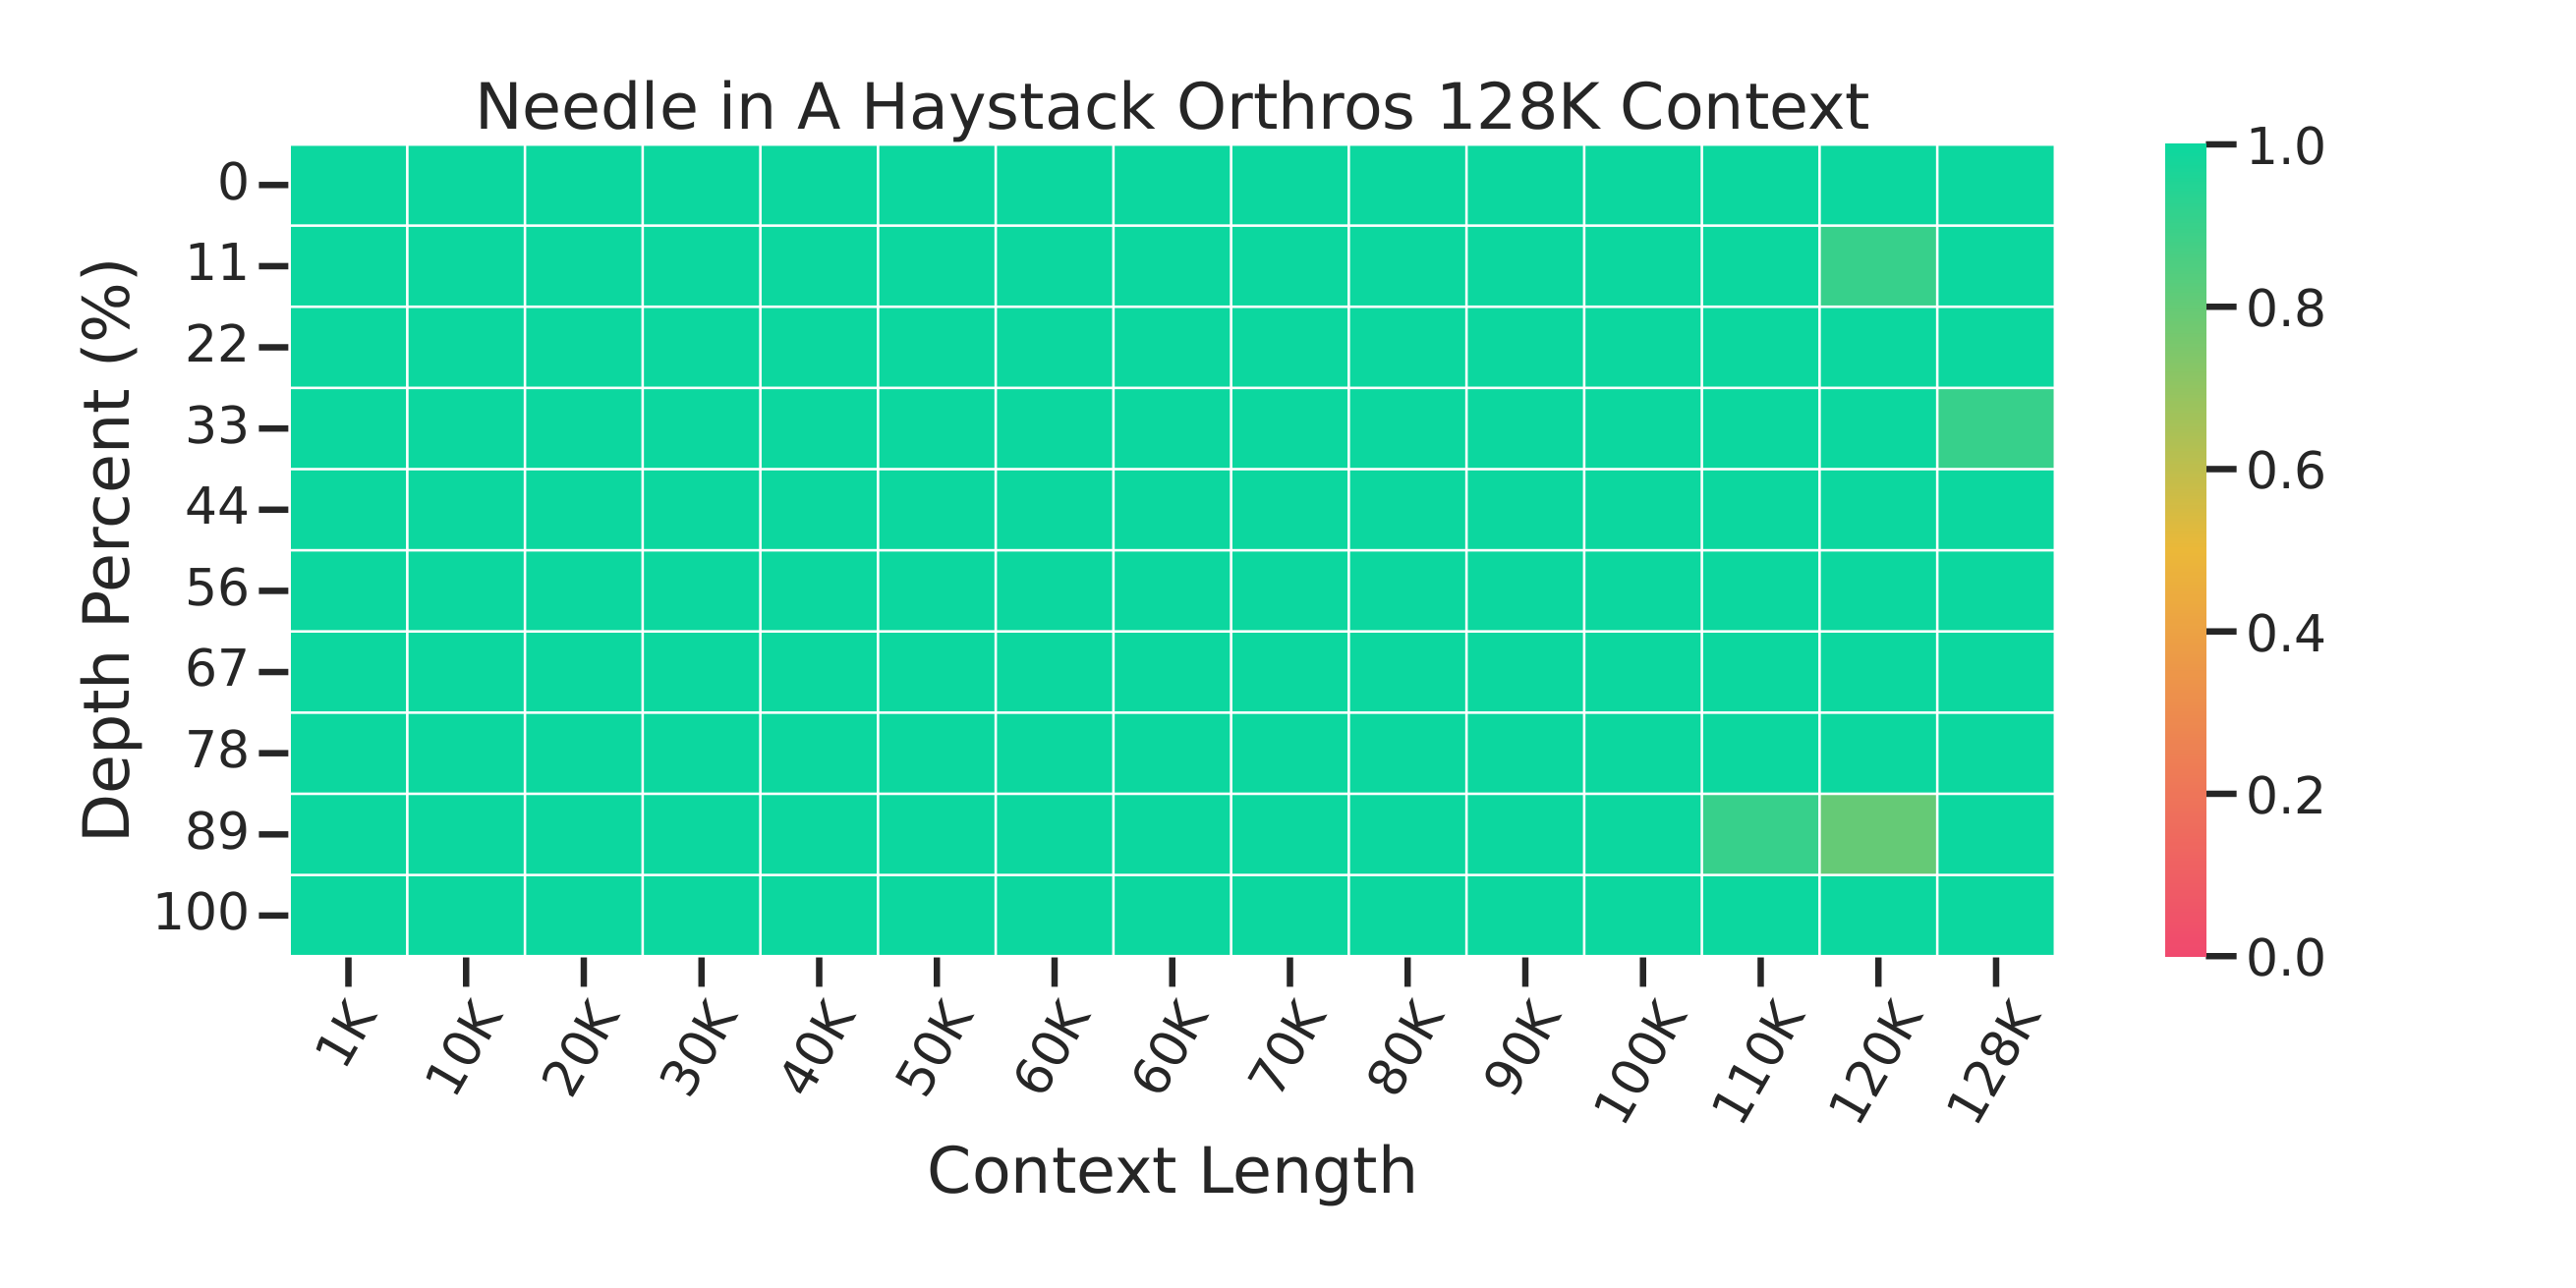
原文 Fig. 3,PDF p. 10。横轴为上下文长度,纵轴为 needle 插入深度,颜色为准确率;多数格接近 1。这个实验使用 Qwen3-8B 转换版,再增加 20B-token ProLong 训练。它支持长距离精确信息可被读取,不能把这种近乎满分的单 needle 检索直接等同于所有复杂长文推理能力。
4.5 纯预填充:21.9× 的条件是 8 卡、1M 输入
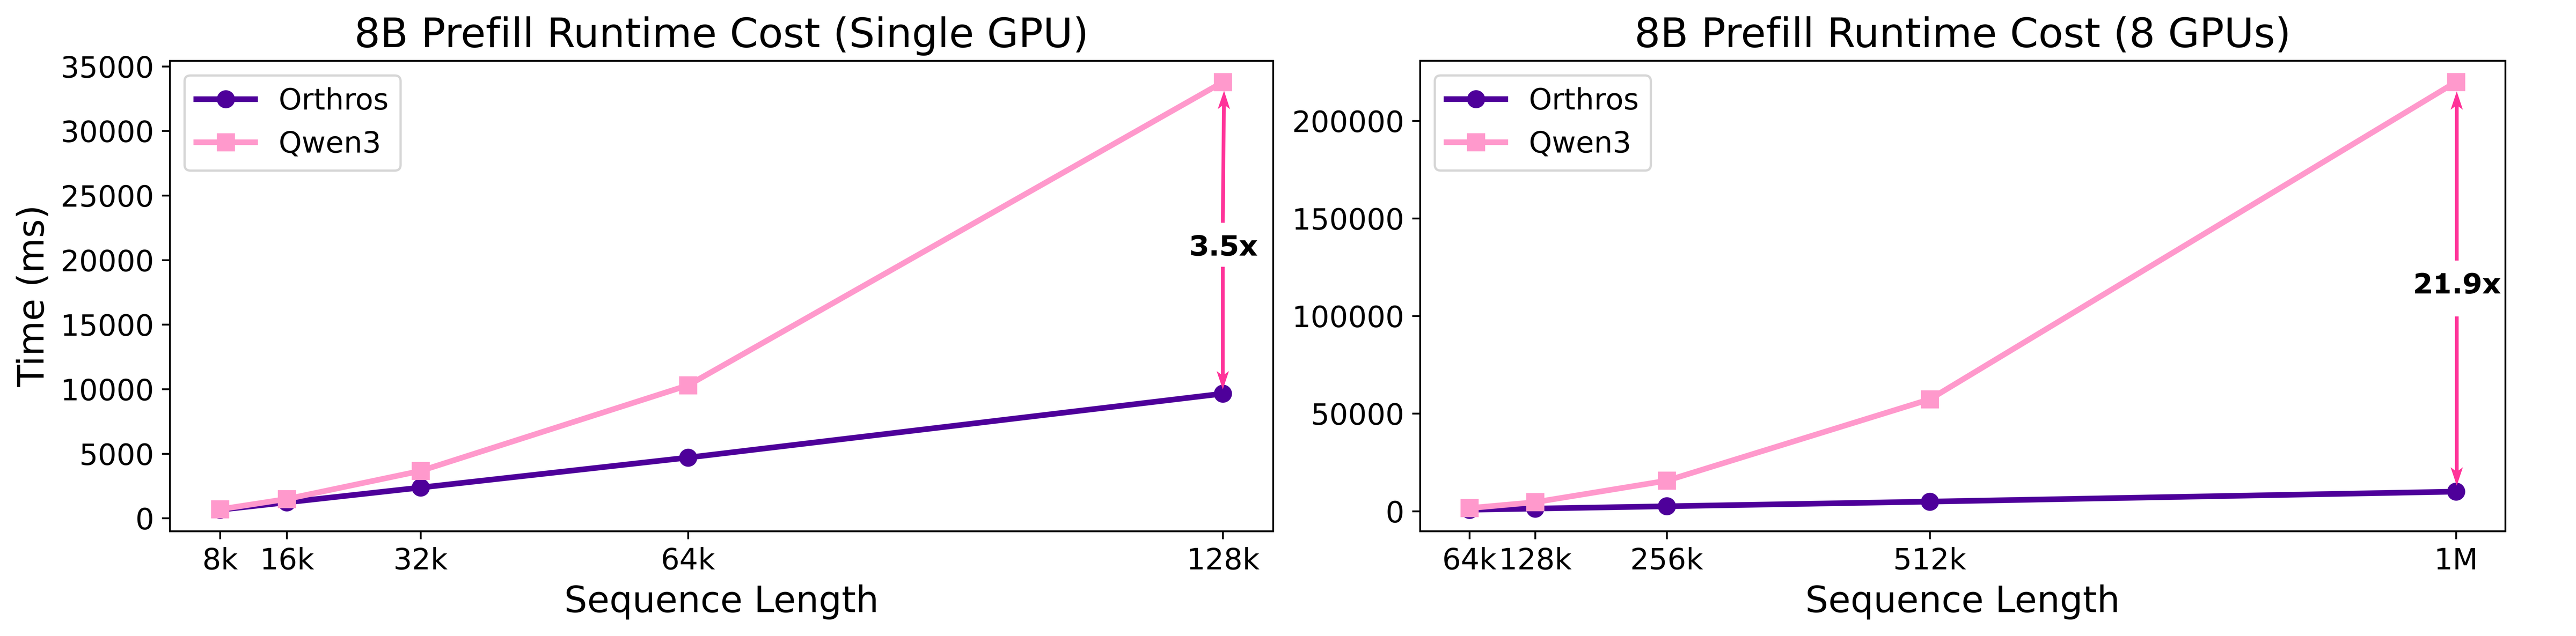
原文 Fig. 4,PDF p. 11。左右图分别为单卡和 8 卡;横轴序列长度,纵轴毫秒,紫色为 Orthros,粉色为 Qwen3。单卡在 128K 处标注 3.5×,8 卡在 1M 处标注 21.9×。多卡测试启用了序列并行;实现为 FLA 风格模型与高性能 kernel。
长度增加时,Qwen3 的二次注意力代价增长更快,而 Orthros 主要在基础流做固定窗口操作,只有末尾一次全局查询,符合预填充的线性长度分析。图没有给误差条,本文不从曲线反推超出图中标注精度的绝对时间。
这组数字与下面的 SGLang 端到端测试不同:硬件卡数、输入长度、软件路径和计时范围均有区别。特别是 21.9× 不代表单卡完整生成加速 21.9×。
4.6 端到端:首 token 更快,长输出会稀释收益
单 H100、SGLang、batch=2、Triton attention,Table 4 的三组长度与结果如下:
| 输入 / 每请求输出 | 模型 | TTFT(s)↓ | E2E(s)↓ | Output(tok/s)↑ | Decode-only(tok/s)↑ |
|---|---|---|---|---|---|
| 128K / 128 | Transformer | 77.249 | 84.911 | 3.0 | 33.7 |
| 128K / 128 | Orthros | 17.016 | 24.647 | 10.4 | 33.3 |
| 127K / 1K | Transformer | 76.160 | 137.715 | 14.9 | 33.2 |
| 127K / 1K | Orthros | 17.301 | 76.345 | 26.8 | 33.7 |
| 120K / 8K | Transformer | 67.770 | 548.357 | 29.9 | 34.1 |
| 120K / 8K | Orthros | 15.210 | 488.830 | 33.5 | 34.6 |
来源:Table 4,PDF p. 11。按报告数值计算:
| 配置顺序 | 128K / 128 | 127K / 1K | 120K / 8K |
|---|---|---|---|
| TTFT 加速 | 4.54× | 4.40× | 4.46× |
| E2E 加速 | 3.45× | 1.80× | 1.12× |
Orthros 把主要收益放在 prefill。虽然每个 decode step 要处理双流 token,decode-only 吞吐在这个小 batch 设置中与对应 Transformer 接近,但第一组仍略低(33.3 vs 33.7),不能概括成解码普遍更快。输出增多后,E2E 被解码时间主导,prefill 节省的相对份额变小,呈现典型的阶段占比效应。
原文正文一句将输入输出长度笼统写成 128、1K、8K,Table 4 的列头则明确是 128K/128、127K/1K、120K/8K;以上依表头记录,避免把这些数据误读为短 prompt 测试。
“额外 FLOP 被 I/O 掩盖”是有条件的系统解释。 两流共享大权重,低 batch 下加载权重的成本可能使额外 token-wise 算术不增加太多延迟;但长上下文也需要读取完整 KV,批量增大后计算与内存瓶颈都会变化。论文只展示 batch=2,不能据此保证高并发或不同硬件下也无解码成本。
4.7 Orthros-H:还可以与层间 hybrid 组合,但不是基础 Orthros 的同一结果
| 配置 | Linear Hybrid E2E(s) | Orthros-H E2E(s) | 计算得到的加速 |
|---|---|---|---|
| 128K / 128 | 28.130 | 12.771 | 2.20× |
| 127K / 1K | 46.308 | 30.724 | 1.51× |
| 120K / 8K | 189.302 | 173.887 | 1.09× |
来源:Table 4,PDF p. 11。Orthros-H 的 decode-only 吞吐分别为 97.3、105.8、99.5 token/s,对照 Linear Hybrid 为 98.8、96.8、98.3。其全局读取/线性层混合进一步改变了解码开销。
该结果说明阶段内异构与层间混合并不互斥。应在 Orthros vs Transformer、Orthros-H vs Linear Hybrid 两组内解释收益,不能把 Orthros-H 的高吞吐直接当作全部 full cross-attention Orthros 的表现。Table 4 是系统速度比较,本文没有同时给出 Orthros-H 的完整能力表来建立同质量 Pareto 优势。
五:结论——保留全量记忆,减少不必要的全局查询
Orthros 最有启发性的机制,是让“可供未来检索的记忆构建”和“此刻要产出答案的全局读取”分别沿两条流进行。输出流不写 KV 的依赖隔离,使模型能够在预填充中跳过多数全局路径,而仍与训练计算对齐。它保留的是全历史访问能力,压缩的是预填充时的全局 query 数量。
实际判断时,以下条件最关键:
- 收益取决于输入/输出比例。 长 prompt、短回答是主要受益区间;训练和长生成仍有二次全局读取,长输出的端到端收益会缩小。
- 数据预算与计算预算要区分。 双流 token-wise 路径提高训练成本,按原始 token 对齐的质量比较不能自动解释为等 FLOP 优势。
- 没有解决 KV 内存增长。 历史 KV 被完整保留,长序列高并发部署仍受容量和带宽约束。
- 工程兼容有具体前提。 因果位置对齐、双流融合、MoE 的成对路由都需要处理;若成对 token 被送到不同专家,会破坏权重读取共享。agentic RL 与不同 batch 场景仍是后续方向。
本文因而适合被看作一套明确的阶段分工设计:用更贵的训练及输出路径,换取预填充的结构性节省,同时通过全历史查询保持较强召回。下一步最有价值的验证,是在相同质量与训练计算预算下,测量多种输入/输出分布、并发和缓存预算下的服务收益。