OAL:按维度贡献分组的二次注意力核——中文精读笔记
论文:Not All Dimensions Are Equal: Outlier-Aware Attention Linearization with Grouped Quadratic Kernels
作者:Weiqi Sun、Qianyue Wu(共同一作)、Wenjia Wang、Tianyang Hu;香港中文大学(深圳)、北京师范大学珠海校区、新加坡国立大学。
版本:arXiv:2610.13674v1,2026-10-09 提交;获取与研读日期:2026-10-19。
来源:版本化 arXiv 页面 · 本地论文 PDF · 作者提供的代码链接。
配套材料:英文汇报 PDF · 可编辑 Beamer 源文件。以下页码均为原文 PDF 页码,与本版本印刷页码一致。
论文总览
OAL(Outlier-Aware Attention Linearization)研究如何把已经训练好的 softmax 注意力转换成线性注意力,同时尽量保留原模型行为。作者发现,query–key 点积的贡献在维度间很不均匀:少量高贡献维度一旦被近似,就能保留相当大比例的完整注意力输出误差。因此,他们让低贡献维度共享参数,让高贡献尾部获得更细的分组,并学习组内线性项和组间二次交互的系数。
方法有三层结构:用贡献统计确定固定分组;用正值二次核表达不同组的作用;用 Hadamard–diagonal(HD)恒等式,把该核的因果计算改写为前缀状态累积。**HD 递推对选定二次核是精确的,近似发生在以二次核替换指数核这一步。**分组压缩的是可学习系数,当前实现仍存储原始维度对的状态。(Sec. 4,pp. 5–8;App. D,pp. 21–22)
在 Qwen2.5-0.5B 冻结注意力实验中,投影前 RelMSE 从最强受测基线 DiJiang 的 0.474 降到 0.432,相对降低约 8.9%。在相同 LoRA 适配预算下,相对单组可学习二次核,OAL 将 Qwen 的 WikiText-103 PPL 从 31.71 降到 27.50,将 Llama-3.2-1B 的 PPL 从 36.03 降到 32.99,并改善三个下游任务。(Tables 2–3,pp. 8、10)
这些结果支持贡献感知参数共享的价值,但部署取舍很具体:转换后的质量仍明显落后于 LoRA-softmax;当前算子在测试范围内也比 FlashAttention 更慢、更占显存。模型实验保留了部分 softmax 层,因此整个转换模型的 prefill 计算仍含二次项。(Sec. 4.4、5.2,pp. 7–10;App. E–F,pp. 22–23)
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 预训练注意力转换的保真问题与维度不均匀性 | pp. 1–2 |
| 2 Preliminaries | softmax、可分离线性注意力、全局二次核 | p. 3,Eq. (1) |
| 3.1 Query–Key Outliers and Dimension-Wise Contributions | 定义贡献统计 | pp. 3–4,Fig. 1、Eq. (2) |
| 3.2 Approximation Error Concentration on High-Contribution Dimensions | 少数维度的误差干预 | pp. 4–5,Table 1 |
| 4.1 Dimension-Aware Linearization | 逐维二次核、HD 恒等式和因果状态 | pp. 5–6,Eq. (3)–(6) |
| 4.2 Outlier-Aware Dimension Grouping | 按贡献共享参数、组数诊断 | pp. 6–7,Fig. 2 |
| 4.3 The OAL Algorithm | 正值参数化、离线拟合和在线求值 | pp. 6–8,Eq. (7)、Algorithm 1 |
| 4.4 Complexity Analysis | 状态成本与算子性能 | pp. 7–9,Fig. 3 |
| 5.1 Frozen-Attention Approximation Fidelity | 固定 Q/K/V 的误差对比 | pp. 8–9,Table 2 |
| 5.2 End-to-End Conversion and Downstream Performance | 混合模型转换后质量 | pp. 9–10,Table 3 |
| 6 Related Work;7 Discussion | 方法定位、结论和规模限制 | pp. 10–11 |
| A Additional Analysis of Query–Key Heterogeneity | 跨模型、高斯/随机维度对照、干预定义、稳定性 | pp. 14–17,Figs. 4–6、Table 4 |
| B Grouping and Coefficient-Calibration Details | bootstrap 分组、初始化、数据划分、组数诊断协议 | pp. 17–20,Eq. (16)–(20) |
| C Frozen-Attention Error Metrics | MSE、RelMSE 的归一化与聚合 | pp. 20–21,Eq. (21)–(22) |
| D Global Reference and HD Realization | 全局核的包含关系、精确等价和状态数量 | pp. 21–22,Eq. (23)–(25) |
| E Runtime and Memory Benchmark | 硬件、精度、后端和显存统计口径 | p. 22 |
| F Conversion and LoRA Setup | 替换层、基线适配、LoRA 与评估协议 | pp. 22–25,Fig. 7 |
一:动机——为什么不让所有维度共用同一个近似
1.1 问题来自预训练表示的异质性
单头注意力的未归一化权重是 $\exp(q^\top k/\sqrt{d_h})$。二阶 Taylor 展开给出 $1+s+\tfrac12s^2$,可学习全局二次核进一步写成 $a+bs+cs^2$。它们先把所有坐标贡献加成一个分数 $s$,再使用统一系数。
OAL 的切入点是预训练表示中不同坐标的尺度相差很大。作者关注的是 RoPE 之后、真正进入注意力计算的 Q/K 坐标乘积,而非单独的激活幅值。对输入 $p$,定义因果配对集合 $\Omega_p=\{(i,j):1\le j\le i\le N_p\}$,并计算:
这是 Eq. (2),p. 4。先对每个输入的因果配对求平均,再对输入等权平均,避免长输入仅因配对数量更多就支配统计。绝对值衡量贡献幅度,正负抵消不会把一个幅度很大的坐标隐藏起来;它并非该维度对最终 softmax 概率的可加贡献。
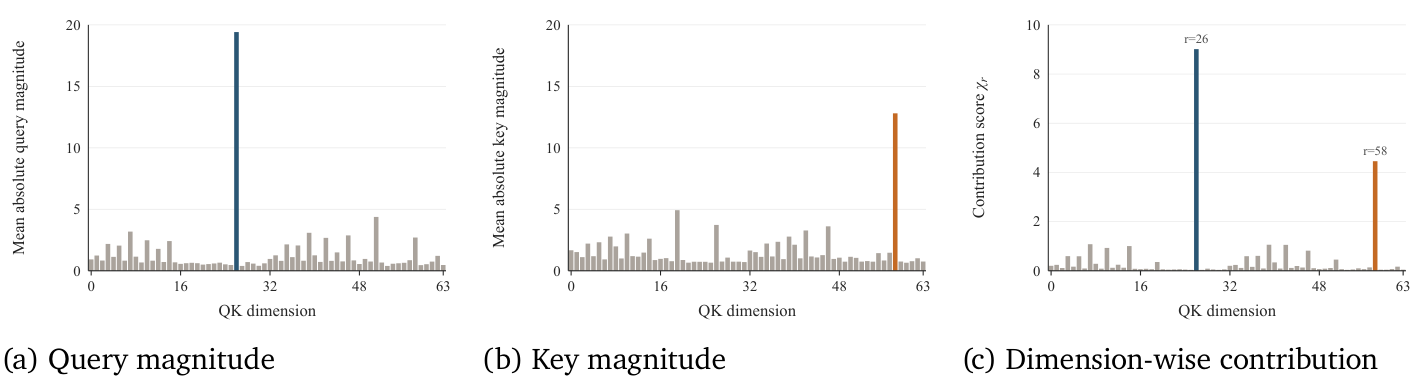
原文 Fig. 1,p. 4。三个面板的横轴都是 QK 维度;纵轴依次是平均绝对 query、key 幅值和 $\chi_r$。示例头中,$r=26$ 的 query 和 $r=58$ 的 key 特别突出,二者也成为主要贡献维度。应联合观察 Q、K 和乘积统计,不能仅按 query 幅值选择 outlier。
1.2 少数维度与大部分近似误差相关
作者对每个受测头选择所有非 bulk 分组的并集 $\mathcal S_h$。Qwen 第 4、12、20 层的 42 个 query heads 共选出 147 个维度,占 $147/(42\times64)=5.47\%$。
实验仅近似 $\mathcal S_h$,剩余维度在未归一化核层面保持精确:
然后对这个混合核做因果归一化并乘以原始 V,得到输出误差 $\mathcal E_{\mathcal S}$,报告 $R_{\mathcal S}=\mathcal E_{\mathcal S}/\mathcal E_{\rm full}$。这是保留误差比例;由于归一化和各维度交互,它不构成误差的可加归因。(App. A.2,pp. 15–16,Eq. (8)–(14))
| 近似方法 | 仅近似高贡献维度的保留误差 | 高斯 Q/K 对照 |
|---|---|---|
| Performer | 37.8% | 4.7% |
| SpectraFormer | 58.1% | 18.1% |
| DiJiang | 64.8% | 19.4% |
| TaylorShift | 63.9% | 13.6% |
原文 Table 1,p. 5。约 5.5% 的维度便保留 37.8%–64.8% 的完整输出误差,支持把更多拟合自由度分配给高贡献维度。高斯对照将 Q/K 换为独立标准正态样本,重新执行相同分组与干预。
另一个独立对照是在真实预训练表示的 bulk 维度中,随机抽取与 $\mathcal S_h$ 等大的集合。1,000 次随机对照均未达到观测保留误差,采用加一校正得到 $p=1/1001\approx0.000999$。这个显著性结果来自随机坐标检验,并非高斯对照。干预使用 16 段不重叠的 WikiText-2 4096-token 序列,每段每层采样 32 个因果 query 位置;随机方法先平均五个随机种子的 MSE 再求比例,最后跨层和输入宏平均。(App. A.2,p. 16,Eq. (15))
1.3 跨模型与稳定性证据支持固定分组
GPT-2 Medium 的代表性注意力头也存在贡献集中,只是较大贡献分布在更多坐标上(Fig. 4,p. 14)。Qwen 示例头的 Top-5 贡献占比为 50.71%;高斯样本中重新选 Top-5 或使用原模型坐标位置,分别约为 7.82%、7.81%(Fig. 5,p. 15)。
在另一个输入稳定性诊断中,校准输入与保留输入的逐维贡献 Spearman 相关系数为 0.991,Top-5 重合 5/5。固定序列的前缀长度从 128 增长至 4096 时,$r=26,58$ 始终是最大的两个维度,合计贡献约 46%–49%。这些是代表性单头的观察,为离线确定、随后保持固定的分组提供依据。(App. A.3,Fig. 6、Table 4,p. 17)
二:方法——贡献分组、正值二次核、精确递推
2.1 从全局标量核扩展到逐维系数
| 符号 | 含义与维度 |
|---|---|
| $N,d_h,d_v$ | 序列长度、query/key 维度、value 维度 |
| $q_i,k_i\in\mathbb R^{d_h}$;$v_i\in\mathbb R^{d_v}$ | token $i$ 的单头向量;Q/K 已应用 RoPE |
| $x_r=q_rk_r/\sqrt{d_h}$ | 单个 query–key 对在坐标 $r$ 的带符号贡献 |
| $\chi_r$ | 多输入上的平均绝对贡献,用于离线分组 |
| $\mathcal G_g,g(r),G$ | 第 $g$ 组、坐标到组的映射、组数 |
| $s_g=\sum_{r\in\mathcal G_g}x_r$ | 当前 query–key 对的组贡献;$s=\sum_gs_g$ |
| $L\in\mathbb R^{(G+1)\times(G+1)}$ | 每层、每 query head 独立学习的下三角因子 |
| $u_j=[v_j;1]\in\mathbb R^{d_v+1}$ | 同时携带输出分子与归一化分母的扩展 value |
把全局核展开:
统一系数隐含了两个共享约束:所有坐标的一次项都用 $b$,所有坐标对的二次交互都用 $c$。OAL 先解除它们:
Eq. (3),p. 5。$C_{rr}$ 控制本坐标平方,$C_{rt}$ 控制跨坐标交互。二阶是同时保留平方项和交互项的最低阶数。这里的二次求和包含有序对,所以展开对称矩阵时非对角交互实际出现两次。
再按组共享 $b_r$ 和 $C_{rt}$,得到关于 $(s_1,\ldots,s_G)$ 的二次函数。它仍保留不同组之间的交互;不是把各组当作彼此独立的注意力头,也没有把 outlier 单独交给精确 softmax。
2.2 如何让分组反映稳定的贡献差异
每层每 query head 独立确定分组,query heads 按模型原有 GQA 映射使用相应 KV head。流程如下。(App. B,pp. 17–19)
- 用 40 条短提示的 $\chi_r$ 把坐标从低到高稳定排序为 $\pi_1,\ldots,\pi_{d_h}$。
- 仅在最高贡献尾部附近找切点。令 $m=\lceil\alpha d_h\rceil$,候选位置为 $k=\max(1,d_h-m),\ldots,d_h-1$,包含尾部开始前的边界。
- 计算相邻贡献比 $\rho_k=\chi_{\pi_{k+1}}/\max(\chi_{\pi_k},\varepsilon)$,检查是否存在明显跳跃。
- 做 1,000 次提示级 bootstrap,有放回重采样提示,但始终保持原坐标排序。每次比较上侧集合的最小贡献与下侧集合的最大贡献:
- 同时满足 $\rho_k\ge\tau$、$S_k\ge\gamma$ 的自然切点全部保留。若不足两组,按 $(S_k,\rho_k)$ 的降序优先级补充切点;补充切点不必满足自然阈值。
这里 $\varepsilon$ 只用于贡献比的数值除零保护,与下文核的正值下界 $\epsilon$ 概念不同。
| 分组设置 | Qwen2.5-0.5B | Llama-3.2-1B |
|---|---|---|
| 尾部比例 $\alpha$ | 0.25 | 0.50 |
| bootstrap 支持阈值 $\gamma$ | 0.9 | 0.5 |
| 间隔比例阈值 $\tau$ | 1.5 | 1.5 |
| 最小组数 | 2 | 2 |
| 实际组数 | 2–5 | 2–4 |
没有显式最大组数,也没有额外最小组大小约束。最低两组是一个设计选择,意味着即使自然分界不明显,也会划出尾部子组。分组一旦建立,在系数拟合、LoRA 适配和评估时都固定。
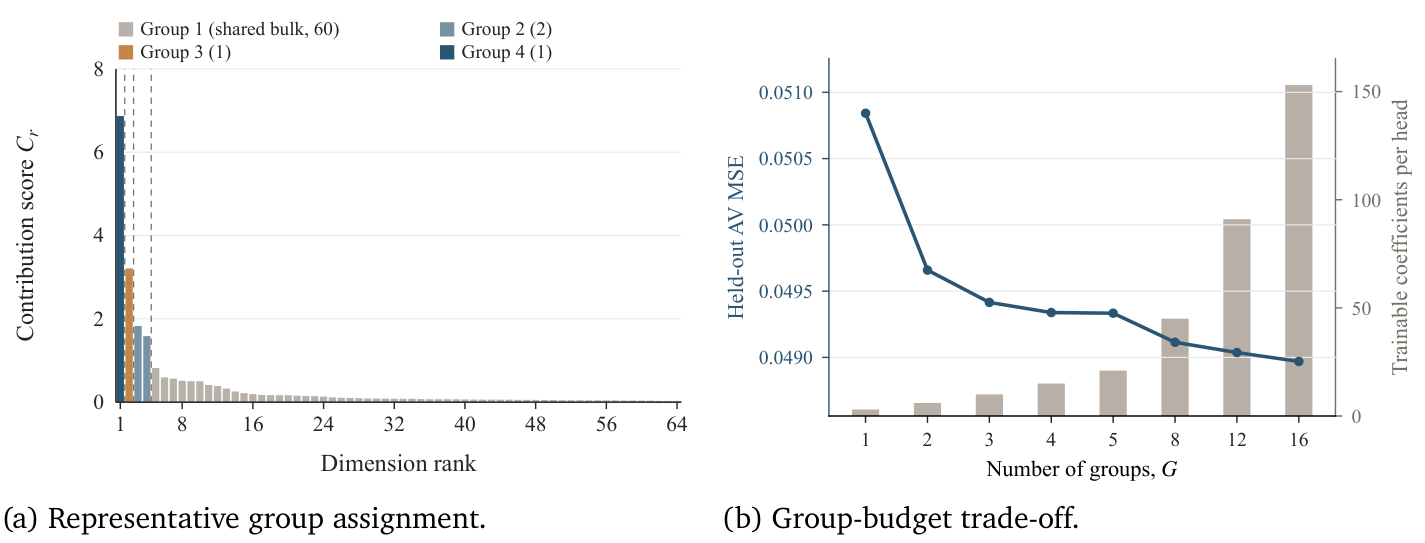
原文 Fig. 2,p. 7。左图为 Qwen 第 4 层第 0 头,横轴按贡献排序,图上从高到低展示;四组大小为 60、2、1、1,较大的 bulk 共享参数。右图横轴是固定组数,蓝线对应左轴的保留集 attention-output MSE,柱状对应右轴的每头参数量。低组数阶段获得多数误差下降,继续细分收益递减。
右图是单独的预算诊断:固定 $G$ 后选排序中最大的 $G-1$ 个相邻间隔,使用相同训练、验证和保留数据。它没有运行上述自然阈值/bootstrap 自适应选组流程,因此不应把某个固定预算点当作全部头的统一最佳组数。(App. B,p. 20)
2.3 正值参数化让分母保持有效
令 $\bar{\mathbf s}=[1,s_1,\ldots,s_G]^\top$、$M=LL^\top$,定义:
Eq. (7),p. 7。对应逐维系数为:
因此任意 query–key 对的权重均至少为 $\epsilon$,非空因果前缀上的分母严格为正;在精确算术中,第 $i$ 个位置的分母至少为 $i\epsilon$。允许一次项和某些交互系数为负,并不破坏完整核值为正。
每头可学习参数数目是下三角元素数 $(G+1)(G+2)/2$。$G=1,2,4,5$ 时分别为 3、6、15、21 个参数。全局二次核是 $G=1$ 的受控基线,也可以通过让所有组共享相同的矩阵条目嵌入更大的 $G$,所以组核的函数族包含正值全局二次核。(App. D,pp. 21–22)
下面是理解表达能力的教学例子,并非论文实验:取 $G=2$、$M=\operatorname{diag}(1,4,1)$,则 $\kappa=\epsilon+1+4s_1^2+s_2^2$。两个贡献分配 $(1,0)$ 和 $(0,1)$ 的总分都为 1,统一标量核必须给出相同值,组核却分别给出 $5+\epsilon$、$2+\epsilon$。这是额外自由度的来源;它的取值是否有用由归一化输出拟合决定。
正值权重与 Mercer 核正定性是不同条件。$M\succeq0$ 保证关于组分数的二次式非负,却不保证任意一组 query/key 向量形成的 Gram 矩阵半正定。本文的线性求值依赖代数可分离性,不依赖存在同一个实特征映射满足 $\kappa(q,k)=\phi(q)^\top\phi(k)$。(App. D,p. 21)
2.4 HD 恒等式如何消除 token 两两计算
对 value 通道 $\ell$,令 $D_\ell$ 的对角元素为 $V_{j,\ell}$,有:
Eq. (4),p. 5。看单个 query 更直接:
右侧先累积一个 $d_h\times d_h$ 的 key 二阶矩,再由 query 读出。实现不需要创建 $D_\ell$,也不应真的生成最外层 $N\times N$ 矩阵;只计算每个 query 对应的对角元素。
因果场景把累积范围改为 $j\le i$。将 $v_j$ 增广为 $u_j=[v_j;1]$,一次维护三种状态:
Eq. (5),p. 6。每个 $H_{2,i,rt}$ 都是 $d_v+1$ 维向量。输出用 query 组合这些状态:
Eq. (6),p. 6。前 $d_v$ 个通道是加权 value,最后一个通道把 value 替换为 1,恰好累积同一套核权重的归一化分母。把状态定义代回去、交换求和次序,就得到 $\widetilde u_i=\sum_{j\le i}\kappa_{\rm OAL}(q_i,k_j)u_j$,证明递推与直接两两求值一致。(App. D,p. 21,Eq. (25))
一个 token 到来时,先用它的 K/V 更新状态,再用当前 Q 读出,因而包含 $j=i$ 的自注意力项。状态记录 K/V 的统计,组相关系数参与 query 侧读出;GQA 因此可以共享 KV 状态。
2.5 三个阶段使用不同数据与训练目标
| 阶段 | 固定内容 | 优化或产生的内容 | 数据 |
|---|---|---|---|
| 贡献分组 | 预训练模型 | 每层每 query head 的固定分组 | 40 条短提示 |
| 输出校准 | 分组及预训练 Q/K/V | 下三角因子 $L$ | WikiText-2:8 段训练、2 段验证,每段 4096 tokens |
| 模型适配 | 分组、原始主干权重 | $L$ 和全层 Q/K/V/O 的 LoRA | WikiText-103,512 次更新 |
校准直接匹配归一化注意力输出:
Eq. (20),p. 19。相比只拟合 $\exp(s)$ 或未归一化权重,它同时考虑分子、分母以及给定 V 后的输出误差。
WikiText-2 拼接后的块 16–23 用于拟合,24–25 用于验证,0–15 留作冻结注意力评估。Adam 学习率 0.02,FP32 参数,每次采一段序列中的 32 个因果 query 位置,每个初始化最多 1,000 次更新,梯度范数裁剪 10;每 100 次验证,连续 400 次更新未改善则停止。三个初始化分别是已学习全局核的嵌入、二阶 Taylor 初值、全局核的高斯扰动,每头按验证 MSE 选择。全局二次基线使用相同的数据、优化与候选预算。(App. B,pp. 19–20)
2.6 参数少并不意味着二阶状态小
直接两两求值成本为 $O(N^2(d_h+G^2+d_v))$;HD 求值成本为:
固定 head 维度后,时间对序列长度线性、状态不随序列增长。但具体维度常数很大:有序维度对实现需要 $(1+d_h+d_h^2)(d_v+1)$ 个状态元素。利用 $H_{2,rt}=H_{2,tr}$,对称压缩为:
压缩后的读出对非对角项乘 2,才能保留原有交互。由该公式计算,当 $d_h=d_v=64$ 时,一个逻辑状态有 139,425 个元素,而 $G=5$ 的系数只有 21 个参数。这两个数量分别描述状态容量和可学习参数,不能互相替代,也不是整算子的峰值显存。(Sec. 4.4,pp. 7–8;App. D–E,pp. 21–22)
三:实验——三个问题、三种证据口径
3.1 冻结注意力:隔离核替换本身的误差
对象为 Qwen2.5-0.5B Base 第 4、12、20 层全部 query heads,序列长度 4096,使用相同的 post-RoPE Q/K 和 V。对每段保留序列 $b$,先汇集受测层与头,再计算:
其中 $B$ 为保留序列数,$n_b$ 为序列 $b$ 的输出张量所含标量元素数。两者都是越低越好。RelMSE 先按每段真实输出能量归一化,再平均;不是用跨段误差总和除以跨段能量总和。$W_o$ 之前评估各头输出;$W_o$ 之后先按原顺序拼接头,再通过冻结的输出投影,分母也换成投影后真实输出的能量。(Sec. 5.1,pp. 8–9;App. C,pp. 20–21)
3.2 模型转换:同一小预算适配后的质量
Qwen 替换零起始编号第 3–20 层,保留最前、最后各三层 softmax;Llama 替换第 1–14 层,保留首尾各一层。替换范围由中间层的大激活分布启发,各转换方法在同一主干内使用同样范围。(App. F,pp. 22–23)
所有方法,包括 softmax 参考,都在每层的 Q/K/V/O 投影加入 LoRA:rank 8、缩放参数 16、dropout 0.05。以 WikiText-103 下一 token 预测训练 512 次更新,序列长 4096、batch 1、无梯度累积,即 2,097,152 个输入 token。AdamW 学习率 $5\times10^{-4}$、权重衰减 0.01,前 5% 更新预热后 cosine 衰减;训练种子固定为 42,每 128 次更新在固定 32 个验证块上评估 NLL 并选 checkpoint。(App. F.2,p. 25)
PPL 使用 WikiText-103 测试集的独立、不重叠 4096-token 块,每块评分 4095 个下一 token,丢弃不足一块的末尾。下游是零样本 normalized accuracy:PIQA 验证集 1,838 题、HellaSwag 验证集 10,042 题、ARC-Easy 测试集 2,376 题。前两者按候选 token 数归一化条件对数似然,ARC-E 按选项字符数归一化,因此应按论文协议解读这些准确率。(App. F.3,p. 25)
3.3 基线各自代表什么
| 方法 | 本文实际使用的近似与可训练部分 | 对比意义 |
|---|---|---|
| Performer | 每头 250 个固定正交随机特征;仅训练 LoRA | 固定随机特征近似 |
| SpectraFormer | OPRF–FastFoodL,65 个正特征;每层共享的三条 64 维可训练向量 | 少参数可学习结构投影 |
| DiJiang | DCT 投影、特征维 softmax;每头 64 个可学习正权重 | 固定投影配合可学习特征重加权 |
| TaylorShift | Q/K 单位范数归一化,固定 $1+s+\tfrac12s^2$;每头学习温度 | 统一二阶多项式近似 |
| Learned global | OAL 的 $G=1$ 正值核;同样输出校准与联合 LoRA | 最直接的全局/分组系数对照 |
| Softmax (LoRA) | 全部层保留 softmax,使用同一 LoRA 预算 | 转换后的质量差距参考 |
这些是共同预训练接口下的因果适配,保留原生 Q/K/V/O、RoPE 和 GQA。DiJiang 移除了原模型的 positional decay、GroupNorm 和输出门;TaylorShift 关闭额外的输出幅度归一化。因而表格比较的是这些适配版本。Hedgehog 等密集 MLP 特征映射未纳入,本文也没有与完整 LoLCATs 流程对比。(App. F.1,pp. 23–25)
3.4 性能实验:固定形状的注意力算子
硬件为 A100-SXM4-40GB,batch 1、14 个 query heads、2 个 KV heads、$d_h=d_v=64$、BF16 输入,$N=2^{10}$ 至 $2^{15}$。OAL 固定 $G=5$,与 $G=1$ 的 Learned Global 共用 HD block-GEMM 后端,128-token blocks、BF16 Tensor Core 收缩、FP32 工作系数。它不是逐层执行实际异构分组的完整转换模型。(App. E,p. 22)
Performer 与 SpectraFormer 的特征及前缀累积使用 FP64,DiJiang 使用 FP32,并显式复制 GQA 共享的 K/V;TaylorShift 未额外优化 kernel。跨方法的速度差同时受到精度和实现优化程度影响。计时关闭梯度、预热后 CUDA 同步,报告 forward 的平均延迟;显存是包含驻留输入、状态和 workspace 的峰值 PyTorch allocated tensor memory。
四:结果——精度改善成立,部署优势仍需补足
4.1 冻结注意力:四个误差指标均最低
| 方法 | 投影前 MSE ↓ | 投影前 RelMSE ↓ | 投影后 MSE ↓ | 投影后 RelMSE ↓ |
|---|---|---|---|---|
| Performer | 0.103 | 0.569 | 0.038 | 0.710 |
| SpectraFormer | 0.106 | 0.585 | 0.041 | 0.772 |
| DiJiang | 0.086 | 0.474 | 0.033 | 0.631 |
| TaylorShift | 0.088 | 0.490 | 0.034 | 0.649 |
| OAL | 0.078 | 0.432 | 0.031 | 0.595 |
原文 Table 2,p. 8。相对 DiJiang,投影前 RelMSE 降幅为 $(0.474-0.432)/0.474=8.86\%$;投影后为 $(0.631-0.595)/0.631=5.71\%$。摘要中的 8.9% 指前者,不能将它同时套到投影后。投影改变误差的方向与能量,两个 RelMSE 也使用不同归一化分母。
Table 2 没有列出 Learned global。隔离分组作用的直接证据来自 Fig. 2 的单头固定组数诊断,以及 Table 3 中校准和适配预算相同的 $G=1$ 对照。
4.2 Qwen:分组提高语言建模与下游任务质量
| 方法 | WikiText-103 PPL ↓ | PIQA ↑ | HellaSwag ↑ | ARC-E ↑ |
|---|---|---|---|---|
| Softmax (LoRA) | 10.89 | 70.18 | 51.38 | 62.63 |
| Performer | 37.03 | 57.78 | 30.37 | 38.93 |
| SpectraFormer | 34.78 | 59.19 | 31.77 | 41.84 |
| DiJiang | 36.05 | 59.90 | 31.47 | 41.41 |
| TaylorShift | 39.50 | 59.90 | 31.18 | 40.78 |
| Learned global | 31.71 | 61.15 | 32.43 | 41.41 |
| OAL | 27.50 | 64.69 | 37.20 | 50.38 |
原文 Table 3 左半部分,p. 10;任务准确率单位为 %。相对 Learned global,PPL 降低 4.21,约 13.28%;PIQA、HellaSwag、ARC-E 分别提高 3.54、4.77、8.97 个百分点。OAL 是受测转换方法中四项最优,但 softmax 参考的 PPL 为 10.89,保留预训练能力的差距仍很大。
4.3 Llama:效果方向一致,幅度取决于任务
| 方法 | WikiText-103 PPL ↓ | PIQA ↑ | HellaSwag ↑ | ARC-E ↑ |
|---|---|---|---|---|
| Softmax (LoRA) | 8.19 | 74.92 | 62.84 | 59.43 |
| Performer | 50.39 | 57.07 | 27.42 | 32.58 |
| SpectraFormer | 45.09 | 59.36 | 30.41 | 36.49 |
| DiJiang | 56.27 | 58.92 | 28.75 | 36.32 |
| TaylorShift | 62.67 | 57.40 | 28.95 | 35.77 |
| Learned global | 36.03 | 57.40 | 35.02 | 33.46 |
| OAL | 32.99 | 63.66 | 35.42 | 41.67 |
原文 Table 3 右半部分,p. 10。相对 Learned global,PPL 降低 3.04,约 8.44%;三项准确率分别提高 6.26、0.40、8.21 个百分点。HellaSwag 的改善明显小于另外两项。实验使用单一适配训练种子,因此这些应视为该共同预算下的点估计,尤其不宜过度解读 0.40 个百分点的差距。
4.4 分组与效率:额外系数开销小,二阶实现成本仍大
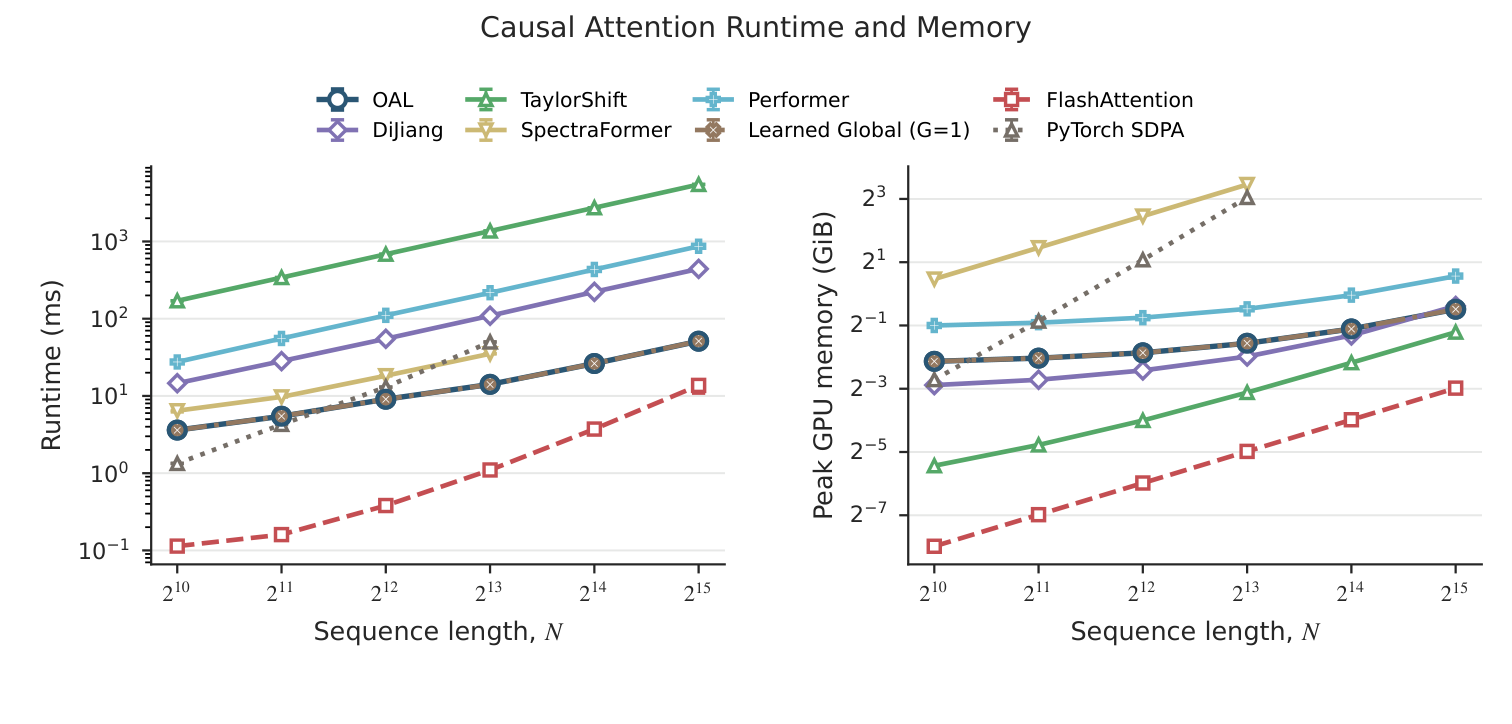
原文 Fig. 3,p. 9。横轴均为序列长度,左侧纵轴为毫秒延迟,右侧为 GiB 峰值 allocated memory,采用对数刻度。OAL 与 Learned Global 的曲线接近,支持在相同 HD 后端中从 1 组增至 5 组的额外算子开销较小;较长序列段的延迟呈近似线性增长。
**FlashAttention 在所有受测长度上都更快且更省显存。**它虽然计算完整 softmax,但内核优化和显存访问方式更成熟。SpectraFormer 与 math-backend SDPA 的曲线停在 8192,是预运行显存预算守卫跳过后续点,并非实际发生 OOM。不能将图上的截止点写成“运行到 16K 爆显存”。(Sec. 4.4,pp. 7–8;App. E,p. 22)
图中只测 forward 算子,不提供完整模型延迟或逐 token 自回归解码延迟。与此同时,模型质量实验保留 softmax 层,所以本文同时展示了线性算子的可行性与混合转换模型的精度,尚未给出全模型线性复杂度和端到端提速的联合结果。
五:结论——把有限的拟合自由度分配给高贡献结构
OAL 最有价值的设计是把预训练表示统计转换成参数共享规则:用坐标乘积的贡献而非单一向量幅值定义异质性;用少数组及跨组二次项表达它;直接匹配归一化输出;最后通过 HD 递推保持对指定核的精确求值。这样把“需要拟合什么”与“如何高效累积”联系起来,也提供了 $G=1$ 的明确受控参照。
从证据看,误差干预、固定组数诊断、两个主干上的转换结果共同支持非均匀系数共享。OAL 增加的组系数数量很少,但这一优势属于参数经济性;维度对状态、适配后的 softmax 质量差距,以及当前落后于 FlashAttention 的算子表现,决定了它现阶段更适合作为注意力转换的建模思路。
进一步研究最直接的三个问题是:在相同组数与参数预算下,贡献分组相对随机或均匀分组究竟提供多少收益;能否压缩 $H_2$ 状态并保留跨维度交互;当主干规模和上下文显著超出本文的 0.5B–1B、4K 质量评估设置时,固定分组与输出校准能否继续有效。前两者分别关系到分组准则的独立价值和工程可用性,后者关系到方法能否扩展到更实际的模型。