Understanding Mamba-3 Through Oscillatory Dynamics:中文精读笔记
作者:Shutian Liang、Yue Song(清华大学 College of AI)
论文版本:arXiv:2610.13341v1,2026-10-09 提交
获取与研读日期:2026-10-19;本次成品 r1
链接:arXiv · 原文 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
这篇论文研究 Mamba-3 中输入相关旋转的作用:循环记忆除了控制“保留多少”,为什么还需要控制“朝哪个方向演化”?作者把每个二维状态对的衰减—旋转转移写成欠阻尼(underdamped)二阶动力系统,并依次研究其状态追踪能力、长上下文语言建模收益,以及相位如何影响历史状态与新写入的叠加和读出。
核心结论有三层。数学上,固定单个时间区间内的系数后,非零旋转可以精确对应欠阻尼系统;实验上,输入相关的欠阻尼更新显著优于无旋转、静态旋转以及另外两种阻尼状态追踪模型;机制上,相位干预和隐藏状态测量支持这样的解释:旋转通过改变相对方向,调节信息累积,并维持写入与读出的坐标一致性。
语言建模收益需要按规模和实验类型理解。187M、444M 模型各用 100B tokens 从头训练,有旋转版本在 PG-19 上都获得更低困惑度;LongBench-E 平均分则分别从 9.76 变为 9.53、从 10.61 变为 13.22。对已经训练好的 1.5B 模型去掉旋转,会产生远大于这类训练差异的性能损害。因此,“模型已学会依赖相位”与“具有相位的架构更容易学到哪些能力”是两条需要分别阅读的证据链。(Sec. 3–5,PDF pp. 4–9。)
结构地图
| 原文章节 | 主要问题与作用 | PDF 页码、关键证据 |
|---|---|---|
| 1 Introduction | 从保留强度转向状态演化方向 | pp. 1–2;Fig. 1 |
| 2 Background;2.1 Selective State-Space Models;2.2 Damped Second-Order Dynamics | Mamba 转移形式与三种阻尼制度 | pp. 2–3;Eqs. (1)–(8),Table 1 |
| 3 An Oscillatory Interpretation of Mamba-3 | 衰减—旋转如何对应欠阻尼系统 | p. 4;Eqs. (9)–(17) |
| 4 Oscillation and State Tracking;4.1–4.3 | 同一二阶状态结构中的阻尼对照、模态几何、任务表现 | pp. 4–6;Eqs. (18)–(27),Table 2 |
| 5.1 Oscillation across Language Tasks | 事实关系预测与上下文预测对相位的依赖是否相同 | pp. 6–7;Fig. 2 |
| 5.2 Pretraining and Long-Context Evaluation | 从头训练后,旋转是否改善长度泛化 | pp. 7–8;Fig. 3,Tables 3–4 |
| 5.3 The Role of Phase in Long-context Language Modeling | 相位扰动、状态累积和写读一致性 | pp. 8–9;Fig. 4,Tables 5–7 |
| 6 Conclusion | 保留、组合和访问三个层面的解释 | p. 9 |
| A Extension to Linear Attention and Recurrent Models;A.1–A.7 | 将冻结转移的谱分析推广到六类循环结构 | pp. 15–20;Tables 8–9 |
| B Related Work | 振子模型、复数谱和状态追踪的研究背景 | pp. 20–21 |
| C Mathematical Derivations;C.1–C.4 | 矩阵指数、模态持续性、恒定写入累积、反射构造 | pp. 21–24 |
| D Implementation Details;D.1–D.5 | 训练、PG-19 计分、干预和状态统计的实际口径 | pp. 24–27;Tables 10–11 |
| E Additional Results;E.1–E.3 | 模计数相位编码、其他语料和训练过程 | pp. 27–29;Figs. 5–9 |
一:动机——循环记忆需要控制方向
标准状态空间模型(state-space model,SSM)把序列压缩到循环状态:
这里 $x_t,y_t\in\mathbb R^d$,$h_t\in\mathbb R^h$;$\bar A_t\in\mathbb R^{h\times h}$ 控制历史传播,$\bar B_t,C_t\in\mathbb R^{h\times d}$ 分别负责写入、读出。本文重点分析第一项,之后再通过实验把它与写入和读出联系起来。(Sec. 2.1,PDF pp. 2–3,Eqs. (1)–(5)。)
Mamba-1 使用逐坐标衰减;Mamba-2 在同一 head 内使用共享标量衰减 $\alpha_t I$。对于后一种更新,单看历史传播,旧状态只缩短而不转向。Mamba-3 给每个旋转状态对加入输入相关的 $\theta_t$:
$\rho_t$ 决定径向保留比例,$\theta_t$ 决定旋转方向与角度。它与常见固定位置计划的 RoPE 的区别在于,相位增量由输入决定。SISO 和 MIMO 共享这一转移结构,差异主要在写入和读出参数化;本文对它们分别做干预,而没有把二者混成一种模型。
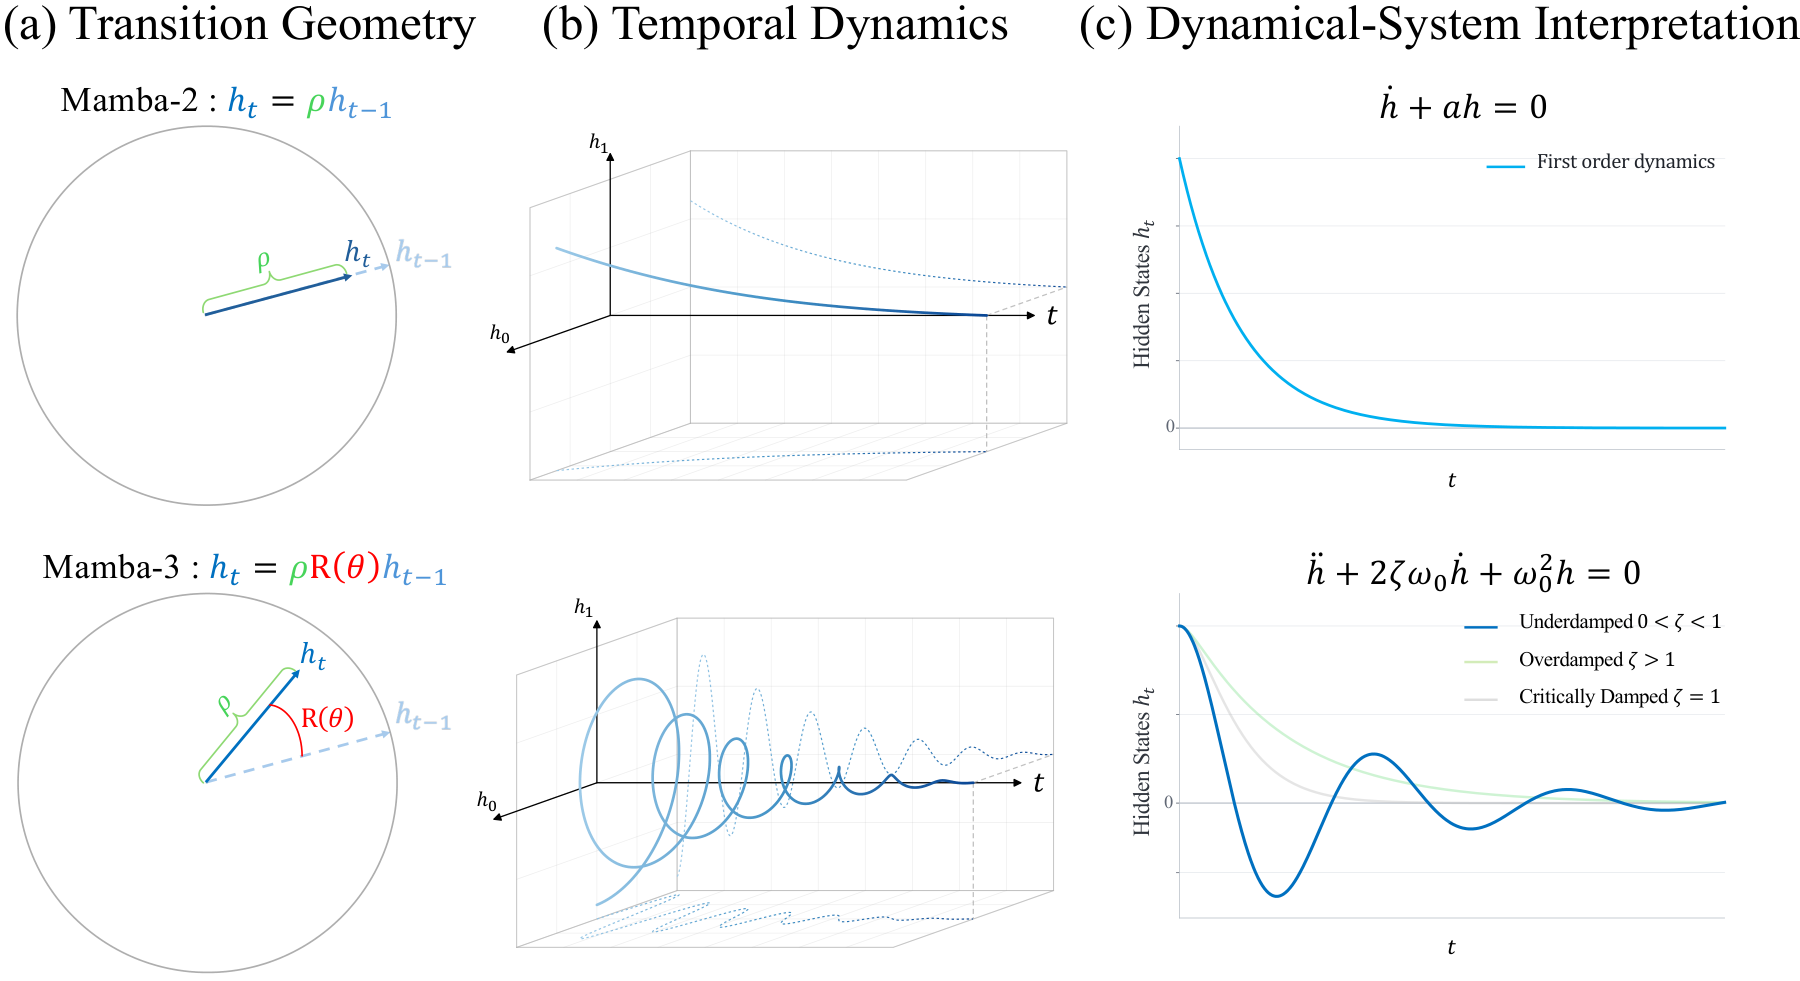
原文 Fig. 1,PDF p. 2。左列比较状态缩放和缩放后旋转;中列画固定系数、无输入情况下的轨迹;右列连接到一阶衰减和二阶阻尼响应。它说明的是转移几何,不是语言建模结果。论文真正要检验的是:这种方向变化能否支持循环计算,以及它是否比单纯增加两个坐标之间的耦合更有用。
二:方法与理论——把旋转写成欠阻尼系统
2.1 从离散更新到精确的区间内连续流
令二维状态对 $z_t=(H_t,P_t)^\top$ 的齐次更新为
在长度为 $\Delta_t>0$ 的区间内,定义
其中 $a_t$ 是衰减率,$\nu_t$ 是有符号角频率;若 $\Delta_t$ 以某种连续时间单位计,它们分别具有逆时间、弧度/时间单位。这里的连续时间是构造转移的参数化,不必等同于 token 的物理时间。
取生成元 $A_t^{\mathrm{rot}}=-a_tI+\nu_tJ$。由于 $J^2=-I$,矩阵指数的偶数项和奇数项分别成为余弦和正弦:
$I$ 与 $J$ 可交换,因此
这是一段区间内冻结系数时的精确实现,无需欧拉近似。论文在这一步分离掉加性输入,只解释齐次传播。(Sec. 3,PDF p. 4,Eqs. (9)–(13);App. C.1,PDF p. 21。)
2.2 为什么一定落在欠阻尼区域
略去区间下标,二维一阶方程为
对第一式求导,用第二式及 $\nu P=-\dot H-aH$ 消去 $P$,得到
与标准方程 $\ddot H+2\zeta\omega_0\dot H+\omega_0^2H=0$ 比较:
只要 $a>0$ 且 $\nu\ne0$,便有 $0<\zeta<1$:这是欠阻尼。$a$ 控制包络衰减,$|\nu|$ 控制振荡频率,$\operatorname{sign}(\nu)$ 控制旋转方向。辅助坐标可由 $P=-(\dot H+aH)/\nu$ 恢复,所以此时两种表述在区间内等价。(PDF p. 4,Eqs. (14)–(17)。)
一个影响消融理解的细节。 当 $\nu=0$,上述坐标恢复失效;原旋转坐标中的转移退化成 $e^{-a\Delta}I$。它与下面的临界阻尼二阶系统具有不同的 Jordan 结构。因此,“将旋转关闭”与“训练临界阻尼二阶变体”是两个不同对照。这个区分来自公式本身,不能仅凭“都不振荡”把二者合并。
2.3 保留二阶结构,改变阻尼制度
为了区分振荡的作用与双坐标耦合的作用,作者构造
对应受迫方程为
| 制度 | 参数约束 | 特征根与直觉 |
|---|---|---|
| 欠阻尼 | $\kappa_t=-\nu_t^2<0$ | $-a_t\pm i\nu_t$;一对等衰减的振荡模态 |
| 临界阻尼 | $\kappa_t=0$ | 重根 $-a_t$;含多项式因子的非振荡响应 |
| 过阻尼 | $0<\kappa_t| 两个不同负实根;慢、快模态 | |
三者均用 $\bar A_t(\kappa_t)=\exp(\Delta_tA_t(\kappa_t))$ 离散化,保持状态维度、输入/读出和输入更新规则相同。过阻尼实现取 $r_t=ca_t\tanh\nu_t$、$\kappa_t=r_t^2$,$0 论文进一步固定自然频率 $\omega_0>0$,改变 $a$,令 $\kappa=a^2-\omega_0^2$,研究无输入、固定系数系统的长期行为。 过阻尼。 令 $r=\sqrt{a^2-\omega_0^2}$,两根为 $-a\pm r$。快、慢模态的相对幅度按 $e^{-2rt}$ 趋于零。如果初态具有非零慢模态分量,方向最终由慢模态主导。它可以保留一个衰减很慢的方向,但两个方向的相对信息会失衡。 临界阻尼。 当 $a=\omega_0$,可写成 $A=-\omega_0I+N$,其中 $N^2=0$ 且 $N\ne0$: 指数衰减率是 $\omega_0$;去掉共同衰减及多项式因子后,传播算子趋向秩一。 欠阻尼。 两根为 $-a\pm i\nu$,两种模态幅度相同。在旋转坐标中 长度统一缩放,夹角保持,不产生逐步增强的方向偏置。这并不意味着幅度不衰减;保留的是相对二维几何。若回到一般二阶坐标,角度保持应理解为经固定可逆坐标变换后的性质。 在固定 $\omega_0$ 的比较下,欠阻尼的衰减率 $a<\omega_0$;过阻尼的主导衰减率为 所以临界阻尼具有最快的渐近指数衰减,欠阻尼的特点则是保留两个同速衰减的方向。这个定理采用固定自然频率;前述实验是在统一结构中约束不同谱族,不能自动说成所有学习到的模型都匹配了同一个 $\omega_0$。(Sec. 4.2,PDF p. 5,Eqs. (22)–(27);App. C.2,PDF pp. 22–23。) Parity、Mod 3 和无括号算术需要随着输入持续更新内部状态。前两项使用一层模型,算术使用三层;$d_{\mathrm{model}}=d_{\mathrm{state}}=64$,batch size 256,AdamW,共训练 10,000 步。训练长度下限为 3,上限从 40 线性增长到 160;Parity/Mod 3 用前 6,000 步增长,算术用全部训练过程增长。学习率在 $10^{-4}$ 到 $10^{-2}$ 间对数取八档,用最佳验证准确率选择配置,最终报告长度 224 上的结果。 对照包括三种二阶阻尼制度,以及 Mamba-2、无旋转 Mamba-3、静态旋转 Mamba-3。原表指标名是 Scaled Accuracy (%),越高越好;v1 正文及附录没有展开缩放公式,因此下文保留这一名称,不将其改称原始样本准确率。(App. D.1,PDF p. 24;Table 2,PDF p. 6。) 预训练采用 Llama-3.1 tokenizer,训练上下文 2048 tokens。187M 为 12 层、$d_{\mathrm{model}}=768$;444M 为 24 层、$d_{\mathrm{model}}=1024$。两者 $d_{\mathrm{state}}=128$,head dimension 64,MIMO rank 4,chunk size 16,全局 batch size 256。峰值学习率分别为 $3\times10^{-3}$、$1.5\times10^{-3}$,余弦退火至 $10^{-5}$;AdamW 的 $\beta_1,\beta_2=(0.9,0.95)$、weight decay 0.1、gradient clip 1.0;BF16 计算,参数和优化器状态保留 FP32。(App. D.3,PDF pp. 24–25,Table 10。) 论文取 $C\in\{1,2,4,8,16,32,64\}\times10^3$ tokens,对长度 $L>C$ 的书籍按步长 $\max(10,\lfloor(L-C)/10\rfloor)$ 抽取窗口。每个窗口开始时清零状态,只给最后 100 tokens 计分: 这考察经过较长前缀后预测末尾 token 的能力。相同 $C$ 下,干预与 native 使用相同书籍、窗口和计分位置;不同 $C$ 下,满足长度要求的书籍集合以及位置可能改变。因此应优先比较同一横坐标上的模型差异,不能把整条曲线的升降全部归因于“同一个样本增加了上下文”。这里 PG-19 的 2K 是 2000 tokens,训练设定则是 2048;图中用 2K 简记训练长度。(App. D.3–D.4,PDF pp. 24–26。) 其他四个语料的测试采用另一口径:将文档用 EOS 连接,分成 4096-token 序列,每段起点重置状态,在四个连续 1024-token 位置区间分别汇总 PPL。图上的 1K–4K 是这些位置段,不是每次重新初始化的独立上下文窗口。 原文 Table 2,PDF p. 6;Scaled Accuracy (%) ↑,测试长度 224。 欠阻尼在模计数任务上的优势非常明显;算术得分相对过阻尼高 14.08 个缩放分数点。静态旋转的失败则说明,单有转圈的能力还不够,模型需要根据当前符号决定是否转、转多少。 原文 Fig. 5,PDF p. 27。左图是一个选定的 Parity 状态对:输入 0、1 对应约 $0.50^\circ$、$179.51^\circ$;右图的 Mod 3 状态对对应 $0.21^\circ$、$119.78^\circ$。它们接近理想规则:输入 0 不转,输入 1 转 $360^\circ/m$。图中展示的是选定状态对,并非所有通道都遵循同一编码。 教学上可把 Parity 看成两状态圆环:读到 1 时转半圈,读到 0 时保持位置。恒定角度更新会在 0 上也推进相位,因此无法直接实现这个条件计数规则。附录的相位几何把表中的统计优势连接到了具体计算过程。(App. E.1,PDF p. 27。) 原文 Fig. 2,PDF p. 6。横轴是窗口起始层,纵轴是窗口宽度;上、下两行分别为 SISO、MIMO,左右为事实关系和 LAMBADA。色条表示准确率变化,蓝色下降,红色上升;范围是 −45 到 +3 个百分点,正负颜色幅度并不对称。 事实关系预测通常变化较小,一些中间层窗口甚至略有改善;LAMBADA 则在大量窗口下明显下降,干预层数增加通常更严重。这支持“相位与利用当前上下文密切相关”的解释。该实验本身是在既有模型上破坏组件,下一组从头训练实验才检验带旋转架构最终能学到什么。(Sec. 5.1,PDF pp. 6–7。) 原文 Fig. 3,PDF p. 7。横轴为上下文窗口长度,纵轴为 PPL,越低越好;蓝线无旋转、橙线有旋转,虚线为约 2K 的训练长度。上图 187M,下图 444M。两种规模中橙线均更低,444M 在 16K–64K 的差距较明显。原图没有列出逐点精确数值,宜用曲线解释趋势。 两个无旋转模型在长上下文上也保持稳定,并没有出现预训练后移除旋转那样的崩溃。旋转带来了额外收益,但这组结果同时说明,稳定长度外推并不以旋转为必要条件。 原文 Table 3,PDF p. 7。这里是 13 个任务的平均得分,不是单一分类准确率。444M 的提高约为 24.6% 相对增幅,但用 +2.61 分 更直接。 444M 的收益也不均匀: 差值由原文 Table 3 相减得到;全称见 Table 11,PDF p. 27。平均改善主要来自 few-shot 和代码任务,合成计数和检索反而下降。因此不能把模计数小任务的优势直接等同于所有长文本计数/检索能力提升。 标准语言建模结果如下: 原文 Table 4,PDF p. 8。平均列汇总 LAMBADA、HellaSwag、PIQA、ARC-Easy、ARC-Challenge、WinoGrande、OpenBookQA;其中 HellaSwag 和 ARC-Challenge 用原表的 原文 Fig. 4,PDF p. 8。纵轴是累计相位的 cos/sin 分量,横轴是距序列末尾的 token 偏移;上下分别为 SISO/MIMO,三列展示慢、中、快三种轨迹,各列时间尺度不同。作者从至少完成一圈的通道中,按 phase travel 选约第 10、50、99 百分位的代表,因此这是选取的轨迹示例,不是全通道周期分布。(App. D.4,PDF p. 25。) 相位干预均作用于全部层、head 和整个评测窗口: 以下为 PPL;括号内是该长度相对 native 的倍率: 原文 Table 5,PDF p. 8。SISO 对反向最敏感,且置零/反向的损害随长度急剧增加;MIMO 对置零最敏感,相位重排/反向的倍率随长度变化较小。SISO 在 2K 时相位重排的损害小于衰减重排,到 64K 时反而更大;MIMO 的三种相位干预均比这里采用的衰减重排更具破坏性。结果说明 learned phase 的具体结构参与预测,不能只用“有无某个复数参数”概括其作用。(Sec. 5.3,PDF pp. 8–9;App. D.4,PDF pp. 25–26。) 在实现使用的状态坐标中,作者写作 并测量 此处 $P_t$ 表示传播下来的矩阵状态,与 Sec. 3 二维状态对里的标量辅助坐标 $P$ 不同。虽然式中只显式出现标量衰减,旋转的作用已进入该实现的相位坐标及写入/读出;它与前面的旋转状态表述不能逐符号混读。 可以用以下恒等式理解余弦的意义: 在另外两项给定时,越正向对齐,交叉项越大,越容易产生相长累积。这个恒等式是本次讲解补充,原文实验报告的是余弦和 RMS。 原文 Table 6,PDF p. 9。用至少 64K tokens 的 validation 书籍,从零状态连续运行前 64,000 tokens,16K/64K 测量来自同一条不中断轨迹。两项统计均排除前 2000 tokens:余弦先按时间平均,再对 $24\times64$ 层—head 对取中位数,最后等权平均书籍;RMS 则先平均平方 Frobenius 范数,对层—head 取中位数,再开方并平均书籍。范数包含全部状态坐标,没有按状态维度归一化,因此更适合比较同一模型的干预前后。(App. D.4,PDF p. 26。) 相位置零后,对齐和状态幅度都增大,支持作者关于旋转调节累积的解释。这里还不能将 PPL 损害全归于范数,因为相位干预也改变了编码及写读关系;论文下一组实验正好显示后者的重要性。 附录 C.3 对固定 $0\le\rho<1$、固定相位和恒定写入 $u$ 分析 几何级数给出 把分母展开,更容易看出方向的作用: 没有旋转时,稳态增益为 $1/(1-\rho)$,$\rho$ 接近 1 时可能很大。若 $\theta\not\equiv0\pmod{2\pi}$,第二项增加,使恒定写入的稳态累积降低,而每一步的径向保留比例仍然是 $\rho$。 教学例子,非论文实验值:取 $\rho=0.99$、$\|u\|=1$。$\theta=0$ 时稳态范数为 100;$\theta=\pi/2$ 时为 $1/\sqrt{1+0.99^2}\approx0.711$。同样的保留系数,反复写入方向是否对齐会产生极大差别。这个例子采用恒定驱动和固定系数,不是输入相关 Mamba-3 全网络的统一范数上界。(App. C.3,PDF p. 23,Eqs. (115)–(120);分母展开和数值例子为本次补充。) 这里仅在 64K 窗口的最后 100 tokens 干预;此前历史由原模型处理并保留。Remove $B$/$C$ 指去掉相应向量上的旋转,保留向量本身,而非停止写入/读出。 原文 Table 7,PDF p. 9;App. D.4,PDF p. 26。 单侧去掉旋转会严重破坏预测,两侧同时去掉反而部分恢复。这支持“写入编码与读出坐标必须兼容”。联合干预仍差于 native,作者认为可能还因为已有历史状态是按原相位积累的。联合去除 $B,C$ 的旋转与重新编码全部既有历史不是同一操作。 原文 Fig. 6,PDF p. 28。列分别为 CodeParrot、MATH-Hard、TriviaQA、SlimPajama;上/下行为 187M/444M。横轴表示四个连续 1024-token 位置段;前两段在训练长度内,后两段在训练长度外。187M 的旋转模型在 MATH-Hard 上更差,在另外三个数据集更好;444M 在四个数据集的各位置段都更好,CodeParrot、TriviaQA 的差异较清楚,SlimPajama 很小。(App. E.2,PDF pp. 27–28。) 原文 Fig. 7,PDF p. 28。横轴训练步数,纵轴验证 PPL;插图放大最后 20,000 步。两种规模在训练末期都有旋转版本较低,差距并非仅由某次长文本干预产生。 原文 Figs. 8–9,PDF p. 29。各面板对应 2K、8K、16K、32K、64K 评测窗口,横轴是训练步数。训练结束时有旋转版本在各显示长度上 PPL 较低;444M 在长上下文中的分离更明显。这些曲线支持长度和规模相关的收益变化。(App. E.3,PDF pp. 28–29。) 这篇工作的主要产出是机制解释和受控实验证据。衰减控制信息留下多少,相位控制历史贡献如何相互组合、如何与当前写入叠加,以及读出如何访问这些表示。二阶解释提供了比较不同谱族的统一框架;状态追踪、从头预训练和相位干预分别支持不同环节。 最有信息量的证据组合是:双坐标耦合相同的任务对照中,欠阻尼获胜;在小型语言模型从头训练时,旋转改善长上下文困惑度;在官方大模型里,破坏 learned phase 会使性能下降,同时增大历史—更新对齐,写读联合干预又部分修复性能。把这些结果放在一起,可以提出“相位同时参与动态计算、累积控制和坐标匹配”的解释。 令循环矩阵状态 $S_t\in\mathbb R^{d_k\times d_v}$, 冻结单一区间的系数,忽略 $U_t$,便可逐列研究 $T_t$。设单位范数 key 为 $k$,$\Pi=kk^\top$、$H=I-\beta\Pi$、$D=\operatorname{Diag}(\boldsymbol\alpha)$。这里的 $H$ 是转移矩阵,与主文标量 $H$ 无关。 原文 App. A,PDF pp. 15–20,Table 8。上述结论是区间内冻结转移的分类;随着输入改变,key 和模态基也可能改变。 DeltaNet 与 Gated DeltaNet。 取 $b=-\log(1-\beta)/\Delta$,DeltaNet 的生成元为 $-b\Pi$,其 key 方向速率为 $b$,其余方向速率为 0。对某个正交方向与 key 方向组成的平面,可写成 $\ddot u+b\dot u=0$。Gated DeltaNet 再引入 $\gamma=-\log\alpha/\Delta$,得到 这些二维表示都共享同一个 key 模态,不能把它们数成许多独立的二阶存储单元。(App. A.3–A.4,PDF pp. 16–18。) KDA。 虽然 $HD$ 通常不对称,但 为正定对称矩阵,且其谱小于 1。故可以选实模态基,令 $b_i=-\log\lambda_i/\Delta$。两个不同速率的模态满足 这里可以选择不重叠的模态对。相同速率的退化情形不满足上述“两个不同模态速率”的消元条件,不能直接据 $\zeta=1$ 把它当成非平凡临界 Jordan 块。(App. A.5,PDF pp. 18–19。) Complex KDA。 作者用 $\beta=2$ 的 Householder 反射,配合带负号的对角门构造 其判别式为 当 $|\cos\theta|<2\sqrt{-\alpha}/(1-\alpha)$ 时,特征值为模长 $\rho=\sqrt{-\alpha}<1$ 的复共轭对,可在实模态坐标中写成衰减—旋转,再获得欠阻尼实现。负门打开了这类谱结构的可能,但并非任意负门与角度组合都会产生复根。(App. A.6,PDF p. 19;App. C.4,PDF pp. 23–24。) Momentum DeltaNet。 其 key 方向的状态—动量块为 当 $\tau^2<4\alpha\mu$ 且 $0<\alpha,\mu<1$ 时,其特征值构成模长 $\sqrt{\alpha\mu}$ 的复共轭对,也能实现欠阻尼动力学。这些分析给出的是可产生振荡的条件;如何稳定地学习和控制有用的欠阻尼模态,作者仍列为后续方向。(App. A.7,PDF p. 20。) 首先,理论中的“精确”指冻结单个区间系数的齐次流。跨 token 的输入相关系数、输入注入和层间非线性需要另外处理;固定系数系统的渐近几何不能原样当成整个语言模型的长期轨迹定理。 其次,最严重的 PPL 恶化来自对官方 1.5B 已训练模型进行干预;从头预训练的无旋转模型依然稳定。因而不能据此把旋转宣称为稳定外推的必要条件。要进一步建立“抑制累积导致 PPL 改善”的因果机制,可以在保留相位编码的同时单独控制范数,或在移除相位后只修复累积过程,观察预测能否恢复——这是本次阅读提出的后续实验。 最后,预训练证据覆盖 187M 和 444M 两个规模,原表没有给多随机种子的误差范围。444M 的 +2.61 分平均收益和部分任务的回退都应保留;187M 的小幅平均差异不宜被叙述为稳定胜负。未来最值得检验的是,输入相关相位何时主要服务于模态计算,何时主要服务于写入干扰控制,以及这两者是否需要不同的训练或约束设计。2.4 模态持续性:保存幅度与保存几何不是一回事
三:实验——先区分比较对象和计分方式
3.1 状态追踪:训练短序列,在更长序列上测试
3.2 语言实验分为“从头训练”和“预训练后干预”
实验组 模型与数据 对照改变什么 主要输出 语言任务敏感性 官方 1.5B SISO/MIMO;Relations、LAMBADA 在连续层窗口内将相位置零;扫描起点和宽度 相对原模型的准确率变化,单位为百分点 从头预训练 187M/444M MIMO;每个模型 FineWeb-Edu 100B tokens 旋转通道比例 0 与默认 0.5 验证 PPL、PG-19、LongBench-E、标准任务 相位结构干预 官方 1.5B SISO/MIMO;PG-19 置零、反向、重排相位,另设衰减重排 PPL 与相对 native 的倍率 隐藏状态诊断 同一官方模型;PG-19 validation 长书 原相位与移除相位 历史—更新余弦、RMS 状态范数 写读一致性 64K PG-19 窗口 只在最后 100 token 去掉 $B$、$C$ 或两者的旋转 末尾 100 token 的 PPL 3.3 PG-19 的“64K”具体测量什么
四:结果与机制分析
4.1 状态追踪需要输入相关的旋转
模型 / 制度 Parity Mod 3 无括号算术 Mamba-2 3.91 0.04 36.76 Mamba-3,无旋转 3.03 0.78 48.95 Mamba-3,静态旋转 4.05 0.85 25.49 过阻尼 3.27 0.58 81.60 临界阻尼 3.22 0.32 1.97 欠阻尼(Mamba-3) 100.00 95.26 95.68 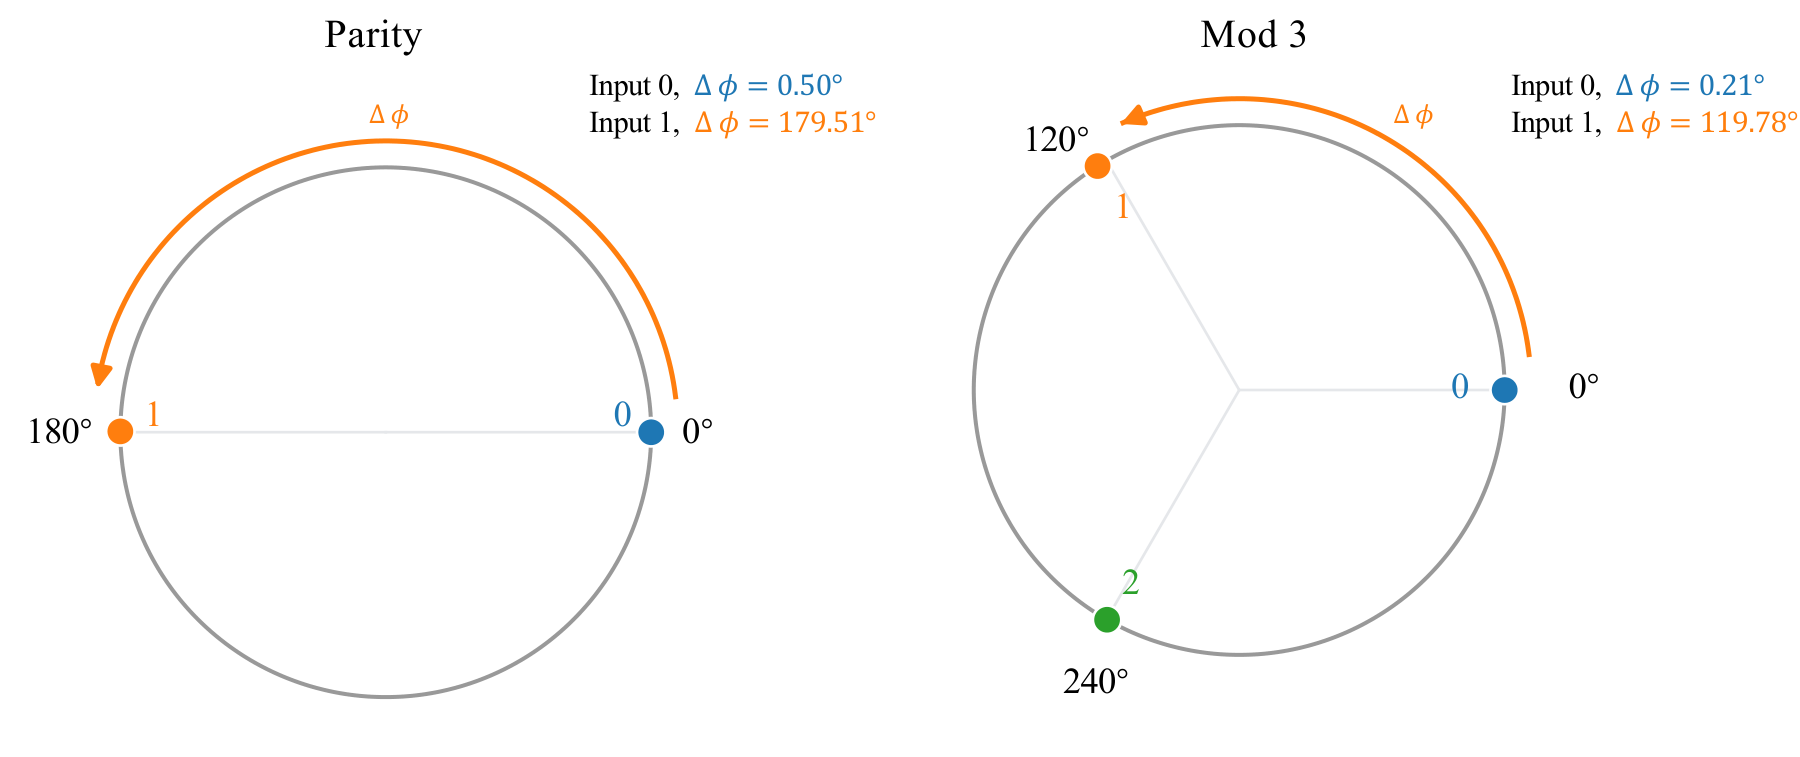
4.2 事实关系与上下文预测对相位的依赖不同
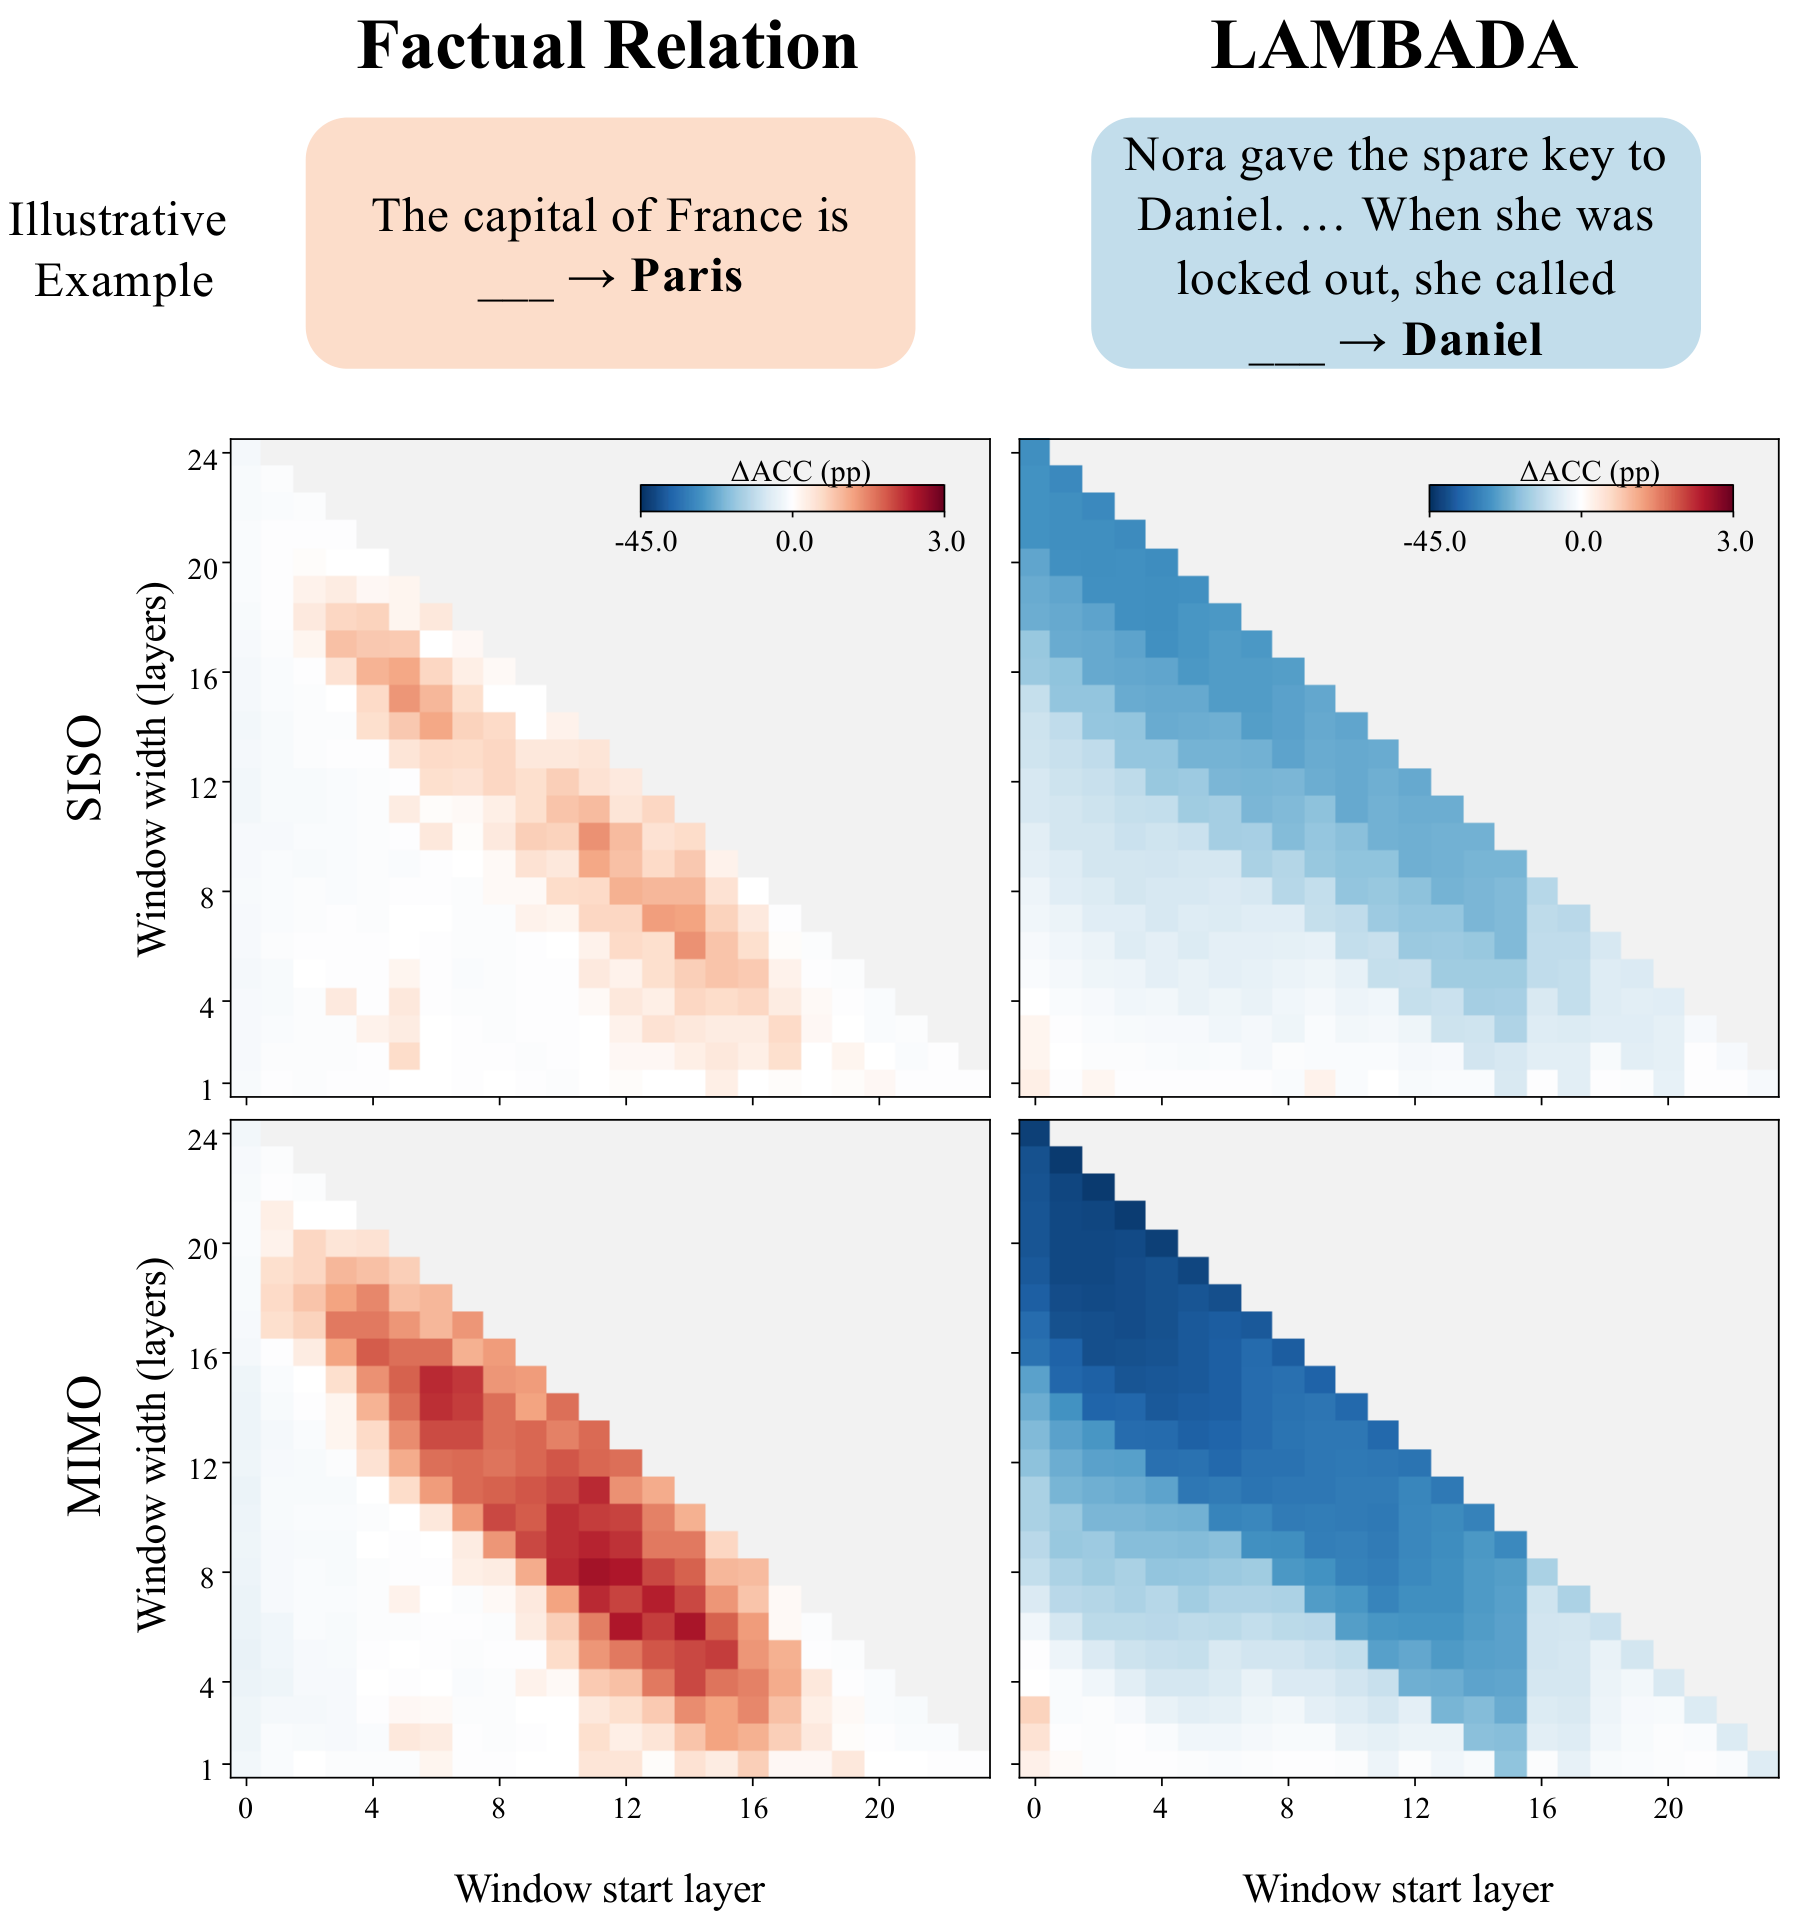
4.3 从头训练:困惑度收益在两个规模上都有,下游收益有规模差异
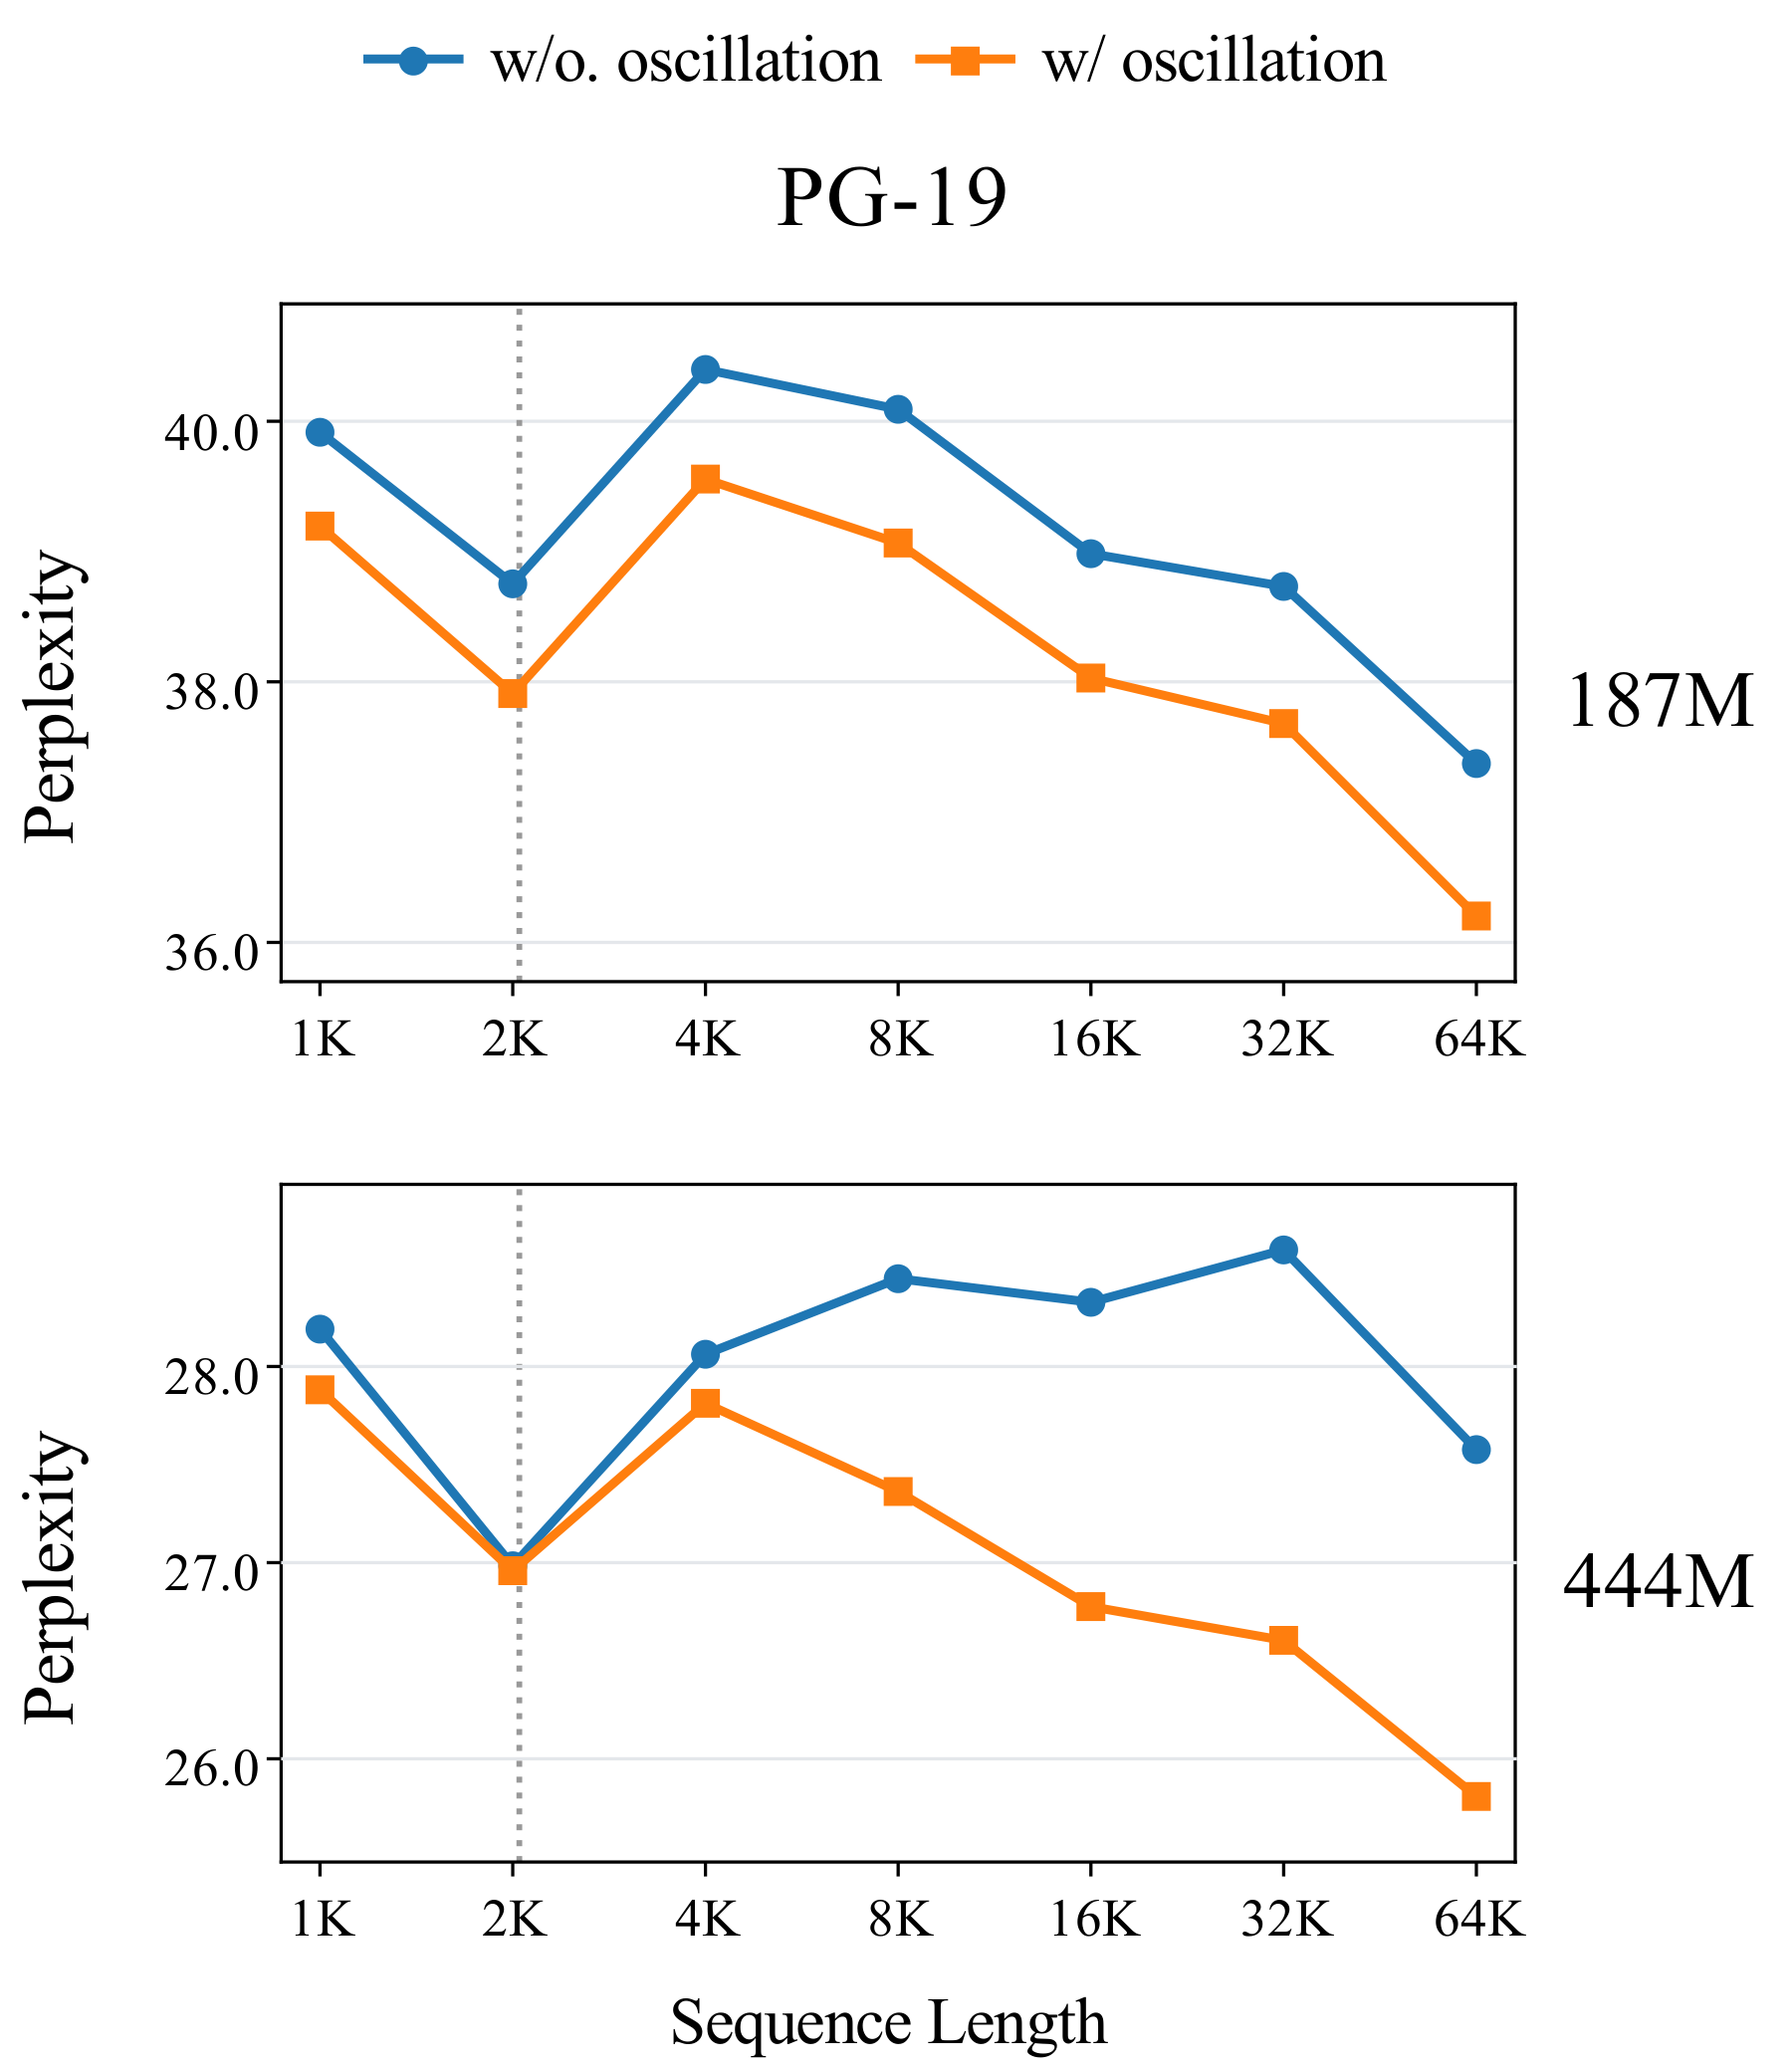
模型规模 无旋转 LongBench-E 平均分 有旋转平均分 差值(分) 187M 9.76 9.53 −0.23 444M 10.61 13.22 +2.61 LongBench-E 任务 无旋转 有旋转 差值(分) Passage Count 5.96 3.57 −2.39 PassageRetrieval-en 7.19 5.95 −1.24 GovReport 8.37 8.50 +0.13 MultiNews 10.52 10.23 −0.29 MultiFieldQA-en 10.71 11.38 +0.67 Qasper 5.28 5.06 −0.22 2WikiMQA 7.29 8.79 +1.50 HotpotQA 5.13 5.95 +0.82 SAMSum 10.36 19.61 +9.25 TREC 11.00 18.33 +7.33 TriviaQA 19.29 21.56 +2.27 Long Code Completion 19.58 28.58 +9.00 RepoBench-P 17.19 24.31 +7.12 规模 / 配置 FineWeb-Edu PPL ↓ LAMBADA PPL ↓ LAMBADA acc (%) ↑ 七项平均 acc (%) ↑ 187M,无旋转 16.32 38.04 31.73 43.63 187M,有旋转 16.18 32.97 33.59 43.43 444M,无旋转 12.68 18.38 41.01 50.18 444M,有旋转 12.60 17.19 42.83 51.08 acc_n 归一化准确率,其余用 acc。187M 平均分基本相当,444M 增加 0.90 个百分点;困惑度下降与任务准确率提高并不一一对应。4.4 相位结构干预:角度的数值、符号和通道归属都重要
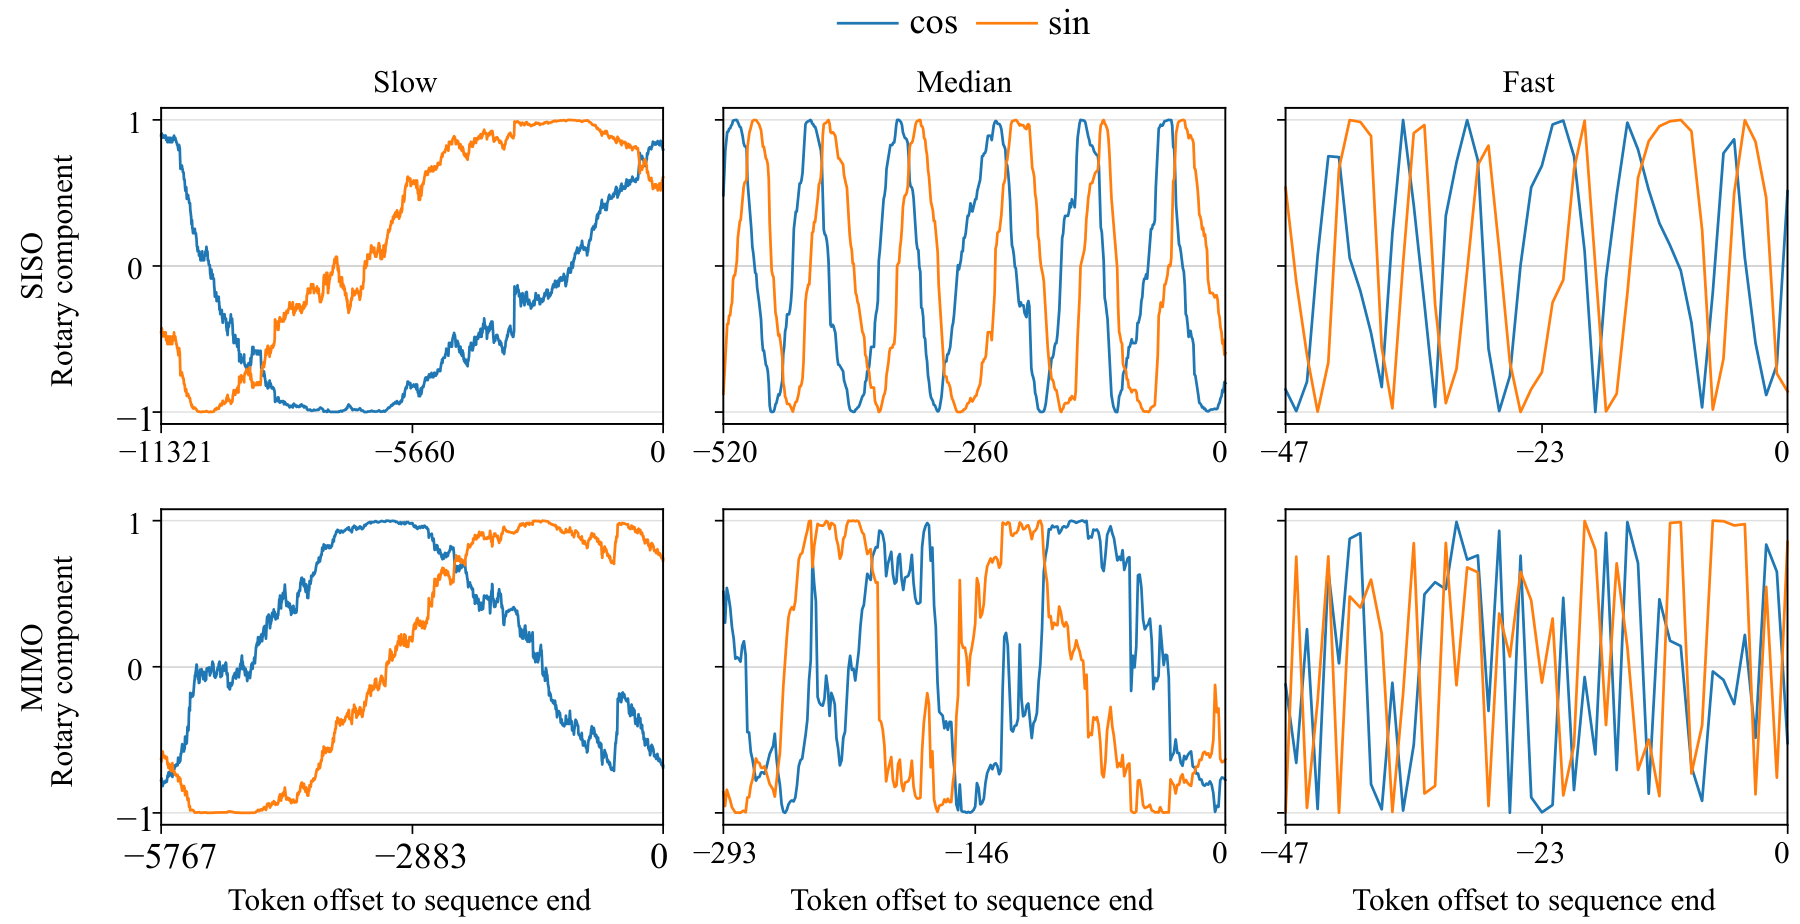
模型 / 干预 2K 16K 64K SISO native 21.09 21.41 20.60 SISO 衰减重排 114.52(5.43×) 126.51(5.91×) 125.27(6.08×) SISO 相位重排 50.24(2.38×) 96.05(4.49×) 149.37(7.25×) SISO 相位置零 67.99(3.22×) 285.66(13.34×) 851.49(41.33×) SISO 相位反向 152.27(7.22×) 597.91(27.93×) 1526.52(74.10×) MIMO native 21.12 21.47 20.52 MIMO 衰减重排 25.87(1.22×) 25.94(1.21×) 24.89(1.21×) MIMO 相位重排 64.43(3.05×) 70.44(3.28×) 65.72(3.20×) MIMO 相位置零 197.17(9.34×) 320.40(14.92×) 309.36(15.08×) MIMO 相位反向 74.34(3.52×) 78.76(3.67×) 73.89(3.60×) 4.5 状态累积:旋转改变历史与新输入的夹角
模型 / 长度 余弦 native → 移除相位 RMS 范数 native → 移除相位 SISO,16K 0.293 → 0.429 7.635 → 8.899 SISO,64K 0.294 → 0.474 7.621 → 9.437 MIMO,16K 0.241 → 0.488 10.073 → 12.022 MIMO,64K 0.242 → 0.499 10.078 → 12.047 4.6 一个可算清楚的累积模型
4.7 写入与读出必须共享兼容的相位坐标
末尾干预 SISO PPL MIMO PPL Native 20.60 20.52 去掉 $B$ 的旋转 186.28(9.04×) 100.41(4.89×) 去掉 $C$ 的旋转 250.90(12.18×) 117.68(5.74×) 两侧同时去掉旋转 42.79(2.08×) 59.46(2.90×) 4.8 附加实验:收益随数据集和训练阶段变化
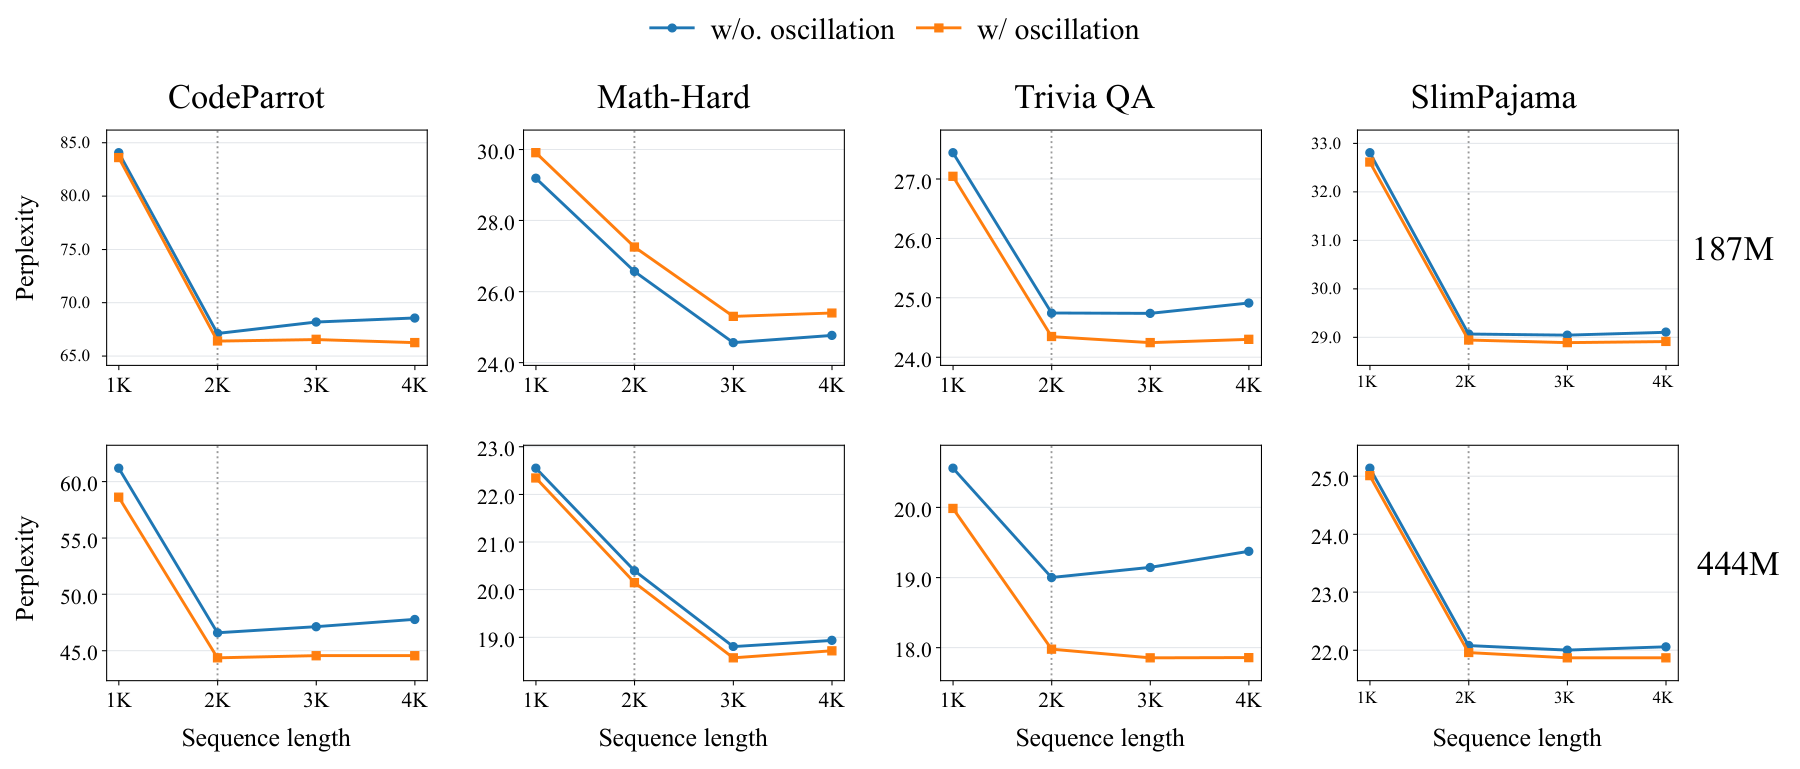
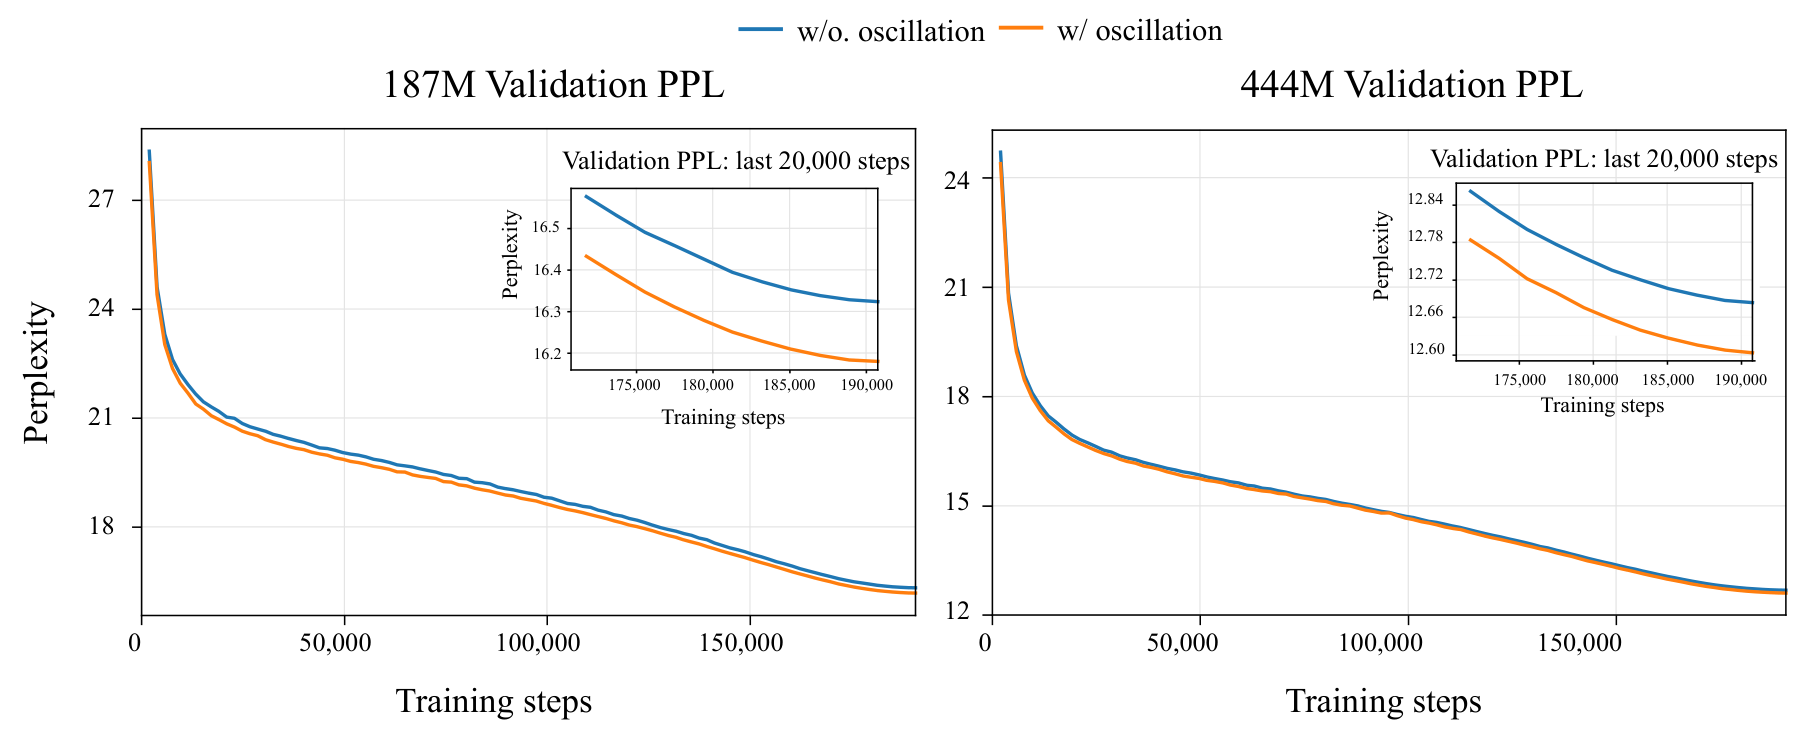
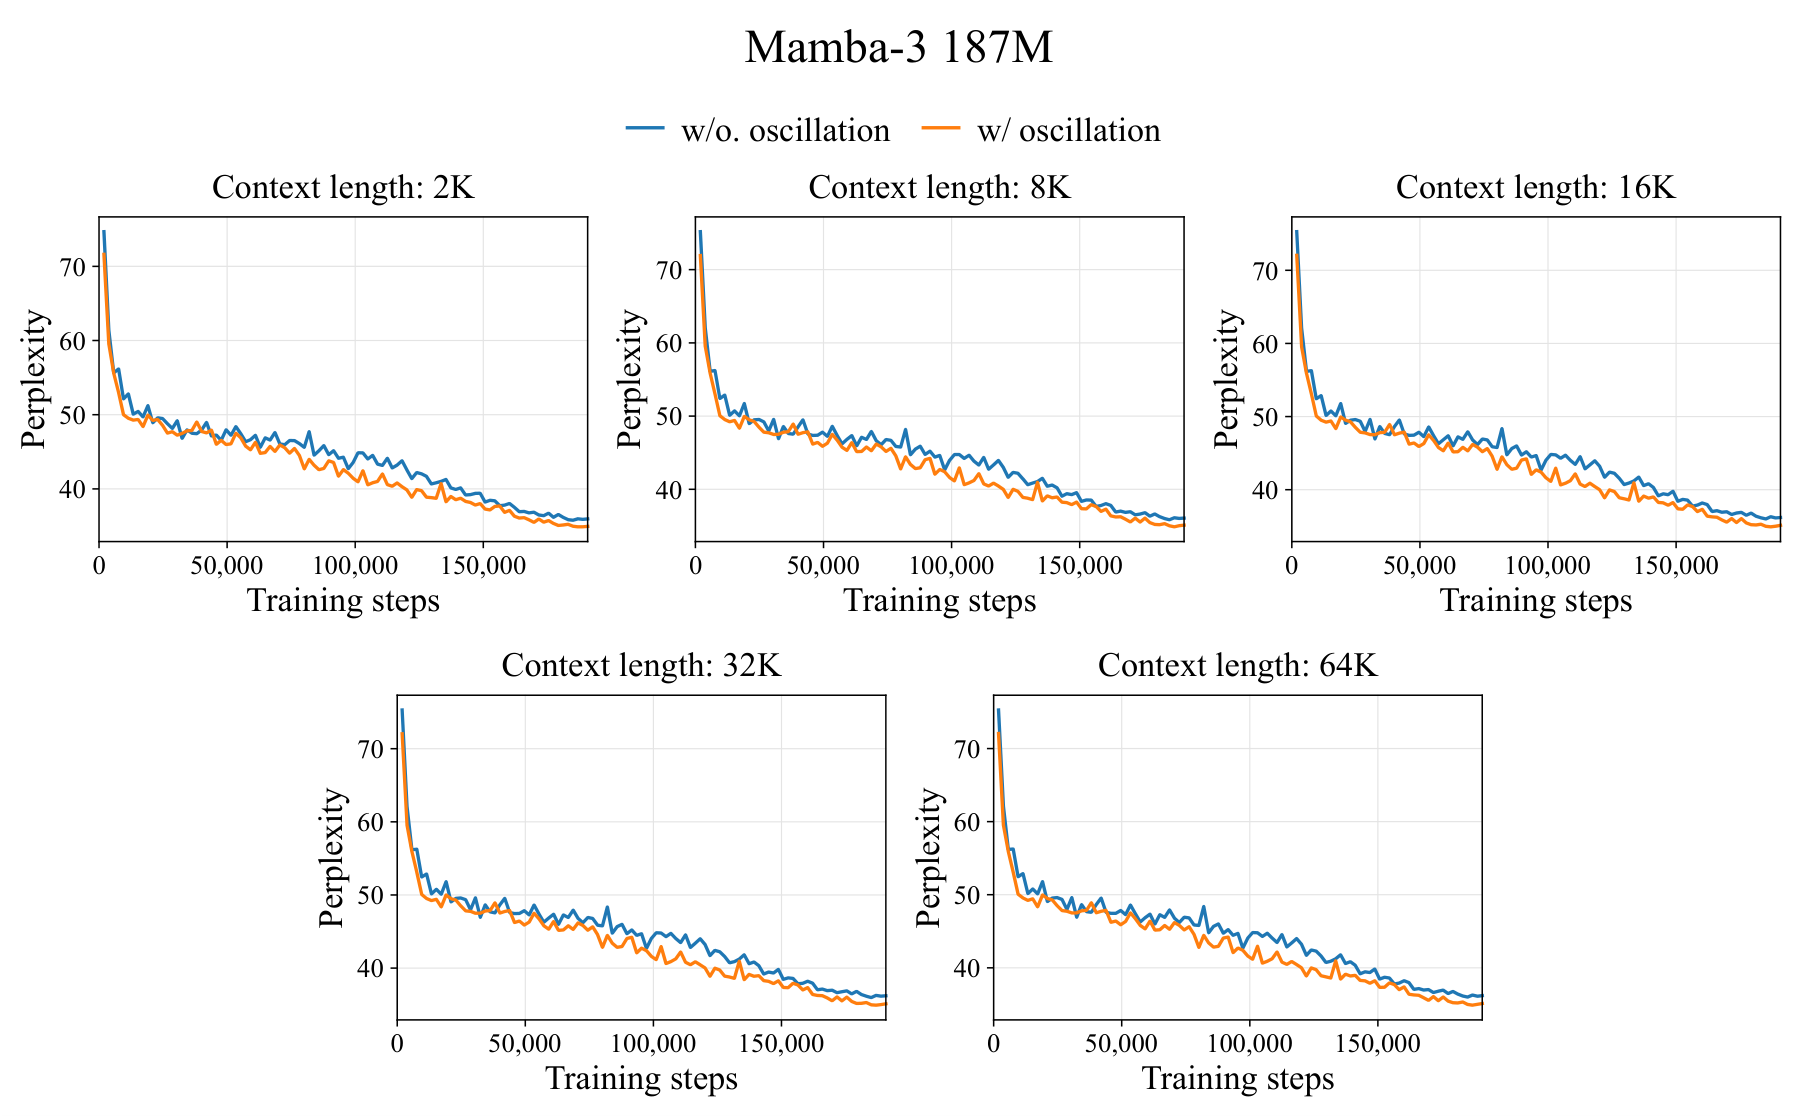
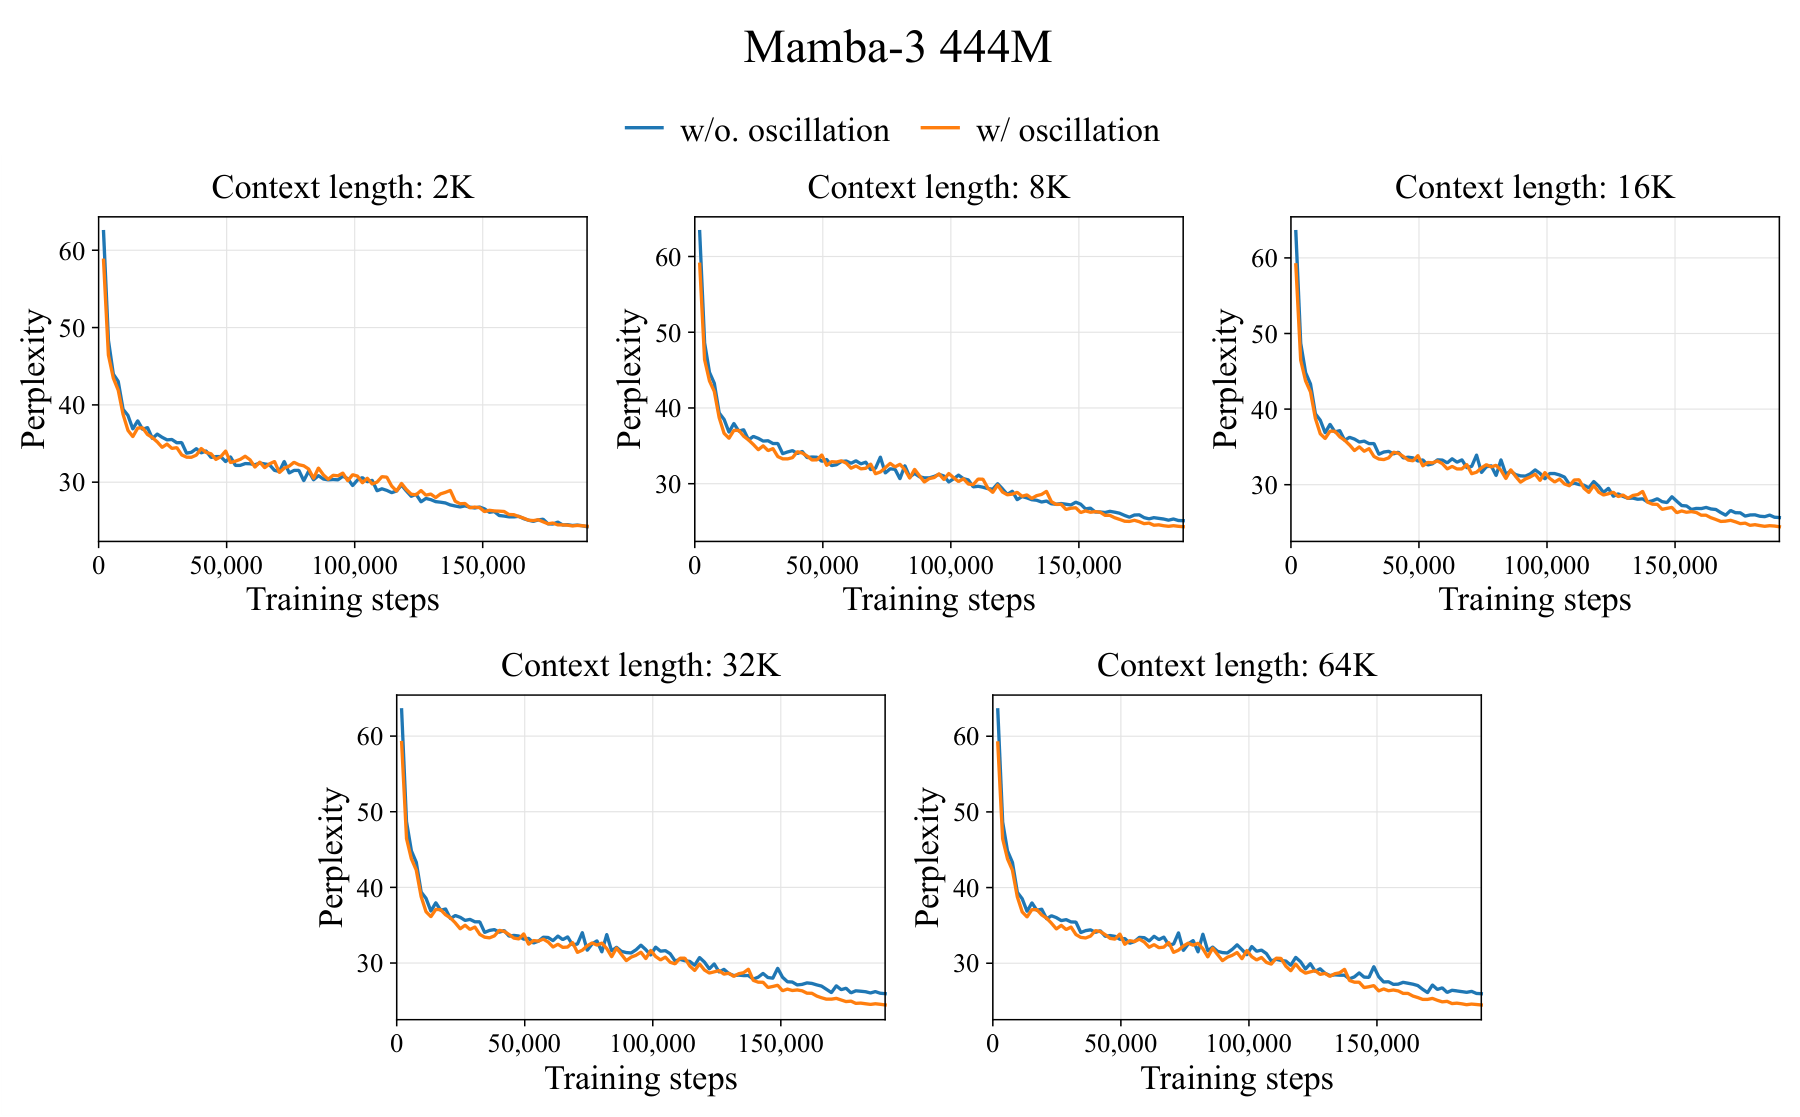
五:结论、架构联系与研究启发
5.1 论文贡献的合理位置
5.2 附录 A:从 Mamba 到线性注意力的谱视角
模型 冻结齐次转移 在论文给定约束下的结构 Linear Attention $I$ 原状态保持;全更新为加性积累 DeltaNet $H$,$0<\beta<1$ key 方向衰减,正交方向保持 Gated DeltaNet $\alpha H$,$0<\alpha<1$ 两种正实衰减率 KDA $HD$,$0<\alpha_i<1$,$0<\beta<1$ 实特征值均位于 $(0,1)$,冻结模态非振荡衰减 Complex KDA $HD$,允许带符号门和更大 $\beta$ 满足条件时出现复共轭模态 Momentum DeltaNet 对 $(S,M)$ 的块转移 动量和状态耦合满足条件时出现振荡模态 5.3 哪些边界会改变结论的理解