One Model to Loop Them All:Elastic Latent Recurrence 中文精读
作者:Faisal Ladhak、Shantanu Acharya、Santiago Akle Serano、Simeng Sun、Boris Ginsburg、Krishna C Puvvada;前两位共同一作。
版本:arXiv:2610.12582v1,2026-10-08 提交;本次研读与获取日期:2026-10-15。
原文:arXiv · 本地 PDF · 英文汇报 PDF · 可编辑 Beamer。以下页码均指从 1 开始的原文 PDF 页码。
论文总览
弹性潜在循环(Elastic Latent Recurrence,ELR)研究一个很实际的问题:能否用一个 checkpoint 同时提供低延迟和高质量档位,而且低延迟档不必先牺牲原本的能力? 模型把中间一段网络重复执行,循环次数 $k$ 控制每个输出 token 的计算量。论文的关键是让 $k=1$ 保持接近同规模非循环模型的表现,再让 $k>1$ 带来额外收益。
方法的三个组成部分各有分工:自适应差分更新决定每轮隐藏状态改变多少;同一次优化更新内混合浅、深路径的梯度,保护单循环表现;循环条件调制告诉共享层当前进度和总预算,让不同轮次形成分工。训练成本通过延后引入多循环来控制;混合专家(Mixture-of-Experts,MoE)的路由复用和最后一轮 KV 缓存分别减少重复路由工作与注意力缓存。
在同数据、同 token 预算的配对实验中,4B 模型的十任务平均分从基线 65.65 变为单循环 65.13、四循环 72.38;30B-A3B 模型对应 65.04、66.08、70.83。完整方案经过后训练得到 Koi-4B,作者评测工具估算的 AA-Index v4.1 从 17.52 升至 29.23。后者没有配对的非循环训练对照,且不是 Artificial Analysis 官方评测结果。(Sec. 4–5;PDF pp. 6–10、21–22)
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 提出 one-loop tax 与部署目标 | pp. 1–3;Fig. 1 |
| 2. Latent Recurrent Models | 定义共享循环块、独立层数与有效深度 | pp. 3–4;Eq. (1) |
| 3. Method | 门控更新、rank override、条件调制与三种成本控制 | pp. 4–6;Eqs. (2)–(5) |
| 4. One-Loop Accuracy and Gains from Additional Loops | 4B/30B-A3B 配对实验及路由复用 | pp. 6–8;Fig. 2、Table 1 |
| 5. Koi-4B: A Post-Trained GDP-Hybrid ELR Model | 完整训练流程、能力扩展、KV 缓存取舍 | pp. 9–11;Fig. 3、Table 2 |
| 6. Ablations | 逐项分析更新规则、训练深度、采样、override、延后训练与调制 | pp. 11–14;Figs. 4–6、Table 3 |
| 7. Related Work;8. Conclusion | 与已有循环方法的关系及未解决问题 | pp. 14–15 |
| A. Model Architecture and Training Details | 结构、优化器、混深度实现、Koi 后训练 | pp. 18–20;Tables 4–6 |
| B. Matched-Baseline Benchmark Results | 十任务协议与逐任务分数 | pp. 20–22;Tables 7–9 |
| C. Koi-4B Evaluation and Detailed Results | AA 分项、输出 token 口径、KV 策略失败案例 | pp. 22–24;Tables 10–12 |
| D. Inference Latency Measurements | H100 上的延迟测量与负载敏感性 | pp. 24–25;Fig. 7 |
| E. Route Replay Analysis;F. Ablation Results | 路由漂移诊断、计时与输入重注入消融 | pp. 25–26;Tables 13–14 |
一:动机——让单循环成为有用的起点
1.1 弹性深度为何需要保护最低计算档
深度方向的参数共享,把模型的权重存储量与实际执行深度分开。固定权重可以执行更多轮,从而在设备放得下的模型上继续增加推理计算。这里的潜在循环发生在隐藏表示中,不需要为了执行一轮网络而输出一段额外文本。
但如果单循环能力明显弱于同规模普通模型,用户必须先付出若干轮额外计算才能追回原有水平;需要低延迟时仍得另备一个模型。作者把这项差距称为 one-loop tax。ELR 的评价重点因此是“浅端是否仍可用,以及在这个起点上多算的收益”,并非寻找所有训练预算下最优的参数规模。(Sec. 1;PDF pp. 1–3)
1.2 相同骨干不等于训练计算完全相同
论文的配对比较控制了骨干配置、训练数据、token 数和优化设置,但 ELR 多循环阶段仍消耗更多计算。无条件调制的门控新增约 0.2% 的 4B/0.5B 参数;30B MoE 对总参数约为 0.02%。完整 Koi 条件模块另增 155.6M 参数,约为骨干的 3.94%。因此“固定参数量”应理解为同一 checkpoint 改变 $k$ 时不新增参数;单循环相对基线的执行层数一致,实际门控开销很小。(Appendix A;PDF pp. 18–20)
二:方法——状态更新、梯度混合与循环分工
2.1 三段骨干与两种深度
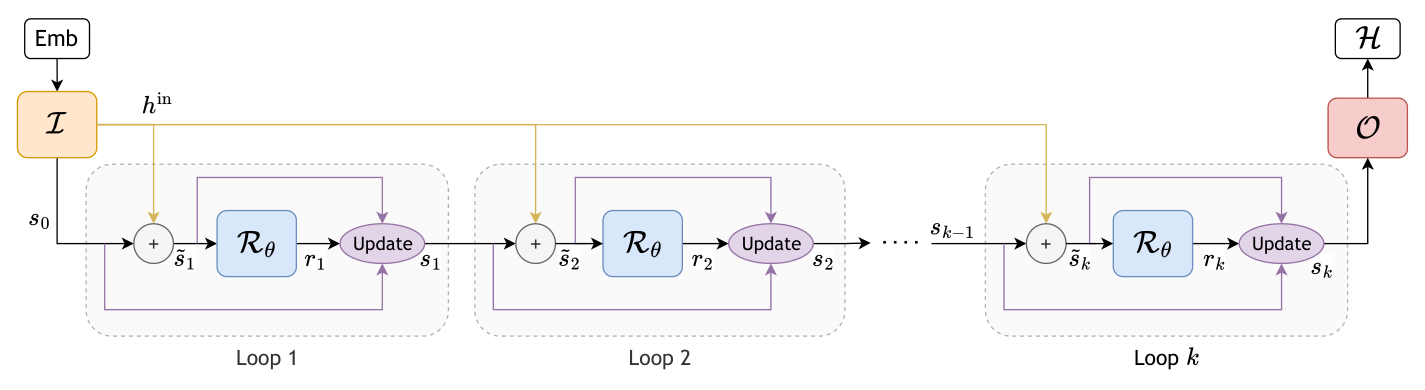
原文 Fig. 1,PDF p. 2。沿横向读取:输入块只运行一次,黄色路径把输入表示送到每一轮,共享循环块输出候选表示,再由紫色更新模块决定状态改变多少,最后交给输出块。
| 符号 | 含义 |
|---|---|
| $\mathcal I,\mathcal R_\theta,\mathcal O$ | 输入块、参数共享的循环块、输出块 |
| $L_{\mathrm{in}},L_{\mathrm{rec}},L_{\mathrm{out}}$ | 三个块中的独立层数 |
| $h^{\mathrm{in}}$ | 输入块产生的固定表示 |
| $s_i,r_i,\tilde s_i$ | 第 $i$ 轮更新后状态、候选状态、重注入后的输入 |
| $d$ | 隐藏维度;按单 token 写式时,状态在 $\mathbb R^d$ 中 |
| $k,K$ | 当前请求/样本的循环预算、训练支持的最大预算 |
| $f,\rho$ | 强制单循环的 rank 比例、使用混合深度的训练 token 比例 |
初始化与读出为
独立层数为 $D_{\mathrm{unique}}=L_{\mathrm{in}}+L_{\mathrm{rec}}+L_{\mathrm{out}}$,实际执行层数为
4B 和 30B-A3B 均按 $14/24/14$ 分块,所以 $k=1,2,3,4$ 分别执行 52、76、100、124 层。每增加一轮只重跑中间 24 层。原文把一个注意力(attention)、Gated DeltaProduct(GDP)或前馈(FF)子层各算一层,这里的“52 层”不宜直接对照通常把 attention+MLP 合算为一层的 Transformer 深度。(Sec. 2–3.1,Eq. (1),PDF pp. 3–4;Appendix A.1,p. 18)
2.2 Adaptive delta:学习该改多少
未加入循环条件调制时,每轮执行
原文 Eq. (2),PDF p. 4。$W_\beta\in\mathbb R^{d\times d}$,$b_\beta,\gamma\in\mathbb R^d$;参数跨循环共享,共新增 $d^2+2d$ 个。sigmoid 部分让不同 token、不同通道选择不同步长,softplus 部分提供可学习的逐通道基准步长。
候选 $r_i$ 可以理解为共享网络提出的一次修改建议,$r_i-s_{i-1}$ 是修改方向。门控决定接受多少修改,因此原状态有一条直接保留的路径。教学例子:某通道当前值为 2、候选值为 5、步长为 0.35,则新值为 $2+0.35(5-2)=3.05$。
三个门参数都以零初始化时,$\beta_i=\tfrac12\log2\approx0.3466$。这使训练初期采用较小步长;不过 softplus 没有上界,学成后的 $\beta_i$ 不一定小于 1,不能把公式始终当成凸组合或把它视作收缩性保证。
大模型中第一轮输入是 $\tilde s_1=2h^{\mathrm{in}}$。0.5B 默认消融则省略重注入,采用 $\tilde s_i=s_{i-1}$;两者的具体差异在第四部分单独分析。
2.3 在同一次更新里训练浅、深路径
对每个 microbatch,先共享采样一个多数 rank 使用的 $k\sim U\{1,\ldots,K\}$,再让轮换的一部分数据并行 rank 强制用 $k=1$。完成各自前后向后,在优化器更新前平均梯度。所有实际执行的循环都参与反向传播,不截断循环梯度。(Sec. 3.2,PDF pp. 4–5;Appendix A.3,p. 19)
任一 rank 单循环的边际概率与平均循环数为
这是原文 Eq. (3)。配对大模型使用 $K=4,f=0.10$,因此
教学例子:100 个数据并行 rank 中,若当前抽到四循环,则约 10 个做一循环,90 个做四循环,同一次更新同时接收两种深度的信号。下一 microbatch 强制浅路径的 rank 位置轮换。
仅把全体同步采样的 $p_1$ 提高到相同值,不会产生这样的单次更新组成。一个有助于理解的分析是:在固定参数下,相同深度边际分布可以对应相同的期望梯度;但梯度方差、跨深度相关性和 Adam 等优化器的状态演化会不同。论文用匹配边际分布的消融支持“梯度如何被分组”确实影响结果,没有直接测量哪一种优化效应主导。
2.4 循环条件调制:让共享层知道进度和预算
只共享权重而不给轮次信息,会要求同一个函数自行从状态中判断当前处于什么阶段。ELR 显式提供
其中 $\phi$ 是正弦嵌入。$\tau_i$ 表示相对进度,$\kappa$ 表示相对最大训练深度的预算。例如在 $K=4$ 下,$(i,k)=(1,1)$ 和 $(1,4)$ 的进度/预算分别为 $(1,1/4)$ 与 $(1/4,1)$。因此“只运行一轮”和“多轮中的第一轮”可以采用不同策略。
输入块不调制;循环块按 $(i/k,k/K)$ 调制;输出块按 $(1,k/K)$ 调制。每个循环/输出子层 $f$ 使用
原文 Eq. (4),PDF p. 5。第一行调整归一化后的输入;第二行用低秩方向补充循环相关的修正;第三行控制该层输出的残差强度。$B\in\mathbb R^{r\times d}$、$A\in\mathbb R^{d\times r}$,$g(c_i)\in\mathbb R^r$;$\lambda,\mu,\omega$ 的输出在 $\mathbb R^d$。这些参数逐层独立、跨循环共享。
此外,第二轮开始的循环入口重新归一化并调节输入重注入:
令 $r_i=\mathcal R_\theta(z_i;c_i)$,出口再调节更新幅度:
门 $\beta_i$ 仍由未经过入口调制的 $\tilde s_i$ 计算。条件向量只依赖 $(i,k)$,推理时可预计算条件向量和各线性 head 的输出,但逐 token 的归一化与低秩修正仍属于模型运算。
2.5 零初始化为什么能保留切换前的函数
条件模块在单循环训练切换到混合深度时才加入,所有条件 head 初始化为零。由上式可直接得到:
- 每个子层的缩放、平移、低秩修正和输出调制均为恒等改动;输出块也不受预算影响。
- 第一轮保留原有入口和 adaptive-delta 更新。
- 后续轮的出口因子为零,无论候选状态如何,都有 $s_i=s_{i-1}$。
所以在精确算术下,加入条件模块的瞬间,任何 $k$ 都得到原单循环 checkpoint 的函数输出。训练再逐渐开启后续轮的修正。这是保留已经训练好的 ELR 单循环模型:该模型从一开始就带有 adaptive-delta gate,并非把任意普通预训练模型直接替换为上述公式就能保持函数。(Sec. 3.3,PDF p. 5)
2.6 延后混合深度:用较短阶段学习弹性
前期只训练 $k=1$,末期才混合深度;切换时保留模型、优化器状态及学习率调度。若多循环阶段占训练 token 的 $\rho$,原文按层执行次数近似成本:
原文 Eq. (5),PDF p. 6。对于 $14/24/14$、$\bar k=2.35$,多循环阶段的层执行比为 $84.4/52\approx1.623$;只放在最后 25% tokens,总比值为 $1.156$,约增加 16%。Koi 的多循环阶段占后 50%,对应约 $1.31\times$,不可套用 16%。
这个估计用层数代理计算量,未逐项计入不同层成本、条件模块、通信及数据并行等待,所以不能把 $+16\%$ 当成已测得的训练墙钟时间增长。
2.7 MoE 路由复用与最后一轮 KV 缓存
跨循环路由复用(cross-loop route replay):每个循环块中的 MoE 层,只在第一轮计算专家索引和路由权重,后续轮沿用同一 token 的选择。专家仍处理本轮更新后的表示,dispatch、all-to-all 通信、专家计算和结果组合仍需执行。训练时首轮负载均衡辅助损失乘以实际循环数 $k$,保持其累计权重。(Sec. 3.4,PDF p. 6)
最后一轮 KV 缓存(last-loop KV caching):对每个循环 attention 层只留一套缓存。解码 token $t$ 的第 $i$ 轮查询,读取此前 token 的最终轮 KV,以及当前 token 的第 $i$ 轮 KV;当前 token 的槽位随循环被覆盖,最终留下最后一轮结果。它改变了原先“第 $i$ 轮查询读取第 $i$ 轮历史”的规则,是无需重训练的近似推理策略。
Koi 六个 attention 层中有三个在循环块。由此可推导 attention KV 相对一循环的比例为
四循环时从 $2.5\times$ 降至 $1\times$;128K-token 请求、BF16 下对应 7.5 GiB 降至 3.0 GiB。GDP 层仍保留各循环的状态,但其大小不随序列长度增长,四循环时每请求低于 25 MiB。这里保持不变的是 attention KV,不能据此说所有运行时显存完全不变。(Sec. 5.3,PDF pp. 10–11)
三:实验——三条证据线的配置与比较对象
3.1 配对预训练实验:检验单循环表现和增加深度的收益
| 配置 | GDP-Hybrid-4B | GDP-Hybrid-30B-A3B |
|---|---|---|
| 总参数/活跃参数 | 约 4B,稠密 | 约 30B/3B,MoE |
| 骨干 | 23 GDP + 6 attention + 23 FF 子层 | 同布局,FF 换为 MoE |
| 隐藏维度 | 3,072 | 2,688 |
| 训练 tokens | 1T | 300B |
| 优化器 | AdamW | Muon + AdamW |
| ELR 分块、训练深度 | $14/24/14$;$K=4,f=0.10$ | 同左 |
| 混合深度启动 | 75% tokens 后 | 75% tokens 后 |
| 循环条件调制 | 无 | 无 |
两者均用 Nemotron 3 Ultra 预训练语料的一个子集,序列长度 8,192,全局 batch 为 768。基线与 ELR 保持相同数据、token 预算及优化配置;峰值学习率均为 $1.2\times10^{-3}$,最低为 $1.2\times10^{-5}$,末 15% tokens 衰减。MoE 使用 512 个 routed experts,每 token 选择 22 个;动态路由与 replay 变体从同一个单循环 checkpoint 开始续训。(Sec. 4.1,PDF pp. 6–7;Appendix A,pp. 18–19)
十任务平均是各任务百分制分数的算术平均,越大越好:MMLU/MMLU-Pro 为 5-shot;ARC-Challenge 为 25-shot;WinoGrande 为 5-shot;CommonsenseQA 为 7-shot;RACE-high 为 0-shot;GSM8K 为 8-shot CoT 答案准确率;MATH-500 为 4-shot pass@1;HumanEval 为 0-shot pass@1;MBPP sanitized 为 3-shot pass@1。知识和常识任务采用准确率,数学答案通过 Math-Verify 判断等价性。(Table 7,PDF p. 21)
3.2 GPT-0.5B 消融:定位哪些选择决定结果
消融骨干有 15 个 attention 和 15 个 MLP 子层,按 $8/14/8$ 分块,隐藏维度 1,024。训练 300B tokens,使用 AdamW;默认从头混深度,$K=5,f=0.15$,即 $p_1=0.32,\bar k=2.70$。指标为验证损失,越低越好;非循环基线为 1.6852。
默认不做输入重注入。固定深度模型不使用 override。调制消融在后 25% 的混深度阶段加入条件维度 256、低秩维度 $r=256$ 的模块,新增 31.6M 参数,约为骨干的 6.34%。(Sec. 6,PDF pp. 11–14;Appendix A,pp. 18–19)
3.3 Koi-4B:完整方案是否能走到后训练
| 阶段 | 数据/预算 | 深度安排 |
|---|---|---|
| 预训练 | 7T tokens,8K context | 前 50% 单循环;后 50% 混深度并加入零初始化条件模块 |
| 中训练 | 50B tokens,扩到 256K context | 均匀采样 $k=1\ldots4$,10% rank override |
| 监督微调(SFT) | Nemotron 3.5 Super 文本数据,4 epochs | 同上 |
| 可验证奖励强化学习(RLVR) | 同源可验证奖励数据,200 steps | $k=1,2,3,4$ 按 $4:1:1:1$ 分配 |
预训练语料 blend 在 44% tokens 处切换,循环分布在 50% 处切换,是两个不同事件。RLVR 用异步 GRPO:每个 prompt 生成 16 条 rollout,同一 prompt 的 rollout 使用相同 $k$;256 个 prompt 构成一步,使用 leave-one-out 基线与奖励归一化。推理引擎各固定一个循环数;课程机制按通过率把更难的 prompt 分配给更深的循环。(Appendix A.4,PDF pp. 19–20)
Koi 按 AA-Index v4.1 的 benchmark 和权重评估,同时报告 IFBench、LiveCodeBench v6 和 MATH-500。所有参考模型也由作者自己的 harness 评估。CritPt 权重为 6%,实际未运行,统一按零贡献计入;GDPval 的分项是 Elo,不能把它与其他百分制分数直接作普通加权平均来复算指数。(Sec. 5.1,PDF p. 9;Table 10,p. 22)
四:结果——收益来自哪里,成本落在哪里
4.1 配对实验:平均单循环接近基线,第二轮收益最大
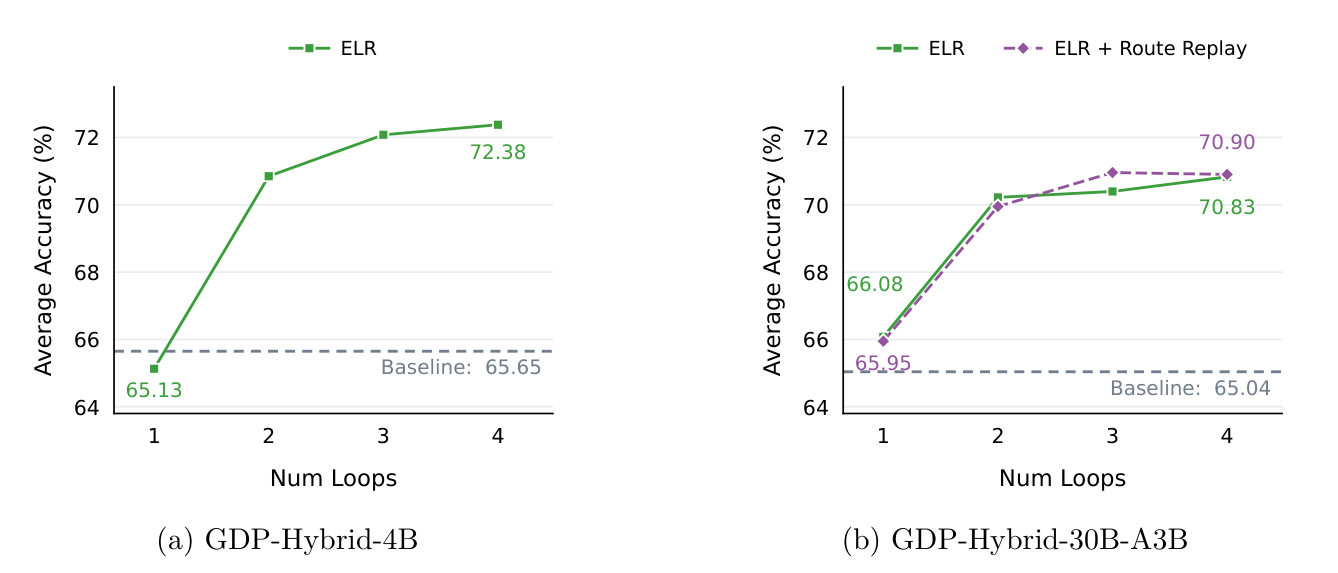
原文 Fig. 2,PDF p. 7。横轴为推理循环数,纵轴为十任务平均分;每条折线来自同一个 checkpoint,虚线为非循环基线。右图另列 route replay 变体。
| 模型 | 非循环基线 | $k=1$ | $k=2$ | $k=3$ | $k=4$ |
|---|---|---|---|---|---|
| 4B ELR | 65.65 | 65.13 | 70.85 | 72.08 | 72.38 |
| 30B-A3B ELR | 65.04 | 66.08 | 70.22 | 70.40 | 70.83 |
| 30B-A3B ELR + replay | 65.04 | 65.95 | 69.95 | 70.96 | 70.90 |
数据来自 Tables 8–9,PDF pp. 21–22。4B 的单循环比基线低 0.52 个百分点,四循环比自身单循环高 7.25 个百分点,比非循环基线高 6.73 个百分点。30B 动态路由对应为 +1.04、+4.75、+5.79 个百分点,三个比较基准不能混用。
4B 的第二轮贡献 $70.85-65.13=5.72$ 个百分点,占一到四循环总提升约 79%;三循环累计约 96%。30B 动态路由第二轮占约 87%。作者认为这与后续轮的训练暴露不足相符:在该采样分布下,训练样本执行到第二、三、四轮的比例只有 67.5%、45%、22.5%。尚未通过重加权实验确立这就是边际收益下降的原因。(Sec. 4.2,PDF pp. 7–8)
“接近基线”是平均意义,逐任务存在实质差异:4B 单循环的 GSM8K 从基线 76.3 降至 71.0,而 MATH-500 从 64.1 升至 69.3。增加循环也不保证每项都单调上升,HumanEval 从二循环 66.5 降至四循环 64.0;replay 模型的整体平均也在三到四循环从 70.96 变为 70.90。部署档位应结合任务分布选择。(Tables 8–9)
4.2 实测推理成本:有效深度与延迟分别看
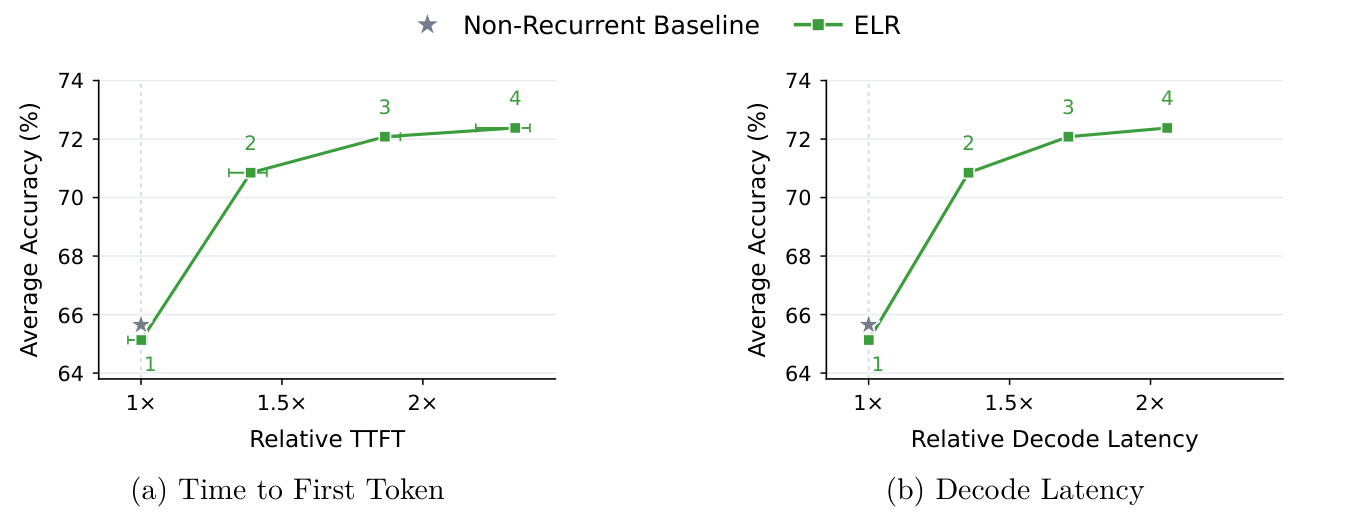
原文 Fig. 7,PDF p. 25。两图纵轴都是 4B 十任务平均分,横轴分别是相对首 token 延迟(TTFT)和每 token 解码延迟;数字标记 $k$,横向误差条为计时比值的 95% bootstrap 区间。
测量在单张 H100 80GB、BF16、vLLM 0.20.2 下进行,主负载为 batch 1、1,024 prompt tokens、固定生成 128 tokens。prefill 用 eager,decode 用 CUDA graph;忽略 EOS,并关闭前缀缓存、chunked prefill、推测解码和 torch.compile。两次热身后测七次,取中位数。(Appendix D,PDF pp. 24–25)
单循环解码延迟与基线基本一致;在不同 prompt 长度和 batch 的 CUDA graph 测量中,差异为 −0.26% 至 +0.07%。四循环 TTFT 为基线的 $2.33\times$,每 token 解码为 $2.06\times$。三循环在 $1.87\times$ TTFT 下得到约 96% 的一到四循环平均增益。这里的 confidence interval 只度量计时波动,不度量模型准确率不确定性。
4.3 Route replay:训练加速明显,推理收益较小
首先检验第一轮路由是否还能代表第四轮。对 256 个验证文档的 2K-token 窗口,十个循环 MoE 层平均结果如下:
| 诊断量 | 原文结果 | 含义 |
|---|---|---|
| 首轮/第四轮专家使用频次余弦相似度 | 0.978 | 总体负载分布很接近 |
| 单 token 保留的首轮专家比例 | 53.17% | 约一半具体专家发生变化 |
| 固定第四轮输入,replay 与动态路由的 routed 输出余弦 | 0.767 | 首轮决策仍保留较多 token 相关信息 |
| 将首轮路由在文档内错位后的对应输出余弦 | 0.227 | 仅保持总体频次无法替代 token 对应关系 |
Table 13,PDF p. 26。输出比较固定同一层、同一个第四轮输入,不把替代输出继续传播到后续层,因此是局部路由影响的诊断。包含 shared experts 后,replay/错位对照的 full-MoE 输出余弦分别为 0.918/0.718。
| 相对动态路由 ELR | 仅推理开启 replay | 训练与推理均 replay |
|---|---|---|
| 四循环验证损失变化,越小越好 | +0.0055 | +0.0038 |
| 混深度阶段平均更新耗时变化 | — | −11.7% |
| 固定四循环训练更新耗时变化 | — | −19.6% |
| 8K 全上下文推理 forward 耗时变化 | −1.2% | −1.2% |
Table 1,PDF p. 8。四循环十任务平均为动态路由 70.83、replay 70.90,点估计非常接近。训练速度收益是混合深度阶段的更新耗时下降,不是整个预训练过程减少 11.7%。
四循环全网 router 执行数从 53 降至 23,但专家计算与通信仍在,因此 8K forward 加速仅约 1.2%。训练额外省掉重复 router 反向传播和辅助损失计算,收益更大。该推理计时使用八张 H100、Megatron-LM 和专家并行,并不是上一节单张 H100 的逐 token decode 测试。(Sec. 4.3;Appendix E)
4.4 Koi-4B:完整方案的能力与输出长度
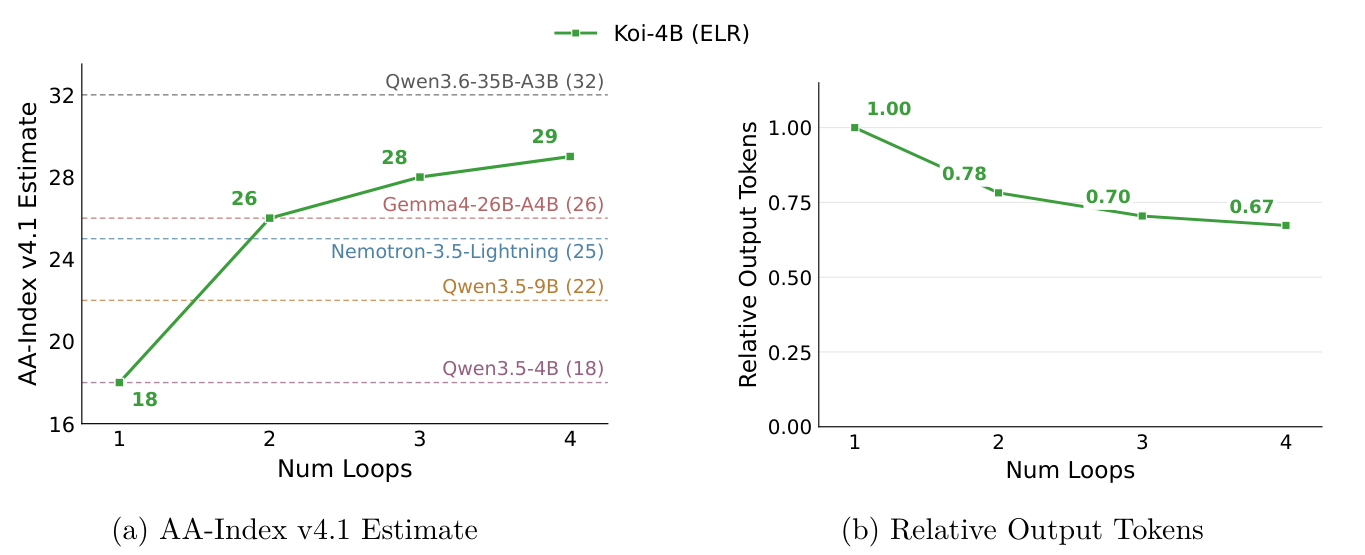
原文 Fig. 3,PDF p. 9。左图为作者 harness 的 AA-Index v4.1 估算值,图中取整;右图为八项 benchmark 输出 token 比值的几何平均。两边横轴均为同一 Koi checkpoint 的推理循环数。
| 指标 | $k=1$ | $k=2$ | $k=3$ | $k=4$ |
|---|---|---|---|---|
| AA-Index v4.1 estimate | 17.52 | 25.57 | 27.93 | 29.23 |
| Terminal-Bench 2.1(%) | 12.1 | 22.9 | 26.5 | 28.0 |
| SciCode(%) | 17.7 | 28.0 | 30.8 | 33.4 |
| GPQA Diamond(%) | 59.9 | 69.9 | 73.6 | 72.8 |
| LiveCodeBench v6 pass@1(%) | 50.5 | 66.8 | 71.6 | 71.9 |
| MATH-500(%) | 88.8 | 96.6 | 97.2 | 97.2 |
| 输出 token 几何平均比 | 1.0000 | 0.7821 | 0.7046 | 0.6732 |
分数来自 Table 10,PDF p. 22;token 比值来自 Table 11,p. 23。在该 harness 中,取整后的单循环 18 分与 Qwen3.5-4B 相当,二循环 26 分与 Gemma4-26B-A4B 相当,四循环 29 分仍低于 Qwen3.6-35B-A3B 的 32 分。这说明一个约 4B 级权重集合可以覆盖更宽的质量档位;由于参考模型的训练数据和预算不同,它们不能替代配对消融。
令 $T_b(k)$ 为 benchmark $b$ 每次 rollout 的平均输出 token 数,原文 Eq. (6) 定义
它对八项已运行 benchmark 等权,而非用 AA 指数权重;AA-Omniscience 两个分项共享生成,因此只计一次。一次 rollout 累计所有请求、agent turn 和子步骤的 completion tokens,包括推理文本与被截断请求,不包括评审模型和用户模拟器。
四循环比单循环少 32.7% 输出 tokens,作者将其解释为潜在深度部分替代显式推理轨迹。这个观察与解释相符,但输出预算、失败与任务交互也会改变长度,尚没有把两种推理形式的替代关系单独隔离。
作者用每 token 延迟和输出长度相乘,估计二循环解码总耗时约 $1.36\times0.7821\approx1.06$ 倍,四循环约 $2.06\times0.6732\approx1.39$ 倍。这里将 GDP-Hybrid-4B 的固定负载计时与 Koi 的跨 benchmark 长度比结合,是粗略的 decode 成本估算;不包括长 prompt 的 prefill、工具调用及端到端任务调度。(Sec. 5.2;Appendices C.1、D)
4.5 Last-loop KV:显存收益明确,任务质量需要逐项看
四循环时,缓存从 7.5 GiB 降为 3.0 GiB,节省 60% attention KV。下表选择几项能说明取舍的结果,分数越大越好;差值照录原文未舍入值计算的结果。
| benchmark | 单循环 | 四循环 per-loop | 四循环 last-loop | last − per(百分点) |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 12.1 | 28.0 | 27.4 | −0.6 |
| Humanity’s Last Exam | 5.9 | 11.9 | 10.5 | −1.4 |
| AA-LCR | 51.3 | 68.3 | 65.3 | −3.0 |
| LiveCodeBench v6 | 50.5 | 71.9 | 70.2 | −1.6 |
| MATH-500 | 88.8 | 97.2 | 97.0 | −0.2 |
| AA-Omniscience non-hallucination | 86.1 | 85.9 | 88.2 | +2.3 |
Table 2,PDF p. 10。LiveCodeBench 显示值相减为 −1.7,而表内 −1.6 由未舍入原值计算。正文使用“0–3%”概括降幅时,这里应按表注理解为百分点。
深度收益大部分仍在,但性能下降不是在所有任务上都可忽略。二、三循环也有升有降:二循环的 Banking 从 16.75 升到 19.85;三循环的 LiveCodeBench 从 71.59 降至 69.21。作者在九项可获得逐题结果的 benchmark 上作配对比较,27 个跨深度比较中有 7 个达到未经多重比较校正的 $|z|\ge2$;这些是单次运行内的题目差异,不包含跨次运行变化。(Table 12;Appendix C.2,PDF pp. 23–24)
最重要的失败案例是 GDPval-AA v2。 在 220 个任务中,last-loop KV 的失败数量在二、三、四循环分别为 13、29、52,而 per-loop 为 1、6、12,主要因超时;agent turns 还增加 17%–19%。超时任务没有 Elo 判断,两个策略实际评分的任务集合不同,评审参照集也不同。因此作者未给出可比 GDPval 分数,也没有给出 last-loop KV 的整体 AA-Index。(Appendix C.2,PDF p. 24)
另一个容易误读的现象是输出长度下降:last-loop KV 在多数 benchmark 产生更少 tokens,但不少节省来自更少请求触及输出上限。Terminal-Bench 中,避免在达到上限的请求上继续消耗 tokens 解释了 96%–98% 的长度下降,同时 agent turns 反而增加 3%–7%。所以“文本更短”并不直接等同于任务完成更快。
4.6 消融一:状态更新规则决定浅端能否保住
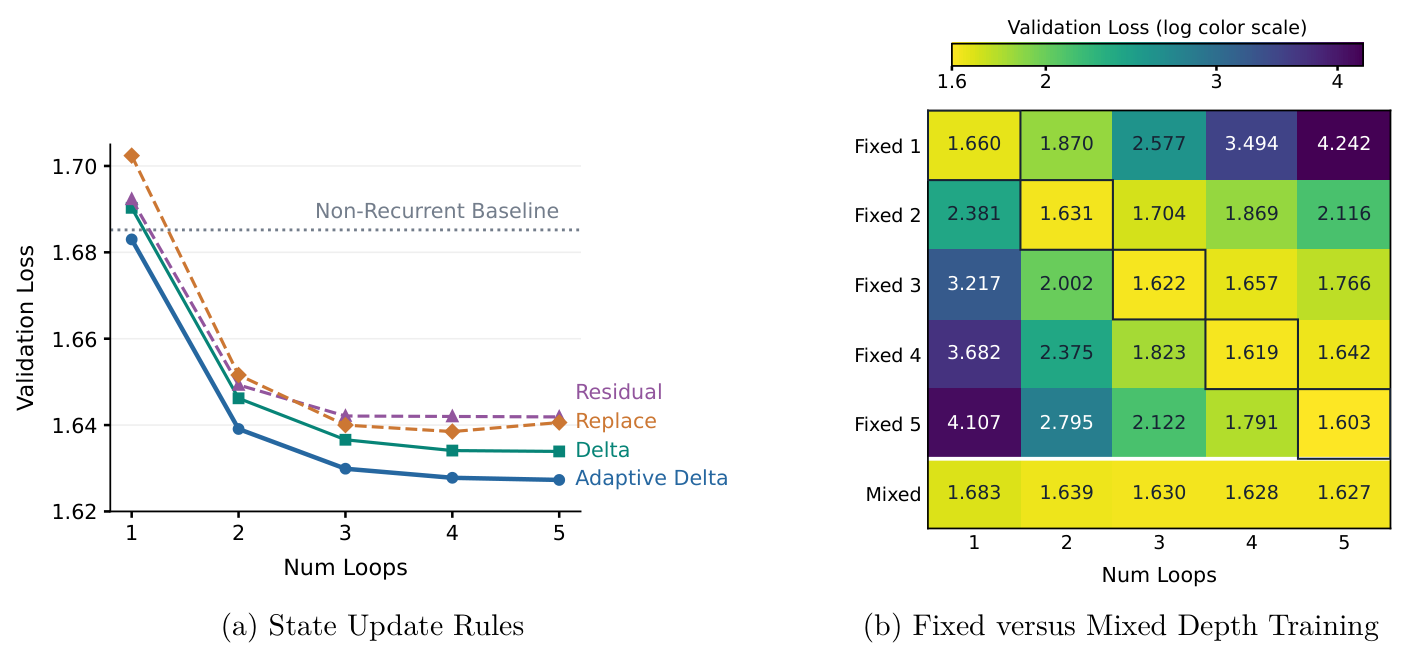
原文 Fig. 4,PDF p. 11。左图横轴为测试循环数、纵轴为验证损失;虚线代表无参数更新规则,实线代表学习步长。右图每一行是一个独立训练的模型,每一列为测试深度;标框对角线表示训练与测试深度相同,颜色为损失的对数刻度。
四种更新的区别是:
| 更新规则 | 计算 | 主要观察 |
|---|---|---|
| Replace | $s_i=r_i$ | 单循环最差,四到五循环损失回升 |
| Residual | $s_i=s_{i-1}+r_i$ | 三轮后基本停止改善 |
| Delta | $s_i=s_{i-1}+\alpha\odot(r_i-s_{i-1})$ | $\alpha$ 是输入无关的学习率,初值 0.05;表现次优 |
| Adaptive delta | 使用输入相关的 $\beta_i$ | 默认配置中唯一达到单循环基线水平的更新;所有深度最好 |
Adaptive delta 比普通 delta 每个深度的损失低约 0.006–0.007。这支持两层判断:学习修正幅度比直接替换/累加更适合弹性深度;使幅度依赖 token 表示还能进一步受益。(Sec. 6.1,PDF p. 11)
4.7 消融二:固定深度模型不会自然获得弹性
固定一循环训练的模型在一循环损失 1.660,改成五循环直接升至 4.242;固定五循环训练的模型在五循环为 1.603,改成一循环为 4.107。混合训练则从一循环 1.683 平稳降到五循环 1.627。
这说明共享参数本身不足以让模型支持改变循环数,训练分布必须覆盖服务深度。固定深度专家在各自训练深度更强,但维持整条服务曲线需要多个 checkpoint。单循环 ELR 训练模型还优于普通基线 1.685:在默认无输入重注入配置中,两者主要差别是跨循环块的学习门控,说明该结构即使不循环也可能有用。(Sec. 6.2,PDF p. 12;Fig. 4b)
4.8 消融三、四:相同 $p_1$,梯度的分组方式仍重要
| 方案 | $p_1$ | 单次更新最多深度数 | 相对 step time | $k=1$ 损失 | $k=5$ 损失 |
|---|---|---|---|---|---|
| 非循环基线 | — | — | — | 1.6852 | — |
| 同步均匀采样 | 0.20 | 1 | 1.00 | 1.7077 | 1.6313 |
| rank 独立均匀采样 | 0.20 | 5 | 1.36 | 1.6937 | 1.6147 |
| 同步加权采样 | 0.32 | 1 | 1.00 | 1.6871 | 1.6316 |
| 同步采样 + 15% override | 0.32 | 2 | 1.00 | 1.6830 | 1.6273 |
| rank 独立加权采样 | 0.32 | 5 | 1.36 | 1.6774 | 1.6194 |
Table 3,PDF p. 12。后三行具有相同边际分布:$p_1=0.32$,其他四个深度各 0.17。独立采样允许更多深度在同一次更新中汇合,损失最低,但全体必须等最深的 rank,step time 增加约 36%。Override 保持本来抽到的最大深度,取得部分质量收益而不增加同步方案的 step time。
增大 override 比例会持续改善一循环,但会牺牲深路径。$f=0.15$ 是默认实验测试的比例中首次让单循环损失低于基线的值,因此作者选取接近三分之一的单循环边际概率。(Secs. 6.3–6.4,PDF pp. 12–13)
4.9 消融五、六:延后训练省计算,条件调制补回深端质量
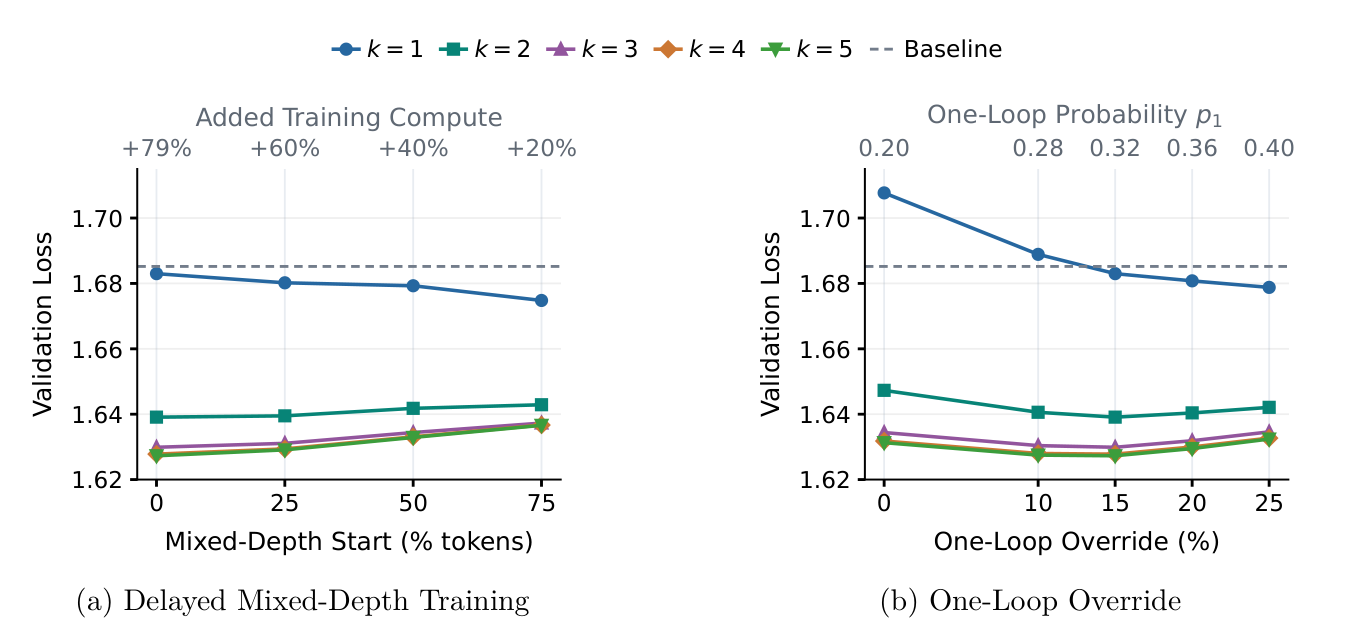
原文 Fig. 5,PDF p. 13。每个横轴点对应一个独立训练模型;不同颜色表示测试深度。左图横轴为开始混深度时已消耗的 token 比例,上轴是估计额外训练计算;右图横轴为 override 比例,上轴是对应的 $p_1$。它与“同一个 checkpoint 改变测试深度”的 Fig. 2 不是同一种横轴含义。
在 0.5B、$K=5$ 配置下,从头混深度估计训练计算为基线的 $1.79\times$。在 25%、50%、75% tokens 后启动,分别变为 $1.60\times$、$1.40\times$、$1.20\times$,保留原五循环相对非循环基线损失改善的约 97%、90%、84%。最晚启动时五循环损失增加约 0.009,但一循环仍优于基线。这一组的 +20% 与大模型的 +16% 使用不同分块和最大深度,不能混写。(Sec. 6.5,PDF p. 13)
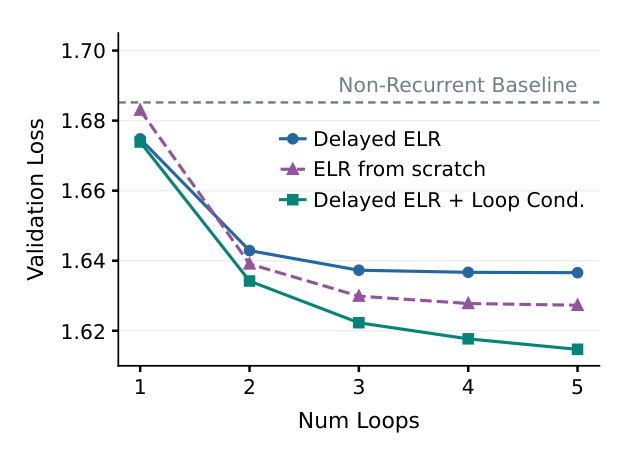
原文 Fig. 6,PDF p. 14。横轴为测试循环数,纵轴为验证损失;蓝色为延后训练、紫色为从头混深度、绿色为延后训练加调制。绿色深端明显更低,而一循环近似不变。
在最后 25% tokens 才加入条件模块,一循环损失由 1.6748 变成 1.6739;二循环减少约 0.009、五循环减少约 0.022。一到五循环的损失下降从约 0.038 扩大至 0.059。其五循环 1.6147 优于未加条件模块的从头混深度 1.6273。(Sec. 6.6,PDF pp. 13–14)
该比较同时改变了训练安排和模型容量:条件模块多 31.6M 参数。它支持“延后训练加条件调制”这一组合的效果,不能单独归因于延后训练优于一切从头训练;原文没有提供相同条件模块从头训练的对应曲线。
4.10 输入重注入:小模型收益不依赖这一项
Table 14(PDF p. 26)给出默认无重注入与有重注入的直接比较:
| 循环输入 | $k=1$ 损失 | $k=5$ 损失 |
|---|---|---|
| $s_{i-1}$ | 1.6830 | 1.6273 |
| $s_{i-1}+h^{\mathrm{in}}$ | 1.6858 | 1.6325 |
该配置下重注入略差;有重注入的一循环 1.6858 也略高于非循环基线 1.6852。因此严格意义上的“单循环无损”取决于配置,不能只依据取整后的曲线判断。附录说明重做固定/混合深度、采样、override 和延后训练比较后排序保持一致;对更新规则比较的迁移只是作者预期,未展示对应重注入实验。
五:结论与研究启发
ELR 的主要贡献是把弹性深度落实为一套可持续训练、可服务的方案。可学习步长给共享循环块保留旧状态的选择;浅深梯度同次更新保护最低计算档;进度/预算调制再让不同轮次发展出不同功能。证据最完整的结论是:在所测配对预训练中,单循环十任务平均接近原骨干,多循环显著提高平均分,且沿用基线优化设置即可训练。
对架构研究而言,有三个具体启发。首先,多深度训练的目标不能只由采样直方图描述,还应关注每次更新实际混合了哪些路径。其次,扩展计算能力可以通过函数保持的增量方式接入:先让新增深度的出口为零,再学习何时使用它。第三,参数共享、专家决策复用和 KV 复用发生在不同对象上,节省的分别是权重存储、路由计算和缓存,质量代价也须分别测量。
论文仍留下几项会影响应用判断的问题。多循环收益通常在第二轮之后快速减小,是否可用不同深度采样改善尚未测试;服务时每个请求固定预算,预算条件化使中途自适应停止不再等同于从开始就指定较小预算;超出训练最大循环数的外推没有评估。完整 Koi 的优势需要结合额外训练量与条件参数理解,MoE 的后训练也尚未完成。Last-loop KV 尤其适合进一步做任务级成本评估,因为节省缓存与 GDPval 超时增加在本文中同时出现。
如果继续这条路线,最能澄清机制的实验包括:在相同参数与计算预算下比较“从头加条件”与“后期加条件”;固定深度边际分布而系统改变单次更新的混合方式;增加后几轮的训练暴露并测量各轮边际收益;对 KV 策略同时报告任务成功率、超时数、端到端时间及显存。以上是基于本文证据提出的后续研究问题。