REMORY:为上下文压缩学习残差记忆
论文题名:REMORY: Learning Residual Memory for Context Compaction
作者:Hanchen Xia、Baoyou Chen、Yutang Ge、Naihao Deng、Senqiao Yang、Zilong Dong、Weihao Yuan、Siyu Zhu
版本:arXiv:2610.11287v1,提交于 2026-10-08
获取与研读日期:2026-10-13
原文:arXiv 页面 · 在线 PDF · 本地 PDF
配套汇报:英文幻灯片 PDF · 可编辑 TeX
论文总览
长任务智能体必须反复压缩历史。文本摘要通常能保存任务主线,却可能丢失以后才变得关键的来源关联、失败反馈和操作细节。REMORY 在每次压缩时,读取当前历史及新摘要,生成最多 4,096 个软记忆 token(soft memory tokens),将其接在摘要之后。训练目标是让冻结的主模型读取这份压缩上下文时,尽量接近它读取完整历史时的后续响应分布。
这形成了三种互补的信息载体:摘要保存可读状态,连续记忆补充预测所需线索,工具检索提供精确原始记录。 作者将这种以摘要为条件、沿序列追加补偿信息的方式称为残差记忆(residual memory)。其“残差”含义来自摘要之后剩余的预测差距,而非预先定义的一组遗漏事实。(Sec. 2,PDF pp. 3–4)
最能解释机制的结果来自 SummHay:加入记忆后,内容覆盖率只从 67.55 变为 67.95,引用 F1 却从 56.98 变为 61.03,联合得分从 39.84 升到 43.39。后者接近原始上下文的 43.41,而平均输入位置数仅为原始上下文的 5.2%。这里保住的是联合指标:压缩后的内容覆盖仍低于完整上下文,来源归属则更好。(Table 1,PDF pp. 4–5)
端到端实验中,Qwen3.8-27B 在四个任务集上提升 3.0–9.8 个分数点,GLM-5.3-Flash 在两个任务集上提升 3.3 和 4.1 个分数点。解释这些收益时需要保留两个条件:BrowseComp 和 Terminal-Bench 每种配置只运行一轮;论文的美元成本是按 token 折算的生成费用,不包含源特征编码与记忆网络执行。(Tables 2–3,PDF pp. 5–6)
结构地图
下文页码均指从 1 开始的 PDF 页码,本版本与正文印刷页码一致。
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 提出压缩后信息可用性问题;概述残差记忆 | pp. 1–2;Figs. 1–2 |
| 2 Residual Memory | 定义软记忆接口及训练方法 | pp. 3–4;Fig. 3;Eqs. (1)–(3) |
| 2.1 A memory supplement to the summary | 递归压缩、网络结构和容量上限 | p. 3;Eq. (1) |
| 2.2 Learning through a frozen actor | 重建预训练与摘要条件续写蒸馏 | pp. 3–4;Eqs. (2)–(3) |
| 3.1 Source attribution after compaction | 隔离压缩表示对信息恢复、来源归属的影响 | pp. 4–5;Table 1 |
| 3.2 End-to-end agent performance | 比较任务成绩、工具行为和生成成本 | pp. 5–6;Tables 2–3 |
| 3.3 The first action after compaction | 固定摘要,比较压缩后的下一步动作 | p. 6 |
| 3.4 Case studies | 展示长期模拟交易与代码修复轨迹 | pp. 6–7;Figs. 4–5 |
| 4 Related Work | 定位于摘要、检索和连续压缩方法之间 | p. 7 |
| 5 Conclusion | 总结三类信息载体的分工 | p. 7 |
一:动机——压缩之后,哪些历史还能影响下一步?
1.1 有限窗口带来反复的信息转换
智能体的上下文包括用户指令、计划、工具输出、失败记录和已经完成的操作。随着交互继续,输入长度逐步增长;接近压缩边界时,大段历史被摘要替换,长度骤降,再进入下一轮增长。原图 2(a) 的横轴是请求序号,纵轴是输入 token 数,锯齿形轨迹展示的就是这个循环。(Sec. 1,PDF pp. 1–2)
困难在于,压缩时无法完整预测未来的问题。一个当下无关的页面来源、已经失败过的命令参数,可能在若干轮之后决定下一步该做什么。即便摘要保留了“目前正在修复某个函数”,它也可能没有保留具体尝试及其反馈之间的联系。
作者借人类有限工作记忆与长期记忆之间的协作说明设计动机:活跃窗口之外的信息仍应能支持当前决策。这个类比提供了思路;REMORY 实际实现的是神经网络生成的连续输入向量,论文没有建立生物记忆机制与模型模块的一一对应。(Sec. 1,PDF p. 2)
1.2 为什么保留摘要,同时学习补充通道?
摘要已经是一个有用、可读的任务检查点。保留它后,连续记忆可以集中优化“给定这份摘要,主模型还缺少哪些预测线索”。同时,存档和文件工具继续承担精确恢复原文的职责。这样,记忆网络无需将全部历史无损编码,也无需输出人类可读的第二份长摘要。
这个设计还给出了直接的对照问题:同样增加输入位置,把预算用于生成补充文本是否也能取得收益?论文在 SummHay 中设置 Summary++ 正是为了回答这一点。(Sec. 3.1,PDF pp. 4–5)
二:方法——摘要条件下的连续记忆与行为蒸馏
2.1 一次压缩边界上的输入、计算与输出
原文 Eq. (1) 定义:
| 符号 | 含义 |
|---|---|
| $i$ | 第 $i$ 次上下文压缩边界 |
| $H_i$ | 当前待压缩历史,包含上一份摘要、已有软记忆以及上次压缩后的新增交互 |
| $S_i$ | 本次生成的新文本摘要 |
| $\mathcal C_\phi$ | 可训练记忆网络,参数为 $\phi$ |
| $M_i$ | 在主模型输入空间中的一串连续向量 |
| $m$ | 最终记忆槽位上限,实验为 4,096 |
| $p_\theta$ | 负责实际行动和响应的主模型,参数 $\theta$ 保持冻结 |
一次压缩的处理顺序是:生成 $S_i$;记忆网络结合 $H_i$ 和 $S_i$ 构造 $M_i$;把持久指令、$[S_i;M_i]$ 和此后的新交互交给主模型。下一次压缩时,旧摘要与旧记忆一起成为当前历史的一部分。因此,跨边界的记忆来自反复更新的状态,而不要求每次把最早的全部历史重新塞入活跃窗口。(Sec. 2.1,PDF p. 3)
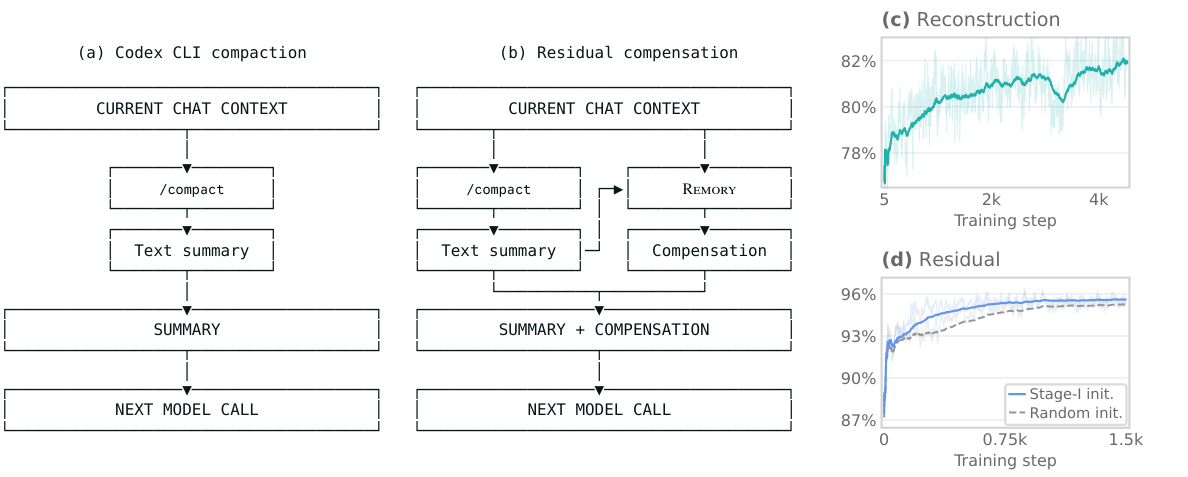
图源:原文 Fig. 3,PDF p. 3,复用作者矢量图并转为 PNG。左侧 (a) 是仅保留摘要的流程;中间 (b) 多出一个同时接收历史和摘要的 REMORY 分支;右侧 (c,d) 是训练步数与教师—学生 top-1 预测一致率,详见 2.5 节。
为说明向量维度,记主模型输入宽度为 $d$、实际槽位数为 $k_i$,则 $M_i\in\mathbb R^{k_i\times d}$、$k_i\le4096$。这是依据原文接口补充的记号。若 $E(S_i)$ 是摘要的普通 token embedding,主模型看到的这一部分输入可写为:
这里发生的是沿序列维度拼接。网络没有对历史和摘要作逐元素相减;残差补偿的意义由后续预测目标决定。软记忆也没有被量化为词表 token,因而“4,096 个位置”表示连续向量占用的序列长度。
2.2 记忆网络怎样把长历史变成有限槽位?
网络使用冻结主模型的特征和可学习查询,并行预测记忆向量;通过对摘要的**门控交叉注意力(gated cross-attention)**调节记忆构造。每个最多 1,024 个源位置的块输出 64 个软 token;长输入通过层级压缩把最终输出限制在 4,096 个槽位内,并保持来源顺序。(Sec. 2.1,PDF p. 3)
对填满的块,局部位置压缩率是 $1024/64=16$。这个数字描述单个压缩步骤。最终摘要长度、末块是否填满、是否经过更多层级,都会影响完整输入的实际压缩率;最终槽位上限也不限制源编码和中间表示的大小。
| 冻结主模型 | 记忆网络的结构来源 | 可训练参数量 |
|---|---|---|
| Qwen3.8-27B | 改造 DFlash | 1.94B |
| GLM-5.3-Flash | 改造 DFlash-2,含分组动态卷积 | 1.502B |
这些网络的输出任务是连续记忆构造。论文借用了相应架构,并未把其原本的词表草稿生成目标作为 REMORY 的输出目标。
工程含义(本次分析):该方法需要能向主模型注入连续输入的部署接口;训练时还需要让损失经主模型对这些输入反向传播。主模型权重保持不变,仍然可以对输入求导。与此同时,十亿级记忆网络和历史特征编码都有实际计算开销,不能由最终槽位数推断整个系统的运行成本。
2.3 两阶段训练的分工
| 阶段 | 教师看到什么 | 学生看到什么 | 两者共同预测的目标 | 作用 |
|---|---|---|---|---|
| Stage I:重建 | 源文本与复述指令 | 软记忆与相同复述指令 | 源文本 | 先学会让冻结模型从连续记忆中恢复信息 |
| Stage II:摘要条件续写 | 原始交互历史 | 固定摘要与由历史构造的记忆 | 同一条后续助手响应 | 学习补偿摘要之后剩余的行为差距 |
Stage I 使用 MMFineReason-Full-2.3M 的文本字段。Stage II 从 Stage I 的参数初始化,使用推理和代码轨迹,包括 Open-PerfectBlend 的提示、预先生成的摘要和 Qwen 生成的响应;样本按前置上下文长度组织课程学习。未来响应只作为监督目标,记忆编码器不读取它。(Sec. 2.2,PDF p. 4)
两阶段的区别在于信息保留标准。重建要求尽可能保留源信息;续写要求在摘要已知的情况下,保留能改变后续预测的信息。由于没有显式的去重损失,记忆可以与摘要内容重叠。作者也不要求每个遗漏事实都可从软记忆中独立解码出来。
2.4 反向 KL 如何训练一个冻结主模型的输入接口?
教师和学生使用同一个冻结主模型。对目标响应 $y$ 的位置 $j$,原文 Eq. (2) 为:
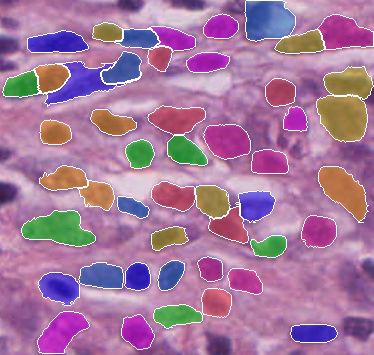
$C_{\mathrm{full}}$ 是教师的原始上下文,$C_{\mathrm{mem}}$ 是学生的压缩上下文,两者都包含持久指令。$y_{ 原文 Eq. (3) 使用学生到教师方向的反向 KL: $\mathcal V$ 为词表;$w_j>0$ 是位置权重,略微强调响应前段。损失覆盖完整响应和完整词表,仅更新 $\phi$。KL 的方向不能交换:这里按学生分布 $q_j$ 加权,约束压缩输入下学生赋予较高概率的续写与教师分布相容。(Sec. 2.2,PDF p. 4) 教学推导:将某个响应位置的概率向量对记忆求导,可把更新路径概括为 中间的 $\partial q_j/\partial M$ 穿过冻结主模型。这说明“冻结”约束的是参数更新,并不意味着在主模型入口截断梯度。摘要已经提供了可用信息,记忆网络收到的梯度便来自压缩上下文仍未匹配教师的部分,这就是残差学习在该方法中的具体含义。 Fig. 3(c) 的横轴是 Stage I 训练步数,纵轴为教师—学生 top-1 一致率,曲线总体从约 78% 上升到约 82%。Fig. 3(d) 在同一残差训练目标和数据顺序下比较 Stage I 初始化与随机初始化:前者在早期上升更快,后期两者逐渐接近约 95%–96%。这些近似值来自图上读数。(PDF p. 3) 曲线支持先学习重建有助于优化残差接口。由于两张图对应不同阶段、不同任务与数据,不能把它们的纵轴差异解释为同一评测从 82% 提升到 96%;它们也没有给出“去掉 Stage I 后最终任务成绩下降多少”的消融结果。 教学例子,非论文实例:历史中,文档 A 支持结论甲,文档 B 支持结论乙;摘要保留了两个结论,却弱化了它们与来源的对应关系。若后续响应需要给结论甲添加引用,仅靠摘要可能把来源写成 B。REMORY 的监督目标会奖励能让主模型更接近完整历史预测的连续表示,因此有机会保留“甲对应 A”的关联线索。 这个例子对应了 SummHay 的结果形状:结论覆盖变化不大,引用却更准确。它并不要求某个单独槽位可被解释为“文档 A”,而是说明哪类遗漏信息能通过预测损失获得训练信号。 实验覆盖 10 个文档集合的全部 92 个查询,主模型固定为 Qwen3.8-27B。四种输入分别是原始上下文、摘要、摘要加额外文本 Summary++、摘要加 REMORY。后三种条件保持基础摘要、问题、主模型和解码一致;Summary++ 使用与软记忆相同的额外位置预算。生成答案时没有工具、存档访问或来源检索,标准洞见及引用只参与评分。(Sec. 3.1,PDF pp. 4–5) 指标都以更高为好,但统计对象不同: 论文使用 GPT-5.6-Sol 和基准的 coverage 提示进行评判,并保留生成失败、格式错误的查询。由于平均口径不同,表中三个汇总值不能简单当作同一分母上的分数,也不能直接用 Coverage 的均值乘 Citation F1 的均值来重建联合得分。 每组主模型内的对照固定权重、Codex CLI 执行框架、提示、工具、解码、预算和压缩策略,双方都能检索精确历史。Qwen 的窗口为 262,144 个位置,GLM 为一百万个位置;干预是在每次压缩后额外加入最多 4,096 个记忆槽位。所用记忆检查点均完成两阶段训练。(Sec. 3.2,PDF p. 5) 这里应与 SummHay 区分:智能体对照允许检索,而且有记忆一侧增加了输入位置;等额外位置的文本补充对照只出现在 SummHay。 作者从 100 条 Qwen BrowseComp 轨迹中取得 488 对下一步动作,固定持久提示和摘要,用此前历史建立评价标准,再由 GPT-5.6-Sol 匿名比较动作。候选推理内容不交给评判器,反事实工具调用不实际执行。该实验更直接地考察记忆通道如何影响压缩后的第一步选择。(Sec. 3.3,PDF p. 6) 来源:原文 Table 1,PDF p. 4;解释及输入长度见 PDF p. 5。 相对摘要,作者报告 Coverage 增加 0.40、Citation F1 增加 4.04、Joint score 增加 3.55 个分数点。4.04 来自未四舍五入的原始值;直接相减表中的 61.03 和 56.98 会得到 4.05。联合得分增益的集合级配对 bootstrap 95% 区间为 $[+0.74,+6.21]$,条件是已经生成并完成评判的输出。 Citation F1 的平均对象会随着覆盖情况变化。作者进一步只看两个摘要条件共同覆盖的 553 条洞见,引用 F1 仍从 57.31 提升到 61.41。这使“记忆改善了同一内容与证据的关联”这一解释更有说服力,而不只依赖覆盖集合的变化。(Sec. 3.1,PDF p. 5) 由报告的均值相减,记忆条件比纯摘要多约 3,631 个位置。5.2% 统计的是摘要与记忆合起来的平均输入,而非只统计记忆槽位。它对应约 19.28 倍的输入位置缩减;这个位置比率没有直接给出计算加速倍数。 结果包含一个具体取舍:相对原始上下文,REMORY 的覆盖率低 4.51 分,引用 F1 高 4.43 分,联合得分低 0.02 分。等联合得分并不意味着两个信息恢复维度都保持不变。另一方面,Summary++ 基本没有改善指标,说明在该协议和预算下,增加一般生成文本未能达到学习到的连续补充表示的效果。 来源:Table 2,PDF p. 5;均为 Qwen3.8-27B,误差项是五轮运行的标准差。 AutomationBench 的验证器任务和 JobBench 的专业任务评判都改善,说明收益覆盖了多种工作形式。两者的分数定义依各自基准而定,因此比较重点是同一任务集内的增益。 来源:Table 3,PDF p. 5。分数为基准报告的百分制成绩,增益是分数点;一轮结果没有跨轮标准差。 GLM 使用更大的上下文窗口,仍从每次压缩的记忆补充中获益。这说明窗口扩大会延后压缩压力,却未消除压缩边界的信息保留问题。原文 Fig. 1 还列出其他前沿模型的公开成绩,但它们来自不同执行框架与协议,论文内部最直接的证据仍是上述同模型对照。 来源:Table 3,PDF p. 5;百分比按 $(\text{无}-\text{有})/\text{无}$ 计算并取一位小数。 “重复”是在单项任务内,同一工具返回完全相同输出的次数,排除规划和轮询;“错误”是失败的命令或显式工具错误。四组比较的重复总数减少 17.9%–29.8%,错误总数减少 25.3%–49.7%。这些变化与更好地使用历史反馈相符,但统计量是整个任务集的事件总数:两条轨迹可能有不同调用次数和长度,因此不能直接解释成每次调用的错误概率下降相同比例。(Sec. 3.2,PDF pp. 5–6) 来源:Tables 2–3,PDF p. 5;相对变化为本次按表格值计算。 成本采用 2026 年 9 月未缓存 API 单价折算主模型和摘要 token,并把软记忆位置计为输入。它排除源特征编码、记忆网络执行和工具开销。因此结果表明多数设置中的按 token 计价的生成费用下降;是否降低真实部署总成本,还取决于新增计算能否被减少的交互抵消。JobBench 展示了得分与费用同时上升的情况。(Sec. 3.2,PDF p. 6) 来源:Sec. 3.3,PDF p. 6。 与完整任务成绩相比,这项实验把观察点前移到压缩后的第一步,并固定文本检查点。因此,偏好更容易与新增记忆通道联系起来。其结果变量是拟议动作的质量判断;反事实调用没有执行,不能把 70.7% 解释为任务成功率,也不能据此确定若真正走另一条动作分支会得到什么结果。 两个并行运行的 Qwen 模拟交易账户使用相同上下文策略。以 9 月 23 日为截止点,基于初始 20,000 美元虚拟本金和已结算市场计算收益: 来源:Sec. 3.4,PDF p. 6。 图源:Fig. 4,PDF p. 6。左面板横轴是 2026-09-22 的 UTC 时间、纵轴是输入位置数;灰线表示无记忆,紫线表示有记忆,双方都保留增长后重置的轨迹。右面板统计的是独立的 9 月 20–23 日评测中的压缩间隔,单位为分钟;无/有记忆分别有 51/41 个不跨重启的会话内间隔。有记忆条件中两个间隔超出显示范围,但仍计入箱线统计。 压缩总次数从 56 降到 45,与响应总数下降同时发生;按每千次响应归一化,压缩次数反而上升。因此该案例更直接说明交互更少、平均上下文略短,从而生成费用更低。两个账户选择市场和入场时机不同,ROI 的差异不宜用来估计记忆机制的独立收益效应。 在一项 Terminal-Bench 细胞分割任务中,压缩之前的一次重构删除了辅助函数。摘要保留了已知错误和备份文件身份,却没有保留确切编辑命令。在摘要与记忆共同可用的情况下,主模型重新读取两个文件,恢复辅助函数,最终通过全部九项验证器测试。(Sec. 3.4,PDF pp. 6–7) 图源:Fig. 5,PDF p. 7,复制作者提供的两张原始 PNG。该轨迹展示了摘要、记忆和文件检索如何共同支持修复;由于模型确实重新读取了文件,不能逐项把恢复的细节归因于软记忆。 按原文 Sec. 4 的定位,摘要与检索类方法解决的是“保留怎样的显式检查点、何时取回原文”,连续压缩类方法解决的是“如何把长输入映射为可供主模型使用的短表示”。REMORY 将两条思路结合:保留摘要及检索接口,把连续表示训练为以已有摘要为条件的预测补充。(PDF p. 7) 这张表归纳原文的相关工作定位;最有辨识度的组合是固定主模型、摘要条件记忆、两阶段训练及跨压缩边界的状态延续。 SummHay 在禁用检索、固定摘要的情况下提升引用质量,且额外文本在同位置预算下没有取得类似收益,支持学习连续补充通道的价值。端到端任务表现和下一步动作偏好进一步说明,这类信息可以影响实际决策过程。来源归属收益大于覆盖收益,为“记忆帮助建立内容与证据的关联”提供了具体证据。 各设计组件的独立贡献仍未完全拆开:论文没有分别消融摘要条件门控、层级压缩结构和最终记忆预算;Stage I 初始化的比较主要是训练流上的一致率曲线。若要确定收益中有多少专门来自“摘要条件化”,最直接的后续比较是同容量、同训练预算的非摘要条件记忆网络。这是本次分析提出的实验问题。 实现细节与训练配方。 正文给出结构来源、块大小、槽位上限、参数量、数据来源与损失,但没有展开记忆网络层级配置、层级压缩的具体调度、优化器及完整训练超参数。因此它足以解释方法主线,尚不足以仅按论文精确复建同一检查点。(Sec. 2,PDF pp. 3–4) 总计算成本。 4,096 是最终可见记忆的长度上限,源编码和中间表示可以更大;训练需要经冻结主模型反传,推理增加十亿级网络计算。现有费用表没有把这些开销计入,实际系统应结合每次压缩延迟、显存占用和总任务时间评估收益。(Secs. 2.1、3.2,PDF pp. 3、6) REMORY 最值得带走的启发是:压缩的目标可以定义为保住未来行为所需的信息,而可读摘要可以成为学习这种表示的条件。 摘要、软记忆与精确检索各自承担适合自己的工作,论文中的引用质量与行动改进正是这种分工的实证体现。2.5 训练曲线支持什么?
2.6 一个帮助理解“预测补偿”的例子
三:实验——把表示质量、任务完成和下一步动作分开比较
3.1 SummHay:固定问题,隔离压缩表示
3.2 智能体实验:同一主模型内控制其余条件
基准 任务内容 任务数 主模型与运行轮数 判定方式 BrowseComp 网络研究与检索 1,266 Qwen、GLM;各配置 1 轮 匹配的 GPT-5.6-Sol 评判 Terminal-Bench 2.1 命令行任务 89 Qwen、GLM;各配置 1 轮 任务验证器 AutomationBench 业务自动化工作流 600 Qwen;各配置 5 轮 任务验证器 JobBench 专业任务 65 Qwen;各配置 5 轮 匹配的 GPT-5.6-Sol 评判 3.3 下一步动作:固定同一检查点
四:结果——最强证据来自哪些比较?
4.1 来源归属改善,接近完整上下文的联合得分
输入表示 Coverage ↑ Citation F1 ↑ Joint score ↑ 原始上下文 72.46 56.60 43.41 摘要 67.55 56.98 39.84 摘要 + 额外文本(Summary++) 67.52 56.94 39.78 摘要 + REMORY 67.95 61.03 43.39 表示 平均输入位置数 相对原始上下文 原始上下文 96,872 100% 摘要 1,393 约 1.44% 摘要 + REMORY 5,024 约 5.19%,论文取 5.2% 4.2 端到端收益覆盖工作流、命令行与网络研究
工作流结果:五轮运行
基准 无残差记忆 有残差记忆 分数增益 AutomationBench $35.5\pm1.3$ $45.3\pm1.0$ +9.8 JobBench $33.4\pm1.25$ $41.0\pm1.41$ +7.6 Terminal-Bench 与 BrowseComp:各配置一轮
主模型 基准 无记忆 有记忆 分数增益 Qwen3.8-27B Terminal-Bench 2.1 71.9 76.4 +4.5 Qwen3.8-27B BrowseComp 74.0 77.0 +3.0 GLM-5.3-Flash Terminal-Bench 2.1 84.3 87.6 +3.3 GLM-5.3-Flash BrowseComp 84.9 89.0 +4.1 重复输出和工具错误总数下降
主模型 / 基准 重复输出:无 → 有 相对减少 工具错误:无 → 有 相对减少 Qwen / Terminal-Bench 459 → 377 17.9% 933 → 568 39.1% Qwen / BrowseComp 25,801 → 18,105 29.8% 25,244 → 12,698 49.7% GLM / Terminal-Bench 334 → 240 28.1% 664 → 496 25.3% GLM / BrowseComp 8,316 → 5,834 29.8% 7,498 → 5,412 27.8% 生成费用通常减少,但计算口径必须一致
主模型 / 基准 无记忆:美元/任务 有记忆:美元/任务 相对变化 Qwen / AutomationBench 0.59 0.53 −10.2% Qwen / JobBench 3.09 3.21 +3.9% Qwen / Terminal-Bench 4.29 2.86 −33.3% Qwen / BrowseComp 5.39 4.69 −13.0% GLM / Terminal-Bench 3.27 3.05 −6.7% GLM / BrowseComp 5.65 5.00 −11.5% 4.3 固定摘要后,下一步动作更常受到评判器偏好
比较结果 对数 占全部 488 对 有记忆动作获胜 345 70.7% 平局 21 4.3% 有记忆动作落败 122 25.0% 4.4 案例一:长期模拟交易中的上下文与费用
记录项 无残差记忆 有残差记忆 已结算 ROI −11.86% +5.11% 记录的生成费用 303.81 美元 170.30 美元 响应数 5,336 3,013 完成的压缩次数 56 45 每千次响应的压缩次数 10.5 14.9 平均活跃上下文位置数 105,372 101,185(含记忆) 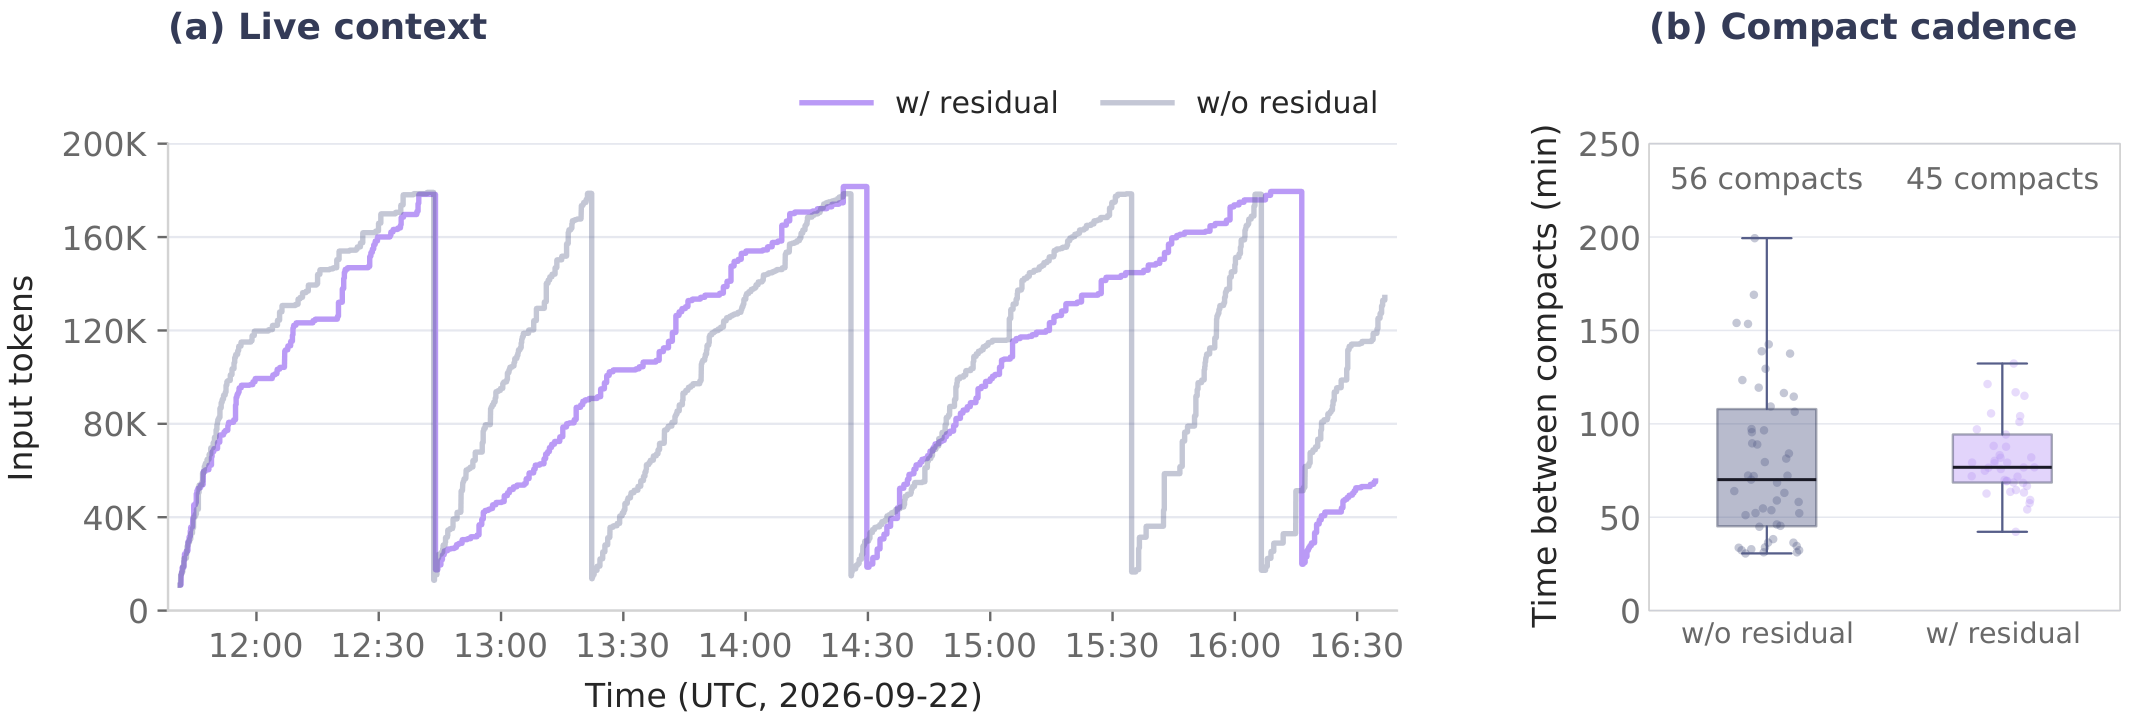
4.5 案例二:细胞分割任务中的错误恢复
任务图像 主模型实际查看的分割叠加图 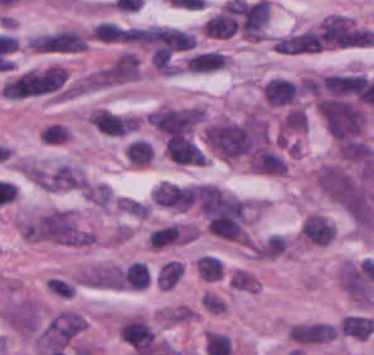
五:结论——贡献、方法位置与实际取舍
5.1 与相关方法的关系
原文讨论的方向 REMORY 与其关系 ReadAgent、MemGPT、ReSum、AgentFold 等摘要/记忆管理方法 保留文本检查点及原始记录访问,增加一个学习得到的连续通道 AutoCompressors、Gist Tokens、ICAE、LCLMs 等连续上下文表示 使用软记忆压缩历史,同时把已生成摘要纳入条件 基于分布匹配的提示压缩 以完整历史下的续写预测作为保留信息的行为标准 Transformer-XL、Recurrent Memory Transformer 等跨片段状态 在连续压缩边界间传递更新后的摘要与记忆 5.2 哪些设计已经得到较直接支持?
5.3 复现与部署时最关键的两个缺口