What can linear attention learn from nonlinear teachers in-context?:中文研读笔记
- 作者:Mary Letey、Arman Rysmakhanov、Yue M. Lu、Cengiz Pehlevan、Jacob A. Zavatone-Veth;前两位为共同一作。
- 版本:arXiv:2610.10761v1,提交于 2026-10-07;本次获取与研读日期:2026-10-29。
- 原文:在线 PDF · 本地 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码,与本版印刷页码一致。
- 发表:已接收至 NeurIPS 2026 的 2nd Workshop on Principles of Generative Modeling(PriGM),依据作者发表列表中的 Workshop 归属;未查到单篇正式论文集或公开录用决定页面。这里指 Workshop,非 NeurIPS 主会论文。查证截至 2026-10-29。
- 代码:代码待发布。作者提供的仓库目前仅有标题为
single-index-icl的 README,未见实现文件;这与论文首页“图表代码已提供”的表述存在时间上的落差。查证截至 2026-10-29。
论文总览
这篇论文问:一个以简化线性注意力为基础的上下文学习器,在遇到非线性回归任务 $y=f(\boldsymbol{x}^{\top}\boldsymbol{w})+\varepsilon$ 时,究竟能够提取多少任务信号?作者给出的答案是:在指定的高维比例极限与无正则设置下,只有 $f$ 在高斯分布下的一阶 Hermite 分量进入可学习信号,其余分量进入泛化误差,作用类似额外噪声。
关键归约是把非线性任务替换为线性任务:任务协方差乘 $a_1^2$,噪声方差从 $\rho$ 换成 $\rho_{\mathrm{nonlinear}}=\rho+\sum_{m\ne1}a_m^2$。这里 $a_1=\mathbb E[g f(g)]$,$g\sim\mathcal N(0,1)$。有了一阶分量,已有线性 ICL 的误差理论便可复用;没有一阶分量,训练变成无信号回归,误差在预训练样本数接近参数规模时出现插值峰。
论文的贡献是给出一种可计算的表达能力限制:预训练序列更多、上下文更长、训练任务更多,可以改善一阶分量的估计,却不能消除当前预测器无法表达的非线性残差。两组小维度合成实验分别展示噪声等效与任务多样性转变。图 1 的数值解释需要注意正文公式与图例的尺度不一致,详见第四部分;图 2 更直接地展示了抬高的误差下限。(Sec. 3,PDF pp. 3–4,Result 1、Figs. 1–2。)
结构地图
| 原文章节 | 作用 | PDF 页码与关键内容 |
|---|---|---|
| 1 Introduction | 从线性任务理论转向非线性教师,界定简化模型 | pp. 1–2 |
| 2 Setup | 单指标任务、数据比例、预测器及训练方法 | pp. 2–3,Eqs. (1)–(7) |
| 3 Theoretical results and analysis | 非线性—噪声等效、无信号分支与任务多样性转变 | pp. 3–4,Eqs. (8)–(11),Result 1,Figs. 1–2 |
| 4 Conclusion | 总结不可学习非线性带来的误差下限 | p. 4 |
| A Gaussian equivalent for $\boldsymbol{w}^{\top}\boldsymbol{x}$ | 用任务范数集中解释标准高斯近似 | p. 7 |
| B Population averages | 推导标签、特征及交叉二阶矩 | pp. 8–9,Lemma 1,Eqs. (12)–(14) |
| C Derivation of the ICL formula | 接入已有线性理论,单独求解 $a_1=0$ | p. 10,Eq. (15) |
致谢与参考文献在 PDF pp. 5–6。本文没有独立实验章节,数值验证集中在 Sec. 3。
一:动机——非线性教师暴露了什么瓶颈?
线性回归 ICL 的已有理论能够分析预训练规模、上下文长度与任务多样性如何影响测试误差,但教师函数本身是线性的。这很容易把“能够从上下文估计线性规则”与“能够从上下文学习一般规则”混在一起。作者把教师扩展到单指标模型(single-index model):任务由方向 $\boldsymbol w$ 指定,标签由该方向上的投影经过固定非线性 $f$ 得到。
“单指标”表示非线性只依赖一个标量 $\boldsymbol{x}^{\top}\boldsymbol w$,并不表示任务方向已知。预训练要跨任务学习可复用的参数;测试时面对新的 $\boldsymbol w$,只能利用当前 prompt 中的例子预测查询标签。该设置保留了任务推断,同时把非线性的来源控制得很清楚。
作者关注的是 reduced linear-attention predictor,而非任意含有线性注意力模块的完整网络。其输出对查询输入始终线性,因此一个自然问题是:非线性目标虽然无法被完整表达,是否会以某种方式改变学习过程?论文的答案不是简单的“完全学不了”,而是把目标拆成可学习投影与不可学习残差,进而计算后者如何影响有限样本误差。(Sec. 1,PDF pp. 1–2。)
二:方法——任务、预测器与 Hermite 分解
2.1 三种数据规模分别控制什么
每条 prompt 含 $\ell$ 个上下文例子和一个查询输入:
输入独立采样自 $\mathcal N(\boldsymbol0,I_d/d)$,标签噪声独立且方差为 $\rho$。同一 prompt 共享同一个任务 $\boldsymbol w$。预训练先从 $\mathcal N(\boldsymbol0,C_{\mathrm{train}})$ 抽取 $k$ 个任务,均匀分配到 $n$ 条序列;测试任务重新从 $\mathcal N(\boldsymbol0,C_{\mathrm{test}})$ 抽取,允许任务分布发生变化。(Sec. 2,PDF p. 2,Eq. (1)。)
| 符号 | 含义 | 高维比例 | 主要作用 |
|---|---|---|---|
| $d$ | 输入维度 | 基础尺度 | 预测器参数量约为 $d^2$ |
| $\ell$ | 每条 prompt 的上下文例子数 | $\alpha=\ell/d$ | 当前任务统计量的估计质量 |
| $k$ | 不同预训练任务数 | $\kappa=k/d$ | 训练任务覆盖的方向 |
| $n$ | 预训练序列总数 | $\tau=n/d^2$ | 跨任务参数拟合的样本负载 |
| $\rho$ | 标签噪声方差 | — | 观测噪声,不是标准差 |
| $\lambda$ | 岭正则参数 | 主结果取 $\lambda\to0$ | 控制参数估计与插值行为 |
三种比例不能互相替代。例如增加同一批任务的训练序列会增大 $\tau$,却不增加 $\kappa$。主分析取 $d\to\infty$,同时保持 $\alpha,\kappa,\tau$ 为常数量级。(Eq. (3),PDF p. 2。)
2.2 模型究竟在计算什么
把上下文压缩成两个统计量:
前者是标签与输入的经验相关,后者是标签的经验二阶矩。论文构造
本次分析中的展开:若将参数写成 $\Gamma=[A,\boldsymbol b]$,其中 $A\in\mathbb R^{d\times d}$、$\boldsymbol b\in\mathbb R^d$,则
这样便能看清表达瓶颈:上下文改变了预测方向 $A\boldsymbol u+s\boldsymbol b$,但对查询输入仍是没有截距的线性函数。标签平方 $s$ 的存在没有给查询端引入非线性,也不能直接输出一个常数偏置。(Sec. 2,PDF p. 3,Eqs. (4)–(5)。)
训练时把 $\Gamma$ 和 $H^\mu$ 向量化为 $\boldsymbol\gamma$、$\boldsymbol h_\mu$,在约 $d^2$ 维特征空间做岭回归:
这是跨 prompt 学习共享参数;测试时 $\Gamma^*$ 固定,只重新计算 $\boldsymbol u,s,H$。论文分析的是这一闭式训练问题,而不是完整 Transformer 的梯度训练动力学。无正则情形按 $\lambda\to0$ 理解,样本不足时对应相应的极限解。(Eq. (6),PDF p. 3。)
2.3 一阶 Hermite 分量不是一阶 Taylor 项
在标准高斯测度下,用正交归一 Hermite 多项式展开:
其中 $h_0(g)=1$、$h_1(g)=g$、$h_2(g)=(g^2-1)/\sqrt2$,并且 $\mathbb E[h_m(g)h_j(g)]=\delta_{mj}$。所以
这里度量的是在整个高斯输入分布下与线性函数的相关性,不是 $f$ 在零点的局部导数。下表是教学例子,由上述定义直接计算,非原文实验:
| $f(g)$ | $a_1$ | 非一阶分量的平方能量 | 对该预测器的意义 |
|---|---|---|---|
| $g$ | $1$ | $0$ | 完全在线性可表达范围内 |
| $g^2-1$ | $0$ | $2$ | 非零目标,但没有线性可学习信号 |
| $g^3$ | $3$ | $6$ | 可利用 $3g$,剩余 $g^3-3g$ 无法表达 |
| 常数 $c$ | $0$ | $c^2$ | 没有查询截距,常数项也进入残差 |
特别地,“非线性函数”不等于“没有线性模态”。$g^3$ 在 Taylor 表达中没有一次项,却有强的一阶 Hermite 分量。(原文定义:Eq. (2),PDF p. 2。)
2.4 两个噪声量必须分清
定义
$\rho_f$ 是标签的总二阶矩;若 $a_0\ne0$,它不是中心化方差。$\rho_{\mathrm{nonlinear}}$ 则是观测噪声与线性预测器不可利用部分的总平方能量。其求和包括 $m=0$,不只是二阶及更高阶模态。将这些部分称作“等效噪声”,指它们在所研究的渐近误差公式中发挥的作用,不表示原始非线性残差与输入统计独立。(Eq. (8),PDF p. 3。)
三:理论分析与验证——归约为什么成立
3.1 标准高斯近似需要任务范数集中
固定 $\boldsymbol w$ 时,$\boldsymbol x^{\top}\boldsymbol w$ 精确服从 $\mathcal N(0,\|\boldsymbol w\|^2/d)$,方差并不自动等于 1。令 $\sigma_{\boldsymbol w}=\|\boldsymbol w\|^2/d$,对高斯任务有
因此 Result 1 对训练与测试协方差都要求
第一条固定总信号强度,第二条让范数波动消失。有效秩 $r_{\mathrm{eff}}=(\operatorname{tr}C)^2/\operatorname{tr}(C^2)$ 因而必须发散;例如把全部信号放在固定数量的方向上,不满足此条件。结合 $f$ 至多多项式增长的假设,作者在后续矩计算中渐近地用标准高斯变量替代投影。(Result 1,PDF p. 3;Appendix A,PDF p. 7。)
3.2 决定信号通道的是 $\mathbb E[y\boldsymbol x]$
将输入分成平行于 $\boldsymbol w$ 与垂直于它的两部分,独立高斯噪声和垂直分量均不贡献平均相关。取 $\omega=\|\boldsymbol w\|^2/d\to1$ 后:
因此上下文相关向量的平均方向只看见一阶 Hermite 系数。另一方面,有限长度上下文中的波动仍然受到全部标签能量 $\rho_f$ 影响。论文 Appendix B 的主导矩,在 $\omega\to1$ 后可写为
最后一式采用原文的向量化排列;换一种排列只会相应置换坐标。$\rho_f/\alpha$ 项说明更长上下文可以减弱统计量噪声,$a_1^2\boldsymbol w\boldsymbol w^{\top}$ 是任务信号结构。原推导还写出了涉及 $\mathbb E[g^2f(g)^2]$、$\mathbb E[gf(g)^3]$、$\mathbb E[f(g)^4]$ 的有限 $\ell$ 修正,并在主导极限中省略。(Appendix B,PDF pp. 8–9,Eqs. (12)–(14)。)
3.3 主结果:把线性理论中的三个量替换掉
对于 $a_1\ne0$,考虑替代教师
其任务协方差为 $a_1^2C$,标签总二阶矩为 $a_1^2+\rho_{\mathrm{nonlinear}}=\rho_f$,与上述主导矩匹配。把这些矩代入既有线性任务的随机矩阵推导,得到
右侧不是只增加标签噪声:训练与测试的信号协方差也一起缩放。因此非线性可以同时削弱有效信号并增大相对噪声。各向异性和训练—测试任务对齐的结构仍保留在 $C_{\mathrm{train}},C_{\mathrm{test}}$ 中。(Result 1,Eq. (9),PDF p. 3;Appendix C,PDF p. 10。)
这是一条无正则渐近风险归约。作者通过高斯近似、主导二阶矩与先前工作的 resolvent 分析得到它;Appendix A 明确采用渐近替换,Appendix B 忽略有限长度项。阅读时应把它作为该高维模型的结论,而非有限维分布相同的恒等式。
3.4 没有一阶分量时,为什么还会有双下降?
当 $a_1=0$,标签与特征的主导交叉矩消失,任务相关项也从特征二阶矩中消失。令 $q=\rho_{\mathrm{nonlinear}}/\alpha$,Appendix C 的辅助量满足
定义 $\widetilde\lambda=\lambda(1+\chi_0)$,在 $\lambda\to0$ 下,$\tau<1$ 时得到 $\widetilde\lambda=q(1-\tau)/\tau$,$\tau>1$ 时得到 0。代回误差公式:
参数数目是 $d(d+1)$,而 $n=\tau d^2$,所以渐近插值阈值是 $\tau=1$。在正的残差能量下,靠近阈值,拟合偶然样本相关会放大误差;$\tau\to\infty$ 时才回到 $\rho_{\mathrm{nonlinear}}$。此分支不再依赖 $\alpha$ 或 $\kappa$,因为没有可供它们改善的一阶信号。(Eq. (10),PDF p. 3;Eq. (15),PDF p. 10。)
由公式直接得到的教学数值是:$\tau=0.5$ 与 $\tau=2$ 时误差均为 $2\rho_{\mathrm{nonlinear}}$,$\tau=0.9$ 时为 $10\rho_{\mathrm{nonlinear}}$。这些倍数是推导结果,不是论文的模拟点。也由此可见,观察到双下降曲线本身,并不能说明模型已经学到了非线性任务规则。
四:结果——两张图分别验证什么
4.1 Figure 1:有限预训练数据下的噪声等效
原文 Fig. 1,PDF p. 4;直接使用作者矢量图转出的 PNG,保留原坐标和图例。
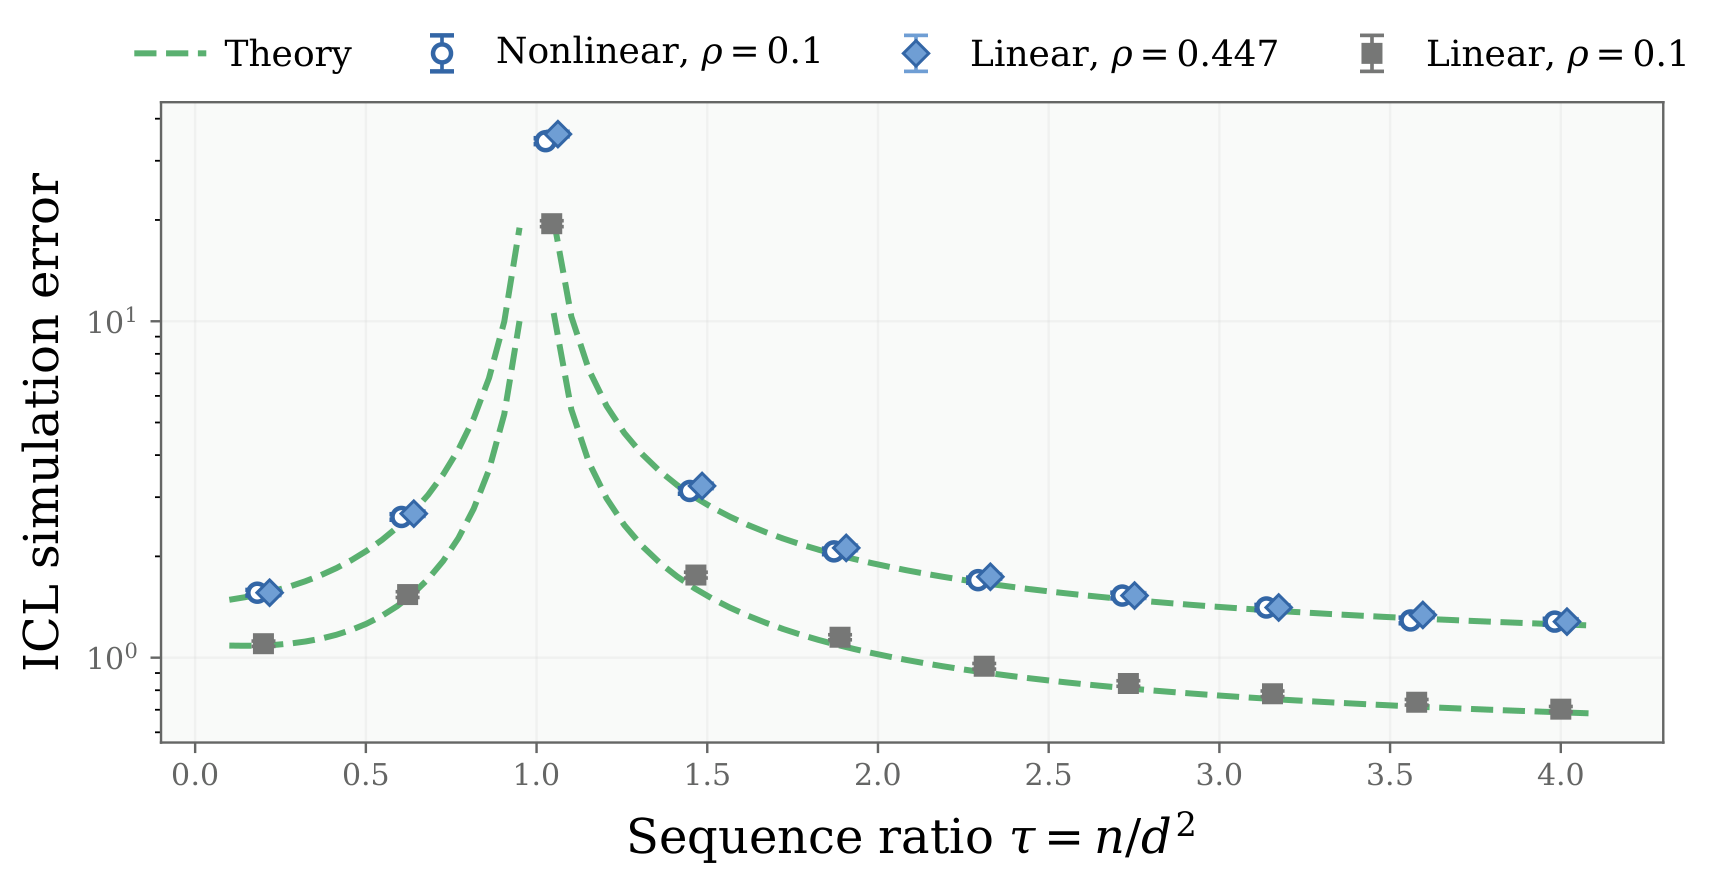
横轴是序列比例 $\tau=n/d^2$,纵轴是对数刻度的 ICL simulation error,数值越低越好。空心圆为非线性教师,菱形为提高噪声后的线性教师,灰方块为原噪声水平的线性教师,绿色虚线为理论曲线。固定 $d=64$、$\alpha=2$、$\kappa=2$、$C_{\mathrm{train}}=C_{\mathrm{test}}=I_d$;因此上下文长度与任务数均为 128。
| 比较对象 | 教师 | 图例中的噪声 $\rho$ | 比较作用 |
|---|---|---|---|
| 非线性目标 | $\sin(\boldsymbol w^{\top}\boldsymbol x)$ | $0.1$ | 检验非线性残差的影响 |
| 噪声调整后的线性目标 | $\boldsymbol w^{\top}\boldsymbol x$ | $0.447$ | 对照等效噪声预测 |
| 原噪声线性目标 | $\boldsymbol w^{\top}\boldsymbol x$ | $0.1$ | 展示额外残差造成的差距 |
原图展示非线性点与噪声调整后的线性点接近,二者都在 $\tau\approx1$ 附近出现高误差,并在右侧下降。比较角色是理论等效模型和原始线性基准,没有完整 Transformer 或其他非线性学习器的性能比较。图中有误差棒,但正文和图注未定义其统计口径,因此不据此作显著性判断。
解释这张图时必须处理尺度问题。 对 $f(g)=\sin g$、$\rho=0.1$,从论文定义直接算得
这是本次依据定义补充的解析计算。$0.447$ 对应将一阶信号归一为单位强度之后的噪声方差。而 PDF p. 3 的 Fig. 1 说明文字写成 $(a_1^2+\rho_{\mathrm{nonlinear}})/a_1^2$,代入会得到 $1.447029$;这个量是归一化标签总二阶矩,与图例噪声方差相差 1。
此外,把非线性问题的标签按 $1/a_1$ 缩放时,MSE 也应按 $1/a_1^2$ 缩放;图轴和图注没有说明是否进行了这一归一化。故原图的重合应理解为作者展示的等效比较,不能据此断言两个原始教师在未缩放的 MSE 下直接相等。主结果 Eq. (9) 本身已明确要求同时缩放协方差,是更清楚的结论表述。
4.2 Figure 2:跨过任务多样性转变后,误差下限仍然抬高
原文 Fig. 2,PDF p. 4;直接使用作者原图。
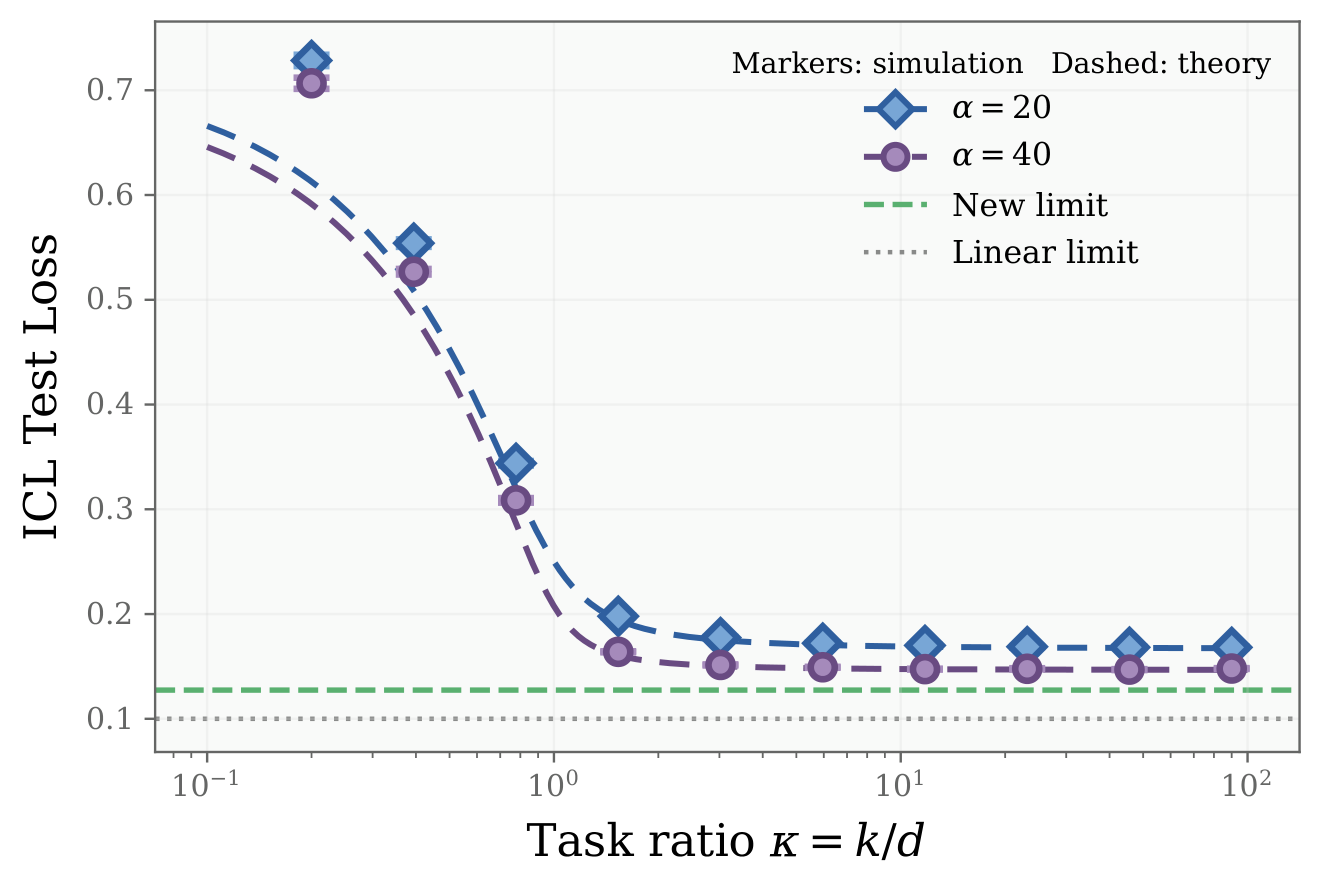
横轴是对数刻度的任务比例 $\kappa=k/d$,纵轴为 ICL 测试平方误差,越低越好。蓝色菱形对应 $\alpha=20$,紫色圆点对应 $\alpha=40$;点是模拟,虚线是理论。绿色水平线是新的非线性下限,灰色点线是原标签噪声下限 $\rho=0.1$。
设置为 $d=32$、$f(g)=\tanh g$、$\rho=0.1$、$\tau=\alpha/2$,对应 Sec. 3 的各向同性任务讨论。两组上下文与预训练规模分别是:
| $\alpha$ | $\ell=\alpha d$ | $\tau$ | $n=\tau d^2$ |
|---|---|---|---|
| 20 | 640 | 10 | 10,240 |
| 40 | 1,280 | 20 | 20,480 |
这张表由图注比例换算而来。两条曲线的比较同时增加了上下文长度和预训练序列数,不能归因于单独增加上下文。
原文承接已有线性理论指出,当 $\alpha,\tau\to\infty$ 且 $\tau\propto\alpha$ 时,在 $\kappa=\operatorname{rank}(C_{\mathrm{train}})/d$ 附近存在任务多样性的转变。对于 $C_{\mathrm{train}}=C_{\mathrm{test}}=I_d$,阈值为 $\kappa=1$。训练任务较少时难以覆盖新的任务方向;任务足够多时,模型能够把一阶规则推广到新任务,但对于 $a_1\ne0$,其极限仍是
图中有限维曲线在 $\kappa\approx1$ 一带快速下降,而非出现不连续跳变;大 $\kappa$ 时两组曲线仍高于绿色下限,符合有限上下文与有限训练规模尚有估计误差的解释。达到该各向同性下限的条件是任务覆盖充分且 $\alpha,\tau$ 增大,不要求 $\kappa$ 本身也必须趋于无穷。(Sec. 3,Eq. (11),PDF pp. 3–4。)
为解释绿色水平线,本次按论文定义对高斯期望作数值积分,得到
也就是说,下限相对原噪声水平多出约 $0.027415$ 的平方误差。这些小数是由公式补充计算的,不是原文表格报告值或从图像读出的精确实验数据。它们解释了为何绿色线在 $0.1$ 上方,也说明剩余误差不全来自有限任务覆盖。
五:结论——应如何使用这条理论
论文最有用的贡献是把函数复杂度转换为两个可计算量:一阶信号强度 $a_1^2$ 和非一阶残差能量 $\rho_{\mathrm{nonlinear}}-\rho$。在所分析的预测器中,增加数据主要解决估计问题;提高能够学习的函数阶数,则需要改变查询到输出的函数形式。非线性读出或特征变换因而是自然方向,原文 Introduction 也据此区分了包含非线性读出的同期工作。
实际理解有三个关键落点。第一,先查看 $\mathbb E[g f(g)]$,不要凭函数的 Taylor 次数判断它是否有线性信号。第二,分清 $\alpha$、$\kappa$、$\tau$:上下文统计噪声、任务覆盖和参数估计样本量是不同问题。第三,比较线性与非线性教师时保持信号尺度和 MSE 单位一致;图 1 的归一化缺口正说明这一步会改变数值解释。
适用范围由模型本身限定:独立各向同性高斯输入、高斯任务且有效秩增长、至多多项式增长的 $f$、指定比例极限和无正则风险。带非线性读出、多层非线性变换或不同记忆更新规则的网络,需要重新分析其可利用的统计量。当前两组实验验证了 $d=64$ 的正弦教师和 $d=32$ 的双曲正切教师;它们支持本文的机制分析,尚不能据此给实际语言模型作数值性能预测。
值得在组会上继续讨论的是:如果在查询端加入一个可学习的非线性映射,原先进入 $\rho_{\mathrm{nonlinear}}$ 的哪些 Hermite 模态可以重新成为信号?这会直接把本文的误差分解转化为架构设计问题。