From Hybrid Attention to Hybrid Position:中文研读笔记
论文:Mechanics of Long-Context Hybrid Models Part 1.1: From Hybrid Attention to Hybrid Position
作者:Xiaoran Liu、Ziwei He、Xipeng Qiu;Fudan University / Shanghai Innovation Institute / OpenMOSS Team
版本:arXiv:2610.10114v1,提交于 2026-10-07;获取与研读日期:2026-10-10。
材料与成品:原文 PDF · 英文汇报 PDF · 可编辑 Beamer。下文页码均为从 1 开始的 PDF 页码,与本版印刷页码一致。
论文总览
本文研究的是:为什么少量全局注意力与大量高效注意力能够协作,以及这种协作为什么在“直接外推”和“继续训练”时表现不同。 作者将混合架构重新解释为混合位置归纳偏置:无显式位置编码的全注意力(NoPE)负责较粗的全局定位,RoPE、滑窗注意力或带门控的线性注意力负责更集中的信息处理。关键不只是更换注意力算子,还包括两类模块的比例、作用范围和训练阶段。
两条最实用的结论分别针对不同目标。对于滑窗注意力(SWA)混合模型,短上下文训练时的小窗口有利于外推,但长上下文继续预训练时一直保留小窗口,可能让优化过度集中在局部预测;扩大窗口并采用 LongCE 可以缓解。对于 GLA/GDN 线性注意力(LA)混合模型,作者在推理时限制 LA 的作用范围,同时增强 NoPE 的注意力 logit 尺度,明显改善训练长度之外的表现。
最醒目的结果是:776M 的四种 GLA/GDN-NoPE、按层/按头混合模型,在仅以 4K 长度训练后,通过 SWLA + Log 在 64K 的 NIAH-SK1 上均达到 100%。 同一设置下 SK2、SK3 仍有明显下降,其他规模也不都达到 100%;这一结果应理解为特定检索任务上的 16 倍长度外推。(Table 1,p. 23;Table 16,p. 51)
结构地图
| 原文章节 | 核心问题 | PDF 位置 |
|---|---|---|
| §1 Introduction;§2 Related Work | 混合架构为何值得从位置偏置角度分析 | pp. 2–4 |
| §3.1 Setup;§3.2 Short-Context Training | 统一架构与训练设置;4K 训练后的外推 | pp. 4–7,Figs. 1–5 |
| §3.3 Long-Context Training | 32K 继续训练为何使 SWA 与 LA 排名反转 | pp. 7–10,Figs. 6–9 |
| §4.1 Ratio Ablation and Noise Analysis | 全局分支越多是否越好;谁更怕噪声 | pp. 10–12,Figs. 10–11 |
| §4.2 Attention Analysis of Hybrid Position | 熵、命中率、检索头揭示怎样的分工 | pp. 11–14,Figs. 12–13 |
| §5.1 Short-Context Learning Trap of SWA Hybrids | PPL 曲线与参数变化如何解释训练陷阱 | pp. 14–16,Figs. 14–15 |
| §5.2 Short-Window Weariness and Long-Window Laziness | 窗口大小与 LongCE 如何改善训练 | pp. 15–18,Figs. 16–20 |
| §6.1 Extended Hybrid Position Analysis | 如何分析没有概率注意力分布的 LA | pp. 17–20,Eq. (1)、Figs. 21–22 |
| §6.2 Length Extrapolation of LA Hybrid | SWLA 实现与 EME 外推策略 | pp. 20–23,Figs. 23–25、Table 1 |
| §6.3 Efficiency Comparison;§7 Conclusion / Limitations | 性能收益的工程条件与研究范围 | pp. 22–25,Figs. 26–27 |
| Appendix A Extended Verification | 训练细节、LongBench、学习率、层布局及开放问题 | pp. 32–37,Table 2、Figs. 28–36 |
| Appendix B Detailed Evaluation Results | 各规模、架构、窗口、外推策略的详细分数 | pp. 38–60,Tables 3–25 |
一:动机——“更长”包含两个不同问题
**长度外推(length extrapolation)**是在训练结束后,让模型处理比训练时更长的输入,不再更新权重。本文主要从 4K 训练长度外推到 8K、16K、32K、64K。**上下文扩展(context extension)**则是在短上下文预训练后,用 32K 文本继续训练 5B tokens。经过这个阶段,64K 仍然属于外推,不能把扩展后的所有评测长度都称为训练范围内。
这一区分决定了如何评价架构。若一种模型在 4K 训练后直接看 64K 很稳定,它可能只是很好地限制了位置分布变化;这并不自动说明它能从额外的长文本训练中学到更多长程依赖。反过来,能够充分拟合 32K 训练数据的模型,也可能在超出训练长度时迅速退化。
传统全注意力用 RoPE 显式编码相对位置;SWA 限制可见的键位置;GLA/GDN 则通过历史状态的门控与更新引入依赖距离和内容的偏置。NoPE 去掉显式位置编码,但依然处于有因果掩码、深度堆叠和其他模块的网络中,不能据此把整个模型看成没有任何顺序信息。本文希望把这些差异放到同一个“局部/位置偏置分支与全局分支协作”的框架内。(§§1–3,pp. 2–4)
二:方法——从注意力类型到位置分工
2.1 模型名称、输入输出与混合方式
输入是因果语言模型的 token 序列,每个注意力模块从隐藏表示得到 query、key、value,再将上下文信息写回当前 token 的隐藏表示。本文比较的主要模块如下。
| 名称 | 直接读取历史的方式 | 本文中的位置偏置与角色 |
|---|---|---|
| RoPE full attention | 对全部可见历史做 softmax 加权 | 显式旋转位置编码;传统基线 |
| NoPE full attention | 对全部可见历史做 softmax 加权 | 去除显式 RoPE;倾向全局粗定位 |
| SWA | 仅对最近窗口内历史做 softmax 加权 | 默认窗口 128,窗口内仍使用 RoPE |
| GLA | 门控线性递归状态 | 门控连乘产生内容相关的位置偏置 |
| GDN | 带门控及 delta 更新的递归状态 | 同样带隐式位置偏置,但更新机制不同 |
**按层混合(LH)**的默认布局是在三个高效注意力层之后插入一个 NoPE 全注意力层;**按头混合(HH)**让两类头在同层并行协作。默认比例 3:1 指“位置偏置/高效模块 : NoPE”,不是全局模块占 75%。例如 SWA-NoPE-LH 表示按层混合 SWA 与 NoPE;SWA-RoPE-LH 的全局层仍带 RoPE。
还需区分两种容易混淆的滑窗:SWA-NoPE 默认从训练开始就使用 128-token SWA;SWA-4k-NoPE 是给原本 RoPE-NoPE 全注意力模型的 RoPE 分支施加 4K 推理窗口。它们的训练经历不同。
全局 NoPE 保留全部历史 KV。因此,即使高效分支是常数状态,整个混合模型仍有随长度增长的全局 KV 缓存和全注意力计算。RoPE-NoPE 混合本身更没有消除全注意力的二次计算量。(§3.1,p. 4;§3.2,pp. 4–7)
2.2 为何没有 RoPE 的线性注意力仍有位置偏置
原文以 GLA 为例,指出 $q_t$ 与 $k_s$ 的交互包含门控乘积:
这里 $\boldsymbol{\alpha}_i$ 是第 $i$ 个 token 的门控向量;它与下节 softmax 权重 $\alpha_{t,s}$ 是不同对象。历史越远,乘积涉及的因子越多。因此,即使没有显式位置嵌入,交互也依赖两端之间的序列距离和内容。(§6.2,p. 21)
以下是帮助理解上述乘积的教学展开。取行向量 $q_t,k_t\in\mathbb R^{1\times d_k}$、$v_t\in\mathbb R^{1\times d_v}$ 和状态 $S_t\in\mathbb R^{d_k\times d_v}$,写成:
零初始状态下展开可得:
例如将每一步门控简化为标量 0.99,则相距 100 步的保留因子为 $0.99^{100}\approx0.366$,相距 1000 步约为 $4.3\times10^{-5}$。真实门控是数据相关的,这个例子只展示“没有 RoPE 也会感知距离”的原因。它也解释了为何限制门控连乘跨度可能改善外推。
2.3 用 Jacobian 定义扩展注意力分布
softmax 注意力已有非负且和为 1 的概率分布,而 LA 的交互系数可能带符号、也不归一化。直接额外套 softmax 会改变原计算的解释。作者改用 value 到输出的 Jacobian 范数,统一衡量各历史位置的影响强度。
原文 Eq. (1) 从 softmax 情形出发:
这里 $J_{t,s}$ 是 $d_v\times d_v$ 矩阵;$\|\cdot\|_2$ 明确指诱导矩阵 2-范数,即谱范数。上述导数是在注意力内部将 $q,k$ 等其他分支固定、考察 value 路径时成立;若对同一输入同时引起的所有分支变化求总导数,不能直接使用这一等式。
把原文对归一化的文字说明写成显式公式,令可见位置集合为 $\mathcal V_t$,且分母非零:
$L$ 为评测上下文长度;完整因果前缀的末端有 $L=t+1$ 个可见位置。作者用 $\log L$ 将熵归一化。在 softmax 情形,扩展分布还原原分布;在 LA 情形,它只用于分析,无需修改前向计算。(§6.1,Eq. (1),p. 18)
这一构造测量的是局部敏感度的强弱。例如输出中两个 value 的系数分别为 $+2$ 和 $-2$,范数归一化会给出 $(0.5,0.5)$,无法表示它们可能发生的符号抵消。这是本次分析中对指标含义的解释:扩展熵适合比较注意力的集中程度,但不能单独代表正确答案的贡献。另外,归一化熵的分母随 $L$ 增加,因此其下降也不能独立证明绝对有效感受野在缩小。
2.4 熵—命中率图如何揭示分工
作者结合三种探针,而不是只画注意力热图:
- Top-$k$ 命中率:在 4K RULER SK1 输入末端的 query token 上,检查分数最高的 $k$ 个历史位置是否命中待检索信息。横向改变 $k$;散点图固定使用 top-64。
- 检索头分数:沿用 DuoAttention 的检索头/流式头区分,观察头是否需要初始 sink、最近窗口之外的远端信息。作者把分数分为低 $(0,10^{-5})$、中 $[10^{-5},10^{-3})$、高 $[10^{-3},1)$ 三档。
- 归一化注意力熵:在 PG19 上测量注意力集中还是分散。高熵意味着更分散,不等于检索更准确。
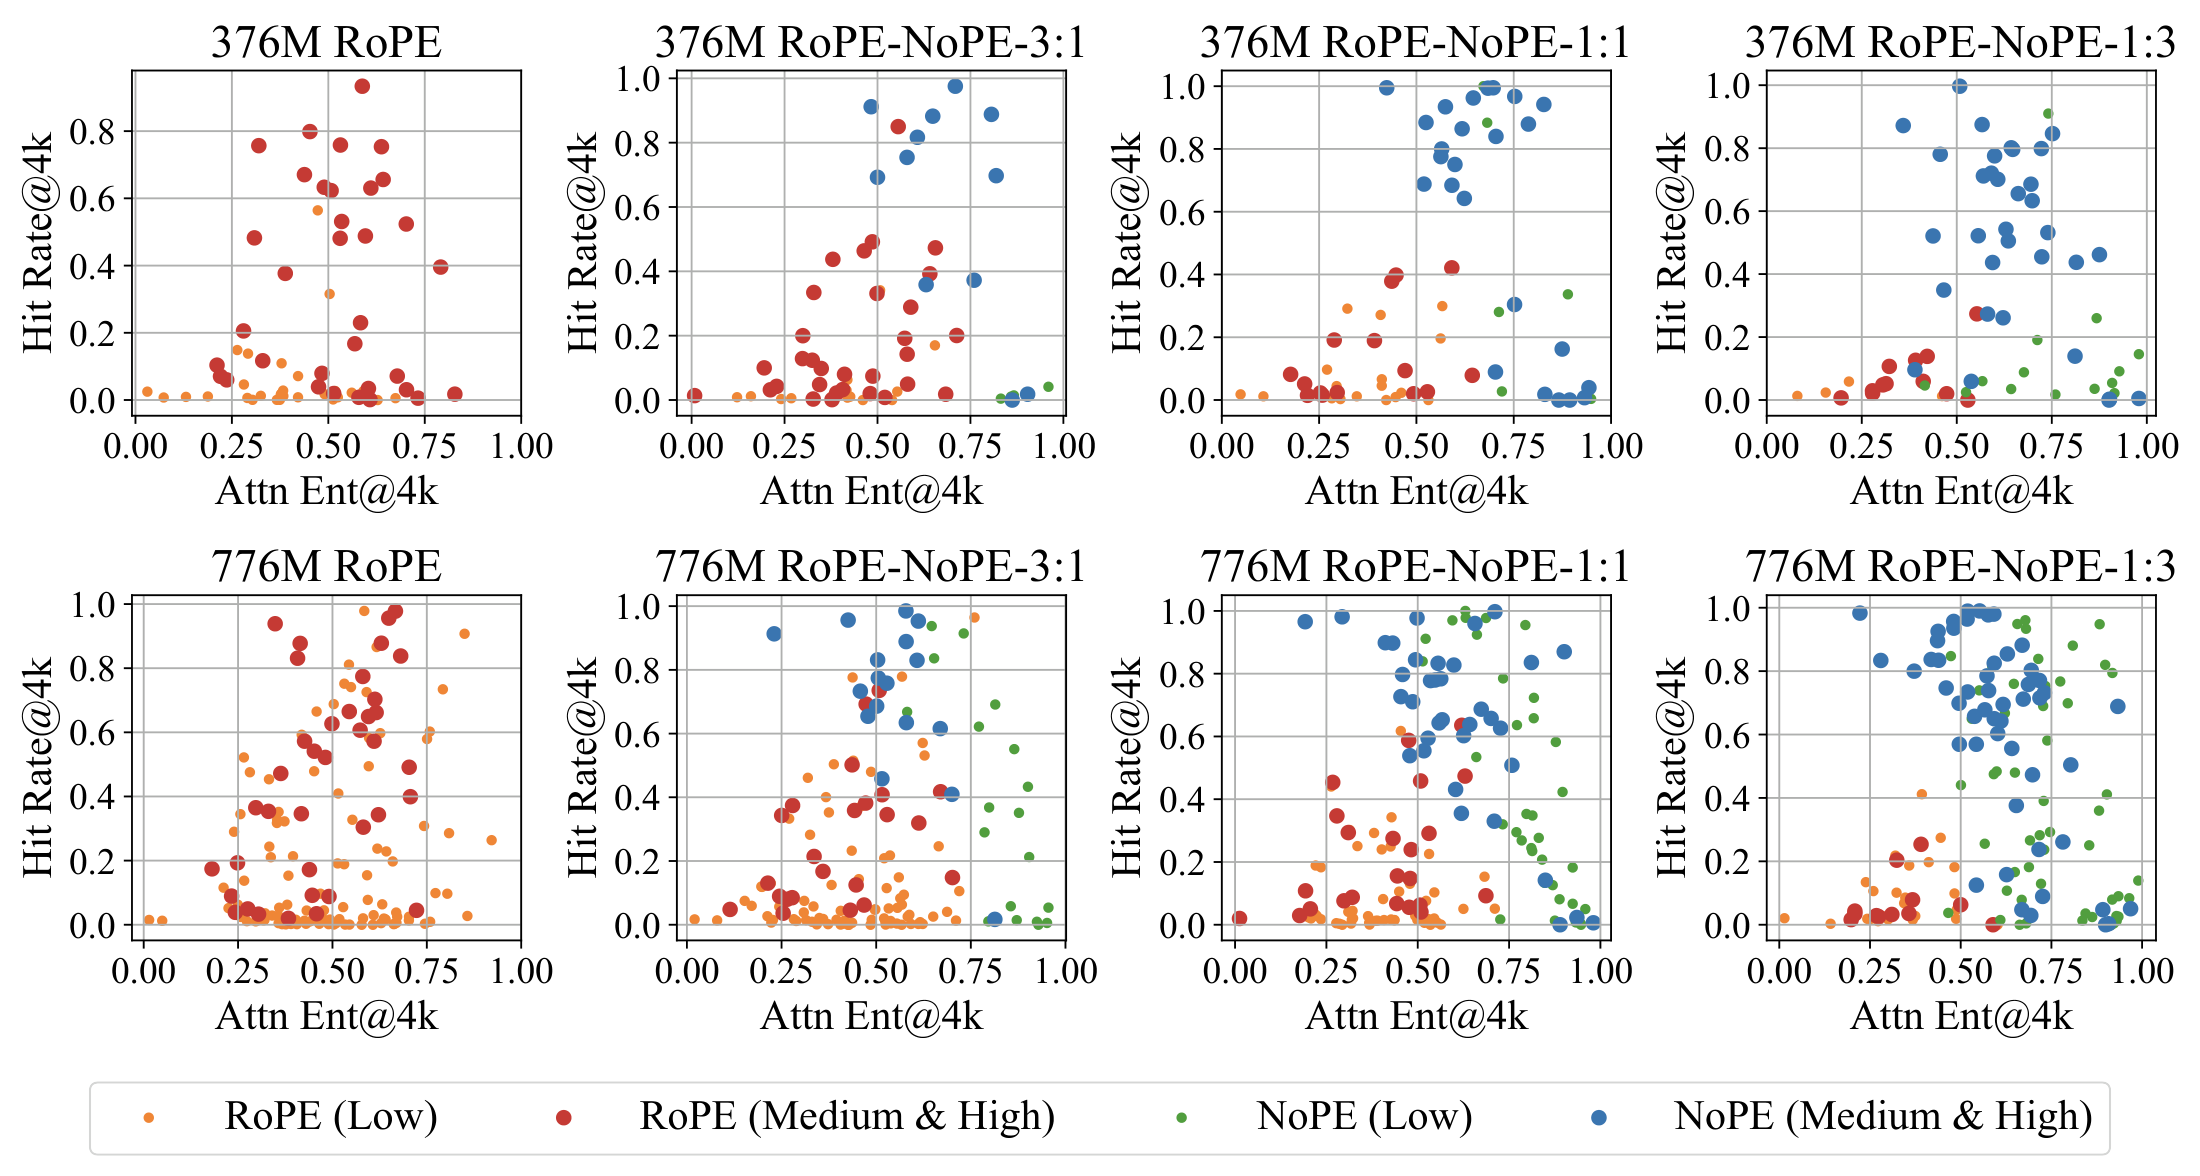
来源:Fig. 12(b),p. 13,作者原始图件。横轴是 4K 时的归一化熵,纵轴是 top-64 命中率,每点一个头;上下两行分别为 376M、776M。四列从纯 RoPE 到 3:1、1:1、1:3 混合;颜色还区分模块类型和检索分数档位。
NoPE 头更多落在命中率较高或熵较高的带状区域,RoPE 头更多占据左下方扇区。随着 NoPE 占比增加,两组的区域边界重新分配。作者称之为潮汐效应(Tidal Effect):全局粗定位与局部集中处理的职责会随配比移动,而不是每一类头都有固定不变的功能。
作者将这种分工解释为“少量 NoPE 做全局聚合,多数位置偏置模块抑制噪声”。支持这一解释的干预是:在 1:1 HH 模型、4K 输入中,给位置偏置头加入同类高斯噪声,性能通常比给 NoPE 头加噪声下降更大。该结果显示局部分支对最终输出很重要;“降噪”是对探针与干预共同结果的机制解释。(§4,pp. 10–14,Figs. 10–13)
2.5 滑动窗口线性注意力与 EME
**滑动窗口线性注意力(Sliding-Window Linear Attention,SWLA)**把带门控 LA 的直接历史作用范围限制在训练长度附近。作者采用可以复用现有 FlashLinearAttention 算子的重叠窗口近似。窗口 $W=4096$,步长 $S=1024$ 时:
| 运行 LA 的 token 区间(含端点) | 保留的输出区间 |
|---|---|
| $[0,4095]$ | $[0,4095]$ |
| $[1024,5119]$ | $[4096,5119]$ |
| $[2048,6143]$ | $[5120,6143]$ |
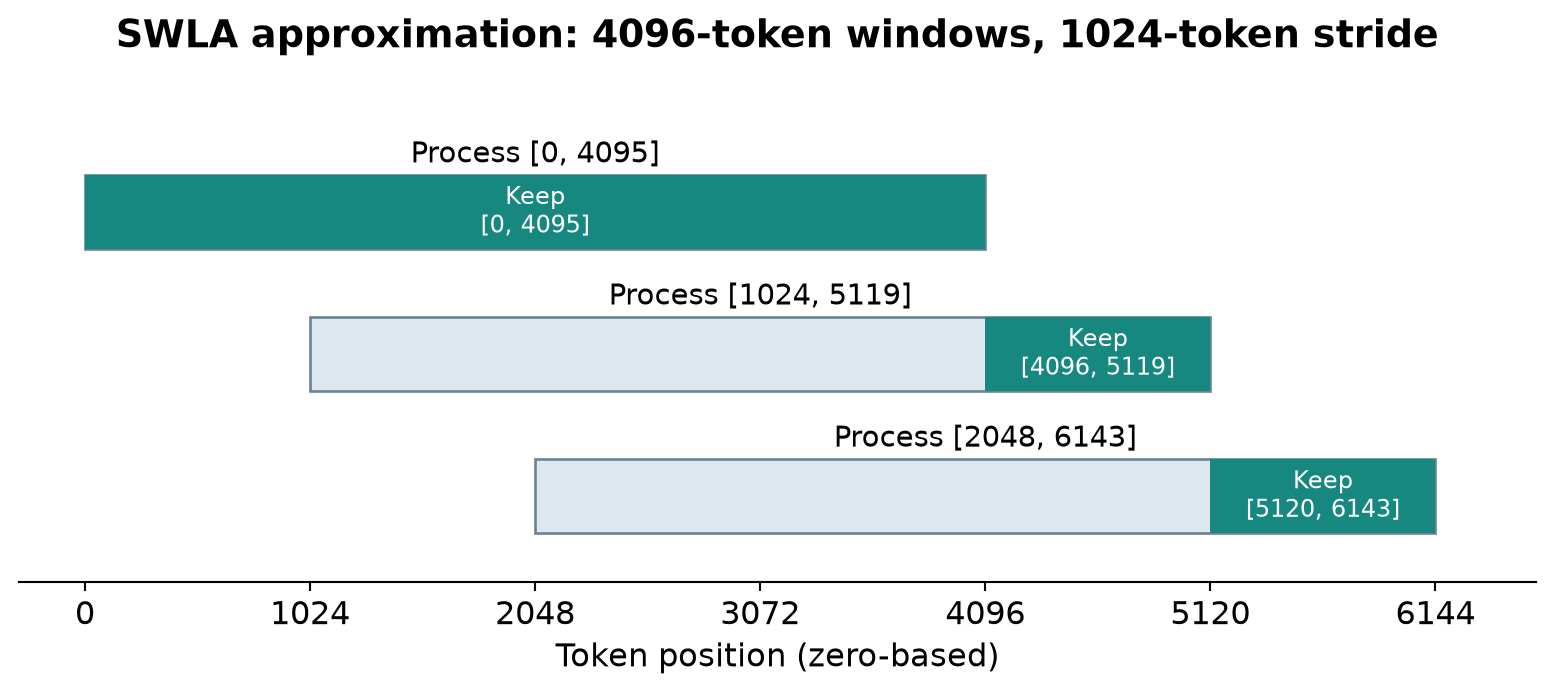
根据 §6.2、p. 20 绘制的教学示意,非论文原图。灰色与绿色合起来是本窗口参与计算的输入,绿色标出保留输出。各窗口使用独立的局部状态,再按原序拼接输出;保留跨窗口的完整旧状态会失去限制历史范围的效果。
后续每块只保留最后 1024 个位置。它们的可见局部前缀长度为 3073–4096,而不是每个位置都精确看到最近 4096 tokens。因此它是固定滑窗的近似。对于长输入,窗口重复处理量约为 $W/S=4$ 倍;这是根据区间推导的 LA 分支算量估计,不是论文报告的端到端减速倍数。NoPE 分支继续负责全局访问,LA 模块输入本身也可能已包含其他层传播的全局信息。
另一半是 Log:增大 NoPE 注意力的 logit 尺度,减轻候选 token 增多时的权重分散。按作者“以训练长度为对数底”的描述,对外推长度 $L\ge L_0$ 可写为:
这是对论文文字方案的表达,原文没有给这一式编号。以 4096 到 65536 为例,$c=16/12=4/3$;“16 倍长度”并非把 logits 乘 16。更大的尺度使 softmax 更集中。
作者把限制位置偏置分支的作用跨度,同时增强 NoPE 全局聚合称为马太效应(Matthew Effect),相应外推策略简称 EME。RoPE-NoPE 使用“RoPE 分支的 SWA + NoPE 的 Log”,LA-NoPE 使用“SWLA + NoPE 的 Log”。推理策略不需要额外训练,但适用对象是已经训练好的对应混合模型。(§3.2,p. 4;§6.2,pp. 20–23)
三:实验——比较条件与分数口径
3.1 两阶段预训练
| 条件 | 短上下文预训练 | 长上下文继续预训练 |
|---|---|---|
| 上下文 / token 预算 | 4K / 50B tokens | 32K / 5B tokens |
| 语料 | DCLM-Baseline-1.0 | LongWanjuan 完整长文档 |
| 每批 tokens | 1M | 0.5M |
| 优化器 / 峰值学习率 | AdamW / $10^{-3}$ | AdamW / $10^{-3}$ |
| 权重衰减 / warm-up | 0.1 / 0.5B tokens | 0 / 1B tokens |
| 调度 | 余弦衰减至 0 | 余弦衰减至 0 |
| 全注意力 RoPE base | 10000 | 调至 500000 |
使用 Llama 3 tokenizer,词表 128256,BFloat16 训练。376M、776M、1B、3B 的层数分别为 8、12、16、24,hidden size 分别为 1024、1536、2048、3072;每头维度由配置可算出为 128。主比较使用 MHA,query 头数和 KV 头数相同。3B 用 16 张 H200,其余用 8 张。(Appendix A,Table 2,p. 32)
这两阶段同时改变文本长度与训练语料,所以“继续训练前后”的差异应放在这一训练配方内理解。学习率稳健性实验补充了 $10^{-4},2\times10^{-4},5\times10^{-4},10^{-3}$ 四档,但没有把长文语料与长度影响完全分离。(Appendix A.2,pp. 34–35)
3.2 基线各自回答什么问题
- 纯 RoPE 全注意力:传统模型能做到什么。
- RoPE-NoPE 全注意力混合:在注意力算子仍为 softmax 时,只混合位置编码是否也有效。
- SWA/GLA/GDN-RoPE 与 -NoPE:高效模块搭配不同全局位置编码的差别。
- Dynamic NTK、Log、SWA/SWLA、EME:位置插值、全局尺度修正、局部跨度限制及其组合各贡献多少。
- 按层/按头、混合比例、窗口大小、LongCE、YOCO-like 布局:机制是否依赖具体配方。
3.3 指标如何读
| 指标 | 衡量对象 | 方向与口径 |
|---|---|---|
| PG19 PPL | 长文本语言建模的平均预测质量 | 越低越好;不能仅凭总体下降判断长依赖学得更好 |
| PG19 LongPPL | 作者引用的、强调长程依赖预测质量的指标 | 越低越好;本文沿用该指标,未重新定义完整计算流程 |
| RULER | 合成长上下文检索等能力 | 分数越高越好;评测 4K–64K 五档 |
| BABILong | 长干扰上下文中的状态追踪与问答 | 分数越高越好;表中 0K–64K 共七档,0K 是该基准的长度标签 |
| NIAH-SK1/SK2/SK3 | RULER 中三种单键检索子任务 | 准确率百分数;本文未展开三个子任务的完整生成协议 |
| LongBench | 问答、摘要、ICL、合成任务、代码等 | 使用各任务评分后汇总;输入上限 31500,输出上限 500 |
| 短任务平均分 | TruthfulQA、LAMBADA、PIQA 等 12 项 | 2K 内评测;数值越高越好 |
| TTFT / TPOT / TGS | 首 token 延迟 / 每输出 token 延迟 / 每 GPU 每秒 tokens | 延迟越低越好,吞吐越高越好 |
详细表中的 All 是 5 个 RULER 长度分数与 7 个 BABILong 长度分数的合并平均,并非两个基准均值再各占一半。≤4K 合并 RULER 4K 与 BABILong 0K/2K/4K,>4K 合并两个基准的 8K/16K/32K/64K 八项。下文保持原报一位小数,不将不同汇总口径混用。(Tables 7–15,pp. 43–50)
四:结果——从排名反转到可干预机制
4.1 短训练后的外推与长训练后的排名反转(§3)
Figs. 1–4 同时比较训练损失、PG19 PPL/LongPPL 和长任务分数。作者观察到,混合模型在训练长度内也常有较低的训练损失与困惑度;仅混合 RoPE 与 NoPE 的全注意力模型也能获益。因此这里的改善不完全来自减少全注意力计算。加入高效模块之后,全局分支采用 NoPE,通常比保留 RoPE 更有利于长任务与外推。(pp. 4–6)
先看 776M、默认 3:1、按层混合的可比结果:
| 模型 | 4K 训练 + Log:All | 32K 继续训练:All | 前者 >4K | 后者 >4K |
|---|---|---|---|---|
| SWA-NoPE-LH | 29.7 | 29.4 | 27.8 | 24.8 |
| GLA-NoPE-LH | 20.1 | 33.2 | 12.0 | 30.3 |
| GDN-NoPE-LH | 21.4 | 42.0 | 14.6 | 39.5 |
来源:Table 7,p. 43;Table 11,p. 47。左侧不是直接外推,而是已经使用 NoPE 的 Log 修正;LA 尚未使用本文新增的 SWLA。
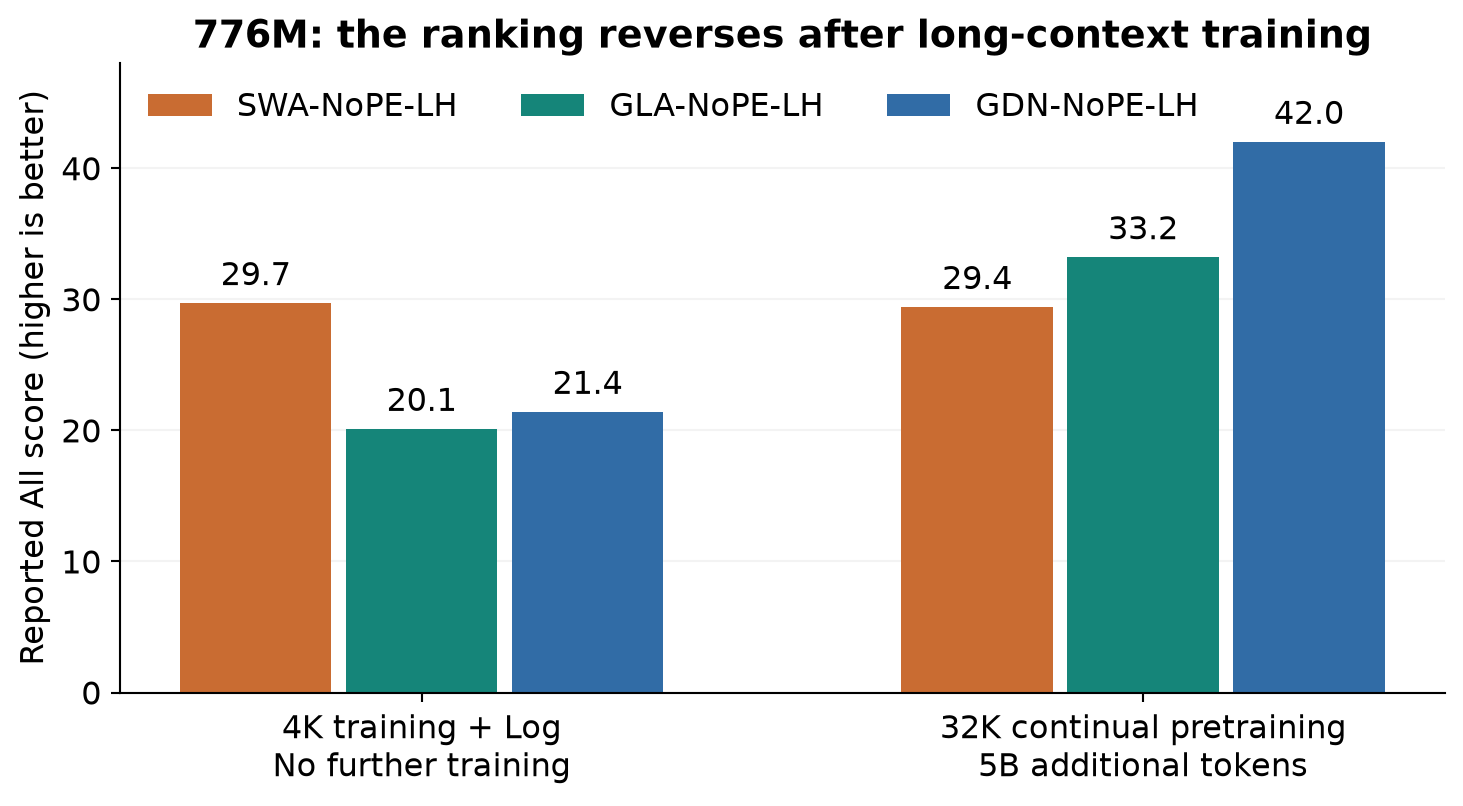
根据上述两张原表重绘。横轴分开表示不再训练和额外训练 5B tokens,纵轴为 All 分数。SWA 的稳定外推没有转换成明显的继续训练收益,GDN 则从 21.4 升到 42.0。这就是作者所称的跷跷板效应(Seesaw Effect)。
原文将 LA 的“训练域内拟合较好、域外泛化较弱”概括为 No-Free-Lunch Effect。这里是实验现象的名称,不是关于模型泛化的数学定理;也不能理解为 LA 在每个域内任务都领先。按头混合的继续训练改善通常更明显,例如 776M SWA-NoPE-HH 的 All 从 31.6(Short + Log)到 35.2,较按层混合更少出现停滞。(Tables 9、12,pp. 45、48)
NoPE 配合高效模块的收益也能从匹配模型看出:776M 的 SWA-RoPE-LH 直接外推 All 为 15.3,SWA-NoPE-LH 为 24.8。RoPE-NoPE 的外推则还需要正确处理 RoPE 分支跨度:776M RoPE-NoPE-LH 的 All 在直接外推、NTK + Log、4K 窗口 + Log 下分别为 12.0、19.5、24.2。(Table 7,p. 43)
4.2 更多 NoPE 不是单调更好,3:1 也不是统一最优(§4)
776M RoPE-NoPE-HH 在 EME 下,3:1、1:1、1:3 的 All 分别为 30.4、25.7、22.3,支持保留较多位置偏置模块。噪声实验与高熵、低命中率 NoPE 头的存在,为“全局聚合可能混入无关信息,需要其他头协作处理”的解释提供了依据。
但比例应按模块区分:776M SWA-NoPE-HH + Log 的相同比例分数为 31.6、35.2、31.9,以 1:1 更高;GDN-NoPE-HH 的直接外推也有 1:1 优于 3:1 的结果。作者关于 3:1 的主要趋势不能扩写成所有架构的最优配比。(Table 17,p. 52;Figs. 10–13,pp. 11–13)
4.3 SWA 的短上下文学习陷阱(§5.1)
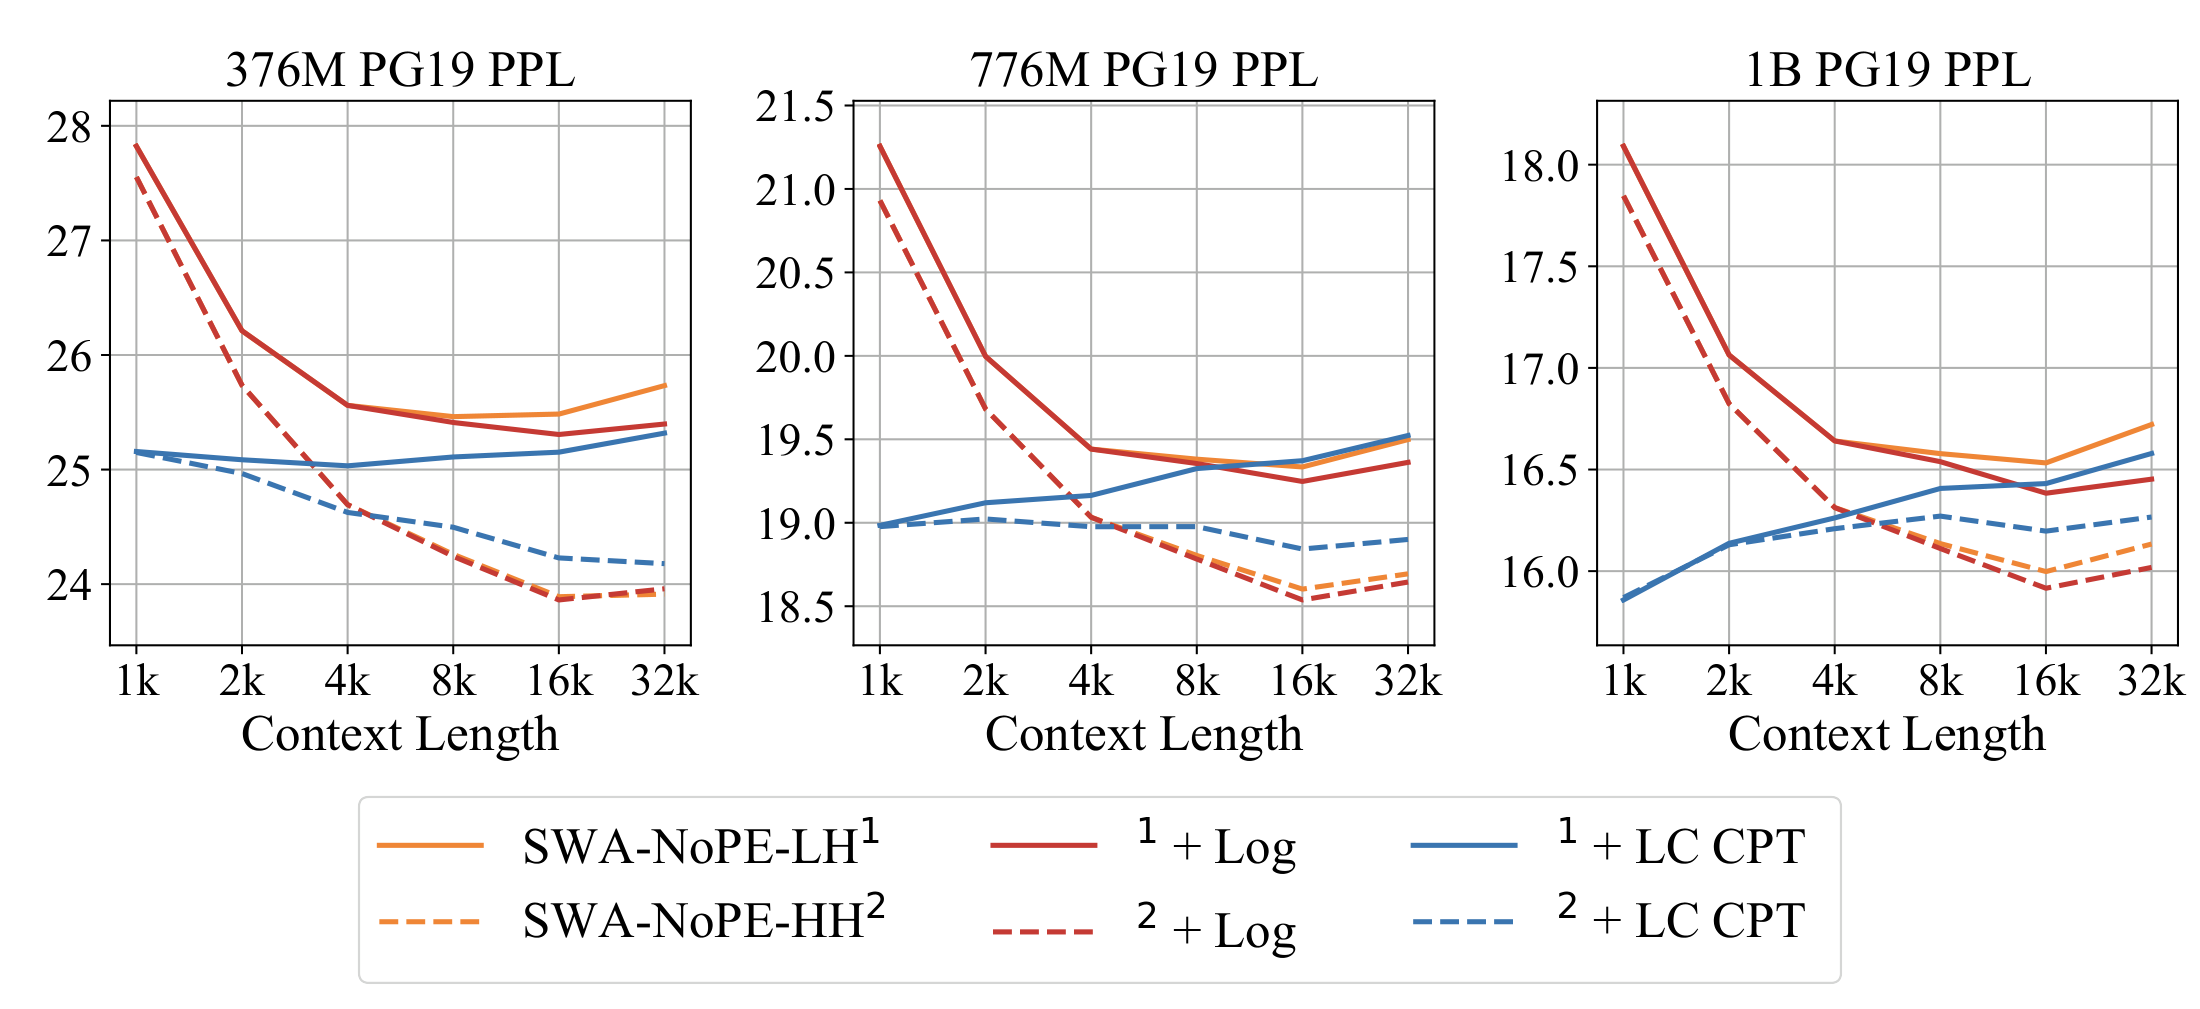
来源:Fig. 14(a),p. 15。三幅图分别是 376M、776M、1B,横轴是评测上下文长度,纵轴为 PPL、越低越好;实线/虚线对应 LH/HH,颜色区分原始外推、Log 和继续预训练。
作者观察到,SWA-NoPE-LH 在长训练后,短上下文位置的损失显著降低,但更长上下文位置改善有限,使 PPL 曲线转而随长度上升。模型获得了更多长文训练,却优先优化了较容易的局部预测。
辅助证据来自参数相对变化:
撇号表示继续训练后的参数。作者逐头计算再按层平均,HH 中分别汇总两类头。SWA 分支的 $W_Q,W_K$ 相对变化显著大于 NoPE 分支;GLA/GDN 与 NoPE 之间则更接近。固定 128-token 窗口让获得大量更新的分支依旧主要建模局部依赖,支持短上下文学习陷阱这一解释。参数位移是累积更新的观测量,不是直接测得的梯度预算。(Fig. 15,p. 16)
4.4 窗口扩展和 LongCE 如何缓解陷阱(§5.2)
作者把继续训练时的 SWA 窗口从 128 扩到 256、512、1024、2048、4096,并相应调整 RoPE base;也采用 LongCE,让训练更重视长程依赖。LongCE 是引用已有工作的目标,本文侧重验证其作用,没有展开全部公式和实现细节。
| 776M SWA-NoPE-LH,32K 继续训练 | RULER 32K | RULER 64K | >4K 汇总 | All |
|---|---|---|---|---|
| 原配方,窗口 128 | 21.2 | 14.4 | 24.8 | 29.4 |
| 窗口扩大到 2K | 29.4 | 25.0 | 30.6 | 34.0 |
| LongCE,窗口仍为 128 | 26.7 | 18.4 | 27.5 | 32.2 |
| 2K 窗口 + LongCE | 39.7 | 35.3 | 35.7 | 37.4 |
来源:Table 15,p. 50。两者结合使 All 增加 8.0 分,>4K 汇总增加 10.9 分;RULER 64K 增加 20.9 分。这些是分数的绝对差值。
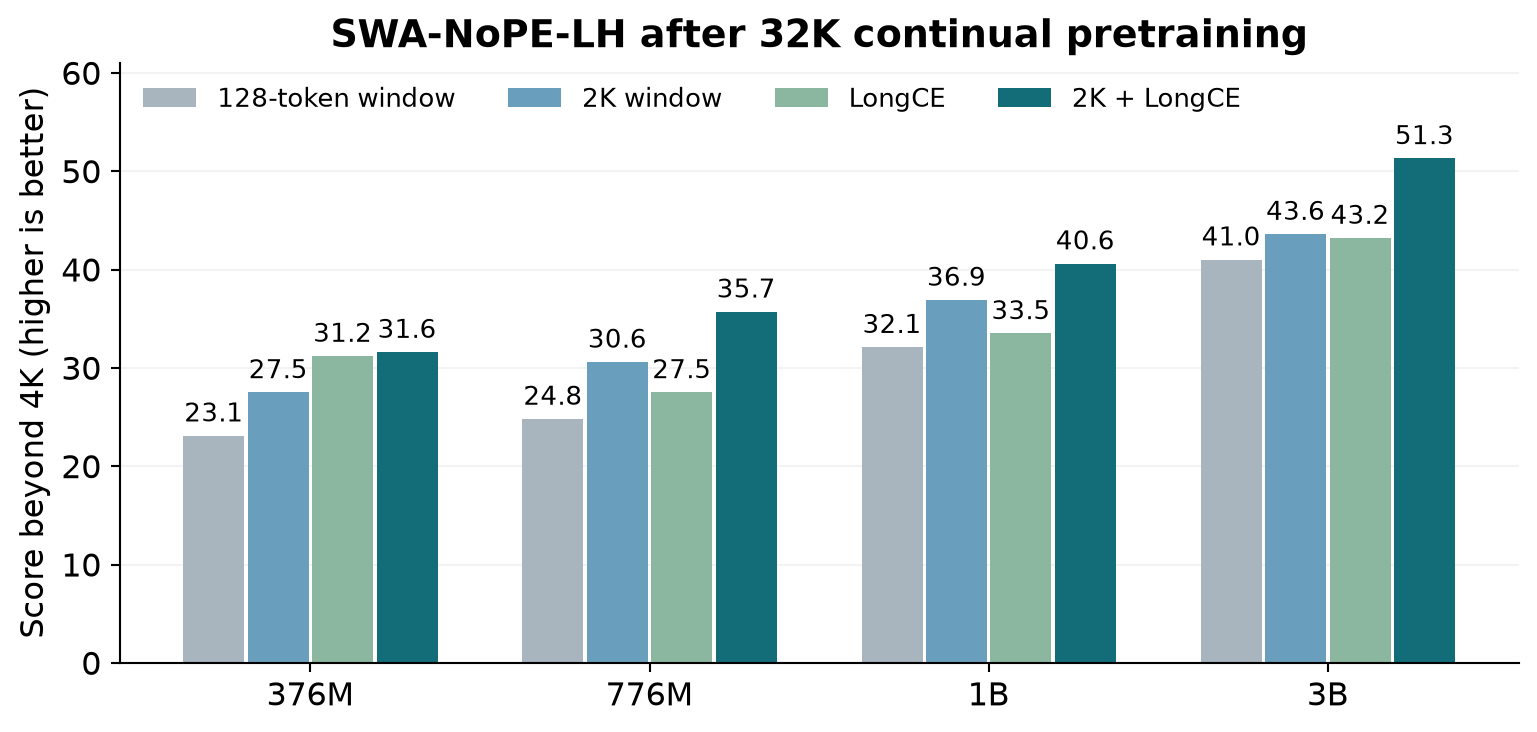
根据 Table 15、p. 50 重绘,纵轴为 >4K 汇总分数。组内四根柱分别是原配方、扩窗、LongCE、两者结合。在 376M 上两者结合相对 LongCE 单独使用的增益较小;776M 和 3B 上组合收益明显。就 776M All 而言,改进后的 SWA 为 37.4,仍低于同设置 GDN-NoPE-LH 的 42.0;因此“更有竞争力”不意味着每个规模都追平 GDN。
窗口实验体现两个阶段不同的偏好:
| 776M SWA-NoPE-LH 的窗口 | 128 | 512 | 2K | 4K |
|---|---|---|---|---|
| 短训练后直接外推:>4K | 20.4 | 22.2 | 18.6 | 17.7 |
| 长继续训练后:>4K | 24.8 | 28.4 | 30.6 | 31.1 |
| 长继续训练后:All | 29.4 | 32.6 | 34.0 | 33.7 |
来源:Tables 13–14,p. 49。短训练中,过大的窗口可能让模型减少对全局分支的依赖,作者称为长窗口惰性(Long-Window Laziness);长训练中,过小窗口阻碍利用新增长程信息,称为短窗口疲乏(Short-Window Weariness)。表中趋势并不单调:短训练的 512 比 128 更好;长训练的 2K 在 All 最好,4K 在 >4K 更高。因此“按阶段调节窗口”比“窗口越小/越大越好”更准确。
扩窗实验还同时调节位置编码:128 时 base=10000,256/512/1024/2048/4096 对应约 90000/700000/6000000/50000000/400000000。不能把这些结果当作完全固定 RoPE 的单变量窗口消融。(Appendix A.3,p. 36)
4.5 扩展熵将 GLA/GDN 纳入位置偏置框架(§6.1)
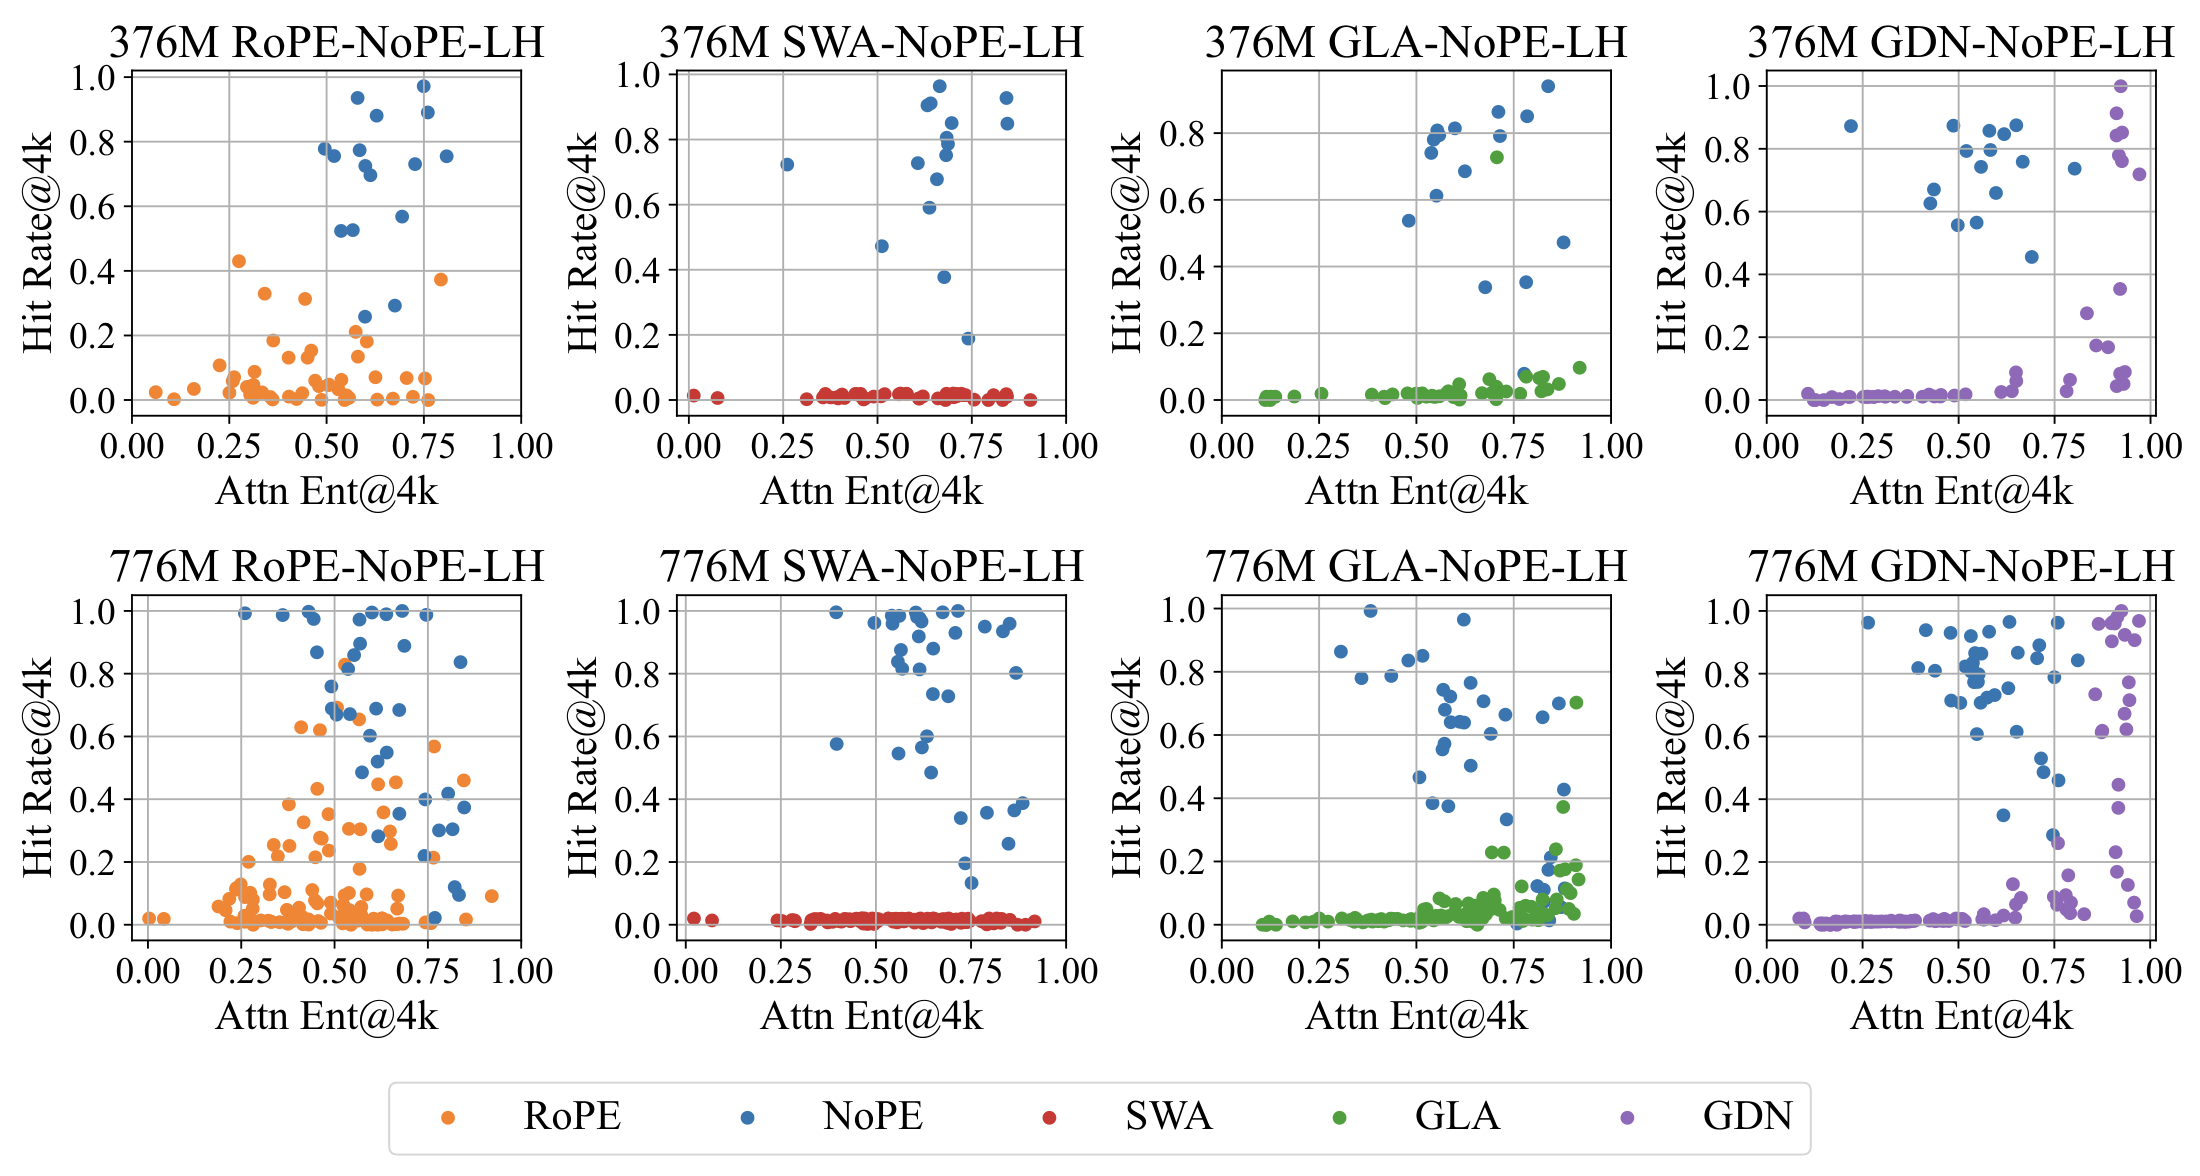
来源:Fig. 21(b),p. 19。横轴仍为 4K 时的归一化熵,纵轴为 top-64 命中率;上下两行分别是 376M、776M,列间比较 RoPE/SWA/GLA/GDN 与 NoPE 的组合。
SWA 的直接读取范围固定,远端 needle 命中率接近底部。GLA/GDN 比 NoPE 更倾向中低熵、低命中区域,整体行为更像位置偏置模块;其位置又不像 RoPE 那样完全重叠,说明具体更新规则仍然重要。改变 HH 混合比例时,GLA/GDN 与 NoPE 的区域边界也会移动,扩展了潮汐效应的适用对象。(Figs. 21–22,pp. 19–20)
这一步使 SWLA 的设计有了动机:既然门控 LA 也含训练跨度内形成的位置偏置,就可以测试把其直接作用跨度约束在训练长度附近,而不是默认递归结构天然能处理任意更长输入。
4.6 SWLA 与 Log 的组合收益,以及 100% 结果的条件(§6.2)
| 776M、4K 训练后的按层模型 | 直接外推 >4K | 仅 Log | 仅 SWLA | SWLA + Log |
|---|---|---|---|---|
| GLA-NoPE-LH | 11.2 | 12.0 | 17.2 | 27.0 |
| GDN-NoPE-LH | 14.7 | 14.6 | 25.3 | 29.3 |
来源:Table 7,p. 43。这里的 SWLA 窗口为 4K;>4K 为八个基准—长度单元的平均。
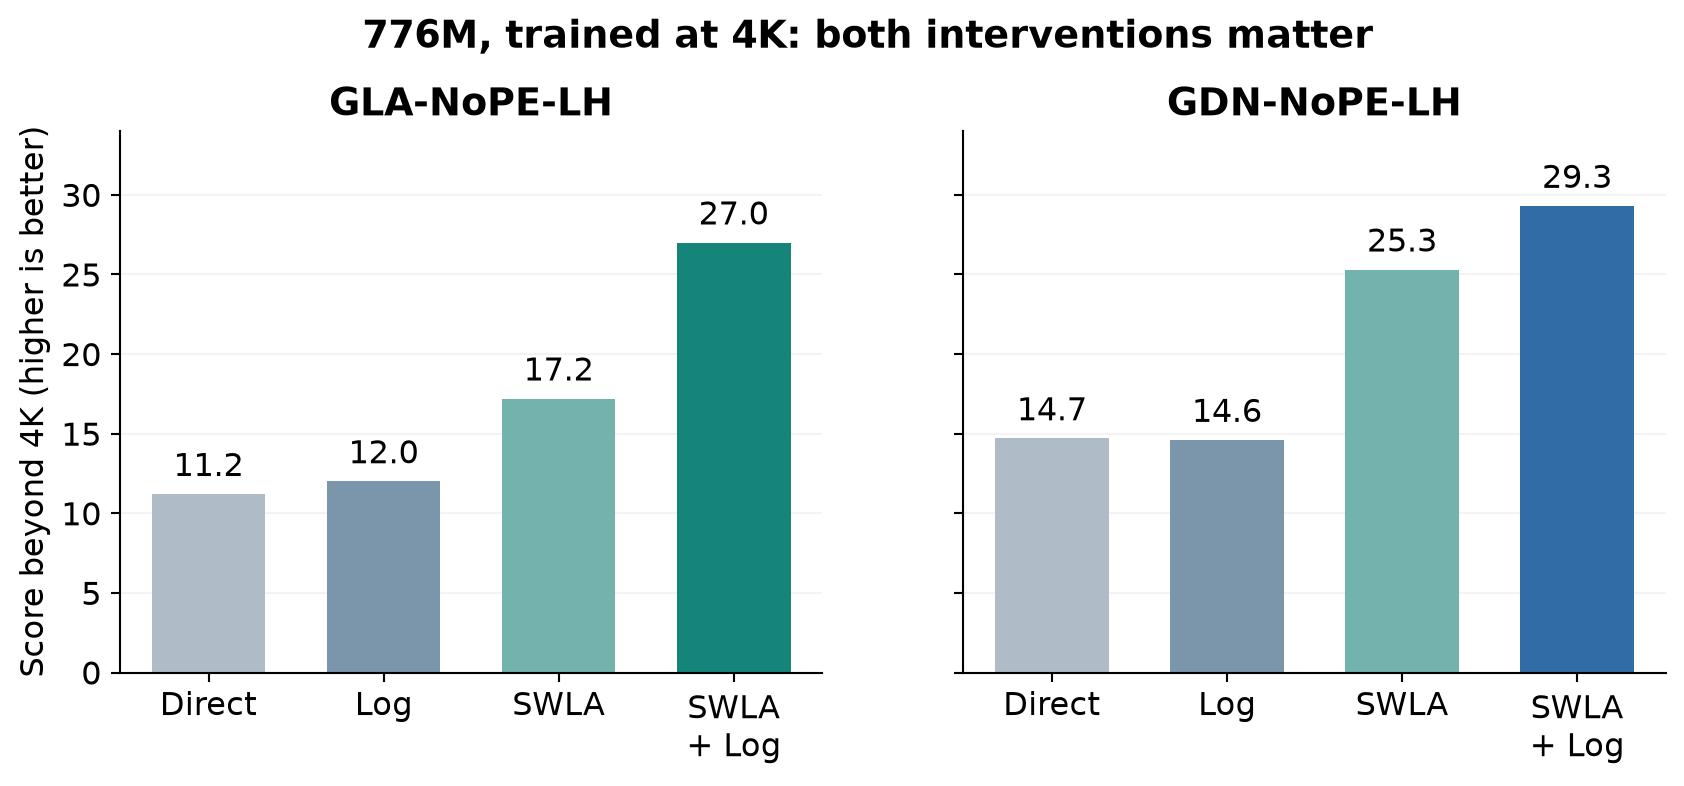
根据 Table 7、p. 43 重绘。GLA 仅做全局尺度修正几乎没有解决外推退化;先限制 LA 跨度,再增强 NoPE,收益更大。GDN 的 Log 单独使用略低于直接外推,而配合 SWLA 后有效。这一交互比单看一个 100% 分数更能说明策略的机制价值。
把 headline 对应的 NIAH 结果拆开,64K 准确率为:
| 776M 模型 | SK1:直接 | SK1:EME | SK2:EME | SK3:EME |
|---|---|---|---|---|
| GLA-NoPE-LH | 0% | 100% | 59% | 64% |
| GLA-NoPE-HH | 0% | 100% | 31% | 34% |
| GDN-NoPE-LH | 99% | 100% | 90% | 53% |
| GDN-NoPE-HH | 92% | 100% | 35% | 16% |
来源:Table 1,p. 23。GDN 的 SK1 原本就很强,且这两种 GDN 模型只用 Log 在 64K SK1 也达到 100%。SWLA 的关键收益还体现在更难的任务:例如 GDN-NoPE-LH 的 64K SK2,从直接外推或仅 Log 的 0%,提高到 SWLA 的 53%、组合后的 90%。
更大模型也不保证 headline 自动成立:Table 16、p. 51 中,3B GLA-NoPE-HH + EME 在 64K 的 SK1/2/3 为 5% / 100% / 73%;1B GLA-NoPE-HH 的 SK1 为 64%。这些具体失败项说明,应按模型规模、布局和子任务报告外推,而不能用 776M 的单键检索结果概括所有模型。
原文 Fig. 25 将 EME 后各类模型与 SWA 比较,整体差距缩小,但不是处处相同:例如 3B 按层混合,SWA + Log 的 All 为 47.2,GLA/GDN + EME 分别为 43.1、44.8。(Table 8,p. 44)
4.7 效率收益与 SWLA 实现代价(§6.3)
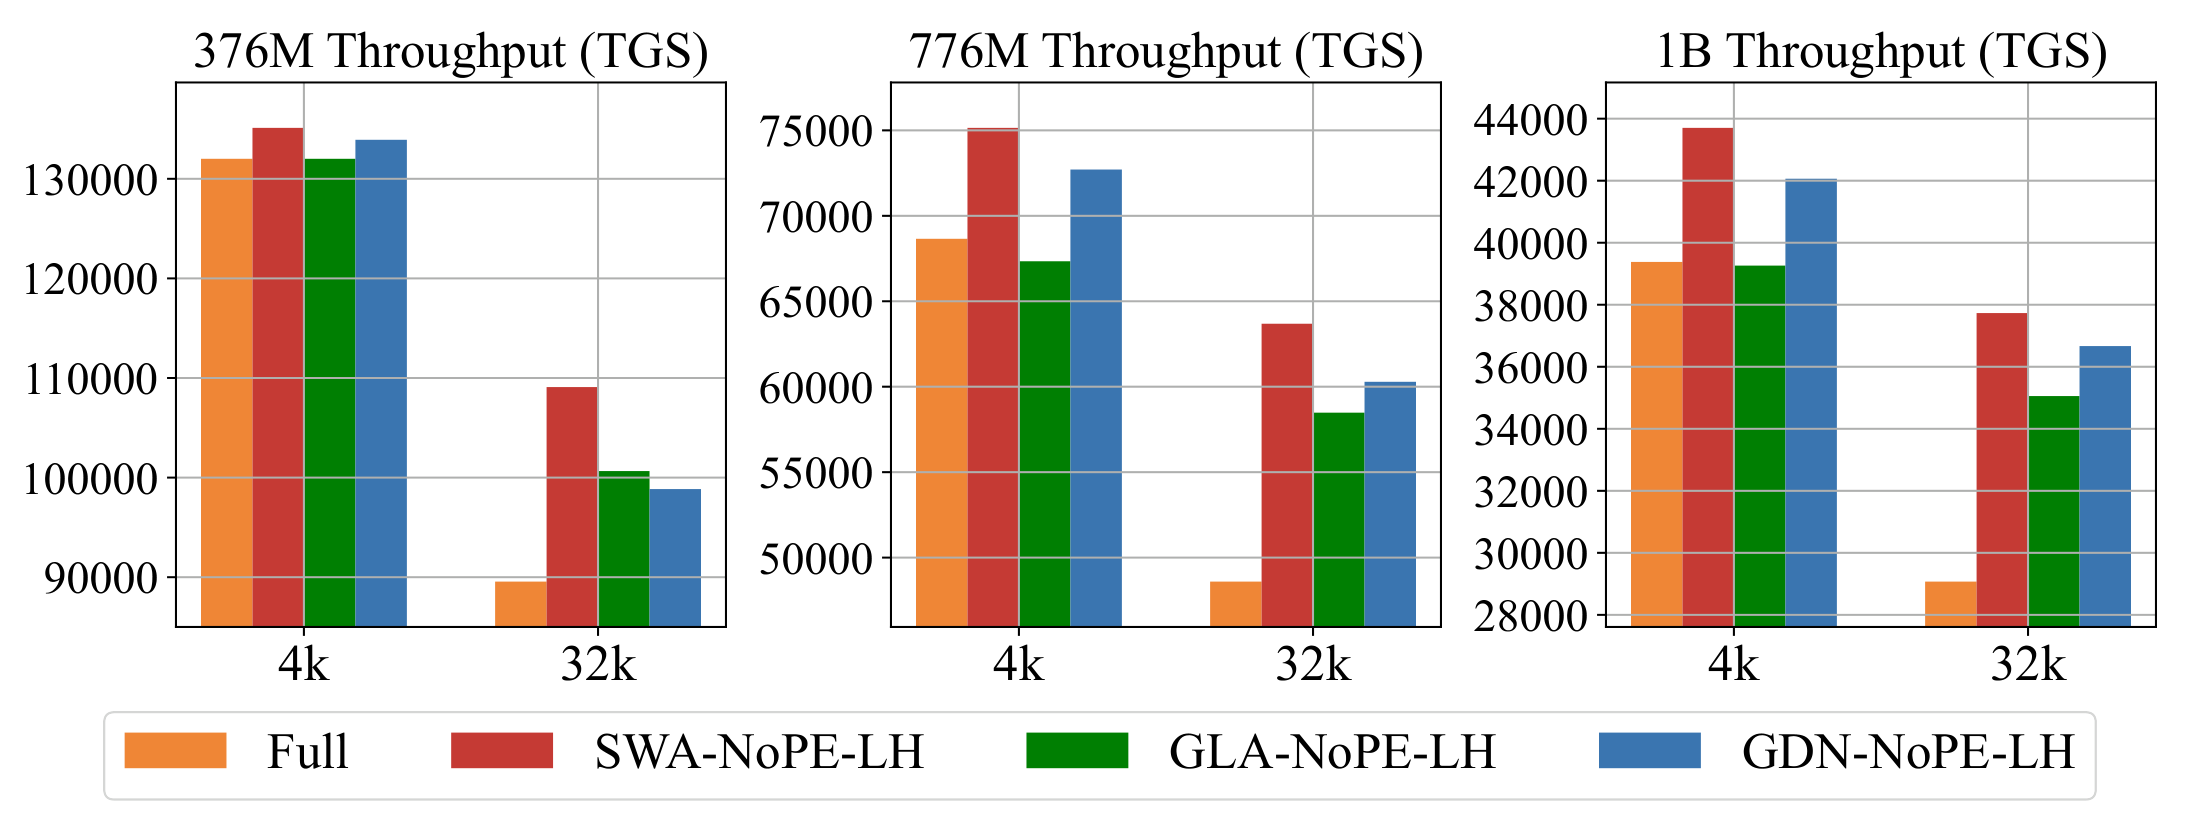
来源:Fig. 27(a),p. 24。三个面板对应 376M、776M、1B,横轴是 4K/32K 训练长度,纵轴 TGS 表示每 GPU 每秒处理的 tokens;四种颜色对应全注意力与三种 NoPE 混合模型。硬件均为 8 张 H200;这里没有把 16 卡训练的 3B 混入比较。
原图显示,在更长上下文或较大模型上,混合模型的吞吐和缓存优势更明显。但解码 TPOT 并非在所有规模、长度都更优;Fig. 26 中部分小模型的 GLA/GDN 解码比全注意力慢。架构的算量减少,需要结合实际算子和内存实现看。
GLA/GDN 状态以 FP32 保存,默认 128 窗口的 SWA 缓存用 FP16,两者缓存曲线因此接近。HH-SWA 的 QKV 拼接方式还使其峰值推理显存接近全注意力,不能仅按头比例推断显存下降。
原文 §6.3 文字称 TTFT/TPOT 都以微秒计,但 Fig. 26 的轴分别标为 秒(s)和毫秒(ms);阅读图中的延迟应按轴标理解。图中测量对象是所列基础混合模型,没有单列本文重叠窗口 SWLA/EME 的完整成本,因此不能直接把这些效率曲线当成 EME 的速度实测。(pp. 22–24)
4.8 附录中的推广与不成立情形
LongBench。 在更真实的任务组合上,作者强调 ICL 子任务能观察到类似趋势。以 3B LH 为例:
| 模型 | 短训练 + Log 的 LongBench Avg. | 长继续训练后的 Avg. |
|---|---|---|
| SWA-NoPE-LH | 20.1 | 23.7 |
| GLA-NoPE-LH | 17.7 | 25.2 |
| GDN-NoPE-LH | 18.1 | 24.9 |
来源:Tables 19、22,pp. 54、57。排名反转在此得到支持;但 776M LH 的短训练 + Log 均值为 SWA 12.6、GLA 13.0、GDN 12.7,本身就没有 SWA 明显领先。HH 在长训练后也常表现接近。论文讨论的是总体趋势,不能改写成每个模型配置都发生反转。
EME 也改善部分 LongBench 设置,例如 776M GLA-NoPE-LH 从直接外推 13.0 到 EME 14.2,GDN 从 12.6 到 14.6。不过这些小型预训练模型在复杂问答与摘要上的绝对表现仍低,作者最有力的机制证据来自检索、状态追踪与 ICL,而非成熟指令模型的综合能力。(Appendix A.1,pp. 32–34;Table 18,p. 53)
学习率与层布局。 四档学习率均能观察到 SWA 长训练收益相对 LA 较弱。在 YOCO-like 布局中,作者把高效注意力层全部置于底部;这描述的是一种层排列,不应直接等同于复现完整 YOCO 的所有缓存共享机制。776M 的 All 在短训练 + Log 时为 SWA 30.6、GLA 21.7、GDN 25.6,长训练后为 30.6、36.1、31.4,支持跷跷板效应。扩窗/LongCE 仍有帮助,但 EME 的收益在这种排列中减弱,说明跨层信息交互会影响效果。(Figs. 32–34,pp. 35–36;Table 24,p. 59)
其他位置设计。 固定窗口 128、降低 SWA 的 RoPE base 有时有利,但各配置没有一致单调趋势;将 4K 训练时的全局 RoPE 在长训练时移除(DRoPE)也未得到统一规律。GLA 与 GDN 的差异可能涉及 delta rule,但本文将原因留待后续分析。(Appendix A.3,pp. 36–37;Table 25,p. 60)
NoPE 的角色不是架构外的绝对属性。 SWA/GLA/GDN 与全局 RoPE 搭配时,全局 RoPE 的散点也会向较高熵区域移动;纯 NoPE 模型的训练不稳定又妨碍干净对比。作者因此把高熵带状分布限定为混合场景中的观察,而非宣称所有 NoPE 或所有 softmax 都具有同一功能。(Figs. 35–36,p. 37)
短任务表现。 Tables 3–6 在 2K 内测量 12 类标准任务,混合模型与传统模型大体相当。776M LH 短训练时,RoPE、SWA-NoPE、GLA-NoPE、GDN-NoPE 的均值分别为 40.3、40.6、40.3、41.3;长继续训练后分别为 39.2、39.3、39.7、39.9。长上下文配方改善特定长任务,不代表短任务也同步提高。(pp. 39–42)
五:结论——如何使用这篇论文的发现
本文最有价值的是把几种表面不同的注意力模块连接到一个可以做干预实验的位置分工框架:全局分支负责获取远处信息,位置偏置分支负责集中处理;外推与继续训练需要分别设计这两部分。 扩展注意力熵提供了跨算子的观察工具,窗口/Log 消融则把机制解释转成可检验的改进。
如果目标是不改权重地延长已经训练好的 LA-NoPE 模型,可以从“限制 LA 直接跨度 + NoPE Log 修正”这一组合进行验证,并同时看 RULER、BABILong、LongBench 和实际成本。如果目标是把 SWA 模型继续训练到长上下文,应联合考虑窗口、RoPE base 与长依赖训练目标;沿用短训练阶段的小窗口可能让新增训练主要改善局部预测。
用于实际架构判断时,最关键的条件有三点。第一,研究主要覆盖 376M–3B、50B tokens 的预训练模型,尚未验证后训练推理、agent 或多模态能力。第二,3:1、2K 与 100% 都有具体实验条件,应回到相应表格和指标选择配方。第三,SWLA 的重叠近似与全局 NoPE 都有实际成本,精度改进不能直接换算成生产系统的速度收益。
基于本文证据,值得进一步验证的方向是:用减少重复计算的 SWLA 实现重新测量准确率—吞吐取舍;分别干预局部分支和全局分支的训练更新,以更直接地检验“局部优化偏重”的机制;以及联合调度训练长度、窗口、RoPE base 与混合比例。这些是本次分析提出的后续问题,不是论文已经完成的结果。