WavePrune:RoPE 通常只需一个旋转周期
论文:WavePrune: One period is often enough for RoPE
作者:Guancheng Du、Luotian Huang、Shaowen Wang、Si Li、Kaifeng Lyu(清华大学;前三位同等贡献)
版本:arXiv:2610.06963v1,2026-10-03 提交;获取与研读日期:2026-11-11。
原文:arXiv v1 · 本地 PDF
- 发表:截至 2026-11-11,未查到正式发表或录用信息;arXiv 页面与论文首页标为预印本。使用 ICLR 2027 模板不能据此判断已录用。
- 代码:作者官方实现已公开,含实验脚本、CUDA 内核和 Python 集成目录;完整 README 仍待补充。
论文总览
RoPE 把相对距离编码成多个频率的旋转相位。它既带来平移不变性,也带来周期重复:本来应关注前一个 token 的注意力头,可能在更远的位置反复遇到相似的相位,从而沿注意力矩阵形成“幽灵次对角线”(ghost sub-diagonals)。WavePrune 的核心规则很简单:每个二维 RoPE 通道只在距离不超过自身波长时贡献 QK logit。高频通道只服务近邻,低频通道仍可连接远处。
论文用三类证据连接这一机制与实际效果:常量 Q/K 下的近周期性定理及注意力可视化;无需训练的长上下文评测与从头预训练;与 Tensor Core 对齐的 FlashWavePrune 内核。在五个预训练模型中,四个 HELMET 均分提高,Qwen3-8B 从 35.7 到 40.0;Llama3.1-8B 则从 38.2 降至 35.2。GPT-2 架构模型在训练长度 2048、验证长度 4096 时,使用 WavePrune 预训练比仅推理时启用更好。A100、32K、head dimension 128 的注意力内核获得约 1.15× prefill 和 1.24× decode 加速。
最有价值的认识是:保留相对位置信息,不必保留每个频率无限重复的旋转响应;但已训练模型可能把这些重复响应用于有效计算。 Llama 的失败正好揭示后一种情况。(Sec. 3–4,PDF pp. 4–11;Appendix E,p. 28)
结构地图
下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
| 原文章节 | 论证作用 | 页码与主要证据 |
|---|---|---|
| 1 Introduction | 区分平移不变性与周期性,提出首周期截断 | pp. 1–2,Fig. 1 |
| 2 Preliminaries | QKV、因果注意力、RoPE 与频率调度 | p. 3,Eq. (2)–(5) |
| 3.1 WavePrune: Channel-wise Attention Truncation | 通道截断、阈值与分组近似 | p. 4,Eq. (6),Fig. 2–3 |
| 3.2 Analysis: Periodicity of RoPE Distracts Attention | 幽灵次对角线与定理 1 | pp. 4–6,Fig. 4,Eq. (7) |
| 3.3 Efficient Implementation: FlashWavePrune | 16 维分组、三类计算路径 | pp. 6–7,Eq. (8),Fig. 5 |
| 4.1 Training-Free Integration | 长上下文与通用能力 | pp. 7–8,Table 1 |
| 4.2 Pretraining Experiments | 预训练与推理开关的四种组合 | p. 8、Fig. 6 p. 9;Table 10 p. 32 |
| 4.3 Controlled Experiments | 近程稀释与远程干扰两种假说 | pp. 8–9,Fig. 7 p. 10 |
| 4.4 System Efficiency | 内核延迟与系统消融 | pp. 9–10;Tables 3–4、11 |
| 4.5 Ablation Studies | 周期阈值、近似误差、通道数量 | pp. 10–11,Fig. 8 |
| 5 Related Work;6 Conclusion and Future Work | 与频率缩放、稀疏注意力及 ATFlash 的关系 | pp. 10–12 |
| Appendix A–B | 定理 1 证明、随机 Q/K 推广及稀疏性界 | pp. 18–24 |
| Appendix C–G | 内核、评测协议、Llama 失败、合成数据、超参数 | pp. 25–29 |
| Appendix H–I | 完整结果、NLL、通道分解与跨模型注意力图 | pp. 30–40 |
一:动机——RoPE 的有用性质与多余重复
1.1 为什么会有位置混淆?
对每个注意力头,模型先得到 $Q,K,V\in\mathbb R^{n\times d_h}$。RoPE 将一个 $d_h$ 维向量拆成 $d_h/2$ 个二维通道。第 $c$ 个通道在位置 $i$ 旋转 $if_c$,常见频率为
$f_c$ 的单位可理解为弧度/token,$w_c$ 为 token 距离。通道编号越大,频率越低、波长越长。Qwen3 的原生 RoPE base 为 $10^6$;长上下文启用频率缩放时,WavePrune 从缩放后的实际频率重新计算阈值。
设 $\varphi_i^{(c)}(q_i)$ 为位置 $i$ 旋转后的第 $c$ 个 query 通道,则因果位置 $j\le i$ 的标准 logit 为
当固定该通道的 query/key 内容时,其贡献可写为 $m_c^Qm_c^K\cos((i-j)f_c+\omega_c)$,其中 $m_c^Q,m_c^K$ 是该通道 query/key 的范数,$\omega_c$ 为初始相对角度。共同平移 $i,j$ 不改变相对距离,因此不改变位置作用;但将距离推进约一个波长,又会回到相似相位。多个通道的波长一般没有共同的短整数周期,问题表现为近周期性,而非完整 logit 严格按某个短周期重复。(Sec. 2–3.2,PDF pp. 3–5)
1.2 为什么斜线不一定都代表有效依赖?
注意力矩阵横轴是 key 位置、纵轴是 query 位置;固定滞后 $i-j=\Delta$ 对应一条次对角线。前一个 token 头应突出 $\Delta=1$,但 RoPE 的重复相位可能制造更远的平行亮线。随着上下文增长,新增的高 logit 会进入同一个 softmax 分母,分走目标位置的注意力质量。
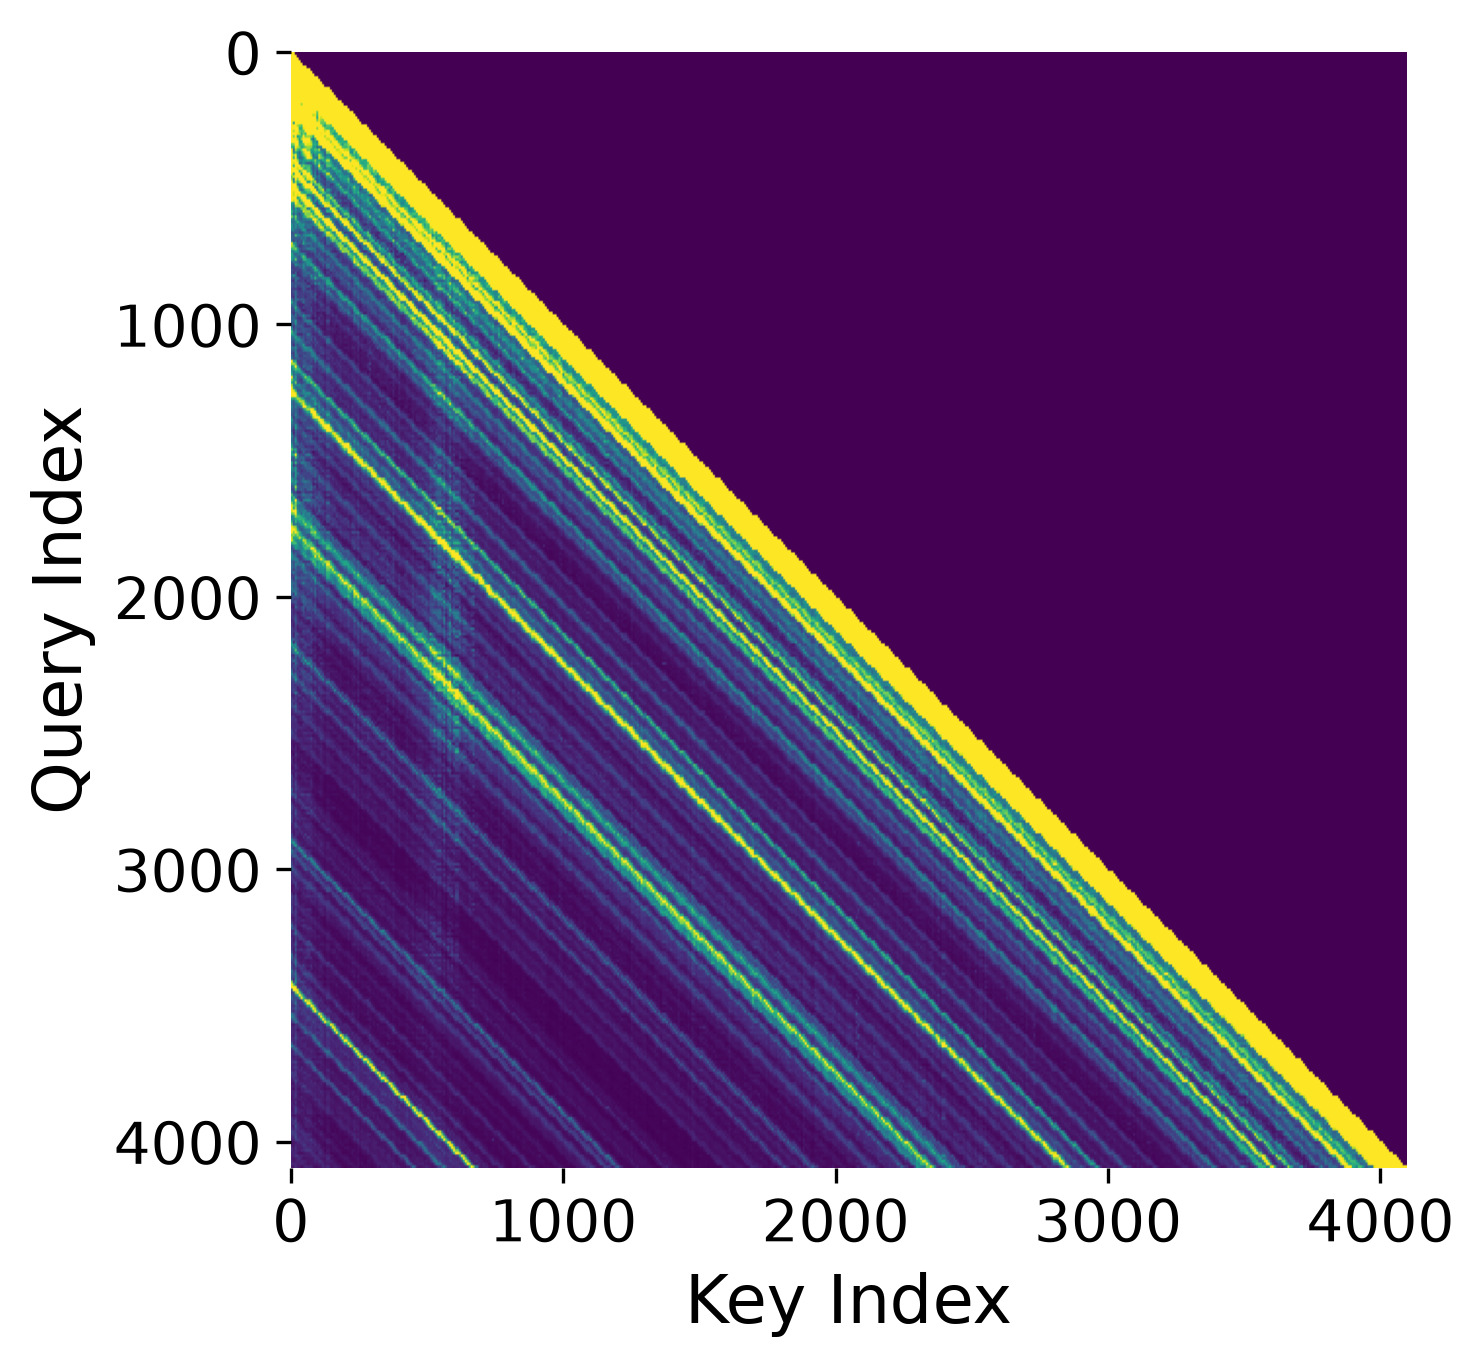
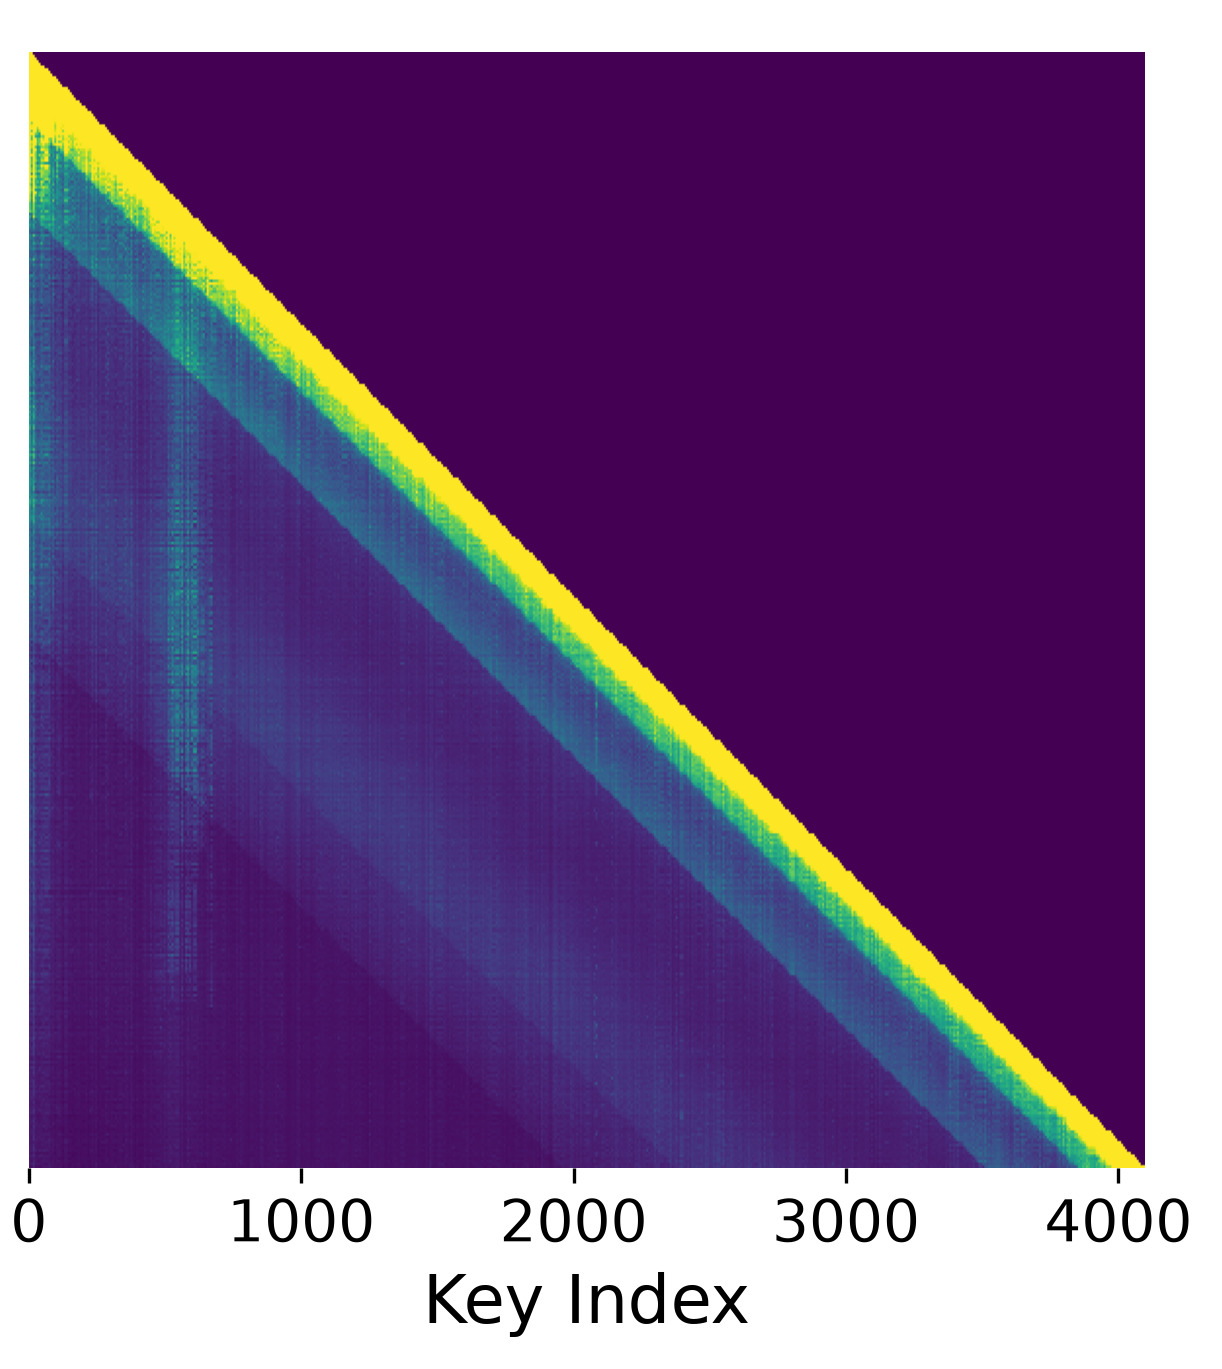
来源:原 Fig. 1 两侧面板,PDF p. 2;Qwen3-8B layer 0 head 20,100 条 PG19 序列、每条 4096 tokens 的平均注意力。亮线表示较大注意力;截断后远处的平行条纹明显减少。跨层、跨模型补充图位于 Figs. 15–18,pp. 35–38。这个例子支持“重复相位造成干扰”的解释;哪些通道实际有用仍取决于模型。
二:方法——从逐通道规则到 GPU 内核
2.1 精确 WavePrune 的计算
对 $j\le i$,原 Eq. (6) 定义
未来 token 仍用因果掩码设为 $-\infty$;随后按通常方式计算
这里有三个容易误解的细节。
- 截断的是某通道对 logit 的贡献。 被截断的项变成 0;不是将整个 token 对设为 $-\infty$。即使某个距离上所有通道贡献都被清零,logit 为 0 仍会参与 softmax。它与普通滑动窗口注意力有本质差别。
- 远程连接仍存在。 在某个距离,高频通道已经停止贡献,低频通道可能仍处于首周期,可以继续完成内容匹配。$V$ 的聚合路径保持通常形式。
- 归一化因子仍是 $\sqrt{d_h}$。 论文没有按保留的通道数重新缩放。掩码由频率与距离决定,不依赖本次输入内容,也不需额外学习参数。
阈值写成 $w_c=\alpha\pi/f_c$ 可控制剪枝强度;默认 $\alpha=2$ 对应一个周期,$\alpha\to\infty$ 回到不剪枝。由于距离通常是整数,实际保留条件等效于距离不超过 $\lfloor w_c\rfloor$。原公式在首周期边界使用 $\le$。(Sec. 3.1,PDF p. 4)
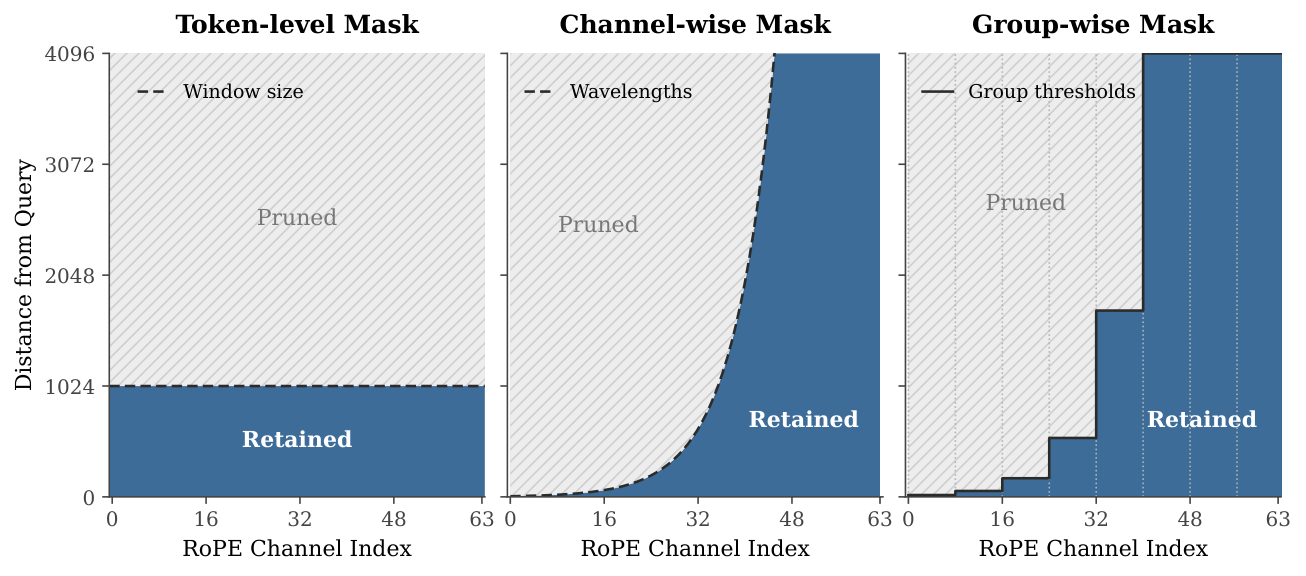
来源:原 Fig. 2,PDF p. 4。横轴为 RoPE 通道编号,纵轴为 query–key 距离,蓝色保留、斜线区剪除。左图是统一 token 窗口,中图是逐通道波长窗口,右图是硬件分组后的阶梯阈值。
教学例子。 对 $d_h=128,\theta=10^6$ 的原生频率,第 0 个通道波长约 $6.28$,第 31 个约 $5063$。距离为 100 时,前者被清零,后者仍可贡献;这能说明为何局部剪枝不会直接取消所有远程注意力。
2.2 理论:为什么多通道仍会出现近重复?
定理 1 的条件是各位置使用相同的 query $q_i=q$ 与相同的 key $k_i=k$。此时 logit 仅为滞后 $\Delta$ 的函数。记 $L^\star=\sup_{\Delta\ge0}L_\Delta$,则对任意 $\tau>0$ 和频率调度,存在无穷多个滞后满足
所以即使内容完全相同,最大 logit 附近的次对角线也会反复出现。(Sec. 3.2,Eq. (7),PDF p. 5;Appendix A,p. 18)
证明的关键不是找共同精确周期,而是在多通道相位空间找足够接近的返回点:
- 固定 Q/K 后,logit 是有限个余弦的加权和。余弦是 1-Lipschitz,故
- 所有相位都在有限维的 $[-\pi,\pi)^{d_h/2}$ 中。将其分为有限多个小格,无穷多个整数位置必有无穷多个落在同一格;这些位置差形成无穷多个近周期。
- 先找距上确界不超过 $\tau/2$ 的位置,再叠加扰动不超过 $\tau/2$ 的近周期,得到结论。
定理 2 的推广允许 Q/K 来自以均值为中心的对称 i.i.d. 分布;其反射论证使用独立的随机向量。对任意 $\tau>0$,存在无穷多个 $P$,使
这是一侧 logit 差界:竞争位置不会比目标位置低超过 $2\tau$ 的事件至少有 $1/4$ 概率,并非两个 logit 绝对差都很小。定义均值通道的敏感度
以 $t_i^s$ 表示降序排列后的敏感度,则最小这样的 $P$ 有界
直觉是小贡献通道可吸收进误差预算,只需细分少数敏感方向,周期上界的指数取决于有效敏感通道数。证明先用相位空间覆盖得到确定性界,再用关于均值的四种反射,其内积和等于四倍均值内积,推出至少 $1/4$ 的概率界。(Appendix B.2–B.4,PDF pp. 19–24)
softmax 的含义可直接推导:若目标与竞争位置的 logit 差不超过 $2\tau$,则目标注意力至多为 $1/(1+e^{-2\tau})$。取 $\tau=\tfrac12\ln((1-\epsilon)/\epsilon)$,即得原 Corollary 1 的 $A_{i,i-\Delta}\le1-\epsilon$ 概率下界。
这个理论解释了重复响应的结构来源;其有限长度意义取决于敏感度稀疏性。作者在 Appendix B.3 的脚注也指出:图上贡献稀疏不必然意味着上述 $\sigma_\tau(t)$ 很小,因为大范数向量的点积仍可能接近零。常量 Q/K 定理与对称独立分布也不同于真实上下文相关的隐藏状态。实验提供了实际长度上确实出现条纹的证据。
WavePrune 用有限支撑替代每通道无限延伸的余弦,因而可以破坏这种首峰反复回归的结构。它不会自动使每个真实注意力头都只保留唯一峰:内容差异及模型已学习的功能仍会起作用。
2.3 FlashWavePrune:让稀疏规则适配 Tensor Core
精确规则的障碍在于每个二维通道有不同的距离谓词,QK 不再是一次普通矩阵乘法。FlashWavePrune 将 16 个标量 head dimensions,也就是 8 个二维 RoPE 通道组成一组,与 MMA 指令的收缩维度 16 对齐。每组阈值取组内最大值:
$d_k$ 是标量维度所属通道的波长阈值。取最大值意味着保留部分超过本通道首周期的贡献,属于对精确掩码的放宽。组内先做标准 GEMM,再对该组结果统一掩码;大部分实验默认使用这一近似实现。(Sec. 3.3,PDF pp. 6–7)
对一个 query block 和 key block,距离构成区间 $[l_D,r_D]$。按每组阈值分类:
| 条件 | 处理 | 获得的节省 |
|---|---|---|
$d'_g| 整组跳过 | 少做 QK;decode 少读该组 K cache | |
$l_D\le d'_g| 先算组内 GEMM,再逐位置掩码 | 仅边界组支付掩码开销 | |
| $d'_g\ge r_D$ | 直接走完整保留的后缀 GEMM | 使用标准 FA2 计算路径 |
阈值按维度单调增加,因此只需 splitL、splitR 两个分界点。前向内核只为当前模型真正可达的分界组合做编译特化,避免穷举导致代码膨胀。反向中 head dimension 变为输出轴,需在 MMA 前掩码梯度操作数;联合计算 $dQ,dK$,共享一次掩码。反向的完整双分界特化会引起局部内存与调用开销,因此只对后缀边界特化。(Appendix C,PDF pp. 25–27)
计算上的实际取舍:当前实现主要优化 QK 路径,softmax 和 AV 仍遵循 FA2 路径。因此论文给出的收益是内核常数级加速,不能直接解释为整层线性复杂度。按通道驱逐过期 K cache 的容量节省留作未来工作;减少读取流量与降低已分配 KV cache 大小是两件事。
三:实验——每组实验检验什么?
3.1 无训练集成:质量能否保持?
Baseline 是同一个模型的原始注意力;WavePrune 无微调地替换注意力计算,并沿用模型自身的频率缩放。评测涵盖 Qwen3-8B/32B、Gemma3-12B、Ministral3-3B、Llama3.1-8B。Qwen 超过 32K 使用 YaRN,并关闭 thinking mode。
长上下文评测取 HELMET 的六类任务:Recall(检索隐含信息)、RAG(噪声语料问答)、Re-rank(段落相关性排序)、Cite(带引用长回答)、LongQA(长文档问答)、ICL(大量示例下分类)。各项及均分越高越好。论文将 64K、128K 两个长度的结果平均,并报告跨任务标准差。
这里使用了调整后的 HELMET 协议:NarrativeQA 改用 ROUGE-1 F1,Summ 摘要任务被删除;RULER MV 与 JSON KV 的最大输出长度分别提高至 200、300。它们影响分数的定义,所以比较应限于本论文同协议下的 baseline。Table 1 的灰色标准差是任务层面变异。(Sec. 4.1,PDF pp. 7–8;Appendix D,pp. 27–28)
通用能力使用 lm-evaluation-harness 默认配置,涵盖 MMLU、CMMLU、BBH、DROP、GSM8K、MATH、MBPP、HumanEval。完整通用表只列上述前四个模型,没有给出 Llama3.1-8B 行。
3.2 从头预训练:模型能否学会更易外推的模式?
GPT2-base/medium/large 分别为 117M/345M/774M,将绝对位置嵌入替换为 base $10^4$ 的 RoPE。在 OpenWebText 上训练 64,000 步,训练长度固定 2048,外推验证长度 4096;每步有效 batch 为 120 条序列,总计约 15.7B tokens。使用 AdamW、学习率 $6\times10^{-4}$、2000 步 warmup 后余弦衰减。对每个规模配对比较启用/禁用 WavePrune,并在 medium、large 上检查训练与评估的四种开关组合。指标为验证 loss,越低越好。(Sec. 4.2,PDF p. 8;Appendix G,p. 29)
3.3 两个合成任务:把短程与远程需求分开
- Tetranacci:$a_n=(a_{n-1}+a_{n-2}+a_{n-3}+a_{n-4})\bmod1000$。只需近四项,数字经 GPT-2 tokenizer 编码并以 EOT 分隔;初始四项和 padding 不计 loss。重复四项状态会导致数列周期,构造时剔除这种样本,避免任务自身周期性混淆 RoPE 分析。
- NIAH:在 OpenWebText 背景中随机插入七位 magic number,末尾要求取回。只对目标数字与最终 EOT 监督,测试远程检索。
二者各有 50 万样本,99:1 划分,GPT2-base 训练长度 2048、验证 4096。前者看近邻质量是否随长度变差,后者看远程检索是否受高频距离振荡干扰。(Sec. 4.3,PDF pp. 8–9;Appendix F,pp. 28–29)
3.4 系统实验与消融
在 NVIDIA A100 上比较 FlashWavePrune 与 FlashAttention-2:bf16、batch 32、GQA 32 个 query heads / 8 个 KV heads、因果注意力,主设置 $d_h=128$,另有 $d_h=64$。Prefill 在 3 次 warmup 后取 10 次计时中位数;decode 在 10 次 warmup 后取 50 次中位数。加速比为 $t_{\mathrm{FA2}}/t_{\mathrm{WP}}$,越大越好。
质量消融则使用 Qwen3-8B、32K HELMET,改变 $\alpha$、精确/分组实现及被截断的高频通道数量。该 32K 实验的分数不能与 Table 1 的 64K/128K 均分直接混用。
四:结果——收益在哪里,失败在哪里?
4.1 长上下文:四个模型均分提高,任务间有取舍
| 模型 | Baseline | WavePrune | 均分变化 |
|---|---|---|---|
| Ministral3-3B | 39.1 | 39.7 | +0.6 分 |
| Qwen3-8B | 35.7 | 40.0 | +4.3 分 |
| Gemma3-12B | 38.2 | 38.7 | +0.5 分 |
| Qwen3-32B | 55.1 | 56.3 | +1.2 分 |
| Llama3.1-8B | 38.2 | 35.2 | −3.0 分 |
来源:Table 1,PDF p. 8;六任务、64K/128K 平均,分数越高越好。Qwen3-8B 的 +4.3 是分数差,约相对提高 12%,两者不能混称为 4.3% 提升。
Qwen3-8B 的 Recall 为 63.7→69.7,Re-rank 为 14.7→21.6,ICL 为 22.9→32.9;但 Cite 为 15.7→15.2。Qwen3-32B 也有 Recall 79.1→86.5 与 Cite 27.1→23.9 的取舍。平均改善并非每类任务都改善。
分长度看,Qwen3-8B 的均分在 64K 为 37.77→41.65,在 128K 为 33.52→38.28;Ministral 的对应改善只有 42.03→43.19、36.16→36.27。后者的长长度收益很小。Llama 在两个长度都变差:40.88→37.07、35.54→33.35。(Tables 8–9,PDF p. 31)
PG19 上的语言建模结果提供补充:Qwen3-8B 在 32K、无 YaRN 时 NLL 曲线几乎重合;128K、使用 YaRN 时 WavePrune NLL 更低。(Fig. 11,PDF p. 30)
4.2 通用任务:列出的四个模型均值小幅改善
| 模型 | 八项通用任务均分:Baseline → WavePrune |
|---|---|
| Ministral3-3B | 47.47 → 48.10 |
| Qwen3-8B | 63.77 → 64.09 |
| Gemma3-12B | 55.77 → 56.15 |
| Qwen3-32B | 52.05 → 52.91 |
来源:Table 7,PDF p. 31。这些结果说明在所列短上下文任务上,大规模修改 logit 组成仍可保留整体能力;各单项有升有降。不能把这一表扩展为 Llama 的通用能力结论。
4.3 预训练:训练时纳入规则比只在推理时启用更好
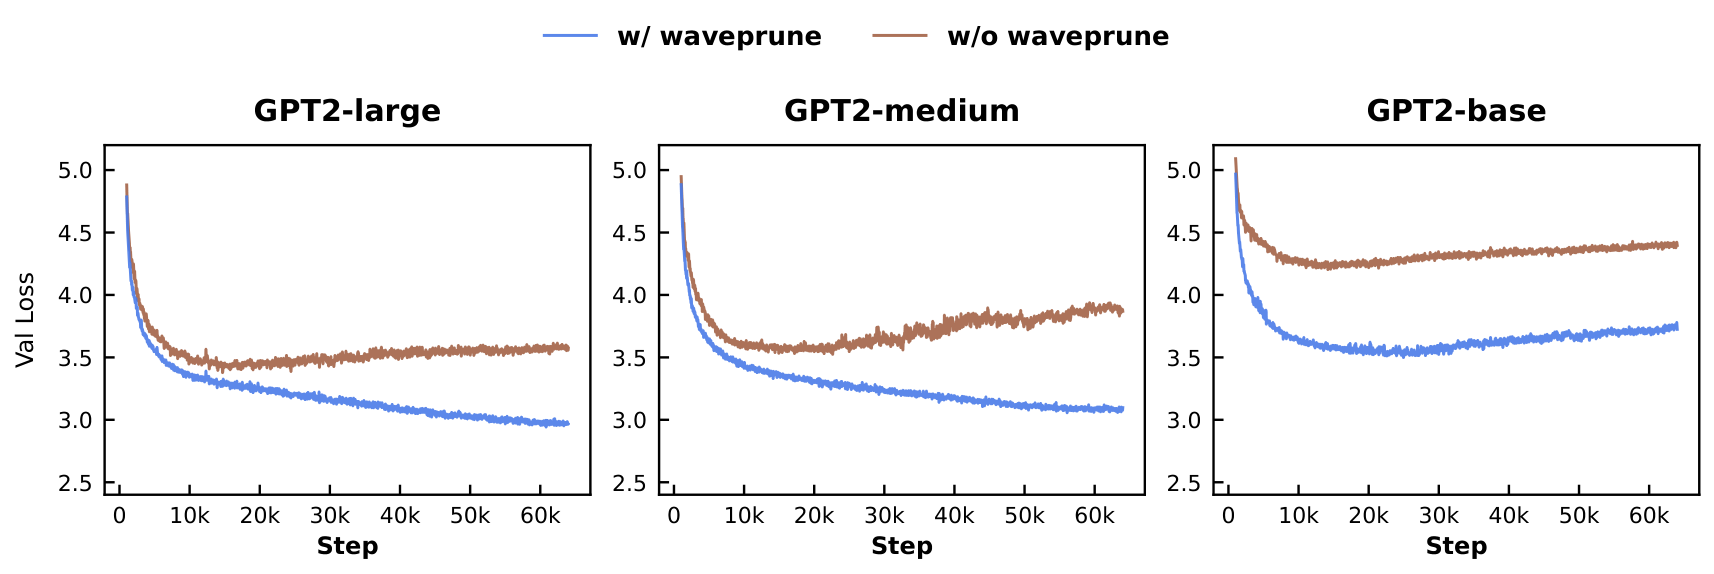
来源:原 Fig. 6,PDF p. 9。横轴训练步数,纵轴长度 4096 的验证 loss;左中右是 large、medium、base,蓝色为 WavePrune,棕色为 baseline。三个规模都降低外推 loss;baseline 后期的外推 loss 反升,WavePrune 对此有所缓解。
Table 10 的精确结果更能分清机制:
| 模型 | 预训练 | 评估 | Loss @2048 ↓ | Loss @4096 ↓ |
|---|---|---|---|---|
| GPT2-medium | 原始 RoPE | 原始 RoPE | 3.0270 | 3.8564 |
| GPT2-medium | 原始 RoPE | WavePrune | 3.0261 | 3.3314 |
| GPT2-medium | WavePrune | 原始 RoPE | 3.6210 | 4.3849 |
| GPT2-medium | WavePrune | WavePrune | 3.0196 | 3.0953 |
| GPT2-large | 原始 RoPE | 原始 RoPE | 2.9009 | 3.5618 |
| GPT2-large | 原始 RoPE | WavePrune | 2.9003 | 3.1797 |
| GPT2-large | WavePrune | 原始 RoPE | 3.7816 | 4.5162 |
| GPT2-large | WavePrune | WavePrune | 2.8974 | 2.9536 |
来源:Table 10,PDF p. 32。仅推理启用已经有用;训练、推理都启用得到更低 loss。反过来,训练时启用后又在推理时关闭,会明显变差,说明模型适应了截断后的计算规则。域内 2048 loss 则与 baseline 接近。Fig. 12(p. 30)表明训练后增大 RoPE base 时,WavePrune 的外推优势仍存在。
4.4 控制实验:短程保真与远程稳定
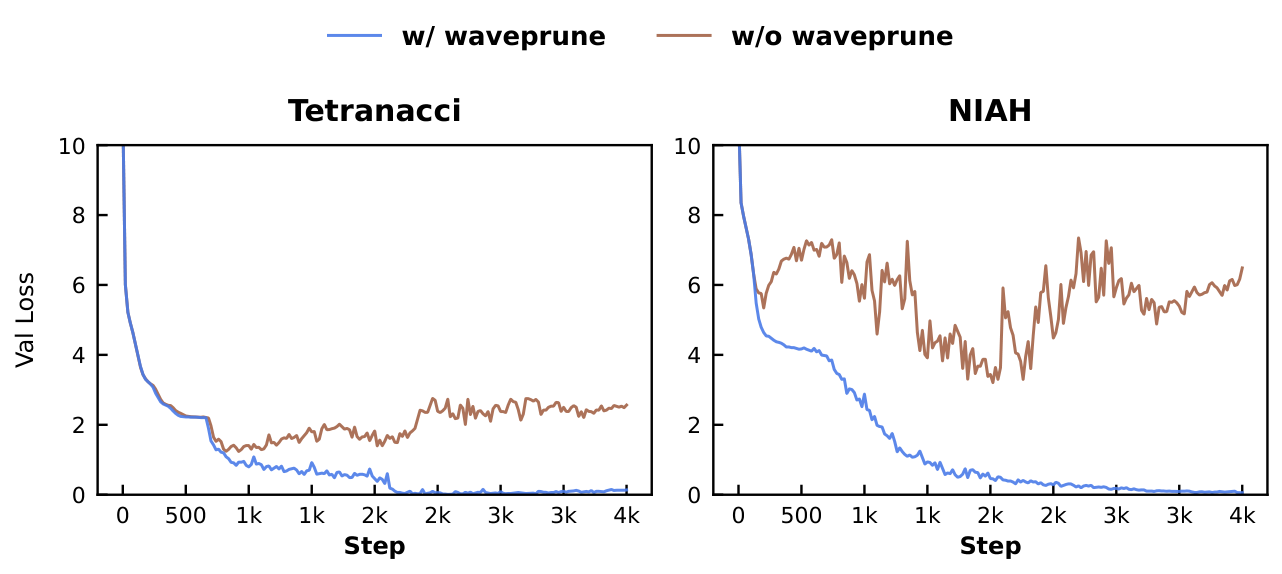
来源:原 Fig. 7,PDF p. 10。横轴训练步数、纵轴 4096 长度验证 loss;左右为 Tetranacci、NIAH,颜色与 Fig. 6 一致。两个任务都明显降低外推损失。
Tetranacci 测量距离不超过 15 的近邻注意力,在 12 层上平均:baseline 从训练长度的 0.161 降到验证长度的 0.123,保留率 76.7%;WavePrune 为 0.179→0.148,保留率 82.8%。后者既有更多局部注意力,也在外推时少流失 6.1 个百分点的保留率。(Table 13,PDF p. 33;保留率按原表报告,注意原始均值已经四舍五入。)
NIAH 的 Table 14 选择各模型按层/头顺序排列的前八个 retrieval heads,展示四条验证样本中最终答案 token 对 magic number 邻域(距离≤5)的平均注意力。WavePrune 的前几个头更持续地关注目标;四样本 loss 为 0.030、0.005、0.003、0.001,baseline 则为 6.328、4.734、10.840、5.767。原表也有 WavePrune 第五个头在两个样本注意力为 0,因此应理解为检索行为总体更稳定,而非每个头在每个样本都激活。(PDF p. 33)
这些结果分别支持作者的两种解释:远处重复峰会稀释近邻注意力;在适合低频检索的模型中,移除远距离高频振荡能稳定目标匹配。
4.5 Llama 的反例:高频未必只做局部计算
Llama3.1-8B 的退化主要集中在检索。作者检查一个 32K NIAH 例子:needle 位于中段,layer 16 head 21 依靠波长约 571 的通道把远处 needle 信息传到最终 token。实际距离远超 571,但信号仍稳定有效;WavePrune 恰好删去了它。
作者尝试提高 $\alpha$、只截断最前面的高频通道、仅修改开头或末尾层、按 ProLong 配方继续训练 base/instruct 模型,均未恢复原 baseline。(Appendix E,PDF p. 28)这给方法划出具体适用条件:频率提供的是尺度先验,已训练模型可以将高频通道用于跨周期内容检索;统一阈值会破坏这种分工。
4.6 系统效率:前向节省明显,反向收益有限
| 场景($d_h=128$) | 长度 | FA2 延迟 | WavePrune 延迟 | 加速比 |
|---|---|---|---|---|
| Prefill | 8K | 82.17 | 75.03 | 1.10× |
| Prefill | 32K | 1306.79 | 1132.27 | 1.15× |
| Prefill | 64K | 5337.95 | 4490.98 | 1.19× |
| Decode | 8K | 0.826 | 0.734 | 1.13× |
| Decode | 32K | 3.059 | 2.459 | 1.24× |
| Decode | 128K | 12.193 | 9.528 | 1.28× |
来源:Table 11,PDF p. 32,A100、bf16、batch 32、GQA 32/8。原 Table 11 的延迟列未明确写单位;正文与邻近内核表使用毫秒,这里保留原始数值与比值,不自行补列单位。128K、H128 prefill 两者均 OOM;H64 的 32K prefill/decode 仅为 1.09×/1.05×,显示 head dimension 对收益很重要。
32K H128 的 1.15×/1.24× 是延迟比,按原始数值换算的延迟降低约为 13.4%/19.6%;不是整模型吞吐必然提高 15%/24%。Prefill 主要节省 QK FLOPs,decode 还减少 K 读取,AV 路径仍保留。
系统消融中,去掉分界特化会使 H128 prefill 相对最终内核慢 1.47×,去掉只计算保留后缀的 QK GEMM 则慢 1.46×;decode 去掉仅加载后缀 K 会慢 1.14×。H64 decode 的后一项比值为 0.99×,因此作者“每项都必要”的概括存在这个小例外。(Table 3,PDF p. 26)
反向延迟在 8K 为 93.30→101.31 ms(+8.58%),16K 为 363.24→377.08 ms(+3.81%),32K 为 1434.34→1436.88 ms(+0.18%)。因此不能把前向加速直接推广为相同比例的训练加速。(Table 4,PDF p. 27)
4.7 消融:一个周期是有效默认值,分组近似有条件地准确
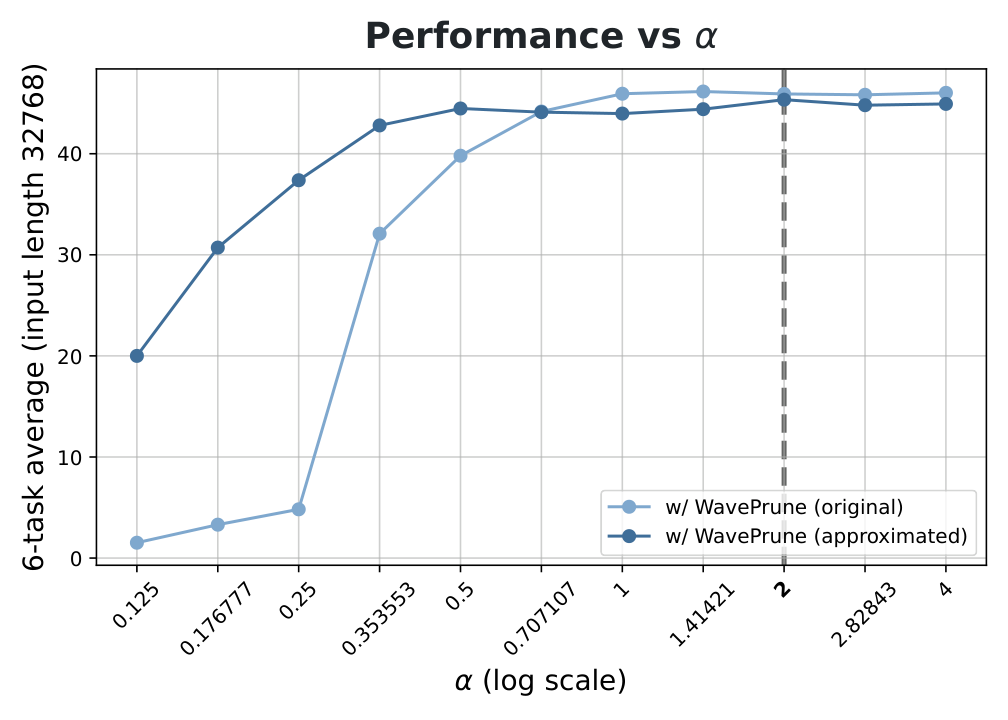
来源:原 Fig. 8a,PDF p. 11。横轴为对数尺度 $\alpha$,纵轴为 Qwen3-8B、32K 的六任务均分;浅色是精确截断,深色是分组近似,虚线 $\alpha=2$ 为首周期。精确版在略小于 2 处最高,近似版在 2 附近最高,温和阈值下二者接近;很小 $\alpha$ 时二者差异很大。原因是组最大阈值放宽了组内高频通道的窗口。
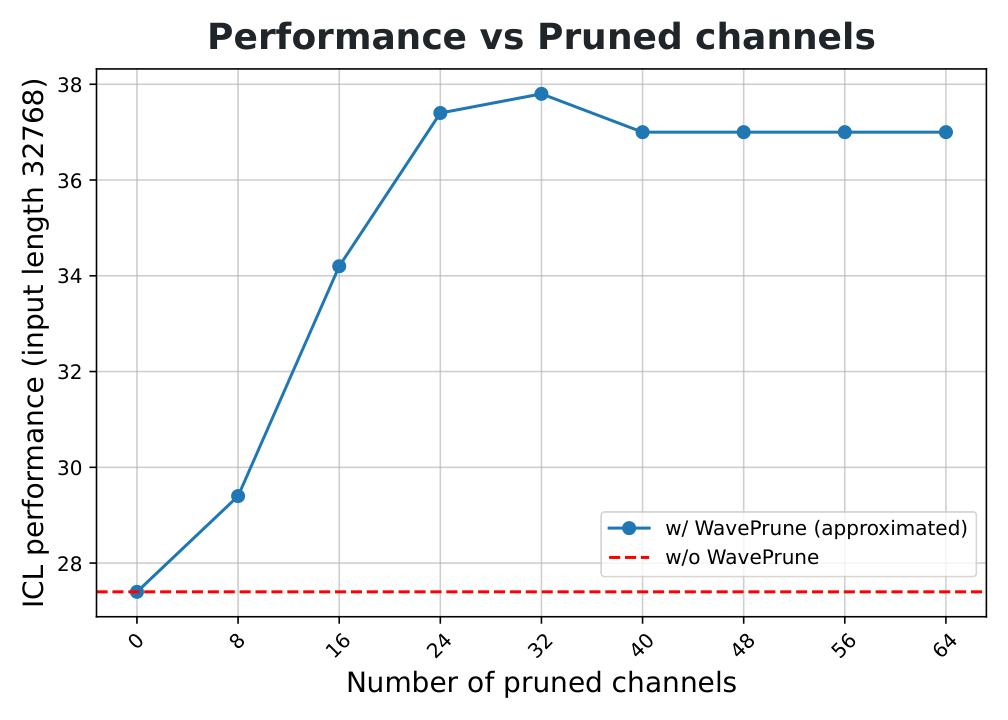
来源:原 Fig. 8b,PDF p. 11。横轴为从最高频起启用截断的通道数,纵轴仅是 ICL 分数。8、16、24 个通道附近有明显提升;32 后再加到 40 有小幅回落,40 以后平台。原生 Qwen3 的组末通道 7/15/23/31/39/47 波长约为 28/160/900/5063/28472/160114 tokens(Table 12,p. 32);后续组的窗口已超过 32K,继续启用截断不会改变当前上下文的计算。这说明收益覆盖多个频段,也不能将曲线理解成严格单调提升。
五:结论与启发
WavePrune 将位置编码分析与硬件稀疏计算连在一起:相位重复解释了某些注意力条纹,首周期截断提供无需学习的规则,16 维分组则将规则转换为 Tensor Core 可执行的计算路径。其贡献既包括四个预训练模型上的均分改善,也包括预训练时更好的 2× 长度外推,以及可测量的前向内核加速。
与修改 RoPE 频率的方法相比,它保留现有频率,在频率对应的距离上限制贡献,因此可以结合 YaRN 等缩放。与普通稀疏注意力相比,它同时沿序列距离与 head dimensions 施加掩码。论文还明确讨论同期 ATFlash:两者均采用波长相关窗口和硬件分组,作者将本工作的区别归纳为首周期而非默认两周期、幽灵次对角线分析、以及从头预训练实验。(Sec. 5,PDF pp. 10–11)
本次分析认为,最值得继续研究的是按头的功能选择阈值:前一个 token 头与 Llama 的远程 retrieval head 不应仅凭相同频率使用完全相同的窗口。作者也提出 head-specific thresholds 与微调作为后续方向;不过恢复 Llama 退化的直接尝试尚未成功。其次,当前系统只利用部分 K 读取与 QK 计算的稀疏性,KV 容量回收仍有实现空间。预训练证据目前来自 117M–774M、2048→4096 的设置,更大训练规模及更大外推倍数会是决定方法价值的下一步实验。