Balancing Memory Pathways:混合语言模型的记忆利用与辅助监督
原题:Balancing Memory Pathways: Analyzing and Improving Memory Utilization in Hybrid LMs
作者:Hyunji Lee、Joykirat Singh、Zaid Khan、Justin Chih-Yao Chen、Elias Stengel-Eskin、Alessandro Sordoni、Arman Cohan、Mohit Bansal
版本:arXiv:2610.06750v1,2026-10-05 提交;研读日期:2026-11-13。
原文:本地 PDF;英文汇报 PDF;可编辑 TeX。本文页码均指从 1 开始的 PDF 页码。
论文总览
这篇论文研究一个训练问题:模型具备互补的记忆通路,是否就会学会同时利用它们? 对注意力与递归层交替组成的混合语言模型,作者的回答是否定的。普通监督微调(SFT)提高了任务分数,但收益主要体现为对注意力通路的依赖增加,递归状态携带历史信息的能力没有同步改善。
方法很直接:同一个训练样本做正常的完整通路预测,再做一次“注意力不能跨越历史—当前边界、递归状态仍连续传播”的预测。两者使用相同的监督目标,以 $\mathcal L_{\mathrm{SFT}}+0.25\mathcal L_{\mathrm{rec}}$ 联合优化。第二项让过去的信息必须经过递归状态才能影响当前答案;正常分支保留两条通路一起工作的训练条件。推理时使用完整模型。
在作者的训练预算匹配协议下,六个 QA 数据集的微平均分数在 Qwen3.5-4B 上从 34.6 提高到 38.5,在 Nemotron-H-4B-Instruct 上从 31.0 提高到 36.2;Qwen 的 recurrent-only 分数则从 5.0 提高到 22.8。智能体任务中两模型的平均增益在 BabyAI PutNextLocal 达到 22.0 个百分点。更有启发性的是附录:纯注意力模型同时获得文本摘要与隐式 KV 记忆时,也会偏用前者;按信息类型分配辅助监督后,联合记忆分数从 24.1 提高到 28.6。
主要贡献是记忆利用的诊断和训练目标设计。 “平衡”指改善被忽视通路的可用性并提高整体结果,并未要求两条通路在所有样本上贡献相等。
结构地图
| 原文章节 | 论证作用 | PDF 位置 |
|---|---|---|
| 1 Introduction | 提出记忆利用失衡及辅助监督思路 | pp. 1–3,图 1 |
| 2 Background & Related Work | 混合结构、两类通路的相对优势 | pp. 3–4,图 2–3 |
| 3 Experimental Setup | 模型、训练与任务 | pp. 4–5 |
| 4 Standard SFT Favors Attention over Recurrence | 定义通路干预,比较 SFT 前后 | pp. 5–6,图 4–5 |
| 5 Encouraging Recurrent Memory Use Improves Performance | 目标函数及 QA、智能体结果 | pp. 6–8,表 1–2、图 6 |
| 6 Auxiliary Supervision Generalizes | 失败重试、成功示范和双记忆扩展 | pp. 8–10,图 7–8 |
| 7 Conclusion | 多通路结构需要针对性的训练 | p. 10 |
| A Details on Role Analysis | 问题分组与平衡抽样 | p. 14 |
| B Details on Experimental Setup | 指标、训练轮数与智能体协议 | p. 14 |
| C Additional Analysis | 权重、重试与文本/隐式记忆方法及消融 | pp. 14–18,图 9–11、表 3、式 (1) |
一:动机——增加记忆通路为何仍然不够?
1.1 两种历史访问方式
注意力层可以直接访问过去 token 的 KV,适合精确回忆某个实体、位置或原句;其完整序列计算随长度呈二次增长,KV cache 随长度增长。线性递归层,如 Gated DeltaNet 和 Mamba2,则把历史持续写入固定大小状态,序列计算线性增长,状态大小不随长度增长。后一种方式更有利于紧凑整合信息,但精确细节可能在状态更新中丢失。(Sec. 2.1,PDF p. 3)
混合模型同时拥有两种机制,仍面临训练上的选择:若正常任务损失可以主要靠注意力下降,递归状态未必学到另一种有效的信息组织方式。作者并未从优化动力学推导这种偏好,而是先用干预实验观察它,再用针对性的监督改变它。
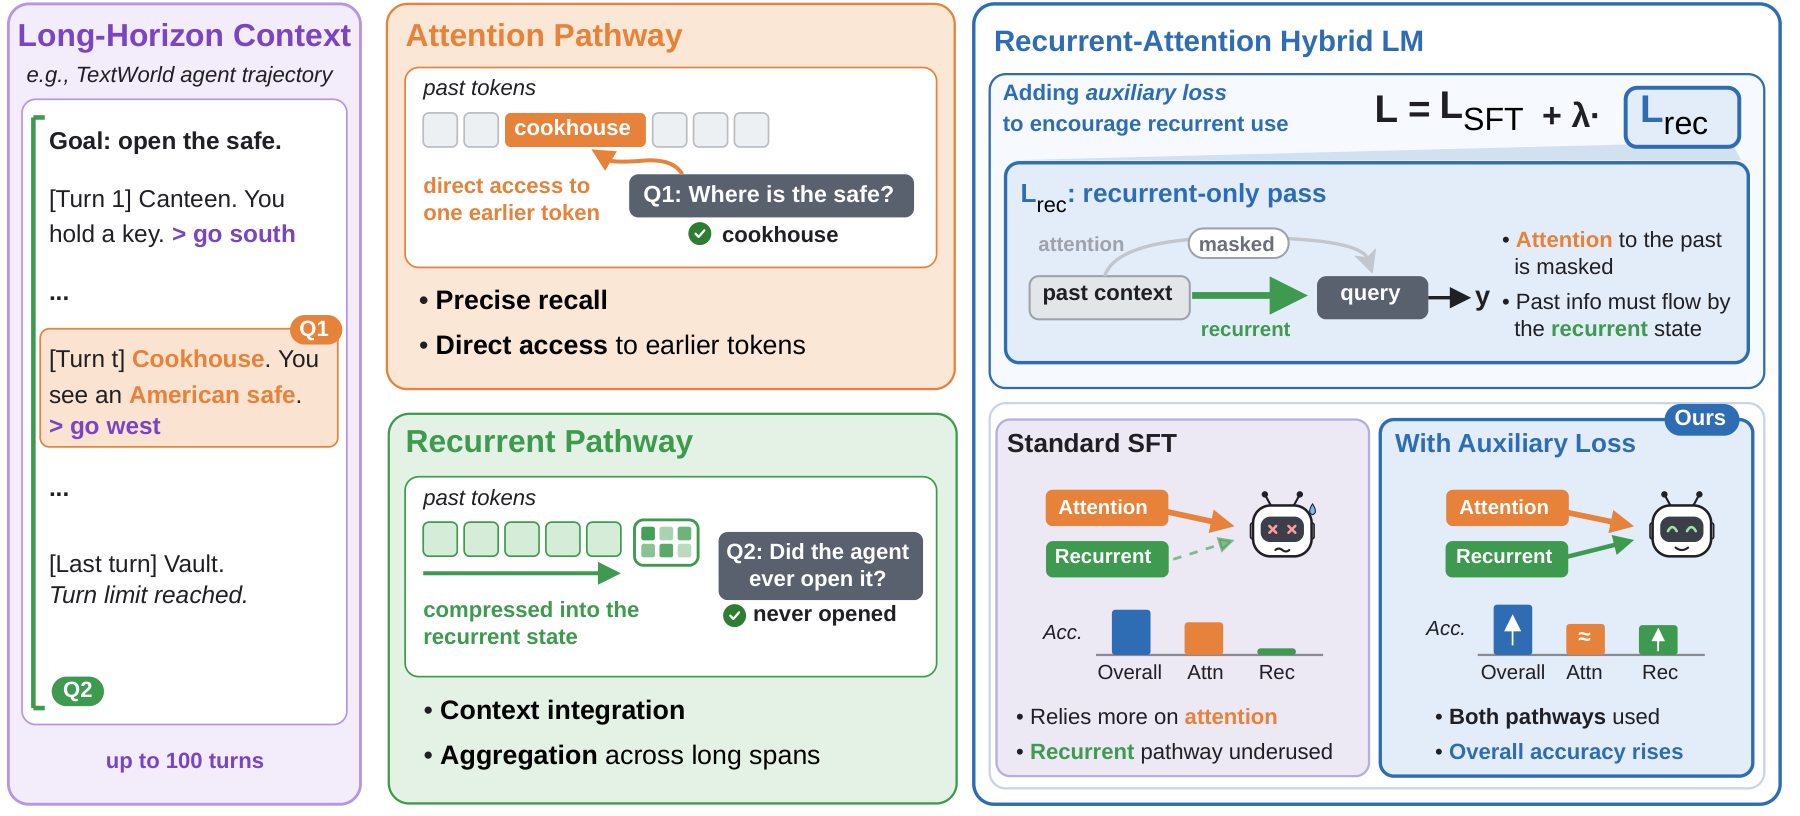
原图 1,PDF p. 2。中间展示两类记忆的访问方式;右侧展示训练时阻断注意力跨历史边界的辅助分支。图中的“记住保险柜位置”与“判断是否曾经打开保险柜”用于说明精确回忆与跨轨迹整合的区别。
1.2 “互补”有哪些证据?
首先,作者对 Qwen3.5 做整类层的消融,观察相对原模型的负对数似然增量 $\Delta\mathrm{NLL}$,越大说明被消融的部分对该评估越重要。
| 评估任务 | 消融注意力层 | 消融递归层 |
|---|---|---|
| Based NQ:检索问答 | +5.3 | +1.5 |
| PG19:语言建模 | +1.3 | +3.7 |
来源:Sec. 2.2,图 2,PDF pp. 3–4。语言建模一行按图例读取:注意力是 1.3,递归是 3.7。检索与语言建模的反向敏感性支持两者角色不同;“递归更善于整合”是作者结合任务属性作出的解释。
接着,作者使用更细的跨段信息传递干预,比较不同 QA 类型。定义注意力保留率:
它表示递归状态不能跨段时还能保留多少完整模型分数。两种问题划分分别平衡样本量,不是把所有测试样本强行分为四个互斥类别。
| 问题类型 | Full | Attention-only | 保留率 |
|---|---|---|---|
| Verbatim:归一化答案出现在文档中 | 48.7 | 30.8 | 63% |
| Non-verbatim:归一化答案不在文档中 | 20.5 | 9.5 | 46% |
| Single-evidence:单证据 | 33.6 | 20.2 | 60% |
| Multi-evidence:多证据 | 28.3 | 14.2 | 50% |
来源:图 3,PDF p. 4;附录 A,p. 14。Verbatim 约占测试集 34.6%,约 2.8k 个,与等量非逐字样本比较;单证据约 2.5k,多证据约 3.3k,后者下采样到约 2.5k。缺少证据标注的样本不参与后一比较。
非逐字、多证据问题在关闭递归跨段传递时损失更大,支持它们更需要状态中的历史整合。这里的保留率是整个混合模型在干预条件下的行为,不能等同于纯 Transformer 与纯递归模型的比较。
二:方法——把诊断干预变成训练信号
2.1 Full、Recurrent-only、Attention-only 的精确定义
把输入划为 past 和 current 两部分。QA 中,past 是文档上下文,current 包含问题及其后续预测。干预控制的是历史信息能通过哪种机制跨越段边界;每段内部,两类层始终都在运行。(Sec. 4.1,PDF p. 5)
| 条件 | 注意力能否跨段访问历史? | 递归状态能否跨段传播? |
|---|---|---|
| Full | 能 | 能 |
| Recurrent-only | 不能 | 能 |
| Attention-only | 能 | 不能,边界处重置历史贡献 |
这一区别决定了结果如何解释:Recurrent-only 分数很低,说明当前模型难以仅通过递归状态传递任务所需的跨段信息,而不是说注意力层已被删除、模型变成了一台独立递归网络。Sec. 2 的整层消融与这里的干预也应区分。
2.2 Recurrent-only:阻断注意力的跨段边
令 $t$ 为当前 query 位置,$s$ 为 key 位置,$\sigma(t)$ 为 token 所属段。注意力归一化之前,加上掩码:
同段因果注意力保持不变,先前段的 KV 无法被当前段直接读取。递归层不重置,仍顺序处理整个序列。因此,文档中的信息要影响问题答案,必须先进入递归状态。掩码只规定注意力的连边关系,不规定状态具体应该记什么。(Sec. 4.1,PDF p. 5;原式未编号)
2.3 Attention-only:截断递归状态的跨段贡献
保留标准的全历史因果注意力,对 $t>1$ 的递归更新施加:
$S_t$ 是处理第 $t$ 个 token 后的状态;$\mathcal A_t$ 是作用在旧状态上的递归转移;$w_t$ 是当前 token 的写入项。段边界处指示函数为 0,旧段状态的直接贡献被截断,当前 token 的写入仍保留。式子是作者对干预的通用表示,不是把两种模型的具体状态转移都假定为同一种算法。(Sec. 4.1,PDF p. 5;原式未编号)
教学例子:输入为“文档|问题与答案”。Recurrent-only 在竖线处保留状态、屏蔽问题侧对文档 KV 的读取;Attention-only 在竖线处清掉递归历史,但问题仍能注意到文档 token。二者都可以在问题与答案这段内部使用注意力和递归计算。
2.4 辅助递归监督
作者用上述 Recurrent-only 条件重新计算同一监督目标,得到 $\mathcal L_{\mathrm{rec}}$,再联合正常损失:
$\theta$ 表示模型参数,实验以 LoRA 更新可训练适配器。两个分支都使用监督的 next-token 预测,差别是历史访问权限。完整分支学习同时使用两条通路,受限分支迫使任务相关的信息在递归状态中保留并被读出;它没有添加新记忆模块,也没有额外的递归状态标签。(Sec. 5.1,PDF p. 7;权重见附录 C.1,pp. 14–15)
正常分支很关键:只训练 $\mathcal L_{\mathrm{rec}}$ 会改变模型的整个训练信息条件,整体 QA 分数反而低于普通 SFT。作者还定义对称的 $\mathcal L_{\mathrm{attn}}$:用 Attention-only 干预计算同一目标,作为“继续强化已占优势通路”的对照。
训练预算:辅助目标增加了每步计算,作者把带辅助损失的优化步数减半,以匹配总训练计算。因而这里比较的是作者的计算匹配协议,不能把它描述为相同优化步数或相同样本暴露次数下的比较。推理使用 Full 条件,无需执行辅助分支;论文没有给出相应墙钟开销或推理提速测量。
三:实验——对象、指标与比较协议
3.1 模型与训练
| 项目 | 配置 |
|---|---|
| Qwen3.5-4B | 24 个 Gated DeltaNet 层、8 个全注意力层 |
| Nemotron-H-4B-Instruct | 24 个 Mamba2 层、4 个全注意力层 |
| 参数高效微调 | 各层 LoRA,rank 16、scaling 32、dropout 0.05 |
| 优化 | AdamW,学习率 $10^{-4}$,cosine,3% warmup,有效 batch 16 |
| 训练长度 | 5 epochs、early stopping;辅助目标按上述协议减半优化步数 |
来源:Sec. 3,PDF p. 4;附录 B,p. 14。主要通路诊断图展示 Qwen3.5,任务性能在两个混合模型上比较。纯注意力扩展另用 Qwen3-4B-Instruct。
3.2 QA 与智能体任务
QA 训练池来自 DROP、HotpotQA、Qasper、NarrativeQA,共 12k 训练、2k 验证样本。测试还加入未纳入该训练池的 MuSR 与 MINTEval,总计约 8.2k,平均上下文 84k tokens。DROP、HotpotQA、NarrativeQA、MINTEval 的大型测试集各抽取 1.5k;MINTEval 使用 wiki-revision 和 git-commit。(Sec. 3,PDF p. 5;附录 B.1,p. 14)
论文统一称“accuracy”,实际指标如下,均为越高越好:
| 数据集 | 指标 |
|---|---|
| Qasper、NarrativeQA | 归一化后的 token-level F1 |
| DROP、HotpotQA、MINTEval | 归一化后的 exact match(EM) |
| MuSR | 输入全部选项,生成选项文本,计算 EM |
表 1 的 Avg 是所有测试样本上的微平均,综合了各数据集规定的分数;不是六个数据集分数的算术平均,也不应解释为每一列都采用相同的二元正确率。
| 环境 | 训练 | 测试 | 成功条件/规模 |
|---|---|---|---|
| TextWorld | Quest | Quest、Treasure | 100 步内完成目标;训练 1,000、验证 150、测试 200 个游戏,种子不重叠 |
| BabyAI | MiniBossLevel | PutNextLocal、GoToObjMaze | 使用关卡官方步数上限;训练与各测试关卡各 100 个实例 |
智能体使用 gold trajectories 做 SFT,指标是完成目标的游戏比例。重试实验最多 7 次,把之前的失败轨迹提供在上下文中;成功示范实验从同一游戏的成功轨迹池抽 5 条示范。(附录 B.2,PDF p. 14)
四:结果——从失衡诊断到针对性修复
4.1 普通 SFT 提高任务分数,却很少改善递归跨段利用
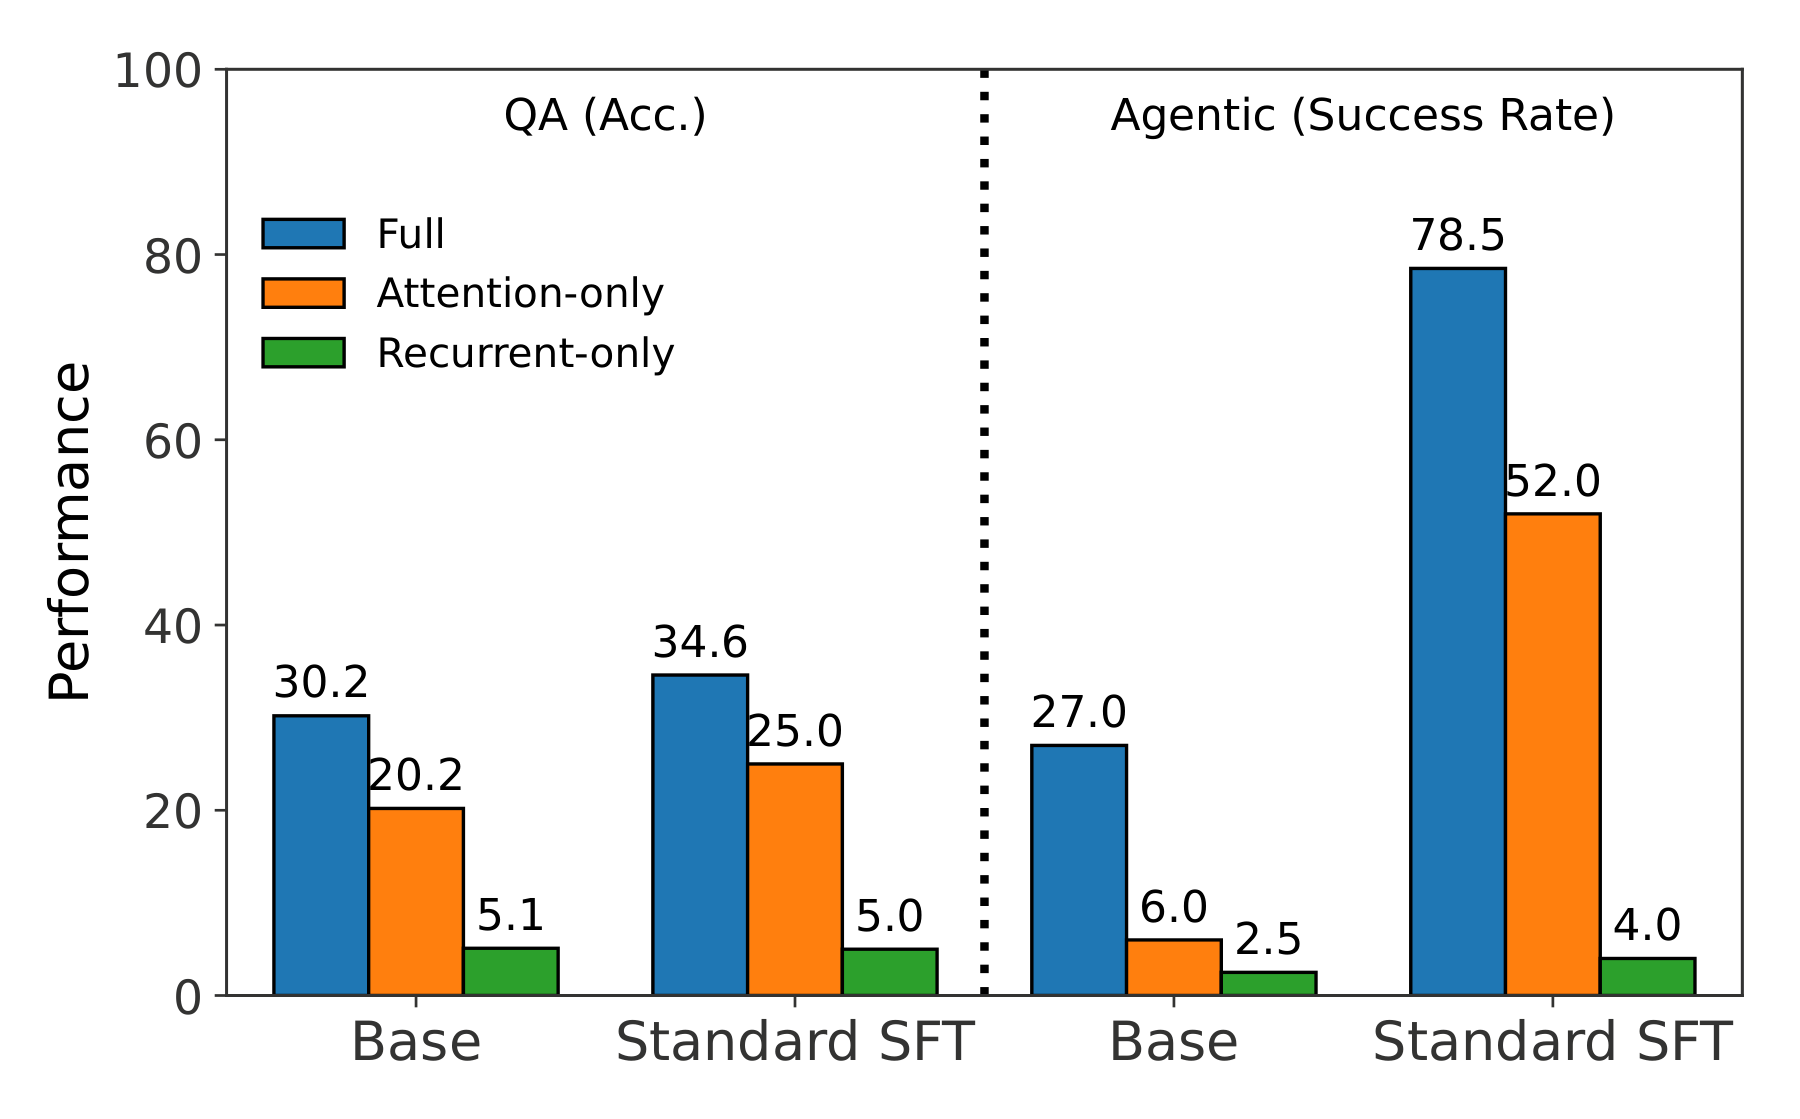
原图 4,PDF p. 6。横轴先比较 QA,再比较 Quest 智能体;每组分 Base 与 Standard SFT。纵轴为各自任务的百分制分数。蓝色 Full、橙色 Attention-only、绿色 Recurrent-only。
| Qwen3.5 任务与条件 | Base | 标准 SFT | 变化(百分点) |
|---|---|---|---|
| QA:Full | 30.2 | 34.6 | +4.4 |
| QA:Attention-only | 20.2 | 25.0 | +4.8 |
| QA:Recurrent-only | 5.1 | 5.0 | −0.1 |
| Quest:Full | 27.0 | 78.5 | +51.5 |
| Quest:Attention-only | 6.0 | 52.0 | +46.0 |
| Quest:Recurrent-only | 2.5 | 4.0 | +1.5 |
标准 SFT 的改进与注意力条件下的改进相伴,递归独立承担跨段传递时仍然弱。进一步按问题类型看,图 5 的注意力保留率增幅为:Verbatim +28.0、Non-verbatim +18.8、Single-evidence +23.0、Multi-evidence +19.5 个百分点。前两种注意力更占优势的类型(逐字、单证据)平均增幅 25.5;另两种平均约 19.2。(Sec. 4.2,PDF p. 6)
这也解释为什么要同时报告 Full 与通路干预分数:只看 Full 提高,会漏掉记忆利用结构几乎没有改善这一现象。
4.2 QA:长文档收益突出,短任务存在回退
下面保留表 1 的正常 SFT 与递归辅助两行。所有增益均是百分点。
| 数据集 | Qwen SFT | Qwen +Rec | 增益 | Nemotron SFT | Nemotron +Rec | 增益 |
|---|---|---|---|---|---|---|
| DROP | 48.6 | 46.9 | −1.7 | 42.4 | 44.5 | +2.1 |
| MuSR | 45.6 | 44.8 | −0.8 | 40.9 | 38.1 | −2.8 |
| HotpotQA | 43.1 | 44.0 | +0.9 | 38.7 | 42.1 | +3.4 |
| Qasper | 30.1 | 35.9 | +5.8 | 28.1 | 34.1 | +6.0 |
| NarrativeQA | 24.4 | 33.7 | +9.3 | 21.9 | 31.7 | +9.8 |
| MINTEval | 21.1 | 28.9 | +7.8 | 18.8 | 27.8 | +9.0 |
| 微平均 | 34.6 | 38.5 | +3.9 | 31.0 | 36.2 | +5.2 |
来源:表 1,PDF p. 7。Qasper、NarrativeQA、MINTEval 的增益明显较大。按这三项作为长上下文组、其余三项作为较短组,对两模型的六个增益等权平均,可以分别得到约 +8.0 与 +0.2 个百分点,对应引言中的分组总结;这是按数据集与模型等权汇总的增益,不是表尾微平均,也不是控制其他因素的纯长度实验。
短任务的回退同样值得保留:Qwen 的 DROP 与 MuSR 下降,Nemotron 的 MuSR 下降。辅助目标有明确的整体收益,但并未在所有数据集上占优。
4.3 通路变化与目标消融:需要“完整目标+弱通路辅助”
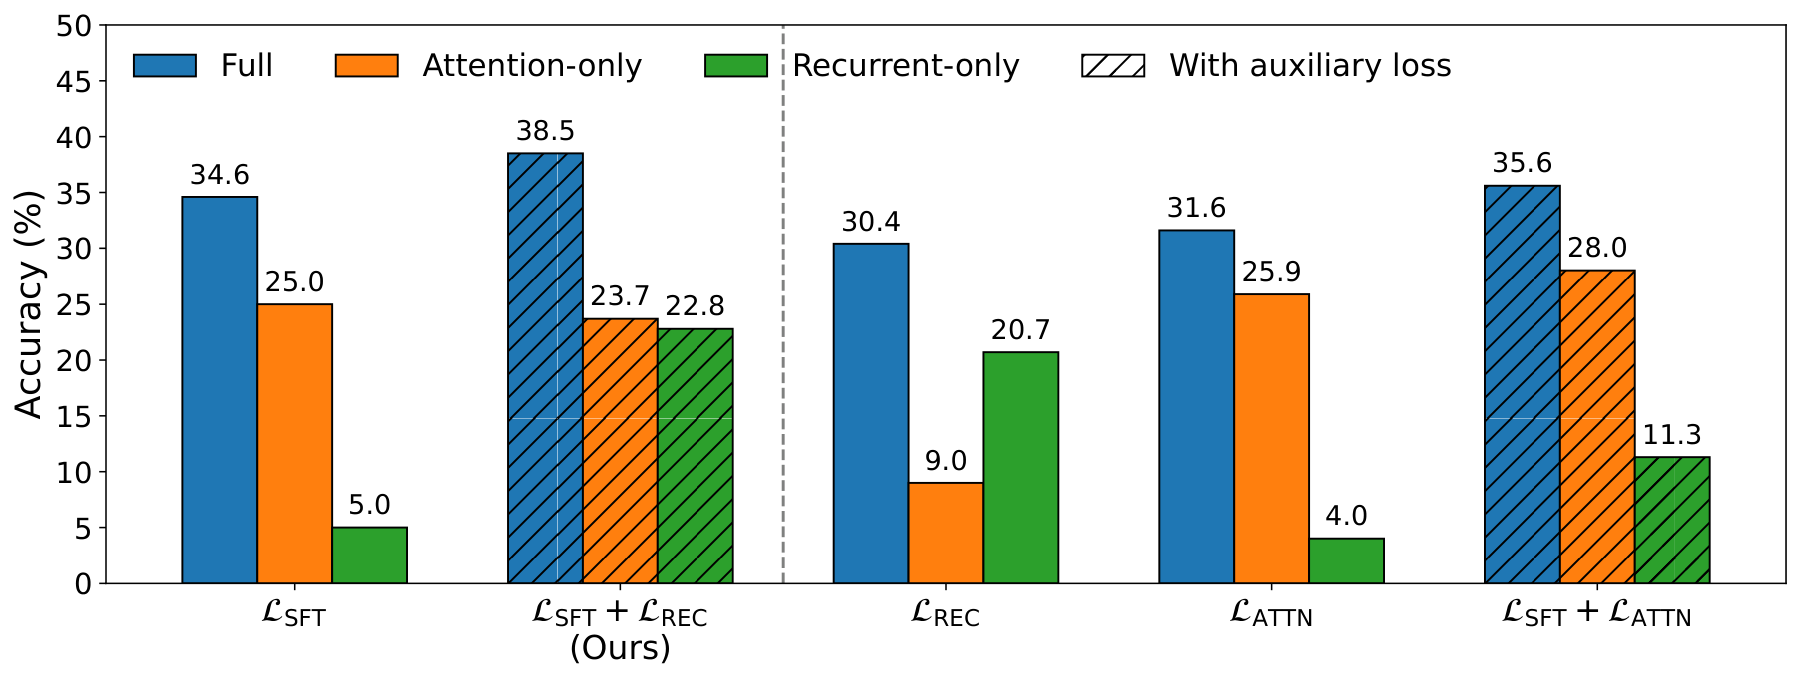
原图 6,PDF p. 8。横轴是训练目标,柱色仍表示 Full、Attention-only、Recurrent-only 的评估条件,斜线表示包含辅助损失。它同时回答“模型总体是否更好”和“目标强化了哪种历史访问能力”。
| Qwen 训练目标 | Full | Attention-only | Recurrent-only |
|---|---|---|---|
| SFT | 34.6 | 25.0 | 5.0 |
| SFT + Rec | 38.5 | 23.7 | 22.8 |
| Rec only | 30.4 | 9.0 | 20.7 |
| Attn only | 31.6 | 25.9 | 4.0 |
| SFT + Attn | 35.6 | 28.0 | 11.3 |
加入 Rec 辅助后,递归分数 +17.8,注意力分数 −1.3,整体 +3.9。这是作者“主要补强被忽略通路,同时大体保留另一通路”的直接证据。这里不需要两种干预分数完全相等。
两个模型的 Full 微平均消融如下:
| 目标 | Qwen | Nemotron |
|---|---|---|
| SFT | 34.6 | 31.0 |
| SFT + Rec | 38.5 | 36.2 |
| Rec only | 30.4 | 29.8 |
| Attn only | 31.6 | 31.4 |
| SFT + Attn | 35.6 | 34.1 |
来源:表 1,PDF p. 7。两模型等权平均,SFT + Rec 相对 SFT 约 +4.6,SFT + Attn 约 +2.1。只用受限目标的平均表现低于正常 SFT,说明辅助项应与 Full 训练共存。注意力辅助在某些短任务上更好,例如 Qwen DROP 54.0 对递归辅助 46.9;目标选择应结合任务的信息需求。
权重消融:图 9(PDF p. 15)在 Qwen 的 TextWorld Quest 上扫描 $\lambda=0,0.25,0.5,0.75,1.0$。所有非零测试值均超过 SFT 的 78.5;图中 0.25 和 0.5 都约为 80.5,作者选用 0.25 作为统一设置。该实验支持在所测区间有收益,不构成跨任务最优权重的系统搜索。
4.4 智能体:BabyAI 的增益更大
| 模型与目标 | Quest | Treasure | PutNextLocal | GoToObjMaze |
|---|---|---|---|---|
| Qwen SFT | 78.5 | 44.0 | 46.0 | 63.0 |
| Qwen SFT + Rec | 80.5 | 56.0 | 73.0 | 83.0 |
| Qwen 增益 | +2.0 | +12.0 | +27.0 | +20.0 |
| Nemotron SFT | 70.5 | 40.5 | 30.0 | 77.0 |
| Nemotron SFT + Rec | 75.5 | 47.0 | 47.0 | 84.0 |
| Nemotron 增益 | +5.0 | +6.5 | +17.0 | +7.0 |
| 两模型平均增益 | +3.5 | +9.25 | +22.0 | +13.5 |
来源:表 2,PDF p. 8。论文将 Treasure 的 9.25 四舍五入为 9.3。任务内所有训练目标的对照如下,数字顺序为 Quest / Treasure / PutNextLocal / GoToObjMaze:
| 模型 | Rec only | Attn only | SFT + Attn |
|---|---|---|---|
| Qwen | 75.5 / 45.0 / 13.0 / 37.0 | 76.5 / 44.0 / 31.0 / 50.0 | 77.0 / 49.0 / 47.0 / 70.0 |
| Nemotron | 68.5 / 40.0 / 17.0 / 20.0 | 71.5 / 42.0 / 37.0 / 54.0 | 72.0 / 44.5 / 43.0 / 80.0 |
递归辅助在这四项、两个模型上都优于 SFT,注意力辅助平均增益更小;仅训练受限目标尤其损害 BabyAI。作者指出 BabyAI 全部轨迹平均 134.0 步,TextWorld 为 42.2 步;仅成功轨迹分别为 40.2、13.8 步。这与长上下文 QA 中的趋势一致。环境、动作与任务结构也同时变化,所以这些数据支持“长轨迹更受益”的解释,不能独立分离长度的作用。
4.5 从失败与成功轨迹中利用经验
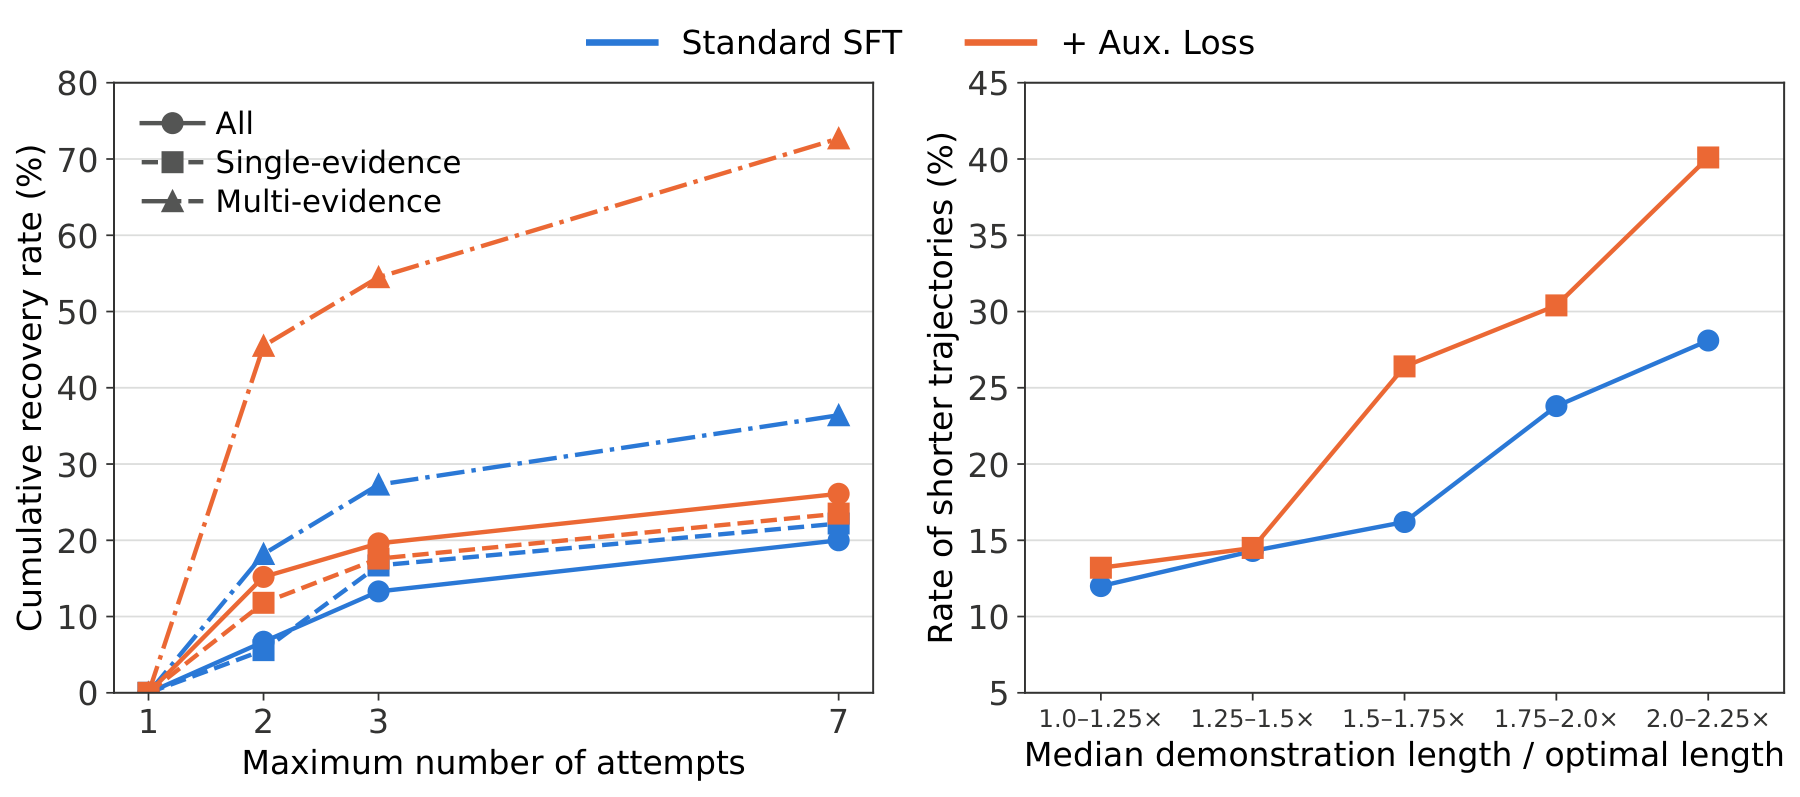
原图 7,PDF p. 9。左图横轴是最多尝试次数,纵轴是累计恢复率;蓝色为 SFT,橙色为辅助训练,圆点/方块/三角分别为 All、Single-evidence、Multi-evidence。右图横轴为示范轨迹中位长度与最优长度的比值,纵轴为生成“成功且短于全部给定示范”的轨迹比例。
失败重试:MINTEval 每次把先前失败答案放入上下文,再尝试回答。正文给出按尝试预算汇总的单证据恢复率 14.8→17.6,多证据 27.3→57.6,分别 +2.8 和 +30.3 个百分点。多证据组的橙色曲线明显高于蓝色,支持辅助训练改善了对失败经验的跨信息整合。
需要保留的原文口径问题:Sec. 6 将 QA 总体平均增益写为 +16.6 个百分点,但图 7 左侧 All 实线在预算 2、3、7 次时的差距目测约为 9、6、6 个百分点,不能直接读出 16.6;16.6 则近似等于单/多证据组增益的等权平均 $(2.8+30.3)/2$。原文没有交代足以消除差异的分母或汇总权重。因此,应将 16.6 标为“正文报告的汇总值”,避免与 All 曲线同义使用。图中预算 1 的恢复率为 0,也说明恢复率应与首轮成功率区分。
TextWorld 上也把先前失败轨迹给模型,最多 7 次。附录图 10(PDF p. 15)显示辅助模型随着尝试次数增加继续提高,而 SFT 较早趋平;正文报告平均恢复增益 +19.2 个百分点。这是累积预算下的恢复效果,不是表 2 的单次游戏成功率。
成功但非最优的示范:每个游戏提供 5 条成功轨迹,检查新轨迹是否成功且严格短于其中最短的一条。辅助训练平均提高这一比例 6.0 个百分点,示范相对最优路径越冗长时优势更明显。这个指标衡量从冗余成功经验中提炼更好策略的频率,不表示平均路径长度直接减少 6%,也不表示已经达到最优路径。
4.6 推广:纯注意力模型也会忽略一种记忆
这一组使用 Qwen3-4B-Instruct,将记忆类型从内置的注意力/递归通路改为显式文本记忆(textual memory)和隐式记忆(latent memory)。(Sec. 6,PDF pp. 9–10;附录 C.3,pp. 15–18)
文本记忆是文档摘要,模型读取摘要与问题后生成答案。隐式记忆是在文档末尾添加 $K$ 个可学习 memory tokens,先让它们注意到文档,再保存这些位置在每个 Transformer 层的 KV,作为回答阶段的 prefix cache。训练分两阶段:先用推理监督训练信息编码,再训练基于记忆回答;第二阶段的答案损失回传到记忆构建过程。
图 11(PDF p. 16)在不同的匹配记忆预算下比较 Latent − Text:文本在逐字、单证据问题上更强,隐式记忆在非逐字、多证据问题上更有竞争力。非逐字曲线在部分预算下仍为负,准确表述是“文本优势减小”,不能说隐式记忆在这类问题的所有预算上都更好。图 8 的联合记忆主实验另使用文本 8k tokens、隐式 128 slots,不能与图 11 的预算扫描混为一谈。
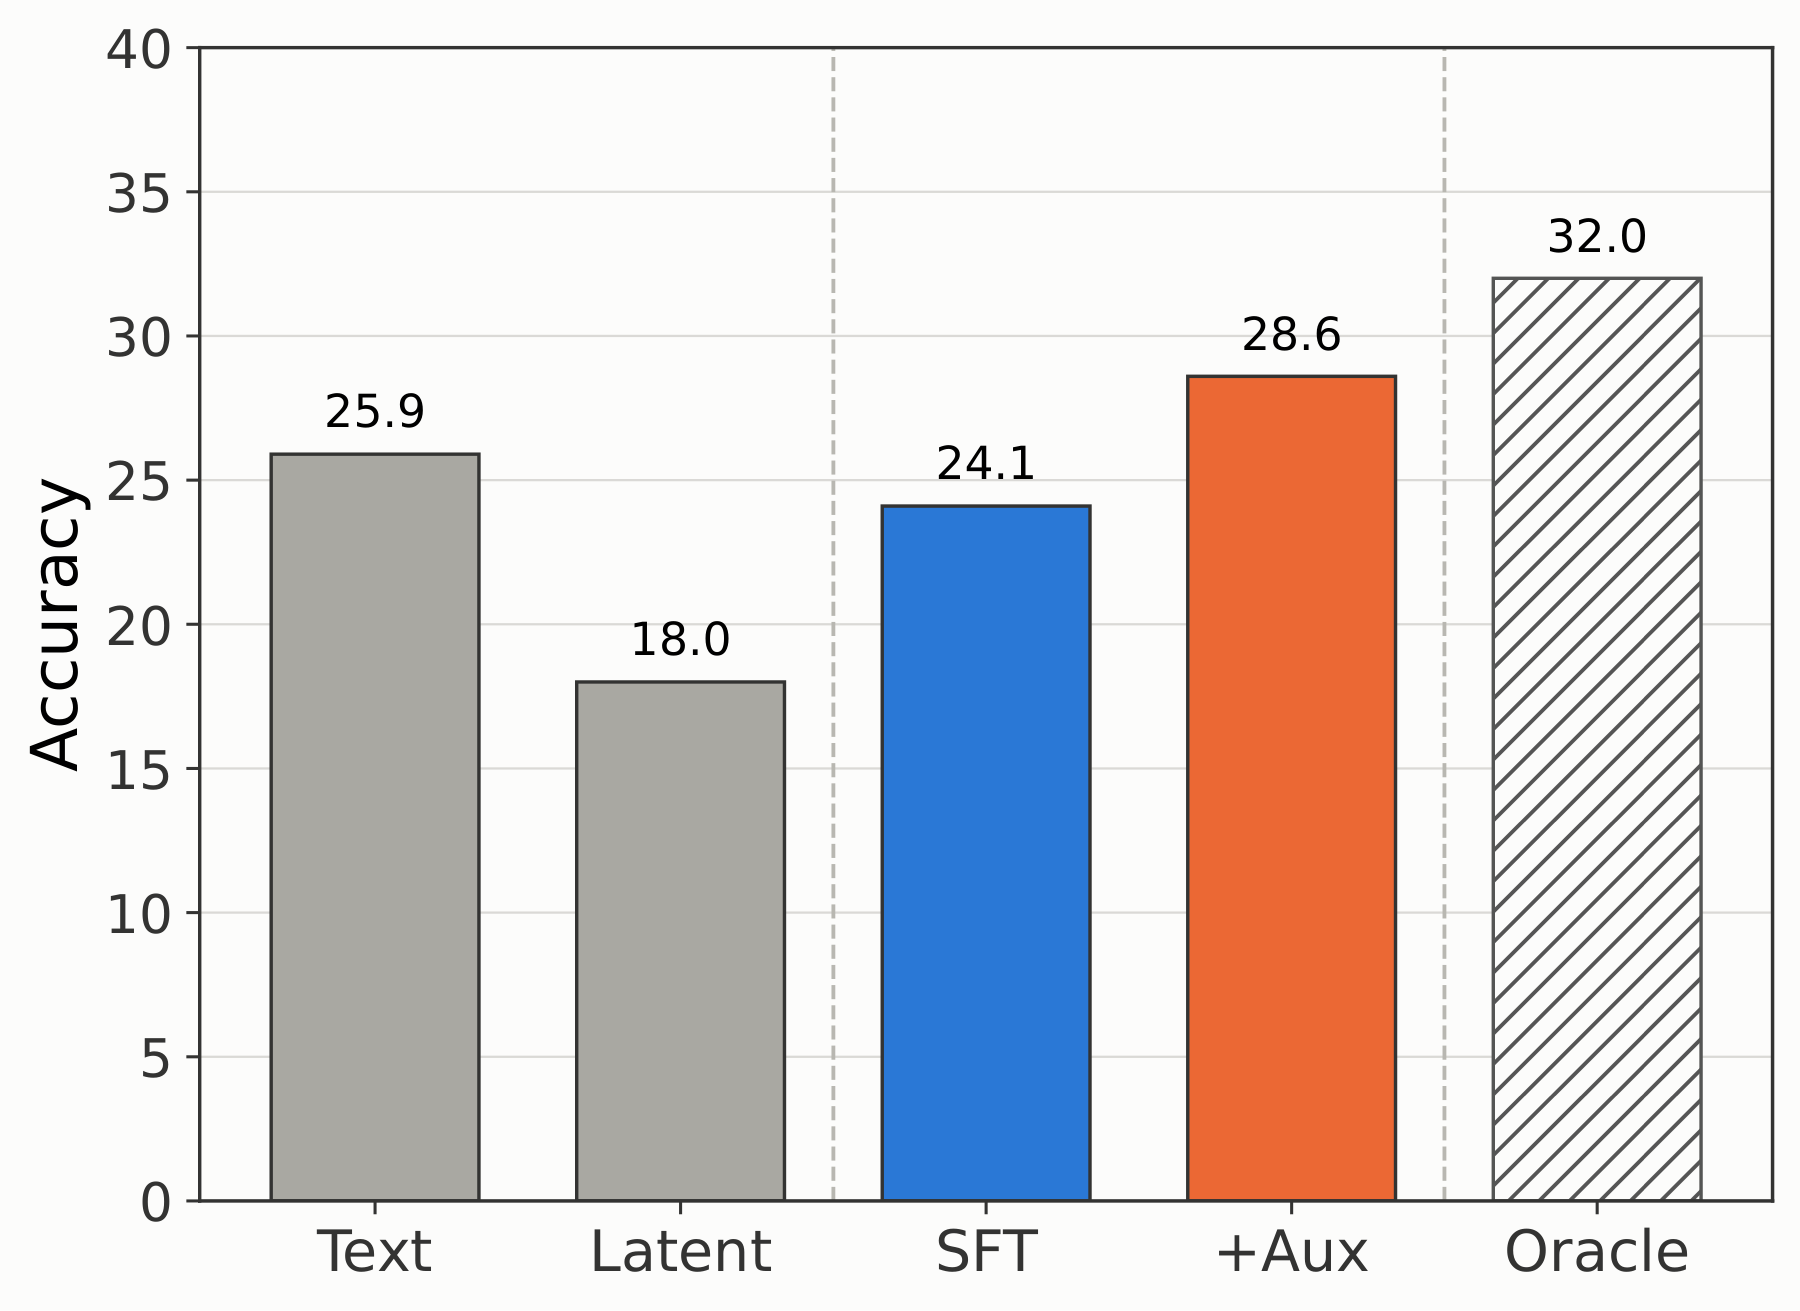
原图 8,PDF p. 9。Text 25.9,Latent 18.0,标准 SFT 联合使用两者只有 24.1,辅助训练为 28.6;Oracle 32.0 是按样本事后选择更好的单记忆预测,表示这两个预测的互补潜力,不是可部署的路由器,也不是任意联合模型的理论上界。
用角色分配让辅助目标利用合适的记忆
令 $T_i,L_i$ 为第 $i$ 个文档的文本与隐式记忆,$q_i,y_i$ 为问题和目标答案:
式 (1) 在完整损失外加入:
来源:PDF p. 17,式 (1)。$j$ 是同一来源数据集中、文档长度相近的无关样本,$\operatorname{sg}$ 表示停止梯度,$\lambda=0.25$。Text-role 保留正确文本、用无关隐式记忆代替 $L_i$,并停止对无关记忆的梯度,避免辅助项更新其 writer;Latent-role 保留正确隐式记忆、换掉文本。与混合模型屏蔽一条通路相比,这里通过让另一种记忆与目标无关来迫使模型利用指定记忆。
角色标准的含义:
| 标准 | Text-role | Latent-role |
|---|---|---|
| Verbatim | 逐字问题 | 非逐字问题 |
| Reverse | 非逐字问题 | 逐字问题 |
| Random | 均匀随机分配 | 均匀随机分配 |
| Outcome | 隐式单记忆模型回答不正确 | 隐式单记忆模型回答正确 |
Outcome 按原文规则优先检查隐式模型是否答对;并非只保留“一个正确、另一个错误”的样本。角色由训练信息决定,Full 推理不需要提前知道金答案是否逐字出现。
分配依据比“辅助项越多越好”更重要
定义 $\Delta$Latent / $\Delta$Text:把相应记忆替换成无关上下文构建的记忆后,分数下降多少,正数越大表示这种干预的影响越大,负数表示替换反而改善分数。它与前文 recurrent-only / attention-only 的通路评估是两种不同的诊断。
| 变体 | 分数 | ΔLatent | ΔText |
|---|---|---|---|
| Naive 联合 SFT | 24.1 | −2.4 | +11.4 |
| Outcome | 26.1 | +0.8 | +11.5 |
| Verbatim | 28.6 | +4.7 | +10.4 |
| Reverse | 24.5 | +1.1 | +7.2 |
| Random | 23.9 | −1.0 | +10.5 |
| Latent-aux:全部分给隐式角色 | 26.1 | +3.4 | +8.5 |
| Text-aux:全部分给文本角色 | 24.9 | +0.0 | +14.5 |
| Unrouted:每个样本同时施加两种辅助项 | 24.4 | −1.2 | +9.1 |
| Oracle | 32.0 | — | — |
来源:表 3,PDF p. 17,解释见 p. 18。Naive 的负 ΔLatent 表明隐式记忆未有效帮助预测,甚至可能干扰。Verbatim 既提高了隐式利用,又大体保留文本利用;一律强化隐式记忆虽有收益,但损失更多文本利用。随机分配及不分角色地堆叠两项辅助损失都没有带来类似改善。
因此,纯注意力扩展比主方法更进一步:先辨别记忆的相对优势,再让不同样本走合适的辅助通路。它也引入了额外的记忆构建和角色分配设计,不能简单说是原来屏蔽注意力的一项损失原封不动迁移。
五:结论与讨论
这篇论文最有价值的思路是:用信息流干预识别被训练忽视的记忆,再把同一种干预用于辅助监督。 诊断与方法共享一个可操作的定义,使 Full 分数提高与具体通路能力的变化可以放在一起检验。两个混合模型、QA 和智能体任务,以及文本/隐式记忆扩展,共同支持多记忆系统需要专门的训练信号。
结果也指向具体取舍。辅助递归监督在长文档和长轨迹任务上收益突出,却会牺牲部分短 QA 项;训练增加一次受限计算,作者靠减半优化步数匹配预算,尚不能据此得出相同训练步数下的收益或墙钟效率结论。主实验集中在 4B 级模型的 LoRA SFT,而非重新训练架构。通路干预同时改变信息可达性,其性能差距适合衡量当前模型的依赖和可用能力,不能唯一分解完整预测中每条通路的贡献。
本次分析认为,下一步最值得做的是把角色分配从人工准则变为可学习机制,同时在固定训练 FLOPs、样本暴露与墙钟时间的多种预算下分别评估;对长度的判断则可在同一任务中控制证据量、位置和上下文长度。这样能进一步区分“递归记忆得到更多使用”与“何时用它最划算”。