LoGRA:用低秩梯度 Sketch 扩展大模型强化学习——中文精读笔记
原题:LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches
作者:Shaokun Zhang、Yifan Zhang、Jian Hu、Yueying Li、Hao Zhang、Binfeng Xu、Jan Kautz、Yi Dong(NVIDIA)
版本:arXiv:2610.06647v3,2026-10-17 修订;本次获取于 2026-10-23。
原文:本地 PDF · 作者 TeX 源码 · 代码链接(作者提供)
论文总览
问题:大模型强化学习后训练需要反复生成、更新和同步策略。即使模型权重放得下,稠密梯度与 Adam 状态仍会把训练 GPU 显存推到容量之外。LoGRA 把选定权重矩阵的梯度直接累计为低秩 sketch,并用 sketch 构造权重更新;另用预测 KL 调整步长,避免一次更新使策略概率突变。它的重点是保留完整权重矩阵、压缩更新所需的信息。(Sec. 1–2,PDF pp. 1–5)
在论文的八张 H100 80GB、其中四张训练的配置下,1.5B 与 7B 模型的平均训练显存分别降低 21.8% 和 45.7%;7B 的 MATH-500 峰值 Pass@1 与稠密 Adam 基本相同。27B 的密集 Adam 在首次分配优化器状态时 OOM,而 LoGRA 完成 200 次数学任务更新,并在另一组 Reasoning-Gym 任务上持续训练超过 1,100 个记录步。(Table 1,PDF p. 7;Fig. 4,PDF p. 7)
结构地图
| 原文章节 | 论证作用 | PDF 位置 |
|---|---|---|
| 1. Introduction | 说明 RL 显存瓶颈与压缩梯度的动机 | pp. 1–2;Fig. 1 |
| 2.1. Low-rank gradient sketches | 定义 sketch、直接累计与低秩权重更新 | pp. 2–3;Eqs. (1)–(4) |
| 2.2. Applying LoGRA to RL post-training | 训练/生成端更新流程与同步载荷 | pp. 3–4;Algorithm 1 |
| 2.3. Step-size control with predicted KL | 用局部 KL 曲率选择更新倍率 | pp. 4–5;Eqs. (5)–(7) |
| 3.1–3.2. Setup / Main Experiments | 模型、数据、基线、显存及准确率 | pp. 5–7;Figs. 2–3,Table 1 |
| 3.3. Sustained 27B training | 单节点长程训练 | p. 7;Fig. 4 |
| 3.4. Further Analysis | 秩/投影消融、LoRA 比较、KL 预算 | pp. 7–10;Figs. 5–6,Table 2 |
| 4–5. Related Works / Conclusion | 与参数高效及系统方法的关系和总结 | p. 10 |
| Appendix A–D | KL 推导、RowAdam、数据与超参数 | pp. 13–17;Tables 3–4 |
一:动机——为什么压缩梯度,而不是只压缩权重
以 7B 模型为例,BF16 权重约需 14 GB;Adam 的两个 FP32 动量缓冲区另需约 56 GB,还没算梯度和激活。FSDP、检查点重算和卸载能重新分配这些开销;LoRA 则冻结原权重、只训练适配器。LoGRA 选择另一条路径:原矩阵仍直接接收更新,但其梯度累计、优化器状态和更新表示尽可能保持紧凑。这也适合训练器与生成器反复同步权重的 RL 工作流。(Sec. 1,PDF pp. 1–2)
作者用二值结果奖励说明直觉:每个回答只收到很少的外部反馈,未必需要保存高维梯度的每个坐标才能有效改进策略。这个直觉提出压缩的可能性;实际保真度和训练效果仍由后面的消融与任务实验检验。(Sec. 1,PDF p. 2)
二:方法——直接累计低秩梯度并控制策略变化
2.1 Sketch 的维度、计算与含义
对一层权重 $W\in\mathbb R^{d\times k}$,稠密梯度为 $G=\nabla_W\mathcal L\in\mathbb R^{d\times k}$。LoGRA 为它抽取固定于本次累计过程的随机投影 $A\in\mathbb R^{r\times k}$,其中 $r\ll\min(d,k)$,得到
$S$ 是梯度 sketch,$U$ 是优化器处理后的同形状 sketch;基础 SGD 取 $U=S$。$\eta$ 是标称步长,$\alpha$ 是下节控制的全局倍率。$SA$ 与 $G$ 同形状,但单步更新的秩最多为 $r$;这是近似梯度,不是精确重建。默认 $A_{ij}$ 是独立的 $\pm1/\sqrt r$。由这个采样定义可推得 $\mathbb E[A^\top A]=I$,因此固定 $G$ 时 $\mathbb E[GA^\top A]=G$;单次采样仍有重建误差。(Eqs. (1)–(4),PDF pp. 2–3;期望等式为依据原式的推导)
关键实现不是先算出 $G$ 再压缩。以线性层的一个样本为教学例子,若输入 $x\in\mathbb R^k$、反传导数 $g\in\mathbb R^d$,该样本贡献 $gx^\top$,则其 sketch 可直接算作 $g(Ax)^\top$。对每个微批相加时,只保留 FP32 的 $d\times r$ 累计器。权重正常参与前向计算;压缩的是选定矩阵的梯度缓存。对 $d=k=4096,r=64$,一个 FP32 累计器由 64 MiB 降至 1 MiB;实际总显存还包含权重、投影、激活等。(Sec. 2.1–2.2,PDF p. 3)
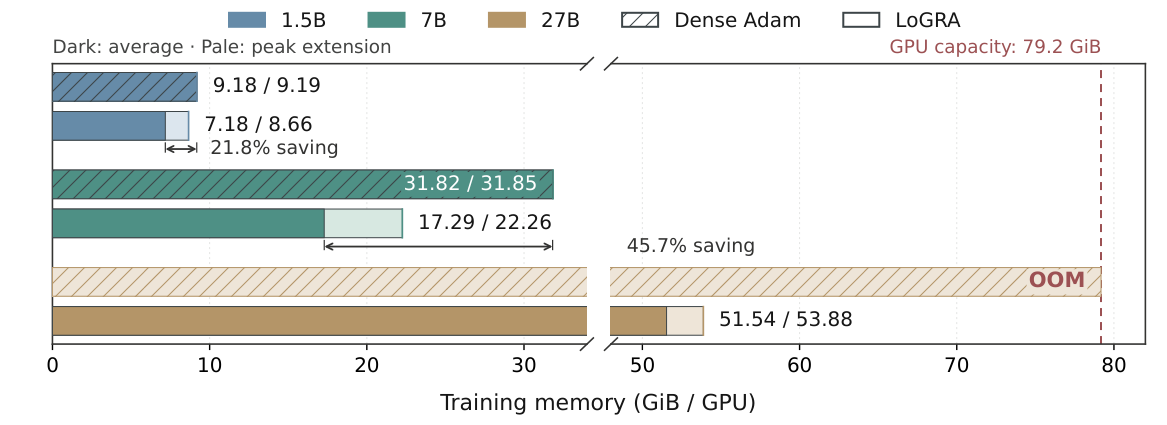
原图 Fig. 1(PDF p. 1)展示每张训练 GPU的平均/峰值显存;27B 的稠密条只表示 OOM 门槛,不能读作测得的稠密显存值。图中横轴在 34–48 GiB 处断开。
2.2 多步更新、RowAdam 与生成端同步
每个选定的 attention/MLP 投影矩阵各有 $A,S,U$,其它参数固定;整步共用同一个 $\alpha$。每步重采样 $A$,因此各步低秩增量可落在不同子空间,合并到完整 $W$ 后,累计变化无需保持秩 $r$。训练器可以只发送因子 $\alpha\eta U$ 与随机种子,让生成端重建 $A$ 并施加同一更新,理论载荷由 $O(dk)$ 降至 $O(dr)$ 加少量元数据。(Algorithm 1,PDF pp. 3–4)
主实验为与 Adam 保留一定自适应性,使用 RowAdam:对 sketch 的每一行追踪平方均值 $v_{t,i}$,按 $1/(\sqrt{\widehat v_{t,i}}+\epsilon_t)$ 缩放,再把处理后矩阵的 Frobenius 范数调回原 sketch 的范数。它只需每行一个二阶状态,$\beta_2=0.95$,没有 Adam 的一阶动量,也不是逐参数 Adam。因此 Table 1 的对照同时改变了梯度表示和优化器。(Appendix B,PDF pp. 14–15)
2.3 预测 KL:让步长适应策略敏感度
只限定权重更新范数不能保证输出分布变化小。令所有选定矩阵的候选更新组成 $D$,其中 $D_W=-\eta UA$;在训练批中抽取若干已生成 token 的上下文 $\mathcal P$,比较同一上下文、同一温度 $T$ 下的旧/新 next-token 分布。局部展开给出
这里 $p(s)=\operatorname{softmax}(z(s)/T)$,$\dot z_v(s)$ 是 token $v$ 的 logit 沿 $D$ 的方向导数,$q(D)$ 是未缩放候选步的局部 KL 曲率系数,$\delta$ 是平均预测 KL 预算。若 $q(D)=4\delta$,步长至多缩到原来一半;若预测很小,倍率也受 $\alpha_{\max}$ 限制。方差项只关心 token 间相对 logit 变化:给所有 logit 加同一常数不改变 softmax。附录推导先用 $K_s(0)=K'_s(0)=0$ 得到二次项,再将其写为方向导数的概率加权方差。局部近似约束的是预测 KL,实际更新后的 KL 可能不同。(Eqs. (5)–(7),PDF pp. 4–5;Appendix A,pp. 13–14)
27B 长程实验为效率使用直接 KL 评估的有限差分探针估计 $q(D)$,而非 Eq. (6) 的 JVP 形式;因此“公式中的估计量”和“所有实验的具体实现”不能简单画等号。(Sec. 3.3,PDF p. 7)
三:实验设计与指标
主比较在一台八 H100 80GB 节点上进行:四张 GPU 做 FSDP 训练,四个独立生成引擎占用其余 GPU;BF16、激活检查点、无 CPU 卸载。模型为 Qwen2.5-Math-1.5B/7B 和 Qwen3.8-27B。DAPO-Math-7.5K 取 7,500 个去重提示;每步 128 个提示、每提示一个回答,训练上下文上限 4,096 token。MATH-500 测试集有 500 题,每题生成四个回答;Pass@1 是这 2,000 个回答的平均二值正确率,数值越高越好。(Sec. 3.1–3.2,PDF p. 5;Appendix C–D,pp. 15–16)
主实验每个可运行设置有三个随机种子。LoGRA 用秩 256、逐步刷新 Rademacher 投影、RowAdam、从 $2\times10^{-4}$ 余弦退火到 $2\times10^{-5}$ 的预测 KL 预算;稠密基线用 Adam 和学习率退火。原文称 1.5B/7B 跑 20,000 次更新、27B 跑 200 次;图 2 与峰值准确率只统计前 200 次,Table 1 的显存和吞吐覆盖完整运行。显存是训练 GPU 的每步峰值分配量,表中“平均”再对时间取均值;“峰值”是三种子均值曲线的最大值,不是单卡瞬时最大值。吞吐为每小时完成更新数。(Sec. 3.2,PDF pp. 5–7;Table 1)
四:结果——能省多少,学习是否保留
4.1 主实验:显存大幅下降,吞吐近似持平
| 模型 | 方法 | 平均显存 GiB/GPU ↓ | 峰值显存 GiB/GPU ↓ | 更新/小时 ↑ | 峰值 Pass@1 % ↑ | 峰值 Pass@4 % ↑ |
|---|---|---|---|---|---|---|
| 1.5B | Dense | 9.18 | 9.19 | 54.28 | 63.77 | 80.33 |
| 1.5B | LoGRA | 7.18 | 8.66 | 55.44 | 67.87 | 82.47 |
| 7B | Dense | 31.82 | 31.85 | 25.28 | 72.48 | 85.33 |
| 7B | LoGRA | 17.29 | 22.26 | 25.73 | 72.33 | 85.13 |
| 27B | Dense | OOM | OOM | — | — | — |
| 27B | LoGRA | 51.54 | 53.88 | 6.99 | 71.52 | 81.87 |
数值为 Table 1 的三种子均值(PDF p. 7);原表还给出样本标准差。1.5B 的平均显存相对 Dense 降 21.8%,7B 降 45.7%。7B Pass@1 只差 0.15 个百分点,吞吐 25.73 对 25.28 更新/小时;因此在这一规模的主要收益是显存容量,而不是明显提速。27B Dense 在首次 Adam 状态分配时 OOM,无法计算同条件下的显存节省百分比或吞吐比。Fig. 2 的曲线补充显示前 200 次更新的学习过程,Fig. 3 展示每步显存而不是整个节点的总显存。(PDF pp. 6–7)
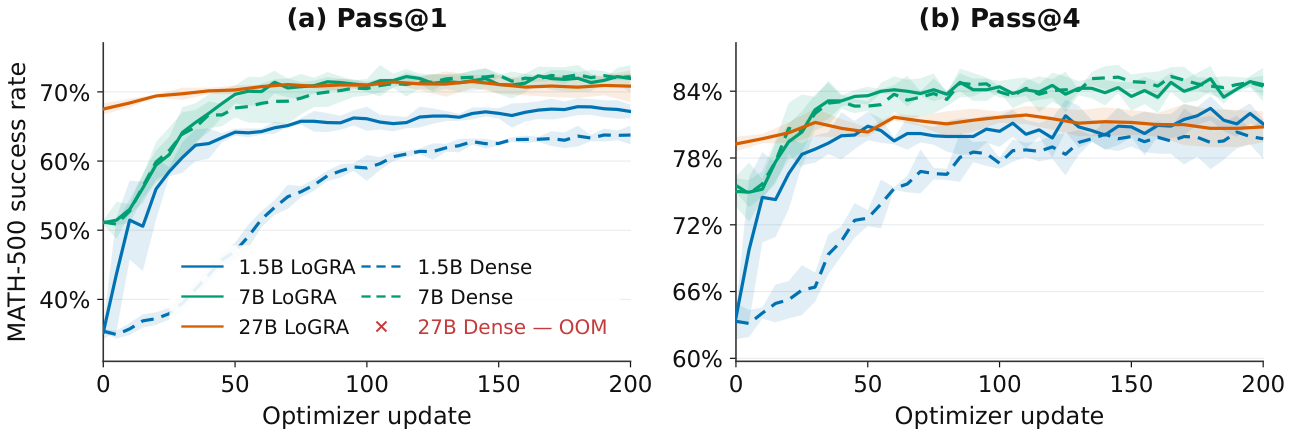
原图 Fig. 2(PDF p. 6):左为 Pass@1、右为 Pass@4,横轴是实际优化器更新,曲线/阴影为三种子的均值/样本标准差。
4.2 另一组 27B 长程实验:超过 1,100 个记录步
单独的 Reasoning-Gym Hard 实验包含八种可验证任务,训练集 38,948 题、留出集 193 题;指标是八任务 verifier 分数的等权宏平均。该运行用秩 256、SGD sketch、16,384-token 上下文和逐渐收紧的 KL 预算,只有一条 seed 42 轨迹,约每 20 个记录步评估一次。(Sec. 3.3,PDF p. 7;Appendix C–D,pp. 15–16)
留出宏平均从 39.69% 升至 62.94%,第 1,060 步峰值 65.52%;最后五次评估处于 59.11%–64.16%。同一轨迹的平均回答长度从 8,312 降至 4,705 token,达到上下文上限的比例从 34.72% 降至 12.95%。这些读数说明所报告配方在这条轨迹中持续学习,且没有观察到持续性分数崩塌。(Fig. 4,PDF p. 7)
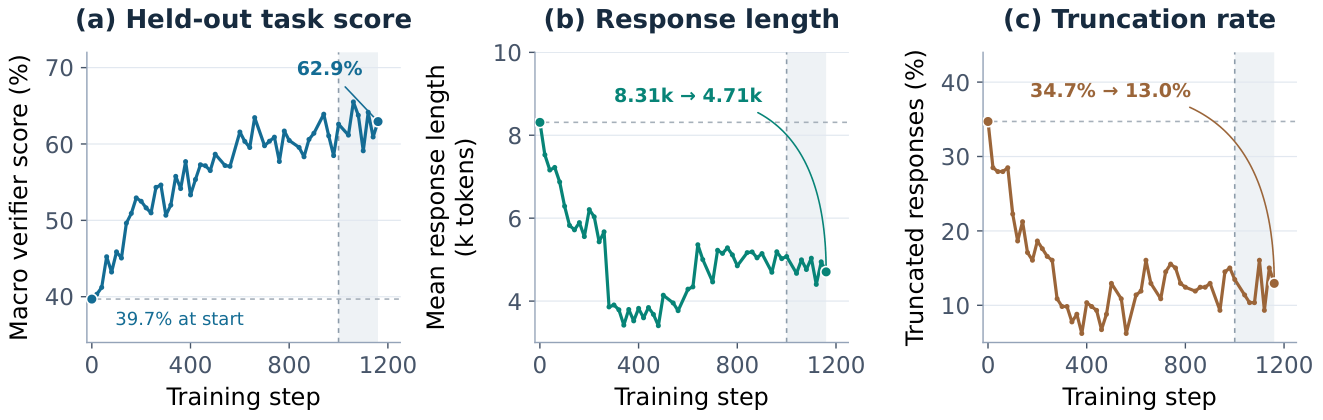
原图 Fig. 4(PDF p. 7):三面板共用“训练步”横轴;分数是八任务宏平均,长度与截断率帮助判断分数变化是否伴随输出行为异常。
4.3 压缩设计:提高秩的效应最明显
在 1.5B 的单次消融中,秩 $r\in\{4,16,64,256\}$ 越高,MATH-500 Pass@1 越高;从 4 到 256,三种投影配置提升 3.02–3.95 个百分点。秩 256 时固定 Rademacher、逐步刷新 Rademacher、逐步刷新 Gaussian 分别为 68.50%、68.31%、67.42%,短程内没有稳定的“刷新必优”排序。对应的梯度重建余弦均值约从 0.046 升至 0.348;同层同秩的刷新与分布差异远小于秩差异。余弦只测单个微批的重建相似度,任务表现仍以图 5(a) 为依据。(Sec. 3.4.1,Fig. 5,PDF p. 8;Appendix D.3,p. 17)
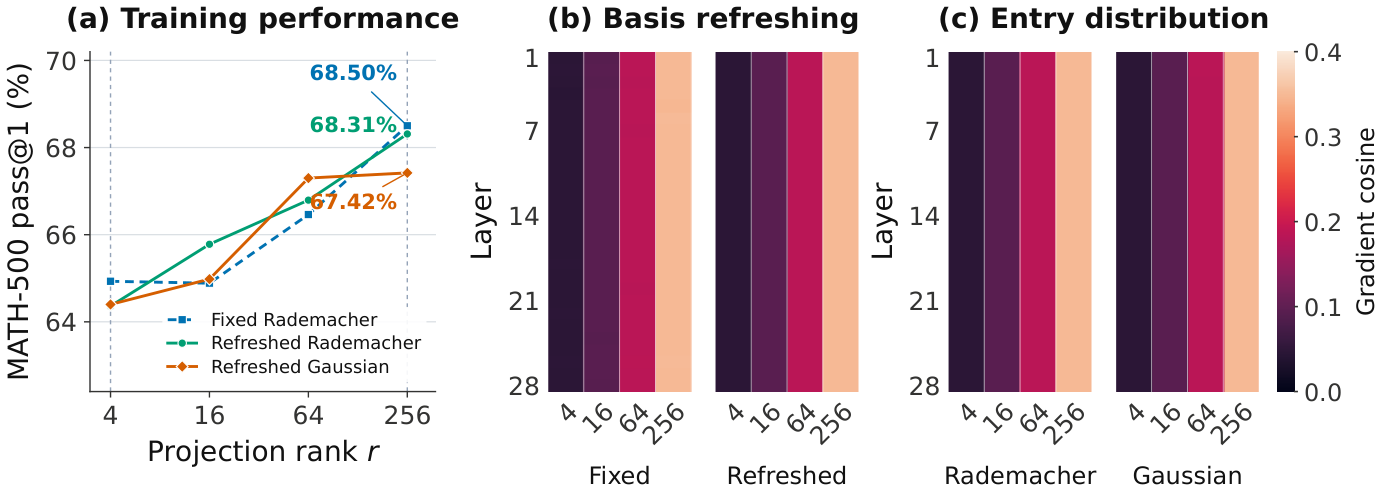
原图 Fig. 5(PDF p. 8):(a) 是任务准确率;(b)(c) 是逐层重建余弦热图,色条统一为 0–0.4,不能把热图读成准确率。
4.4 LoRA 比较:显存更低,但速度与 Pass@1 未占优
在 1.5B、秩 256、三种子设置中,LoGRA / LoRA 的平均训练显存为 7.18 / 13.21 GiB,峰值为 8.66 / 13.38 GiB;Pass@1 是 68.47% / 70.45%,训练调用耗时是 11.31 / 10.63 秒/更新。LoGRA 的 Pass@4 高 0.40 个百分点。这里的秒/更新不含生成与同步;LoRA 与 LoGRA 使用不同优化器、步长计划与计数方式,因此这张表支持“此配方下 LoGRA 更省训练显存”,不能单独归因于适配器参数化差异。(Sec. 3.4.2,Table 2,PDF p. 9;Appendix D.4,p. 17)
4.5 KL 预算:保守预算比过大预算更可靠
1.5B 长程消融采用两种子、SGD sketch,比较无 KL 控制、固定预算 $1.5\times10^{-3}$、固定预算 $1.5\times10^{-4}$、以及 $2\times10^{-4}\to2\times10^{-5}$ 退火。第 700–800 个记录步的原始评估均值 Pass@1 依次为 70.30%、63.43%、71.03%、71.47%;对应平均回答长度为 774、976、858、832 token。过大的固定预算出现性能退化;小预算与退火预算维持较高尾段准确率。不过无控制组也保持稳定,而且退火组的初始预算与固定小预算不同,不能从这组两种子实验断言 KL 控制是稳定的必要条件,或将差异仅归因于“退火”本身。(Sec. 3.4.3,Fig. 6,PDF pp. 9–10)
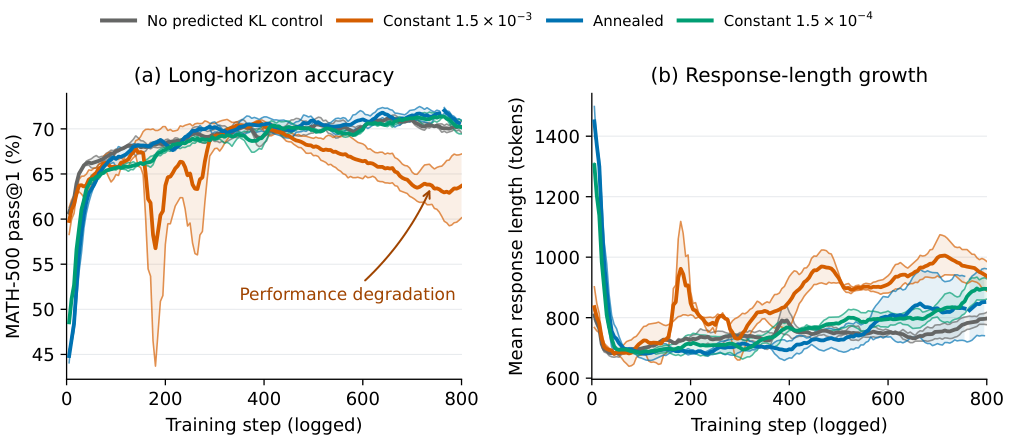
原图 Fig. 6(PDF p. 9):粗线为两种子均值、细线为单次运行,横轴是记录步;展示曲线经过五次评估移动平均,上述尾段数值则取未平滑的原始评估。
五:结论与读论文时要保留的区分
LoGRA 的有效设计单元是“直接累计 $S=GA^\top$,用 $UA$ 更新完整权重,再按预测 KL 缩放”。实验最强的证据是单卡训练显存降低和同一八卡节点上 27B 可训练;1.5B/7B 的端到端更新吞吐仅小幅变化。预测 KL 的消融支持合适的小预算,而非“加上控制必然稳定”。
还要分清可实现的同步机制与实际测量范围:方法节给出通过低秩因子与随机种子同步生成端的方案,但附录 D.1 明确写主实验两组均使用 full-weight policy synchronization。因此 Table 1 的吞吐和显存结果不能当作低秩同步节省带宽的实测数字;这部分仍需要单独通信测量。主比较的 RowAdam 与 Dense Adam 也不是同一优化器,准确率差异不能只归因于 sketch。(Sec. 2.2、Table 1、Appendix B/D.1,PDF pp. 3、7、14–16)