Large Language Continuous Diffusion Models:中文研读笔记
方法:Sigma(scaling up Gaussian diffusion models for language)
作者: Zhihan Yang、Wei Guo、Jean-Marie Lemercier、Simon Welker、Yonggan Fu、Mohammad Mahdi Kamani、Sajad Norouzi、Julius Berner、Tomas Geffner、Karsten Kreis、Yongxin Chen、Molei Tao、John Thickstun、Pavlo Molchanov、Ante Jukić、Arash Vahdat、Morteza Mardani。机构为 NVIDIA、Cornell University、Georgia Institute of Technology。
版本: arXiv:2610.02665v1,arXiv 提交于 2026-10-02;本次获取与研读日期为 2026-10-14。
原文: arXiv 页面 · 本地论文 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码,与该文件印刷页码一致。
论文总览
Sigma 研究的是:在可学习的低维连续空间中,扩散语言模型能否扩展到 3B/8B,并承担条件数学推理与代码生成? 它沿用 Plaid/RePlaid 的似然训练框架,把每个 token 映射为 16 维单位向量,在这些向量上做高斯扩散;序列按 32-token 块生成,块间自回归,块内联合去噪。通过 AR 权重初始化、辅助 AR 损失、嵌入空间的无分类器引导(classifier-free guidance,CFG)和分数温度(score temperature,ST),作者把连续模型推进到与同规模掩码扩散模型 NLD 接近的水平。
这篇论文有三条相互连接的贡献。第一,连续扩散具有可用的大模型训练配方,3B/8B 基座模型的六任务均值为 64.34/69.67,NLD 为 64.74/70.22。第二,CFG 与 ST 能调节单次质量和多次采样覆盖率,在 MBPP 的 pass@256 上得到 91.8% 对 87.6%。第三,少步生成取决于采样器、嵌入几何和轨迹蒸馏的共同设计:SUSReg 改善 16/8 步表现,PDD 尤其改善 4 步表现,但代码任务仍有明显质量损失。(Secs. 3–6;Tables 1–4、8;PDF pp. 3–10、33。)
本次分析的核心判断: 最有价值的是一套贯通“大规模连续建模—推理时控制—少步压缩”的实证配方。当前结果支持准确率竞争力和采样可控性;高步数生成仍慢于充分优化的 AR 系统,少步结果与最终解码开销需要一起解读。
结构地图
| 原文章节 | 解决的问题 | PDF 定位 |
|---|---|---|
| 1. Introduction | 为什么把连续扩散扩展到条件语言推理 | pp. 1–2;Fig. 1 |
| 2. Background | Plaid、NELBO、可学习噪声调度与自条件 | pp. 2–3;Eqs. (1)–(2) |
| 3. Large Language Continuous Diffusion Models | 分块概率模型、双流训练、AR 初始化与正则化 | pp. 3–5;Figs. 2–3,Eqs. (3)–(6) |
| 4. Language Generation via Continuous Diffusion Sampling | DDPM/DDIM、CFG/ST、基座模型与 pass@k | pp. 5–8;Figs. 4–6,Tables 1–2 |
| 5. Few-Step Generation | 时间网格、SUSReg 与 PDD | pp. 8–9;Fig. 7 |
| 6. Supervised Fine-Tuning | 从基座能力到指令模型 | p. 10;Tables 3–4 |
| 7. Conclusions | 方法贡献与后续方向 | p. 10 |
| A. Related Work;B. Limitations and Future Work | 方法谱系、速度与解码鲁棒性问题 | pp. 20–22 |
| C. Additional Background: Masked Diffusion Language Models | 掩码扩散与 NLD 的损失、采样口径 | pp. 23–25 |
| D. Training and Inference Algorithms;E. Implementation Details and Additional Results for Pre-training | 完整算法、架构、SUSReg、初始化消融 | pp. 26–30;Algorithms 1–2,Table 5 |
| F. Implementation Details and Additional Results for Likelihood-based Benchmarks | 用似然界对多选答案打分 | pp. 31–32;Tables 6–7 |
| G. Implementation Details and Additional Results for Inference | 引导、步幅、求解器、pass@k、耗时与证明 | pp. 33–53;Tables 8–20,Figs. 10–20 |
| H. Implementation Details and Additional Results for Supervised Fine-Tuning | 数据、冻结参数、评测协议 | pp. 54–56;Tables 21–22 |
| I. Implementation Details and Additional Results for Parallel Decoding Distillation | 并行预测头、局部 rollout、蒸馏目标 | pp. 57–60;Eqs. (32)–(43) |
| J. Example Outputs | 基座与指令模型的定性样例 | pp. 61–63 |
一:动机——连续状态能提供什么?
1.1 从“决定哪个 token”变成“移动一组连续向量”
论文的掩码扩散对照从被遮盖的 token 序列出发,每一步按置信度提交若干离散 token,已提交的位置保持固定。Sigma 则在一个块内同时更新所有位置的连续潜变量,直到最后才读出 token。这让去噪过程可以使用连续 ODE/SDE 的时间网格、引导和轨迹蒸馏工具,也让局部预测在生成期间保持可修改。(Sec. 1,App. C;PDF pp. 1–2、23–25。)
这里有两个需要同时记住的尺度:16 维是每个 token 的扩散状态维度;Transformer 的隐藏维度和输出词表仍然很大。 Sigma 的词表为 131,072,3B/8B 骨干宽度为 3,072/4,096。连续状态降低的是轨迹表示维度,并没有消除每一步的大词表投影与 softmax。
1.2 本文如何承接已有方法
Plaid 提供可学习单位球面嵌入、变分扩散和类别重参数化;RePlaid 对齐现代语言模型架构;NLD 提供可缓存前缀的分块结构和 AR 适配思路。Sigma 把这些部件组织成可训练到 3B/8B 的条件生成系统,并系统研究 CFG、ST、少步求解与蒸馏。
作者在摘要使用“首个大规模连续 dLM”的表述;附录 A 的更具体定位是似然训练的 3B/8B 连续 dLM,并与匹配的掩码 dLM 正面对比条件推理和代码。该附录也列出了其他表示路线上的 7B/8B 工作,因此理解创新时应保留这个方法范围。(PDF pp. 20–21。)
二:方法——训练连续几何,再控制生成轨迹
2.1 输入、状态与输出
| 符号 | 含义与形状 |
|---|---|
| $\mathbf{x}$ | token 序列的 one-hot 表示,$L\times V$ |
| $\mathbf{E}$ | 可学习扩散嵌入表,$V\times d_e$;$d_e=16$,每行范数为 1 |
| $\mathbf{e}=\mathbf{xE}$ | 干净 token 的连续嵌入,$L\times d_e$ |
| $\mathbf{z}_t$ | 噪声时间 $t$ 的连续状态;单块为 $L'\times d_e$ |
| $\mathbf{x}_\theta$ | 去噪器输出的词表概率;单块为 $L'\times V$ |
| $\mathbf{e}_\theta=\mathbf{x}_\theta\mathbf{E}$ | 预测的干净嵌入均值,$L'\times d_e$ |
| $\mathbf{c}$ | prompt 与已经生成的块组成的干净前缀 |
| $L',B$ | 块长与块数;主实验 $L'=32$,$B=L/L'$ |
| $\gamma(t)$ | 负对数信噪比,$-\log\operatorname{SNR}(t)$ |
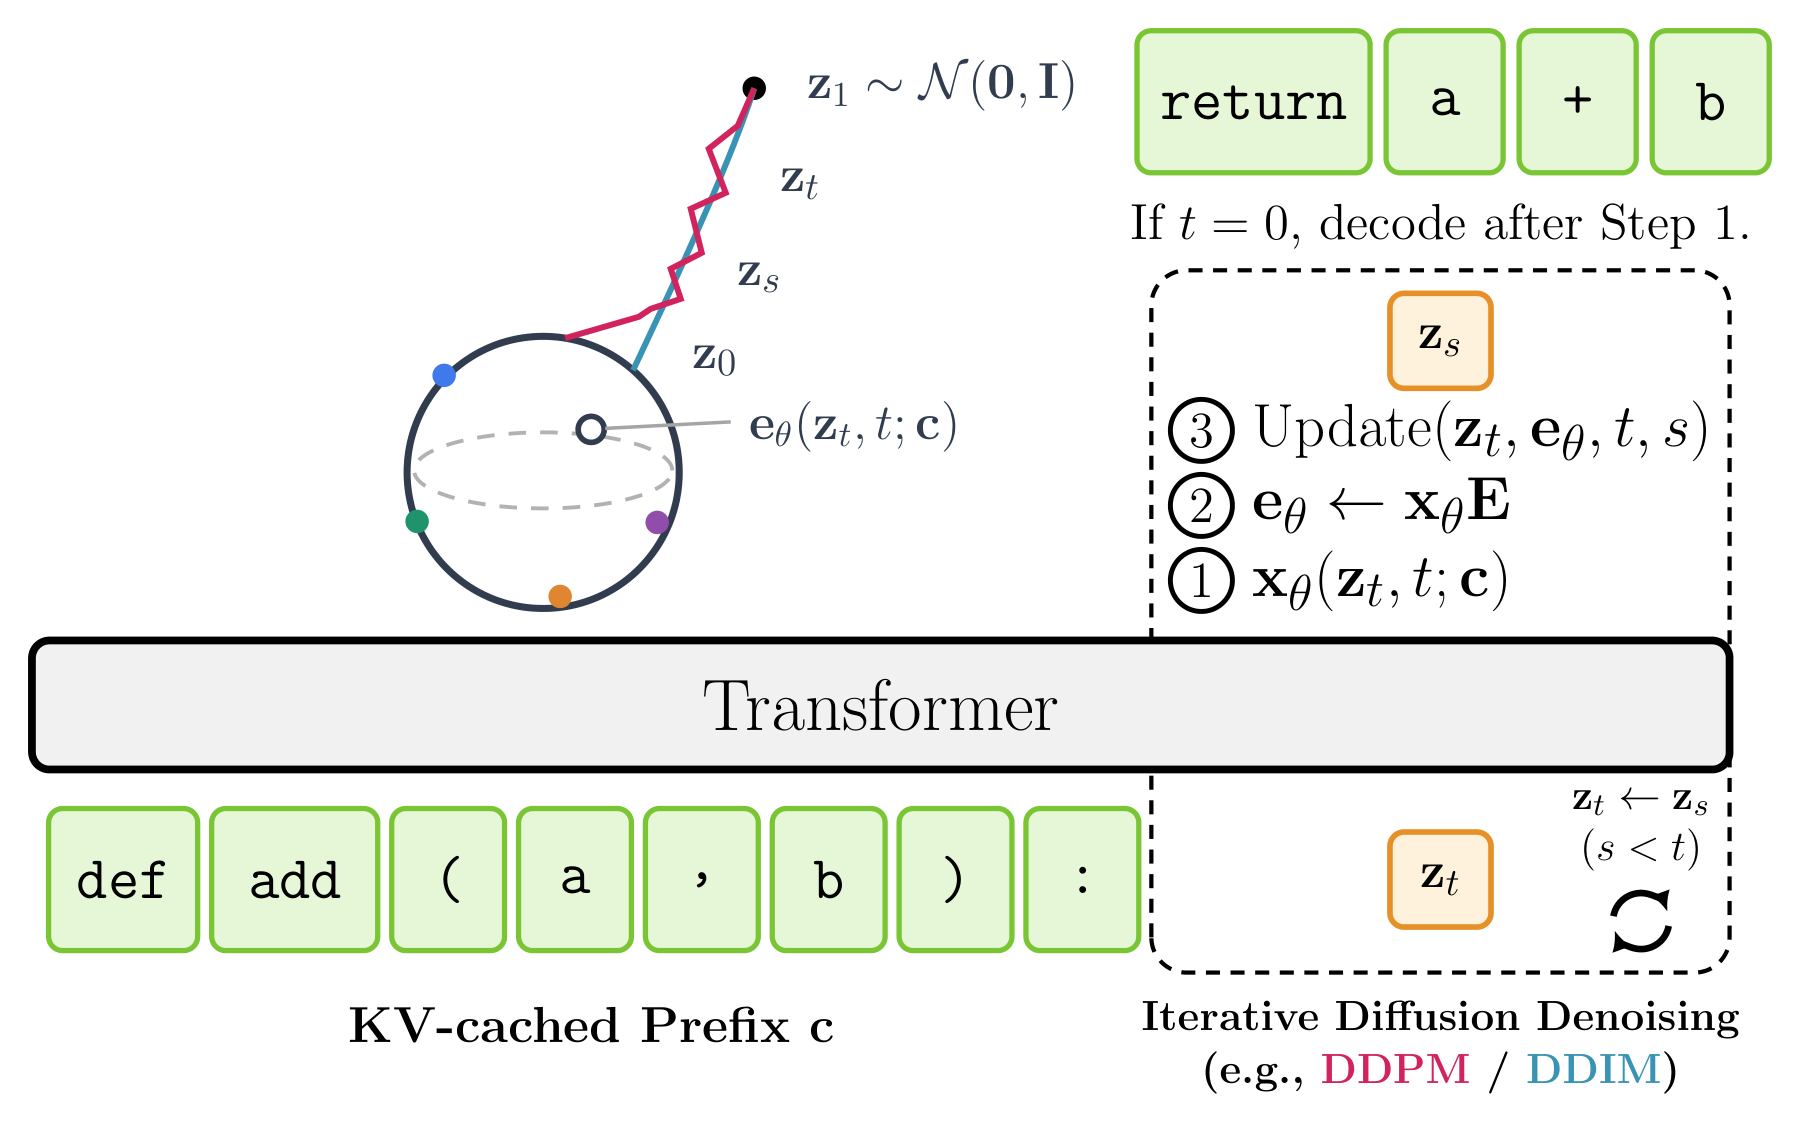
图源:原 Fig. 1 左面板,PDF p. 2。先缓存干净前缀;当前块从高斯噪声开始,反复经过去噪器、概率到均值的映射和连续状态更新,最后才离散解码。图中的球体用于示意 16 维嵌入几何。
2.2 前向扩散与类别重参数化
前向过程是方差保持的高斯加噪:
其中 $t=0$ 接近干净端,$t=1$ 接近高斯端;有限的可学习端点使两端都保留近似误差。信噪比随 $t$ 增大而减小:
去噪器预测词表概率,再计算
这就是类别重参数化(categorical reparameterization):一个位置可能同时相信多个候选 token,连续更新使用这些 token 嵌入的概率加权平均。因为权重非负且和为 1,未引导的预测位于词表嵌入的凸包内,范数不超过 1;CFG/ST 后的预测则可以越出这个范围。(Sec. 2,Eq. (1);PDF pp. 2–3。)
教学例子: 若一个位置对两个 token 的概率分别为 0.6 和 0.4,预测就是 $0.6\mathbf{E}_a+0.4\mathbf{E}_b$。连续采样可以继续移动这个向量,后续步骤再改变两个候选的相对权重。扩散嵌入由训练共同优化,其几何也影响这个平均值的可辨识性。
2.3 分块概率模型与三项 NELBO
Sigma 对块间条件概率作自回归分解:
每个块的负证据下界(negative ELBO,NELBO)包括三项:
上式为原 Eq. (4) 省去块上标的写法。先验项让高噪声端匹配标准高斯;重建项让低噪声端能读回 token;扩散项让模型在各噪声尺度预测干净嵌入。由于 $\operatorname{SNR}'(t)<0$,MSE 的实际权重为正。嵌入表同时出现在目标、加噪状态和预测均值中,因此它也是似然训练的一部分。(Eqs. (2)–(4),PDF p. 3。)
噪声调度写为 $\gamma(t)=\gamma_0+(\gamma_1-\gamma_0)\tilde\gamma(t)$。端点 $\gamma_0,\gamma_1$ 优化 NELBO;固定端点后,连续时间扩散积分对内部时间重参数化不变,因此 $\tilde\gamma$ 优化的是 Monte Carlo 估计方差。论文用扩散损失的二阶矩训练内部形状。这也解释了为什么适合训练方差控制的时间参数化,未必适合有限步推理。(Sec. 2;App. D,PDF pp. 3、27。)
2.4 双流训练如何避免重复计算
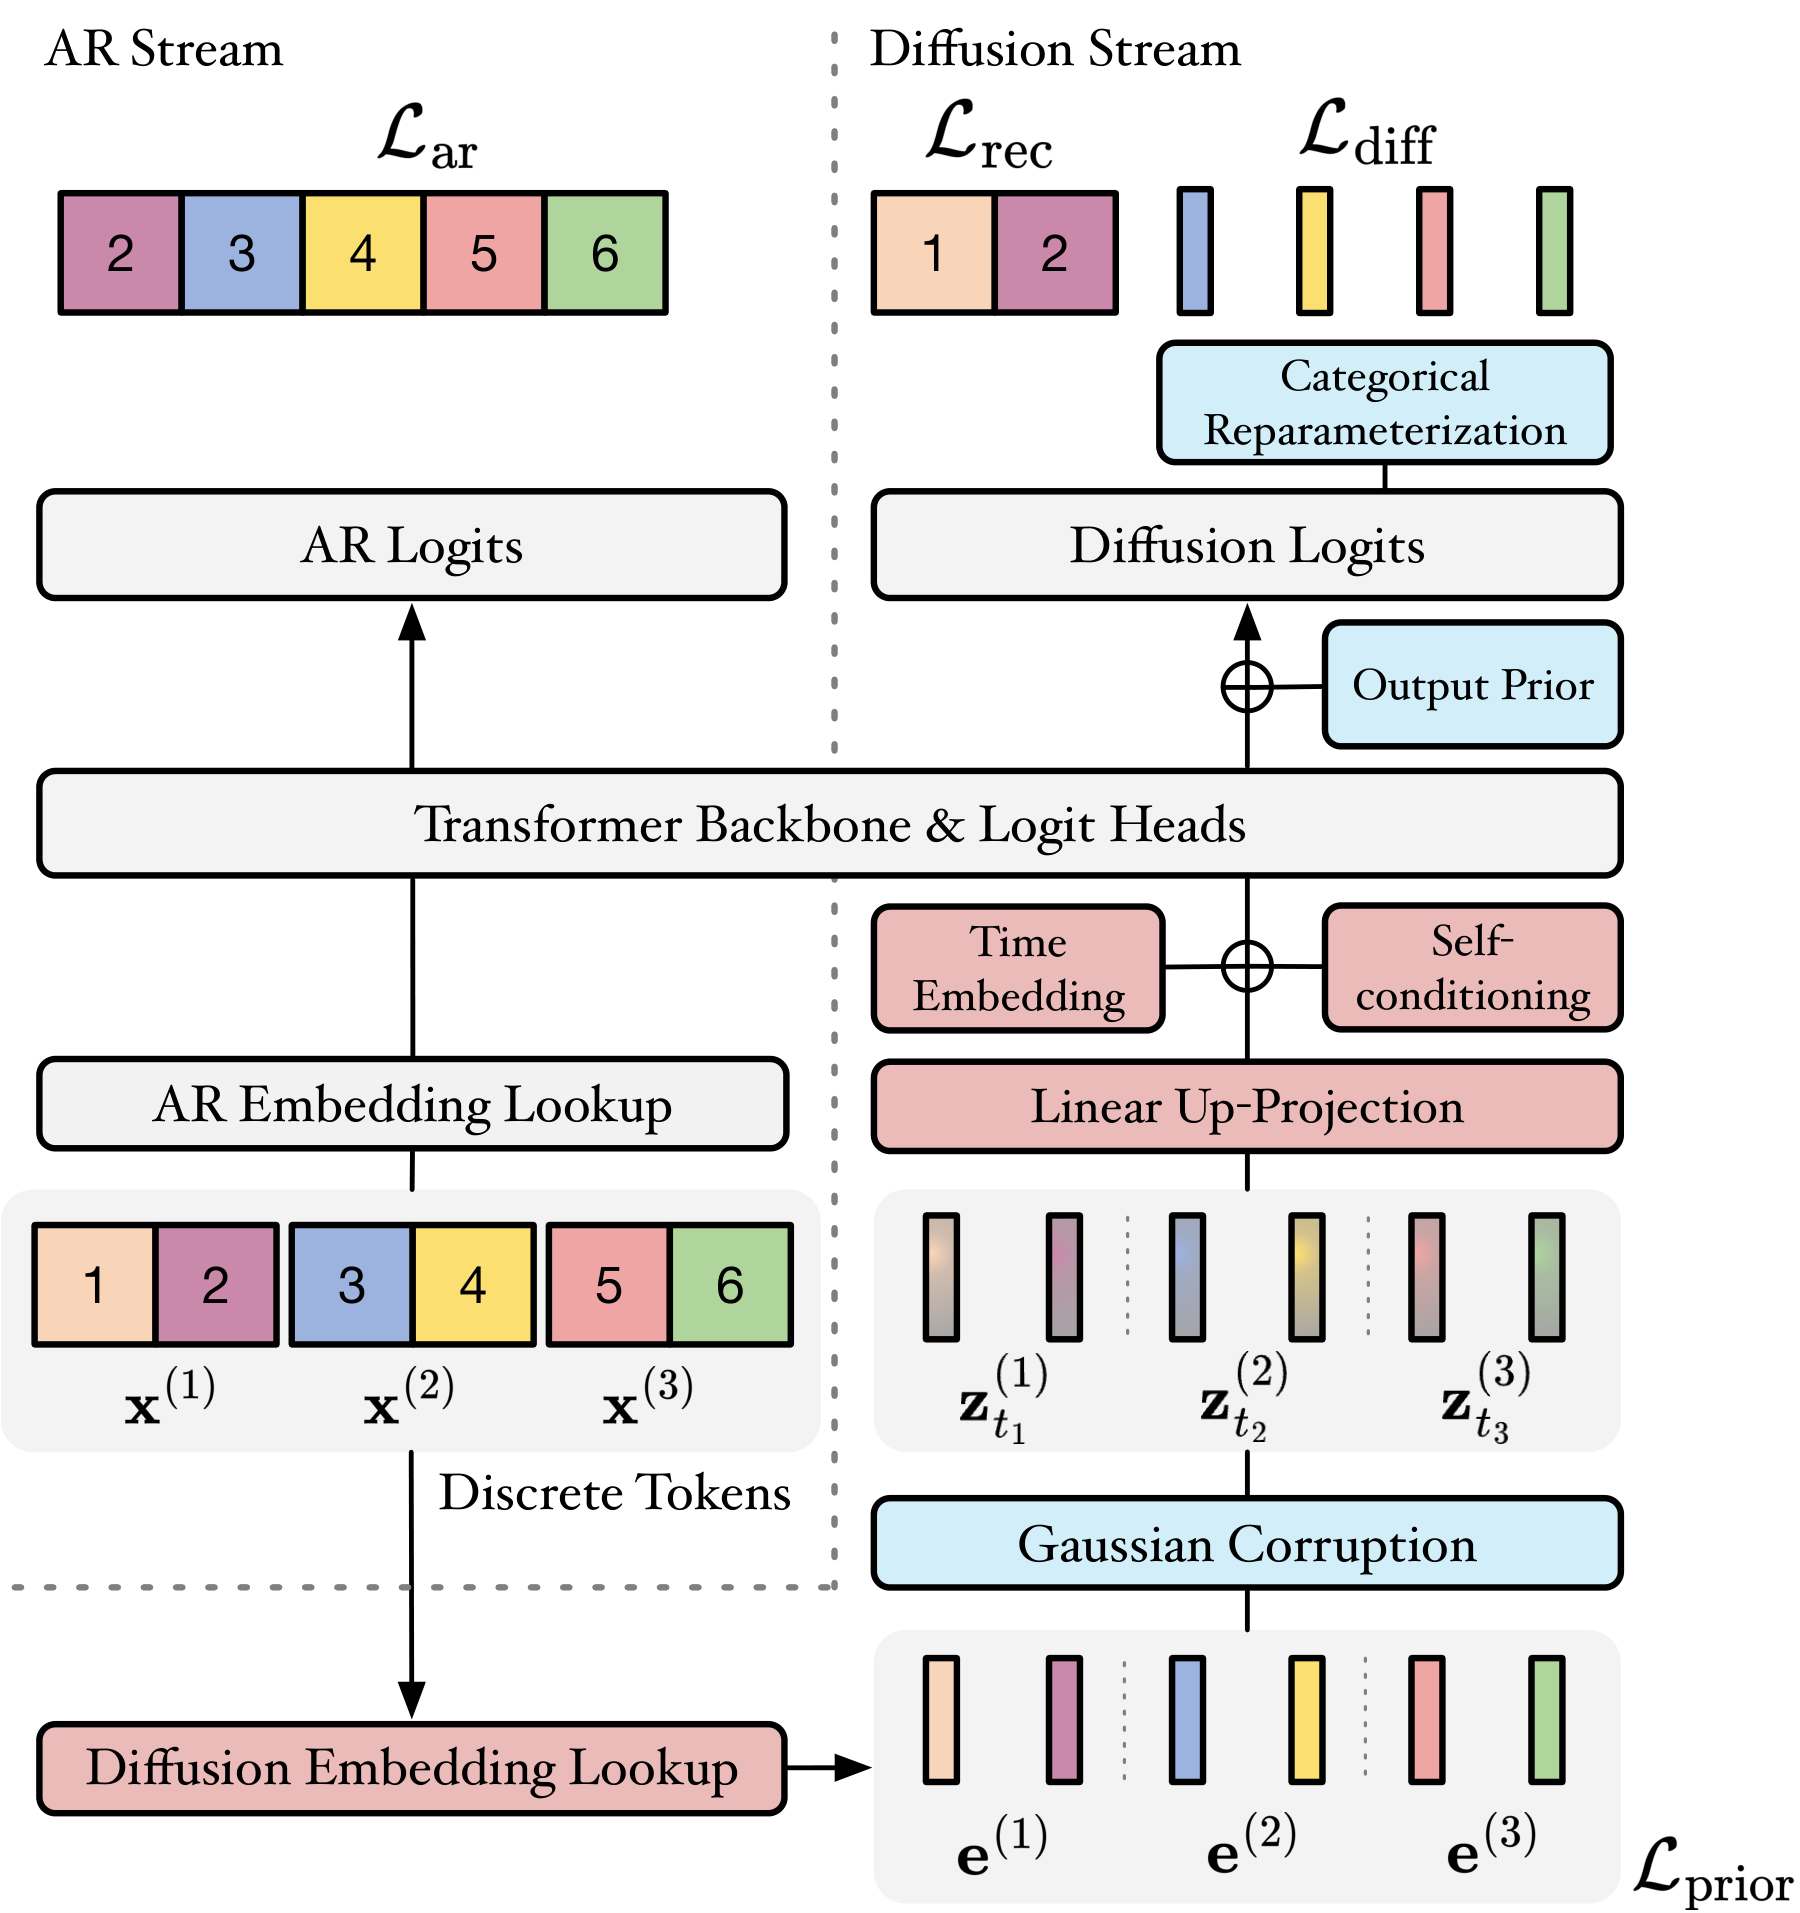
图源:原 Fig. 2a,PDF p. 4。左侧 AR 流读取干净离散 token,右侧扩散流读取加噪后的低维嵌入;两者共享 Transformer,使用各自的输出头。
干净流采用因果注意力。扩散块可以看所有更早的干净块,并在自己的噪声块内双向交互,不能读到当前块的干净答案或后续内容。这个掩码允许训练时把全部块放进一次前向计算,每块独立采样时间。
重建发生在 $t=0$,扩散损失发生在随机 $t$,因此作者按块随机选择一个目标,使用 Horvitz–Thompson 估计保持无偏:
10% 的块学习重建,90% 的块学习随机时间去噪,相应的逆概率权重补偿了采样频率。重建损失并非每个时间点都计算;这一点与少步采样时的终点鲁棒性密切相关。(Eq. (5),Algorithm 1;PDF pp. 3、26。)
2.5 AR 初始化、辅助损失与自条件
骨干、AR 嵌入等从已经训练过 1T token 的 AR 检查点初始化。16 维扩散嵌入因维度不同而随机初始化。继续预训练目标为
旗舰配方先用 $w_{\mathrm{diff}}=1.0$,在约 200B 个继续训练 token 后切换为 0.3。辅助 AR 目标既保留 AR 生成能力,也稳定共享骨干的优化。Fig. 3 的早期从零/AR 初始化实验使用块长 64,最终主实验为块长 32,比较曲线时应保留这个区别。(Sec. 3.2,PDF pp. 4–5;App. E,p. 28。)
自条件(self-conditioning,SC)让去噪器再接收一个预测的干净嵌入。训练时 25% 的样本先无梯度前向得到估计,再把 detached 估计输入第二次前向;其余样本输入零。作者估计额外非嵌入 FLOPs 约 8%。推理时直接复用上一去噪步的预测,只给条件分支输入未经 CFG/ST 修改的均值;无条件分支保持零 SC。(Sec. 2、Fig. 4b,PDF pp. 3、7。)
2.6 DDPM、DDIM 与最后的离散解码
给定前缀 $\mathbf c$,每个新块从 $\mathbf z_1\sim\mathcal N(0,I)$ 开始。根据当前均值预测 $\hat{\mathbf e}_\theta$ 得到噪声预测
DDIM 用确定性更新
DDPM 则每步加入新的高斯随机性:
DDIM 的确定性是相对于固定初始噪声而言,多次重新采样 $\mathbf z_1$ 仍可生成不同回答。最终在 $t=0$ 再运行一次条件去噪器,按词表维度取 $\arg\max_v\mathbf x_\theta^{l,v}$ 得到 token。这里以 Algorithm 2 为准;Sec. 4.1 的文字把读出写到 $\mathbf x_\theta\mathbf E$ 后面,但该乘积只有 16 维,不能直接作为词表 argmax。(PDF pp. 6、27。)
干净前缀使用 AR 嵌入构建因果 KV cache,整个块的去噪步骤可复用它。新生成 token 的 KV 在下一块首步并入,无需单独额外调用。主文报告的 $N$ 个扩散步不包含最终读出:默认提交完整 32-token 块时,真实前向次数为每块 $N+1$。因此 32 步对应约 $33/32$ 次前向/生成 token,4 步对应约 $5/32$;每次处理的是一整个块,不能把这些比率直接当作端到端加速比。
2.7 CFG 与 ST:两个控制不同参照点的外推
令 $\mathbf e_c$ 为带干净前缀、带 SC 的预测,$\mathbf e_\varnothing$ 为去掉全部前缀和 SC 的预测。CFG 为
它增强“看到前缀以后发生的变化”。$w=1$ 退化为普通条件预测。由于预训练采用序列 packing,第一块天然没有前缀,作者据此在推理时启用无条件分支,无需额外训练 context dropout。(Sec. 4.2,PDF p. 6。)
ST 把 score 放大为原来的 $1/\tau$,其均值形式为
它相对于 $\mathbf z_t/\alpha_t$ 外推。这个参照点是对干净嵌入的噪声估计;较小 $\tau$ 增强模型建议的去噪修正。ST 不是 softmax logits 的温度。 前者改变连续 score,后者改变词表概率再取均值,二者在几何上不同。
由高斯加噪的 Tweedie 关系,
所以 CFG 与 ST 可以合成为
对应的 score 是 $\tau^{-1}[w\mathbf s_c+(1-w)\mathbf s_\varnothing]$。对每一分支先做 ST 再做 CFG,或先 CFG 后 ST,得到同一个仿射变换。原 Proposition 1 将其关联到每个噪声时间上 $p_t(\cdot\mid\mathbf c)^{w/\tau}p_t(\cdot\mid\varnothing)^{(1-w)/\tau}$ 的对数梯度;这一推导解释局部引导方向,不直接给出有限步采样最终分布的精确性。(Eq. (28),PDF pp. 45–46。)
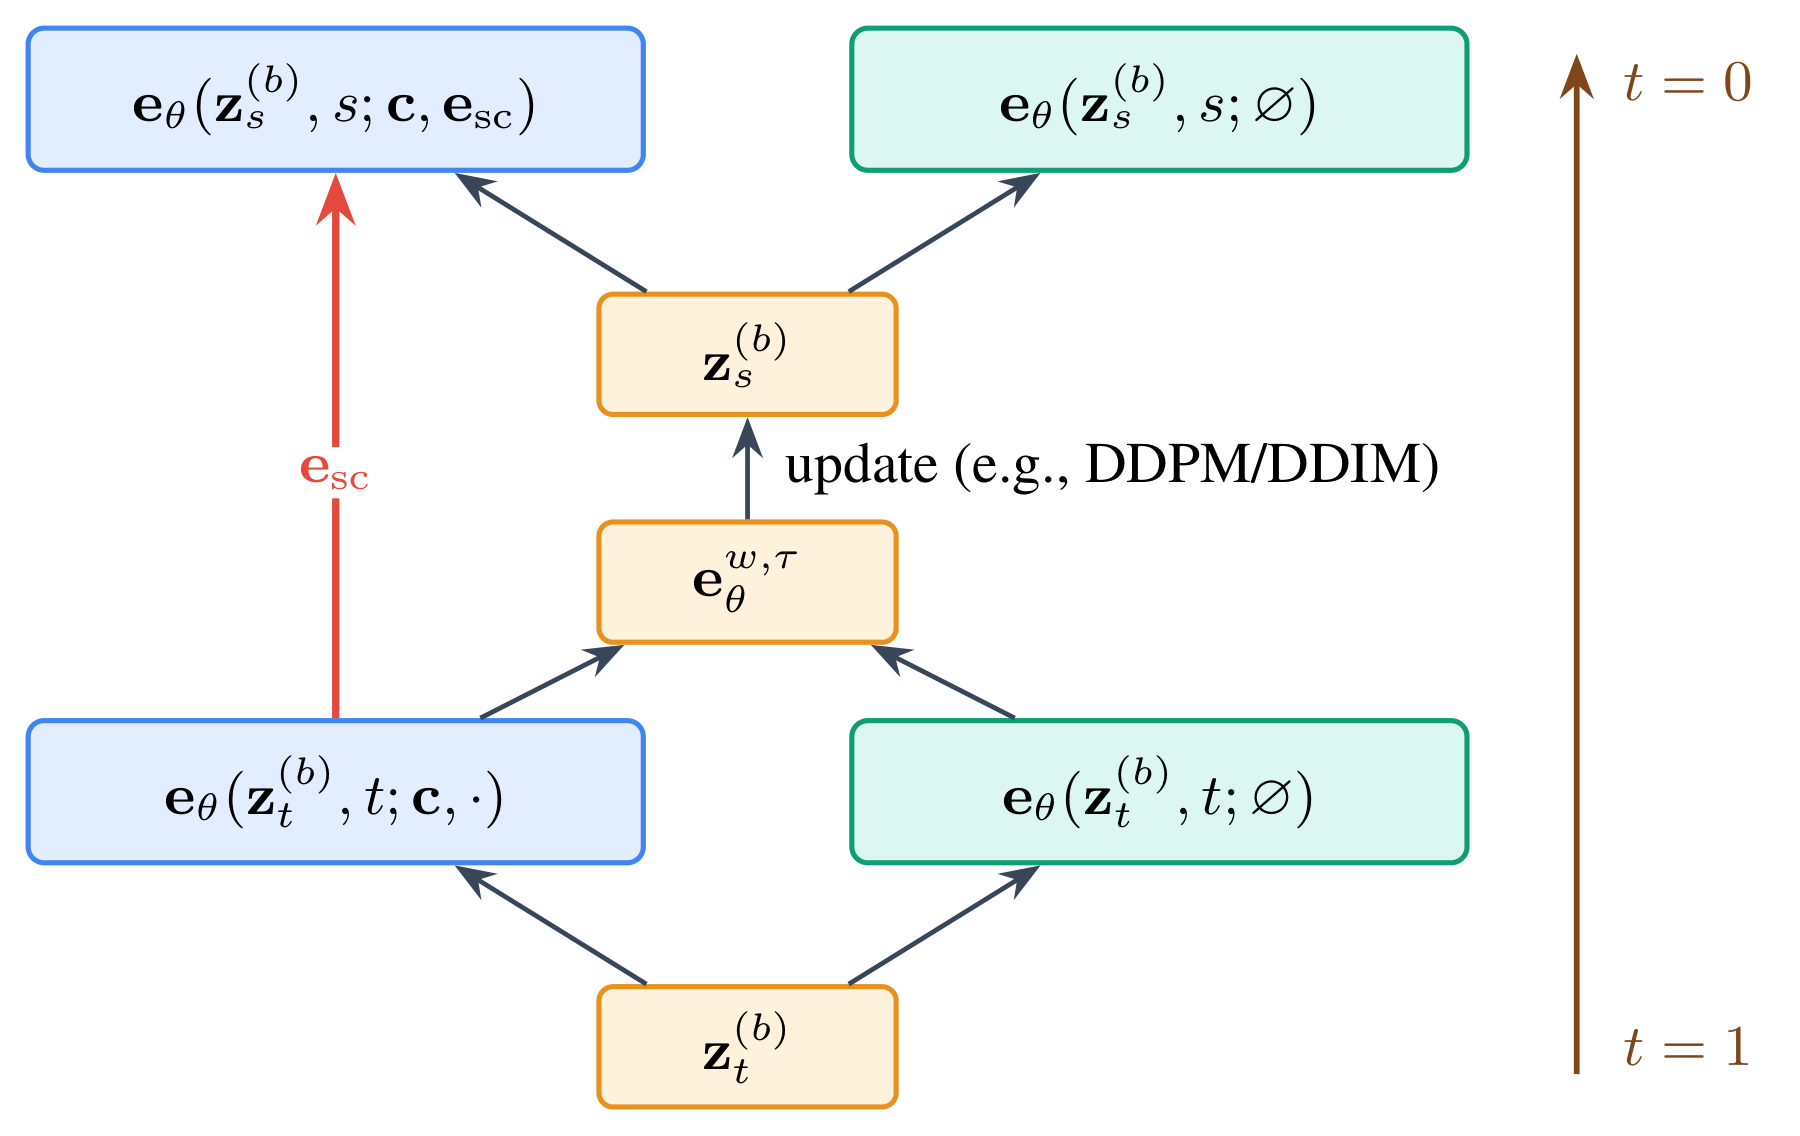
图源:原 Fig. 4b,PDF p. 7。两分支产生均值;橙色路径完成引导及状态更新;红色路径传递未引导的条件均值。条件/无条件分支通过注意力掩码打包进一次 Transformer 前向,减少 batch=1 时的额外权重读取。
2.8 时间网格:训练调度与推理步数分开设计
作者比较三种网格:均匀 $t$、均匀负对数信噪比 $\gamma$、EDM-$\rho$。均匀 $\gamma$ 满足
EDM 在 $\tilde\sigma=\sigma/\alpha$ 的 $1/\rho$ 次幂上等距。由于 $\tilde\sigma=e^{\gamma/2}$,当 $\rho\to\infty$ 时,幂均值趋于几何均值,EDM 网格就趋于均匀 $\gamma$。有限步实验中,DDIM 配均匀 $\gamma$ 是低 NFE 下的稳健选择;DDPM-256 主结果使用 EDM $\rho=7$。(Sec. 5.1,App. G.6/G.11;PDF pp. 8–9、38–39、46、49。)
2.9 SUSReg:让词表嵌入充分利用单位球面
作者观察到,虽然嵌入有 16 维,自由似然训练后按主成分衡量只剩约 4 个有效维度。直觉上,过度聚集会让相邻 token 更难分辨,并放大少步积分误差和最终解码敏感性。
Sketched Uniform Spherical Regularization(SUSReg)把词表视为经验分布 $p_E=V^{-1}\sum_v\delta_{\mathbf e_v}$。对随机方向 $\mathbf a_m\sim\operatorname{Unif}(\mathbb S^{15})$,比较一维投影的经验特征函数与均匀球面分布的目标特征函数:
这里把原 Eq. (16) 的积分变量 $t$ 改写为 $u$,以区别扩散时间;$M$ 在本式为随机方向数。目标分布的一维密度正比于 $(1-x^2)^{(d_e-3)/2}$,定义于 $[-1,1]$。它通过多个随机切片约束整体分布,避免显式计算所有 token 对之间的距离。
论文配置为 $\lambda_{\mathrm{susreg}}=0.005$、512 个方向、$[-5,5]$ 上 17 个梯形积分点,正则项按每 token 加到扩散损失上。它改变了嵌入几何,对验证 PPL 几乎没有惩罚,同时改善少步生成。(Sec. 5.2,App. E.1;PDF pp. 9、28–29。)
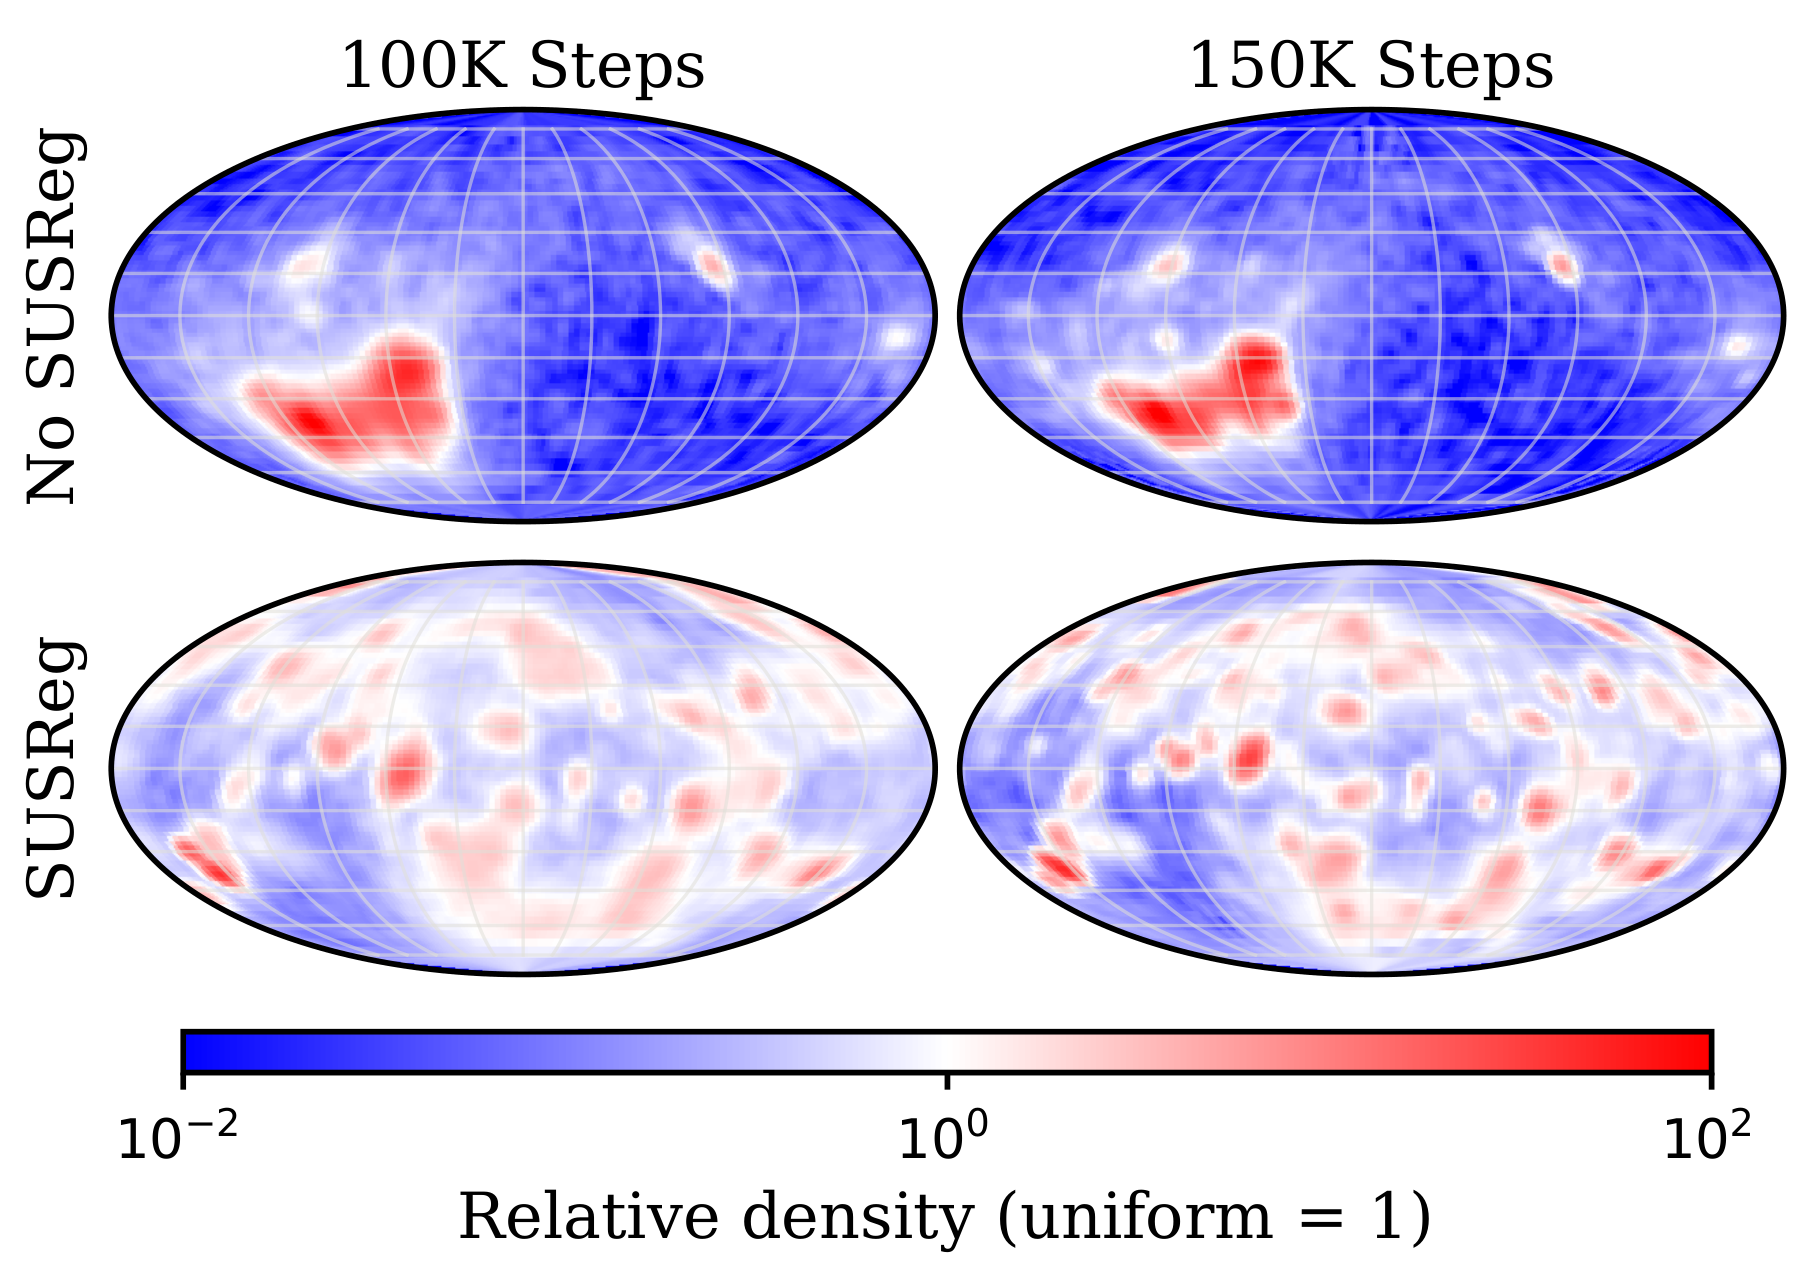
图源:原 Fig. 8,PDF p. 29。列为 100K/150K 训练步,行为不使用/使用 SUSReg;颜色是相对均匀分布的密度,1 表示均匀。随机投影后的聚集区域明显减少;这是几何诊断,少步任务成绩提供了另一组直接证据。
2.10 PDD:一次骨干前向,预测多个细网格更新
并行解码蒸馏(Parallel Decoding Distillation,PDD)保留教师的细积分网格,但减少昂贵的 Transformer 调用。令细网格有 $G$ 个区间,目标调用预算为 $M$,每个时间段覆盖 $\Delta=G/M$ 个细区间。在段首运行一次学生骨干,各个轻量头同时预测该段后续所需的 $\Delta$ 个干净嵌入,然后用普通 DDIM 递推逐步更新状态。只有段末状态进入下一次骨干前向。(App. I.1,Eqs. (32)–(34),PDF p. 57。)
教学解释: 如果一个 32 区间网格被分成 4 段,每段一次骨干给出 8 个预测,之后连续做 8 次便宜的向量更新。节省发生在神经网络计算,细网格算术仍然顺序执行。
PDD 的几个设计决定了它能否保持原模型能力:
- 残差头: 保留原始词表 readout 得到的均值作为 anchor,每个头预测 $\hat{\mathbf e}^{S,\mathrm{raw}}=\exp(2\tanh\mathbf s)\odot\hat{\mathbf e}^{S,\mathrm{anchor}}+\mathbf r$。最后一层零初始化使所有头初始复现 anchor;残差允许预测离开词表凸包,从而拟合 CFG 外推。
- 蒸馏 CFG,显式保留 ST: 单条件学生拟合教师的 CFG 结果,推理不再需要无条件分支;ST 仍按当前局部状态解析计算。回归目标本身不包括 ST。
- 段内 on-policy: 段首来自干净数据的前向加噪分布;之后的监督点来自当前学生的局部 rollout,教师在这些学生到达的状态给出目标。这是局部 on-policy,而非从序列开头开始的完整生成轨迹训练。
- 关闭 SC: 并行预测头无法依赖段内前一头的循环自条件,因此教师和学生都关闭 SC。
- 保留读出与 AR 行为: 在嵌入 MSE 之外加入教师到学生的重建分布和 AR 分布的前向 KL。
蒸馏目标为
教师固定,学生采用 rank-128、scale-256 的 LoRA;嵌入、词表投影和噪声调度冻结。残差头为 32 个宽度 384 的三层 MLP,训练 10K 步,batch 256,使用 512-token 干净前缀和 32-token 目标块。4 步结果采用 $(w,\tau)=(4,0.4)$,8 步采用 $(3,0.3)$,CFG 已蒸馏入学生。(App. I.2–I.5,PDF pp. 57–60。)
附录有一个复现时需要澄清的细节:I.3 要求每段无放回选取 $P$ 个局部节点,I.5 写 $P=8$,同时报告 32 个绝对时间索引头和 4/8 步预算。若据此取 $G=32$,8 步时每段只有 4 个节点,原文未说明这时如何调整 $P$。这不影响表中已报告结果的读取,但不足以唯一恢复该采样实现。
2.11 SFT 保留双目标,默认固定连续几何
SFT 从 150K 步基座检查点开始,只在 assistant 回答位置监督,目标按监督 token 数归一化:
数据为与 NLD 相同的单轮、non-thinking 版本,92.1% 的回答以空的 <think></think> 开头。训练时对 prompt 左侧补至多 31 个无监督 token,让回答从 32-token 网格开始;回答末尾用受监督 EOS 补满块。推理前缀采用偏移块掩码,无需这个 padding。
默认冻结 $\mathbf E$、调度网络及其端点,训练骨干、条件投影与两个输出头。配置为 8K 步(约 2.4 epochs)、全局 batch 256、序列长 4096、学习率 $2.5\times10^{-6}$。冻结/解冻的效果将在结果部分讨论。(Sec. 6,App. H;PDF pp. 10、54–56。)
三:实验——哪些比较是匹配的?
3.1 预训练与比较角色
| 项目 | 原文设置 |
|---|---|
| 数据与 tokenizer | 与 NLD 对齐的数据;Mistral-NeMo,$V=131{,}072$ |
| 序列 / 块长 | 4096 / 32;早期部分消融使用块长 64 |
| 继续训练 | 150K 步,batch 512,超过 300B token;起点已有 1T token AR 训练 |
| 3B 架构 | 26 层,宽 3072,FFN 9216;作者报告非嵌入 3.0B、总参数 3.8B |
| 8B 架构 | 34 层,宽 4096,FFN 14336;非嵌入 7.4B、总参数 8.5B |
| 注意力 | 两规模均 32 个 query head、8 个 KV head,head dim 128 |
| 训练量 | 约 9,600 / 19,200 GB200 GPU 小时,对应 3B / 8B |
NLD 是主要控制对照:数据、骨干、AR 起点与适配思路尽量一致,区别主要落在连续还是掩码扩散及其推理方法。LLaDA、Dream、SDAR 和其他 AR 模型提供外部参照,但不能把跨模型差距完全归因于连续表示。3B/8B 为作者模型名,参数量判断以附录的总参数口径为准。(Sec. 3.2,App. E,PDF pp. 4–5、28。)
3.2 基座模型协议
| 基准 | 题数 / 提示 | 指标与生成预算 |
|---|---|---|
| GSM8K | 1319,8-shot | 提取最后一个数并 exact match;256 tokens |
| Minerva Math | 5000,4-shot | 数学表达式规范化后判符号等价;512 tokens |
| HumanEval / HumanEval+ | 各 164,0-shot | 去代码围栏、AST 提取最长合法代码,再执行测试;512 tokens |
| MBPP / MBPP+ | 500 / 378,3-shot | harness 原生 pass@1,不使用上述 AST 后处理;512 tokens |
六任务平均是未加权的任务分数平均,越高越好。MBPP 与 MBPP+ 的样本集大小不同,后者数值更高不能据此推断增强测试更容易。Sigma 每个问题生成 10 个 sampling lanes,表中为各 lane 全题集成绩的均值 $\pm2\mathrm{SE}$;这是生成随机性误差条。
主配置为 DDPM-256、EDM $\rho=7$、$(w,\tau)=(2,0.1)$、SC 开启。NLD 主表采用块长 32 的置信度阈值贪心采样,按任务取 0.8/0.9 中较好阈值。主表是质量比较,采样计算预算没有统一为相同延迟。(App. G.1,PDF pp. 33–34。)
3.3 SFT、似然打分与多次采样的口径不同
指令模型覆盖十个任务:数学四项、代码三项、MMLU、GPQA 和 IFEval。MMLU/GPQA 在这里生成答案字母再评分;IFEval 为 instruction-level loose-following rate。Sigma 的最大生成长度为 GSM8K 1536,代码、MMLU、IFEval 2560,AIME/MATH-500/GPQA 4096。大部分 baseline 来自 NLD 论文,NLD-8B 扩散行是在对齐协议下重跑的结果。(App. H.2,PDF p. 55。)
附录 F 的基座多选实验则用候选答案的负 NELBO 排序:Sigma 用 128 个分层时间样本和 8 个重建样本;NLD 用低方差、按遮盖数量采样的 NELBO 估计。ARC-e/c、HellaSwag、PIQA 使用按字符长度归一化的分数,WinoGrande/MMLU 使用普通准确率。此处 MMLU 与指令表的“生成答案”评测属于不同协议。(PDF pp. 31–32。)
pass@k 衡量一次问题的 $k$ 个候选中至少有一个正确解的概率。对 $n$ 个样本中 $c$ 个正确的情形,作者用
它描述正确解覆盖率,需要外部判题来识别成功,不等于部署时已经挑出正确答案的成功率。跨模型误差区间按题目配对计算。MBPP 的 Sigma 使用 256-step DDPM,对照 NLD 为 32 transfer steps;GSM8K、Geometry、AIME 的 Sigma 使用 32-step DDIM。多次采样的横轴 $k$ 是样本数,不能跨协议直接当作相同算力。(App. G.8,PDF pp. 42–44。)
四:结果——准确率、可控性与少步质量分别看
4.1 AR 初始化和辅助正则化能否迁移到连续模型?
Fig. 3a/b 显示,从零训练和 AR 初始化两种情况下,带 SC 的 Sigma 都能接近 NLD 的扩散验证 PPL;AR 初始化明显加快收敛。Fig. 3c 中,移除辅助 AR 目标使 AR 流恶化,合适的联合权重也改善扩散 PPL。去掉 AR 正则化的六任务 CFG/ST 扫描整体较差,说明该训练选择对下游生成有实际作用。(PDF pp. 5、47–48。)
附录 E.2 又比较 AR 起点与 NLD/MDLM 起点,继续训练均为 300B token。MDLM 初始化的六任务均值在 DDPM-256 下为 64.67,AR 初始化为 64.34;在 DDIM-32 下为 61.64 对 60.45。增益主要出现在 MBPP 系列,HumanEval 系列反而下降。因此 AR 起点是有效配方,MDLM 起点也可行,但收益有任务差异。(Table 5,PDF p. 30。)
4.2 基座模型:均值接近,数学和代码存在取舍
下表保留主表的均值;全部为扩散模式、块长 32,单位为 %。
| 模型 / 采样 | GSM8K | Minerva | HumanEval | MBPP | 六任务均值 |
|---|---|---|---|---|---|
| NLD-3B | 83.40 | 63.96 | 56.10 | 57.60 | 64.74 |
| Sigma-3B DDPM-256 | 84.50 | 64.60 | 59.45 | 52.32 | 64.34 |
| Sigma-3B DDIM-32 | 81.91 | 62.76 | 56.59 | 47.26 | 60.45 |
| Sigma-3B DDIM-16 | 78.08 | 60.16 | 47.50 | 41.84 | 55.17 |
| NLD-8B | 87.26 | 65.16 | 62.80 | 67.00 | 70.22 |
| Sigma-8B DDPM-256 | 89.07 | 67.47 | 61.40 | 64.78 | 69.67 |
| Sigma-8B DDIM-32 | 87.78 | 67.13 | 58.54 | 59.54 | 66.72 |
来源:Tables 1–2,PDF p. 8。六任务均值还包括未展示的 HumanEval+ 与 MBPP+。
3B 的高步数 Sigma 在 GSM8K 上高出 NLD 1.10 个百分点,在 HumanEval 上高出 3.35,但 MBPP 低 5.28,最终均值低 0.40。8B 同样在数学上较强,六任务均值低 0.55。这说明连续扩散可以达到强掩码模型附近的质量,同时还没有形成各类任务上的一致优势。
与外部扩散基座模型相比,Sigma-3B 的均值比 LLaDA-8B 的 41.78 高 22.56 个百分点,比 Dream-7B 的 58.74 高 5.60;这一差距包含训练配方、数据和初始化的共同影响。Sigma-3B 的辅助 AR 模式均值为 65.47,8B 为 66.53,说明保留 AR 目标不意味着两种解码模式会以相同方式改善。
4.3 CFG/ST 改变连续轨迹的价值
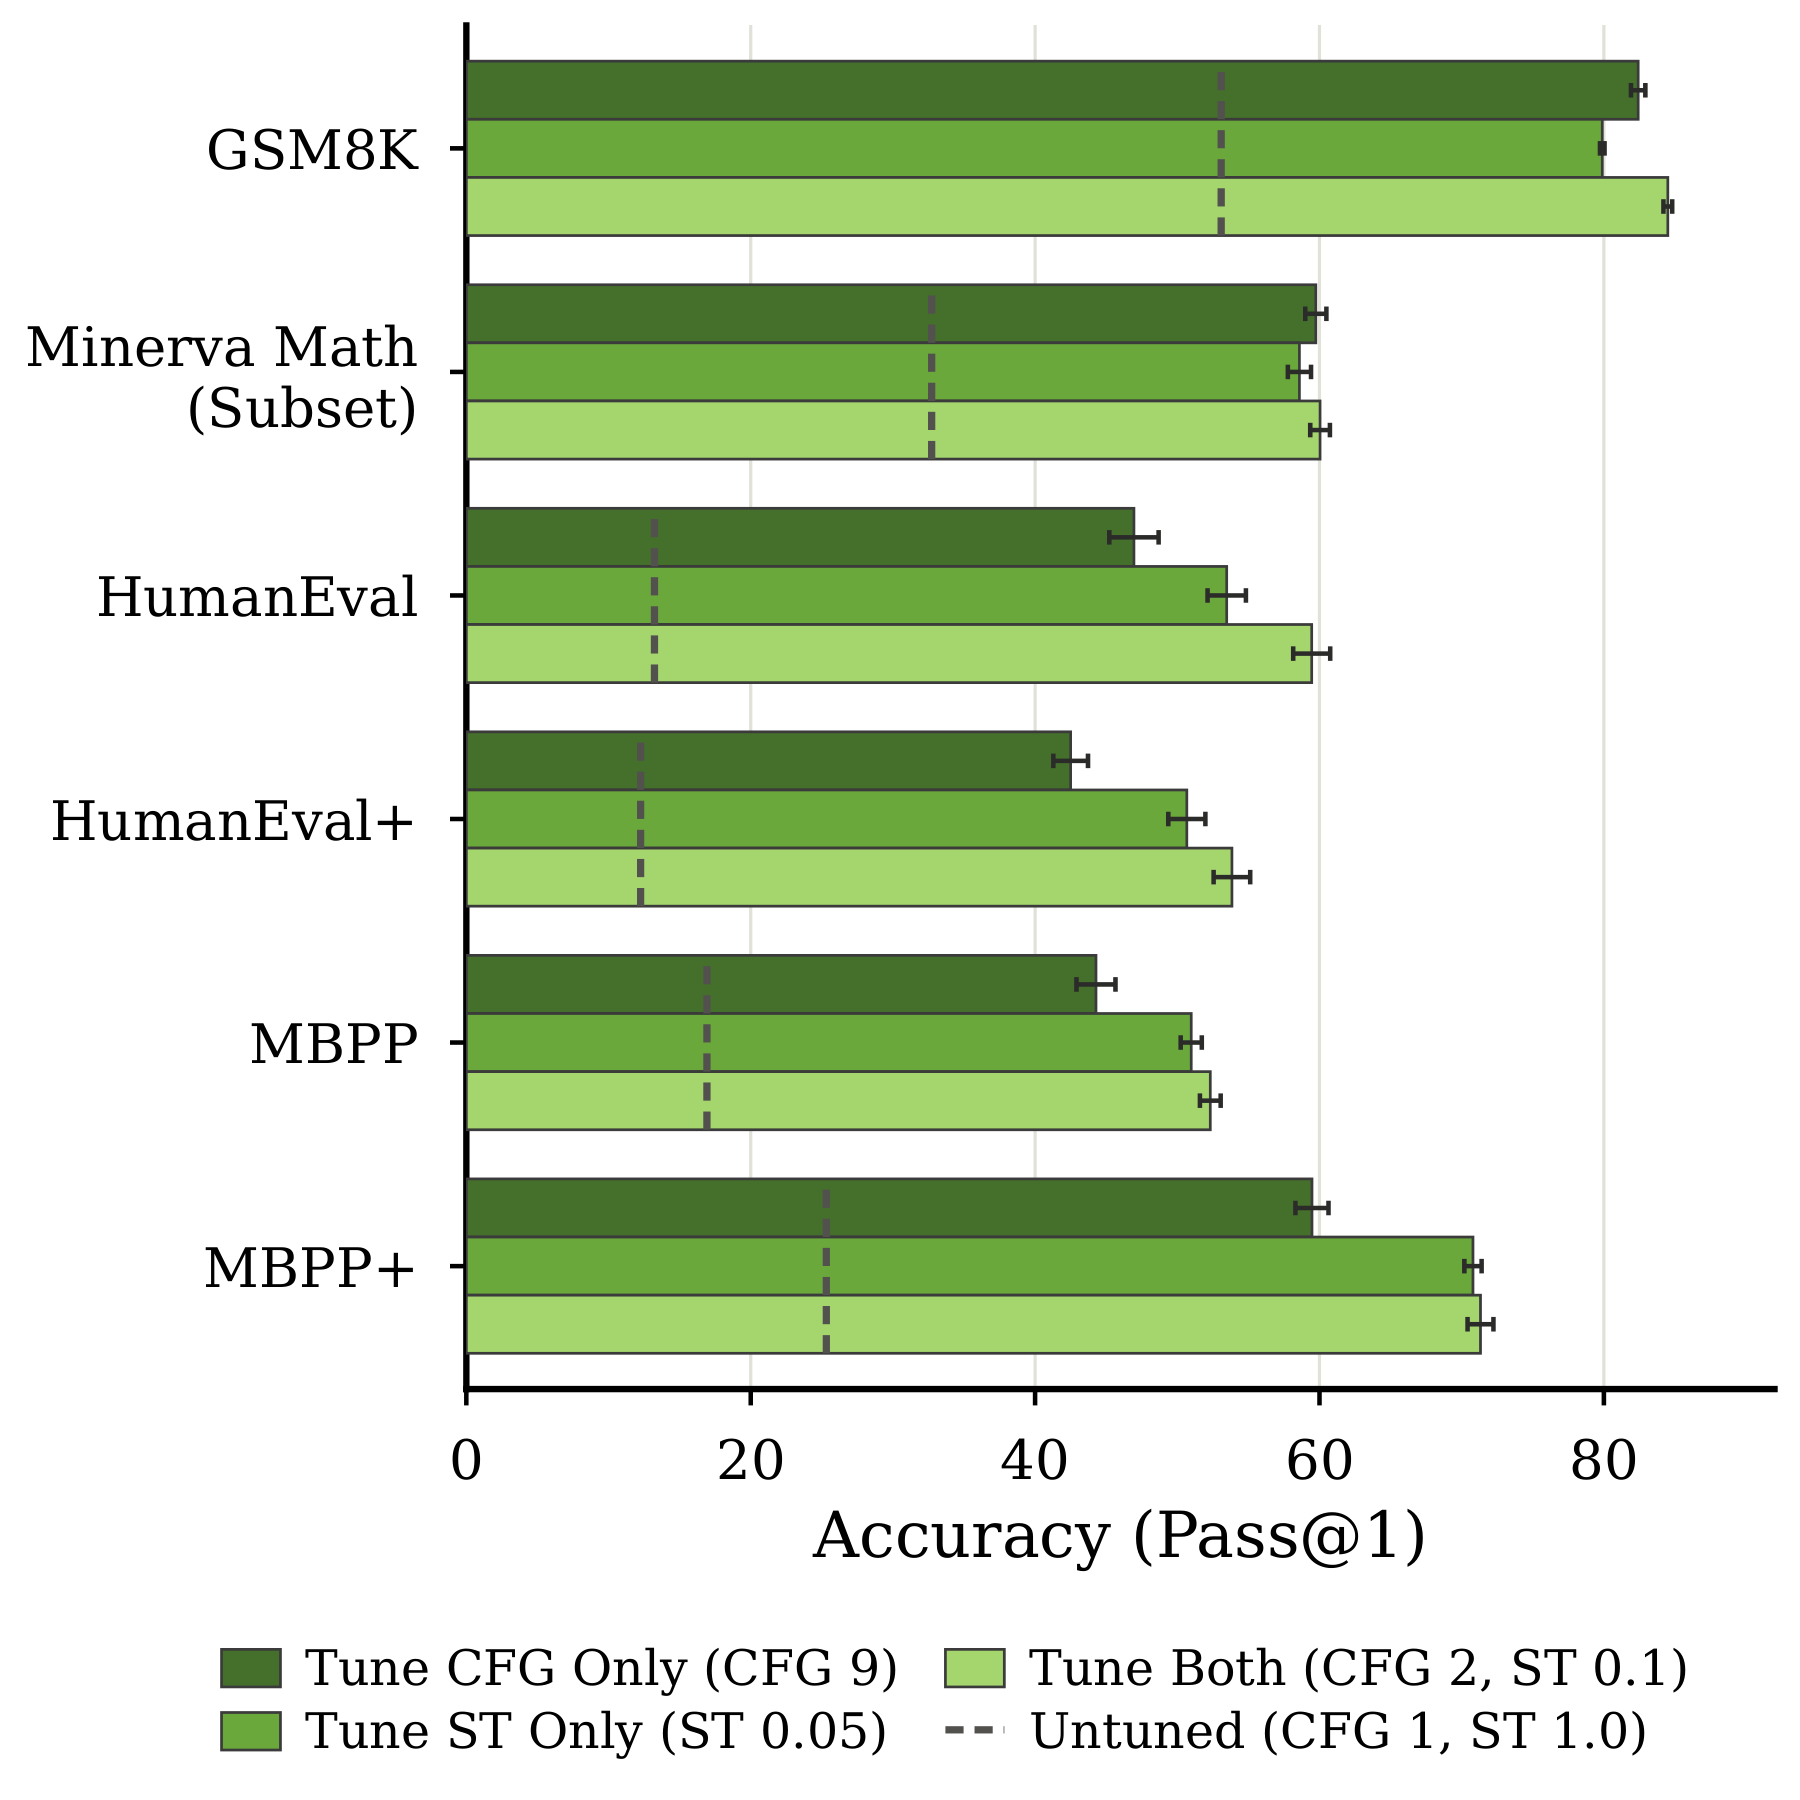
图源:原 Fig. 5,PDF p. 7。横轴为 pass@1 准确率,纵轴为六个任务;比较只调 CFG、只调 ST、同时调两者以及均不使用的设置。联合配置 $(w,\tau)=(2,0.1)$ 更强,支持把两个控制量作为组合调参对象。
附录检验了三个可能的替代解释。
引导应该在哪个空间做? 在 DDIM-64、$\tau=0.3$ 下,HumanEval 的最佳 embedding CFG 为 56.22,最佳 logit CFG 为 53.78;DDPM-256、$\tau=1$ 下为 46.95 对 29.70。GSM8K/DDIM 是例外,logit CFG 为 83.49,embedding CFG 为 83.19。logit 引导常在 $w=2$ 达峰后迅速变差,嵌入引导的有效范围更宽。(Table 9,PDF p. 35。)
只有 softmax 温度是否足够? 在无 CFG 的 DDPM-256 下,logit 温度能把 GSM8K 从 52.44 提到 79.11;硬 MAP 端点也有 78.61,说明这种锐化本身有用。但在 CFG/ST 已开启的 DDIM 设置上,再加 logit 温度会使最佳 83.19 下降。ST 对均值进行外推,logit 温度始终把均值限制在词表凸包内,后者不能完全替代前者。(Tables 10–11,PDF p. 36。)
坏预测只去掉 SC 是否足够? 在 DDIM-64/$\tau=0.3$ 下,保留上下文但去掉 SC 的最佳 GSM8K 为 76.19,去掉上下文和 SC 为 83.19;HumanEval 为 50.91 对 56.22。结果支持使用完整无条件分支。(Tables 12–13,PDF p. 37。)
4.4 少步采样:SUSReg 与 PDD 的作用阶段不同
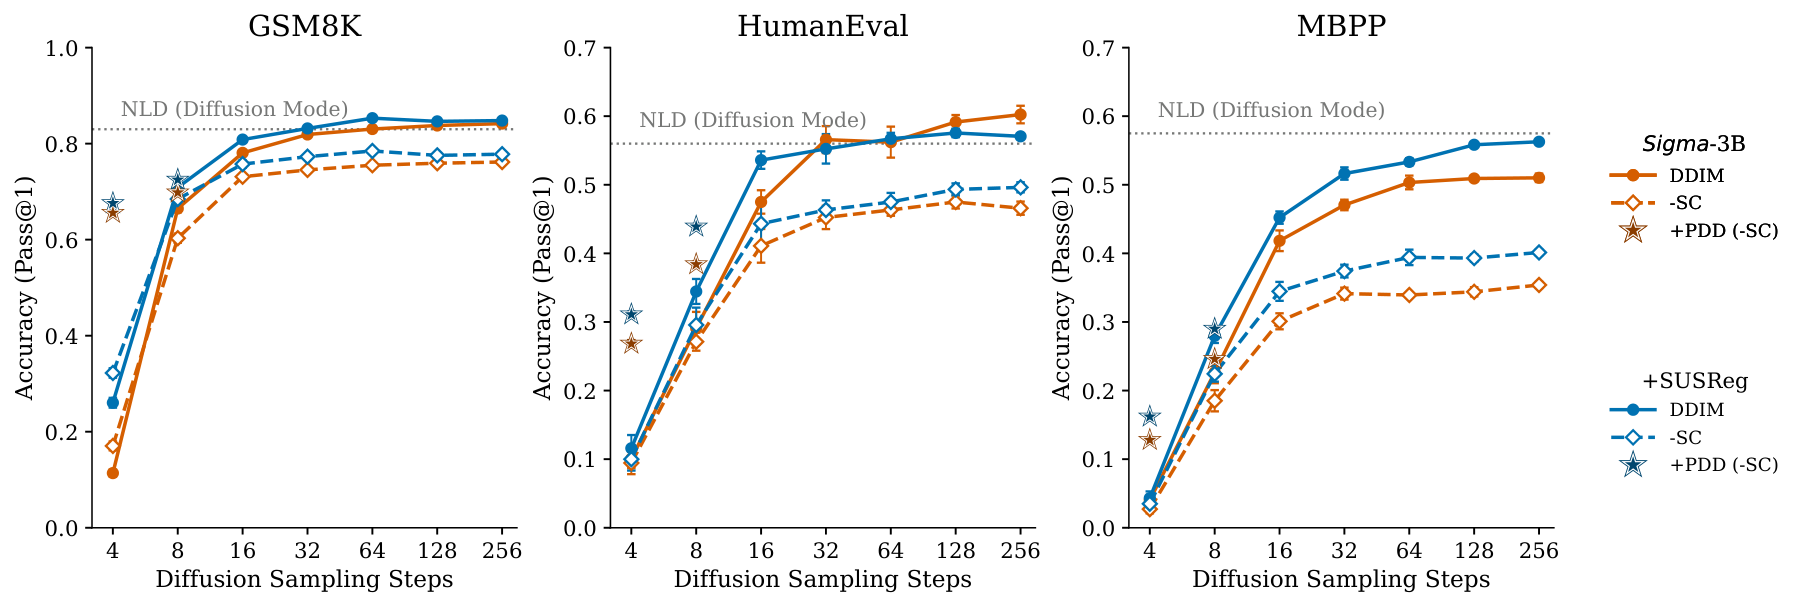
图源:原 Fig. 7,PDF p. 9。横轴为每块扩散步数,纵轴为 pass@1;橙色是基础 Sigma,蓝色为 SUSReg;实线保留 SC,虚线去掉 SC,星形为关闭 SC 的 PDD。三面板依次为 GSM8K、HumanEval、MBPP。代码面板在很少步数下更难保持质量。
| 3B 配置 | 普通 Sigma 六任务均值 | + SUSReg 均值 | SUSReg 增益(百分点) |
|---|---|---|---|
| DDIM-256,SC 开 | 63.88 | 64.34 | +0.46 |
| DDIM-32,SC 开 | 60.41 | 61.85 | +1.44 |
| DDIM-16,SC 开 | 55.17 | 58.50 | +3.33 |
| DDIM-8,SC 开 | 37.06 | 42.76 | +5.70 |
| DDIM-4,SC 开 | 7.74 | 11.80 | +4.06 |
| PDD-8,SC 关 | 42.12 | 46.79 | +4.67 |
| PDD-4,SC 关 | 31.74 | 35.45 | +3.71 |
来源:Table 8,PDF p. 33。DDIM 使用均匀 $\gamma$,每个预算选择相应的 CFG/ST;PDD 使用蒸馏时的配置。因此这些是各预算下的系统配方比较,含超参数差异。原文有一处数值不一致: Table 1 的 DDIM-32 MBPP 为 47.26、均值 60.45,Table 8 为 47.06、均值 60.41。本表沿用 Table 8,前一节沿用 Table 1,未将二者混为一条记录。
SUSReg 的作用在 16/8 步尤其清楚;PDD 在 4 步把带 SUSReg 的均值从 11.80 提高到 35.45。对应 GSM8K 为 26.04→67.60,HumanEval 为 11.59→31.10,MBPP 为 4.32→16.20。到 8 步,PDD+SUSReg 的均值为 46.79,仍低于 16 步非蒸馏 SUSReg 的 58.50。它确实缓解极少步数下的退化,但四步代码生成仍是明显短板。
4.5 为什么更高阶 ODE 求解器反而失败?
在相同 16 次去噪调用、相同均匀 $\gamma$ 网格和 DDIM 选出的 CFG/ST 下,GSM8K 的 DDIM 为 78.08,DPM-Solver++(2M) 为 33.18,$\rho$AB1-DEIS 为 48.96,$\rho$AB2-DEIS 为 2.65,$\rho$RK-DEIS 为 0.86。HumanEval/MBPP 也未发现高阶方法优于 DDIM。(Table 16,PDF p. 40。)
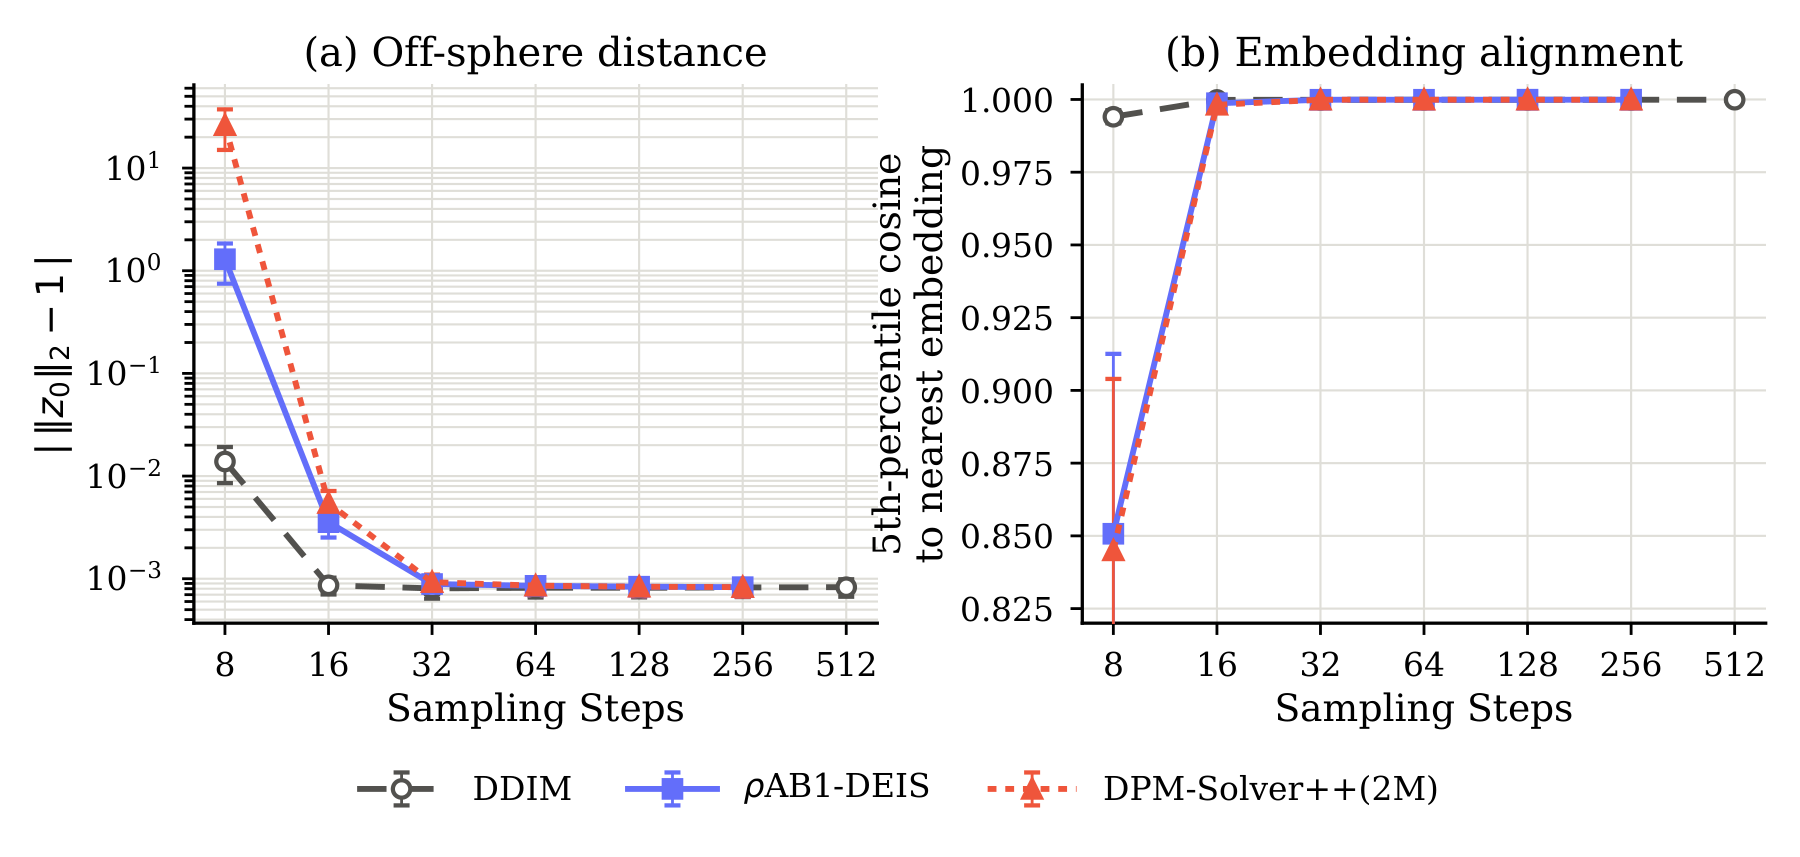
图源:原 Fig. 15,PDF p. 50。左图纵轴是终点偏离单位球面的平均距离,越小越好;右图是与最近词表向量余弦相似度的第 5 百分位,越高越好。8 步时,DDIM、$\rho$AB1-DEIS、DPM-Solver++ 的偏离距离分别为 0.014、1.29、26.2;对应相似度为 0.994、0.851、0.845。(诊断设置见 App. G.7,PDF p. 41。)
作者的解释是,高阶外推把低步数终点推到训练中很少出现的区域,而重建损失主要训练 $t=0$ 附近的读出;数值积分误差最终被放大成 token 错误。这也提示“连续轨迹”不保证可以直接使用图像扩散的高阶求解器。该比较沿用 DDIM 的引导超参数,其证据支持当前设置下的稳健性判断,尚未比较每个求解器各自完整调优后的最优值。
4.6 多次采样:覆盖率改善有强弱不同的证据
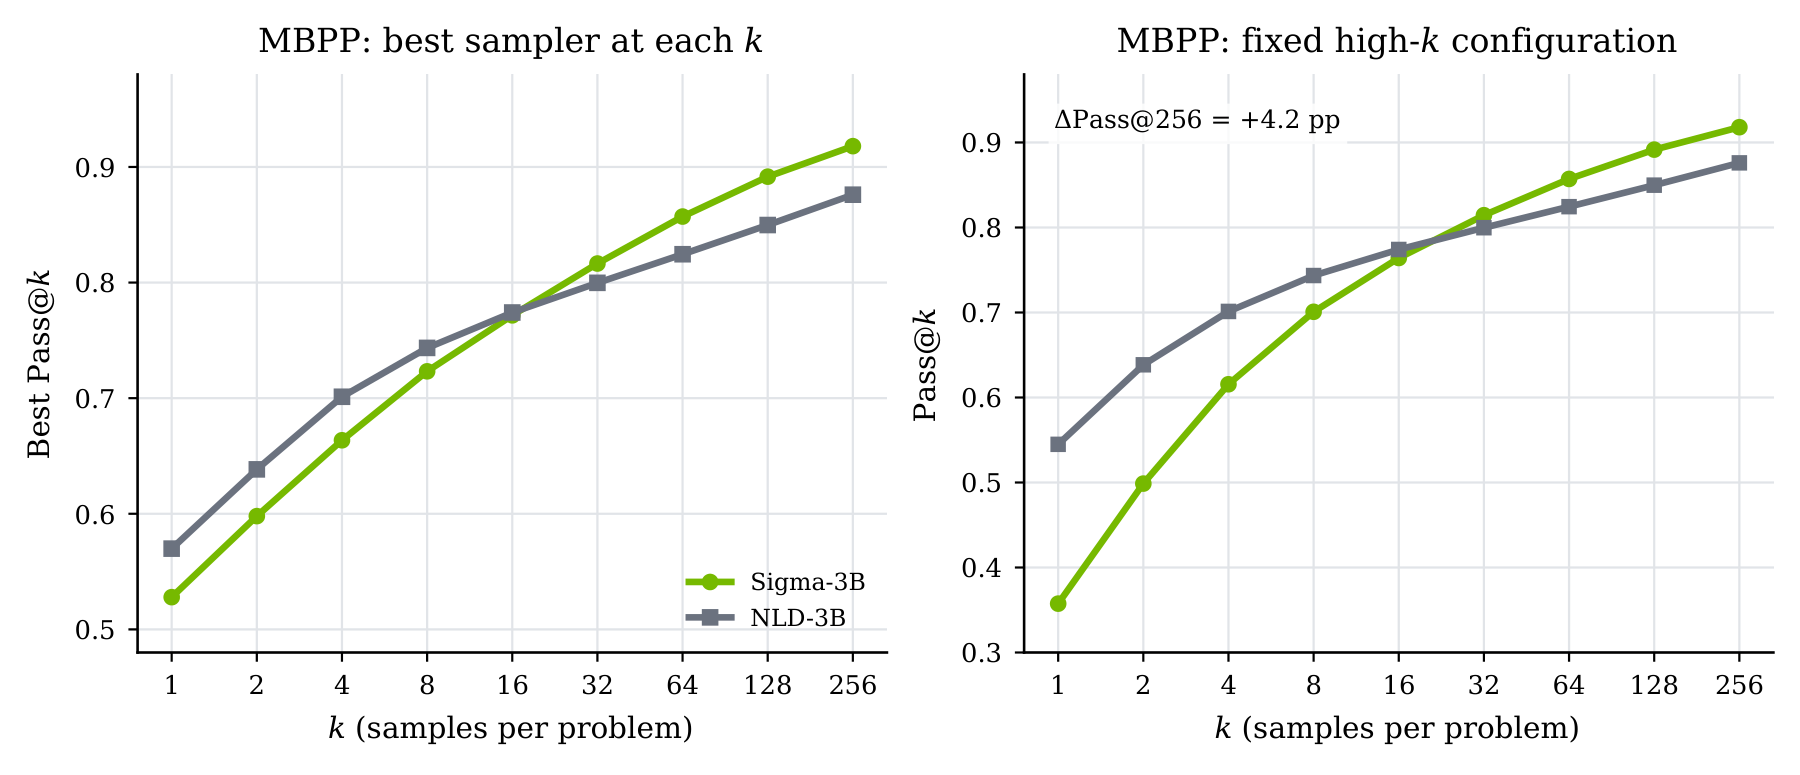
图源:原 Fig. 16,PDF p. 51。横轴是每题样本数,纵轴是 pass@k。左图允许每个 $k$ 从各自网格挑最佳设置,右图给每个模型固定一个高覆盖率设置。固定配置仍达到 Sigma 91.8%、NLD 87.6% 的 pass@256;差值 +4.2 个百分点,配对 95% CI 为 [+1.7,+6.7]。Sigma 用 256 步 DDPM,NLD 用 32 transfer steps;这是样本覆盖率比较。
在这组固定 MBPP 配置中,Sigma 的完全相同字符串重复率为 10.4%,NLD 为 53.1%;每题平均正确样本数反而是 91.5 对 139.5,但不同正确字符串数是 71.4 对 46.9。它们共同说明,降低单次锐化可以换取更广覆盖。字符串去重只是表面多样性的诊断,不直接等价于独立的推理策略。(App. G.8.1,PDF p. 42。)
| 任务 / 设置 | 主要发现 | 解释所需条件 |
|---|---|---|
| MBPP,3B base | pass@256:91.8% 对 87.6% | 固定配置差值区间排除 0;两家采样步数不同 |
| Geometry,3B base | 高覆盖配置 pass@512 约 95.4% 对 94.2% | 原文报告差值约 +1.3 pp,CI [-0.3,+2.8];匹配 pass@1 后与最佳 NLD 近乎重合 |
| GSM8K,3B base | 256 次中至少解出 1314/1319 对 1305/1319 题 | 固定 Sigma $(2,1.0)$,NLD $(0.9,1.0)$;pass@256 配对差约 +0.68 pp,CI [+0.2,+1.2] |
| AIME 2025,3B instruct | pass@256:63.3% 对 53.3% | 仅 30 道题;与最佳 NLD 的区间跨 0,27 个配对比较仅 1 个排除 0 |
来源:App. G.8,Tables 17–19,Figs. 16–19;PDF pp. 42–44、51–52。
Geometry 的 matched-pass@1 控制尤其有信息量:当 NLD 的 temperature 调到 1.0,Sigma 的多样性优势没有形成稳定的更高覆盖;对较低温度的 NLD 则有明显增益。AIME 的趋势较强,但题目数决定了统计分辨率,多抽同一道题无法代替增加题目覆盖。AIME 实验中两家回答上限分别为 4096/16384 tokens,作者称正常输出没有触及较短上限。
4.7 SFT:整体接近 NLD,任务分布不同
| 扩散模式 | 3B 十任务均值 | 8B 十任务均值 |
|---|---|---|
| NLD-Instruct | 52.89 | 59.92 |
| Sigma-Instruct DDPM-256 | 52.15 | 59.27 |
| Sigma-Instruct DDIM-32 | 49.86 | 57.01 |
来源:Tables 3–4,PDF p. 10。两种规模的高步数均值分别比 NLD 低 0.74/0.65 个百分点,符合作者“接近”的总体判断。
看 8B 的具体任务,Sigma DDPM-256 的 GPQA 为 44.70(NLD 33.33),IFEval 为 79.14(73.02);但 MATH-500 为 78.88(84.60),AIME25 为 16.33(23.33),HumanEval 为 79.76(83.54)。平均值接近来自不同任务上的互补,不能读成更强的困难数学推理。3B 的 Sigma 在 HumanEval 为 77.62,高于 NLD 74.39,但 LiveCodeBench-CPP 为 11.17,低于 NLD 16.30。
默认冻结连续几何的 3B 模型,DDPM-256 均值为 52.15,解冻后为 51.65;DDIM-32 则从 49.86 变为 50.84。两采样器上的排序反转,因此作者把冻结作为较简单的默认选择,没有证据支持冻结必然更优。(Table 22,PDF p. 56。)
4.8 补充结果:似然打分、提交步幅与系统开销
似然多选。 在附录 F 的六项候选打分任务上,Sigma/NLD 扩散模式均值分别为 3B 的 68.40/68.03,8B 的 72.28/73.02。它说明连续模型的变分界具有可用的答案排序能力。该协议使用多次 Monte Carlo 估计,并依赖双向注意力能处理非 32-token 的候选长度。(Tables 6–7,PDF pp. 31–32。)
Commit stride。 每次仍去噪 32 个位置,但只提交前 $S\in\{8,16,32\}$ 个,其余尾部丢弃,下一个窗口重新加噪。名义预算为 $32N/S$,包含读出后的真实预算为 $32(N+1)/S$。3B 在名义 256 下,DDIM-64/stride-8 均值 67.00,高于 DDPM-256/stride-32 的 64.34;但实际每 32 个提交 token 分别需 260 与 257 次前向。名义 32 下,DDIM-16/stride-16 为 61.82,DDIM-32/stride-32 为 60.45,而 DDIM-8/stride-8 下降为 57.76。小步幅可利用更短的提交跨度,但每窗去噪太粗时会失效。(Tables 14–15,PDF pp. 38–40。)
块内稳定顺序。 Fig. 20 横轴是块内位置,纵轴是最终 token 以至少 0.9 概率保持稳定后的次序。Sigma 的靠前位置更晚稳定、靠后位置更早稳定,相比 NLD 的左到右倾向弱一些。曲线仍与位置相关;它描述中间预测的稳定顺序,最终实际提交仍在块末统一发生。(App. G.9,PDF pp. 44、53。)
Packed CFG 的耗时。 在单张 H100、Sigma-3B BF16、batch=1、只生成首块、前缀长约 729–814 的实验中,块长 32 的一次前向从 19.08 ms 变为 19.89 ms,增加 4.2%;块长 64 从 19.31 ms 变为 19.80 ms,增加 2.6%。主要额外开销来自第二份 logits、softmax 和类别重参数化。这个测量支持 CFG 的较小边际延迟,测量范围是每次去噪调用,并未给出整个系统相对 AR 的端到端优势。(Table 20,PDF pp. 44–45。)
五:结论与研究启发
Sigma 说明,可学习低维嵌入上的连续扩散可以扩展成有竞争力的条件语言模型。AR 迁移提供了训练起点,双流目标让骨干适应连续输入,CFG/ST 让已训练模型在质量和覆盖率之间选择操作点,SUSReg 与 PDD 又把连续表示转化为少步优化的入口。
这套方法最值得借鉴的三个联系是:似然优化同时塑造表示几何;表示几何又决定少步采样和解码的鲁棒性;蒸馏能减少网络调用,但需要保留词表读出与引导行为。单独提高求解器阶数、单独降低采样步数,都没有自动解决这些联系带来的误差。
实际取舍集中在两点。其一,高步数质量比较与生成速度分属不同证据,当前少步代码准确率仍明显下降。其二,低维嵌入带来紧凑轨迹,也使最终 token 读出对几何扰动敏感;训练只在接近干净端施加强重建约束,因而终点偏移是值得继续解决的瓶颈。(App. B,PDF p. 22。)
基于论文的下一步研究方向,可优先考虑在更多噪声时刻增强类别读出鲁棒性、让蒸馏保留 SC 的收益,并用相同真实前向次数或墙钟时间比较 pass@k 覆盖率。奖励引导、验证器驱动后训练和多模态统一连续空间是作者提出的后续方向,本文尚未给出这些方向的实证结果。