The Surprising Effectiveness of Shared Memory in Looped Transformers:中文研读笔记
作者:Giovanni Monea、Keshav Ramji、Yousef El-Kurdi、Luis A. Lastras、Yoav Artzi、Nathan Godey、Ramón Fernandez Astudillo(Cornell University / IBM Research)。
版本:arXiv:2610.02383v1,2026-10-01 提交;本次研读日期:2026-10-07。本文页码均为从 1 开始的 PDF 页码,与论文印刷页码一致。
材料与成品:arXiv · 原文 PDF · 英文汇报 PDF · 可编辑 Beamer。
论文总览
循环 Transformer(Looped Transformer,LT)反复执行同一组层,借助更多计算提高一个固定参数模型的能力。但参数共享并不意味着上下文记忆共享:通常每轮循环都写自己的键值缓存(KV cache),因此循环次数越多,缓存也越大。
本文提出循环预测 Transformer(Looped Prediction Transformer,LPT):第一轮在每个注意力层建立完整上下文缓存,后续轮次读取同一层的首轮缓存,并仅保留自己的短窗口。训练从一开始就使用这种读写方式。它同时改变了前向的信息来源和反向的梯度路径,使首轮更适合构建记忆,后续轮次更适合逐步形成预测。
最值得记住的结果是:在 150M–1B 参数、4,096-token 上下文下,五轮 LPT 用约 1/4.7 的缓存优于对应 LT;将相同机制用于 Gated DeltaNet 混合模型得到 H-LPT,五轮时相对同参数单次标准 Transformer 的 PPL 降低 1.12–1.82,平均准确率提高 3.1–5.6 个百分点,上下文内存减少约 76%–79%。代价是增加循环计算;本文比较重点是参数与记忆利用效率。[Sec. 3–5,pp. 3–6,Table 1]
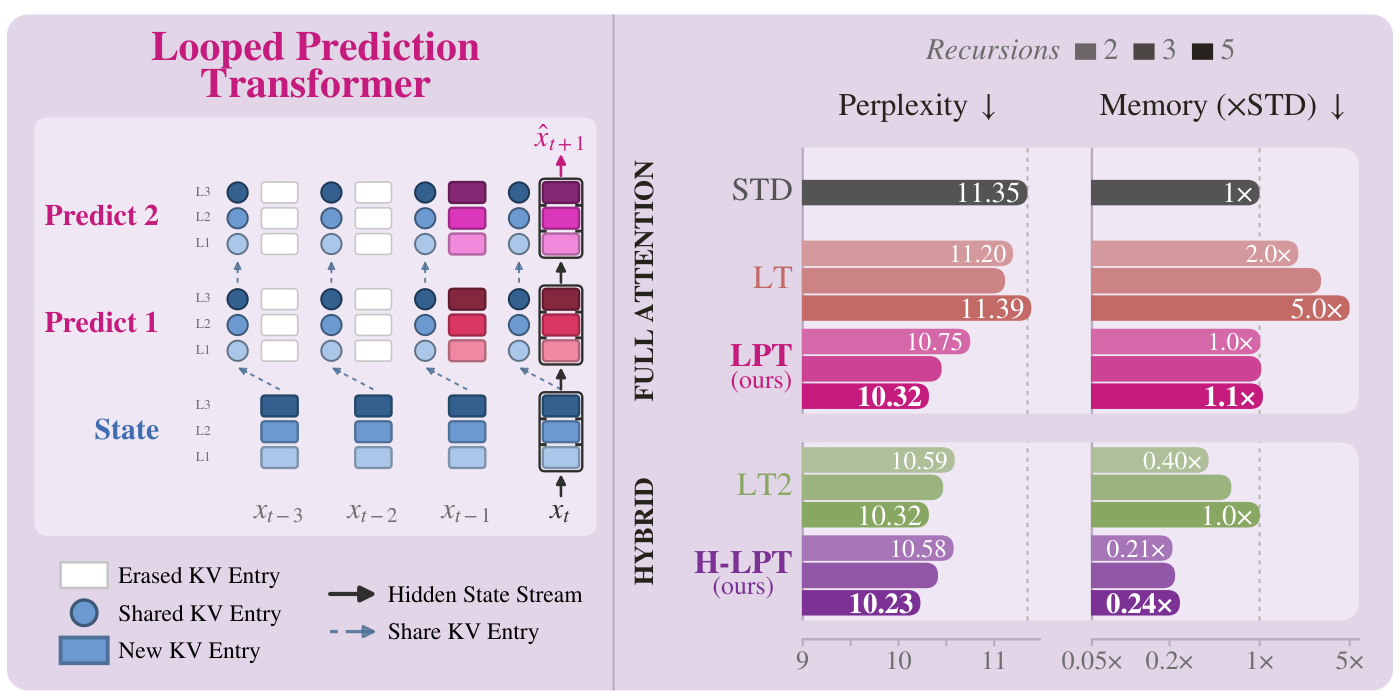
原图 1,p. 1。左侧从下往上是首轮状态计算与后续预测计算:蓝色圆点表示复用的首轮 KV,空白格表示不再保存的局部历史。右侧同组模型使用相同参数规模;柱长分别表示 PPL 和相对 STD 的上下文内存,均越小越好。
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 将共享缓存从推理期压缩转为预训练归纳偏置 | p. 2;Fig. 1 在 p. 1 |
| 2 Looped Transformers | 定义循环、隐藏状态与逐轮缓存 | pp. 2–3;Eq. (1)–(2) |
| 3 Looping with Shared Memory | 共享读出、局部窗口、混合模型及缓存成本 | pp. 3–4;Eq. (3)–(4) |
| 4 Experimental Setup | 基线、训练目标、数据和指标 | pp. 4–5;Table 1 |
| 5 Results | 质量、记忆及循环深度比较 | pp. 5–6;Fig. 2 |
| 6 Why Memory Sharing Helps | 监督目标、窗口、注意力、表示与梯度机制 | pp. 6–9;Fig. 3–8 |
| 7 Related Work | 与跨流、跨层分工及已有循环共享方案的关系 | pp. 8–9 |
| 8 Discussion | 贡献、计算成本和适用范围 | p. 10 |
| A Architecture and Training Details | 配置、归一化、实现及优化 | p. 15;Table 2 |
| B Seed Variance and Statistical Tests | S 规模四种随机种子的统计比较 | pp. 15–16;Table 3–4 |
| C Normalization between Recursions | 更强 LT 归一化对照 | pp. 16–17;Table 5 |
| D Additional Analysis Details | PCA、梯度分解与 detach 实验细节 | pp. 17–20;Eq. (5),Fig. 9–13,Table 6 |
| E Experiments at Nine Recursions | 九轮结果、中间读出和跨规模比较 | pp. 20–23;Table 7,Fig. 14–16 |
| F Decoding Speed and Memory on a GPU | H100 容量、吞吐和单请求延迟 | pp. 24–26;Table 8,Fig. 17 |
一:动机——权重已经共享,为什么记忆还要逐轮增长?
LT 用一个有 $L$ 层的模块重复计算 $R$ 次,其有效深度是 $LR$,参数量却接近一个 $L$ 层模型。问题在于,同一层在不同循环中收到的隐藏状态不同,因而生成的 KV 不同。标准做法保存全部 $R$ 份完整缓存,缓存规模随 $R$ 线性增长。上下文较长或批量较大时,这部分内存可能抵消参数共享带来的优势。
已有推理期缓存复用说明,一轮写出的记忆可能服务于其他轮次。但一个在独立缓存上训练的模型,未必知道怎样写出适合反复读取的首轮记忆。本文的假设是:把共享方式直接写进训练架构,可以让模型学到不同轮次的分工,甚至从中获得质量收益。[Sec. 1–2,pp. 2–3]
这里的共享发生在同一层的不同循环之间。每个注意力层仍有自己的首轮缓存;不同层并未被合并为一个 KV 库。LPT 也保留了完整的串行隐藏状态递推,因此后续计算既接收上一轮的计算结果,也能重新访问首轮建立的记忆。
二:方法——首轮写长期记忆,后续轮次带着短期状态反复读取
2.1 循环骨架与符号
| 符号 | 含义 |
|---|---|
| $L$、$R$ | 共享模块的层数、循环次数 |
| $T$、$d$ | 序列长度、隐藏维度 |
| $h_{\mathrm{in}}^{(t)},h^{(t)}\in\mathbb R^{T\times d}$ | 第 $t$ 轮的输入、输出残差流 |
| $\mathcal M^L$ | 同一组 $L$ 层 Transformer 组成的模块 |
| $\mathcal C^{(t)}$ | 固定某一层后,第 $t$ 轮写入的 KV 缓存 |
| $\omega$ | 后续轮次保留的历史位置数;当前位置另外参与注意力 |
论文的递推为:
$\mathcal N_{\mathrm{rec}}$ 与 $\mathcal N_{\mathrm{out}}$ 是分别参数化的 RMSNorm:前者服务于继续计算,后者服务于词表预测。LPT 沿用这套循环骨架,主要改动在注意力读取哪些 KV。[Sec. 2,p. 3,Eq. (1)]
2.2 共享缓存与局部缓存进入同一个 softmax
标准 LT 在位置 $i$ 的第 $t$ 轮只读取本轮的因果前缀:
LPT 则使用:
[Sec. 2–3,p. 3,Eq. (2)–(3)]
第一轮称为状态轮(state recursion),负责完整的上下文记忆。其余是预测轮(prediction recursions),读取首轮全局缓存,加上本轮最近 $\omega$ 个历史位置和当前位置的 KV。序列边界和文档边界仍受因果掩码限制。
两组 KV 共同归一化。将原式展开成单头的教学表达,令 $K_s,V_s$ 为共享条目,$K_l,V_l$ 为局部条目,则:
$d_h$ 为头维度,分号表示沿条目维拼接;完整注意力还包含原模型的位置编码。两种来源直接竞争同一份概率质量,模型可以随查询改变对长期记忆与局部状态的依赖。相同 token 在两组中的条目具有不同循环标签,并不会因位置相同而去重。
两个边界设置有助于理解:
- $\omega=0$:不保存预测轮的历史,但当前位置自己的 KV 仍参与注意力。因此它也不等于纯共享缓存的交叉注意力。
- $\omega=T$:预测轮保留完整的本轮缓存,结构上相对 LT 额外增加首轮缓存访问。这时可检验质量改善是否必须依赖短窗口,同时也失去了短窗口的缓存节约。
2.3 训练与自回归解码的数据流
训练时,各预测轮沿序列维拼接共享 KV 与本轮 KV,以 FlexAttention 块掩码分别实现共享区的完整因果访问和本地区的滑动窗口访问。全部被屏蔽的块可跳过计算。[Sec. 3,p. 4;App. A,p. 15]
下面是单个新 token 的教学性流程;层索引在这里显式写出:
h = embedding(current_token)
for recursion t = 1 ... R:
    for layer ell = 1 ... L:
        由当前 h 生成 q, k, v
        若 t = 1:
            将当前 KV 加入该层的首轮全局缓存
            对首轮缓存执行因果注意力
        否则:
            读取该层首轮缓存 + 本轮窗口 + 本轮当前 KV
            在上述条目上用一次 softmax 计算注意力
            更新本轮短窗口,最多保留 omega 个历史位置
        完成该层的残差与前馈计算
    若还要继续循环: h = recurrent_norm(h)
由最后一轮的 h 计算下一个 token 的 logits
解码实现可以分别算两组注意力,再用各自的 log-sum-exp 权重合并成与联合 softmax 相同的结果;论文 GPU 实现采用这种方式。它不同于把两个独立归一化的输出直接等权相加。[App. F,p. 24]
2.4 缓存节约的来源与精确口径
按缓存位置数计,省略两组 KV、头维度、批量和数据类型等共同因子:
[Sec. 3,p. 4,Eq. (4)]
从第二轮开始,每增加一次循环,持久缓存只增加 $L\omega$ 个位置,取代 LT 的 $LT$ 个位置;但每轮依然要读取完整的共享前缀。对于普通多头注意力,若要换成字节数,还需乘以 $2B n_h d_h b$,分别对应 K/V、批量、头数、头维度和每元素字节数。这是由原式补充的量纲说明。
以 $T=4096,R=5,\omega=64$ 为例,每层:
| 数量 | 计算 | 结果 |
|---|---|---|
| LT 持久缓存位置数 | $5\times4096$ | 20,480 |
| LPT 持久缓存位置数 | $4096+4\times64$ | 4,352 |
| LPT / LT | $4352/20480$ | 21.25% |
| LT / LPT | $20480/4352$ | 4.706 倍 |
| LPT / 单次 STD | $4352/4096$ | 1.0625 倍 |
| 相对 LT 的额外注意力条目比例 | $4\times64/(5\times4096)$ | 1.25% |
这些计算采用论文的稳态缓存口径:当前 KV 在入缓冲区前参与注意力,$\omega$ 计历史位置。1.25% 衡量注意力条目增量;把投影和前馈等计算一起计入后,论文 Table 1 的总解码 FLOPs 增量不到 1%。共享减少存储副本,并不免除每轮读内存与计算注意力。
2.5 混合版本 H-LPT
基线 LT2 将大多数层替换为门控 DeltaNet(Gated DeltaNet,GDN),按约每五层一个完整注意力层的模式循环。GDN 的递归状态大小不随上下文长度增长,但 LT2 剩下的全注意力层仍逐轮保存完整缓存。
H-LPT 只把这些全注意力层改成 LPT 的共享规则。各个 GDN 层在各轮仍保留自己的递归状态。因此其总上下文内存需要同时计入共享/局部 KV 和所有 GDN 状态,不能直接把 LPT 内存除以五。小模型、有限层数和状态精度也会影响最终比例。[Sec. 3,p. 3;Sec. 4,p. 5;App. F,p. 24]
三:实验——比较的是相同参数预算下如何使用额外计算
3.1 模型与训练配置
| 配置 | S | M | L |
|---|---|---|---|
| 基础参数量 | 151.9M | 454.2M | 1.01B |
| 共享层数 $L$ | 12 | 24 | 36 |
| 隐藏维度 $d$ | 768 | 1,024 | 1,280 |
| 注意力头数 | 12 | 16 | 20 |
| FFN 维度 | 3,072 | 4,096 | 5,120 |
| FineWeb-Edu 训练 token | 20B | 20B | 50B |
[Sec. 4,pp. 4–5;App. A,p. 15,Table 2]
所有模型从头预训练,使用 GPT-2 tokenizer、4,096-token 序列、RMSNorm、SwiGLU、RoPE 和输入输出嵌入权重共享。文档打包时插入结束标记,注意力不跨文档边界,边界 token 不计入语言建模损失。
主比较取 $R=2,3,5$,LPT/H-LPT 默认 $\omega=64$。AdamW 的 $\beta=(0.9,0.95)$,weight decay 为 0.1,梯度裁剪阈值为 1.0,全局批量为 $96\times4096$ tokens,bf16 混合精度。学习率在首 50M tokens 内升至 $6\times10^{-4}$,中段保持不变,最后 10% 训练降至 $6\times10^{-5}$。同一套超参数用于所有模型,未逐模型调优。[App. A,p. 15]
同规模模型的参数和训练 token 数大体匹配,循环更多则训练与推理计算更多。更深更窄的 DeepStd 用于比较不共享权重的深度增加,并非同解码 FLOPs 的更大标准模型。
3.2 基线各自回答什么
| 模型 | 结构与比较角色 |
|---|---|
| STD | 单次标准 Transformer,参数规模和成本归一化参照 |
| LT | 全模块串行循环,每轮完整独立 KV;LPT 的主要对照 |
| LT2 | GDN + 全注意力混合循环;H-LPT 的直接对照 |
| PLT | 共享首轮缓存、门控双注意力与并行循环;检验另一种共享架构 |
| Loopie | 每一层重复后再进入下一层;检验另一种参数复用顺序 |
| DeepStd | 不共享权重、加深并缩窄;匹配有效深度和近似参数量 |
| SPS | 将记忆与预测分到不同残差流;在附录与两轮成本比较 |
PLT 与 LPT 同时在循环连接和注意力融合方式上有差别,因此二者的差距体现整体设计效果,不能单独归因于串行顺序或单个 softmax。[Sec. 4,p. 4;Sec. 7,p. 9;App. A、E,pp. 15、20–21]
3.3 训练目标和评价指标
Final loss 只在最后一轮计算下一个 token 的负对数似然(NLL)。Adaptive loss 按学习得到的逐 token 停止分布加权各轮 NLL,并施加权重 0.1 的 KL 正则。主表的 LT 使用 adaptive loss,其余模型使用 final loss;这一区别与 LT 在作者默认归一化下的训练稳定性有关。Fig. 3 与 App. C 进一步分离监督目标和归一化的影响。[Sec. 4,p. 5;App. A,p. 15]
PPL 在 10M 留出 FineWeb-Edu tokens 上评估,越低越好。PPL 与以自然对数计算的平均 NLL 关系为 $\mathrm{PPL}=\exp(\mathrm{NLL})$:PPL 本身无量纲,NLL 才以 nats/token 计。原文 Introduction 的“PPL 降低 1.09 nats”混用了单位;Table 1 中对应的是 PPL 绝对差 1.09。
准确率是 ARC-Easy、HellaSwag、PIQA、SciQ、LAMBADA 五个零样本任务的平均值,使用 LM Evaluation Harness。准确率差采用百分点。内存和每个生成 token 的 FLOPs 在 4,096 上下文下解析计算,按同规模 STD 归一化;表头虽写 KV,混合模型这一列也包含 GDN 状态。
四:结果——共享影响了质量、分工和训练路径
4.1 全注意力模型:LPT 更能利用增加的循环
下表保留不同规模和深度的 PPL;LT 使用主表 adaptive loss,LPT 使用 final loss。
| 规模 | LT,2/3/5 轮 | LPT,2/3/5 轮 | 五轮 PPL 降低 | 五轮准确率:LT → LPT |
|---|---|---|---|---|
| S | 16.17 / 15.98 / 16.00 | 15.73 / 15.28 / 14.91 | 1.09 | 52.4% → 54.9% |
| M | 13.28 / 13.13 / 13.34 | 12.91 / 12.55 / 12.33 | 1.01 | 57.9% → 61.6% |
| L | 11.20 / 11.11 / 11.39 | 10.75 / 10.45 / 10.32 | 1.07 | 63.4% → 68.2% |
来源:Table 1,p. 4。五轮时 LT 的上下文内存为 STD 的 5 倍,LPT 为约 1.06 倍,几乎相同的解码 FLOPs 下,LPT 同时取得较好的 PPL 与准确率。主表 LT 的 PPL 从三轮到五轮不再改善,LPT 在三种规模都继续降低。
其他基线提供了两个补充信息。五轮 PLT 的 S/M/L PPL 为 15.49/12.65/10.59,高于 LPT 的 14.91/12.33/10.32;虽然两者缓存接近,其预测质量不同。Loopie 和 DeepStd 也未显示同样一致的随深度收益,说明仅仅把网络执行得更深并不足以得到 LPT 的结果。
4.2 混合模型:最显著的是质量与内存组合
| 规模 | STD:PPL / Acc. | 五轮 H-LPT:PPL / Acc. | PPL 降低 | 准确率增加 | H-LPT 内存 / STD |
|---|---|---|---|---|---|
| S | 16.83 / 51.5% | 15.01 / 54.6% | 1.82 | 3.1 pp | 0.21 |
| M | 13.79 / 56.1% | 12.31 / 61.4% | 1.48 | 5.3 pp | 0.21 |
| L | 11.35 / 62.5% | 10.23 / 68.1% | 1.12 | 5.6 pp | 0.24 |
来源:Table 1,p. 4;相对内存数值经过原表四舍五入。五轮 H-LPT 相对五轮 LT2 的 PPL 优势为 0.15/0.12/0.09,准确率优势为 0.9/1.2/0.8 个百分点。质量改善较全注意力配对小,但剩余全注意力缓存得到显著压缩。
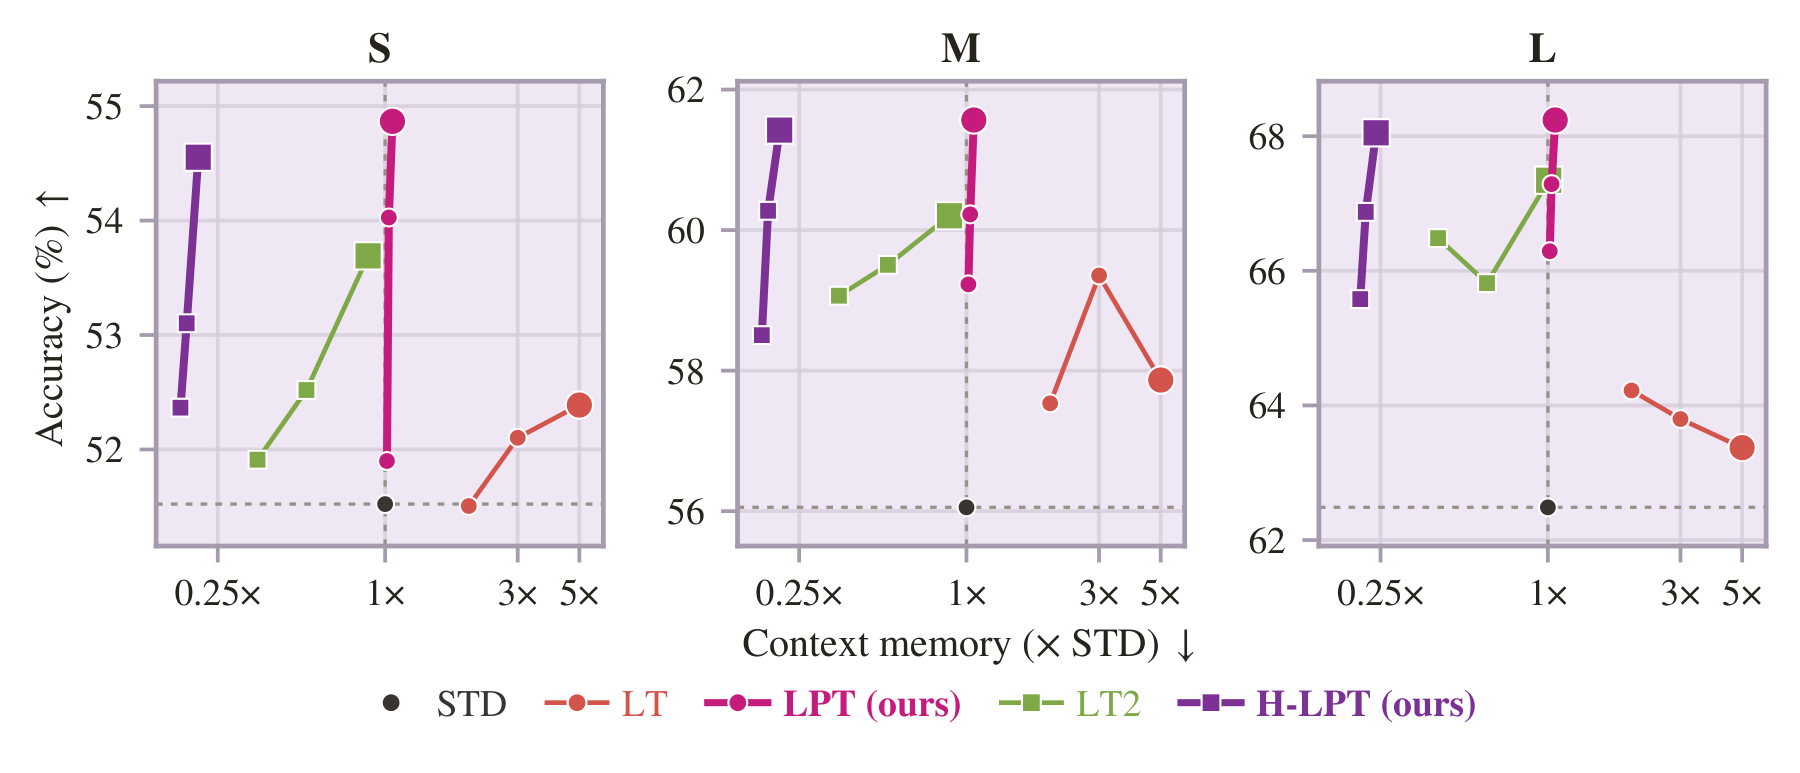
原图 2,p. 5。横轴为相对 STD 的上下文内存,越左越省;纵轴为五任务平均准确率,越高越好。三个面板对应 S/M/L,曲线沿 2、3、5 轮变化,最大标记是五轮。H-LPT 的曲线集中在约 0.2 倍内存区域,而普通 LT 向右移动得很快。
对“质量提升”应分别看指标:H-LPT 的 PPL 在主表各配对中都较好,但两轮 M/L 的准确率分别为 58.5%/65.6%,低于 LT2 的 59.1%/66.5%。因此不能把五轮的双指标优势推广为每个设置下都占优。
4.3 监督方式:共享允许中间轮次专注于继续计算
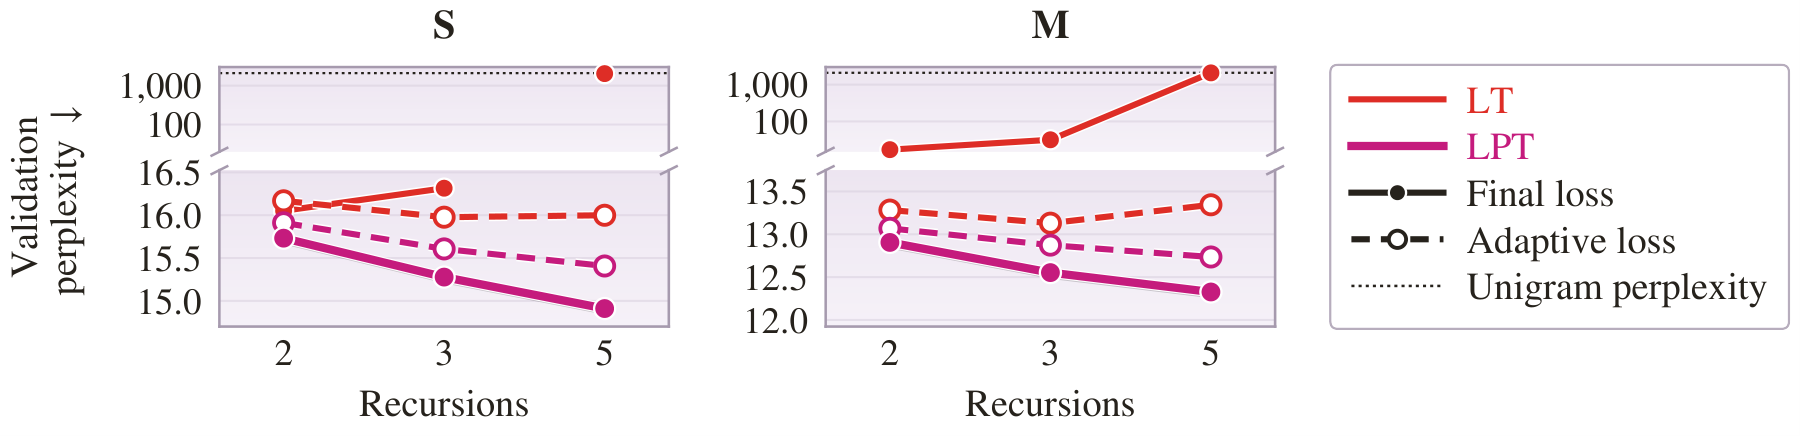
原图 3,p. 7。红色为 LT,品红为 LPT;实心点是 final loss,空心点是 adaptive loss。上方断轴区域以对数尺度展示训练失败的高 PPL,不能与下方线性区域直接按距离比较。
在默认 Ouro 归一化下,final-loss LT 随循环数增加明显变差:S 五轮 PPL 为 2,040,M 五轮为 2,090。LPT 的 final loss 则稳定,且相对自己的 adaptive loss 降低 PPL 约 0.16–0.50。作者解释为,中间轮次无需提前通过同一预测头完成任务,可以形成服务于后续计算的表示。[Sec. 6,p. 6;Table 5,p. 17]
九轮中间读出探针也观察到,final-loss LPT 的中间输出通过最终预测头读取时 PPL 很高,最终一轮明显降低。由于这个头只针对最后一轮训练,探针反映的是与该读出头的适配程度,不能据此认定中间隐藏状态不含预测信息;其 16 条序列上的数值也不同于主验证集结果。[App. E,p. 22]
4.4 窗口消融:收益主要依赖共享访问
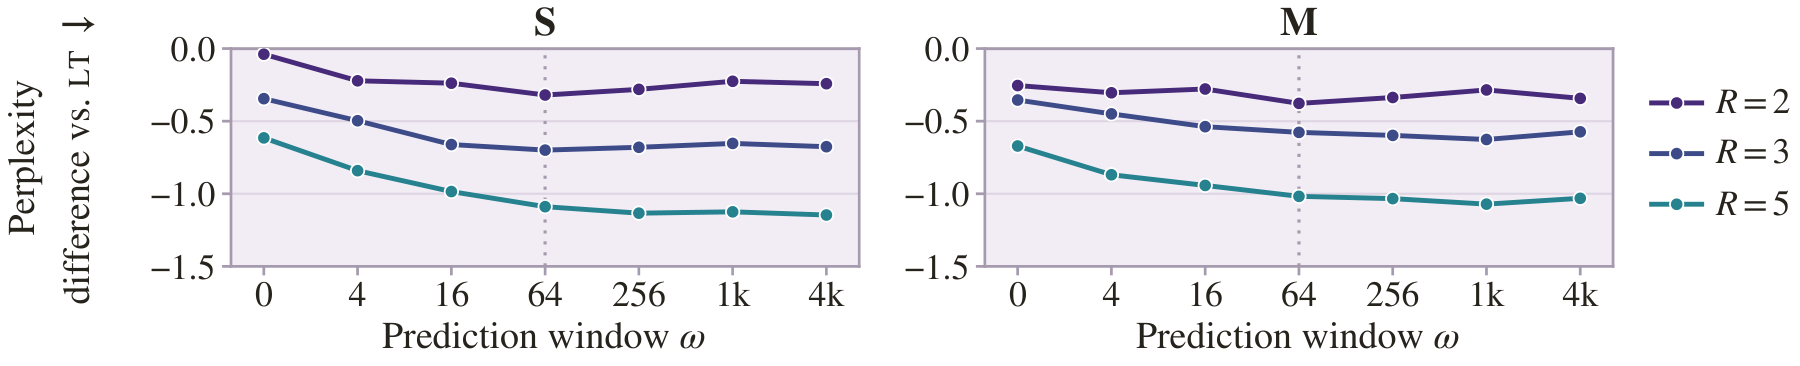
原图 4,p. 7。横轴为 $\omega\in\{0,4,16,64,256,1024,4096\}$,纵轴为 LPT 相对 LT 的 PPL 差,低于零表示 LPT 更好;LT 在每个深度选择两种监督中较好的一个。虚线标出默认窗口 64。
所有窗口大小下,S/M 和所测循环深度的 LPT 都较好。$\omega=0$ 时仍有收益,说明预测轮无需保存很长的本轮历史;扩大到完整缓存后,LPT 仍降低 PPL 0.24–1.15,说明收益并非只能由短窗口约束解释。短窗口是效率选择,共享访问才是关键结构变化。[Sec. 6,p. 6]
这里的主张也有明确边界:$\omega=0$ 仍包含当前本轮 KV,$\omega=T$ 的共享模型会执行更多注意力。该消融用来解释质量来源,不能把所有窗口设置都当成同样省内存的方案。
4.5 前向使用:共享记忆确实被读取,并形成不同表示
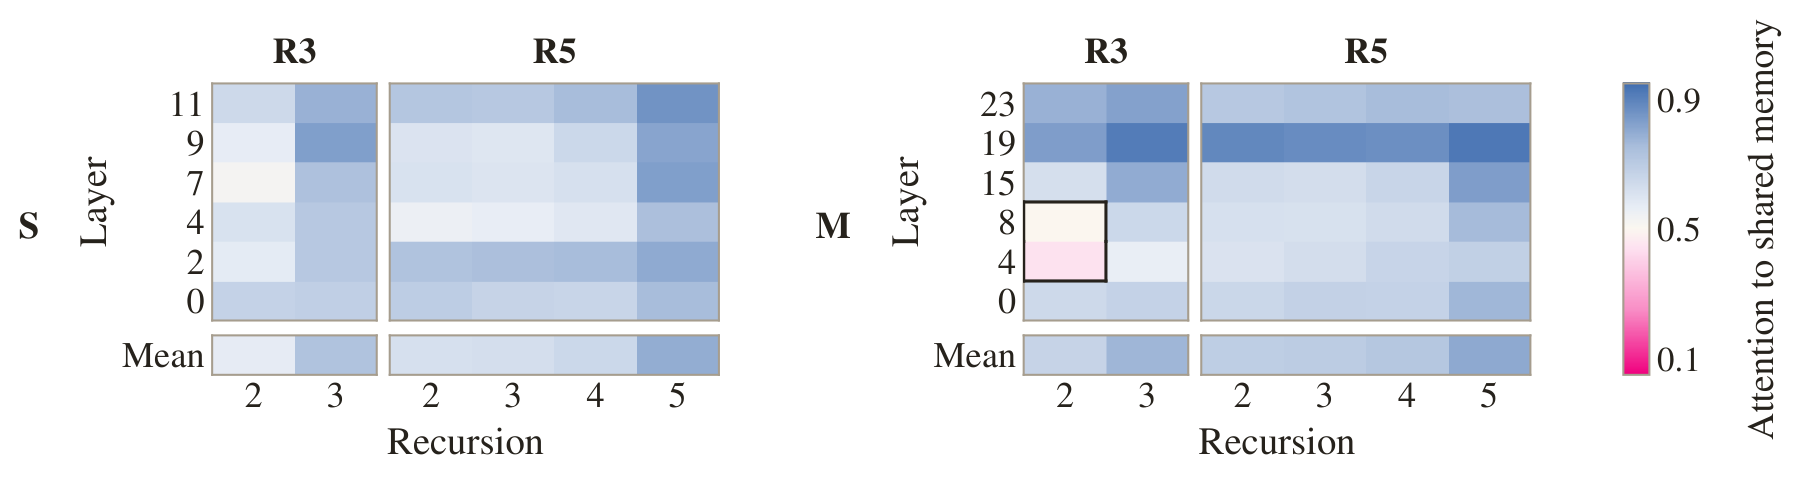
原图 5,p. 8。热图横轴是预测轮次,纵轴是选出的六层,底行是全部层的均值,蓝色越深代表分配给共享 KV 的注意力权重总量越大。对同一条 4,096-token 验证序列,先在查询和头上平均后,较早预测轮的共享占比约为 57%–71%,最后一轮达到 73%–80%。
短窗口下共享侧条目更多,因此仅凭多数注意力落到共享侧还不足以解释偏好。附录 Fig. 11 的完整预测缓存对照总体仍偏向共享侧,但部分层及早期预测轮存在例外;它支持共享记忆有持续作用,而非所有层都同样偏好共享侧。[Sec. 6,pp. 6–7;App. D,p. 19]
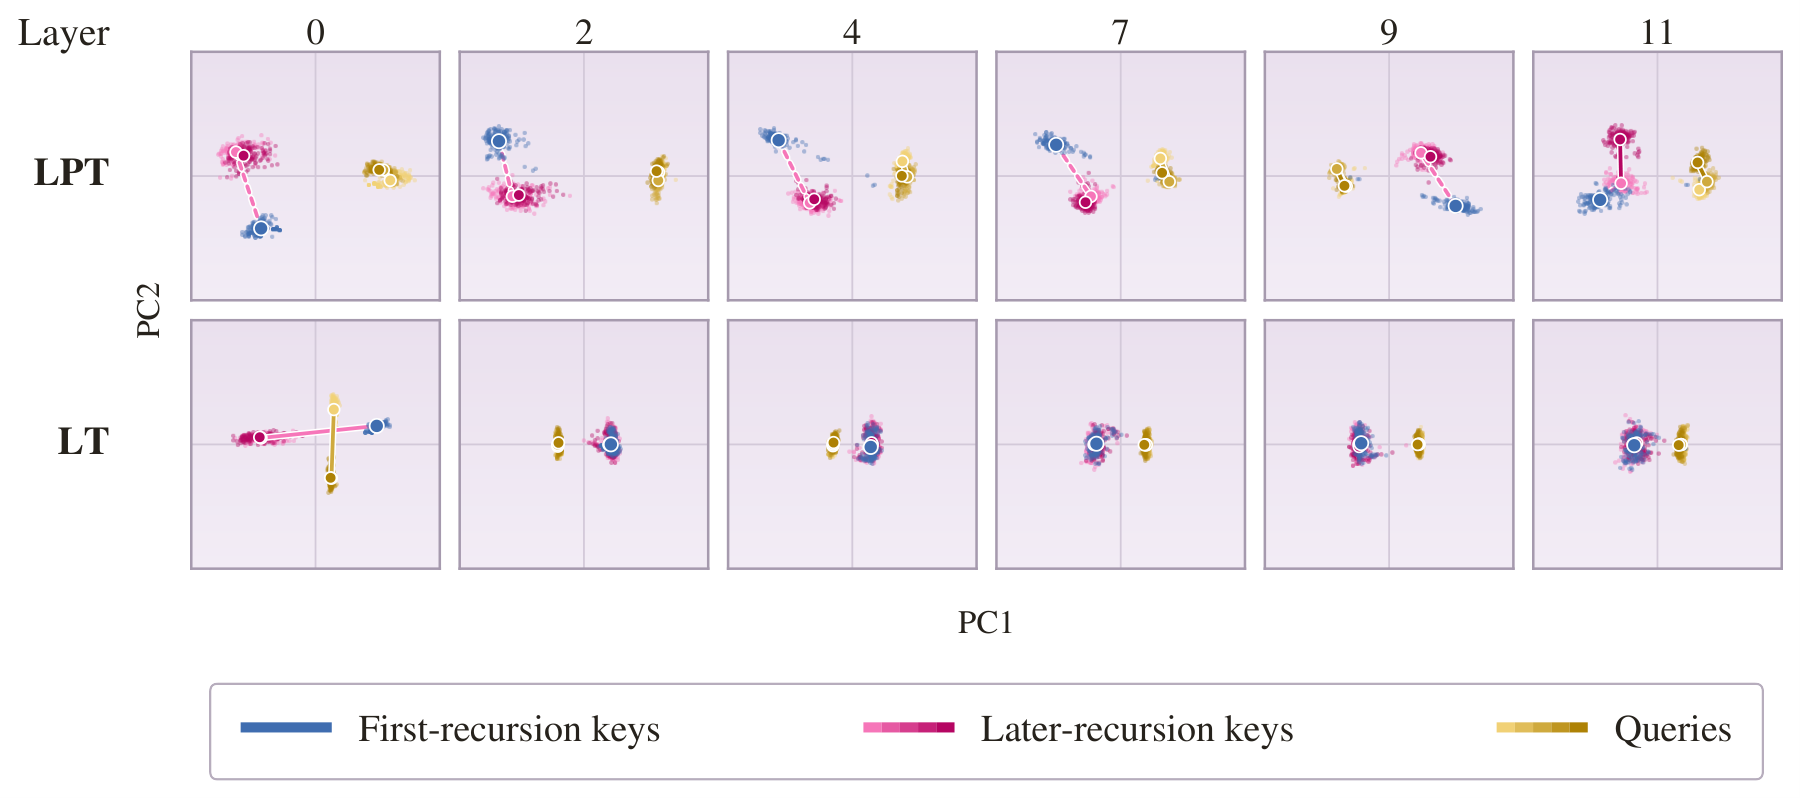
原图 6,p. 8。上排 LPT、下排 LT,六列为不同层;蓝色是首轮 keys,品红是后续轮 keys,黄色是 queries,圆点为 token,较大标记为质心。分析使用 S 三轮模型,两者都用 final loss;取 RoPE 之前的 Q/K,拼接各头,对每个模型和每层分别拟合联合 PCA。
LPT 的共享 keys 与局部 keys 更易区分,LT 各轮 keys 重叠更多;完整预测窗口和其他 S/M 深度下也保留类似现象。它支持“共享记忆与局部记忆承担不同角色”,并说明共享有效不要求各轮写出相似 keys。各面板 PCA 基底独立,图中距离和方向不能跨模型直接当成对齐的语义坐标。[Sec. 6,p. 7;App. D,pp. 17–18]
4.6 反向学习:共享 KV 为首轮提供直接梯度路径
只靠串行残差流时,最终损失对首轮的影响要经过后续循环;LPT 的每次共享 KV 读取还产生一条直接连回首轮存储操作的路径。这是本文最重要的机制解释。
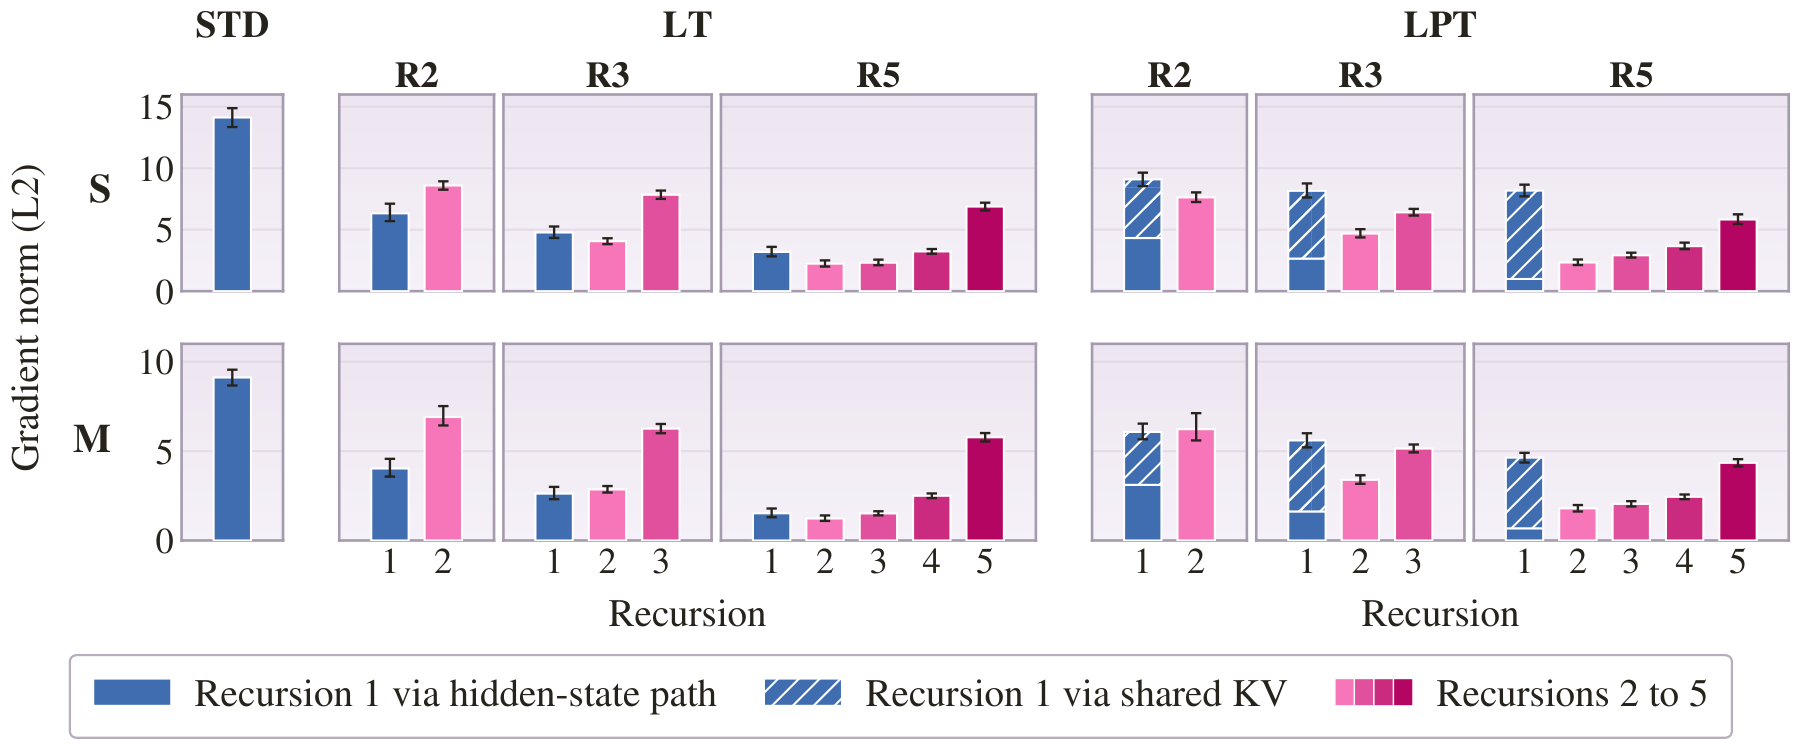
原图 7,p. 9。纵轴为梯度的 L2 范数,横向按 STD、不同深度 LT 与 LPT 分组;S/M 各一行。LPT 首轮柱中的斜线部分是共享 KV 路径在总梯度方向上的投影,蓝色实部为隐藏状态路径,后续轮为品红色。
实验在相同 32 条验证序列上,各选 32 个固定位置计算最后一轮的交叉熵。为了分离同一组参数在不同轮的使用贡献,反向计算时给各轮分配值相同但独立的参数副本;前向数值不变,各轮梯度相加恢复共享参数梯度。测量仅涉及 Transformer block 权重,排除嵌入、读出、循环归一化和停止门。
对首轮,通过在后续读取处 detach 共享 KV 得到 $g_{\mathrm{hidden}}$,再用
得到另一条路径的贡献。范数不可直接相加,所以原图按下式堆叠:
[App. D,pp. 17–19,Eq. (5) 在 p. 18]
LT 首轮梯度随深度明显衰减;LPT 保留更多信号,五轮时共享路径贡献占主要部分。误差条是 32 条序列 bootstrap 的 95% 区间,表示探针样本变化,不是重新训练种子间的变化。完整窗口和 adaptive-loss LPT 也有类似路径贡献。
作者进一步从头训练阻断共享读取梯度的 LPT,保持前向读取和隐藏状态路径不变:
| 规模、模型(全部 final loss) | 两轮 PPL | 三轮 PPL | 五轮 PPL |
|---|---|---|---|
| S,LT | 16.05 | 16.32 | 2,040 |
| S,LPT detach 共享 KV | 16.34 | 16.14 | 33.21 |
| S,完整 LPT | 15.73 | 15.28 | 14.91 |
| M,LT | 17.10 | 31.74 | 2,090 |
| M,LPT detach 共享 KV | 13.87 | 1,995 | 1,527 |
| M,完整 LPT | 12.91 | 12.55 | 12.33 |
来源:Table 6,p. 20;Fig. 8,p. 9。每个设置下阻断路径都使 PPL 变差,M 的深循环甚至训练失败。首轮仍通过隐藏状态路径和共享权重接受更新;实验移除的是特定直接路径。这比单纯观察注意力或梯度更有力地支持共享梯度对学习有帮助,但没有继续分离路径变短、梯度尺度和方向改变各自的作用。
附录还发现,共享/隐藏路径的梯度范数比在新随机初始化时就随循环数增长,训练后通常更大。更多循环本身增加共享读取次数,因此“比例变大”不应单独作为学到有效分工的证据;detach 实验是更关键的补充。[Fig. 13,p. 20]
4.7 更强的归一化对照与种子重复
默认 Ouro LT 的不稳定性并不代表所有 LT 都有同样问题。作者额外测试 pre-norm only、sandwich only、input norm、update norm、KEEL 五种方案;完成的替代方案都能使用 final loss 训练。对每个设置选最佳 LT 后,LPT 仍较好,但优势缩小:
| 规模 | 最佳 LT:2/3/5 轮 PPL | LPT:2/3/5 轮 PPL | 按表内数值计算的差值 |
|---|---|---|---|
| S | 16.04 / 15.65 / 15.24 | 15.73 / 15.28 / 14.91 | 0.31 / 0.37 / 0.33 |
| M | 12.96 / 12.75 / 12.76 | 12.91 / 12.55 / 12.33 | 0.05 / 0.20 / 0.43 |
来源:Table 5,p. 17。M 两轮差值按显示值为 0.05,原文叙述写约 0.06,可能涉及未显示的小数;如此小的差距需要结合种子变化理解。另一个细节是 M 最佳 LT 从三轮的 12.75 到五轮 12.76,基本持平。学习率和 warmup 没有围绕这些训练稳定性问题进一步调优。由此应将“LPT 在作者设置下更稳”与“所有普通 LT 都需要中间监督”区分开。
S 规模所有主表模型有四个种子,初始化和数据顺序一起变化,跨种子最大 PPL 标准差约 0.08。LPT 对 LT 的配对平均 PPL 差为 −0.40/−0.71/−1.05,单侧配对 t 检验的 $p$ 值均小于 $10^{-4}$;H-LPT 对 LT2 的对应 $p$ 值也小于 0.01。LPT 对 PLT 的两轮比较弱一些,$p=0.048$。这些统计针对 S 的 PPL,M/L 主表和下游准确率没有同等重复范围。[App. B,pp. 15–16,Table 3–4]
4.8 九轮:纯注意力版本的深度收益出现边界
| 规模 | LPT:PPL,5 → 9 轮 | LPT:Acc.,5 → 9 轮 | H-LPT:PPL,5 → 9 轮 | H-LPT:Acc.,5 → 9 轮 |
|---|---|---|---|---|
| S | 14.91 → 14.80 | 54.9% → 55.6% | 15.01 → 14.74 | 54.6% → 55.0% |
| M | 12.33 → 12.39 | 61.6% → 61.8% | 12.31 → 12.14 | 61.4% → 61.6% |
| L | 10.32 → 10.87 | 68.2% → 66.5% | 10.23 → 10.11 | 68.1% → 68.7% |
来源:App. E,pp. 20–23,Table 7 在 p. 21。五轮到九轮,LPT 只有 S 的 PPL 继续改善,L 规模两项指标都回落;H-LPT 的三种规模则继续改善。此时 LPT 的内存仍仅约为 STD 的 1.12 倍,但解码 FLOPs 已升到约 7.68–8.66 倍。记忆增长受控,不意味着反复执行始终有效。
SPS 在两轮相近内存与 FLOPs 的条件下,S/M/L 的 PPL 为 16.18/12.99/10.77;LPT 是 15.73/12.91/10.75。这个补充对照把跨流分工与跨循环分工联系起来,但后两种规模的差距较小。[Table 7,p. 21]
4.9 GPU:更大的批量改善峰值吞吐,延迟仍由循环计算决定
测试使用单张 H100 80GB、bf16、4,096 上下文和统一 PyTorch/FlexAttention/CUDA Graph 解码实现。各模型选择可容纳的最大批量,必要时用其 95% 以装入 CUDA graph;延迟另外在 batch=1 下测量。测试使用随机权重,反映该实现的结构开销。[App. F,p. 24]
以下选取 1B 规模以同时观察容量和延迟:
| 模型 | 循环 | 最大批量 | 吞吐 token/s | 单请求每步延迟 ms |
|---|---|---|---|---|
| STD | 1 | 108 | 3,162 | 6.7 |
| LT | 5 | 21 | 303 | 37.9 |
| LPT | 5 | 101 | 578 | 42.3 |
| LT2 | 5 | 103 | 1,776 | 21.7 |
| H-LPT | 5 | 390 | 2,553 | 22.6 |
| H-LPT | 3 | 444 | 4,333 | 13.6 |
来源:Table 8,p. 25。五轮 LPT 相对 LT 可容纳约 4.81 倍序列、峰值吞吐提高约 90.8%,而 batch=1 的延迟升高约 11.6%。这几个指标并不冲突:容量优势让更多请求并行,但单条请求仍要经过所有循环。按相同批量比较,论文报告 LPT 比 LT 慢约 3%–8%,H-LPT 比 LT2 慢约 2%–3%。
H-LPT 的三轮方案在三种规模下达到 STD 约 1.4–1.5 倍峰值吞吐,PPL 同时降低 0.94–1.44;五轮继续提高质量,但峰值吞吐为 STD 的约 81%–88%。混合模型实测上下文内存为 STD 的约 20%–27%,高于解析的 18%–24% 范围,因为实现以 fp32 保存 GDN 状态,还计入短卷积窗口。它们都是上下文状态口径,不等于总 GPU 内存节约相同比例。[App. F,pp. 24–26]
五:结论与研究启发
本文最有价值的贡献,是把循环中的记忆构建和预测细化组织成一种可学习的分工。一个缓存被多轮读取后,不仅服务于更多前向查询,也从这些读取处接收训练信号。窗口消融、表示分析、梯度探针和从头训练的 detach 对照共同支撑这一解释,其中 detach 对学习作用的证据最直接。
在已有研究的坐标中,SPS 把记忆和预测分到残差流,YOCO 等方法分到不同层,LPT 则把这种分工放到循环轮次中,仍复用相同层参数。与最接近的 PLT 相比,它保留串行递推,并用联合 softmax 融合共享与局部记忆。这里是按本文 Sec. 7 对设计位置的归纳,并非这些其他论文的新实验比较。
实际选择取决于瓶颈。 若参数存储和上下文状态容量受限,并允许更多每请求计算,LPT/H-LPT 的质量—记忆组合有吸引力。若目标是低 batch 的延迟,表 8 中循环成本仍十分明显;若关心高并发吞吐,混合版本在三轮时显示出更好的组合。
本文证据范围为单一预训练语料、最多 1B 参数、4,096 上下文;未提供同解码 FLOPs 的更大标准模型对照,也未测试长上下文任务。参数匹配回答的是固定模型容量如何利用额外计算,尚未回答给定总计算预算应选择多大模型。九轮 LPT 的退化及归一化对照进一步说明,缓存结构、优化方式和有效深度需要一起设计。[Sec. 8,p. 10;App. C、E、F]
本次分析认为,后续最有信息量的实验是:在相同计算预算下加入更大 STD 对照;将共享梯度的方向与尺度分开干预;以及在扩展上下文后检验首轮记忆能否支持需要多步加工的远程检索。它们分别检验资源配置、机制因果性和记忆表示能力。论文提出的逐 token 自适应循环、多个状态轮及状态/预测交替,也值得与这些实验结合。