Clock Diffusion:中文精读笔记
论文:Clock Diffusion: Efficient Semi-Autoregressive Continuous Diffusion Language Models
作者:Yair Schiff、Omer Belhasin、Roy Uziel、Matan Rusanovsky、Ran Zilberstein、Marianne Arriola、Gilad Turok、Guanghan Wang、Volodymyr Kuleshov、Michael Elad(NVIDIA / Cornell University)
版本:arXiv:2610.00894v1,2026-10-01 提交;获取与研读日期:2026-10-19。
原文:arXiv · 本地 PDF
配套:英文幻灯片 PDF · 可编辑 TeX。以下页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
论文总览
Clock Diffusion 把连续扩散语言模型的生成过程改造成一条从左向右推进的去噪流水线:不同 token 使用错开的局部时钟,左侧 token 先结束去噪、确定离散取值并写入 KV cache,右侧 token 则继续共同去噪。由此,连续扩散获得变长生成和可复用的前缀缓存。框架同时包含概率模型、训练注意力掩码、似然界和采样算法;其滑窗高斯实例叫 ClockDLM,分块实例叫 B-ClockDLM。
最有说服力的三组结果是:
| 问题 | 关键结果 | 应如何理解 |
|---|---|---|
| 连续扩散的语言建模能力 | OWT 上 ClockDLM,$S=4$,PPL 上界 19.5;BD3LM 同块宽为 20.7,RePlaid 为 21.3,AR 为 17.5 | 在表 1 比较的扩散模型中最好,仍有与 AR 的差距 |
| 能否减少数学代码生成的调用次数 | GSM8K 上 $S=32$,标准 ClockDLM 为 59.6% / 188.1 NFE,Confidence 为 60.0% / 59.5 NFE | 同一类扩散模型可通过推理规则减少约 3.16 倍调用次数 |
| 联合训练与自推测解码能达到什么水平 | Cache Grab-SSD 为 67.6% / 35.5 NFE,AR baseline 为 64.3% / 158.4 NFE | SSD 使用加入 AR 损失单独重训的模型;提升包含训练与解码两方面 |
来源:表 1、2,PDF p. 7;附录 F、G.3,pp. 28、33。NFE 是模型前向调用次数;这些倍率不是实测延迟倍率。
这篇论文的重要启发是:局部噪声进度决定哪些状态还会变化,注意力依赖决定哪些状态可以永久缓存,两者必须一起设计。 滑窗并不自动带来高并行吞吐;在每 token 去噪预算 $N=S$ 时,标准滑窗进入稳定阶段后每次调用仅完成一个 token,显著减少调用次数还需要更小的 $N$ 或 Cache Grab。
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction;2 Background | 连续/离散扩散、SAR 的动机和高斯扩散基础 | pp. 2–3 |
| 3.1 Parameterization | 局部时钟、活跃/冻结状态、生成联合分布与变分界 | pp. 3–4;式 (2)–(10) |
| 3.2 Key-Value Cache Sampling;3.3 Efficient Training | 采样流程与 $2L$ 训练布局 | pp. 4–5;算法 1、图 2 |
| 3.4 Special Cases of Clock Diffusion;3.5 Clock Diffusion Language Models | 全序列、分块、滑窗与高斯嵌入实例 | pp. 5–6;式 (11) |
| 3.6 Cache Grab Samplers: Accelerated Inference for ClockDLMs | Confidence 与 SSD | p. 6;图 3 |
| 4.1 Likelihood Evaluation;4.2 Mathematical Reasoning | OWT 与 TinyGSM → GSM8K | pp. 7–8;表 1、2,图 4、5 |
| 4.3 Summarization;4.4 Ablations | CNN/DailyMail 与窗口、阈值消融 | pp. 8–9;表 3、图 6 |
| 5 Related Work;6 Discussion & Conclusion | 与位置噪声调度工作的关系及局限 | p. 9 |
| A Clock Diffusion Variational Bound | 联合分布分解、冻结项 KL 消失 | pp. 17–18 |
| B Clock Diffusion Language Models | 高斯损失、连续时间极限、RePlaid 组件、分块/滑窗推导 | pp. 18–23 |
| C Additional Training & Evaluation Details for Clock Diffusion Language Models | 随机时钟训练、代理重建项、无偏验证估计 | pp. 23–25 |
| D Additional Clock Diffusion Sampling Details;E Cache Grab Sampler Algorithms | 预算、缓存融合、两类提前提交算法 | pp. 25–28;图 7、算法 4、5 |
| F Additional Experimental Setup Details | 各任务架构、训练和评估设置 | pp. 28–32;表 4–6 |
| G Additional Experimental Results | MAUVE、完整阈值消融、联合训练、生成示例 | pp. 31–38;图 8、表 7–8 |
| H Assets | 数据、模型组件和软件来源 | p. 39 |
一:动机——连续扩散为什么需要新的生成组织方式
全序列连续扩散把整段文本嵌入为连续向量,再反复去噪。它能同时考虑多个位置,却难以像 AR 那样逐步确定可缓存的前缀:如果前缀的隐藏状态仍依赖后续正在变化的噪声,旧 KV 就不能原样复用。论文比较的全序列模型还受到固定输出画布的限制,不能充分利用生成 EOS 后的提前停止。(Sec. 1–2,pp. 2–3;附录 F.2,p. 30)
分块半自回归扩散已经在离散空间展示了方向:块之间从左向右生成,块内部双向去噪。然而,必须等整个块完成才能缓存。作者希望把“同时完成一整块”放宽为“不同位置先后完成”,使缓存更及时更新,也为按置信度提前提交前缀创造条件。
位置相关噪声本身已有 AR-Diffusion、Diffusion Forcing、Rolling Diffusion 等先例。本文把这种机制用于离散文本的连续表示,并配套推导语言模型的似然界、向量化训练和 KV cache 采样。其增量贡献应从这一整套机制理解。(Sec. 5,p. 9)
二:方法——时钟、依赖和提交规则如何配合
2.1 输入、输出与核心符号
模型输入是已完成的离散前缀、当前活跃窗口的连续噪声向量以及各位置的局部噪声时间;输出是活跃位置上的词表分布。该分布一方面提供下一次高斯反向更新的干净嵌入估计,另一方面在提交时转为离散 token。
| 符号 | 含义 |
|---|---|
| $L,V,d$ | 序列长度、词表大小、扩散嵌入维度;实验中 $d=16$ |
| $\mathbf x^\ell\in\{0,1\}^V$ | 位置 $\ell$ 的 one-hot token |
| $E\in\mathbb R^{V\times d}$ | 可学习嵌入矩阵,各行单位 $L_2$ 范数 |
| $\mathbf e^\ell=E^\top\mathbf x^\ell$ | 干净 token 嵌入 |
| $\mathbf z_t^\ell\in\mathbb R^d$ | 全局时间 $t$ 下的位置状态 |
| $u^\ell(t)$ | 该位置自己的局部扩散时间;生成时从 1 降到 0 |
| $\varphi(\ell),r$ | 时钟相位和全局时间的缩放系数 |
| $\mathcal A_{s\mid t},\mathcal C_t$ | 从 $t$ 到 $s |
| $S,N,T$ | 最大活跃窗口宽、每 token 去噪预算、标准采样总步数 |
局部时间 $u=0$ 表示到达调度的低噪声端点;有限的 $\gamma_0$ 不要求噪声方差严格为零。缓存中存储的是提交后离散 token 的干净前向状态,而不是保留一个低噪声 latent 充当 KV。(附录 B.2、B.4、D,pp. 18–21、26)
2.2 用局部时钟规定谁在这一步发生变化
在全局正向加噪时间 $t\in[0,1]$ 上,每个局部时钟单调不减,满足 $u^\ell(0)=0$、$u^\ell(1)=1$。作者主要研究
生成沿 $t:1\to0$ 运行。相位越大的位置越早开始、越早结束去噪,每个位置活跃的全局时间宽度都是 $1/r$。(式 (9),p. 4)
若某一步局部时间没有变化,作者将该位置的正向与反向转移都设为恒等转移:
因此可以把一轮更新分成
在这里的截断相位时钟中,冻结位置是尚未开始的纯噪声位置或已经完成的位置。它们不需要重新去噪。反向生成只预测活跃部分,条件是当前活跃 latent 和已提交的离散前缀;新完成的位置再通过分类分布读出 token。(式 (2)–(8),pp. 3–4)
2.3 全序列、分块与滑窗是三种相位选择
全序列:$\varphi(\ell)=0$,则所有位置都按 $u^\ell(t)=t$ 同步去噪。
分块:令 $B=L/S$,$b(\ell)=1+\lfloor(\ell-1)/S\rfloor$,取
同块时钟相同,相邻块没有去噪重叠。每完成一块再开始下一块。这恢复了“块间 AR、块内扩散”的分解,只是本文在 token embedding 上使用高斯噪声。(附录 B.5,pp. 21–22,式 (33)–(38))
滑窗:取
相邻位置局部时钟相差 $1/S$,至多 $S$ 个位置处于活跃区间。位置 $\ell$ 在
完成,此时后方活跃位置 $j$ 的时间为 $u^j(\tau_\ell)=(j-\ell)/S$。例如 $S=4$,一个 token 完成时,相关窗口的局部时间阶梯为 $[0,1/4,1/2,3/4]$;左端可提交,右侧仍提供部分去噪的上下文。(式 (11),p. 5;式 (41)–(44),pp. 22–23)
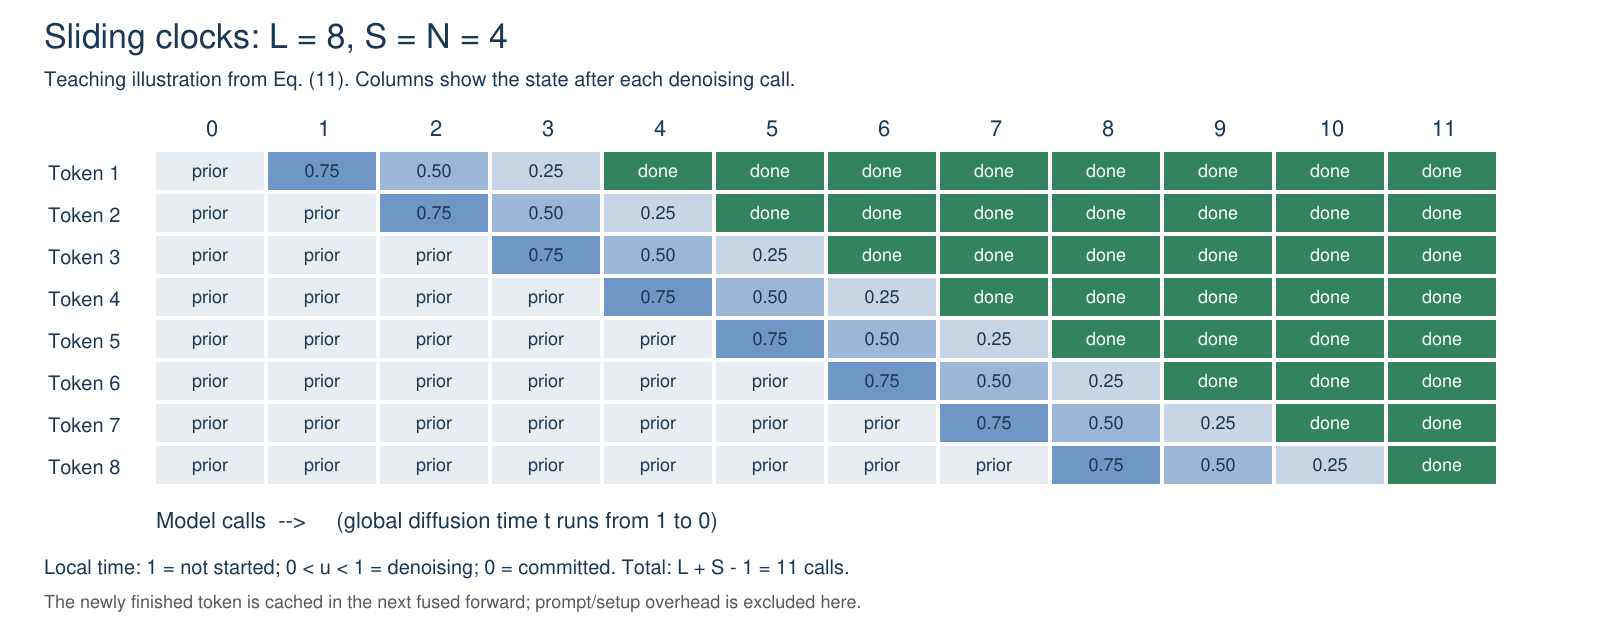
教学示意,并非原论文实验图:按式 (11) 计算。横轴是已完成的模型调用数,纵轴是 token 位置;数字是局部时间,绿色表示已提交,灰色表示尚未开始。$L=8,S=N=4$ 时共有 11 次去噪调用。第一项用 4 步完成,其后每步再完成一项;新完成 token 的实际缓存写入与下一次前向融合。
2.4 能缓存的前缀必须在提交后保持依赖不变
将 token 固定下来还不够。如果它的隐藏状态在计算时读取了右侧未完成 token,后者变化后,缓存仍然失效。因此,滑窗的干净 token 路径使用逐 token 因果注意力;分块版本允许同一个已完成块内部双向注意力。
训练把同一序列排成长度 $2L$ 的布局:前半段为干净 token,后半段为噪声 token。注意力掩码为
| 依赖方向 | 分块模型 | 滑窗模型 | 作用 |
|---|---|---|---|
| 干净 → 干净 | block causal | token causal | 缓存仅依赖提交时已知的信息 |
| 干净 → 噪声 | 禁止 | 禁止 | 避免把动态状态写进永久缓存 |
| 噪声 → 干净 | 可读本组之前的前缀 | 同左 | 提供已完成条件,遮住本组真值 |
| 噪声 → 噪声 | 同一组双向 | 同左 | 在当前去噪组内并行推断 |
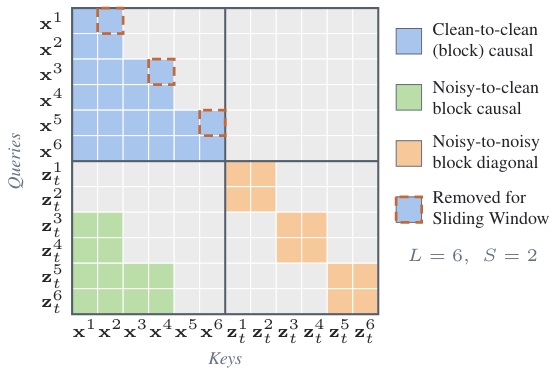
原图 2,PDF p. 5。行是 query,列是 key;蓝、绿、橙分别表示上述 CC、NC、NN 路径。虚线框标出了从分块掩码转为滑窗掩码时要移除的连接。训练组彼此不重叠,每组模拟一次活跃窗口;这使多个条件前缀下的损失可在一次批量前向中计算。
推理时还要避免每提交一个 token 就额外做一次完整缓存前向。作者将“新提交的干净 token”和“下一轮活跃噪声 token”拼接,同一次前向既写缓存又去噪;新提交 token 不能读取噪声 token,所以写出的 KV 与单独执行干净缓存前向一致。
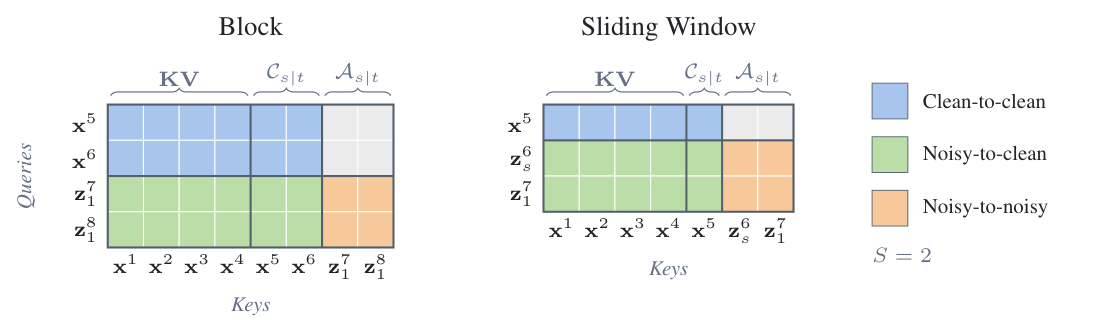
原图 7,PDF p. 26。左为分块,右为滑窗;列含已有 KV、新提交 token 和活跃 token,行只含这次需要计算的新 token。干净行右侧的灰色格正是缓存可复用的关键。
2.5 高斯扩散实例:网络预测 token 分布,反向过程更新嵌入
每个位置的正向噪声分布为
网络输出词表概率 $\mathbf x_\theta^\ell\in\Delta^V$,由此得到
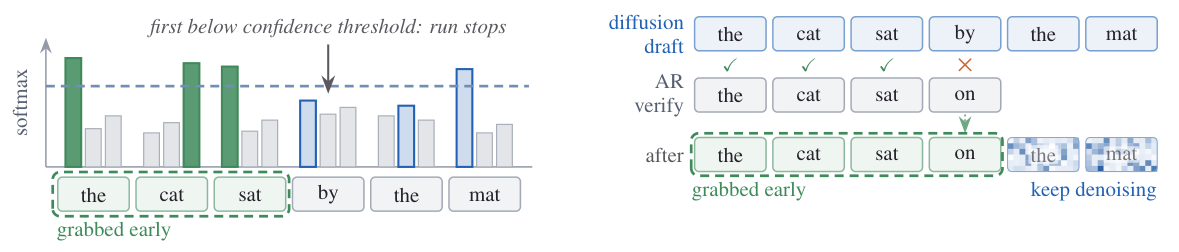
这一般是多个 token embedding 的加权平均。因各行嵌入归一化,$\|\mathbf e^\ell\|_2=1$,而 $\|\mathbf e_\theta^\ell\|_2\le1$。令 $a=u^\ell(s) 后验协方差为 $(\sigma_{b\mid a}^2\sigma_a^2/\sigma_b^2)I_d$。学习的反向更新用预测嵌入替代真实嵌入。上式只是将原文高斯后验的时间换成局部时间,未改变转移形式。(Sec. 2,p. 3;附录 B.1–B.2,pp. 18–19,式 (22)) 实验还沿用并调整 RePlaid 的训练设计: 来源:附录 B.4,pp. 19–21,式 (28)–(32)。解析 prior 没有一同经过上述 soft-cap。数学与摘要实验的 DDPM 更新使用 top-1 token 的嵌入,自条件也采用前一步 top-1;因此应区分训练/似然估计中的后验均值参数化和任务采样时的 top-1 策略。(附录 F.2–F.3,pp. 30–31) 对潜变量轨迹应用 Jensen 不等式,并利用生成联合分布的分解,可得 三项分别约束:终端分布接近标准高斯;位置完成时能正确读出 token;活跃位置的学习反向转移接近真实后验。冻结位置在两种转移中都是同一个 Dirac 分布,其 KL 为零,所以它们从扩散损失中消失。(式 (10)、附录 A,pp. 4、17–18) 对共享后验协方差的高斯转移,单位置扩散 KL 化为 生成从较大噪声走向较小噪声,括号非负。连续时间极限为 $\mathcal A_{t^+}$ 是从稍大时间到达 $t$ 时的活跃集合。时钟绝对连续、基础 SNR 调度连续可微时,上式几乎处处成立。时钟导数不是任意权重:将每个位置从全局时间换到局部时间,$du=\dot u^\ell(t)dt$,该因子恰好抵消变量替换的尺度。(式 (23)、(27)、(47)–(48),pp. 19、23) 滑窗重建项也不同于“把全序列一起去噪到零再分类”。位置 $\ell$ 完成时,其目标是 此时后方位置的噪声仍呈 $1/S,2/S,\ldots$ 阶梯。对所有位置和相应噪声取期望再求和,才是理论上的滑窗重建项。(式 (44),p. 23) 这是主文“优化变分目标”需要结合附录理解的部分。 训练扩散项:每个位置独立抽取 $U[0,1]$ 时间,再在宽 $S$ 的组内升序排列。组内左侧更干净,但间隔不再固定为 $1/S$。作者这样做,是为了覆盖 Cache Grab 每次提交不同数量 token 后形成的不规则时钟间隔。不能把算法 3 的随机排序直接称为固定滑窗轨迹的无偏采样。(附录 C.2,p. 24) 训练重建项:所有位置同时放在 $u=0$,用相同的 $2L$ 布局和滑窗掩码计算交叉熵。这比真实提交时拥有更干净的后方上下文;作者明确将其作为便宜的训练代理,而非滑窗重建损失的有效界。(附录 C.2,p. 24) 验证重建项:均匀抽取组偏移 $\rho\in\{0,\ldots,S-1\}$,相应平移注意力掩码。组内位置偏移记为 $j(\ell)=(\ell-\rho)\bmod S$,设置 每个位置以 $1/S$ 的概率成为组头,乘 $S$ 正好补偿抽样;组头的噪声模式也与真实完成时刻一致。序列两端只保留合法位置。(式 (50)–(51),p. 25) 验证扩散项:另生成噪声,每组再抽一个 $U\sim U[0,1]$,设置 $u^\ell=(j(\ell)+U)/S$。组内保持 $1/S$ 间隔,随机偏移又使各 token 的边际局部时间均匀覆盖 $[0,1]$。两个损失分别使用一次自条件 bootstrap 和一次计分前向,所以每批共四次前向。(式 (52),p. 25) 这样,论文报告的扩散 PPL 来自负对数似然的变分上界,即对每 token NELBO 取指数;等价地,真实 PPL 不高于该理论界。有限 Monte Carlo 估计还包含采样误差。AR 行是通常的 PPL,不能把两类数值都解释成精确似然,也不能把训练代理本身当作验证界。 对齐时间网格下,每次调用使活跃位置的局部时钟前进 $1/N$,因而 分块每 $N$ 步同时提交 $S$ 个 token;滑窗均摊每 $N/S$ 步提交一个 token。$N=S$ 时,滑窗的总去噪调用数是 $L+S-1$,包含流水线启动和收尾成本。若 $N 这些是固定生成长度下的去噪预算公式。实验 NFE 另计 prompt ingestion、必要缓存与读出、SSD 验证,并按 EOS 停止,因此不能把上述 $T$ 直接替换成表格中的平均 NFE。 原图 3,PDF p. 6。左图中,越过虚线阈值的位置只有构成最左连续段时才能提交;右图接受一致草稿,并在首次不一致处加入 AR 修正 token,后续位置保留噪声状态。 Cache Grab-Confidence 用年龄 $k^\ell$ 记录位置已获得多少次去噪,局部时间为 $u^\ell=1-k^\ell/N$。位置满足以下任一条件即可候选提交:预算用完,或最大词表概率达到阈值 $\eta<1$。真正提交的是从窗口左端开始的最长连续候选段。 例如概率为 $[0.98,0.96,0.70,0.99]$、阈值为 $0.95$,且各位置预算尚未用完,只提交前两个位置;第四个位置需等待第三个。剩余位置保留 latent、年龄和去噪进度,右侧补入新噪声。$\eta=1$ 关闭置信度测试。B-ClockDLM 的规则更严格:整个块所有待生成位置都过阈值才能提前提交,否则继续至预算耗尽。(教学例子;算法 4–5、附录 E.1,pp. 26–27) Cache Grab-SSD 则让同一模型兼任扩散草稿器和 AR 验证器。必须先在干净半段加入 AR 预测损失,AR head 与扩散输出层共享权重,AR 损失权重为 1.0。每轮两次前向: 与 Confidence 不同,SSD 中时钟到零不会强制提交,该位置必须通过验证或成为 AR 修正。在论文这种 top-1 草稿/验证规则下,输出保持与同一个联合训练模型的 AR 解码一致;这里不是指与单独训练的 AR baseline 一致。因此,SSD 超过 baseline 的准确率并不矛盾,也不能全部归因于“加速解码令答案更准”。(附录 E.2、F,pp. 27–28;表 5,p. 31) 来源:附录 F.1–F.3、表 4–6,pp. 28–32。SmolLM、Qwen3 的名称在这里对应 tokenizer 或架构来源,不能据此将实验模型当作这些已预训练模型。OWT 训练使用 64 张 H100-80GB;数学和摘要使用 32 张。各任务采用 AdamW、梯度裁剪 1.0 和 EMA 0.9999。 数学实验把 prompt 作为干净条件,只对代码续写扩散;超长样本过滤,短样本右填充,扩散损失包含 padding。摘要实验则只监督目标区域,padding 同时从损失和注意力中排除。摘要文章和目标分别截断为 512、180 token,生成最少 50 个非 EOS token,另有长度和重复惩罚。这些任务设置不能混用。(pp. 30–32) RePlaid 是最直接的对照:它同样在可学习 token embedding 上进行高斯扩散,但使用全序列生成。B-ClockDLM 用于隔离分块与滑窗的差异;BD3LM 是分块离散扩散;MDLM 为掩码扩散,也测试了在推理时施加分块生成的版本;SW-SetDLM 为另一种滑窗离散方法。AR 提供常规从左到右生成的参考。 PPL 越低越好,衡量模型对数据的概率拟合;pass@1 越高越好,此处判定的是程序执行得到的答案;ROUGE 越高越好,衡量摘要与参考的词汇/序列重合;MAUVE 越高越好,用于比较生成文本与真实文本的分布。不同指标回答不同问题,低 PPL 不直接保证低预算下的生成质量。 生成评估使用 seed 1,在单节点 8 张 H100 上每卡 batch 1。表中 NFE 为每条序列的均值,$\pm$ 是跨样本的标准差。它计入全部模型前向,包括 prompt、缓存、最终读出和 SSD 的 AR 验证。每次前向处理的 token 数、缓存长度和模式不同,所以 NFE 只刻画调用层面的计算需求。(附录 F,p. 28) 原表 1,PDF p. 7;除 AR 外为变分 PPL 上界。表中部分 baseline 来自既有论文,RePlaid 和 Clock 系列为本工作训练。 最强的匹配块宽比较是 $S=4$:ClockDLM 比 BD3LM 低 1.2 PPL,约为相对下降 5.8%。论文所说“缩小与 AR 的差距约 38%”来自 这与“PPL 本身降低 38%”是不同的量。窗口越小,条件结构越接近 AR,结果整体更好;但滑窗并非在所有宽度优于分块:$S=64$ 时 21.1 略差于分块的 20.9。 原表 2,PDF p. 7;阈值由表 7(p. 33)确定。Clock 系列该表使用 $N=S$。 标准滑窗相对 RePlaid 提升 15.1 个百分点,相对增幅约 33.9%;相对同宽分块高 5.3 个百分点。这支持“逐步确定前缀的生成结构有益”的解释。但单看该表的 $S=32$ 标准设置,ClockDLM 仍比 BD3LM 低 2.2 个百分点,NFE 也略多,不能把它写成在所有配置上全面胜出。 原图 4,PDF p. 8。横轴是平均 NFE(对数刻度,向左更省调用),纵轴是 GSM8K pass@1,左/右面板为 $S=32/64$。Clock/B-Clock 通过改变每 token 预算 $N$ 扫描曲线;SW-SetDLM 扫描的是置信度阈值。绿色滑窗曲线相较全序列 RePlaid 明显改善了质量—调用数关系,也在多个低调用预算处具有优势;不同方法的扫描变量并不相同。 从表 2 直接计算,Confidence 的调用比为 $188.1/59.5\approx3.16$,准确率从 59.6% 到 60.0%。与 AR baseline 比,调用比为 $158.4/59.5\approx2.66$,但准确率低 4.3 个百分点。这是一个清楚的质量—计算取舍。 SSD 对标准 ClockDLM 的调用比为 $188.1/35.5\approx5.30$;对独立 AR baseline 为 $158.4/35.5\approx4.46$,准确率高 3.3 个百分点。解释其准确率时必须看联合训练消融: 原表 8,PDF p. 33。两列都没有使用 SSD 采样,NFE 基本不变,例如 $S=32$ 为 188.1 与 187.4。因此,AR 辅助目标本身已经提高了扩散模式的表现。再切换到 SSD,才得到主表联合模型的 67.6% / 35.5 NFE。 原文 Sec. 4.2 还称联合训练改善 AR 模式;表 8 直接隔离展示的是标准扩散解码的改善,读取该表时应按其列定义理解。 原表 7,PDF p. 33,使用 $N=S$,此表为便于比较只列 NFE 均值。滑窗可以按前缀提前提交,分块必须等全块过阈值,所以后者节省调用的幅度较小。 阈值下降时 NFE 持续下降,但数学准确率有波动:例如滑窗 $S=32$ 在 $\eta=0.99$ 时为 57.7%,在 $0.8$ 和 $0.7$ 时反而都为 60.0%。作者认为程序执行的正确性可能被少量 token 改动显著影响,因此不呈简单单调规律。(Sec. 4.4、附录 G.2,pp. 9、32–33) 原表 3,PDF p. 8;均为从头训练,表中省略 NFE 标准差。相对 RePlaid 的 $T=1024$ 配置,滑窗 $S=32$ 的三项 ROUGE 分别增加 3.8、1.4、1.7,调用数减少约 $1025/120.3=8.52$ 倍。 但与离散模型相比差距明显;与 AR 比,ClockDLM 的 ROUGE-1 接近,ROUGE-2/L 更低且调用更多。因此本文在数学任务上的强结果不能直接迁移为“所有条件生成任务都优于 AR/离散扩散”。 原图 6,PDF p. 9。横轴为 NFE,纵轴为 ROUGE-1,绿/蓝代表 $S=32/64$,空心点为没有提前提交的标准采样。降低阈值会向左移动并大体损失质量;正文报告从 0.99 降到 0.7 约减少 1.1–1.2 倍调用,ROUGE-1 相对下降至多 1.3%。比较起点是 0.99,而不是空心标准点。(Sec. 4.3,p. 8) 原图 8,PDF p. 32;实验说明在附录 G.1,pp. 31–32。横轴为 NFE,纵轴为 MAUVE,绿色为 $S=64$ 的 ClockDLM,虚线为 RePlaid。使用 5,120 条生成序列,以 ModernBERT-large 特征计算指标。 在约 512 次及以上调用的区域,ClockDLM 更强;而约 64–256 次调用时,绿色曲线接近零。作者的解释是:固定总调用数时,滑窗给每个 token 的去噪预算很少。例如总预算约 256,$S=64$ 的滑窗每个 token 约只获得 16 步,RePlaid 的每个位置则都获得 256 步。这揭示了窗口并行度、每 token 迭代深度与输出质量之间的真实取舍。 图中还对每个模型选择了更好的采样后处理:RePlaid 最好不使用 nucleus filtering 或重复惩罚;ClockDLM 更适合重复惩罚,top-$p$ 的优选值随调用预算变化。因此该图比较的是各自调优后的结果。 附录 G.4 的生成示例可帮助判断输出形态,但不足以代替上述指标:数学示例经过正确程序和答案筛选;OWT 示例的预算并不相等(RePlaid 257 NFE、ClockDLM 1087 NFE)。摘要示例仍出现事实或连贯性问题,例如 ClockDLM 对 CERN/LHC 文章的摘要错误使用美国指向。ROUGE 的提升尚未解决这一类生成错误。(pp. 33–38) Clock Diffusion 的主要贡献是把连续扩散的局部时间、已完成前缀的依赖约束和缓存更新组织成一致的生成框架。滑窗实例比整块同步提交更灵活,既能逐步形成稳定前缀,也允许保留尚未完成的连续状态。Confidence 直接利用这一点节省推理调用,SSD 则把它与同模型的 AR 验证结合。 实验支持的结论有清楚层次:OWT 上,报告的扩散 PPL 上界达到 19.5;数学代码生成上,普通滑窗明显改进全序列连续模型,Confidence 在约 60% 准确率下大幅降低调用数,联合训练的 SSD 进一步达到 67.6%;摘要和低预算开放生成仍暴露出质量不足。模型规模也主要限于论文所测试的较小架构,尚需验证在大规模预训练及实际服务环境中的收益。(Sec. 6,p. 9;表 1–3、图 8) 对后续研究,最直接的三个问题是:能否以可接受代价让训练重建上下文更接近真实提交时刻;能否在低 NFE 的开放生成中更好分配每 token 的去噪深度;能否在保留缓存有效性的同时允许更灵活的生成顺序。它们分别对应本文的训练代理、低预算失败区和左到右提交约束,具有具体可检验的机制目标。 我的判断:这篇工作的价值不只在刷新一个数字,更在于说明连续扩散可以获得成熟语言模型所需的前缀缓存与变长生成能力。阅读和使用它时,最应保留的三个区分是:理论时钟与训练代理、Confidence 与需重训的 SSD、NFE 收益与真实运行效率。组件 具体计算或作用 方差保持调度 $\alpha_u^2+\sigma_u^2=1$;令 $\gamma_u=-\log\mathrm{SNR}(u)$,则 $\alpha_u^2=\operatorname{sigmoid}(-\gamma_u)$ 可学习噪声调度 单调 MLP 或正斜率积分参数化;调度形状按扩散损失的二阶矩降低估计方差;端点是否学习随任务变化 16 维嵌入瓶颈 噪声在小维度空间中演化,再投影至 Transformer 宽度 输入尺度归一化 $\mathbf z_t^\ell/\sqrt{\alpha^2/d+\sigma^2}$,使期望平方范数保持为 $d$;干净上下文乘 $\sqrt d$ 自条件(self-conditioning) 将前一次干净嵌入预测送回模型;训练时四分之一的样本先做无梯度预测,验证时全部样本使用两次前向 批次拆分 重建与扩散项分别用批次子集估计,再按抽样比例倒数缩放,节省前向计算 解析 logit prior $\pi_t^\ell=(\alpha/\sigma^2)E\mathbf z_t^\ell$,提供当前 latent 对每个 token 的高斯似然信息 网络 logit soft-capping $\mathbf x_\theta^\ell=\operatorname{softmax}\big(30\tanh(h_\theta^\ell/30)+\pi_t^\ell\big)$ 2.6 似然界为什么只需要计算活跃位置
2.7 实际训练使用灵活代理,PPL 验证恢复固定时钟的估计
2.8 标准采样预算:流水线改善缓存时机,调用数仍取决于 $N/S$
2.9 Cache Grab:提前结束一部分 token 的计算
三:实验——各组比较实际检验什么
3.1 数据与训练设置
任务 数据与输出 主要配置 评价口径 语言建模 OpenWebText;长度 1024 的拼接文本;最后 10 万文档为验证集 DiT,12 层 / 宽 768 / 12 heads;100 万更新;全局 batch 512;GPT-2 tokenizer 全验证集 PPL,扩散用变分上界;100 万步 EMA checkpoint 数学推理 TinyGSM 问题 → Python 程序;GSM8K 测试 同类 DiT;长度 512;25 万更新;batch 512;SmolLM tokenizer 1,319 题,每题生成一次;执行代码,数值误差容许 $10^{-3}$;zero-shot pass@1 摘要 CNN/DailyMail v3.0.0;文章 → 摘要 Qwen3 风格架构从头训练,28 层 / hidden 256;画布 768;最多 50 万更新;batch 128 11,490 篇;ROUGE-1/2/L;选最低验证损失 checkpoint 3.2 baseline 与指标
四:结果——优势出现在哪里,代价又在哪里
4.1 OWT:最好的扩散 PPL 上界仍与 AR 有差距
模型 $S$ PPL ↓ AR baseline — 17.5 MDLM 全序列 23.1 RePlaid(重训) 全序列 21.3 BD3LM 16 22.3 BD3LM 4 20.7 B-ClockDLM 64 / 16 / 4 20.9 / 20.8 / 20.2 ClockDLM 64 / 16 / 4 21.1 / 20.6 / 19.5 4.2 GSM8K:标准滑窗先缩小质量差距,Cache Grab 再大幅减少调用
模型/采样 窗口 NFE/序列 ↓,均值 ± SD pass@1 ↑ AR baseline — 158.4 ± 48.7 64.3% MDLM,全序列 — 112.4 ± 5.6 40.4% MDLM + SAR decoding 32 184.1 ± 72.1 53.1% BD3LM 32 177.7 ± 48.2 61.8% SW-SetDLM ≤64 174.1 ± 53.6 52.0% RePlaid 全序列 1025.0 ± 0.0 44.5% B-ClockDLM 32 190.1 ± 47.3 54.3% ClockDLM,标准 32 188.1 ± 44.8 59.6% ClockDLM + Confidence,$\eta=0.7$ 32 59.5 ± 27.6 60.0% ClockDLM + SSD,联合训练 32 35.5 ± 21.6 67.6% 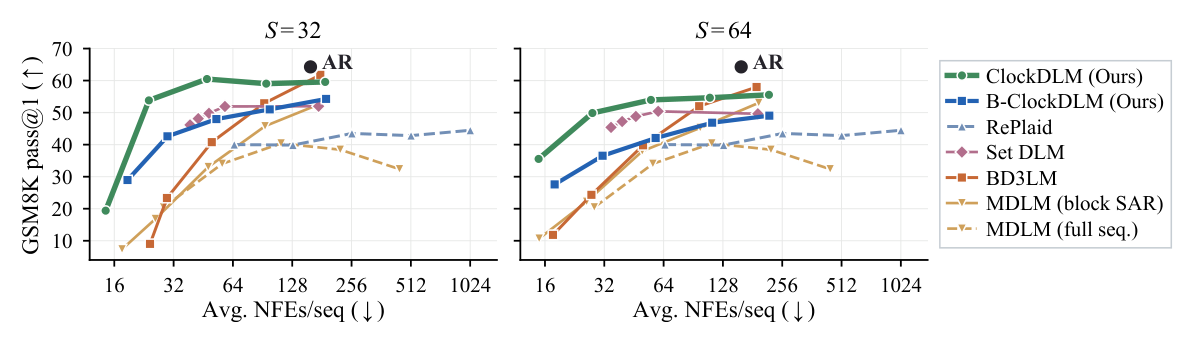
4.3 Confidence 是同模型推理加速;SSD 还包含联合训练收益
$S$ 仅扩散训练,标准扩散解码 AR + 扩散训练,标准扩散解码 准确率变化 4 65.7% 66.6% +0.9 个百分点 8 63.8% 67.2% +3.4 个百分点 16 60.0% 63.8% +3.8 个百分点 32 59.6% 63.5% +3.9 个百分点 64 55.6% 61.3% +5.7 个百分点 4.4 阈值与窗口消融:减少调用较稳定,准确率不总单调
模型 $S$ 标准:NFE / 准确率 $\eta=0.7$:NFE / 准确率 ClockDLM 32 188.1 / 59.6% 59.5 / 60.0% ClockDLM 64 219.1 / 55.6% 78.4 / 53.6% B-ClockDLM 32 190.1 / 54.3% 71.1 / 53.4% B-ClockDLM 64 220.1 / 49.1% 103.6 / 48.4% 4.5 摘要:优于连续 baseline,但离散扩散仍更强
模型 设置 平均 NFE ↓ ROUGE-1 / 2 / L ↑ AR — 73.1 35.9 / 14.8 / 25.0 MDLM,SAR $S=32$ 96.0 40.0 / 18.0 / 27.1 BD3LM $S=32$ 110.7 39.4 / 17.5 / 27.0 SW-SetDLM $S\le64$ 72.2 39.7 / 17.9 / 27.8 RePlaid $T=1024$ 1025.0 32.2 / 12.7 / 22.1 RePlaid $T=128$ 129.0 30.4 / 11.1 / 20.7 B-ClockDLM $S=32$ 91.3 33.6 / 11.3 / 21.8 ClockDLM $S=32$ 120.3 36.0 / 14.1 / 23.8 ClockDLM $S=64$ 152.4 34.0 / 11.7 / 21.7 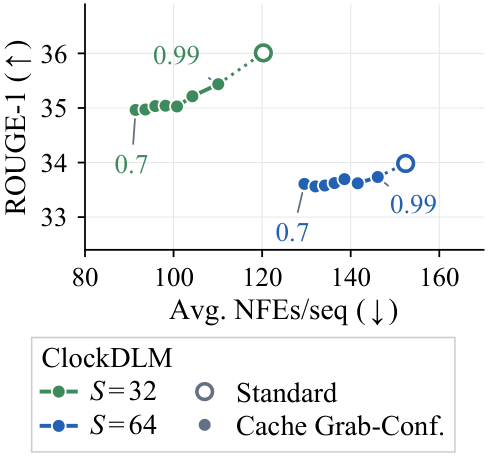
4.6 开放式生成:低 PPL 没有消除低预算采样的困难
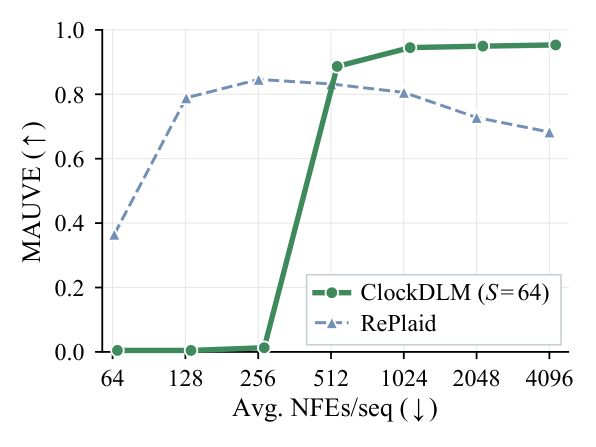
五:结论——值得带走的机制与后续问题