Cogentic:多智能体如何积累可用的数学证明
论文:Cogentic: Multi-Agent Orchestration for Automated Proof Discovery
作者:Yang Cai、Vineet Gupta、Yanchen Jiang、Christopher Liaw、Aranyak Mehta、Grigoris Velegkas、Di Wang
机构:Google Research;Yang Cai 另属 Yale University,Vineet Gupta 另属 Google DeepMind
版本:arXiv:2609.40324v1,提交于 2026-09-30;本次获取与研读日期:2026-10-03
链接:arXiv · 本地原文 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
Cogentic 研究的问题是:当一个开放数学问题需要反复试错、拆解中间引理和检查细微漏洞时,怎样让语言模型的多轮推理形成持续进展?它将研究工作组织成一个闭环:编排器分配研究方向,多个证明者独立提出证明,验证者同时做单篇审查和同轮横向审查,再把失败原因与通过复核的局部结果分别保存,供下一轮使用。
这套设计最有价值的部分是改变跨轮次记忆的内容和可信度。一个整体失败的证明仍可能含有正确引理;这些引理被提取、改写为独立陈述并再次验证后,可以进入长期账本。下一轮因此既知道哪些路径受阻,也获得能够直接引用的中间成果。(§2.1–2.4,PDF pp.4–5)
作者使用 Gemini,在在线学习、拍卖理论和机制设计中报告五项新结果,包括高效的 $O(d)$ 在线逆优化遗憾界、双边市场仅增加两名卖家的竞争复杂度界、大量专家下 anytime 遗憾的最优首项常数、简单售卖机制的 3.52 近似因子,以及自动竞价中的更优无政府代价。结果由领域专家事后检查,完整数学论证分布在伴随论文中;本篇主体提供系统架构、定理陈述和部分证明思路。(§3,PDF pp.5–10)
理解这篇论文时,应将两个层面分开:五项定理体现了具体的数学产出;“哪个智能体模块带来了多少收益”则需要受控的系统比较。本篇展示的是研究案例,未给出等预算基线或模块消融。因此最有依据的评价是:它展示了一套能产出有价值证明的研究工作流,并给出了值得复用的记忆与验证设计。
结构地图
下表均使用从 1 开始的 PDF 页码。
| 原文章节 | 内容与作用 | 定位 |
|---|---|---|
| 1. Introduction | 自然语言证明发现的困难,与形式化证明和可计算评分搜索的关系 | pp.1–2 |
| 2. The Harness | 智能体分工、共享工作区、轮次流程 | pp.2–5;Fig.1 在 p.3 |
| 2.1. Directions and Assignments | 方向分配、独立摘要与上下文选择 | p.4 |
| 2.2. Verification | 单篇与跨证明的对抗审查 | p.4 |
| 2.3. Cross-Round Communication | 尝试记录与已验证引理账本 | p.4 |
| 2.4. Process Level Adaptation | 从历史审查日志调整流程 | pp.4–5 |
| 2.5. Termination and Output | 选择已通过证明、扩写和终稿审查 | p.5 |
| 3. Results | 五项成果总表 | Table 1,p.6 |
| 3.1. Efficient Online Inverse Linear Optimization | 高效、proper、anytime 的 $O(d)$ 界及势函数思路 | pp.5–7;Theorem 1 |
| 3.2. Competition Complexity for Two-Sided Markets | 较小一侧只增加两名交易者 | p.7;Theorem 2 |
| 3.3. Anytime Regret with $n$ Experts | anytime 与固定时域的首项常数渐近一致 | pp.7–8;Theorem 3 |
| 3.4. Simple versus Optimal Revenue for an Additive Buyer | 联合收入尺度截断与 3.52 近似 | pp.8–9;Theorem 4 |
| 3.5. Price of Anarchy for Autobidding Auctions | 比例式随机分配及两类 PoA 界 | pp.9–10;Theorem 5 |
| 4. Discussion | 人类检查、后续加工,以及理解速度的瓶颈 | p.10 |
| A. Prompts Used for the Problems | 五个问题的实际输入;自动竞价有两份提示 | pp.14–17 |
一、动机:开放问题需要保留什么样的进展
开放问题往往没有一个便宜、忠实的自动评分函数。某个组合结构是否满足约束有时可以运行程序检查,但一段自然语言证明可能只在量词、边界条件或所引用定理的假设上出错,整体仍显得非常可信。单次生成因此同时面临搜索与验证两方面的困难。(§1,PDF pp.1–2)
多次独立采样能够增加候选答案,却未必记住先前为何失败。长对话能够累积上下文,却容易让未证猜测、错误步骤和正确结论混在一起。Cogentic 的工作分解恰好对应三种需要:保留多条证明路径,持续攻击候选证明,以及将有依据的局部成果沉淀为后续共同使用的材料。
它的输出是供数学研究者阅读的自然语言证明。系统中的验证者仍是智能体;外部专家检查是作者报告成果时的另一层验证。这里的“formal writer”负责写出完整数学文稿,并不表示输出已经成为 Lean 等证明助手可核验的形式化证明。(§1、§2.5、§4,PDF pp.1–2、5、10)
二、方法:搜索、审查和记忆怎样连接
2.1 从一个问题到一份可审阅的论文
输入是问题陈述及提供的参考材料。系统共享磁盘工作区,按轮次运行;预算耗尽也是终止条件。成功通过验证的结果被整理为包含定理、证明、依赖引理、记号和背景的自包含文稿。
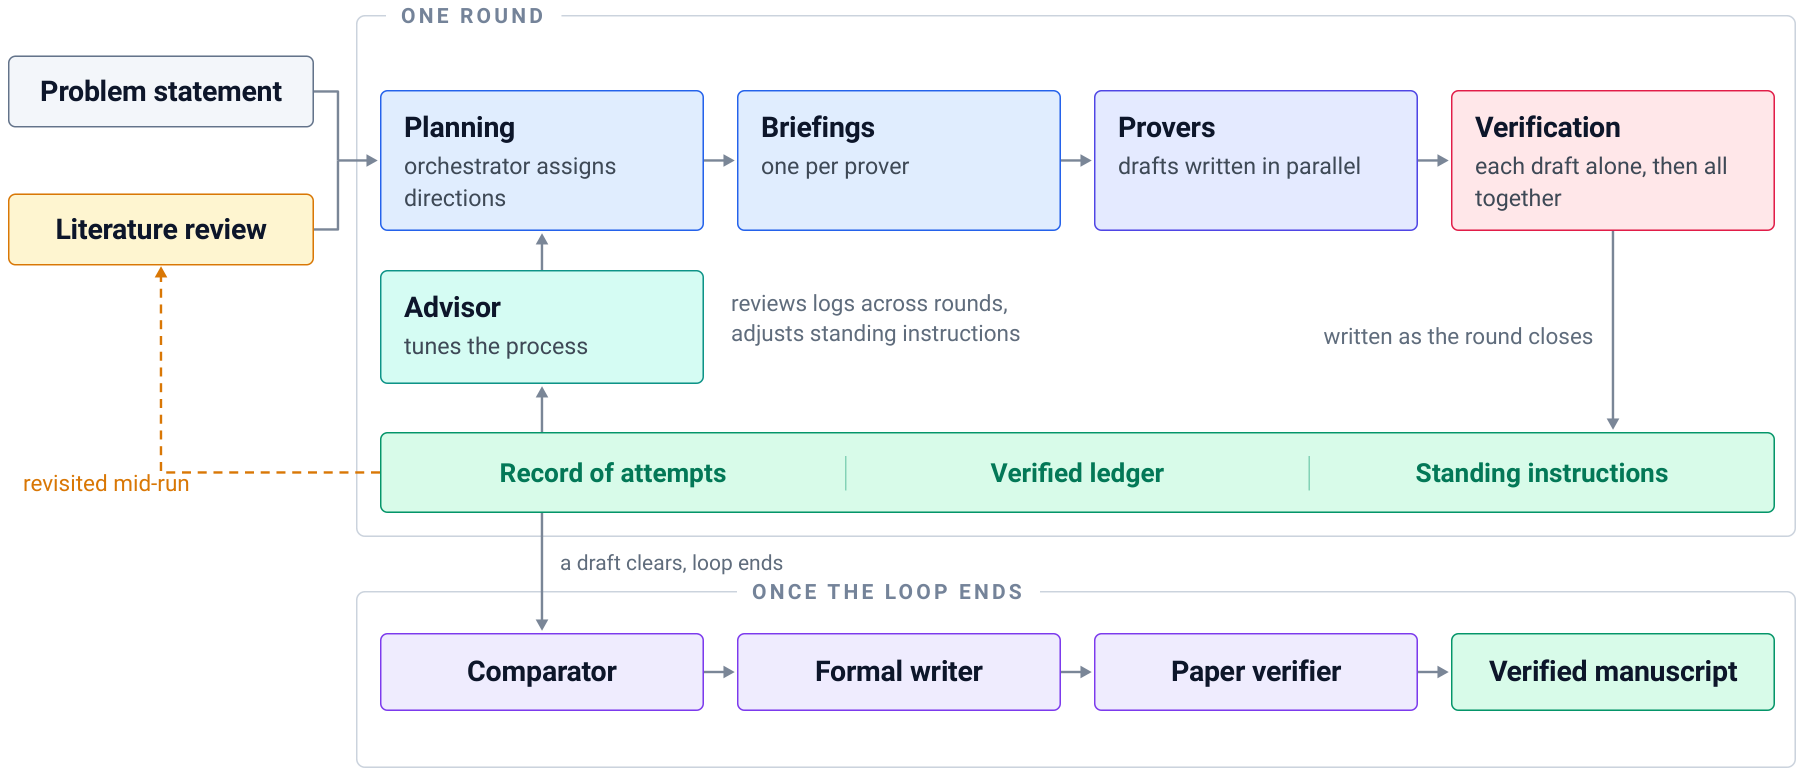
图源:原文 Fig.1,PDF p.3,复用作者矢量图。先从左到右读上方主链:问题与文献背景 → 方向分配 → 个别简报 → 并行证明 → 验证;再看下方反馈链:尝试记录、已验证账本、常驻指令返回下一轮。最下方是候选通过后进行的比较、写作和终稿核查。
图注把个别简报的编写称为 advisor 的工作,§2.1 则明确由编排器生成独立 summarizer 来完成;按正文的功能划分理解,它与 §2.4 跨轮次调整流程的 process advisor 是不同职责。
| 组件 | 读取的材料 | 产出及职责 |
|---|---|---|
| 编排器(orchestrator) | 全局状态、尝试记录、验证结果和顾问建议 | 决定调用谁、分配哪些方向、管理记录;不亲自做数学推导 |
| 文献审阅者(literature reviewer) | 问题与当前技术障碍 | 定义、已有定理与相关文献;遇到反复受阻的步骤时可重新检索 |
| 摘要者(summarizer) | 历次尝试、意见与公共材料 | 为每个证明者独立生成有选择的简报 |
| 证明者(prover) | 所分方向、简报、账本及必要的原文件 | 独立形成候选证明;自行选择技术路线 |
| 验证者(verifier) | 单篇证明或同轮全部证明 | 具体缺口、引用问题、通过或不通过的判断 |
| 账本审计者(auditor) | 失败证明中被认可的局部片段 | 独立表述的引理,并再次交给验证者复核 |
| 流程顾问(process advisor) | 跨轮次验证日志 | 调整分配与指令,指出反复出现的流程问题 |
| 比较、写作与终稿审查组件 | 已通过证明及其依赖 | 选择较强结果,扩写文稿,再检查写作是否引入错误 |
来源:§2,PDF pp.2–5。原文描述的是职责划分,没有给出固定的每轮智能体数量或完整调度算法。
2.2 方向独立与上下文选择
一个“方向”可以是某个具体常数界、一个构造、寻找反例,或者修补已有证明。分配方向后,证明者自行决定怎样推进。同一轮的摘要者也独立读取历史,因而即使处理相近方向,各证明者收到的上下文不必相同。(§2.1,PDF p.4)
这一设计同时处理上下文长度和搜索多样性。把全部历史塞给每个证明者既昂贵,也容易令所有实例围绕同一份叙述思考。独立简报保留不同的历史解读;长文档仅给路径,由证明者按需打开。这里的“独立”是任务执行与简报生成的独立性,不能据此假设多个模型判断的错误在统计上独立。
2.3 两种范围的验证
每份候选证明经过两种检查:一位验证者专门检查这份稿件,另一位将本轮所有稿件放在一起比较。前者适合逐步寻找推导漏洞;后者能够发现不同证明重复使用同一个未经证明的假设。两者都通过,候选才被接受。(§2.2,PDF p.4)
以下是对接受规则的教学记号,并非论文中编号公式:
其中 $P_i$ 是第 $i$ 份证明,$\mathcal P_r$ 是第 $r$ 轮的证明集合。两个验证结果分别代表单篇审查和同轮比较。
对抗性体现在检查的起点:每一步都需要理由,引用也要核对。这个接受规则不是多数投票;它要求候选经受两种检查范围。论文没有报告验证器的误接受率,因此账本的“已验证”应理解为通过该流程审查。
2.4 尝试记录与已验证账本
尝试记录(record)保存研究历史:想证明什么、用了什么办法、在哪一步受到什么反驳。它支持下一轮分配,也防止重复提交同一种错误。
已验证账本(verified ledger)保存可继续使用的数学内容:验证者可能否定整篇证明,但认可其中一个局部引理。审计者把它提取出来,补齐假设和结论,改写成自包含陈述,再独立复核。只有复核通过的内容才成为后续证明者可直接引用的条目。经验证的反例也会进入账本,用于排除某个不可能的目标。(§2.3,PDF p.4)
教学例子:假设一份证明由引理 A、引理 B 和最后的组合步骤组成。验证者发现组合步骤错误,但 A 正确。记录写下组合步骤的漏洞;A 则经过独立表述和复核进入账本。下一轮可以从 A 出发改造 B 或组合方式。一个被确认的反例如果只推翻某个更强常数,也应保留它实际排除的范围。
这一机制的意义是让一次失败也可能增加后续可用的知识。代价在于,错误一旦被提升为公共引理,影响也会跨轮次扩散,所以“先从上下文中提取,再独立验证”是关键步骤。
2.5 从日志调整流程,再审查最终文稿
流程顾问读取整个运行期间的审查日志,寻找反复出现的错误模式。例如多份稿件都省略某类条件,或单篇验证者屡次漏掉同一漏洞,下一轮便可加强相关要求。编排器同时承担大量并发协调工作,难以把全部历史装入自己的上下文,因此由专门顾问总结这些模式。(§2.4,PDF pp.4–5)
原文明确限制编排器和流程顾问发表数学意见:它们不能凭自己的判断猜答案、推荐证明技术或宣布某方向已无希望。读者可以把这理解为一种减少中央偏好干扰的设计;这是机制解释,论文没有通过消融验证其效果。经验证的反例可以排除方向,流程调度也可以响应已有结果,这与凭控制器直觉裁定数学真假不同。
候选通过后,系统可以继续探索可能带来更强结果的剩余方向。终止时,比较器选择较强的已验证证明,写作组件补齐文稿,最后的审查把成稿与已接受证明对照,避免扩写过程中丢失条件或改错结论。(§2.5,PDF p.5)
三、理论产出的评价口径
作者在自身熟悉的三个领域选择问题,用 Gemini 运行系统,再由领域专家检查证明。多数问题的调用规模记为 $O(100)$,最难问题记为 $O(1000)$。这是作者报告的大致数量级,文中没有逐题的 token 数、耗时、费用或完整的模型配置,因此不能把它直接转换为确定的复现成本。(§1、§3,PDF pp.1、5)
Table 1 的“已有最好结果”是数学界限的比较对象,例如旧遗憾上界或旧机制的近似比,并非对语言模型进行的对照实验。原文没有给出单智能体、单次采样或删除账本后的等预算比较,也没有报告总共尝试多少开放问题及失败任务。因此五项成果应按其定理内容评价,无法从“五项”计算通用成功率或归因到某一个模块。
此外,正文的“无人工数学干预”描述运行阶段;具体输入和后处理需要结合附录理解:
| 问题 | 附录实际提供的方向或目标 | 对自主性与结果的解释 |
|---|---|---|
| 在线逆优化 | 给出切平面问题,要求关于 $d$ 为多项式且与 $T$ 无关的界,指出来源论文 | 算法与证明仍需系统探索 |
| 双边市场 | 指定 STR,并直接要求证明加入两名卖家足够 | 目标机制和常数已给定 |
| Anytime 专家学习 | 给出现有论文及大量专家时 anytime 代价趋于 1 的猜想 | 任务是解决所指定猜想 |
| 简单收入机制 | 目标为 3 近似;若做不到先尝试 4,再加强 | 最终报告 3.52,改进了 5.2,但没有达到提示中的 3 |
| 自动竞价,两人 | 给定比例分配机制及 1.5 猜想 | 作者事先已有候选机制与常数,系统寻找证明及下界 |
| 自动竞价,多人 | 要求设计依赖人数和出价的机制,尽量接近已有下界 | 作者称具体机制与分析由系统提出 |
来源:Appendix A.1–A.5,PDF pp.14–17;§3.5,p.10。附录 A.5 还说明,最初两个自动竞价提示均允许假设所有查询上的估值严格为正,作者随后另请 Gemini 修改输出证明以移除该假设。§4 说明人类补充了文献定位、论述,有时进一步推进成果。因而本研究展示的是在专家提出的问题和约束内自动推进证明,再进行专家审查和加工的工作流。
四、五项数学结果:改进了什么,为什么成立
4.1 在线逆线性优化:总损失不再随时间增长
问题设定。 隐藏的线性目标向量 $w^*\in\mathbb B\subseteq\mathbb R^d$ 固定,$\mathbb B$ 为欧氏单位球。第 $t$ 轮给出紧行动集 $X_t\subseteq\mathbb B$,学习者选 $\hat x_t\in X_t$,随后看到专家选择
学习者看不到 $w^*$,也看不到行动的目标函数值。评价量是累计短缺:
每一项均非负,所以“关于 $T$ 一致有界”意味着有限的总损失预算,而不仅是平均损失趋于零。维度 $d$、轮次 $t$ 与终止时域 $T$ 的作用必须区分。(§3.1,PDF p.5)
Proper 条件。 学习者必须在看到本轮行动集之前,提交一个非零线性目标估计 $\hat w_t$,然后依据它在 $X_t$ 上做一次线性优化。这给出可解释的目标估计,也限制了学习者的决策形式。
Theorem 1。 存在确定性的、proper 的 anytime 算法,使
每轮需要 $O(d^2)$ 次算术运算和一次对 $X_t$ 的线性优化。后者是另计的 oracle 操作,其实际成本取决于行动集,不能省略。(PDF p.6)
| 比较对象 | 界与计算代价 | 新结果解决的缺口 |
|---|---|---|
| 已有高效算法 | $O(d\ln T)$,随 $T$ 增长 | 去掉时域依赖 |
| 已有 $O(d)$ 算法 | 非 proper;有限实现可需要每轮 $T^{\Theta(d)}$ 次测试 | 同时获得 proper 与高效性 |
| 本文报告的算法 | $O(d)$,每轮 $O(d^2)$ 加一次线性优化 | 将三项要求放在同一算法中 |
来源:§3.1,PDF pp.5–7;Table 1,p.6。
证明主线。 问题可归约为强分离 oracle 的切平面游戏。学习者查询 $p_t$,对手返回单位向量 $v_t$,满足 $\langle w^*-p_t,v_t\rangle\ge0$。令 $g_t=-v_t$,用正定矩阵 $H_t$ 描述当前的变度量几何,并定义
这里 $H_t$ 是 $d\times d$ 矩阵,$s_t$ 是方向在当前对偶度量下的标量长度。作者介绍了两个相互配合的修改:将秩一增量 $g_tg_t^\top$ 按 $s_t$ 自归一化;将传统的 $\log\det H_t$ 势函数改为
原文给出的核心性质是:势函数从 $d$ 开始,始终非负,而且每轮至少减少 $\frac{\tau}{4}s_t^2$,其中 $\tau=\Theta(1/d)$。于是求和得到
再取迭代步长 $\alpha=\Theta(1/d)$,距离收缩分析和归约给出
上述求和是对原文证明概要的展开。关键在于,下降势函数只有一个由维度决定的初始预算,因此累计步长平方也能脱离 $T$;传统的体积型势函数则留下 $d\log T$。(§3.1,PDF pp.6–7)
原文还指出,证明只用到专家本轮表现不差于学习者,所以可以覆盖未必真正最优的专家。伴随论文另含抗污染、秩自适应变体,以及凸函数最小化的应用:若函数为 $L$-Lipschitz,某个极小点距初始点不超过 $R$,则仅用次梯度方向可得到无限运行中的总次优差 $O(dLR)$。(p.7)
边界。 任意算法的下界为 $\Omega(\sqrt d)$;本篇已提到后续工作获得了不高效的紧 $O(\sqrt d)$ 界。因此这里的贡献重点是高效的 $O(d)$,高效实现最优维度依赖仍是开放方向。(p.7)
4.2 双边市场:在较小一侧招募两名交易者
设有 $m$ 名买家、$n$ 名卖家,且 $m\ge n\ge1$。买家估值分布 $F_B$ 一阶随机占优于卖家成本分布 $F_S$。若以累积分布函数表示,这意味着每个阈值 $z$ 上 $F_B(z)\le F_S(z)$;它约束的是分布,并不要求每次抽样的买家估值都高于每名卖家成本。
交易收益(gains from trade,GFT)衡量成交买家的价值减去对应卖家成本带来的总增益。这里的 $\operatorname{OPT}(m,n)$ 是原市场的期望 first-best GFT,$\operatorname{STR}$ 是 Seller Trade Reduction 机制的期望 GFT。(§3.2,PDF p.7)
Theorem 2。 在上述条件下,
这比较的是扩充市场上的简单机制与原市场上的 first-best。增加参与者带来的竞争弥补机制约束造成的损失。此前的常数招募结果需要两侧都扩充,分析使用每侧至少 20,000 名额外参与者;新结果只在原来人数较少的卖家侧增加两名。(§3.2,p.7;Table 1,p.6)
结果还包含“增加一名不够”的紧性结论,即使原来 $m=n=1$ 也成立。关于下界的机制范围,Table 1 明确写出 DSIC、IR、弱预算平衡,分别表示占优策略激励相容、个体理性和不需外部补贴;Theorem 2 的摘要表述则使用 prior-independent。引用这个下界时应保留所讨论的机制约束,避免把正文的简略措辞扩张为完全不受约束的机制不可能性。
本篇没有展开 STR 的具体规则或该定理的证明步骤;完整机制与论证见伴随论文。这一小节的直接贡献是同时改进招募常数与招募方向。
4.3 Anytime 专家学习:首项常数不必为未知时域付费
每轮学习者选择 $n$ 个专家上的概率分布 $p_t$,随后对手给出损失向量 $\ell_t\in[0,1]^n$。为解释评价量,可将标准遗憾写成
它将学习者累计期望损失与事后最好的单个专家比较。固定时域算法事先知道 $T$,可以把乘法权重的参数调到 $\sqrt{T\ln n/2}$ 的保证;anytime 算法不知道终止时间,要求同一个运行在所有 $t$ 上都满足界。原先大量专家的 anytime 上界是 $\sqrt{t\ln n}$,首项常数相差 $\sqrt2$。(§3.3,PDF pp.7–8)
Theorem 3。 对所有损失序列,存在无需预知时域的算法,同时对所有 $t\ge1$ 满足
相对误差在 $n\to\infty$ 时消失,因而渐近首项常数与固定时域相同。这里的渐近变量是专家数 $n$,不是运行时长 $t$;原文也指出,两专家情形存在严格的 anytime 代价,所以不能把结论读成“所有有限 $n$ 的界都完全一致”。(PDF pp.7–8)
证明主线:控制同时活跃的子算法。 为几何网格上的每个候选时域
运行一个乘法权重实例,再用主算法聚合。这里 $m$ 是实例编号,$H^m$ 是原文对网格时域的记号。任意时刻 $t$,总能找到时域在 $[t,(1+\varepsilon)t]$ 内的实例,网格近似只损失 $\sqrt{1+\varepsilon}$ 因子。困难是:若全部实例一直保留,聚合复杂度会随 $t$ 增长,额外遗憾也会带上时间依赖。
作者让第 $m$ 个实例只在
之间活跃。在忽略取整的直观计数中,时刻 $t$ 活跃的实例满足 $t\le H^m\le t/\delta$。几何网格落在这个区间内的点数为
与 $t$ 无关。原文还需要控制任一实例生存期间新加入的实例数,因为新实例会分走聚合器已有的概率质量;仅限制某一时刻的数量还不足以完成分析。(§3.3,PDF p.8)
延迟启动留下的早期前缀需要递归处理,其代价形成
取 $\varepsilon=\sqrt{\ln\ln n/\ln n}$、$\delta=\varepsilon^3$,网格粗糙度、聚合开销和前缀递归合起来只需 $1+O(\varepsilon)$ 的因子。这个证明的启发是:通过安排候选算法的生命周期,让元学习器承担的复杂度由精度要求而非总时间决定。
4.4 简单售卖与最优收入:联合尺度截断得到 3.52
设一个买家对 $n$ 件物品具有可加估值,各物品估值独立抽样。$\operatorname{SRev}$ 是分别为各物品设置固定价格能够获得的最优期望收入,$\operatorname{BRev}$ 是整包售卖的最优期望收入。$\operatorname{OPT}$ 允许更复杂甚至随机化的机制。(§3.4,PDF p.8)
Theorem 4。 令 $M=\max\{\operatorname{SRev},\operatorname{BRev}\}$,则
已有近似因子经历了 $6\to5.2$,本文推进到 3.52,因子越小越好。为帮助理解这个数,简单机制至少保留最优收入的 $1/3.52\approx28.41\%$,旧的 5.2 保证对应约 $19.23\%$。这些百分数是由上界倒数换算的最坏情形保证,没有对应某个数据集上的实测收入增长。最优因子的已知下界为 2;提示中的目标 3 尚未由此结果实现。(§3.4,p.8;Appendix A.4,p.16)
证明主线。 令 $v_j$ 为物品 $j$ 的估值,
对偶框架给出
要控制的是买家最喜爱物品以外的总价值。原有分析按 $\operatorname{SRev}$ 截断,将其分成 core 与 tail 分别估计;新分析改用同时考虑分别售卖和整包售卖的尺度 $M$,定义
这将目标压缩成一个截断后的总价值期望,免去单独处理 tail。进一步固定 $\mathbb E[V_M]$,构造控制二阶矩 $\mathbb E[V_M^2]$ 上下界的极值分布,利用两边约束限制 $\mathbb E[V_M]/M$,最终得到常数 3.52。(§3.4,PDF pp.8–9)
机制直觉是:如果截断后总价值的均值过大,整包销售本身就应能获得较高收入,而 $M$ 已经包含该收入尺度。这种联系帮助收紧界。不过本篇只介绍矩方法的思路,未列出决定 3.52 的完整极值计算,具体常数推导应读伴随论文。
4.5 自动竞价:随机比例分配改善福利损失
广告主通过自动竞价系统参与多次查询拍卖,并受到投入回报率(return-on-spend,RoS)约束。本节研究 prior-free 机制,即机制不依赖估值分布先验。无政府代价(price of anarchy,PoA)衡量最优分配福利与最坏均衡福利的比值,越接近 1 越好。(§3.5,PDF p.9)
此前二价拍卖的紧 PoA 为 2,确定性机制在所讨论的设置中也无法突破 2。随机机制可以改进两人情形:已有结果约为 1.89,随后随机一价机制达到 1.8。
Cogentic 使用 $r$-Proportional First-Price Auction,记作 $\mathsf{pFPA}_r$。竞标者 $i$ 对查询 $j$ 出价 $b_{i,j}$,其获胜概率为
有竞争出价时,获胜者支付自己的出价 $b_{i,j}$;若没有竞争出价,则免费获胜。$r$ 控制分配对高出价的偏向程度。作为教学例子,两人分别出价 1、2 时,$r=1$ 给出 $1/3$、$2/3$ 的获胜概率;$r=4$ 给出 $1/17$、$16/17$。这个例子只说明机制的随机分配规则,不是 PoA 的证明或仿真结果。
Theorem 5 分为两项。
| 情形 | 机制与上界 | 必要解释 |
|---|---|---|
| $n=2$ | $\mathsf{pFPA}_1$,$\mathrm{PoA}\le1.5$ | 在作者限定的匿名机制类及附加假设下有匹配的 1.5 下界;Table 1 指出匿名、单调的范围 |
| 一般 $n\ge2$ | $\mathsf{pFPA}_{2n}$,$\mathrm{PoA}\le2-\frac1{4n+1}$ | 上界要求 undominated bids:满足 RoS 时,任何参与者都不能通过提高某次查询的出价进一步增加获胜量 |
来源:§3.5、Theorem 5,PDF p.9;Table 1,p.6。
一般 $n$ 的已有匿名机制下界在偶数 $n$ 上为
新上界与这个下界在“距离 2 的改善量”上都是 $\Theta(1/n)$,仅在常数上相差。两人结果是匹配的精确常数,一般 $n$ 结果则只匹配改善量的阶,二者的“最优”程度不同。$n\to\infty$ 时,这项福利保证逐渐接近 2。
还要区分两个参数选择:把 $n=2$ 代入通用机制得到的是 $r=4$、上界 $17/9\approx1.889$;1.5 的保证来自专门的 $r=1$。不能把两条定理合并成一个同时具有两种保证的机制。(代入计算为教学说明。)
作者说明,两人比例机制和 1.5 猜想在运行前已有;系统给出上、下界证明。多人机制与分析则由系统提出。本篇没有展开 PoA 的完整证明,参考文献中该伴随论文在 v1 时标为 forthcoming。(§3.5,PDF pp.9–10;References,p.11)
五、结论:可复用的设计与仍需回答的问题
Cogentic 的实质贡献,是把开放问题求解组织成一个能够积累中间成果的过程:多条证明路径保留搜索空间,对抗验证提供具体反驳,经过独立复核的引理构成下一轮的起点。五项数学结果说明这套工作流能够在专家提出的研究问题上产生新的界、算法或证明。
对研究智能体的设计,最值得吸收的有三点:
- 按用途组织记忆。 失败记录保留搜索经验,已验证账本保存可引用的数学内容,常驻指令保存流程改进;它们承担不同作用。
- 让验证覆盖多个范围。 单篇逐步检查、同轮比较、引理独立复核和终稿对照分别针对不同错误来源。
- 把部分成功转成后续资源。 整体证明失败时,仍可提取有明确假设和结论的有效片段,让下一轮站在更高的起点。
下一步系统研究最需要的是等预算比较与可审查的过程轨迹。例如删除账本是否显著降低解决率,跨证明验证是否减少漏错,某条关键引理在哪一轮进入账本并被后续复用。这些问题直接关系到该架构为何有效;本篇的成功案例尚未分离各模块贡献。
另一个实际瓶颈是专家阅读速度。作者指出,系统生成候选结果的速度可能超过人类理解速度;将证明转入 Lean 等工具可以增加机器核验能力,但理解证明为何成立、它启发了什么新问题,仍需要独立投入。(§4,PDF p.10)
原文与进一步阅读
下面的伴随论文按主论文参考文献列出;本笔记对五项成果的讲解以 Cogentic v1 的定理与证明概要为依据。
- Cogentic 主论文,2609.40324v1。
- Efficient Online Inverse Optimization with $O(d)$ Regret,2609.13440。
- The Power of Recruiting the Smaller Side: Two Additional Traders Suffice in Two-Sided Markets,2609.27304。
- Prediction with Expert Advice: Anytime Regret with Many Experts Matches the Fixed-Time Constant,2609.27206。
- Improved Revenue Guarantees for Selling Separately and Bundling,2609.28873。
- Efficiency of Generalized Proportional First-Price Auctions Under Auto-bidding:主论文 v1 的参考文献标为 forthcoming;作者项目页用于发布后续成果。