The Evolution of Attention in Large Language Models:中文研读笔记
题名:The Evolution of Attention in Large Language Models: Mechanisms, Trade-offs, and Emerging Trends
作者:Zhentao Tan、Jingyi Shen、Yanbo Li、Yao Liu、Yue Wu、Jieping Ye(Alibaba Token Hub, Alibaba Group)
版本:arXiv:2609.39661v1,2026-09-30;本次获取与研读日期:2026-10-04。
材料:arXiv 页面 · 原文 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码,本版本与印刷页码一致。
论文总览
这篇综述的核心贡献,是把高效注意力研究整理成一个关于上下文记忆如何保存、更新、访问和使用的设计问题。作者用五个分析维度——记忆表示(Memory Representation)、记忆更新(Memory Update)、访问(Access)、读出(Readout)、整合(Integration)——解释 Softmax Attention、Sparse Attention、Linear Attention、状态空间模型(SSM)和混合架构之间的关系。这里的记忆指当前序列产生的模型内部状态,包括 KV、摘要、记忆槽和递归状态;预训练参数与外部检索数据库不属于核心讨论范围。(Sec. 1–2,pp. 4–10)
理解全文可以抓住两条路径。显式记忆路径保留可枚举的内容单元,努力降低存储、索引和读取成本;递归状态路径把历史压入状态,努力改善更新规则、有效容量和可恢复性。两者越来越关注相同的功能,但仍保留不同的记忆接口。能够受完整历史影响,与能够单独找回某个历史 token,是两个不同的性质。
论文另有两组描述性证据:截至 2026-09-22 的 59 条发布级记录、14 个模型谱系,以及同日冻结的 11 个高性能开放权重模型端点。在可分类的 58 条记录中,32 条为单一主要机制,26 条为混合架构;混合记录的占比从 2024–2025 年的 9/25 上升到 2026 年的 17/27。作者据此讨论架构采用趋势,不进行统一预算下的机制性能排名。(Sec. 8,Tables 17–18,pp. 48–50;Table S1,pp. 57–58)
最终的研究假说是:未来可沿时间范围、网络深度、记忆载体、表示粒度共同组织持久记忆,并协调稀疏写入与稀疏读取。这个假说尚没有在本文中被实现和实验验证;它是机制梳理与架构观察共同引出的设计方向。(Sec. 9.3,pp. 53–55)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键定位 |
|---|---|---|
| 1 Introduction | 说明成本、分类范围、文献与架构样本口径 | 4–6;Table 1 |
| 2 A Unified Memory-Centric View of Attention | 定义五个功能维度,区分历史覆盖与可寻址性 | 6–10;Fig. 1,Eqs. (1)–(5),Tables 2–3 |
| 3 Softmax Attention | 头/通道/层压缩、时间压缩、读出与输出调节 | 10–15;Fig. 2,Eq. (7) |
| 4 Sparse Attention | 结构、自路由、独立索引,以及时间/跨层复用 | 15–26;Figs. 3–7,Eqs. (8)–(37) |
| 5 Linear Attention | 状态编辑、容量扩展、时间扩展与协调 | 26–36;Tables 4–10,Fig. 8 |
| 6 State Space Models | 时不变/选择性动力学、SSD、读写接口 | 36–42;Figs. 9–12,Eqs. (55)–(59) |
| 7 Hybrid Architecture: Composing Heterogeneous Memory Mechanisms | 层、头、分支、token 四种组合粒度 | 42–48;Fig. 13,Tables 13–16 |
| 8 Attention Designs in Publicly Documented LLM Architectures: Evolution, Coordination, and Frontier Adoption | 纵向架构盘点与冻结端点比较 | 48–51;Fig. 14,Tables 17–18 |
| 9 Synthesis Across Mechanisms, Architectures, and Future Directions | 机制综合、深度方向的记忆管理、多维路由假说 | 51–55;Fig. 15,Eqs. (68)–(70) |
| 10 Conclusion | 汇总记忆组织与质量—成本取舍 | 55–56 |
| A Supplementary Materials: Publicly Documented Architecture Inventory | 发布记录、谱系、架构分类与原始来源映射 | 57–58;Table S1 |
一:动机——先看清成本究竟发生在哪里
密集因果注意力让当前位置直接比较历史 token,支持细粒度、查询相关的信息检索。代价主要落在三个位置:预填充时的二次交互数,解码时随历史长度增长的 KV 存储与搬运,以及候选增加后对有效检索的干扰。标称上下文窗口扩大,并不自动使远距离证据更容易被利用。(Sec. 1,p. 4;Sec. 4,p. 15)
在固定层宽下,密集注意力对长为 $L$ 的序列需要约 $O(L^2d)$ 的注意力计算;单步解码约为 $O(Ld)$。内存友好的执行内核可以减少中间矩阵物化,却保留同样的查询—键交互。架构修改则可能改变记忆本身或查询可读取的对象。两者解决的成本层面不同。
只按“是否线性复杂度”分类,容易遗漏重要问题:GQA 与 MLA 是否保留 token 身份?稀疏路由是否仍扫描全部索引?固定状态是否需要昂贵更新?少量全局层是否仍保留随长度增长的缓存?五维框架的价值,就是使这些问题可以分别表述和比较。
二:方法——用五维框架读懂四类机制及其组合
2.1 五个维度与两个最重要的边界
| 维度 | 要回答的问题 | 典型干预 |
|---|---|---|
| 表示 Representation | 历史以什么单位、容量、粒度存在? | token KV、低秩 latent、记忆槽、关联矩阵 |
| 更新 Update | 新信息如何进入、替换或修正记忆? | 追加、衰减、Delta 修正、合并摘要 |
| 访问 Access | 当前查询允许读取哪些已有单位? | 因果集合、局部窗口、Top-k、选中状态行 |
| 读出 Readout | 如何从允许的对象提取上下文? | 候选内 Softmax、状态收缩、SSM 投影 |
| 整合 Integration | 已形成的读出怎样变成模块输出? | 拼接投影、门控、异构分支融合 |
作者用记忆模式 $\rho$ 指定表示的类型与组织。$x_t$ 为当前位置输入,$q_t$ 为查询;$\mathcal M_t^-$、$\mathcal M_t^+$ 分别表示更新前后记忆;$\widehat{\mathcal M}_t$ 为实际读路径可见的记忆;$\mathcal C_t$ 为可参与读取的视图;$r_t$ 为读出,$o_t$ 为模块输出:
这是原文 Eqs. (1)–(5) 的功能记号(pp. 7–8),不规定必须先更新再读,也不要求五个独立实现模块。修改一个操作可能同时影响多个维度。
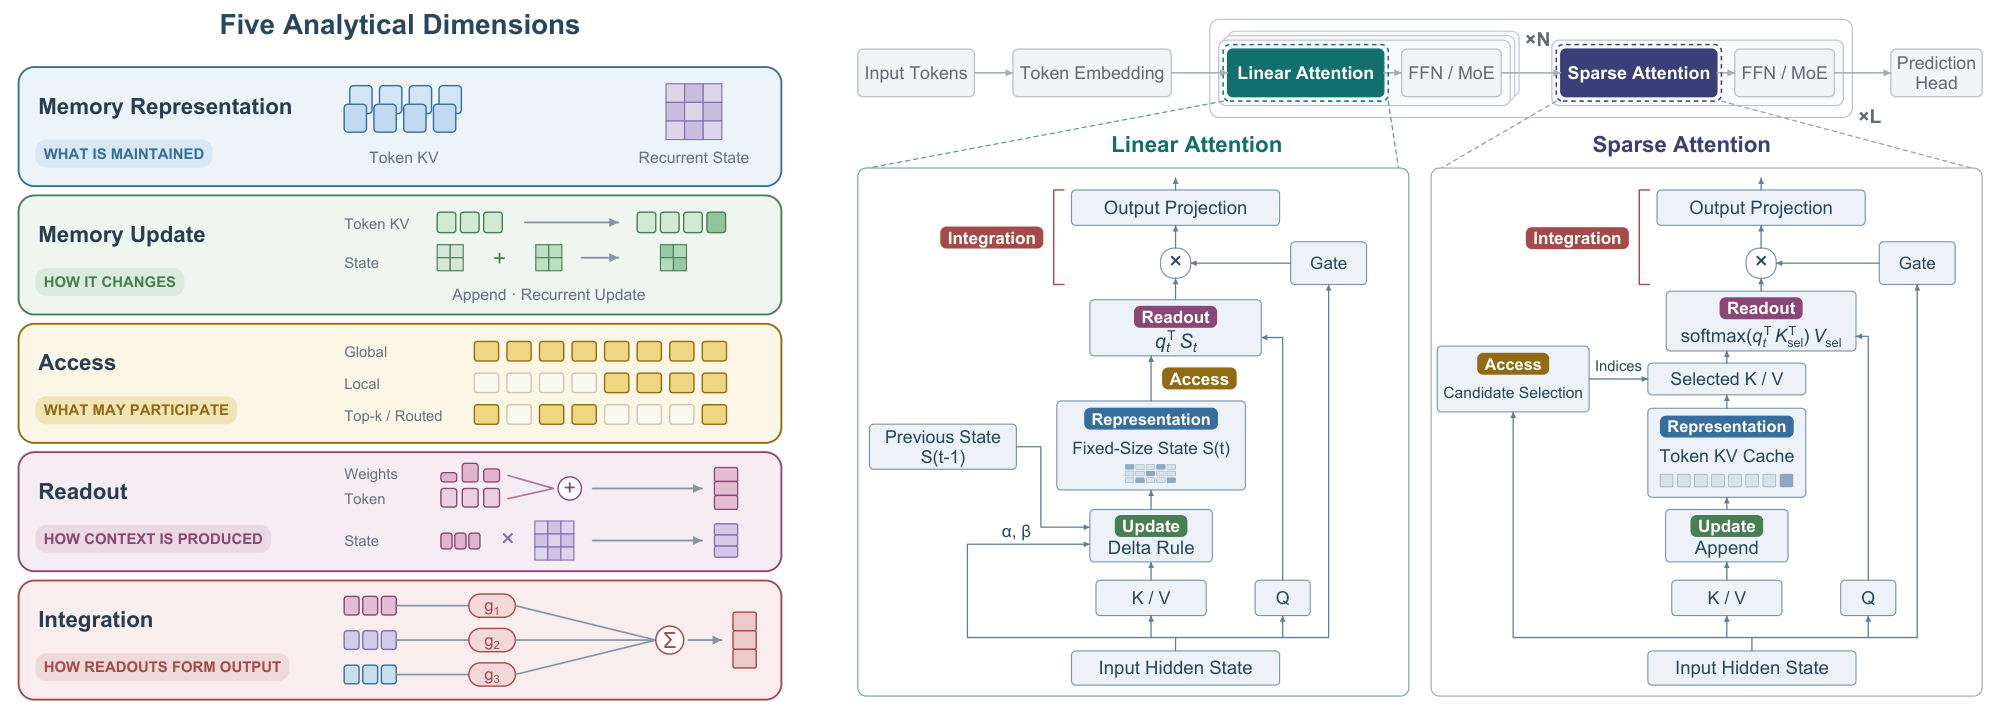
原文 Fig. 1,p. 7。左侧定义五种功能;右侧把它们映射到线性状态与稀疏 KV 两种模块。线性模块通过状态收缩读取压缩历史,稀疏模块先筛选候选再做 Softmax;两者最后都可能门控和投影。
边界一:历史覆盖与可寻址性。 一个固定矩阵可以承载全部历史的影响,但通常不能提供“第 1000 个 token 的独立 KV”。相反,完整 KV 缓存保留逐 token 可寻址性,同时随 token 数增长。固定数量的显式记忆槽也可枚举,却已不对应每个原始 token。
边界二:候选选择、权重计算与输出门控。 Top-k 删除候选属于 Access;对同一候选集合改变分数或归一化属于 Readout;读出完成后乘一个门属于 Integration。门接近零只有在执行前使相关运算被跳过,才可能省去相应计算和 KV 读取。(Sec. 2.1、3.3,pp. 8–9、14)
章节家族与功能维度并不一一对应。稀疏注意力通常仍用 Softmax 读出,SSM 与线性注意力有递归形式上的交集,混合架构则描述组合方式。Table 3 的 P/S 是作者对主要设计关注点的定性标记,不是文献频数或互斥分类。(Sec. 2.2,pp. 9–10)
2.2 Softmax:压缩哪个轴,决定保留什么信息
标准单头读出为:
$\mathcal R_t$ 是当前可访问的记忆位置,$h$ 是头编号,$d_h$ 是头维度;这里的局部记号 $o_{t,h}$ 是头读出,后续还要做多头整合。(Eq. (6),p. 10)
头、通道、深度三个轴
对于批量 $B$、缓存长度 $T$、独立产生 KV 的层数 $L_{\mathrm{KV}}$、KV 头数 $H_{\mathrm{KV}}$、每标量 $s$ 字节,标准缓存大小为:
系数 2 对应 K 与 V;公式假定二者头维度相同。(Eq. (7),p. 11)
| 方法 | 修改的量或结构 | 保留的能力与主要取舍 |
|---|---|---|
| MHA | 每个查询头有独立 KV,$H_{\mathrm{KV}}=H_q$ | 头专属表示充分,缓存重复多 |
| MQA | 所有查询头共享一组 KV,$H_{\mathrm{KV}}=1$ | 减少重复与带宽,KV 表示自由度降低 |
| GQA | 每组查询头共享 KV | 在 MHA 与 MQA 之间选择容量 |
| MLA | 每 token 缓存紧凑 KV latent 与位置分量 | 降低通道负担,收益依赖 latent 宽度、投影吸收与内核 |
| CLA | 后续层复用来源层的 KV | 减少独立 KV 层,消费者仍计算自己的查询与注意力 |
MLA 的关键不只是对已生成的缓存做低秩近似。它把 KV 投影设计成共同的降维和按头上投影,并将适当矩阵吸收到查询/输出路径。RoPE 会妨碍内容键上投影的直接吸收,因此要拆分内容与位置部分。TransMLA 关注已有 GQA 检查点向这种结构的转换与继续训练。(Sec. 3.1.2,p. 12)
教学算例,非论文实验。 取 $B=1,T=32768,L_{\mathrm{KV}}=32,d_h=128,s=2$,32 个 KV 头对应 16 GiB;8 个 KV 头的 GQA 对应 4 GiB;MQA 对应 0.5 GiB。若 GQA 再每 4 层共享一次 KV,缓存为 1 GiB。这里仅计算上述公式中的 KV,不含权重、临时空间和元数据。头/层共享改变增长系数,长度翻倍仍使缓存翻倍。
沿时间压缩:哪些细节在未来查询之前就被合并
Sec. 3.2(pp. 12–14)区分两类表示策略。固定容量记忆把历史反复写入有限状态:RMT 用段间读写 memory tokens;TransformerFAM 用块间反馈 latent;Trellis 与 Lattice 使用可被注意力读取的 KV 槽,并设计遗忘或优化式更新。原始 token 一旦并入槽或 latent,便不再作为独立条目保留。
动态分辨率记忆则保留近期细节,把较远历史换成粗粒度摘要。KSA 结合局部 Sliding Chunk Attention 与远程摘要;HCA Core 对高度压缩的全局条目做密集 Softmax。这里“密集”指读取全部压缩条目,并不表示保留全部原始 token。压缩后的远程条目数量仍可能随历史增加,因此要区分固定容量和较慢增长。
改读出或整合:选择性增强不自动缩小缓存
Talking-Heads 与 DCMHA 在头之间混合 Softmax 前后的分数/权重;Differential Attention 相减两张 Softmax 图,最终有效权重可为负;FoX 将依赖输入的遗忘放进分数路径。这些主要影响 Readout。MoH 路由头的输出贡献,Gated Attention 在头读出后施加 sigmoid 门,主要影响 Integration。它们可与 GQA、MLA 或稀疏读取组合,但单凭权重集中或输出归零,不能推导出执行量减少。(Sec. 3.3,p. 14)
2.3 Sparse Attention:内容记忆、地址记忆与候选生命周期
稀疏注意力通常先由证据 $e_{t,:}^{(\ell)}$ 在层 $\ell$ 的可寻址单位 $\mathcal U_t^{(\ell)}$ 中选择预算为 $b_t$ 的集合,再读取其内容:
$\mathcal I_t$ 可以按 token、页、块或压缩条目组织。上式是 Eqs. (8)–(9)(p. 15);候选内的 Softmax 仍是精确计算,但候选本身经过筛选。
结构约束:训练前定义与训练后发现
Longformer/BigBird 以局部、全局及随机连接组织图结构;Sparse Transformer 与 LongNet 使用跨距或多尺度稀疏连接。训练时就采用这些约束,参数能适应部署时的访问范围,代价是内容适应性受预定拓扑限制。因果全局位置仍须遵守不能读取未来的规则。(Sec. 4.1.1,pp. 16–17)
StreamingLLM、LM-Infinite 从已训练模型的行为出发,保留起始位置与近期窗口;MInference 先离线确定每头的模式家族,再按当前 Q/K 实例化部分位置。它们便于改造已有模型,但需要面对训练时密集、推理时删边造成的计算变化。保留 sink 和近期窗口不会恢复任意中间位置的历史证据。(Sec. 4.1.2,p. 17)
自路由:让主干表示同时承担检索线索
Reformer 的哈希分组、Routing Transformer 的聚类,把表示相近但位置可能很远的 token 放进同一组。平衡分组时,后者的成本约为 $O(LGd+L^2d/G)$,取 $G\approx\sqrt L$ 得到 $O(L^{3/2}d)$;排序、均衡和不规则 gather 仍有代价。(Sec. 4.2.1,p. 18)
块路由把物理读取单位改成连续块。Quest/XAttention 根据已有模型估计页/块相关性;MoBA 则用主干 key 的块均值 $\bar k_u$ 计算 $e_{t,u}=q_t\bar k_u^\top$,选择历史 Top-k 块并保留当前块,再对选中块的原始 token KV 做 Softmax。其块评分与最终 token 评分有相同表示空间,稀疏训练能共同适应这一接口。FlashMoBA 进一步优化 Top-k 与 gather 的执行。(Eqs. (14)–(17),p. 19)
NSA 的压缩分支既是可读取内容,也产生细粒度选择的证据。压缩概率先按选择块聚合,再在共享 KV 的查询头间求和,选择块级 Top-n;最终把压缩、选中原始块、滑动窗口三条路径的输出通过输入相关门组合。它同时涉及表示、访问和整合。(Sec. 4.2.2,pp. 19–20)
Landmark Attention、SSA 与 HiLS 将摘要 token 放入序列。HiLS 特别能说明 Access 与 Readout 的区别。它近似块 $u$ 的未归一化注意力质量:
$\alpha_{u,j}$ 由块内 landmark query 与该块 key 的 Softmax 产生。选中块后,块内仍计算准确的 token 权重,但跨块概率质量使用 $\widehat Z_{t,u}=e^{\widehat s_{t,u}}$ 分配:
其中 $c(j)$ 为 token 所在块,局部窗口使用准确质量 $Z_{t,\mathrm{loc}}$。摘要分数进入连续读出权重,使语言模型损失可以训练它,而非只影响不可微的离散选择。(Eqs. (23)–(28),p. 20)
补充推导。 对任意概率分布 $\alpha$,有 $\sum_j\alpha_js_j+H(\alpha)\leq\log\sum_je^{s_j}$。因此,上述摘要打分可理解为当前 query 的块 LogSumExp 的变分下界;当摘要的 $\alpha$ 接近当前 query 对块内 token 的分布时更准确。这解释了单一块摘要同时服务很多不同 query 时的表示压力。
独立索引:聚合发生在打分前还是打分后
独立代理路由使用单独参数形成 index query/key。地址记忆负责快速判断去哪里找,内容记忆保存最终读取的 KV。地址压缩与内容压缩应分开核算。(Sec. 4.3,pp. 21–24)
| 机制 | 打分时扫描什么 | 最终选择单位 | 最终读出的内容 | 关键区别 |
|---|---|---|---|---|
| DSA | 每个历史 token 的 index key | token,所有主注意力头共享集合 | 原 token 的 MLA 内容 | 融合多个索引头的分数 |
| MSA | 每个历史 token 的 index key | 块,按 GQA 组独立选择 | 原始 token KV | 先 token 打分,再块内 max-pool |
| QSA | 先平均池化得到的微块 index key | 微块,共享选择后展开 | 原始 token KV | 池化在打分前,缩短索引扫描 |
| CSA | 压缩 index key | 压缩内容条目,配合局部窗口 | 压缩全局内容与局部原始 KV | 地址和内容都被压缩 |
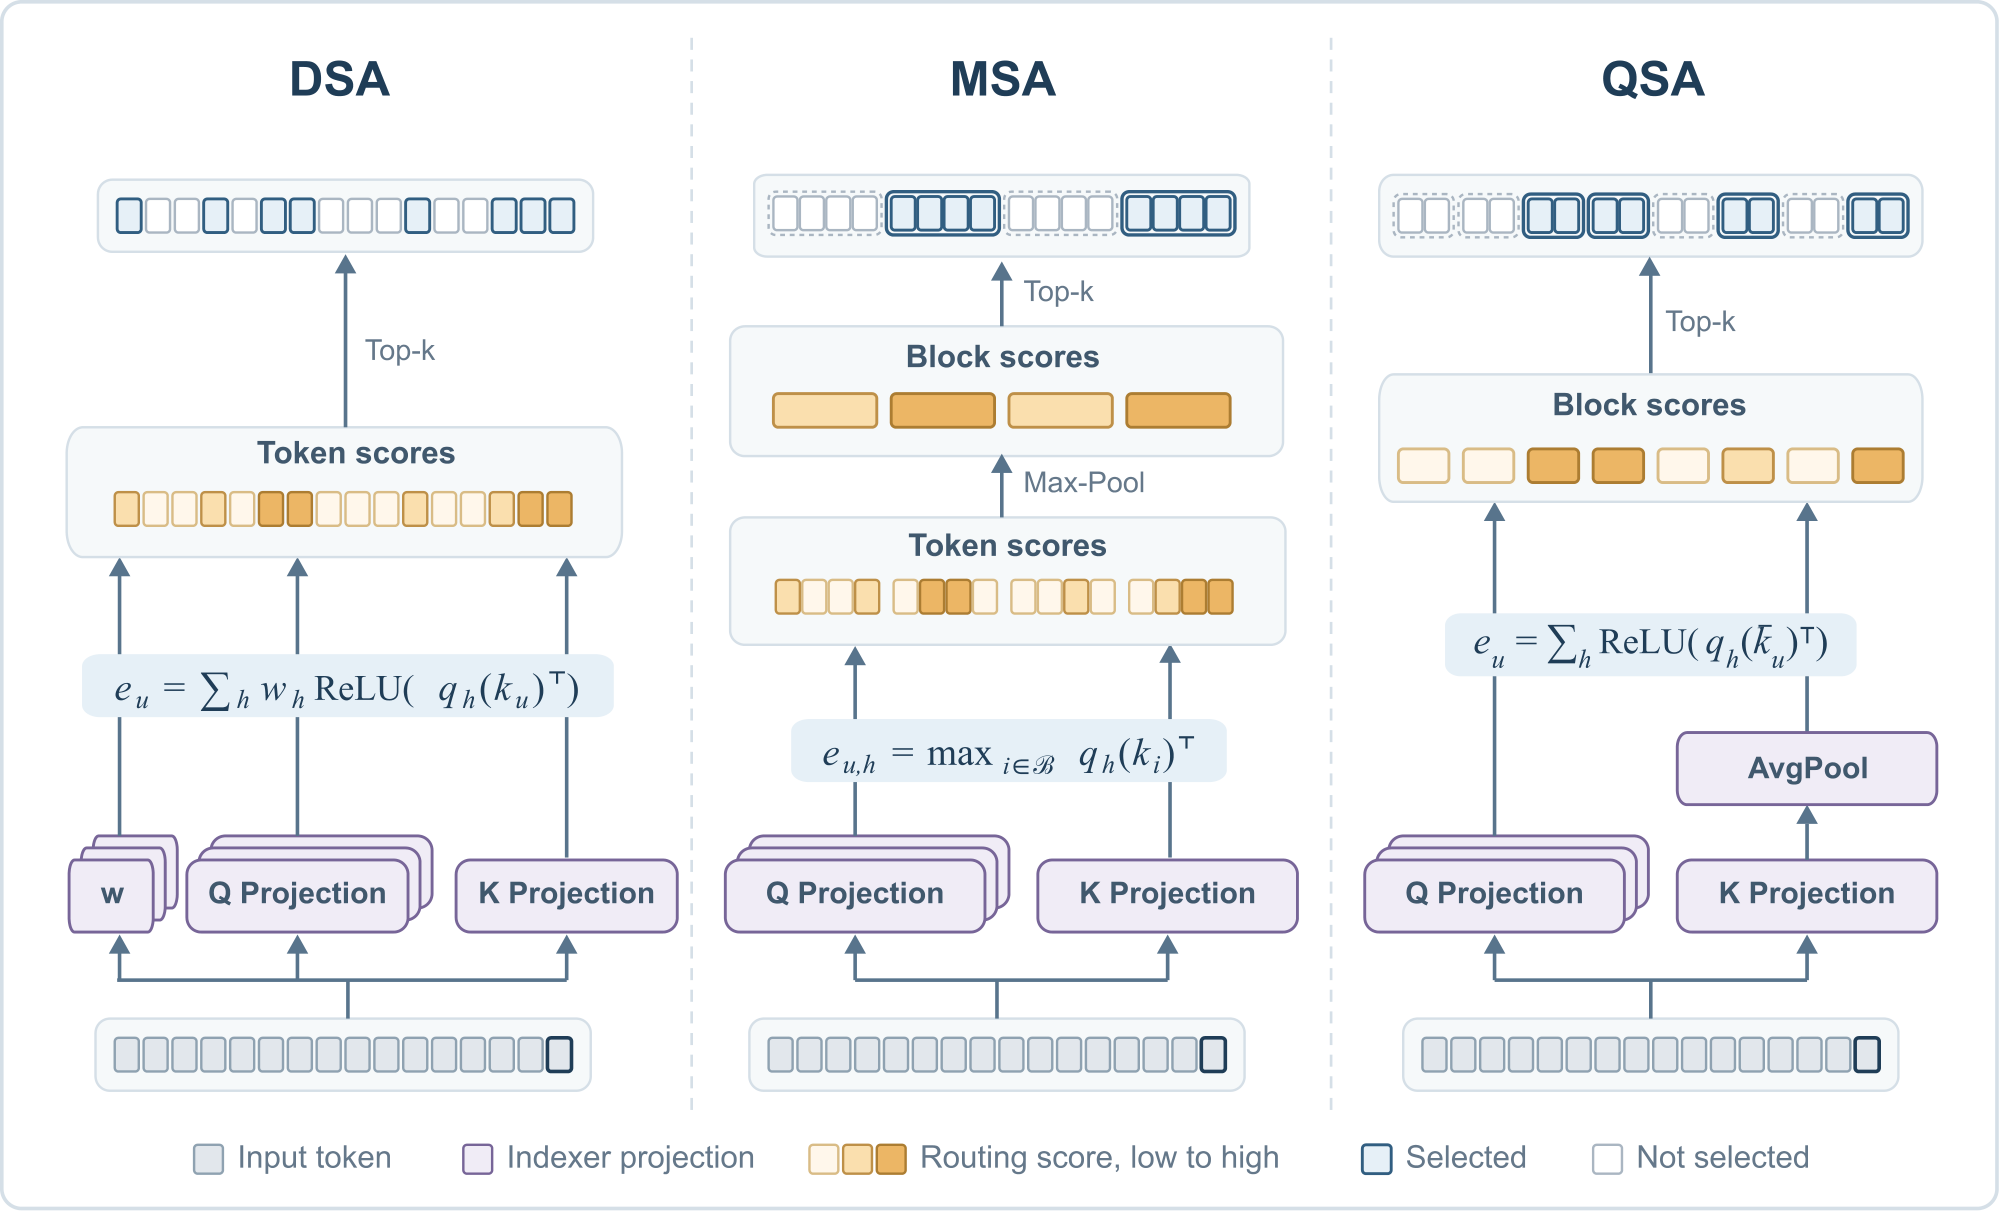
原文 Fig. 7,p. 23。沿每列自下向上看:DSA 融合索引头分数;MSA 对 token 分数取块内最大值;QSA 先平均池化索引 key 再计算分数。图内公式经过简化,完整定义见 Eqs. (29)–(31),pp. 21–23。
DSA 的完整评分是 $e^I_{t,u}=\sum_h w^I_{t,h}\operatorname{ReLU}(q^I_{t,h}(k^I_u)^\top)$。索引先经密集注意力分布蒸馏,再随主干适应稀疏支持;索引输入使用 stop-gradient,使索引主要由 KL 目标训练,主干由语言建模目标训练。其分数只用于候选选择,不进入最终 Softmax。MSA 也采用类似分阶段监督,但每个索引头服务一个 GQA 组。QSA 在打分前压缩索引序列,仅评分完整微块,当前未完整块的 token 另行保留。(Sec. 4.3.1–4.3.2,pp. 21–23)
最容易误读的一点:块级选择不等于块级扫描。 MSA 依然逐 token 计算索引分数;QSA 才通过先池化 key 缩短扫描长度。QSA 保留原始内容,而 CSA 的历史细节已经被合并。二进制索引也只是降低每个地址的比较/存储成本,未自动减少地址数量。SeerAttention 等冻结主干的插件训练,还应与原生稀疏训练区分。(pp. 22–24)
时间与深度复用:分别刷新内容、地址和候选集合
ReTopK 根据当前 query 与缓存 query 的相似度召回若干历史候选集合,加上近期窗口,再用当前 query 重新打分和选择。复用的是候选身份,当前注意力权重仍重新计算;相似度不足时回退全历史精确 Top-k,并周期刷新,防止误差积累。(Eqs. (33)–(35),pp. 24–25)
跨层复用可共享不同对象。TidalDecode、Kascade 与 IndexCache 主要共享选中索引。IndexCache 的 Full 层运行索引器,Shared 层继承前一个 Full 层的选择;这里 Full 指索引完整扫描,不等同于主注意力读取所有 token。各层仍可有自己的 KV。YOIO/CLSA 进一步让下游层共享 KV 和一次路由决定。(Sec. 4.4.2,p. 25)
CSA2 将内容刷新与候选刷新拆开:
| 模式 | 全局 KV / index key | 候选索引 | 仍需计算 |
|---|---|---|---|
| Full | 重新产生 | 完整索引扫描、生成新 Top-k | 本层主查询与局部窗口 KV |
| Reindex | 复用最近 Full 层 | 用本层索引查询在共享候选池中重新选 | 本层主查询与局部窗口 KV |
| Reuse | 复用 | 继承最近产生的候选集合 | 本层主查询与局部窗口 KV |
解码时,第一个 Full 层还生成供后续 Reindex 层使用的较大候选池。HySparse/HySparse2 也复用全局 KV 与选择线索;HySparse2 将近期窗口并入同一稀疏 token 集合,减少分支分离。复用越远,对跨层表示兼容性与及时刷新的要求越高。(Eq. (37),pp. 25–26)
本次分析可将稀疏系统的单步成本写成一个记账式:证据构造 + 索引扫描 + Top-k + KV gather + 候选内读出 + 刷新摊销。这不是论文新增的复杂度定理,而是对 Sec. 4 各类开销的归纳;只统计最后的稀疏矩阵乘法,会遗漏决定速度的部分。
2.4 Linear Attention:有限状态中的关联写入与修正
若核相似度可分解为 $K(q_t,k_i)=\phi(q_t)^\top\phi(k_i)$,令 $\phi(k_t)\in\mathbb R^{d_k}$、$v_t\in\mathbb R^{d_v}$,可累积:
其中 $S_t\in\mathbb R^{d_k\times d_v}$,$z_t\in\mathbb R^{d_k}$,帽号表示实际可读的更新前/后状态。归一化形式要求特征映射使分母有适当定义;后续方法可能采用无归一化收缩、输出归一化和门控。固定维度的单状态解码不需要增长的 token KV,训练则可用并行或分块形式计算同一递归。(Eqs. (38)–(39),p. 27)
更新规则的主线:保留、擦除、写入
作者用 $\bar S_{t-1}=\alpha_t\odot S_{t-1}$、$S_t=\bar S_{t-1}-E_t+W_t$ 分析更新角色,随后在 Table 7(p. 31)统一各方法的状态朝向。下表省略各方法的特征生成、归一化与输出门;$k_t,v_t$ 为递归实际使用的向量,$D_t=\operatorname{Diag}(\alpha_t)$。
| 方法 | 核心递归 | 新增的控制能力 |
|---|---|---|
| Linear Transformer | $S_t=S_{t-1}+k_tv_t^\top$ | 直接叠加关联 |
| RetNet | $S_t=\alpha^hS_{t-1}+k_tv_t^\top$ | 每头固定时间尺度 |
| GLA | $S_t=D_tS_{t-1}+k_tv_t^\top$ | 输入相关的通道遗忘 |
| DeltaNet | $S_t=(I-\beta_tk_tk_t^\top)S_{t-1}+\beta_tk_tv_t^\top$ | 在当前地址纠正旧预测 |
| GDN | $S_t=\alpha_t(I-\beta_tk_tk_t^\top)S_{t-1}+\beta_tk_tv_t^\top$ | 标量遗忘后做 Delta 修正 |
| KDA | $S_t=(I-\beta_tk_tk_t^\top)D_tS_{t-1}+\beta_tk_tv_t^\top$ | 通道遗忘后做 Delta 修正 |
遗忘控制历史整体或通道的保留速度;Delta 修正针对当前 key 所指向的旧关联。HGRN2 进一步让遗忘下界随深度增加,并把写入地址与 $1-\alpha_t$ 相连,使不同层具有不同保留尺度。DeltaProduct 则在一个 token 内依次执行多次 Delta 变换。(Sec. 5.1,pp. 27–31)
擦除的一般形式为 $E_t=U_t^e((R_t^e)^\top X_{t-1}^e)$:$R_t^e$ 决定从状态读什么,$U_t^e$ 决定沿什么方向修改。DeltaNet 的两个方向对齐于同一个 $k_t$;GDN2 用 $b_t\odot k_t$ 读取待擦内容,用 $k_t$ 修改状态,并以 value 侧门 $w_t$ 独立控制写入:
EDA 先沿独立方向 $e_t$ 擦除,再沿 $k_t$ 修正:
两个顺序操作展开后总擦除项的秩至多为 2。RWKV-7 则以归一化 removal key 读取旧关联,使用通道 removal rate 改变移除方向,再由独立 add key 写入。它的擦除源是 $S_{t-1}$,与在已衰减状态上擦除的 GDN2/EDA 有所区别。(Eqs. (42)–(50)、Table 7,pp. 28–31)
顺序很重要。 标量 $\alpha_t I$ 与 Delta 矩阵可交换,而一般通道矩阵 $D_t$ 不可交换。把 KDA 的“先通道遗忘、后修正”随意调序,会改变递归本身。
用在线优化理解 Delta 写入
Table 8(p. 31)给出综述整理的等价逐 token 目标。对 DeltaNet:
对状态做单位步长梯度更新,就得到 Delta 递归:写入量由“当前目标减去已有预测”的残差决定。相比之下,直接加法对应相关性目标 $-\langle S^\top k_t,v_t\rangle$,不检查当前地址已经预测了什么。GDN/KDA 在衰减后的状态上优化同一个重构目标;EDA 先在擦除地址拟合零,再在写地址拟合当前 value。这是对内部状态更新的等价解释,不是推理时对全部预训练权重执行梯度下降。(Sec. 5.1.5,pp. 30–32)
教学例子。 令 $k=(1,0)^\top$、$S_0=0$、标量 value 先为 1 后为 3,且 $\beta=1$。直接加法在同一地址最终读出 4;Delta 更新先读出 1,再按残差 $3-1$ 修正,最终读出 3。在单位范数 key 上,Delta 可以替换当前关联;不同 key 重叠时,修正仍可能干扰其他关联。因此更好的更新不等于无限容量。
扩容量与扩时间是两个不同方向
SSE 和 SDM 增加状态行,使总容量可以增长而每次只激活少量区域。SSE 保留固定分组,先选组再在组内读写,结构规则但组边界可能阻止有用行参与;SDM 使用扁平记忆表与独立 Product-Key Memory 读写路由,写入行接受 Delta 更新,未选行维持旧内容。独立路由更灵活,也可能出现“常写不读”“常读但未获得合适写入”的错配。稀疏激活控制每步操作量,全部持久状态仍需存储。(Sec. 5.2,pp. 32–33;Table 9)
时间扩展则将不同历史区间保存在不同状态 $S_t^{(m)}$,读出后再按 $\lambda_{t,m}$ 整合:
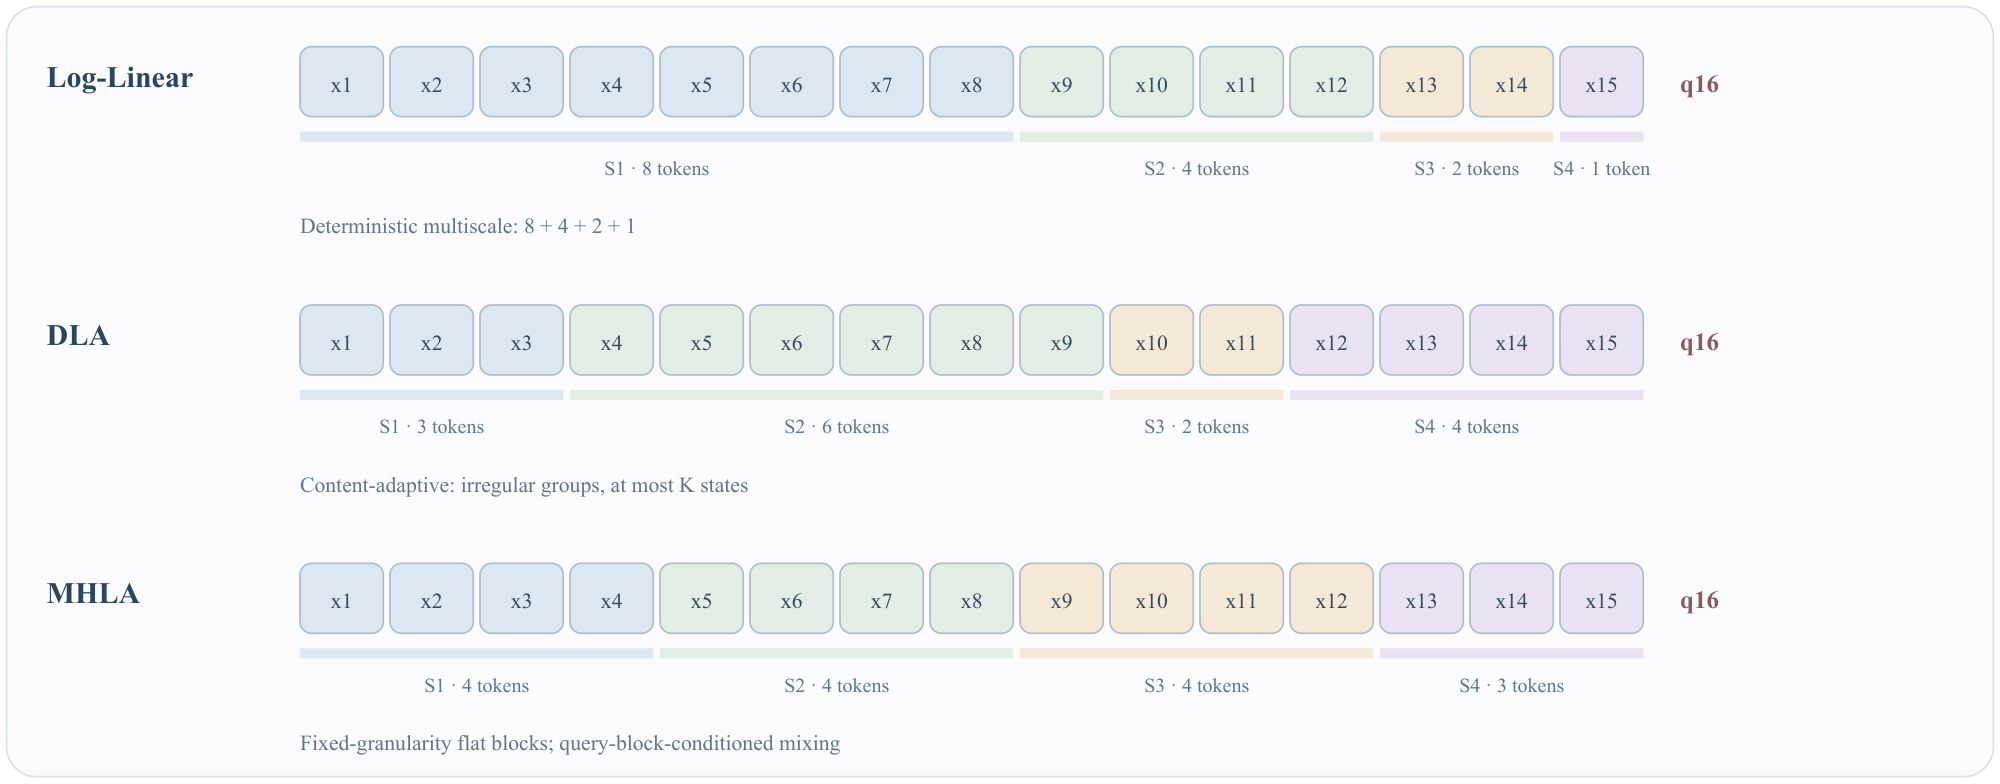
原文 Fig. 8,p. 34。横向是历史 token,三行对应不同分段政策;图中的 8+4+2+1 是位置驱动的多尺度示意,非实验曲线。
| 方法 | 时间组织 | 状态数量与取舍 |
|---|---|---|
| Log-Linear Attention | Fenwick / 二进制进位式合并 | $M_t=O(\log t)$;近期细、远期粗,固定边界可能跨语义段 |
| DLA | 用 State Information Score 建段,预算满后合并相邻低信息段 | $M_t\leq K$;内容自适应,依赖分段与合并质量 |
| MHLA | 保留固定粒度块摘要,由 query block 混合 | 随保留块数增长;没有内建的固定容量保证 |
因此,“线性注意力都只保留一个固定大小状态”只适用于其典型单状态形式,不能直接套到所有扩展。(Sec. 5.3,Eqs. (53)–(54)、Table 10,pp. 33–35)
Sec. 5.4(pp. 35–36)讨论另外两个协调方向:SLA 通过 key 侧门分配跨头写入、query 侧门整合头输出;连续门不自动构成跳过头计算的稀疏访问。CLVR 则把当前写入相关的内部 value 信号经残差流传给后续层,保留宿主递归。由于该信号未必是完整读出,不能机械归入标准的读出后 Integration,也不等同于共享跨层持久状态。
2.5 SSM:控制状态动力学,再控制状态的读写接口
时不变离散 SSM 的核心为:
其中 $x_t\in\mathbb R^m,h_t\in\mathbb R^n,r_t\in\mathbb R^p$,因此 $\bar A\in\mathbb R^{n\times n}$、$\bar B\in\mathbb R^{n\times m}$、$C\in\mathbb R^{p\times n}$。当 $h_0=0$ 且算子时不变时:
系数只依赖时间差,因而既有卷积视图,也有递归视图。HiPPO 提供按给定历史测度维护多项式近似系数的基础;S4 使用结构化转移实现高效核计算,S4D 简化为对角结构,S5 采用联合 MIMO 状态与并行 scan。scan 利用仿射状态变换的可结合复合,转移结构决定复合成本。(Eqs. (55)–(56),p. 37)
Mamba 让步长 $\Delta_t$、写入参数 $B_t$ 和读出参数 $C_t$ 随输入变化,$\bar A_t=\exp(\Delta_t A)$。推理时变化的是状态与输入生成的控制量,生成控制量的网络权重固定。一般选择性递归不再由单一、仅依赖 lag 的卷积描述,因而使用 selective scan。(Sec. 6.1.2,p. 38)
Mamba-2 的结构化状态空间对偶(SSD)使用头内标量转移。令 $H_t\in\mathbb R^{N\times P}$、$b_t,c_t\in\mathbb R^N$、$u_t\in\mathbb R^P$:
当前读方向与历史写方向的匹配,乘上中间时间步的衰减,就构成一个下三角“注意力式”系数矩阵。这个系数没有 Softmax 概率归一化;它揭示特定 SSM 与关联递归的计算联系。(Eqs. (57)–(58),pp. 38–39)
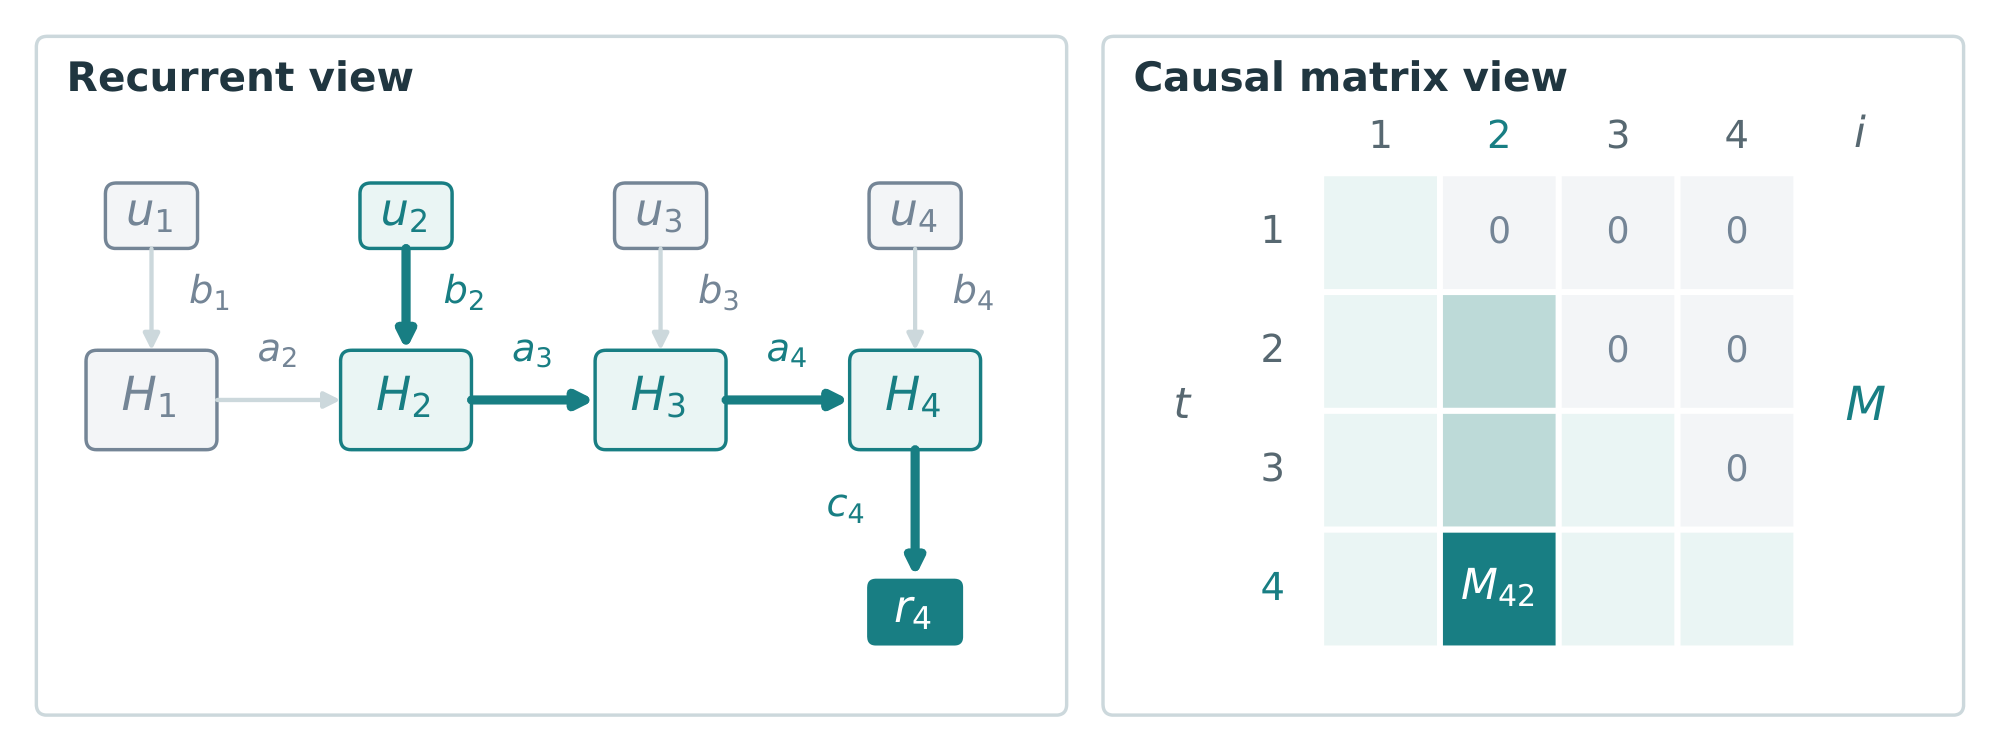
原文 Fig. 11,p. 39。左侧高亮 $u_2$ 经 $b_2$ 写入、$a_3a_4$ 传播、$c_4$ 读取的路径;右侧高亮同一贡献对应的矩阵元素 $M_{42}=(c_4^\top b_2)a_3a_4$。读出位于行、源输入位于列。
固定头数和 $N,P$ 时,SSD 的状态量与单步解码核心工作不随上下文长度增长;增加状态维度仍会增加存储与运算。训练的块计算和解码的递归是同一核的不同执行方式。(Table 11,p. 39)
Sec. 6.2(pp. 40–41)进一步区分状态有多大与每次有多少读写方向。Mamba-3 MIMO 可用 $C_t^{\mathrm{multi}}\in\mathbb R^{N\times R}$ 对同一状态进行多方向读取:$Y_t=H_t^\top C_t^{\mathrm{multi}}\in\mathbb R^{P\times R}$,直接乘法成本与 $NPR$ 成正比。更多端口能提供同一状态的更多视图,无法找回状态已经丢失的信息。MIMOMamba 则用共享基矩阵生成的多项式代数建立矩阵值对偶,机制与增加读写方向不同。HADES 组织共享/专家时间滤波分量,MuonSSM 以动量和轻量正交化处理注入方向,分别改进头的时间角色与更新几何。
2.6 Hybrid:组合发生在哪里,决定哪些功能被协调
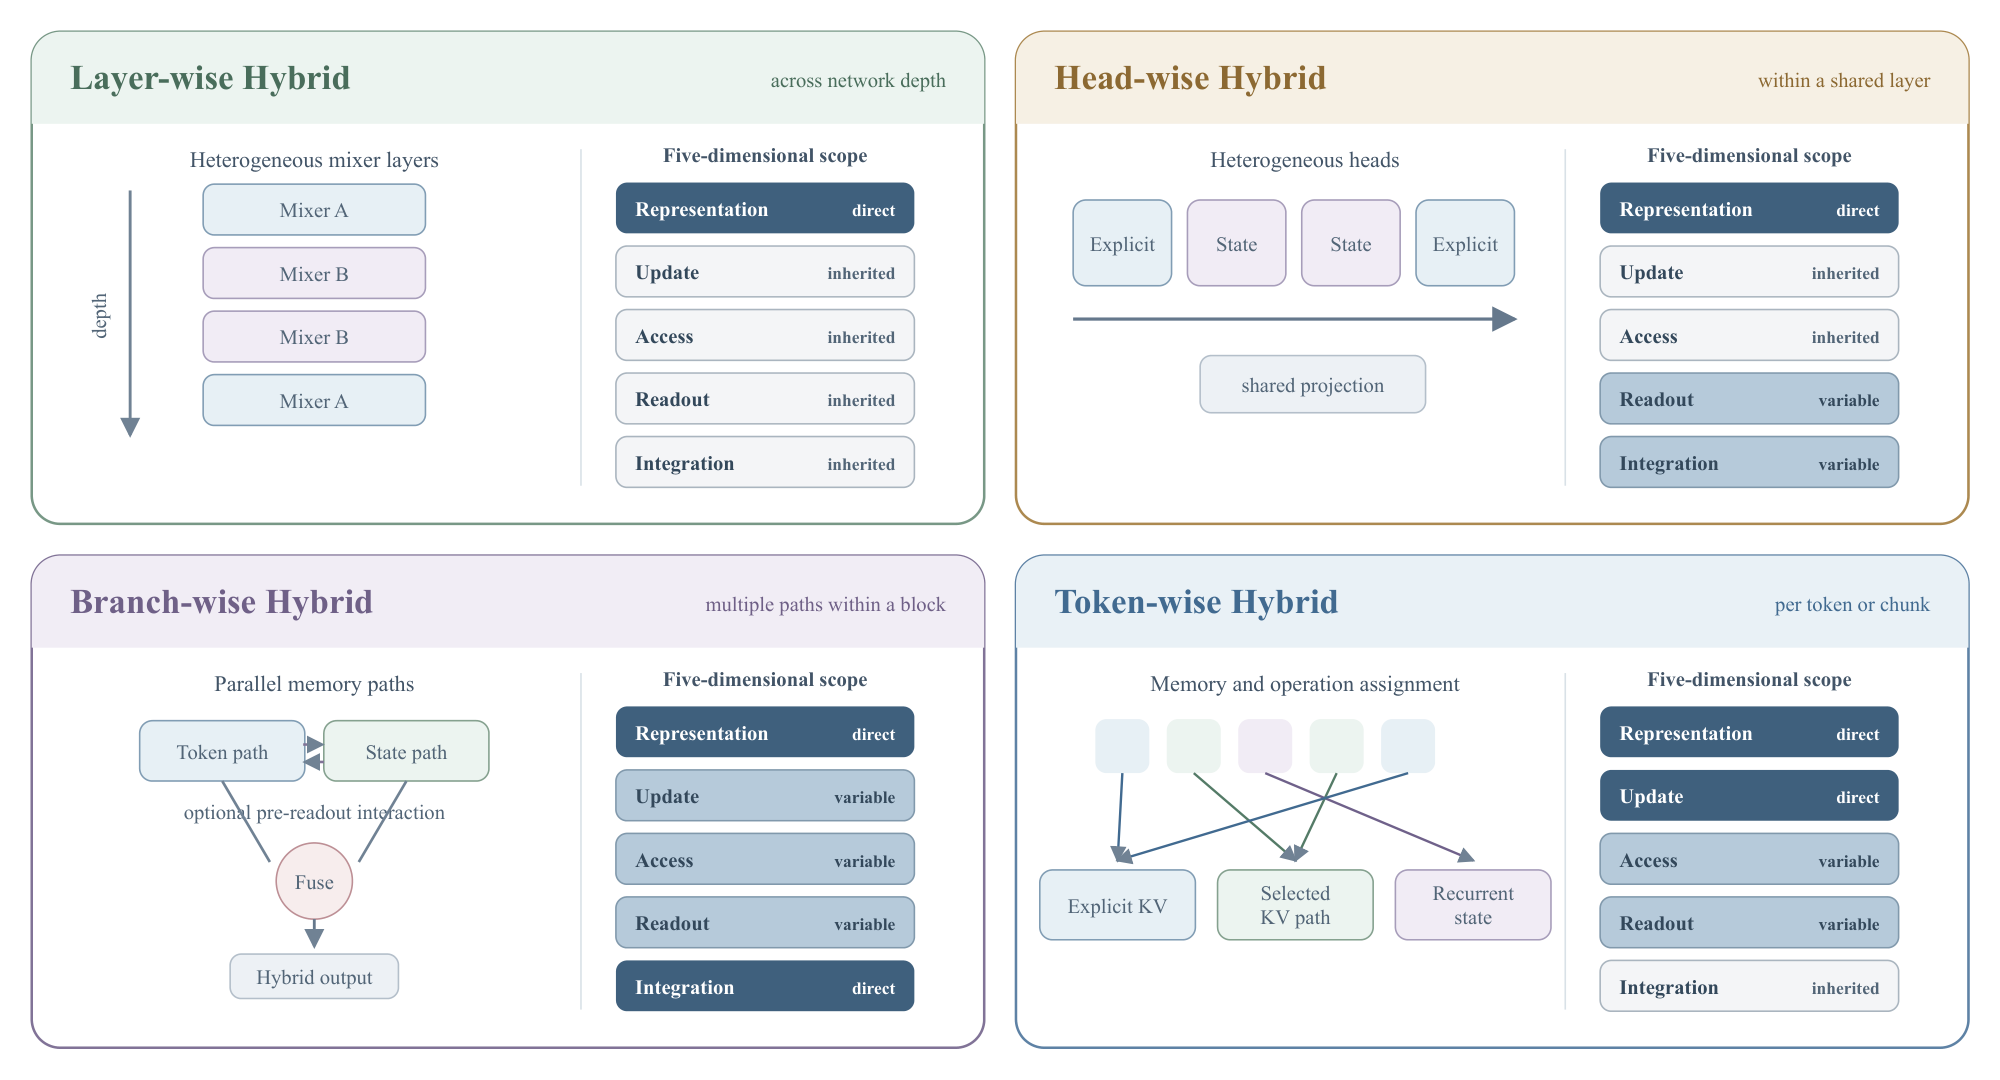
原文 Fig. 13,p. 43。四个面板分别沿层、头、分支、token 分配机制;颜色深浅表示五维框架中的典型干预位置,属于定性解释。
| 粒度 | 核心决策 | 代表机制与取舍 |
|---|---|---|
| 层级 | 哪些深度放哪些 mixer | Jamba/Samba 等预定比例;便于模块化,但配比未必符合层功能 |
| 头级 | 同一层的头预算怎样分配 | Hymba/Falcon-H1 固定分配,DuoAttention/HydraHead 按功能保留,Elastic Attention 随输入选模式 |
| 分支级 | 异构记忆路径在哪里融合 | Infini-attention 融合读出,Titans-MAG 融合各自形成的输出 |
| token 级 | 每个 token 保留何种表示、执行何种操作 | LoLCATs/NHA 按时间边界,LoLA/STILL 按内容分数,NAtS-L 学习操作分配 |
层分配的证据来源。 除预定周期外,LightTransfer/Priming 直接诊断原模型的层;Jet-Nemotron/PostNAS 与 HypeNet/HALO 先对齐替代模块,再做选择与适应;KL-Guided Layer Selection 在学生蒸馏与恢复 Softmax 层之间迭代,用 KL 下降衡量层的重要性。训练/迁移策略与最后的部署拓扑需要分别描述。(Sec. 7.1,pp. 42–44)
头分配有三个容易混淆的动态性。 DuoAttention/HydraHead 在辨认或转换后固定头的角色;Elastic Attention 在推理时随输入变化;深度自适应分配让不同层使用不同全局/高效头比例。这三者分别回答“哪个头”“当前输入用什么模式”“每层给多少预算”。(Sec. 7.2,pp. 44–45)
融合位置。 Infini-attention 先得到局部读出 $A_{\mathrm{dot}}$ 和压缩记忆读出 $A_{\mathrm{mem}}$,再计算 $A=\sigma(\beta)\odot A_{\mathrm{mem}}+(1-\sigma(\beta))\odot A_{\mathrm{dot}}$,随后做共享多头输出投影。Block-Recurrent Transformer 双向融合 token/state 读出;DART 将 chunk-state 检索作为 SSM 读出的门控修正。Titans-MAG 则在两个分支独立产生输出后融合。Memorizing Transformer 的外部 kNN 记忆作为接口类比的边界例子出现,不改变本文内部上下文记忆的核心范围。(Sec. 7.3,p. 46)
token 的记忆生命周期。 LoLCATs 把离开近期窗口的 token 累积进关联状态,并联合归一化读取局部 KV 与该状态;NHA 则使用长期槽并统一 Softmax。LoLA 用自召回误差、STILL 用自显著性,决定离窗 token 进入显式历史 KV 还是压缩状态。NAtS-L 进一步选择 token/chunk 执行 Softmax 或 GDN。分配计算算子与选择历史候选是不同层面的路由,只有改变当前可读记忆视图时才直接影响 Access。(Sec. 7.4,p. 47)
三:验证依据——这篇综述怎样支持架构层面的判断
本文的验证主体是文献整理与公开架构记录的描述性分析,没有新增统一训练实验、消融或跨机制吞吐排行榜。文献覆盖截至 2026-09-22,采用定向检索、前后向引用追踪及一手技术文档;作者说明其为有组织的代表性覆盖,并非穷尽式系统综述。(Sec. 1,p. 5)
纵向清单从 2022 年延续至截止日期,以发布记录为计数单位。一起发布且共用注意力骨架的模型可归为一条;单独发布的版本或明确骨架变化形成新记录。多模态模型仅分析公开的自回归语言骨架,不把视觉编码器等计入分类。Hybrid 要求在层、头、分支或 token 路径中实例化至少两种可区分机制/访问制度;一个稀疏候选集合同时包含窗口和远程 token,本身不自动成为 Hybrid。(Sec. 8,p. 48;Appendix A,p. 57)
第二组材料是 Artificial Analysis Intelligence Index v4.3.2 的冻结快照。论文选取 11 个高性能开放权重端点,max/xhigh 视为端点配置,注意力结构与参数规模来自相应公开模型材料。Table 18 以发布日期倒序排列,并未给出这些端点的指数得分。因此它适合回答哪些架构进入该样本,而不能据表格行序推出哪种注意力更强。(Sec. 8.3,p. 50)
两组材料也没有按模型规模、数据量、后训练、推理预算和内核做匹配。下面的百分比是整理样本内的发布记录比例,不是行业市场份额或性能增益。
四:结果——多样化、层间互补与跨层复用
4.1 架构设计呈现多条路线并存
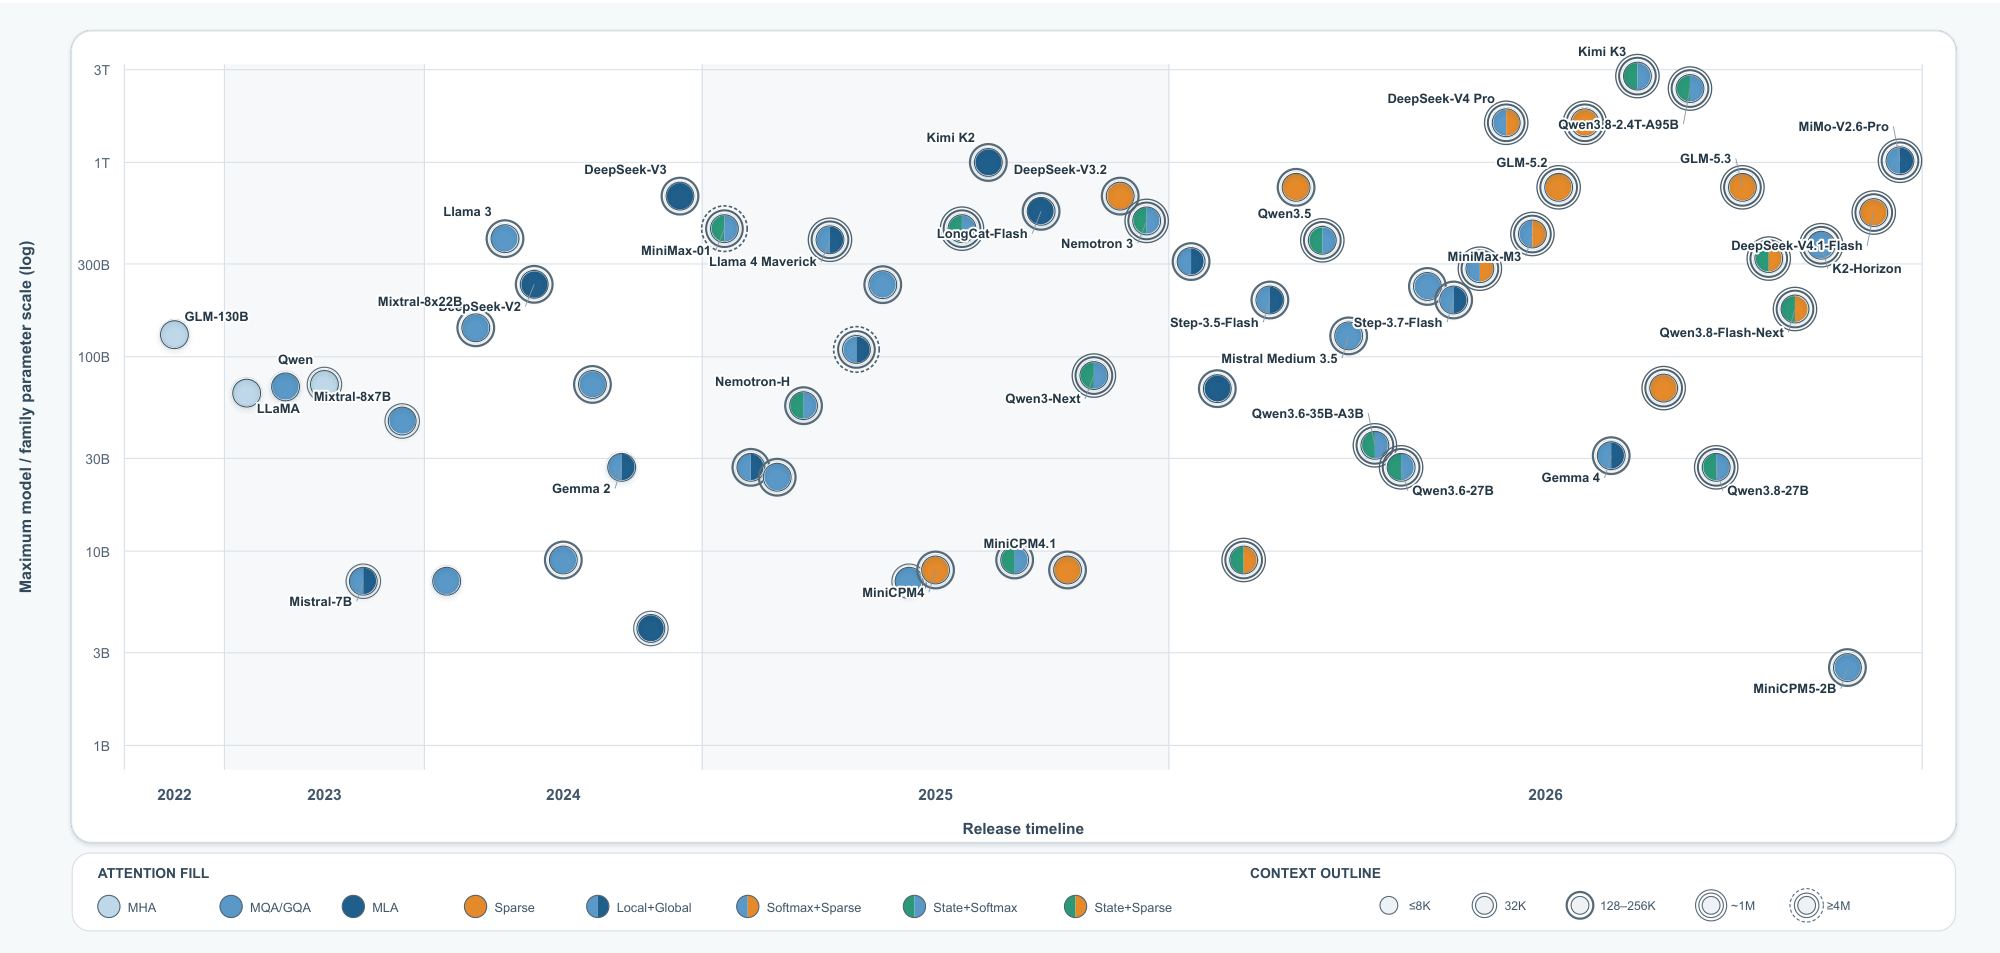
原文 Fig. 14,p. 49。横轴为发布时间,纵轴为代表模型总参数规模的对数刻度;填充表示注意力组合,边框表示上下文长度档位。分色节点表示机制混合,不表示性能分数。图中覆盖 58 条可分类记录,但某个包含规模变体的记录可画成多个节点,不能简单把节点数当作记录数。
GQA、MLA、稀疏读取和递归状态持续并存,因为它们分别控制 KV 重复、通道宽度、访问范围和历史压缩。单个谱系也可能改变方向:论文记录 MiniMax 从 Lightning/Softmax 混合转向全 GQA,再转向密集/稀疏组合;这说明架构演变并非单方向替换序列。(Sec. 8.1,pp. 48–49)
4.2 混合记录增加,跨层复用仍集中于少数模式
| 时段 | 可分类记录 | 单一主要家族 | Hybrid | 跨层复用属性 |
|---|---|---|---|---|
| 2022–2023 | 6 | 6(100%) | 0 | 0 |
| 2024–2025 | 25 | 16(64%) | 9(36%) | 0 |
| 2026,截至 09-22 | 27 | 10(37%) | 17(63%) | 5(19%) |
| 合计 | 58 | 32 | 26 | 5 |
来源:Table 17,p. 50;合计行为本次按原表相加。59 条总记录中,Kimi k1.5 因注意力未单独披露被排除;各时期百分比分母为可分类记录,原表按整数百分比四舍五入。跨层复用可与前两类重叠,不能作为第三个互斥类别相加。
作者观察到混合主要通过预定层级调度实现:一些层提供精细显式检索,另一些层提供局部处理或递归历史传播。与此同时,5 条跨层复用记录只对应 3 种基础模式:GLM-5.2/5.3 的 IndexShare,DeepSeek-V4.1-Flash 的 CSA2,以及 LongCat-2.0/Flash-Lite-Sparse 的 LSA。不能把 5 次发布解读成 5 种独立创新。(Sec. 8.2,pp. 49–50)
两个深度方向的概念也应分开:层级混合决定“每层做哪种记忆处理”;跨层复用决定“哪些 KV、索引 key 或候选集合继续给后续层使用”。后者改变这些中间产物的生命周期。
4.3 冻结的 11 个端点都保留显式 token 检索路径
下表保留 Table 18 与本文结论最相关的架构列,全部属于 2026-09-22 冻结样本,不表示当前实时排名。
| 模型端点 | 论文记录的注意力骨架 |
|---|---|
| MiMo-V2.6-Pro | 60 个 SWA-GQA 层 + 10 个全局 GQA 层 |
| DeepSeek-V4.1-Flash(max) | CSA2 + SWA;跨层 KV、索引及 Top-k 复用 |
| K2-Horizon-375B-A23B | 全 GQA |
| GLM-5.3-Flash | 34 个 KDA 层 + 11 个压缩索引 DSA 层 |
| GLM-5.3(max) | MLA-based DSA + IndexShare/IndexCache |
| Qwen3.8-Flash-Next | 3 GDN : 1 QSA |
| DeepSeek-V4 Pro 0813(max) | CSA/HCA 层级混合 |
| Qwen3.8-2.4T-A95B | 3 GDN : 1 gated full-GQA |
| Qwen3.8-27B(xhigh) | 3 GDN : 1 gated full-GQA |
| Kimi K3(max) | 3 KDA : 1 Gated MLA |
| MiniMax-M3 | 3 个密集注意力层 + 57 个 MSA 层 |
来源:Sec. 8.3,Table 18,p. 50。SWA 为滑动窗口注意力;所有比例均按表中给定顺序。
这一样本显示高性能端点仍有明显架构异质性;递归状态常与显式检索协作,纯 GQA 也在样本内。都有显式 token 路径不等于都保存全部历史的精确全局 KV:局部窗口本身就提供 token 级路径,而较远历史可能已经压缩。该观察支持互补性的描述,尚不足以判定某一路径是高性能的必要条件。
五:结论、启发与可检验的后续问题
5.1 真正趋同的是设计问题的范围
显式记忆逐步加入压缩、合并、索引、路由、门控和复用;递归状态逐步加入擦写控制、容量扩展、多时间尺度和选择性读取。它们关注的功能越来越重叠,表示接口和计算方式仍有差异。原文 Fig. 15(p. 52)的小条形表示作者对代表性工作活动程度的定性归纳,没有对应定量文献计数;不应把它解释成实测增长曲线。(Sec. 9.1,pp. 51–52)
5.2 网络深度成为记忆组织坐标
层级混合利用不同深度处理互补信息;跨层复用延长中间记忆产物的使用时间。两者一起提出新问题:哪些层负责产生高成本内容,哪些层只读取,哪些层需要重新选择,什么时候已有表示变得陈旧?这是本文从机制分类推进到架构设计的关键一步。(Sec. 9.2,pp. 52–53)
5.3 多维持久记忆与稀疏读写是假说
作者提出的地址空间为:
四个坐标依次为时间范围、深度、记忆载体和粒度;$\mathcal M_t=\{M_t[a]:a\in\mathcal A_t\}$。这是逻辑地址组织,可只实例化部分地址,无需实际分配完整笛卡尔积张量。(Eq. (68),p. 53)
Sparse Write 选择 $\mathcal W_t\subseteq\mathcal A_t$ 并调用各载体适用的更新规则;Sparse Read 则按前述 Access—Readout—Integration 使用已存在的记忆。写与读可以选择不同地址,但必须协调:写入很少被读的位置会浪费资源,反复读取未得到适当写入的位置也不能有效回忆。(Eqs. (69)–(70),pp. 53–54)
与普通前馈 MoE 相比,记忆路由的区别在于持久性:一次写入会改变未来查询可用的信息。因此训练要处理延迟收益、读写一致性、状态占用、干扰和错误写入恢复,而不只优化当前 token 的计算分配。(Sec. 9.3.3,p. 54)
作者给出四个可逐步实施的方向(Sec. 9.3.4,pp. 54–55):
- 按工作负载选择表示:精确 KV、索引、摘要、递归状态分别服务不同精度和稳定性需求。例如代码仓库用仓库摘要、文件/符号索引与活跃片段精确 KV。
- 非对称构建与检索:轻量预填充产生摘要和地址,解码先读粗粒度表示,需要时再升级到细节。
- 增量生命周期控制:对记忆产物选择复用、刷新、转换或失效;源文件局部变化只触发受影响部分更新。
- 联合路由记忆与计算:先定义有限配置菜单,再让任务状态选择记忆类型、粒度、注意力模式、计算深度与写回动作。
这些建议需要在匹配的存储、计算和路由预算下验证质量—效率取舍。当前论文提供的是共同描述语言与研究路径,没有给出一个已经胜出的统一 Memory-MoE 系统。
5.4 本次分析:怎样用这篇综述判断一个新方法
对新方法,先找到它改变的记忆对象,再核算随上下文增长的量,会比只看“线性”“稀疏”标签更有用:
| 设计选择 | 优先检查的实际问题 |
|---|---|
| GQA / MLA / 层共享 | token 是否仍可单独检索?到底减少头、通道还是独立缓存层? |
| 稀疏路由 | 地址扫描有多长?候选召回如何?索引与 gather 是否抵消收益? |
| 状态递归 | 状态容量与单步更新代价多大?纠正新关联会干扰哪些旧关联? |
| 多状态扩展 | 全部状态存储量与每步激活量分别是多少?状态数随长度如何增长? |
| 混合与跨层复用 | 精确路径的剩余缓存有多大?共享对象是什么?何时必须刷新? |
这篇综述最适合作为机制定位与研究问题生成的地图。它的局限也与这一用途一致:代表性样本影响采用比例,混合标签依赖所选组合粒度,跨层复用证据集中于少数模式,模型前沿比较未消除规模、训练和推理配置的混杂。选择实际架构时,仍需在目标任务和硬件上同时比较检索质量、持久状态、预填充、解码与路由开销。