LeapQuant:通过准确的递归状态量化加速线性注意力
原题:LeapQuant: Efficient Linear Attention with Accurate Recurrent State Quantization
作者:Yi Pan、Haocheng Xi(共同一作)、Kan Zhu、Xingyang Li、Yibo Wu、Mayank Mishra、Hongtao Zhang、William X. Zheng、Baris Kasikci、Song Han、Kurt Keutzer、Rishabh Iyer、Ion Stoica。
版本与时间:arXiv:2609.38166v1,提交于 2026-09-29;本次获取与研读:2026-10-19,修订 r1。
原文与成品:arXiv · 本地 PDF · 英文汇报 PDF · 可编辑 TeX。
论文总览
LeapQuant 研究的是线性注意力在推理时反复读写的递归状态矩阵。状态大小虽然不随上下文长度增长,但每生成一个 token 都搬运整个矩阵,仍会消耗大量显存带宽;前缀缓存还会保存许多状态检查点,扩大容量需求。
直接把状态改存为 BF16 或 INT8 会反复舍入。每一步的误差进入下一步状态,而少数大幅值行列又扩大了量化间隔。作者把问题拆成两部分:减少误差注入次数,减小每次注入的误差。具体方法是:
- 按窗口量化(per-window quantization):固定窗口起点的低精度状态,把窗口内更新保存为高精度向量记录;默认每 16 个 token 才重建、量化一次完整状态。
- 补偿 token(Compensator Tokens):用少量高精度低秩因子保留状态中的主导结构,并复用真实 token 的秩一更新路径。
- 残差平滑(residual smoothing):对剩余矩阵按 key 通道缩放,再量化;读出时恢复坐标。
在三个完整模型、四个主要任务组成的 12 组结果中,8 位 LeapQuant 和 FP32 状态的平均分均为 75.5%。默认 8 位表示的窗口边界状态约为 1.19 字节/元素,相对 FP32 缩小约 3.4 倍;作者报告端到端输出吞吐平均约 1.47 倍。这些收益来自状态表示和推理内核的共同改变,其他模型组件沿用基线精度。(Table 1,PDF p. 7;Sec. 4.3,PDF pp. 8–9)
结构地图
下文页码均指本地原文 PDF,从 1 开始计数。
| 原文章节 | 主要作用 | PDF 页码与证据 |
|---|---|---|
| 1 Introduction | 带宽、检查点容量和量化误差问题 | pp. 1–2;Fig. 1 |
| 2 Related Work | 区分线性注意力、量化和状态管理研究 | pp. 2–3 |
| 3.1 Preliminaries | 统一递归更新及量化误差记号 | pp. 3–4;Eq. (1) |
| 3.2 Per-window quantization | 固定边界状态和更新记录 | p. 4;Eqs. (2)–(4),Figs. 2–3(Fig. 2 在 p. 3) |
| 3.3 Compensator Tokens | 高精度低秩分量与更新路径复用 | pp. 5–6;Eqs. (5)–(6),Figs. 4–6 |
| 3.4 Residual smoothing | 平滑残差并恢复坐标 | p. 6;Eq. (7) |
| 4.1 Setups | 模型、任务、实现及对照 | pp. 6–7 |
| 4.2 Accuracy Results | 8/6/4 位状态对模型质量的影响 | pp. 7–8;Table 1 |
| 4.3 Efficiency Results | 内核、解码、内存和端到端吞吐 | pp. 8–9;Figs. 7–9 |
| 4.4 Ablation Study | 设计贡献、窗口与秩的选择 | p. 9;Tables 2–3 |
| 5 Conclusion | 低精度状态服务的意义 | p. 10 |
| A Instances of the General Update | 不同架构的统一表示 | p. 13;Table 4 |
| B Derivations | 误差传播、窗口展开和平滑读出 | pp. 14–15;Eqs. (8)–(10) |
| C Full Downstream Results | GSM8K 和全部量化格式 | p. 15;Table 5 |
| D Additional Efficiency Evaluation | 1K–8K 和最长 128K 的效率 | pp. 15–16;Figs. 10–11 |
| E Evaluation Details | 生成采样设置 | p. 16;Table 6 |
一:动机——固定大小的记忆仍然需要反复搬运
1.1 线性注意力消除了历史长度增长,却留下了状态读写
每个注意力头维护 $S_t\in\mathbb R^{d_k\times d_v}$。常规解码从高带宽显存(HBM)读出旧状态,更新、计算输出,再写回新状态。单步算术量相对搬运字节数较少,因而容易受内存带宽约束。很多层与很多并发请求同时执行时,这个固定成本会变得可观。
前缀缓存带来另一种成本:为了在多个前缀位置恢复状态,系统要保存多份检查点。本文内存实验按每 1,024 个缓存 token 保存一份线性状态计算,因此单个请求的即时状态大小固定,并不意味着缓存总量固定。
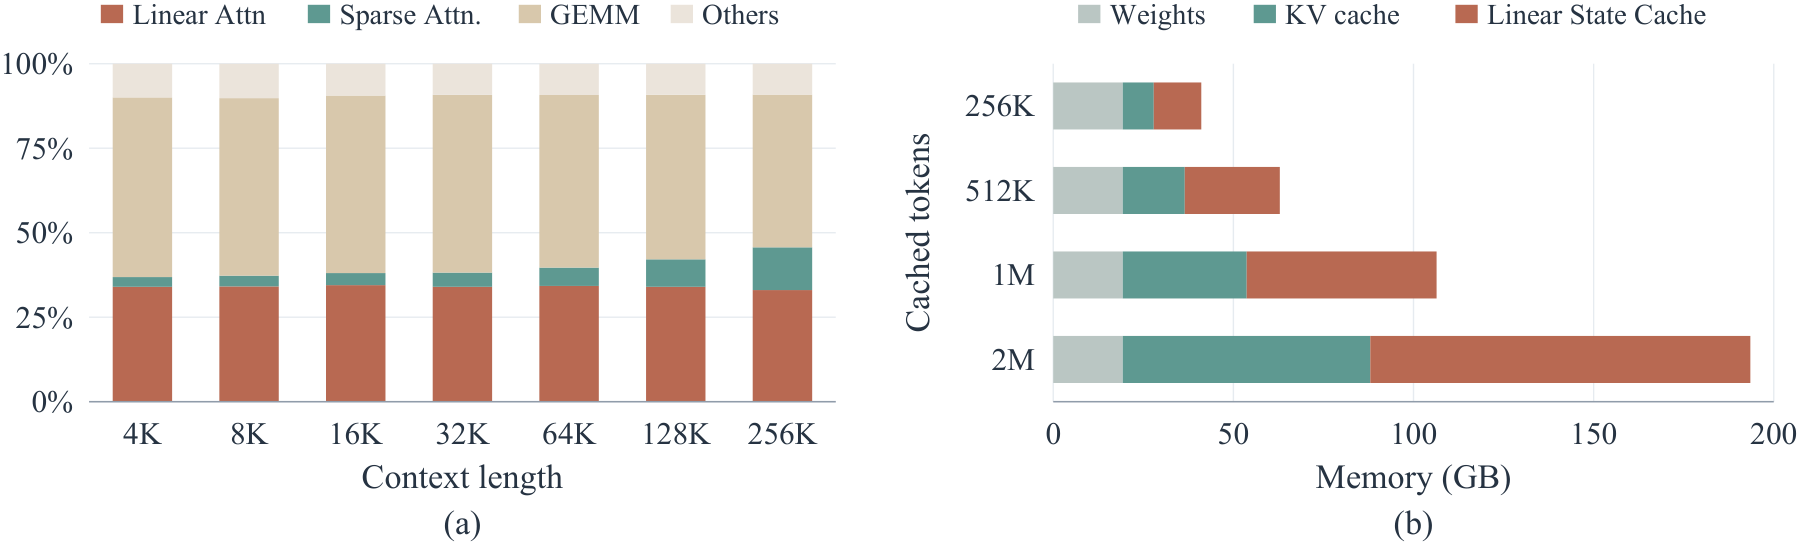
原文 Fig. 1,PDF p. 2。 左图纵轴为解码时间占比,横轴为上下文长度;GLM-5.3-Flash-NVFP4、B200、batch 256 下,线性注意力占比随上下文变化较小。右图横轴为 GPU 内存 GB,纵轴为缓存 token 总量,展示 Qwen3.5-9B 的权重、KV cache 和状态检查点容量。两幅图分别解释带宽优化和容量优化的动机。
1.2 为什么普通 KV 量化经验不能直接照搬
已经缓存的历史 KV 通常不随每个新 token 反复改写。递归状态则不断读出、更新和重新量化,舍入误差也随递归继续传播。加上状态存在显著的行列异常值,仅优化一次量化的表示精度不足以解决整个轨迹的问题。
作者将已有的 KVQuant、QuaRot、TurboQuant 适配到递归状态,作为比较对象。论文的方法位置是:把分块线性注意力的状态展开方式用于低精度解码,再把高精度低秩结构组织为可与更新记录共用执行路径的向量对。低秩加量化、分块展开本身都有先例,本文的特点是围绕递归误差和推理开销组合这些机制。(Sec. 2,PDF pp. 2–3)
二:方法——将密集状态改成可读出的分解表示
2.1 统一的状态更新
原文 Eq. (1):
| 符号 | 维度 / 类型 | 含义 |
|---|---|---|
| $S_t$ | $d_k\times d_v$ | 第 $t$ 步递归状态 |
| $q_t,k_t,\beta_t$ | $d_k$ 维向量 | 输出查询、写入方向、delta 更新的读取方向 |
| $v_t,o_t$ | $d_v$ 维向量 | 当前 value 与输出 |
| $\alpha_t$ | 对角衰减系数;可由标量广播 | 各 key 坐标保留多少旧状态 |
| $u_t=v_t-S_{t-1}^{\top}\beta_t$ | $d_v$ 维向量 | 真实写入的修正值 |
| $p,r$ | 正整数 | 窗口长度、补偿 token 数 |
| $\operatorname{quant}_b,\operatorname{dequant}_b$ | 量化 / 反量化算子 | 低位载荷及其尺度元数据的编码和恢复 |
更新先衰减旧状态,再写入秩一矩阵 $k_tu_t^\top$。其中 $u_t$ 依赖旧状态,因此缓冲的是计算好的修正向量,不是只保存输入 $v_t$ 就结束。没有 delta rule 时令 $\beta_t=0$。
需要区分主文 $\beta_t$ 与 GDN/KDA 原生记号中的标量步长。附录 A 使用 $\tilde k_t,b_t$ 分别表示主文的写向量 $k_t$、读向量 $\beta_t$,原生 $k_t,\beta_t$ 则保留原模型含义:
| 模型 | $D_t$ | 写向量 $\tilde k_t$ | 读向量 $b_t$ |
|---|---|---|---|
| DeltaNet | $I$ | $\beta_t k_t$ | $k_t$ |
| Gated DeltaNet(GDN) | $\alpha_t I$ | $\beta_t k_t$ | $\alpha_t k_t$ |
| Kimi Delta Attention(KDA) | $\operatorname{Diag}(\alpha_t)$ | $\beta_t k_t$ | $\alpha_t\odot k_t$ |
例如 KDA 的 $(I-\beta_tk_tk_t^\top)D_tS_{t-1}+\beta_tk_tv_t^\top$ 可展开成上表形式。RWKV7 的独立擦除和写入方向需要拆成两个秩一子步骤;DeltaProduct 也按多个子步骤处理。因此数学表示可覆盖的架构范围大于本文实际验证质量与效率的 GDN/KDA 范围。(Appendix A,Table 4,PDF p. 13)
2.2 误差为何累积:传播项与新误差项
定义相对未量化状态轨迹的偏差:
并以 $\varepsilon_t$ 表示当前量化额外引入的误差。在固定层输入、两条轨迹使用相同更新系数的条件下,附录 Eq. (8) 等价于
这里 $A_t$ 是本笔记为解释而引入的简写。若 $E_0=0$,进一步展开得到
每次舍入产生的误差都要经历后续的衰减和擦除,再通过 query 进入输出。逐 token 量化让每一步都可能出现新的 $\varepsilon_s$;按窗口量化让完整状态重新量化这一误差源只在边界出现。缓冲向量和算术本身仍有有限精度误差。
这个推导解释单层递归误差如何传播。完整模型中,上游激活与生成 token 也会因量化改变,不能把固定系数的递推直接当成端到端误差上界。论文主要依赖轨迹实验和任务实验验证实际质量。(Appendix B.1,PDF p. 14)
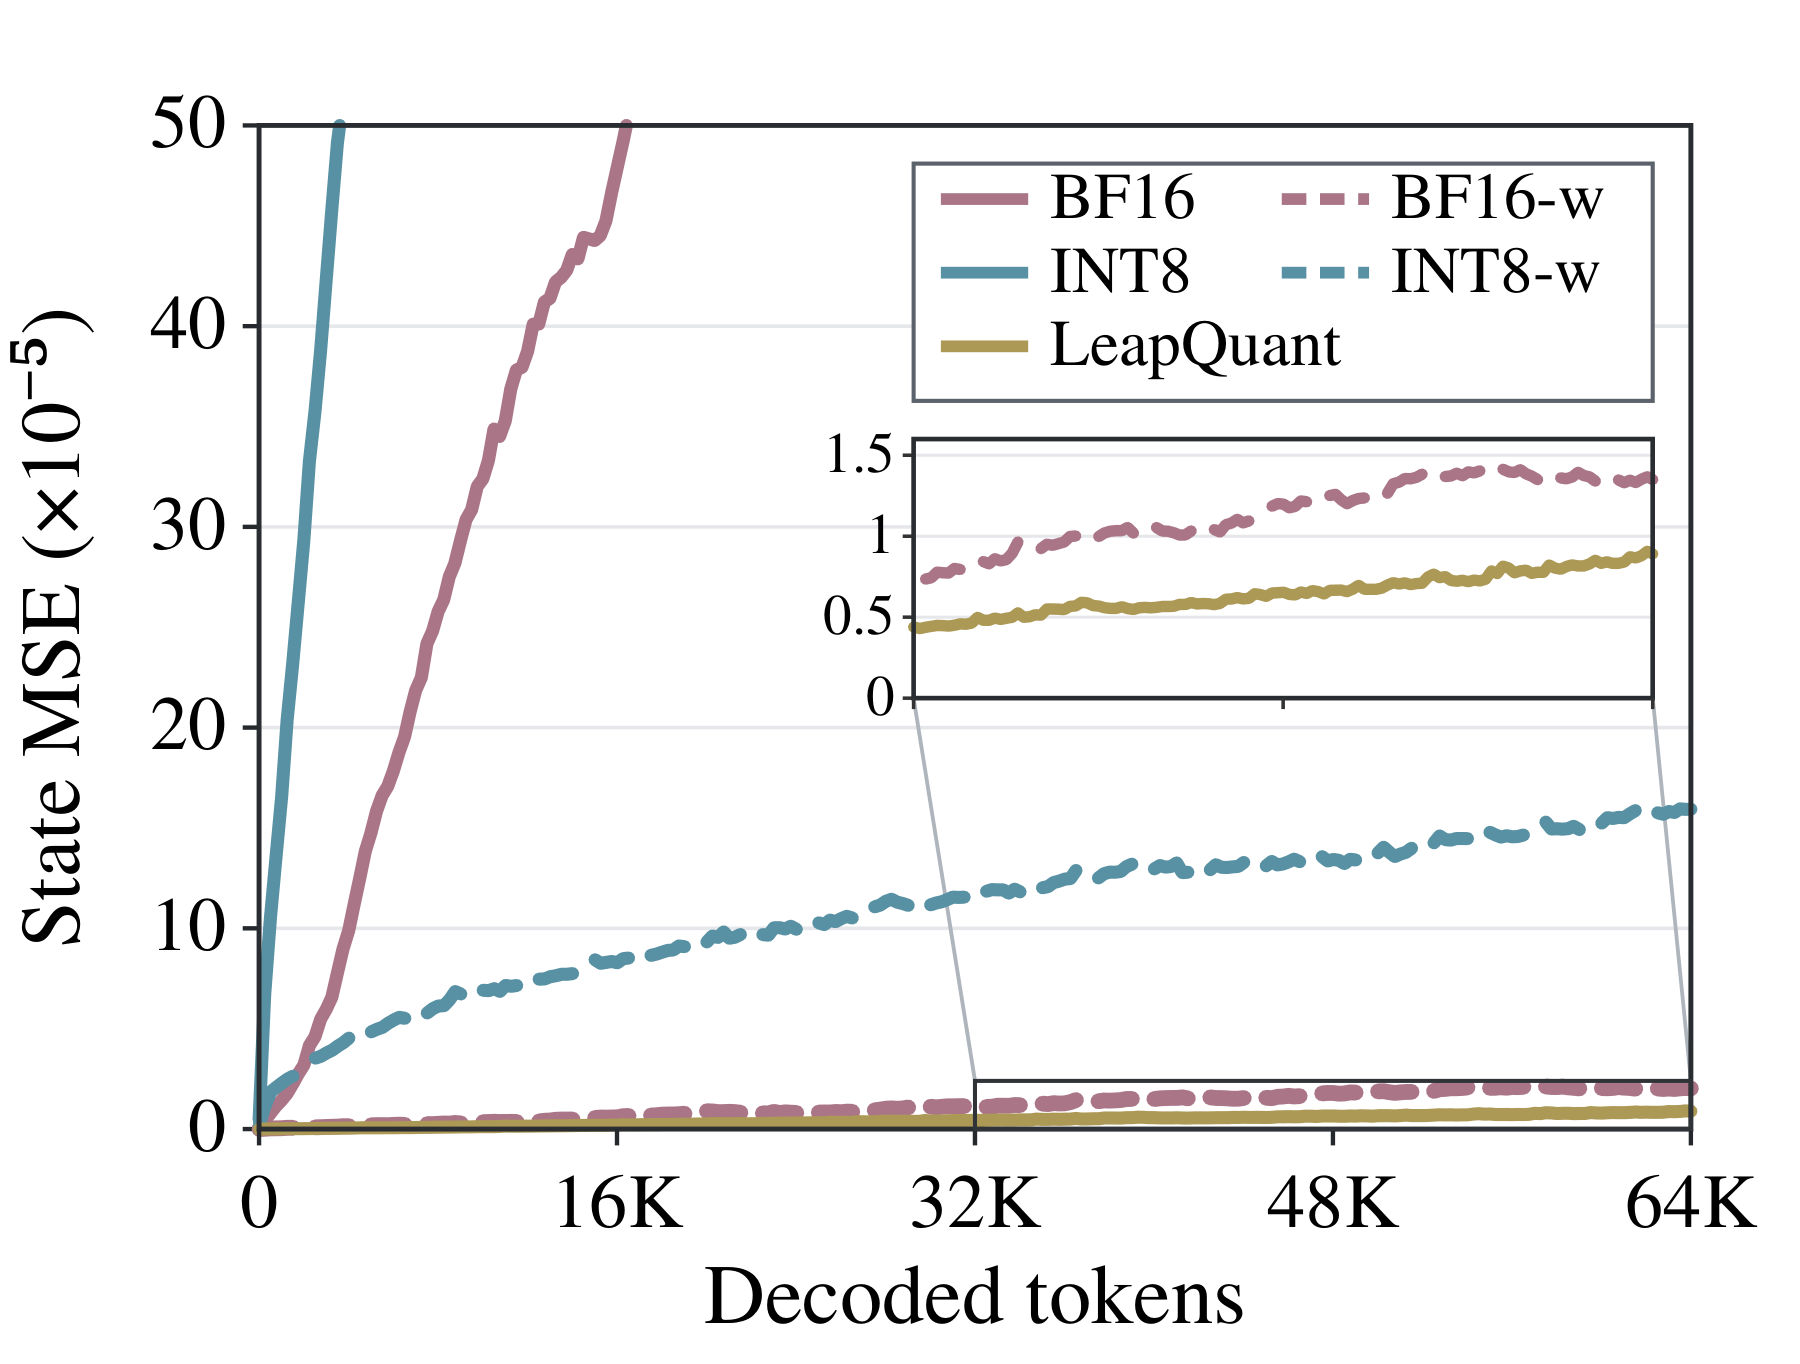
原文 Fig. 3,PDF p. 4。 横轴为 PG-19 上解码 token 数,最长 64K;纵轴为 Qwen3.5-9B 状态相对 FP32 的 MSE,标度为 $10^{-5}$。图例中 -w 表示每 16 个 token 量化一次,内嵌小图放大低误差曲线。正文报告,64K 位置 BF16-w 相对逐步 BF16 的误差下降约 100 倍,INT8-w 相对逐步 INT8 下降约 39 倍,LeapQuant 的误差进一步降低。量化频率减少 16 倍不意味着 MSE 必然只减少 16 倍:被逐步舍入丢弃的微小更新可能存在相关性。
教学例子。 在固定步长为 1 的最近整数舍入下,初值为 10,每步加 0.1:每步舍入会一直停在 10;累积 16 次后才舍入,则把 11.6 舍入到 12。相对精确结果,误差绝对值分别是 1.6 和 0.4。这个标量例子只说明延迟舍入如何保存小更新,不是论文的量化器配置或实验数据。
2.3 窗口化:每步输出,窗口末尾才写回密集状态
固定窗口起点 $\hat S_0$,保存 $(\alpha_i,k_i,u_i)$。定义累计对角衰减
把递归逐项展开,即原文 Eq. (4):
式中的量化状态参与运算时隐含反量化。到 $\ell=p$ 时重建 $S_p$,再形成下一窗口的低精度边界表示。
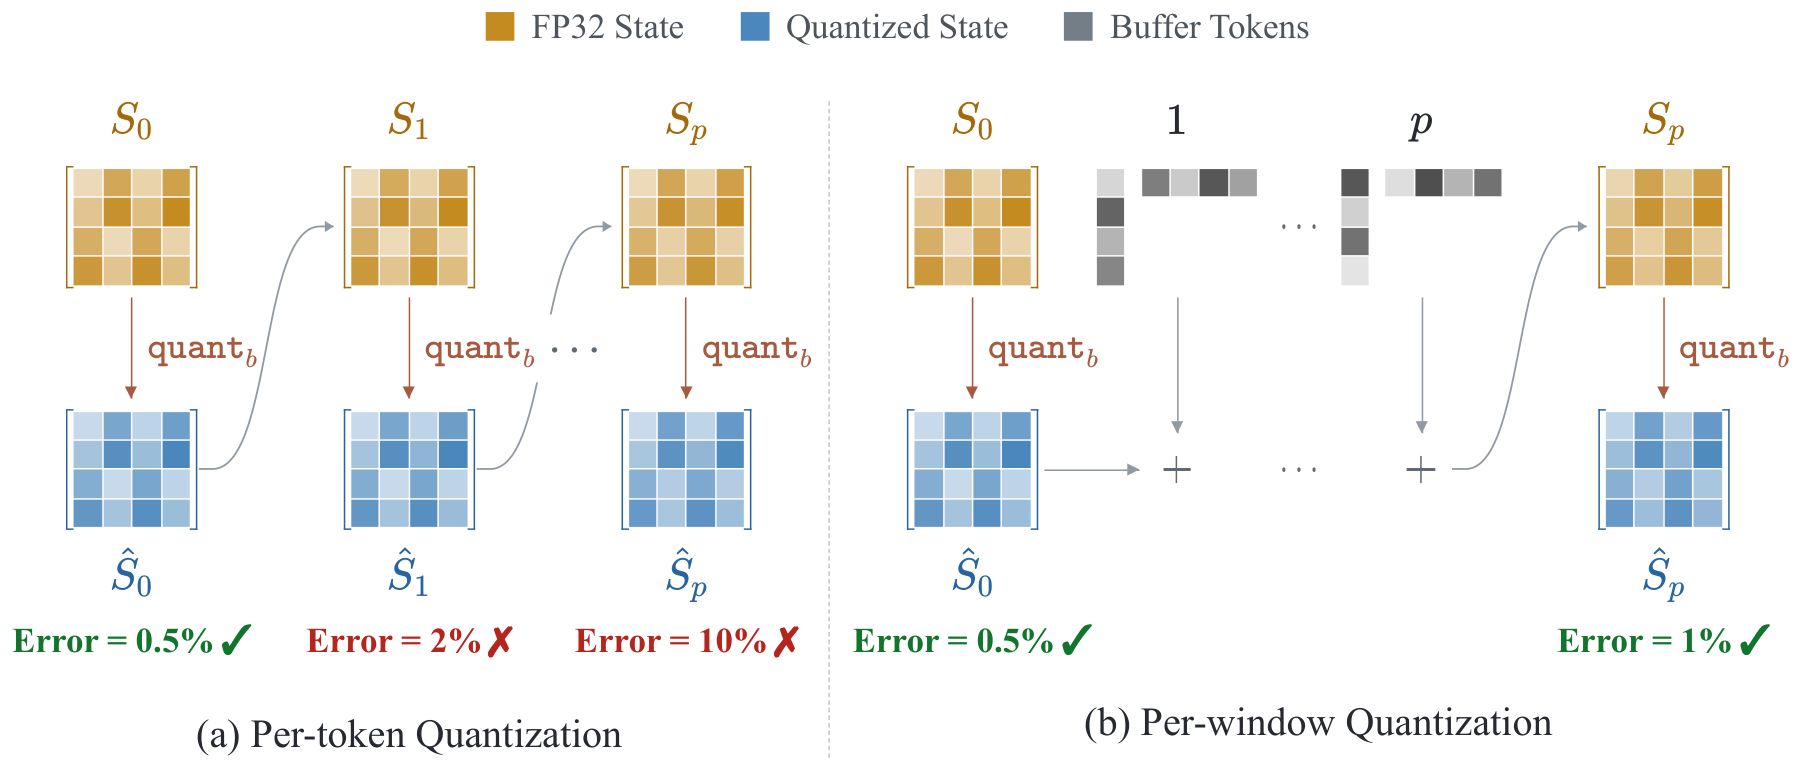
原文 Fig. 2,PDF p. 3。 左侧每个更新后都重新量化;右侧让起点状态保持不变,用高精度向量记录窗口内变化。图中 0.5%、2%、10% 等数字是机制示意,不能当成实测误差读数。
关键是无需为了生成每个输出都显式构造 $S_\ell$。由对角矩阵 $\Gamma^\top=\Gamma$,对任意读取向量 $x$ 有
这就是附录 Eq. (9) 在窗口起点为 0 时的形式。取 $x=\beta_i$ 并读取第 $i-1$ 步,得到计算 $u_i$ 所需的旧状态投影;加入第 $i$ 条记录后,取 $x=q_i$ 得到输出。自回归生成仍然每步进行,窗口长度不会要求等待 16 个 token 才输出。
基础状态读出成本为 $O(d_kd_v)$,每条向量记录增加 $O(d_k+d_v)$,累计衰减可增量维护。窗口化减少密集状态的重建、量化和写回频率,每个 token 仍需读取基础状态及缓冲记录,不能把 $p=16$ 直接解释成总带宽成本下降 16 倍。(Sec. 3.2,PDF p. 4;Appendix B.2,PDF p. 14)
2.4 补偿 token:把大幅值结构变成几条高精度更新
窗口化后,一次量化仍可能因异常值而损失较多信息。Fig. 5(PDF p. 6)的横轴为保留的奇异方向数,纵轴为累计能量占比,展示中位数与四分位区间;少数方向已经捕获大部分能量。这一观察支持用较小的秩保护主导结构,因此作者拟合一个低秩分量:
残差定义为 $R_p=S_p-\tilde K\tilde U^\top$,所以分解本身在精确算术下是恒等式;近似来自残差量化和有限精度存储:
原文 Eq. (5) 先写出最小化 $\|S_p-ku^\top\|_F$ 的秩一拟合目标,Eq. (6) 推广到 $r$ 个外积。实现用幂迭代拟合,不能把这一目标式理解成每个窗口都执行完整、精确的 SVD。
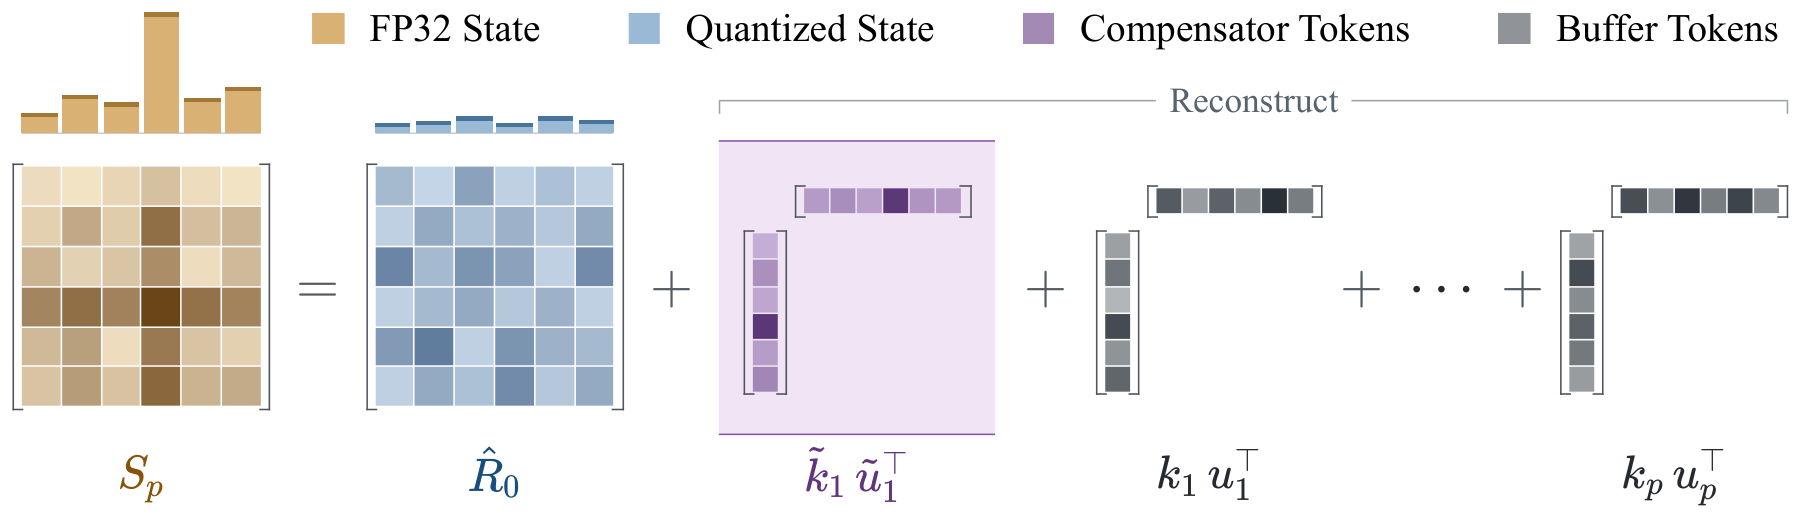
原文 Fig. 4,PDF p. 5。 蓝色为低位残差,紫色为补偿向量对,灰色为真实 token 的更新记录;顶部柱形说明移走主导结构后行范数更平坦。图示省略了完整的时间衰减,实际计算遵循 Eq. (7)。
称之为“token”,是因为 $(\tilde k_h,\tilde u_h)$ 与真实更新 $k_ju_j^\top$ 都是秩一外积,可共用解码内核的向量记录路径。它们没有文本含义,不产生输出。补偿记录被放在新窗口真实记录之前,自身加入时采用恒等衰减,随后与窗口起点状态一起经历真实 token 的衰减。
窗口结束时,旧补偿项与真实更新共同参与重建;旧补偿项随后被替换为新拟合项。保存的补偿向量数始终是 $r$,不会随上下文累积。默认 $r=4$、因子为 FP16;4 位实验改用 $r=8$。(Sec. 3.3,PDF pp. 5–6;Sec. 4.1,PDF p. 7)
2.5 残差平滑:只改变残差坐标
对残差 $R_0$,每个 key 行的尺度 $c_a$ 取该行平均绝对值的平方根,并设置正数下限:
上式的近似号仅省略下限处理;论文未给出该下限的具体常数。量化 $C^{-1}R_0$,读出时乘回 $C$。$C$ 在一个窗口内固定,在下一个边界根据新残差重算。原文 Eq. (7) 为
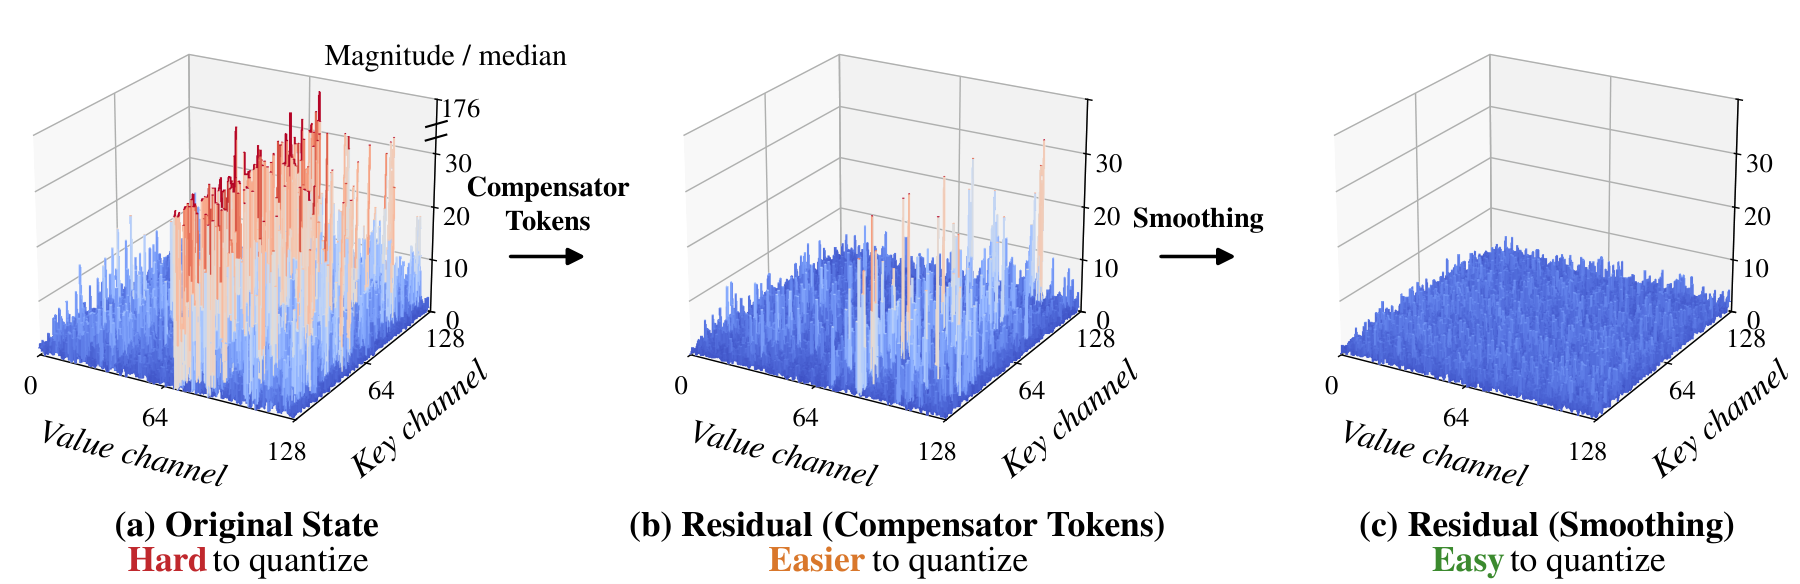
原文 Fig. 6,PDF p. 6。 三幅图依次是原状态、移去补偿项后的残差、平滑后的残差;底面为 key/value 通道,竖轴为幅值相对中位数的比值。示例取 Qwen3.5-9B 第 13 层第 16 头、8K 上下文,最大值从 176 倍降至 47 倍,再到 5.3 倍。前两幅用原状态的中位数归一化,第三幅使用平滑后残差的中位数;这是分布形状变化,不能直接当成同尺度的绝对误差下降倍数。
附录 B.3 明确了 8 位残差采用按 value 通道的对称 INT8 量化。设 $Z_0$ 为整数载荷,$B$ 为 value 侧对角尺度:
$C$ 作用于 key 坐标,$B$ 作用于 value 投影。这些尺度只用于量化残差,不能再乘到已在原始坐标中的补偿项或真实更新上。
完整读出式为原文 Eq. (10):
三项分别是“量化残差”“补偿项”“窗口内真实更新”的投影,解释了为何三种机制可以在一个状态读取路径中组合。(Sec. 3.4,PDF p. 6;Appendix B.3,PDF pp. 14–15)
2.6 一次窗口的执行过程
下面是基于上述公式整理的教学伪代码,Read 使用 Eq. (10),不代表作者代码接口:
持久表示:量化残差 Rhat、残差尺度 C/B、补偿因子 Ktilde/Utilde
当前窗口:真实更新列表 records

对每个新 token i:
    u_i = v_i - Read(当前表示, records, beta_i)
    records.append(alpha_i, k_i, u_i)
    o_i = Read(当前表示, records, q_i)
    若记录数达到 p:
        S = Reconstruct(当前表示, records)
        Ktilde, Utilde = PowerIterationFit(S, rank=r)
        R = S - Ktilde @ Utilde.T
        重新计算行平滑尺度 C 与量化尺度 B
        Rhat = Quantize(C^{-1} @ R)
        清空 records
    输出 o_i
其本质是修改推理状态的保存和读取方式。模型无需重训,也无需校准数据;窗口边界仍要付出低秩拟合、尺度更新和量化的运行时成本。
三:实验——质量、内核与服务吞吐分别比较
3.1 模型与推理设置
| 模型 | 线性注意力 | 本文使用范围 |
|---|---|---|
| Qwen3.5-9B | GDN | 完整模型质量与效率 |
| Qwen3.5-35B-A3B | GDN | 完整模型质量与效率 |
| Kimi-Linear-48B-A3B-Instruct | KDA | 完整模型质量与效率 |
| Qwen3.8-Flash | GDN | 8 层版本,仅测效率 |
| GLM-5.3-Flash | KDA | 8 层版本,仅测效率 |
两种 8 层版本保留单层解码成本,但不保留完整模型输出,不能据其吞吐推断完整模型的质量。实现集成于 vLLM,解码内核使用 TileLang。默认 $p=16$,8/6 位用 $r=4$,4 位用 $r=8$;补偿向量与更新缓冲采用 FP16,平滑尺度为 FP32。其他组件沿用基线精度。(Sec. 4.1,PDF pp. 6–7)
3.2 任务、指标和生成协议
主要质量表使用 AIME 2026、GPQA-Diamond、LiveCodeBench v6、MMLU-Pro。表头中的 MMLU 实际指 MMLU-Pro;LCB 指 LiveCodeBench。附录 Table 5 增加 GSM8K。分数单位均为百分比,越高越好;作者报告三个随机种子的平均结果。Table 1 的 Avg. 是三个模型、四个任务共 12 个分数的平均,不包含 GSM8K。
两个 Qwen 模型开启 thinking:temperature 1.0、top-p 0.95、top-k 20、presence penalty 1.5,最大输出 81,920 tokens。Kimi 是无 thinking 模式的指令模型:temperature 1.0、top-p 1.0、presence penalty 0,最大输出 65,536 tokens。每个模型的所有方法使用相同提示与采样设置,最大模型长度设为输出上限加 8,192。(Appendix E,Table 6,PDF p. 16)
3.3 对照方法与效率口径
质量对照包括 FP32/BF16 状态,逐步 FP8/INT8,以及适配的 KVQuant、QuaRot、TurboQuant;6/4 位组还包括 NVFP、MXFP、按通道 INT 等格式。原文选择较好的直接量化格式进入主表,附录保留全部结果。质量主表中的量化基线每个 token 都重新量化,因此它比较的是完整方法组合;窗口、补偿与平滑各自的贡献要看消融。
| 效率实验 | 比较对象与配置 | 指标 |
|---|---|---|
| 单层内核 | FLA FP32 状态内核;32 heads,$d_k=d_v=128$ | token/s,及相对基线倍数 |
| 纯解码 | vLLM FP32 状态,开启 CUDA graphs,默认 4K 上下文 | 整个模型的 decode throughput |
| 内存 | 每 1K 缓存 token 保存状态检查点 | 状态字节数、端到端显存减少比例 |
| 离线端到端 | GSM8K、MMLU-Pro、GPQA 工作负载 | output token/s,包含并发容量收益 |
内核实验覆盖 B200、RTX PRO 6000、RTX 5090;图示端到端结果使用 B200 和 RTX PRO 6000。Kimi 的端到端吞吐采用 Qwen3.5-9B 的长度分布模拟生产 KDA 工作负载,需与其自然较短输出的质量评测区分。(Sec. 4.3,PDF pp. 8–9)
四:结果——8 位接近基线,收益取决于状态所占成本
4.1 8 位质量:保留长推理比保留简单任务更困难
| 状态方法 | 12 组平均分(%) | 相对 FP32(百分点) |
|---|---|---|
| FP32 | 75.5 | 0.0 |
| BF16 逐步 | 68.7 | −6.8 |
| LeapQuant 8 位 | 75.5 | 0.0 |
| FP8 逐步 | 34.2 | −41.3 |
| INT8 逐步 | 26.3 | −49.2 |
| KVQuant 8 位适配 | 67.0 | −8.5 |
| QuaRot 8 位适配 | 50.1 | −25.4 |
| TurboQuant 8 位适配 | 49.6 | −25.9 |
来源:Table 1,PDF p. 7;百分点按表中一位小数相减。
最能体现问题的是 Qwen3.5-9B:AIME 从 FP32 的 87.9% 降到 BF16 的 72.1%、逐步 FP8 的 14.6%、逐步 INT8 的 7.1%;LeapQuant 8 位保持 87.9%。其 LCB 同样恢复到 FP32 的 64.1%。这说明减少误差累积可以比单纯增加存储位数更有效。
平均相同不代表每格相等。三个模型的 8 位 LeapQuant 与 FP32 单项差值介于 −0.8 至 +0.8 个百分点,支持接近无损的描述;没有方差或区间可供判断这些小差别的显著性。Kimi 生成较短,作者认为它对逐步量化相对不敏感,但其 BF16 MMLU-Pro 仍从 72.4% 降到 64.0%。
附录增加的 GSM8K 分别为:FP32 96.1 / 96.7 / 92.1,8 位 LeapQuant 96.3 / 96.5 / 92.0(顺序为 Qwen9B、Qwen35B、Kimi)。较简单数学任务的表现较稳定;只看 GSM8K 会低估长推理和代码生成的量化风险。(Table 5,PDF p. 15)
4.2 更低位宽:6 位有损,4 位存在明显模型差异
| 位宽 | LeapQuant 平均分(%) | 同组较强对照 | 对照平均分(%) |
|---|---|---|---|
| 8 | 75.5 | KVQuant | 67.0 |
| 6 | 72.4 | TurboQuant / NVFP6 | 31.9 / 29.6 |
| 4 | 60.4 | TurboQuant / MXFP4 | 22.9 / 9.7 |
来源:Table 1,PDF p. 7。6 位相对 FP32 的平均差为 −3.1 个百分点,4 位为 −15.1 个百分点。4 位配置同时把补偿数从 4 增至 8。
4 位 Kimi 的四项分数为 67.9 / 69.2 / 40.5 / 73.4,与 FP32 的 67.5 / 70.3 / 41.4 / 72.4 相差不超过 1.1 个百分点。相比之下,Qwen3.5-35B-A3B 的 AIME 从 91.5% 降至 59.2%,LCB 从 75.6% 降至 37.4%。因此,4 位依然明显优于对照,但接近无损的主要证据来自 8 位。
4.3 单层内核:大 batch 下压缩带宽很有效
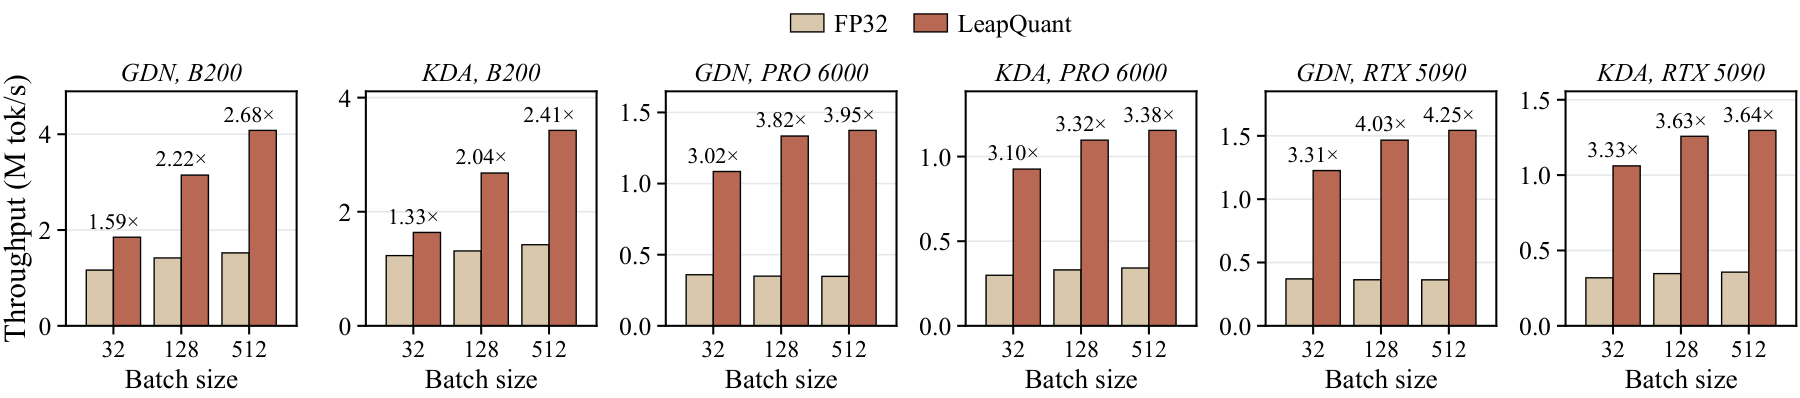
原文 Fig. 7,PDF p. 8。 六个面板分别展示 GDN/KDA 与三种 GPU 的组合;横轴是 batch size,纵轴是百万 token/s,柱上数字为相对 FP32 的吞吐倍数。
| GPU,batch 512 | GDN 加速 | KDA 加速 |
|---|---|---|
| NVIDIA B200 | 2.68× | 2.41× |
| RTX PRO 6000 | 3.95× | 3.38× |
| RTX 5090 | 4.25× | 3.64× |
配置为单层、32 heads、$128\times128$ 状态。更高并发增大了状态流量占比;作者据此解释为什么消费级/工作站 GPU 的收益更大。摘要的 2.05–3.70× 是概括性的平均范围,上表是明确 batch 下的结果,两者统计口径不同。
4.4 整个模型解码:未优化部分稀释了内核收益
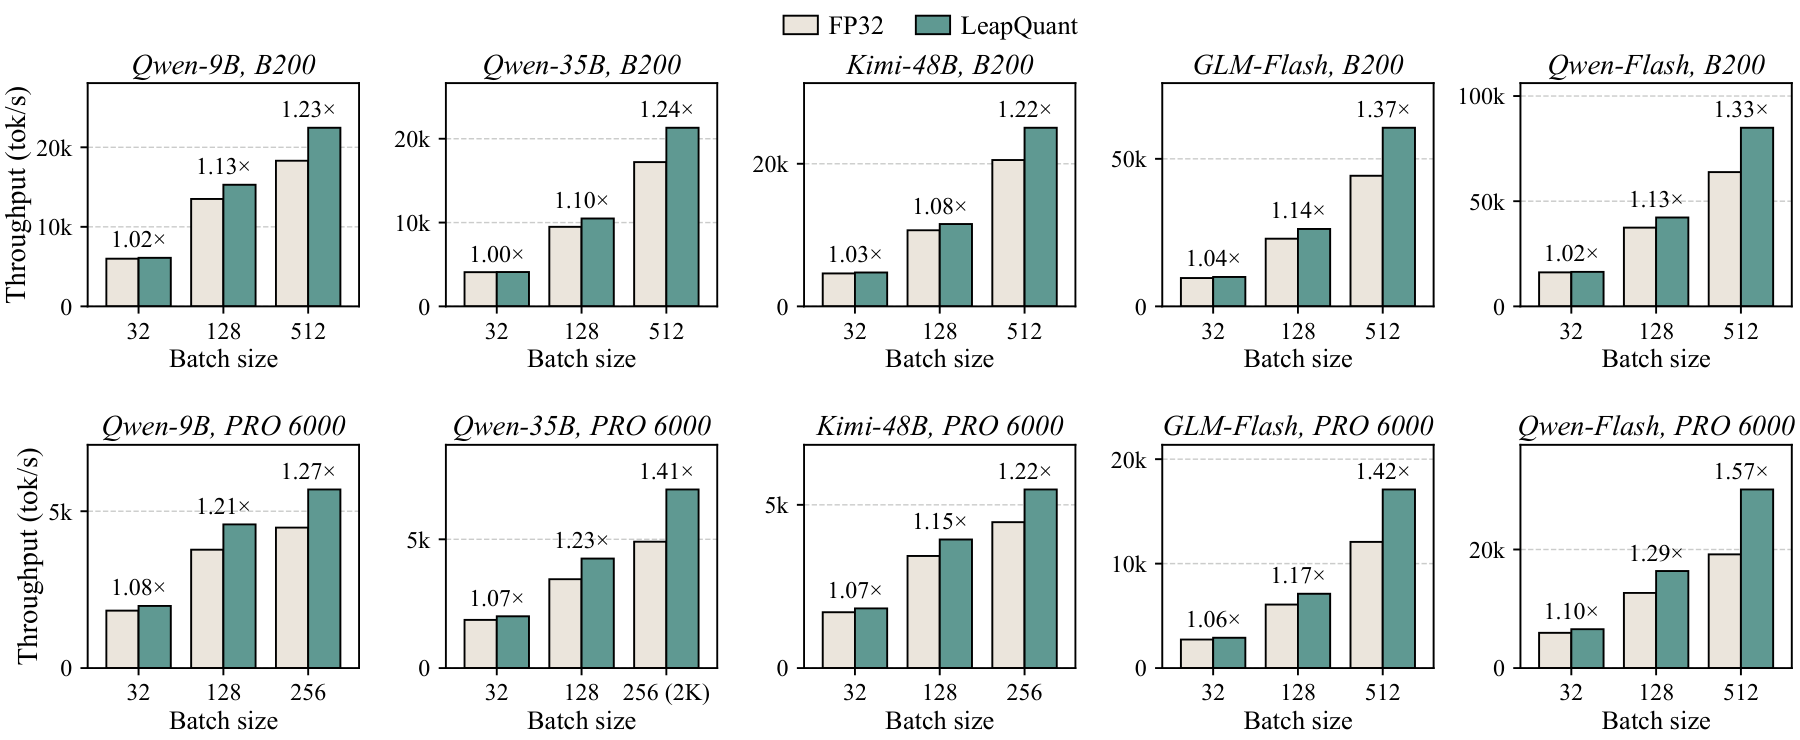
原文 Fig. 8,PDF p. 8。 每列对应一个模型,上排 B200,下排 RTX PRO 6000;横轴为 batch,纵轴为千 token/s。默认上下文 4K。
在 B200、batch 512 下,五个模型按 Qwen9B、Qwen35B、Kimi、GLM-Flash、Qwen-Flash 顺序,收益为 1.23 / 1.24 / 1.22 / 1.37 / 1.33×。后两个为 8 层效率模型。RTX PRO 6000 在可容纳的最大 batch 下为 1.27 / 1.41 / 1.22 / 1.42 / 1.57×。
该图有一个影响横向比较的例外:RTX PRO 6000 上三个完整模型最大 batch 为 256,Qwen35B 此时上下文改为 2K;两个 8 层模型可测到 batch 512。小 batch 收益较弱,例如 B200 上 Qwen35B 的 batch 32 为 1.00×。整模吞吐还受权重计算、MoE、其他注意力层等成本约束,不能由单层 4 倍收益直接推算。
4.5 状态内存:8 位残差不等于每元素只占 1 字节
原文报告窗口边界表示为 1.19 字节/元素。按 $d_k=d_v=128,r=4$,可以做如下表示尺寸推算:
这与约 1.19 字节一致;$4/1.1875\approx3.37$,即约 3.4 倍的边界状态压缩。尺寸推算对应向量尺度按 FP32 计的表示账本,不是独立的显存测量。还要另外计算活跃请求的更新缓冲,不能把 3.4 倍套到整个模型或每步所有内存流量。
正文给出 $p=16$ 时每头每层约 8 KiB 的 FP16 更新缓冲。结合 Table 4 的显式记录数,GDN 的 $16(1+128+128)\times2=8,224$ 字节约为 8 KiB;KDA 若显式保存每个通道的衰减,则 $16(128+128+128)\times2=12,288$ 字节,即 12 KiB。这是按附录记录格式的推算,说明缓冲大小依赖架构;正文的约 8 KiB 不应无条件应用到所有记录形式。
按每 1K 缓存 token 一个检查点的设置,作者报告端到端显存分别减少 41% / 51% / 56%(Qwen9B / Qwen35B / Kimi),Qwen9B 在一张 B200 上最多可容纳约 1.4 倍并发请求。检查点越多,压缩边界表示的价值越明显。(Sec. 4.3,PDF pp. 8–9;Appendix A/B.3,PDF pp. 13–14)
4.6 端到端推理:同时受益于更快解码与更高并发
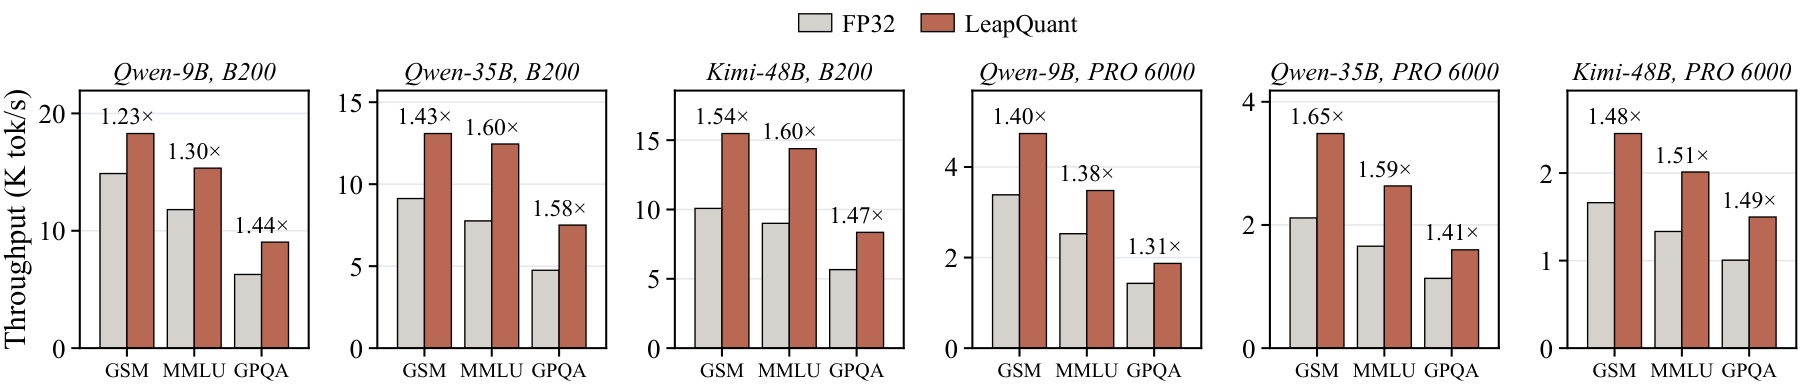
原文 Fig. 9,PDF p. 9。 六幅图为三个完整模型在两种 GPU 上的离线推理;横轴依次是 GSM8K、MMLU-Pro、GPQA,纵轴为千输出 token/s,柱上为吞吐倍数。
| 模型 | B200:GSM / MMLU / GPQA | RTX PRO 6000:GSM / MMLU / GPQA |
|---|---|---|
| Qwen3.5-9B | 1.23 / 1.30 / 1.44× | 1.40 / 1.38 / 1.31× |
| Qwen3.5-35B-A3B | 1.43 / 1.60 / 1.58× | 1.65 / 1.59 / 1.41× |
| Kimi-Linear-48B-A3B | 1.54 / 1.60 / 1.47× | 1.48 / 1.51 / 1.49× |
总体范围为 B200 1.23–1.60×、RTX PRO 6000 1.31–1.65×。图中 18 个四舍五入倍数的算术平均约 1.47,与作者的总体描述一致。这是输出吞吐,而非单请求延迟或首 token 延迟。Kimi 使用 Qwen9B 长度分布这一条件也适用于这里的全部 Kimi 数字。
4.7 消融:窗口化贡献最大,补偿和平滑收回剩余质量
| Qwen3.5-9B 状态方案 | AIME(%) | LCB(%) | 内核加速 |
|---|---|---|---|
| FP32 逐步 | 87.9 | 64.1 | 1.00× |
| BF16 逐步 | 72.1 | 49.6 | 1.64× |
| BF16 + 窗口 | 87.8 | 62.9 | 1.71× |
| INT8 逐步 | 7.1 | 9.2 | 2.43× |
| INT8 + 窗口 | 82.4 | 60.6 | 2.64× |
| 再加补偿 token | 86.6 | 61.5 | 2.56× |
| 再加平滑,即完整方法 | 87.9 | 64.1 | 2.52× |
来源:Table 2,PDF p. 9;内核在 batch 256 相对 FP32 比较。
窗口化把 INT8 的 AIME 提高 75.3 个百分点,是最大的单步改进。补偿和平滑再分别补回 4.2、1.3 个百分点。完整方法的内核速度略低于只有窗口的 INT8,但换回了基线质量。BF16 的窗口化结果也表明,时间上的误差注入频率是独立于 8 位格式选择的重要因素。
| 固定 $r=4$,窗口 $p$ | AIME / LCB(%) | 内核加速 |
|---|---|---|
| 4 | 86.2 / 62.8 | 1.59× |
| 8 | 87.1 / 63.2 | 2.13× |
| 16 | 87.9 / 64.1 | 2.52× |
| 32 | 87.9 / 64.2 | 2.20× |
| 固定 $p=16$,补偿数 $r$ | AIME / LCB(%) | 内核加速 |
|---|---|---|
| 2 | 85.7 / 63.4 | 2.57× |
| 4 | 87.9 / 64.1 | 2.52× |
| 8 | 88.1 / 64.0 | 2.37× |
| 16 | 87.9 / 62.8 | 0.74× |
来源:Table 3,PDF p. 9。
增大 $p$ 可减少边界处理,却扩大每步读取的缓冲、占用更多共享内存,$p=32$ 因此比 16 慢。增大 $r$ 提高低秩容量,但拟合与重建成本最终会暴露出来,$r=16$ 甚至慢于 FP32。默认 $(p,r)=(16,4)$ 是本文测得的质量与速度折中,并非两个参数越大越好。
4.8 长上下文:混合架构决定收益会不会被稀释
附录 Fig. 10 在 B200 上补充 1K、2K、4K、8K 上下文和多个 batch。该图是堆叠柱:浅色为 FP32 吞吐、深色为 LeapQuant 增量,完整柱高才是新吞吐。混合稠密全注意力的模型随上下文增大,未优化的全注意力占比上升;Kimi 在 8K、batch 512 下仍有 1.18× 解码加速。
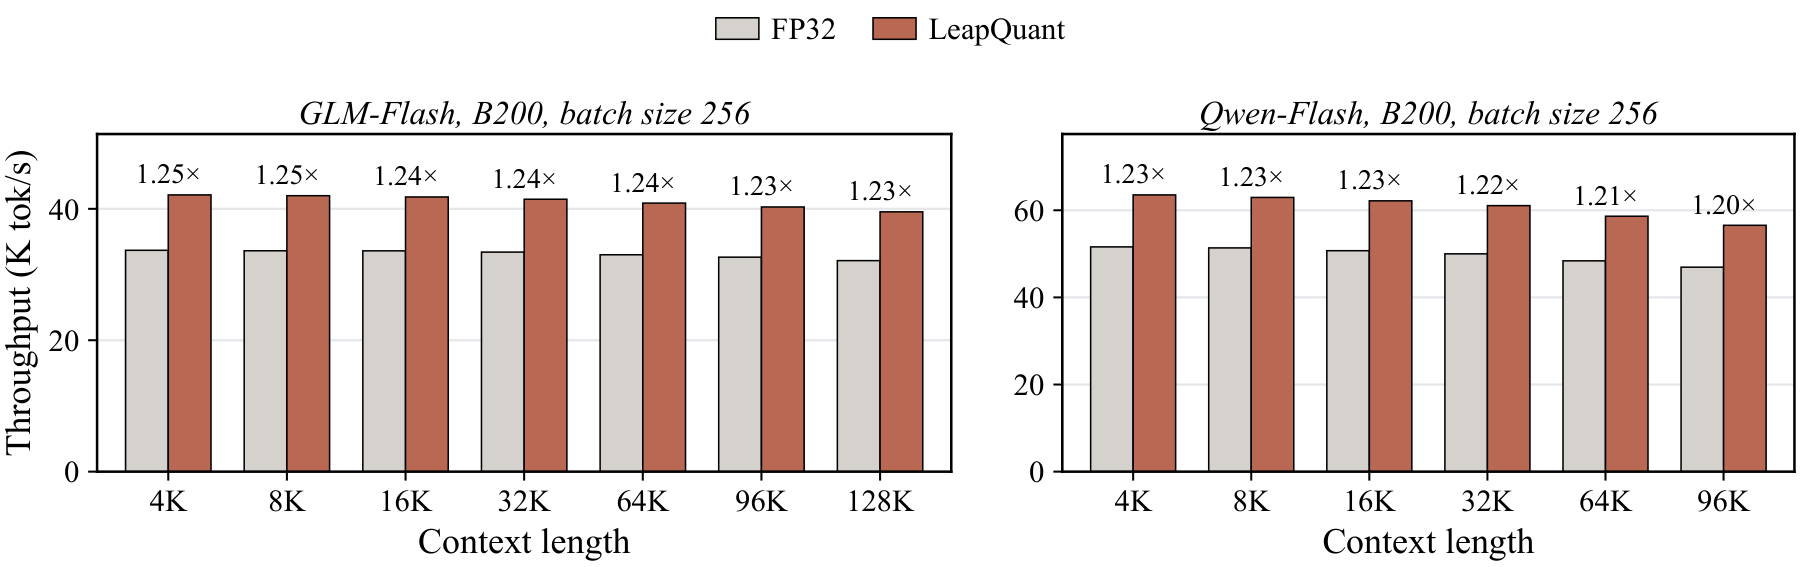
原文 Fig. 11,PDF p. 16。 B200、batch 256;左图 GLM-5.3-Flash 最长 128K,右图 Qwen3.8-Flash 最长 96K,均为 8 层效率版本。GLM 从 4K 的 1.25× 到 128K 的 1.23×;Qwen 从 4K 的 1.23× 到 96K 的 1.20×。线性注意力与稀疏注意力组合时,长上下文对相对收益的稀释较小。这组实验测量的是速度,未测量这些长度下的任务准确率。
五:结论——量化递归记忆,需要同时设计时间和表示
LeapQuant 最值得借鉴的思想是把何时量化纳入状态表示设计。递归更新经常比旧状态小,把每次微小变化都立即舍入会持续损失信息;用向量记录保留近期变化,再在窗口边界处理密集状态,可以同时改善精度和数据搬运。补偿 token 则让低秩保护和真实更新共享计算形式,使质量修复能够以较低的额外内核开销实现。
本论文最充分的实证结论是:在所测 GDN/KDA 完整模型中,8 位残差、少量 FP16 补偿项和窗口更新组合,保留了接近 FP32 的质量,并在大 batch 与前缀缓存较重的负载中产生吞吐收益。4 位有明显的模型和任务差异;小 batch、全注意力占比大的负载、过大的补偿秩也会削弱收益。
进一步研究可以沿两个具体问题展开:一是按层、按头或按轨迹动态选择 $p,r$,只在需要时多付出精度成本;二是在相同窗口机制下比较不同残差量化器和补偿拟合策略,区分表示选择与量化时机的贡献。这里是基于本文消融的研究推论,尚无本文实验结果。
图件均来自 Yi Pan 等人的 arXiv:2609.38166v1 作者源码,与原文对应图核对;原论文采用 CC BY 4.0 许可。除明确标出的教学例子、尺寸推算和研究推论外,实验数字均引用该版本原文。