Mixture of Self-Improving Branches for Agent Harness Optimization:中文精读笔记
作者:Haoyu Dong、Yuhang Zhou、Zihao Lin、Yifan Wu、Bo Peng、Mingyi Wang、Xiangjun Fan、Lizhu Zhang、Zhuokai Zhao
论文版本:arXiv:2609.37834v1,2026-09-29 提交;本次获取于 2026-10-23。
原文:本地 PDF · 作者 TeX 源码
论文总览
这篇论文研究的不是底层语言模型参数,而是包在模型外面的 agent harness:检索、提示词、工具接口、验证和控制流程等可执行代码。已有 Meta-Harness 让编码代理反复提出 harness、在固定开发集上评估,再用历史结果指导下一次提案;作者认为,固定开发题集和固定提案指导容易让搜索沿同一条轨迹前进,忽略总体分数稍低但能解决不同问题的候选。(Sec. 1–2,PDF pp. 1–3)
新方法并行维护两个搜索分支:根据各分支前沿候选对每道开发题的覆盖情况,动态调整分支的开发子集;同一编码代理还定期从各分支的局部历史修改其提案指导文件 SKILL.md。最终每分支选一个按自身开发子集得分最高的 harness,再训练路由器,在执行新题之前选用其中一个。四个“任务 × 行动模型”设置中,开发集选择的系统在留出测试集上都超过开发集选择的 Meta-Harness;最大的是 Math–Gemini,准确率由 46.0% 升至 62.0%,即 16.0 个百分点、相对提升 34.8%。(Table 1,PDF p. 6)
结构地图
| 原文章节 | 主要作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | harness 搜索的动机、分支与部署路由 | pp. 1–2;Fig. 1 在 p. 3 |
| 2. Related Work | 自动 harness 设计、多样性搜索、指导更新与路由 | pp. 2–4 |
| 3. Branching Search with Evolving Objectives and Policies | 分支目标、覆盖投票、指导更新、路由 | pp. 4–5;Eqs. (1)–(2)、Algorithm 1 |
| 4.1–4.2. Setup / Development-Selected Performance | 数据、模型、基线与四组主要结果 | p. 6;Table 1 |
| 4.3. Different Search Trajectories | 分支机制与互补覆盖 | pp. 7–8;Fig. 2 |
| 4.4. Router Analysis | 路由相对单专家的得失 | p. 8;Table 2 |
| 4.5. Method Ablation Studies | 开发集更新频率与两组件消融 | pp. 8–9;Table 3 |
| 4.6. Test Performance Analysis | 只用于事后分析的 test-best 候选 | p. 9;Table 4 |
| 5. Conclusion | 结果范围与成本、重复评估限制 | pp. 9–10 |
| Appendix A–E | token 用量、开发集演化、指导文件、路由细节、发现的 harness | pp. 12–20;Tables 5–6、Figs. 3–7 |
一:动机——改变搜索要优化的题,而不只改变答案代码
一个 harness 决定模型能检索什么、何时调用工具、何时要求验证或修订,因此同一行动模型可以因 harness 不同而表现不同。Meta-Harness 的迭代已能利用代码、得分和执行轨迹,但每次都在同一开发集上评价、使用固定提案指导。若候选 A 总分更高、候选 B 仅擅长一批 A 经常失败的题,按固定总体分数选父本可能不断扩展 A,B 的能力难被继续开发。(Sec. 1,PDF pp. 1–2)
作者的思路是让目标函数也随搜索改变:每个分支保留自己相对擅长的开发题,让这些题在本分支的候选排名中占比更高;再把本分支的成功和失败写入局部提案指导。分支的目标和提案倾向由此共同演化。部署时不比较不同分支的开发分数,因为分母和题集已经不同,而是为每道新题选择一个专家。(Sec. 1、3,PDF pp. 2、4–5)
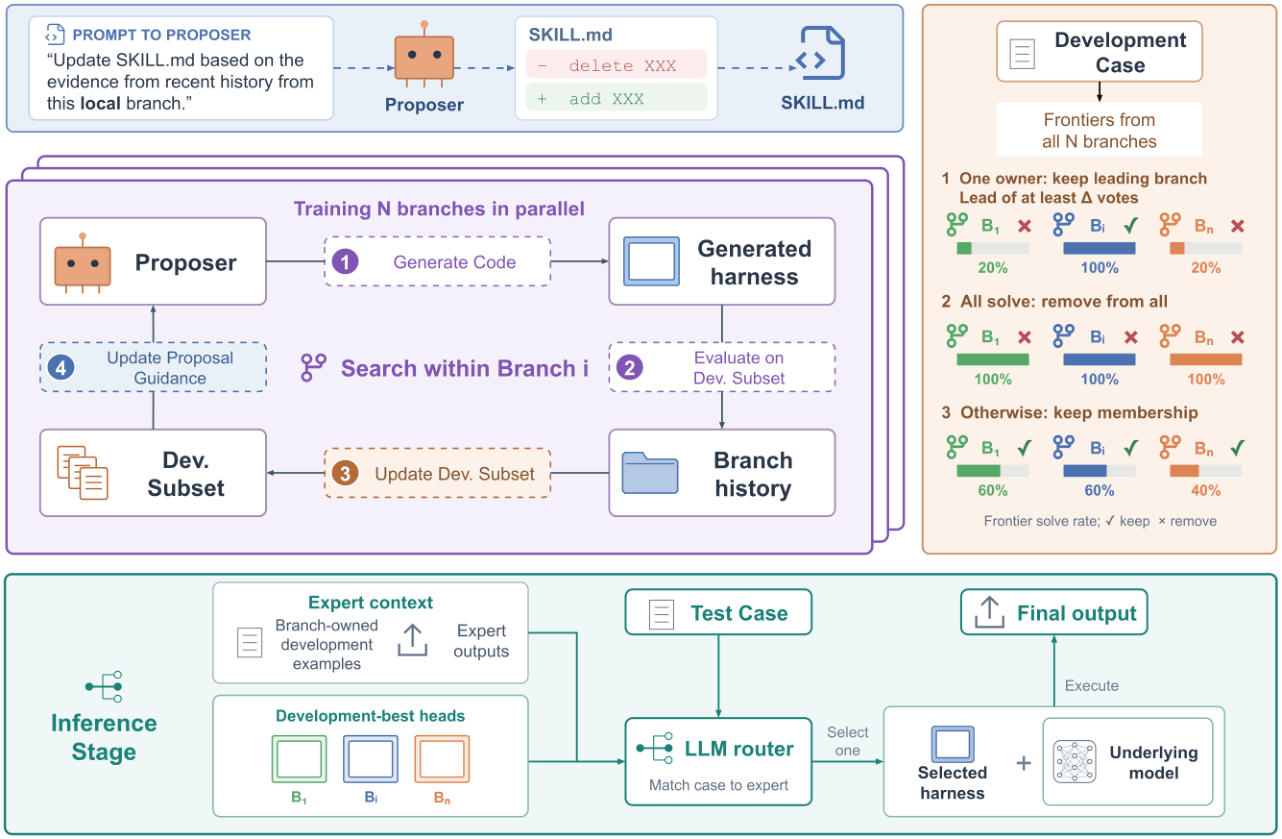
原图 Fig. 1(PDF p. 3):上半部是分支内“提案—评估—更新开发集/指导”的循环;右边列出开发题的三种归属规则;底部路由器在测试题执行前选择一个最终分支头。
二:方法——两个分支如何分化、如何合用
2.1 分支状态与优化目标
记完整开发集为 $\mathcal X$。在迭代 $t$,分支 $b$ 有当前题集 $\mathcal X_b^t\subseteq\mathcal X$、候选 harness 集合 $\{H\}_b^t$、含代码/分数/执行轨迹的局部历史 $\mathcal D_b^t$,以及记录提案经验的指导 $S_b^t$。共享的编码提案模型 $P$ 是 Claude Opus 4.6;执行候选的行动模型 $M$ 随任务设置而变。所有分支从相同种子 harness、完整开发集与初始指导出发。(Sec. 3,PDF p. 4)
候选 $H$ 在分支中的目标是其当前题集上的平均期望奖励:
$f_M(H,x)$ 是用 $H$ 驱动 $M$ 处理题目 $x$ 的随机执行轨迹,$r$ 是任务奖励;论文用观察到的平均奖励估计期望。分支的“头” $\widehat H_b^t$ 是当前候选中在 $\mathcal X_b^t$ 上得分最高者。由于题集会变,即使代码不变,候选排名和头也可能改变。每轮 $P$ 可阅读该分支既有 harness、得分及轨迹,再提出一个新 harness。(Eq. (1)、Algorithm 1,PDF pp. 4–5)
2.2 用前沿覆盖投票更新开发题归属
每个分支选当前得分最高的 $q$ 个候选组成前沿 $\mathcal F_b^t$,并对开发题 $x$ 计数:
若所有分支的前沿成员都解出 $x$,把它从所有子集移除;否则,若某分支的票数比其它任一分支至少高 $\Delta$,只让这个领先分支保留该题;其余情形维持原归属。例如 $q=5,\Delta=2$ 时,$4:1$ 使题独属领先分支,$5:5$ 使题从双方移除,$3:2$ 则保持原状。这里比较的是相对覆盖差异,不是按数学、代码等人工任务类别划分。(Eq. (2)、Sec. 3,PDF p. 4;例子是对规则的教学展开)
实验用两个分支、20 轮搜索,$q=5,\Delta=2$;各分支至少有五个候选后,默认每轮更新开发子集。图 3 中 Math–Gemini 在第 20 轮的 250 道开发题里,双方共享 25 题、分支 1 专属 14 题、分支 2 专属 6 题、双方移除 205 题。这说明目标确实大幅分化,也意味着最终分支头是按远小于完整开发集的子集选出的。(Sec. 4.1,PDF p. 6;Fig. 3,PDF p. 14)
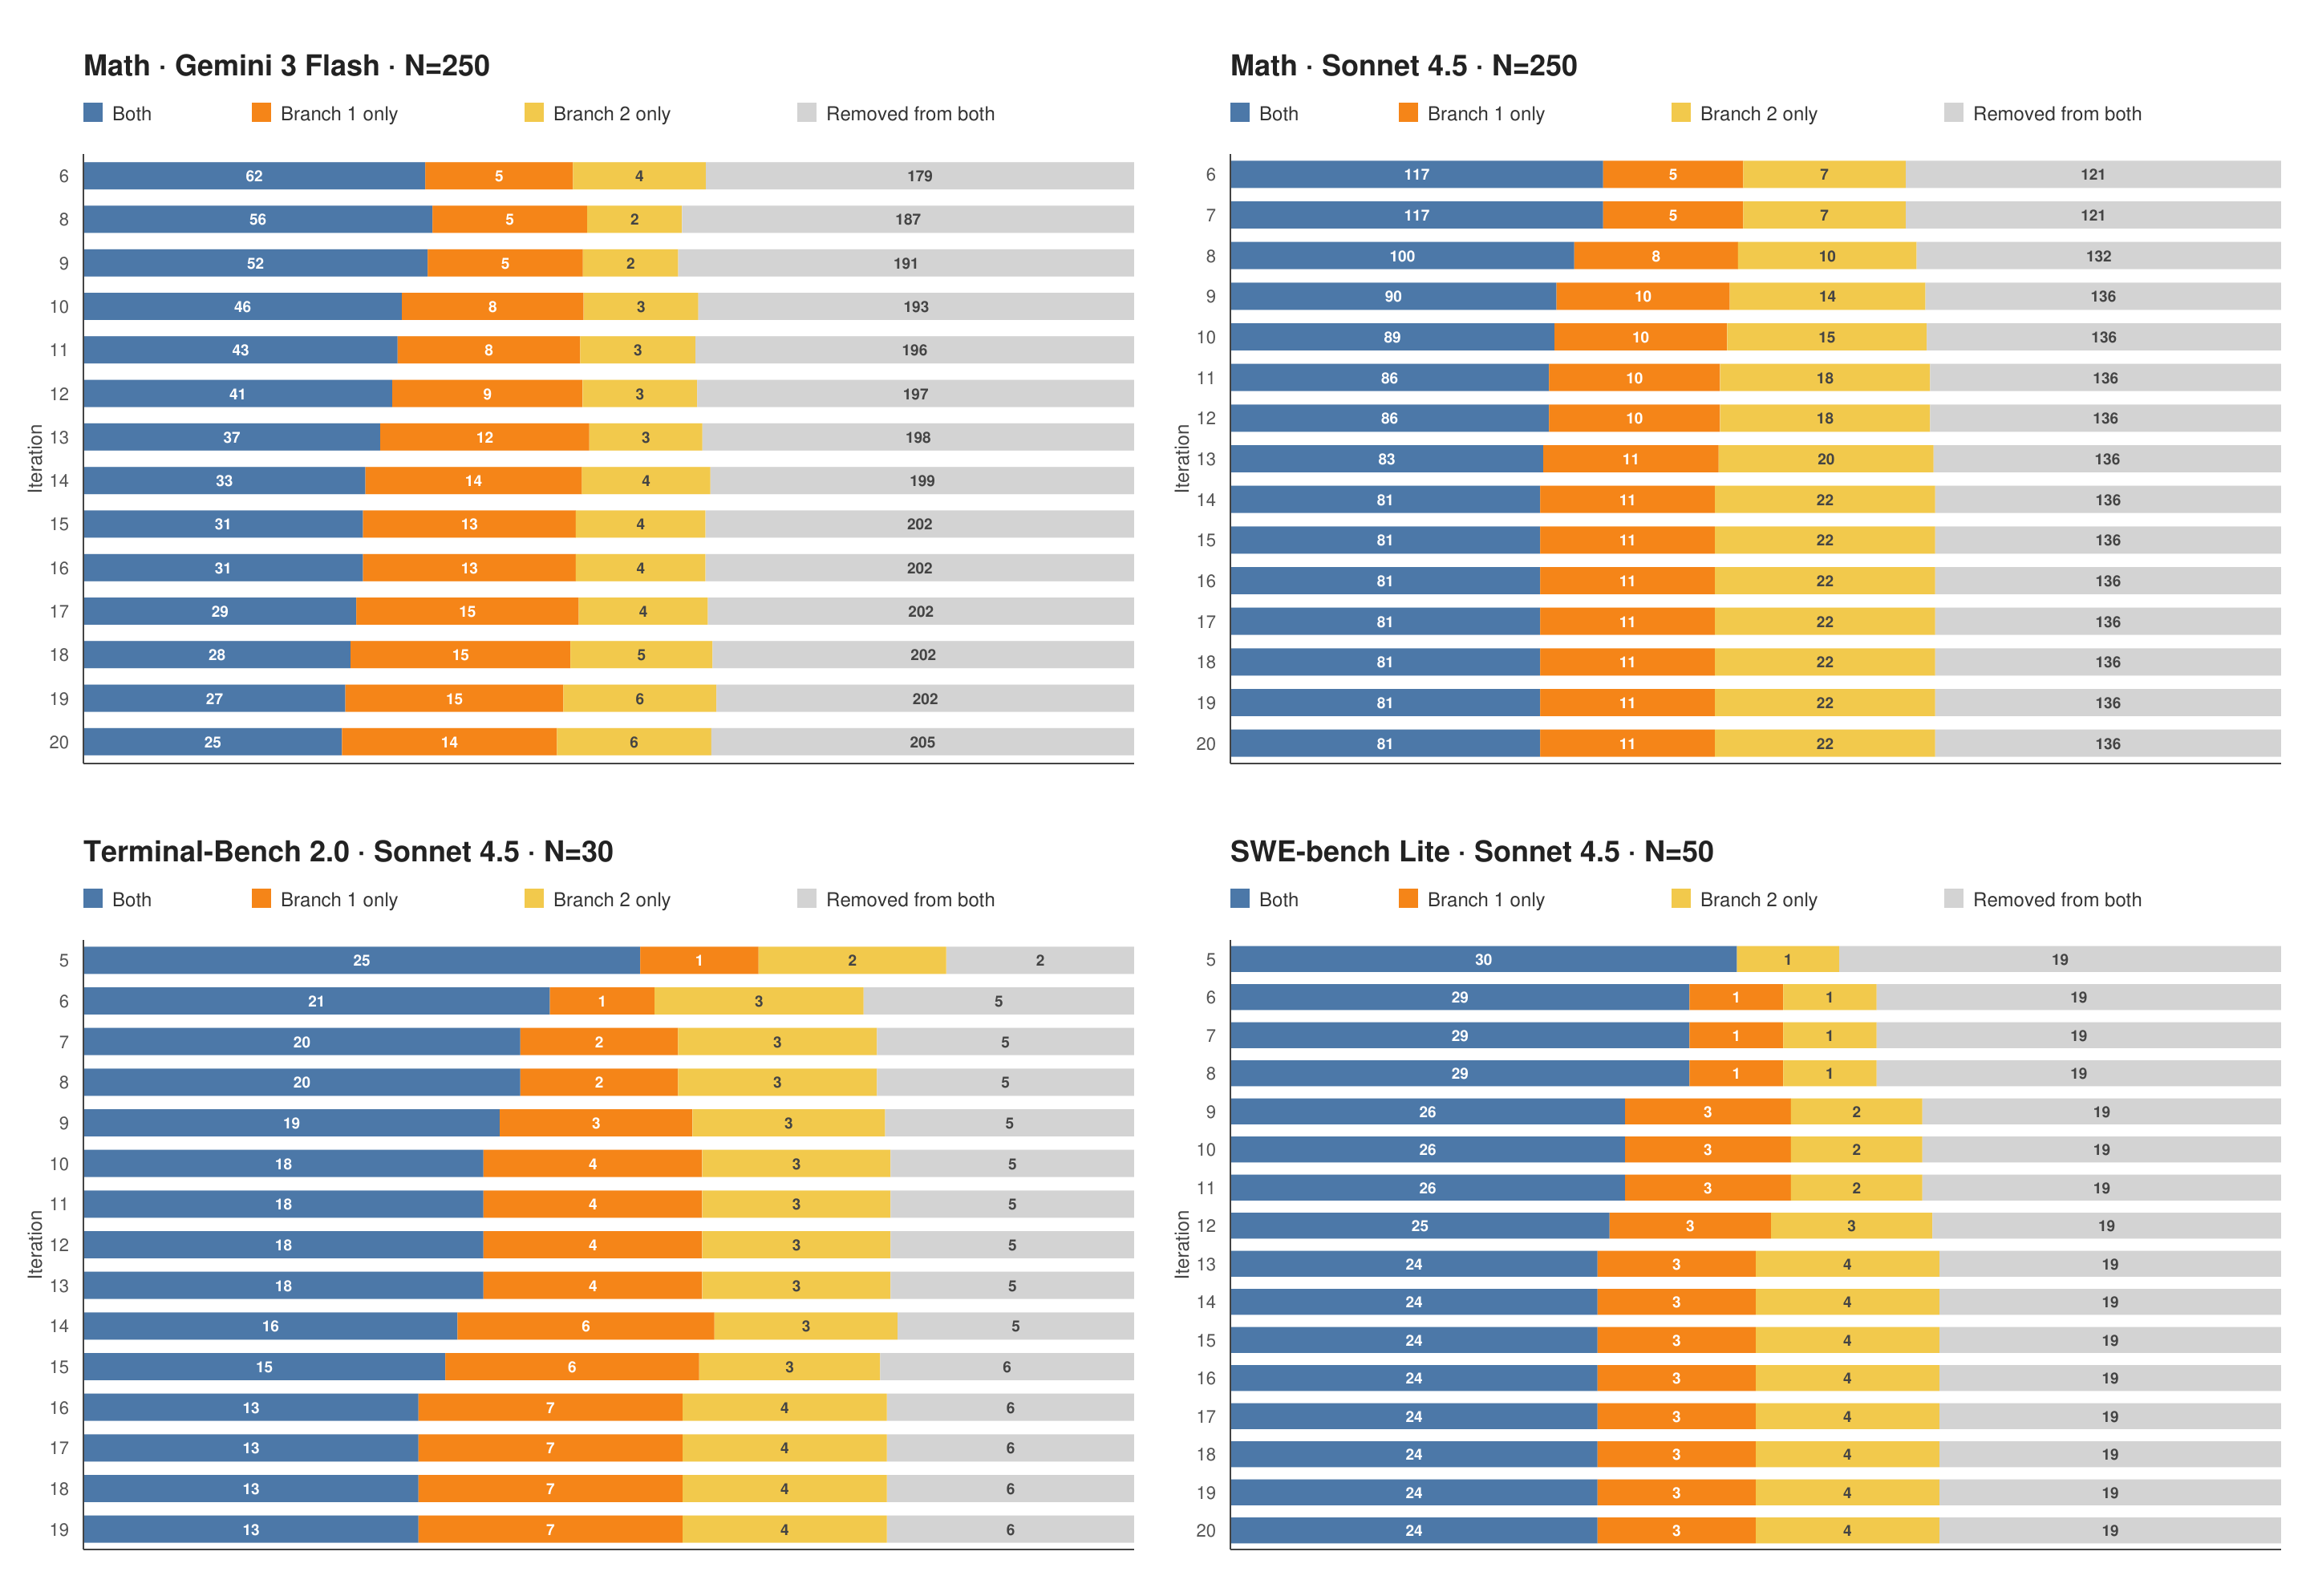
原图 Fig. 3(PDF p. 14):每条横条的四色数字相加等于对应设置的初始开发题数;色块宽度采用 $\log(1+n)$ 缩放,不能直接按像素宽度读题目比例。
2.3 分支局部指导:把搜索经验写回 SKILL.md
每五轮,仍由提案模型 $P$ 使用该分支最近的候选结果修订 $S_b^t$。附录中的更新提示要求:在同一开发题阶段比较分数,将一次实现的成败与跨多次实现重复出现的证据区分开;保留探索空间,不把开发题文本、答案或题号写入指导文件。开发题更新改变候选排名,指导更新改变下一轮怎样提出代码,两者作用不同。(Sec. 3,PDF pp. 4–5;Appendix C.1,PDF pp. 14–15)
Math–Gemini 的记录说明了“目标改变—头更替—后续提案延伸”的具体链条:分支 2 在第 13 轮删掉四道开发题,子集由 44 变 40;自由形式推导的 harness 取代几何感知双求解器成为头。随后第 14–19 轮的候选保留其自由推导,同时陆续加入针对性检索、构造/必要性双向论证、答案一致时的挑战等机制。另一分支更强调对检索解答中的具体事实和答案约束做检查。这个轨迹支持“开发集变化可以重新排列父本并改变后续探索”的机制解释;它本身不能把后续测试提升单独归因于第 13 轮的删题。(Sec. 4.3,PDF p. 7;Appendix B.2,PDF pp. 13–14;Fig. 4,PDF p. 16)
2.4 最终路由怎样避免使用新题的正确答案
搜索结束后,每个分支只保留在其最终开发子集上得分最高的头。路由器使用行动模型 $M$,输入包括两份专家源码、仅由开发集构造的“恰好一个头解出”的示例及两头在这些开发示例上的输出;用 GEPA 优化路由指令,示例标签是那个成功的头。面对新题,路由器先输出专家选择,然后才执行被选中的 harness;此时看不到两个专家在新题上的输出,也没有新题的正确性反馈。(Sec. 3,PDF p. 5;Appendix D.1–D.2,PDF pp. 17–19)
三:实验协议与比较对象
| 设置 | 行动模型 $M$ | 开发集 / 留出测试集 | 留出指标 ↑ |
|---|---|---|---|
| 奥赛级数学 | Gemini 3 Flash | 250 / 200 | 题目准确率 |
| 奥赛级数学 | Claude Sonnet 4.5 | 250 / 200 | 题目准确率 |
| Terminal-Bench 2.0 | Claude Sonnet 4.5 | 30 / 58 | 任务通过率 |
| SWE-bench Lite | Claude Sonnet 4.5 | 50 / 250 | issue 解决率 |
数学 harness 可从超过 50 万道题的解答库检索;Terminal-Bench 用真实软件环境中的长任务,SWE-bench Lite 用仓库快照和可执行测试。固定基线分别涵盖数学的无记忆/少样本/BM25 检索、Terminal-Bench 的 Terminus 系列及 SWE-bench Lite 的原版 mini-swe-agent。主要搜索基线 Meta-Harness 在固定开发集和固定提案指导下选择单一 harness;本文方案保留两分支头并路由。主表只用开发数据做 harness 与路由配置选择,留出集用于报告。(Sec. 4.1–4.2,Table 1,PDF p. 6)
四:结果——性能、互补性、组件和成本
4.1 留出测试:四组都超过 Meta-Harness
| 设置 | Meta-Harness | 本文路由系统 | 绝对提升 | 相对提升 |
|---|---|---|---|---|
| Math–Gemini | 46.0% | 62.0% | 16.0 个百分点 | 34.8% |
| Math–Sonnet | 29.0% | 30.5% | 1.5 个百分点 | 5.2% |
| Terminal-Bench 2.0 | 44.8% | 50.0% | 5.2 个百分点 | 11.6% |
| SWE-bench Lite | 63.6% | 66.0% | 2.4 个百分点 | 3.8% |
这些是 Table 1 的开发集选择后、留出测试集上的分数(PDF p. 6)。例如 34.8% 是 $(62-46)/46$ 的相对增幅,不是 34.8 个百分点。最大增益在 Math–Gemini;Math–Sonnet 和 SWE-bench Lite 的绝对差异较小。论文未给主结果提供独立重复搜索的方差,结论应对应这些具体搜索运行、开发/测试划分和行动模型。(Sec. 4.2、5,PDF pp. 6、9–10)
4.2 两个头确有互补题目,路由只利用其中一部分
| 设置 | 头 1 | 头 2 | 路由 | 两头覆盖并集(理想上界) |
|---|---|---|---|---|
| Math–Gemini | 56.0% | 58.0% | 62.0% | 67.0% |
| Math–Sonnet | 26.0% | 31.0% | 30.5% | 36.0% |
| Terminal-Bench 2.0 | 44.8% | 48.3% | 50.0% | 55.2% |
| SWE-bench Lite | 65.6% | 66.4% | 66.0% | 70.4% |
头和路由的测试分数来自 Table 2(PDF p. 8);并集来自 Fig. 2(b)(PDF p. 7),是事后知道“任一头是否做对”才能计算的非部署上界。Math–Gemini 路由比更强单头高 4.0 个百分点,Terminal-Bench 高 1.7 个百分点;另外两组各比更强单头少一道测试题。Math–Gemini 独属头 1/头 2 的正确题分别有 18/22 道,路由成功选到其中 12/18 道,总共利用 30/40 次独属成功,距并集仍差 5.0 个百分点。互补性存在,不代表当前路由已充分兑现它。(Sec. 4.3–4.4,PDF pp. 7–8)
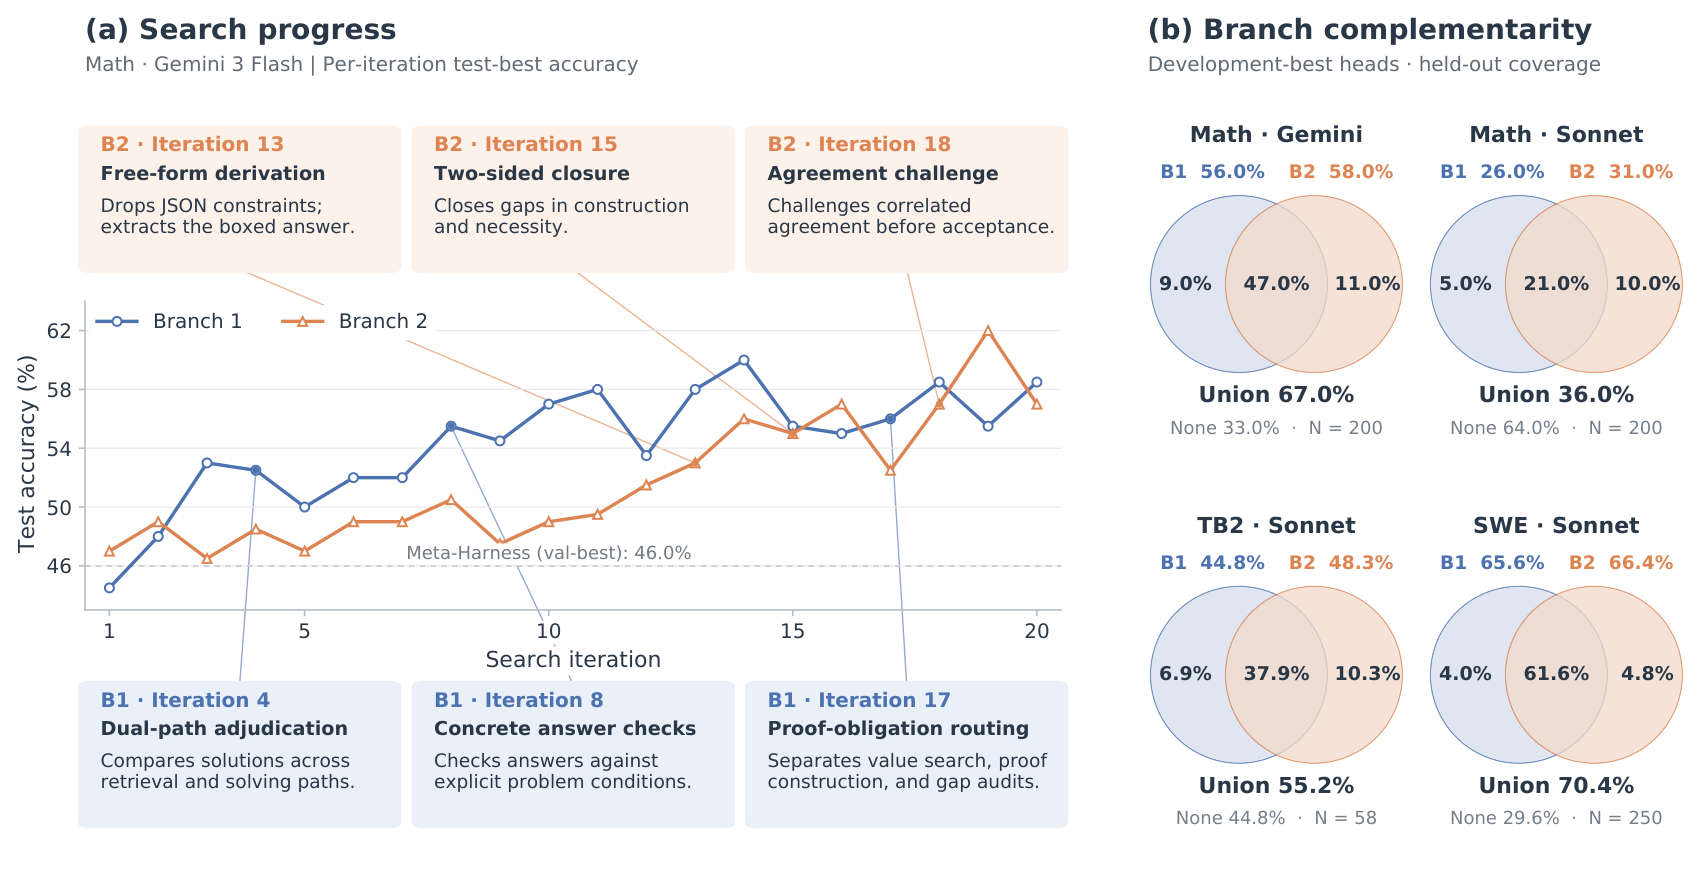
原图 Fig. 2(PDF p. 7):左侧的“每轮 test-best”只供事后分析搜索轨迹,不是在线提案或最终部署所使用的选择标准;右侧圆形面积为示意,百分数以完整留出集为分母。
4.3 消融:开发题更新与提案指导更新一起最好
Math–Gemini 下,开发子集每 5/3/1 轮更新时,默认路由的留出准确率依次是 53.0% / 56.0% / 62.0%。组件的 $2\times2$ 对照为:两者都关闭 51.0%;只更新指导 50.0%;只剪枝开发集 54.0%;两者都开 62.0%。在所测配置中,指导更新单独没有提升,和动态开发题组合后表现最好。这支持两组件的交互作用,但实验表只给汇总准确率,没有把每一次轨迹变化与最终增益建立独立因果对应。(Table 3,PDF pp. 8–9)
路由器本身也有消融。使用专家源码、独属开发示例及其输出的完整输入时,GEPA 优化使 Math–Gemini 由 59.5% 到 62.0%、Terminal-Bench 由 46.6% 到 50.0%,SWE-bench Lite 却由 66.4% 到 66.0%;增加上下文并非各设置都获益。主表采用完整上下文加 GEPA 的方案。(Appendix D.2,Table 6,PDF pp. 18–19)
4.4 事后 test-best 与真实部署选择要分开
Table 4 从每种方法预先按开发成绩挑出的十个候选中,再按测试成绩找最高者:Math–Gemini 的 Meta-Harness / 本文是 49.0% / 58.0%,Math–Sonnet 32.5% / 32.5%,Terminal-Bench 46.6% / 50.0%,SWE-bench Lite 63.6% / 66.4%。这是衡量搜索能发现什么候选的事后参考,部署时无法用测试正确率选人。Math–Gemini 的实际路由为 62.0%,高于事后最强单个候选 58.0%,因为逐题组合可以超过任何一个专家。(Sec. 4.6,Table 4,PDF p. 9)
4.5 代价:性能比较并非等 token 预算
| 使用 Claude Sonnet 4.5 的设置 | Meta-Harness 总 token(百万) | 本文总 token(百万) | 本文 / 基线 |
|---|---|---|---|
| 数学 | 79.92 | 172.90 | 2.16× |
| Terminal-Bench 2.0 | 2,366.80 | 4,001.39 | 1.69× |
| SWE-bench Lite | 1,907.17 | 2,951.48 | 1.55× |
Table 5(PDF p. 13)把任务求解与 harness 编写 token 相加,并将缓存 token 只计一次;数学这一行的行动模型是 Claude Sonnet 4.5,不能直接移用为最大增益 Math–Gemini 的成本。双分支虽通过删题减轻后续评估,完整搜索仍更贵。论文未报告等 token 成本下的性能比较,因此当前实验支持“在所用搜索流程下表现更好”,尚不能确定单位计算预算的收益。(Appendix A、Conclusion,PDF pp. 12–13、9–10)
五:结论与值得继续检验的问题
最值得借鉴的机制是把搜索目标从固定平均分改成相对前沿覆盖驱动的动态题集,再用分支局部历史更新提案指导;最终用开发数据训练路由器组合两个按不同题集选出的头。论文给出了头更替的具体记录,以及跨四组设置的留出成绩与互补覆盖。主要实证收益集中在 Math–Gemini 和 Terminal-Bench 2.0;Math–Sonnet、SWE-bench Lite 的路由收益较小,且路由在这两组稍低于最强单头。(Sec. 4–5,PDF pp. 6–10)
后续最直接的验证是等搜索 token 预算的对照与多次独立搜索的波动,因为附录记录的总消耗更高、正文也承认重复评估有限。复现动态剪枝时,还需明确一个实现细节:算法写新候选只在当前 $\mathcal X_b^t$ 上评价,却又对开发题比较各分支前沿的逐题覆盖;论文没有具体说明候选从未在某道已退出本分支的题上运行时,覆盖票如何补齐或处理。这个细节会影响开发题归属与可复现性。(Algorithm 1、Eq. (2),PDF pp. 4–5;Appendix A,pp. 12–13)