Context Language Models:中文研读笔记
作者:Rulin Shao、Shannon Zejiang Shen、Junjie Oscar Yin、Yuetai Li、Minheng Wang、Hamish Ivison、Radha Poovendran、Nathan Lambert、Teng Xiao、Mike Lewis、Wen-tau Yih、Luke Zettlemoyer、Pang Wei Koh。
版本:arXiv:2609.37725v1,提交于 2026-09-29;获取及研读日期:2026-10-10。
原文:arXiv 页面 · 本地 PDF · 作者代码链接。下文页码均指从 1 开始的 PDF 页码,与本版印刷页码一致。
论文总览
Context Language Models(CLMs,上下文语言模型)把下一轮究竟让模型看到什么交给模型自己决定。实现非常直接:把实时上下文镜像为一个可编辑文件,模型通过 Bash 或程序修改文件,运行框架再将修改同步到下一次模型调用。模型由此可以精确保留片段、原位更新状态、删除无关工具输出、把材料移到外存,以及自行编写和复用压缩函数。
这项工作在三个层面推进同一个思路:先用现有模型直接执行上下文编辑,再通过技能文档演化和强化学习改善编辑策略,最后通过后缀缓存复用(Suffix Cache Reuse,SCR)降低编辑后的重算开销。CLM 是对上下文状态转换接口与行为的改造;其零样本实现使用现有模型,并未要求一种新的 Transformer 层。(Sec. 4,pp. 4–6)
最有代表性的结果包括:Qwen3.6-27B 在 BrowseComp-Plus 上达到 59.4% 准确率,相对摘要基线提高 11.4%,前缀复用 FLOPs 减少 21.5%;Qwen3.5-9B 经 RL 后从 28.8% 提升到 42.5%,成本由 1.52 降至 1.34 PFLOPs/题;独立的 SGLang 服务实验中,SCR 将计算量从 10.98 降至 7.14 PFLOPs/题,两种服务方式的准确率均为 60.2%。这些结果分别来自不同实验,不能串接成同一条训练或加速曲线。(Fig. 5、Table 2、Fig. 9,pp. 7、9)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 总体问题、方案与贡献 | pp. 1–3,Fig. 1 |
| 2 Related Work | 区分固定框架、受限操作和可编辑上下文 | p. 3 |
| 3 Pilot Study with ContextBench: A Diagnostic for Context Management | 用合成任务隔离上下文管理能力 | pp. 3–4,Fig. 2 |
| 4.1 Formal Definition and Implementation with Context as a File | 文件机制、多智能体、计算口径 | pp. 4–5,Eqs. (1)–(3),Fig. 3 |
| 4.2 In-Context Learning and Reinforcement Learning for CLMs | 文本策略演化、成功门控效率优势 | pp. 5–6,Eqs. (4)–(6) |
| 4.3 (More) Efficient CLM Serving with Suffix Cache Reuse | 复用编辑后保留的缓存 | p. 6,Fig. 4 |
| 5.1 Evaluating CLMs Zero-Shot on Long-Horizon Agentic Tasks | 编程、搜索、数学和长期软件优化 | pp. 7–8,Figs. 5–6,Table 1 |
| 5.2 Learning Better Context-Management Strategies in Context or in Weights | 自然语言控制、技能演化和 RL | pp. 8–9,Figs. 7–8,Table 2 |
| 5.3 (More) Efficient Serving with Suffix Cache Reuse | 服务端成本分解 | p. 9,Fig. 9 |
| 6 Discussion and Future Work | 上下文完整性、扩大训练与框架蒸馏 | p. 10 |
| A Extended Related Work | 进一步定位外存、元优化和缓存复用 | pp. 13–14 |
| B Suffix Cache Reuse;C Prefix-Reuse FLOPs Computation | 混合注意力实现、近似与成本公式 | pp. 14–18,Figs. 10–14,Eqs. (7)–(9) |
| D ContextBench;E Experimental Configurations | 任务、基线、预算和训练配置 | pp. 18–24,Tables 3–5,Figs. 15–16 |
| F Supplementary Results;G Analysis on the Context Length Awareness of Existing LMs | 规模效应、128K、奖励消融和长度感知 | pp. 24–27,Figs. 17–22 |
一:动机
1. 上下文管理同时决定信息质量与计算成本
长任务的上下文会混合原始需求、搜索材料、失败尝试、工具输出、计划和当前进度。每次全部追加,会让过时内容不断占用窗口;达到阈值后统一生成摘要,又可能损失必须逐字保留的信息。例如,一个检索系统需要记住准确字符串,一个协作系统只需更新某个子任务的状态,两者适合的操作很不一样。
固定摘要框架把“何时压缩、压缩哪些内容、保留什么结构”大部分写在框架里。Self-Compact、ACM 等方法增加模型决策权,但可执行的操作仍由工具接口预先定义。CLM 将策略和具体变换一并交给模型,使它能够针对当前任务编写程序操作上下文。(Secs. 1–2,pp. 1–3)
2. 可编辑上下文与外存如何配合
区分两类文件有助于理解这篇论文:普通外存文件保存以后可能用到的资料;上下文文件直接规定下一次模型调用的输入。把一份搜索结果写入普通文件,并不会自动从实时上下文中移除它。CLM 可以把原文存盘、将实时上下文替换为索引,再在需要时检索回来。
作者对递归语言模型(RLM)的定位也基于此:RLM 将大输入作为环境中的变量,按需读取并递归处理;CLM 则编辑不断变化的交互历史。两者可以组合,一种控制材料进入上下文的方式,另一种控制进入之后的保留与更新。(Sec. 2,p. 3;App. A,pp. 13–14)
二:方法
1. 从追加输出到生成下一轮上下文
普通语言模型的上下文转换为:
其中 $c_t$ 是第 $t$ 轮上下文,$\theta$ 是模型参数,$\oplus$ 表示拼接。CLM 则抽象为:
这里的 $f^{\mathrm{CLM}}_\theta$ 包含模型控制的上下文变换过程。它可以保留现有文本、删去片段、插入笔记或调用自己定义的编辑函数,不要求每轮重新生成整份文件。(Sec. 4.1,p. 4)
一次实际交互包含以下步骤:
- 框架将实时上下文镜像到文件,并在系统提示中提供路径。
- 模型基于当前上下文生成回答、工具调用或编辑程序。
- 编辑上下文文件后,框架同步文件与下一轮模型输入;没有编辑时仍按通常方式追加生成内容。
- 多智能体场景保留多份上下文文件,各自与对应模型调用同步;创建和删除额外文件可对应子智能体的启动与终止。
以下是教学例子:一次搜索得到 30K tokens,模型把完整文本保存为普通资料文件,将实时上下文中的搜索结果换成“已核实结论、证据文件路径、尚未解决的问题”。下一轮只处理这份工作状态;需要核对原文时,再读取相关文件。此例说明文件同步语义,不是作者的原始轨迹。
论文的真实轨迹中,CLM 通过 163 次原位编辑维护多智能体状态表,同时把上下文维持在 6–8K tokens;另一个轨迹定义并调用 compact_turns 37 次。它还会建立内部 notes 标记、删除失败搜索的冗长输出、保留后续待尝试的想法。这些例子展示了可以表达的策略类型,而大规模效果由后面的定量实验支持。(Fig. 3,p. 5)
2. 为什么缩短上下文仍可能增加计算
标准前缀缓存只复用从头连续匹配的部分。如果上下文从 $[A,B,C]$ 改为 $[A,B',C]$,虽然 $C$ 的文本没变,它依赖的前缀已变,通常需要重新预填充 $B'$ 和 $C$。因此,成本应累计整个轨迹的重算和解码,而不能只看最终上下文长度。(Eq. (3),p. 5)
附录给出更具体的估算。令 $P_t$ 为本轮输入 token 数,$G_t$ 为生成 token 数,$R_t$ 为可复用前缀长度,$U_t=P_t-R_t$,则:
总轨迹成本为 $\sum_t F_t$。$C_{\mathrm{token}}$ 是每个新处理 token 的 MLP 和投影运算量;$C_{\mathrm{attn}}=4L_{\mathrm{attn}}h_qd_h$ 是每对 query–key 的注意力运算量,$L_{\mathrm{attn}}$、$h_q$、$d_h$ 分别表示全注意力层数、查询头数和头维度。方括号第一项对应新预填充的注意力计算,后两项对应解码过程。长度以 token 计,$F_t$ 以 FLOPs 计,1 PFLOP=$10^{15}$ FLOPs。(App. C,p. 17)
原文 Qwen3.6-27B 配置给出 $C_{\mathrm{token}}\approx48.70\times10^9$、$C_{\mathrm{attn}}\approx3.93\times10^5$。取 $P_t=20{,}000$、$G_t=500$,不同复用前缀得到:
| 可复用前缀 $R_t$ | 情形 | 单轮 FLOPs |
|---|---|---|
| 18,000 | 大部分历史仍可复用 | $1.41\times10^{14}$ |
| 10,000 | 中间编辑破坏后半段缓存 | $5.74\times10^{14}$ |
| 0 | 从开头编辑,无法复用前缀 | $10.81\times10^{14}$ |
以上是作者选择长度的示例,不是实验均值。由此可见,好的策略需要在当轮重算与未来多轮节省之间权衡。(Fig. 14,p. 18)
该 FLOPs 口径省略嵌入/输出层、Gated DeltaNet 状态更新、归一化、激活及 softmax 等操作;附录 C 的一般统计按前导消息匹配历史输入,RL 统计另用相邻轮次的精确 token 前缀匹配。它是明确口径下的模型计算估算,并非端到端耗时或 API 账单。(App. C,p. 17;App. E,p. 24)
3. 通过自然语言和技能文档学习策略
固定参数时,给定技能文档 $s$:
文档可以规定触发阈值、子任务边界或编辑前备份等行为。进一步令 $\tau(x;s)$ 为任务 $x$ 在技能 $s$ 下的完整轨迹,$R(\tau)$ 为轨迹奖励,则文本演化试图优化:
实现过程是训练样本上生成轨迹、提议模型阅读轨迹并改写技能、开发集评估并保留准确率与成本的 Pareto 前沿。辅助演化由更强模型提议,自演化由同一个模型执行与提议;二者都只改变技能文本。(Sec. 4.2,pp. 5–6)
附录配置中,候选先经过 6 个训练实例筛选,再增加 12 个实例,最后在每任务 102 个开发实例上判断前沿。最终选最高开发准确率,差异在一个标准误内时优先低成本。辅助演化冻结候选档案后,在 102 个测试实例、3 个种子上评估一次。这使测试集结果与反复用于筛选的开发集结果有明确区别。(App. E,p. 23)
4. 强化学习:只在成功轨迹之间比较效率
上下文编辑会删除或改写早期动作的输入,因此不能拿最终上下文重新计算所有旧动作的概率。作者采用 stepwise GRPO:保留每次调用的实际输入,把完整轨迹的结果优势分配给各段生成,在各自原始上下文下计算策略梯度;不对文件编辑过程求导。(Sec. 4.2,p. 6;App. A,p. 14)
仅奖励“多编辑”或“删得多”,可能鼓励无意义操作。论文增加成功门控的效率优势。这里 $c_i$ 表示轨迹 $\tau_i$ 的 FLOPs 成本,与前面表示上下文的 $c_t$ 含义不同;$\mathcal G_g^+$ 是组 $g$ 的成功轨迹集合,$\bar c_g$ 是其中平均成本:
少于两条成功轨迹时,整组的效率优势设为 0;总优势为 $A_i=A_i^{\mathrm{out}}+w_{\mathrm{eff}}A_i^{\mathrm{eff}}$。它只给更便宜的成功轨迹加分,失败轨迹不会因省算力得到效率奖励。附录训练设置为 $w_{\mathrm{eff}}=0.25$,应用于上下文管理 token。(p. 6;App. E,p. 24)
教学计算:成功轨迹成本分别为 1 和 3 PFLOPs,平均为 2,则效率优势分别为 $+0.5$ 与 $-0.5$;另一条失败轨迹即使只花 0.1 PFLOPs,这一项也为 0。成功门控减少了“快速失败就能拿效率分”的动机,但训练稳定性仍需实际曲线判断。
5. SCR:保留未变文本的旧状态,节省重新预填充
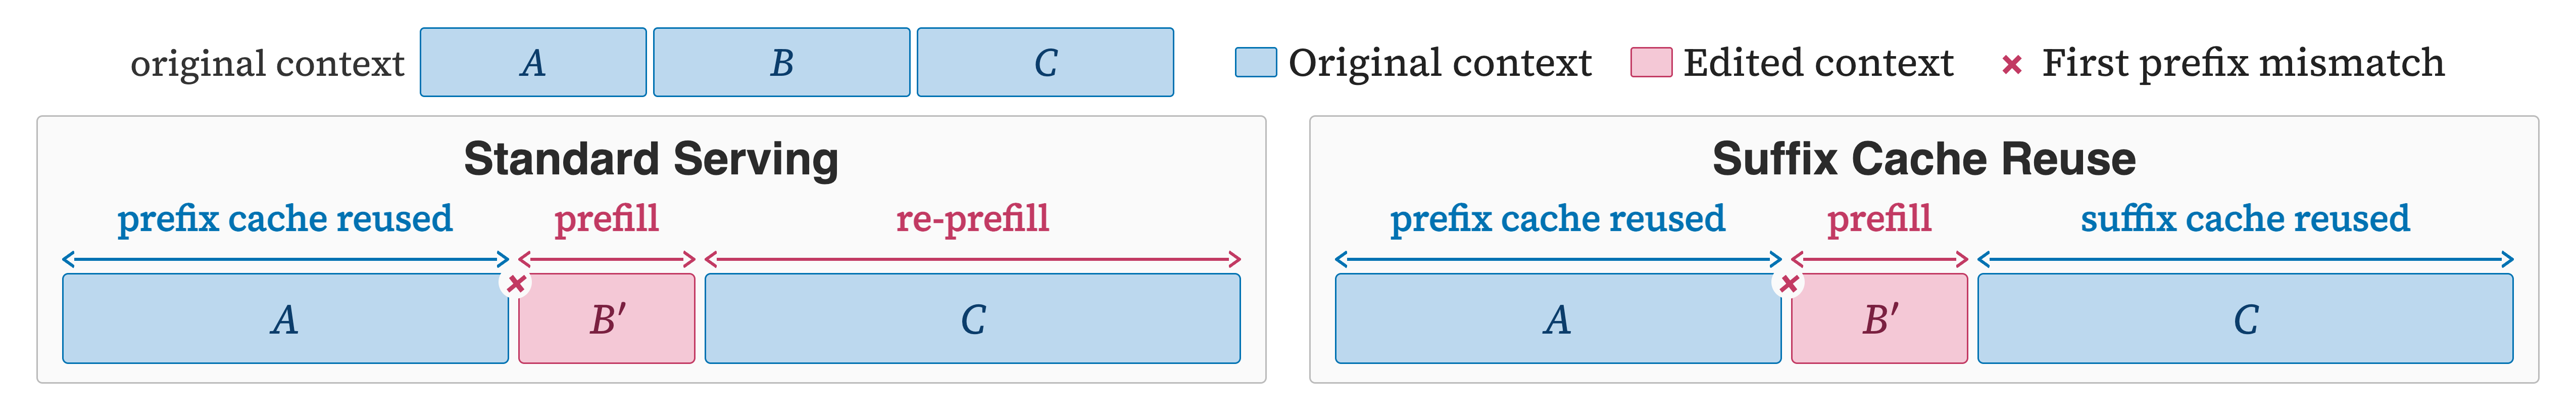
原图 4,PDF p. 6。蓝色是保留文本,粉色是改写文本;标准服务需要重算 $B'$ 和 $C$,SCR 额外保留 $C$ 的缓存。
在全注意力层中,SCR 对比前后两次输入,找出编辑后幸存的片段,按长度优先复用最多 $K$ 段,主实验取 $K=6$。保留的 key/value 被移到新位置,key 的旋转位置编码也相应调整;新增文本仍需要预填充。移动后的条目放在会话私有缓存中,不污染共享 radix tree;分配失败则回退到通常重算。(App. B,pp. 14–15)
这是近似复用:旋转位置可以修正,但旧 key/value 仍携带原前缀的语义影响。在 $B$ 改为 $B'$ 后,保留的 $C$ 状态不等于在新上下文完整重算的状态。作者认为旧状态有时可保留有益历史,但是否有益取决于任务,不能由位置修正推出语义等价。(Sec. 4.3,p. 6;App. B,p. 15)
6. 混合模型中的线性注意力处理
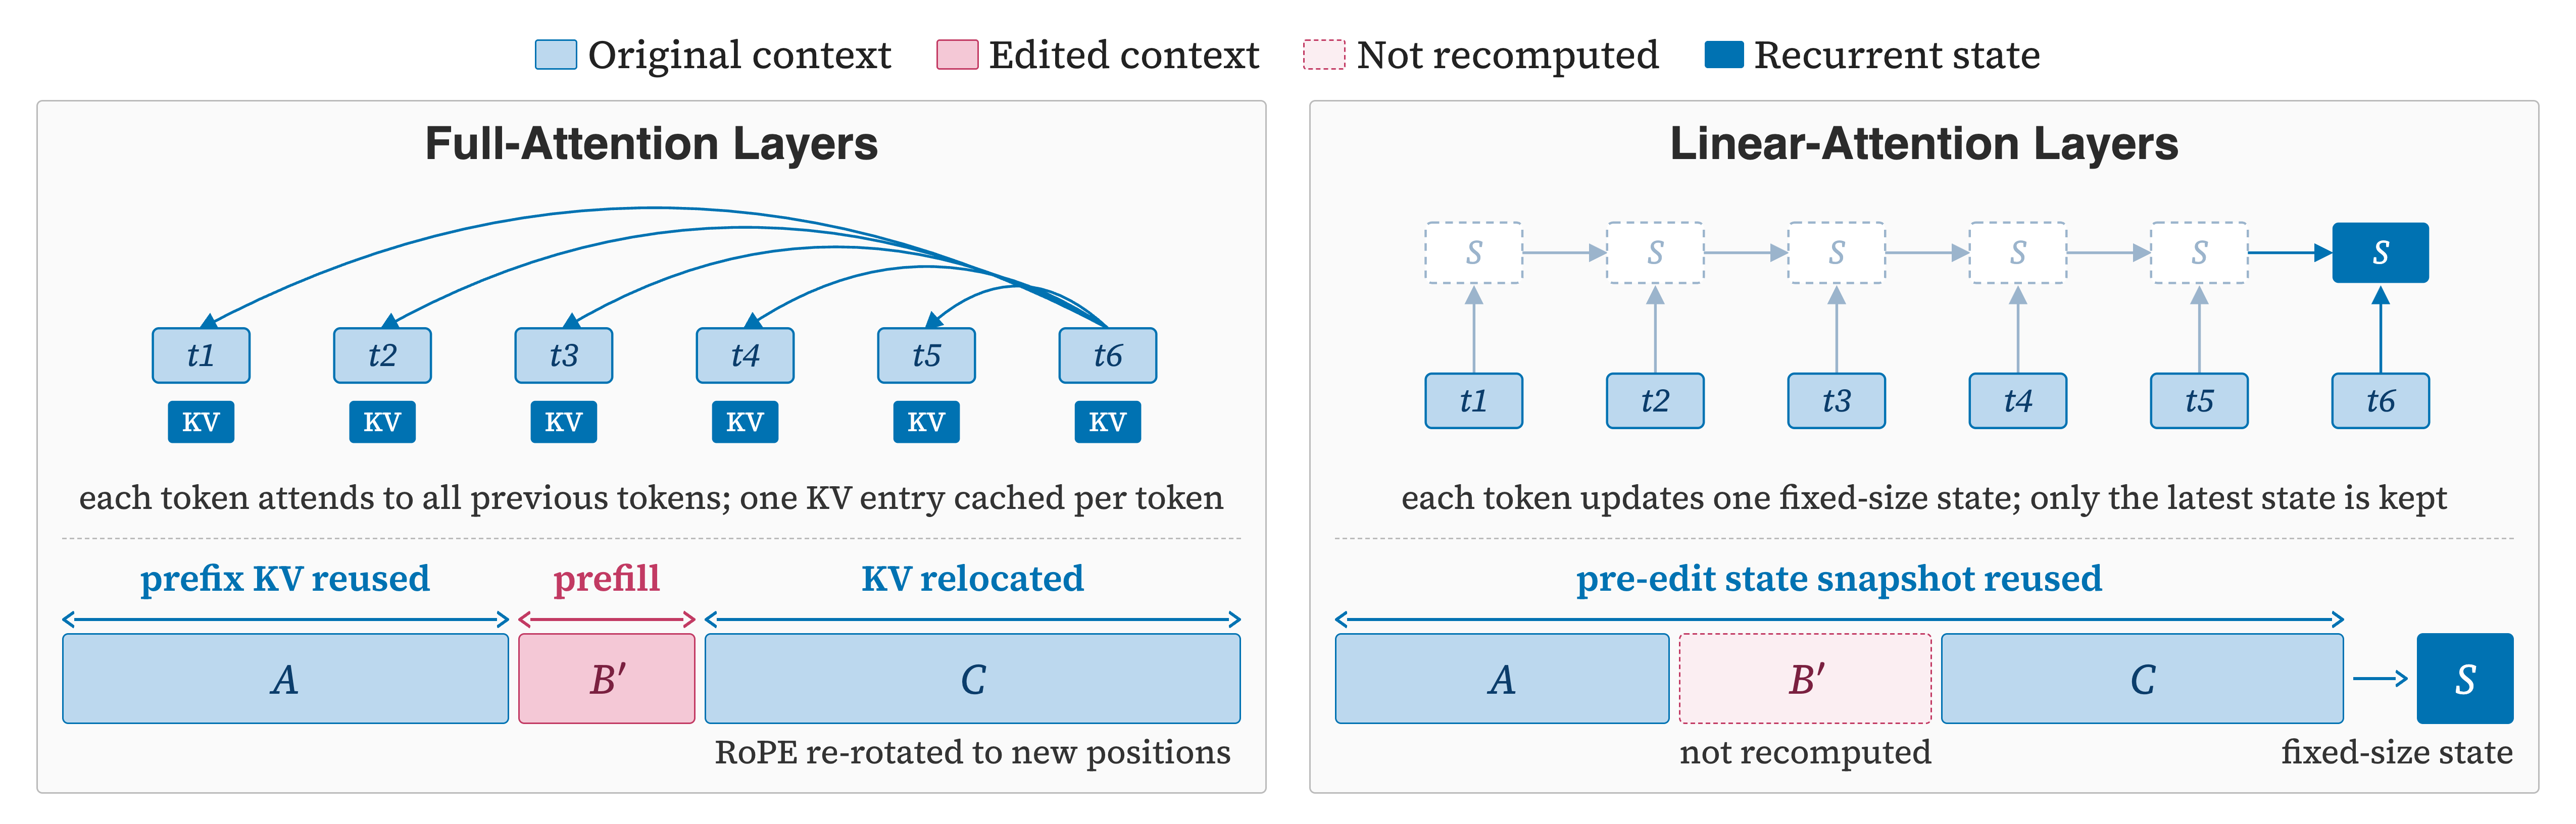
原图 10,PDF p. 15。左侧搬移逐 token 的 KV;右侧直接沿用编辑前的递归状态快照。
实验所用 Qwen3.6-27B 的 64 层中,48 层为线性注意力、16 层为全注意力。线性层没有可以逐 token 搬移的 KV,SCR 在这些层沿用编辑前快照,不按修改后的历史重放递推。新增 $B'$ 仍在全注意力层重算,并可通过后续层输入影响线性层。由此,文本上下文已经改变,内部递归状态却可能保留被删内容的信息。(App. B,p. 15)
我的理解是:SCR 将“当前可见文本”和“保留下来的内部状态”部分分离。这解释了它为何可以省算力,也指出了未来需要重点测试的场景——删除错误信息、替换过时事实或修正指令时,旧状态影响能否及时消退。
三:实验
1. ContextBench 怎样隔离上下文管理
ContextBench 连续向同一会话推送操作,每个操作必须先进入上下文,框架不能在输入时截断或移走它。模型处理完后才放行下一个操作。四类任务如下:
| 任务 | 要维护的内容 | 评分方式,越高越好 |
|---|---|---|
| Needle Retention | 大量干扰文本中的指定行 | 最终上下文中逐字保留的 needle 比例 |
| Sudoku Sketchpad | $16\times16$ 棋盘,逐轮只改指定格子 | 每次更新后完全正确的棋盘版本比例 |
| KV Store | 随机键值批次,之后进行 24 次查询 | 完整值的精确匹配准确率 |
| Log Triage | 大量服务日志,之后查找或计数 | 24 个问题的精确答案准确率 |
所有答案按实时上下文评分,只存到文件里而没有检索回答不计分。窗口为 32,768 tokens,其中 2,048 留给输出;生成器控制单个操作和必要保留信息能放进剩余窗口。上下文压力定义为累计输入量除以窗口长度,最高约 $24\times$。这样,原始流无法全部保留,但合理管理后的工作状态可以放得下。(Sec. 3,p. 4;App. D,pp. 18–21,Table 3)
模型为 GPT-5.4,每个难度 4 个种子,部分难度 8 个。各方法获得相同任务说明和适配自身工具的详细技能说明,因此这里的“零样本”意指没有对模型进行额外训练,不能理解为完全不给方法指导。(App. E,pp. 19、22;Table 4,p. 21)
2. 对照方法分别控制了什么
| 对照 | 管理机制 | 与 CLM 比较的意义 |
|---|---|---|
| Base / Mini-SWE-Agent | 追加历史,无主动压缩 | 没有上下文管理的下限 |
| Codex-style Summary | 达预算 75% 时生成摘要 | 固定触发、统一重写历史 |
| MEM1 | 每轮更新保留状态;本文重实现推理循环 | 高频、固定流程的状态压缩 |
| Self-Compact | 达一定占用后定期询问模型是否压缩 | 由模型决定触发,但操作固定 |
| ACM | 模型调用管理上下文及记忆检索工具 | 更丰富但预定义的操作集合 |
| Context Folding | 分支轨迹完成后折回摘要 | 能否消除已进入主上下文的负担 |
| RLM | 环境变量、REPL 与递归访问 | 按需读取大输入的策略 |
作者尽可能使用原实现;CLM 在距离预算约 2,048 tokens 时收到编辑提醒。提醒是当前实现的一部分,后文长度感知实验解释了为何仍需要环境提示。(App. E,p. 19)
3. 真实任务与统计口径
| 实验 | 对象与模型 | 预算、指标与统计 |
|---|---|---|
| TB2.1 / TBLite | 终端编程;Qwen3.6-27B,附录含 9B | TB2.1 有 89 题;验证器评分;成本按每题 FLOPs |
| BrowseComp-Plus | 830 个固定语料问题;Qwen3.6-27B | 搜索 top-10 片段、读文档;答案由裁判模型判完整正确;未答算错 |
| 数学优化 | 四个问题;Claude 4.6 Sonnet | 每方法一次运行,100 次已评分尝试或 5 小时;报运行内最好分数 |
| EdgeBench-10 | 从 48 个可运行任务选 10 个;Qwen3.6-27B / Claude 4.6 Sonnet | 每任务 3 种子、12 小时;按任务取 best-of-three,成本为单次平均并计入子智能体 |
| Software World | 六个代码库、六个智能体;GPT-5.6-Sol | 272K 上下文、超过 24 小时;未见过的四个下游包、17 项任务;执行指令数加速的几何平均,损坏任务计 1.0 |
Software World 以累计 API 美元支出比较资源,而非使用前面开源模型的 FLOPs 指标。(App. E,pp. 22–23)
预算描述有两处实质差异:Fig. 5 把三个基准统一写为 32K、100 轮,但 App. E 写 TB2.1/TBLite 为 32,000 tokens、64 轮,BCP 为 23,560 tokens、100 轮;BCP 的 CLM 编辑轮不计入上限,超限可回退重试最多 6 次。下文保留作者报告的结果,但不能把图注理解成完全相同的调用预算。EdgeBench 子智能体上限也在正文写为 5、附录写为 6,复现时需要进一步核对实现。(Fig. 5,p. 7;App. E,p. 22)
4. 强化学习配置
Qwen3.5-9B 在 3,040 条 OpenResearcher 提示上训练 70 步,每步 8 个提示、每提示 32 条轨迹。学习率 $10^{-6}$,KL 系数 0.01,使用动态采样、截断重要性采样;另用 500 个 OpenResearcher 验证问题选 checkpoint,再在 BCP 上测试。CLM 主配置加入效率优势以及工具调用/格式失败惩罚;附录将主摘要基线描述为只用任务奖励,奖励消融另外见 Fig. 21。(App. E,pp. 23–24)
因此,Table 2 比较的是各自训练后的系统,不能将全部差异单独归因为同一种损失下的上下文接口。零样本 BCP 使用的服务、预算和裁判设置也与 RL 部分不同,不应把附录零样本 9B 的 39.9% 与 Table 2 的 28.8% 当作同一实验的矛盾起点。
四:结果
1. ContextBench:原位编辑和按需移出信息具有明显优势
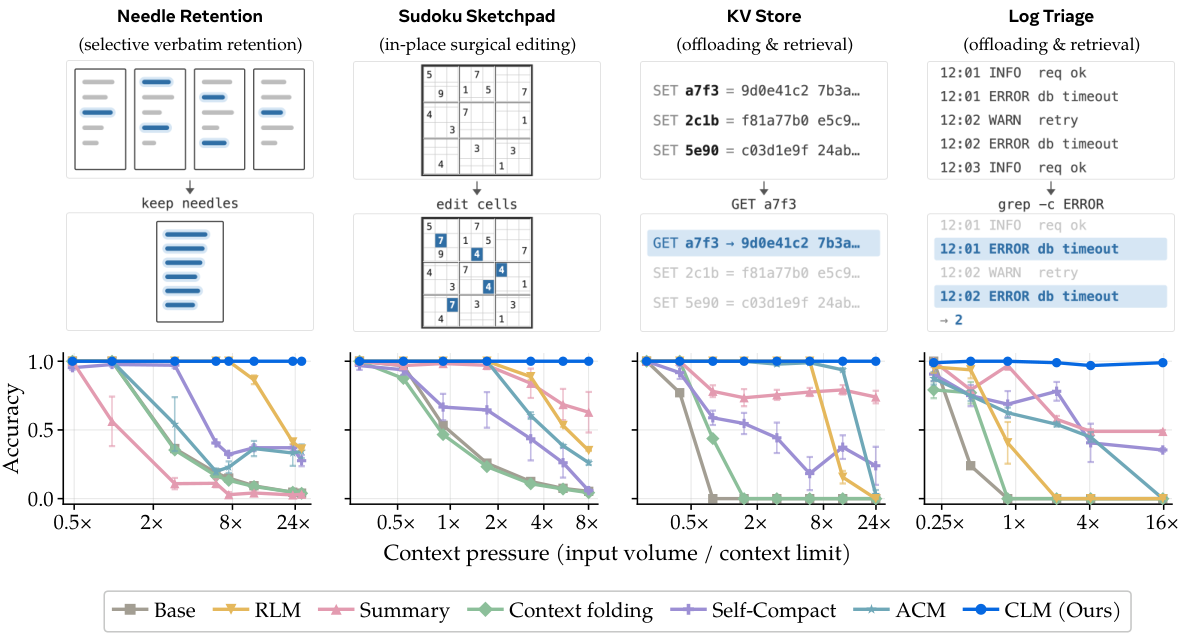
原图 2,PDF p. 4。四列依次是逐字保留、棋盘状态更新、键值查询和日志查询;横轴为上下文压力,纵轴为准确率。蓝色 CLM 在各压力水平基本维持接近满分,而其他方法在高压力下明显下降。
这个结果的机制解释相当具体:摘要对逐字字符串有损;棋盘适合定点修改,重复生成整盘既增加输出又容易出错;键值与日志可以存盘,但必须同时删去实时上下文里的旧材料。CLM 的优势来自能执行这些不同操作,而不仅是拥有额外存储空间。(Sec. 3,pp. 3–4;App. D,pp. 18–21)
2. Sec. 5.1.1:编程与深度搜索
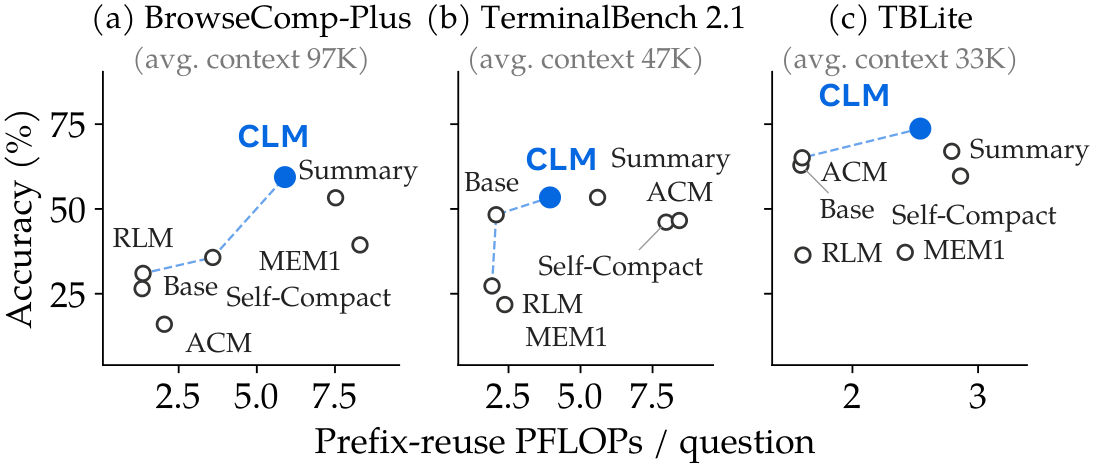
原图 5,PDF p. 7。纵轴为准确率,横轴为每题 prefix-reuse PFLOPs,理想方向是左上;蓝色虚线连接性能—成本 Pareto 前沿。
| 任务 | CLM 对摘要基线的结果 | 计算量 |
|---|---|---|
| BrowseComp-Plus | 59.4% 准确率;相对提高 11.4% | 少 21.5% |
| TerminalBench 2.1 | 准确率持平 | 引言报少 29.5%,正文约写为基线的 70% |
| TBLite | 73.7% 对 67.0%,提高 6.7 个百分点 | 约为基线的 91% |
BCP 对 MEM1 的计算量也减少 28.9%。这些结果表明,在把中途编辑导致的重算计入以后,CLM 仍可改善性能—成本关系。(Sec. 5.1.1,p. 7)
能力依赖在附录中很明显:9B 在 TB2.1 平均每题编辑 1.4 次,半数题目不编辑;27B 为 2.6 次。峰值上下文的中位数分别为 30.2K 与 17.6K。9B 在 BCP 超过摘要基线,但图 17 中其编程准确率并未全面领先。让模型自己管理上下文,需要足够的编辑决策和工具使用能力。(App. F,p. 24,Fig. 17)
3. Sec. 5.1.2:开放探索与长时程任务
数学优化。 OpenEvolve 是专门的程序演化框架;OpenEvolve-Agent 给候选生成器增加环境交互。CLM 通过一般 Bash 接口和上下文中的演化指导开展探索。
| 方法 | 圆填充:半径和 ↑ | Heilbronn:最小三角形面积 ↑ | 距离比评分 ↑ | Erdős 最小重叠界 ↓ |
|---|---|---|---|---|
| OpenEvolve | 2.541 | 0.03127 | 0.07690 | 0.38123 |
| OpenEvolve-Agent | 2.525 | 0.03053 | 0.07724 | 0.38167 |
| CLM | 2.618 | 0.03653 | 0.07758 | 0.38094 |
| CLM + 子智能体 | 2.636 | 0.03617 | 0.07758 | 0.38109 |
来源:Table 1,p. 7;进展曲线 Fig. 18,p. 25。距离比图中具体评分为 $(\min/\max)^2$。单智能体 CLM 相对 OpenEvolve 的 Heilbronn 评分提高约 16.8%、圆填充约 3.0%。包含子智能体的 CLM 系统在圆填充更好;这张表是单次运行内最佳值,不能当作重复实验均值,也不表示获得了数学最优性证明。
单代码库优化。 EdgeBench 的任务包括优化、科学计算、软件工程和游戏环境;指标经各任务 judge 归一到 0–100,表示解题质量。
| 模型与预算 | 摘要:分数 / PFLOPs | CLM:分数 / PFLOPs | CLM + 子智能体:分数 / PFLOPs |
|---|---|---|---|
| Qwen3.6-27B,32K | 42.3 / 437 | 44.6 / 179 | 44.2 / 181 |
| Claude 4.6 Sonnet,32K | 42.3 / 未给此口径 | 51.0 / 未给此口径 | 50.4 / 未给此口径 |
| Qwen3.6-27B,128K | 47.8 / 222 | 47.3 / 142 | 50.2 / 219 |
来源:Fig. 6a,p. 8;Fig. 19,p. 25。分数是每任务 best-of-three 后汇总,FLOPs 是每次运行的平均。32K 下 Qwen 的单智能体 CLM 比摘要高 2.3 分,按表中数值计算相对约 5.4%,计算量少约 59.0%。128K 时单智能体 CLM 更省算力但略低分,子智能体版本才达到最高分;“子智能体有用与否”随窗口和任务组织变化。
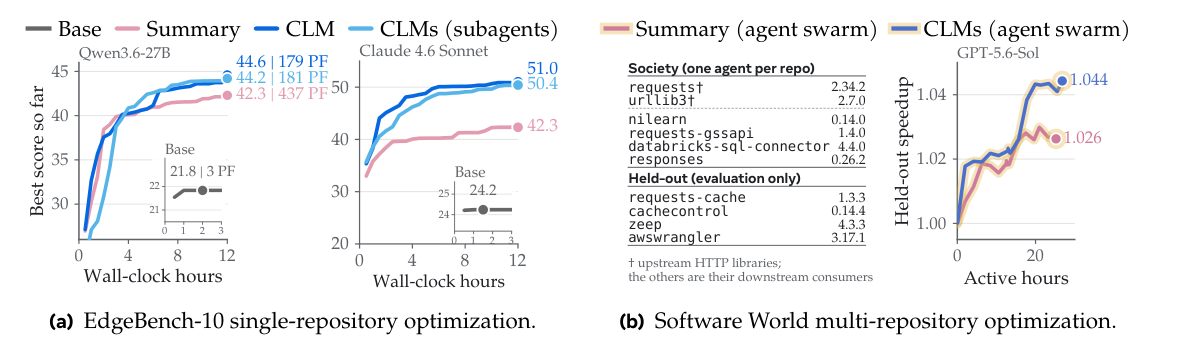
原图 6,PDF p. 8。左侧看 12 小时内最好分数的积累;右侧看未见下游工作负载的执行效率。两边纵轴衡量不同对象,不能横向比较数值大小。
多代码库 Software World。 六个智能体优化相互依赖的包,评估只使用未向智能体开放的下游包。图 6b 最终加速比约为 CLM 1.044、摘要 1.026,论文报告同等支出下加速收益多 65%。这里比较的是相对 1.0 基线的增量;不是整体运行速度提高 65%,也不是 1.65 倍。图上标签已四舍五入,不能用两项标签精确反算论文的 65%。(Sec. 5.1.2,p. 8;App. E,p. 23)
4. Sec. 5.2:策略可以被指示、演化和训练
一句话控制行为。 Claude 4.6 Sonnet 按 16K、24K、32K 阈值收到压缩指令后,首次压缩的上下文中位数分别为 16.0K、23.6K、30.9K。在子问题边界前后观察的边界后两轮内压缩率,由 0.40 提升到 0.88;要求备份后,约 0.68 的编辑前有完整备份,另约 0.09 为部分备份,无指令时图中为 0。(Fig. 7,p. 9)
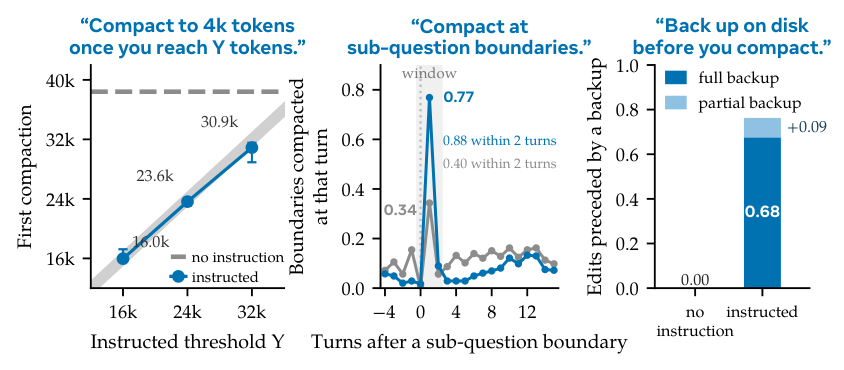
原图 7,PDF p. 9。三个面板分别测时机、语义边界和备份行为;它们展示可控性,没有直接测“该指令能提高最终解题率”。备份结果也说明遵从并非完美。阈值实验用 30 个较长问题,边界实验每条件 189 个会话,备份分析有 91 个配对问题;不能将三个比例当作同一批样本。(App. E,p. 23)
文本演化。 辅助演化用 Qwen3.6-27B 执行、Claude Fable 5.1 提议技能;自演化用 Opus 5 同时承担两者。开发集的辅助演化结果为:
| ContextBench 任务 | 初始准确率 | 选定技能准确率 |
|---|---|---|
| Needle Retention | 97.6% | 100.0% |
| Sudoku Sketchpad | 45.3% | 65.8% |
| KV Store | 22.3% | 83.8% |
| Log Triage | 0.0% | 100.0% |
最重要的留出测试结果是 KV Store 38.3% → 74.2%,提高 35.9 个百分点,不能以开发集的 61.5 点提升替代。Opus 5 起点已在 94%–100% 左右,自演化主要表现为同等或更高准确率下减少成本。(App. F,pp. 25–26,Fig. 20)
成本图也有选择条件:Qwen 的演化成本按完成预算约束的运行统计,Fig. 20 图注进一步写作 solved runs;Opus 用美元/任务。因此图中的 Pareto 点不等于包含所有失败运行和技能搜索开销的总成本。(App. E,p. 23;Fig. 20,p. 26)
强化学习主结果。
| 方法,Qwen3.5-9B | BCP 准确率:训练前 → 后 | PFLOPs/题:训练前 → 后 |
|---|---|---|
| 摘要框架 | 34.7% → 42.1% | 4.01 → 2.19 |
| CLM | 28.8% → 42.5% | 1.52 → 1.34 |
来源:Table 2,p. 9。CLM 增加 13.7 个百分点,相对为 47.6%;自身成本减少约 11.8%(摘要取整为 12%)。训练后与摘要相比,准确率高 0.4 个百分点,计算量少约 38.8%。这比单看“47.6% 提升”更清楚地说明结果:训练使较小模型弥补管理能力不足,在接近摘要框架的质量下保持更低成本。
奖励消融存在值得保留的图文差异。 正文 p. 9 说两种框架加入效率奖励都没有明显准确率损失,但 Fig. 21 的粉色实线表示 Summary + FLOPs reward,其准确率在训练 step 40 降至图示约 1%;蓝色 CLM 曲线则较稳定。附录主训练配置也明确把摘要主基线写成仅任务奖励。因而,Table 2 的最终比较与“效率奖励对两种框架都稳定有效”是不同主张;后者没有得到这张曲线的一致支持。(App. E,p. 24;Fig. 21,p. 26)
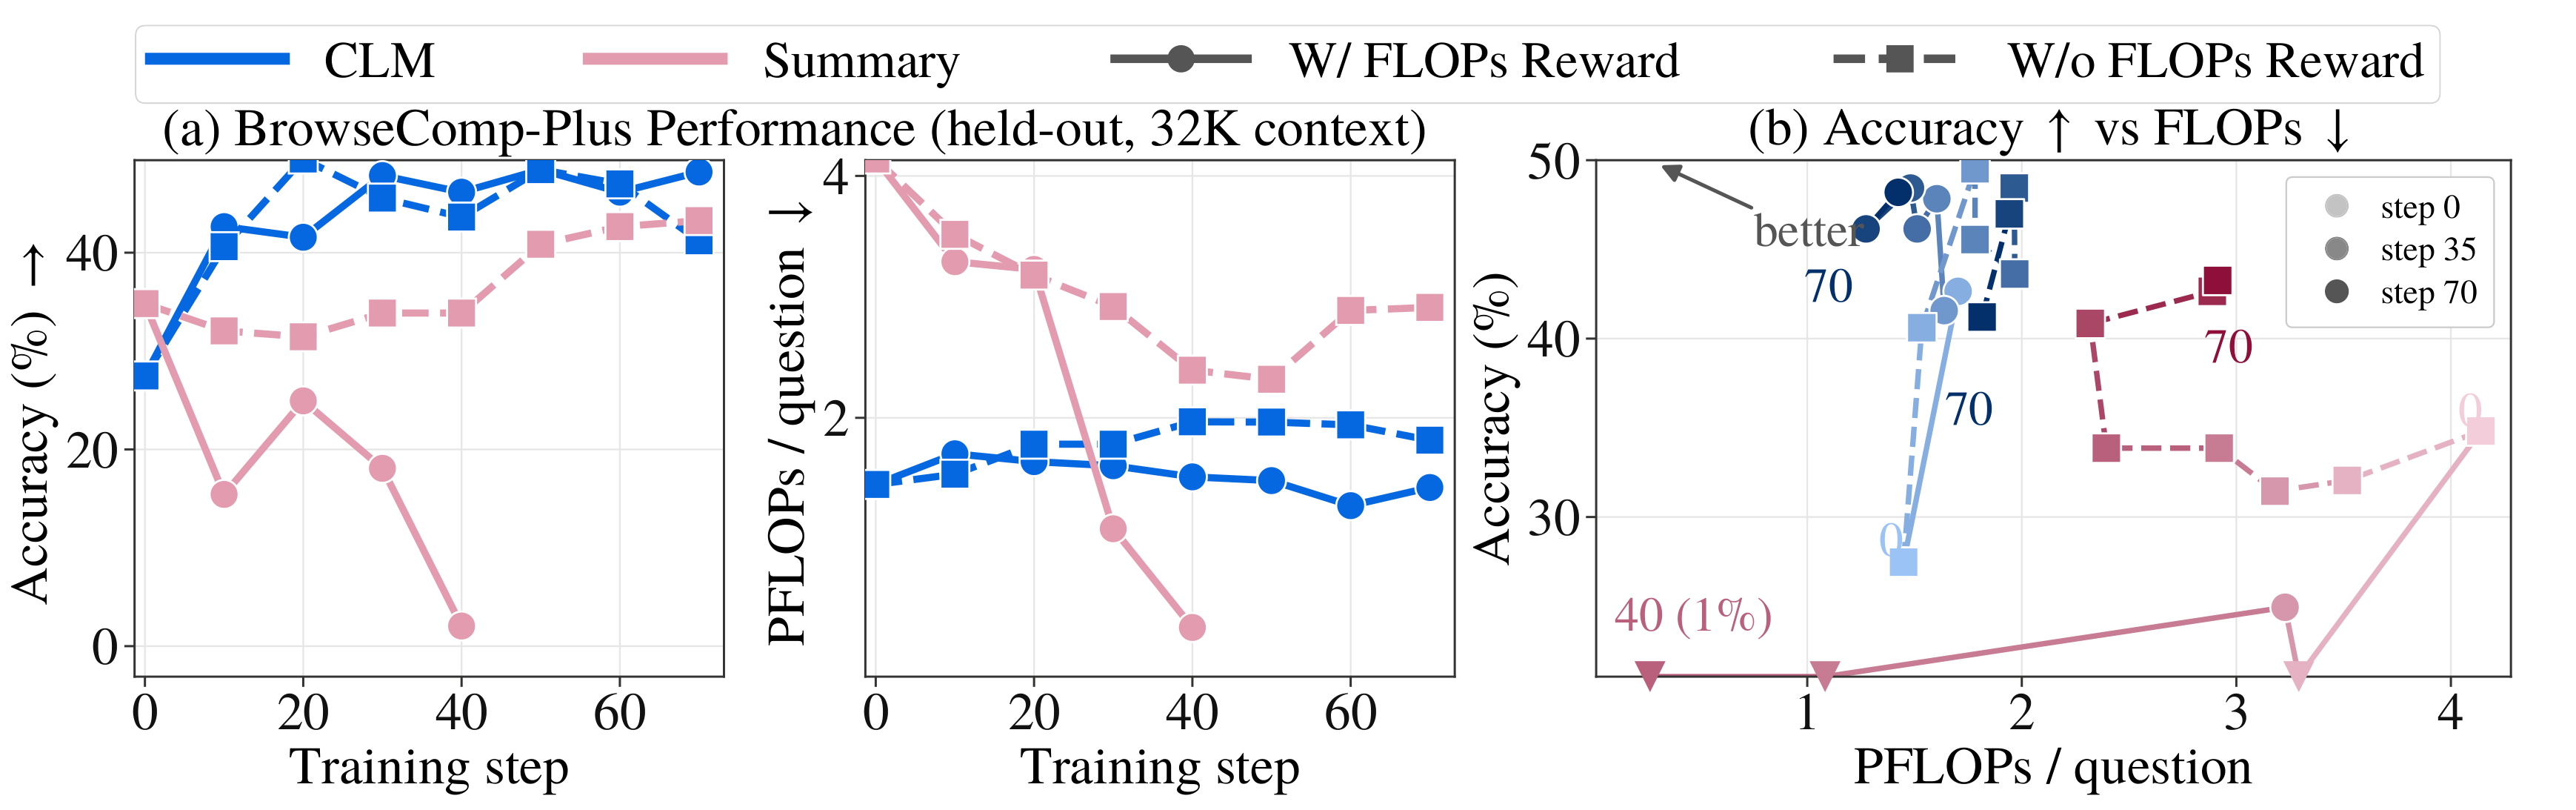
原图 21,PDF p. 26。蓝/粉区分 CLM/摘要,实线圆点与虚线方点区分有/无 FLOPs 奖励。左图直接显示上述摘要训练退化,右图把低于主坐标范围的点标为三角形。
5. Sec. 5.3:SCR 降低重算,但收益不全来自 CLM 主动编辑
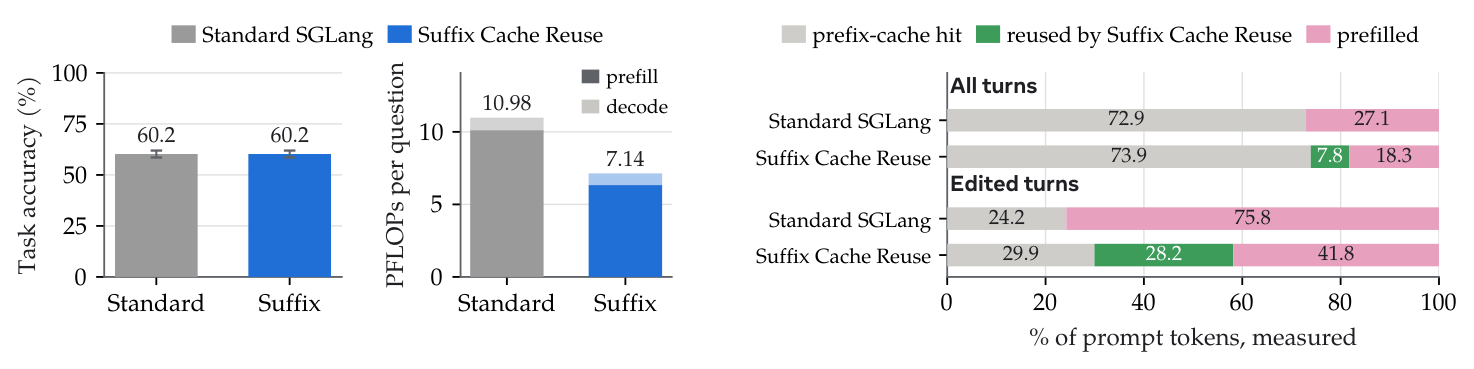
原图 9,PDF p. 9。左侧两个小图分别给准确率和 FLOPs;右侧条形图的分母为输入 token 数,是 token 类型占比,不是 FLOPs 占比。
在 Qwen3.6-27B、830 题 BCP 的 SGLang 实验中:
| 服务方式 | 准确率 ↑ | PFLOPs/题 ↓ |
|---|---|---|
| 标准 SGLang | 60.2% | 10.98 |
| Suffix Cache Reuse | 60.2% | 7.14 |
计算量减少约 35.0%。所有轮次中,SCR 额外复用了 7.8% 的输入 token;在编辑后的轮次中,这一比例为 28.2%,预填充比例由 75.8% 降到 41.8%。这些比例说明节省来自哪些处理路径,但不能直接替换为时延加速比例。(Fig. 9,p. 9)
进一步拆分,全轮次额外复用的 7.8 个百分点中,5.3 来自聊天模板移除先前 reasoning tokens 后对幸存文本的复用,2.5 来自其他上下文编辑。因此 SCR 的大量收益也适用于通常的推理模型聊天服务,并非 CLM 独有。(Fig. 12,p. 16)
作者在 64 个 BCP 问题上扫描 $K\in\{1,2,3,6,12,64\}$,图中准确率对 $K$ 较稳健,复用收益到 $K=6$ 附近趋于饱和。剩余重算的重要来源是混合模型递归状态只在请求边界保存:当新请求在一个缓存跨度中间分叉时,找不到足够近的状态快照,连未改的前缀也可能重算。更细粒度的状态检查点是明确的服务优化方向。(Figs. 11、13,pp. 16–17)
五:结论
这篇论文最有价值的贡献,是把上下文管理变成模型可表达、可学习的程序性能力。精确保留、原位更新、移出后检索、摘要、维护任务账本等行为不再必须由单一框架策略统一处理。实验同时表明,策略质量与基础模型能力、窗口大小、任务结构密切相关:9B 需要训练来补足能力,128K 下多智能体的优势也不同于 32K。
工程上应把两个层面分开评价。CLM 的前缀复用 FLOPs 结果已经计入编辑导致的通常重算;SCR 在此之外更改了服务端的状态复用方式,换取额外节省。后者会保留旧前缀影响,在线性注意力层尤其明显,评估时需要包含事实修正与删除等语义敏感操作。
上下文的可写性还改变了完整性问题。作者指出,外部材料中的提示注入或模型自行生成的指令可能经编辑后长期留存。维护可信指令与任务状态的边界,是可编辑上下文系统本身需要解决的问题。(Sec. 6,p. 10)
后续最直接的研究路线包括:让模型学会在长期收益与缓存破坏之间选择编辑位置和时机;改善长度感知,减少依赖外部提醒;将现有框架中的有效管理程序转成技能或训练数据。附录 G 的 50 个输入诊断显示,模型会出现分桶式长度估计,靠近估计位置的 token 数提示通常更有帮助。这提供了一个比“完全移除框架”更具体的训练目标。(Fig. 22,p. 27)