What Makes Recurrence Effective in Looped Language Models?:中文研读笔记
作者:Xinlin Zhuang、Siyuan Wang、Imran Razzak、Weiyang Liu(香港中文大学、MBZUAI)。
版本:arXiv:2609.36636v1,2026-09-29 提交;获取与研读日期:2026-10-15。
原文:arXiv v1 · 本地 PDF · 英文汇报 PDF · 可编辑 Beamer。下文页码均为 PDF 页码,与本版本印刷页码一致。
论文总览
循环语言模型(Looped Language Models,LoopLMs)重复执行同一组 Transformer 层,用较少独立参数提供更深的计算。本文追问的是:模型只在固定循环次数下训练,推理时多算几轮,究竟增加了有效推理,还是破坏了已经学好的表示?
作者从三个方面回答这个问题。第一,更多循环对能力的影响并不一致:Llama 风格的 BaseLoop $4\times5$ 从有效深度 20 增至 40 时,推理组分数从 28.52 升至 31.49,知识组却从 62.80 降至 52.11。第二,哪些层参与共享很重要:固定输出层 Coda 常能缓解少循环时的知识退化,固定输入层 Prelude 在部分配置中更利于推理外推。第三,每轮提供什么条件信号比单纯增加注入参数更重要:高容量的静态初始状态注入容易在深循环下崩溃,而近期状态差分和时间门控可以形成互补。
最有代表性的组合是 channel-wise history-state injection + Loop Gating(H+LG)。在 Qwen 风格 BaseLoop $4\times7$、历史窗口 $w=2$ 的组合对照中,推理深度扩到训练深度的三倍时,Overall 为 37.30,超过无条件 BaseLoop 的 35.60,也超过单独历史注入的 36.14。按论文给出的参数化计算,该组合只增加 $2\times1024+8=2056$ 个参数。它的贡献是改善指定配置下的预算适应性,并没有消除知识—推理取舍或找到跨架构统一最优的设计。(Sec. 3、6;Fig. 1、7;Table 8、10;PDF pp. 3–4、9、29–30。)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码 / 主要证据 |
|---|---|---|
| 1 Introduction | 提出训练循环数之外的计算扩展问题 | 1–2 |
| 2 Preliminaries and Evaluation Settings | 模型定义、预算、任务组 | 2–4;Eq. (1) |
| 3 When Does Recurrence Help? | 能力分化、难度分层、物理深度与循环数 | 4–5;Fig. 1 在 p. 3 |
| 4 Which Computations Should Be Recurrent? | BaseLoop/CoreLoop 与边界层分配 | 5–6;Fig. 2–3 |
| 5 How Should Recurrence Be Conditioned? | 初始状态、历史状态和时间条件 | 6–8;Eq. (2)–(3)、Fig. 4–6 |
| 6 When Are Conditioning Mechanisms Composable? | 两两组合、三者组合及计算交互 | 8–10;Fig. 7–8 在 p. 9 |
| A Limitations;B Extended Literature Review | 规模与外推边界;相关工作的定位 | 15–16 |
| C Experimental Settings | 架构、训练、任务、几何探针的精确定义 | 17–25;Table 1–6、Eq. (4)–(33) |
| D Full Experimental Results | 优化器、边界层、注入、时间门控、组合的完整结果 | 26–35;Table 7–12、Fig. 9–21 |
| E Further Analysis | 初始噪声、未归一化交互及分层分析 | 33、35–36;Fig. 22–23 |
一:动机——参数共享之后,计算为什么未必仍然有效?
独立的深层网络可以让不同层承担不同变换。循环模型则反复使用同一函数;权重相同,输入的隐藏状态却随轮次改变。训练只要求第 $K$ 轮的输出有用,既不直接监督提前停止的状态,也不直接约束第 $K+1$ 轮以后的轨迹。因此,推理时增加循环次数并不是免费获得一个训练过的更深模型。
这产生三个相互关联的问题:当前任务是否真的需要更多组合计算;独立层与共享层怎样分工;共享函数能否感知自己正处于什么轨迹和计算阶段。本文把这些问题拆成受控对照,重点不是提出一个庞大的新架构,而是寻找使循环计算持续有效的设计条件。
论文将相关工作区分为从头预训练循环结构,以及把循环结构迁入已有预训练模型两条路线;本文属于前者。初始状态注入沿用 Huginn 一类设计,AdaLN 调制借鉴 LoopFormer;本文重点考察的新增方案是相对历史状态注入,以及它与轻量时间门控的组合。(Sec. 1;App. B,PDF pp. 1–2、15–16。)
二:方法——区分网络布局、状态条件和时间条件
2.1 基本模型及统一符号
按照 Sec. 2.1 和 App. C.1 的定义,模型写成
这是原文 Eq. (1) 的结构,省略了最终归一化。$x$ 是长度为 $n$ 的 token 序列,$h^t\in\mathbb R^{n\times d}$ 是第 $t$ 次循环后的隐藏状态;循环发生在网络深度方向。核心内部仍是带因果掩码的 Transformer 注意力。
| 符号 | 含义 |
|---|---|
| $p$、$P$ | 只执行一次的 Prelude 层数及输入变换 |
| $s$、$F$ | 共享核心的独立层数及其组合函数 |
| $c$、$C$ | 只执行一次的 Coda 层数及输出变换 |
| $K$ | 训练循环次数,即 training horizon |
| $r$ | 推理循环次数 |
| $\gamma_t$ | 可选的初始状态、历史状态或时间条件 |
| $L_{\mathrm{phys}}=p+s+c$ | 物理深度,反映独立参数层数 |
| $D=L(r)=p+rs+c$ | 有效深度,反映实际执行的层数 |
配置统一记作 $p+s\times K+c$。BaseLoop 令 $p=c=0$,CoreLoop 则保留至少一侧边界层。例如,$4\times5$ 表示四个独立核心层重复五次;$0+2\times9+2$ 表示两个核心层重复九次,再执行两个独立输出层。两者物理深度均为 4、训练有效深度均为 20,但计算分工不同。
原文符号需留意:Sec. 3 开头把配置乘积写成 $K\times s$,并在文字解释中交换了两者含义;后面的部分附录又用 $K$ 表示核心层数。本笔记统一采用 Sec. 2.1 与 Table 2 的 $s\times K$ 口径,所有具体配置均按“核心层数 × 训练循环次数”理解。(PDF pp. 2–4、18。)
2.2 初始状态注入:每轮重读一个固定参考
在每次共享核心执行之前,先把当前状态 $h$ 和初始状态 $h_0$ 混合:
原文 Eq. (2) 考察四种混合形式:
| 形式 | 注入函数 | 新增参数 |
|---|---|---|
| Scalar | $h+\alpha h_0$ | $1$ |
| Channel-wise | $a\odot h+b\odot h_0$ | $2d$ |
| Residual Channel-wise | $(\mathbf1+\delta_a)\odot h+b\odot h_0$ | $2d$ |
| Dense | $W_hh+W_0h_0$ | $2d^2$ |
$\alpha$ 是标量,$a,b,\delta_a$ 是 $d$ 维向量,$W_h,W_0$ 是 $d\times d$ 矩阵;函数逐 token 作用于隐藏通道。所有参数在循环轮次及 token 位置间共享,并与主干一起训练。初始化分别为 $\alpha=0$、$(a,b)=(\mathbf1,\mathbf0)$、$(\delta_a,b)=(\mathbf0,\mathbf0)$、$(W_h,W_0)=(I,0)$,因此初始行为与原始 BaseLoop 一致。
Channel-wise 与 Residual Channel-wise 的函数表达能力相同,但权重衰减的中心不同:衰减 $a$ 会把当前状态的系数推向 0,衰减 $\delta_a$ 则把系数推向 1。这解释了为什么两种写法可能训练出不同外推行为,不能只根据函数形式把它们视为完全相同的实验。(Sec. 5.1;App. C.1;PDF pp. 7、18。)
2.3 历史状态注入:利用轨迹的相对变化
作者提出的历史注入使用近期完成的循环状态与当前状态之差:
这是 Eq. (3),其中 $w$ 是最大历史窗口,$j$ 表示相对滞后,$\mathcal B_j$ 是按滞后区分、跨轮次共享的可学习算子。它可以是标量乘法 $\beta_j x$、逐通道乘法 $b_j\odot x$ 或稠密线性变换 $B_jx$,分别增加 $w$、$wd$、$wd^2$ 个参数。
这里的历史只包括 $h_1,\ldots,h_{\ell-1}$,排除嵌入状态 $h_0$。因此 $m_0=m_1=0$,前两次变换仍是 $h_1=F(h_0)$、$h_2=F(h_1)$;第一次用到历史的是
所有历史算子从零初始化。训练时缓存状态不 detach,梯度可以沿历史连接以及常规循环链回传。(Sec. 5.1,PDF p. 7;App. C.1,PDF pp. 18–19,Eq. (4)–(5)。)
教学解释:对 $w=1$ 的标量形式,核心输入可改写为
若 $\beta=0.2$,它向上一轮状态回拉;若 $\beta=-0.2$,则沿刚才的变化方向继续外推。论文不约束系数的符号,因此该机制既可以抑制某些通道的漂移,也可以强化趋势,并不必然是凸平均或固定形式的动量。差分在两个状态接近时自然变小,提供了与当前轨迹相关的信号;静态 $h_0$ 则不具备这种变化信息。
较小的参数开销不等于没有运行开销。直接实现需保存最多 $w$ 个历史状态,缓存规模为 $O(wnd)$,并执行额外差分和混合;这是由公式得到的实现分析。本文没有提供吞吐或延迟实测来量化这部分代价。
2.4 时间条件:让共享核心感知阶段与总预算
每轮使用归一化时间 $t_\ell=\ell/T$ 和步长特征 $\Delta t=1/T$,组成八维特征:
训练时 $T=K$;主实验推理采用 rescaled time grid,设置 $T=r$。例如训练七轮而推理二十一轮时,$\Delta t$ 从 $1/7$ 变成 $1/21$,并在同一个 $[0,1]$ 区间内放置更多时间点。(App. C.1,PDF pp. 19–20,Eq. (7)。)
Loop Gating,LG。 用一个八维参数向量 $q$ 调节整次核心执行的更新:
这是 Eq. (8),仅增加 8 个参数。$q=0$ 时 $g_\ell=1$,恢复普通循环。门值没有被限制在 $[0,1]$。
Branch Gating,BG。 在每个共享层的 attention 与 MLP 残差分支分别设置标量门。以层 $k$ 的分支 $b$ 为例:
各分支拥有不同的 $q_k^b\in\mathbb R^8$,总参数量为 $16s$。BG 能分别控制注意力聚合与通道变换,而 LG 只缩放整轮的净更新。
AdaLN。 在 RMSNorm 输出上使用通道缩放,同时对残差分支使用通道门控:
$W_k^b\in\mathbb R^{2d\times8}$,两类分支合计增加 $32sd$ 个参数。本文的 AdaLN 没有时间相关的加性偏移;保留主干 RMSNorm 原有参数。BG 与 AdaLN 的条件权重也从零初始化。(Eq. (9)–(11),PDF p. 19;本节已把附录用于层数的 $K$ 换回统一符号 $s$。)
有两个实现含义值得保留。其一,$\Delta t$ 只进入特征,更新式没有再乘一个显式的 $\Delta t$;不能直接将其视为某个已证明稳定的常微分方程求解器。其二,重设总循环数会改变从第一轮开始的门控信号;不同推理预算的轨迹不必共享相同前缀。因此,如果要另做自适应早停,还需要决定使用哪一种时间网格。这两点分别来自附录的明确说明与时间定义的直接推论。
2.5 组合设计的具体意义
历史条件回答“最近几轮状态往哪里走”,时间条件回答“当前处于整个计算过程的什么位置”。两者提供不同信息,所以存在互补的可能。本文在 Qwen $4\times7$ 上比较 I+H、I+T、H+T 及 I+H+T,其中 I 为初始状态,H 为历史状态,T 为 LG 或 BG。
主图 Fig. 7 的状态注入统一采用逐通道参数化,历史窗口为 $w=2$。对应 $d=1024$,H 增加 2048 个参数,LG 增加 8 个,共 2056 个。稠密 H 则单独需要 $2\times1024^2=2{,}097{,}152$ 个参数。这个对照支持“选择合适的信息与参数化”比“注入容量越大越好”更关键。(Sec. 6;App. D.6;PDF pp. 9、30–31。)
三:实验——预算和指标决定了比较的含义
3.1 模型、数据与训练
所有模型均从随机初始化开始训练;Llama3.1-1B 和 Qwen3-0.6B 在这里表示架构家族,不是直接调用同名官方预训练权重。循环模型只保留少量独立 Transformer 层,实际参数量相应下降。
| 项目 | Llama 风格家族 | Qwen 风格家族 |
|---|---|---|
| 非循环参考深度 / 参数 | 20 层 / 1,007,482,368 | 28 层 / 596,049,920 |
| $d$ / FFN 维度 | 1536 / 5376 | 1024 / 3072 |
| Query / KV 头数 | 12 / 3 | 16 / 8 |
| 训练有效深度 | 20 | 28 |
| 主训练 token 数 | 约 20.15B | 约 12.00B |
| 代表性循环模型 | $4\times5$,516,699,648 参数 | $4\times7$,218,507,264 参数 |
两者都使用因果 GQA、RoPE、SwiGLU 和 RMSNorm。Llama 的 embedding 与输出头不共享,Qwen 的共享;Qwen 额外使用 QK-Norm。因此减少物理层并不会按同一比例减少全部参数,词表相关参数仍占相当部分。(Table 1–2,PDF pp. 17–18。)
训练数据来自 FineWeb-Edu-350BT,文档拼接为 2048-token 序列。训练 token 数按与有效训练深度对应的非循环参考规模乘以约 20 设定,并非按循环模型实际独立参数数目重新分配。所有轮次完整反向传播,损失施加在最后循环输出的 next-token prediction 上。训练不混合循环次数、不使用提前退出,也不在测试阶段更新参数。
优化器为 Muon 与 AdamW 的分组组合:attention/FFN 矩阵用 Muon,embedding、输出头及非矩阵参数等用 AdamW;权重衰减 0.1、梯度裁剪 1.0。WSD 日程为约 5% warmup、85% stable、10% decay,最终学习率降至峰值的 10%。使用 bfloat16,全部实验使用随机种子 42。(App. C.2,PDF pp. 20–21。)
3.2 哪些实验真的匹配了哪些预算?
同一物理深度下的 BaseLoop/CoreLoop 对照匹配独立层数、有效训练深度和 token 预算;不同循环数的推理点按实际有效深度比较。以四层 Llama 为例:
| 配置 | 物理深度 | 训练有效深度 | 主要用途 |
|---|---|---|---|
| $4\times5$ | 4 | 20 | 全部层循环 |
| $0+2\times9+2$ | 4 | 20 | 把边界层放在输出端 |
| $1+2\times9+1$ | 4 | 20 | 两侧各一个固定层 |
| $2+2\times9+0$ | 4 | 20 | 把边界层放在输入端 |
不过,Sec. 3 比较 $2\times10$、$4\times5$、$5\times4$ 和 $10\times2$ 时,物理深度与参数量本来就是被研究的变量。NonLoop $20\times1$ 也有更多独立参数。它们匹配的是训练有效深度与训练配方,不能笼统称作所有预算完全相同。尤其“循环模型超过 NonLoop”使用了更多推理层执行:例如 30 对 20,或 40 对 20。NonLoop 是参考线,原文所称的 upper-bound 并非数学上界。(Sec. 2.2、3;Table 2,PDF pp. 3–5、18。)
3.3 下游指标怎样汇总?
所有任务采用零样本评测;选项长度不同的多选任务用长度归一化准确率,固定形式选项用普通准确率,分数越高越好。
| 任务组 | 组成 | 汇总 |
|---|---|---|
| Knowledge | SciQ、ARC-Easy、PIQA | 三项任务等权均值 |
| Reasoning | ARC-Challenge、WinoGrande、OpenBookQA、HellaSwag、CommonsenseQA、ProofWriter、CLUTRR、BBH | 八项任务等权均值 |
BBH 仅选用 14 个子任务,包含逻辑排序、日期与时序、物体交换追踪等;其余子任务因该模型规模下接近随机、区分能力弱而排除。PIQA 被作者归为知识组,是依据其对物体属性与用途知识的依赖。两组是操作性的任务划分,并非知识与推理能力的纯粹分离。(App. C.3,PDF pp. 21–22,Table 4–6。)
原文明确给出两个组内均值,但对 Overall 的文字描述较简略。由结果表数值可确认,其口径与十一项任务等权平均一致:
例如 Table 10 的 BaseLoop 在 $D=84$ 时,$(3\times52.29+8\times29.34)/11=35.599\ldots$,报告为 35.60。Overall 不是两个组分数的简单二分之一平均,因此阅读总体变化时应同时查看组内分数。
四:结果——按原文问题逐组展开
4.1 何时增加循环有用?——Sec. 3
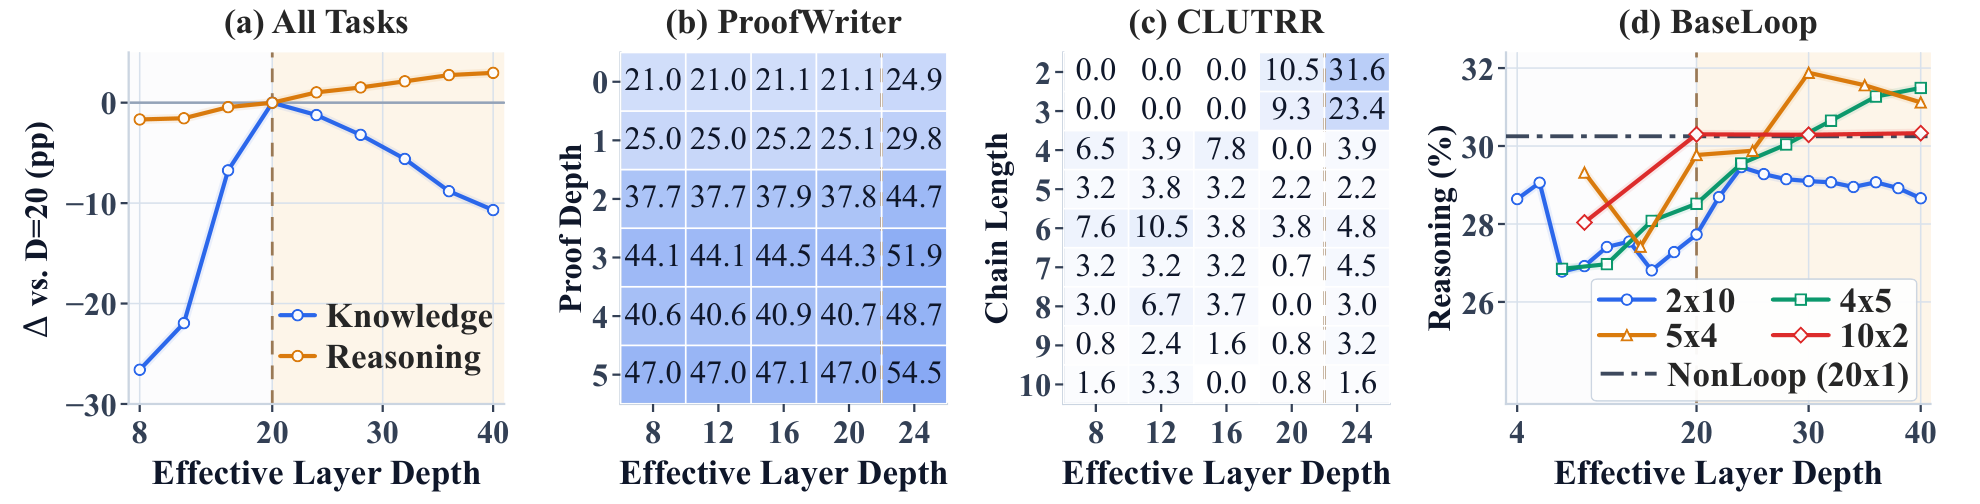
来源:Fig. 1,PDF p. 3。横轴均为有效推理深度;(a) 是相对训练深度的分数变化,单位为百分点;(b)(c) 是不同难度下的绝对准确率;(d) 比较不同核心深度与训练循环次数。虚线标训练深度,阴影为外推区间。
推理可以继续改善,知识却会下降。 对 Llama $4\times5$,Table 8 给出:
| 指标,% | $D=20$,$r=5$ | $D=40$,$r=10$ | 差值,百分点 |
|---|---|---|---|
| Knowledge | 62.80 | 52.11 | −10.69 |
| Reasoning | 28.52 | 31.49 | +2.97 |
| Overall | 37.87 | 37.11 | −0.76 |
这组结果同时说明训练深度不是推理能力的严格上限,以及总体表现未必随推理分数一起上升。正文 p. 4 把这组例子写成 $2\times10$,并误写循环边界为 4;Fig. 1(a) 的图注与 Table 8 明确对应 $4\times5$,故应按后者理解。(Table 8,PDF p. 29。)
更难的实例没有获得稳定更大的收益。 在 $2\times10$ 模型的 ProofWriter 分层中,$D=20\to24$ 时,证明深度 3、4、5 的准确率分别从 44.3、40.7、47.0 升至 51.9、48.7、54.5,即 +7.6、+8.0、+7.5 个百分点。CLUTRR 却主要改善较短关系链:长度 2 从 10.5 升至 31.6,长度 3 从 9.3 升至 23.4;更长链的绝对准确率仍较低且变化不一致。额外循环是否有用,取决于任务结构及已有能力,而非仅由“需要多少步推理”决定。(Fig. 1(b,c),PDF p. 3。)
同样的训练有效深度可以形成不同轨迹。 $2\times10$ 的浅核心较早达到峰值,之后退化;$10\times2$ 的深核心在外推区间变化较平;$5\times4$ 与 $4\times5$ 的平衡配置在所测范围内更能利用额外计算。$5\times4$ 在 $D=30$ 的推理分数为 31.88,超过 NonLoop 在 $D=20$ 的 30.25,但推理层执行数增加了 50%;$4\times5$ 达到 31.49 时则增加了 100%。这些结果支持用额外计算换取参数效率,不能据此声称在相同推理预算下全面优于非循环模型。(Fig. 1(d),PDF pp. 3–5。)
4.2 哪些计算应保持独立?——Sec. 4 与 App. D.2
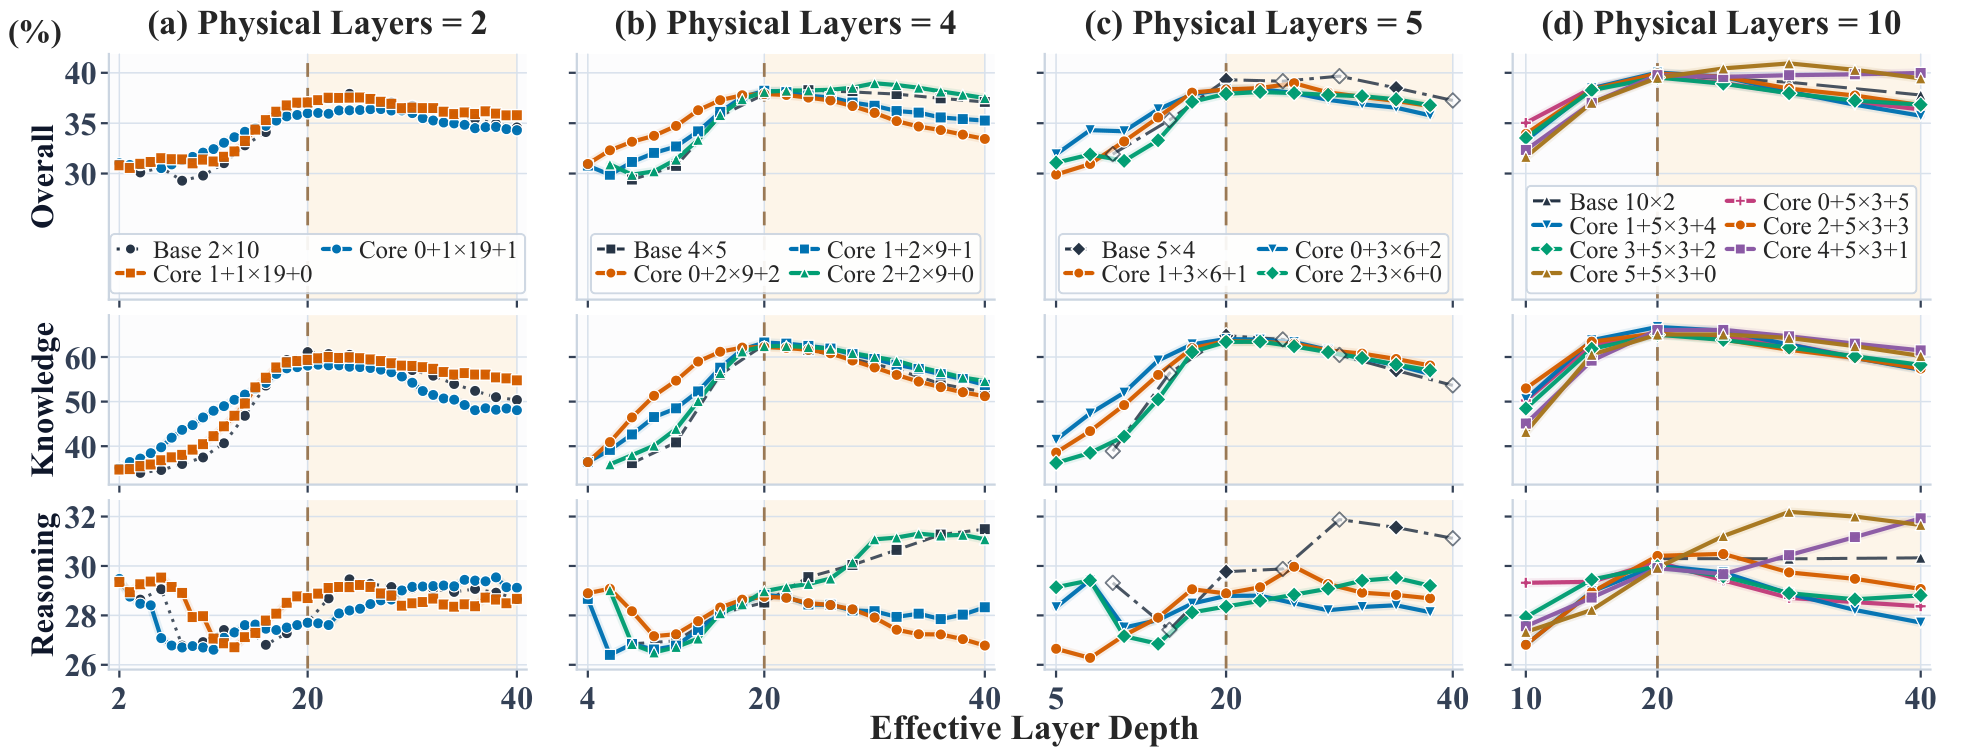
来源:Fig. 2,PDF p. 5。四列分别固定 2、4、5、10 个物理层;三行依次为 Overall、Knowledge、Reasoning。同一列内比较层的分配,不能跨列把结果视为等参数对照。
少循环时,有 Coda 的配置通常更能保持知识表现。四层模型中的 $0+2\times9+2$ 在低预算端明显好于 BaseLoop;作者解释为独立输出变换能把尚未充分迭代的状态接到稳定的读出路径。在训练深度附近,各配置更接近,因为这一深度的状态及输出路径直接受到训练目标约束。
超过训练深度以后,Prelude 较重的 Llama 配置常有较好的推理趋势,例如四层中的 $2+2\times9+0$ 和十层中的 $5+5\times3+0$、$4+5\times3+1$。这表明输入变换可以改善共享核心的起点,但不存在跨家族通用的最佳分配:在 Qwen 四层对照中,$D=56$ 时 BaseLoop 的 Overall 与 Reasoning 高于三个 CoreLoop 配置,而平衡配置在训练深度 $D=28$ 的 Overall 与 Knowledge 最好。(Fig. 9,PDF p. 27;App. D.2,PDF p. 26。)
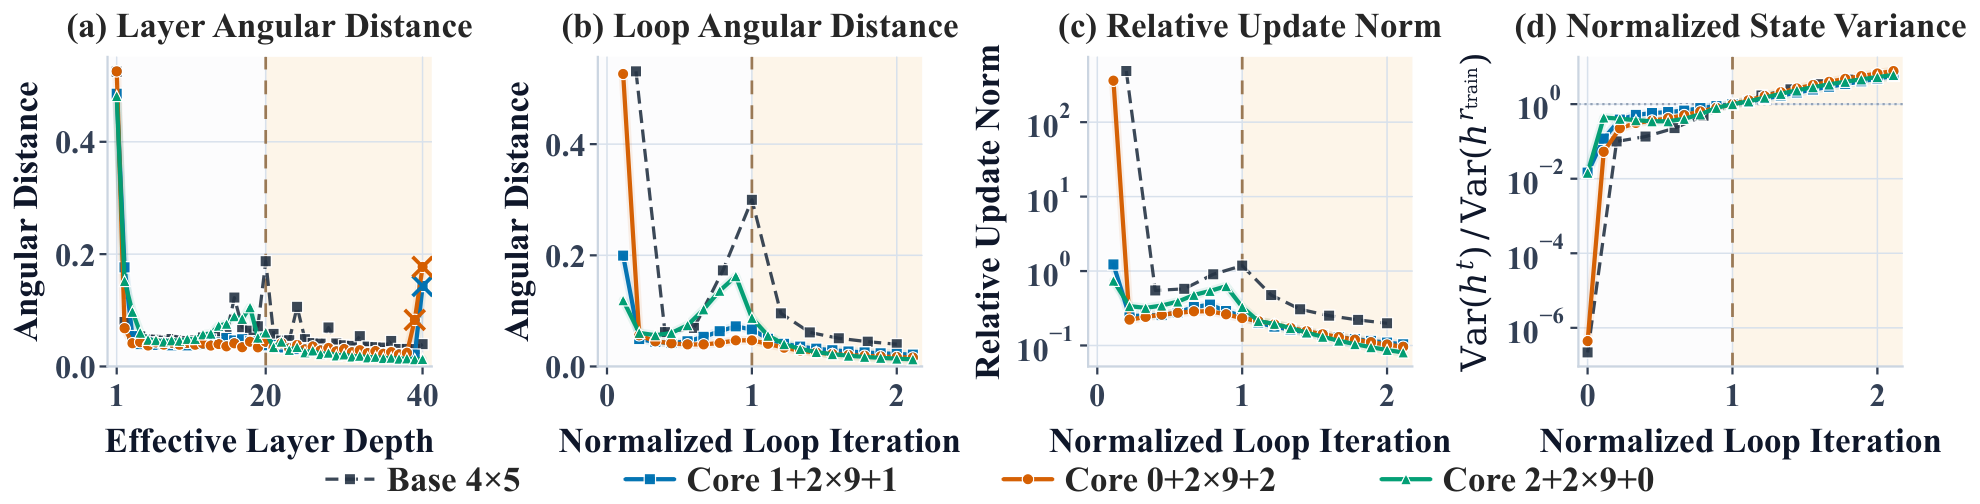
来源:Fig. 3,PDF p. 5。(a) 横轴为执行层位置,叉号标识 Coda;(b)(c)(d) 的横轴按各自训练循环数归一化,1 表示训练终点;(c)(d) 为对数纵轴。状态方差是每个 token 内各隐藏通道的方差再对 token 平均,并除以该模型训练终点的方差。
外推时,连续循环间的角距离和相对更新范数在减小,但归一化状态方差仍上升。小更新可以持续累积,状态仍可能离开训练时的分布。“变化越来越小”不足以判断是否应该继续计算或停止。 这成为后续引入轨迹条件以及计算交互探针的动机。
4.3 静态输入、历史状态和参数化的取舍——Sec. 5.1
Qwen $4\times7$ 的主要结果如下,三项均为百分比分数,越高越好:
| $D=84$ 的方法 | Overall | Knowledge | Reasoning |
|---|---|---|---|
| BaseLoop | 35.60 | 52.29 | 29.34 |
| Dense 初始状态注入 | 29.88 | 32.28 | 28.98 |
| Dense 历史注入,$w=1$ | 37.15 | 54.16 | 30.77 |
| Dense 历史注入,$w=2$ | 31.90 | 38.99 | 29.24 |
| Dense 历史注入,$w=4$ | 30.38 | 32.73 | 29.50 |
| Scalar 历史注入,$w=4$ | 37.24 | 59.18 | 29.01 |
| Channel-wise 历史注入,$w=2$ | 36.14 | 53.86 | 29.49 |
来源:Table 10,PDF p. 30。各行使用同一主干与训练配方,注入参数量不同。
稠密初始状态注入的退化尤其集中在知识组:从训练深度的 58.77 降至 32.28。用一步历史差分替换静态初始状态后,知识分数回到 54.16、推理达到 30.77,明显缓解崩溃。但扩大 Dense 历史窗口又导致退化,说明“更多历史”与“更大注入容量”并不自动更好。对 Llama,Table 8 也显示 Dense 初始状态注入在四种配置中均出现明显知识下降。(PDF pp. 29–30。)
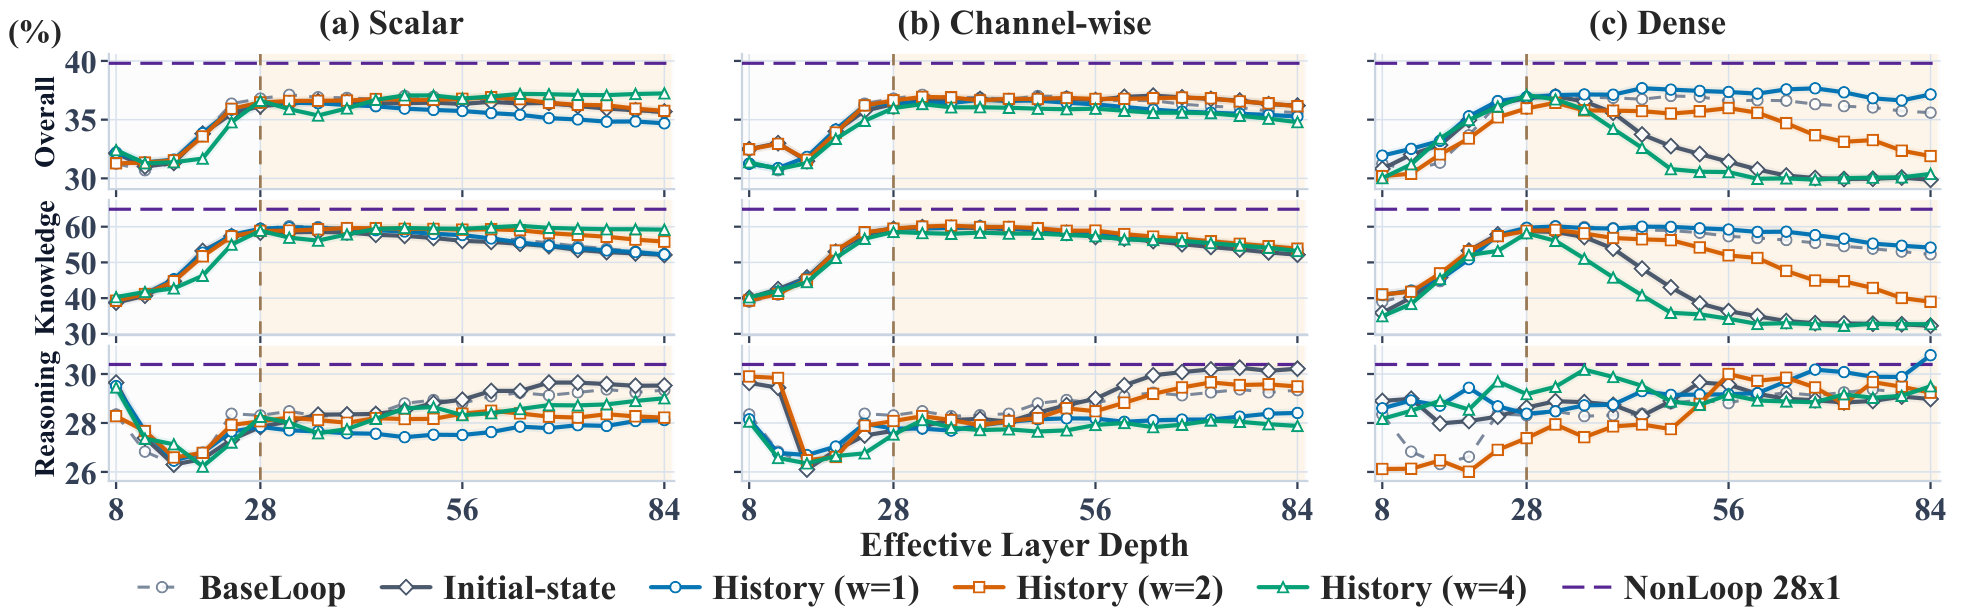
来源:Fig. 5,PDF p. 7。三列为 Scalar、Channel-wise、Dense,三行为总体、知识、推理;横轴最大为训练深度的三倍。比较窗口时要先固定参数化,再看各能力的变化。
正文概括轻量历史注入“收益有限”,但完整表格提供了一个重要补充:Scalar、$w=4$ 在 $D=84$ 的 Overall 比 BaseLoop 高 1.64 个百分点,Knowledge 高 6.89 个百分点,同时 Reasoning 低 0.33 个百分点。它只需四个历史标量,是很强的低成本对照。Channel-wise 的最佳窗口则为 $w=2$;不能把 Dense 的 $w=1$ 偏好推广到所有参数化。(App. D.4,PDF pp. 27–28;Table 10,p. 30。)
4.4 时间门控有用,但依赖核心深度——Sec. 5.2 与 App. D.5
| Qwen $7\times4$,$D=56$ | Overall | Knowledge | Reasoning |
|---|---|---|---|
| BaseLoop | 36.59 | 60.33 | 27.68 |
| LG | 36.91 | 59.24 | 28.54 |
| BG | 38.46 | 58.67 | 30.88 |
| AdaLN | 38.01 | 61.72 | 29.12 |
来源:Table 12,PDF p. 31;Fig. 6,p. 8。BG 的 Overall 比 BaseLoop 高 1.87 个百分点,推理高 3.20 个百分点,知识却低 1.66 个百分点。AdaLN 的优势主要在知识保持。这是调制粒度与任务取舍的具体例子。
同一方法换到其他循环配置,收益会消失。Qwen $2\times14$ 在训练深度与两倍深度上,三种时间条件的 Overall 均未超过 BaseLoop;$4\times7$ 的两倍深度收益很小。Llama $4\times5$ 在 $D=40$ 时,AdaLN 把知识从 52.11 提升至 59.68、Overall 从 37.11 提升至 37.91,却把推理从 31.49 降至 29.75。(Table 11–12,PDF p. 31。)
一个影响结论的原文不一致:Sec. 5.2 的 p. 8 文字称 Qwen $14\times2$ 在 $D=56$ 时 LG 的推理为 29.61、AdaLN 为 28.78;Table 12 实际列出 29.22 和 29.36,Fig. 6(d) 的曲线也支持后者排序。因此这里不沿用“该配置 LG 推理高于 AdaLN”的文字主张。
4.5 哪些机制能形成互补?——Sec. 6 与 App. D.6
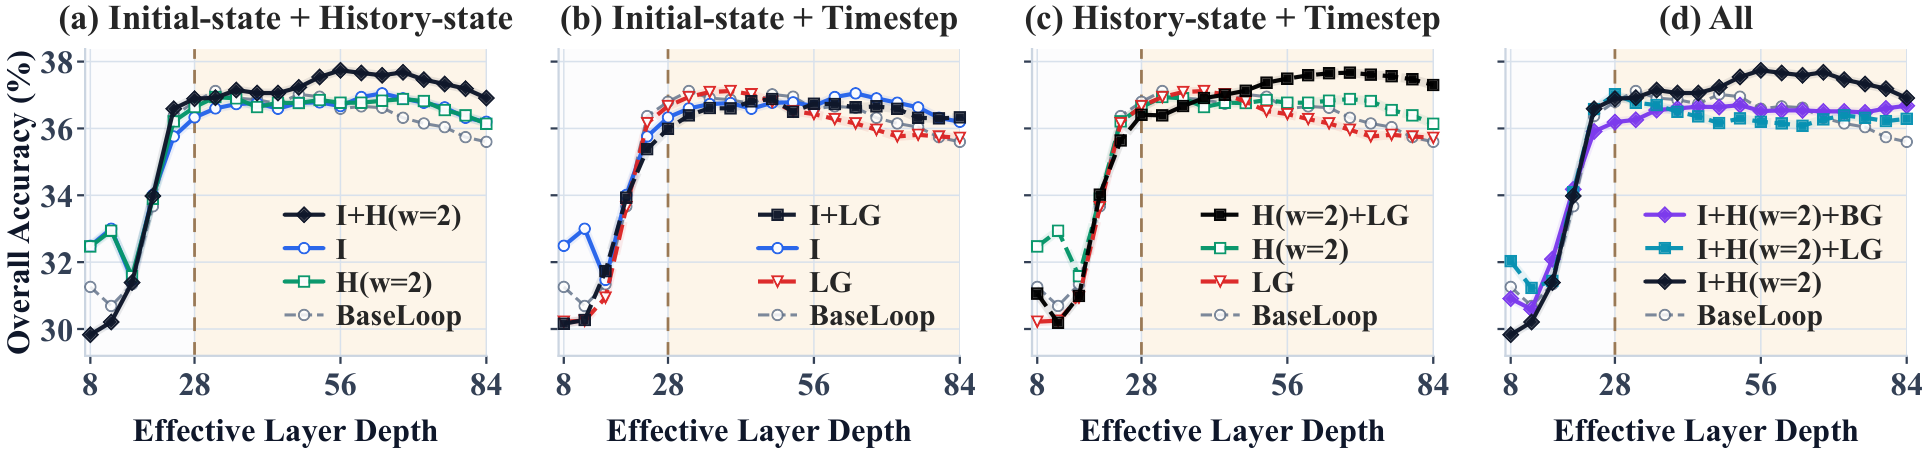
来源:Fig. 7,PDF p. 9。四个面板分别比较 I+H、I+T、H+T、三者组合;横轴为有效深度,纵轴为 Overall。主图状态注入均为逐通道形式,$w=2$。
| Qwen $4\times7$,$D=84$ | Overall | 相对 BaseLoop,百分点 |
|---|---|---|
| BaseLoop | 35.60 | 0 |
| H,channel-wise,$w=2$ | 36.14 | +0.54 |
| I+LG | 36.33 | +0.73 |
| I+H | 36.91 | +1.31 |
| H+LG,channel-wise,$w=2$ | 37.30 | +1.70 |
来源:Sec. 6、Fig. 7(PDF p. 9),Table 10 与 App. D.6(PDF p. 30)。H+LG 比 H 单独高 1.16 个百分点,其 Knowledge 为 56.32,比 BaseLoop 的 52.29 高 4.03 个百分点,也高于 I+LG 的 52.92。
不同组合呈现出具体而非统一的规律:
- I+H:逐通道、$w=2$ 在 $D=56$ 达到 37.74,超过 I 的 36.67 和 H 的 36.77;但 Dense 组合会重新引入知识崩溃,$w=1$、$D=84$ 的知识只有 32.77,而对应 H 单独为 54.16。
- I+T:训练深度下 I+BG 与 I+LG 的 Overall 只有 35.89、35.99,均低于各自门控单独的 37.16、36.68;深度外推的互补也很有限。
- H+T:逐通道 H 与 LG 在深循环下形成较清晰的联合收益。相同 $w=2$ 下,改用 Dense H+LG 的 Overall 只有 31.68,显示更多参数没有带来更好的组合。
- I+H+T:加入第三种信号没有稳定超越两两组合。附录四个三机制配置在 $D=56$ 的 Overall 为 35.69–36.60,低于 I+H 的 37.74 和 H+LG 的 37.49。
以上数值来自 App. D.6,PDF pp. 29–31,完整曲线见 Fig. 14–21,PDF pp. 32–35。Fig. 17 的图注把 I+T 标为 Dense,但它的数值与主图的 channel-wise 对照一致;需要具体复现该附图时,应进一步核对实验配置记录。
H+LG 是这里匹配逐通道参数化和 $w=2$ 后最好的主要配对。它不等于所有单独机制、窗口和指标上的严格最优:Scalar H、$w=4$ 单独就达到 37.24,距离 37.30 只有 0.06 个百分点;Fig. 20 还显示 $w=4$ 的组合具有不同的知识—推理偏好。单种子结果不足以确定这些近似分数之间的稳定排序。
4.6 机制证据:衡量后续计算是否依赖此前计算
角距离与更新范数描述“状态变了多少”,作者进一步提出计算交互(computational interaction)来测量“后面的更新有多依赖前面的计算”。
具体做法是在正常运行之外,另运行一次同样的输入,但把某个有效位置 $i$ 的一次 block 执行替换为恒等映射。其余位置,包括同一共享权重的其他执行次数,继续正常运行。对后续位置 $j$,定义更新
这是 Eq. (25)–(29) 的合写。$C=0.1$ 表示跳过前面那次执行所引起的下游更新变化,其平均范数相当于正常更新平均范数的十分之一。分子比较更新向量,包含方向变化;它是平均范数之比,不能与“每个 token 的比值再平均”混用。
探针在冻结检查点的 FineWeb 验证样本上测量:49 个 packed sequences,共选择 100,000 个 next-token 位置。角距离与相对更新范数每序列取一个位置,方差和交互使用全部选中位置。Qwen 的交互曲线只取源、目标都处在训练七轮之外的 block 对,再按循环间隔 lag 汇总;主文跨 lag 的百分比按 block 执行对数量加权。(App. C.4,PDF pp. 22–25。)
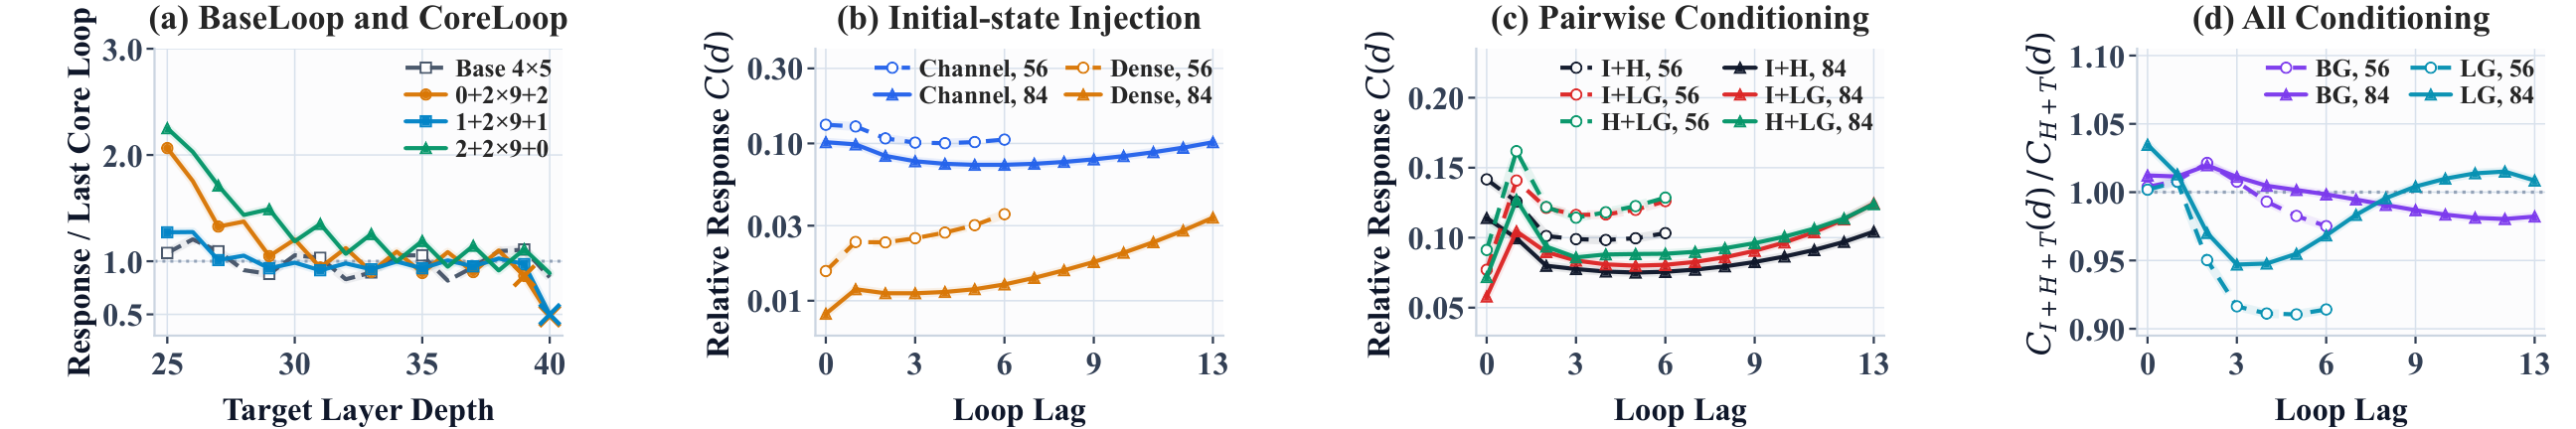
来源:Fig. 8,PDF p. 9。(a) 是 Llama 的位置响应;(b) 比较两种初始注入;(c) 比较三组配对条件;(d) 比较三机制与相应 H+T。后面三个面板的空心虚线为 $D=56$,实心线为 $D=84$,横轴为循环 lag;不同 lag 的点聚合了不同位置对。
在 $D=84$、lag 1–6 的共同区间,H+LG 的平均相对交互比 I+H 高 18.6%,比 I+LG 高 10.4%;同一循环内的响应却不一定更大。加入 I 后,H+LG 在 lag 2–6 的平均交互在 $D=56$、84 分别下降 7.4%、4.2%,同时准确率下降。
附录进一步核对分子:H+LG 的未归一化响应比 I+H、I+LG 分别高 6.4%、10.2%,相对交互在全部 16 个共享源/目标 block 配对上都更高;因此该现象不只是分母缩小。三机制的下降也有真实分子变化,但并非所有层对都下降,$D=84$ 的 LG 三机制只有 9/16 层对的平均 $C$ 更低,BG 的变化更弱。(App. E.2、Fig. 23,PDF p. 36。)
这些探针支持作者的解释:历史信号与时间门控使后续循环更多地利用先前计算。它们衡量的是验证文本上的计算依赖;更大的扰动响应也可能来自敏感性,因此其与有益推理之间的因果联系仍需要更直接的任务干预来建立。
4.7 支撑训练选择的附录实验
优化器试验。 在独立的六架构、十项下游任务先导实验中,Muon 对 BaseLoop $3\times4$ 的平均分为 40.74,AdamW 为 39.98;Huginn $1+2\times5+1$ 的 AdamW 运行未成功收敛,Muon 达到 41.72。其他成功的架构比较中,Muon 也有较小平均增益,因此作者在主实验采用它。这张表的十任务平均包含 MMLU、RACE 等,不能与主实验十一任务的 Overall 直接横比。(App. D.1、Table 7,PDF p. 26。)
初始噪声。 Qwen $4\times7$ 的 Scalar、Channel-wise、Residual Channel-wise 初始注入,对比无噪声与 0.03 的初始化噪声,直到 $D=84$ 都没有一致收益,因而使用无噪声作为默认。(App. E.1、Fig. 22,PDF pp. 33、35–36。)
五:结论——可带走的设计原则与适用条件
本文最有价值的发现是,循环模型的可扩展性需要同时看任务、核心配置、状态轨迹和预算。有效深度相同并不意味着实际行为相同;达到某个很小的角距离或更新量也不代表后续循环一定有效。
如果部署主要需要少循环,固定输出层值得作为重点对照;如果目标是超出训练深度的推理,要联合调节核心深度、训练循环数和 Prelude/Coda 分配。条件信号方面,逐通道历史差分与轻量时间门控是有实证支持的候选,但 Scalar 历史注入也是不可遗漏的低成本对照。对知识密集任务,需要直接检查其随循环数的曲线,避免用总体或推理平均分掩盖知识下降。
证据集中在约 1B 及以下的参考架构、固定训练预算和固定循环数预训练,历史及组合实验主要使用一个 Qwen $4\times7$ 配置,最深测试到三倍训练深度。全部实验使用一个随机种子;主文也没有实测端到端延迟、缓存开销或自动预算分配。因此更大模型、多种子重复、与实际部署成本联合评价,是检验这些设计能否形成稳定工程收益的直接下一步。
对后续研究尤其有启发的两个问题是:能否以任务正确性而非单纯状态收敛训练停止策略;能否通过控制交互强度的干预,确认 H+LG 的性能收益确实由跨循环信息利用带来。它们分别连接本文的预算适应性结果与机制探针,尚属于待检验方向。