FRAC:Fractional State Space Transition for Long Sequence Modeling
作者:Ivan Kobyzev、Abbas Ghaddar、Ali Nasiri-Sarvi、Lifeng Shang、Yufei Cui;Huawei Noah’s Ark Lab,Montreal Research Center。前两位作者为共同一作。
论文版本:arXiv:2609.36314v1,提交于 2026-09-28。获取与研读日期:2026-10-07。
arXiv 页面 · 本地原文 PDF · 英文汇报 PDF · 可编辑幻灯片。下文页码均指从 1 开始的 PDF 页码,与本文印刷页码一致。
论文总览
FRAC 研究一个具体问题:在推理时只能保存固定大小状态的条件下,怎样让遥远历史的影响衰减得更慢? 作者从分数阶微分方程出发,把具有幂律尾部的记忆核近似成一组跨越多个数量级的指数模式,再加入逐 token 的时间控制和读写路由,得到可并行扫描、可逐步解码的状态空间模型(State Space Model,SSM)。
最值得记住的机制是:每个模式仍按指数衰减,但一组恰当分布、加权的快慢模式,可以在目标时间范围内表现出近似幂律记忆。实际 FRAC 采用 16 个固定几何间隔的时间尺度,并通过输入控制保留率及读写权重。它把“记忆怎样随距离消退”作为架构设计变量。
主要证据来自三组设置:约 200K 参数模型从 512 长度训练外推至 128K;1.3B 参数语言模型用 100B tokens、4K 序列预训练后测试长上下文;约 7M 参数模型在 DNA 序列上比较不同训练长度。1.3B 实验中,FRAC 的 LongBench 平均分为 17.9,Gated DeltaNet(GDN)为 16.0;短上下文 LM Harness 平均准确率为 55.1,接近 Transformer 与 Mamba3-MIMO 的 55.3。但代码补全和截断至 2K 的真实检索并不占优,解码速度也没有超过所有基线。(Sec. 4,pp. 6–9;Appendix F,p. 25。)
理论与模型之间有一个必须保留的区别:固定参数系统的精确零阶保持离散化给出写入系数 $(1-\rho)/\lambda$,论文全部实验采用的却是 $1-\rho$。作者在 Appendix D 明确将其作为改善稳定性的建模选择。因此,完整 FRAC 应理解为由分数阶理论指导的选择性架构,而非任意变系数分数阶方程的精确求解器。
结构地图
| 原文章节 | 作用 | PDF 页码与关键内容 |
|---|---|---|
| 1 Introduction | 从固定状态压缩引出记忆衰减规律 | pp. 1–2 |
| 2 Preliminaries | Caputo 导数、Mittag–Leffler 核、连续指数混合与有限近似 | pp. 2–4;Eqs. (1)–(12),Theorems 1–2 |
| 3 Method | 模式库、离散递推、选择性读写、完整网络层 | pp. 4–6;Proposition 3,Eqs. (13)–(24),Fig. 1 |
| 4.1 Synthetic Benchmarks | 重尾外推与 MADLab 能力探针 | pp. 6–7;Fig. 2,Table 1 |
| 4.2 Language Modeling | NIAH、LongBench、短上下文与真实检索 | pp. 7–8;Fig. 3,Tables 2–4 |
| 4.3 DNA modeling | 长训练上下文是否改善基因序列建模 | p. 9;Fig. 4 |
| 5 Related Work / 6 Conclusion | 与选择性 SSM、关联记忆及分数阶方法的关系 | pp. 9–10 |
| A Discussion of Theorem 1 | 两种记忆核的谱密度与尺度变换 | p. 17;Eqs. (25)–(27) |
| B Proof of Theorem 2 | 截断、对数网格求积与不同误差范数 | pp. 17–19 |
| C Proof of Proposition 3 | 从核误差推到状态轨迹误差 | pp. 20–21 |
| D Frac State Transition Algorithm | 实际算法及其相对精确 ZOH 的改动 | p. 21;Algorithm 1,Remarks 7–8 |
| E Experimental Setting | 数据、模型配置、评价协议 | pp. 21–25;Tables 5–7 |
| F FracMixer Efficient Implementation | Triton 实现、吞吐及数值稳定性 | pp. 25–26;Table 8 |
| G FRAC Ablation | 架构消融与有限模式逼近质量 | pp. 26–27;Tables 9–10 |
| H Limitations and Broader Impact | 时间尺度覆盖、模式成本及扩展方向 | pp. 27–28 |
一:动机——固定状态还需要选择合适的遗忘规律
自回归注意力可以保留随上下文增长的 KV 缓存,而递归 SSM 把过去压缩进固定维度状态。后者节省历史存储,但也必须决定:哪些信息在每一步被保留,保留多久,如何被新输入覆盖。
以最简单的一阶系统为例:
没有新输入时,初始状态的影响按 $e^{-\lambda t}$ 消退,特征时间尺度为 $\lambda^{-1}$。一个很慢的指数模式能保存较远历史,却难以同时覆盖跨度悬殊的依赖。已有 SSM 可以组合多个模式、学习门控;FRAC 的主张是进一步用分数阶理论约束模式的时间尺度分布和权重,使它们形成重尾记忆先验。(Sec. 1–2.2,pp. 1–2。)
这与几类相关思路的关系是:Mamba 系列强化输入选择性与离散状态更新;GDN 强化关联记忆的更新与过滤;Mixture-of-Memories 增加可路由的记忆容量;FRAC 重点设计随时间衰减的形状。FRAC 的多个 mode 是对时间尺度积分的离散化节点,与 Mamba3 的多输入多输出(MIMO)秩不是同一种含义。作者认为,分数阶记忆可以进一步与 delta rule 结合,但本文未实现这种组合。(Sec. 5–6,pp. 9–10。)
二:方法——从分数阶记忆到可扫描的递推
2.1 用非局部导数描述历史依赖
对 $0<\alpha<1$,Caputo 分数阶导数定义为:
它在时刻 $t$ 汇总整个过去的变化量 $f'(\xi)$,权重随时间距离呈代数衰减。论文的起点是分数阶松弛方程:
这里 $h(t)$ 是状态,$u(t)$ 是外部输入,$\alpha$ 是分数阶阶数,$\lambda$ 控制松弛尺度,$\Gamma$ 为 Gamma 函数。$\alpha=1$ 时对应普通一阶系统;$0<\alpha<1$ 时,导数本身依赖历史。直接离散它通常需要保存历史轨迹,因此还不能直接成为固定状态的神经网络层。(Sec. 2.2,p. 2,Eqs. (1)–(3)。)
2.2 必须区分两种核:初始状态与过去输入
Mittag–Leffler 函数推广了指数函数:
固定 $\alpha,\lambda$ 的分数阶系统有解:
第一项描述初始状态的松弛,第二项描述输入的冲激响应。两者都具有多项式尾部,但尾指数不同:
因此,“记忆按 $t^{-\alpha}$ 衰减”准确对应齐次松弛核;不能将同一个指数直接套到输入冲激响应上。这些渐近形式描述大 $t$ 行为,Mittag–Leffler 核并非在所有时间上都是纯幂律。(Sec. 2.3,p. 3,Eqs. (4)–(8)。)
2.3 连续指数混合把非局部记忆变成一组局部动态
Theorem 1 给出非负扩散表示:
这里 $\tau$ 是指数模式的时间尺度,大 $\tau$ 对应慢遗忘。Appendix A 给出:
这一表示的价值在于:幂律尾部可以由快慢不同的指数衰减共同构成,每个指数模式都可用一阶 ODE 独立维护;困难从保存全部历史转为近似时间尺度积分。(Sec. 2.4,pp. 3–4;Appendix A,p. 17。)
2.4 有限指数和:误差保证在哪个范围成立
Theorem 2 在固定 $0<\alpha<1$、$\lambda>0$ 和有限区间 $[0,T]$ 上,将两种核近似到同一组几何网格:
对任意 $\varepsilon>0$,存在足够的模式数与正系数 $c_m,d_m$,使:
第二个保证采用 $L^1$ 误差,是因为 $g(t)$ 在 $t\to0^+$ 时具有可积奇点,而任何有限指数和在零点均有界,无法在包含零点的区间上一致逼近该冲激核。
证明的关键步骤是先截去极快和极慢模式中足够小的尾部质量,再令 $x=\log\tau$,用中点求积离散剩余积分。若对数步长为 $h=\log q$,便得到:
其中的 $\tau_m$ 来自变量替换 $d\tau=e^x dx$。这也解释了为什么在大时间尺度端,离散权重满足 $c_m\propto\tau_m^{-\alpha}$,而不是密度本身的 $\tau^{-\alpha-1}$。(Sec. 2.5,p. 4,Eqs. (10)–(12);Appendix B,pp. 17–19。)
这个定理给出存在性和误差形式,没有为本文具体的 16 个模式证明统一精度或明确的模式数上界。实际网格与模式数还依赖后面的消融和数值拟合实验。
2.5 用有限个状态实现近似系统
Proposition 3 构造:
每个 $s_m$ 只需保存当前值。将其显式解代入读出,齐次部分得到 $\sum c_me^{-t/\tau_m}$,输入部分得到 $\sum d_me^{-t/\tau_m}$,恰好对应上面的两种核近似。对有界输入,状态误差满足:
证明分别控制初始状态项与输入卷积项;后者用输入上界乘以核的 $L^1$ 误差。这是从“核能够近似”走到“状态轨迹能够近似”的连接。(Sec. 3.1,pp. 4–5,Eqs. (13)–(16);Appendix C,pp. 20–21。)
2.6 精确 ZOH、选择性控制与实际写入系数
零阶保持(Zero-Order Hold,ZOH)在单个时间段内固定输入和控制量。对上述模式积分,可得:
利用分数阶核对 $\lambda$ 的自相似性,FRAC 保留共享的基础网格,使用有效时间尺度:
$\Delta_t\lambda_t^{1/\alpha_t}$ 可以理解为当前 token 推动内部时钟前进的距离;它越大,所有模式在这一步遗忘得越多。$\alpha_t$ 还会影响读写先验,所以它并非一个独立的“记忆长度旋钮”。(Sec. 3.2,p. 5,Eqs. (17)–(20)。)
两种写入系数需要分别列出:
| 形式 | 写入系数 | 对应范围 |
|---|---|---|
| 正文精确 ZOH 推导 | $\tilde\beta_{t,m}=(1-\tilde\rho_{t,m})/\lambda_t$ | 固定系统的模式 ODE 离散化 |
| Algorithm 1 及全部实验 | $\tilde\beta_{t,m}=1-\tilde\rho_{t,m}$ | 论文实际训练的选择性 FRAC |
作者明确说明,去掉除以 $\lambda_t$ 的振幅因子,是为了让时间尺度控制与显式写入振幅缩放分离,并改善训练稳定性。$\lambda$ 为常数时,可通过状态和读出常数缩放关联两种形式;逐 token 变化的 $\lambda_t$ 不具备这种简单等价性。(Appendix D,p. 21,Remark 7。)
2.7 读写路由:重尾先验加内容残差
FRAC 对每个 token 分别生成读权重和写权重:
忽略内容残差时,权重与 $\tau_m^{-\alpha_t}$ 成正比,呼应有限求积系数的大时间尺度渐近式。较小 $\alpha_t$ 使这一分布更平坦,给慢模式相对更多的权重。内容残差则允许当前输入偏离默认分布,将不同信息写入或读出不同模式。两条路径使用独立投影;附录实现为 $g(u)=\sigma(p)Wu$,其中 $p$ 是可学习标量门。
读先验有渐近理论依据,写先验采用相同形式是经验设计,理论没有唯一规定它。softmax 还引入非负、和为一的规范化约束;这些学习权重也不是 Theorem 2 的精确求积系数。(Sec. 3.2,p. 6,Eq. (23);Appendix D,p. 21。)
实际实验中的核心递推为:
这里 mode 维度上共享同一 head 的内容向量,逐 mode 的标量保留率和路由权重作用在该向量的所有坐标上。多头形式的主要张量是:
| 符号 | 形状,不含 batch | 含义 |
|---|---|---|
| $u_t$ | $H\times d_h$ | 局部卷积后的内容向量 |
| $\Delta_t,\alpha_t,\lambda_t$ | $H$ | 每个 head 的时间控制量 |
| $\tau$ | $M$ | 全部 head 使用的基础时间尺度网格 |
| $b_t,c_t,\tilde\rho_t$ | $H\times M$ | 写路由、读路由和模式保留率 |
| $S_t$ | $H\times M\times d_h$ | 解码时缓存的主要递归状态 |
教学例子:若有效步长为 1,三个模式的 $\tau$ 分别取 $1,16,256$,单步保留率约为 $0.368,0.939,0.996$。64 步后,单纯历史保留因子约为 $1.6\times10^{-28},0.018,0.779$。快模式反映近期变化,慢模式留下远处影响;读写权重决定这些影响对当前输出有多大贡献。该例只解释递推,不是论文实验。
2.8 完整层如何生成这些量
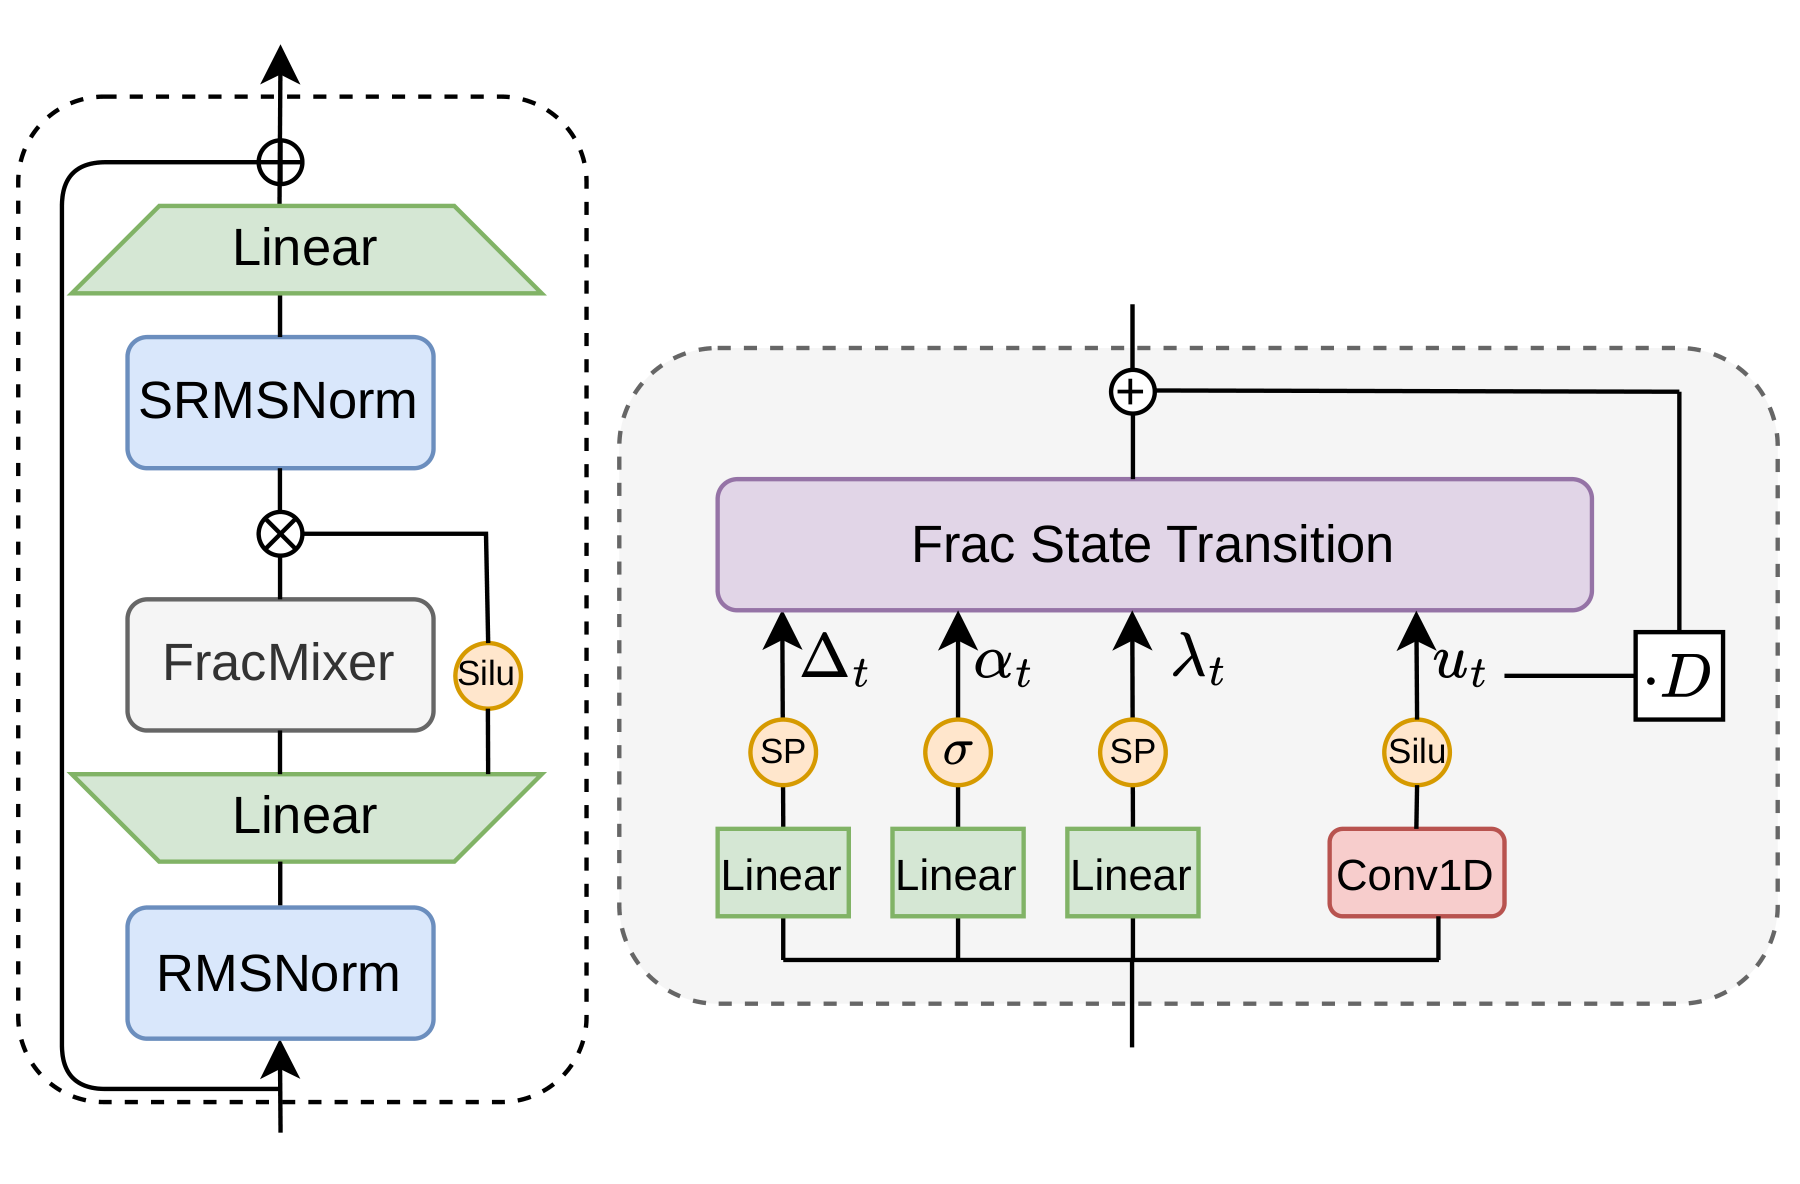
原文 Fig. 1,p. 6。图中信息自下向上流动:左侧为完整层,右侧展开 FracMixer。
输入经 RMSNorm 和线性投影后进入两类分支。控制分支从卷积前的表示生成 $\Delta_t,\alpha_t,\lambda_t$,分别经 softplus、sigmoid、softplus 约束取值;内容分支经局部深度可分离因果 Conv1D 和图中所示的 SiLU 得到 $u_t$。状态模块读出后与直接通路 $Du_t$ 相加,再经外部的门控归一化、输出投影及残差路径形成层输出。
语言模型采用 $M=16$,基础时间尺度在 $[1,2^{17}]$ 上几何分布。$\Delta$ 裁剪至 $[10^{-4},1]$,$\lambda$ 裁剪至 $[0.25,4]$。时间尺度上限选择时考虑了最长 64K 的语言模型外推评测;真实遗忘距离还取决于累计内部步长,不能把 $\tau$ 无条件等同于 token 数。(Sec. 3.3,p. 6;Appendix E.3,p. 23。)
2.9 为什么能并行训练并保持固定解码状态
对一个 head、一个特征坐标,模式状态满足一阶仿射递推:
其中 $\mathbf v_t$ 是本步写入向量。两个仿射变换的复合为 $(\Lambda_2\Lambda_1,\Lambda_2\mathbf v_1+\mathbf v_2)$,复合具有结合律,因此可以做并行扫描。训练与 prefill 采用分块计算,解码只更新缓存中的 $S_t$。按直接递推计,序列长度 $L$ 下状态更新工作量为 $O(LHMd_h)$,单层解码状态为 $O(HMd_h)$;训练激活存储不能据此称为与长度无关。
将零初始状态下的递推展开,可得到一个有助于理解的有效历史权重(本次教学推导):
这显示当前读权重、当时写权重,以及中间所有 token 的时间控制共同决定历史影响。完整模型一般不是只依赖距离 $t-k$ 的固定卷积核。
实现中,为避免两个很小的累计指数相除,作者直接计算累计对数衰减之差:
Triton kernel 分别承担参数融合、块内构造、跨块状态传递和输出混合。模式归约维度仅为 16,作者采用单层分块。(Sec. 3.2,p. 6,Eq. (24);Appendix F,pp. 25–26。)
三:实验——分别检验衰减先验、语言能力和计算成本
3.1 基线与主实验配置
Mamba2 是成熟的选择性 SSM 对照;Mamba3-SISO 与 Mamba3-MIMO 检验更强离散化和表达能力;GDN 检验带遗忘门的 delta-rule 关联更新;Transformer 检验直接访问上下文的自注意力模型。在约 200K/500K 参数实验中,Mamba3 只使用 SISO,因为作者的 MIMO 实现不支持匹配所需的小 hidden size。
1.3B 主实验统一使用从去重 FineWeb-Edu 抽取的 100B tokens、Llama-2 的 32K 词表、完全打包的 4K 序列。hidden size 为 2048、head 数为 16;通过层数和架构配置使参数量接近:FRAC、Mamba2、Mamba3-SISO 为 48 层,Mamba3-MIMO 为 44 层,GDN 为 22 层,Transformer 为 26 层。Transformer 使用 Qwen3 架构实现。
训练使用 AdamW,学习率 $6\times10^{-4}$、10% warm-up、weight decay 0.1、全局 batch 1M tokens,配合 FSDP 和混合精度。硬件为两台各 8 张 80GB 加速卡的节点;论文未明确卡的具体型号,因此速度数字应与该实现和硬件条件一起理解。(Appendix E.3,pp. 23–24。)
3.2 各项实验在回答什么
| 实验 | 设置与指标 | 检验问题 |
|---|---|---|
| Heavy-tail probe | 单层约 200K 参数;512 训练,512–128K 测试;准确率越高越好,10 次运行的均值±标准差 | 是否能把重尾聚合规律外推到更长输入 |
| MADLab | 约 500K 参数;两层序列混合与两层 SwiGLU 交替;5 seeds,任务准确率 | 引入该记忆先验是否保留压缩、模糊召回、记忆与选择复制能力 |
| NIAH | 1.3B 模型;4K 训练后在 1K–64K 检索 passkey、数字或 UUID;准确率 | 超出训练长度后,单个目标信息是否仍可取回 |
| LongBench v1 | 14 项任务;QA 的 F1、摘要的 ROUGE、TREC 准确率、代码的编辑相似度,均越高越好 | 长文档理解和生成是否受益 |
| LM Harness | 两项困惑度及八项准确率;平均分只计算八项准确率 | 短上下文能力有无明显代价 |
| Recall-Retrieval | 六项真实检索任务,cloze-completion 格式,全部截断至 2K | 短上下文的真实信息提取能力 |
| DNA | HG38,约 7M 参数;各自在 1K–64K 长度训练并以同长度测试;困惑度越低越好 | 增加训练上下文是否改善序列建模 |
| 架构消融 | 390M 参数、30B tokens、4K 训练;16K 文档困惑度 | 哪些结构选择贡献性能 |
MADLab 在每个任务和模型上搜索学习率、weight decay,再按五个 seed 的平均官方分数选择配置;该数字应按这一调参协议解读。普通 ICR 与 noisy ICR 在各模型上饱和,正文只呈现另外四项。(Appendix E.2,pp. 22–23。)
四:结果——长距离收益明显,但取决于任务
4.1 Heavy-tail probe:最直接地验证归纳偏置
序列包含背景 token 和稀疏 $\pm1$ 事件,事件间距服从截断 Zipf 分布。分类标签由历史事件的重尾加权和之符号决定:
原文附录先说明标签取符号,随后公式列出未取符号的和;上式将两者合并表达。很小的尾指数 $0.1$ 使远处事件仍有明显权重,因而直接针对论文希望引入的记忆规律。
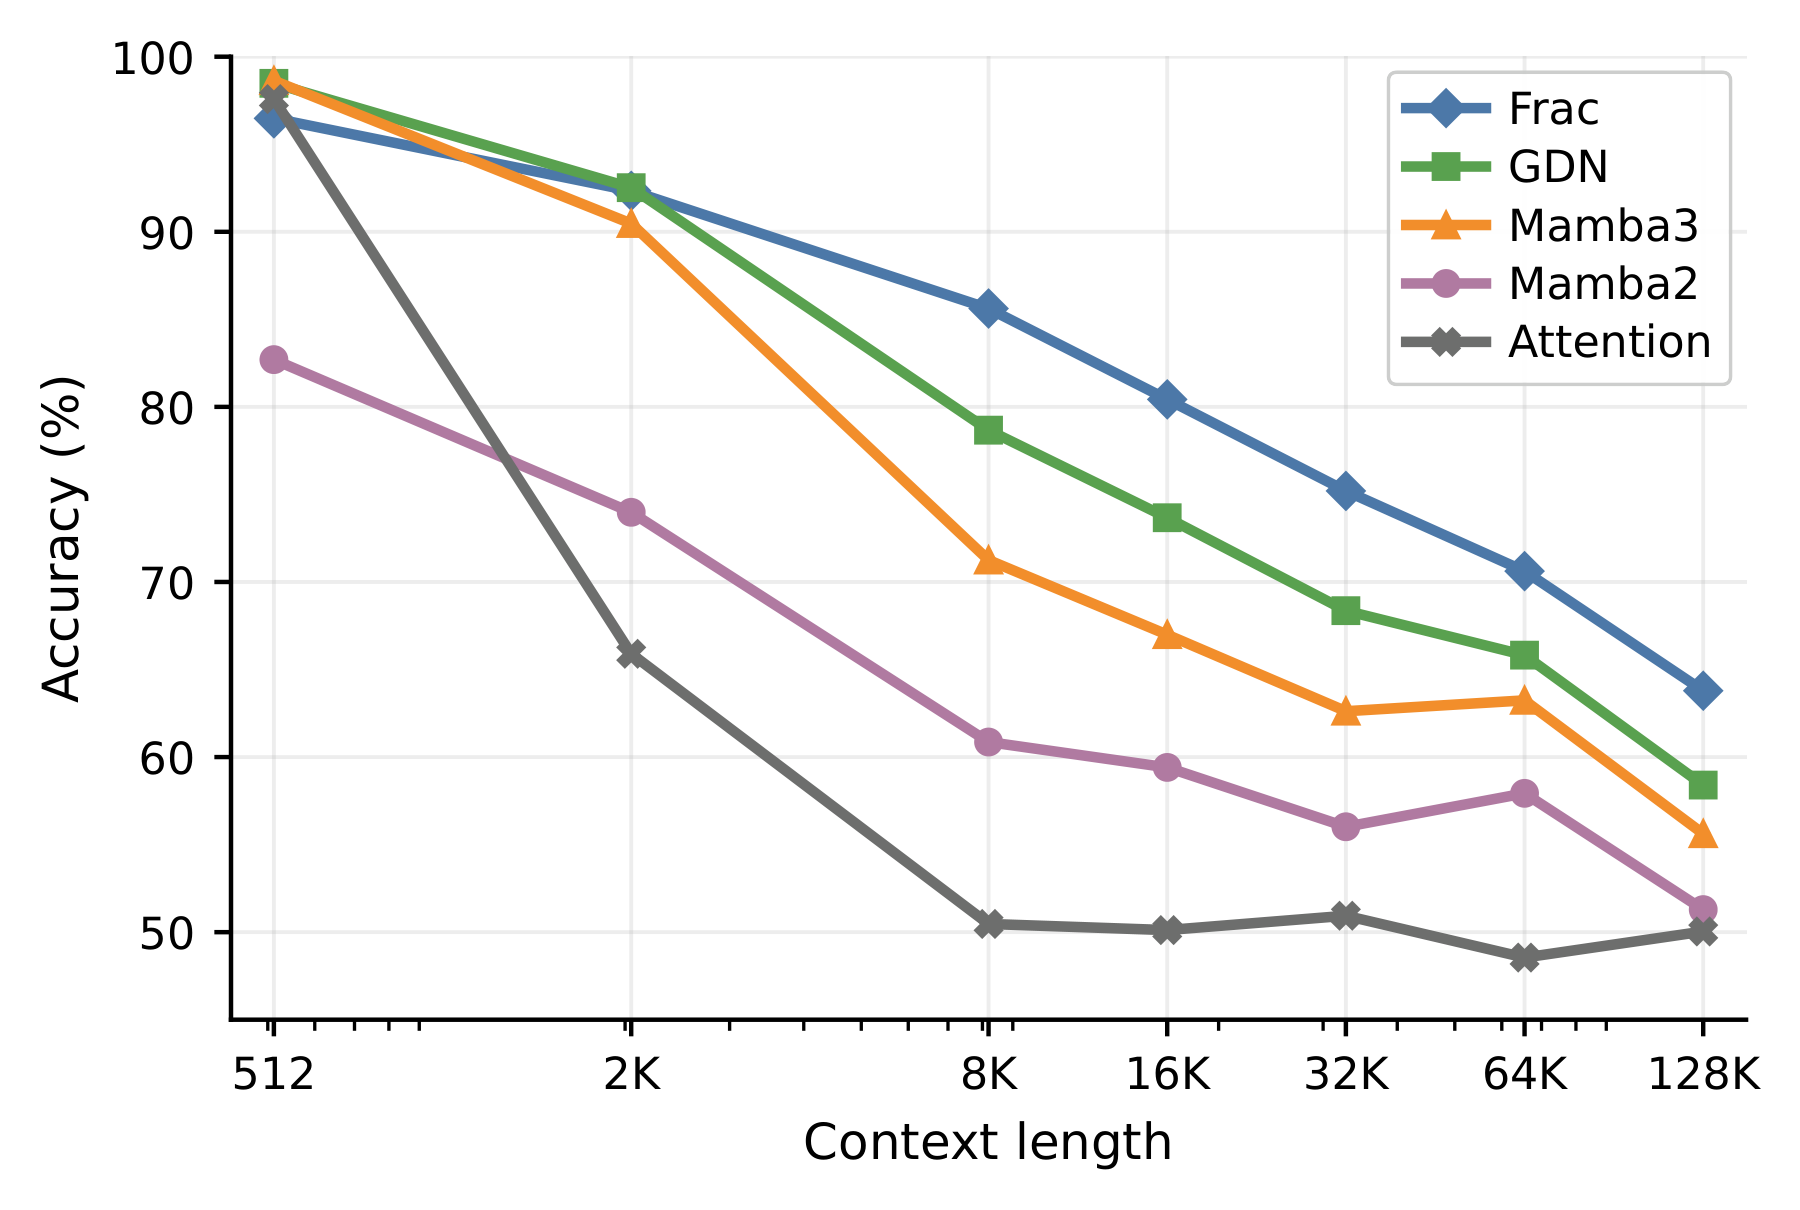
原文 Fig. 2,p. 7。横轴为测试长度,纵轴为准确率;所有模型只在长度 512 上训练。长上下文的精确数值来自 Table 6(p. 22),下表选取四个长度,单位为百分数,± 为 10 次运行的标准差。
| 模型 | 512 | 8K | 64K | 128K |
|---|---|---|---|---|
| Attention | 97.6±0.8 | 50.5±3.3 | 48.6±1.7 | 50.0±3.7 |
| Mamba2 | 82.7±2.9 | 60.9±4.5 | 57.9±3.2 | 51.3±4.3 |
| Mamba3-SISO | 98.6±0.7 | 71.3±7.5 | 63.2±4.4 | 55.6±3.8 |
| GDN | 98.5±0.6 | 78.7±3.4 | 65.8±2.5 | 58.4±3.8 |
| FRAC | 96.5±2.5 | 85.6±3.0 | 70.6±2.0 | 63.8±1.9 |
FRAC 在训练长度上并非最好,但从 8K 开始领先所有对照。128K 时相对 GDN 高 5.4 个百分点,相对 Attention 高 13.8 个百分点。这个结果支持:合适的衰减结构能够提高对重尾聚合规律的长度泛化。任务本身按幂律设计,因此自然语言实验仍是检验收益是否超出该合成设定的关键。
MADLab 的结果较温和:FRAC 四项平均准确率 75.4,Mamba3-SISO 74.8,GDN 74.3,Mamba2 73.8。FRAC 的压缩和模糊召回为 $90.4\pm0.2$、$11.5\pm0.2$;Mamba3-SISO 为 $89.1\pm0.2$、$10.1\pm0.4$。记忆与选择复制均接近 100%。所以平均优势主要来自压缩和模糊召回,后者的绝对准确率仍低。(Table 1,p. 7。)
4.2 NIAH:延缓外推退化,仍有很长距离的失败
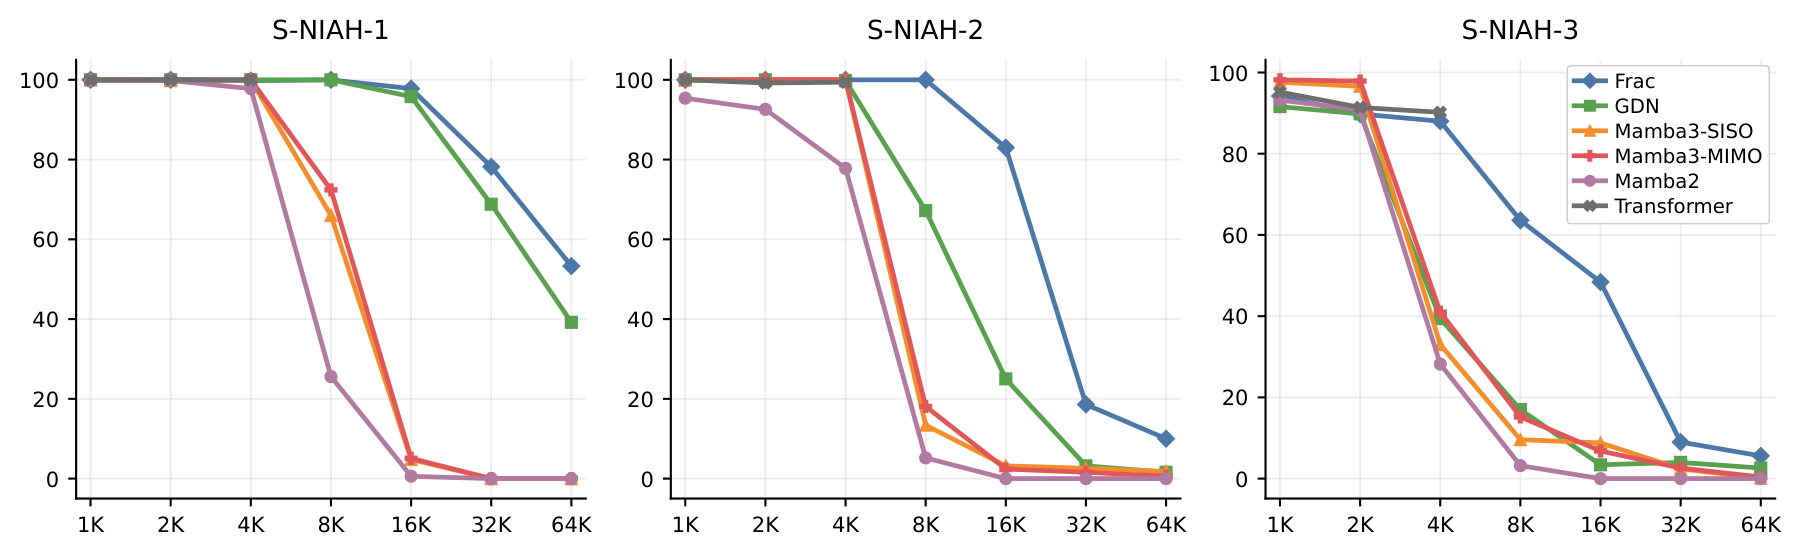
原文 Fig. 3,p. 8。三个面板的横轴均为 1K–64K 测试长度,纵轴均为准确率。蓝色为 FRAC,绿色为 GDN;其他曲线依图例区分。S-NIAH-1 在重复填充文本中检索 passkey,S-NIAH-2 在自然文本干扰中检索数字,S-NIAH-3 检索 UUID。(任务定义见 Appendix E.3,p. 24。)
4K 以内各模型相近;超过训练长度后,FRAC 的下降通常更慢,尤其在 S-NIAH-2 的 8K–16K、S-NIAH-3 的 8K–16K 区间。重复填充任务对 GDN 的过滤机制也很有利,论文明确将其列为相对趋势的例外。
但“表现更好”与“64K 稳定检索”有实质差别:图中 FRAC 在 64K 的 S-NIAH-2、S-NIAH-3 也已落至约一成或以下。重尾状态能延缓信息消退,未消除固定状态检索的困难。原图说明 Transformer 在 4K 之后得分为零,这是本文 4K 预训练基线及其评测协议下的外推结果。(Sec. 4.2,pp. 7–8。)
4.3 LongBench:平均最优,代码补全明显落后
14 项任务的平均分如下,均为越高越好:
| 模型 | LongBench 平均分 |
|---|---|
| Transformer | 14.7 |
| Mamba2 | 12.0 |
| GDN | 16.0 |
| Mamba3-SISO | 14.4 |
| Mamba3-MIMO | 11.4 |
| FRAC | 17.9 |
来源:Table 2,p. 8。按论文报告的一位小数,FRAC 相对最强线性基线 GDN 提高 1.9 分,相对提升约 11.9%;正文写作“1.9%”,更准确的表述应区分分数差和相对百分比。
以下按原文五类任务列出 FRAC 与 GDN 的逐项对照。这是任务分数,QA 使用 F1,摘要使用 ROUGE,TREC 使用准确率,代码使用编辑相似度;因此整套平均分不是统一的“准确率”。
| 类别 | 任务 | FRAC | GDN | FRAC−GDN |
|---|---|---|---|---|
| 单文档 QA | NarrativeQA | 13.2 | 11.5 | +1.7 |
| 单文档 QA | Qasper | 14.0 | 10.1 | +3.9 |
| 单文档 QA | MultiFieldQA-en | 25.8 | 24.4 | +1.4 |
| 多文档 QA | HotpotQA | 8.5 | 7.3 | +1.2 |
| 多文档 QA | 2WikiMQA | 12.2 | 14.8 | −2.6 |
| 多文档 QA | MuSiQue | 5.1 | 4.8 | +0.3 |
| 摘要 | GovReport | 13.8 | 7.9 | +5.9 |
| 摘要 | QMSum | 18.9 | 18.9 | 0.0 |
| 摘要 | MultiNews | 16.3 | 14.3 | +2.0 |
| 少样本 | TREC | 39.0 | 40.0 | −1.0 |
| 少样本 | TriviaQA | 24.5 | 21.6 | +2.9 |
| 少样本 | SAMSum | 28.2 | 13.2 | +15.0 |
| 代码 | LCC | 11.0 | 18.7 | −7.7 |
| 代码 | RepoBench-P | 19.5 | 16.9 | +2.6 |
粗体表示 FRAC 在全部六个模型中为该任务最优,共 8/14 项。优势较明显的项目包括 GovReport 与 SAMSum;但 LCC 的 FRAC 得分只有 11.0,Transformer 为 26.0,Mamba2 为 23.4。RepoBench-P 的最高分也来自 Mamba2(26.5),FRAC 为 19.5。
这说明持久记忆与精确代码延续并不自动同时改善。数据长度也能解释为何结果比纯 NIAH 更复杂:14 项任务中有 8 项的平均输入长度低于 8K,LCC 平均仅 1,235 tokens;NarrativeQA 平均为 18,405 tokens。LongBench 混合了长距离信息利用、局部建模和不同生成能力。(Table 7,p. 24。)
4.4 短上下文:保持竞争力,但真实检索排第三
| 模型 | Wiki. 困惑度↓ | LAMBADA 困惑度↓ | LM Harness 平均准确率↑ | 2K Recall-Retrieval 平均分↑ |
|---|---|---|---|---|
| Transformer | 15.3 | 13.6 | 55.3 | 38.5 |
| Mamba2 | 16.7 | 13.5 | 53.8 | 29.9 |
| GDN | 16.4 | 13.6 | 54.2 | 30.9 |
| Mamba3-SISO | 16.1 | 13.7 | 54.6 | 35.1 |
| Mamba3-MIMO | 15.9 | 12.3 | 55.3 | 36.8 |
| FRAC | 16.5 | 13.5 | 55.1 | 36.4 |
来源:Tables 3–4,p. 8。LM Harness 平均列排除前两项困惑度,只平均 LAMBADA、PIQA、HellaSwag、WinoGrande、ARC-e、ARC-c、OpenBookQA、BoolQ 八项准确率;HellaSwag 和 ARC-c 使用长度归一化准确率 acc_n。
FRAC 的 55.1 距离最高值仅 0.2 个百分点。它在 OpenBookQA 得分最高(41.8),但 Wikitext 困惑度比 Transformer 更高。论文主要将这些任务视为约 32–256 tokens 的短上下文能力检查。
真实检索方面,FRAC 的 36.4 比 Transformer 低 2.1 分,比 Mamba3-MIMO 低 0.4 分。它在 SWDE 上最高(43.2),但 FDA 为 20.0,明显低于 Mamba3-MIMO 的 28.9。该组全部截断至 2K,不能用来支持“真实长文档检索整体领先”。
4.5 DNA:上下文增加带来更低困惑度
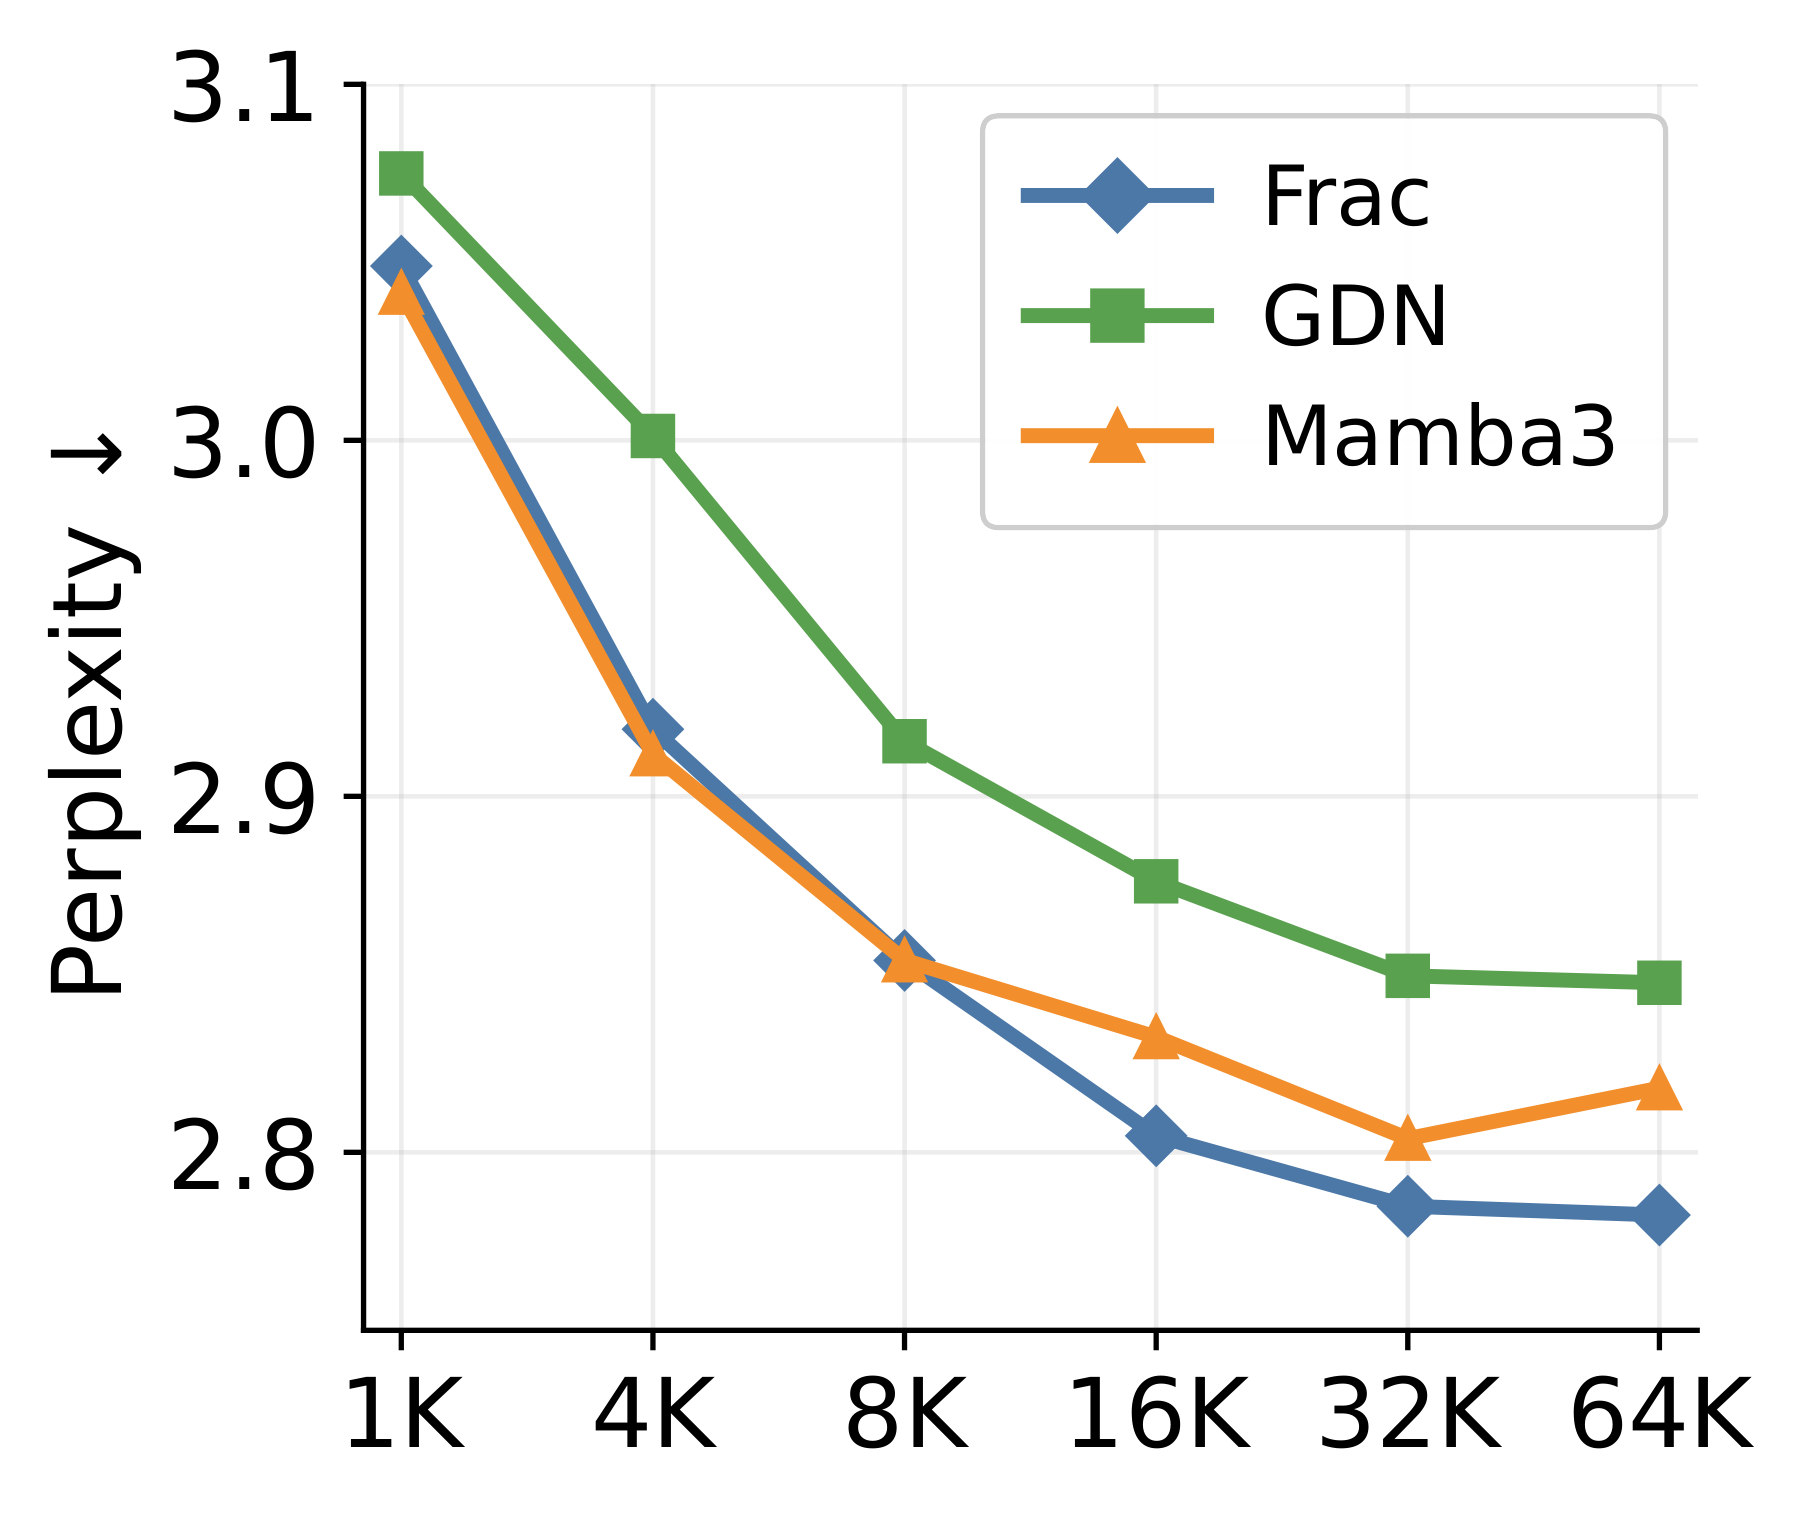
原文 Fig. 4,p. 9。横轴是训练及测试截断长度,纵轴为测试困惑度,越低越好;Mamba3 此处为 SISO。所有模型均约 7M 参数、8 层、hidden size 256、8 heads,使用 HG38 和字符级 DNA tokenizer。(Appendix E.4,p. 25。)
随着长度从 1K 增至 64K,三个模型的困惑度总体下降。FRAC 在短长度与 Mamba3 接近,16K 之后曲线更低,32K–64K 已接近平台。该实验支持 FRAC 从更长训练上下文中受益;每个长度分别训练并以同长度测试,因此它与前面“固定 4K 训练后零样本外推”的 NIAH 证据不同。
4.6 状态容量与吞吐:小状态没有自动变成最快解码
Appendix E.3 按每层主要递归张量比较状态大小,排除短卷积缓存与架构专用辅助缓存:
| 模型 | 主要状态形状 | 每层标量数 | 相对 FRAC |
|---|---|---|---|
| FRAC | $16\times16\times256$ | 65,536 | 1× |
| Mamba2 / Mamba3 | $16\times256\times128$ | 524,288 | 8× |
| GDN | $16\times96\times192$ | 294,912 | 4.5× |
因此,FRAC 的收益并非通过配置更大的每层主要递归状态获得。这里比较的是张量标量数,而非完整模型的显存字节数;不同模型层数也不同。(p. 23。)
Table 8 的实际吞吐如下,单位均为 tokens/s,越高越好:
| 模型 | Prefill 1K | Prefill 4K | Prefill 16K | Decode | Train 4K |
|---|---|---|---|---|---|
| Transformer | 55,839 | 79,173 | 56,297 | 62 | 218,184 |
| Mamba2 | 15,362 | 41,060 | 67,571 | 34 | 278,620 |
| GDN | 10,455 | 35,481 | 58,384 | 20 | 215,357 |
| Mamba3-SISO | 19,517 | 44,998 | 74,314 | 27 | 238,924 |
| Mamba3-MIMO | 13,692 | 30,710 | 46,707 | 25 | 200,994 |
| FRAC | 16,213 | 49,946 | 77,490 | 33 | 241,598 |
来源:Appendix F,p. 25。Prefill 是单卡、batch size 1 的比较;解码吞吐平均于生成 64 tokens,Transformer 的 62 对应 16K 前缀,其 1K/4K 数值分别为 75/72。训练列使用主预训练配置,不能与单卡推理列直接比较硬件效率。
在 16K prefill,FRAC 比 Mamba2 快约 14.7%,比 Transformer 快约 37.6%。但 1K–4K prefill 和解码仍由 Transformer 领先,线性模型中 Mamba2 的 decode 34 也略高于 FRAC 的 33。FRAC 训练吞吐比 Mamba2 低约 13.3%。这些结果体现了长度、kernel 和并行利用率共同决定速度;固定状态的优势不能直接改写为“所有场景更快”。
4.7 架构消融:模式分布、路由和直接通路都重要
消融使用 390M 参数、30B tokens、4K 训练、16K 评估,不是 1.3B 主实验。三个数据集指标均为困惑度,越低越好。
| 变体 | ProofPile | PG19 | GovReport |
|---|---|---|---|
| FRAC,M=16 | 47.2 | 28.4 | 11.3 |
| 固定 $\alpha=1$ | 61.3 | 36.2 | 19.7 |
| 去掉 write prior | 68.5 | 41.6 | 18.2 |
| pure multiscale bank | 76.3 | 47.1 | 17.2 |
| 去掉 softmax 读写归一化 | 80.4 | 36.9 | 15.5 |
| 独立初始化并学习时间尺度 | 54.1 | 34.3 | 13.5 |
| 去掉直接通路 $D$ | 70.9 | 46.4 | 23.6 |
| $M=8$ | 51.4 | 33.9 | 14.5 |
| $M=32$ | 47.9 | 29.1 | 10.6 |
来源:Appendix G,pp. 26–27,Table 9。
固定 $\alpha=1$、删除写入先验、删除 softmax 都使三个数据集恶化,说明收益不只来自“维护多个状态”。pure multiscale bank 同时固定 $\alpha=1$、移除两条读写先验,并改成独立初始化、自由学习的时间尺度;它检验的是整套结构化先验相对通用模式库的作用,不能单独归因到其中一个改动。另一个只改时间尺度的对照也变差,支持固定几何网格的价值。
去掉 $D$ 的损失很大,说明局部直接信息通路与慢记忆同样重要。$M=8$ 稳定恶化,$M=32$ 仅在 GovReport 更好,另外两项略差;作者报告 32 模式增加约 5% 参数并使计算慢约 7%,因此采用 16 模式。
这里的“$\alpha=1$”应按实际架构消融理解:它固定一个控制变量,其余多模式读写结构仍在,不能直接等同于将完整网络替换为单个普通 ODE 模型。
4.8 有限模式的数值拟合:16 个模式够不够
作者还单独拟合齐次核 $E_\alpha(-s^\alpha)$,其中 $s=\lambda^{1/\alpha}t$。固定 $\tau\in[1,2^{17}]$ 的几何网格,对每个 $\alpha\in\{0.10,0.11,\ldots,0.99\}$ 优化满足 $c_m\ge0$、$\sum_m c_m=1$ 的权重,最小化指定区间上的最大绝对误差,再对 $\alpha$ 求平均。
| 模式数 | 各 $\alpha$ 最大绝对误差的平均值 |
|---|---|
| 8 | $1.34\times10^{-3}$ |
| 16 | $6.82\times10^{-4}$ |
| 32 | $6.45\times10^{-4}$ |
来源:Table 10,p. 27。区间为 $s\in[4,6553.6]$,采用固定归一化步长 $\Delta\lambda^{1/\alpha}=0.1$,使 64K tokens 对应 $s=6553.6$。8→16 模式将该误差近乎减半,16→32 的改善较小。
这个实验验证了该模式库表示齐次分数阶曲线的能力。它使用单独优化的混合系数、固定 $\alpha$ 和特定时间区间,没有测量神经网络训练后逐 token 的真实记忆核误差,也没有覆盖冲激核在零点附近的奇异部分。这个区别关系到怎样把数值拟合证据与语言模型结果连接起来。
五:结论——把时间尺度分布作为架构先验
FRAC 的贡献可以沿一条完整链条理解:分数阶方程给出重尾目标;非负扩散表示把它改写为指数模式的积分;有限几何网格把积分变成固定大小状态;选择性控制和规范化读写使该结构能服务于 token 建模;仿射递推则保留并行训练与递归解码的计算形式。
最有启发的设计是以少量模式覆盖多个时间尺度,并让内容选择在哪些尺度上存取。这一原则在重尾合成任务和 4K 训练后的长上下文评估中得到支持,也能与关联更新机制形成互补。
实际取舍集中在三个方面:
- 覆盖范围由模式库与内部时钟共同决定。 在冻结控制后,有限指数和的极远尾部仍由最慢指数模式支配;论文的近似保证针对有限区间。超出有效尺度覆盖,或任务需要迅速清除无关历史时,慢记忆的优势可能减弱。
- 性能收益依赖所需能力。 FRAC 在 LongBench 平均分上领先,却在 LCC 和部分短上下文检索上落后;NIAH 的最难长距离设置仍会明显退化。更持久的状态不自动提供更精确的关联寻址。
- 理论结构与训练模型有明确间隔。 学习的读写权重、逐 token 控制,以及实际去掉 $1/\lambda_t$ 的写入系数,构成了对固定分数阶系统的架构推广。复现时应使用 Algorithm 1 的实验形式,解释时则保留固定系统误差界的适用条件。
作者在结论中提出与 delta-rule 更新结合,在局限中提出视频、科学序列和智能体持续记忆等后续应用;本文尚未提供这些组合或应用的实验。就现有证据而言,FRAC 最清晰的价值是:用可控的多时间尺度先验改善固定状态模型的长距离记忆,同时保留可实际实现的扫描和解码形式。