When Can Attention Heads Be Statically Defined?:中文精读笔记
作者: Weixian Waylon Li、Yintao Tai、Marcio Fonseca、Shay B. Cohen
arXiv: 2609.34650v1,2026-09-28 提交;本次获取:2026-11-10
原文: arXiv 页面 · 本地 PDF
- 发表: 截至 2026-11-10 未查到正式发表信息;arXiv 当前记录为 v1,作者主页将其标为 “Preprint 2026”。arXiv · 作者主页
- 代码: 作者官方实现 SAF,公开仓库包含训练、融合 kernel、评估代码、配置、测试,以及模型与数据发布入口。
论文总览
论文研究一个具体问题:训练中的一些注意力头,其注意力权重在不同输入间变化很小,能否在训练中途改为固定的因果权重矩阵,以免每个样本都重新计算 query-key 分数和 softmax?作者提出 Selective Attention Freezing(SAF,选择性注意力冻结):用一小批校准序列估计每个头的注意力方差,优先选方差低的头;以这些头的注意力概率均值作为固定模式;再将模式压缩为绝对位置偏好和相对距离偏好两个长度为 $T$ 的向量,并用融合 kernel 与普通注意力头一起执行。
SAF 冻结的是“把哪些位置的值向量混合起来”的权重,而不是整个头。被替换头仍然读取当前输入计算出的 $V$,其 value 和 output 投影也继续训练。因而它减少了 query-key 打分、softmax 及相应反向计算,但仍执行固定矩阵与当前 $V$ 的 token mixing。核心结果是:在 124M、4K 的三种子预训练中,中点替换 25% 的头使最终困惑度相对增加 $0.768\pm0.067\%$,替换后的优化器更新快 $1.056\times$;在 1B、8K、四张 GH200 上,对应为 $+0.507\%$ 和 $1.068\times$。这些速度是单步更新速度,不能直接当作端到端训练缩短比例。
结构地图
| 原文部分 | 主要内容 | PDF 页码与定位 |
|---|---|---|
| 摘要、§1 Introduction | 问题、SAF 贡献与主要结果 | pp. 1–2,Fig. 1 |
| §2 Related Work | 输入无关注意力、头裁剪与硬件执行 | p. 2 |
| §3 Replacing Attention with a Fixed Pattern | 选择器、固定模式、紧凑表示、混合 kernel | pp. 3–5,Eqs. (1)–(4),Fig. 2 |
| §4 Experimental Setup | 124M/1B 预训练、控制组、评价协议 | pp. 5–6 |
| §5 Results | 模式与头选择、替换比例/时机、迁移与扩展 | pp. 6–9,Figs. 3–6,Tables 1–3 |
| §6 Conclusion | 总结 | p. 9 |
| Appendix A:Additional Method Details | 算法、替代选择器与 schedule | pp. 15–17 |
| Appendix B:Understanding the Selected Recipe | 均值最优性、头诊断、替换后的恢复 | pp. 18–21,Tables 4–6 |
| Appendix C:Additional Experimental Details | 控制实验、剪枝、MQAR、下游任务、1B 与 Qwen | pp. 22–35,Tables 7–23 |
| Appendix D:Kernel Implementation and Validation | 紧凑拟合、数值验证、prefill 计时 | pp. 36–38,Tables 24–26 |
| Appendix E:Data, Models, and Licences | 数据、预训练模型与许可来源 | p. 38 |
一、动机:少数头可能不需要随输入重算权重
普通因果自注意力对每个头、每个输入计算
$$\mathbf{A}_{\ell h}(\mathbf{X})=\operatorname{softmax}_{\mathrm{causal}}\!\left(\frac{\mathbf{Q}_{\ell h}\mathbf{K}_{\ell h}^{\top}}{\sqrt{d_h}}\right),\qquad \mathbf{Z}_{\ell h}=\mathbf{A}_{\ell h}\mathbf{V}_{\ell h}.$$内容依赖的 $\mathbf{A}$ 让模型动态选择 token 间交互,但也带来 query/key 投影、分数矩阵、softmax 及其反向计算。论文的出发点是头之间存在差异:如果某个头的注意力主要由 query/key 的位置决定,而不是词元内容决定,那么它反复算出的权重可能近似不变。
既有工作已探索固定位置模式、输入平均注意力、随机 token mixing 和注意力裁剪,但作者指出仍有几个训练问题没有一并回答:哪些头适合替换、固定模式怎么选、训练到什么阶段替换,以及固定头与普通头混跑能否在现代 kernel 上获得实际速度与显存收益。SAF 用校准统计、概率均值和混合 kernel 构成一个完整方案(§1,PDF pp. 1–2)。
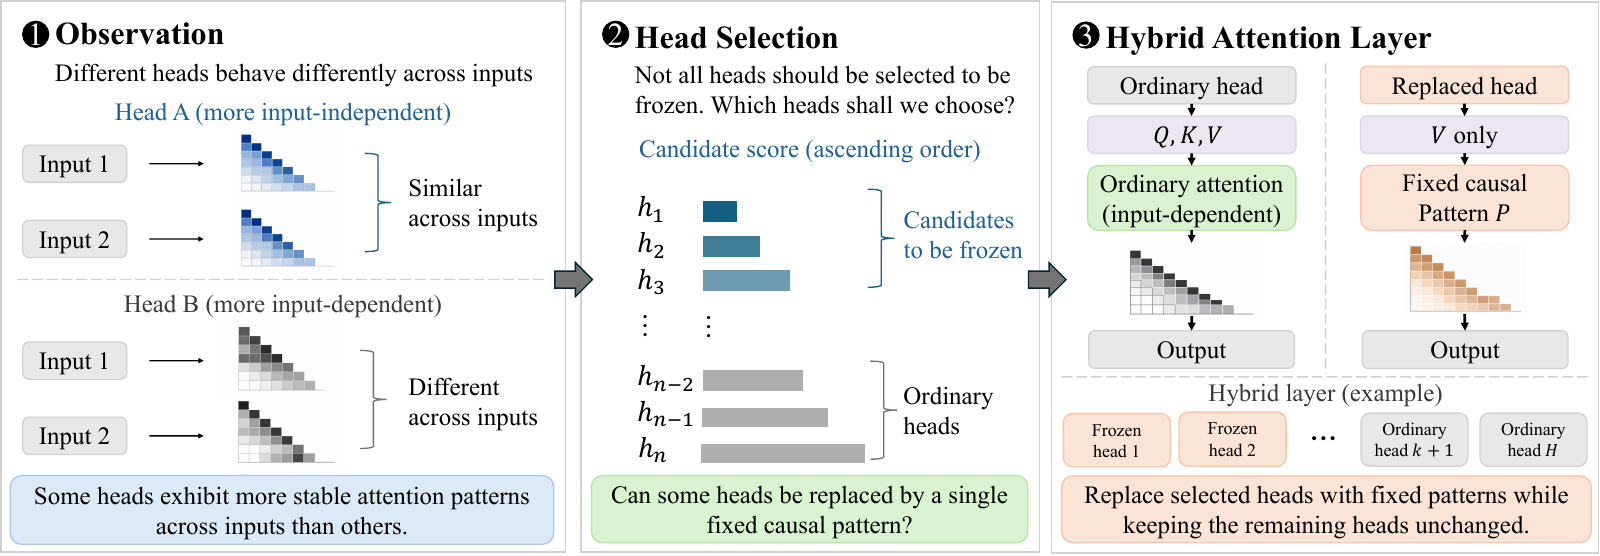
图 1(原文 Fig. 1,PDF p. 2)先对比同一头跨输入的注意力图,再展示按分数排序选择部分头,最后将固定模式头与普通注意力头放在同一层。右侧的关键区别是:普通头使用 $Q,K,V$,被替换头的动态路径只保留 $V$,两者输出仍进入同一混合层。
二、方法:测量输入变化,再固定模式但保留值混合
1. 校准并选择低方差头
在训练检查点上用 $N$ 个校准序列运行模型(不更新权重,也不推进训练数据采样器),得到每个头注意力矩阵的样本均值
$$\widehat{\mathbf{A}}_{\ell h}=\frac{1}{N}\sum_{n=1}^{N}\mathbf{A}_{\ell h}^{(n)}.$$SAF 以跨输入的注意力矩阵重建误差衡量头的变化程度:
$$s_{\ell h}^{\mathrm{var}}=\frac{1}{(N-1)T^2}\sum_{n=1}^{N}\left\|\mathbf{A}_{\ell h}^{(n)}-\widehat{\mathbf{A}}_{\ell h}\right\|_F^2. \tag{1}$$将所有层的头按 $s^{\mathrm{var}}$ 从小到大排序,取 $k=\operatorname{round}(rLH)$ 个头。分数小表示该头的注意力矩阵较容易由一个固定矩阵近似。它衡量的是注意力权重的跨输入变动,不是头的功能重要性或可删除性;注意力本身越集中,方差尺度也会受到影响(§3.1,PDF p. 3)。
作者也比较逐行 forward-KL 分数 $s^{\mathrm{KL}}$,以及 Q/K 梯度、输出幅度、同层冗余和残差影响等备选量。后续预训练里,方差选择在六种上下文长度与替换比例组合下都比 forward-KL 得到更低的最终困惑度(Appendix B.2,PDF p. 19)。
2. 固定模式取概率均值
对一个候选头,作者比较五种因果行随机矩阵:
- Post-softmax mean: 先对各输入的 softmax 注意力取平均,$\mathbf{P}=\widehat{\mathbf{A}}$;每一行仍是因果概率分布。
- Sharp mean: 先对 logits 求均值,再做因果 softmax。
- Gaussian sample: 独立拟合每个 logit 的边际正态分布后采样,再 softmax;忽略不同位置分数的相关性。
- Dirichlet sample: 对注意力概率整行拟合 Dirichlet 后采样。
- Structured random: 在与 SAF 相同的位置/距离参数化上随机取偏好,作为控制。
概率均值在替换率最高到 25% 时与 sharp mean 的 PPL 接近或更低;替换比例更高后差距扩大,Gaussian 与 Dirichlet 均未超过均值(§5.1,PDF p. 6,Fig. 3)。作者在 Appendix B 还给出均值选择的平方误差依据:若目标是用一个固定矩阵近似随机注意力矩阵,则期望平方 Frobenius 误差满足
$$\mathcal{R}(\mathbf{P})=\mathcal{R}(\mathbb{E}[\mathbf{A}])+\frac{1}{T^2}\|\mathbf{P}-\mathbb{E}[\mathbf{A}]\|_F^2.$$所以概率均值是该重建目标下的最优固定矩阵,最小误差正是注意力方差。这解释了为什么“选低方差头”与“为头使用均值模式”能形成配套规则。不过,这个推导优化的是注意力矩阵重建误差,不是语言模型损失;后者还依赖 $V$、输出投影、头间交互和替换后的继续训练(Appendix B.1,PDF p. 18)。
3. 用 $O(T)$ 空间表示固定矩阵
一个稠密固定模式每头要存 $T\times T$ 个数。SAF 改用长度为 $T$ 的两个向量:$\alpha(j)$ 表示 key 绝对位置偏好,$\rho(i-j)$ 表示 query 与 key 的相对距离偏好。对因果位置 $j\le i$:
$$\widehat{\mathbf{P}}(i,j)=\frac{\exp\bigl(\alpha(j)+\rho(i-j)\bigr)}{Z(i)},\qquad Z(i)=\sum_{k=1}^{i}\exp\bigl(\alpha(k)+\rho(i-k)\bigr),$$未来位置 $j>i$ 的权重为零。每一行用自己的 $Z(i)$ 归一化,两个向量让静态模式的存储从 $O(T^2)$ 降到 $O(T)$(Eq. (3),PDF p. 4)。拟合时最小化相对于目标模式的逐行交叉熵;目标的绝对位置边缘和距离边缘是拟合所需的充分统计量(Eq. (4))。SAF 对每个候选头用 400 步 Adam 拟合,要求平均每行 KL 误差不超过 0.2 nat;超过阈值的候选头会跳过,继续按方差顺序寻找可通过的头(Appendix A.2,PDF p. 16)。
4. 中途替换,融合普通与固定头的执行
默认在训练中点执行一次:124M 实验从 5,000 次更新中的第 2,500 次开始校准,安装选好的固定 pattern,然后以原模型权重、优化器状态和数据顺序继续训练。$\alpha,\rho$ 作为无梯度 buffer 固定;普通头及模型其余部分继续训练,被替换头的 $V$ 和 $W^O$ 也继续更新(Algorithm 1,PDF p. 16)。
融合 kernel 每层一次 launch:普通头走 FlashAttention-2 的在线 softmax tile;固定头在寄存器中用 $\alpha,\rho,Z$ 重建因果 tile,再与当前输入的 $V$ 相乘。训练路径中固定头不计算 query/key 投影、分数或 softmax,其注意力反向只需 $dV=\widehat{P}^{\top}dZ$。Qwen 的 GQA 路径因 key/value 在多个 query 头间共享,只省去被替换头的 query 投影,仍保留共享 K/V 投影(§3.3、Appendix D.2,PDF pp. 5、36–37)。
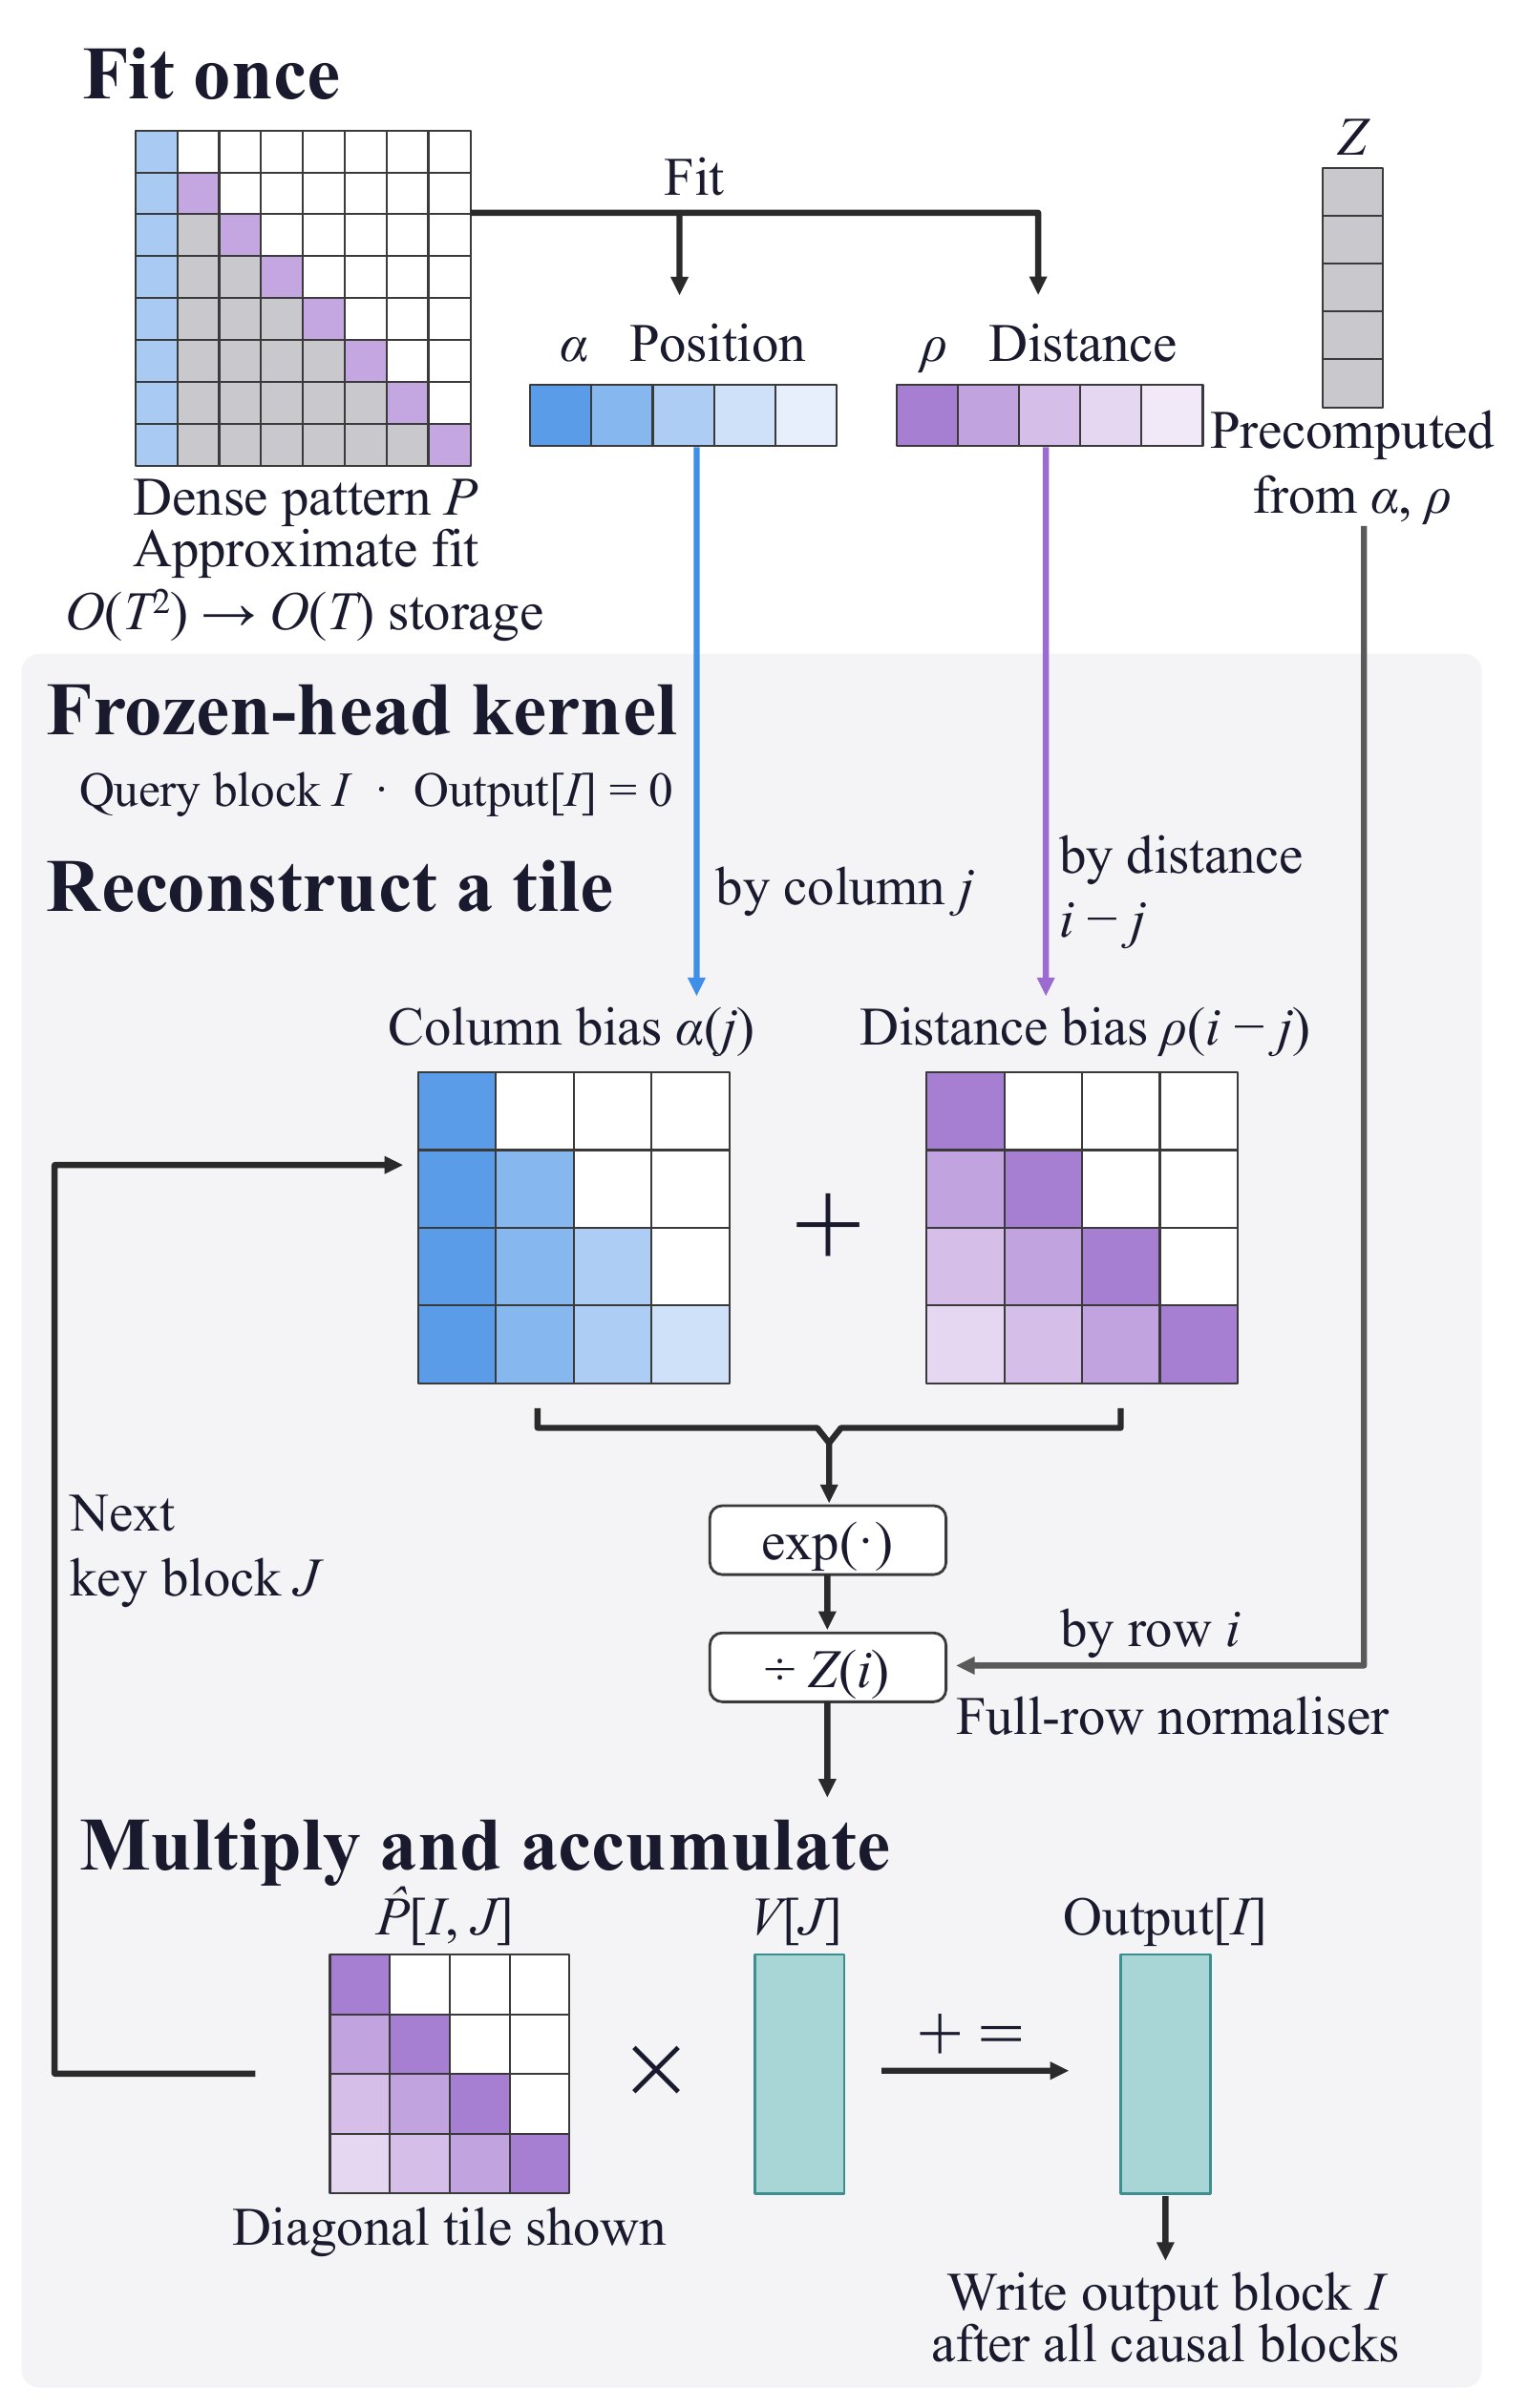
图 2(原文 Fig. 2,PDF p. 5)展示先将稠密模式拟合为位置与距离偏好,执行时按 tile 重建 $\widehat{P}[I,J]$,与 $V[J]$ 相乘并累加到输出。复杂度边界: 存储和打分/softmax 计算减少了,但固定模式仍要与 $V$ 做 token mixing,计算量仍是 $O(T^2d_h)$;因此该方法不是把注意力整体变成线性复杂度。
三、实验设计与指标
124M 预训练与主要控制
基础模型为 12 层、每层 12 头、隐藏维 768 的 decoder,在 FineWeb-Edu 上训练;比较 learned absolute position 和 RoPE。4K 主设置训练 5,000 次更新,每次 491,520 个目标 token,总计 2.4576B token(约 20 token/参数)。方法选择使用 seed 1337,确定 25% 和 50% 两个设置后,再以 seeds 1338、1339 重复。中途替换的控制组从相同检查点、优化器状态、训练配置与数据位置继续,按同一批次对比变体。主困惑度报告用与校准不重叠的 held-out token;三种子对照也另行使用 32 条 held-out calibration 序列(§4、Appendix C.1/C.3,PDF pp. 5–6、22–26)。
基线与测量口径
- 同头剪枝: 移除 SAF 所选头的输出及相应投影,检验保留固定 token mixing 是否比直接删除更有用。
- Gate-Taylor 剪枝: 依据输出门控对损失的梯度选头,作为更贴近剪枝目标的基线。
- 随机选头: 按层匹配 SAF 每层固定头数量,控制收益是否只来自头的层分布。
- 匹配时间: 给各方案同样的总时间预算,快的模型能处理更多 token;与匹配 token 的问题不同。
- 迁移评估: SST-2、BoolQ、QuALITY 下游微调;MQAR 关联回忆;Qwen3-4B 五项 zero-shot 任务;以及 causal prefill。
PPL 变化定义为 $100(p_{\mathrm{rep}}/p_{\mathrm{ord}}-1)$,因此是相对于普通注意力 PPL 的百分比变化。分类变化以百分点(pp)报告。更新速度是普通注意力耗时除以 SAF 耗时,计入梯度累积、反向、裁剪与 AdamW,但主更新 benchmark 不计数据加载、校准和模式拟合;124M 质量与计时使用不同运行。Appendix C 另外给出包含初始训练和干预在内的总路径时间(§4,PDF p. 5;Appendix C.1/C.3,pp. 22–28)。
四、结果:收益取决于替换率、头选择和工作负载
1. 25% 在所测设置里提供较温和的质量–更新速度权衡
| 规模与上下文 | 替换率 | 相对 PPL 变化 | 更新速度 | 峰值显存变化 |
|---|---|---|---|---|
| 124M,4K | 25% | $+0.768\pm0.067\%$ | $1.056\times$ | $-1.96\%$ |
| 124M,4K | 50% | $+2.492\pm0.083\%$ | $1.119\times$ | $-3.04\%$ |
| 124M,8K | 25% | $+0.578\pm0.011\%$ | $1.030\times$ | $-1.63\%$ |
| 124M,8K | 50% | $+2.058\pm0.066\%$ | $1.101\times$ | $-2.55\%$ |
| 124M,16K | 25% | $+0.450\pm0.012\%$ | $1.025\times$ | $-0.82\%$ |
| 124M,16K | 50% | $+1.792\pm0.112\%$ | $1.070\times$ | $-1.57\%$ |
PPL 数字为三种子均值的相对增幅;速度为替换后单次优化器更新的加速比;显存变化相对同一模型普通注意力设置。不同上下文使用各自训练并拟合的模型。替换 50% 通常带来更大速度/显存收益,同时 PPL 代价明显增加。16K 下相对 PPL 代价更低,但单步速度提升也较小(§5.2–5.3,PDF pp. 7–8,Table 2)。
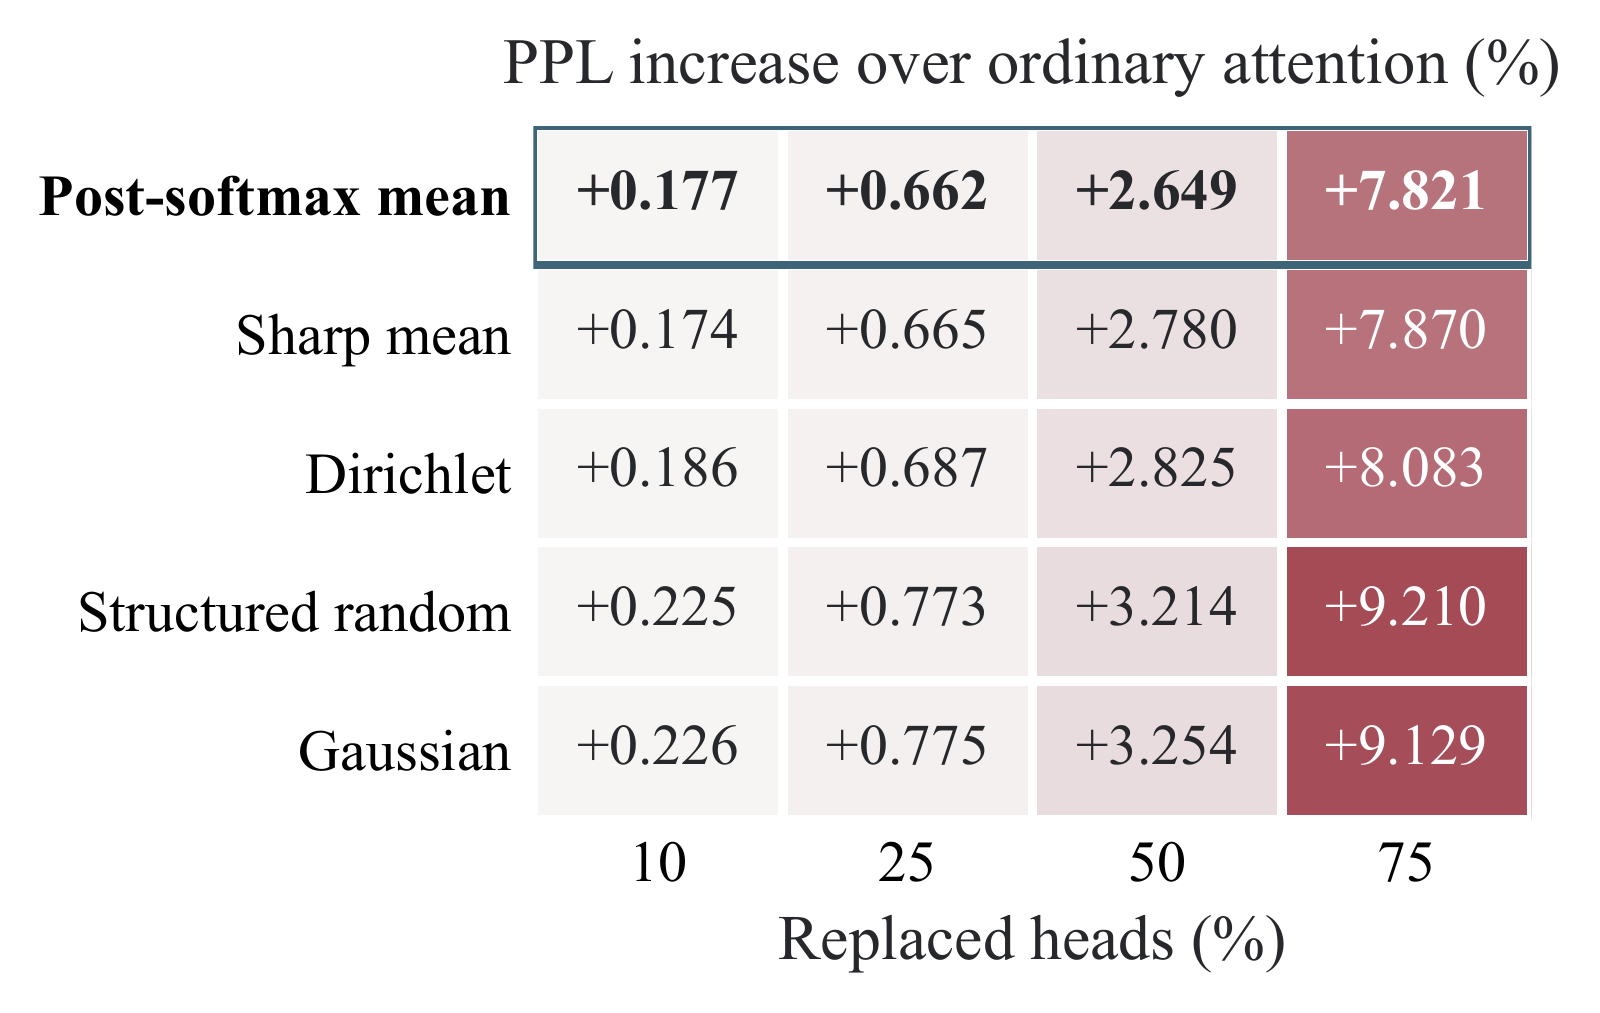
图 3(原文 Fig. 3,PDF p. 6)的横轴为替换头比例,纵向比较概率均值、logit sharp mean、Dirichlet、结构化随机模式和 Gaussian。以 25% 为例,post-softmax mean 的 PPL 增幅为 0.662%,sharp mean 为 0.665%;50% 时分别为 2.649% 和 2.780%。这是模式比较中的单模型结果;三种子主结论使用上表不同的重复实验,故不要把 0.662% 与表中的 $0.768\%$ 混为同一统计口径。
校准与拟合也有一次性成本:124M、4K、25% 控制组的总干预约 $54.9\pm6.0$ 秒,其中约 51.6 秒用于捕获注意力统计、约 3.2 秒拟合。单步速度表不计此成本;另一个包含整个训练路径的三种子控制中,普通注意力为 $188.7\pm2.7$ 分钟,SAF 25% 为 $184.7\pm1.6$ 分钟,显示该特定训练路径仍有净时间节省(Appendix C.3.1,PDF pp. 26–27)。
2. 方差选择胜过随机选择;“可固定”不等于“可删除”
在 25% 匹配 token 三种子控制中,均值模式加方差选择的 PPL 惩罚为 $0.663\pm0.018\%$,直接剪掉同一批低方差头为 $0.806\pm0.018\%$;按层匹配数量随机选头并保留均值模式则为 $1.282\pm0.056\%$。这支持两点:低方差选头本身有价值;保留固定权重下的值混合,比直接删掉同一批头更能保住匹配 token 的 PPL(Table 1,PDF p. 7)。
但在匹配总时间后,25% SAF 的 PPL 惩罚是 $0.456\pm0.108\%$,同头剪枝为 $0.113\pm0.169\%$。剪枝每步更便宜,预算内可完成更多更新(该对照分别约 5,109 和 5,267 次),所以固定时间下剪枝结果更好。较晚介入、匹配 token 的进一步实验中,SAF 仍优于同头方差剪枝(PPL 22.923 对 23.019),但 Gate-Taylor 剪枝更低(22.865);匹配时间下也是 Gate-Taylor 更优(22.798 对 22.895)。所以 SAF 的意义不是“全面胜过剪枝”,而是保留这类头的 token mixing 可在某些 token 预算或特定任务上有益(Appendix C.3.1、C.3.4,PDF pp. 27–29)。
训练匹配时间也支持方差选择:随机选择的 PPL 惩罚在 25%/50% 时比方差选择高 $0.786/0.866$ 个百分点。单头局部诊断里,residual-cosine 对即时损失变化的相关性略高(Spearman 0.810 对方差分数 0.723),但选中整批头后继续训练,方差选择的最终 PPL 增幅反而较低(0.665% 对 0.792%)。局部扰动代价与整批替换、后续适应后的效果不是同一个评价目标(Appendix B.2,PDF p. 19)。
3. 方差偏好早层、较分散的注意力;中点让模型有时间适应
在 124M、4K、25% 设置里,前四层包含 36 个入选头中的 21–24 个。跨 seed 来看,约四分之一训练处选出的 36 个头中有 30–31 个到中点仍被选中。按层匹配后,入选头的平均归一化熵为 0.837,未入选头为 0.678;对最近 64 个 token 的平均注意力质量分别为 19.0% 和 40.7%。方差与即时单头替换代价的关系在控制层与熵后仍为 partial Spearman 0.543。作者将这些作为头/注意力形态的诊断,没有据此指定头的语言学功能(Appendix B.2,PDF p. 20)。
替换时机测试中,训练完成 25%–60% 时介入,最终 PPL 惩罚约 0.662%–0.724%;75% 时为 0.936%;训练结束后直接替换则为 8.168%。早期替换会留下更多适应更新,但注意力排名仍会随训练发展;最佳经验方案是一次性中点替换,而不是频繁逐步重算头集合(§5.2、Appendix C.1,PDF pp. 7、22–23)。
4. 任务迁移与长上下文结果有明显工作负载差异
124M 下游微调在 SST-2、BoolQ、QuALITY 上的平均准确率变化均小于 0.8 个百分点(Table 2b,PDF p. 7)。但更新速度并非都提升:SST-2 的 25%/50% 更新速度为 $0.901/0.925\times$,BoolQ 为 $0.967/0.992\times$,长输入 QuALITY 16K 为 $1.047/1.118\times$。因此更长输入的 QuALITY 上看到较明显加速,不代表短任务微调普遍变快。
Causal prefill 在 124M、16K RoPE 检查点、batch 64 条件下,25% 替换在 512–16K 长度范围加速 $1.092$–$1.116\times$,50% 为 $1.200$–$1.244\times$。但 batch=1、T=4096 的观测中位数分别只有 $0.969\times$ 和 $0.972\times$,受到 kernel launch overhead 影响;这些 prefill 测量不包含逐 token KV-cache decoding(Appendix D.3,PDF p. 38)。
5. 关联回忆显示保留值混合的任务特定优势
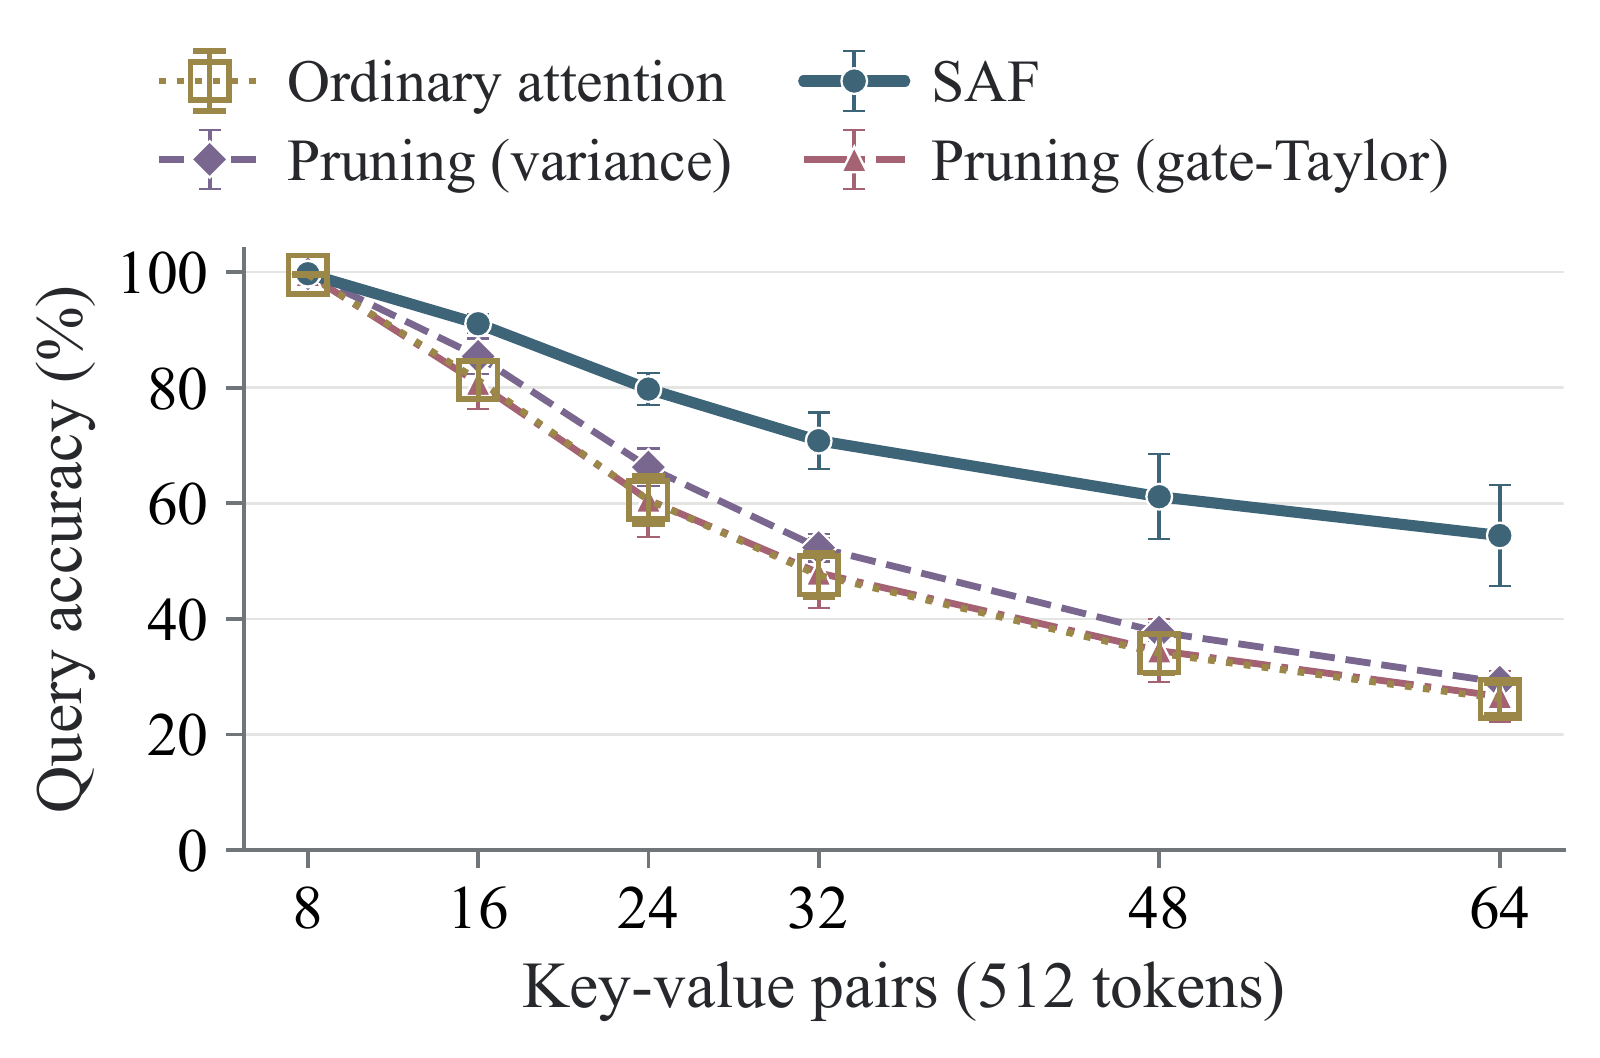
MQAR 任务要求根据序列中较早出现的 key 找回对应 value。所有 124M 模型都先在 512-token 序列、8 对 key-value 上适应,然后在同为 512 token 的输入中增加 pair 数,因此这项测试衡量的是“同一长度里回忆更多关联”,而非处理更长序列。64 对时,SAF 准确率为 $54.42\pm8.70\%$,普通注意力为 $26.19\pm2.75\%$,同头方差剪枝为 $29.03\pm1.42\%$,Gate-Taylor 剪枝为 $26.59\pm4.41\%$;SAF 在 24–64 对的每个预训练种子上都高于两种剪枝(Appendix C.3.6,PDF p. 31;主图 Fig. 5,PDF p. 8)。
这是任务适应后的结果,不是未经适应的即刻替换结果。固定长度外的长度测试(512、2,048、4,096 token,各 8 对)反而由剪枝略占优;对已经 MQAR 训练的模型立即替换,也没有稳定重现 SAF 优势。两个研究的介入阶段和校准域不同,不能据此拆解唯一因果机制(Appendix C.3.6,PDF pp. 31–32)。
6. Qwen zero-shot 与 1B 扩展
Qwen3-4B 的零样本实验不做进一步训练,使用 FineWeb-Edu 校准 512 条序列,按方差或 forward-KL 选头,再在五个任务上测试。方差选择在 15 个任务×比例比较中准确率都高于 forward-KL;10% 替换时五任务平均变化为 $-0.37$ pp,20% 为 $-1.79$ pp,30% 为 $-4.79$ pp。forward-KL 10% 的均值变化为 $-3.27$ pp(§5.3、Appendix C.6,PDF pp. 9、35)。这支持选择器会显著影响静态替换质量,并不意味着 Qwen 上 SAF 不损伤准确率。
1B、8K、19.667B token 的单次预训练中,普通模型 PPL 为 12.446,SAF 25% 为 12.509(相对 +0.507%),Gate-Taylor 剪枝为 12.529,SAF 50% 为 12.698(+2.027%)。四张 GH200 上含 all-reduce 的更新速度:25% 为 $1.0682\times$,50% 为 $1.1667\times$。1B PPL 只有一个预训练 seed;下游任务每个模型三个微调 seed,不能把三次微调重复当成三次独立预训练(§5.4、Appendix C.5,PDF pp. 9、34)。
五、结论与方法启发
这篇论文的机制核心是把“注意力图是否随输入变化”与“头是否值得保留”区分开:低方差的注意力图可由一个位置偏置近似,但该头仍可能通过当前输入生成的 value 参与有用 token mixing。用概率均值替代动态权重,避免把随机采样误当成更好的固定模式;用紧凑表示减少静态模式的状态;用 fused kernel 将理论节省兑现到真实更新和 prefill。
最可信的使用场景是:已训练一段时间的 decoder 中确实存在低方差头,允许以小幅 PPL 上升换取后续更新吞吐或长输入 prefill。比例是关键取舍:25% 的 PPL 代价较小;50% 加速更高,但质量代价也大得多。SAF 也给出清楚的实作提醒:需要校准、模式拟合、匹配运行负载与 kernel;在低 batch、短序列或微调任务上,启动开销可能压过省下的打分计算。最重要的边界是固定 token mixing 仍然是二次计算,且比较剪枝时,结论会随“匹配 token”还是“匹配总时间”改变。