How Linear Attention Remembers:中文研读笔记
作者: Kichang Lee、JaeYeon Park、Songkuk Kim、JeongGil Ko。
论文: arXiv:2609.33093v1,2026-09-27 提交;本次研读日期:2026-10-08。
原文: arXiv 页面 · 本地论文 PDF · 英文汇报 PDF · 可编辑 Beamer 源文件。本文页码均为从 1 开始的 PDF 页码,与原文印刷页码一致。
论文总览
线性注意力将历史压入固定大小的循环状态。本文研究这个状态在预训练模型中如何实际承担记忆:一条事实什么时候进入状态,经过后续上下文后怎样保留,又通过哪条计算路径影响答案。
作者把状态的线性展开与内部因果干预结合起来。在 GLA-340M、GDN-340M 和 GDN-1.3B 上,先用独立开发集选择有强因果效应的循环头,再分别替换事实写入、查询前状态、查询时输出。三类干预串起了“内容特定写入—跨上下文保留—查询时读出”的证据链。四条事实共享状态时,定向替换仍可只改变目标答案;但把编辑方向分解后,可以看到对其他事实的相反影响,说明行为上的选择性与内部耦合能够共存。
最值得记住的三个发现是:
- 状态里有信息,与模型能读出信息,是两个问题。 查询时输出的替换与恢复,将状态变化的行为效应定位到具体读出路径。
- 在所测长度内,事实竞争比单纯增加间隔更影响召回。 后续写入与旧事实写入方向重叠,还会直接降低目标答案的 margin。
- 记忆的直接载体取决于架构。 在被测混合模型中,查询前直接承载目标身份信息的主要是全注意力 KV 缓存;循环层仍可能参与形成这些 KV 和查询。
本文的贡献是机制分析与实验诊断,没有提出新的注意力更新规则或可直接部署的记忆删除算法。(Sec. 1–6,PDF pp. 1–9)
结构地图
| 原文章节 | 作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 从缓存节省转向共享状态的记忆组织问题 | pp. 1–2 |
| 2 Background and Analytical Framework | 状态递推、贡献分解、评测协议 | pp. 2–4,式 (1)–(5)、图 1 |
| 3.1 Content-Specific Writes Persist in Recurrent State | 选头、阻断写入、替换写入及头间非加性 | pp. 4–5,图 2–3 |
| 3.2 Recall Is Mediated by Concentrated Query-Time Read Pathways | 状态替换、输出替换、输出恢复 | p. 5,图 4 |
| 3.3 Shared State Supports Selective Multi-Fact Recall | 四事实编辑及跨事实方向耦合 | p. 6,图 5 |
| 4.1 The Memory Substrate Shifts in Hybrid Architectures | 循环缓存与 KV 缓存的因子干预 | pp. 6–7,图 6 |
| 4.2 Entangled State Memory Limits Selective Manipulation | 负载、间隔、写入重叠及三种失效 | pp. 7–8,图 7–8 |
| 5 Related Work;6 Discussion and Conclusion | 与已有方法的关系、启发与范围 | pp. 8–9 |
| A Model Checkpoints and Experimental Setup | checkpoint、结构和运行配置 | pp. 12–14,表 1 |
| B Selection of Recurrent Heads for Causal Analysis | 开发集选头及稳定性 | pp. 14–15,式 (6)、图 9 |
| C Additional Validation of Recurrent Memory Pathways | 留出集全头扫描、逐层 logit lens | pp. 15–17,图 10–11 |
| D Additional Analysis of Shared-State Organization | 选择性压制、读出路径复用 | pp. 16–18,图 12–13 |
| E Robustness and Generality | 混合模型跨任务验证、更多循环 checkpoint | pp. 18–20,表 2、图 14 |
| F Additional Diagnostics and Scope | 状态特征纠错与自然语句检索能力门槛 | pp. 20–21,图 15、表 3 |
一:动机——固定大小状态如何容纳可区分的事实
标准注意力的 KV 缓存保留逐 token 的键值表示,历史越长,缓存越大。循环线性注意力让每个头只携带一个固定形状的矩阵,新 token 不断更新它。这样可以控制随序列长度增长的存储成本,但许多事实必须共同使用同一状态空间。
关键疑问随之改变:一条事实有没有专属的内部位置?修改一个状态方向是否只影响一个事实?回答失败是因为旧信息已被破坏,还是查询没有访问正确方向?如果模型同时拥有循环状态和 KV 缓存,它实际从哪里取回答案?这些问题不能仅靠最终准确率或状态范数解决,需要在不同时间点改变内部变量,再观察答案如何变化。(Sec. 1,PDF pp. 1–2)
二:方法——把记忆生命周期拆成可干预的环节
2.1 状态的“写入—变换—读取”分解
对一个循环注意力头,原文写成:
| 符号 | 含义与维度 |
|---|---|
| $h_t\in\mathbb R^{d_{\mathrm{model}}}$ | 当前位置的隐藏表示,用于产生查询、写入及状态变换 |
| $S_t\in\mathbb R^{d_k\times d_v}$ | 当前头的循环记忆矩阵 |
| $\mathcal T_t$ | 给定当前 token 表示后,对旧状态线性的变换 |
| $W_t\in\mathbb R^{d_k\times d_v}$ | 当前写入;常见形式为 $u_tv_t^\top$ |
| $u_t\in\mathbb R^{d_k}$,$v_t\in\mathbb R^{d_v}$ | 写入方向与写入内容 |
| $q_t\in\mathbb R^{d_k}$,$o_t\in\mathbb R^{d_v}$ | 查询方向与核心读出向量;式中后者按行向量书写 |
GLA 的旧状态变换主要是数据依赖的乘性门控,例如 $\mathcal T_t(S)=G_t\odot S$。GDN 还沿当前 key 方向执行 delta-rule 修正。公式中的 $o_t$ 抽象掉了架构特定的输出门控和归一化。(Sec. 2.1,式 (1)–(2),PDF p. 2)
设第 $i$ 个 token 初次写入的贡献是 $C_i^{(i)}=W_i$,以后该贡献经过每一步变换:
在 $S_0=0$ 时,由线性性可得:
这给出两个不同环节:$C_i^{(t)}$ 描述过去写入经过后续变换后留下什么;$q_t^\top C_i^{(t)}$ 描述当前查询实际读到了什么。贡献非零,并不保证当前查询能利用它。另一方面,从总和 $S_t$ 通常不能唯一恢复每个来源贡献:可以把任意矩阵加给一个贡献、从另一个贡献减去,而总状态不变。因此,这种数学分解没有自动提供按 token 删除的操作接口。(Sec. 2.2,式 (3)–(5),PDF pp. 2–3)
成立条件很重要: 上述展开是沿一条固定前向轨迹、固定已实现的 $\mathcal T_t$ 后的精确分解。干预后,后续隐藏表示和变换本身可能变化,所以端到端因果效应必须通过重新运行模型测量,不能直接当成原轨迹贡献的机械相减。
教学例子。 忽略门控,令 $S=u_Av_A^\top+u_Bv_B^\top$。若两个单位写入方向正交,且 $q=u_A$,则 $q^\top S=v_A^\top$:共享一个矩阵仍可选择性读出。若 $u_A^\top u_B=\rho\ne0$,读出就包含 $\rho v_B^\top$。这个简化例子说明几何重叠为何可能造成串扰;真实模型还有多层计算、门控和状态反馈,是否造成行为损害仍要看干预实验。
2.2 donor/recipient 配对把“破坏能力”与“改写内容”分开
作者构造接受干预的 recipient 与提供反事实内部变量的 donor。两条输入长度相同,在主要协议中只改变目标 key 绑定的 value。例如一条输入写“Alice 在 Paris”,另一条写“Alice 在 London”,其他内容相同。之后从 donor 取出特定内部变量,替换 recipient 的对应部分。
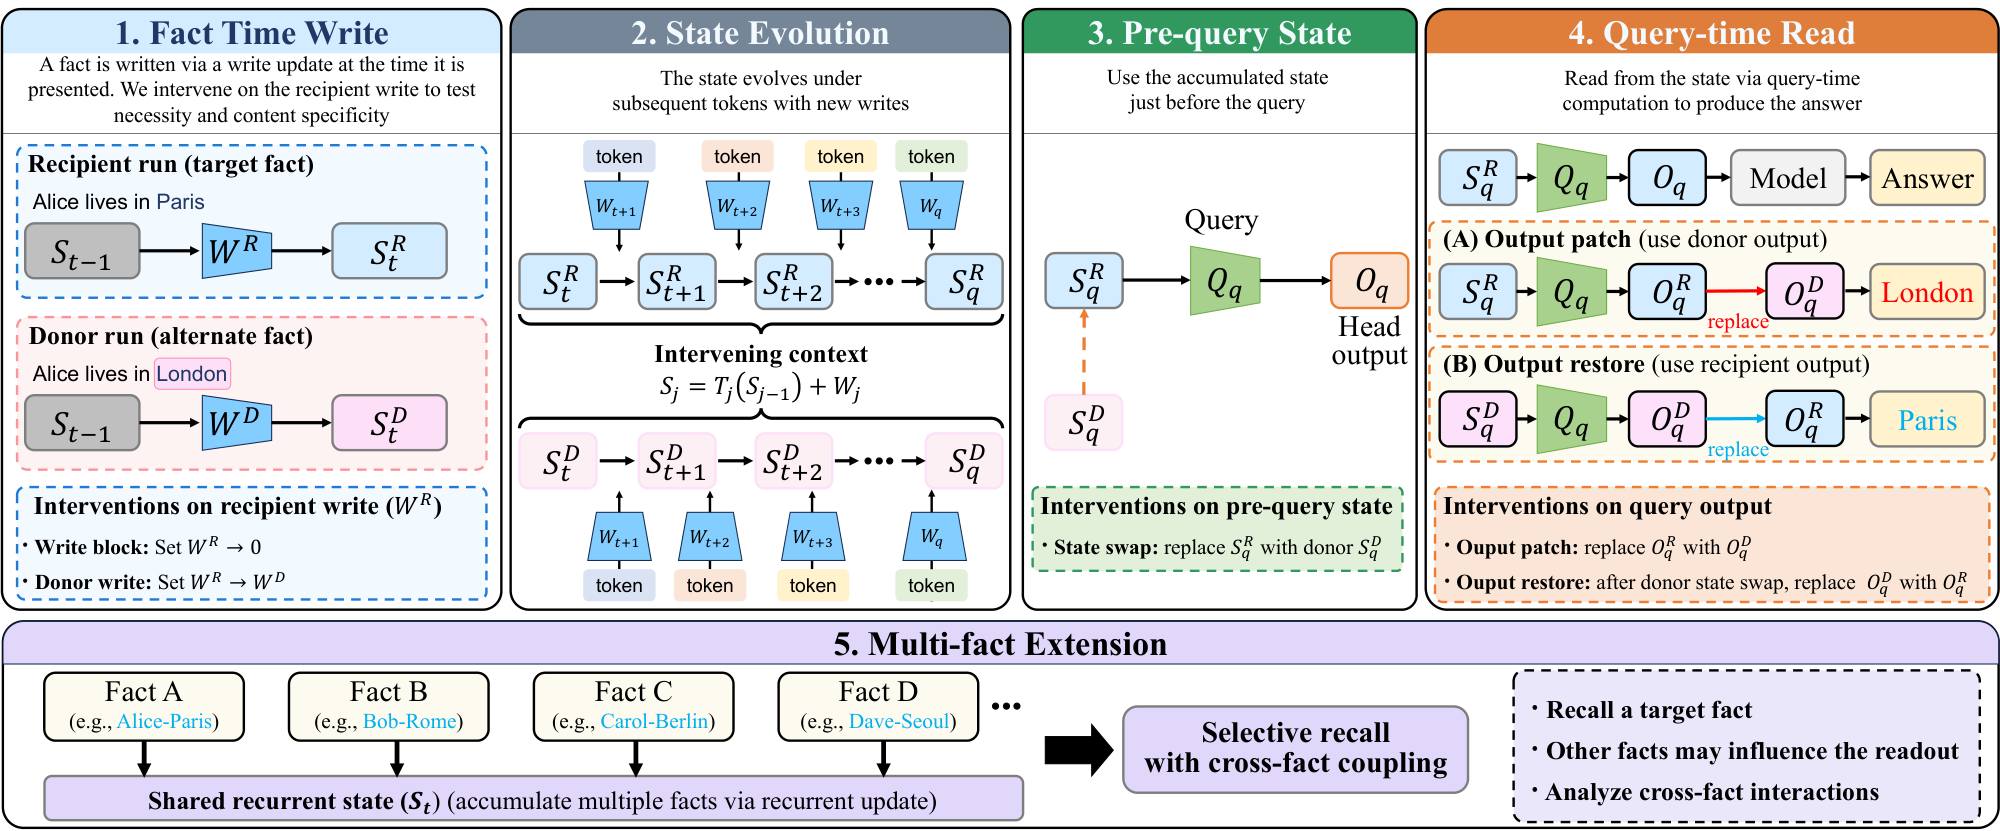
原文图 1,PDF p. 4。按从左到右的顺序读:事实时写入,经过中间上下文,在查询前替换状态,最后在查询时替换或恢复输出。下方扩展到多个事实。图中的单事实干预只作用于开发集选定的一个循环头。
| 干预 | 改变什么 | 检验的问题 |
|---|---|---|
| Write block | 阻断选中头在事实跨度上的写入 | 该写入对后续召回是否重要? |
| Donor write | 用 donor 的事实写入替换 recipient 写入,之后正常运行 | 写入是否携带特定内容,且影响能跨上下文保留? |
| State swap | 查询前换入选中头的 donor 循环矩阵 | 答案相关 donor 信息是否已存在于查询前状态? |
| Output patch | 状态保持 recipient,只换查询时的 donor 头输出 | 单独改变读出路径是否能传递 donor 效应? |
| Output restore | 先换 donor 状态,再恢复 recipient 的查询时输出 | 恢复该输出是否会阻断状态替换的行为效应? |
仅观察阻断导致错误还不够,因为一般性扰动也可能破坏能力。用 donor 内容把答案推向一个指定反事实,并和等范数随机更新、控制头更新比较,提供了更具体的内容因果证据。(Sec. 3.1–3.2,PDF pp. 4–5)
2.3 先选头,再冻结选择做确认
开发集扫描三个主要模型的全部 96、96、192 个头。附录 B 的 16 个 WikiText-103 validation 来源组,每组有四个绑定、每个绑定三次呈现、512 个 filler token 和单 token 查询。每次从独立复制的 recipient cache 出发,只替换一个头的循环矩阵,保留其他状态和 GDN 的短卷积缓存。
头的重要性按 donor 相对 recipient 的 margin 改变量衡量。用文字定义对应的记号,可写为:
这里 $z$ 是候选答案 token 的 logit,$d_i,r_i$ 分别是 donor 与 recipient 的答案,正的 margin 改变量表示更偏向 donor。最终选定 GLA 的 L21H3、GDN-340M 的 L20H2、GDN-1.3B 的 L20H3;层和头均从 0 编号。(图 2,PDF p. 4;附录 B、图 9,PDF pp. 14–15)
v1 的式 (6) 有实质记号问题: PDF p. 14 和 TeX 中两个 margin 括号之间没有减号,呈相乘形式;这与上下文所说的“mean change”、图 9 的 signed margin shift 不一致。上式依据文字定义展开,并非照录原式,也不能据此断言作者代码究竟采用哪一种。复现实验时应先核实这一点。
两个 340M 模型此前已在 12 对样本的探索中选定这些头;后来 16 来源扫描复现了同样选择。1.3B 的选择则直接来自该 16 来源开发协议。确认阶段不再换头。开发集中最佳头分别在 16/16、16/16、15/16 个来源上排名第一,留一来源重算也保持赢家;这些是选择稳定性证据,独立确认还要看附录 C。(附录 B,PDF pp. 14–15)
2.4 用状态方向的投影测量跨事实耦合
令 $\Delta_A$、$\Delta_B$ 为选中头在查询边界上、分别改变事实 A/B 得到的 donor–recipient 状态差。按原文描述展开 Frobenius 投影:
其中 $\langle X,Y\rangle_F=\operatorname{tr}(X^\top Y)$,需 $\Delta_B\ne0$。作者分别把平行分量、正交分量、完整 $\Delta_A$ 加到 recipient 状态,再查询 B,并与各自等范数的高斯扰动比较。这是在测量查询边界的状态差方向;后文图 7 的重叠实验干预的是后续 token 的写入 key,二者不可混为同一个操作。(Sec. 3.3,PDF p. 6)
三:实验——模型、对照与指标分别回答什么
3.1 被测模型与存储结构
| 模型名称 | 实际参数量 | 循环层 / 全注意力层 | 每个循环状态的形状;头数 |
|---|---|---|---|
| GLA-340M | 341.7M | 24 / 0 | $128\times256$;每层 4 头 |
| GDN-340M | 399.5M | 24 / 0 | $256\times256$;每层 4 头 |
| GDN-1.3B | 1.466B | 24 / 0 | $256\times256$;每层 8 头 |
| Hybrid GDN-340M | 382.6M | 16 / 8 | $256\times256$;每循环层 4 头 |
| Qwen3.5-4B / 9B | 活跃文本模型约 4.206B / 8.954B | 各 24 / 8 | $d_k=d_v=128$;16 key 头、32 value 头 |
参数名称沿用 checkpoint 名称,不能把两个“340M”理解成严格等参数或等状态容量。GLA 与 GDN 的单头状态元素数相差两倍。GDN 还带宽度为 4 的因果短卷积,GLA-340M 没有。主干权重冻结、不做额外微调;运行中权重和普通激活使用 BF16,循环 cache 使用 FP32。附录 F 的纠错器是另行训练的小模型,不改变这个主干冻结设定。(附录 A,表 1,PDF pp. 12–14)
纯 GDN-340M 与混合版本共享发布方标称的 20B-token 训练预算、隐藏宽度、深度和 tokenizer,但来自分别发布的 checkpoint,参数量相差约 4.2%。它们用于观察架构边界,不能将差异全部归因于“增加全注意力”这一个变量。
结构记载有一处矛盾: 附录 A 写混合 GDN 的全注意力位于第 2、5、8、11、14、17、20、23 层,即 16 个循环层与 8 个全注意力层;相邻文字却称其为 3:1。按该层列表和表 1 应为 2:1。本文使用明确的 16/8 层数;Qwen 的 24/8 才是 3:1。(PDF p. 13)
3.2 任务与统计单位
主要任务是自然文本 filler 中的受控键值关联召回,从四个平衡候选值的条件似然中选答案,机会水平为 25%。改变事实数、写入位置、后续修改或查询距离,分别检验不同因素。WikiText-103 的开发与确认来源分离;以 source passage 为统计单位,图中误差条通常为来源 bootstrap 的 95% 置信区间。来源组是 token 窗口,不保证来自互不相同的 WikiText 文章。(Sec. 2.3;附录 B)
不同附录实验有自己的样本口径:全头留出扫描用 32 个来源;逐层定位为 96 个来源、另用 128 个来源确认;中性状态压制用 128 个来源;颜色子空间迁移是探索性的 32 来源诊断;扩展 checkpoint 的 top-$k$ 检验用 32 开发来源与 64 测试来源。不能把某一项的 $n$ 或 512-token 配置套到全文所有图上。
3.3 指标与对照
| 指标 | 如何理解 | 方向和比较口径 |
|---|---|---|
| Clean recall accuracy | 未干预时能否选对原答案 | 越高说明原任务能力越强 |
| Donor-answer rate | 干预后输出指定 donor 答案的比例 | 越高表示定向内容转移更成功;不同于普通正确率 |
| Donor-margin shift | 干预前后 donor–recipient logit 差的变化 | 越正表示更偏向 donor;单位为 logit |
| Target/correct-answer margin change | 干预对目标正确答案优势的影响 | 负值说明正确答案的支持减弱 |
| Non-target break rate | 原来正确的非目标答案被干预改错的比例 | 越低误伤越小;分母是原本正确的非目标项 |
| Normalized donor effect | 单种缓存替换的 donor-margin 变化 / 同时替换两类缓存的变化 | 表示相对于完整干预的效应恢复比例,不是准确率 |
等范数随机更新控制“扰动大小”这个解释;控制头干预检验是否任意头都有效;output restore 检验指定读出路径是否传递状态效应;hybrid 的循环-only / KV-only / 两者同时替换则比较不同缓存载体。联合干预直接运行测量,不能默认把各头单独效应相加。
四:结果——从单事实机制到共享状态的失效
4.1 写入确实携带内容,而且头与头相互作用
阻断选中头在事实跨度上的写入,会大幅降低后续召回:
| 模型 | 原始召回 | 写入阻断后 | 下降 |
|---|---|---|---|
| GLA-340M | 93.0% | 14.1% | 78.9 个百分点 |
| GDN-340M | 96.9% | 36.7% | 60.2 个百分点 |
| GDN-1.3B | 93.8% | 57.8% | 36.0 个百分点 |
来源:图 3(a),PDF p. 5;下降值由图中保留一位小数的准确率相减。把写入替换为 donor 内容时,正文报告三模型的 donor-answer rate 为 68%–90%;等范数随机写入和控制头无法复现相同的 donor-margin 变化。这说明所选写入携带了反事实内容,其作用能在之后正常处理上下文时持续存在。
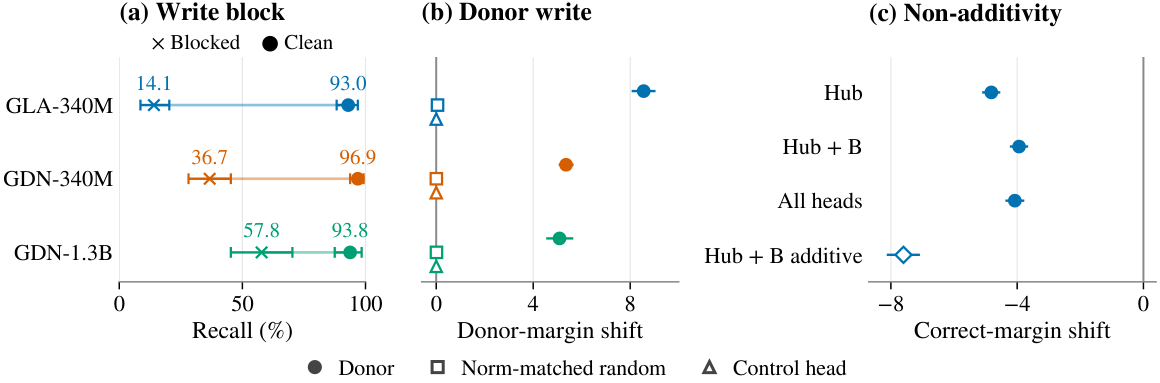
原文图 3,PDF p. 5。左图是召回准确率,圆点为 clean、叉号为阻断;中图横轴是 donor-margin shift;右图横轴是 GLA 正确答案 margin 的变化。右图中,阻断主头 Hub 的损害甚至大于阻断所有头;Hub 与开发集选出的次级头 B=L14H3 联合阻断,其效应也不等于两个单独效应之和。
这个非加性结果很关键:发现一个高影响头,定位的是模型实际依赖的计算回路的一部分。它不能直接被解释成可以脱离其他头独立读写的“事实存储槽”。(Sec. 3.1)
4.2 查询时输出传递了状态的行为效应
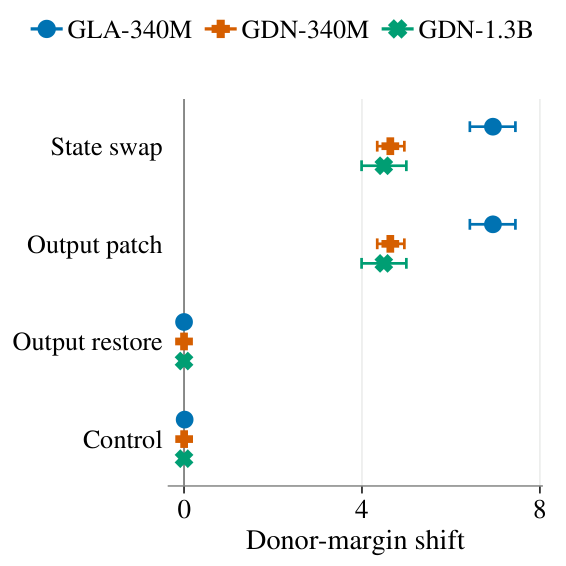
原文图 4,PDF p. 5。横轴是 donor-margin shift,三种颜色对应三个主要模型。先看前两行:state swap 与 output patch 产生接近的正向 donor 效应。再看第三行:换入 donor 状态后恢复 recipient 输出,效应降到接近零。控制干预也接近零。
这把证据链闭合起来:donor 信息在查询前已经进入循环状态,而它最终对答案的影响经由选中头的查询时输出传递。恢复输出相当于在这条路径上切断传播。这里的因果结论针对被干预的路径;它没有要求其他位置完全不含答案信息。(Sec. 3.2)
4.3 四条事实可以分别访问,但方向内部存在耦合
| 模型 | 目标 donor-answer rate | 非目标 break rate |
|---|---|---|
| GLA-340M | 89.1% | 1.42% |
| GDN-340M | 71.9% | 0.41% |
| GDN-1.3B | 61.3% | 0.56% |
来源:四事实实验,图 5(a–b),PDF p. 6。目标转移和非目标误伤是两个不同指标;这里 GDN-1.3B 的目标转移比例也并未超过较小的 GDN。
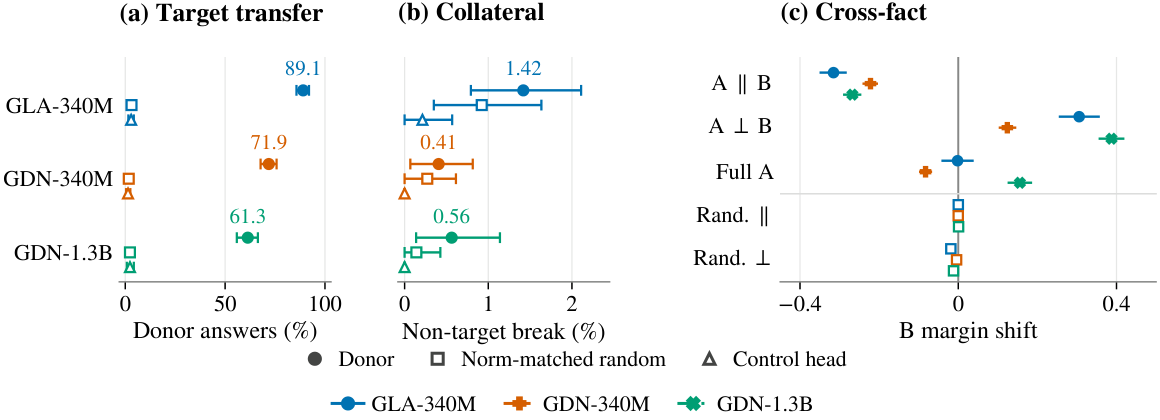
原文图 5,PDF p. 6。左、中面板分别读目标转移率和非目标误伤率。右面板读“改变 A 的状态方向后,B 的正确答案 margin 变化”:平行分量使 B 的 margin 降低,正交分量使它升高;对应随机方向的平均作用更小。完整 A 编辑的有符号净效应较弱,与两部分抵消相一致。
这里的“正交”只是相对于 $\Delta_B$ 的 Frobenius 几何关系。B 的行为输出由后续整个模型决定,所以几何正交不保证行为独立。选择性可能来自结构化的相互抵消与读出组织,而非每条事实占据互不影响的内部坐标。(Sec. 3.3)
4.4 混合模型主要从 KV 缓存直接取回目标身份
作者在查询前分别替换循环状态及其局部缓存、全注意力 KV、或两类同时替换。所有比例以完整干预的 donor-margin shift 为分母。
| 设置 | 循环 / local 的效应恢复比例 | KV 的效应恢复比例 |
|---|---|---|
| 纯 GDN-340M | 几乎完整恢复 | 不适用 |
| 近似匹配的 Hybrid GDN-340M | <1% | >99% |
| Qwen3.5-4B 的 retrieval、latest-value、integration | 0.2%–3.6% | 96%–100% |
Qwen3.5-9B 的 retrieval 也呈现相同分离。正文另外排除了两个 clean 表现接近机会水平的预设条件,因其基础任务能力不足以支撑这类归因。(Sec. 4.1,图 6,PDF p. 7)
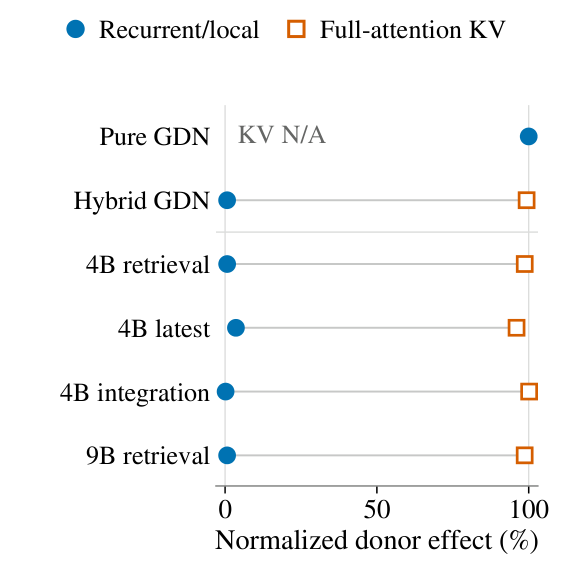
原文图 6,PDF p. 7。横轴是归一化 donor 效应;蓝点为循环/local,橙色空心方块为 KV。这张图应读成“查询前替换哪种缓存能转移答案”,不应把横轴读成检索准确率。
附录 E.1 把 Qwen3.5-4B 扩展到更自然的实体更新及约 4K token 的 RULER single-NIAH:
| 任务 | 来源数 | Clean | 循环 donor | KV donor | KV/full 效应 |
|---|---|---|---|---|---|
| 实体更新 + WikiText | 128 | 93.0% | 0.0% | 85.2% | 97.2% |
| 实体更新 + PG19 | 128 | 89.1% | 0.0% | 89.8% | 96.2% |
| RULER single-NIAH,约 4K | 64 | 100.0% | 0.0% | 100.0% | 97.2% |
来源:表 2,PDF p. 19。表中后三列前两列是 donor 答案比例,最后一列是 margin 效应恢复比例,二者数值不同并不矛盾。
这定位了直接运行时载体。循环层仍可能参与早期事实加工、把信息写进全注意力 KV、形成 query;仅替换查询前缓存并未消融这些历史计算。因此,合理的设计启发是研究两类记忆如何分工,而非据此删除混合模型的循环层。
4.5 负载、间隔与重叠分别暴露不同的失效
竞争事实数。 图 7(a) 固定序列长度,将活跃关联数从 $K=1$ 增至 $K=16$,GLA-340M 和 GDN-340M 的召回约下降 30–40 个百分点。时间间隔。 图 7(b) 固定 $K=4$,将事实到查询的距离从 128 增至 1024 token,召回下降小得多。这支持在所测范围内,竞争事实对状态的压力大于增加普通上下文的影响。filler token 仍然会更新状态,“增加间隔”并非让状态静止等待。(Sec. 4.2,PDF pp. 7–8)
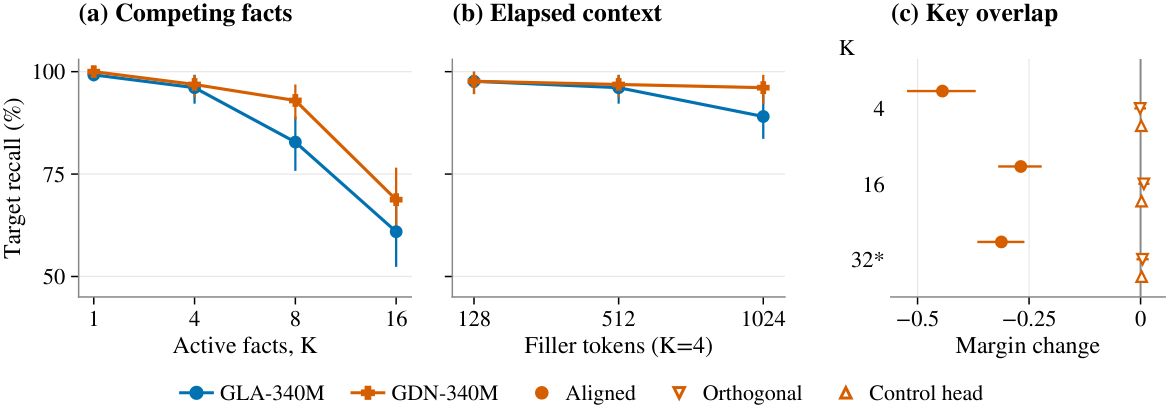
原文图 7,PDF p. 7。左图横轴是事实数,中央横轴是固定 $K=4$ 的 filler 长度,纵轴都是目标召回。右图在不同负载下比较 key 对齐、正交化和控制头操作;横轴越负,目标 margin 损害越大。$K=32$ 使用单独的高负载布局。
写入几何。 作者保持后续干扰 token 的 write key 范数和其余更新设定,把该 key 对齐到目标事实的写入方向。目标 margin 下降约 0.27–0.44 logit;正交化和控制头对齐的平均效应接近零。这在数量之外识别出一个因果因素:哪些新写入与旧记忆方向重叠。
三种能力分开退化。 图 8 同时看 clean recall、目标编辑强度和非目标误伤:
- $K=32$ 时,GLA-340M 和 GDN-340M 的 clean recall 分别约为 47%、60%,GDN-1.3B 约为 69%。
- 随负载增加,目标编辑的 donor-margin shift 大约减半或更多;GLA 某些高负载编辑点没有评估,不能补成零。
- 两个 GDN 模型到 $K=32$ 的非目标 break rate 仍低于 2%。GLA 的误伤明显更高,在约 5% 参考线附近或上方波动。
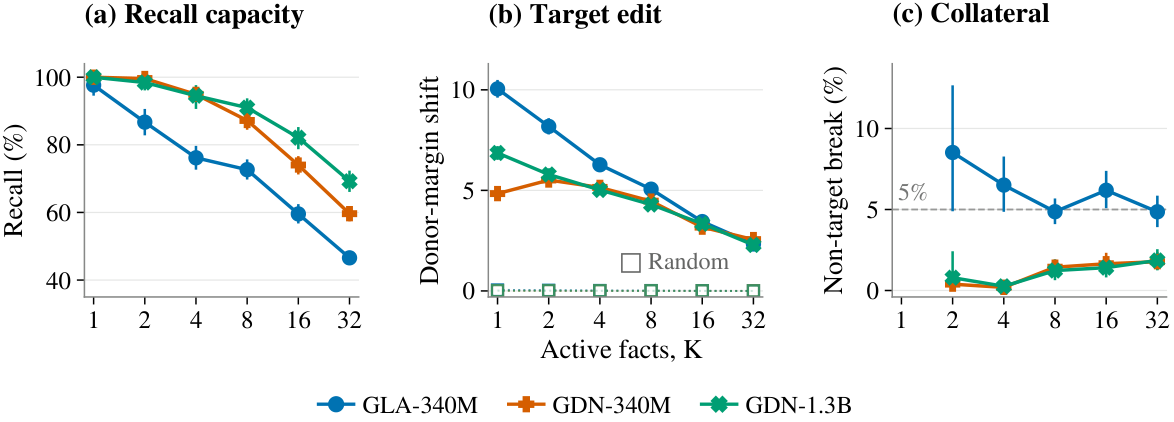
原文图 8,PDF p. 8。三面板横轴均为事实数,纵轴分别为准确率、donor-margin shift、误伤率;随机更新为虚线/空心控制,右图水平虚线是作者选定的 5% 准则。
此处应保留两点图文区别。 正文称 GLA 从低负载开始“超过 5%”,但图 8(c) 在 $K=8,32$ 的点估计略低于 5% 线,且误差条跨线;更准确的表述是 GLA 误伤较高,而非每个负载都超过阈值。另一个区别是图 5 的 $K=4$ GLA 误伤为 1.42%,图 8 的 $K=4$ 点则明显更高;同为 $K=4$ 不代表两图属于同一干预及样本口径,现有描述不足以把两者合并成一条曲线。
作者提出 GDN 按已有内容写入修正,可能缓解累积串扰。这是有机制直觉的解释,但两类 checkpoint 还同时存在状态维度、参数量和训练上的差异;当前结果没有单独识别 delta rule 的净贡献。实际评估时必须同时看“还能记住多少”“目标改动还有效吗”“误伤多少”:目标编辑已变弱时,误伤低本身并不代表编辑成功。
4.6 附录如何补强及限定主线
C:高影响头在留出集仍突出,但全头写/读排名只弱相关。 在 32 个新来源上扫描两个 340M 模型的全部 96 头,选中的头在 fact-time write 与 pre-query state 两种干预中都排名第一,bootstrap 排名区间均为 $[1,1]$。同时超过 0.25-logit 阈值的头只有 GLA 的 1.0%、GDN 的 3.1%。然而全头写/读 Spearman 相关仅为 0.173(95% CI:−0.014–0.320)和 0.149(−0.027–0.285)。局部枢纽吻合,不代表所有头写入重要性与读取重要性都一致。(图 10,PDF p. 16)
逐层 logit lens 在独立 128 来源确认集上显示:GLA 第 21 层循环子层前后,retention 的四选一读出从 28.9% 升至 95.3%;GDN 第 20 层从 25.8% 升至 100%。三次更新任务仍在相同层出现跃升,分别增加 28.9、43.0 个百分点。它定位的是答案在残差流中变得容易被 LM head 读出的层,不能据此认定答案信息此前不存在。(图 11,PDF p. 17)
D.1:中性反事实可选择性压制一个关联。 将目标事实所有出现替换为等长度的自然 filler,跑出“中性”状态,再只把选中头的查询前状态换入原执行:GLA 的目标准确率从 91.8% 降至 7.6%,GDN 从 96.1% 降至 37.1%;其余三事实的平均准确率反而分别增加 2.15、1.11 个百分点。非目标 margin 仍有变化,也有少量原本正确的 GLA 答案被破坏,说明平均准确率能掩盖个体效应。这种操作需要知道并重写目标事实的反事实上下文,是诊断性实验,不提供保证删除或遗忘的实用接口。(图 12,PDF p. 17)
D.2:同一个头可复用,但语义方向随任务变。 固定同一头,改变绑定数、标点模板、value 词表或要求读取更新后的值,GLA 的 qualified donor-answer rate 至少为 89.7%,GDN 为 46.8%–91.9%。探索性的 32 来源实验中,从颜色学得的 rank-4 输出基可转移颜色效应,却在两模型中都不能产生形状 donor 答案;形状效应主要出现在展示的 rank-8 正交分量。因而“头可复用”不等于“存在固定的答案语义子空间”。这里的 qualified rate 也不应直接与图 5 的总体 donor 比例比较。(图 13,PDF p. 18)
E.2:集中读出不等于所有模型都只靠一个头。 在新 checkpoint 上,先用 32 开发来源固定全组件排序,再在 64 测试来源联合替换 top-$k$;用联合实测避免假设效应可加。
| Checkpoint / 条件 | 单个领先组件恢复的完整效应 | 多组件结果 |
|---|---|---|
| GLA-340M,compact 输入 | 94.7% | 近乎 top-1 主导 |
| GLA-7B,compact 输入 | 12.3% | top-16 为 92.3% |
| RWKV7-2.9B,naturalized 输入 | 正文未给精确 top-1 数 | top-32 为 97.8% |
| RWKV7-13.3B,naturalized 输入 | 53.1% | top-32 为 91.6% |
来源:附录 E.2,PDF pp. 19–20,图 14。GLA-7B 的一个可干预状态组由四个 query 头共享,所以“组件”不能一律读成一个 query 头。在新的格式匹配样本组上,RWKV7-13.3B 的冻结 top-1 在 compact 格式恢复 7.5%,naturalized 格式恢复 54.8%。这组数与上表的 53.1% 来自不同 cohort。规模、架构、训练和输入格式共同变化,不能推导“模型越大,记忆越分散”的单调规律;该补充实验也只检验查询前读出集中度。
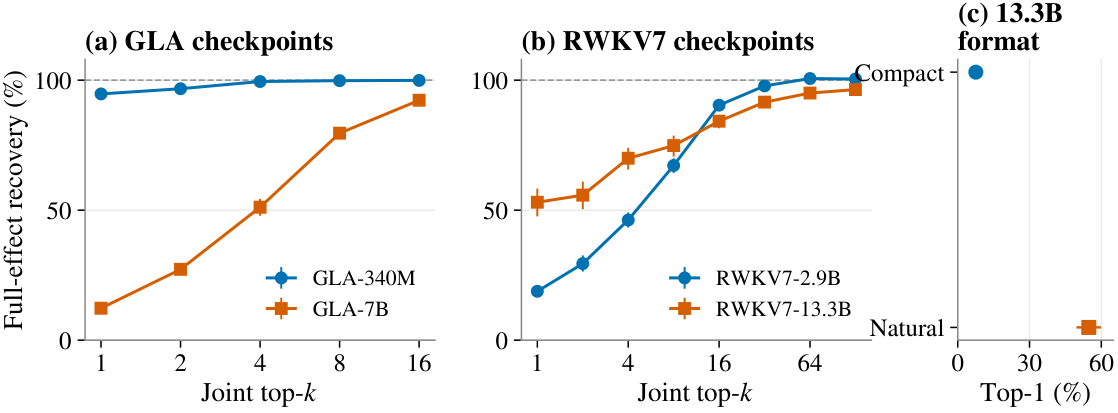
原文图 14,PDF p. 20。左、中图横轴是联合替换的 top-$k$ 组件数,纵轴是完整 donor 效应的恢复比例;右图在新 cohort 比较 13.3B 的两种输入格式。
F.1:部分错误仍可从状态特征中补救,但收益依赖模型。 在来源分离的数据上训练纠错器,将原始四选一 logits 与 query-aligned 状态特征结合,冻结后评估:
| 设置 | 原始准确率 → 纠错后 | 救回的错误 / 破坏的原正确项 |
|---|---|---|
| GLA colors | 24.2% → 52.3% | 64 / 28 |
| GLA shapes,且模板与来源范围变化 | 30.5% → 49.2% | 53 / 29 |
| GDN colors | 46.9% → 48.4% | 29 / 27 |
| Qwen3.5-4B 的循环特征 | 78.9% → 46.9% | 8 / 49 |
来源:图 15,PDF p. 20;附录 F.1,PDF pp. 20–21。GLA 结果支持某些原生读出失败仍保留有用状态信息;GDN 的变化很小,Qwen 反而明显下降,不能把这项诊断包装成通用的解码增强方法。
F.2:自然语句检索的推广遇到基础能力门槛。 作者构造含一个局部证据句、31 个单 token 城市身份、两种固定问法的任务,要求 recipient 与 donor 都先达到 80% 的全词表 top-1 准确率,再做因果分析。
| Filler 长度 | Recipient | Donor | 移除证据后 |
|---|---|---|---|
| 512 token | 56.3% | 53.1% | 0.0% |
| 128 token | 71.9% | 68.8% | 3.1% |
来源:表 3,PDF p. 21;32 个 source family,指标要求同时满足两个问法。两个配置都没有达到预设门槛,因此作者没有继续执行 write/state/read 干预。这个结果具体限制了纯循环模型主线向自然语句检索的推广;它与 Qwen 混合模型表 2 的自然任务成功属于不同模型和不同实验。
五:结论——怎样使用这篇论文的认识
本文把固定大小循环记忆刻画为有结构、可选择访问、但内部耦合的共享状态。核心证据来自互相衔接的写入替换、状态替换和输出恢复,以及跨事实分量与后续 key 重叠的干预。它最有价值的地方,是将最终答错拆解为可能不同的原因:旧信息的保留受损、查询访问路径不合适、目标编辑强度下降,或多个事实之间的干扰。
对于架构设计,本次分析得到三条具体启发。第一,评测记忆时应把事实负载和 token 距离分开控制;只做长距离单针检索容易低估共享状态中的竞争。第二,讨论 delta rule、分区记忆或选择性写入时,应匹配状态容量及训练预算,再判断哪种更新机制改善了干扰。第三,混合模型的系统优化需要分别衡量“形成记忆的计算”与“查询时直接承载身份的缓存”,不能只凭查询前 cache swap 就取消前面的循环计算。
作者提出选择性门控、刷新、分区,以及循环状态与 KV 之间的动态分工,作为后续方向。要把这些方向变成实用记忆管理,还需要不依赖 oracle donor 的操作、自然任务中足够的基础能力,以及同时报告保留、目标改动和误伤的评价。当前论文没有提供从任意总状态唯一找回或删掉某个 token 贡献的方法。
对论文结论的把握应以经过验证的范围为准:主干完整生命周期证据来自特定 GLA/GDN checkpoint 的受控关联召回;更多模型支持读出集中现象,但集中程度和任务格式相关;混合模型直接缓存载体的结论较稳定,却不是严格控制训练的架构因果对照。v1 的选头公式、混合层比例和 GLA 阈值措辞存在上述局部不一致,复现时应逐一澄清。